Zielbild und Publikum

Visualisierung
Kommunikation
R
Python
Zweck, Publikum und der Unterschied zwischen explorativ und erklärend.

Kernideen

  • Vor dem Diagrammtyp steht die Frage, welche Entscheidung die Grafik stützen soll.
  • Explorativ und erklärend sind zwei verschiedene Aufgaben mit verschiedenen Regeln und beim Explorieren entstehen zwangsläufig Scheinbefunde.
  • Das Publikum entscheidet über Vorwissen, Detailtiefe und Fachbegriffe.
  • Eine Grafik ohne Aussage ist eine Ausgabe, keine Darstellung.
  • Misslungen ist nicht gleich misslungen: hässlich, schlecht gelesen oder schlicht falsch, mit sehr verschiedener Dringlichkeit.
  • Der Titel trägt die Aussage, nicht die Beschreibung der Achsen, aber nur, wenn die Daten die Aussage decken.

Erklärung

Diese Seite steht bewusst vor den Werkzeugen. Was danach kommt, ist die Wahrnehmung und daraus die Wahl des Diagrammtyps.

Die Frage vor der Grafik

Jede brauchbare Visualisierung beginnt mit einem Satz, der nichts mit Diagrammen zu tun hat: Welche Entscheidung soll gestützt werden, und wer trifft sie? Erst daraus folgt, was gezeigt werden muss, wie genau es ablesbar sein muss und was weggelassen werden darf.

Ohne diesen Satz entsteht die häufigste Sorte Grafik: technisch korrekt, hübsch, und niemand weiss, was er damit tun soll.

Drei Fragen genügen als Vorbereitung:

  1. Entscheidung: Was soll jemand nach dem Ansehen anders machen als vorher?
  2. Publikum: Wer sieht die Grafik, mit welchem Vorwissen, in welcher Situation, mit wie viel Zeit?
  3. Aussage: Welcher Satz steht am Ende darüber? Wenn er nicht formulierbar ist, fehlt noch etwas.

Derselbe Datensatz trägt dabei verschiedene Aussagen, und jede verlangt eine andere Grafik, Beispiel 1 zeigt drei davon.

Explorativ oder erklärend

Das ist der Unterschied, der am häufigsten übersehen wird, weil beide Sorten gleich aussehen können.

Explorativ Erklärend
Zweck selbst verstehen, Muster finden anderen etwas zeigen
Publikum man selbst jemand anderes
Anzahl viele, schnell, wegwerfbar wenige, sorgfältig
Beschriftung minimal, man kennt die Daten vollständig, mit Einheit und Quelle
Auswahl alles ansehen, auch Sackgassen eine Aussage, alles andere weg
Zeitbudget je Grafik Sekunden Stunden

Der teure Fehler ist, eine explorative Grafik unverändert in einen Bericht zu übernehmen. Sie ist für jemanden gemacht, der die Daten bereits kennt, und lässt das Publikum genau die Arbeit tun, die man ihm hätte abnehmen sollen.

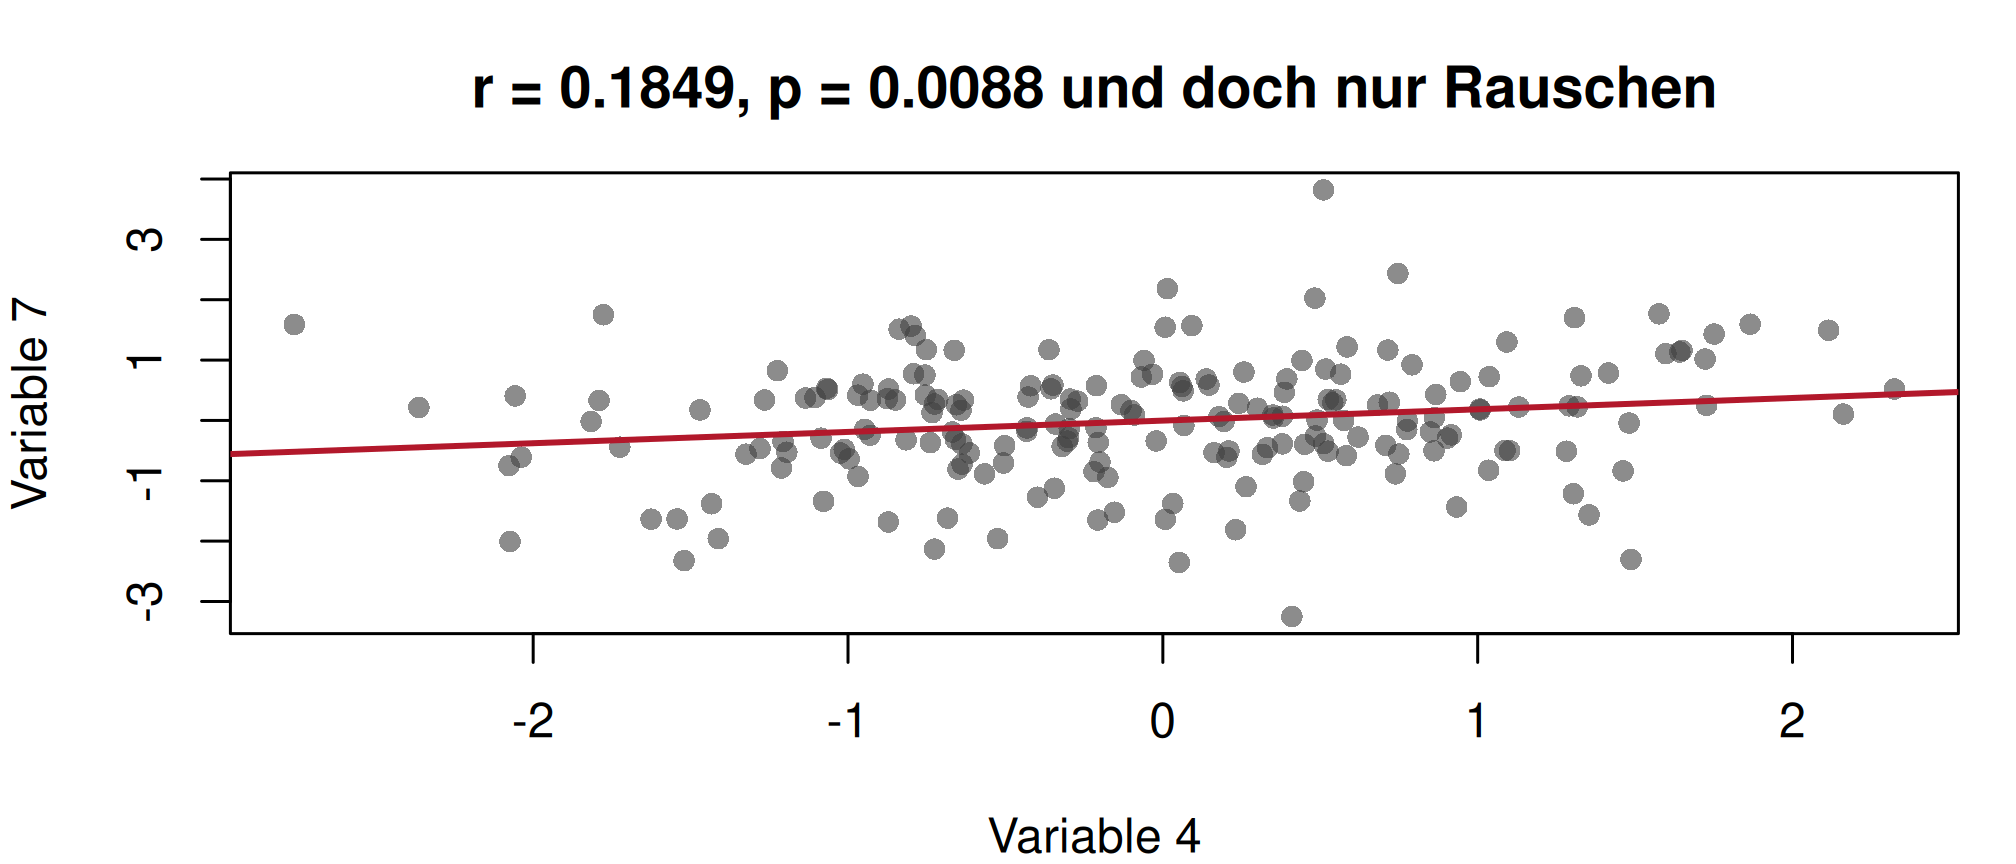
Dazu kommt ein zweiter, weniger bekannter Grund: Beim Explorieren sieht man viele Grafiken, und einige davon zeigen ein Muster, das nur Rauschen ist. Beispiel 2 zählt nach, wie viele.

Das Publikum kennen heisst drei Dinge festlegen

  • Vorwissen: Welche Begriffe sind bekannt? Ein Boxplot ist für Fachleute ein Standard und für viele andere ein Rätsel.
  • Detailtiefe: Braucht das Publikum den einzelnen Wert oder das Muster? Ein Vorstand liest keine Tabelle mit 40 Zeilen, eine Fachgruppe schon.
  • Situation: Wird die Grafik projiziert, gedruckt, am Bildschirm gelesen? Davon hängen Schriftgrösse, Anzahl Elemente und Farbwahl ab.

Hässlich, schlecht gelesen, falsch

Nicht jede misslungene Grafik ist auf dieselbe Weise misslungen, und die Unterscheidung bestimmt, wie dringend die Korrektur ist.

Art Was passiert Beispiel Dringlichkeit
Hässlich korrekt und lesbar, aber ungestaltet Standarddiagramm mit Gitterlinien und Legende in Grau kosmetisch
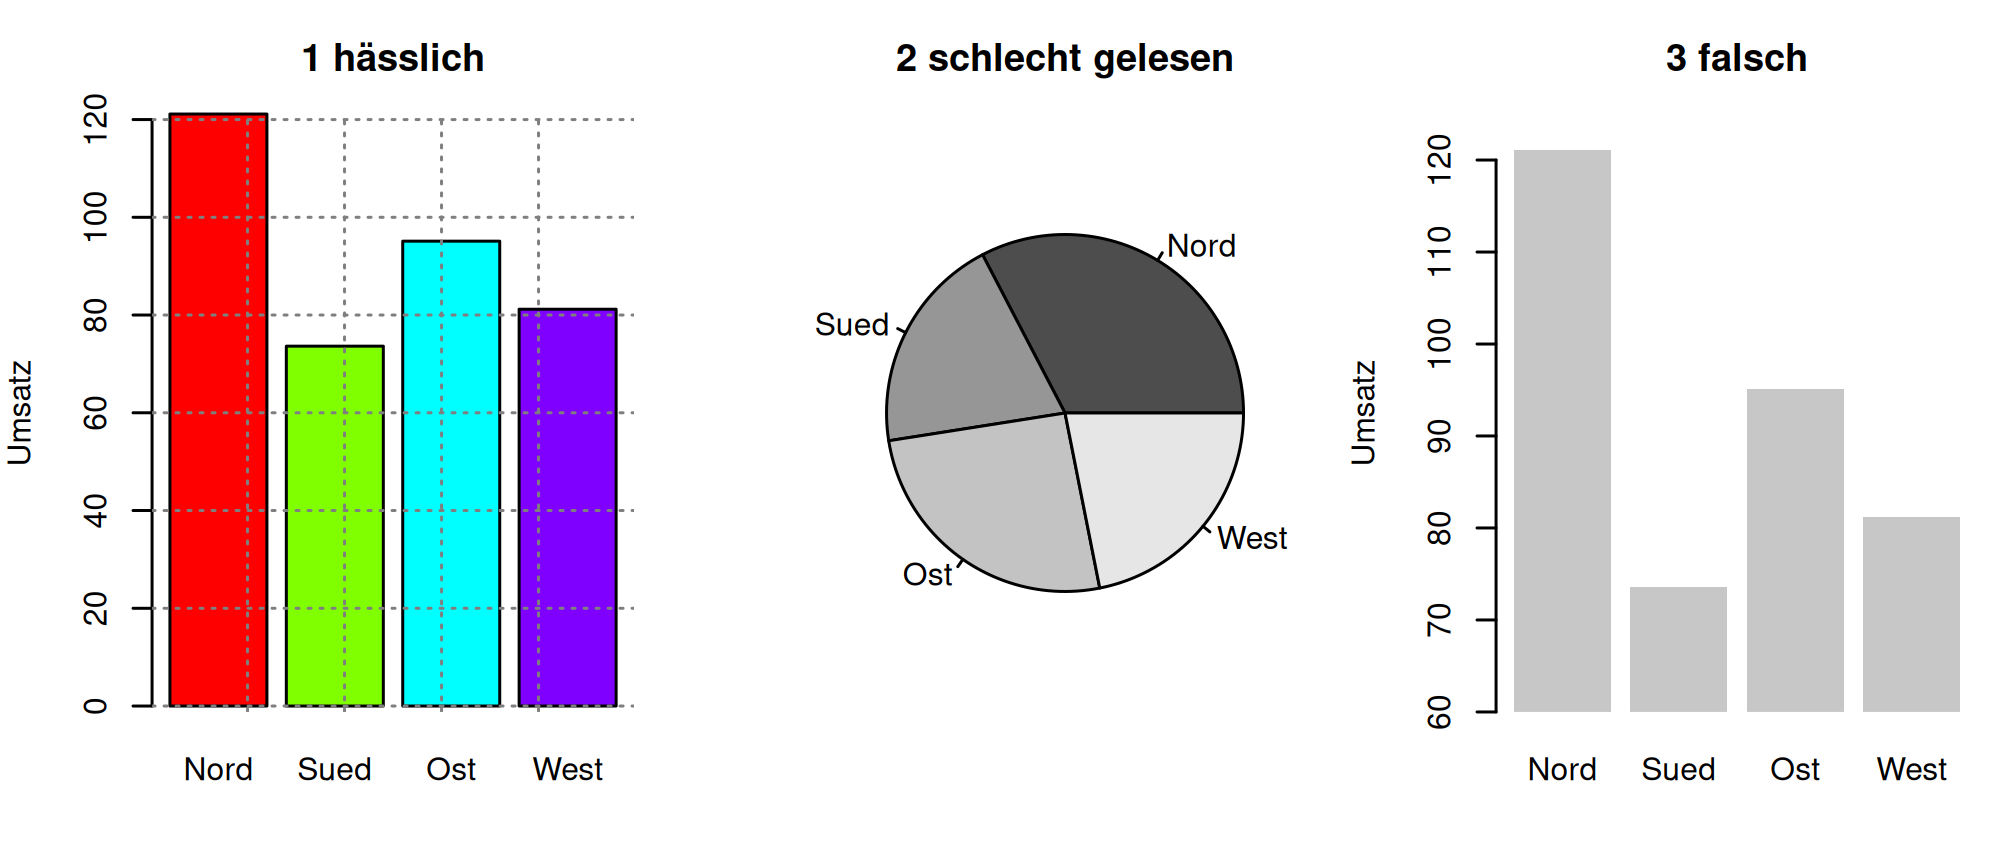
Schlecht gelesen korrekt, aber die Wahrnehmung liest es falsch oder mühsam Tortendiagramm mit zwölf Segmenten, dreidimensionale Säulen ernst, weil das Publikum sich täuscht
Falsch die Zahlen, die Skalierung oder die Geometrie stimmen nicht Balkenachse beginnt bei 90, Fläche nach dem Radius skaliert sofort, denn die Aussage ist unwahr

Die mittlere Kategorie ist die gefährlichste, weil sie unauffällig ist: Es steht nichts Falsches da, und trotzdem nimmt das Publikum etwas Falsches mit. Die Beispiele dazu stehen unter irreführende Darstellungen.

Der Titel gehört der Aussage

Ein Titel wie “Umsatz nach Region 2026” beschreibt, was zu sehen ist, und verschenkt die wirksamste Zeile der Grafik. Wer stattdessen die Aussage hinschreibt, nimmt dem Publikum die Deutungsarbeit ab:

Statt Besser
“Umsatz nach Region 2026” “Der Umsatz wächst nur im Süden”
“Ausschussquote je Maschine” “Maschine 3 verursacht zwei Drittel des Ausschusses”
“Antwortzeiten” “Seit dem Update antwortet das System doppelt so schnell”

Die Bedingung dafür ist, dass die Aussage stimmt und die Grafik sie trägt. Ein Aussagetitel über einer Grafik, die etwas anderes zeigt, ist schlimmer als ein beschreibender, Beispiel 3 prüft drei Titel gegen dieselben Daten.

Beispiele

Frage und Datenlage

Vier Regionen über 24 Monate. Drei verschiedene Entscheidungen wollen gestützt werden und jede braucht eine andere Grafik, obwohl die Daten dieselben sind.

Rechnung

regionen <- c("Nord", "Sued", "Ost", "West")
Z <- normalmatrix(4711, 4, 24)
zeit <- 0:23
niveau <- c(120, 60, 95, 80)
trend <- c(0.0, 1.2, -0.15, 0.1)
daten <- niveau + trend %o% zeit + Z * 6   # 4 Zeilen, 24 Spalten

kennzahlen <- t(sapply(1:4, function(i) {
  y <- daten[i, ]
  m <- lm(y ~ zeit)
  c(mittel = mean(y), sd = sd(y), steigung = unname(coef(m)[2]))
}))
rownames(kennzahlen) <- regionen
round(kennzahlen, 3)
      mittel    sd steigung
Nord 121.126 5.197    0.084
Sued  73.634 9.747    1.258
Ost   95.110 6.436   -0.197
West  81.192 6.682   -0.208
round(c(groesste_region_mittel = max(kennzahlen[, "mittel"]),
        anteil_sued_monat_1 = daten[2, 1] / sum(daten[, 1]) * 100,
        anteil_sued_monat_24 = daten[2, 24] / sum(daten[, 24]) * 100), 1)
groesste_region_mittel    anteil_sued_monat_1   anteil_sued_monat_24 
                 121.1                   16.6                   24.3 
par(mfrow = c(1, 3), mar = c(4, 4, 3, 1))
# Aussage 1: Wer ist am groessten?
barplot(sort(kennzahlen[, "mittel"]), horiz = TRUE, las = 1, col = neutral,
        border = NA, main = "1: Wer ist am grössten?", xlab = "Umsatz")
# Aussage 2: Wer waechst?
matplot(zeit, t(daten), type = "l", lty = 1, lwd = 1.6,
        col = c(neutral, akzent, neutral, neutral),
        xlab = "Monat", ylab = "Umsatz", main = "2: Wer wächst?")
# Aussage 3: Wie verschiebt sich der Anteil?
anteile <- prop.table(daten, margin = 2) * 100
plot(zeit, anteile[2, ], type = "l", lwd = 2, col = akzent, ylim = c(0, 40),
     xlab = "Monat", ylab = "Anteil Süd in Prozent",
     main = "3: Wie verschiebt sich der Anteil?")
par(mfrow = c(1, 1))
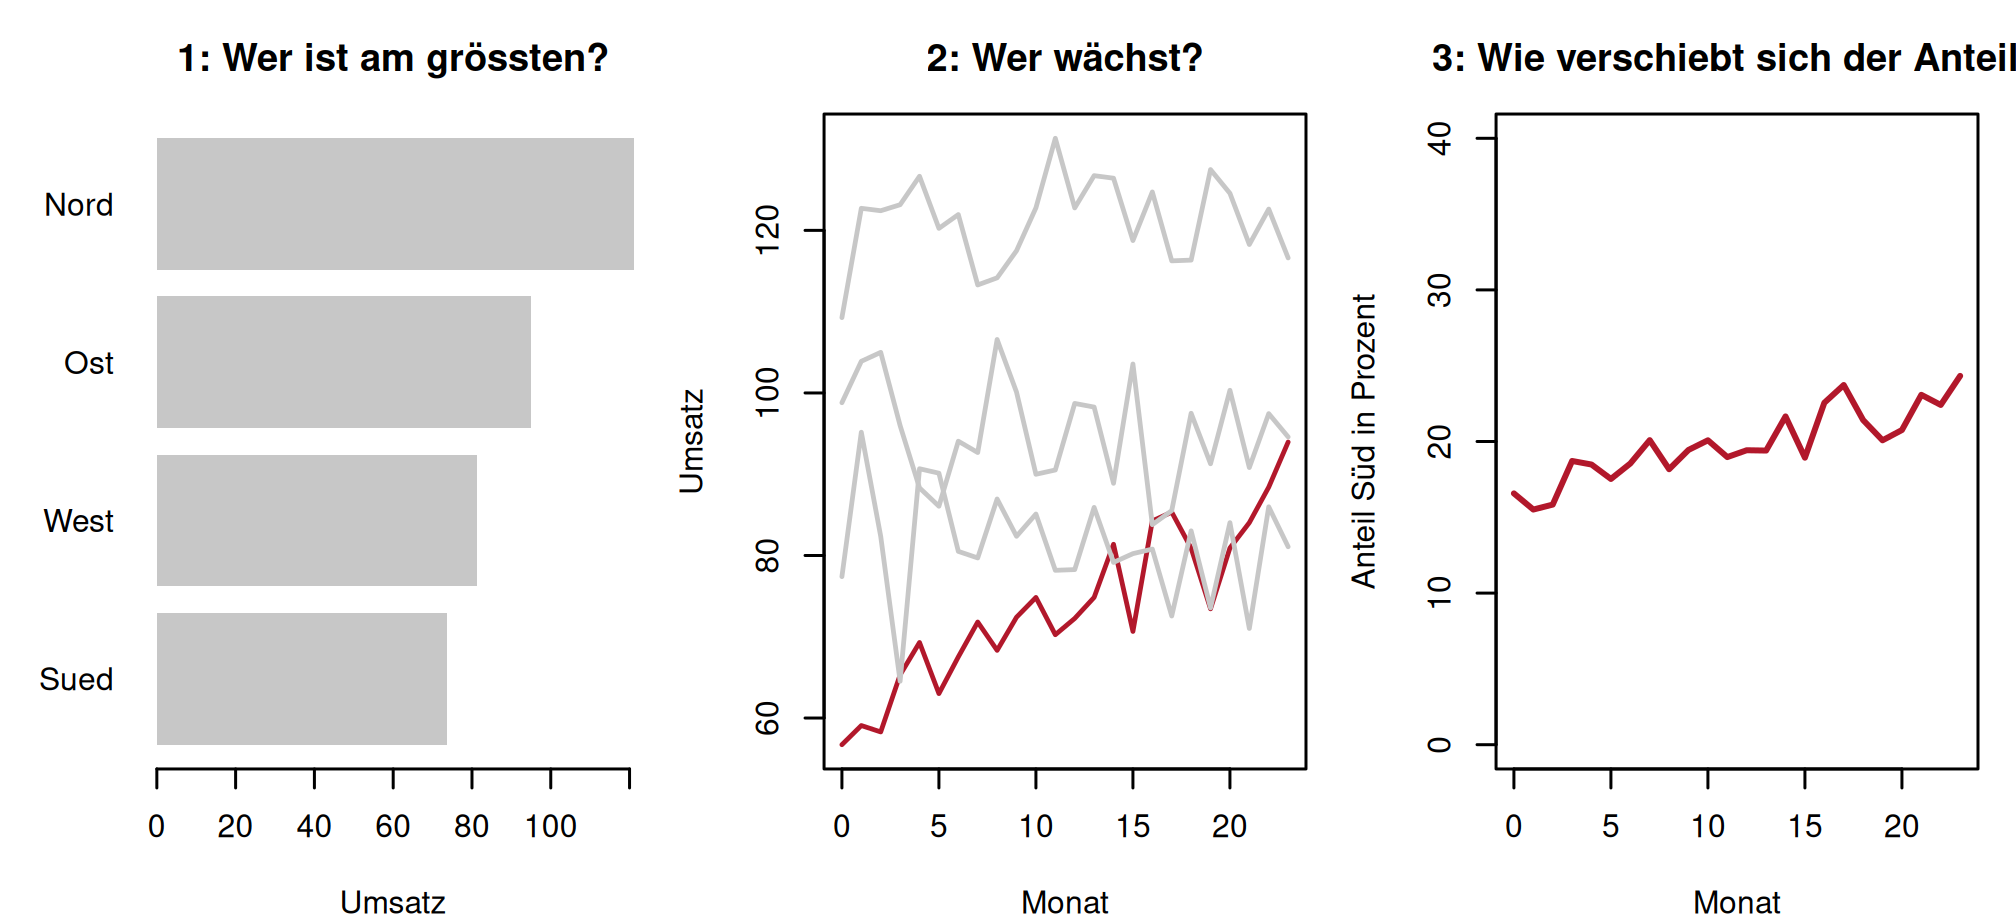
Abbildung 1: Beispiel 1: dieselben Daten für drei Aussagen.
regionen = ["Nord", "Sued", "Ost", "West"]
Z = normalmatrix(4711, 4, 24)
zeit = np.arange(24)
niveau = np.array([120., 60., 95., 80.])
trend = np.array([0.0, 1.2, -0.15, 0.1])
daten = niveau[:, None] + trend[:, None] * zeit + Z * 6

kennzahlen = pd.DataFrame(
    [{"mittel": daten[i].mean(), "sd": daten[i].std(ddof=1),
      "steigung": np.polyfit(zeit, daten[i], 1)[0]} for i in range(4)],
    index=regionen)
print(kennzahlen.round(3))
       mittel     sd  steigung
Nord  121.126  5.197     0.084
Sued   73.634  9.747     1.258
Ost    95.110  6.436    -0.197
West   81.192  6.682    -0.208
print({"groesste_region_mittel": round(float(kennzahlen["mittel"].max()), 1),
       "anteil_sued_monat_1": round(float(daten[1, 0] / daten[:, 0].sum() * 100), 1),
       "anteil_sued_monat_24": round(float(daten[1, -1] / daten[:, -1].sum() * 100), 1)})
{'groesste_region_mittel': 121.1, 'anteil_sued_monat_1': 16.6, 'anteil_sued_monat_24': 24.3}
anteile = daten / daten.sum(axis=0) * 100

fig, achsen = plt.subplots(1, 3, figsize=(7, 3.2))
sortiert = kennzahlen["mittel"].sort_values()
_ = achsen[0].barh(sortiert.index, sortiert.to_numpy(), color=NEUTRAL)
_ = achsen[0].set_title("1: Wer ist am grössten?", fontsize=10)
_ = achsen[0].set_xlabel("Umsatz")
for i in range(4):
    _ = achsen[1].plot(zeit, daten[i], lw=1.6,
                       color=AKZENT if i == 1 else NEUTRAL)
_ = achsen[1].set_title("2: Wer wächst?", fontsize=10)
_ = achsen[1].set_xlabel("Monat")
_ = achsen[1].set_ylabel("Umsatz")
_ = achsen[2].plot(zeit, anteile[1], lw=2, color=AKZENT)
_ = achsen[2].set_ylim(0, 40)
_ = achsen[2].set_title("3: Wie verschiebt sich der Anteil?", fontsize=10)
_ = achsen[2].set_xlabel("Monat")
_ = achsen[2].set_ylabel("Anteil Süd in Prozent")
plt.tight_layout()
plt.show()
Abbildung 2: Beispiel 1: dieselben drei Grafiken in Python.

Output Zeile für Zeile

Region Mittel SD Steigung je Monat
Nord 121.1 5.20 +0.084
Sued 73.6 9.75 +1.258
Ost 95.1 6.44 −0.197
West 81.2 6.68 −0.208
Aussage Kennzahl Passende Grafik
“Nord ist die grösste Region” Mittel 121.1 gegen 73.6 bis 95.1 sortierter Balken
“Nur der Süden wächst” Steigung +1.258 gegen −0.21 bis +0.08 Linien, Süd hervorgehoben
“Der Süden holt auf” Anteil von 16.6 auf 24.3 Prozent eine Linie, der Anteil
Beobachtung Erklärung
Alle drei Aussagen stimmen Und sie stehen nicht im Widerspruch. Nord ist gross und wächst nicht, Süd ist klein und wächst.
Jede braucht eine andere Grafik Der sortierte Balken zeigt die erste und verbirgt die zweite, weil er die Zeit wegmittelt. Die Liniengrafik zeigt die zweite und macht die erste mühsam. Die Anteilskurve zeigt die dritte und keine der beiden anderen.
Die dritte Grafik enthält eine einzige Linie Aus 96 Zahlen wird eine Kurve mit 24 Punkten. Das ist keine Verarmung, sondern die Antwort auf die gestellte Frage.
Ohne die Frage gäbe es keinen Grund, eine davon zu wählen Genau deshalb steht die Frage vor der Grafik und nicht danach.
Die Alternative wäre, alle drei zu zeigen Zulässig, wenn wirklich drei Entscheidungen anstehen. Meistens steht aber eine an, und die anderen zwei kosten nur Aufmerksamkeit.

Die Probe: Wenn sich der Titel der Grafik nicht ändert, sobald man die Grafik austauscht, war der Titel nie eine Aussage. “Umsatz nach Region” passt über alle drei Bilder und sagt bei keinem, was zu sehen ist.

Interpretation und Ergebnissatz

Aus denselben 96 Werten folgen drei zutreffende Aussagen: Nord ist mit einem Mittel von 121.1 die grösste Region, Süd wächst als einzige mit +1.258 je Monat, und Süds Anteil steigt von 16.6 auf 24.3 Prozent. Jede verlangt eine andere Grafik.

Frage und Datenlage

Zehn Variablen, 200 Beobachtungen, alle voneinander unabhängig erzeugt. Wer sie explorativ paarweise ansieht, betrachtet 45 Streudiagramme. Wie viele davon zeigen ein Muster?

Rechnung

p_var <- 10; n <- 200
X <- normalmatrix(1234, p_var, n)

paare <- t(combn(p_var, 2))
ergebnis <- data.frame(
  a = paare[, 1], b = paare[, 2],
  r = apply(paare, 1, function(k) cor(X[k[1], ], X[k[2], ])))
ergebnis$p <- 2 * pt(abs(ergebnis$r) * sqrt((n - 2) / (1 - ergebnis$r^2)),
                     n - 2, lower.tail = FALSE)

c(variablen = p_var, paare = nrow(ergebnis), beobachtungen = n)
    variablen         paare beobachtungen 
           10            45           200 
round(c(signifikant_bei_0.05 = sum(ergebnis$p < 0.05),
        erwartet = nrow(ergebnis) * 0.05,
        bonferroni_schwelle = 0.05 / nrow(ergebnis),
        signifikant_nach_bonferroni = sum(ergebnis$p < 0.05 / nrow(ergebnis))), 5)
       signifikant_bei_0.05                    erwartet 
                    3.00000                     2.25000 
        bonferroni_schwelle signifikant_nach_bonferroni 
                    0.00111                     0.00000 
bestes <- ergebnis[which.max(abs(ergebnis$r)), ]
round(bestes, 4)
   a b      r      p
27 4 7 0.1849 0.0088
par(mar = c(4, 4, 3, 1))
plot(X[bestes$a, ], X[bestes$b, ], pch = 16, col = adjustcolor("grey25", 0.6),
     xlab = paste("Variable", bestes$a), ylab = paste("Variable", bestes$b),
     main = sprintf("r = %.4f, p = %.4f und doch nur Rauschen",
                    bestes$r, bestes$p))
abline(lm(X[bestes$b, ] ~ X[bestes$a, ]), lwd = 2, col = akzent)
Abbildung 3: Beispiel 2: das auffälligste der 45 Paare, reines Rauschen.
p_var, n = 10, 200
X = normalmatrix(1234, p_var, n)

paare = list(itertools.combinations(range(p_var), 2))
ergebnis = pd.DataFrame([{"a": i + 1, "b": j + 1,
                          "r": np.corrcoef(X[i], X[j])[0, 1]}
                         for i, j in paare])
ergebnis["p"] = 2 * stats.t.sf(
    ergebnis["r"].abs() * np.sqrt((n - 2) / (1 - ergebnis["r"] ** 2)), n - 2)

print({"variablen": p_var, "paare": len(ergebnis), "beobachtungen": n})
print({"signifikant_bei_0.05": int((ergebnis["p"] < 0.05).sum()),
       "erwartet": len(ergebnis) * 0.05,
       "bonferroni_schwelle": round(0.05 / len(ergebnis), 5),
       "signifikant_nach_bonferroni":
           int((ergebnis["p"] < 0.05 / len(ergebnis)).sum())})

bestes = ergebnis.loc[ergebnis["r"].abs().idxmax()]
print(bestes.round(4))

i, j = int(bestes["a"]) - 1, int(bestes["b"]) - 1
fig, achse = plt.subplots(figsize=(7, 3))
_ = achse.scatter(X[i], X[j], s=14, color="0.25", alpha=0.6)
k, d = np.polyfit(X[i], X[j], 1)
gitter = np.linspace(X[i].min(), X[i].max(), 2)
_ = achse.plot(gitter, k * gitter + d, lw=2, color=AKZENT)
_ = achse.set_xlabel(f"Variable {i + 1}")
_ = achse.set_ylabel(f"Variable {j + 1}")
_ = achse.set_title(f"r = {bestes['r']:.4f}, p = {bestes['p']:.4f}"
                    " und doch nur Rauschen")
plt.tight_layout()
plt.show()
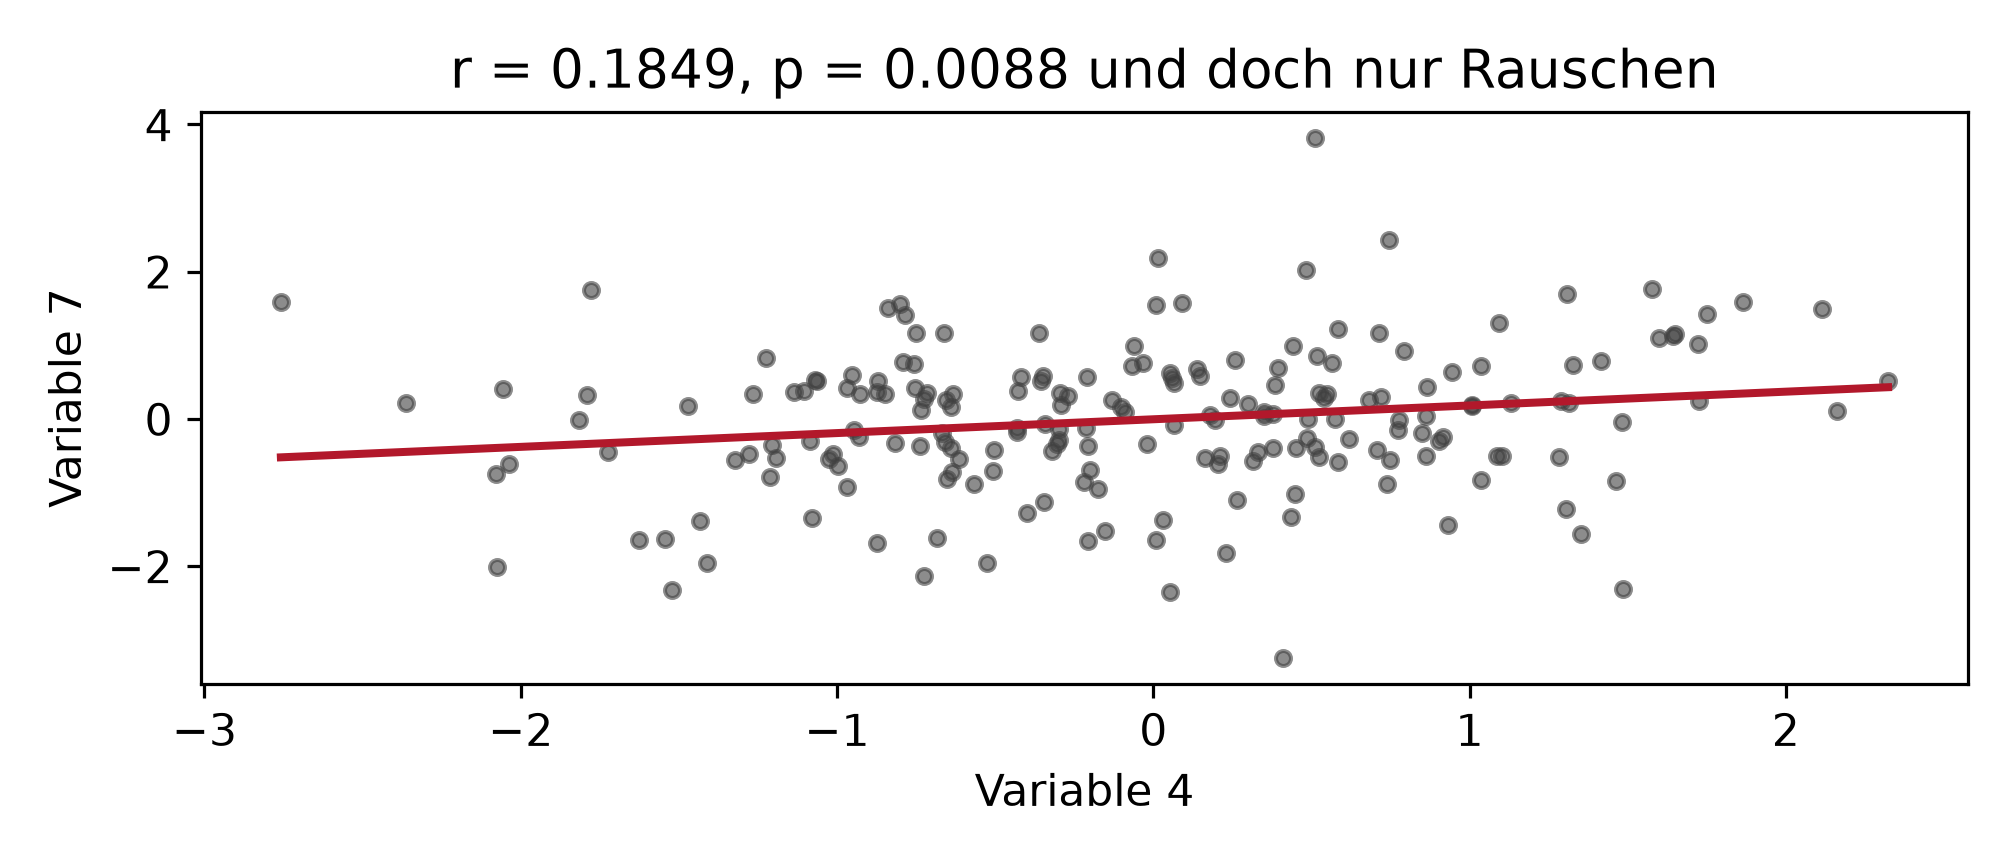
Abbildung 4: Beispiel 2: dasselbe Paar in Python.

Output Zeile für Zeile

Grösse Wert
Variablen 10
paarweise Streudiagramme 45
Beobachtungen je Variable 200
Paare mit p < 0.05 3
davon zu erwarten 2.25
Bonferroni-Schwelle 0.00111
Paare, die diese Schwelle unterschreiten 0

Das auffälligste Paar: Variable 4 gegen 7, r = 0.1849, p = 0.0088.

Beobachtung Erklärung
Drei von 45 Paaren sind “signifikant” Bei konstruierter Unabhängigkeit. Es gibt keinen einzigen echten Zusammenhang in diesen Daten.
Und das ist genau die Erwartung 45 × 0.05 = 2.25. Drei Treffer sind kein Ausreisser, sondern der Normalfall.
Nach Bonferroni bleibt kein einziges übrig Die Korrektur tut genau das, wofür sie da ist. Siehe multiples Testen.
Das stärkste Paar hat r = 0.1849 Im Streudiagramm mit Regressionsgerade sieht das nach einem schwachen, aber vorhandenen Zusammenhang aus. Es ist keiner.
Darum ist Explorieren keine Ergebnisproduktion Die 45 Grafiken sind richtig und nützlich, zum Suchen. Die eine, die auffiel, ist danach eine Hypothese und kein Befund.

Der Schritt, der übersprungen wird: Zwischen “beim Explorieren aufgefallen” und “steht im Bericht” gehört eine Prüfung an neuen Daten oder wenigstens die ehrliche Angabe, wie viele Grafiken angesehen wurden.

Was man sagt Was man sagen müsste
“Variable 4 und 7 hängen zusammen, p = 0.009” “Unter 45 angesehenen Paaren war dies das stärkste; nach Korrektur nicht signifikant”

Das ist derselbe Mechanismus wie beim gewählten Ausschnitt, nur dass hier nicht der Zeitraum, sondern das Variablenpaar gesucht wurde.

Interpretation und Ergebnissatz

Unter 45 paarweisen Streudiagrammen von zehn unabhängigen Variablen erreichen drei einen p-Wert unter 0.05, bei einer Erwartung von 2.25. Das stärkste Paar zeigt r = 0.1849 mit p = 0.0088 und überlebt die Bonferroni-Schwelle von 0.00111 nicht.

Frage und Datenlage

Drei Titelvorschläge für die Regionen-Grafik aus Beispiel 1. Jeder wird gegen die Daten geprüft: Steigung, Konfidenzintervall, p-Wert.

Rechnung

pruefe_trend <- function(y) {
  m <- lm(y ~ zeit)
  s <- summary(m)$coefficients[2, ]
  ki <- unname(confint(m)[2, ])   # unname: sonst heisst die Spalte "unten.2.5 %"
  c(steigung = unname(s[1]), unten = ki[1], oben = ki[2], p = unname(s[4]))
}

pruefung <- t(sapply(1:4, function(i) pruefe_trend(daten[i, ])))
rownames(pruefung) <- regionen
round(pruefung, 4)
     steigung   unten   oben      p
Nord   0.0843 -0.2386 0.4071 0.5938
Sued   1.2578  1.0085 1.5072 0.0000
Ost   -0.1967 -0.5897 0.1962 0.3104
West  -0.2083 -0.6158 0.1993 0.3008
# Deckt das Intervall die Null? Dann ist "waechst" oder "faellt" nicht belegt.
data.frame(region = regionen,
           richtung = ifelse(pruefung[, "unten"] > 0, "waechst",
                             ifelse(pruefung[, "oben"] < 0, "faellt", "nicht belegt")))
     region     richtung
Nord   Nord nicht belegt
Sued   Sued      waechst
Ost     Ost nicht belegt
West   West nicht belegt
def pruefe_trend(y):
    k, d = np.polyfit(zeit, y, 1)
    rest = y - (k * zeit + d)
    se = np.sqrt((rest ** 2).sum() / (len(zeit) - 2)
                 / ((zeit - zeit.mean()) ** 2).sum())
    rand = stats.t.ppf(.975, len(zeit) - 2) * se
    return {"steigung": k, "unten": k - rand, "oben": k + rand,
            "p": float(2 * stats.t.sf(abs(k / se), len(zeit) - 2))}


pruefung = pd.DataFrame([pruefe_trend(daten[i]) for i in range(4)],
                        index=regionen)
print(pruefung.round(4))

richtung = np.where(pruefung["unten"] > 0, "waechst",
                    np.where(pruefung["oben"] < 0, "faellt", "nicht belegt"))
print(pd.DataFrame({"region": regionen, "richtung": richtung}).to_string(index=False))

Output Zeile für Zeile

Region Steigung 95-Prozent-Intervall p Richtung belegt?
Nord +0.084 −0.239 bis +0.407 0.5938 nicht belegt
Sued +1.258 +1.008 bis +1.507 < 0.0001 wächst
Ost −0.197 −0.590 bis +0.196 0.3104 nicht belegt
West −0.208 −0.616 bis +0.199 0.3008 nicht belegt

Drei Titel, geprüft:

Titelvorschlag gedeckt? Begründung
“Umsatz nach Region, 24 Monate” beschreibend, behauptet nichts
“Nur der Süden wächst” ja Süd: Intervall über null; die drei anderen schliessen null ein
“Ost und West brechen ein” nein Steigungen −0.197 und −0.208, beide Intervalle enthalten null
Beobachtung Erklärung
Nur eine von vier Regionen hat einen belegten Trend Süd, mit einem Intervall von +1.008 bis +1.507, das die Null deutlich verfehlt.
Ost und West haben negative Steigungen −0.197 und −0.208. Wer nur die Zahl ansieht, formuliert “beide schrumpfen” und liegt daneben, weil die Intervalle von −0.59 bis +0.20 reichen.
Nord hat die kleinste Steigung von allen +0.084, und p = 0.59. Die Region ist stabil, nicht wachsend.
Der Aussagetitel ist hier möglich “Nur der Süden wächst” ist genau das, was die Prüfung ergibt, inklusive des Wörtchens “nur”.
Ohne die Prüfung wäre der Titel geraten Und mit 24 Monaten Rauschen um ±6 wäre er leicht falsch geraten. Ein Aussagetitel verpflichtet zur Rechnung.

Die drei Stufen eines Titels:

Stufe Beispiel Wann
beschreibend “Umsatz nach Region, 24 Monate” wenn die Grafik zum Nachschlagen da ist
hinweisend “Der Süden entwickelt sich anders” wenn die Richtung klar, das Ausmass aber offen ist
behauptend “Nur der Süden wächst, 1.3 Prozent je Monat” wenn die Rechnung es trägt

Nach unten wird der Titel wirksamer und riskanter. Die Zahl im Titel ist dabei kein Schmuck: Sie macht die Behauptung überprüfbar.

Interpretation und Ergebnissatz

Von vier Regionen hat nur Süd einen belegten Trend (+1.258 je Monat, Intervall +1.008 bis +1.507). Die Intervalle der drei anderen schliessen die Null ein, obwohl zwei negative Punktschätzungen haben. Der Titel “Nur der Süden wächst” ist gedeckt, “Ost und West brechen ein” ist es nicht.

Frage und Datenlage

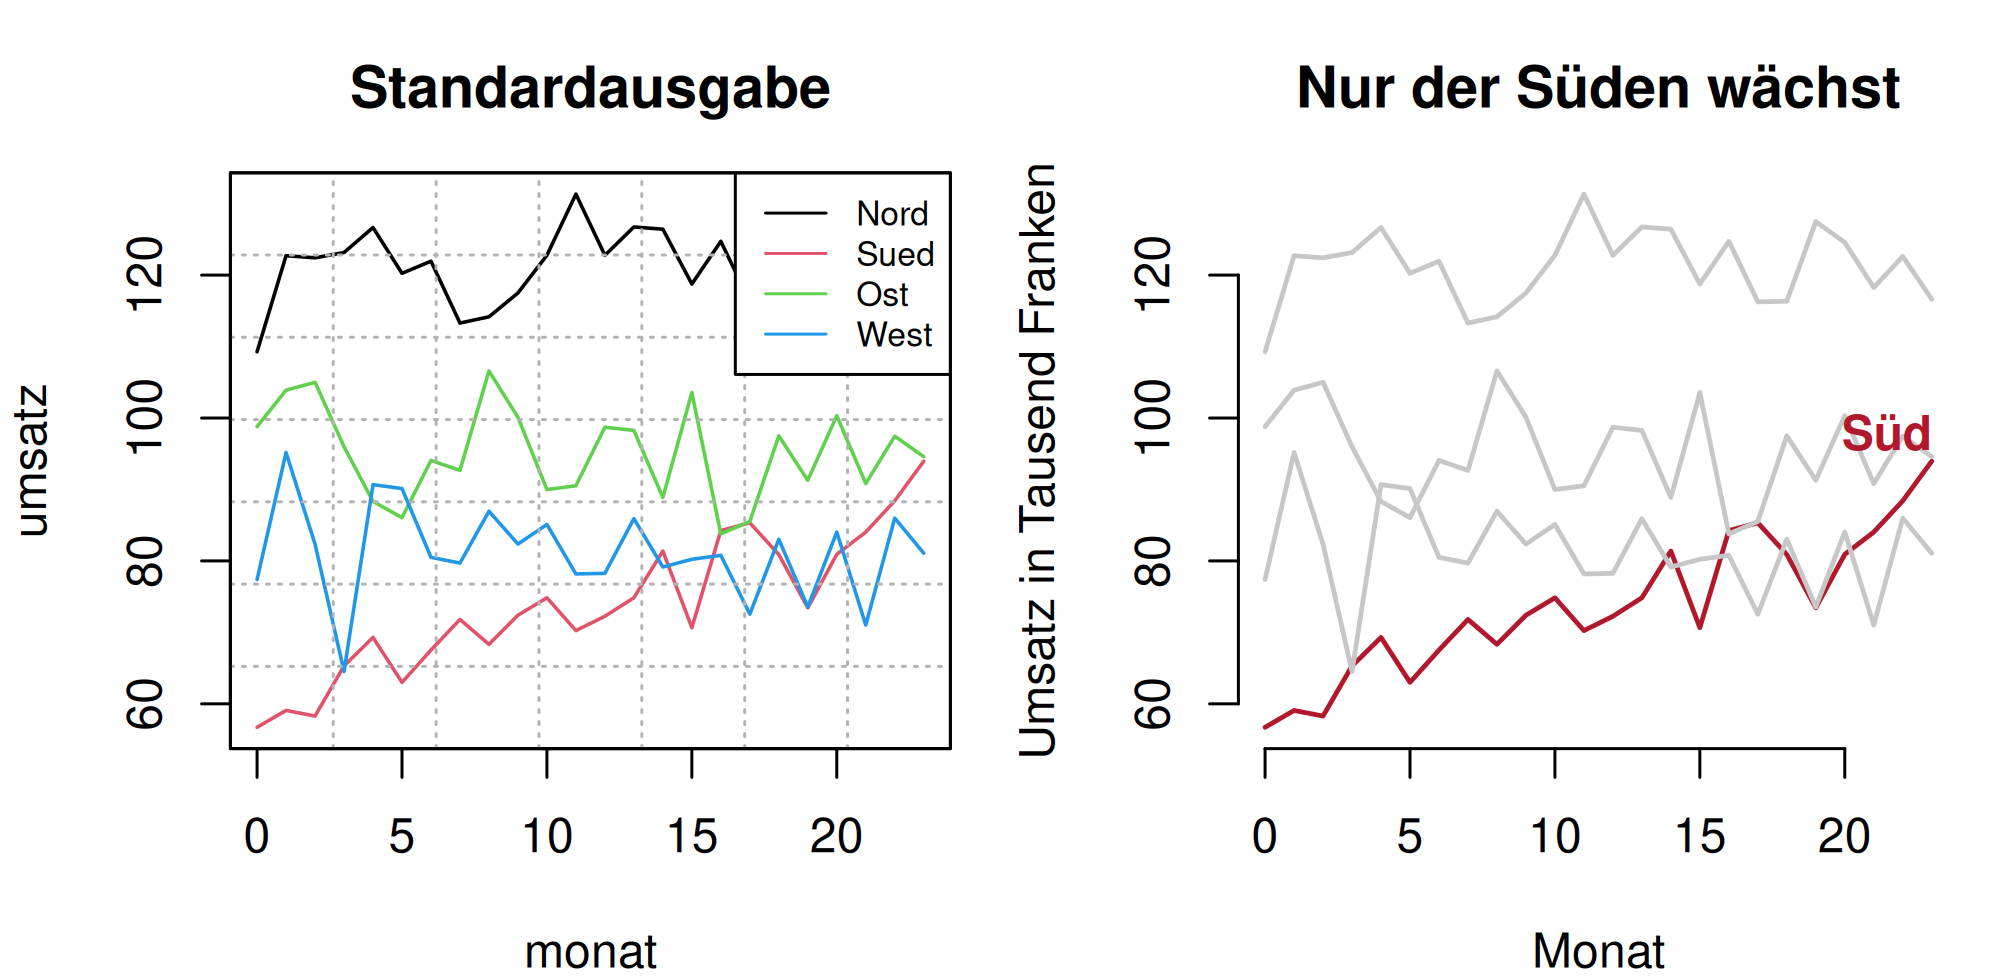
Dieselbe Grafik zweimal: einmal als Standardausgabe aus der Analyse, einmal für den Bericht aufgeräumt. Gezählt wird, wie viele Elemente Daten zeigen und wie viele nicht.

Rechnung

elemente <- data.frame(
  art = c("Datenmarken", "Gitterlinien", "Achsenticks",
          "Legendeneinträge", "Rahmenlinien", "Titel", "Anmerkungen"),
  explorativ = c(96, 14, 18, 4, 4, 0, 0),
  erklaerend = c(96, 4, 10, 0, 0, 1, 2))
elemente
               art explorativ erklaerend
1      Datenmarken         96         96
2     Gitterlinien         14          4
3      Achsenticks         18         10
4 Legendeneinträge          4          0
5     Rahmenlinien          4          0
6            Titel          0          1
7      Anmerkungen          0          2
for (sp in c("explorativ", "erklaerend")) {
  daten_marken <- elemente[1, sp]
  rest <- sum(elemente[-1, sp])
  cat(sprintf("%-12s Datenmarken %d, andere Elemente %d, Anteil Daten %.1f Prozent\n",
              sp, daten_marken, rest, daten_marken / (daten_marken + rest) * 100))
}
explorativ   Datenmarken 96, andere Elemente 40, Anteil Daten 70.6 Prozent
erklaerend   Datenmarken 96, andere Elemente 17, Anteil Daten 85.0 Prozent
lang <- data.frame(
  region = rep(regionen, each = 24),
  monat = rep(zeit, times = 4),
  umsatz = as.vector(t(daten)))

par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))
matplot(zeit, t(daten), type = "l", lty = 1, lwd = 1.2, col = 1:4,
        xlab = "monat", ylab = "umsatz", main = "Standardausgabe")
grid(nx = 7, ny = 7, col = "grey70")
legend("topright", legend = regionen, col = 1:4, lty = 1, cex = 0.7)
box()

matplot(zeit, t(daten), type = "l", lty = 1, lwd = 1.6,
        col = c(neutral, akzent, neutral, neutral), bty = "n",
        xlab = "Monat", ylab = "Umsatz in Tausend Franken",
        main = "Nur der Süden wächst")
text(23, daten[2, 24] + 4, "Süd", col = akzent, adj = 1, font = 2)
par(mfrow = c(1, 1))
Abbildung 5: Beispiel 4: links die Standardausgabe, rechts die aufgeräumte Fassung.
elemente = pd.DataFrame({
    "art": ["Datenmarken", "Gitterlinien", "Achsenticks",
            "Legendeneinträge", "Rahmenlinien", "Titel", "Anmerkungen"],
    "explorativ": [96, 14, 18, 4, 4, 0, 0],
    "erklaerend": [96, 4, 10, 0, 0, 1, 2]})
print(elemente.to_string(index=False))

for sp in ("explorativ", "erklaerend"):
    marken = int(elemente.loc[0, sp])
    rest = int(elemente[sp][1:].sum())
    print(f"{sp:<12} Datenmarken {marken}, andere Elemente {rest},"
          f" Anteil Daten {marken / (marken + rest) * 100:.1f} Prozent")

fig, achsen = plt.subplots(1, 2, figsize=(7, 3.4))
for i in range(4):
    _ = achsen[0].plot(zeit, daten[i], lw=1.2, label=regionen[i])
_ = achsen[0].grid(True, color="0.7")
_ = achsen[0].legend(fontsize=7)
_ = achsen[0].set_xlabel("monat")
_ = achsen[0].set_ylabel("umsatz")
_ = achsen[0].set_title("Standardausgabe")

for i in range(4):
    _ = achsen[1].plot(zeit, daten[i], lw=1.6,
                       color=AKZENT if i == 1 else NEUTRAL)
_ = achsen[1].text(23, daten[1, -1] + 4, "Süd", color=AKZENT, ha="right",
                   fontweight="bold")
for rand in ("top", "right"):
    _ = achsen[1].spines[rand].set_visible(False)
_ = achsen[1].set_xlabel("Monat")
_ = achsen[1].set_ylabel("Umsatz in Tausend Franken")
_ = achsen[1].set_title("Nur der Süden wächst")
plt.tight_layout()
plt.show()
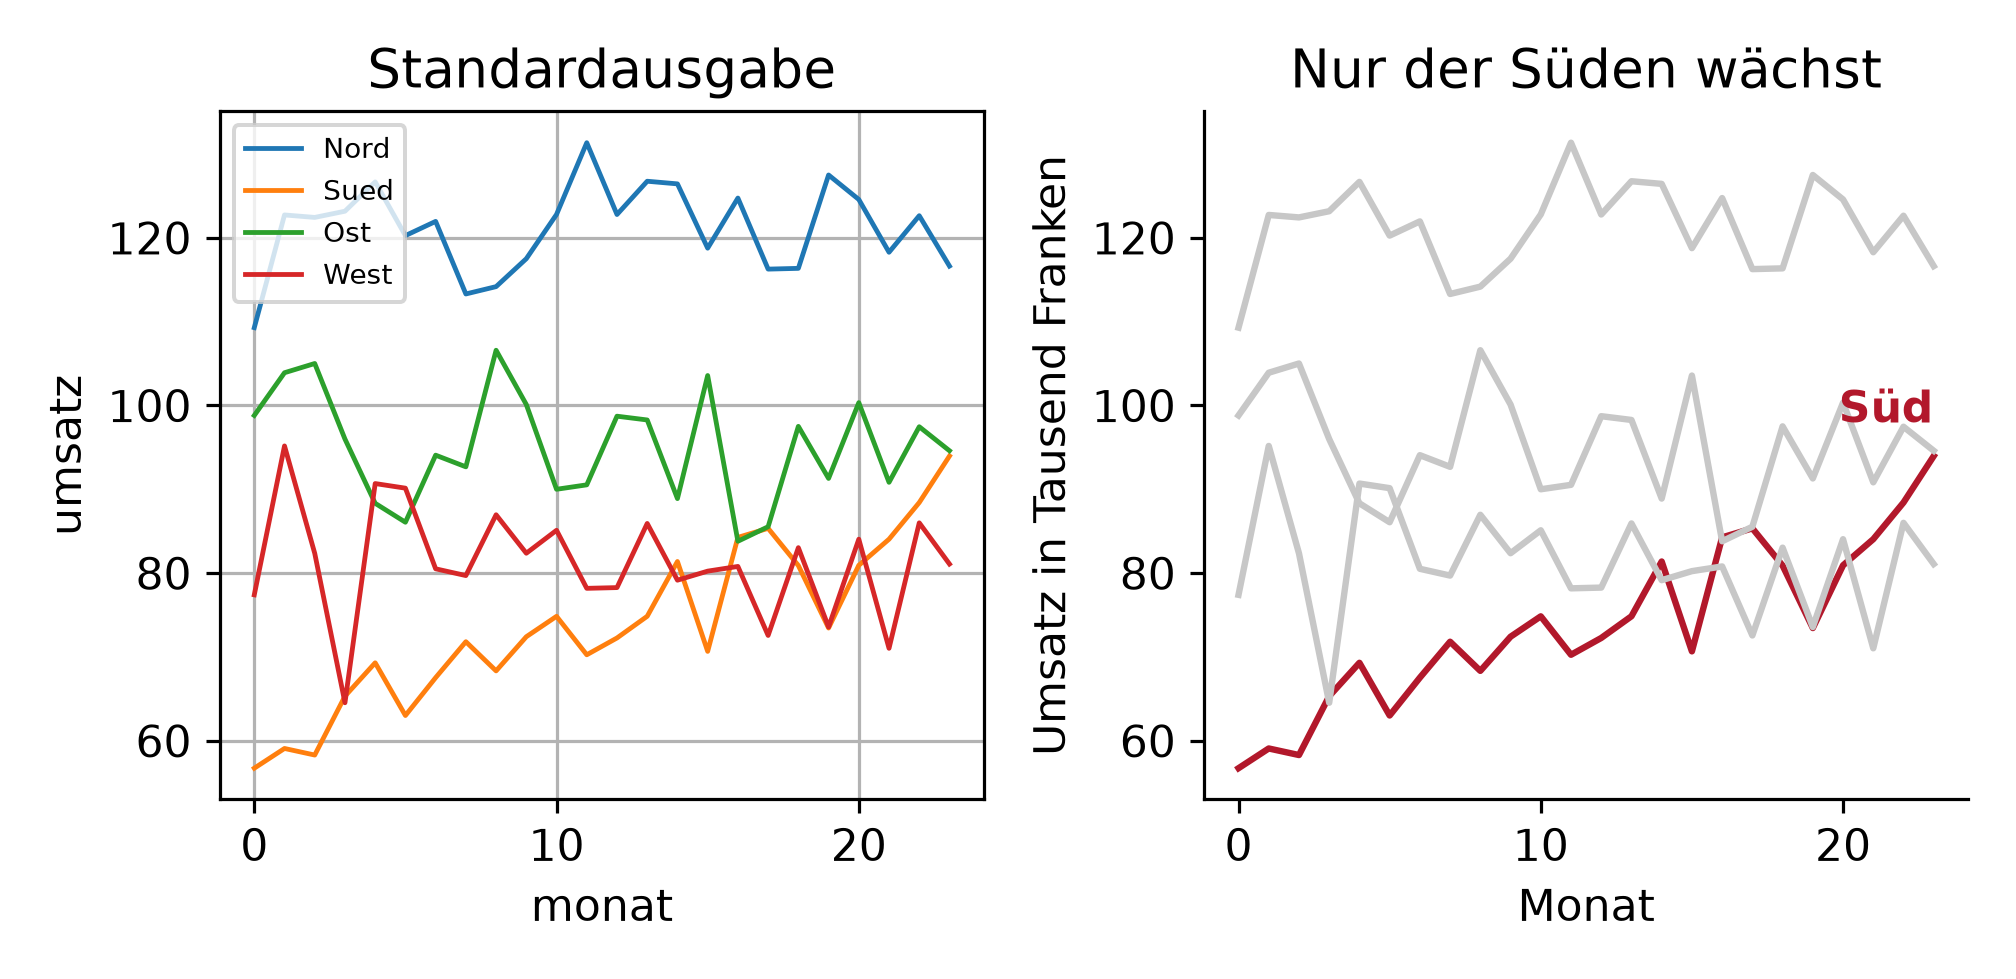
Abbildung 6: Beispiel 4: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

Element explorativ erklärend
Datenmarken 96 96
Gitterlinien 14 4
Achsenticks 18 10
Legendeneinträge 4 0
Rahmenlinien 4 0
Titel 0 1
Anmerkungen 0 2
Fassung Datenmarken andere Elemente Anteil Daten
explorativ 96 40 70.6 Prozent
erklärend 96 17 85.0 Prozent
Beobachtung Erklärung
Die Datenmenge ändert sich nicht 96 Werte in beiden Fassungen. Es wird nichts weggelassen, was Information trägt.
Die anderen Elemente sinken von 40 auf 17 Gitterlinien, Ticks, Rahmen und Legende. Jedes davon hat einmal einen Zweck gehabt und hier keinen.
Die Legende verschwindet ganz Weil die eine Serie, um die es geht, direkt beschriftet ist. Das spart dem Auge den Weg zwischen Linie und Legende, bei vier Serien viermal.
Es kommen drei Elemente dazu Titel und zwei Anmerkungen. Aufräumen heisst nicht nur streichen: Der Titel trägt jetzt die Aussage, die Einheit steht an der Achse.
Die rechte Fassung hat weniger Farben Drei graue Linien und eine rote statt vier bunte. Die Aussage bestimmt, was Farbe bekommt.

Die Zählung ist ein Hilfsmittel, kein Ziel. Der Anteil von 85 Prozent ist keine Norm, die es zu erreichen gilt, eine Grafik ohne Achsenbeschriftung hätte einen noch höheren Wert und wäre unbrauchbar.

Nützlich ist die Zählung als Frage an jedes Element: Was passiert, wenn ich es weglasse? Verliert die Grafik Information, bleibt es. Sieht sie nur anders aus, geht es. Und was fehlt, Einheit, Quelle, Aussage, kommt dazu.

Interpretation und Ergebnissatz

Beide Fassungen zeigen dieselben 96 Werte. Die Zahl der Elemente ohne Dateninhalt sinkt von 40 auf 17, der Anteil der Datenmarken steigt damit von 70.6 auf 85.0 Prozent, bei drei neu hinzugekommenen Elementen für Titel und Beschriftung.

Frage und Datenlage

Drei fehlerhafte Fassungen derselben Grafik. Die Frage ist nicht, welche am schlechtesten aussieht, sondern wie gross der Schaden in jedem Fall ist.

Rechnung

mittel <- kennzahlen[, "mittel"]

# 1 haesslich: nichts stimmt inhaltlich nicht
c(ablesefehler_haesslich = 0)
ablesefehler_haesslich 
                     0 
# 2 schlecht gelesen: Torte statt Balken
grad <- mittel / sum(mittel) * 360
paare <- t(combn(4, 2))
winkel_diff <- apply(paare, 1, function(k) abs(grad[k[1]] - grad[k[2]]))
c(paare_unter_15_grad = sum(winkel_diff < 15), paare = length(winkel_diff))
paare_unter_15_grad               paare 
                  2                   6 
# 3 falsch: Balkenachse ab 60
laengen <- mittel - 60
round(c(echtes_verhaeltnis = max(mittel) / min(mittel),
        dargestelltes_verhaeltnis = max(laengen) / min(laengen),
        verzerrung = (max(laengen) / min(laengen)) / (max(mittel) / min(mittel))), 2)
       echtes_verhaeltnis dargestelltes_verhaeltnis                verzerrung 
                     1.64                      4.48                      2.73 
par(mfrow = c(1, 3), mar = c(4, 4, 3, 1))
barplot(mittel, names.arg = regionen, col = rainbow(4), border = "black",
        ylab = "Umsatz", main = "1 hässlich")
grid(col = "grey50")
pie(mittel, labels = regionen, col = grey.colors(4), main = "2 schlecht gelesen")
barplot(mittel, names.arg = regionen, col = neutral, border = NA,
        ylim = c(60, 125), xpd = FALSE, ylab = "Umsatz", main = "3 falsch")
par(mfrow = c(1, 1))
Abbildung 7: Beispiel 5: hässlich, schlecht gelesen, falsch.
mittel = kennzahlen["mittel"].to_numpy()

print({"ablesefehler_haesslich": 0})

grad = mittel / mittel.sum() * 360
winkel_diff = [abs(grad[i] - grad[j])
               for i, j in itertools.combinations(range(4), 2)]
print({"paare_unter_15_grad": sum(1 for d in winkel_diff if d < 15),
       "paare": len(winkel_diff)})

laengen = mittel - 60
print({"echtes_verhaeltnis": round(float(mittel.max() / mittel.min()), 2),
       "dargestelltes_verhaeltnis": round(float(laengen.max() / laengen.min()), 2),
       "verzerrung": round(float((laengen.max() / laengen.min())
                                 / (mittel.max() / mittel.min())), 2)})

fig, achsen = plt.subplots(1, 3, figsize=(7, 3))
_ = achsen[0].bar(regionen, mittel,
                  color=["#FF0000", "#00FF00", "#0000FF", "#FFFF00"],
                  edgecolor="black")
_ = achsen[0].grid(True, color="0.5")
_ = achsen[0].set_title("1 hässlich")
_ = achsen[0].set_ylabel("Umsatz")
_ = achsen[1].pie(mittel, labels=regionen,
                  colors=[str(g) for g in np.linspace(0.3, 0.85, 4)])
_ = achsen[1].set_title("2 schlecht gelesen")
_ = achsen[2].bar(regionen, mittel - 60, bottom=60, color=NEUTRAL)
_ = achsen[2].set_ylim(60, 125)
_ = achsen[2].set_title("3 falsch")
_ = achsen[2].set_ylabel("Umsatz")
plt.tight_layout()
plt.show()
Abbildung 8: Beispiel 5: dieselben drei Fassungen in Python.

Output Zeile für Zeile

Fassung Messbarer Schaden
1 hässlich, Regenbogenfarben, Gitter, Rahmen 0 Ablesefehler: alle Werte bleiben korrekt ablesbar
2 schlecht gelesen, Torte statt Balken 2 von 6 Paaren unterscheiden sich um weniger als 15 Grad
3 falsch, Achse ab 60 echtes Verhältnis 1.65, dargestelltes 4.44, Verzerrung 2.69-fach
Beobachtung Erklärung
Die erste Fassung ist nur hässlich Jeder Wert lässt sich korrekt ablesen, die Achse beginnt bei null, die Länge stimmt. Der Schaden ist ästhetisch und damit der geringste.
Die zweite täuscht, ohne zu lügen Zwei von sechs Paarvergleichen liegen unter 15 Grad und sind damit Ratesache. Es steht nichts Falsches da; das Publikum nimmt trotzdem etwas Falsches mit.
Die dritte behauptet Unwahres Aus einem Verhältnis von 1.65 wird eines von 4.44. Die Grafik sagt, Nord sei viereinhalbmal so gross wie Süd. Tatsächlich ist es das 1.65-Fache.
Die Dringlichkeit folgt der Zahl 0 bis 2 von 6, Faktor 2.69. Wer Zeit für genau eine Korrektur hat, korrigiert die dritte.
Am häufigsten korrigiert wird die erste Weil sie am schnellsten auffällt. Das ist die falsche Reihenfolge.

Die Prüfreihenfolge, die daraus folgt:

  1. Stimmt es? Achsen, Skalierung, Geometrie, Aggregation. Das ist die Prüfliste unter irreführende Darstellungen.
  2. Wird es richtig gelesen? Kanal zur Aufgabe passend? Das ist Wahrnehmung und Kodierung.
  3. Sieht es gut aus? Erst jetzt.

In der Praxis läuft es meistens rückwärts und dann bleibt für die erste Frage keine Zeit mehr.

Interpretation und Ergebnissatz

Die drei Fehlerarten unterscheiden sich messbar: Die hässliche Fassung verursacht keinen Ablesefehler, die Torte macht 2 von 6 Paarvergleichen zur Ratesache, und die abgeschnittene Achse übertreibt das Verhältnis von 1.65 auf 4.44, eine Verzerrung um den Faktor 2.69.

Verständnisfragen

Eine explorative Grafik aus der Analyse soll in den Abschlussbericht. Was ist zu tun?

Übernehmen, sie zeigt das Ergebnis korrekt
Korrektheit genügt nicht: sie ist für jemanden gemacht, der die Daten schon kennt.
Neu bauen für das Publikum des Berichts
Richtig. Zu klären sind Aussage, Vorwissen und Detailtiefe; im Beispiel sank die Zahl der Elemente ohne Dateninhalt dabei von 40 auf 17, während Titel und Einheit dazukamen.
Nur den Titel anpassen
Der Titel ist ein Teil davon, aber Auswahl und Beschriftung tragen die Verständlichkeit.

Beim Explorieren von zehn unabhängigen Variablen fällt ein Paar mit p = 0.009 auf. Was ist das?

Der erwartete Zufallsbefund unter 45 Vergleichen
Richtig. Erwartet waren 2.25 signifikante Paare bei reinem Rauschen, gefunden wurden drei. Nach Bonferroni bleibt keines übrig.
Ein schwacher, aber echter Zusammenhang
Die Variablen wurden nachweislich unabhängig erzeugt.
Ein Fehler im Zufallsgenerator
Über dreissig Saaten entsprach die Zahl auffälliger Paare der Erwartung.

Drei Regionen haben Steigungen von +0.084, −0.197 und −0.208 je Monat. Welcher Titel ist gedeckt?

Keiner, der eine Richtung behauptet, alle drei Intervalle enthalten die Null
Richtig. Die Intervalle reichen etwa von −0.6 bis +0.4; die Vorzeichen der Punktschätzungen tragen keine Aussage.
“Ost und West brechen ein”, beide Steigungen sind negativ
Genau das ist der Fehlschluss: Das Vorzeichen allein belegt nichts.
“Nord wächst am stärksten”
Nord hat mit +0.084 die kleinste Steigung aller vier Regionen und p = 0.59.

Dieselben Daten sollen “Nord ist am grössten” und “nur Süd wächst” zeigen. Genügt eine Grafik?

Nein, die zwei Aussagen verlangen verschiedene Darstellungen
Richtig. Der sortierte Balken mittelt die Zeit weg und verbirgt den Trend, die Liniengrafik macht den Grössenvergleich mühsam. Beide Aussagen stimmen.
Ja, eine Liniengrafik zeigt beides
Sie zeigt den Trend gut und den Niveauvergleich schlecht, weil die Linien verschieden hoch verlaufen.
Nein, weil die Aussagen sich widersprechen
Sie widersprechen sich nicht: Nord ist gross und stabil, Süd klein und wachsend.

Ein Diagramm ist korrekt gerechnet, aber die zwölf Segmente einer Torte sind kaum unterscheidbar. Wie ist das einzuordnen?

Als kosmetisches Problem
Kosmetisch wäre es, wenn die Grafik nur ungestaltet aussähe.
Als Wahrnehmungsproblem: das Publikum liest die Anteile falsch
Richtig. Winkel lassen sich schlecht vergleichen; im Beispiel lagen 2 von 6 Paarvergleichen unter 15 Grad. Der Balken löst dieselbe Aufgabe besser.
Als Rechenfehler
Gerechnet ist alles richtig, gelesen wird es falsch.

Drei Fassungen einer Grafik sind hässlich, schlecht lesbar und falsch. In welcher Reihenfolge korrigiert man?

Zuerst die falsche, dann die schlecht lesbare, zuletzt die hässliche
Richtig, nach dem Schaden: Verzerrung um den Faktor 2.69 gegen 2 von 6 unlesbaren Vergleichen gegen null Ablesefehler.
Zuerst die hässliche, sie fällt am meisten auf
Genau das passiert in der Praxis, und es ist die falsche Reihenfolge.
Alle gleichzeitig
Wenn die Zeit reicht, gern; die Frage ist, womit man anfängt, wenn sie nicht reicht.

Verlinkte Ressourcen