Dimensionen reduzieren, Ladungen und erklärte Varianz lesen.
Die Beispieldaten werden nicht zufällig gezogen, sondern deterministisch aus Normalverteilungsquantilen konstruiert. R und Python rechnen deshalb mit exakt denselben 300 Zeilen und liefern dieselben Eigenwerte und Ladungen. Nur die Vorzeichen der Ladungen können sich zwischen den beiden Ausgaben unterscheiden, und das ist bei diesem Verfahren bedeutungslos.
Kurzsteckbrief
Fragestellung
Lassen sich viele korrelierte Variablen durch wenige unkorrelierte zusammenfassen, ohne viel Information zu verlieren?
Zielvariable
keine, das Verfahren ist unüberwacht
Eingang
mehrere metrische Variablen, meist standardisiert
Was die Methode liefert
Komponenten mit Eigenwerten, erklärte Varianzanteile, Ladungen je Variable, Komponentenwerte je Beobachtung
R-Funktion
prcomp(daten, scale. = TRUE), gelesen mit summary() und $rotation
Typische Fragestellungen: Zwanzig Sensorwerte auf zwei bis drei Kennzahlen verdichten, korrelierte Prädiktoren vor einem Modell entflechten, einen Datensatz zweidimensional darstellen, um Gruppen zu sehen.
Die Hauptkomponentenanalyse ist eine Umrechnung, keine Modellierung: Sie sucht die Richtungen im Raum, in denen die Daten am stärksten streuen, und beschreibt jede Beobachtung durch ihre Lage entlang dieser Richtungen. Weil die Komponenten unkorreliert sind, löst sie zugleich das Problem sich doppelnder Variablen.
Situation
Stattdessen
Es geht um dahinterliegende Ursachen, nicht um Verdichtung
Korrespondenzanalyse, oder Gower-Distanz und Clustering
Der Zusammenhang ist deutlich nichtlinear
nichtlineare Verfahren, etwa UMAP oder Kernel-PCA
Die Variablen sind praktisch unkorreliert
nichts zu verdichten; die Analyse liefert nur eine Drehung
Grundidee und Modell
Gesucht ist die Richtung im Variablenraum, entlang der die Daten am stärksten streuen. Das ist die erste Hauptkomponente. Die zweite ist die Richtung mit der nächstgrössten Streuung, die auf der ersten senkrecht steht, und so weiter. Die Komponenten sind Linearkombinationen der ursprünglichen Variablen.
\[z_{ij} = \sum_{k} a_{kj} \cdot \tilde{x}_{ik}\]
Bestandteil
Bedeutung
\(\tilde{x}_{ik}\)
standardisierter Wert von Variable \(k\) bei Beobachtung \(i\)
\(a_{kj}\)
Ladung: Gewicht von Variable \(k\) in Komponente \(j\)
\(z_{ij}\)
Komponentenwert von Beobachtung \(i\) auf Komponente \(j\)
Eigenwert
Varianz, die eine Komponente auf sich zieht
Rechnerisch ist es die Eigenwertzerlegung der Korrelationsmatrix, wenn standardisiert wurde, und der Kovarianzmatrix, wenn nicht. Der Unterschied ist gross: ohne Standardisierung dominiert die Variable mit der grössten Varianz, siehe Distanzmasse. Bei verschiedenen Einheiten wird deshalb immer standardisiert.
Die Summe aller Eigenwerte ist bei standardisierten Daten gleich der Anzahl Variablen. Ein Eigenwert von 1 entspricht damit genau dem Informationsgehalt einer einzelnen Variablen, und das ist der Grund für die Faustregel, Komponenten mit Eigenwert über 1 zu behalten.
Erste Komponente ist praktisch die grösste Variable
scale. = TRUE beziehungsweise StandardScaler
Keine extremen Ausreisser
Varianz ist nicht von wenigen Punkten getrieben
Streudiagramme, Ausreisserdiagnostik
Komponenten zeigen auf die Ausreisser
robuste Varianten, Ursachen prüfen
Output lesen
R, summary(prcomp(...)):
Grösse
Was sie sagt
Faustregel oder Falle
Standard deviation
Wurzel des Eigenwerts je Komponente
quadriert ergibt den Eigenwert
Proportion of Variance
Anteil der Gesamtvarianz, den die Komponente erklärt
summiert sich über alle Komponenten zu eins
Cumulative Proportion
kumulierter Anteil
die Zahl, an der man die Anzahl Komponenten festlegt
$rotation
Ladungen: Gewicht jeder Variablen in jeder Komponente
Vorzeichen sind beliebig
$x
Komponentenwerte je Beobachtung
die neuen Variablen für weitere Analysen
$sdev
Standardabweichungen, für den Screeplot
Eigenwert ist $sdev^2
$center, $scale
verwendete Mittelwerte und Streuungen
nötig, um neue Daten identisch zu transformieren
Python, PCA:
Zugriff
Was er liefert
Unterschied zu R
explained_variance_ratio_
Varianzanteile
wie Proportion of Variance
explained_variance_
Eigenwerte, mit n minus 1 normiert
R normiert gleich, die Werte stimmen überein
components_
Ladungen, aber zeilenweise je Komponente
in R spaltenweise; deshalb transponieren
transform(X)
Komponentenwerte
wie $x
n_components_
Anzahl Komponenten
kein summary()
Tabelle selbst zusammenstellen
in R eine Zeile
Zwei Stolpersteine gelten in beiden Sprachen. Die Vorzeichen der Ladungen sind beliebig: Eine Komponente und ihr Negativ beschreiben dieselbe Richtung, und die Programme wählen willkürlich. Ein Vorzeichenwechsel zwischen zwei Läufen oder zwischen R und Python ist kein Fehler. Standardisierung geschieht nicht automatisch: In R braucht es scale. = TRUE, in Python einen eigenen Schritt davor.
Wie viele Komponenten behalten?
Kriterium
Regel
Grenzen
Kaiser
Eigenwert grösser als 1
Mechanisch. Ein Eigenwert von 1.02 und einer von 0.98 unterscheiden sich in nichts Inhaltlichem.
Screeplot
bis zum Knick
Der Knick ist Auslegungssache und manchmal nicht vorhanden.
Kumulierte Varianz
so viele, bis ein gesetzter Anteil erreicht ist, oft 80 Prozent
Der Anteil wird vorher festgelegt, nicht nachträglich passend gewählt.
Deutbarkeit
nur Komponenten behalten, die sich benennen lassen
Das wichtigste Kriterium und das einzige, das inhaltlich argumentiert.
Die Kriterien widersprechen sich regelmässig. Dann wird die Entscheidung begründet und nicht die Regel gewechselt, bis das Ergebnis gefällt.
Interpretationsfallen
Die erste Komponente ist nicht die wichtigste Variable. Sie ist die Richtung der grössten Streuung, und Streuung ist nicht Bedeutung.
Erklärte Varianz ist keine Modellgüte. Sie sagt, wie viel Streuung erhalten bleibt, nicht ob das Ergebnis brauchbar ist.
Vorzeichen der Ladungen sind beliebig. Eine Komponente kann in zwei Läufen gespiegelt erscheinen; inhaltlich ändert das nichts.
Komponenten sind keine Ursachen. Sie sind Rechengrössen. Wer nach dahinterliegenden Grössen sucht, nimmt die Faktorenanalyse.
Ohne Standardisierung entscheidet die Einheit. Das ist der häufigste stille Fehler, siehe Beispiel 2.
Ausreisser bestimmen Richtungen. Ein einzelner extremer Punkt kann eine Komponente vollständig auf sich ausrichten.
Zwei Dimensionen sind eine Wahl, keine Wahrheit. Wenn zwei Komponenten nur 40 Prozent erklären, ist die Punktwolke in der Ebene eine grobe Projektion, und Abstände darin sind mit Vorsicht zu deuten.
Ergebnis berichten
Vorlage für den Ergebnissatz:
Eine Hauptkomponentenanalyse auf [Anzahl] standardisierten Variablen (n = [n]) ergibt [Anzahl] Komponenten mit Eigenwert über eins, die zusammen [Anteil] der Varianz erklären. Komponente 1 lädt hoch auf [Variablen] und wird als [Deutung] gelesen, Komponente 2 auf [Variablen] als [Deutung].
Genannt werden: Anzahl Variablen und Beobachtungen, ob standardisiert wurde, Eigenwerte und kumulierte erklärte Varianz, die Ladungen der behaltenen Komponenten, das Kriterium für die Anzahl und die inhaltliche Deutung. Ohne Deutung ist eine Komponentenanalyse nur eine Zahlenumformung.
An einer Fertigungslinie werden sechs Grössen aufgezeichnet: Vibration in Millimetern je Sekunde, Temperatur in Grad Celsius, Stromaufnahme in Ampere, Taktzeit in Sekunden, Ausstoss in Stück und Luftfeuchte in Prozent. Für 300 Schichten liegen die Werte vor. Gefragt ist, ob sich die sechs Kennzahlen auf wenige zusammenfassen lassen und was diese wenigen inhaltlich bedeuten.
Voraussetzungen prüfen
Vor jeder Komponentenanalyse steht die Korrelationsmatrix. Sie beantwortet die Frage, ob es überhaupt etwas zu verdichten gibt, und die Varianzen beantworten die Frage, ob standardisiert werden muss.
Die Korrelationsmatrix zeigt zwei Blöcke. Vibration, Temperatur und Stromaufnahme korrelieren untereinander mit 0.93 bis 0.95. Taktzeit und Ausstoss korrelieren mit -0.94; das negative Vorzeichen ist inhaltlich richtig, weil eine kürzere Taktzeit mehr Stück je Schicht bedeutet. Die Luftfeuchte korreliert mit allem unter 0.07, also mit nichts.
Die Varianzen reichen von 2.4 bei der Stromaufnahme bis 3971 beim Ausstoss, ein Verhältnis von rund 1 zu 1650. Der Grund sind die Einheiten: Ampere und Stück sind schlicht verschieden grosse Zahlen. Ohne Standardisierung würde die erste Komponente deshalb den Ausstoss abbilden und sonst nichts, wie Beispiel 2 zeigt.
Zieht so viel Varianz auf sich wie knapp drei einzelne Variablen. Das ist der Werkzeugblock.
PC2
1.388
1.925
32.0 %
80.4 %
Knapp zwei Variablen wert. Das ist der Durchsatzblock.
PC3
1.000
0.999
16.6 %
97.0 %
Genau eine Variable wert, und das ist wörtlich zu nehmen: Diese Komponente ist die Luftfeuchte.
PC4 bis PC6
0.316 / 0.255 / 0.136
0.100 / 0.065 / 0.019
zusammen 3.0 %
100 %
Das Messrauschen der einzelnen Sensoren.
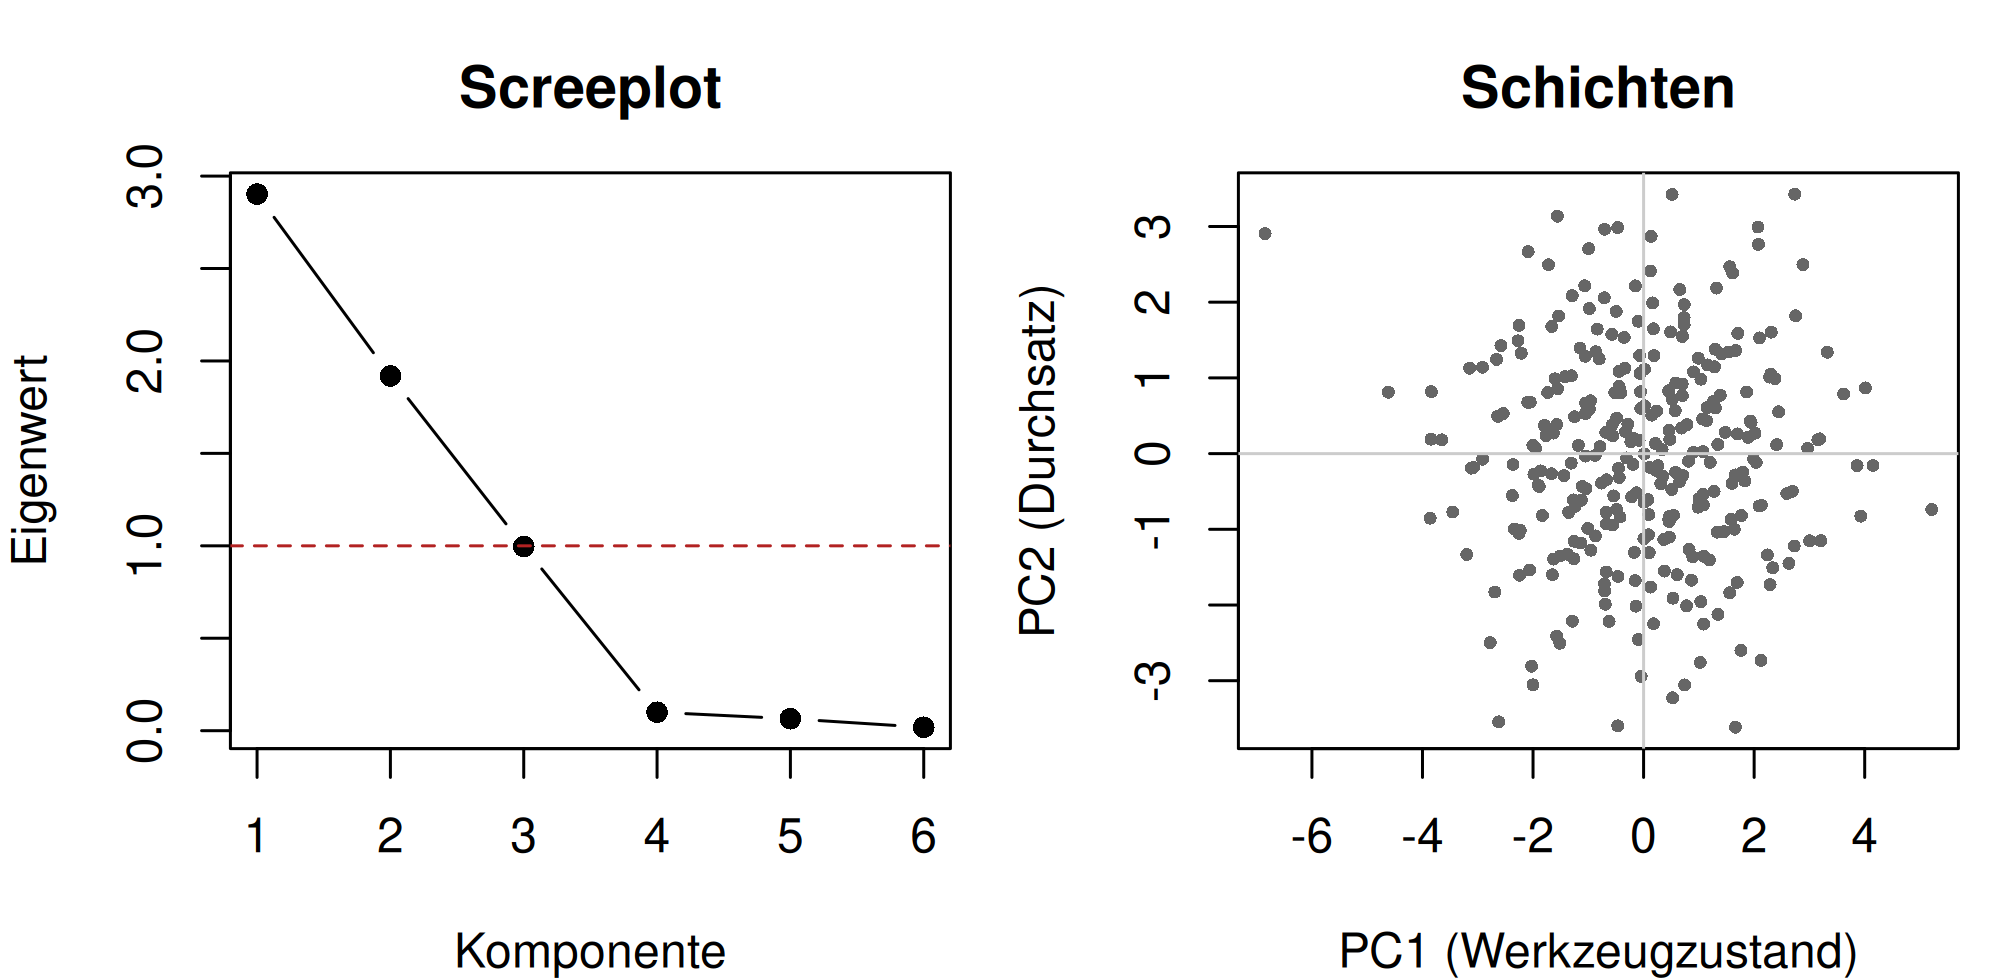
Der Eigenwert ist die entscheidende Zahl, weil er eine feste Bezugsgrösse hat: Bei standardisierten Daten trägt jede Ausgangsvariable genau 1 bei, und die Eigenwerte summieren sich auf die Anzahl Variablen, hier 6. Ein Eigenwert von 2.912 heisst also wörtlich “so viel Information wie 2.9 der ursprünglichen Variablen”.
Dann die Ladungen:
Variable
PC1
PC2
PC3
Wie das zu lesen ist
vibration
0.570
0.108
-0.019
Hohe Ladung auf PC1, sonst nichts.
temperatur
0.568
0.073
-0.030
Ebenso.
stromaufnahme
0.570
0.091
-0.031
Ebenso. Drei praktisch gleiche Ladungen bedeuten: PC1 ist der ungewichtete Durchschnitt dieser drei Grössen.
taktzeit
-0.112
0.698
-0.005
Trägt PC2, mit umgekehrtem Vorzeichen zum Ausstoss.
ausstoss
0.112
-0.698
0.018
Ebenso. Die beiden Ladungen von 0.698 und -0.698 sind betragsgleich: PC2 ist im Wesentlichen die Differenz der beiden standardisierten Grössen.
luftfeuchte
0.043
0.023
0.999
Lädt auf nichts ausser der eigenen Komponente. Eine Variable, die mit keiner anderen zusammenhängt, bekommt ihre eigene Komponente mit Eigenwert 1.
Zur Grössenordnung der Ladungen: Bei sechs Variablen hat jede Ladungsspalte die Länge 1, eine Gleichverteilung auf alle sechs entspräche also je 0.41. Werte um 0.57 sind demnach hoch, Werte unter etwa 0.15 sind Rauschen. Die Schwelle hängt an der Anzahl Variablen und ist keine feste Zahl.
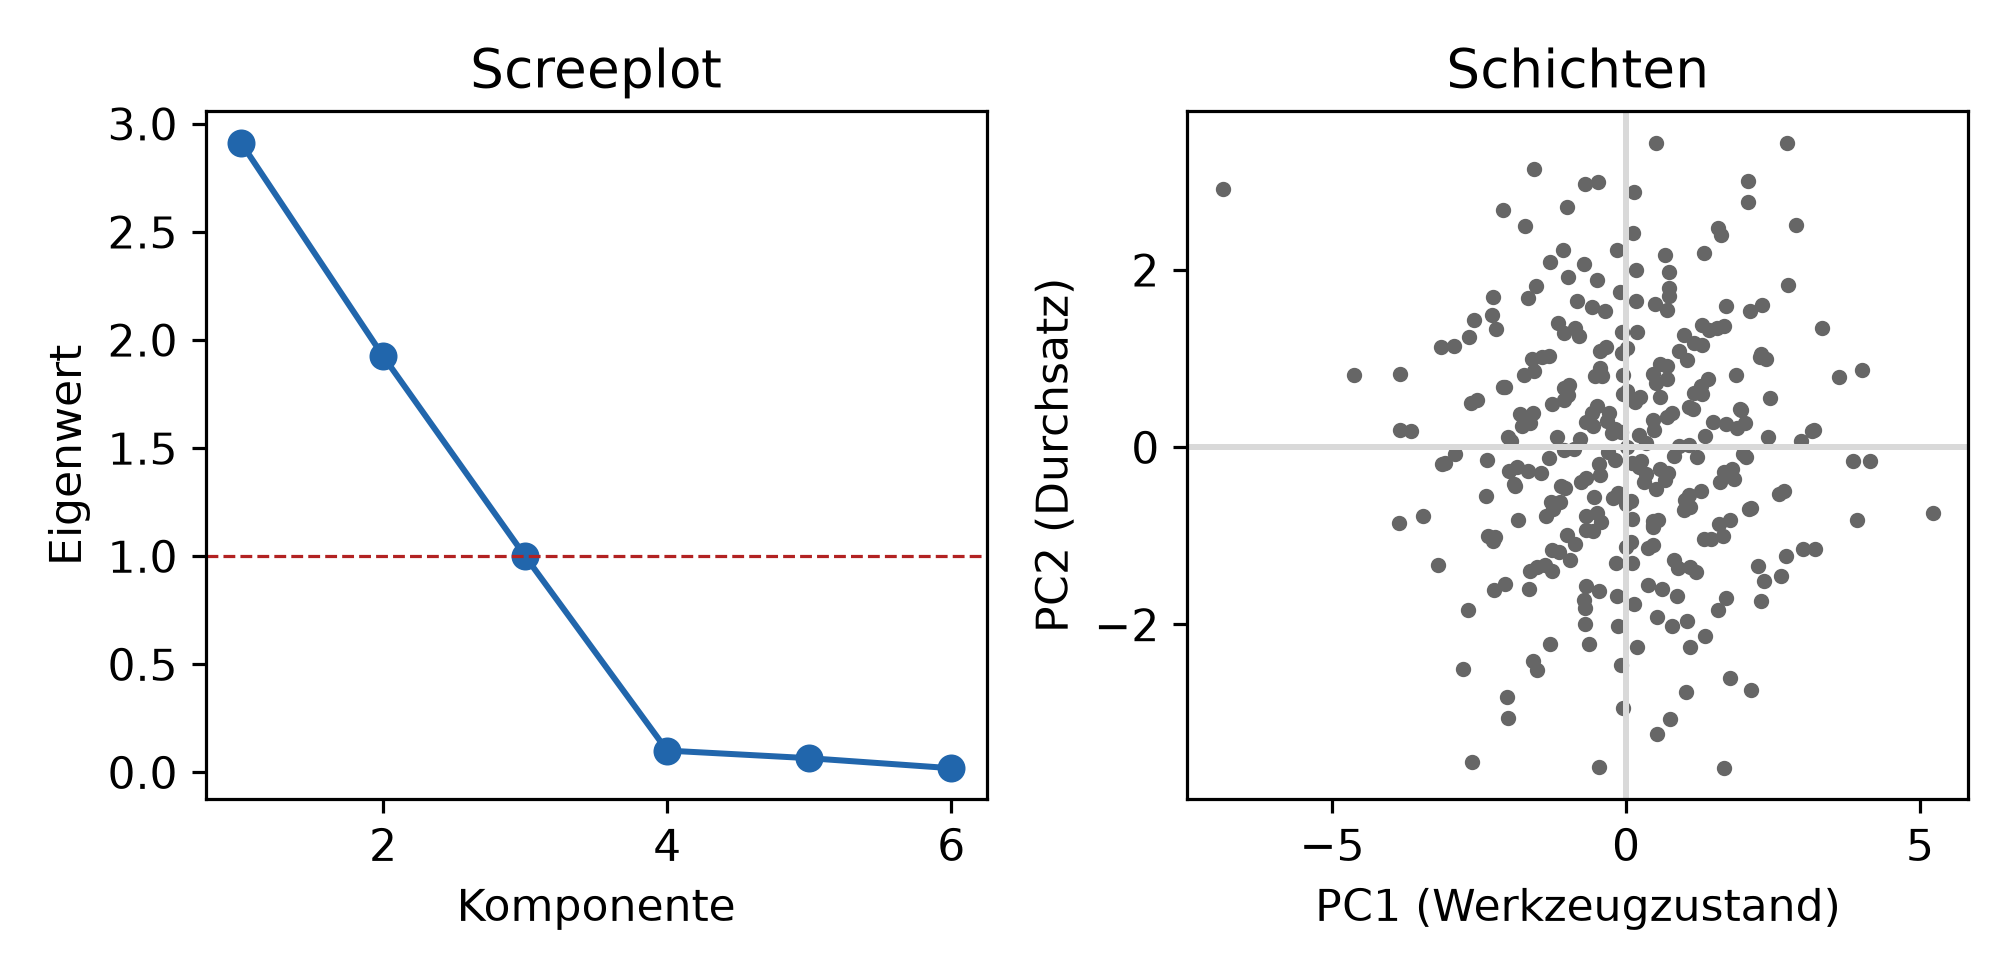
Abbildung 2: Beispiel 1: dieselbe Darstellung in Python.
Der Screeplot fällt von 2.91 auf 1.93 auf 1.00 und knickt dann scharf auf 0.10 ab. Nach dem Knick ist die Sache eindeutig, davor nicht: Das Kaiser-Kriterium (Eigenwert grösser 1) liefert zwei Komponenten, weil PC3 mit 0.999 knapp darunter liegt. Ein Hundertstel mehr, und dieselbe Regel hätte drei geliefert. Genau das ist gemeint, wenn vor mechanischen Schwellen gewarnt wird.
Inhaltlich ist die Entscheidung trotzdem klar, und zwar nicht wegen der Zahl, sondern wegen der Ladungen: PC3 ist nichts anderes als die Luftfeuchte, die mit keiner anderen Grösse zusammenhängt. Sie zu behalten hiesse, eine Ausgangsvariable unter neuem Namen mitzuschleppen. Wer sie braucht, nimmt sie direkt und nennt sie Luftfeuchte.
Interpretation und Ergebnissatz
Die Sensordaten enthalten zwei gemeinsame Bewegungen und eine eigenständige Grösse. Die erste Bewegung erfasst Vibration, Temperatur und Stromaufnahme; alle drei steigen zusammen, was zum Bild eines zunehmend abgenutzten Werkzeugs passt. Die zweite erfasst den Gegensatz von Taktzeit und Ausstoss, also die Durchsatzeinstellung der Linie. Die Luftfeuchte bleibt für sich.
Praktisch heisst das: Statt sechs Sensorwerte zu überwachen, genügen zwei Kennzahlen plus die Luftfeuchte, und man behält 97 Prozent der Streuung. Der Preis ist, dass die beiden Kennzahlen erst über die Ladungen erklärt werden müssen.
Eine Hauptkomponentenanalyse auf sechs standardisierten Sensorgrössen (n = 300) ergibt zwei Komponenten mit Eigenwert über eins, die zusammen 80.4 Prozent der Varianz erklären. Komponente 1 (Eigenwert 2.91, 48.4 Prozent) lädt gleichmässig auf Vibration, Temperatur und Stromaufnahme (Ladungen 0.57) und wird als Werkzeugzustand gelesen. Komponente 2 (Eigenwert 1.93, 32.0 Prozent) stellt Taktzeit und Ausstoss gegenüber (Ladungen 0.70 und -0.70) und wird als Durchsatz gelesen. Die dritte Komponente (Eigenwert 1.00) entspricht der Luftfeuchte, die mit keiner anderen Grösse zusammenhängt; sie wird als eigene Variable weitergeführt statt als Komponente.
Frage und Datenlage
Dieselben 300 Schichten und dieselben sechs Sensoren, nur wird diesmal nicht standardisiert. In R heisst das scale. = FALSE (die Voreinstellung), in Python schlicht, den StandardScaler wegzulassen. Das ist der häufigste stille Fehler dieses Verfahrens, weil das Programm nicht warnt.
Sieht nach einem hervorragenden Ergebnis aus: eine Komponente genügt. Genau dieser scheinbare Erfolg ist das Warnsignal.
Anteil PC2
2.36 %
Anteil PC3
0.87 %
Ladung ausstoss auf PC1
0.998
Die Auflösung. PC1 besteht praktisch vollständig aus dem Ausstoss.
Ladung taktzeit auf PC1
-0.061
Ladung vibration auf PC1
0.007
Vibration, Temperatur und Stromaufnahme kommen in der ersten Komponente überhaupt nicht vor.
Ladung vibration auf PC2
0.844
Der Werkzeugblock taucht erst in der zweiten Komponente auf, die aber nur 2.4 Prozent trägt.
Der Vergleich mit Beispiel 1 zeigt den Schaden. Standardisiert erklärt PC1 48.4 Prozent und fasst drei Sensoren zusammen; unstandardisiert erklärt PC1 96.7 Prozent und ist eine einzige Variable unter anderem Namen. Der Ausstoss gewinnt nicht, weil er wichtiger wäre, sondern weil er in Stück gezählt wird und seine Varianz mit 3971 rund 1650 Mal so gross ist wie die der Stromaufnahme in Ampere. Wäre der Ausstoss in Tausend Stück erfasst worden, sähe das Ergebnis völlig anders aus.
Interpretation und Ergebnissatz
Zwei Zeichen verraten den Fehler zuverlässig: Eine einzelne Komponente erklärt unplausibel viel, und ihre Ladungen konzentrieren sich auf eine Variable. Beides lässt sich in einem Blick auf die Ladungstabelle prüfen.
Nicht standardisiert wird nur dann, wenn alle Variablen dieselbe Einheit haben und die Unterschiede in der Streuung inhaltlich gewollt sind, etwa bei mehreren Messungen derselben Grösse an verschiedenen Stellen. In allen anderen Fällen ist die Standardisierung Pflicht.
Ohne Standardisierung beschreibt die erste Komponente mit 96.7 Prozent erklärter Varianz im Wesentlichen den Ausstoss (Ladung 0.998), weil dessen Varianz durch die Einheit um Grössenordnungen über den übrigen liegt. Berichtet wird die Analyse auf standardisierten Daten.
Frage und Datenlage
Sechs Kennzahlen aus verschiedenen Bereichen eines Betriebs, die inhaltlich nichts miteinander zu tun haben. Das Beispiel zeigt, wie das Ergebnis aussieht, wenn es nichts zu reduzieren gibt, und warum man die Analyse dann abbricht statt sie zu berichten.
Schon hier ist die Sache entschieden. Es gibt keine gemeinsamen Bewegungen.
Eigenwerte
1.147, 1.046, 1.022, 0.986, 0.968, 0.851
Alle nahe 1, also trägt jede Komponente etwa so viel wie eine einzelne Variable. Genau das ist die Definition von “nichts gewonnen”.
Anteile
19.1 %, 17.4 %, 17.0 %, 16.4 %, 16.1 %, 14.1 %
Alle nahe an einem Sechstel, also 16.7 Prozent.
kumuliert nach zwei Komponenten
36.4 %
Wer hier zwei Komponenten behält, wirft rund zwei Drittel der Information weg und bekommt dafür zwei Mischungen, die sich nicht benennen lassen.
Das Kaiser-Kriterium liefert hier scheinbar drei Komponenten mit Eigenwert über 1. Das ist reine Stichprobenschwankung: Bei sechs unabhängigen Variablen liegen die Eigenwerte per Konstruktion um 1 herum, und etwa die Hälfte davon landet darüber. Ein Kriterium, das ausgerechnet bei strukturlosen Daten ein Ergebnis liefert, taugt nicht als alleinige Entscheidungsgrundlage.
Interpretation und Ergebnissatz
Der Abbruch ist hier das richtige Ergebnis und kein Misserfolg. Er lässt sich zudem vorwegnehmen: Die Korrelationsmatrix zeigt das Fehlen von Struktur, bevor eine einzige Komponente gerechnet ist. Deshalb steht sie am Anfang jeder Analyse.
Wer es formal prüfen will, kann den Bartlett-Test auf Sphärizität oder das KMO-Mass heranziehen; beide beantworten die Frage “gibt es genug Korrelation für eine Reduktion”. Der Blick auf die Matrix genügt in den meisten Fällen.
Die sechs Kennzahlen sind praktisch unkorreliert (alle Korrelationen unter 0.12); die Eigenwerte liegen zwischen 0.85 und 1.15, jede Komponente erklärt rund ein Sechstel der Varianz. Eine Dimensionsreduktion ist hier nicht sinnvoll; die Variablen werden einzeln weiterverwendet.
Frage und Datenlage
Zurück zu den Sensordaten aus Beispiel 1. Die beiden Komponenten sollen nun als Eingang für ein anschliessendes Verfahren dienen, etwa ein Clustering der Schichten oder eine Regression. Der Grund dafür ist technisch: Vibration, Temperatur und Stromaufnahme messen fast dasselbe, und in einer Distanz oder einem Regressionsmodell zählt dieses eine Merkmal dann dreifach.
Nicht ungefähr null, sondern konstruktionsbedingt exakt null. Die Komponenten stehen senkrecht aufeinander.
Varianz von PC1
2.912
Identisch mit dem Eigenwert. Das ist keine Zufälligkeit, sondern die Definition: Der Eigenwert ist die Varianz der Komponentenwerte.
Varianz von PC2
1.925
Ebenso.
erste Komponentenwerte
Beträge von 0 bis rund 7
Sie sind zentriert; der Nullpunkt ist die durchschnittliche Schicht. Ein Betrag von rund 7 auf PC1 bedeutet eine Schicht weit am Rand des Werkzeugblocks, ein Betrag nahe 0 eine unauffällige. Ob dieser Rand das positive oder das negative Ende ist, hängt an der willkürlichen Orientierung der Komponente und kann sich zwischen R und Python unterscheiden.
Interpretation und Ergebnissatz
Der Gewinn ist die Unkorreliertheit, der Preis die Deutbarkeit. Ein Clustering auf PC1 und PC2 liefert Gruppen im gedrehten Raum; um sie zu beschreiben, muss man über die Ladungen zurückrechnen und sagen, dass “Gruppe 2 hohe Werte auf der Werkzeugkomponente hat, also hohe Vibration, Temperatur und Stromaufnahme”.
Drei Regeln für die Weiterverwendung:
Regel
Grund
Standardisierung und Komponenten aus den Trainingsdaten lernen, dann auf neue Daten anwenden
Sonst fliesst Information aus den Testdaten in die Transformation ein. In R über predict(pca, neue_daten), in Python über pca.transform() mit demselben StandardScaler.
Nicht nach der Zielvariable auswählen
Die Komponentenanalyse kennt die Zielvariable nicht. Die erste Komponente muss für eine Vorhersage nicht die nützlichste sein; unter Umständen ist es die vierte.
Wenn Deutbarkeit zählt, lieber Variablen weglassen als Komponenten bilden
Eine weggelassene Variable erklärt sich von selbst, eine Komponente nicht.
Für die weitere Auswertung wurden die ersten beiden Komponenten verwendet (zusammen 80.4 Prozent der Varianz, konstruktionsbedingt unkorreliert). Die Standardisierung und die Komponentengewichte wurden auf den Trainingsdaten bestimmt und unverändert auf die übrigen Daten angewendet.
Verständnisfragen
Die erste Komponente erklärt 96.7 Prozent der Varianz und lädt mit 0.998 auf einer einzigen Variablen. Was ist die naheliegendste Erklärung?
Es wurde nicht standardisiert, und diese Variable hat die grösste Varianz
Richtig. Ohne Standardisierung entscheidet die Einheit. Ein Blick auf die Varianzen der Ausgangsvariablen bestätigt das sofort, siehe Beispiel 2.
Die Variable ist die wichtigste im Datensatz
Wichtigkeit lässt sich aus Streuung nicht ableiten.
Die übrigen Variablen sind fehlerhaft
Sie sind nur im Vergleich kleinskaliert.
In Beispiel 1 hat die dritte Komponente einen Eigenwert von 0.999 und lädt mit 0.999 auf der Luftfeuchte. Was bedeutet das?
Die Luftfeuchte hängt mit keiner anderen Variablen zusammen und bildet ihre eigene Komponente
Richtig. Bei standardisierten Daten trägt jede Variable genau 1 bei. Eine Variable ohne Zusammenhang zu den übrigen behält ihren Beitrag vollständig und erscheint als eigene Komponente mit Eigenwert 1. Sie zu behalten hiesse, dieselbe Variable unter neuem Namen mitzuführen.
Die Komponente ist besonders wichtig, weil ihr Eigenwert genau 1 beträgt
Eigenwert 1 ist keine Auszeichnung, sondern genau der Beitrag einer einzelnen Variablen.
Die Luftfeuchte wurde falsch skaliert
Sie ist standardisiert wie alle anderen; das Ergebnis liegt an ihrer fehlenden Korrelation.
In einem zweiten Lauf haben alle Ladungen der ersten Komponente das umgekehrte Vorzeichen. Was folgt daraus?
Nichts, das Vorzeichen einer Komponente ist beliebig
Richtig. Eine Komponente und ihr Negativ beschreiben dieselbe Richtung. Für die Deutung dreht man die Vorzeichen so, dass sie sich gut beschreiben lässt.
Die Analyse ist instabil
Instabil wären wechselnde Ladungsmuster, nicht ein Vorzeichenwechsel.
Die Daten haben sich geändert
Der Wechsel tritt auch bei identischen Daten auf.
Alle sechs Eigenwerte liegen zwischen 0.85 und 1.15, drei davon über 1. Das Kaiser-Kriterium empfiehlt also drei Komponenten. Was ist zu tun?
Drei Komponenten behalten, das Kriterium ist eindeutig
Es ist eindeutig und trotzdem falsch. Bei unkorrelierten Variablen streuen die Eigenwerte um 1, und etwa die Hälfte landet darüber.
Keine Reduktion vornehmen, es gibt keine gemeinsame Struktur
Richtig. Gleichverteilte Eigenwerte bedeuten unkorrelierte Variablen. Die Analyse liefert dann nur eine Drehung, und die Komponenten sind nicht deutbar. Sichtbar ist das schon in der Korrelationsmatrix.
Auf Kovarianzen statt Korrelationen umstellen
Das verschiebt nur das Gewicht zur Variablen mit der grössten Varianz.
Die Varianz der ersten Komponentenwerte beträgt 2.912, und der Eigenwert der ersten Komponente beträgt ebenfalls 2.912. Zufall?
Nein, der Eigenwert ist definiert als die Varianz der Komponentenwerte
Richtig. Beide Zahlen sind dieselbe Grösse, einmal aus der Eigenwertzerlegung und einmal direkt aus den transformierten Daten berechnet.
Ja, bei anderen Daten fallen die Werte auseinander
Die Gleichheit gilt immer.
Nein, weil standardisiert wurde
Die Standardisierung sorgt dafür, dass sich die Eigenwerte auf die Anzahl Variablen summieren, nicht für diese Gleichheit.
Warum sind Komponenten für ein anschliessendes Clustering nützlich, aber nicht umsonst?
Sie sind unkorreliert, dafür schlechter deutbar
Richtig. Korrelierte Ausgangsvariablen gehen mehrfach in die Distanz ein; Komponenten verhindern das. Die Gruppen müssen dann aber über die Ladungen zurückübersetzt werden.
Sie sind robuster gegen Ausreisser
Im Gegenteil, Ausreisser prägen die Richtungen.
Sie machen eine Standardisierung überflüssig
Die Standardisierung geschieht davor und ist Voraussetzung.