Diagrammtyp wählen

Visualisierung
Wahrnehmung
R
Python
Vom Datentyp und der Botschaft zur passenden Darstellung.

Kernideen

  • Die Wahl folgt der Aufgabe, nicht dem Aussehen.
  • Sechs Aufgaben decken fast alles ab: Mengen, Verteilungen, Anteile, Zusammenhänge, Verläufe, Unsicherheit.
  • Das Skalenniveau entscheidet, welche Darstellung überhaupt zulässig ist.
  • Ordinale Reihenfolgen sind Information und werden nie alphabetisch sortiert.
  • Ein Boxplot zeigt fünf Zahlen und verbirgt die Form, auch dann, wenn die Daten in der Nähe des Medians fast leer sind.
  • Ab einigen tausend Punkten zeigt ein Streudiagramm nicht mehr die Daten, sondern nur noch den zuletzt gezeichneten Punkt je Bildschirmstelle.
  • Nicht beim Lieblingsdiagramm anfangen, sondern bei der Aussage.

Erklärung

Vorwissen: Wahrnehmung und Kodierung für die Rangfolge der Kanäle und Skalenniveaus für die Frage, was mit welchen Daten zulässig ist. Umgesetzt wird die Wahl mit ggplot2, matplotlib oder seaborn und plotly.

Zuerst die Aufgabe bestimmen

Die Frage lautet nicht “welches Diagramm sieht gut aus”, sondern “welche Art von Aussage soll transportiert werden”. Sechs Aufgaben decken den Alltag ab:

Aufgabe Typische Frage Kandidaten
Mengen vergleichen Wer ist grösser, wie viel liegt dazwischen? Balken, sortierter Punktplot, Heatmap
Verteilung zeigen Wie streuen die Werte, gibt es mehrere Gipfel? Histogramm, Dichtekurve, Boxplot, Violinplot, empirische Verteilungsfunktion
Anteile zeigen Wie verteilt sich ein Ganzes? gestapelter Balken, Torte bei wenigen Teilen, Mosaik, Treemap
Zusammenhang zeigen Hängen zwei Grössen zusammen? Streudiagramm, Blasendiagramm, Steigungsdiagramm
Verlauf zeigen Wie entwickelt sich etwas über die Zeit? Liniendiagramm, Flächendiagramm, Kalender-Heatmap
Unsicherheit zeigen Wie genau ist die Schätzung? Fehlerbalken, Konfidenzband, Quantilpunkte

Der Weg ist immer derselbe: Aussage formulieren, Aufgabe zuordnen, aus den Kandidaten den einfachsten wählen, der die Aussage trägt.

Dann das Skalenniveau prüfen

Datentyp Beispiel Zulässig Nicht zulässig
kontinuierlich Temperatur, Umsatz, Dauer Position, Länge, Fläche, Farbverlauf
diskret gezählt Stückzahl, Anzahl Personen wie kontinuierlich zwischen den Punkten interpolieren
kategorial mit Ordnung Note, klein/mittel/gross Position, sequenzieller Farbverlauf alphabetisch sortieren
kategorial ohne Ordnung Standort, Produktgruppe Form, qualitative Palette Farbverlauf, der eine Rangfolge suggeriert

Drei Regeln fallen daraus:

  1. Ordinale Reihenfolge erhalten. “klein, mittel, gross” alphabetisch sortiert ergibt “gross, klein, mittel” und macht die Grafik unlesbar.
  2. Nominale Daten nicht mit Verlaufsfarben. Ein Verlauf behauptet eine Ordnung, die es nicht gibt.
  3. Ab etwa sieben Kategorien ist Farbe als Unterscheidungskanal am Ende. Dann trennt Position, etwa als sortierte Balken oder kleine Teilgrafiken.

Die drei häufigsten Fehlgriffe

Torte statt Balken. Winkel liest sich schlechter als Länge. Eine Torte funktioniert bei zwei, höchstens drei Teilen und wenn es um “ungefähr die Hälfte” geht, nicht um Rangfolgen. Durchgerechnet unter Wahrnehmung und Kodierung, Beispiel 1.

Linie über kategoriale Achsen. Eine Linie behauptet, dass es zwischen den Punkten Werte gibt. Zwischen “Bern” und “Chur” gibt es keine.

Doppelachse für zwei Grössen. Die zweite Achse ist frei skalierbar, also ist auch der suggerierte Gleichlauf frei erfunden, siehe irreführende Darstellungen. Besser sind zwei Teilgrafiken übereinander mit gemeinsamer Zeitachse.

Wenn es viele Beobachtungen sind

Ab einigen tausend Punkten überdecken sich die Marken im Streudiagramm, und man sieht nur noch eine Wolke. Drei Auswege, in dieser Reihenfolge:

  1. Transparenz und kleinere Punkte
  2. Binning: Sechsecke oder Kacheln statt Punkte
  3. Zusammenfassen: Dichtekonturen oder eine Glättungslinie über die Punkte

Beispiel 2 beziffert, wie viel dabei auf dem Spiel steht.

Beispiele

Frage und Datenlage

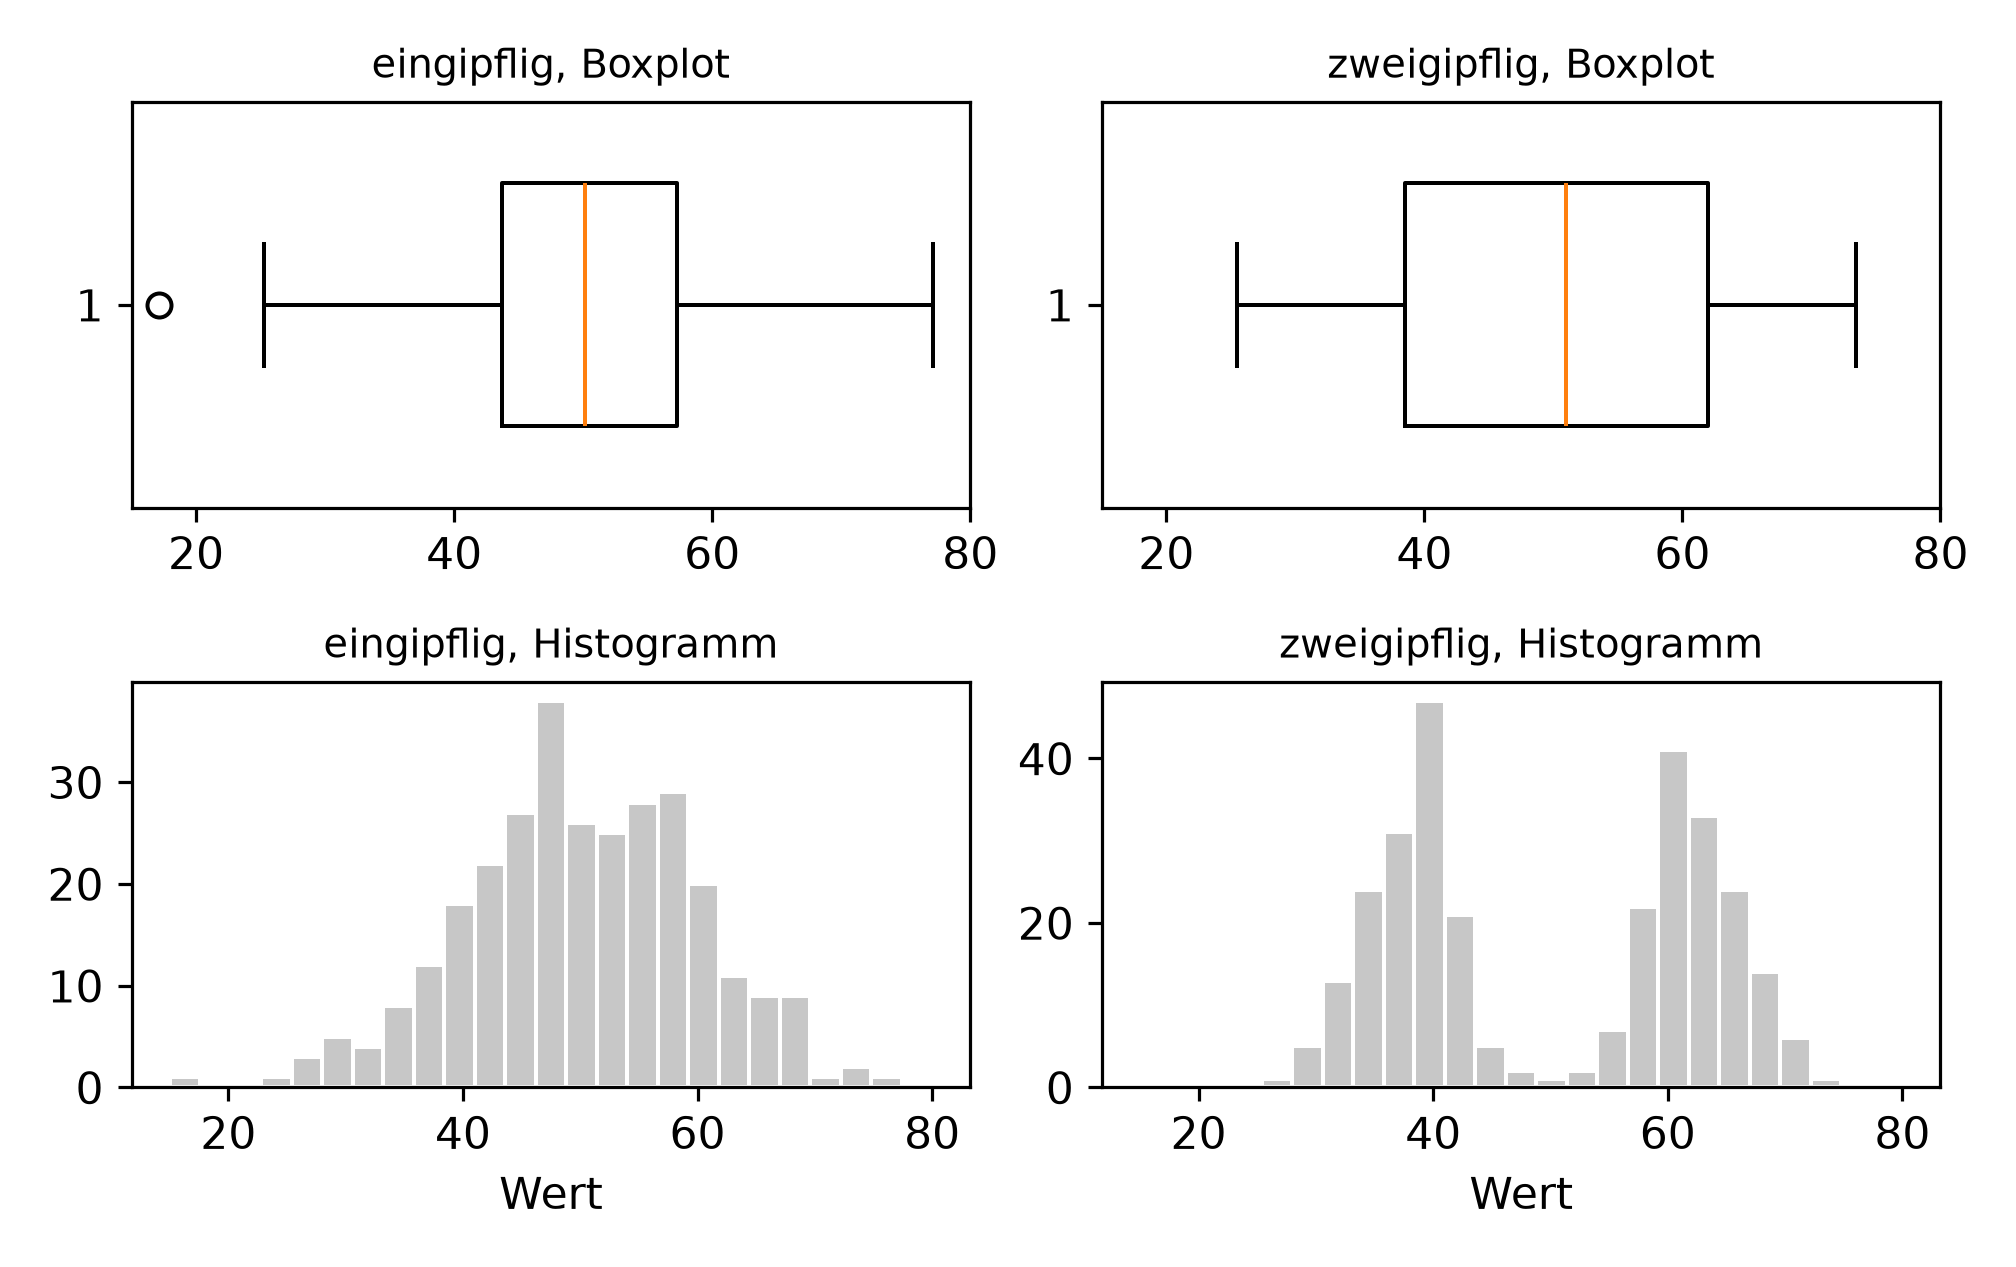
Zwei Verteilungen mit je 300 Werten: eine eingipflige um 50 und eine zweigipflige mit Schwerpunkten bei 38 und 62. Beide haben denselben Mittelwert. Was zeigt der Boxplot davon?

Rechnung

Z <- normalmatrix(1212, 2, 300)
einfach <- 50 + Z[1, ] * 10
zweigipflig <- c(38 + Z[2, 1:150] * 4, 62 + Z[2, 151:300] * 4)

for (nm in c("einfach", "zweigipflig")) {
  x <- get(nm)
  q <- quantile(x, c(0, 0.25, 0.5, 0.75, 1))
  cat(sprintf("%-12s min %6.2f  Q1 %6.2f  Median %6.2f  Q3 %6.2f  max %6.2f  Mittel %6.2f  SD %5.2f\n",
              nm, q[1], q[2], q[3], q[4], q[5], mean(x), sd(x)))
}
einfach      min  17.10  Q1  43.70  Median  50.13  Q3  57.26  max  77.10  Mittel  50.05  SD  9.87
zweigipflig  min  25.51  Q1  38.53  Median  50.95  Q3  61.97  max  73.47  Mittel  50.17  SD 13.00
# Wie viele Werte liegen ueberhaupt in der Naehe des Medians?
round(c(einfach_band_46_54 = mean(einfach > 46 & einfach < 54) * 100,
        zweigipflig_band_46_54 = mean(zweigipflig > 46 & zweigipflig < 54) * 100), 1)
    einfach_band_46_54 zweigipflig_band_46_54 
                  29.7                    1.7 
par(mfrow = c(2, 2), mar = c(4, 4, 2.5, 1))
boxplot(einfach, horizontal = TRUE, ylim = c(15, 80), col = neutral,
        main = "eingipflig, Boxplot")
boxplot(zweigipflig, horizontal = TRUE, ylim = c(15, 80), col = neutral,
        main = "zweigipflig, Boxplot")
hist(einfach, breaks = 25, xlim = c(15, 80), col = neutral, border = "white",
     main = "eingipflig, Histogramm", xlab = "Wert")
hist(zweigipflig, breaks = 25, xlim = c(15, 80), col = neutral, border = "white",
     main = "zweigipflig, Histogramm", xlab = "Wert")
par(mfrow = c(1, 1))
Abbildung 1: Beispiel 1: oben die Boxplots, unten dieselben Daten als Histogramm.
Z = normalmatrix(1212, 2, 300)
einfach = 50 + Z[0] * 10
zweigipflig = np.concatenate([38 + Z[1][:150] * 4, 62 + Z[1][150:] * 4])

for name, x in [("einfach", einfach), ("zweigipflig", zweigipflig)]:
    q = np.percentile(x, [0, 25, 50, 75, 100])
    print(f"{name:<12} min {q[0]:6.2f}  Q1 {q[1]:6.2f}  Median {q[2]:6.2f}"
          f"  Q3 {q[3]:6.2f}  max {q[4]:6.2f}"
          f"  Mittel {x.mean():6.2f}  SD {x.std(ddof=1):5.2f}")
einfach      min  17.10  Q1  43.70  Median  50.13  Q3  57.26  max  77.10  Mittel  50.05  SD  9.87
zweigipflig  min  25.51  Q1  38.53  Median  50.95  Q3  61.97  max  73.47  Mittel  50.17  SD 13.00
print({"einfach_band_46_54":
           round(float(((einfach > 46) & (einfach < 54)).mean() * 100), 1),
       "zweigipflig_band_46_54":
           round(float(((zweigipflig > 46) & (zweigipflig < 54)).mean() * 100), 1)})
{'einfach_band_46_54': 29.7, 'zweigipflig_band_46_54': 1.7}
fig, achsen = plt.subplots(2, 2, figsize=(7, 4.4))
for spalte, (name, x) in enumerate([("eingipflig", einfach),
                                    ("zweigipflig", zweigipflig)]):
    _ = achsen[0, spalte].boxplot(x, vert=False, widths=0.6)
    _ = achsen[0, spalte].set_xlim(15, 80)
    _ = achsen[0, spalte].set_title(f"{name}, Boxplot", fontsize=10)
    _ = achsen[1, spalte].hist(x, bins=25, range=(15, 80), color=NEUTRAL,
                               edgecolor="white")
    _ = achsen[1, spalte].set_title(f"{name}, Histogramm", fontsize=10)
    _ = achsen[1, spalte].set_xlabel("Wert")
plt.tight_layout()
plt.show()
Abbildung 2: Beispiel 1: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

Verteilung Minimum Q1 Median Q3 Maximum Mittel SD
eingipflig 17.10 43.70 50.13 57.26 77.10 50.05 9.87
zweigipflig 25.51 38.53 50.95 61.97 73.47 50.17 13.00
Anteil im Band 46 bis 54
eingipflig 29.7 Prozent
zweigipflig 1.7 Prozent
Beobachtung Erklärung
Die Mediane liegen bei 50.13 und 50.95 Praktisch gleich, und beide Mittelwerte bei 50.1. Die fünf Kennzahlen des Boxplots unterscheiden sich nur in der Breite der Box.
Nur 1.7 Prozent der zweigipfligen Werte liegen in der Nähe ihres Medians Gegen 29.7 Prozent bei der eingipfligen. Der Median der zweigipfligen Verteilung liegt in einem Bereich, in dem fast keine Daten sind, er ist rechnerisch korrekt und inhaltlich irreführend.
Die grössere SD ist der einzige Hinweis 13.00 gegen 9.87. Wer nur die Kennzahlen sieht, hält die zweite Verteilung für etwas breiter gestreut, nicht für zweigipflig.
Das Histogramm zeigt es sofort Zwei Berge mit einem Tal dazwischen. Kein Nachdenken nötig.
Der Boxplot bleibt trotzdem nützlich Für den Vergleich vieler Gruppen: kompakt, und Lage und Streuung sind über Position vergleichbar. Bei wenigen Gruppen ist die Form wichtiger.

Die Entscheidungsregel für Verteilungen:

Anzahl Gruppen Empfehlung
1 bis 3 Histogramm oder Dichtekurve, die Form ist die Aussage
4 bis 10 Violinplot oder Boxplot mit überlagerten Punkten
mehr als 10 Boxplot, sortiert nach Median

Der Zusatz “mit überlagerten Punkten” ist der billigste Gewinn der ganzen Liste: Er kostet eine Codezeile und hätte den zweiten Gipfel sichtbar gemacht.

Interpretation und Ergebnissatz

Beide Verteilungen haben einen Mittelwert um 50.1 und Mediane von 50.13 und 50.95. In der Nähe des Medians liegen jedoch 29.7 Prozent der eingipfligen, aber nur 1.7 Prozent der zweigipfligen Werte, ein Unterschied, den der Boxplot nicht zeigt und das Histogramm sofort.

Frage und Datenlage

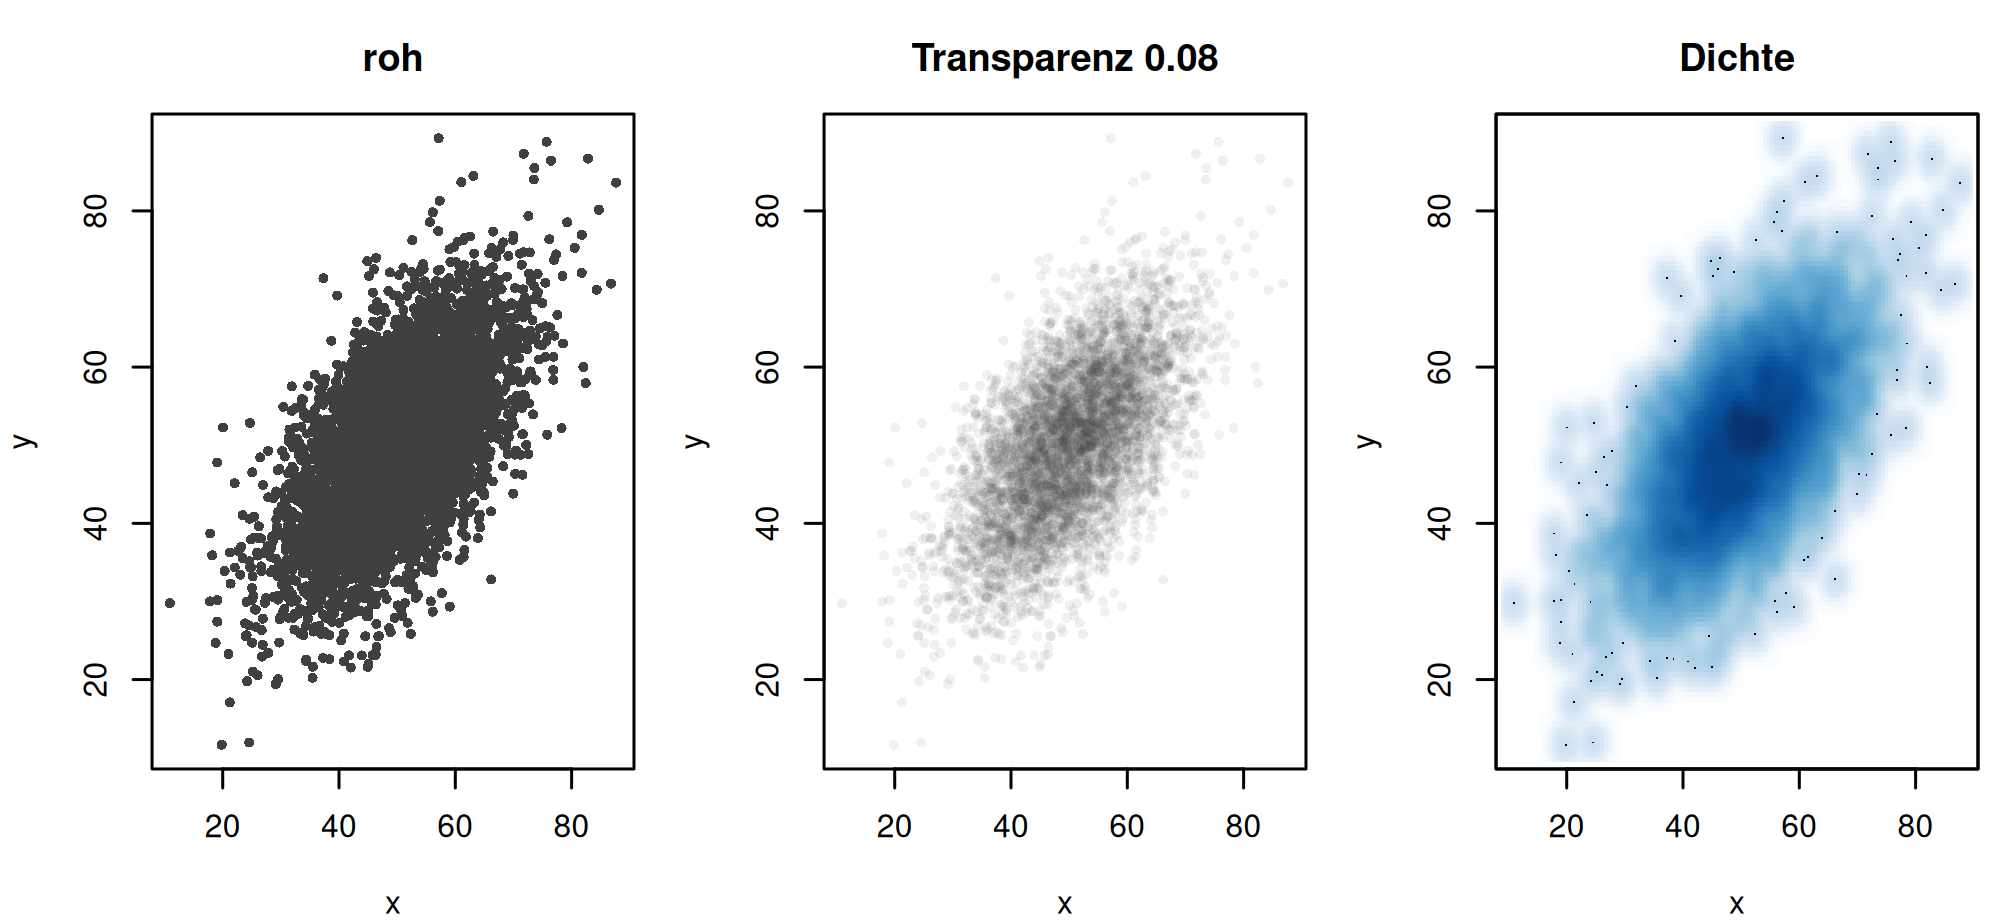
5000 Punkte in einem Streudiagramm. Die Frage ist nicht, ob es unübersichtlich wird, sondern wie viele Punkte überhaupt noch sichtbar sind. Gezählt wird über ein Raster in der Grössenordnung einer Punktmarke.

Rechnung

n <- 5000
Z <- normalmatrix(5566, 2, n)
x <- 50 + Z[1, ] * 10
y <- 0.6 * x + 20 + Z[2, ] * 8
round(c(korrelation = cor(x, y)), 4)
korrelation 
     0.6036 
for (zellen in c(60, 120)) {
  ix <- floor((x - min(x)) / (max(x) - min(x)) * (zellen - 1e-9))
  iy <- floor((y - min(y)) / (max(y) - min(y)) * (zellen - 1e-9))
  schluessel <- ix * zellen + iy
  belegt <- length(unique(schluessel))
  cat(sprintf("Raster %3dx%3d: %4d belegte Zellen, %4.1f Prozent der Punkte verdeckt, dichteste Zelle %2d Punkte\n",
              zellen, zellen, belegt, 100 * (1 - belegt / n),
              max(table(schluessel))))
}
Raster  60x 60: 1021 belegte Zellen, 79.6 Prozent der Punkte verdeckt, dichteste Zelle 23 Punkte
Raster 120x120: 2451 belegte Zellen, 51.0 Prozent der Punkte verdeckt, dichteste Zelle 10 Punkte
par(mfrow = c(1, 3), mar = c(4, 4, 3, 1))
plot(x, y, pch = 16, cex = 0.7, col = "grey25", main = "roh")
plot(x, y, pch = 16, cex = 0.7, col = adjustcolor("grey25", alpha.f = 0.08),
     main = "Transparenz 0.08")
smoothScatter(x, y, main = "Dichte", xlab = "x", ylab = "y")
par(mfrow = c(1, 1))
Abbildung 3: Beispiel 2: dieselben 5000 Punkte roh, mit Transparenz und als Sechseckraster.
n = 5000
Z = normalmatrix(5566, 2, n)
x = 50 + Z[0] * 10
y = 0.6 * x + 20 + Z[1] * 8
print({"korrelation": round(float(np.corrcoef(x, y)[0, 1]), 4)})

for zellen in (60, 120):
    ix = np.floor((x - x.min()) / (x.max() - x.min()) * (zellen - 1e-9)).astype(int)
    iy = np.floor((y - y.min()) / (y.max() - y.min()) * (zellen - 1e-9)).astype(int)
    schluessel = ix * zellen + iy
    _, anzahl = np.unique(schluessel, return_counts=True)
    belegt = len(anzahl)
    print(f"Raster {zellen:3d}x{zellen:3d}: {belegt:4d} belegte Zellen,"
          f" {100 * (1 - belegt / n):4.1f} Prozent der Punkte verdeckt,"
          f" dichteste Zelle {anzahl.max():2d} Punkte")
Raster  60x 60: 1021 belegte Zellen, 79.6 Prozent der Punkte verdeckt, dichteste Zelle 23 Punkte
Raster 120x120: 2451 belegte Zellen, 51.0 Prozent der Punkte verdeckt, dichteste Zelle 10 Punkte
fig, achsen = plt.subplots(1, 3, figsize=(7, 3.2))
_ = achsen[0].scatter(x, y, s=5, color="0.25")
_ = achsen[0].set_title("roh")
_ = achsen[1].scatter(x, y, s=5, color="0.25", alpha=0.08)
_ = achsen[1].set_title("Transparenz 0.08")
_ = achsen[2].hexbin(x, y, gridsize=40, cmap="Greys")
_ = achsen[2].set_title("Sechseckraster")
for achse in achsen:
    _ = achse.set_xlabel("x")
    _ = achse.set_ylabel("y")
plt.tight_layout()
plt.show()
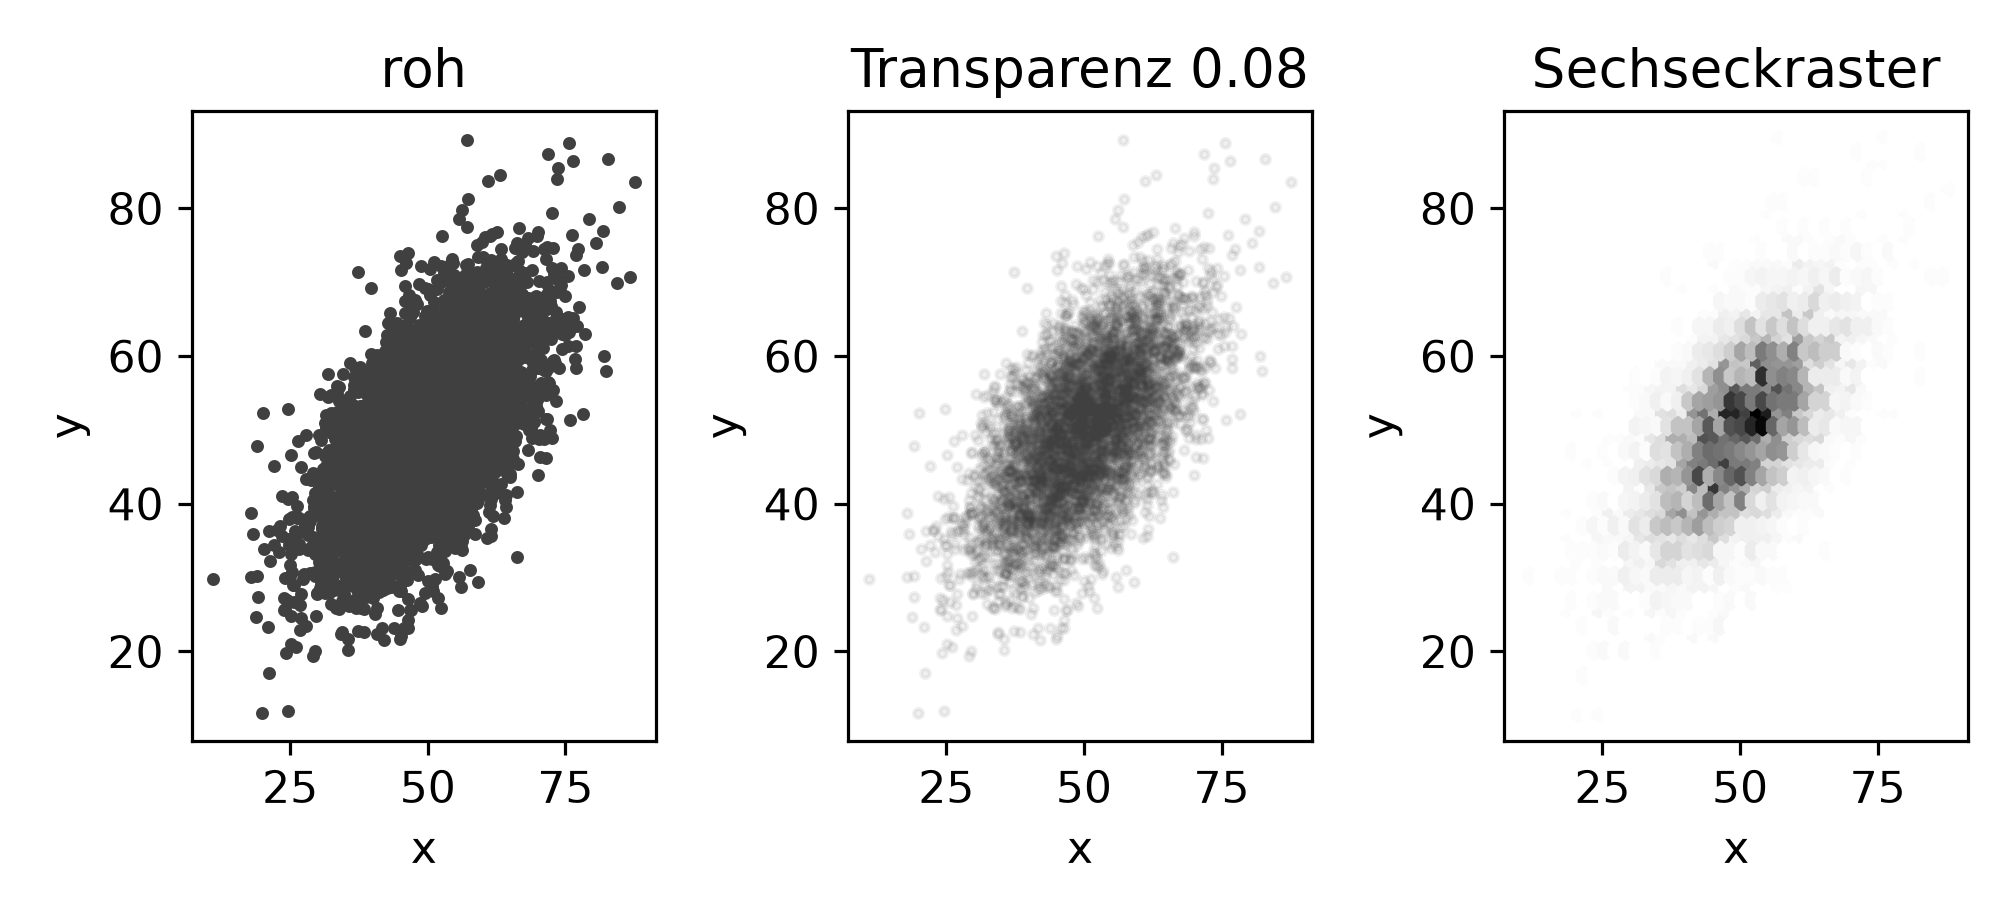
Abbildung 4: Beispiel 2: dieselben drei Darstellungen in Python.

Output Zeile für Zeile

Raster belegte Zellen verdeckte Punkte dichteste Zelle
60 × 60 1021 von 5000 79.6 Prozent 23 Punkte
120 × 120 2451 von 5000 51.0 Prozent 10 Punkte

Korrelation zwischen x und y: 0.6036.

Beobachtung Erklärung
Bei grober Auflösung sind fast 80 Prozent der Punkte unsichtbar Sie liegen auf einer Stelle, die schon belegt ist. Man sieht also 1021 Punkte und glaubt, 5000 zu sehen.
Selbst bei feiner Auflösung ist es die Hälfte 51 Prozent bei 120 × 120 Zellen. Das Problem verschwindet nicht durch eine grössere Grafik, es wird nur kleiner.
In der dichtesten Zelle liegen 23 Punkte Ein einzelner sichtbarer Punkt steht dort für 23. Genau in der Mitte der Wolke, wo die meiste Information wäre.
Das verzerrt den Eindruck der Form Der Rand der Wolke ist dünn besetzt und daher vollständig sichtbar, die Mitte ist dicht und wird auf einen Punkt reduziert. Ein rohes Streudiagramm zeigt systematisch die Ausreisser und unterschlägt die Masse.
Transparenz und Raster lösen dasselbe Problem verschieden Transparenz behält die einzelnen Punkte und macht Dichte über Helligkeit sichtbar; das Raster gibt die Einzelpunkte auf und zeigt Dichte als Zahl je Zelle.

Welcher Ausweg wann:

Punktzahl Mittel
bis ~1000 kleinere Punkte genügen meist
1000 bis ~20 000 Transparenz, Wert um 0.05 bis 0.2
ab ~20 000 Sechseckraster (geom_hex, ax.hexbin) oder Dichtekonturen
beliebig viele, wenn es um den Trend geht Glättungslinie über eine ausgedünnte Punktwolke

Die Transparenz ist so zu wählen, dass die dichteste Stelle gerade noch nicht gesättigt ist, hier also etwa 1/23, entsprechend 0.04 bis 0.08.

Interpretation und Ergebnissatz

Von 5000 Punkten sind bei einer Auflösung von 60 × 60 Zellen nur 1021 Stellen belegt: 79.6 Prozent der Punkte liegen auf einer bereits gezeichneten Position, in der dichtesten Zelle 23 übereinander. Die Verdeckung trifft systematisch die dichte Mitte und nicht die Ränder.

Frage und Datenlage

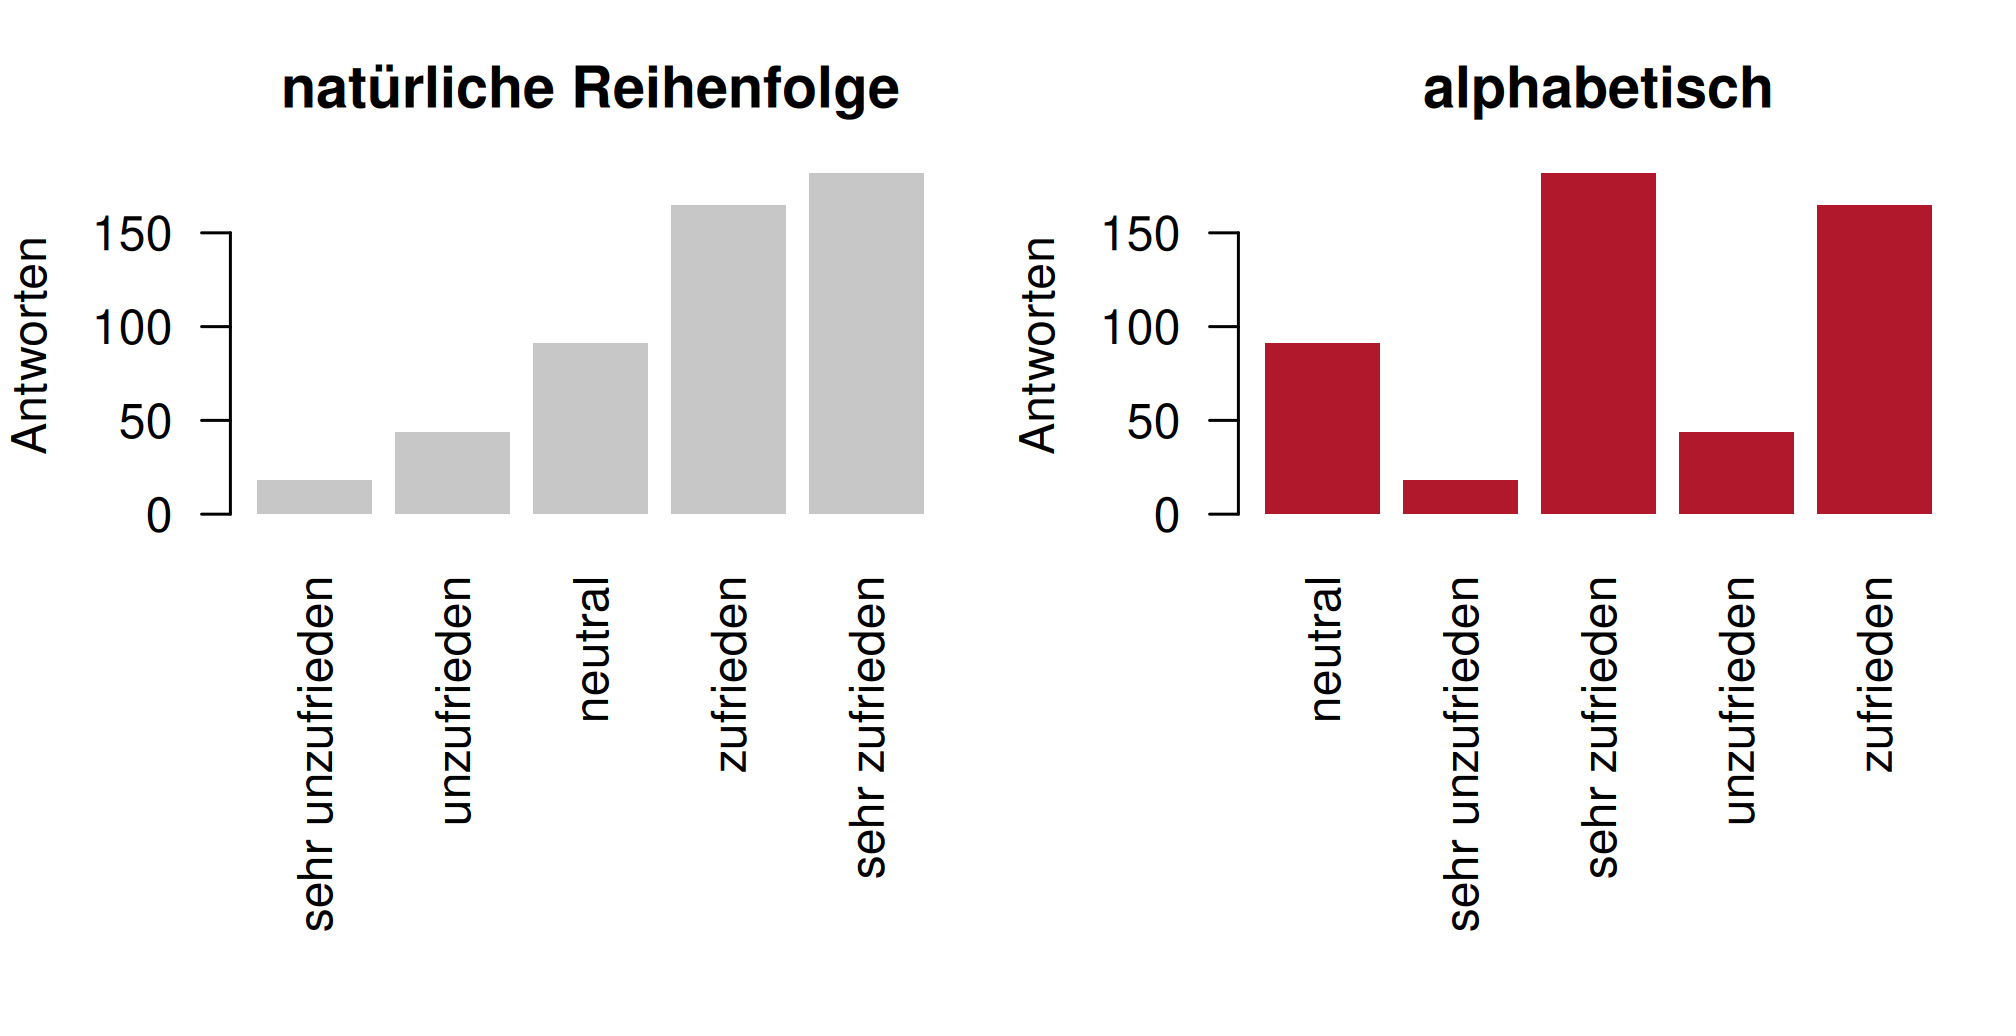
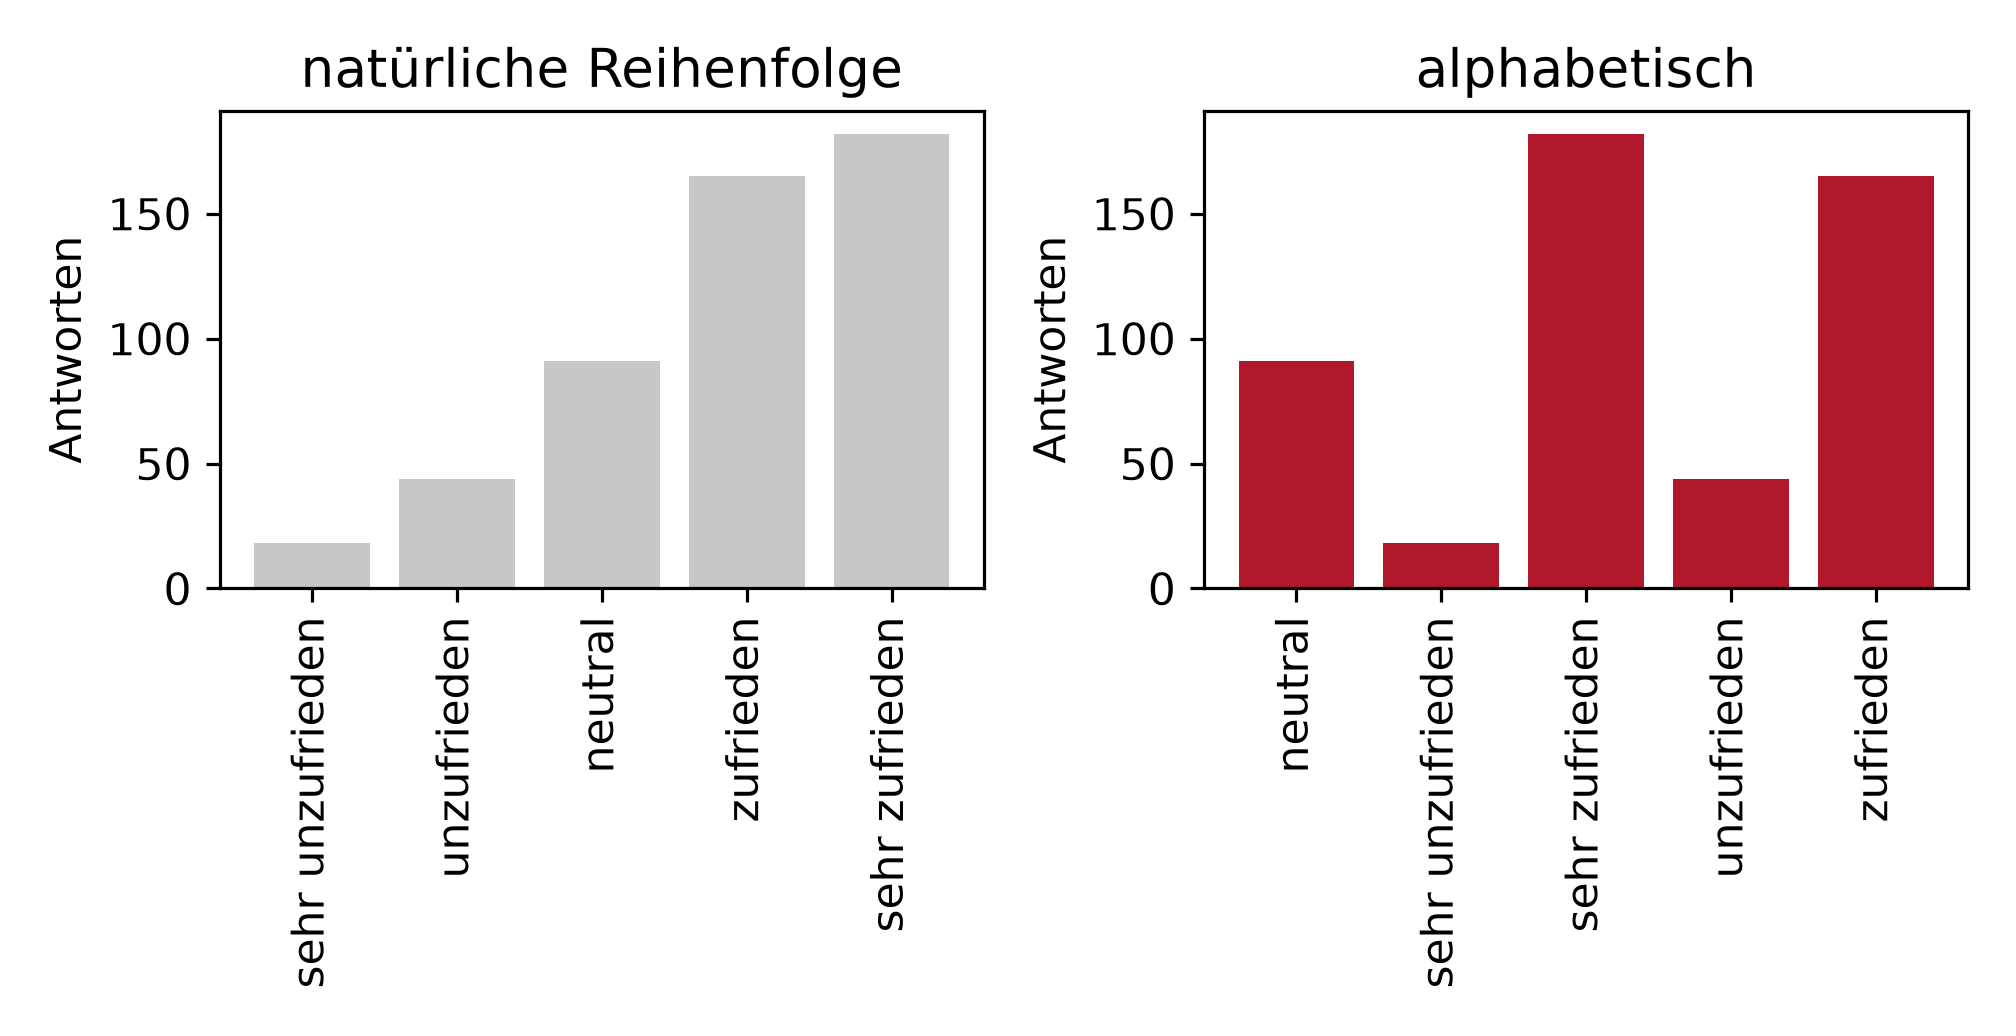
Eine Zufriedenheitsumfrage mit 500 Antworten auf fünf ordinalen Stufen. Einmal in der natürlichen Reihenfolge dargestellt, einmal alphabetisch sortiert und die Frage, was dabei messbar verloren geht.

Rechnung

stufen <- c("sehr unzufrieden", "unzufrieden", "neutral",
            "zufrieden", "sehr zufrieden")
anzahl <- c(18, 44, 91, 165, 182)

reihenfolge <- order(stufen)
data.frame(alphabetisch = stufen[reihenfolge], anzahl = anzahl[reihenfolge])
      alphabetisch anzahl
1          neutral     91
2 sehr unzufrieden     18
3   sehr zufrieden    182
4      unzufrieden     44
5        zufrieden    165
round(c(spearman_natuerlich = cor(1:5, anzahl, method = "spearman"),
        spearman_alphabetisch = cor(1:5, anzahl[reihenfolge], method = "spearman"),
        anteil_zufrieden_oder_besser = sum(anzahl[4:5]) / sum(anzahl) * 100), 4)
         spearman_natuerlich        spearman_alphabetisch 
                         1.0                          0.3 
anteil_zufrieden_oder_besser 
                        69.4 
par(mfrow = c(1, 2), mar = c(9, 4, 3, 1))
barplot(anzahl, names.arg = stufen, las = 2, col = neutral, border = NA,
        ylab = "Antworten", main = "natürliche Reihenfolge")
barplot(anzahl[reihenfolge], names.arg = stufen[reihenfolge], las = 2,
        col = akzent, border = NA, ylab = "Antworten", main = "alphabetisch")
par(mfrow = c(1, 1))
Abbildung 5: Beispiel 3: links die natürliche Reihenfolge, rechts alphabetisch.
stufen = ["sehr unzufrieden", "unzufrieden", "neutral",
          "zufrieden", "sehr zufrieden"]
anzahl = np.array([18, 44, 91, 165, 182])

reihenfolge = sorted(range(5), key=lambda i: stufen[i])
print(pd.DataFrame({"alphabetisch": [stufen[i] for i in reihenfolge],
                    "anzahl": anzahl[reihenfolge]}).to_string(index=False))

print({"spearman_natuerlich":
           round(float(stats.spearmanr(np.arange(5), anzahl).statistic), 4),
       "spearman_alphabetisch":
           round(float(stats.spearmanr(np.arange(5), anzahl[reihenfolge]).statistic), 4),
       "anteil_zufrieden_oder_besser":
           round(float(anzahl[3:].sum() / anzahl.sum() * 100), 4)})

fig, achsen = plt.subplots(1, 2, figsize=(7, 3.6))
_ = achsen[0].bar(stufen, anzahl, color=NEUTRAL)
_ = achsen[0].set_title("natürliche Reihenfolge")
_ = achsen[1].bar([stufen[i] for i in reihenfolge], anzahl[reihenfolge],
                  color=AKZENT)
_ = achsen[1].set_title("alphabetisch")
for achse in achsen:
    _ = achse.set_ylabel("Antworten")
    _ = achse.tick_params(axis="x", rotation=90)
plt.tight_layout()
plt.show()
Abbildung 6: Beispiel 3: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

natürliche Reihenfolge sehr unzufrieden unzufrieden neutral zufrieden sehr zufrieden
Antworten 18 44 91 165 182
alphabetisch neutral sehr unzufrieden sehr zufrieden unzufrieden zufrieden
Antworten 91 18 182 44 165
Kennzahl Wert
Spearman (Position gegen Anzahl), natürlich 1.0000
Spearman, alphabetisch 0.3000
Anteil “zufrieden” oder besser 69.4 Prozent
Beobachtung Erklärung
In der natürlichen Reihenfolge steigen die Balken monoton Spearman genau 1.0. Die Aussage “je zufriedener, desto häufiger” ist die Form der Grafik selbst, man muss keine Zahl lesen.
Alphabetisch sinkt der Zusammenhang auf 0.3 Aus einer Treppe wird ein Zickzack. Dieselben fünf Zahlen, dieselben fünf Balken.
Die beiden “sehr”-Stufen landen nebeneinander “sehr unzufrieden” (18) direkt neben “sehr zufrieden” (182), die beiden Extreme der Skala, weil beide mit “sehr” beginnen.
Der Fehler entsteht von allein Weder R noch Python kennen die Reihenfolge einer Zeichenkette. Wer nichts angibt, bekommt die alphabetische. Das ist die Voreinstellung, nicht die Entscheidung.
Die Rettung ist ein Faktor mit gesetzten Stufen factor(x, levels = stufen) in R, pd.Categorical(x, categories=stufen, ordered=True) in Python.

Die alphabetische Sortierung hängt zudem an der Spracheinstellung. Gross- und Kleinschreibung, Umlaute und länderspezifische Regeln führen zu verschiedenen Reihenfolgen auf verschiedenen Rechnern, dieselbe Grafik sieht dann woanders anders aus.

Auf dieser Seite sind alle Stufen klein geschrieben und ohne Umlaute, damit R und Python garantiert dieselbe Reihenfolge liefern. Das ist ein Umweg um das Problem, keine Lösung: Die Lösung ist, die Reihenfolge festzulegen.

Mehr zum Thema unter Skalenniveaus.

Interpretation und Ergebnissatz

In der natürlichen Reihenfolge steigen die Antwortzahlen monoton, der Rangkorrelationskoeffizient zwischen Position und Anzahl beträgt 1.0. Alphabetisch sortiert sinkt er auf 0.3, und die Extremstufen “sehr unzufrieden” und “sehr zufrieden” stehen nebeneinander.

Frage und Datenlage

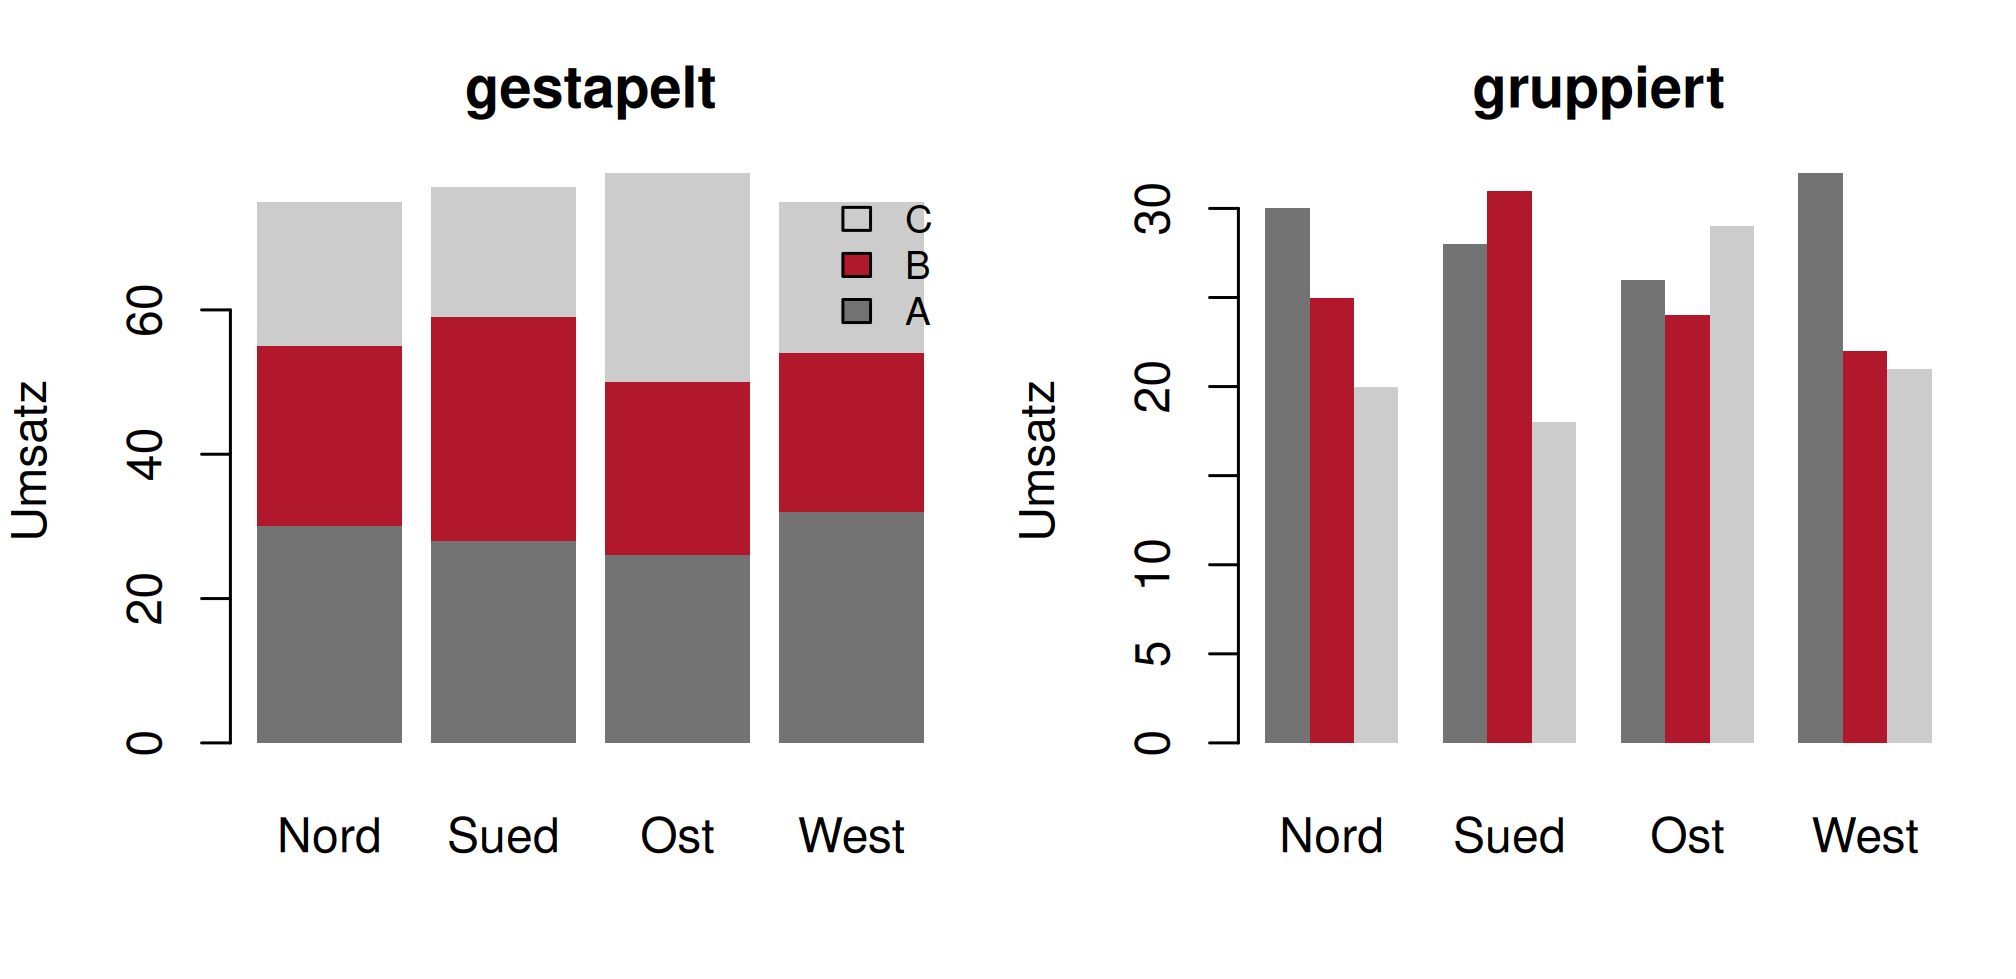
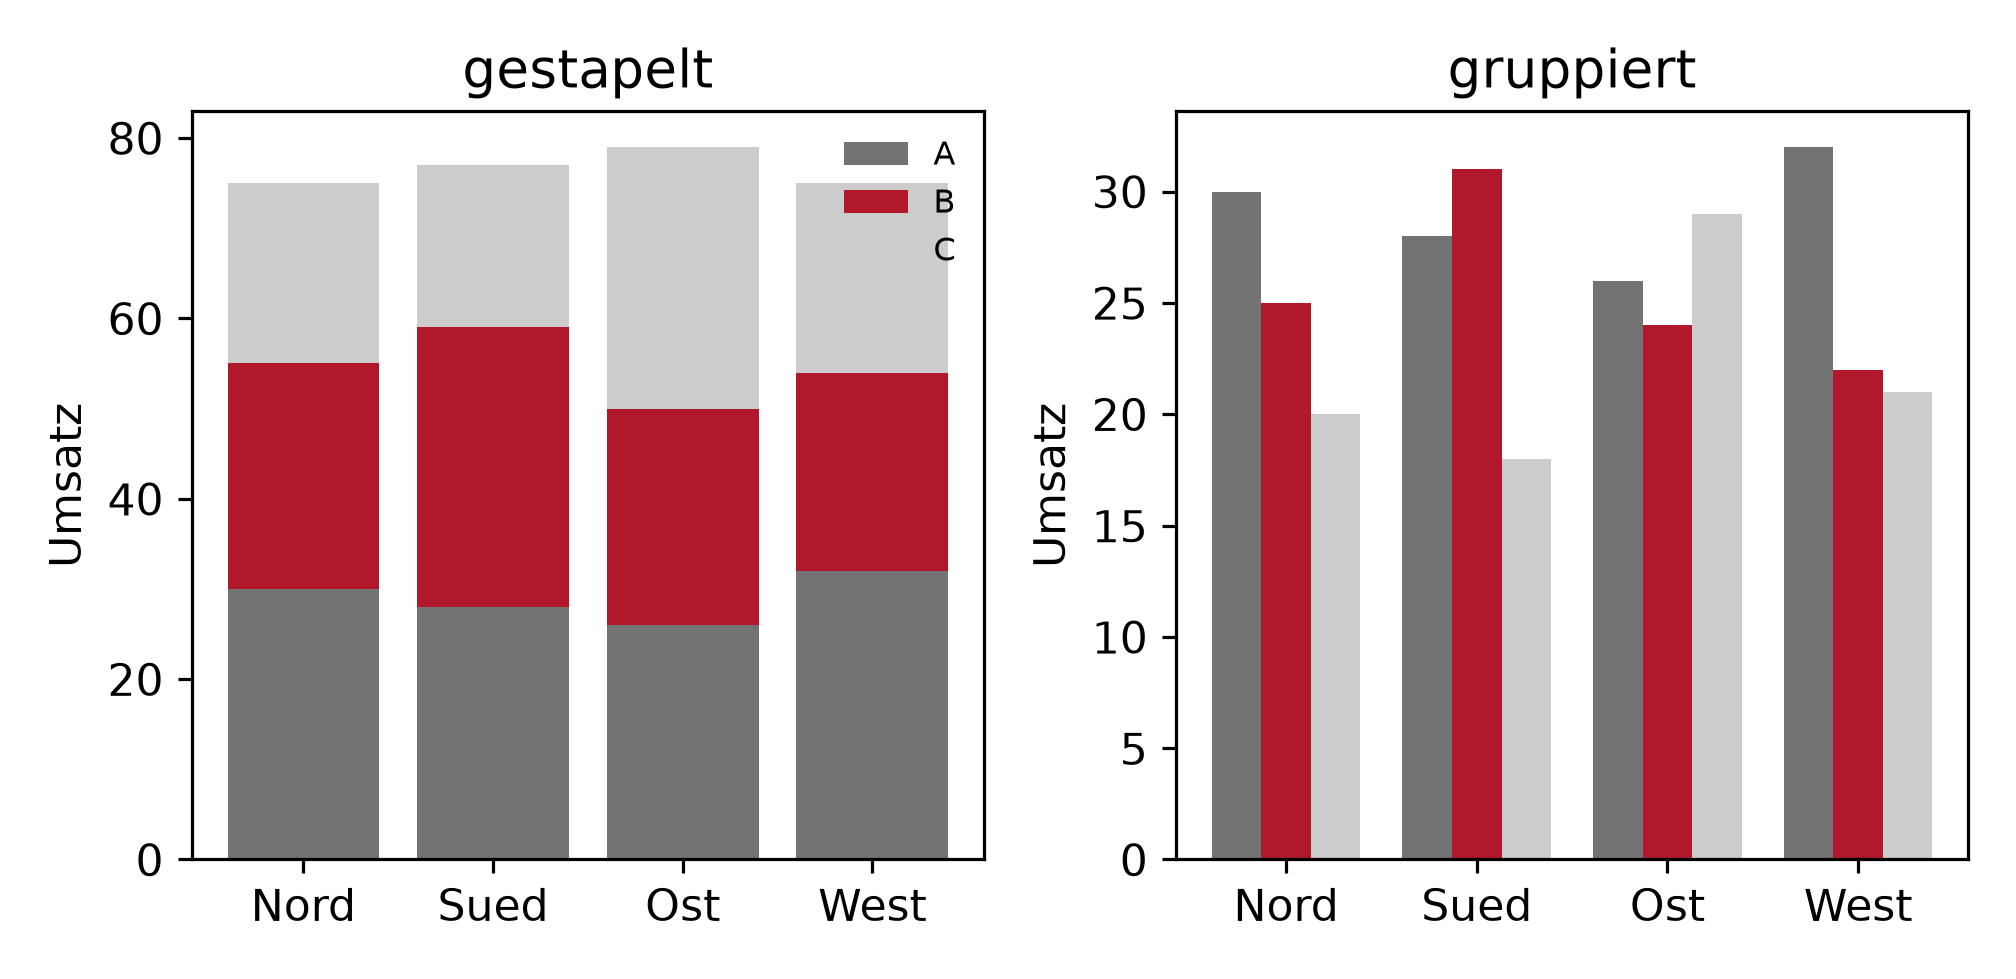
Vier Regionen mit je drei Produktgruppen. Die Frage: In welcher Region ist die Produktgruppe B am stärksten? Einmal als gestapelter Balken, einmal gruppiert.

Rechnung

regionen <- c("Nord", "Sued", "Ost", "West")
mat <- rbind(Nord = c(30, 25, 20), Sued = c(28, 31, 18),
             Ost = c(26, 24, 29), West = c(32, 22, 21))
colnames(mat) <- c("A", "B", "C")
mat
      A  B  C
Nord 30 25 20
Sued 28 31 18
Ost  26 24 29
West 32 22 21
c(groesste_B = regionen[which.max(mat[, "B"])],
  wert = max(mat[, "B"]))
groesste_B       wert 
    "Sued"       "31" 
round(c(spannweite_der_startlinien = max(mat[, "A"]) - min(mat[, "A"]),
        unterschied_in_B = max(mat[, "B"]) - min(mat[, "B"])), 1)
spannweite_der_startlinien           unterschied_in_B 
                         6                          9 
farben <- c("grey45", akzent, "grey80")
par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))
barplot(t(mat), col = farben, border = NA, ylab = "Umsatz",
        main = "gestapelt", legend.text = colnames(mat),
        args.legend = list(x = "topright", bty = "n", cex = 0.8))
barplot(t(mat), beside = TRUE, col = farben, border = NA, ylab = "Umsatz",
        main = "gruppiert")
par(mfrow = c(1, 1))
Abbildung 7: Beispiel 4: links gestapelt, rechts gruppiert.
regionen = ["Nord", "Sued", "Ost", "West"]
mat = pd.DataFrame([[30, 25, 20], [28, 31, 18], [26, 24, 29], [32, 22, 21]],
                   index=regionen, columns=["A", "B", "C"], dtype=float)
print(mat)
         A     B     C
Nord  30.0  25.0  20.0
Sued  28.0  31.0  18.0
Ost   26.0  24.0  29.0
West  32.0  22.0  21.0
print({"groesste_B": regionen[int(np.argmax(mat["B"]))],
       "wert": float(mat["B"].max())})
{'groesste_B': 'Sued', 'wert': 31.0}
print({"spannweite_der_startlinien": float(mat["A"].max() - mat["A"].min()),
       "unterschied_in_B": float(mat["B"].max() - mat["B"].min())})
{'spannweite_der_startlinien': 6.0, 'unterschied_in_B': 9.0}
farben = ["0.45", AKZENT, "0.80"]
fig, achsen = plt.subplots(1, 2, figsize=(7, 3.4))
unten = np.zeros(4)
for spalte, farbe in zip(mat.columns, farben):
    _ = achsen[0].bar(regionen, mat[spalte], bottom=unten, color=farbe,
                      label=spalte)
    unten = unten + mat[spalte].to_numpy()
_ = achsen[0].set_title("gestapelt")
_ = achsen[0].legend(frameon=False, fontsize=8)
breite = 0.26
for k, (spalte, farbe) in enumerate(zip(mat.columns, farben)):
    _ = achsen[1].bar(np.arange(4) + (k - 1) * breite, mat[spalte],
                      width=breite, color=farbe, label=spalte)
_ = achsen[1].set_xticks(np.arange(4), regionen)
_ = achsen[1].set_title("gruppiert")
for achse in achsen:
    _ = achse.set_ylabel("Umsatz")
plt.tight_layout()
plt.show()
Abbildung 8: Beispiel 4: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

Region A B C
Nord 30 25 20
Sued 28 31 18
Ost 26 24 29
West 32 22 21
Kennzahl Wert
Region mit dem grössten B Sued (31)
Spannweite der Startlinien von B (= Höhe von A) 6.0
Unterschied in B, grösste minus kleinste Region 9.0
Beobachtung Erklärung
Im gestapelten Balken hat nur A eine gemeinsame Grundlinie A liegt unten und lässt sich über Position vergleichen, Rang 1 der Kanalrangfolge. B und C schweben und lassen sich nur über Länge vergleichen, Rang 3.
Die Startlinien von B schwanken um 6.0 Bei einem echten Unterschied in B von 9.0. Die Störgrösse ist also zwei Drittel so gross wie das Signal, deshalb ist “welche Region hat das grösste B” im gestapelten Balken kaum zu beantworten.
Gruppiert ist die Antwort sofort da Alle B-Balken stehen auf derselben Grundlinie. Sued ragt heraus.
Der gestapelte Balken kann dafür etwas anderes Er zeigt die Summe je Region auf einen Blick, was der gruppierte nicht kann.
Es gibt keinen Sieger, nur eine Frage “Wie gross ist das Ganze?” → gestapelt. “Wie vergleichen sich die Teile?” → gruppiert. Wer beides braucht, zeichnet beides.

Die Sonderregel für gestapelte Balken: Die Reihenfolge der Segmente ist eine Entscheidung. Die Kategorie, auf die es ankommt, gehört nach unten, damit sie die gemeinsame Grundlinie bekommt.

Bei gestapelten Balken mit Anteilen (alle Stapel gleich hoch) verschwindet das Problem für das unterste und das oberste Segment, beide haben eine Grundlinie. Nur die Mitte bleibt schwer lesbar. Bei mehr als drei bis vier Segmenten ist ein Stapel ohnehin nicht mehr zu lesen; dann sind kleine Teilgrafiken die bessere Wahl.

Interpretation und Ergebnissatz

Die Produktgruppe B ist in Sued mit 31 am grössten; der Unterschied zur schwächsten Region beträgt 9.0. Im gestapelten Balken schwanken die Startlinien von B jedoch um 6.0, sodass der Vergleich dort kaum möglich ist, im gruppierten Balken steht er auf gemeinsamer Grundlinie.

Frage und Datenlage

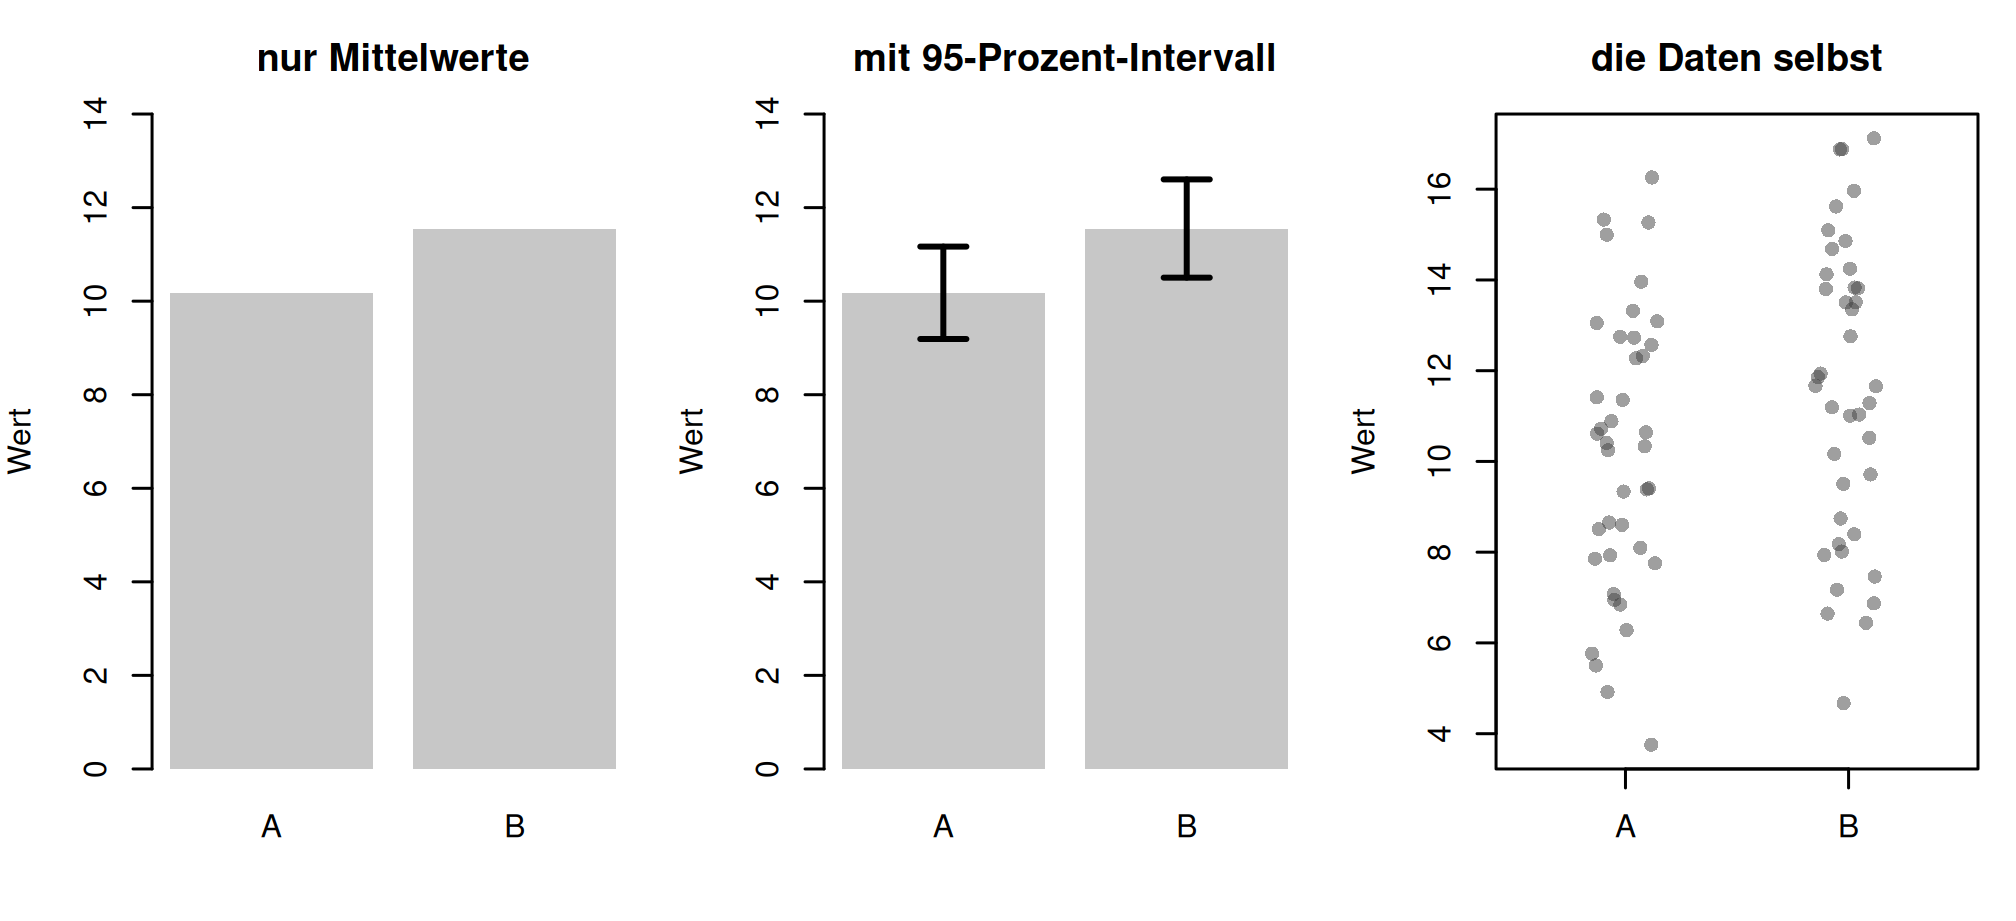
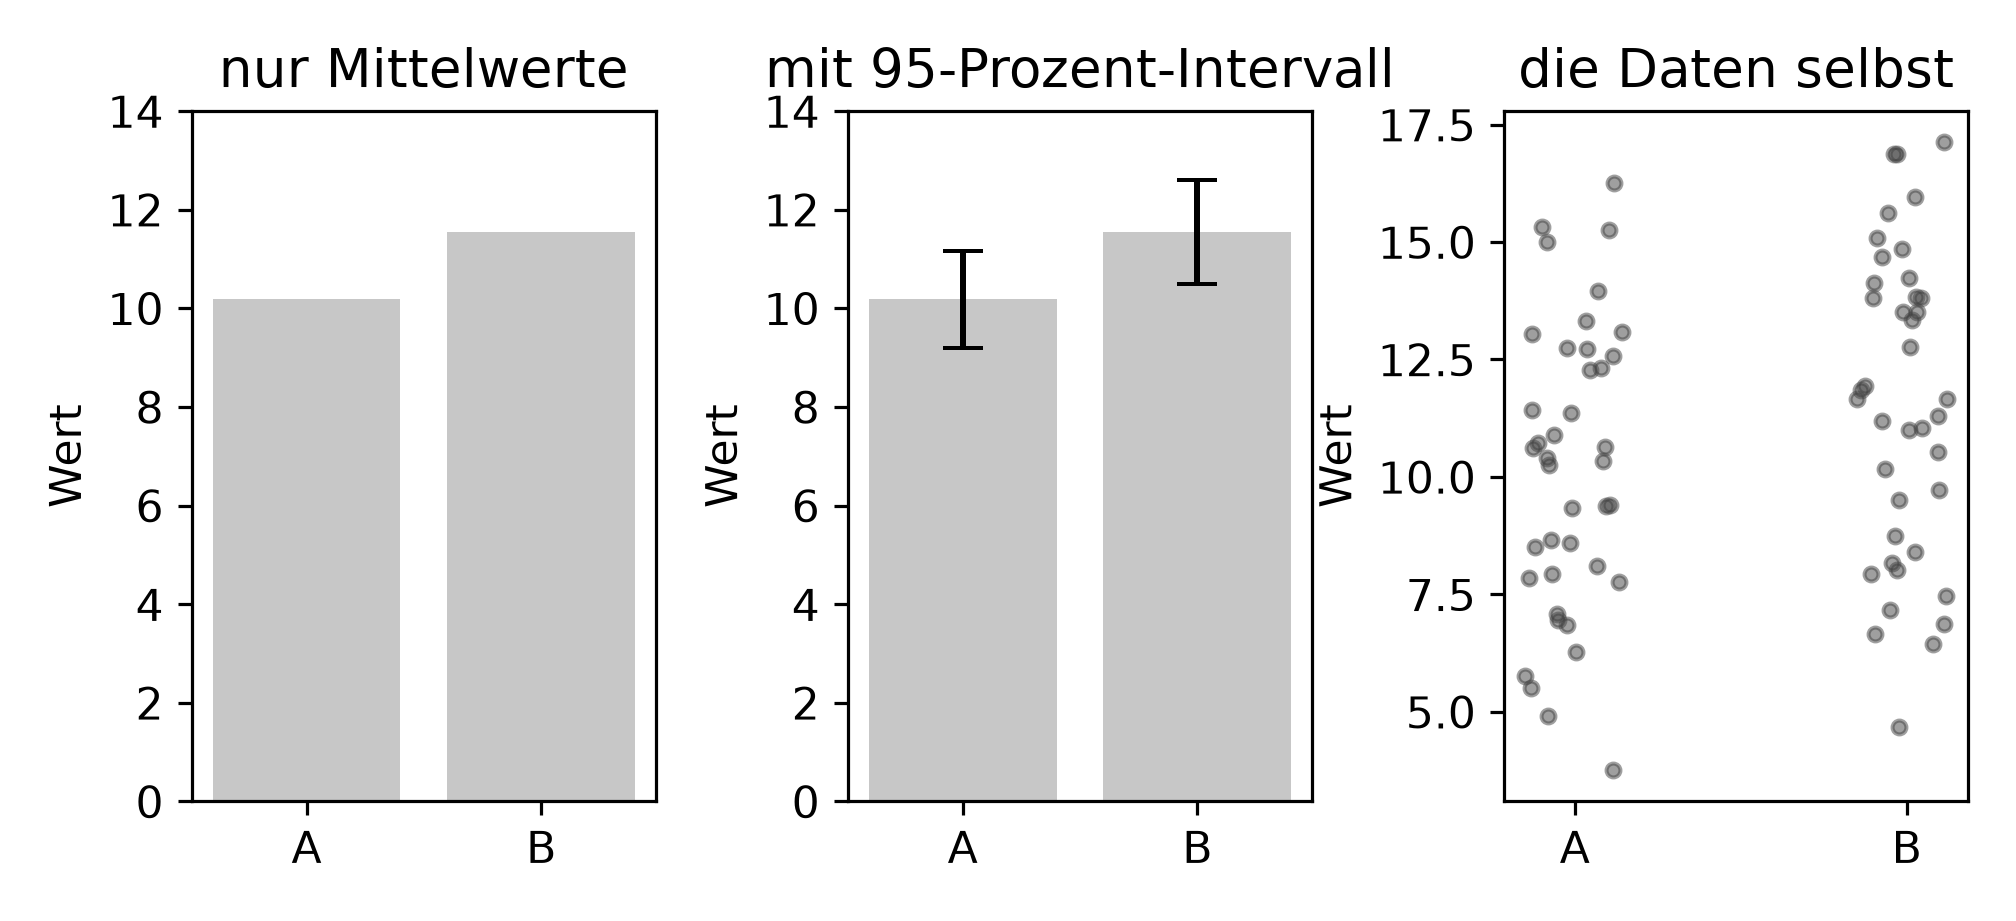
Zwei Gruppen zu je 40 Messungen, Mittelwerte 10.18 und 11.55. Ein Balkendiagramm zeigt zwei Balken verschiedener Höhe. Trägt es die Aussage “B ist grösser als A”?

Rechnung

Z <- normalmatrix(8899, 2, 40)
a <- 10.2 + Z[1, ] * 3
b <- 11.8 + Z[2, ] * 3

kennzahl <- function(x) {
  se <- sd(x) / sqrt(length(x))
  ki <- qt(0.975, length(x) - 1) * se
  c(mittel = mean(x), sd = sd(x), se = se,
    unten = mean(x) - ki, oben = mean(x) + ki)
}
round(rbind(A = kennzahl(a), B = kennzahl(b)), 3)
  mittel    sd    se  unten   oben
A 10.179 3.090 0.489  9.191 11.167
B 11.553 3.283 0.519 10.503 12.603
test <- t.test(b, a, var.equal = TRUE)
round(c(differenz = mean(b) - mean(a), t = unname(test$statistic),
        p = test$p.value), 4)
differenz         t         p 
   1.3740    1.9275    0.0576 
par(mfrow = c(1, 3), mar = c(4, 4, 3, 1))
mitten <- c(mean(a), mean(b))
barplot(mitten, names.arg = c("A", "B"), col = neutral, border = NA,
        ylim = c(0, 14), ylab = "Wert", main = "nur Mittelwerte")

mp <- barplot(mitten, names.arg = c("A", "B"), col = neutral, border = NA,
              ylim = c(0, 14), ylab = "Wert", main = "mit 95-Prozent-Intervall")
grenzen <- rbind(kennzahl(a), kennzahl(b))
arrows(mp, grenzen[, "unten"], mp, grenzen[, "oben"],
       angle = 90, code = 3, length = 0.08, lwd = 2)

plot(rep(1:2, each = 40) + (lehmer(31, 80) - 0.5) * 0.3, c(a, b),
     pch = 16, col = adjustcolor("grey25", alpha.f = 0.5), xaxt = "n",
     xlab = "", ylab = "Wert", main = "die Daten selbst", xlim = c(0.5, 2.5))
axis(1, at = 1:2, labels = c("A", "B"))
par(mfrow = c(1, 1))
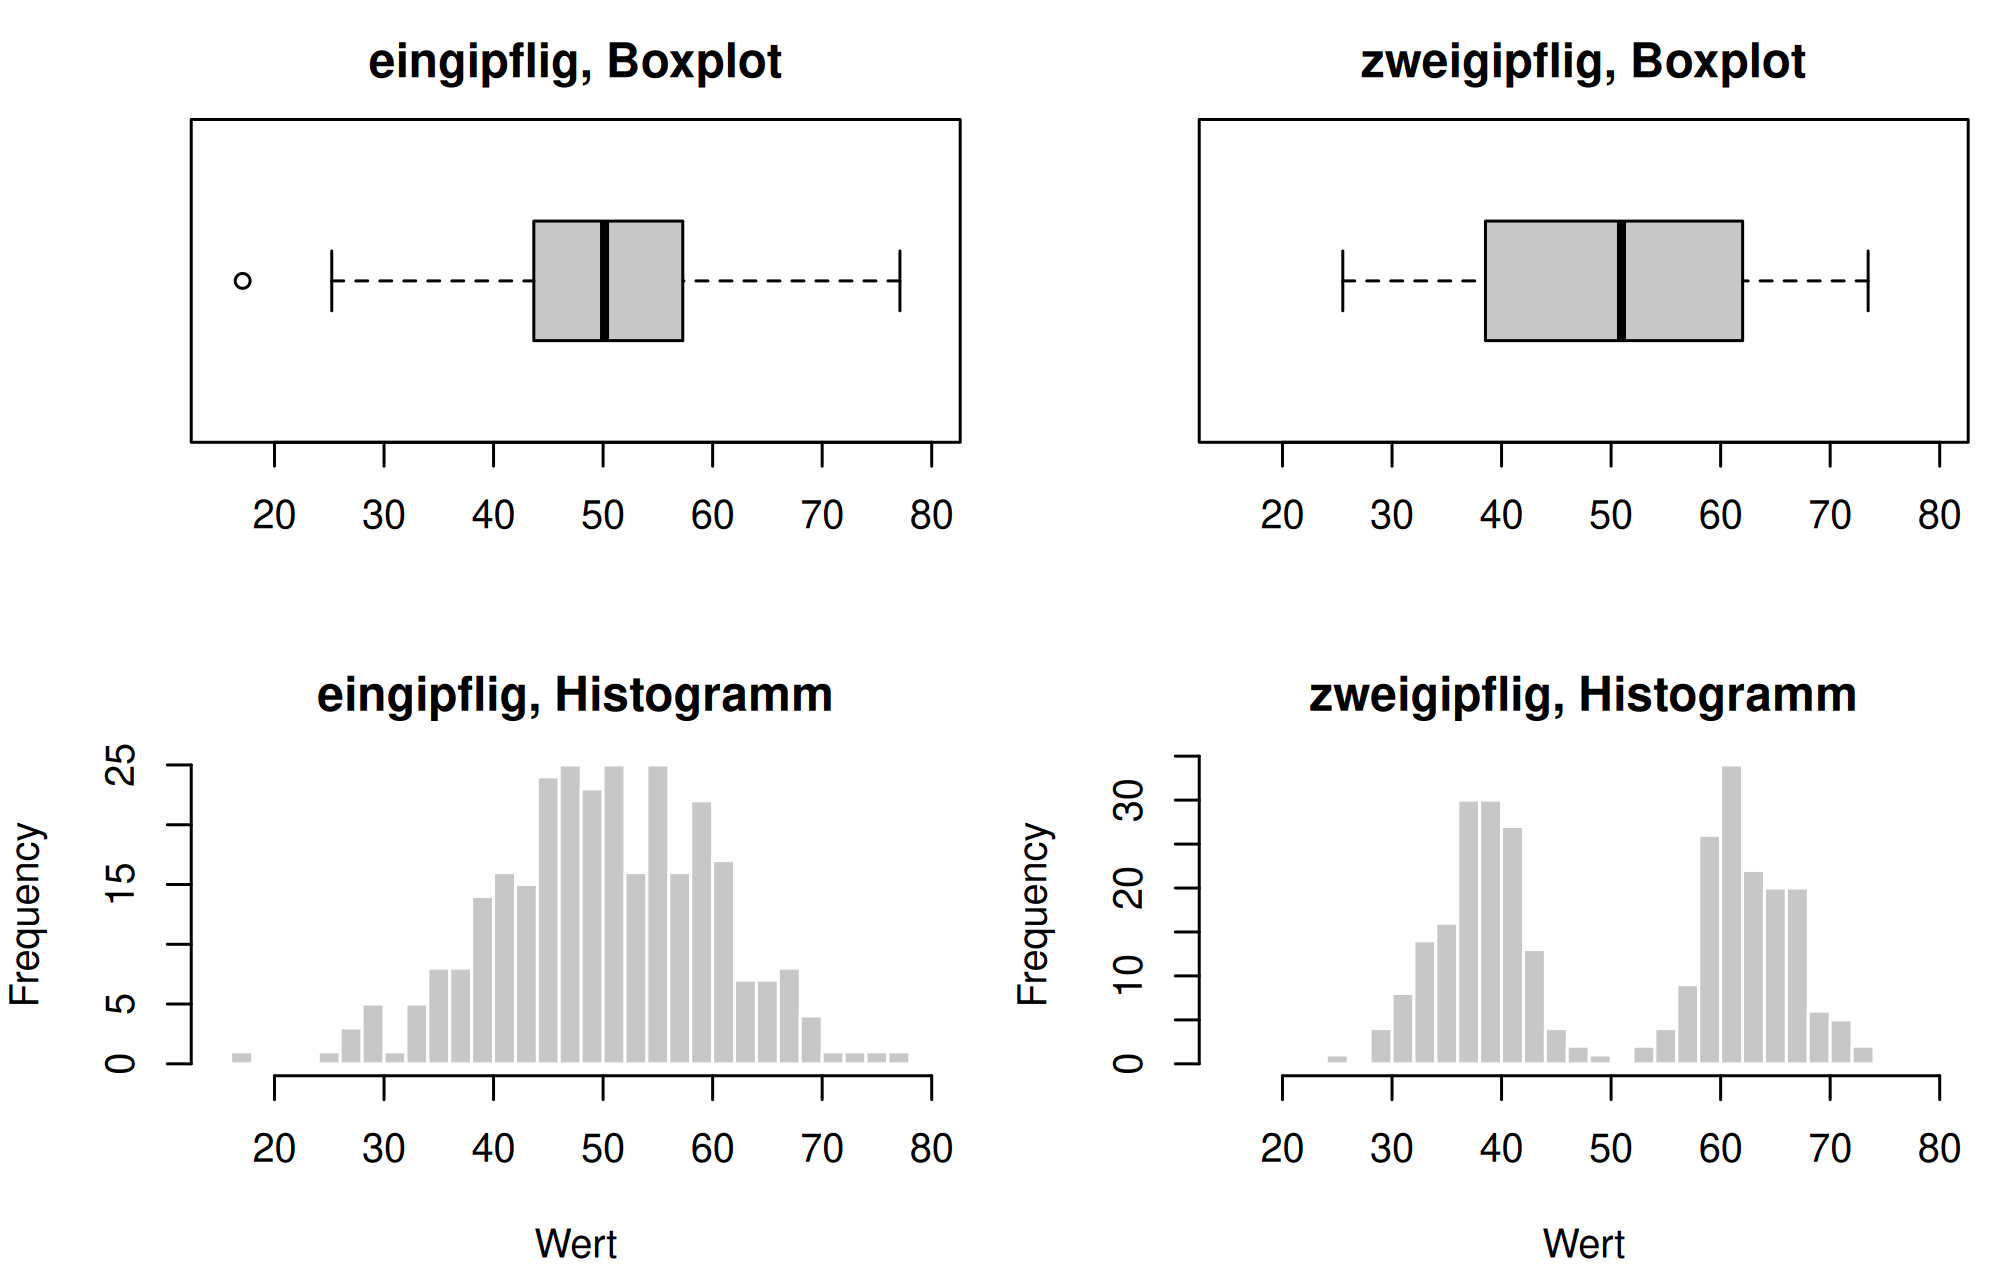
Abbildung 9: Beispiel 5: links nur die Mittelwerte, Mitte mit Konfidenzintervall, rechts die Daten.
Z = normalmatrix(8899, 2, 40)
a = 10.2 + Z[0] * 3
b = 11.8 + Z[1] * 3


def kennzahl(x):
    se = x.std(ddof=1) / np.sqrt(len(x))
    ki = stats.t.ppf(.975, len(x) - 1) * se
    return {"mittel": x.mean(), "sd": x.std(ddof=1), "se": se,
            "unten": x.mean() - ki, "oben": x.mean() + ki}


print(pd.DataFrame({"A": kennzahl(a), "B": kennzahl(b)}).round(3).T)

t, p = stats.ttest_ind(b, a)
print({"differenz": round(float(b.mean() - a.mean()), 4),
       "t": round(float(t), 4), "p": round(float(p), 4)})

kA, kB = kennzahl(a), kennzahl(b)
mitten = [kA["mittel"], kB["mittel"]]
fehler = [kA["oben"] - kA["mittel"], kB["oben"] - kB["mittel"]]

fig, achsen = plt.subplots(1, 3, figsize=(7, 3.2))
_ = achsen[0].bar(["A", "B"], mitten, color=NEUTRAL)
_ = achsen[0].set_ylim(0, 14)
_ = achsen[0].set_title("nur Mittelwerte")
_ = achsen[1].bar(["A", "B"], mitten, color=NEUTRAL, yerr=fehler, capsize=5)
_ = achsen[1].set_ylim(0, 14)
_ = achsen[1].set_title("mit 95-Prozent-Intervall")
streu = (lehmer(31, 80) - 0.5) * 0.3
_ = achsen[2].scatter(np.repeat([1, 2], 40) + streu, np.concatenate([a, b]),
                      s=12, color="0.25", alpha=0.5)
_ = achsen[2].set_xticks([1, 2], ["A", "B"])
_ = achsen[2].set_title("die Daten selbst")
for achse in achsen:
    _ = achse.set_ylabel("Wert")
plt.tight_layout()
plt.show()
Abbildung 10: Beispiel 5: dieselben drei Darstellungen in Python.

Output Zeile für Zeile

Gruppe Mittel SD Standardfehler 95-Prozent-Intervall
A 10.179 3.090 0.489 9.191 bis 11.167
B 11.553 3.283 0.519 10.503 bis 12.603
Kennzahl Wert
Differenz 1.374
t 1.9275
p 0.0576
Beobachtung Erklärung
Der reine Balken zeigt einen klaren Unterschied 11.55 gegen 10.18, gut sichtbar. Das Bild behauptet eine Gewissheit, die in den Daten nicht steht.
Die Intervalle überlappen sich 10.503 bis 12.603 gegen 9.191 bis 11.167, der Überlappungsbereich reicht von 10.50 bis 11.17.
Der p-Wert liegt bei 0.0576 Also knapp über der üblichen Schwelle. Nicht “kein Unterschied”, aber auch nicht “nachgewiesen”.
Die Punktwolke zeigt, warum Beide Gruppen streuen mit SD um 3.1 bis 3.3, die Differenz beträgt 1.37. Die Verteilungen überlappen sich fast vollständig.
Der Balken unterschlägt 39 von 40 Werten je Gruppe Er zeigt nur den Mittelwert. Ein Balkendiagramm von Mittelwerten ist die datenärmste Darstellung, die es gibt, eine Zahl je Balken.

Die Regel für Mittelwertvergleiche: Ein Balken ohne Unsicherheitsmass ist bei Messdaten fast immer die falsche Wahl.

Stichprobengrösse bessere Darstellung
bis ~30 je Gruppe alle Punkte zeigen, Mittelwert als Strich darüber
30 bis ~200 Punkte mit Streuung plus Intervall, oder Boxplot mit Punkten
darüber Boxplot oder Violinplot mit Intervall des Mittelwerts

Und: Überlappende Konfidenzintervalle sind kein Test. Sie sind ein konservativer Hinweis, der p-Wert kann trotz Überlappung unter 0.05 liegen. Der Test gehört gerechnet, siehe Hypothesentests und t-Test für zwei Stichproben.

Interpretation und Ergebnissatz

Die Mittelwerte betragen 10.179 und 11.553, die Differenz 1.374. Die 95-Prozent-Intervalle überlappen sich (9.19 bis 11.17 gegen 10.50 bis 12.60) und der t-Test ergibt p = 0.0576. Das reine Balkendiagramm zeigt einen deutlichen Unterschied, den die Daten nicht belegen.

Verständnisfragen

Eine Umfrage misst Zufriedenheit auf einer Skala von “sehr unzufrieden” bis “sehr zufrieden”. Die Grafik sortiert die Balken alphabetisch. Was ist der Fehler?

Die Ordnung der Kategorien ist Information und geht verloren
Richtig. Im Beispiel sank die Rangkorrelation zwischen Position und Anzahl von 1.0 auf 0.3, und “sehr zufrieden” landete direkt neben “sehr unzufrieden”.
Balken sind für Umfragedaten ungeeignet
Sie sind hier passend, nur die Sortierung stimmt nicht.
Die Skala ist zu fein
Fünf Stufen sind unproblematisch.

Zwei Verteilungen haben Mediane von 50.13 und 50.95. Genügt der Boxplot?

Nein, bei der einen liegen nur 1.7 Prozent der Werte in der Nähe des Medians
Richtig. Sie ist zweigipflig, der Median fällt ins Tal dazwischen. Der Boxplot zeigt fünf Zahlen und keine Form; das Histogramm zeigt es sofort.
Ja, gleiche Mediane heissen ähnliche Verteilungen
Der Mittelwert war ebenfalls fast gleich, die Formen sind völlig verschieden.
Nein, weil die Standardabweichungen verschieden sind
Der Unterschied 13.0 gegen 9.9 ist ein Hinweis, erklärt die Zweigipfligkeit aber nicht.

Ein Streudiagramm mit 5000 Punkten wirkt als dichte Wolke. Wie viele Punkte sind tatsächlich sichtbar?

Rund ein Fünftel, der Rest liegt auf schon belegten Stellen
Richtig, im Beispiel 1021 belegte Rasterzellen von 5000 Punkten. In der dichtesten Zelle lagen 23 Punkte übereinander.
Alle, sie überlappen nur
Überlappen heisst verdecken; der untere Punkt trägt nichts mehr zum Bild bei.
Das lässt sich nicht bestimmen
Über ein Raster in Markengrösse lässt es sich genau auszählen.

Warum ist im gestapelten Balken die mittlere Kategorie schwer zu vergleichen?

Sie hat keine gemeinsame Grundlinie, ihre Startlinie schwankt
Richtig. Im Beispiel schwankten die Startlinien um 6.0 bei einem echten Unterschied von 9.0. Nur das unterste Segment liegt auf gemeinsamer Position.
Die Farben sind zu ähnlich
Auch mit klar getrennten Farben bliebe das Problem der fehlenden Grundlinie.
Gestapelte Balken sind grundsätzlich falsch
Für die Summe je Gruppe sind sie gerade die richtige Wahl.

Zwei Balken zeigen Mittelwerte von 10.18 und 11.55. Was fehlt?

Ein Unsicherheitsmass, die Intervalle überlappen sich und p liegt bei 0.058
Richtig. Der Balken zeigt eine Zahl je Gruppe und unterschlägt die Streuung von rund 3.1, die fast so gross ist wie der Abstand.
Nichts, der Unterschied ist ja sichtbar
Sichtbar ist er, belegt nicht.
Eine logarithmische Achse
Die ändert an der Unsicherheit nichts.

Zwei Kennzahlen mit sehr verschiedenen Einheiten sollen im Zeitverlauf verglichen werden. Was ist die bessere Lösung als eine zweite y-Achse?

Beide Reihen auf denselben Wertebereich normieren und in eine Grafik
Möglich, aber die Normierung ist ebenso willkürlich wie die zweite Achse.
Zwei Teilgrafiken übereinander mit gemeinsamer Zeitachse
Richtig. Der zeitliche Zusammenhang bleibt sichtbar, und keine Skalierung suggeriert einen Gleichlauf, den es so nicht gibt.
Eine Kennzahl weglassen
Das löst das Darstellungsproblem, aber nicht die Aufgabe.

Verlinkte Ressourcen