Prüfverteilungen: t, Chi-Quadrat und F

Wahrscheinlichkeit
R
Python
Woher die Verteilungen kommen, unter denen Teststatistiken beurteilt werden.

Kernideen

  • Prüfverteilungen sind keine Modelle für Daten, sondern Verteilungen von Kennzahlen, die aus Daten berechnet werden.
  • Chi-Quadrat ist die Verteilung einer Summe quadrierter Standardnormalen, deshalb taucht sie überall dort auf, wo Quadrate summiert werden: Varianzen, Abweichungsquadrate in Kreuztabellen.
  • t entsteht, wenn die Streuung im Nenner geschätzt statt bekannt ist. Sie ist breiter als die Normalverteilung, weil zwei Grössen zufällig sind statt einer.
  • F ist das Verhältnis zweier Varianzschätzungen, die Verteilung hinter jeder Varianzanalyse.
  • Alle drei haben Freiheitsgrade als einzigen Parameter (F hat zwei), und alle drei nähern sich mit wachsenden Freiheitsgraden einem einfacheren Fall.
  • Die drei hängen zusammen: \(t^2_{df} = F_{1,df}\), und \(F\) ist ein Quotient zweier Chi-Quadrat-Grössen.

Erklärung

Warum es eigene Verteilungen braucht

Die Normal-, Binomial- oder Exponentialverteilung beschreiben Daten: Körper- grössen, Trefferzahlen, Wartezeiten. Prüfverteilungen beschreiben etwas anderes, nämlich, wie eine aus den Daten berechnete Kennzahl streut, wenn man den Datensatz gedanklich immer wieder neu zieht.

Das ist der Grund, weshalb sie kaum je zur Beschreibung eines Merkmals auftauchen und doch in jeder Testtabelle stehen.

Die drei auf einen Blick

Chi-Quadrat \(\chi^2_{df}\) \(t_{df}\) \(F_{d_1, d_2}\)
entsteht als \(\sum_{i=1}^{df} Z_i^2\) \(\dfrac{Z}{\sqrt{V/df}}\) \(\dfrac{V_1/d_1}{V_2/d_2}\)
Wertebereich \([0, \infty)\) \((-\infty, \infty)\) \([0, \infty)\)
Form rechtsschief symmetrisch, glockenförmig rechtsschief
Erwartungswert \(df\) \(0\) (für \(df > 1\)) \(\dfrac{d_2}{d_2 - 2}\)
Varianz \(2\,df\) \(\dfrac{df}{df-2}\)
Grenzfall für grosse \(df\) normal für grosse \(df\) normal \(F_{d_1,\infty} = \chi^2_{d_1}/d_1\)
typischer Einsatz Kreuztabellen, Varianzen Mittelwertvergleiche Varianzanalyse, Modellvergleich

\(Z\) steht dabei jeweils für eine standardnormalverteilte Grösse, \(V\) für eine chi-quadrat-verteilte.

Freiheitsgrade

Ein Freiheitsgrad ist ein Wert, der noch frei variieren kann. Bei \(n\) Beobachtungen und einem daraus geschätzten Mittelwert bleiben \(n-1\): Kennt man den Mittelwert und \(n-1\) Werte, ist der letzte festgelegt.

Jeder geschätzte Parameter kostet einen Freiheitsgrad. Deshalb steht in der Stichprobenvarianz \(n-1\) im Nenner, deshalb hat der t-Test bei zwei Gruppen \(n_1 + n_2 - 2\) Freiheitsgrade, und deshalb hat eine Kreuztabelle mit \(r\) Zeilen und \(c\) Spalten \((r-1)(c-1)\).

Die Zusammenhänge

\[t^2_{df} = F_{1, df} \qquad\text{und}\qquad F_{d_1, d_2} = \frac{\chi^2_{d_1}/d_1}{\chi^2_{d_2}/d_2}\]

Der erste Zusammenhang erklärt, warum der t-Test bei zwei Gruppen und die einfaktorielle Varianzanalyse denselben p-Wert liefern: Es ist derselbe Test, einmal mit Vorzeichen und einmal ohne.

Beispiele

Frage und Datenlage

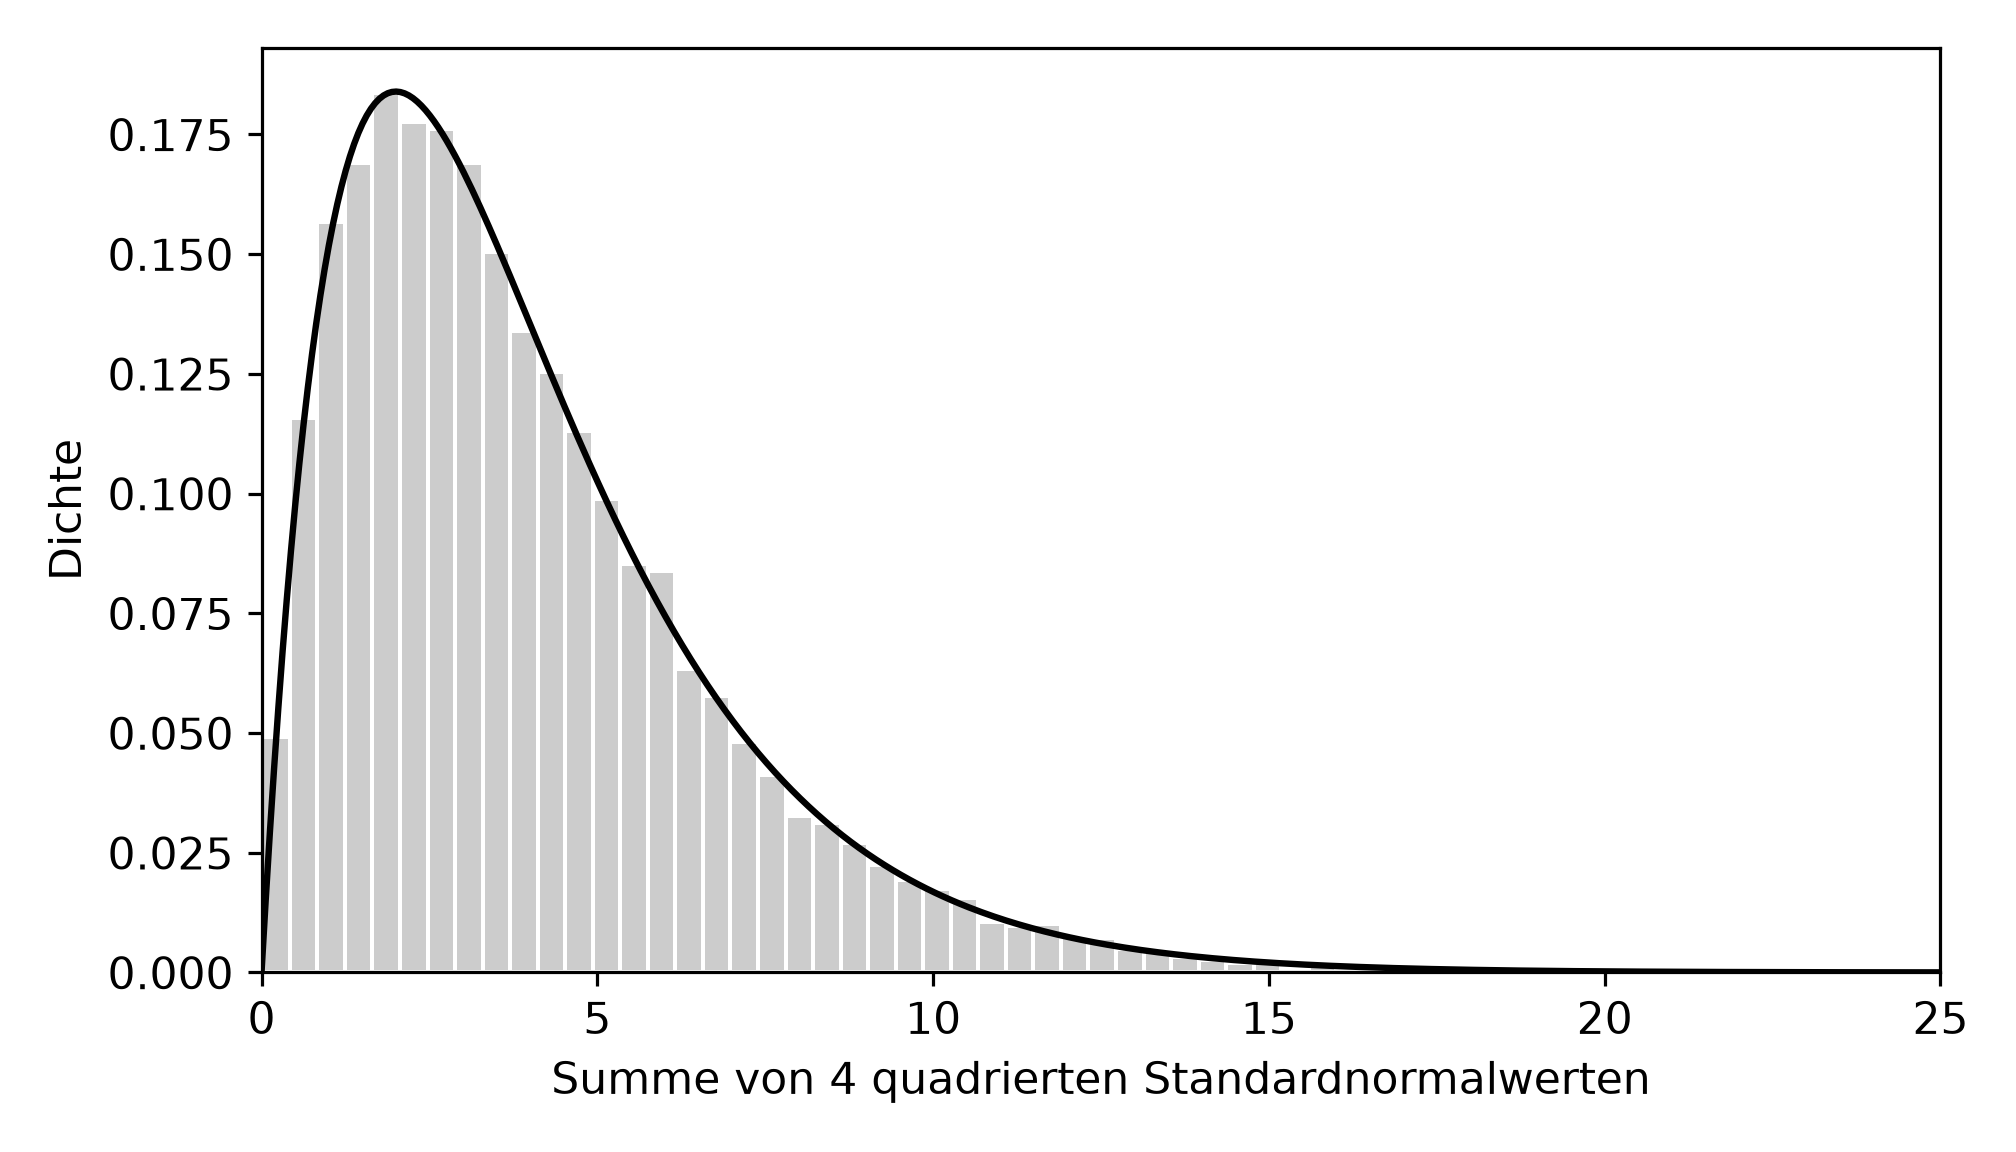
Die Definition lautet: Summiere \(df\) unabhängige quadrierte Standardnormalwerte. Was kommt dabei heraus, und stimmt es mit der Theorie überein?

20 000 Wiederholungen, Freiheitsgrade 1, 2, 4 und 10.

Rechnung

N <- 20000
zeilen <- list()

for (fg in c(1, 2, 4, 10)) {
  Z <- normalmatrix(4711, N, fg)
  X <- rowSums(Z^2)
  schief <- mean((X - mean(X))^3) / sd(X)^3
  zeilen[[as.character(fg)]] <- c(
    df = fg, mittel = mean(X), varianz = var(X),
    median = median(X), median_theorie = qchisq(0.5, fg),
    schiefe = schief, schiefe_theorie = sqrt(8 / fg),
    anteil_ueber_q95 = mean(X > qchisq(0.95, fg)))
}
rm(fg)   # damit df weiter die F-Dichte bleibt
round(do.call(rbind, zeilen), 4)
   df mittel varianz median median_theorie schiefe schiefe_theorie
1   1 1.0004  1.9834 0.4696         0.4549  2.8335          2.8284
2   2 1.9822  3.8970 1.3712         1.3863  1.9302          2.0000
4   4 3.9961  7.9940 3.3533         3.3567  1.3887          1.4142
10 10 9.9744 19.7141 9.3256         9.3418  0.8717          0.8944
   anteil_ueber_q95
1            0.0489
2            0.0508
4            0.0512
10           0.0502
# Und die Dichte darueber gelegt, fuer df = 4
Z <- normalmatrix(4711, N, 4)
X <- rowSums(Z^2)
ggplot(data.frame(x = X), aes(x)) +
  geom_histogram(aes(y = after_stat(density)), bins = 60,
                 fill = "grey80", colour = "white") +
  stat_function(fun = dchisq, args = list(df = 4), linewidth = 0.9) +
  coord_cartesian(xlim = c(0, 25)) +
  labs(x = "Summe von 4 quadrierten Standardnormalwerten", y = "Dichte")
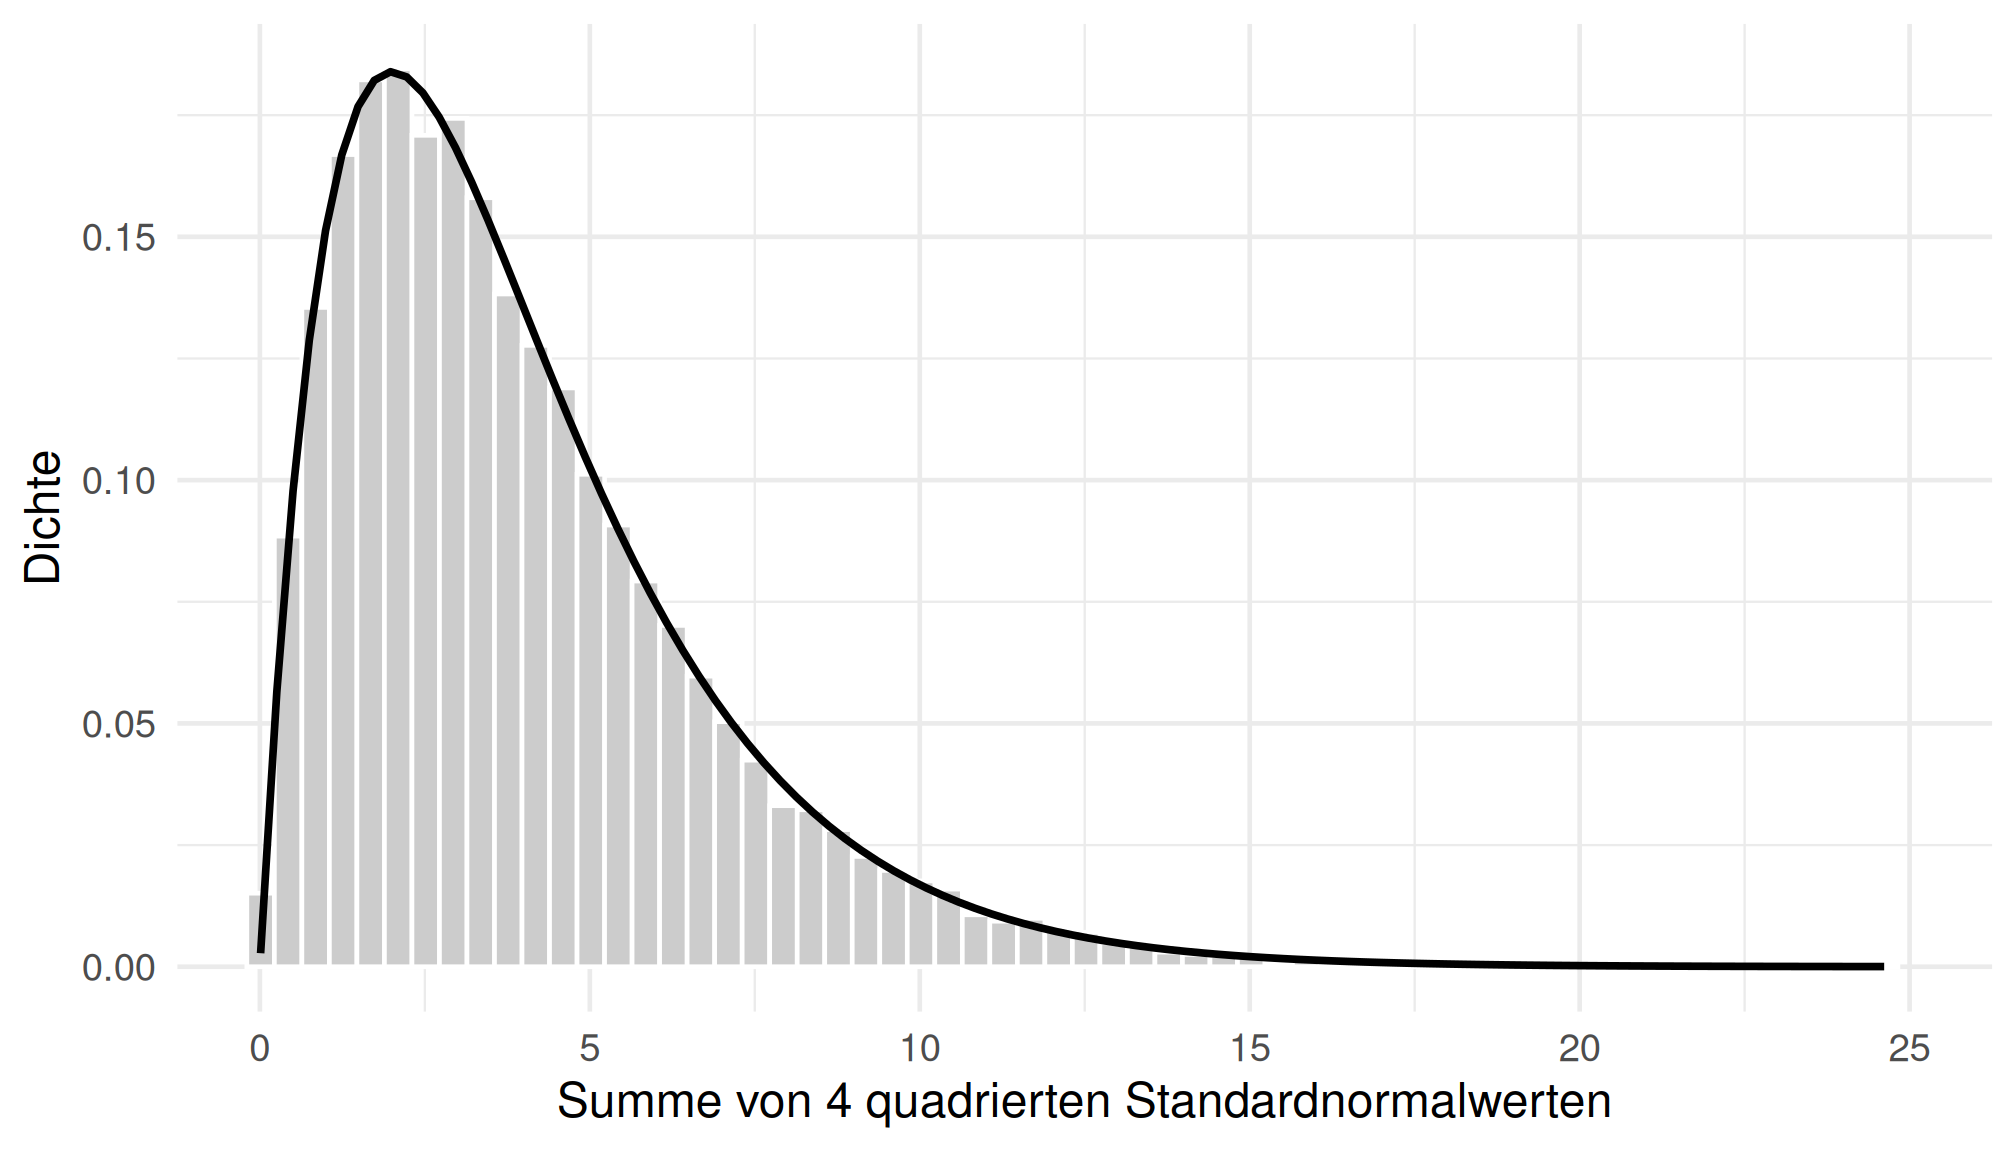
Abbildung 1: Beispiel 1: simulierte Summen quadrierter Standardnormalwerte gegen die Chi-Quadrat-Dichte.
N = 20000
zeilen = []

for df in [1, 2, 4, 10]:
    Z = normalmatrix(4711, N, df)
    X = (Z ** 2).sum(axis=1)
    zeilen.append({"df": df, "mittel": X.mean(), "varianz": X.var(ddof=1),
                   "median": np.median(X), "median_theorie": stats.chi2.ppf(.5, df),
                   "schiefe": stats.skew(X), "schiefe_theorie": np.sqrt(8 / df),
                   "anteil_ueber_q95": (X > stats.chi2.ppf(.95, df)).mean()})
print(pd.DataFrame(zeilen).round(4).to_string(index=False))
 df  mittel  varianz  median  median_theorie  schiefe  schiefe_theorie  anteil_ueber_q95
  1  1.0004   1.9834  0.4696          0.4549   2.8338           2.8284            0.0489
  2  1.9822   3.8970  1.3712          1.3863   1.9303           2.0000            0.0508
  4  3.9961   7.9940  3.3533          3.3567   1.3888           1.4142            0.0512
 10  9.9744  19.7141  9.3256          9.3418   0.8717           0.8944            0.0502
Z = normalmatrix(4711, N, 4)
X = (Z ** 2).sum(axis=1)

fig, achse = plt.subplots(figsize=(7, 4))
achse.hist(X, bins=60, density=True, color="0.8", edgecolor="white")
gitter = np.linspace(0, 25, 400)
achse.plot(gitter, stats.chi2.pdf(gitter, 4), lw=1.6, color="black")
achse.set_xlim(0, 25)
(0.0, 25.0)
achse.set_xlabel("Summe von 4 quadrierten Standardnormalwerten")
achse.set_ylabel("Dichte")
plt.tight_layout()
plt.show()
Abbildung 2: Beispiel 1: dieselbe Simulation in Python.

Output Zeile für Zeile

df Mittel Varianz Median Median theoretisch Schiefe Schiefe theoretisch Anteil über \(q_{0.95}\)
1 1.000 1.983 0.470 0.455 2.834 2.828 0.0489
2 1.982 3.897 1.371 1.386 1.930 2.000 0.0508
4 3.996 7.994 3.353 3.357 1.389 1.414 0.0512
10 9.974 19.714 9.326 9.342 0.872 0.894 0.0502
Beobachtung Erklärung
Der Mittelwert ist jedes Mal ungefähr df \(E(Z^2) = 1\) für jede Standardnormale, und \(df\) davon aufsummiert ergibt \(df\). Das ist die ganze Herleitung.
Die Varianz ist ungefähr 2 df 1.98, 3.90, 7.99, 19.71 gegen 2, 4, 8, 20.
Der Median liegt unter dem Mittelwert 3.353 gegen 3.996 bei df = 4. Die Verteilung ist rechtsschief; ein einzelner grosser Quadratwert zieht den Mittelwert nach oben, den Median nicht.
Die Schiefe sinkt von 2.83 auf 0.87 Genau wie \(\sqrt{8/df}\) es verlangt. Mit wachsenden Freiheitsgraden wird die Verteilung symmetrisch, der zentrale Grenzwertsatz wirkt auch auf eine Summe von Quadraten.
Der Anteil oberhalb des 95-Prozent-Quantils liegt bei 0.049 bis 0.051 Die Simulation trifft die theoretischen Quantile. Damit ist geprüft, dass die Konstruktion stimmt und nicht nur die ersten zwei Momente passen.

Eine Falle des Lehmer-Generators, die hier zuschlägt. Auf den anderen Seiten dieser Sammlung bekommt jede Variable eine eigene Saat. Für eine Summe aus vielen Quadraten geht das schief: Ein multiplikativer Generator erzeugt aus der Saat \(s\) die Folge \(16807^k \cdot s \bmod m\). Zwei Saaten, von denen die eine ein kleines Vielfaches der anderen ist, liefern deshalb linear abhängige Ströme.

Saatpaar Korrelation der Ströme
1000 und 1001 0.030
7001 und 7002 −0.016
101 und 202 0.584

Bei 202 = 2 · 101 ist der zweite Strom exakt das Doppelte des ersten modulo \(m\). Die Folge davon in diesem Beispiel: Mit zehn einzeln gesäten Spalten ergab sich eine Schiefe von 3.63 statt 0.89 und ein Ablehnanteil von 0.13 statt 0.05, bei korrektem Mittelwert und korrekter Varianz. Der Fehler wäre also durch eine Kontrolle der ersten zwei Momente nicht aufgefallen.

Regel: Für mehrdimensionale Daten einen langen Strom ziehen und umformen (normalmatrix oben), nicht eine Saat je Spalte. Und nie Saaten wählen, bei denen die eine ein kleines Vielfaches der anderen ist.

Interpretation und Ergebnissatz

Die Summe von \(df\) quadrierten Standardnormalwerten folgt der Chi-Quadrat-Verteilung mit \(df\) Freiheitsgraden: Mittelwert \(df\), Varianz \(2\,df\), rechtsschief mit einer Schiefe von \(\sqrt{8/df}\), die mit wachsendem \(df\) verschwindet.

Frage und Datenlage

Der Zusammenhang, der die Chi-Quadrat-Verteilung in die Praxis bringt:

\[\frac{(n-1)\,s^2}{\sigma^2} \sim \chi^2_{n-1}\]

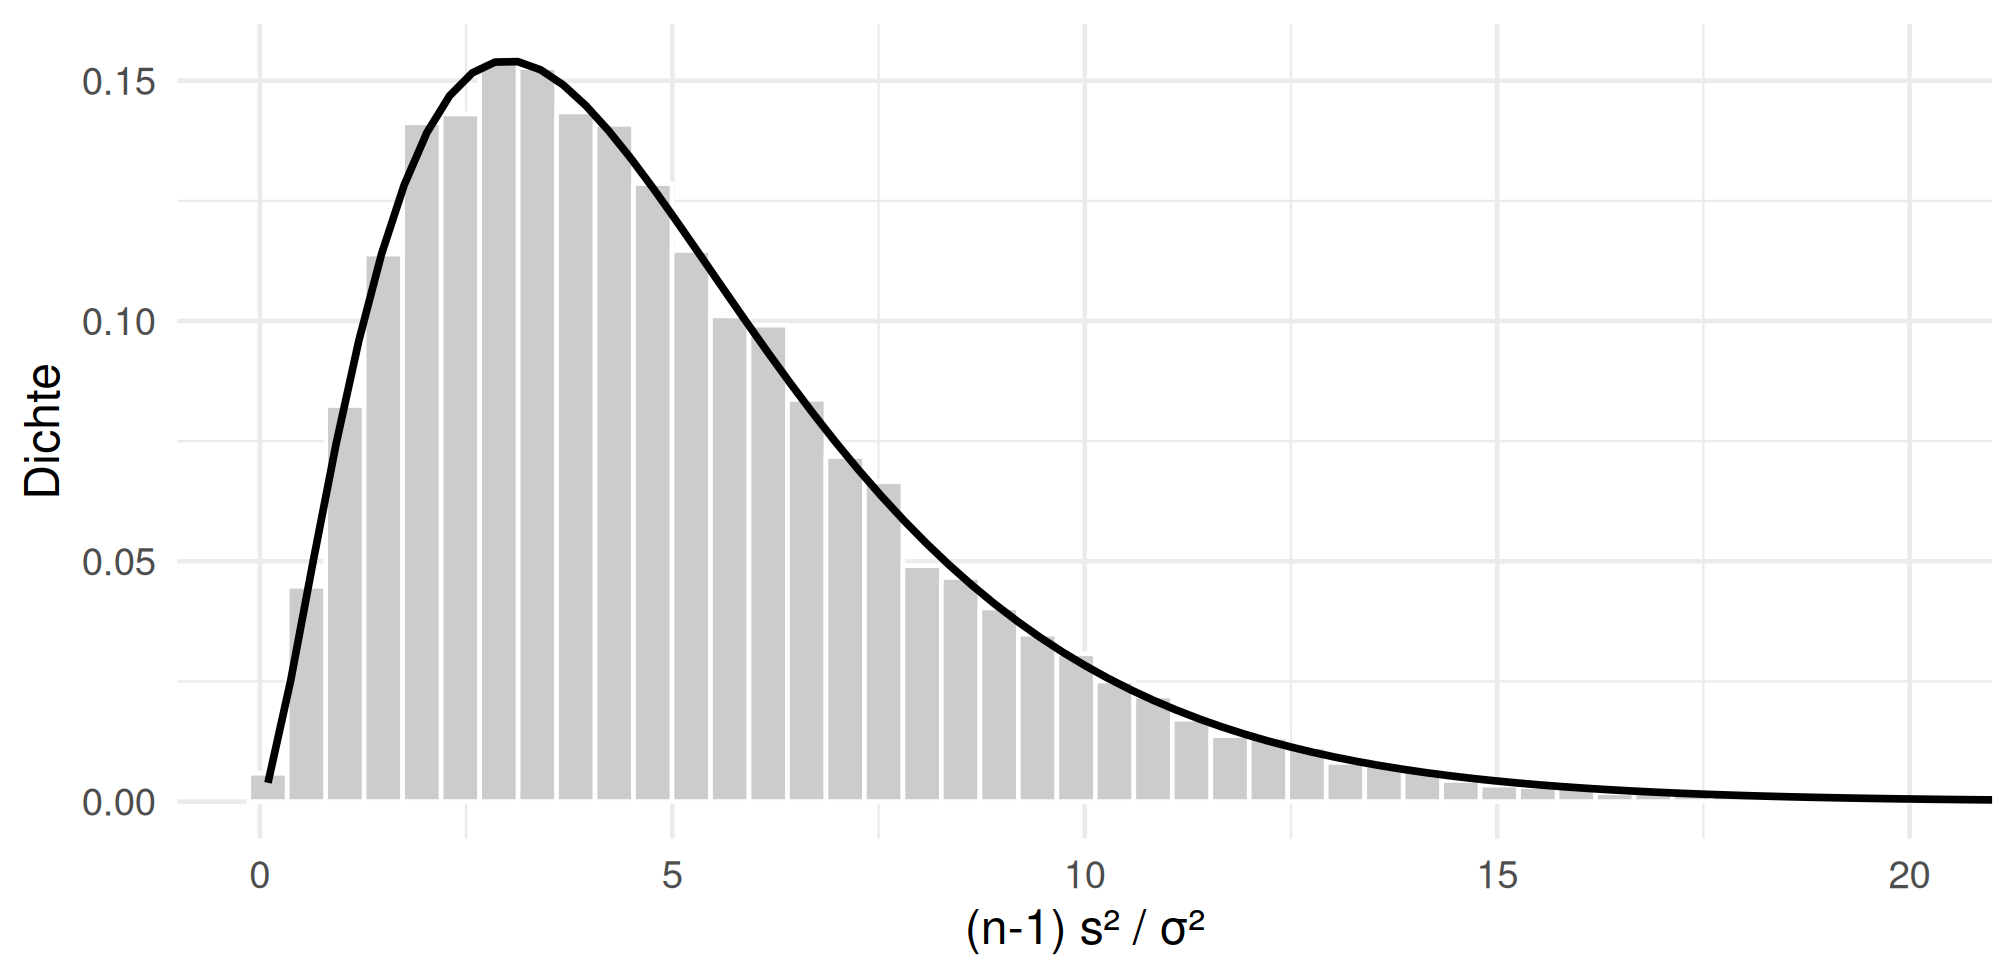
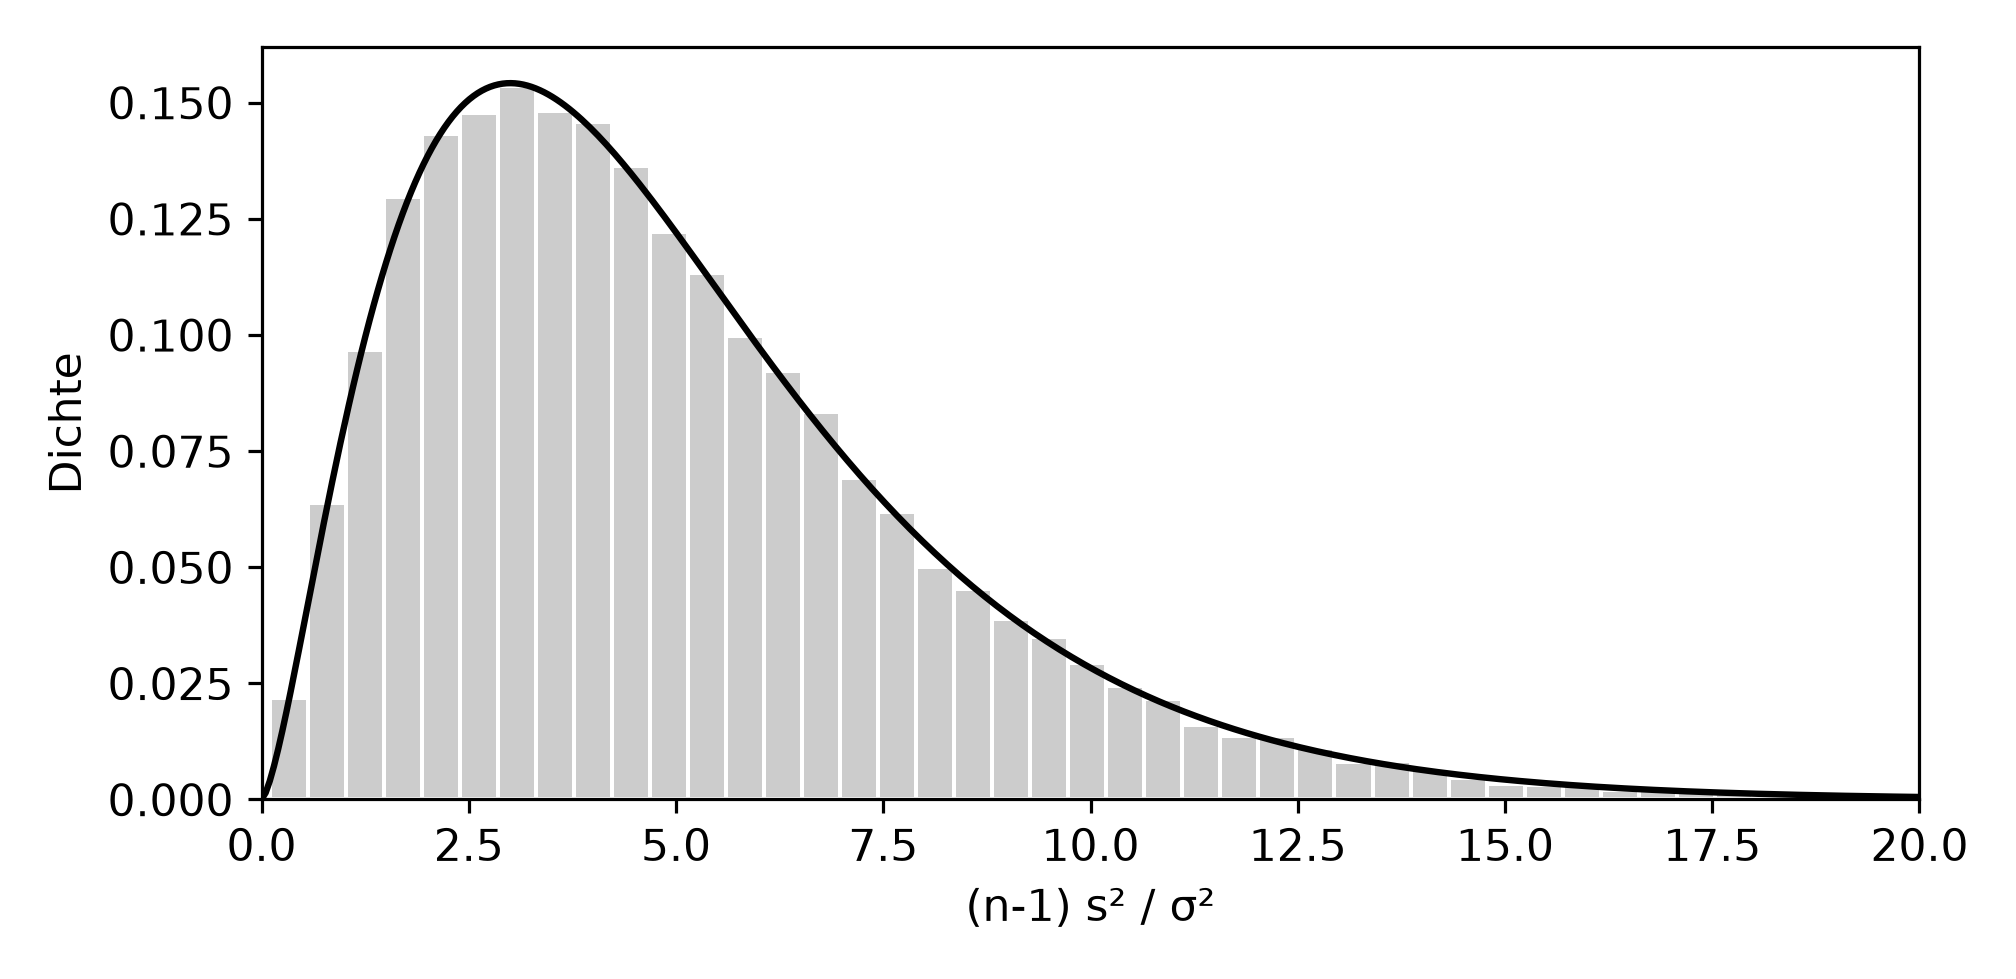
Sechs Beobachtungen aus einer Standardnormalverteilung, 20 000 mal. Warum \(n-1\) und nicht \(n\)?

Rechnung

N <- 20000; n <- 6
S <- normalmatrix(4711, N, n)
s2 <- apply(S, 1, var)
groesse <- (n - 1) * s2 / 1   # sigma^2 = 1

round(c(mittel = mean(groesse), theorie_mittel = n - 1,
        varianz = var(groesse), theorie_varianz = 2 * (n - 1),
        anteil_unter_q05 = mean(groesse <= qchisq(0.05, n - 1)),
        anteil_ueber_q95 = mean(groesse > qchisq(0.95, n - 1))), 4)
          mittel   theorie_mittel          varianz  theorie_varianz 
          4.9988           5.0000           9.9781          10.0000 
anteil_unter_q05 anteil_ueber_q95 
          0.0504           0.0496 
# Der Vergleich: durch n statt durch n-1 geteilt
s2_falsch <- apply(S, 1, function(z) mean((z - mean(z))^2))
round(c(mit_n_minus_1 = mean(s2), mit_n = mean(s2_falsch), wahrer_wert = 1), 4)
mit_n_minus_1         mit_n   wahrer_wert 
       0.9998        0.8331        1.0000 
ggplot(data.frame(x = groesse), aes(x)) +
  geom_histogram(aes(y = after_stat(density)), bins = 60,
                 fill = "grey80", colour = "white") +
  stat_function(fun = dchisq, args = list(df = n - 1), linewidth = 0.9) +
  coord_cartesian(xlim = c(0, 20)) +
  labs(x = "(n-1) s² / σ²", y = "Dichte")
Abbildung 3: Beispiel 2: Verteilung der skalierten Stichprobenvarianz bei n = 6.
N, n = 20000, 6
S = normalmatrix(4711, N, n)
s2 = S.var(axis=1, ddof=1)
groesse = (n - 1) * s2 / 1.0

print({"mittel": round(float(groesse.mean()), 4), "theorie_mittel": n - 1,
       "varianz": round(float(groesse.var(ddof=1)), 4),
       "theorie_varianz": 2 * (n - 1),
       "anteil_unter_q05": round(float((groesse <= stats.chi2.ppf(.05, n - 1)).mean()), 4),
       "anteil_ueber_q95": round(float((groesse > stats.chi2.ppf(.95, n - 1)).mean()), 4)})
{'mittel': 4.9988, 'theorie_mittel': 5, 'varianz': 9.9781, 'theorie_varianz': 10, 'anteil_unter_q05': 0.0503, 'anteil_ueber_q95': 0.0496}
s2_falsch = S.var(axis=1, ddof=0)
print({"mit_n_minus_1": round(float(s2.mean()), 4),
       "mit_n": round(float(s2_falsch.mean()), 4), "wahrer_wert": 1})
{'mit_n_minus_1': 0.9998, 'mit_n': 0.8331, 'wahrer_wert': 1}
fig, achse = plt.subplots(figsize=(7, 3.4))
achse.hist(groesse, bins=60, density=True, color="0.8", edgecolor="white")
gitter = np.linspace(0, 20, 400)
achse.plot(gitter, stats.chi2.pdf(gitter, n - 1), lw=1.6, color="black")
achse.set_xlim(0, 20)
(0.0, 20.0)
achse.set_xlabel("(n-1) s² / σ²")
achse.set_ylabel("Dichte")
plt.tight_layout()
plt.show()
Abbildung 4: Beispiel 2: dieselbe Verteilung in Python.

Output Zeile für Zeile

Grösse Wert Theorie
Mittelwert von \((n-1)s^2/\sigma^2\) 4.999 5
Varianz 9.978 10
Anteil unter \(q_{0.05}\) 0.0503 0.05
Anteil über \(q_{0.95}\) 0.0496 0.05
Teiler mittlere geschätzte Varianz wahrer Wert
\(n-1\) 1.0000 1
\(n\) 0.8331 1
Beobachtung Erklärung
Die skalierte Varianz verhält sich exakt wie \(\chi^2_5\) Mittelwert 5, Varianz 10, beide Randanteile bei 5 Prozent. Nicht nur ungefähr, sondern in allen vier Kennzahlen.
Die Freiheitsgrade sind 5, nicht 6 Die Abweichungen werden vom geschätzten Mittelwert gemessen, nicht vom wahren. Kennt man fünf davon, ist die sechste festgelegt, weil sich alle sechs zu null addieren.
Mit \(n\) im Nenner ergibt sich im Mittel 0.833 statt 1 Also \(5/6\) des wahren Werts, genau der Faktor \((n-1)/n\). Das ist die Bessel-Korrektur, hier nicht als Formel, sondern als gemessene Unterschätzung.
Die Verteilung ist stark rechtsschief Bei \(n = 6\). Ein Konfidenzintervall für eine Varianz ist deshalb nicht symmetrisch um die Schätzung, anders als bei einem Mittelwert.

Warum das praktisch wichtig ist: Aus dieser Verteilung folgt das Konfidenzintervall für eine Varianz,

\[\left[\frac{(n-1)s^2}{\chi^2_{1-\alpha/2}},\ \frac{(n-1)s^2}{\chi^2_{\alpha/2}}\right]\] und bei kleinem \(n\) ist es erschreckend breit. Bei \(n = 6\) und \(s^2 = 1\) reicht es von 0.39 bis 4.85, also über mehr als eine Zehnerpotenz. Wer eine Streuung schätzen will, braucht deutlich mehr Beobachtungen als für einen Mittelwert.

Interpretation und Ergebnissatz

Die mit \((n-1)/\sigma^2\) skalierte Stichprobenvarianz folgt bei normalverteilten Daten der Chi-Quadrat-Verteilung mit \(n-1\) Freiheitsgraden. Teilt man stattdessen durch \(n\), unterschätzt die Schätzung die wahre Varianz im Mittel um den Faktor \((n-1)/n\), hier 0.833 statt 1.

Frage und Datenlage

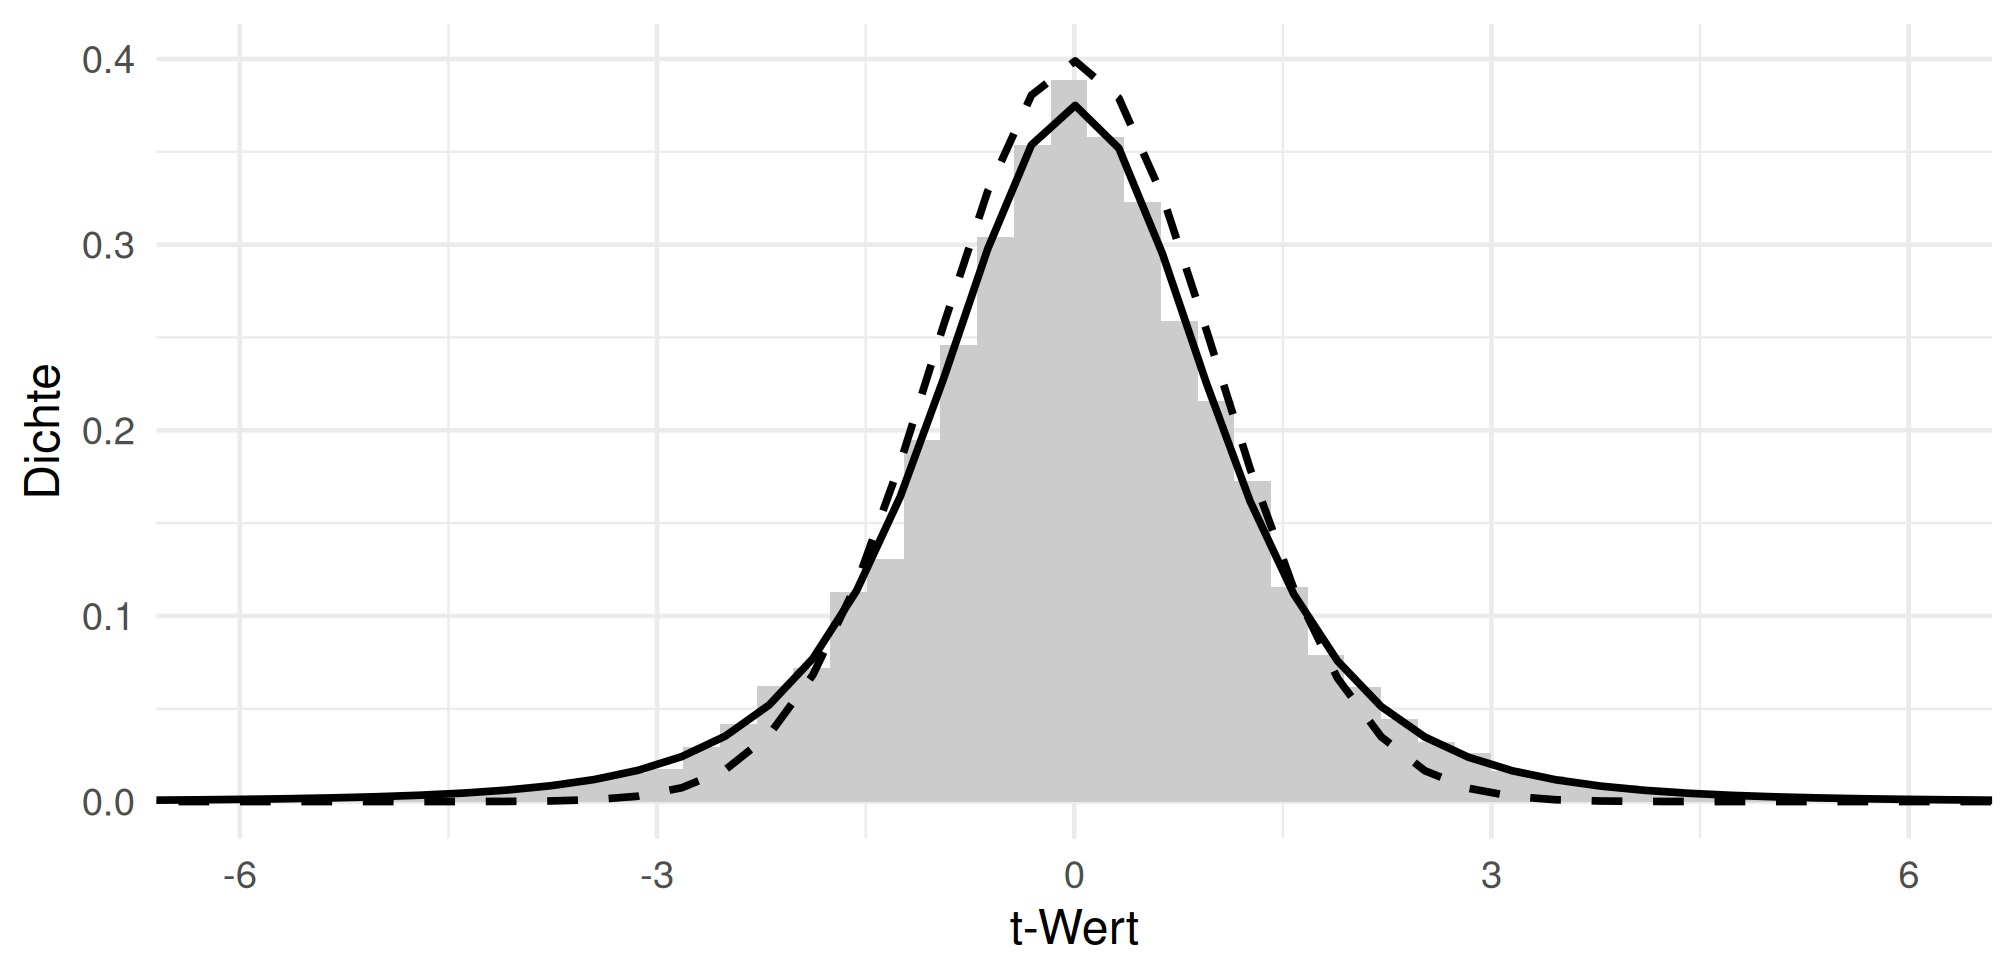
Eine Stichprobe von fünf Werten, der Mittelwert wird an seiner geschätzten Streuung gemessen. Was passiert, wenn man dabei mit 1.96 rechnet, als wäre die Streuung bekannt?

Rechnung

N <- 20000; n <- 5
S <- normalmatrix(5711, N, n)
mittel <- rowMeans(S)
streuung <- apply(S, 1, sd)

t_wert <- mittel / (streuung / sqrt(n))   # Streuung geschaetzt
z_wert <- mittel / (1 / sqrt(n))          # Streuung bekannt

round(c(sd_t = sd(t_wert), theorie_sd_t = sqrt((n - 1) / (n - 3)),
        sd_z = sd(z_wert),
        anteil_t_ueber_196 = mean(abs(t_wert) > 1.96),
        anteil_t_ueber_tquantil = mean(abs(t_wert) > qt(0.975, n - 1)),
        anteil_z_ueber_196 = mean(abs(z_wert) > 1.96),
        t_quantil = qt(0.975, n - 1)), 4)
                   sd_t            theorie_sd_t                    sd_z 
                 1.3853                  1.4142                  1.0054 
     anteil_t_ueber_196 anteil_t_ueber_tquantil      anteil_z_ueber_196 
                 0.1242                  0.0495                  0.0515 
              t_quantil 
                 2.7764 
# Was das fuer Konfidenzintervalle bedeutet: deckt das Intervall die wahre 0?
breite_z <- 2 * 1.96 * streuung / sqrt(n)
breite_t <- 2 * qt(0.975, n - 1) * streuung / sqrt(n)
round(c(ueberdeckung_mit_196 = mean(abs(mittel) < 1.96 * streuung / sqrt(n)),
        ueberdeckung_mit_t = mean(abs(mittel) < qt(0.975, n - 1) * streuung / sqrt(n)),
        mittlere_breite_z = mean(breite_z),
        mittlere_breite_t = mean(breite_t)), 4)
ueberdeckung_mit_196   ueberdeckung_mit_t    mittlere_breite_z 
              0.8758               0.9504               1.6539 
   mittlere_breite_t 
              2.3428 
ggplot(data.frame(x = t_wert), aes(x)) +
  geom_histogram(aes(y = after_stat(density)), bins = 120,
                 fill = "grey80", colour = NA) +
  stat_function(fun = dt, args = list(df = n - 1), linewidth = 0.9) +
  stat_function(fun = dnorm, linewidth = 0.9, linetype = "dashed") +
  coord_cartesian(xlim = c(-6, 6)) +
  labs(x = "t-Wert", y = "Dichte")
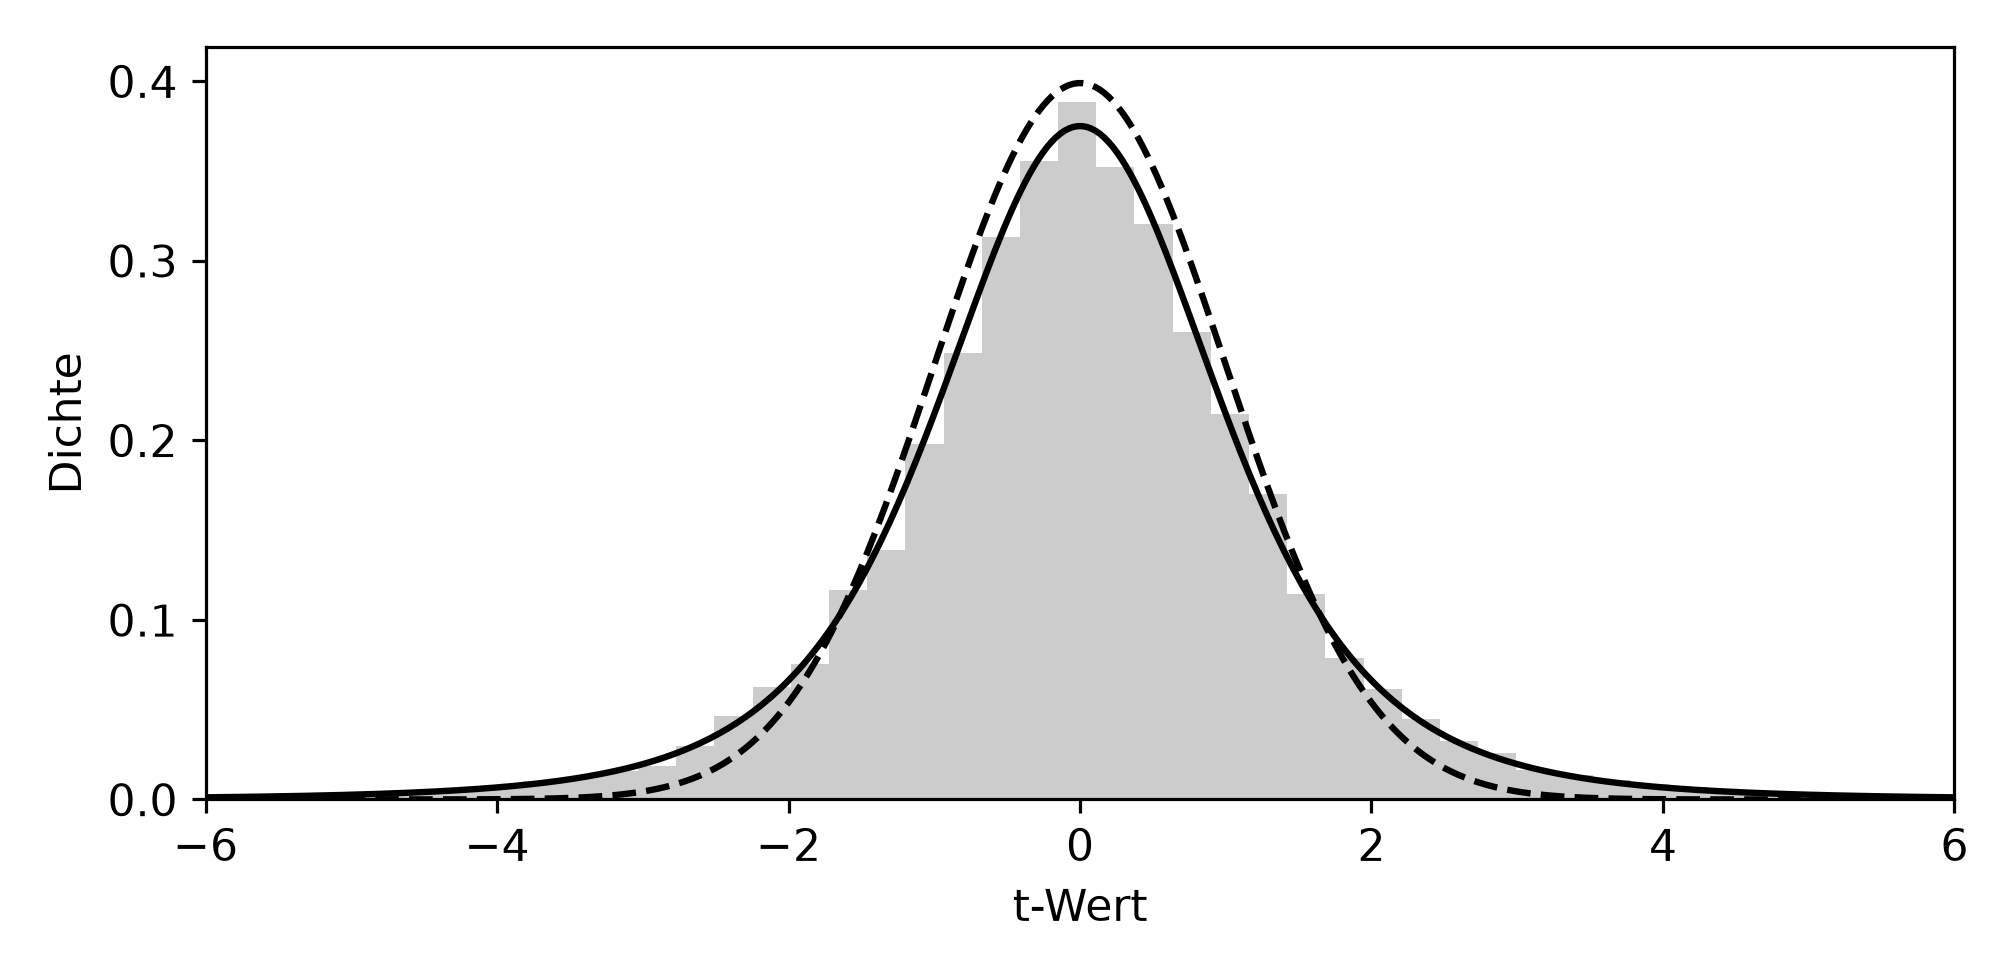
Abbildung 5: Beispiel 3: t-Verteilung mit 4 Freiheitsgraden gegen die Standardnormalverteilung.
N, n = 20000, 5
S = normalmatrix(5711, N, n)
mittel = S.mean(axis=1)
streuung = S.std(axis=1, ddof=1)

t_wert = mittel / (streuung / np.sqrt(n))
z_wert = mittel / (1 / np.sqrt(n))

print({"sd_t": round(float(t_wert.std(ddof=1)), 4),
       "theorie_sd_t": round(float(np.sqrt((n - 1) / (n - 3))), 4),
       "sd_z": round(float(z_wert.std(ddof=1)), 4),
       "anteil_t_ueber_196": round(float((abs(t_wert) > 1.96).mean()), 4),
       "anteil_t_ueber_tquantil":
           round(float((abs(t_wert) > stats.t.ppf(.975, n - 1)).mean()), 4),
       "anteil_z_ueber_196": round(float((abs(z_wert) > 1.96).mean()), 4),
       "t_quantil": round(float(stats.t.ppf(.975, n - 1)), 4)})
{'sd_t': 1.3853, 'theorie_sd_t': 1.4142, 'sd_z': 1.0054, 'anteil_t_ueber_196': 0.1242, 'anteil_t_ueber_tquantil': 0.0495, 'anteil_z_ueber_196': 0.0515, 't_quantil': 2.7764}
breite_z = 2 * 1.96 * streuung / np.sqrt(n)
breite_t = 2 * stats.t.ppf(.975, n - 1) * streuung / np.sqrt(n)
print({"ueberdeckung_mit_196":
           round(float((abs(mittel) < 1.96 * streuung / np.sqrt(n)).mean()), 4),
       "ueberdeckung_mit_t":
           round(float((abs(mittel)
                        < stats.t.ppf(.975, n - 1) * streuung / np.sqrt(n)).mean()), 4),
       "mittlere_breite_z": round(float(breite_z.mean()), 4),
       "mittlere_breite_t": round(float(breite_t.mean()), 4)})
{'ueberdeckung_mit_196': 0.8758, 'ueberdeckung_mit_t': 0.9505, 'mittlere_breite_z': 1.6539, 'mittlere_breite_t': 2.3428}
fig, achse = plt.subplots(figsize=(7, 3.4))
achse.hist(t_wert, bins=120, density=True, color="0.8")
gitter = np.linspace(-6, 6, 400)
achse.plot(gitter, stats.t.pdf(gitter, n - 1), lw=1.6, color="black")
achse.plot(gitter, stats.norm.pdf(gitter), lw=1.6, ls="--", color="black")
achse.set_xlim(-6, 6)
(-6.0, 6.0)
achse.set_xlabel("t-Wert")
achse.set_ylabel("Dichte")
plt.tight_layout()
plt.show()
Abbildung 6: Beispiel 3: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

Grösse Streuung bekannt (z) Streuung geschätzt (t)
Standardabweichung der Statistik 1.005 1.385 (Theorie \(\sqrt{4/2} = 1.414\))
Anteil mit Betrag über 1.96 0.0515 0.1242
Anteil über dem richtigen Quantil 0.0515 (bei 1.96) 0.0495 (bei 2.7764)
Konfidenzintervall Überdeckung mittlere Breite
mit 1.96 gerechnet 0.8758 1.654
mit \(t_{0.975;4} = 2.7764\) 0.9505 2.343
Beobachtung Erklärung
Die t-Statistik streut stärker als die z-Statistik 1.385 gegen 1.005. Im Nenner steht eine geschätzte Grösse, und deren Zufälligkeit kommt zur Zufälligkeit des Zählers hinzu. Ist die geschätzte Streuung zufällig klein, wird der Bruch gross.
Mit 1.96 gerechnet liegt der Fehler 1. Art bei 12.4 Prozent statt 5 Mehr als das Doppelte. Bei \(n = 5\) ist das kein Schönheitsfehler, sondern ein anderer Test.
Das Konfidenzintervall deckt nur 87.6 Prozent statt 95 Dieselbe Sache von der anderen Seite gesehen.
Der Preis der Korrektur ist die Breite 2.343 gegen 1.654, also 42 Prozent breiter. Die Unsicherheit über die Streuung wird ehrlich mitgetragen.
Mit dem richtigen Quantil stimmt alles 0.0495 und 0.9505. Die t-Verteilung ist genau die Korrektur, die es braucht.

Wie schnell die Korrektur unwichtig wird: Der Faktor \(t_{0.975;df}\) nähert sich 1.96.

df 1 2 5 10 30 100
\(t_{0.975}\) 12.706 4.303 2.571 2.228 2.042 1.984 1.960

Ab etwa 30 Freiheitsgraden liegt der Unterschied unter 5 Prozent, daher die verbreitete Faustregel. Unter 10 ist er dramatisch, und bei df = 1 (die Cauchy-Verteilung) hat die t-Verteilung keinen Erwartungswert und keine Varianz mehr.

Das erklärt zugleich, warum die t-Verteilung selten für Daten verwendet wird und trotzdem in jeder Tabelle steht: Sie beschreibt nicht Messwerte, sondern das Verhältnis aus Schätzung und geschätztem Standardfehler.

Interpretation und Ergebnissatz

Bei \(n = 5\) führt das Rechnen mit dem Normalquantil 1.96 statt mit \(t_{0.975;4} = 2.776\) zu einem Fehler 1. Art von 12.4 statt 5 Prozent und zu Konfidenzintervallen, die nur 87.6 statt 95 Prozent überdecken. Mit dem t-Quantil stimmen beide Werte.

Frage und Datenlage

\(F\) ist ein Verhältnis zweier Varianzschätzungen. Zwei Dinge werden hier geprüft: dass die Konstruktion stimmt, und was passiert, wenn die Daten nicht normalverteilt sind.

Rechnung

N <- 20000; d1 <- 5; d2 <- 10
A <- normalmatrix(6811, N, d1)
B <- normalmatrix(9137, N, d2)
Fwert <- (rowSums(A^2) / d1) / (rowSums(B^2) / d2)

round(c(mittel = mean(Fwert), theorie_mittel = d2 / (d2 - 2),
        median = median(Fwert), theorie_median = qf(0.5, d1, d2),
        anteil_ueber_q95 = mean(Fwert > qf(0.95, d1, d2))), 4)
          mittel   theorie_mittel           median   theorie_median 
          1.2481           1.2500           0.9273           0.9319 
anteil_ueber_q95 
          0.0508 
# Der Zusammenhang t^2 = F
round(c(t_quantil_hoch2 = qt(0.975, 4)^2, F_quantil = qf(0.95, 1, 4)), 4)
t_quantil_hoch2       F_quantil 
         7.7086          7.7086 
ggplot(data.frame(x = Fwert), aes(x)) +
  geom_histogram(aes(y = after_stat(density)), bins = 150,
                 fill = "grey80", colour = NA) +
  stat_function(fun = df, args = list(df1 = d1, df2 = d2), linewidth = 0.9) +
  coord_cartesian(xlim = c(0, 6)) +
  labs(x = "F-Wert", y = "Dichte")
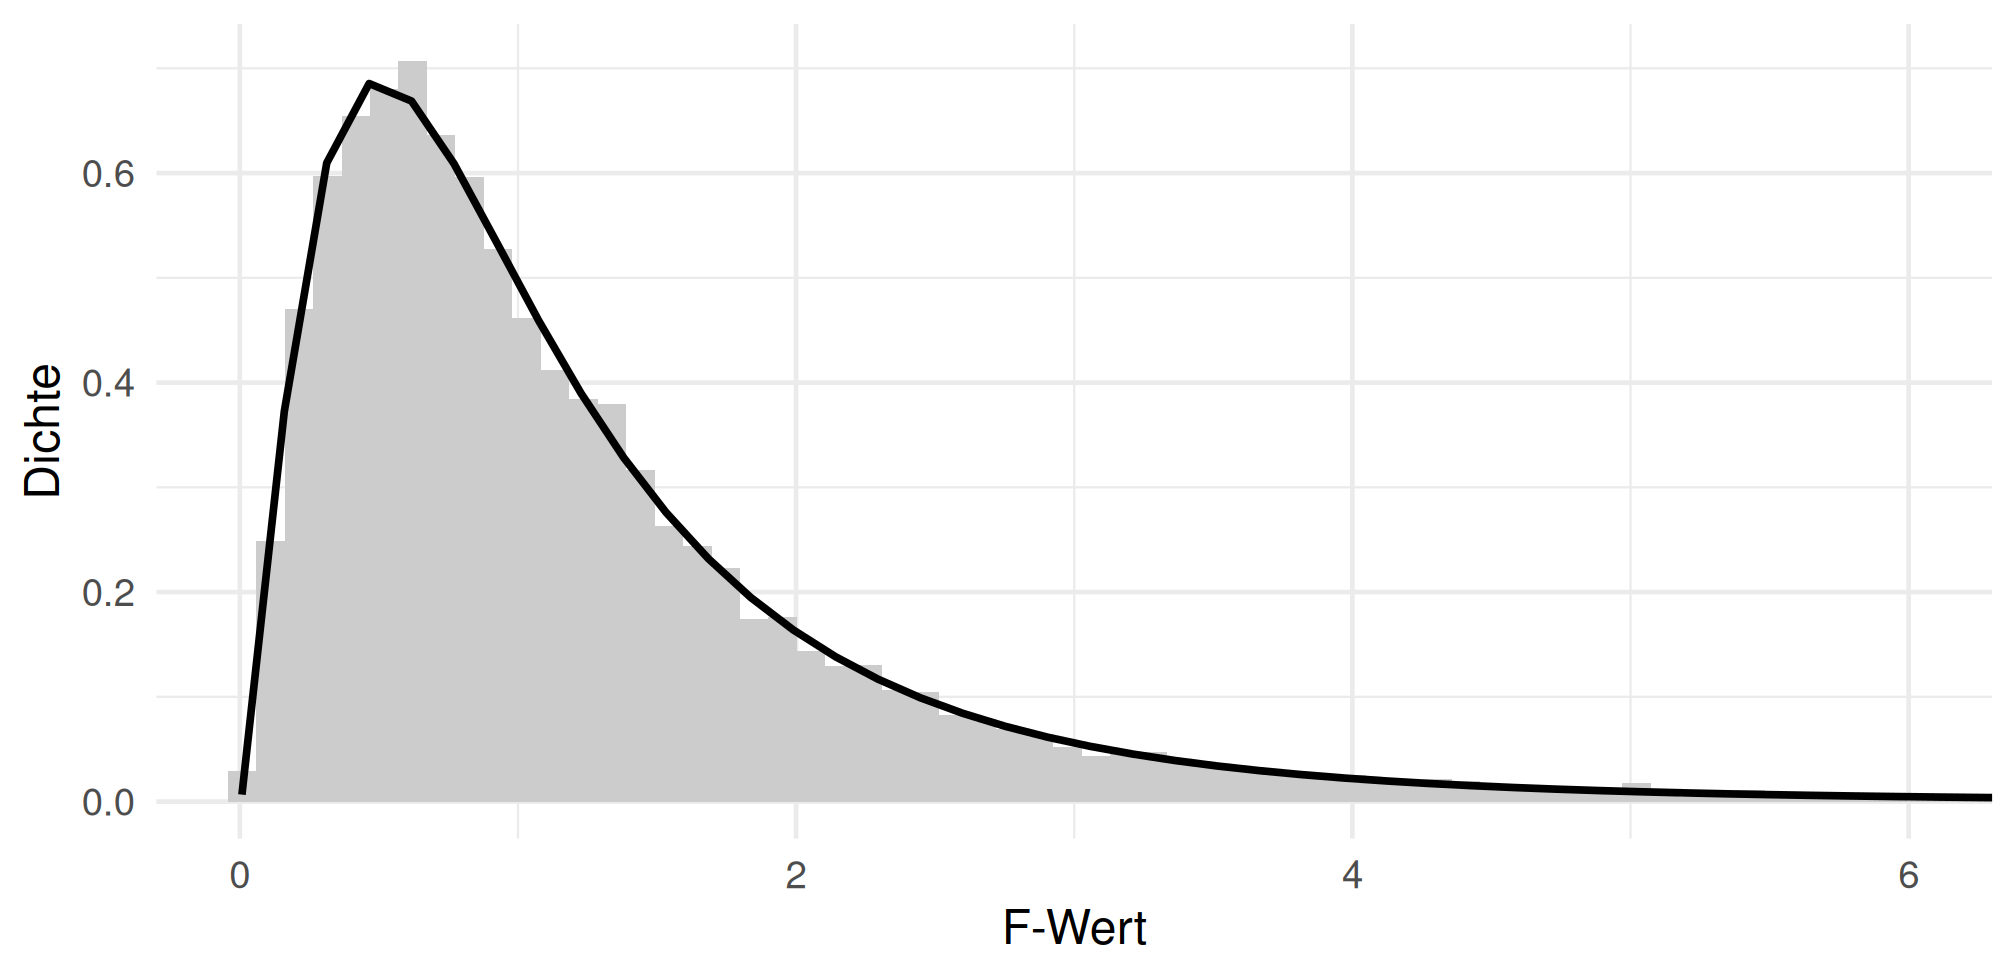
Abbildung 7: Beispiel 4: simuliertes Varianzverhältnis gegen die F-Dichte.
# Wie robust ist der F-Test auf gleiche Varianzen?
# Beide Gruppen haben immer dieselbe Varianz -- abgelehnt werden duerfte in
# 5 Prozent der Faelle.
N <- 10000; n1 <- 20; n2 <- 20
u <- matrix(lehmer(2718, N * (n1 + n2)), nrow = N, byrow = TRUE)
normal <- qnorm(u)
exponential <- -log(u)

varquotient <- function(M) {
  apply(M[, 1:n1], 1, var) / apply(M[, (n1 + 1):(n1 + n2)], 1, var)
}
unten <- qf(0.025, n1 - 1, n2 - 1); oben <- qf(0.975, n1 - 1, n2 - 1)

fn <- varquotient(normal); fe <- varquotient(exponential)
round(c(F_test_normal = mean(fn < unten | fn > oben),
        F_test_exponential = mean(fe < unten | fe > oben),
        krit_unten = unten, krit_oben = oben), 4)
     F_test_normal F_test_exponential         krit_unten          krit_oben 
            0.0502             0.2661             0.3958             2.5265 
# Brown-Forsythe als Alternative: F-Statistik auf den Abstaenden zum Median
brown_forsythe <- function(M) {
  A <- M[, 1:n1]; B <- M[, (n1 + 1):(n1 + n2)]
  dA <- abs(A - apply(A, 1, median)); dB <- abs(B - apply(B, 1, median))
  mA <- rowMeans(dA); mB <- rowMeans(dB)
  gesamt <- (mA * n1 + mB * n2) / (n1 + n2)
  zwischen <- n1 * (mA - gesamt)^2 + n2 * (mB - gesamt)^2
  innen <- rowSums((dA - mA)^2) + rowSums((dB - mB)^2)
  zwischen / (innen / (n1 + n2 - 2))
}
kf <- qf(0.95, 1, n1 + n2 - 2)
round(c(bf_normal = mean(brown_forsythe(normal) > kf),
        bf_exponential = mean(brown_forsythe(exponential) > kf),
        woelbung_normal = mean((normal - mean(normal))^4) / sd(normal)^4,
        woelbung_exponential = mean((exponential - mean(exponential))^4) /
          sd(exponential)^4), 4)
           bf_normal       bf_exponential      woelbung_normal 
              0.0375               0.0475               3.0080 
woelbung_exponential 
              9.1316 
N, d1, d2 = 20000, 5, 10
A = normalmatrix(6811, N, d1)
B = normalmatrix(9137, N, d2)
Fwert = ((A ** 2).sum(axis=1) / d1) / ((B ** 2).sum(axis=1) / d2)

print({"mittel": round(float(Fwert.mean()), 4),
       "theorie_mittel": round(d2 / (d2 - 2), 4),
       "median": round(float(np.median(Fwert)), 4),
       "theorie_median": round(float(stats.f.ppf(.5, d1, d2)), 4),
       "anteil_ueber_q95":
           round(float((Fwert > stats.f.ppf(.95, d1, d2)).mean()), 4)})
{'mittel': 1.2481, 'theorie_mittel': 1.25, 'median': 0.9273, 'theorie_median': 0.9319, 'anteil_ueber_q95': 0.0508}
print({"t_quantil_hoch2": round(float(stats.t.ppf(.975, 4)) ** 2, 4),
       "F_quantil": round(float(stats.f.ppf(.95, 1, 4)), 4)})
{'t_quantil_hoch2': 7.7086, 'F_quantil': 7.7086}
fig, achse = plt.subplots(figsize=(7, 3.4))
achse.hist(Fwert, bins=150, density=True, color="0.8")
gitter = np.linspace(0.01, 6, 400)
achse.plot(gitter, stats.f.pdf(gitter, d1, d2), lw=1.6, color="black")
achse.set_xlim(0, 6)
(0.0, 6.0)
achse.set_xlabel("F-Wert")
achse.set_ylabel("Dichte")
plt.tight_layout()
plt.show()
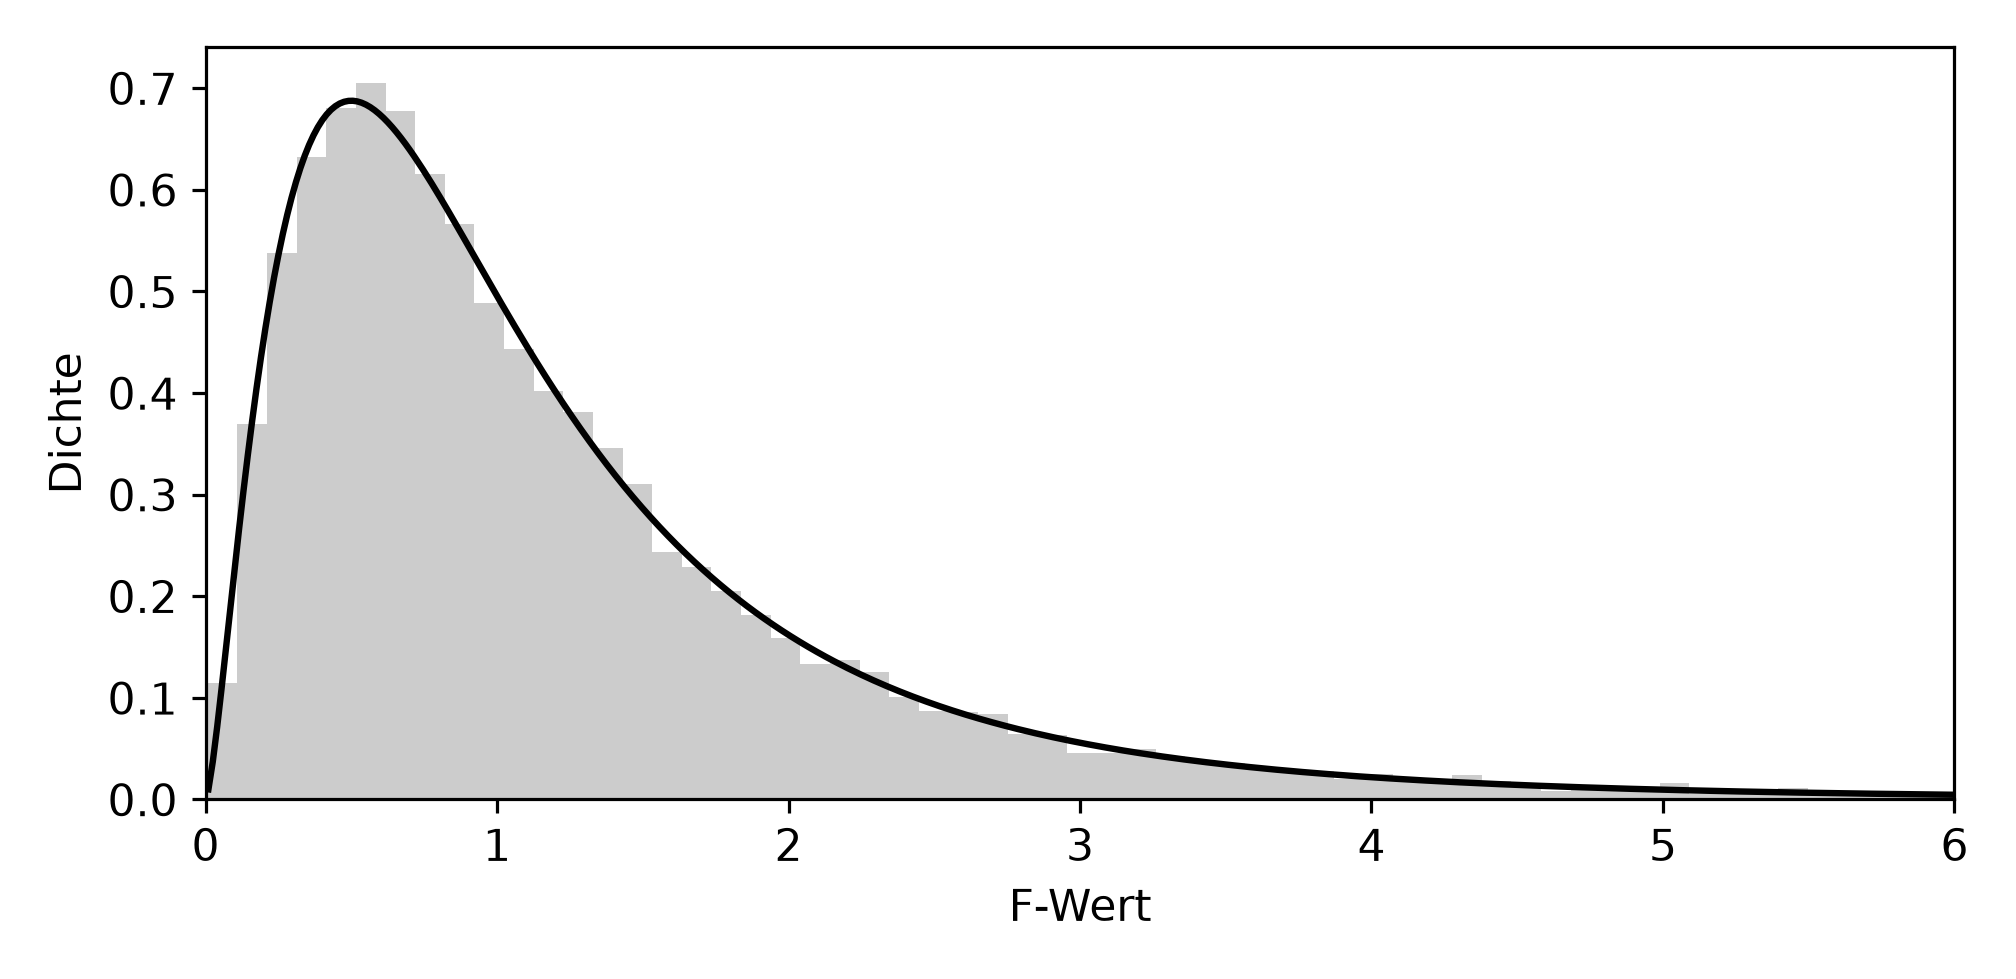
Abbildung 8: Beispiel 4: dieselbe Verteilung in Python.
N, n1, n2 = 10000, 20, 20
u = lehmer(2718, N * (n1 + n2)).reshape(N, n1 + n2)
normal = stats.norm.ppf(u)
exponential = -np.log(u)


def varquotient(M):
    return M[:, :n1].var(axis=1, ddof=1) / M[:, n1:].var(axis=1, ddof=1)


unten = stats.f.ppf(.025, n1 - 1, n2 - 1)
oben = stats.f.ppf(.975, n1 - 1, n2 - 1)
fn = varquotient(normal)
fe = varquotient(exponential)
print({"F_test_normal": round(float(((fn < unten) | (fn > oben)).mean()), 4),
       "F_test_exponential": round(float(((fe < unten) | (fe > oben)).mean()), 4),
       "krit_unten": round(float(unten), 4), "krit_oben": round(float(oben), 4)})
{'F_test_normal': 0.0502, 'F_test_exponential': 0.2661, 'krit_unten': 0.3958, 'krit_oben': 2.5265}
def brown_forsythe(M):
    A, B = M[:, :n1], M[:, n1:]
    dA = np.abs(A - np.median(A, axis=1, keepdims=True))
    dB = np.abs(B - np.median(B, axis=1, keepdims=True))
    mA, mB = dA.mean(axis=1), dB.mean(axis=1)
    gesamt = (mA * n1 + mB * n2) / (n1 + n2)
    zwischen = n1 * (mA - gesamt) ** 2 + n2 * (mB - gesamt) ** 2
    innen = ((dA - mA[:, None]) ** 2).sum(axis=1) + ((dB - mB[:, None]) ** 2).sum(axis=1)
    return zwischen / (innen / (n1 + n2 - 2))


kf = stats.f.ppf(.95, 1, n1 + n2 - 2)
print({"bf_normal": round(float((brown_forsythe(normal) > kf).mean()), 4),
       "bf_exponential": round(float((brown_forsythe(exponential) > kf).mean()), 4),
       "woelbung_normal": round(float(stats.kurtosis(normal.ravel(), fisher=False)), 4),
       "woelbung_exponential":
           round(float(stats.kurtosis(exponential.ravel(), fisher=False)), 4)})
{'bf_normal': 0.0375, 'bf_exponential': 0.0475, 'woelbung_normal': 3.008, 'woelbung_exponential': 9.1317}

Output Zeile für Zeile

Zuerst die Konstruktion, \(F_{5,10}\):

Grösse Simulation Theorie
Mittelwert 1.2481 \(10/8 = 1.25\)
Median 0.9273 0.9319
Anteil über \(q_{0.95}\) 0.0508 0.05
\(t_{0.975;4}^2\) gegen \(F_{0.95;1,4}\) 7.7086 7.7086

Und die Empfindlichkeit, beide Gruppen mit derselben wahren Varianz:

Test normalverteilte Daten exponentialverteilte Daten
F-Test auf gleiche Varianzen 0.0502 0.2661
Brown-Forsythe 0.0375 0.0475
Wölbung der Daten 3.008 9.132
Beobachtung Erklärung
Der Mittelwert ist nicht 1, sondern 1.25 Obwohl Zähler und Nenner denselben Erwartungswert haben. Bei einem Quotienten ist \(E(1/X) \neq 1/E(X)\); der Nennerfreiheitsgrad bestimmt, wie stark der Effekt ist. Bei \(d_2 = 10\) sind es 25 Prozent. Der Median liegt dagegen nahe bei 1.
\(t^2 = F\) auf sieben Stellen 7.7086 beide Male. Der t-Test mit zwei Gruppen und die Varianzanalyse sind derselbe Test.
Der F-Test hält bei Normalverteilung genau 5 Prozent 0.0502. Unter seiner Annahme ist er exakt.
Bei exponentialverteilten Daten lehnt er in 26.6 Prozent der Fälle ab Bei völlig gleichen Varianzen. Das ist mehr als das Fünffache des Versprochenen. Der F-Test auf Varianzgleichheit prüft in Wahrheit die Normalverteilungsannahme mit.
Brown-Forsythe bleibt bei 4.8 Prozent Weil er mit Abständen zum Median statt mit Quadraten rechnet und die Wölbung damit kaum eine Rolle spielt.
Brown-Forsythe ist bei Normalverteilung leicht konservativ 3.75 statt 5 Prozent bei \(n = 20\) pro Gruppe. Der Preis für die Robustheit.

Die praktische Folge: Der klassische F-Test auf Varianzgleichheit, in R var.test(), in Python scipy.stats.f.cdf von Hand, ist als Vorschaltprüfung vor einem t-Test nicht zu gebrauchen. Bei schiefen Daten schlägt er ständig Alarm, ohne dass die Varianzen verschieden wären.

Aufgabe brauchbar nicht brauchbar
Varianzen zweier Gruppen vergleichen Levene, Brown-Forsythe klassischer F-Test
Mittelwerte vergleichen, wenn Varianzen unklar Welch-t-Test (immer) t-Test nach Vorschaltprüfung
Modelle vergleichen (Varianzanalyse, Regression) F-Test, hier ist er am Platz

Beim Modellvergleich ist die F-Verteilung dagegen der richtige Rahmen und gegenüber mässiger Nichtnormalität unempfindlich, weil dort die Mittelwerte im Zähler stehen und der zentrale Grenzwertsatz greift. Beim Varianzvergleich stehen die Streuungen selbst im Zähler, und der Grenzwertsatz hilft nicht.

Interpretation und Ergebnissatz

Das Verhältnis zweier unabhängiger Varianzschätzungen folgt der F-Verteilung; ihr Median liegt nahe bei 1, ihr Mittelwert bei \(d_2/(d_2-2)\). Der F-Test auf Varianzgleichheit hält sein Niveau nur bei normalverteilten Daten: bei exponentialverteilten lehnt er in 26.6 statt 5 Prozent der Fälle ab, während Brown-Forsythe bei 4.8 Prozent bleibt.

Frage und Datenlage

Zwei Gruppen zu je zwölf Messwerten. Drei verschiedene Fragen, drei Teststatistiken, drei Verteilungen, an einem einzigen Datensatz.

Rechnung

n <- 12
X <- normalmatrix(8123, 2, n)
a <- 50 + 8 * X[1, ]
b <- 50 + 8 * X[2, ] + 6

round(rbind(gruppe_a = a, gruppe_b = b), 2)
         [,1]  [,2]  [,3]  [,4]  [,5]  [,6]  [,7]  [,8]  [,9] [,10] [,11] [,12]
gruppe_a 37.8 49.63 56.23 52.34 53.48 52.14 41.48 48.35 61.50 50.21 42.90 43.80
gruppe_b 67.9 63.61 51.07 61.51 61.31 56.65 55.71 69.96 50.31 59.19 50.79 68.15
round(c(mittel_a = mean(a), mittel_b = mean(b),
        sd_a = sd(a), sd_b = sd(b)), 4)
mittel_a mittel_b     sd_a     sd_b 
 49.1542  59.6791   6.7283   6.9586 
# (1) Mittelwertvergleich -> t-Verteilung
ergebnis_t <- t.test(b, a, var.equal = TRUE)
round(c(t = unname(ergebnis_t$statistic), df = unname(ergebnis_t$parameter),
        p = ergebnis_t$p.value), 4)
      t      df       p 
 3.7667 22.0000  0.0011 
# (2) Dieselbe Frage als Varianzanalyse -> F-Verteilung
alle <- c(a, b); gesamtmittel <- mean(alle)
sq_zwischen <- n * (mean(a) - gesamtmittel)^2 + n * (mean(b) - gesamtmittel)^2
sq_innen <- sum((a - mean(a))^2) + sum((b - mean(b))^2)
Fwert <- (sq_zwischen / 1) / (sq_innen / (2 * n - 2))
round(c(sq_zwischen = sq_zwischen, sq_innen = sq_innen, F = Fwert,
        p = pf(Fwert, 1, 2 * n - 2, lower.tail = FALSE),
        t_hoch2 = unname(ergebnis_t$statistic)^2), 4)
sq_zwischen    sq_innen           F           p     t_hoch2 
   664.6400   1030.6165     14.1877      0.0011     14.1877 
# (3) Passen die Daten zur unterstellten Verteilung? -> Chi-Quadrat
grenzen <- qnorm(c(0.25, 0.5, 0.75), 50, 8)
beobachtet <- table(cut(alle, c(-Inf, grenzen, Inf)))
erwartet <- rep(length(alle) / 4, 4)
chi <- sum((beobachtet - erwartet)^2 / erwartet)
round(grenzen, 3); beobachtet
[1] 44.604 50.000 55.396

(-Inf,44.6]   (44.6,50]   (50,55.4] (55.4, Inf] 
          4           2           7          11 
round(c(chi_quadrat = chi, df = 3,
        p = pchisq(chi, 3, lower.tail = FALSE)), 4)
chi_quadrat          df           p 
     7.6667      3.0000      0.0534 
n = 12
X = normalmatrix(8123, 2, n)
a = 50 + 8 * X[0]
b = 50 + 8 * X[1] + 6

print(pd.DataFrame({"gruppe_a": a, "gruppe_b": b}).T.round(2).to_string())
            0      1      2      3      4      5      6      7      8      9      10     11
gruppe_a  37.8  49.63  56.23  52.34  53.48  52.14  41.48  48.35  61.50  50.21  42.90  43.80
gruppe_b  67.9  63.61  51.07  61.51  61.31  56.65  55.71  69.96  50.31  59.19  50.79  68.15
print({"mittel_a": round(float(a.mean()), 4), "mittel_b": round(float(b.mean()), 4),
       "sd_a": round(float(a.std(ddof=1)), 4), "sd_b": round(float(b.std(ddof=1)), 4)})
{'mittel_a': 49.1542, 'mittel_b': 59.6791, 'sd_a': 6.7283, 'sd_b': 6.9586}
t, p = stats.ttest_ind(b, a)
print({"t": round(float(t), 4), "df": 2 * n - 2, "p": round(float(p), 4)})
{'t': 3.7667, 'df': 22, 'p': 0.0011}
alle = np.concatenate([a, b])
gesamtmittel = alle.mean()
sq_zwischen = n * (a.mean() - gesamtmittel) ** 2 + n * (b.mean() - gesamtmittel) ** 2
sq_innen = ((a - a.mean()) ** 2).sum() + ((b - b.mean()) ** 2).sum()
Fwert = (sq_zwischen / 1) / (sq_innen / (2 * n - 2))
print({"sq_zwischen": round(float(sq_zwischen), 4),
       "sq_innen": round(float(sq_innen), 4), "F": round(float(Fwert), 4),
       "p": round(float(stats.f.sf(Fwert, 1, 2 * n - 2)), 4),
       "t_hoch2": round(float(t) ** 2, 4)})
{'sq_zwischen': 664.64, 'sq_innen': 1030.6165, 'F': 14.1877, 'p': 0.0011, 't_hoch2': 14.1877}
grenzen = stats.norm.ppf([.25, .5, .75], 50, 8)
beobachtet = np.histogram(alle, bins=np.concatenate([[-np.inf], grenzen, [np.inf]]))[0]
erwartet = np.repeat(len(alle) / 4, 4)
chi = float((((beobachtet - erwartet) ** 2) / erwartet).sum())
print(np.round(grenzen, 3), beobachtet)
[44.604 50.    55.396] [ 4  2  7 11]
print({"chi_quadrat": round(chi, 4), "df": 3,
       "p": round(float(stats.chi2.sf(chi, 3)), 4)})
{'chi_quadrat': 7.6667, 'df': 3, 'p': 0.0534}

Output Zeile für Zeile

Gruppe Mittelwert Standardabweichung
A 49.154 6.728
B 59.679 6.959
Frage Statistik Verteilung Wert df p
Unterscheiden sich die Mittelwerte? \(t\) t 3.7667 22 0.0011
Dieselbe Frage als Varianzzerlegung \(F\) F 14.1877 1 und 22 0.0011
Passen die Werte zur Verteilung N(50, 8²)? \(\chi^2\) Chi-Quadrat 7.6667 3 0.0534
Beobachtung Erklärung
\(t^2 = 3.7667^2 = 14.1877 = F\) Auf vier Stellen identisch, und die p-Werte ebenso: 0.0011 beide Male. Es ist derselbe Test in zwei Schreibweisen. Der t-Wert trägt das Vorzeichen und sagt, welche Gruppe grösser ist; der F-Wert wirft es weg.
Die Quadratsummen zerlegen die Streuung 664.64 zwischen den Gruppen, 1030.62 innerhalb. \(F\) ist das Verhältnis der beiden, jeweils auf ihre Freiheitsgrade bezogen: \(\frac{664.64/1}{1030.62/22}\).
Der Chi-Quadrat-Test beantwortet eine andere Frage Nicht “sind die Mittelwerte gleich”, sondern “liegen die 24 Werte so, wie N(50, 8²) es erwarten liesse”. Die vier Quartilsklassen sollten je 6 Werte enthalten, beobachtet wurden 4, 2, 7 und 11.
Sein p-Wert liegt bei 0.053 Knapp über 5 Prozent. Der Test bemerkt die Verschiebung der Gruppe B, aber er hat wenig Kraft, weil er 24 Werte in vier Klassen zusammenwirft und dabei die Gruppenzugehörigkeit ignoriert. Der t-Test mit derselben Information kommt auf 0.0011.
Die Freiheitsgrade sind jedes Mal andere 22 beim t-Test (\(2n-2\), zwei geschätzte Mittelwerte), 1 und 22 beim F-Test, 3 beim Chi-Quadrat-Test (vier Klassen minus eine Nebenbedingung, die Summe ist festgelegt).

Die Merkregel, welche Verteilung wann auftaucht:

Im Zähler steht … Verteilung Beispiele
eine Schätzung, im Nenner ihr geschätzter Standardfehler t Ein-/Zweistichproben-t-Test, Regressionskoeffizient
eine Summe von Abweichungsquadraten Chi-Quadrat Anpassungstest, Unabhängigkeitstest, Likelihood-Quotient
ein Verhältnis zweier Varianzschätzungen F Varianzanalyse, Modellvergleich zweier Regressionen

Nicht die Fragestellung entscheidet, sondern die Bauart der Statistik.

Interpretation und Ergebnissatz

An denselben 24 Werten liefert der t-Test \(t(22) = 3.77\) mit \(p = 0.0011\), die Varianzanalyse \(F(1, 22) = 14.19\) mit demselben \(p\), weil \(F = t^2\) gilt, und der Chi-Quadrat-Anpassungstest \(\chi^2(3) = 7.67\) mit \(p = 0.053\), eine andere Frage, eine andere Verteilung, eine andere Antwort.

Verständnisfragen

Warum ist die Chi-Quadrat-Verteilung nie negativ?

Weil sie eine Summe von Quadraten ist
Richtig. Quadrate sind nicht negativ, also ist ihre Summe es auch nicht.
Weil Wahrscheinlichkeiten nicht negativ sind
Das gilt für jede Verteilung und erklärt den Wertebereich nicht.
Weil sie nur bei Häufigkeiten verwendet wird
Sie beschreibt auch die Stichprobenvarianz, und der Grund liegt in der Konstruktion.

Die Simulation ergab bei sechs Beobachtungen im Mittel eine Varianz von 0.833 statt 1, wenn durch n geteilt wurde. Wie heisst dieser Effekt?

Bessel-Korrektur, der Faktor ist n minus eins durch n
Richtig. Die Abweichungen werden vom geschätzten Mittelwert gemessen, der näher an den Daten liegt als der wahre. Fünf Sechstel sind genau 0.833.
Zentraler Grenzwertsatz
Der betrifft die Verteilung von Summen, nicht die Verzerrung einer Varianzschätzung.
Zufall, bei 20 000 Wiederholungen kann das vorkommen
Der Standardfehler liegt hier bei rund 0.004; eine Abweichung von 0.167 ist systematisch.

Warum ist die t-Verteilung breiter als die Normalverteilung?

Weil im Nenner eine geschätzte statt einer bekannten Streuung steht
Richtig. Zwei zufällige Grössen statt einer. Fällt die geschätzte Streuung klein aus, wird der Quotient gross.
Weil die Daten nicht normalverteilt sind
In der Simulation waren sie es exakt, und die t-Verteilung war trotzdem breiter.
Weil der Stichprobenumfang klein ist
Das bestimmt nur, wie viel breiter. Der Grund ist die Schätzung der Streuung.

Bei fünf Beobachtungen wurde mit 1.96 statt mit 2.776 gerechnet. Was war die Folge?

Der Fehler 1. Art stieg auf 12.4 Prozent und die Überdeckung sank auf 87.6 Prozent
Richtig, mehr als das Doppelte des versprochenen Niveaus. Der Preis der Korrektur sind 42 Prozent breitere Intervalle.
Es machte praktisch keinen Unterschied
Ab etwa 30 Freiheitsgraden stimmt das, bei vier nicht.
Die Intervalle wurden zu breit
Sie wurden zu schmal; 1.96 ist kleiner als 2.776.

Der F-Test auf gleiche Varianzen lehnte bei exponentialverteilten Daten in 26.6 Prozent der Fälle ab, obwohl die Varianzen gleich waren. Was folgt daraus?

Er ist als Vorschaltprüfung vor einem t-Test unbrauchbar
Richtig. Er reagiert auf die Wölbung der Verteilung mit, hier 9.1 statt 3.0. Levene oder Brown-Forsythe blieben bei rund 5 Prozent. Praktisch sinnvoller ist ohnehin der Welch-t-Test ohne Vorschaltprüfung.
Exponentialverteilte Daten haben verschiedene Varianzen
Beide Gruppen stammten aus derselben Verteilung.
Die F-Verteilung ist grundsätzlich unbrauchbar
Beim Modellvergleich in der Varianzanalyse ist sie am Platz und unempfindlich, weil dort Mittelwerte im Zähler stehen.

Der t-Wert war 3.7667, der F-Wert 14.1877, beide p-Werte 0.0011. Zufall?

Nein, 3.7667 zum Quadrat ist 14.1877; es ist derselbe Test
Richtig, es gilt t² mit df Freiheitsgraden gleich F mit 1 und df. Der t-Wert behält das Vorzeichen und sagt zusätzlich, welche Gruppe grösser ist.
Zufall bei diesem Datensatz
Der Zusammenhang gilt algebraisch für jeden Datensatz mit zwei Gruppen.
Weil beide Tests dieselben Daten verwenden
Der Chi-Quadrat-Test verwendete ebenfalls dieselben Daten und kam auf p gleich 0.053.

Verlinkte Ressourcen