Typische Fragestellungen: mittlere Durchlaufzeit einer Produktion, Anteil fehlerhafter Teile, durchschnittliche Zustimmung in einer Befragung. Gemeinsam ist ihnen, dass eine Stichprobe vorliegt und eine Aussage über die Grundgesamtheit gemacht werden soll, aus der sie stammt.
Die Methode setzt voraus, dass die Stichprobe zufällig aus der interessierenden Grundgesamtheit gezogen wurde. Diese Bedingung ist die wichtigste und die am häufigsten verletzte: eine bequem erreichbare Stichprobe liefert ein sauber gerechnetes Intervall um den falschen Wert.
Die Kennzahl ist der Median oder ein anderes Quantil
Bootstrap oder verteilungsfreie Intervalle
Die Stichprobe ist nicht zufällig gezogen
kein Verfahren repariert das; die Einschränkung gehört in den Bericht
Grundidee und Modell
Die Kennzahl ist selbst zufällig
Bisher beschrieben Kennzahlen die vorliegenden Daten. Interessant ist aber selten die Stichprobe, sondern das, woraus sie stammt. Aus dreissig gemessenen Werkstücken soll etwas über die gesamte Produktion folgen.
Der entscheidende Gedankenschritt: Eine zweite Stichprobe hätte einen anderen Mittelwert ergeben. Der berechnete Wert ist damit selbst eine Zufallsgrösse, und die Frage lautet, wie stark er von Stichprobe zu Stichprobe schwankt.
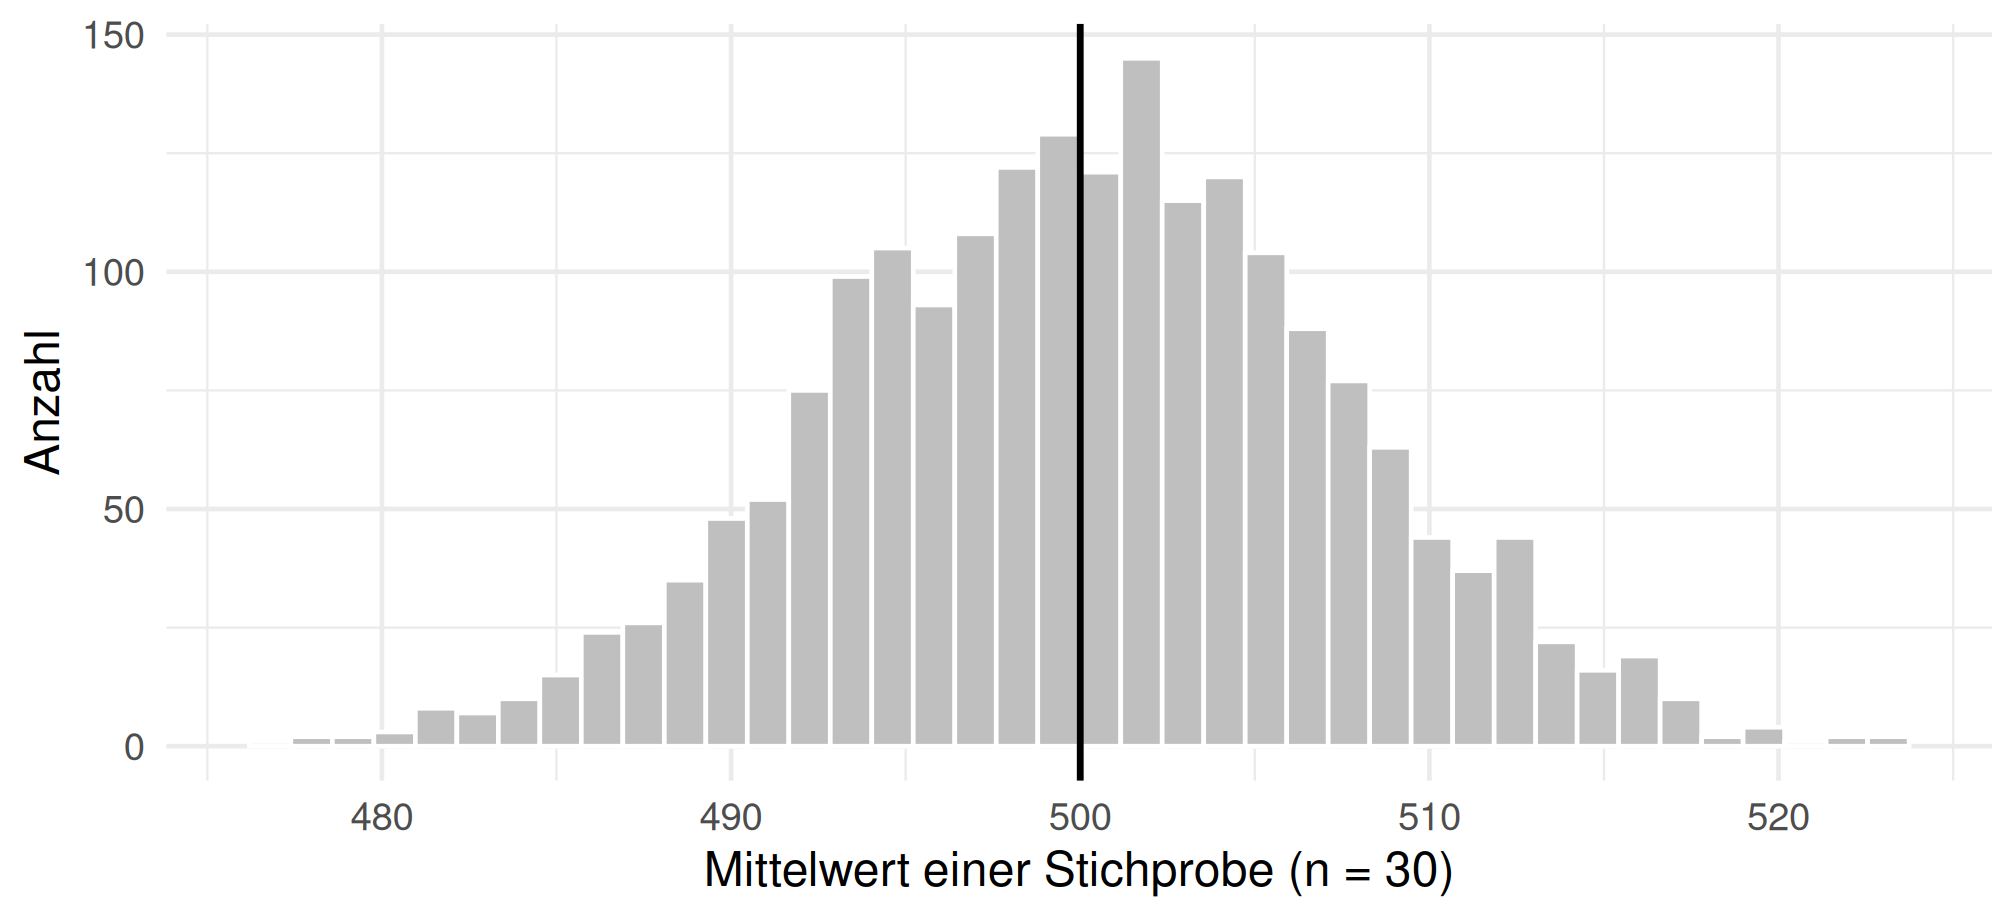
Das lässt sich simulieren, weil wir die Grundgesamtheit hier kennen:
Die simulierte Streuung der 2000 Mittelwerte beträgt 7.32, die Formel \(40/\sqrt{30}\) liefert 7.30. Das ist der Beleg dafür, dass der Standardfehler tatsächlich misst, was er messen soll: die Schwankung des Mittelwerts von Stichprobe zu Stichprobe.
Der aus einer Stichprobe geschätzte Standardfehler weicht davon ab, hier 6.44 statt 7.30, weil auch die geschätzte Standardabweichung schwankt.
Die Wurzel im Nenner hat eine unangenehme Folge: Genauigkeit wird teuer. Wer den Standardfehler halbieren will, braucht die vierfache Stichprobe.
n <-c(10, 40, 160, 640)data.frame(n, standardfehler =round(40/sqrt(n), 2))
Überdeckung weicht vom Niveau ab, vor allem bei kleinem n
Bootstrap oder Transformation
Für Anteile: genügend Treffer
Faustregel: mindestens etwa zehn Treffer und zehn Nichttreffer
Auszählen
Das einfache Intervall reicht über null oder eins hinaus
Wilson oder Clopper-Pearson
Bei grossem n sorgt der zentrale Grenzwertsatz dafür, dass die dritte Voraussetzung praktisch erfüllt ist, auch wenn die Einzelwerte schief verteilt sind.
Output lesen
R, t.test(x):
Grösse
Was sie sagt
Faustregel oder Falle
mean of x
Punktschätzer
die Zahl, um die das Intervall liegt
95 percent confidence interval
Unter- und Obergrenze
die Spanne der mit den Daten vereinbaren Werte
t, df
Teststatistik und Freiheitsgrade
df ist n minus eins; sie bestimmen den Faktor
p-value
zum Test gegen null
für die reine Schätzung ohne Bedeutung
alternative hypothesis
die geprüfte Gegenannahme
erinnert daran, dass t.test zugleich testet
Python, stats.t.interval() liefert nur das Tupel aus Unter- und Obergrenze. Punktschätzer, Standardfehler und Freiheitsgrade stehen dort nicht dabei, sondern werden selbst berechnet und gehören trotzdem in den Bericht. Wer die vollständige Tabelle möchte, nimmt pingouin.ttest(x, 0); sie enthält zusätzlich Effektstärke und Power.
Für Anteile gibt prop.test() in R Schätzwert, Intervall und einen Test aus, proportion_confint() in Python nur die beiden Grenzen. Die Methode steht in Python ausdrücklich im Aufruf (wilson, beta, normal), in R entscheidet die Funktionswahl darüber.
Interpretationsfallen
Was das Intervall bedeutet, und was nicht
Hier liegt die häufigste Fehlinterpretation der ganzen Statistik. Die Aussage bezieht sich auf das Verfahren, nicht auf das einzelne berechnete Intervall. Der wahre Parameter ist fest, das Intervall ist zufällig.
Richtig ist: Wendet man das Verfahren immer wieder an, überdecken 95 Prozent der so erzeugten Intervalle den wahren Wert. Falsch ist die Aussage, der Parameter liege mit 95 Prozent Wahrscheinlichkeit in diesem einen Bereich.
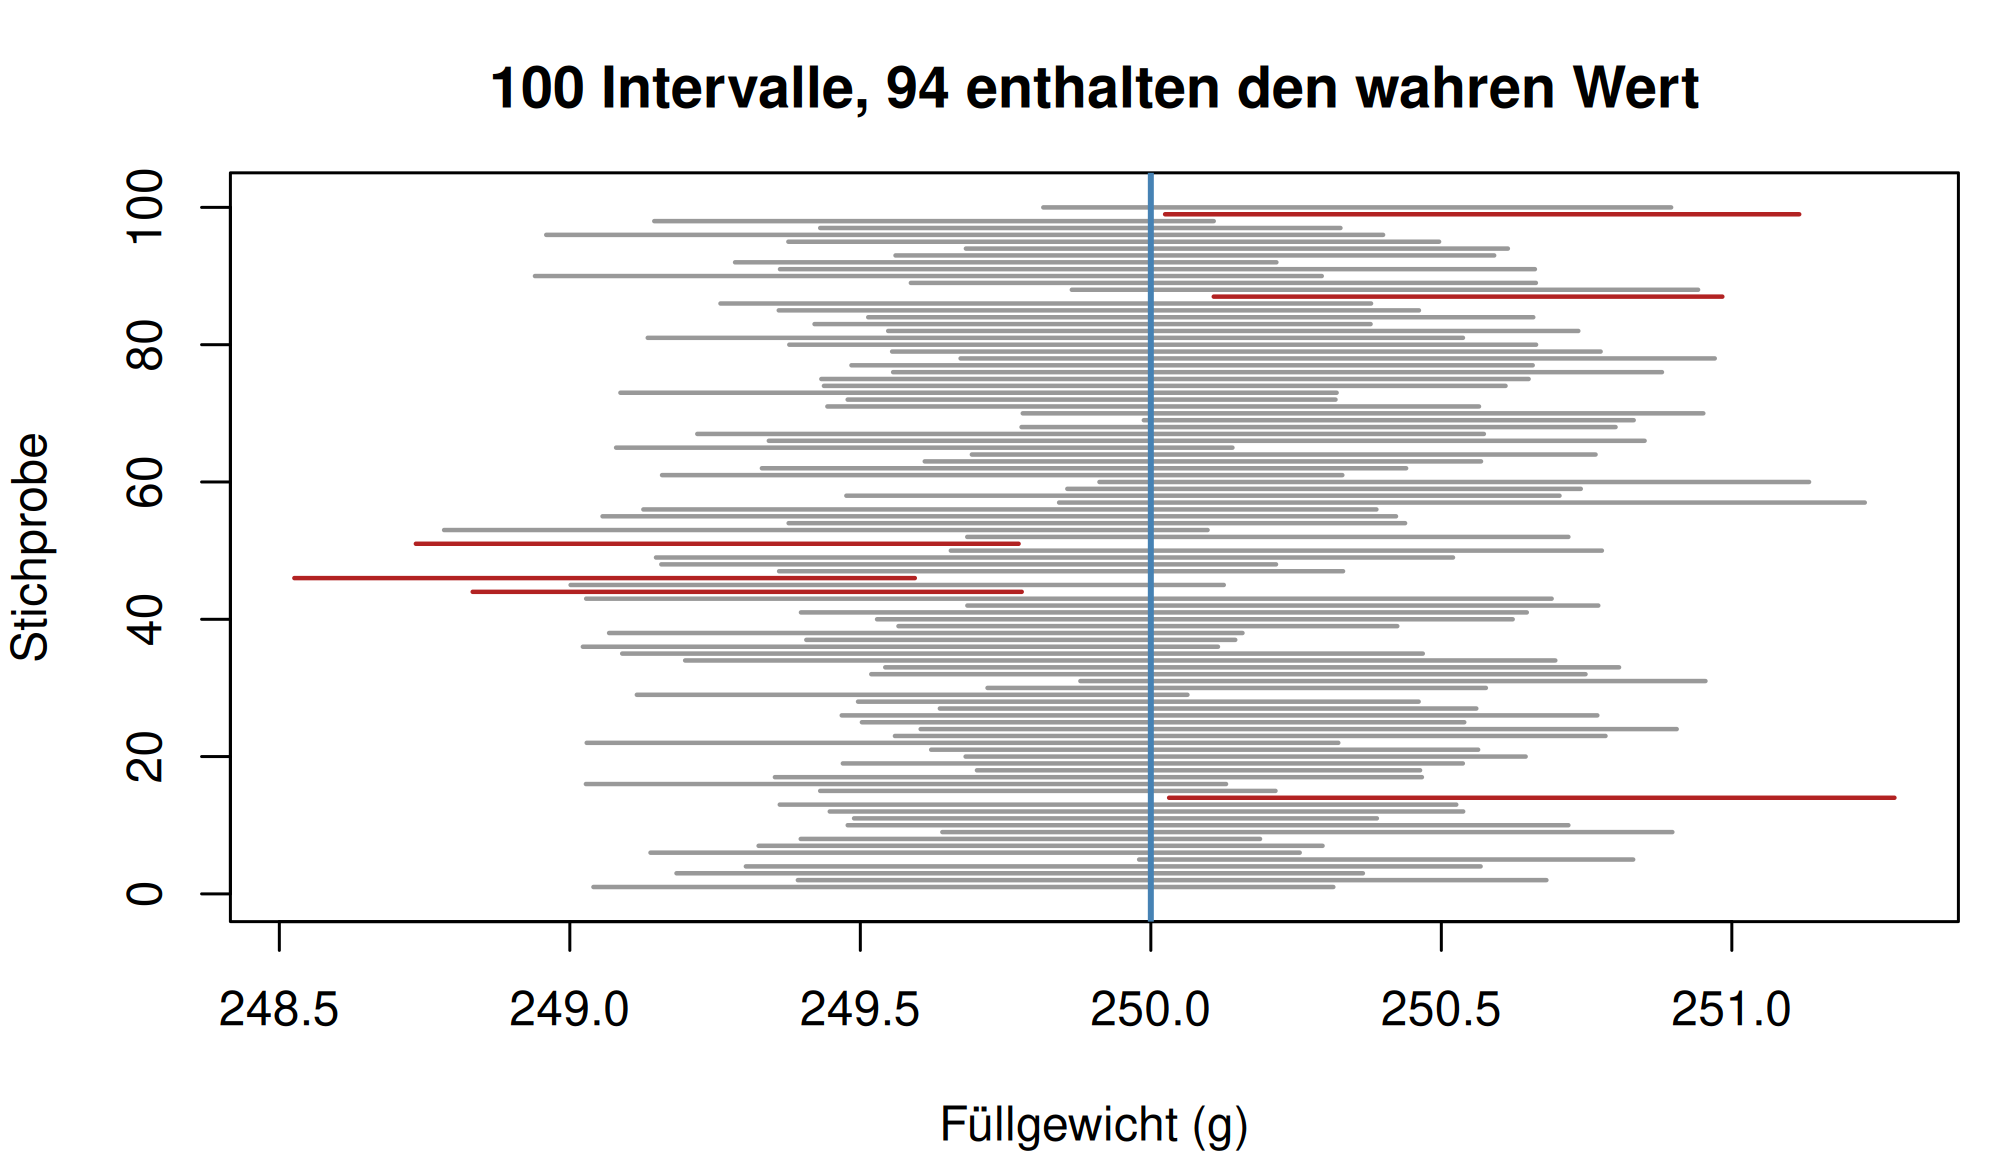
Beispiel 3 zeigt das an hundert Wiederholungen: Die Intervalle wandern, der wahre Wert steht fest, und 94 der 100 enthalten ihn. Welche sechs danebenliegen, lässt sich einem einzelnen Intervall nicht ansehen. Genau deshalb ist die Aussage über das Verfahren und nicht über das Einzelintervall formuliert.
Eine zulässige Kurzform für den Bericht lautet: “Mit den Daten vereinbar sind Werte zwischen [unten] und [oben].”
Dazu kommen drei Verwechslungen, die regelmässig vorkommen:
Standardabweichung und Standardfehler. Die eine beschreibt die Streuung der Einzelwerte, die andere die Genauigkeit des Mittelwerts. Wer beim Berichten das Falsche nennt, gibt eine um den Faktor Wurzel n verschobene Zahl an.
Ein Intervall ist keine Spanne der Einzelwerte. Dafür wäre das Prognoseintervall zuständig, das deutlich breiter ausfällt.
Zwei überlappende Intervalle bedeuten nicht, dass sich zwei Gruppen nicht unterscheiden. Der Vergleich zweier Gruppen wird am Intervall der Differenz beurteilt, nicht am Überlappen zweier Einzelintervalle.
Ergebnis berichten
Vorlage für den Ergebnissatz:
[Kennzahl] beträgt [Schätzwert] [Einheit] (95-Prozent-Konfidenzintervall [unten] bis [oben], n = [n]).
Genannt werden Punktschätzer mit Einheit, Intervall und Niveau, der Stichprobenumfang und bei Anteilen zusätzlich das verwendete Verfahren. Bewertet wird das Ergebnis an der Breite des Intervalls und nicht daran, ob es einen bestimmten Wert enthält.
Zwanzig Packungen werden gewogen, angegeben sind 250 Gramm. Gesucht ist nicht die Frage, ob das Sollgewicht eingehalten wird, sondern eine Spanne plausibler Werte für das mittlere Füllgewicht.
print(f"Intervall: {mittel - t_kritisch*standardfehler:.4f}"f" bis {mittel + t_kritisch*standardfehler:.4f}")
Intervall: 249.3599 bis 250.4201
Output Zeile für Zeile
Grösse
Wert hier
Bedeutung
Wie er zu lesen ist
n
20
Anzahl Packungen
Mittelwert
249.890
Punktschätzung
Die beste Einzelschätzung, aber ohne Angabe ihrer Unsicherheit wertlos.
Standardabweichung
1.133
Streuung der einzelnen Packungen
Beschreibt die Daten. Rund zwei Drittel der Packungen liegen im Bereich 249.89 ± 1.13.
Standardfehler
0.253
Streuung des Mittelwerts
Beschreibt die Schätzung. Er ist \(s/\sqrt{n}\) und damit rund viereinhalbmal kleiner als die Standardabweichung. Die Verwechslung dieser beiden Zahlen ist der häufigste Fehler auf dieser Seite.
\(t\)-Quantil
2.0930
Faktor für 95 Prozent bei 19 Freiheitsgraden
Bei grossem n nähert er sich 1.96. Bei n = 20 ist er noch merklich grösser, was das Intervall verbreitert.
Halbbreite
0.530
\(t \cdot SE\)
Intervall
249.360 bis 250.420
Der Sollwert 250 liegt darin.
Interpretation und Ergebnissatz
Das Intervall enthält den Sollwert 250. Daraus folgt: Ein Test gegen 250 wäre auf dem 5-Prozent-Niveau nicht signifikant. Das Intervall sagt aber mehr als der Test, denn es beziffert, was noch vereinbar ist: Ein wahres mittleres Füllgewicht von 249.4 Gramm ist mit diesen Daten ebenso verträglich wie eines von 250.4.
Ob das genügt, entscheidet die Vorgabe. Bei einer Toleranz von einem halben Gramm reicht das Intervall an beiden Enden knapp daran; für eine belastbare Aussage bräuchte es mehr Packungen, siehe Beispiel 4.
Das mittlere Füllgewicht beträgt 249.89 g (95-Prozent-Konfidenzintervall 249.36 bis 250.42 g, n = 20, SD = 1.13). Der deklarierte Wert von 250 g liegt im Intervall.
Frage und Datenlage
Von 40 geprüften Teilen sind 3 fehlerhaft. Der geschätzte Fehleranteil beträgt 7.5 Prozent. Gesucht ist ein Konfidenzintervall.
Bei Anteilen gibt es mehrere gebräuchliche Verfahren, und sie liefern spürbar verschiedene Ergebnisse. Das ist ein Fall, in dem die Wahl des Verfahrens die Aussage verändert.
Die untere Grenze ist negativ. Ein negativer Fehleranteil existiert nicht; die Formel weiss das nicht.
Wilson
0.026 bis 0.199
0.173
Bleibt im zulässigen Bereich und ist auch bei kleinen Anteilen zuverlässig.
Clopper-Pearson (exakt)
0.016 bis 0.204
0.188
Das breiteste. “Exakt” heisst hier: Es hält das Niveau garantiert ein, tut das aber, indem es eher zu breit ist.
Der Vergleich über verschiedene Ausgangslagen zeigt, wann der Unterschied zählt:
Beobachtung
Wald
Wilson
exakt
3 von 40 (7.5 %)
-0.007 bis 0.157
0.026 bis 0.199
0.016 bis 0.204
8 von 40 (20 %)
0.076 bis 0.324
0.105 bis 0.348
0.091 bis 0.357
20 von 40 (50 %)
0.345 bis 0.655
0.352 bis 0.648
0.338 bis 0.662
45 von 300 (15 %)
0.110 bis 0.190
0.114 bis 0.195
0.112 bis 0.196
Bei einem Anteil nahe 50 Prozent und bei grossem n stimmen alle drei praktisch überein. Nahe 0 oder 1 und bei kleinem n gehen sie auseinander, und dort ist Wald unbrauchbar.
Die Wald-Formel steht in jedem Lehrbuch und sollte trotzdem nicht verwendet werden. Sie unterschreitet das versprochene Niveau von 95 Prozent regelmässig, und zwar nicht nur bei extremen Anteilen. Ihre Beliebtheit rührt daher, dass sie sich von Hand rechnen lässt.
Empfohlen ist Wilson für den Normalfall und Clopper-Pearson, wenn das Niveau garantiert eingehalten werden muss. In R liefert prop.test() Wilson und binom.test() Clopper-Pearson; beide sind eine Zeile.
Interpretation und Ergebnissatz
Von 40 geprüften Teilen waren 3 fehlerhaft (7.5 Prozent, 95-Prozent- Konfidenzintervall nach Wilson 2.6 bis 19.9 Prozent). Das Intervall ist bei diesem Umfang sehr breit; für eine Aussage über die Einhaltung einer Fehlergrenze von 10 Prozent reicht die Datenlage nicht.
Frage und Datenlage
Die verbreitete Formulierung “der wahre Wert liegt mit 95-prozentiger Wahrscheinlichkeit im Intervall” ist falsch. Was stimmt, lässt sich am besten zeigen, indem man die Erhebung hundertmal wiederholt.
Hier ist der wahre Mittelwert bekannt: 250 Gramm bei einer Streuung von 1.2. Aus dieser Grundgesamtheit werden hundert Stichproben zu je zwanzig Packungen gezogen, und für jede wird das Intervall berechnet.
Nahe an den erwarteten 95. Die Abweichung ist Zufall: Bei hundert Wiederholungen schwankt die Zahl um 95 mit einer Standardabweichung von rund 2.2.
verfehlte Intervalle
6
Im Bild rot. Sie sind nicht falsch gerechnet, sondern die vorgesehene Ausnahme.
mittlere Breite
1.122
Die Intervalle sind verschieden breit, weil jede Stichprobe eine eigene Standardabweichung liefert.
Das Bild zeigt den entscheidenden Punkt: Die Intervalle wandern, der wahre Wert steht fest. Die blaue Linie bei 250 ist unverrückbar; was von Stichprobe zu Stichprobe schwankt, sind Lage und Breite der Intervalle.
Deshalb ist die Aussage “mit 95 Prozent Wahrscheinlichkeit liegt der wahre Wert in diesem Intervall” falsch. Der wahre Wert ist eine feste Zahl. Er liegt im berechneten Intervall oder nicht; eine Wahrscheinlichkeit gibt es dafür nicht.
Was stimmt: Das Verfahren trifft in 95 Prozent der Anwendungen. Die Aussage gilt der Methode, nicht dem einzelnen Ergebnis.
Praktisch macht das selten einen Unterschied in der Entscheidung, wohl aber in der Formulierung. Eine zulässige Kurzform lautet: “Mit den Daten vereinbar sind Werte zwischen 249.4 und 250.4 Gramm.”
Interpretation
Der zweite Punkt, den das Bild zeigt: Die verfehlten Intervalle sehen nicht anders aus als die getroffenen. Sie sind nicht auffällig schmal oder auffällig weit verschoben. Es gibt kein Merkmal, an dem sich einem einzelnen Intervall ansehen liesse, ob es zu den 95 oder zu den 5 Prozent gehört.
Frage und Datenlage
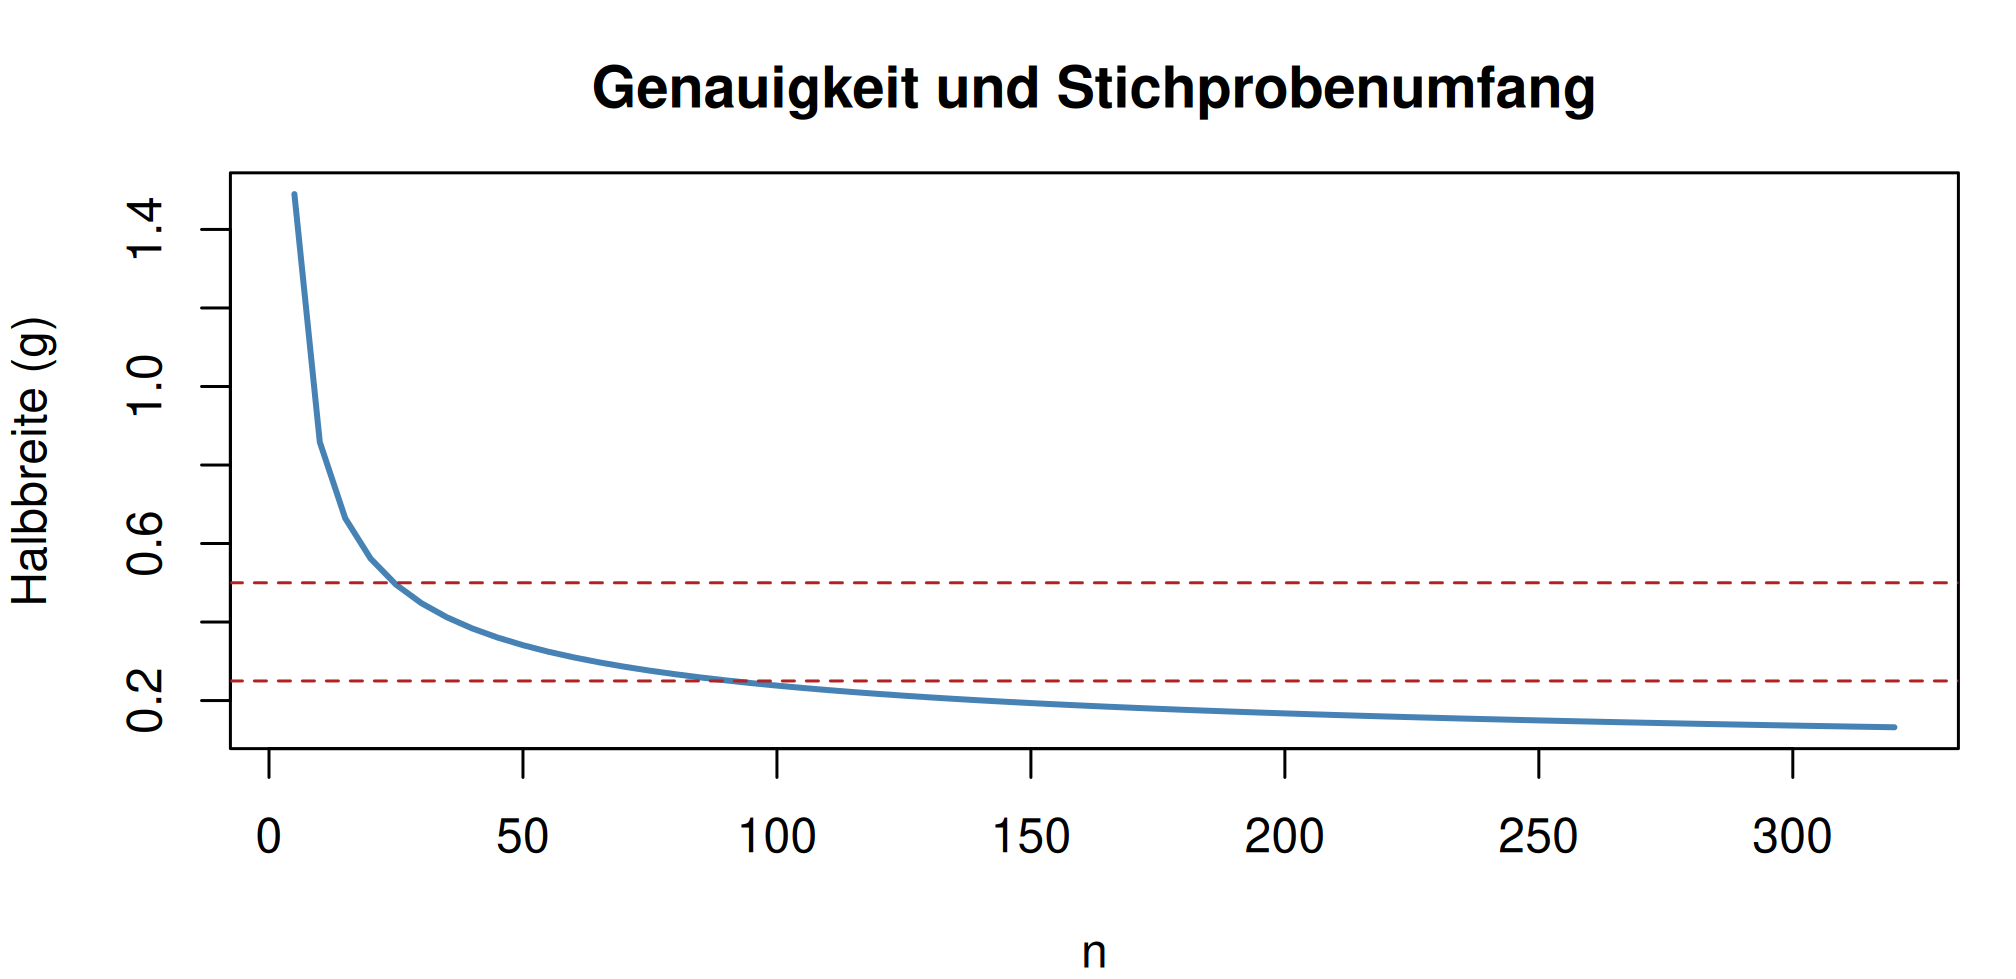
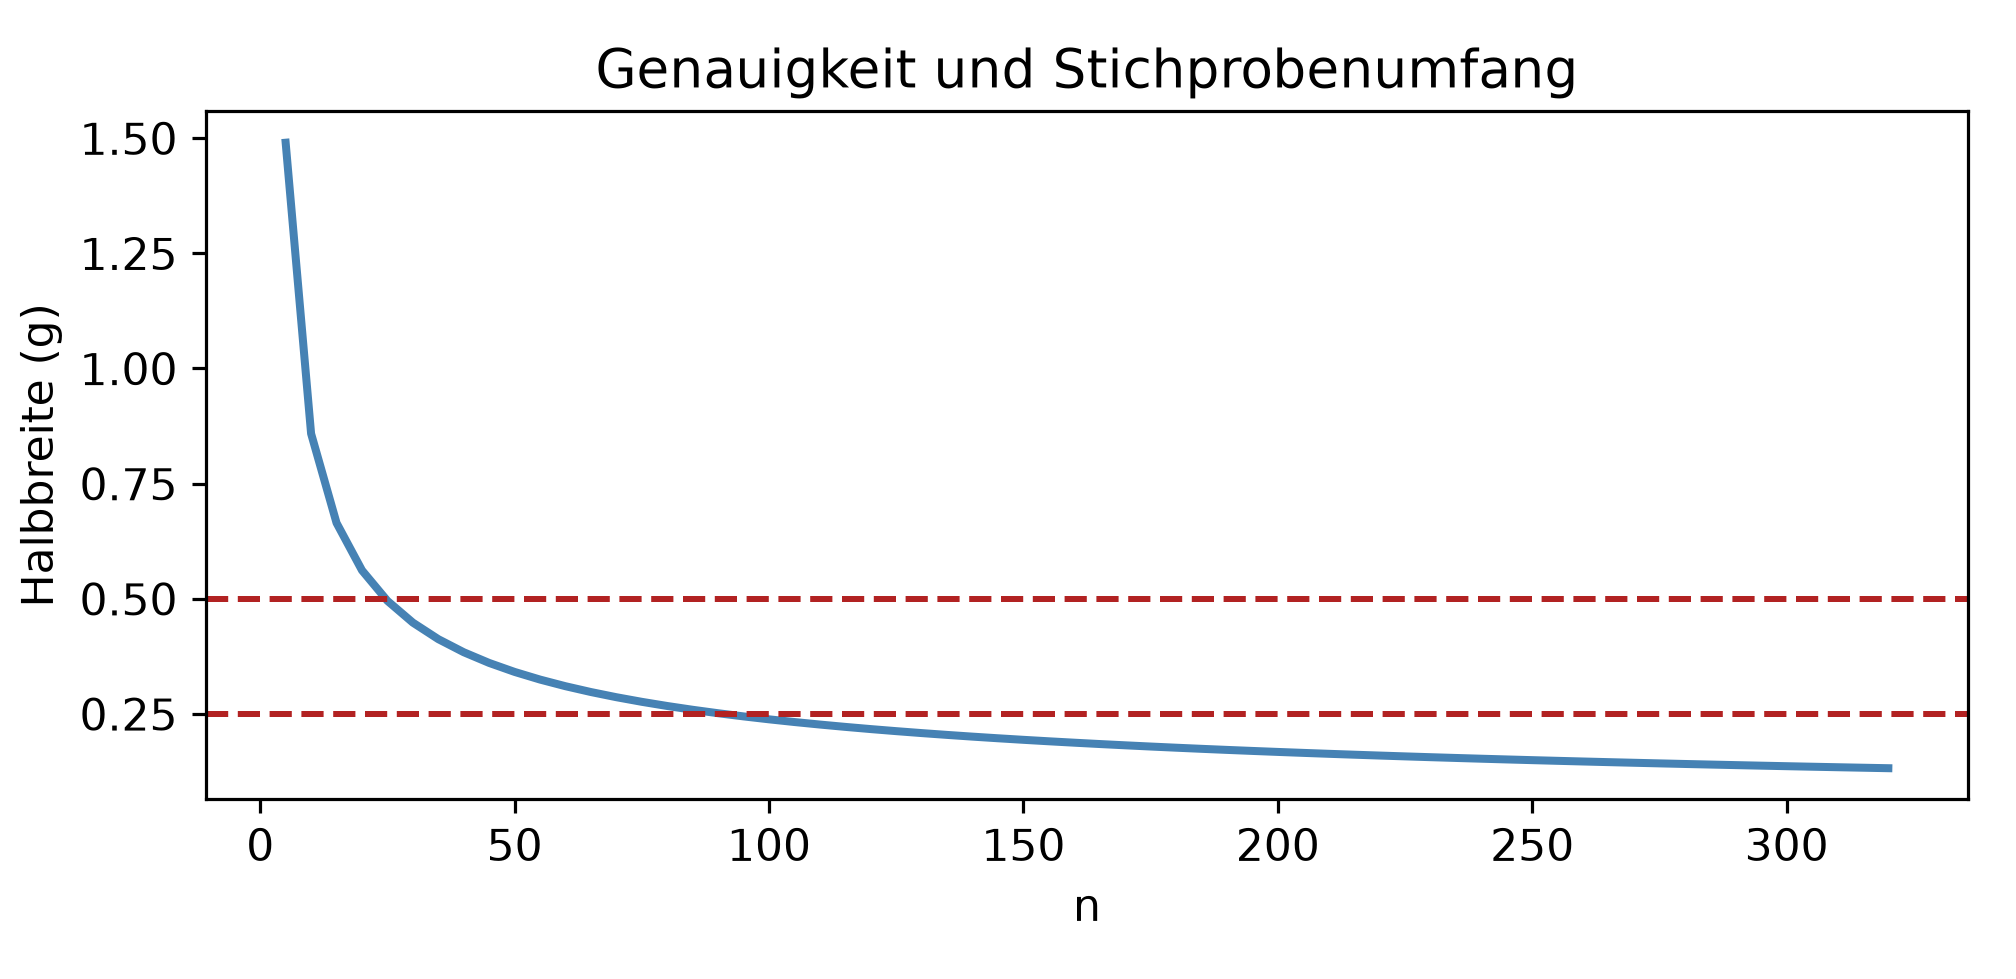
Das Intervall aus Beispiel 1 ist rund ein Gramm breit. Was kostet es, es auf ein halbes Gramm zu bringen?
sigma <-1.2umfaenge <-seq(5, 320, by =5)halbbreiten <-qt(0.975, umfaenge -1) * sigma /sqrt(umfaenge)par(mar =c(4, 4, 3, 1))plot(umfaenge, halbbreiten, type ="l", lwd =2, col ="steelblue",xlab ="n", ylab ="Halbbreite (g)",main ="Genauigkeit und Stichprobenumfang")abline(h =c(0.5, 0.25), lty =2, col ="firebrick")for (nn inc(10, 20, 40, 80, 160, 320)) {cat(sprintf("n = %3d: Halbbreite = %.4f g\n", nn, qt(0.975, nn -1) * sigma /sqrt(nn)))}
n =  10: Halbbreite = 0.8584 g
n =  20: Halbbreite = 0.5616 g
n =  40: Halbbreite = 0.3838 g
n =  80: Halbbreite = 0.2670 g
n = 160: Halbbreite = 0.1874 g
n = 320: Halbbreite = 0.1320 g
Abbildung 5: Beispiel 4: Halbbreite des Intervalls in Abhängigkeit vom Umfang.
Abbildung 6: Beispiel 4: dieselbe Kurve in Python.
for nn in (10, 20, 40, 80, 160, 320): h = stats.t.ppf(0.975, nn -1) * sigma / np.sqrt(nn)print(f"n = {nn:3d}: Halbbreite = {h:.4f} g")
n =  10: Halbbreite = 0.8584 g
n =  20: Halbbreite = 0.5616 g
n =  40: Halbbreite = 0.3838 g
n =  80: Halbbreite = 0.2670 g
n = 160: Halbbreite = 0.1874 g
n = 320: Halbbreite = 0.1320 g
Output Zeile für Zeile
n
Halbbreite
Verhältnis zum vorigen
10
0.858 g
20
0.562 g
0.65
40
0.384 g
0.68
80
0.267 g
0.70
160
0.187 g
0.70
320
0.132 g
0.71
Das Verhältnis nähert sich \(1/\sqrt{2} = 0.707\): Eine Verdoppelung des Umfangs verkleinert das Intervall um rund 29 Prozent, eine Halbierung der Breite verlangt viermal so viele Beobachtungen.
Von 20 auf 80 Packungen, also das Vierfache, halbiert die Halbbreite von 0.56 auf 0.27 Gramm. Die Kurve fällt anfangs steil und wird dann flach; jenseits von etwa hundert Beobachtungen bringt jede weitere spürbar weniger.
Das ist die Kehrseite derselben Wurzel, die auf der Seite zur Power den Stichprobenumfang treibt. Beide Male steht \(\sqrt{n}\) im Nenner, und beide Male folgt daraus dasselbe: Genauigkeit ist teuer, und der Preis steigt quadratisch.
Wer ein Intervall bestimmter Breite braucht, kann den Umfang direkt planen. Für eine Halbbreite \(h\) gilt näherungsweise \(n \approx (1.96 \cdot \sigma / h)^2\); für \(\sigma\) = 1.2 und \(h\) = 0.25 ergibt das rund 89 Beobachtungen.
Interpretation und Ergebnissatz
Die Planung über die Intervallbreite ist der Powerrechnung oft vorzuziehen, weil sie eine inhaltlich fassbare Grösse verwendet: “Wir wollen das mittlere Füllgewicht auf ein Viertelgramm genau kennen” ist eine Vorgabe, über die sich mit Fachleuten sprechen lässt. “Wir wollen einen Effekt von d = 0.5 mit 80 Prozent Wahrscheinlichkeit finden” ist es weniger.
Bei einer angenommenen Streuung von 1.2 g und einer angestrebten Halbbreite von 0.25 g werden rund 89 Packungen benötigt. Mit den vorliegenden 20 Packungen beträgt die Halbbreite 0.53 g.
Verständnisfragen
Warum wird ein Konfidenzintervall breiter, wenn man von 95 auf 99 Prozent Niveau geht?
Weil Sicherheit mit Unschärfe bezahlt wird
Richtig. Ein höheres Niveau verlangt, dass das Verfahren häufiger richtig liegt. Das geht nur, indem mehr Werte zugelassen werden. Bei hundert Prozent wäre das Intervall unendlich breit und wertlos.
Weil die Stichprobe kleiner wird
Der Umfang bleibt unverändert, nur der Faktor vor dem Standardfehler wächst.
Weil die Streuung der Daten zunimmt
Die Daten sind dieselben.
Eine Umfrage berichtet 52 Prozent Zustimmung mit einem Intervall von 49 bis 55 Prozent. Was folgt für die Frage, ob die Mehrheit zustimmt?
Die Mehrheit stimmt zu, der Punktwert liegt über 50
Der Punktwert allein trägt diese Aussage nicht, und genau dafür steht das Intervall daneben.
Die Frage bleibt offen
Richtig. Das Intervall enthält Werte unter fünfzig Prozent, also ist auch eine Minderheit mit den Daten vereinbar.
Die Mehrheit stimmt nicht zu
Ebenso wenig belegt. Beide Möglichkeiten liegen im Intervall.
In ?@fig-ueberdeckung-r sind hundert Konfidenzintervalle gezeichnet, einige verfehlen den wahren Wert. Was zeigt das Bild?
Dass das Verfahren fehlerhaft ist
Die Fehlschläge sind eingebaut und ihre Häufigkeit ist genau das gewählte Niveau.
Dass die Aussage dem Verfahren gilt und nicht dem einzelnen Intervall
Richtig. Rund fünf von hundert verfehlen den wahren Wert. Welches betroffen ist, weiss man in der Praxis nie, weil der wahre Wert unbekannt ist.
Dass die Stichproben zu klein waren
Bei grösseren Stichproben wären die Intervalle schmaler, aber immer noch würden rund fünf Prozent danebenliegen.
Eine Auswertung berichtet den Mittelwert mit der Standardabweichung, eine zweite denselben Mittelwert mit dem Standardfehler. Welche Zahl ist grösser?
Die Standardabweichung, und zwar um den Faktor Wurzel n
Richtig. Der Standardfehler ist die Standardabweichung geteilt durch die Wurzel des Stichprobenumfangs. Bei n = 100 ist er ein Zehntel davon.
Der Standardfehler, weil er die Unsicherheit enthält
Er beschreibt eine andere Streuung, nämlich die des Mittelwerts, und ist deshalb kleiner.
Beide sind gleich gross
Nur bei n = 1, und dann ist keine der beiden Zahlen sinnvoll.