Dashboards und Interaktivität

Dashboards
Interaktivität
Visualisierung
Deployment
R
Python
Was Interaktion bringt, was sie kostet, und wie man Dashboards ordnet.

Kernideen

  • Drei Auslieferungsformen: statisch, interaktiv, dialogisch. Interaktion verschiebt Arbeit zum Publikum und ist deshalb rechtfertigungspflichtig.
  • Ein Dashboard ohne Entscheidungsfrage wird zur Kennzahlentapete.
  • Der Takt bestimmt die Schwelle. Dieselbe Grenze löst bei täglicher Betrachtung Dauerfeuer aus und bei monatlicher nie.
  • Eine Kennzahl ohne festgeschriebene Definition ist keine Kennzahl. Dieselben Rohdaten ergeben je nach Rechenweg deutlich verschiedene Werte.
  • Die wichtigste Zahl gehört oben links, alles Weitere darunter und alles auf eine Bildschirmhöhe.
  • Wer ein Dashboard baut, übernimmt Pflege, nicht nur Erstellung.

Erklärung

Vorwissen: Zielbild und Publikum für die Entscheidungsfrage und Diagrammtyp wählen für die einzelnen Kacheln. Die technische Seite steht unter seaborn und plotly sowie Reproduzierbarkeit.

Drei Formen der Auslieferung

Form Was das Publikum tut Wann passend Kosten
Statisch liest Die Aussage steht fest und gilt für alle gering, Pflege nur bei neuen Daten
Interaktiv filtert, zoomt, wählt aus Verschiedene Leute haben verschiedene Fragen an dieselben Daten Aufbau und laufender Betrieb
Dialogisch fragt in eigenen Worten Fragen sind nicht vorhersehbar hoch, dazu Prüfbarkeit der Antworten

Der häufigste Fehlgriff ist die interaktive Form für eine feststehende Aussage. Wer weiss, was gezeigt werden soll, zeigt es; ein Filtermenü davor ist keine Freiheit, sondern eine Hausaufgabe für das Publikum. Wie viele Ansichten ein Filterset erzeugt, rechnet seaborn und plotly, Beispiel 5 vor.

Was ein Dashboard beantwortet

Ein Dashboard ist kein Ort, an dem alle verfügbaren Kennzahlen gezeigt werden, sondern die laufende Antwort auf eine wiederkehrende Entscheidungsfrage. Vor dem Bauen gehören drei Dinge festgelegt:

  1. Die Frage. “Läuft die Produktion im Rahmen?” ist eine Frage. “Produktionskennzahlen” ist keine.
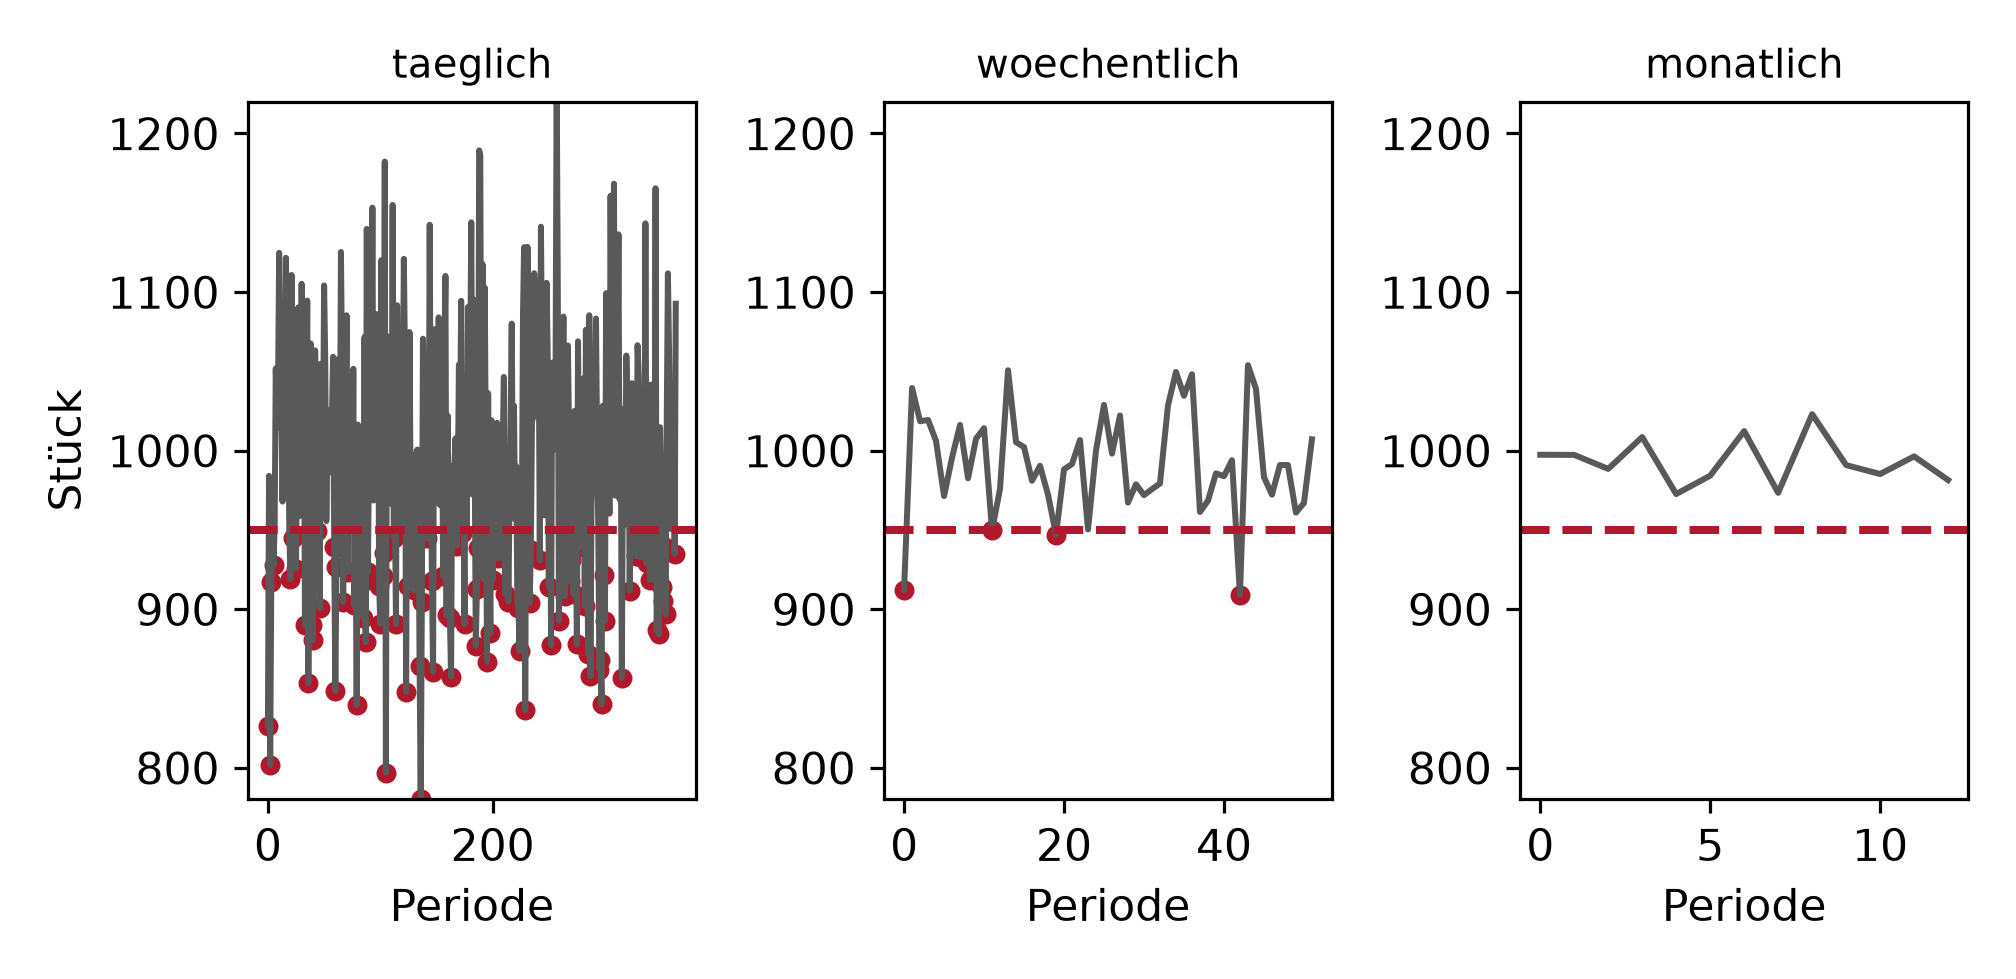
  2. Der Takt. Wird täglich, wöchentlich oder monatlich geschaut? Das bestimmt die Aggregation und was als Abweichung gilt, Beispiel 1 zeigt, wie stark.
  3. Die Reaktion. Was passiert, wenn eine Kennzahl ausschlägt? Wenn es darauf keine Antwort gibt, gehört die Kennzahl nicht auf das Dashboard.

Aufbau

Der Blick beginnt oben links und wandert nach rechts und unten. Daraus folgt eine schlichte Ordnung:

  • Oben links: die eine Kennzahl, um die es geht, gross, mit Vergleichswert (Vorperiode, Ziel, Schwelle).
  • Obere Reihe: zwei bis drei begleitende Kennzahlen im selben Format.
  • Mitte: der Verlauf, der zeigt, wie es dazu kam.
  • Unten: die Aufschlüsselung nach Gruppe, Region oder Produkt.
  • Rand: Filter, Stand der Daten, Quelle.

Weitere Regeln, die sich bewähren:

  • Eine Bildschirmhöhe. Was gescrollt werden muss, wird nicht gesehen.
  • Einheitliche Skalen über vergleichbare Kacheln, sonst täuscht der Vergleich.
  • Kein Ampelrot ohne definierte Schwelle. Farbe ohne Regel ist Meinung.
  • Zahlen mit Einheit und Bezug, nie nackt.

Was danach kommt: Betrieb

Ein Dashboard ist eine Anwendung, keine Abgabe. Damit übernimmt man drei Aufgaben dauerhaft: die Datenzufuhr am Laufen halten, auf Strukturänderungen in der Quelle reagieren, und Kennzahlen entfernen, die niemand mehr anschaut.

Die häufigste Krankheit von Selbstbedienungs-Werkzeugen ist der Wildwuchs: dieselbe Kennzahl in drei Varianten, jede leicht anders gerechnet, und niemand weiss, welche gilt. Beispiel 3 rechnet vor, wie weit die Varianten auseinanderliegen.

Beispiele

Frage und Datenlage

Eine Tagesproduktion, die um 1000 Stück schwankt, ohne Trend, ohne Problem. Eine Schwelle bei 950 Stück soll warnen. Wie oft schlägt sie an, je nachdem ob täglich, wöchentlich oder monatlich geschaut wird?

Rechnung

tage <- 364
produktion <- 1000 + qnorm(lehmer(1919, tage)) * 80
schwelle <- 950

mittelwerte <- function(x, fenster) {
  gruppe <- (seq_along(x) - 1) %/% fenster
  as.vector(tapply(x, gruppe, mean))
}

for (nm in c("taeglich", "woechentlich", "monatlich")) {
  fenster <- c(taeglich = 1, woechentlich = 7, monatlich = 28)[[nm]]
  agg <- mittelwerte(produktion, fenster)
  cat(sprintf("%-14s Perioden %3d  SD der Mittel %6.2f (theoretisch %6.2f)  Alarme %3d (%5.1f Prozent)\n",
              nm, length(agg), sd(agg), 80 / sqrt(fenster),
              sum(agg < schwelle), 100 * mean(agg < schwelle)))
}
taeglich       Perioden 364  SD der Mittel  77.78 (theoretisch  80.00)  Alarme 107 ( 29.4 Prozent)
woechentlich   Perioden  52  SD der Mittel  32.15 (theoretisch  30.24)  Alarme   4 (  7.7 Prozent)
monatlich      Perioden  13  SD der Mittel  14.88 (theoretisch  15.12)  Alarme   0 (  0.0 Prozent)
par(mfrow = c(1, 3), mar = c(4, 4, 3, 1))
for (nm in c("taeglich", "woechentlich", "monatlich")) {
  fenster <- c(taeglich = 1, woechentlich = 7, monatlich = 28)[[nm]]
  agg <- mittelwerte(produktion, fenster)
  plot(agg, type = "l", ylim = c(780, 1220), xlab = "Periode",
       ylab = "Stück", main = nm, col = "grey35")
  abline(h = schwelle, col = akzent, lty = 2, lwd = 2)
  points(which(agg < schwelle), agg[agg < schwelle], col = akzent, pch = 16)
}
par(mfrow = c(1, 1))
Abbildung 1: Beispiel 1: dieselbe Reihe, drei Betrachtungstakte, eine Schwelle.
tage = 364
produktion = 1000 + stats.norm.ppf(lehmer(1919, tage)) * 80
schwelle = 950
reihe = pd.Series(produktion)

takte = {"taeglich": 1, "woechentlich": 7, "monatlich": 28}
for nm, fenster in takte.items():
    agg = reihe.groupby(np.arange(tage) // fenster).mean()
    print(f"{nm:<14} Perioden {len(agg):3d}  SD der Mittel {agg.std(ddof=1):6.2f}"
          f" (theoretisch {80 / np.sqrt(fenster):6.2f})"
          f"  Alarme {(agg < schwelle).sum():3d}"
          f" ({100 * (agg < schwelle).mean():5.1f} Prozent)")
taeglich       Perioden 364  SD der Mittel  77.78 (theoretisch  80.00)  Alarme 107 ( 29.4 Prozent)
woechentlich   Perioden  52  SD der Mittel  32.15 (theoretisch  30.24)  Alarme   4 (  7.7 Prozent)
monatlich      Perioden  13  SD der Mittel  14.88 (theoretisch  15.12)  Alarme   0 (  0.0 Prozent)
fig, achsen = plt.subplots(1, 3, figsize=(7, 3.4))
for achse, (nm, fenster) in zip(achsen, takte.items()):
    agg = reihe.groupby(np.arange(tage) // fenster).mean()
    _ = achse.plot(agg.to_numpy(), color="0.35")
    _ = achse.axhline(schwelle, ls="--", lw=2, color=AKZENT)
    alarm = agg[agg < schwelle]
    _ = achse.scatter(alarm.index, alarm.to_numpy(), s=16, color=AKZENT)
    _ = achse.set_ylim(780, 1220)
    _ = achse.set_title(nm, fontsize=10)
    _ = achse.set_xlabel("Periode")
_ = achsen[0].set_ylabel("Stück")
plt.tight_layout()
plt.show()
Abbildung 2: Beispiel 1: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

Takt Perioden SD der Mittelwerte theoretisch \(80/\sqrt{k}\) Alarme bei 950
täglich 364 77.78 80.00 107 (29.4 %)
wöchentlich 52 32.15 30.24 4 (7.7 %)
monatlich 13 14.88 15.12 0 (0.0 %)
Beobachtung Erklärung
Dieselbe Schwelle löst 29.4 Prozent oder 0 Prozent Alarme aus Je nachdem, wie aggregiert wird. Die Daten sind identisch und völlig unauffällig, es gibt keinen Trend und keinen Ausreisser.
Der Grund steht in der dritten Spalte Die Streuung eines Mittelwerts sinkt mit \(1/\sqrt{k}\): 80, dann 30.2, dann 15.1. Eine Schwelle, die 0.6 Tagesstreuungen entfernt liegt, ist 1.6 Wochenstreuungen und 3.3 Monatsstreuungen entfernt.
Bei täglicher Betrachtung ist die Schwelle Dauerfeuer Mehr als jeder vierte Tag. Nach zwei Wochen schaut niemand mehr hin, der bekannteste Weg, eine Warnung wertlos zu machen.
Bei monatlicher Betrachtung warnt sie nie Auch dann nicht, wenn etwas schiefginge. Beides ist derselbe Fehler: eine Schwelle ohne Bezug zum Takt.
Die Simulation bestätigt die Theorie 77.78 gegen 80.00, 32.15 gegen 30.24, 14.88 gegen 15.12.

Die Regel: Die Schwelle gehört zum Takt, nicht zur Kennzahl.

Takt Streuung der Periodenmittel sinnvolle Schwelle (2 Sigma)
täglich 80.0 840
wöchentlich 30.2 929
monatlich 15.1 970

Wer eine Zahl wie “unter 950 wird rot” festlegt, ohne den Takt dazuzusagen, hat nichts festgelegt. Der saubere Weg sind Kontrollgrenzen, die aus der beobachteten Streuung der jeweiligen Aggregationsebene stammen, der statistische Hintergrund steht unter Schätzen und Konfidenzintervalle.

Interpretation und Ergebnissatz

Eine Schwelle bei 950 Stück löst bei täglicher Betrachtung in 29.4 Prozent der Perioden Alarm aus, bei wöchentlicher in 7.7 Prozent und bei monatlicher nie, bei identischen, unauffälligen Daten. Die Streuung der Periodenmittel sinkt von 80 über 30.2 auf 15.1.

Frage und Datenlage

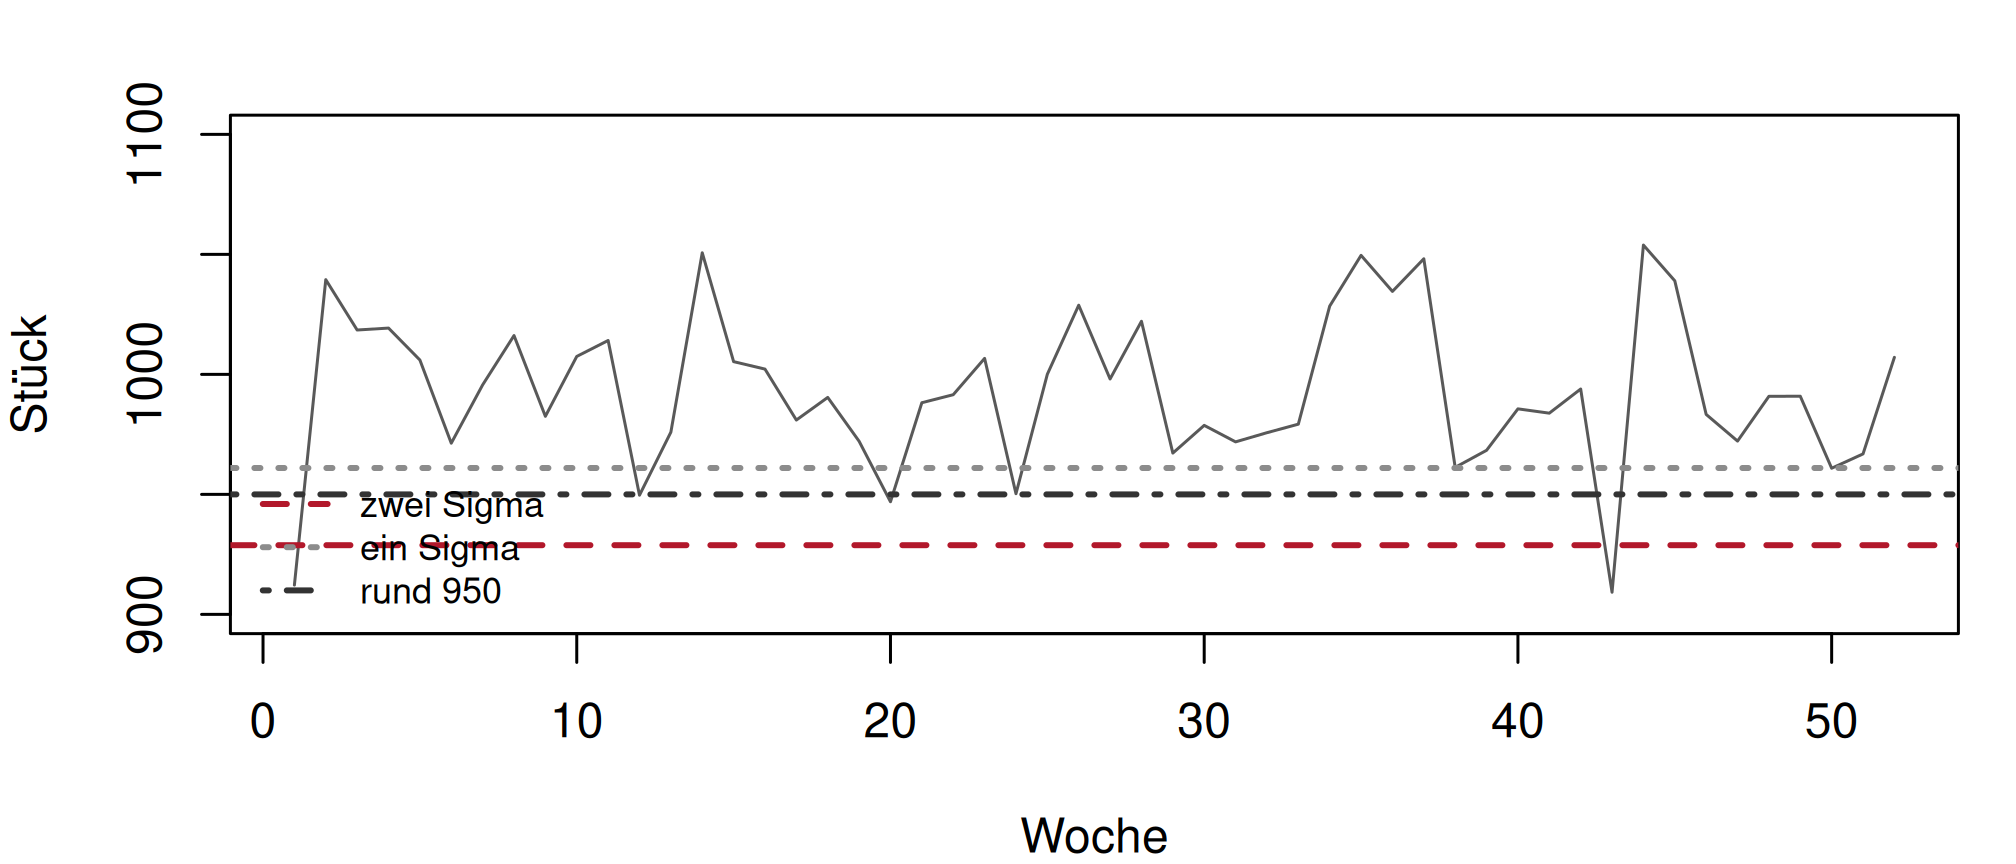
Dieselbe Reihe, drei Arten, die Ampelgrenze zu setzen: aus dem Bauch, aus einem runden Zielwert und aus der beobachteten Streuung.

Rechnung

wochen <- mittelwerte(produktion, 7)
grenzen <- c(
  "rund (950)" = 950,
  "Ziel minus 5 Prozent (950)" = 950,
  "zwei Sigma" = mean(wochen) - 2 * sd(wochen),
  "ein Sigma" = mean(wochen) - 1 * sd(wochen))
round(grenzen, 2)
                rund (950) Ziel minus 5 Prozent (950) 
                    950.00                     950.00 
                zwei Sigma                  ein Sigma 
                    928.84                     961.00 
for (nm in names(grenzen)) {
  anteil <- mean(wochen < grenzen[[nm]]) * 100
  cat(sprintf("%-28s Grenze %7.2f  Alarme %2d von %d (%5.1f Prozent)\n",
              nm, grenzen[[nm]], sum(wochen < grenzen[[nm]]),
              length(wochen), anteil))
}
rund (950)                   Grenze  950.00  Alarme  4 von 52 (  7.7 Prozent)
Ziel minus 5 Prozent (950)   Grenze  950.00  Alarme  4 von 52 (  7.7 Prozent)
zwei Sigma                   Grenze  928.84  Alarme  2 von 52 (  3.8 Prozent)
ein Sigma                    Grenze  961.00  Alarme  6 von 52 ( 11.5 Prozent)
round(c(mittel = mean(wochen), sd = sd(wochen),
        minimum = min(wochen), maximum = max(wochen)), 2)
 mittel      sd minimum maximum 
 993.15   32.15  909.24 1053.89 
par(mar = c(4, 4, 2, 1))
plot(wochen, type = "l", col = "grey35", xlab = "Woche", ylab = "Stück",
     ylim = c(900, 1100))
abline(h = grenzen[["zwei Sigma"]], col = akzent, lty = 2, lwd = 2)
abline(h = grenzen[["ein Sigma"]], col = "grey55", lty = 3, lwd = 2)
abline(h = 950, col = "grey20", lty = 4, lwd = 2)
legend("bottomleft", c("zwei Sigma", "ein Sigma", "rund 950"),
       col = c(akzent, "grey55", "grey20"), lty = c(2, 3, 4), lwd = 2,
       bty = "n", cex = 0.75)
Abbildung 3: Beispiel 2: drei Schwellen auf derselben Wochenreihe.
wochen = reihe.groupby(np.arange(tage) // 7).mean()
grenzen = {"rund (950)": 950.0,
           "Ziel minus 5 Prozent (950)": 950.0,
           "zwei Sigma": wochen.mean() - 2 * wochen.std(ddof=1),
           "ein Sigma": wochen.mean() - 1 * wochen.std(ddof=1)}
print({k: round(float(v), 2) for k, v in grenzen.items()})

for nm, grenze in grenzen.items():
    treffer = int((wochen < grenze).sum())
    print(f"{nm:<28} Grenze {grenze:7.2f}  Alarme {treffer:2d} von {len(wochen)}"
          f" ({100 * treffer / len(wochen):5.1f} Prozent)")

print({"mittel": round(float(wochen.mean()), 2),
       "sd": round(float(wochen.std(ddof=1)), 2),
       "minimum": round(float(wochen.min()), 2),
       "maximum": round(float(wochen.max()), 2)})

fig, achse = plt.subplots(figsize=(7, 3))
_ = achse.plot(wochen.to_numpy(), color="0.35")
_ = achse.axhline(grenzen["zwei Sigma"], ls="--", lw=2, color=AKZENT,
                  label="zwei Sigma")
_ = achse.axhline(grenzen["ein Sigma"], ls=":", lw=2, color="0.55",
                  label="ein Sigma")
_ = achse.axhline(950, ls="-.", lw=2, color="0.2", label="rund 950")
_ = achse.set_ylim(900, 1100)
_ = achse.legend(fontsize=7, frameon=False, loc="lower left")
_ = achse.set_xlabel("Woche")
_ = achse.set_ylabel("Stück")
plt.tight_layout()
plt.show()
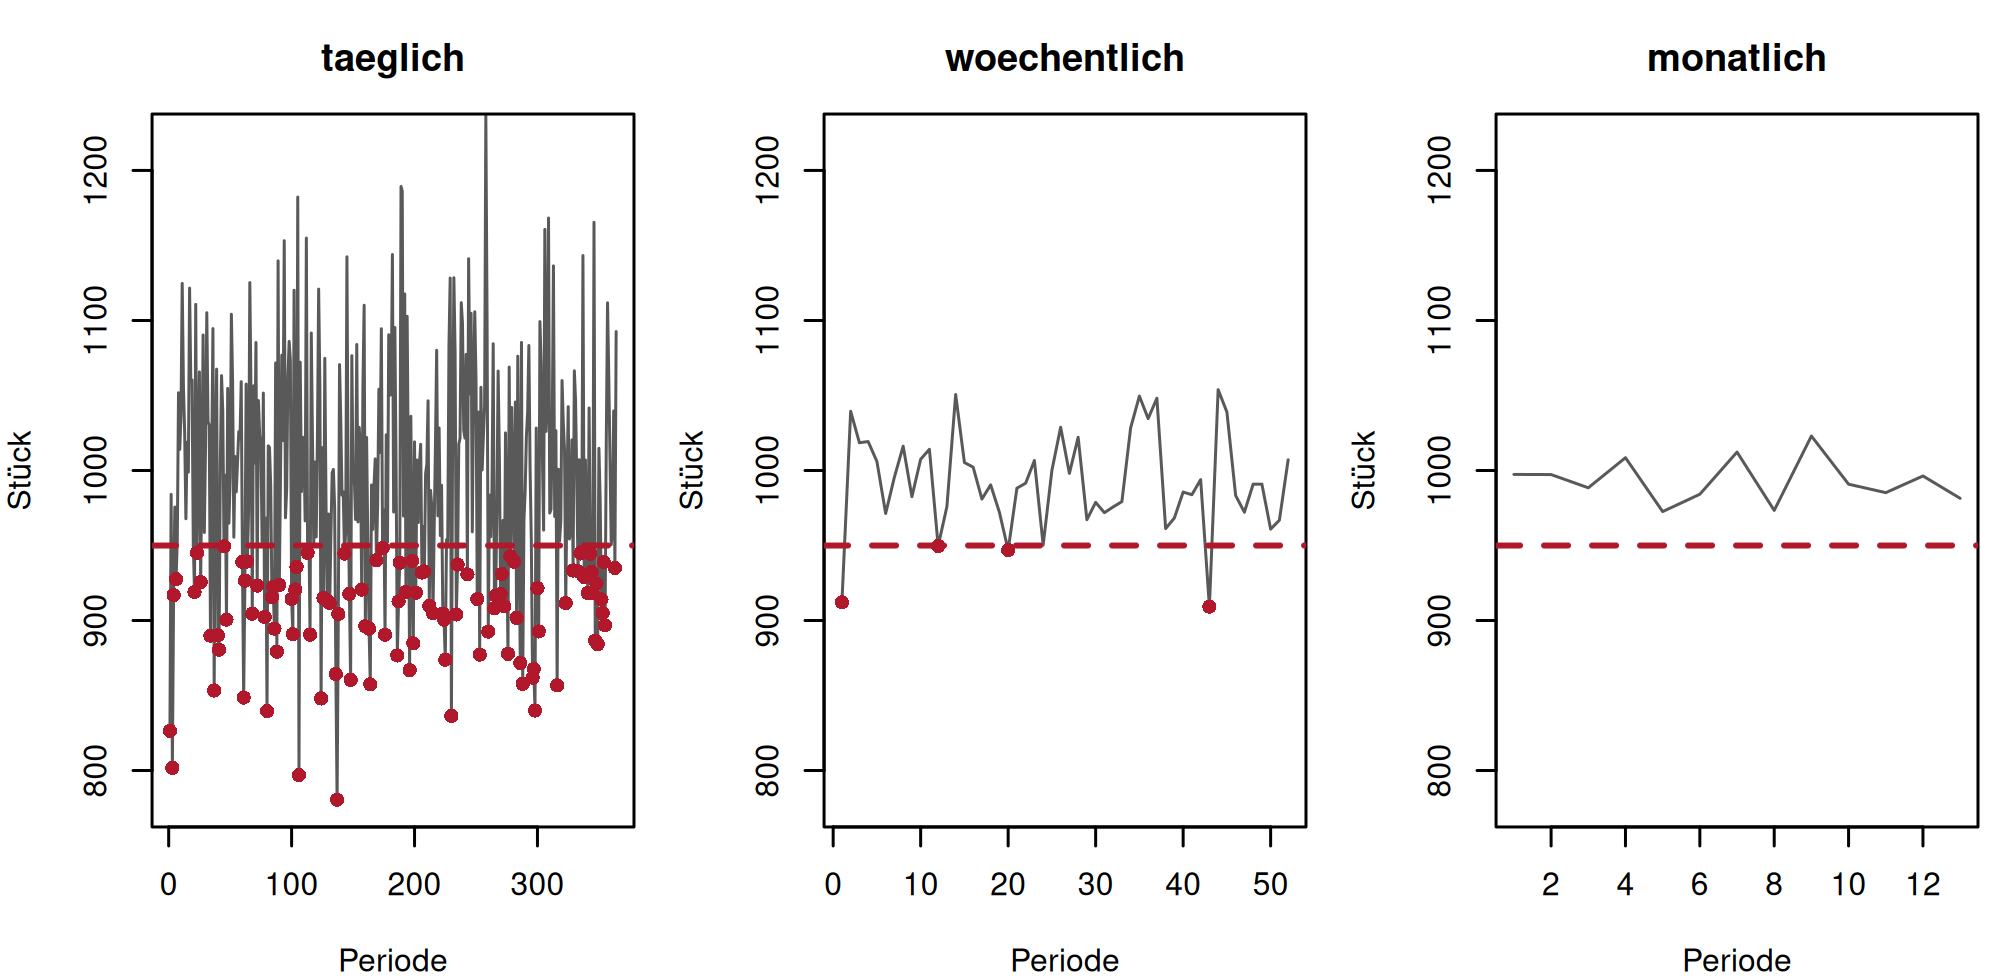
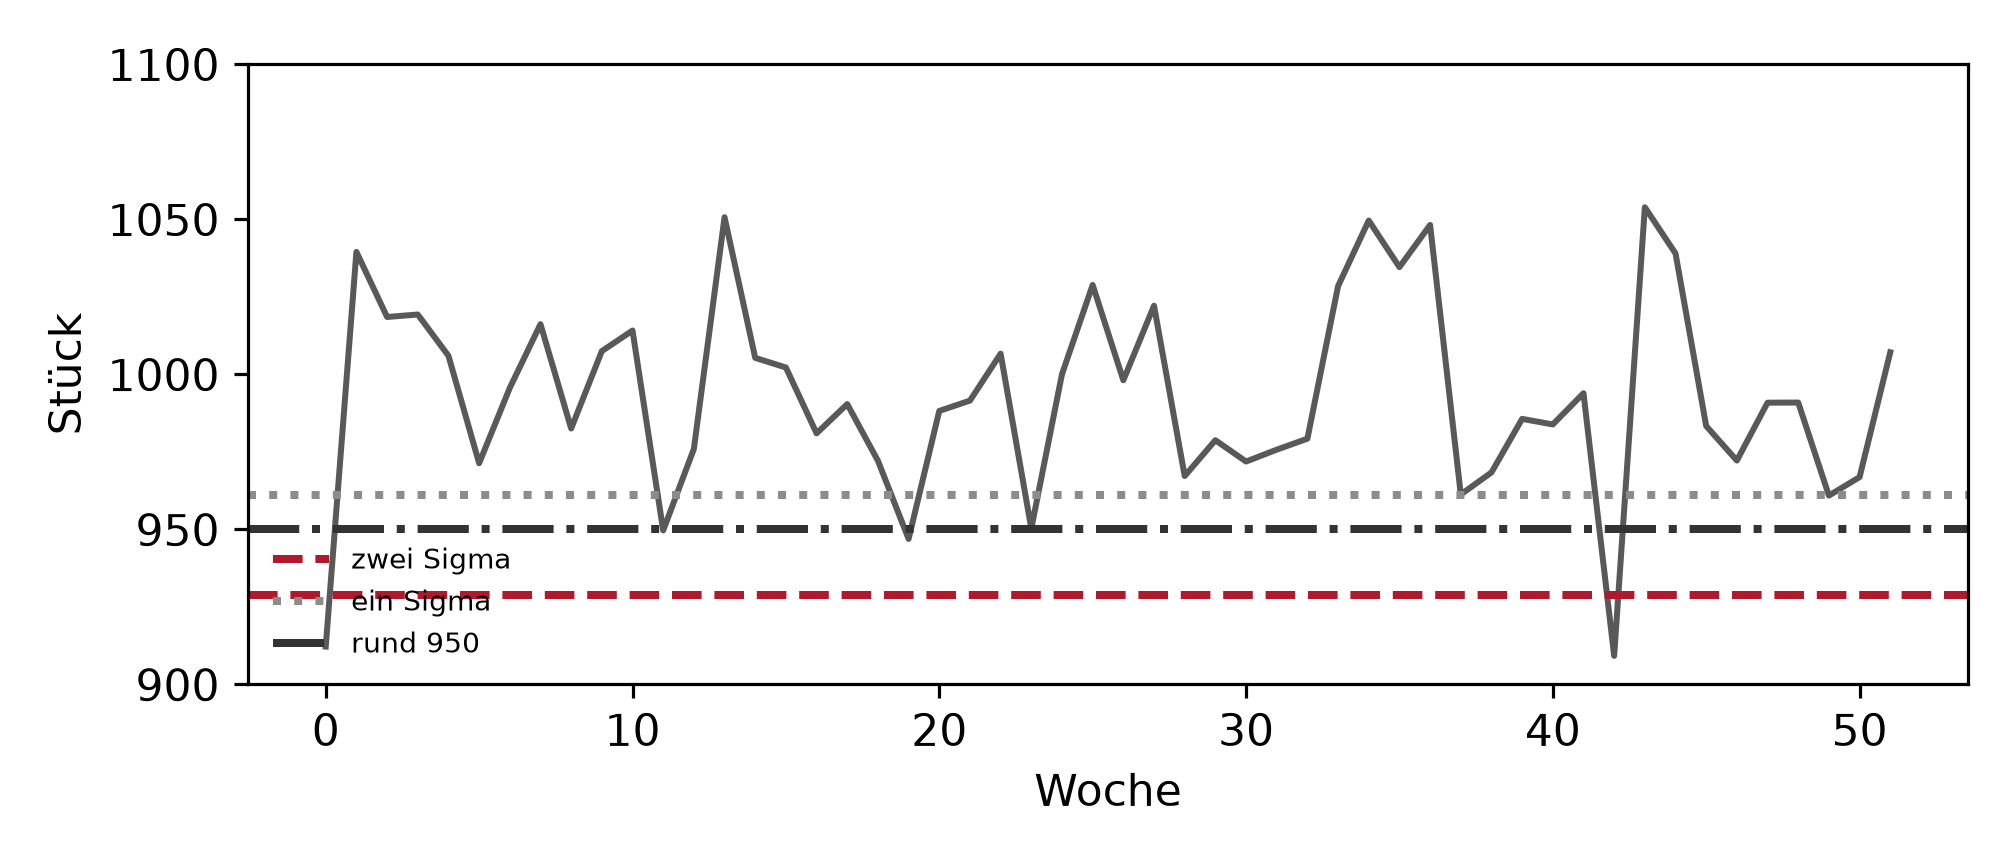
Abbildung 4: Beispiel 2: dieselben drei Schwellen in Python.

Output Zeile für Zeile

Wochenreihe: Mittel 993.15, SD 32.15, Minimum 909.24, Maximum 1053.89.

Grenze Wert Alarme von 52
“rund 950” 950.00 4 (7.7 %)
“Ziel minus 5 Prozent” 950.00 4 (7.7 %)
zwei Sigma 928.84 2 (3.8 %)
ein Sigma 961.00 6 (11.5 %)
Beobachtung Erklärung
Die beiden “runden” Grenzen sind dieselbe Zahl 950, einmal aus dem Bauch und einmal als “fünf Prozent unter dem Ziel von 1000”. Verschiedene Begründungen, dieselbe Willkür und rein zufällig liegt sie zwischen ein und zwei Sigma.
Die Zwei-Sigma-Grenze liegt bei 928.84 Hergeleitet aus der beobachteten Streuung von 32.15. Sie schlägt in 3.8 Prozent der Wochen an, also etwa zweimal im Jahr. Das ist eine Rate, bei der man hinschaut.
Die Ein-Sigma-Grenze löst 11.5 Prozent aus Etwa jede neunte Woche. Als Warnung unbrauchbar, als “beobachten” brauchbar, deshalb haben Kontrollkarten zwei Grenzen.
Der Unterschied zwischen 3.8 und 11.5 Prozent entsteht aus einer Zahl Dem Faktor vor der Standardabweichung. Wer keine Regel festlegt, überlässt diese Entscheidung dem Zufall der Wahl.
Keine der Grenzen ist “richtig” Richtig ist die, die zur Reaktion passt: Wie oft kann und will jemand reagieren? Daraus folgt der Faktor, nicht umgekehrt.

Die drei Fragen, bevor eine Ampel eingebaut wird:

  1. Woher kommt die Grenze? Aus der Streuung, aus einer Zielvorgabe oder aus einer Norm, aber aus etwas.
  2. Wie oft soll sie anschlagen? Daraus folgt der Sigma-Faktor. Zwei Sigma heisst rund fünf Prozent, drei Sigma rund ein Promille.
  3. Was passiert dann? Ohne Antwort gehört die Ampel weg.

Rot ohne Regel ist eine Meinung in Ampelfarben und sie wird vom Publikum als Messung gelesen.

Interpretation und Ergebnissatz

Auf derselben Wochenreihe (Mittel 993.15, SD 32.15) lösen die Grenzen 950, 928.84 und 961.00 in 7.7, 3.8 und 11.5 Prozent der Wochen Alarm aus. Der Unterschied entsteht allein aus dem gewählten Faktor vor der Standardabweichung.

Frage und Datenlage

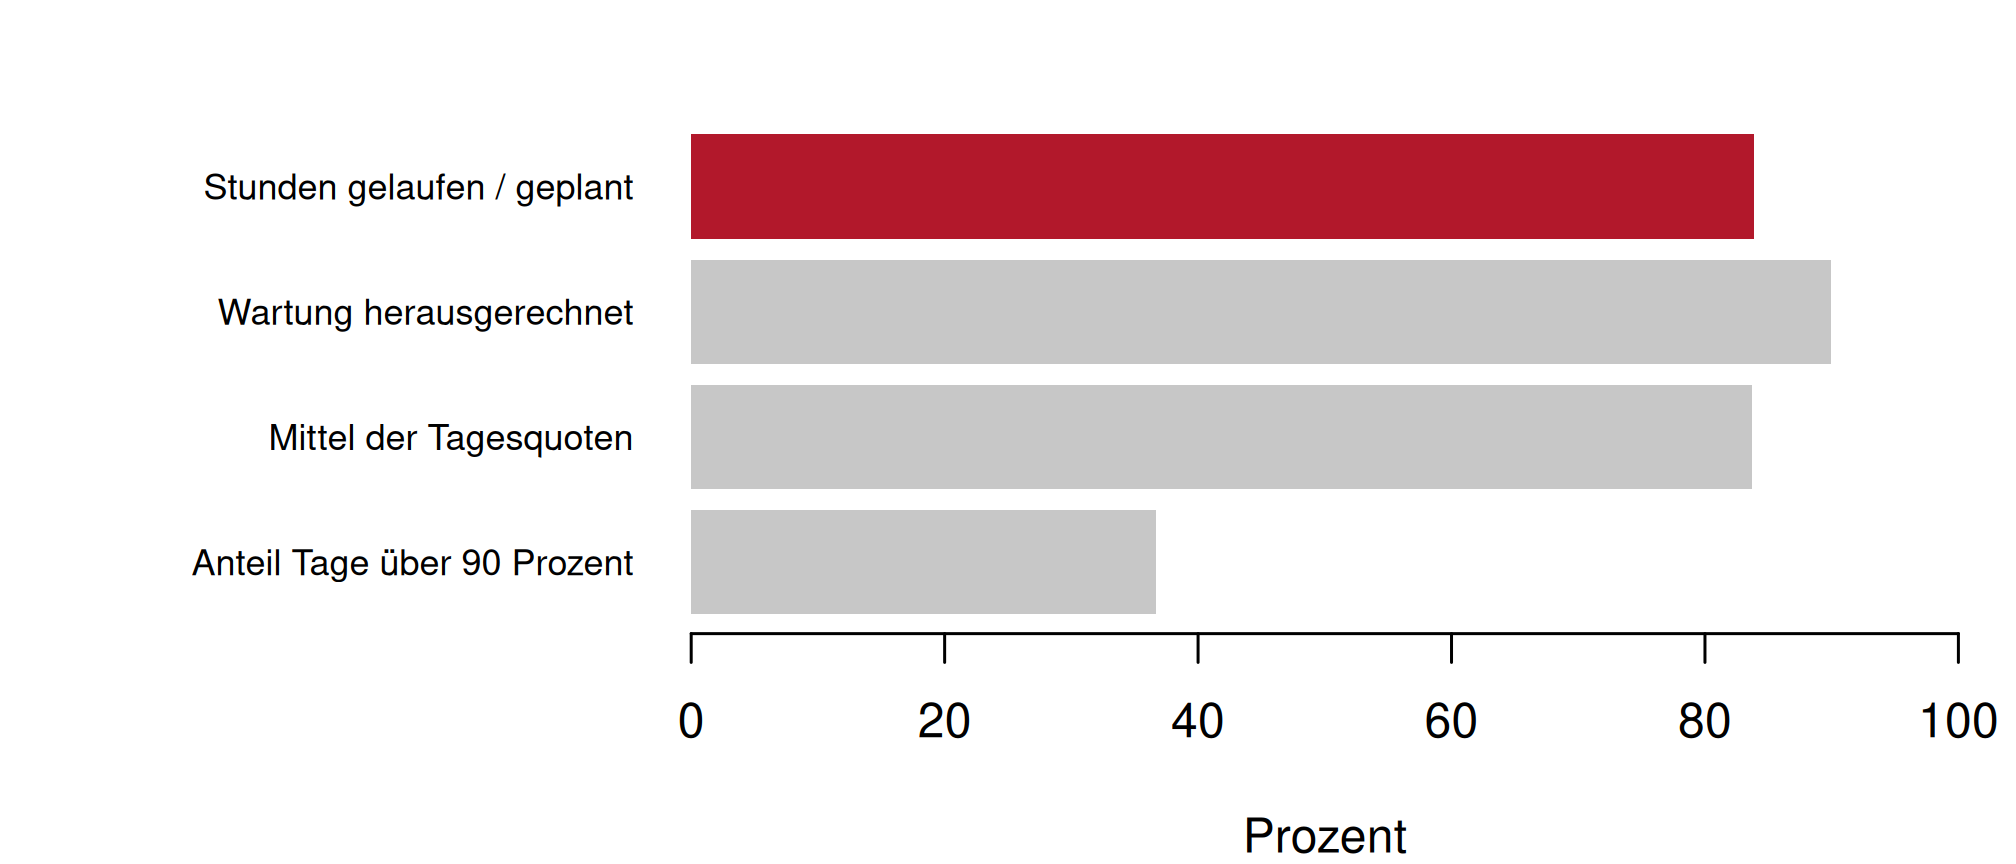
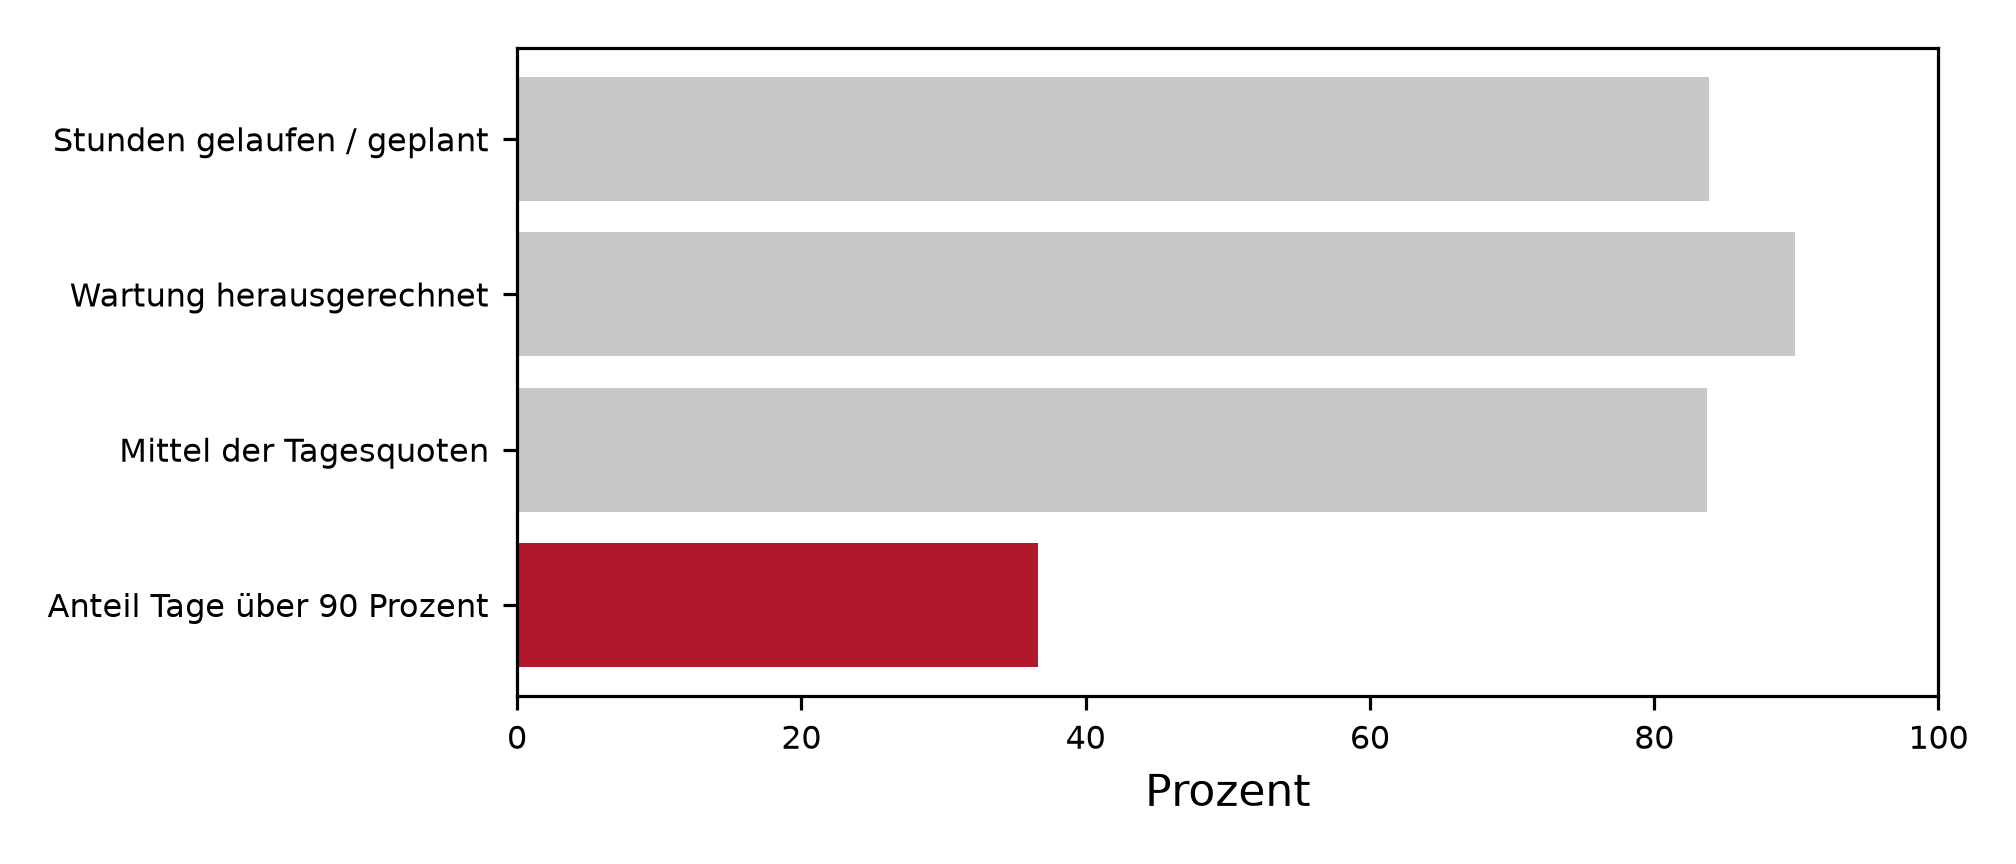
“Verfügbarkeit” über 30 Tage. Aus denselben Rohdaten, geplante Stunden, ungeplanter Stillstand, geplante Wartung, lässt sie sich auf mehrere Arten ausrechnen. Alle heissen gleich.

Rechnung

n <- 30
u <- matrix(lehmer(5252, 3 * n), ncol = 3, byrow = TRUE)
geplant <- round(16 + 4 * u[, 1], 1)
stillstand <- round(u[, 2]^2 * 6, 2)
wartung <- round(u[, 3] * 2, 2)
lief <- geplant - stillstand - wartung
tagesquote <- lief / geplant

round(c(summe_geplant = sum(geplant), summe_stillstand = sum(stillstand),
        summe_wartung = sum(wartung), summe_gelaufen = sum(lief)), 2)
   summe_geplant summe_stillstand    summe_wartung   summe_gelaufen 
          531.70            49.93            36.04           445.73 
varianten <- c(
  "Stunden gelaufen / geplant" = sum(lief) / sum(geplant) * 100,
  "Wartung herausgerechnet" = sum(lief) / (sum(geplant) - sum(wartung)) * 100,
  "Mittel der Tagesquoten" = mean(tagesquote) * 100,
  "Anteil Tage über 90 Prozent" = mean(tagesquote > 0.90) * 100)
round(varianten, 2)
 Stunden gelaufen / geplant     Wartung herausgerechnet 
                      83.83                       89.93 
     Mittel der Tagesquoten Anteil Tage über 90 Prozent 
                      83.69                       36.67 
round(c(spannweite_der_ersten_drei = max(varianten[1:3]) - min(varianten[1:3]),
        schlechtester_tag = min(tagesquote) * 100,
        bester_tag = max(tagesquote) * 100), 2)
spannweite_der_ersten_drei          schlechtester_tag 
                      6.24                      61.11 
                bester_tag 
                     99.53 
par(mar = c(4, 12, 2, 1))
barplot(rev(varianten), horiz = TRUE, las = 1, xlim = c(0, 100),
        col = c(neutral, neutral, neutral, akzent), border = NA,
        xlab = "Prozent", cex.names = 0.75)
Abbildung 5: Beispiel 3: vier Kennzahlen, die alle Verfügbarkeit heissen.
n = 30
u = lehmer(5252, 3 * n).reshape(n, 3)
geplant = np.round(16 + 4 * u[:, 0], 1)
stillstand = np.round(u[:, 1] ** 2 * 6, 2)
wartung = np.round(u[:, 2] * 2, 2)
lief = geplant - stillstand - wartung
tagesquote = lief / geplant

print({"summe_geplant": round(float(geplant.sum()), 2),
       "summe_stillstand": round(float(stillstand.sum()), 2),
       "summe_wartung": round(float(wartung.sum()), 2),
       "summe_gelaufen": round(float(lief.sum()), 2)})

varianten = {
    "Stunden gelaufen / geplant": lief.sum() / geplant.sum() * 100,
    "Wartung herausgerechnet": lief.sum() / (geplant.sum() - wartung.sum()) * 100,
    "Mittel der Tagesquoten": tagesquote.mean() * 100,
    "Anteil Tage über 90 Prozent": (tagesquote > 0.90).mean() * 100}
print({k: round(float(v), 2) for k, v in varianten.items()})

erste_drei = list(varianten.values())[:3]
print({"spannweite_der_ersten_drei": round(float(max(erste_drei) - min(erste_drei)), 2),
       "schlechtester_tag": round(float(tagesquote.min() * 100), 2),
       "bester_tag": round(float(tagesquote.max() * 100), 2)})

fig, achse = plt.subplots(figsize=(7, 3))
namen = list(varianten.keys())
werte = [varianten[k] for k in namen]
farben = [NEUTRAL] * 3 + [AKZENT]
_ = achse.barh(namen[::-1], werte[::-1], color=farben[::-1])
_ = achse.set_xlim(0, 100)
_ = achse.set_xlabel("Prozent")
_ = achse.tick_params(labelsize=8)
plt.tight_layout()
plt.show()
Abbildung 6: Beispiel 3: dieselben vier Kennzahlen in Python.

Output Zeile für Zeile

Rohdaten über 30 Tage Stunden
geplant 531.70
ungeplanter Stillstand 49.93
geplante Wartung 36.04
gelaufen 445.73
Rechenweg “Verfügbarkeit”
Stunden gelaufen / geplant 83.83 %
Wartung herausgerechnet 89.93 %
Mittel der Tagesquoten 83.69 %
Anteil Tage über 90 Prozent 36.67 %

Spannweite der ersten drei: 6.24 Prozentpunkte. Schlechtester Tag 61.11 %, bester 99.53 %.

Beobachtung Erklärung
Die drei stundenbasierten Wege liegen 6.24 Punkte auseinander 83.69 bis 89.93. Alle drei sind vertretbar, alle drei heissen “Verfügbarkeit”.
“Wartung herausgerechnet” ist die freundlichste Zahl 89.93 gegen 83.83. Geplante Wartung als Nichtverfügbarkeit zu zählen oder nicht, ist eine Definitionsfrage und sie entscheidet über sechs Prozentpunkte.
Der Unterschied zwischen 83.83 und 83.69 ist ein Gewichtungseffekt Die Summenquote gewichtet lange Tage stärker, das Mittel der Tagesquoten gewichtet alle Tage gleich. Derselbe Unterschied wie zwischen gewichtetem und ungewichtetem Mittel.
Die vierte Zahl ist etwas ganz anderes 36.67 Prozent ist kein Stundenanteil, sondern ein Tagesanteil. Sie beantwortet die Frage “wie oft lief es gut” statt “wie viel lief es” und sieht trotzdem aus wie dieselbe Kennzahl.
Alle vier auf einem Dashboard nebeneinander Und niemand weiss mehr, welche gilt. Das ist der Wildwuchs, gegen den nur eine festgeschriebene Definition hilft.

Was in die Kennzahlendefinition gehört, damit sie eine ist:

Angabe Beispiel
Zähler tatsächlich gelaufene Stunden
Nenner geplante Stunden einschliesslich Wartung
Aggregation Summe über die Periode, nicht Mittel der Tageswerte
Periode Kalendermonat
Ausschlüsse Feiertage zählen nicht als geplant
Verantwortlich wer die Definition ändern darf

Ohne diese sechs Zeilen ist eine Kennzahl eine Zahl mit einem Namen. Mit ihnen ist sie vergleichbar und nur dann darf sie in eine Zeitreihe.

Interpretation und Ergebnissatz

Aus denselben Rohdaten ergeben drei stundenbasierte Rechenwege Verfügbarkeiten von 83.69, 83.83 und 89.93 Prozent, eine Spannweite von 6.24 Punkten. Ein vierter, ebenso “Verfügbarkeit” genannter Weg zählt Tage statt Stunden und ergibt 36.67 Prozent.

Frage und Datenlage

Wie viele Kacheln passen auf eine Bildschirmhöhe, und was rutscht darunter? Gerechnet für eine typische Auflösung.

Rechnung

bildschirm_hoehe <- 900      # sichtbare Pixel im Browser, 1080 minus Leisten
kopfzeile <- 80
kachel_hoehe <- 220
abstand <- 16

passen <- floor((bildschirm_hoehe - kopfzeile + abstand) / (kachel_hoehe + abstand))
round(c(sichtbare_hoehe = bildschirm_hoehe, kopfzeile = kopfzeile,
        kachelhoehe_mit_abstand = kachel_hoehe + abstand,
        reihen_sichtbar = passen), 0)
        sichtbare_hoehe               kopfzeile kachelhoehe_mit_abstand 
                    900                      80                     236 
        reihen_sichtbar 
                      3 
for (reihen in c(3, 4, 6)) {
  gesamt <- kopfzeile + reihen * (kachel_hoehe + abstand) - abstand
  sichtbar <- min(1, (bildschirm_hoehe - kopfzeile) /
                    (reihen * (kachel_hoehe + abstand) - abstand))
  cat(sprintf("%d Reihen: Gesamthöhe %4d px, sichtbar ohne Scrollen %5.1f Prozent\n",
              reihen, gesamt, 100 * sichtbar))
}
3 Reihen: Gesamthöhe  772 px, sichtbar ohne Scrollen 100.0 Prozent
4 Reihen: Gesamthöhe 1008 px, sichtbar ohne Scrollen  88.4 Prozent
6 Reihen: Gesamthöhe 1480 px, sichtbar ohne Scrollen  58.6 Prozent
bildschirm_hoehe = 900
kopfzeile = 80
kachel_hoehe = 220
abstand = 16

passen = (bildschirm_hoehe - kopfzeile + abstand) // (kachel_hoehe + abstand)
print({"sichtbare_hoehe": bildschirm_hoehe, "kopfzeile": kopfzeile,
       "kachelhoehe_mit_abstand": kachel_hoehe + abstand,
       "reihen_sichtbar": int(passen)})
{'sichtbare_hoehe': 900, 'kopfzeile': 80, 'kachelhoehe_mit_abstand': 236, 'reihen_sichtbar': 3}
for reihen in (3, 4, 6):
    gesamt = kopfzeile + reihen * (kachel_hoehe + abstand) - abstand
    sichtbar = min(1.0, (bildschirm_hoehe - kopfzeile)
                   / (reihen * (kachel_hoehe + abstand) - abstand))
    print(f"{reihen} Reihen: Gesamthöhe {gesamt:4d} px,"
          f" sichtbar ohne Scrollen {100 * sichtbar:5.1f} Prozent")
3 Reihen: Gesamthöhe  772 px, sichtbar ohne Scrollen 100.0 Prozent
4 Reihen: Gesamthöhe 1008 px, sichtbar ohne Scrollen  88.4 Prozent
6 Reihen: Gesamthöhe 1480 px, sichtbar ohne Scrollen  58.6 Prozent

Output Zeile für Zeile

Grösse Wert
sichtbare Höhe im Browser 900 px
Kopfzeile 80 px
Kachel plus Abstand 236 px
Reihen, die sichtbar sind 3
Reihen Gesamthöhe sichtbar ohne Scrollen
3 772 px 100.0 %
4 1008 px 88.0 %
6 1480 px 56.0 %
Beobachtung Erklärung
Auf einen Full-HD-Bildschirm passen drei Kachelreihen Bei 220 Pixel Kachelhöhe. Mehr geht nur mit kleineren Kacheln und die tragen weniger.
Bei sechs Reihen sind 44 Prozent unsichtbar Und das ist genau die Hälfte der Kennzahlen, die jemand für wichtig genug hielt, sie aufzunehmen.
Die vierte Reihe ist die kritische 88 Prozent sichtbar heisst: Die untere Kachel ist angeschnitten. Ein angeschnittenes Element ist schlechter als ein fehlendes, weil es Scrollen suggeriert, ohne zu lohnen.
Die Rechnung ist trivial und wird trotzdem nie gemacht Dashboards entstehen im Entwurfswerkzeug, wo beliebig viel Platz ist. Die Begrenzung ist der Bildschirm des Publikums, nicht der eigene.
Was nicht auf drei Reihen passt, gehört auf eine zweite Seite Mit eigener Frage. Nicht darunter.

Die Aufteilung, die auf drei Reihen passt:

Reihe Inhalt
1 die Leitkennzahl gross, daneben zwei bis drei Begleitzahlen
2 der Verlauf über die Zeit
3 die Aufschlüsselung nach der wichtigsten Gruppierung

Alles Weitere, Detailtabellen, Nebenkennzahlen, Methodik, gehört hinter einen Klick oder auf eine eigene Seite.

Interpretation und Ergebnissatz

Auf 900 sichtbaren Pixeln passen bei 220 Pixel Kachelhöhe drei Reihen. Vier Reihen sind zu 88 Prozent sichtbar, sechs zu 56 Prozent, bei sechs Reihen bleibt also fast die Hälfte der Kacheln ungesehen.

Frage und Datenlage

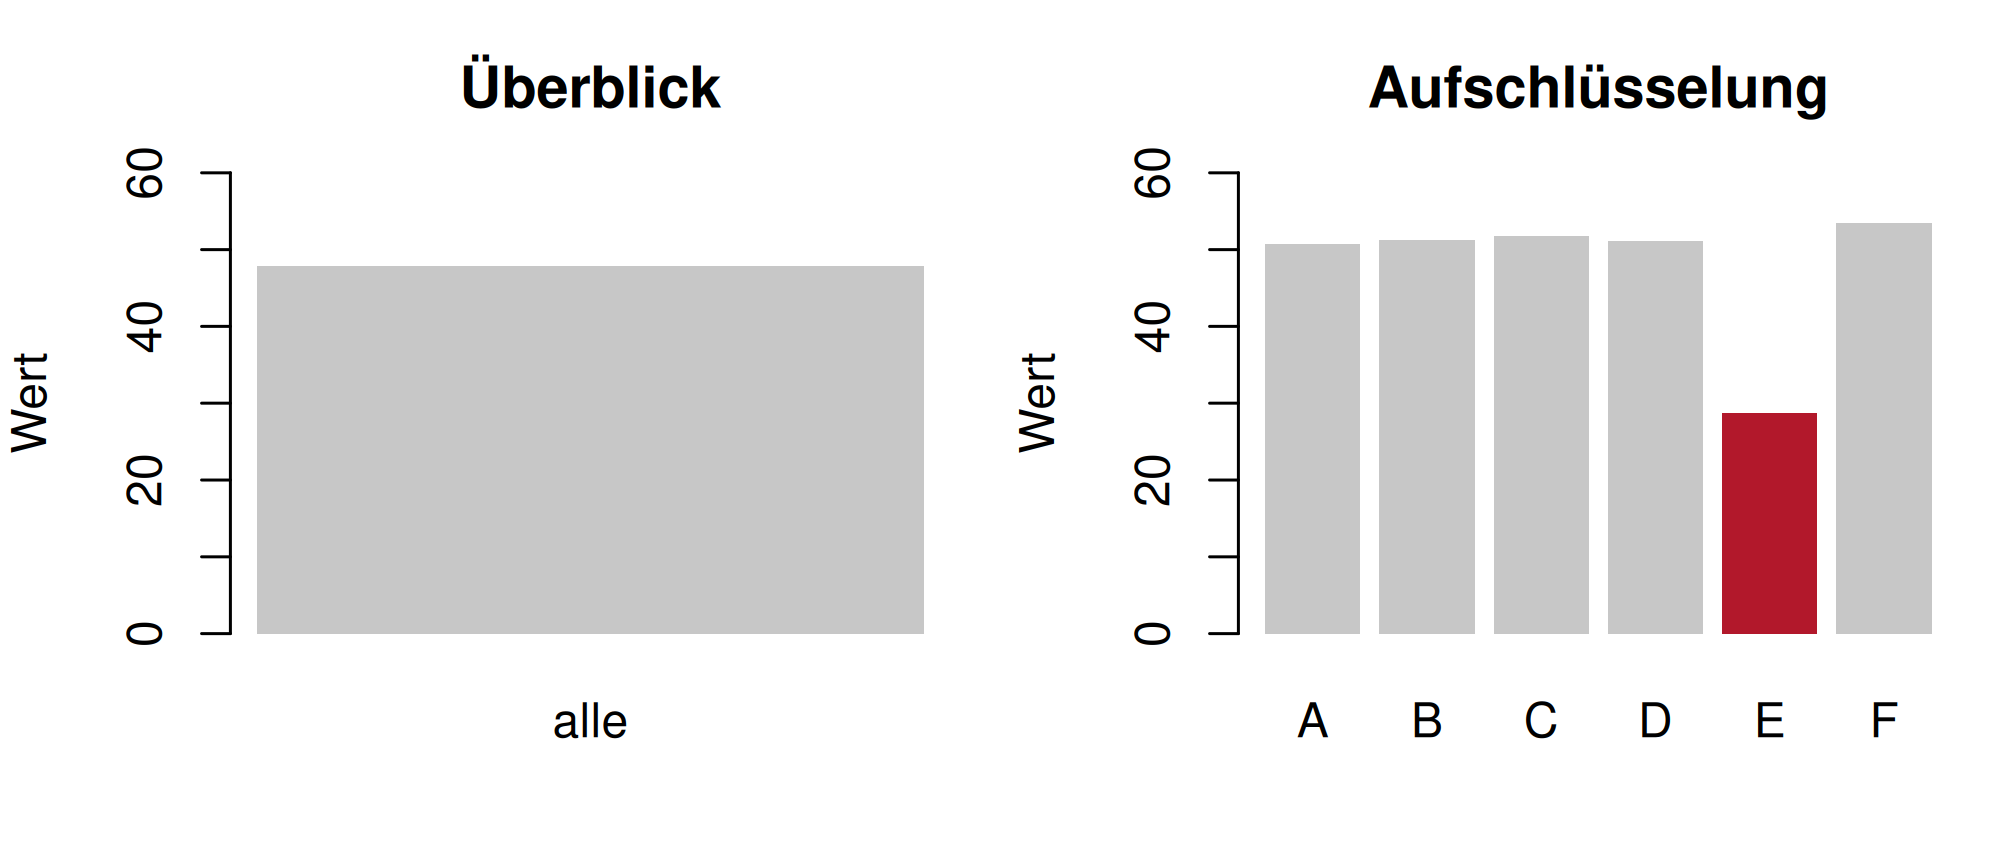
Sechs Standorte, eine Gesamtkennzahl. Die Frage ist, wie viel der Überblick verbirgt und ob die Aufschlüsselung auf das Dashboard gehört.

Rechnung

gruppen <- c("A", "B", "C", "D", "E", "F")
je_gruppe <- 40
basis <- c(50, 52, 49, 51, 30, 53)
z <- qnorm(lehmer(6363, length(gruppen) * je_gruppe))
gruppe <- rep(gruppen, each = je_gruppe)
wert <- rep(basis, each = je_gruppe) + z * 6

gesamt <- mean(wert)
mittel <- tapply(wert, gruppe, mean)
round(c(gesamtmittel = gesamt), 2)
gesamtmittel 
       47.82 
round(mittel, 2)
    A     B     C     D     E     F 
50.79 51.22 51.71 51.11 28.69 53.42 
round(c(ohne_gruppe_E = mean(mittel[names(mittel) != "E"])), 2)
ohne_gruppe_E 
        51.65 
zwischen <- sum(je_gruppe * (mittel - gesamt)^2)
innen <- sum((wert - mittel[gruppe])^2)
round(c(streuung_zwischen = zwischen, streuung_innerhalb = innen,
        anteil_zwischen_prozent = zwischen / (zwischen + innen) * 100), 1)
      streuung_zwischen      streuung_innerhalb anteil_zwischen_prozent 
                17746.6                  9481.7                    65.2 
par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))
barplot(gesamt, names.arg = "alle", col = neutral, border = NA,
        ylim = c(0, 60), ylab = "Wert", main = "Überblick")
barplot(mittel, col = ifelse(mittel < 40, akzent, neutral), border = NA,
        ylim = c(0, 60), ylab = "Wert", main = "Aufschlüsselung")
par(mfrow = c(1, 1))
Abbildung 7: Beispiel 5: die Gesamtzahl und die Aufschlüsselung.
gruppen = ["A", "B", "C", "D", "E", "F"]
je_gruppe = 40
basis = np.array([50, 52, 49, 51, 30, 53])
z = stats.norm.ppf(lehmer(6363, len(gruppen) * je_gruppe))
gruppe = np.repeat(gruppen, je_gruppe)
wert = np.repeat(basis, je_gruppe) + z * 6

gesamt = wert.mean()
mittel = pd.Series(wert).groupby(gruppe).mean()
print({"gesamtmittel": round(float(gesamt), 2)})
{'gesamtmittel': 47.82}
print(mittel.round(2))
A    50.79
B    51.22
C    51.71
D    51.11
E    28.69
F    53.42
dtype: float64
print({"ohne_gruppe_E": round(float(mittel.drop("E").mean()), 2)})
{'ohne_gruppe_E': 51.65}
zwischen = float((je_gruppe * (mittel - gesamt) ** 2).sum())
innen = float(sum(((wert[gruppe == g] - mittel[g]) ** 2).sum() for g in gruppen))
print({"streuung_zwischen": round(zwischen, 1),
       "streuung_innerhalb": round(innen, 1),
       "anteil_zwischen_prozent": round(zwischen / (zwischen + innen) * 100, 1)})
{'streuung_zwischen': 17746.6, 'streuung_innerhalb': 9481.7, 'anteil_zwischen_prozent': 65.2}
fig, achsen = plt.subplots(1, 2, figsize=(7, 3))
_ = achsen[0].bar(["alle"], [gesamt], color=NEUTRAL)
_ = achsen[0].set_ylim(0, 60)
_ = achsen[0].set_title("Überblick", fontsize=10)
_ = achsen[1].bar(mittel.index, mittel.to_numpy(),
                  color=np.where(mittel.to_numpy() < 40, AKZENT, NEUTRAL))
_ = achsen[1].set_ylim(0, 60)
_ = achsen[1].set_title("Aufschlüsselung", fontsize=10)
for achse in achsen:
    _ = achse.set_ylabel("Wert")
plt.tight_layout()
plt.show()
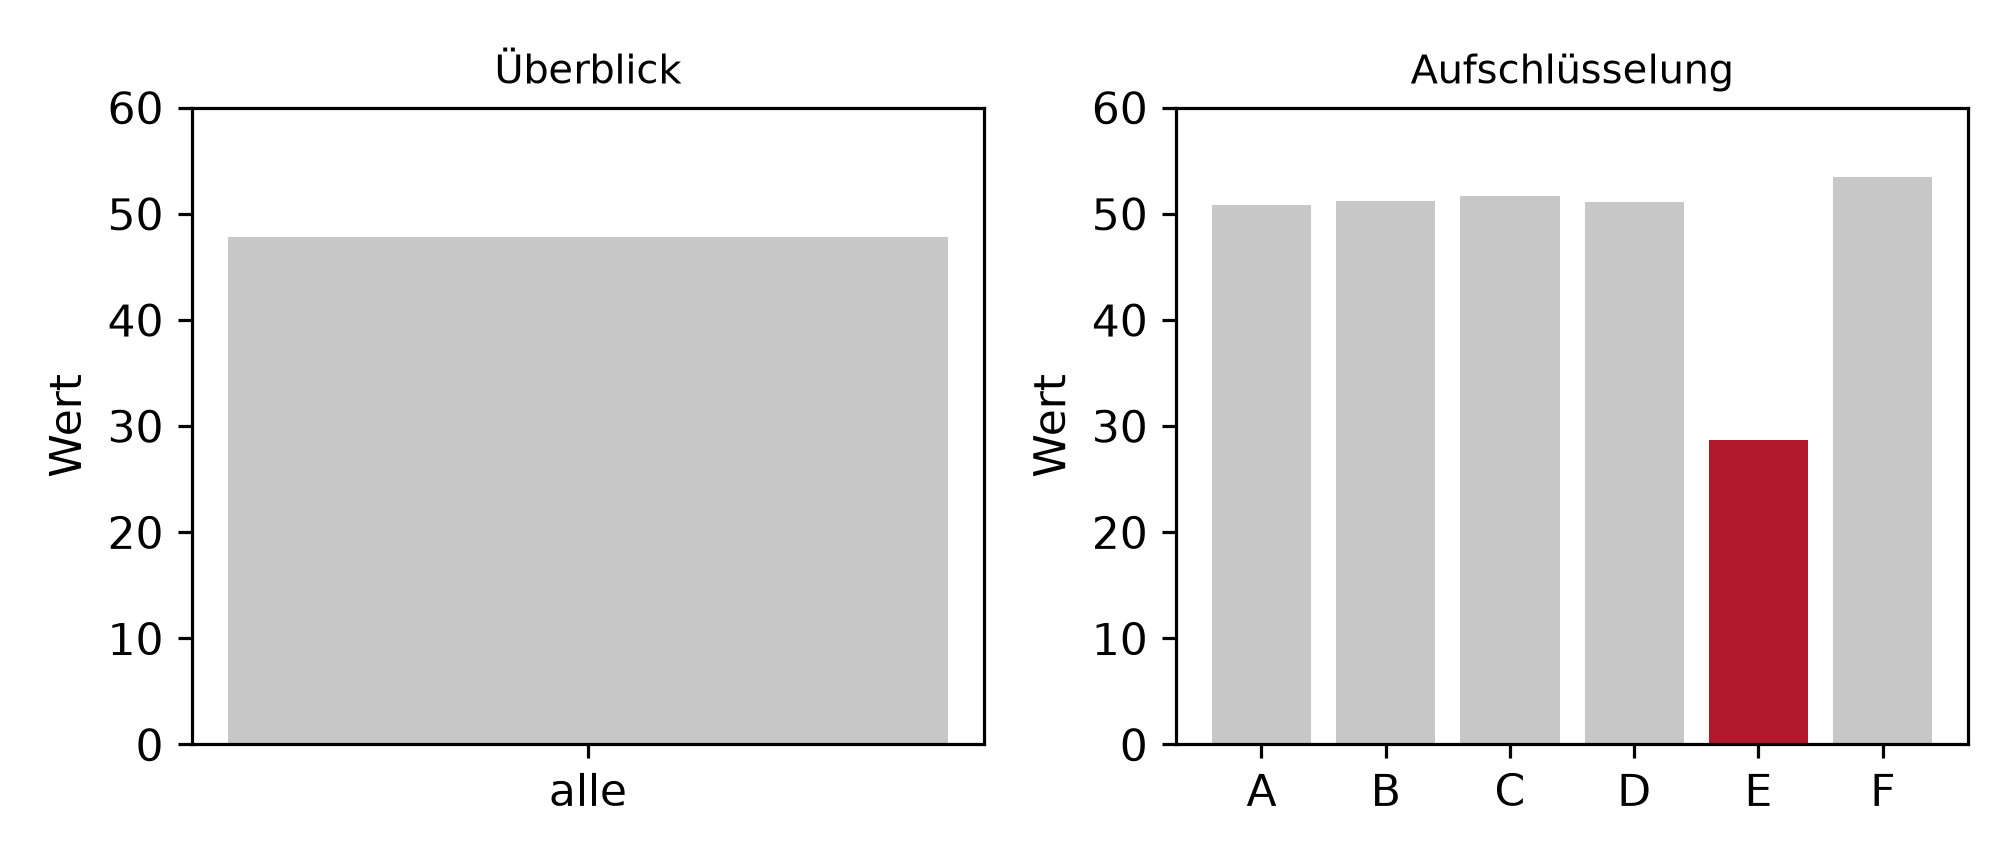
Abbildung 8: Beispiel 5: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

Standort A B C D E F
Mittelwert 50.79 51.22 51.71 51.11 28.69 53.42
Grösse Wert
Gesamtmittel 47.82
Mittel ohne Standort E 51.65
Streuung zwischen den Gruppen 17746.2
Streuung innerhalb der Gruppen 9481.7
Anteil zwischen den Gruppen 65.2 Prozent
Beobachtung Erklärung
Die Gesamtzahl 47.82 sieht unauffällig aus Sie liegt nur gut drei Punkte unter dem Wert der intakten Standorte. Auf einer Kachel allein wäre nichts zu sehen.
Ein Standort liegt bei 28.69 Also bei gut der Hälfte der übrigen. Ohne ihn läge das Mittel bei 51.65.
65.2 Prozent der Streuung liegen zwischen den Gruppen Und nicht innerhalb. Das ist die Kennzahl, die sagt, ob eine Aufschlüsselung lohnt: Steckt die Information in den Gruppen oder im Rauschen?
Bei einem niedrigen Anteil wäre die Aufschlüsselung Ballast Läge er bei 5 Prozent, wären die sechs Balken sechsmal dasselbe mit Rauschen. Dann gehört die Kachel weg.
Die Regel für das Dashboard folgt daraus Eine Aufschlüsselung gehört aufs Dashboard, wenn die Gruppen sich unterscheiden und das lässt sich messen, statt es zu vermuten.

Der Anteil der Zwischen-Gruppen-Streuung ist dasselbe Mass, das in der Varianzanalyse als \(\eta^2\) auftaucht. Auf einem Dashboard beantwortet es eine sehr praktische Frage: Lohnt die Kachel?

Anteil zwischen den Gruppen Empfehlung
unter 10 Prozent Aufschlüsselung weglassen
10 bis 40 Prozent als Detail hinter einem Klick
über 40 Prozent auf das Dashboard, mit Akzent auf dem Ausreisser

Interpretation und Ergebnissatz

Das Gesamtmittel von 47.82 verbirgt, dass ein Standort bei 28.69 liegt, während die übrigen fünf zwischen 50.79 und 53.42 liegen; ohne ihn wäre das Mittel 51.65. 65.2 Prozent der Gesamtstreuung liegen zwischen den Gruppen, die Aufschlüsselung trägt also die eigentliche Information.

Verständnisfragen

Ein Bericht soll monatlich an die Bereichsleitung gehen, die Aussage steht jeweils fest. Welche Form ist richtig?

Statisch, mit der Aussage im Titel
Richtig. Wenn feststeht, was gezeigt werden soll, ist Interaktion nur zusätzlicher Aufwand für beide Seiten. Ein Dashboard lohnt sich, wenn verschiedene Leute verschiedene Fragen an dieselben Daten haben.
Interaktiv, damit sich jeder vertiefen kann
Vertiefung wird selten genutzt und verschiebt die Deutungsarbeit zum Publikum.
Dialogisch, das ist am flexibelsten
Flexibel und am aufwendigsten, und die Antworten müssten geprüft werden.

Eine Schwelle bei 950 löst bei täglicher Betrachtung in 29.4 Prozent der Fälle Alarm aus, bei monatlicher nie. Was ist zu tun?

Die Schwelle aus der Streuung der jeweiligen Aggregationsebene ableiten
Richtig. Die Streuung der Periodenmittel sinkt mit eins durch Wurzel k: 80, dann 30.2, dann 15.1. Eine feste Zahl ohne Angabe des Takts legt nichts fest.
Den Takt auf monatlich umstellen, dann gibt es keine Fehlalarme
Dann warnt sie auch nicht, wenn wirklich etwas schiefgeht.
Die Schwelle tiefer setzen
Das verschiebt das Problem, statt es zu lösen; die Grenze braucht einen Bezug.

Auf einem Dashboard steht eine Kennzahl, für die es keine definierte Reaktion gibt. Was folgt?

Sie bleibt als Kontext stehen
Kontext ist ein Vorwand; sie verbraucht Platz und Aufmerksamkeit.
Sie gehört nicht auf das Dashboard
Richtig. Ein Dashboard stützt Entscheidungen. Eine Kennzahl ohne mögliche Reaktion ist Dekoration und verwässert die, auf die es ankommt.
Sie braucht eine Ampel
Eine Ampel ohne definierte Schwelle macht es schlimmer.

Dieselben Rohdaten ergeben Verfügbarkeiten von 83.69, 83.83 und 89.93 Prozent. Wie kommt das?

Die Rechenwege unterscheiden sich in Nenner und Gewichtung
Richtig. Ob geplante Wartung im Nenner steht, entscheidet über sechs Prozentpunkte; Summenquote und Mittel der Tagesquoten unterscheiden sich in der Gewichtung langer Tage.
Einer der drei Werte ist falsch gerechnet
Alle drei sind vertretbar, und genau das ist das Problem.
Die Daten sind fehlerhaft
Die Rohdaten sind dieselben für alle drei.

Ein Dashboard hat sechs Kachelreihen. Was bedeutet das auf einem Full-HD-Bildschirm?

Rund 44 Prozent sind ohne Scrollen unsichtbar
Richtig. Bei 220 Pixel Kachelhöhe passen drei Reihen auf 900 sichtbare Pixel. Was nicht draufpasst, gehört auf eine zweite Seite mit eigener Frage, nicht darunter.
Das ist kein Problem, man kann ja scrollen
Was gescrollt werden muss, wird in der Praxis nicht gesehen.
Man verkleinert einfach die Kacheln
Kleinere Kacheln tragen weniger; das verschiebt das Problem in die Lesbarkeit.

Woran erkennt man, ob eine Aufschlüsselung nach Gruppen auf das Dashboard gehört?

Am Anteil der Streuung, der zwischen den Gruppen liegt
Richtig. Im Beispiel waren es 65.2 Prozent, die Gruppen tragen also die Information. Läge der Anteil bei 5 Prozent, wären die Balken sechsmal dasselbe mit Rauschen.
An der Zahl der Gruppen
Sechs Gruppen können aufschlussreich oder überflüssig sein; die Zahl sagt nichts.
Daran, ob jemand danach gefragt hat
Ein Anhaltspunkt, aber messen ist besser.

Verlinkte Ressourcen