Regression mit Gruppenstruktur: zufällige Achsenabschnitte und Steigungen, ICC und warum OLS dort zu sicher ist.
Alle Beispiele rechnen mit denselben 180 Personen aus 12 Schulklassen. Die Daten entstehen in beiden Sprachen aus demselben Lehmer-Generator, R und Python sehen also exakt dieselben Werte.
Kurzsteckbrief
Fragestellung
Wie hängt eine Zielgrösse von Prädiktoren ab, wenn die Beobachtungen in Gruppen gebündelt sind?
Zielvariable
metrisch (für binäre Zielgrössen gibt es die verallgemeinerte Form)
Datenstruktur
Personen in Klassen, Messungen in Personen, Filialen in Regionen
Was die Methode liefert
feste Effekte mit Standardfehlern, Varianz der Gruppen und des Rests, ICC
Gemischte Modelle sind zuständig, sobald Beobachtungen nicht unabhängig sind, weil sie aus derselben Gruppe stammen: Schülerinnen derselben Klasse, wiederholte Messungen an derselben Person, Verkäufe derselben Filiale. Innerhalb einer Gruppe ähneln sich die Werte, und eine gewöhnliche Regression tut so, als wäre jede Zeile neue, unabhängige Information.
Situation
Stattdessen
Keine Gruppenstruktur, alle Beobachtungen unabhängig
Jede Klasse bekommt ihren eigenen Achsenabschnitt, aber diese Achsenabschnitte werden nicht einzeln geschätzt, sondern als Streuung um einen gemeinsamen Mittelwert modelliert:
Annähernd normalverteilte zufällige Effekte und Residuen
QQ-Plot der Residuen und der geschätzten \(u_j\)
bei grossen Stichproben meist harmlos
robuste Standardfehler oder Bootstrap
Output lesen
R, summary(lmer(...)):
Abschnitt
Was er sagt
REML criterion at convergence
Anpassungsmass, nur zum Vergleich von Modellen mit denselben festen Effekten
Random effects, Variance und Std.Dev.
\(\sigma_u^2\) je zufälligem Effekt und \(\sigma^2\) als Residual
Number of obs, groups
Anzahl Zeilen und Anzahl Gruppen; entscheidend ist oft die zweite Zahl
Fixed effects, Estimate, Std. Error, t value
wie in der Regression; lme4 gibt bewusst keine p-Werte aus
Python, MixedLM.fit().summary():
Zeile
Was sie sagt
Unterschied zu R
Scale
\(\sigma^2\), die Restvarianz
in R die Zeile Residual
Group Var
\(\sigma_u^2\)
in R (Intercept) unter Random effects
Coef., Std.Err., z, P>\|z\|
feste Effekte mit Wald-Test
R zeigt nur t value, ohne p-Wert
Converged
ob die Schätzung konvergiert ist
in R eine Warnung, falls nicht
Warum lme4 keinen p-Wert zeigt: Die Freiheitsgrade eines festen Effekts sind in gemischten Modellen nicht eindeutig definiert. Python rechnet mit der Normalverteilung, das ist bei vielen Gruppen eine gute Näherung und bei wenigen zu optimistisch.
Interpretationsfallen
OLS auf gruppierten Daten ist zu sicher. Die Schätzung selbst ist oft ähnlich, der Standardfehler aber zu klein, besonders für Merkmale der Gruppe. Beispiel 2 zeigt den Faktor.
Die Stichprobengrösse für Gruppenmerkmale ist die Zahl der Gruppen, nicht die Zahl der Zeilen. 180 Personen in 12 Klassen sind für die Klassengrösse 12 Beobachtungen.
Ein nicht signifikanter Test auf eine Varianzkomponente beweist nicht, dass sie null ist. Der Test liegt am Rand des Parameterraums und ist konservativ.
REML und ML nicht mischen. Modelle mit verschiedenen festen Effekten werden mit ML verglichen; R erledigt das in anova() automatisch, Python nicht.
singular fit ist keine Formalie. Es heisst, dass eine Varianz auf null oder eine Korrelation auf plus oder minus eins geschätzt wurde. Das Modell ist dann zu komplex für die Daten.
Ergebnis berichten
[Zielgrösse] wurde mit einem linearen gemischten Modell mit zufälligem Achsenabschnitt für [Gruppe] ausgewertet ([Anzahl] Beobachtungen in [Anzahl] Gruppen, REML). Je [Einheit Prädiktor] steigt [Zielgrösse] um [Schätzwert] (SE = [SE], 95-Prozent-Konfidenzintervall [unten] bis [oben]). Die Gruppen unterscheiden sich mit einer Standardabweichung von [σu], ICC = [ICC].
Immer genannt werden: Struktur der zufälligen Effekte, Zahl der Gruppen, Schätzverfahren, feste Effekte mit Intervall und die Varianzkomponenten.
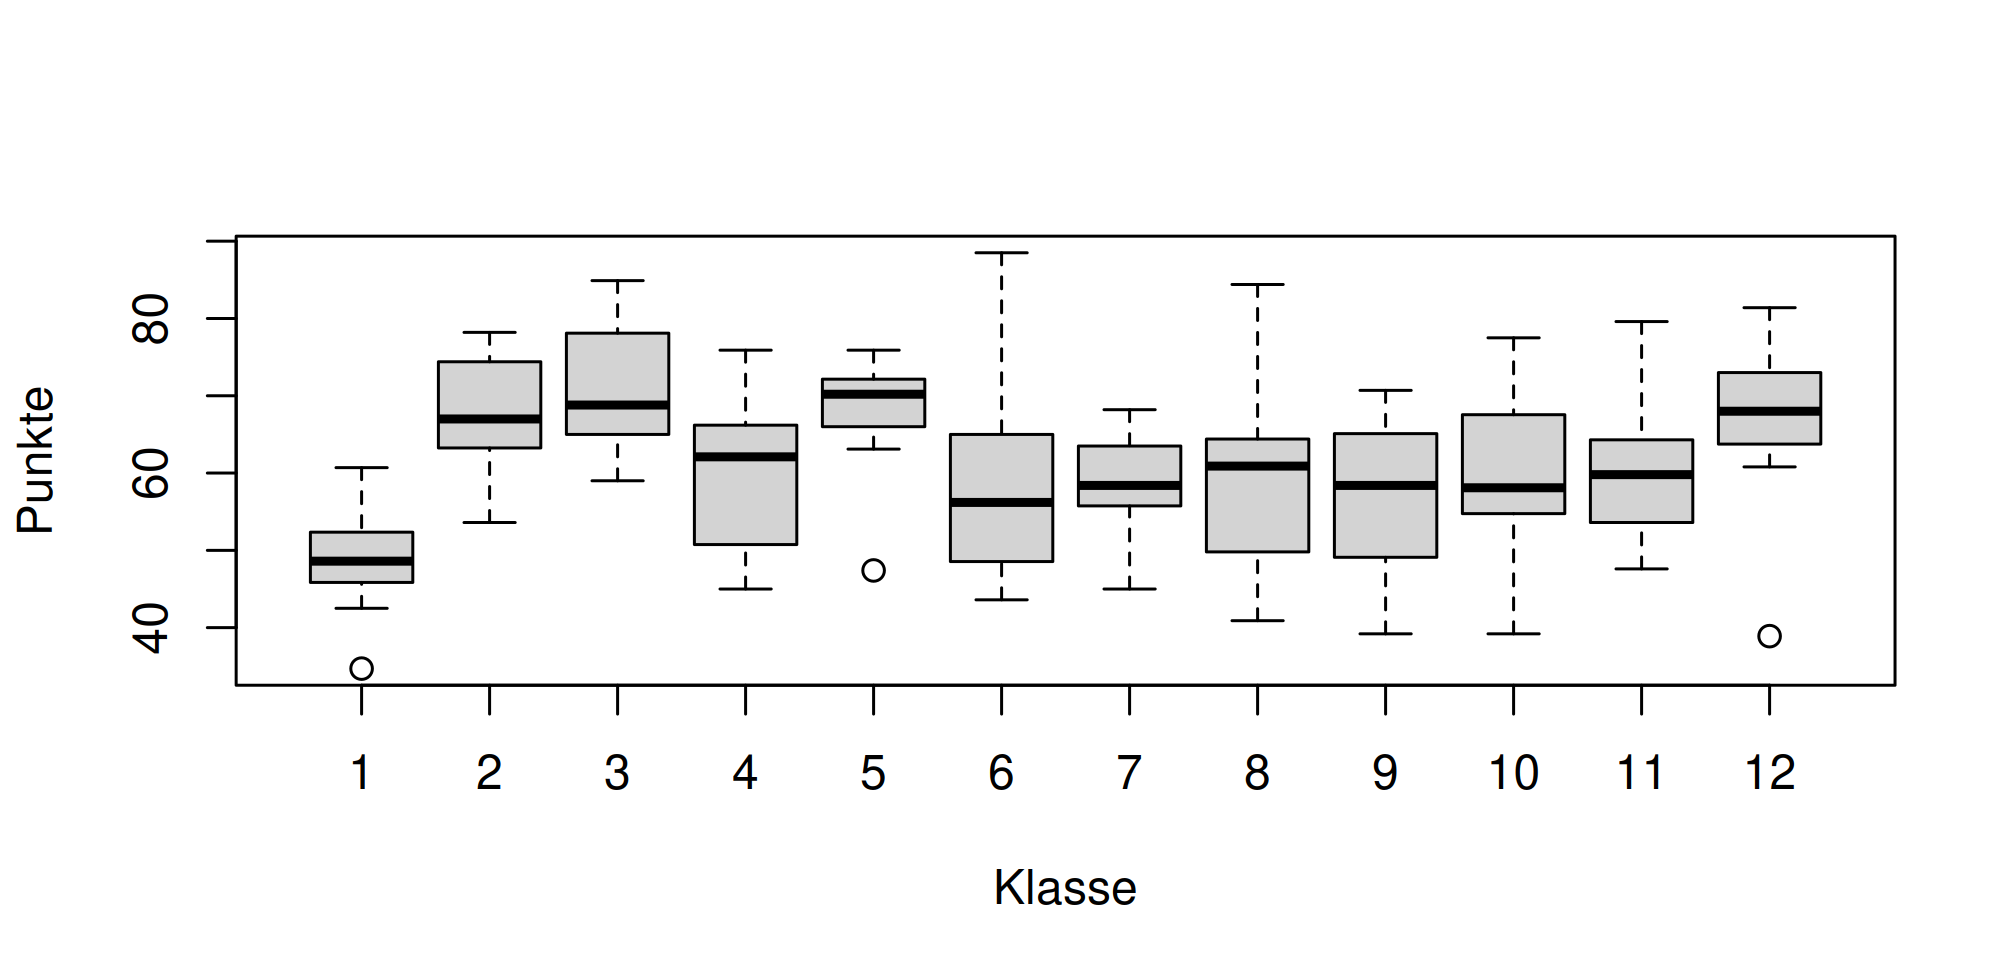
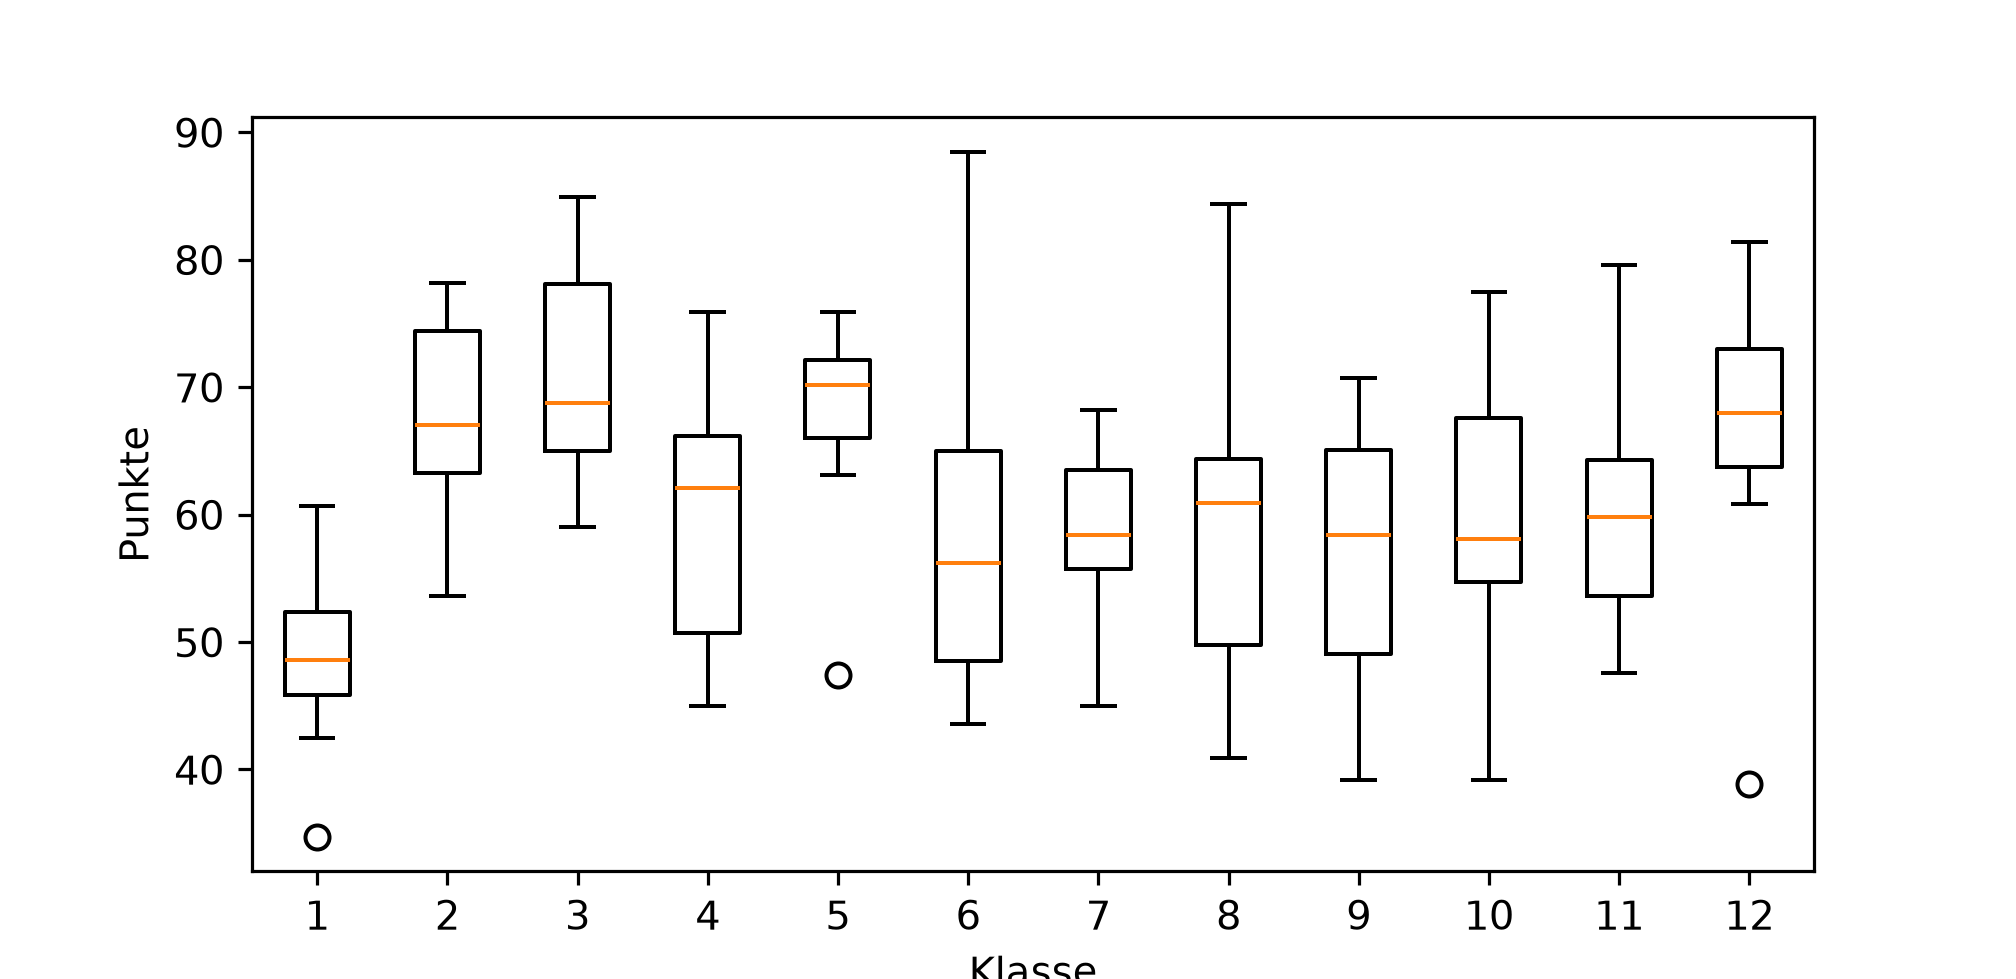
Hängt die Punktzahl in einem Test von den Lernstunden ab, und welcher Anteil der Unterschiede geht auf die Klasse zurück? 180 Personen aus 12 Klassen, je 15.
m0 <-lmer(punkte ~ stunden + (1| klasse), data = schule)summary(m0)
Linear mixed model fit by REML ['lmerMod']
Formula: punkte ~ stunden + (1 | klasse)
   Data: schule

REML criterion at convergence: 1297.3

Scaled residuals:
    Min      1Q  Median      3Q     Max
-2.2868 -0.7036  0.0335  0.6510  3.5559

Random effects:
 Groups   Name        Variance Std.Dev.
 klasse   (Intercept) 34.85    5.903
 Residual             70.23    8.380
Number of obs: 180, groups:  klasse, 12

Fixed effects:
            Estimate Std. Error t value
(Intercept)  50.1142     2.3653  21.187
stunden       2.2244     0.3029   7.344

Correlation of Fixed Effects:
        (Intr)
stunden -0.641
erwartete Punktzahl bei null Lernstunden in einer durchschnittlichen Klasse
extrapoliert, niemand lernt null Stunden; nur als Rechengrösse
stunden
2.224
je zusätzlicher Stunde rund 2.2 Punkte mehr
fester Effekt, gilt über alle Klassen
Standardfehler stunden
0.303
Unsicherheit der Steigung
Das Wald-Intervall reicht von 1.631 bis 2.818.
Varianz Klasse
34.849
Streuung der Klassenniveaus, als Standardabweichung 5.903 Punkte
Eine Klasse eine Standardabweichung über dem Schnitt liegt knapp 6 Punkte höher.
Restvarianz
70.227
Streuung innerhalb der Klassen, als Standardabweichung 8.380
in Python die Zeile Scale
ICC
0.332
ein Drittel der Streuung liegt zwischen den Klassen
weit entfernt von null; die Gruppenstruktur zu ignorieren wäre ein Fehler
Interpretation und Ergebnissatz
Die Lernstunden wirken klar, und zugleich unterscheiden sich die Klassen erheblich. Ein Drittel der Unterschiede zwischen Personen erklärt sich schon dadurch, in welche Klasse sie gehen.
Die Punktzahl wurde mit einem linearen gemischten Modell mit zufälligem Achsenabschnitt je Klasse ausgewertet (180 Personen in 12 Klassen, REML). Je Lernstunde steigt die Punktzahl um 2.224 Punkte (SE = 0.303, 95-Prozent-Konfidenzintervall 1.631 bis 2.818). Die Klassen unterscheiden sich mit einer Standardabweichung von 5.903 Punkten, ICC = 0.332.
Frage und Datenlage
Hat die Klassengrösse einen Einfluss auf die Punktzahl? Die Klassengrösse ist ein Merkmal der Klasse, nicht der Person: Alle 15 Personen einer Klasse haben denselben Wert. Die Daten wurden ohne jeden Effekt der Klassengrösse erzeugt.
berücksichtigt, dass es nur 12 verschiedene Klassengrössen gibt
Die Schätzung ist fast gleich, der Standardfehler aber im gemischten Modell zweieinhalbmal so gross. Hier sind beide Ergebnisse nicht signifikant, und das ist richtig, weil die Daten ohne Effekt erzeugt wurden. Der zu kleine Standardfehler von OLS bleibt aber ein Fehler: Über viele solche Datensätze meldet OLS für ein Klassenmerkmal deutlich öfter einen Scheineffekt, als das Signifikanzniveau zulässt.
Interpretation und Ergebnissatz
Der Unterschied betrifft vor allem Merkmale der Gruppe. Für die Lernstunden, die innerhalb jeder Klasse variieren, liegen die Standardfehler von OLS und gemischtem Modell näher beieinander.
Ein Effekt der Klassengrösse liess sich nicht nachweisen (Schätzung 0.361 Punkte je Person, SE = 1.016, p = 0.72, lineares gemischtes Modell mit zufälligem Achsenabschnitt je Klasse, 12 Klassen).
Frage und Datenlage
Wirkt eine Lernstunde in allen Klassen gleich, oder unterscheidet sich die Steigung zwischen den Klassen? Verglichen werden zwei Modelle mit einem Likelihood-Quotienten-Test, beide mit ML geschätzt.
wie viel besser das komplexere Modell die Daten beschreibt
Df
2
zwei zusätzliche Parameter
die Varianz der Steigung und ihre Korrelation mit dem Achsenabschnitt
Pr(>Chisq)
0.7342
p-Wert des Vergleichs
kein Hinweis, dass die Steigung zwischen den Klassen variiert
AIC (nur R)
Informationskriterium
kleiner ist besser; der Vergleich steht in der Tabelle
Interpretation und Ergebnissatz
Die Daten wurden mit einer leicht unterschiedlichen Steigung je Klasse erzeugt. Der Test findet sie trotzdem nicht: Zwölf Klassen reichen nicht, um eine Streuung von 0.8 Punkten je Stunde von null zu unterscheiden. Das ist Interpretationsfalle drei in der Praxis. Das einfachere Modell ist hier die vertretbare Wahl, ein Beweis für gleiche Steigungen ist das nicht.
Ein Modell mit zufälliger Steigung für die Lernstunden verbesserte die Anpassung nicht (χ²(2) = 0.62, p = 0.73); berichtet wird das Modell mit zufälligem Achsenabschnitt.
Verständnisfragen
Ein Datensatz enthält 2000 Messungen von 20 Filialen. Ein Merkmal der Filiale (Verkaufsfläche) soll den Umsatz erklären. Wie viele unabhängige Beobachtungen stehen für diesen Effekt ungefähr zur Verfügung?
Eher 20 als 2000
Richtig. Die Fläche variiert nur zwischen den Filialen. Innerhalb einer Filiale liefert jede weitere Messung keine neue Information über die Fläche.
2000, jede Messung zählt
Das ist genau die Annahme, mit der OLS den Standardfehler zu klein schätzt.
100, der Durchschnitt je Filiale
Die Zahl der Messungen je Filiale ist für diesen Effekt nicht die Stichprobengrösse.
lme4 meldet boundary (singular) fit. Was ist die sinnvollste Reaktion?
Die Struktur der zufälligen Effekte vereinfachen, etwa die zufällige Steigung weglassen
Richtig. Eine Varianz wurde auf null oder eine Korrelation auf ±1 geschätzt, das Modell ist für die Daten zu komplex.
Die Warnung unterdrücken, die festen Effekte sind trotzdem gültig
Sie können gültig sein, aber das Modell beschreibt eine Struktur, die die Daten nicht tragen.
Auf OLS wechseln
Das ignoriert die Gruppenstruktur ganz und macht die Standardfehler zu klein.
Der ICC eines Modells beträgt zwei Prozent. Was bedeutet das?
Nur zwei Prozent der Streuung liegen zwischen den Gruppen
Richtig. Die Gruppen unterscheiden sich kaum. Bei grossen Gruppen kann selbst das die Standardfehler von Gruppenmerkmalen spürbar vergrössern, der Design-Effekt hängt auch an der Gruppengrösse.
Das Modell erklärt zwei Prozent der Varianz
Der ICC ist kein Bestimmtheitsmass, sondern die Aufteilung der Restvarianz.
Der Effekt der Gruppe ist signifikant
Der ICC ist kein p-Wert und sagt nichts über Signifikanz.