Die Powerrechnung gehört vor die Datenerhebung. Sie beantwortet die Frage, ob sich der geplante Versuch überhaupt lohnt: Wer einen mittleren Effekt sucht und zwanzig Fälle je Gruppe erheben kann, wird ihn in zwei von drei Fällen verfehlen, und das lässt sich vorher wissen.
Nach der Datenerhebung ist ihr Nutzen begrenzt und ihre häufigste Anwendung sogar irreführend, siehe Beispiel 3.
Situation
Stattdessen
Die Daten liegen bereits vor und waren nicht signifikant
Vier Grössen hängen zusammen. Legt man drei fest, ergibt sich die vierte:
Grösse
Übliche Wahl
Bedeutung
Signifikanzniveau \(\alpha\)
0.05
Wahrscheinlichkeit, einen Effekt zu behaupten, den es nicht gibt (Fehler erster Art)
Power \(1-\beta\)
0.80
Wahrscheinlichkeit, einen vorhandenen Effekt zu finden
Effektstärke
aus Vorwissen oder Relevanzschwelle
wie gross der gesuchte Effekt ist, siehe Effektstärken
Stichprobenumfang \(n\)
das Ergebnis
Die Power ist das Gegenstück zum Fehler zweiter Art: \(\beta\) ist die Wahrscheinlichkeit, einen vorhandenen Effekt zu übersehen, und \(1-\beta\) die, ihn zu finden.
Effekt existiert
Effekt existiert nicht
Test signifikant
richtig, Wahrscheinlichkeit \(1-\beta\)
Fehler erster Art, Wahrscheinlichkeit \(\alpha\)
Test nicht signifikant
Fehler zweiter Art, Wahrscheinlichkeit \(\beta\)
richtig
Die Konvention 0.80 bedeutet, dass ein Fehler zweiter Art viermal so oft hingenommen wird wie einer erster Art. Das ist eine Setzung, keine Notwendigkeit: Wo ein übersehener Effekt teuer ist, gehört die Power höher.
Die wichtigste Zahl in der Rechnung ist die Effektstärke, und sie ist die unsicherste. Sie soll den kleinsten Effekt bezeichnen, den zu finden sich lohnt, nicht den erwarteten. Wer den erwarteten einsetzt und danebenliegt, erhebt zu wenig; wer aus einer kleinen Vorstudie schätzt, übernimmt deren Überschätzung, siehe Effektstärken, Beispiel 3.
Output lesen
R, pwr.t.test():
Grösse
Was sie sagt
Falle
n
Umfang je Gruppe
nicht der Gesamtumfang; bei zwei Gruppen verdoppeln
d
angenommene Effektstärke
die Eingabe, nicht ein Ergebnis
sig.level
\(\alpha\)
Voreinstellung 0.05
power
Trefferwahrscheinlichkeit
Voreinstellung, wenn n gesucht wird, ist keine gesetzt; sie muss angegeben werden
alternative
ein- oder zweiseitig
einseitig senkt den nötigen Umfang und verlangt eine vorab festgelegte Richtung
Python, TTestIndPower:
Aufruf
Ergebnis
Unterschied zu R
.power(effect_size=, nobs1=, alpha=)
Power
wie pwr.t.test(n=, d=)
.solve_power(effect_size=, power=, alpha=)
nobs1, also n je Gruppe
wie pwr.t.test(d=, power=)
ratio=
Verhältnis der Gruppengrössen
in R über pwr.t2n.test()
Beide geben gebrochene Umfänge aus. Aufgerundet wird immer, nie ab.
Interpretationsfallen
Nachträglich berechnete Power ist zirkulär. Sie wird aus dem beobachteten Effekt berechnet und ist deshalb eine Umrechnung des p-Werts, siehe Beispiel 3.
Power gilt für den angenommenen Effekt. Ist der wahre Effekt kleiner, ist die tatsächliche Power kleiner.
n ist der Umfang je Gruppe. Der häufigste Ablesefehler.
Ungleiche Gruppen kosten Power. Bei festem Gesamtumfang ist die Aufteilung 50 zu 50 die beste; 80 zu 20 verliert spürbar.
Ausfälle einplanen. Wer 64 je Gruppe braucht und mit 10 Prozent Ausfall rechnet, erhebt 72.
Mehrere Tests senken die Power. Eine Bonferroni-Korrektur auf 0.01 statt 0.05 verlangt rund 50 Prozent mehr Fälle.
Power ersetzt keine Voraussetzungsprüfung. Sie unterstellt, dass das geplante Verfahren anwendbar ist.
Ergebnis berichten
Der Versuch wurde auf einen Effekt von [Effektstärke] ausgelegt, der als kleinste praktisch bedeutsame Grösse festgelegt wurde. Bei \(\alpha\) = 0.05 zweiseitig und einer Power von [Wert] ergibt sich ein Umfang von [n] je Gruppe; erhoben wurden [tatsächlich] je Gruppe.
Genannt werden: die angenommene Effektstärke und ihre Herkunft, \(\alpha\), die angestrebte Power, das Verfahren, und ob ein- oder zweiseitig geprüft wird. Die Herkunft der Effektstärke ist der Punkt, an dem eine Powerrechnung steht oder fällt.
Ein Vergleich zweier Gruppen ist geplant. Als kleinster praktisch bedeutsamer Unterschied wurde ein mittlerer Effekt festgelegt, also \(d = 0.5\). Angestrebt wird eine Power von 0.80 bei \(\alpha\) = 0.05 zweiseitig.
pwr.t.test(d =0.5, power =0.80, sig.level =0.05,type ="two.sample", alternative ="two.sided")
     Two-sample t test power calculation

              n = 63.76561
              d = 0.5
      sig.level = 0.05
          power = 0.8
    alternative = two.sided

NOTE: n is number in *each* group
# Umfang fuer verschiedene Effektstaerkenfor (d inc(0.2, 0.3, 0.5, 0.8, 1.0)) { n <-pwr.t.test(d = d, power =0.80, sig.level =0.05)$ncat(sprintf("d = %.1f: %6.2f je Gruppe, aufgerundet %3d, insgesamt %3d\n", d, n, ceiling(n), 2*ceiling(n)))}
d = 0.2: 393.41 je Gruppe, aufgerundet 394, insgesamt 788
d = 0.3: 175.38 je Gruppe, aufgerundet 176, insgesamt 352
d = 0.5:  63.77 je Gruppe, aufgerundet  64, insgesamt 128
d = 0.8:  25.52 je Gruppe, aufgerundet  26, insgesamt  52
d = 1.0:  16.71 je Gruppe, aufgerundet  17, insgesamt  34
n_noetig = analyse.solve_power(effect_size=0.5, power=0.80, alpha=0.05, ratio=1.0)print("n je Gruppe für d = 0.5:", round(n_noetig, 3),"-> aufgerundet", int(np.ceil(n_noetig)))
n je Gruppe für d = 0.5: 63.766 -> aufgerundet 64
for d in (0.2, 0.3, 0.5, 0.8, 1.0): n = analyse.solve_power(effect_size=d, power=0.80, alpha=0.05, ratio=1.0)print(f"d = {d}: {n:6.2f} je Gruppe, aufgerundet {int(np.ceil(n)):3d}, "f"insgesamt {2*int(np.ceil(n)):3d}")
d = 0.2: 393.41 je Gruppe, aufgerundet 394, insgesamt 788
d = 0.3: 175.38 je Gruppe, aufgerundet 176, insgesamt 352
d = 0.5:  63.77 je Gruppe, aufgerundet  64, insgesamt 128
d = 0.8:  25.52 je Gruppe, aufgerundet  26, insgesamt  52
d = 1.0:  16.71 je Gruppe, aufgerundet  17, insgesamt  34
Output Zeile für Zeile
Effektstärke
n je Gruppe (genau)
aufgerundet
insgesamt
0.2 (klein)
393.41
394
788
0.3
175.38
176
352
0.5 (mittel)
63.77
64
128
0.8 (gross)
25.52
26
52
1.0
16.71
17
34
Die entscheidende Beobachtung: Der Umfang wächst mit dem Quadrat des Kehrwerts der Effektstärke. Ein halb so grosser Effekt braucht viermal so viele Fälle. Von \(d = 0.8\) auf \(d = 0.2\), also ein Viertel der Effektstärke, steigt der Umfang von 26 auf 394 je Gruppe, also auf das Fünfzehnfache.
Das ist der Grund, warum kleine Effekte in der Praxis so schwer nachzuweisen sind, und warum Studien, die kleine Effekte mit kleinen Stichproben finden, skeptisch zu betrachten sind.
Interpretation und Ergebnissatz
Der Versuch wurde auf einen Effekt von \(d\) = 0.5 ausgelegt, der als kleinste praktisch bedeutsame Grösse festgelegt wurde. Bei \(\alpha\) = 0.05 zweiseitig und einer angestrebten Power von 0.80 ergibt sich ein Umfang von 64 Fällen je Gruppe, also 128 insgesamt. Unter Einplanung von 10 Prozent Ausfällen werden 72 je Gruppe erhoben.
Frage und Datenlage
Der Umfang steht fest: zwanzig Fälle je Gruppe, mehr ist nicht zu bekommen. Die Frage dreht sich um: Welche Effekte lassen sich damit überhaupt finden?
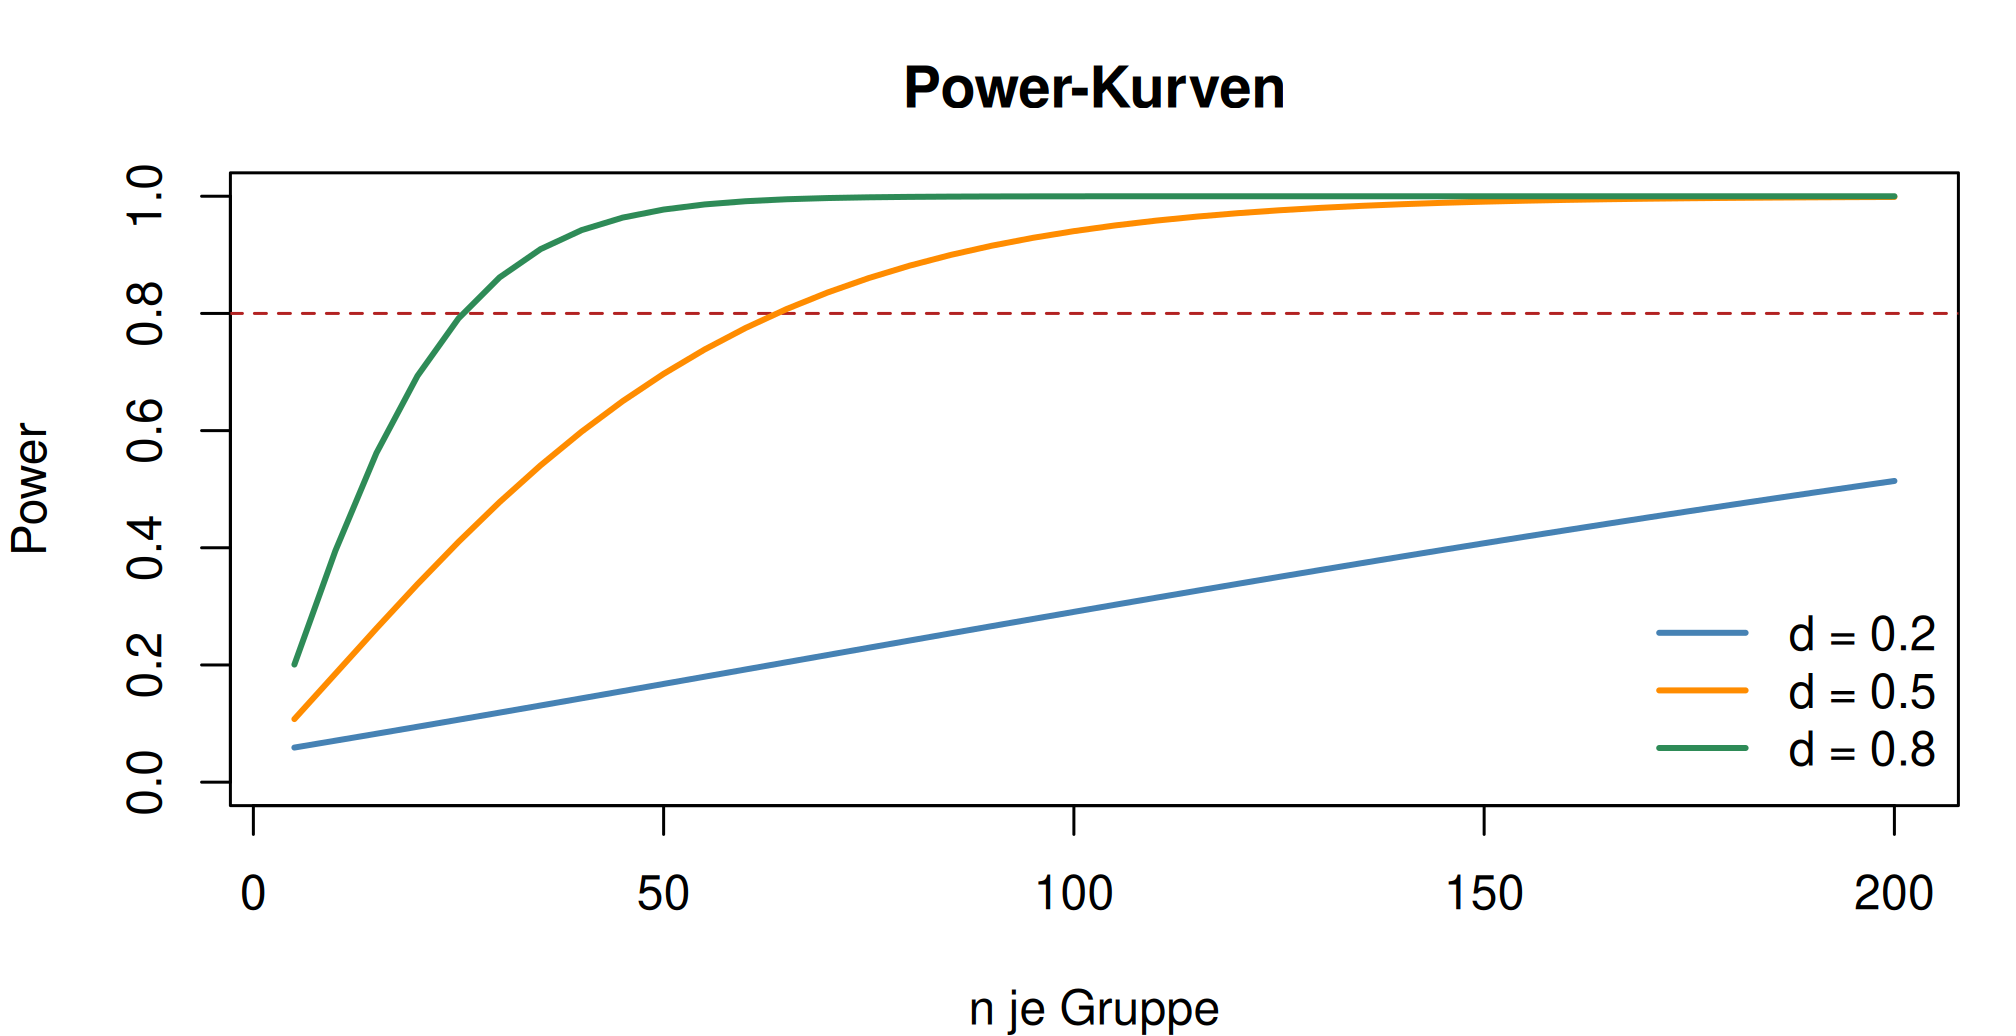
umfaenge <-seq(5, 200, by =5)par(mar =c(4, 4, 3, 1))plot(NULL, xlim =range(umfaenge), ylim =c(0, 1),xlab ="n je Gruppe", ylab ="Power", main ="Power-Kurven")abline(h =0.8, lty =2, col ="firebrick")farben <-c("steelblue", "darkorange", "seagreen")for (i inseq_along(c(0.2, 0.5, 0.8))) { d <-c(0.2, 0.5, 0.8)[i] werte <-sapply(umfaenge, function(n) pwr.t.test(n = n, d = d,sig.level =0.05)$power)lines(umfaenge, werte, col = farben[i], lwd =2)}legend("bottomright", paste("d =", c(0.2, 0.5, 0.8)), col = farben,lwd =2, bty ="n")for (d inc(0.2, 0.5, 0.8, 1.2)) {cat(sprintf("d = %.1f: Power bei n = 20 je Gruppe = %.4f\n", d, pwr.t.test(n =20, d = d, sig.level =0.05)$power))}
d = 0.2: Power bei n = 20 je Gruppe = 0.0946
d = 0.5: Power bei n = 20 je Gruppe = 0.3379
d = 0.8: Power bei n = 20 je Gruppe = 0.6934
d = 1.2: Power bei n = 20 je Gruppe = 0.9588
# Welcher Effekt ist mit n = 20 bei Power 0.80 gerade noch findbar?pwr.t.test(n =20, power =0.80, sig.level =0.05)$d
[1] 0.9091587
Abbildung 1: Beispiel 2: Power in Abhängigkeit vom Umfang, für drei Effektstärken.
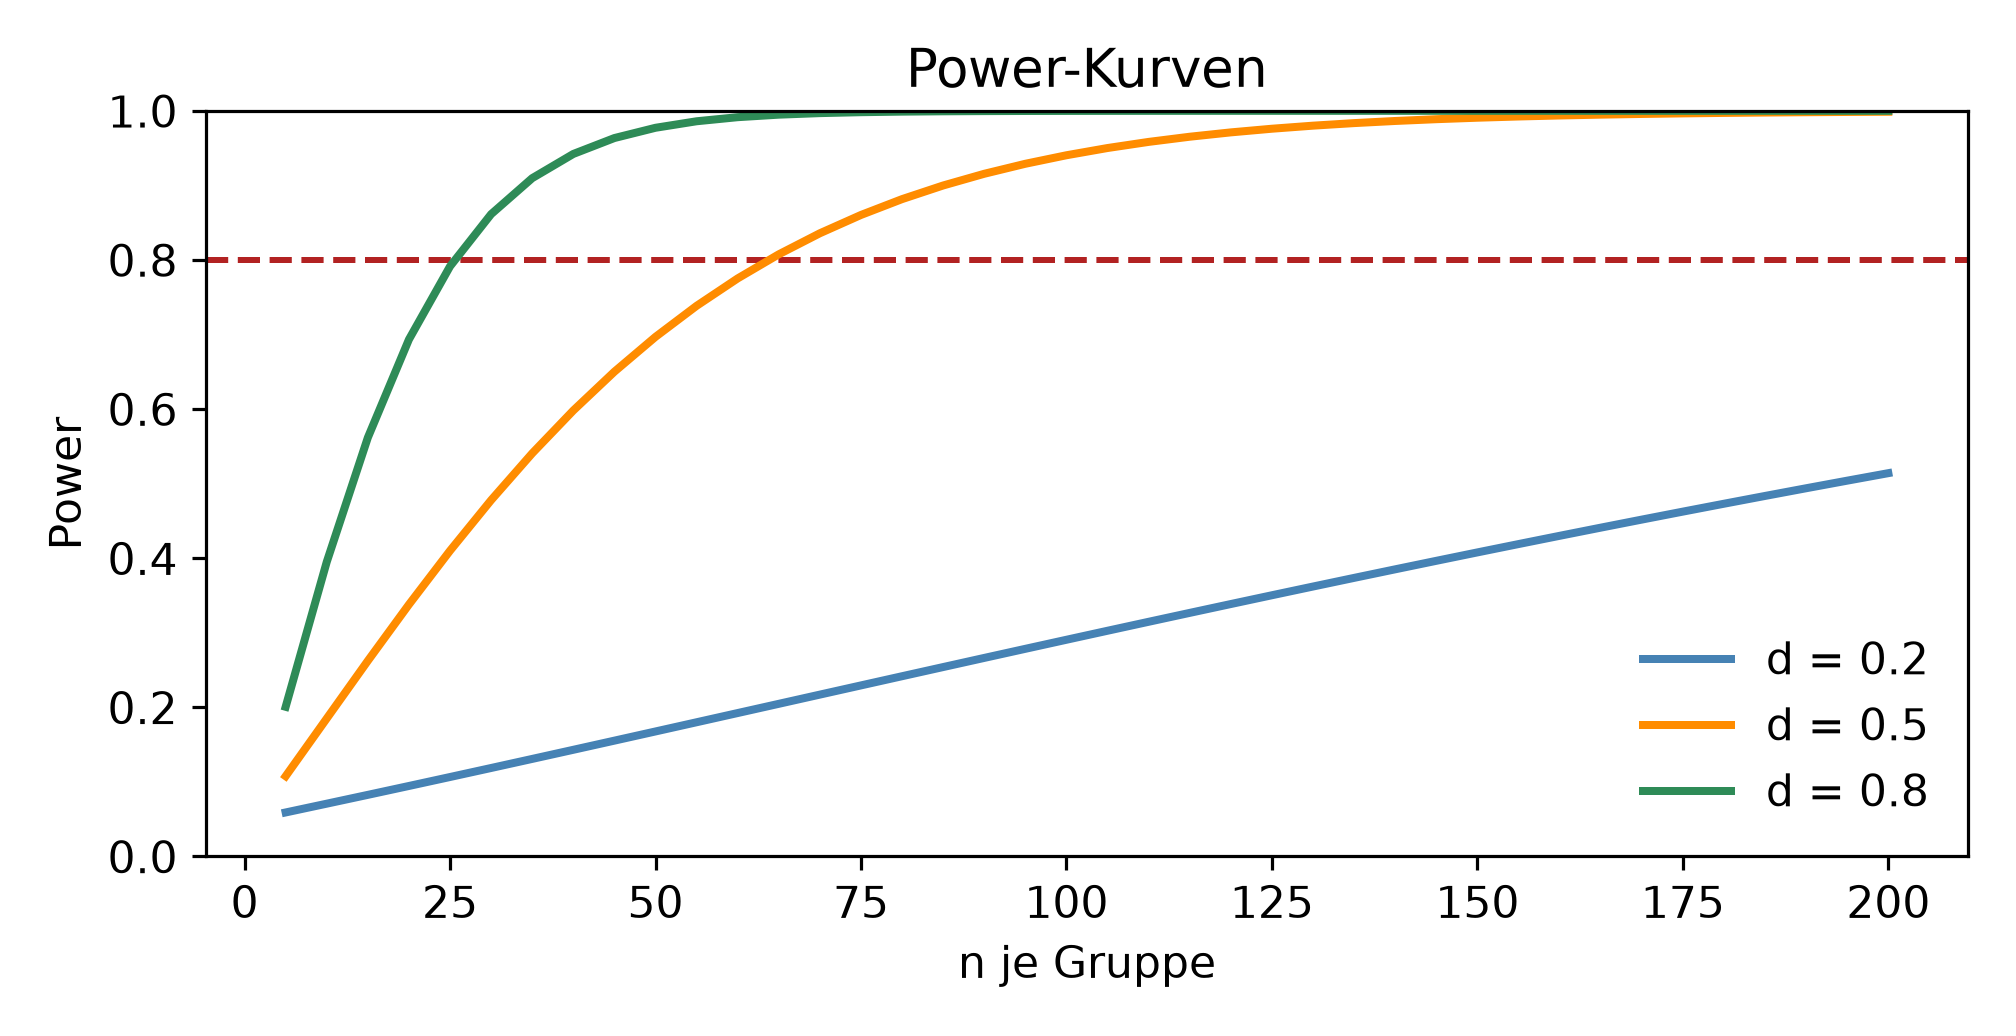
umfaenge = np.arange(5, 205, 5)fig, achse = plt.subplots(figsize=(7, 3.6))achse.axhline(0.8, linestyle="--", color="firebrick")for d, farbe inzip((0.2, 0.5, 0.8), ("steelblue", "darkorange", "seagreen")): werte = [analyse.power(effect_size=d, nobs1=n, alpha=0.05) for n in umfaenge] achse.plot(umfaenge, werte, color=farbe, linewidth=2, label=f"d = {d}")achse.set_xlabel("n je Gruppe")achse.set_ylabel("Power")achse.set_ylim(0, 1)
Abbildung 2: Beispiel 2: dieselben Kurven in Python.
for d in (0.2, 0.5, 0.8, 1.2):print(f"d = {d}: Power bei n = 20 je Gruppe = "f"{analyse.power(effect_size=d, nobs1=20, alpha=0.05):.4f}")
d = 0.2: Power bei n = 20 je Gruppe = 0.0946
d = 0.5: Power bei n = 20 je Gruppe = 0.3379
d = 0.8: Power bei n = 20 je Gruppe = 0.6934
d = 1.2: Power bei n = 20 je Gruppe = 0.9588
findbar = analyse.solve_power(nobs1=20, power=0.80, alpha=0.05, ratio=1.0)print("Mit n = 20 bei Power 0.80 findbar ab d =", round(findbar, 4))
Mit n = 20 bei Power 0.80 findbar ab d = 0.9091
Output Zeile für Zeile
Effektstärke
Power bei n = 20 je Gruppe
Wie das zu lesen ist
0.2
0.095
In neun von zehn Versuchen bleibt ein kleiner Effekt unentdeckt. Die Power liegt kaum über dem Signifikanzniveau von 0.05, also kaum über der Rate falscher Alarme.
0.5
0.338
Ein mittlerer Effekt wird in zwei von drei Versuchen übersehen.
0.8
0.693
Auch ein grosser Effekt bleibt in knapp einem Drittel der Fälle unentdeckt.
1.2
0.959
Erst hier wird der Versuch verlässlich.
Die Kurven zeigen dasselbe grafisch: Für \(d = 0.8\) ist die Schwelle von 0.80 bei rund 26 Fällen je Gruppe erreicht, für \(d = 0.5\) erst bei 64, und für \(d = 0.2\) liegt die Kurve über den ganzen dargestellten Bereich unter 0.55.
Die nützlichste Rechnung bei festem Umfang ist die Umkehrung: Welcher Effekt wäre mit dieser Fallzahl gerade noch findbar? Bei n = 20 je Gruppe und Power 0.80 liegt diese Grenze bei \(d\) = 0.91.
Das ist eine Zahl, mit der sich vorab argumentieren lässt: Wenn der erwartete Effekt deutlich darunter liegt, ist der Versuch in dieser Form nicht aussagekräftig, und die ehrliche Konsequenz ist entweder mehr Daten, ein präziseres Design (etwa gepaart statt ungepaart) oder der Verzicht.
Interpretation und Ergebnissatz
Bei einem festen Umfang von 20 Fällen je Gruppe beträgt die Power für einen mittleren Effekt (\(d\) = 0.5) nur 0.34. Verlässlich findbar (Power 0.80) sind erst Effekte ab \(d\) = 0.91. Der Versuch ist damit nicht geeignet, einen mittleren Effekt nachzuweisen; ein nicht signifikantes Ergebnis wäre nicht als Beleg für dessen Fehlen zu lesen.
Frage und Datenlage
Ein Versuch ist gelaufen und nicht signifikant geworden. Eine verbreitete Reaktion ist, die Powernachträglich aus dem beobachteten Effekt zu berechnen und zu berichten. Was kommt dabei heraus?
Die beiden letzten Spalten sind dieselbe Information in zwei Schreibweisen. Ein kleiner p-Wert geht immer mit hoher nachträglicher Power einher, ein grosser immer mit niedriger, und der Zusammenhang ist bei festem n eindeutig. Die Zeile mit p = 0.05 hat eine Power von genau 0.50, das gilt allgemein und ist kein Zufall dieses Beispiels: Liegt der beobachtete Effekt genau auf der Signifikanzschwelle, ergibt die nachträgliche Rechnung immer eine Power um 0.5.
Warum die Aussage “die Power war zu niedrig, deshalb nicht signifikant” zirkulär ist. Sie berechnet die Power aus genau dem Effekt, der beobachtet wurde, und stellt dann fest, dass ein kleiner beobachteter Effekt eine kleine Power ergibt. Das ist keine neue Erkenntnis, sondern eine Umformulierung von “der beobachtete Effekt war klein”.
Was stattdessen zu berichten ist: das Konfidenzintervall. Es beantwortet die Frage, die tatsächlich interessiert, nämlich welche Effektgrössen mit den Daten noch vereinbar sind. Ein Intervall von -0.2 bis 1.4 sagt “wir wissen es nicht”, eines von -0.1 bis 0.15 sagt “ein bedeutsamer Effekt ist ausgeschlossen”. Der p-Wert von 0.35 sagt in beiden Fällen dasselbe.
Interpretation und Ergebnissatz
Eine Powerrechnung ist nach der Erhebung nur in einer Form sinnvoll: mit einer vorab oder unabhängig festgelegten Effektstärke, um zu zeigen, dass der Versuch für diese Grösse ausgelegt war. Diese Rechnung hängt nicht vom Ergebnis ab und ist deshalb nicht zirkulär.
Der Versuch war auf \(d\) = 0.5 ausgelegt (Power 0.80 bei 64 je Gruppe); erhoben wurden 20 je Gruppe, was die Power auf 0.34 senkt. Das Ergebnis war nicht signifikant (p = 0.35); das 95-Prozent-Konfidenzintervall der standardisierten Differenz reicht von -0.32 bis 0.92 und lässt damit Effekte bis in den grossen Bereich zu.
Frage und Datenlage
Neben der Effektstärke gibt es drei Stellschrauben, die den Umfang deutlich verändern und in der Planung oft übersehen werden: das Signifikanzniveau, die Aufteilung auf die Gruppen und die Wahl zwischen gepaartem und ungepaartem Design.
cat("Wirkung des Signifikanzniveaus (d = 0.5, Power 0.80):\n")
Wirkung des Signifikanzniveaus (d = 0.5, Power 0.80):
for (a inc(0.10, 0.05, 0.01, 0.001)) { n <-pwr.t.test(d =0.5, power =0.80, sig.level = a)$ncat(sprintf(" alpha = %.3f: %6.2f je Gruppe\n", a, n))}
  alpha = 0.100:  50.15 je Gruppe
  alpha = 0.050:  63.77 je Gruppe
  alpha = 0.010:  95.10 je Gruppe
  alpha = 0.001: 139.31 je Gruppe
cat("\nWirkung der Aufteilung bei rund 128 Faellen insgesamt (d = 0.5):\n")
Wirkung der Aufteilung bei rund 128 Faellen insgesamt (d = 0.5):
for (paar inlist(c(64, 64), c(80, 48), c(96, 32), c(110, 18))) { p <-pwr.t2n.test(n1 = paar[1], n2 = paar[2], d =0.5, sig.level =0.05)$powercat(sprintf(" %3d zu %3d: Power = %.4f\n", paar[1], paar[2], p))}
   64 zu  64: Power = 0.8015
   80 zu  48: Power = 0.7757
   96 zu  32: Power = 0.6811
  110 zu  18: Power = 0.4967
cat("\nEinseitig statt zweiseitig (d = 0.5, Power 0.80):\n")
Einseitig statt zweiseitig (d = 0.5, Power 0.80):
cat(sprintf(" zweiseitig: %6.2f einseitig: %6.2f\n",pwr.t.test(d =0.5, power =0.80, alternative ="two.sided")$n,pwr.t.test(d =0.5, power =0.80, alternative ="greater")$n))
zweiseitig: 63.77 einseitig: 50.15
print("Wirkung des Signifikanzniveaus (d = 0.5, Power 0.80):")
Wirkung des Signifikanzniveaus (d = 0.5, Power 0.80):
for a in (0.10, 0.05, 0.01, 0.001): n = analyse.solve_power(effect_size=0.5, power=0.80, alpha=a, ratio=1.0)print(f" alpha = {a:.3f}: {n:6.2f} je Gruppe")
  alpha = 0.100:  50.15 je Gruppe
  alpha = 0.050:  63.77 je Gruppe
  alpha = 0.010:  95.10 je Gruppe
  alpha = 0.001: 139.31 je Gruppe
print("\nWirkung der Aufteilung bei rund 128 Fällen insgesamt (d = 0.5):")
Wirkung der Aufteilung bei rund 128 Fällen insgesamt (d = 0.5):
for n1, n2 in [(64, 64), (80, 48), (96, 32), (110, 18)]: p = analyse.power(effect_size=0.5, nobs1=n1, alpha=0.05, ratio=n2 / n1)print(f" {n1:3d} zu {n2:3d}: Power = {p:.4f}")
   64 zu  64: Power = 0.8015
   80 zu  48: Power = 0.7757
   96 zu  32: Power = 0.6811
  110 zu  18: Power = 0.4967
Output Zeile für Zeile
Signifikanzniveau. Je strenger, desto mehr Fälle:
\(\alpha\)
n je Gruppe
Bemerkung
0.10
50.15
0.05
63.77
die Voreinstellung
0.01
95.10
rund 50 Prozent mehr als bei 0.05
0.001
139.31
mehr als das Doppelte
Das ist der versteckte Preis einer Korrektur für multiples Testen: Wer fünf Tests plant und nach Bonferroni auf \(\alpha\) = 0.01 geht, braucht rund die Hälfte mehr Fälle je Test, um dieselbe Power zu halten.
Aufteilung auf die Gruppen. Bei festem Gesamtumfang:
Aufteilung
Power
Bemerkung
64 zu 64
0.801
das Optimum
80 zu 48
0.776
schon spürbar weniger
96 zu 32
0.681
110 zu 18
0.497
statt 0.80 nur noch 0.50, bei gleichem Gesamtumfang
Die kleinere Gruppe bestimmt die Power fast allein. Eine Kontrollgruppe von 18 Fällen lässt sich nicht dadurch ausgleichen, dass die Behandlungsgruppe auf 110 aufgestockt wird.
Ein- statt zweiseitig senkt den Umfang von 63.77 auf rund 50.15 je Gruppe, also um gut ein Fünftel. Der Preis ist, dass die Richtung vorab festgelegt sein muss und ein Effekt in die andere Richtung nicht nachweisbar wäre, selbst wenn er deutlich ausfiele.
Interpretation und Ergebnissatz
Die grösste Reserve steckt aber nicht in diesen Stellschrauben, sondern im Design. Ein gepaarter Versuch misst dieselbe Person zweimal und entfernt damit die Unterschiede zwischen den Personen aus der Fehlerstreuung. Bei einer Korrelation von 0.8 zwischen den beiden Messungen sinkt der nötige Umfang auf einen Bruchteil.
Deshalb lohnt sich die Frage nach dem Design vor der Frage nach dem Umfang: Fünfzehn Personen, zweimal gemessen, schlagen oft hundert Personen, einmal gemessen.
Geplant war ein Umfang von 64 je Gruppe für \(d\) = 0.5 bei \(\alpha\) = 0.05 und Power 0.80. Wegen der geplanten fünf Vergleiche wurde \(\alpha\) nach Bonferroni auf 0.01 gesenkt, was den Umfang auf 95 je Gruppe erhöht. Die Gruppen werden gleich gross besetzt, da eine ungleiche Aufteilung die Power spürbar senkt.
Verständnisfragen
Ein Versuch mit 20 Fällen je Gruppe ist nicht signifikant geworden. Die nachträglich berechnete Power beträgt 0.28. Was folgt daraus?
Nichts, was der p-Wert nicht schon gesagt hätte
Richtig. Die nachträgliche Power wird aus dem beobachteten Effekt berechnet und ist bei festem n eine eindeutige Umrechnung des p-Werts. Aussagekräftig ist stattdessen das Konfidenzintervall.
Der Versuch war zu klein, deshalb war er nicht signifikant
Der Satz klingt plausibel und ist zirkulär: Er begründet den grossen p-Wert mit einer Zahl, die aus demselben p-Wert stammt.
Es gibt keinen Effekt
Ein nicht signifikantes Ergebnis belegt nie das Fehlen eines Effekts.
Der Umfang für \(d\) = 0.5 beträgt 64 je Gruppe. Wie viele braucht es für \(d\) = 0.25?
Rund viermal so viele, also etwa 250 je Gruppe
Richtig. Der Umfang wächst mit dem Quadrat des Kehrwerts der Effektstärke. Halbierte Effektstärke bedeutet vervierfachten Umfang.
Doppelt so viele, also 128
Der Zusammenhang ist quadratisch, nicht linear.
Dasselbe, der Umfang hängt nur an Power und alpha
Die Effektstärke ist die Grösse, die den Umfang am stärksten bestimmt.
Bei 128 Fällen insgesamt: Welche Aufteilung liefert die höchste Power?
64 zu 64
Richtig. Bei festem Gesamtumfang ist die gleiche Aufteilung optimal. Die kleinere Gruppe bestimmt die Power fast allein; 110 zu 18 erreicht nur 0.50 statt 0.80.
96 zu 32, weil die grössere Gruppe genauer geschätzt wird
Die Genauigkeit der grösseren Gruppe nützt wenig, solange die kleinere die Unsicherheit bestimmt.
Die Aufteilung spielt keine Rolle, nur die Summe zählt
Sie spielt eine erhebliche Rolle, wie die Tabelle in Beispiel 4 zeigt.
Welche Effektstärke gehört in eine Powerrechnung vor der Erhebung?
Der kleinste Effekt, dessen Nachweis sich lohnt
Richtig. Die Powerrechnung soll sicherstellen, dass ein Effekt dieser Grösse gefunden wird. Wer den erwarteten Effekt einsetzt und ihn überschätzt, plant zu klein.
Der in einer Vorstudie beobachtete Effekt
Effektstärken aus kleinen Vorstudien sind systematisch überschätzt und führen zu zu kleinen Umfängen.
Der grösste plausible Effekt
Damit wäre der Versuch für alle kleineren Effekte unterdimensioniert.