Mehrere Prädiktoren, adjustiertes R², Multikollinearität und wie man den Output liest.
Kurzsteckbrief
Fragestellung
Wie hängt eine metrische Zielgrösse gleichzeitig von mehreren Einflussgrössen ab, und wie gross ist der Beitrag jeder einzelnen bei konstant gehaltenen anderen?
Zielvariable
metrisch (intervall- oder verhältnisskaliert)
Prädiktoren
zwei oder mehr, metrisch oder kategorial (kategoriale werden zu Indikatorvariablen)
Was die Methode liefert
Koeffizienten mit Standardfehlern, Konfidenzintervallen und p-Werten, R² und adjustiertes R², F-Test des Gesamtmodells, Residuen für die Diagnostik
R-Funktion
lm(y ~ x1 + x2, data = df), gelesen mit summary(), confint(), car::vif()
Typische Fragestellungen: Miete aus Fläche und Alter einer Wohnung, Absatz aus Preis und Werbebudget, Laborwert aus Dosis und Körpergewicht. Gemeinsam ist ihnen, dass die Zielgrösse metrisch ist, dass mehrere Einflussgrössen zugleich wirken und dass der Beitrag einer einzelnen Grösse interessiert, gerade weil die anderen mit ihr zusammenhängen.
Die Methode passt, wenn der Zusammenhang in den Prädiktoren annähernd linear ist, die Beobachtungen unabhängig sind und die Streuung der Residuen über den Vorhersagebereich ungefähr gleich bleibt.
Transformation der Variablen oder Polynomterme im Modell
Deutlich ungleiche Residuenstreuung
robuste Standardfehler oder Transformation der Zielvariable
Grundidee und Modell
Gesucht ist die Ebene beziehungsweise Hyperebene, die möglichst nah an allen beobachteten Punkten liegt. Nah bedeutet: die Summe der quadrierten senkrechten Abstände zwischen beobachteten und vorhergesagten Werten ist minimal. Das Quadrieren gewichtet grosse Abweichungen stärker und macht die Lösung eindeutig berechenbar.
beobachteter Wert der Zielvariable bei Beobachtung \(i\)
\(\beta_0\)
Achsenabschnitt, erwarteter Wert von \(y\), wenn alle Prädiktoren null sind
\(\beta_j\)
erwartete Änderung von \(y\), wenn \(x_j\) um eine Einheit steigt und alle anderen Prädiktoren konstant bleiben
\(x_{ij}\)
Wert des \(j\)-ten Prädiktors bei Beobachtung \(i\)
\(\varepsilon_i\)
Residuum, der von keinem Prädiktor erfasste Rest, mit Erwartungswert null und konstanter Varianz
Geschätzt wird mit der Methode der kleinsten Quadrate. Sie hat eine geschlossene Lösung, es wird also nicht iteriert und es gibt keine Konvergenzprobleme. Entscheidend für die Interpretation ist die Wendung “bei konstant gehaltenen anderen Prädiktoren”: jeder Koeffizient beschreibt den Beitrag seiner Variable, nachdem der Einfluss der übrigen herausgerechnet ist. Deshalb kann sich ein Koeffizient beim Hinzufügen einer weiteren Variablen deutlich ändern, und deshalb ist er nicht dasselbe wie eine einfache Korrelation.
Voraussetzungen und ihre Prüfung
Voraussetzung
Was sie bedeutet
Prüfung
Folge bei Verletzung
Vorgehen
Linearität
Der Zusammenhang jedes Prädiktors mit der Zielgrösse ist geradlinig
Residuen gegen vorhergesagte Werte, gekrümmtes Muster ist verdächtig
Koeffizienten sind systematisch verzerrt, Vorhersagen in den Randbereichen falsch
Transformation, Polynomterm oder Aufteilung in Bereiche
Unabhängigkeit
Beobachtungen beeinflussen sich nicht gegenseitig
aus dem Erhebungsdesign, bei zeitlicher Ordnung Durbin-Watson
Standardfehler zu klein, p-Werte zu optimistisch
Mehrebenenmodell oder Zeitreihenmodell
Homoskedastizität
Residuenstreuung ist über den Vorhersagebereich konstant
Residuenplot, Breusch-Pagan-Test
Schätzwerte bleiben brauchbar, Standardfehler und p-Werte nicht
robuste Standardfehler oder Transformation
Normalverteilte Residuen
Die Residuen streuen annähernd normal
QQ-Plot der Residuen
betrifft vor allem Tests und Intervalle bei kleinem n, bei grossem n unkritisch
Transformation, Bootstrap
Keine starke Multikollinearität
Prädiktoren sind nicht nahezu Linearkombinationen voneinander
VIF, Werte über 5 sind auffällig, über 10 kritisch
einzelne Koeffizienten instabil und nicht signifikant, obwohl das Modell gut passt
eine Variable entfernen oder zusammenfassen
Keine einflussreichen Einzelfälle
Kein einzelner Punkt bestimmt das Ergebnis
Cook-Distanz, Hebelwerte
Koeffizient hängt an einer Beobachtung
Fall prüfen, Modell mit und ohne ihn berichten
Output lesen
R, summary(modell):
Grösse
Was sie sagt
Faustregel oder Falle
Call
die geschätzte Modellformel
prüfen, ob wirklich das gemeinte Modell gerechnet wurde
Residuals
Minimum, Quartile, Median der Residuen
Median deutlich neben null oder stark unsymmetrische Extreme deuten auf Schieflage
Estimate
geschätzter Koeffizient
Änderung von y je Einheit von x bei konstant gehaltenen anderen Prädiktoren, in den Einheiten der Variablen
Std. Error
Standardfehler des Koeffizienten
Unsicherheit der Schätzung, wächst mit der Streuung und mit Multikollinearität
t value
Estimate geteilt durch Std. Error
Werte über etwa 2 in Betrag sind bei üblichem n signifikant
Pr(>|t|)
p-Wert des Tests, dass der Koeffizient null ist
prüft nur den einzelnen Koeffizienten, sagt nichts über die Grösse des Effekts
(Intercept)
erwartete Miete bei Fläche 0 und Alter 0
oft ohne inhaltliche Bedeutung, weil der Punkt ausserhalb der Daten liegt
Residual standard error
typische Abweichung einer Vorhersage in der Einheit von y
die direkt interpretierbare Gütezahl, hier vergleichbar mit dem simulierten Rauschen
Freiheitsgrade
n minus Anzahl geschätzter Parameter
sinken mit jedem zusätzlichen Prädiktor
Multiple R-squared
Anteil der erklärten Streuung
steigt mit jedem Prädiktor, auch mit einem sinnlosen
Adjusted R-squared
um die Anzahl Prädiktoren korrigiert
die Zahl, die man beim Modellvergleich liest
F-statistic mit p-Wert
Test, ob das Modell insgesamt besser ist als der Mittelwert
signifikant, ohne dass ein einzelner Koeffizient signifikant sein muss, typisch bei Multikollinearität
confint()
95-Prozent-Intervall je Koeffizient
schliesst es null ein, ist der Koeffizient nicht signifikant
Python, modell.summary(), mit den Unterschieden zu R:
Grösse
Was sie sagt
Unterschied zu R
coef, std err, t, P>|t|
wie Estimate, Std. Error, t value, Pr(>
t
[0.025 0.975]
Konfidenzintervall
steht direkt in der Tabelle, in R braucht es confint()
R-squared, Adj. R-squared
wie in R
identisch berechnet
F-statistic, Prob (F-statistic)
Gesamttest
identisch
Df Residuals, Df Model
Freiheitsgrade
R nennt sie im Fliesstext, Python in eigenen Zeilen
AIC, BIC, Log-Likelihood
Kennzahlen für den Modellvergleich
R zeigt sie nicht in summary(), dort über AIC(modell)
Omnibus, Jarque-Bera, Skew, Kurtosis
Tests und Masse zur Normalität der Residuen
in R nicht enthalten, dort über den QQ-Plot
Durbin-Watson
Hinweis auf Autokorrelation der Residuen
Werte um 2 sind unauffällig, in R über dwtest()
Cond. No.
Konditionszahl der Prädiktormatrix
grosse Werte deuten auf Multikollinearität, ergänzend zum VIF
Kein Residual standard error
die Grösse fehlt in der Tabelle
über np.sqrt(modell.mse_resid)
Ausgelassen wird kein Wert: auch Freiheitsgrade, Residualstreuung und die Normalitätskennzahlen gehören zur Beurteilung, und Warnhinweise am Fuss der Python-Tabelle sind Teil des Ergebnisses.
Interpretationsfallen
Signifikanz ist keine Relevanz. Bei grossem n wird ein Koeffizient von 0.4 Einheiten pro Quadratmeter signifikant, ohne für eine Mietentscheidung eine Rolle zu spielen. Relevanz liest man am Schätzwert in seiner Einheit, an seinem Intervall und an der Residualstreuung.
Der p-Wert ist keine Wahrscheinlichkeit für die Nullhypothese. Er ist die Wahrscheinlichkeit dieser oder extremerer Daten, wenn der Koeffizient null wäre. Siehe Hypothesentests: Grundlagen.
R² ist keine Modellrichtigkeit. Ein Modell mit falscher Struktur kann ein hohes R² haben, und ein korrektes Modell für stark streuende Daten ein niedriges. R² steigt zudem mit jedem zusätzlichen Prädiktor; für Vergleiche gilt das adjustierte R².
Ein Koeffizient ist keine Kausalität. “Bei konstant gehaltenen anderen Prädiktoren” heisst konstant gehalten unter den aufgenommenen Variablen. Eine nicht erhobene gemeinsame Ursache bleibt im Modell unsichtbar und verzerrt den Koeffizienten.
Das Konfidenzintervall ist keine Wahrscheinlichkeitsaussage über den wahren Wert. Das Verfahren trifft in 95 Prozent aller Anwendungen den wahren Wert; das konkrete Intervall enthält ihn oder nicht.
Der Achsenabschnitt ist selten interpretierbar. Fläche null und Alter null kommt in den Daten nicht vor. Wer den Achsenabschnitt deuten will, zentriert die Prädiktoren.
Vorhersagen nur im beobachteten Bereich. Ausserhalb der Datenspanne ist die Linearität nicht geprüft und die Vorhersage eine Behauptung.
Ergebnis berichten
Vorlage für den Ergebnissatz:
Ein multiples lineares Modell mit [Prädiktoren] erklärt [Zielvariable] (F([Df Model], [Df Residuals]) = [F], p = [p], adjustiertes R² = [Wert], n = [n]). Bei konstant gehaltenen übrigen Prädiktoren steigt [Zielvariable] pro Einheit [Prädiktor] um [Schätzwert] [Einheit] (95-Prozent-Konfidenzintervall [unten] bis [oben], p = [p]).
Immer genannt werden: Schätzwert in seiner Einheit, Konfidenzintervall, Teststatistik mit Freiheitsgraden, p-Wert, adjustiertes R² und n, dazu die Residualstreuung, wenn es um Vorhersagegüte geht. Genannt wird ausserdem, welche Voraussetzungen geprüft wurden und mit welchem Ergebnis.
Beispiel für eine Ergebnistabelle:
Prädiktor
Schätzwert
Standardfehler
95-Prozent-Intervall
p
Achsenabschnitt
Fläche (m²)
Alter (Jahre)
Abgrenzung zu verwandten Methoden
Methode
Wann diese statt der multiplen linearen Regression
Zielvariable ist eine Zeit bis zu einem Ereignis mit zensierten Fällen
Beispiele
Alle Beispiele rechnen mit demselben Datensatz aus dem Setup-Chunk: 120 Wohnungen mit Miete, Fläche, Alter, Stockwerk, Zimmerzahl und Lage. Die Daten sind deterministisch konstruiert, damit R und Python dieselben Zahlen sehen und jeder Wert im Text nachprüfbar ist.
Von 120 Wohnungen liegen Miete in Franken, Wohnfläche in Quadratmetern und Alter in Jahren vor. Die Frage lautet: Wie viel kostet ein zusätzlicher Quadratmeter, wenn das Alter konstant gehalten wird, und wie viel kostet ein zusätzliches Jahr Alter bei gleicher Fläche?
Genau dieses “bei konstant gehaltenen anderen” ist der Grund für die multiple Regression. Zwei getrennte einfache Regressionen könnten die Frage nicht beantworten, sobald Fläche und Alter zusammenhängen.
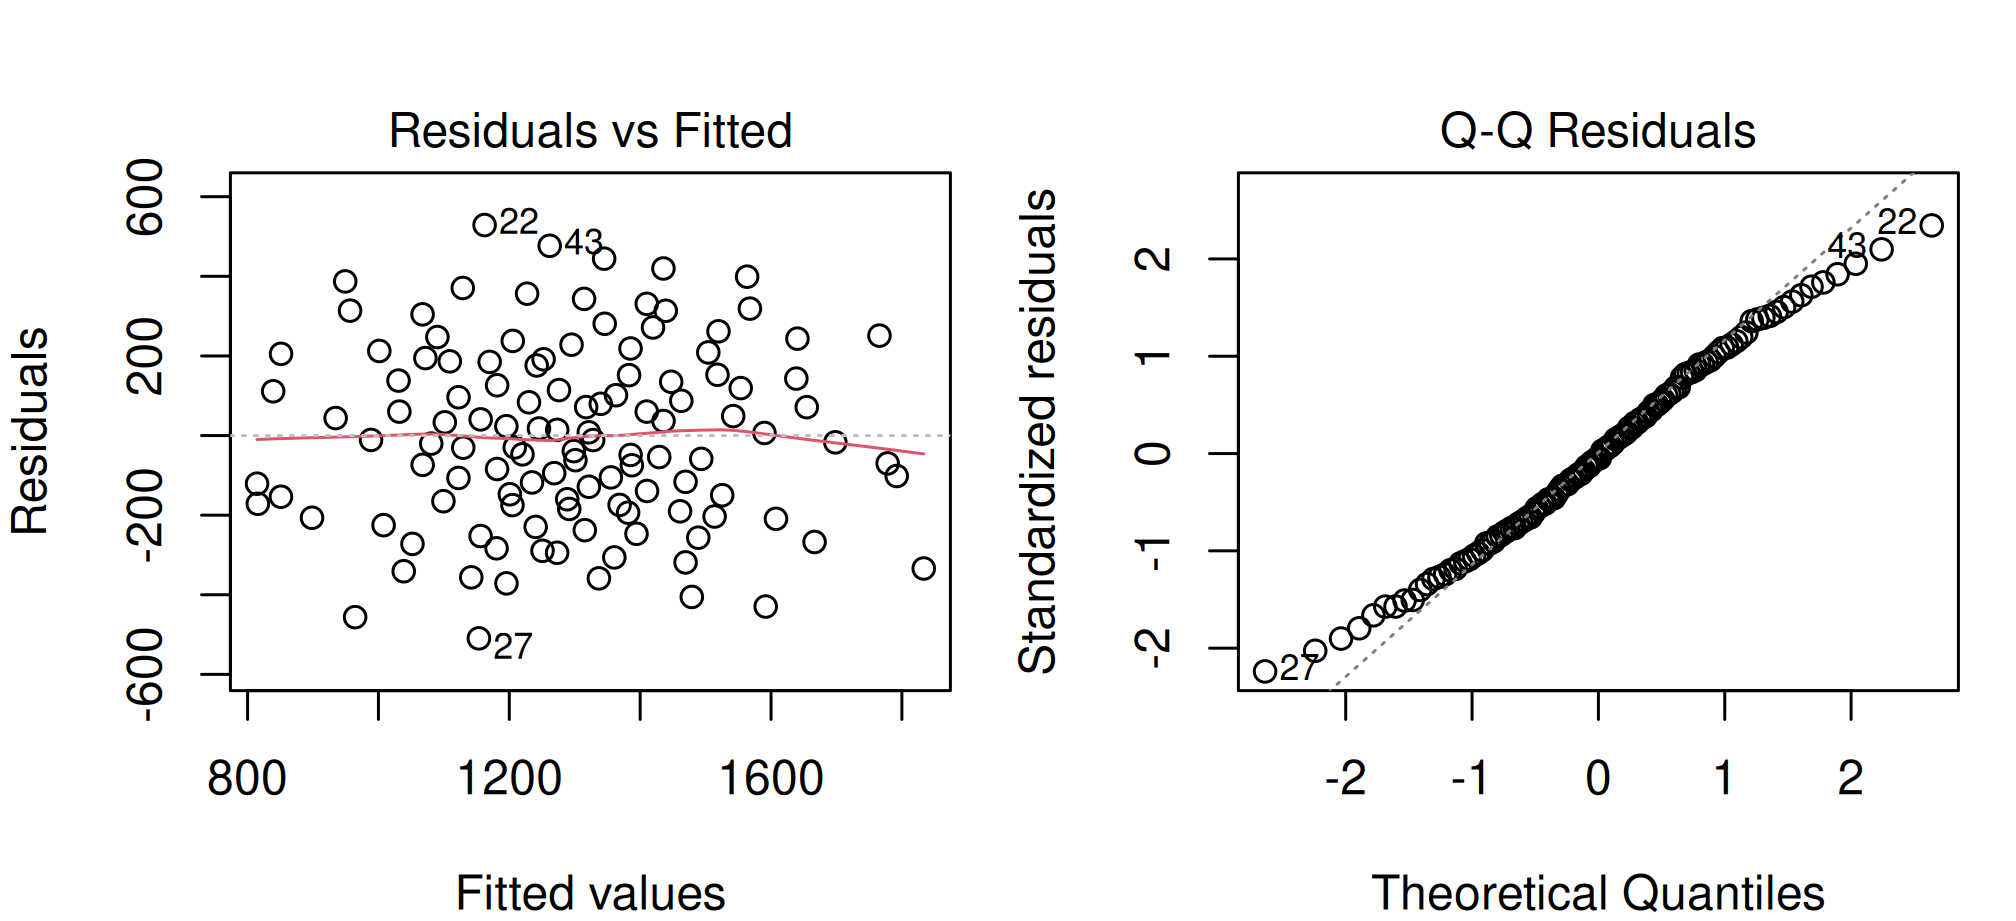
modell <-lm(miete ~ flaeche + alter, data = wohnung)par(mfrow =c(1, 2), mar =c(4, 4, 3, 1))plot(modell, which =1)plot(modell, which =2)par(mfrow =c(1, 1))bptest(modell)
    studentized Breusch-Pagan test

data:  modell
BP = 1.9986, df = 2, p-value = 0.3681
vif(modell)
 flaeche    alter
1.000488 1.000488
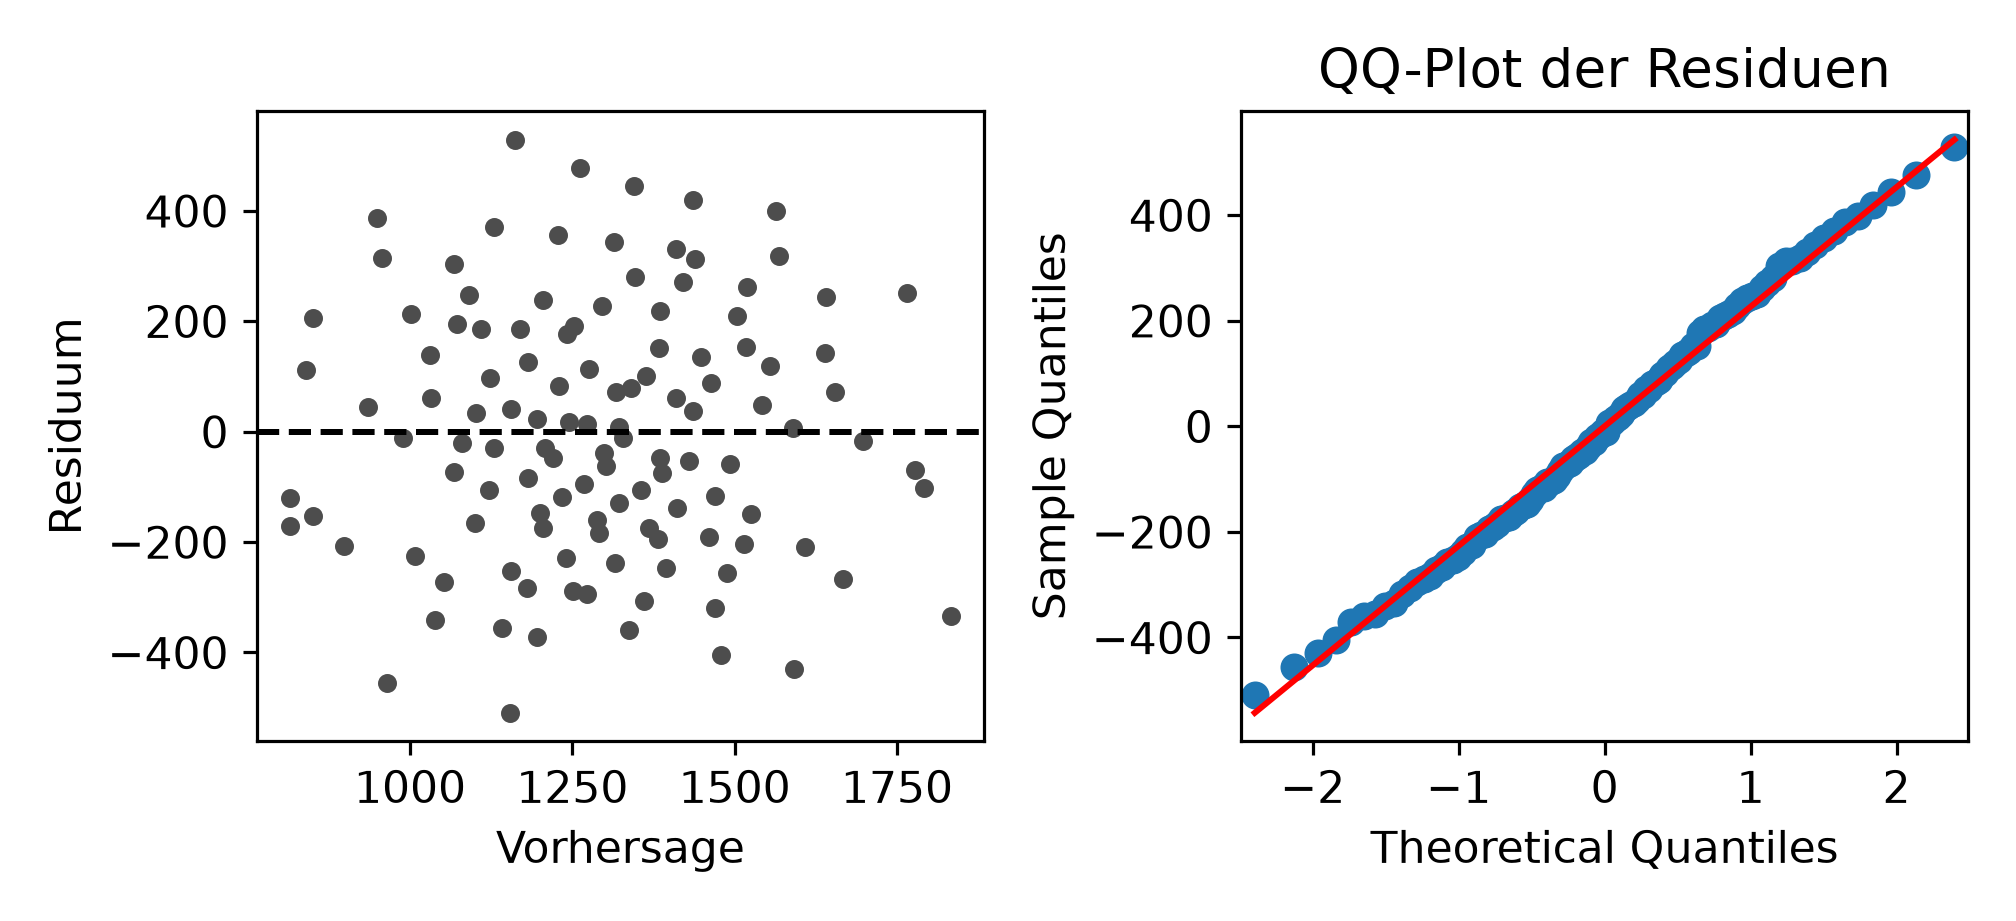
Abbildung 1: Beispiel 1: Residuen gegen Vorhersage und QQ-Plot der Residuen.
Die Residuen streuen strukturlos um die Nulllinie, der QQ-Plot zeigt keine auffällige Abweichung, und der Breusch-Pagan-Test liefert p = 0.37, also keinen Hinweis auf ungleiche Streuung. Die VIF-Werte liegen bei 1.0: Fläche und Alter hängen in diesen Daten praktisch nicht zusammen (r = 0.02), jede der beiden Grössen trägt also eigene Information bei.
Rechnerisch nötig, inhaltlich sinnlos: Eine Wohnung mit null Quadratmetern gibt es nicht. Wer eine deutbare Zahl braucht, zentriert die Prädiktoren.
flaeche Estimate
12.10
Franken je Quadratmeter, bei gleichem Alter
Die zentrale Zahl. Der Zusatz “bei gleichem Alter” ist kein Beiwerk, sondern die eigentliche Leistung der multiplen Regression.
flaeche Std. Error
1.170
Unsicherheit dieser Schätzung
Rund ein Zehntel des Schätzwerts.
flaeche t value
10.340
Schätzwert durch Standardfehler
flaeche Pr(>|t|)
< 0.001
p-Wert für “der Koeffizient ist null”
alter Estimate
-3.23
Franken je Jahr, bei gleicher Fläche
Ältere Wohnungen sind bei gleicher Fläche günstiger.
alter Std. Error
1.429
Fast die Hälfte des Schätzwerts, die Schätzung ist also viel unsicherer als die der Fläche.
alter Pr(>|t|)
0.026
Signifikant, aber knapp.
Konfidenzintervall flaeche
9.78 bis 14.41
plausibler Bereich
Rund fünf Franken breit.
Konfidenzintervall alter
-6.06 bis -0.40
plausibler Bereich
Die aufschlussreichste Zeile der ganzen Ausgabe: Der Alterseffekt liegt irgendwo zwischen 40 Rappen und gut sechs Franken je Jahr. Das ist ein Faktor von 15. Der p-Wert von 0.026 verdeckt diese Unsicherheit vollständig.
Residual standard error
229.4 auf 117 Freiheitsgraden
typischer Vorhersagefehler in Franken
Die praktisch nützlichste Gütezahl. Wer eine Miete aus Fläche und Alter vorhersagt, liegt typischerweise um 229 Franken daneben.
Freiheitsgrade
117
n minus Anzahl Parameter
120 minus 3, also Achsenabschnitt plus zwei Koeffizienten.
Multiple R-squared
0.4869
Anteil erklärter Streuung
Knapp die Hälfte.
Adjusted R-squared
0.4782
um die Parameterzahl korrigiert
Der Abstand zu R² wächst mit jedem zusätzlichen Prädiktor, siehe Beispiel 2.
F-statistic
55.5 auf 2 und 117 df
Gesamttest
Prüft, ob alle Koeffizienten zugleich null sind. Bei mehreren Prädiktoren ist er nicht mehr redundant zu den t-Tests.
Interpretation und Ergebnissatz
Die beiden Koeffizienten sind sehr unterschiedlich gut bestimmt, obwohl beide signifikant sind. Bei der Fläche ist der Effekt auf rund fünf Franken genau eingegrenzt; beim Alter reicht das Intervall über einen Faktor 15. Wer nur die p-Werte liest, sieht diesen Unterschied nicht.
Und die Residualstreuung von 229 Franken setzt den Rahmen: Für die Bewertung einer einzelnen Wohnung ist das Modell zu ungenau. Für die Aussage “ein Quadratmeter kostet rund zwölf Franken” reicht es.
Fläche und Alter erklären zusammen 49 Prozent der Mietunterschiede (F(2, 117) = 55.5, p < 0.001, n = 120). Je Quadratmeter steigt die Miete um 12.10 Franken (95-Prozent-Konfidenzintervall 9.78 bis 14.41, p < 0.001), je Jahr Alter sinkt sie um 3.23 Franken (-6.06 bis -0.40, p = 0.026), jeweils bei konstant gehaltener anderer Grösse. Die typische Abweichung einer Vorhersage beträgt 229 Franken.
Frage und Datenlage
Dem Modell wird das Stockwerk hinzugefügt. Die Frage lautet: Trägt es etwas bei?
modell_stock <-lm(miete ~ flaeche + alter + stockwerk, data = wohnung)summary(modell_stock)
Call:
lm(formula = miete ~ flaeche + alter + stockwerk, data = wohnung)

Residuals:
    Min      1Q  Median      3Q     Max
-509.46 -172.41  -11.01  178.23  528.75

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 422.8675   111.9744   3.776 0.000252 ***
flaeche      12.0966     1.1750  10.295  < 2e-16 ***
alter        -3.2300     1.4364  -2.249 0.026423 *
stockwerk    -0.1122    13.8812  -0.008 0.993564
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 230.3 on 116 degrees of freedom
Multiple R-squared:  0.4869,    Adjusted R-squared:  0.4737
F-statistic:  36.7 on 3 and 116 DF,  p-value: < 2.2e-16
anova(modell, modell_stock)
Analysis of Variance Table

Model 1: miete ~ flaeche + alter
Model 2: miete ~ flaeche + alter + stockwerk
  Res.Df     RSS Df Sum of Sq     F Pr(>F)
1    117 6154434
2    116 6154430  1    3.4668 1e-04 0.9936
modell_stock = smf.ols("miete ~ flaeche + alter + stockwerk", data=wohnung).fit()print(modell_stock.summary().tables[1])
   df_resid           ssr  df_diff  ss_diff       F  Pr(>F)
0     117.0  6.154434e+06      0.0      NaN     NaN     NaN
1     116.0  6.154430e+06      1.0   3.4668  0.0001  0.9936
Output Zeile für Zeile
Ausgabe
Ohne Stockwerk
Mit Stockwerk
Wie das zu lesen ist
stockwerk Estimate
-0.11
Elf Rappen je Stockwerk. Praktisch null.
stockwerk Std. Error
13.881
Der Standardfehler ist mehr als hundertmal so gross wie der Schätzwert.
stockwerk p-Wert
0.994
So gross, wie ein p-Wert kaum werden kann.
Konfidenzintervall
-27.6 bis 27.4
Symmetrisch um null und knapp 55 Franken breit. Das Stockwerk könnte durchaus 25 Franken wert sein, in beide Richtungen; ausgeschlossen ist nur ein sehr grosser Effekt.
Multiple R-squared
0.4869
0.4869
Unverändert in der vierten Stelle.
Adjusted R-squared
0.4782
0.4737
Gesunken. Das ist der Unterschied zwischen den beiden Massen.
Residual standard error
229.4
230.3
Ebenfalls leicht schlechter geworden.
Modellvergleich anova()
F = 0.0001, p = 0.994
Derselbe Test wie der t-Test des Koeffizienten; bei einem einzelnen zusätzlichen Prädiktor sind sie gleichwertig, und F ist exakt t².
Warum R² nicht sinken kann und adjustiertes R² schon. R² misst, wie viel Streuung das Modell erklärt, und ein zusätzlicher Prädiktor kann diesen Anteil nie verringern: Im schlechtesten Fall bekommt er den Koeffizienten null. Deshalb ist R² für den Vergleich von Modellen mit verschieden vielen Prädiktoren unbrauchbar.
Das adjustierte R² zieht für jeden Parameter einen Betrag ab. Trägt ein Prädiktor weniger bei, als dieser Abzug ausmacht, sinkt es. Genau das ist hier passiert, und deshalb ist es die Zahl, die man beim Modellvergleich ansieht, siehe Modellauswahl.
Interpretation und Ergebnissatz
Der Prädiktor wird entfernt, aber nicht wegen des p-Werts allein. Die Entscheidung stützt sich auf drei Dinge: kein erkennbarer Beitrag zur erklärten Streuung, ein gesunkenes adjustiertes R², und ein Konfidenzintervall, das keinen praktisch bedeutsamen Effekt nahelegt.
Wäre das Intervall stattdessen von -5 bis +120 Franken gegangen, wäre “kein Effekt nachweisbar” die falsche Zusammenfassung gewesen: Dann wäre ein grosser Effekt weiterhin vereinbar, und das Modell hätte schlicht zu wenig Daten.
Das Stockwerk trägt nichts zur Erklärung der Miete bei (Koeffizient -0.11 Franken, 95-Prozent-Konfidenzintervall -27.6 bis 27.4, p = 0.99); das adjustierte R² sinkt von 0.478 auf 0.474. Der Prädiktor wurde nicht ins Modell aufgenommen.
Frage und Datenlage
Statt des Stockwerks kommt die Zimmerzahl ins Modell. Sie hängt naturgemäss eng mit der Fläche zusammen: grössere Wohnungen haben mehr Zimmer. In diesen Daten beträgt die Korrelation 0.96.
X = sm.add_constant(wohnung[["flaeche", "alter", "zimmer"]])print({name: round(variance_inflation_factor(X.values, i), 3)for i, name inenumerate(X.columns)})
Dreieinhalbmal so gross. Das ist die eigentliche Wirkung von Multikollinearität: nicht falsche Schätzwerte, sondern unsichere.
Konfidenzintervall flaeche
9.78 bis 14.41
2.56 bis 18.73
Aus einer Spanne von fünf Franken wird eine von sechzehn.
zimmer Estimate
31.49
zimmer Std. Error
84.706
Fast dreimal so gross wie der Schätzwert.
zimmer p-Wert
0.711
Nicht signifikant, obwohl die Zimmerzahl offensichtlich mit der Miete zusammenhängt.
Multiple R-squared
0.4869
0.4876
Praktisch unverändert. Das Modell als Ganzes ist genauso gut wie vorher.
VIF
1.0
12.09 für Fläche und Zimmer
Der Varianzinflationsfaktor sagt, um welchen Faktor die Varianz des Koeffizienten gegenüber unkorrelierten Prädiktoren wächst. 12.09 heisst: Der Standardfehler ist um Wurzel 12.09, also rund 3.5, grösser. Genau der beobachtete Faktor.
Zimmerzahl allein
242.22 Franken je Zimmer
Ohne die Fläche daneben ist der Effekt gross und deutlich. Er beschreibt dann aber die Fläche gleich mit.
Faustregeln zum VIF und was sie bedeuten. Werte unter 5 gelten als unbedenklich, über 10 als kritisch. Wichtiger als die Schwelle ist die Übersetzung: VIF ist der Faktor, um den die Varianz wächst; für den Standardfehler zieht man die Wurzel. Ein VIF von 4 bedeutet einen doppelt so grossen Standardfehler, ein VIF von 100 einen zehnfachen.
Interpretation und Ergebnissatz
Multikollinearität macht das Modell nicht falsch. Die Vorhersagen bleiben genau so gut wie vorher, R² ändert sich nicht, und die Schätzwerte sind erwartungstreu. Was leidet, ist die Aussage über einzelne Koeffizienten: Wenn zwei Prädiktoren fast dasselbe messen, kann kein Verfahren entscheiden, welchem von beiden der gemeinsame Effekt zuzurechnen ist.
Daraus folgt, was zu tun ist:
Ziel
Vorgehen
Vorhersage
Nichts. Multikollinearität stört die Vorhersage nicht.
Aussage über einzelne Effekte
Einen der beiden Prädiktoren weglassen, inhaltlich begründet
Beide Informationen behalten
Zu einer Grösse zusammenfassen, etwa Fläche je Zimmer, oder eine Hauptkomponente bilden
Nicht zulässig ist, nacheinander beide einzeln zu testen und den signifikanten zu berichten.
Fläche und Zimmerzahl sind stark korreliert (r = 0.96, VIF = 12.1). Bei gemeinsamer Aufnahme steigt der Standardfehler der Fläche von 1.17 auf 4.08, und die Zimmerzahl wird nicht signifikant (p = 0.71), obwohl sie allein betrachtet 242 Franken je Zimmer erklärt. Ins Modell aufgenommen wurde die Fläche, weil sie feiner abgestuft ist; die Vorhersagegüte ist von dieser Entscheidung nicht betroffen (R² = 0.487 in beiden Modellen).
Frage und Datenlage
Zu Fläche und Alter kommt die Lage mit drei Stufen: Zentrum, Mittel, Rand. Ein kategorialer Prädiktor mit drei Stufen wird zu zwei Indikatorvariablen; eine Stufe dient als Referenz.
                sum_sq     df         F  PR(>F)
C(lage)   3.495435e+06    2.0   75.5877  0.0000
flaeche   5.956922e+06    1.0  257.6331  0.0000
alter     2.353701e+05    1.0   10.1796  0.0018
Residual  2.658999e+06  115.0       NaN     NaN
Output Zeile für Zeile
Ausgabe
Wert hier
Bedeutung
Wie er zu lesen ist
Referenzstufe
Mittel
die weggelassene Stufe
Sie erscheint nicht in der Ausgabe. R und statsmodels sortieren die Stufen alphabetisch, und Mittel steht vor Rand und Zentrum. Das ist eine reine Zufälligkeit des Alphabets, keine inhaltliche Wahl.
lageRand
-173.26
Differenz Rand gegenüber Mittel
Eine Wohnung am Rand kostet bei gleicher Fläche und gleichem Alter 173 Franken weniger als eine in mittlerer Lage.
lageZentrum
+243.22
Differenz Zentrum gegenüber Mittel
Entsprechend 243 Franken mehr.
Differenz Zentrum zu Rand
416.48
nicht in der Ausgabe
Sie ergibt sich als Differenz der beiden Koeffizienten. Ihr p-Wert steht dort nicht; dafür braucht es einen eigenen Kontrast oder eine andere Referenzstufe.
flaeche Estimate
12.46
Franken je Quadratmeter
Kaum verändert gegenüber Beispiel 1 (12.10), weil die Lage nicht mit der Fläche zusammenhängt.
flaeche Std. Error
0.776
Kleiner als in Beispiel 1 (1.170). Ein zusätzlicher Prädiktor, der Streuung erklärt, macht die übrigen Schätzungen genauer.
Multiple R-squared
0.7783
Sprung von 0.487 auf 0.778.
Residual standard error
152.06
Von 229 auf 152 Franken gefallen.
anova()
gemeinsamer F-Test für lage
Die Frage “spielt die Lage überhaupt eine Rolle” wird mit einem Test über beide Indikatorvariablen beantwortet, nicht mit zwei einzelnen t-Tests.
Zwei p-Werte für eine Frage. Die summary()-Ausgabe liefert je einen t-Test pro Indikatorvariable, also den Vergleich jeder Stufe mit der Referenz. Die Frage “hat die Lage insgesamt einen Einfluss” beantwortet keiner dieser Tests. Dafür ist der F-Test aus anova() da, der beide Indikatorvariablen gemeinsam prüft.
Der Unterschied wird wichtig, wenn eine Stufe wenige Beobachtungen hat: Die einzelnen t-Tests können dann alle unauffällig sein, während der gemeinsame Test anschlägt.
Interpretation und Ergebnissatz
Die Lage ist in diesen Daten der stärkste Einflussfaktor. Bemerkenswert ist der Nebeneffekt: Weil sie viel Streuung erklärt, sinkt die Residualstreuung, und dadurch werden alle Koeffizienten genauer geschätzt. Der Standardfehler der Fläche fällt von 1.17 auf 0.78, ohne dass sich am Schätzwert viel ändert.
Das ist das Gegenstück zu Beispiel 3: Ein Prädiktor, der eigene Information beiträgt, verbessert die Schätzung der anderen; einer, der dieselbe Information noch einmal bringt, verschlechtert sie.
Zur Referenzstufe: Dass hier “Mittel” als Bezugspunkt dient, ist alphabetischer Zufall und passt hier ausnahmsweise gut. Wenn eine andere Stufe inhaltlich der natürliche Bezugspunkt ist, wird sie mit relevel() beziehungsweise Treatment(reference=...) gesetzt, und der Bericht nennt sie ausdrücklich.
Fläche, Alter und Lage erklären zusammen 78 Prozent der Mietunterschiede (n = 120, Residualstreuung 152 Franken). Gegenüber mittlerer Lage kostet eine Wohnung im Zentrum 243 Franken mehr (p < 0.001) und am Rand 173 Franken weniger (p < 0.001), bei gleicher Fläche und gleichem Alter. Je Quadratmeter steigt die Miete um 12.46 Franken (p < 0.001), je Jahr Alter sinkt sie um 3.02 Franken (p = 0.002). Referenzstufe der Lage ist “Mittel”.
Verständnisfragen
Im Output steht für einen Prädiktor Estimate = 11.8, Std. Error = 1.2. Was folgt für das 95-Prozent-Konfidenzintervall?
Es reicht ungefähr von 9.4 bis 14.2 und schliesst die Null nicht ein
Richtig, rund Schätzwert plus minus zwei Standardfehler. Der Koeffizient ist deutlich von null verschieden.
Es reicht von 10.6 bis 13.0
Das ist plus minus ein Standardfehler und entspricht etwa 68 Prozent, nicht 95.
Ohne den p-Wert lässt sich das nicht sagen
Schätzwert und Standardfehler genügen, der p-Wert enthält keine zusätzliche Information darüber.
Der F-Test des Gesamtmodells ist mit p < 0.001 signifikant, R² beträgt 0.71, aber kein einzelner Koeffizient hat einen p-Wert unter 0.05. Was ist die naheliegendste Erklärung?
Ein Rechenfehler, das kann nicht gleichzeitig auftreten
Es kann, und es ist ein bekanntes Muster.
Starke Multikollinearität zwischen den Prädiktoren
Richtig. Gemeinsam erklären sie viel, aber der Beitrag der einzelnen Variable ist nicht trennbar, die Standardfehler werden gross. Prüfen mit VIF.
Das Modell hat zu wenige Prädiktoren
Zusätzliche Variablen würden die Standardfehler eher weiter aufblähen.
Nach Aufnahme eines zweiten Prädiktors fällt der Koeffizient des ersten von 15 auf 4. Was bedeutet das?
Der erste Prädiktor ist unwichtig geworden
Wichtigkeit ist keine Eigenschaft, die sich durch Hinzufügen einer Variablen ändert. Geändert hat sich die Frage, die der Koeffizient beantwortet.
Ein Teil des Zusammenhangs lief über den zweiten Prädiktor
Richtig. Der Koeffizient misst jetzt den Beitrag bei konstant gehaltenem zweitem Prädiktor. Die beiden Grössen hängen zusammen, ein Teil des vorher zugeschriebenen Effekts gehört zum neuen Prädiktor.
Das Modell ist jetzt falsch spezifiziert
Aus der Änderung allein folgt das nicht. Welche Fassung passt, entscheidet die inhaltliche Frage.
Das adjustierte R² sinkt, wenn ein weiterer Prädiktor aufgenommen wird, während das gewöhnliche R² leicht steigt. Was heisst das?
Der Prädiktor erklärt weniger, als seine Kosten an Freiheitsgraden wert sind
Richtig. Das gewöhnliche R² kann durch Hinzufügen nie sinken, das adjustierte schon. Genau deshalb wird für Vergleiche das adjustierte gelesen.
Die Berechnung ist unstimmig
Beide Grössen verhalten sich genau so, wie sie definiert sind.
Der Prädiktor ist mit der Zielvariable negativ korreliert
Die Richtung des Zusammenhangs spielt für R² keine Rolle.