Residuen, Hebelwerte, Ausreisser, VIF und was man bei Verletzungen tut.
Die vier Beispiele rechnen mit vier deterministisch konstruierten Datensätzen. Sie unterscheiden sich in genau einer Eigenschaft, damit sichtbar wird, welche Diagnose worauf anspricht.
Kurzsteckbrief
Fragestellung
Sind die Voraussetzungen eines linearen Modells erfüllt, und wenn nicht, welche und mit welchen Folgen?
Eingang
ein angepasstes Modell aus lm() beziehungsweise smf.ols()
Was die Diagnostik liefert
Residuenplots, Hebelwerte, Cook-Distanzen, studentisierte Residuen, Testverfahren für einzelne Voraussetzungen
Diagnostik ist kein eigener Arbeitsschritt am Ende, sondern gehört zu jedem angepassten Modell. Die Reihenfolge lautet: Modell anpassen, Residuen ansehen, dann Koeffizienten lesen. Wer die Koeffizienten zuerst liest, ist geneigt, die Diagnostik so lange zu deuten, bis sie zum Ergebnis passt.
Sie beantwortet nicht die Frage, ob das Modell inhaltlich sinnvoll ist. Ein Modell kann alle Voraussetzungen erfüllen und trotzdem die falsche Frage beantworten oder eine Scheinbeziehung abbilden.
Die Steigung ist ein Kompromiss und stimmt in keinem Bereich
Streuen die Residuen überall gleich?
Homoskedastizität
Residuenplot, Scale-Location-Plot, Breusch-Pagan
Schätzwerte bleiben brauchbar, Standardfehler und p-Werte nicht
Sind die Residuen annähernd normal?
Normalität der Residuen
QQ-Plot
betrifft Tests und Intervalle, vor allem bei kleinem n
Beeinflussen sich die Beobachtungen?
Unabhängigkeit
Durbin-Watson, Erhebungsdesign
Standardfehler zu klein, p-Werte zu optimistisch
Hängt das Ergebnis an wenigen Punkten?
keine einflussreichen Einzelfälle
Cook-Distanz, Hebelwerte, studentisierte Residuen
Die Aussage hängt an einzelnen Beobachtungen
Nur die erste und die fünfte Frage betreffen die Schätzwerte selbst. Die zweite, dritte und vierte betreffen die Unsicherheit, also Standardfehler, Konfidenzintervalle und p-Werte. Diese Unterscheidung entscheidet darüber, wie dringend eine Verletzung behandelt werden muss.
Die vier Standardplots
plot(modell) in R liefert vier Bilder. Sie beantworten der Reihe nach:
Nummer
Titel
Was er zeigt
Was gut aussieht
1
Residuals vs Fitted
Linearität
strukturlose Wolke um die Nulllinie, keine Krümmung
2
Q-Q Residuals
Normalität
Punkte nah an der Geraden, Abweichungen an den Enden sind üblich
Python hat kein Gegenstück in einem Aufruf; die Plots werden einzeln gebaut.
Output lesen
Kennzahl
Was sie misst
Anhaltspunkt
Falle
Cook-Distanz
wie stark sich alle Vorhersagen ändern, wenn dieser Punkt fehlt
Werte über 1 gelten als auffällig, über 0.5 als beachtenswert
Eine einzelne grosse Cook-Distanz ist ein Befund, viele mittlere sind normal
Hebelwert (leverage)
wie extrem der x-Wert liegt
mehr als das Doppelte oder Dreifache des Mittelwerts \(p/n\)
Hoher Hebel allein schadet nicht, siehe Beispiel 4
studentisiertes Residuum
wie weit der Punkt von seiner eigenen Vorhersage abweicht, in Standardfehlern
Beträge über 3 sind auffällig
misst die y-Richtung, der Hebel die x-Richtung
Breusch-Pagan p
Hinweis auf ungleiche Streuung
grosser p-Wert ist die gute Nachricht
findet nur Streuung, die mit den Prädiktoren zusammenhängt
Durbin-Watson
Korrelation aufeinanderfolgender Residuen
Werte um 2 sind unauffällig, unter 1.5 auffällig
hängt an der Reihenfolge der Zeilen, siehe Beispiel 2
RESET p
Hinweis auf fehlende Nichtlinearität
kleiner p-Wert heisst: das Modell ist fehlspezifiziert
sagt nicht, welcher Prädiktor betroffen ist
VIF
Multikollinearität
über 5 beachten, über 10 kritisch
nur bei mehreren Prädiktoren sinnvoll
Alle diese Tests haben dasselbe Problem wie Normalitätstests: Ihre Aussagekraft hängt am Stichprobenumfang. Bei n = 5000 wird jede belanglose Abweichung signifikant, bei n = 20 bleibt jede grobe unentdeckt. Sie ergänzen die Plots, sie ersetzen sie nicht.
Interpretationsfallen
Ein hohes R² sagt nichts über die Angemessenheit. In Beispiel 2 ist das falsche Modell dasjenige mit dem höheren R².
Nicht jede Verletzung ist gleich schlimm. Ungleiche Streuung verzerrt die Standardfehler, aber nicht die Schätzwerte. Eine übersehene Krümmung verzerrt beides.
Hoher Hebel ist kein Fehler. Ein Punkt weit aussen auf der x-Achse ist wertvoll, solange er auf der Linie der übrigen liegt. Gefährlich ist die Kombination aus hohem Hebel und grossem Residuum.
Ausreisser werden geprüft, nicht entfernt. Das Entfernen ist eine inhaltliche Entscheidung mit Begründung, keine statistische Reinigung.
Durbin-Watson misst die Zeilenreihenfolge. Bei nach x sortierten Daten zeigt er Krümmung an, nicht Autokorrelation.
Die Residuen zählen, nicht die Rohdaten. Weder x noch y müssen normalverteilt sein.
Eine Transformation ändert die Fragestellung. Nach dem Logarithmieren der Zielgrösse beschreibt die Steigung eine relative statt einer absoluten Änderung.
Ergebnis berichten
Die Diagnostik gehört in einen eigenen kurzen Absatz, und zwar vor den Koeffizienten:
Residuen gegen Vorhersage zeigen keine Struktur, der QQ-Plot keine nennenswerte Abweichung, der Breusch-Pagan-Test keinen Hinweis auf ungleiche Streuung (p = [p]). Die grösste Cook-Distanz beträgt [Wert]; einflussreiche Einzelfälle liegen nicht vor.
Bei einer Verletzung gehört dazu, was daraus folgte: welche Kennzahl auffällig war, welche Massnahme gewählt wurde und ob sich das Ergebnis dadurch änderte.
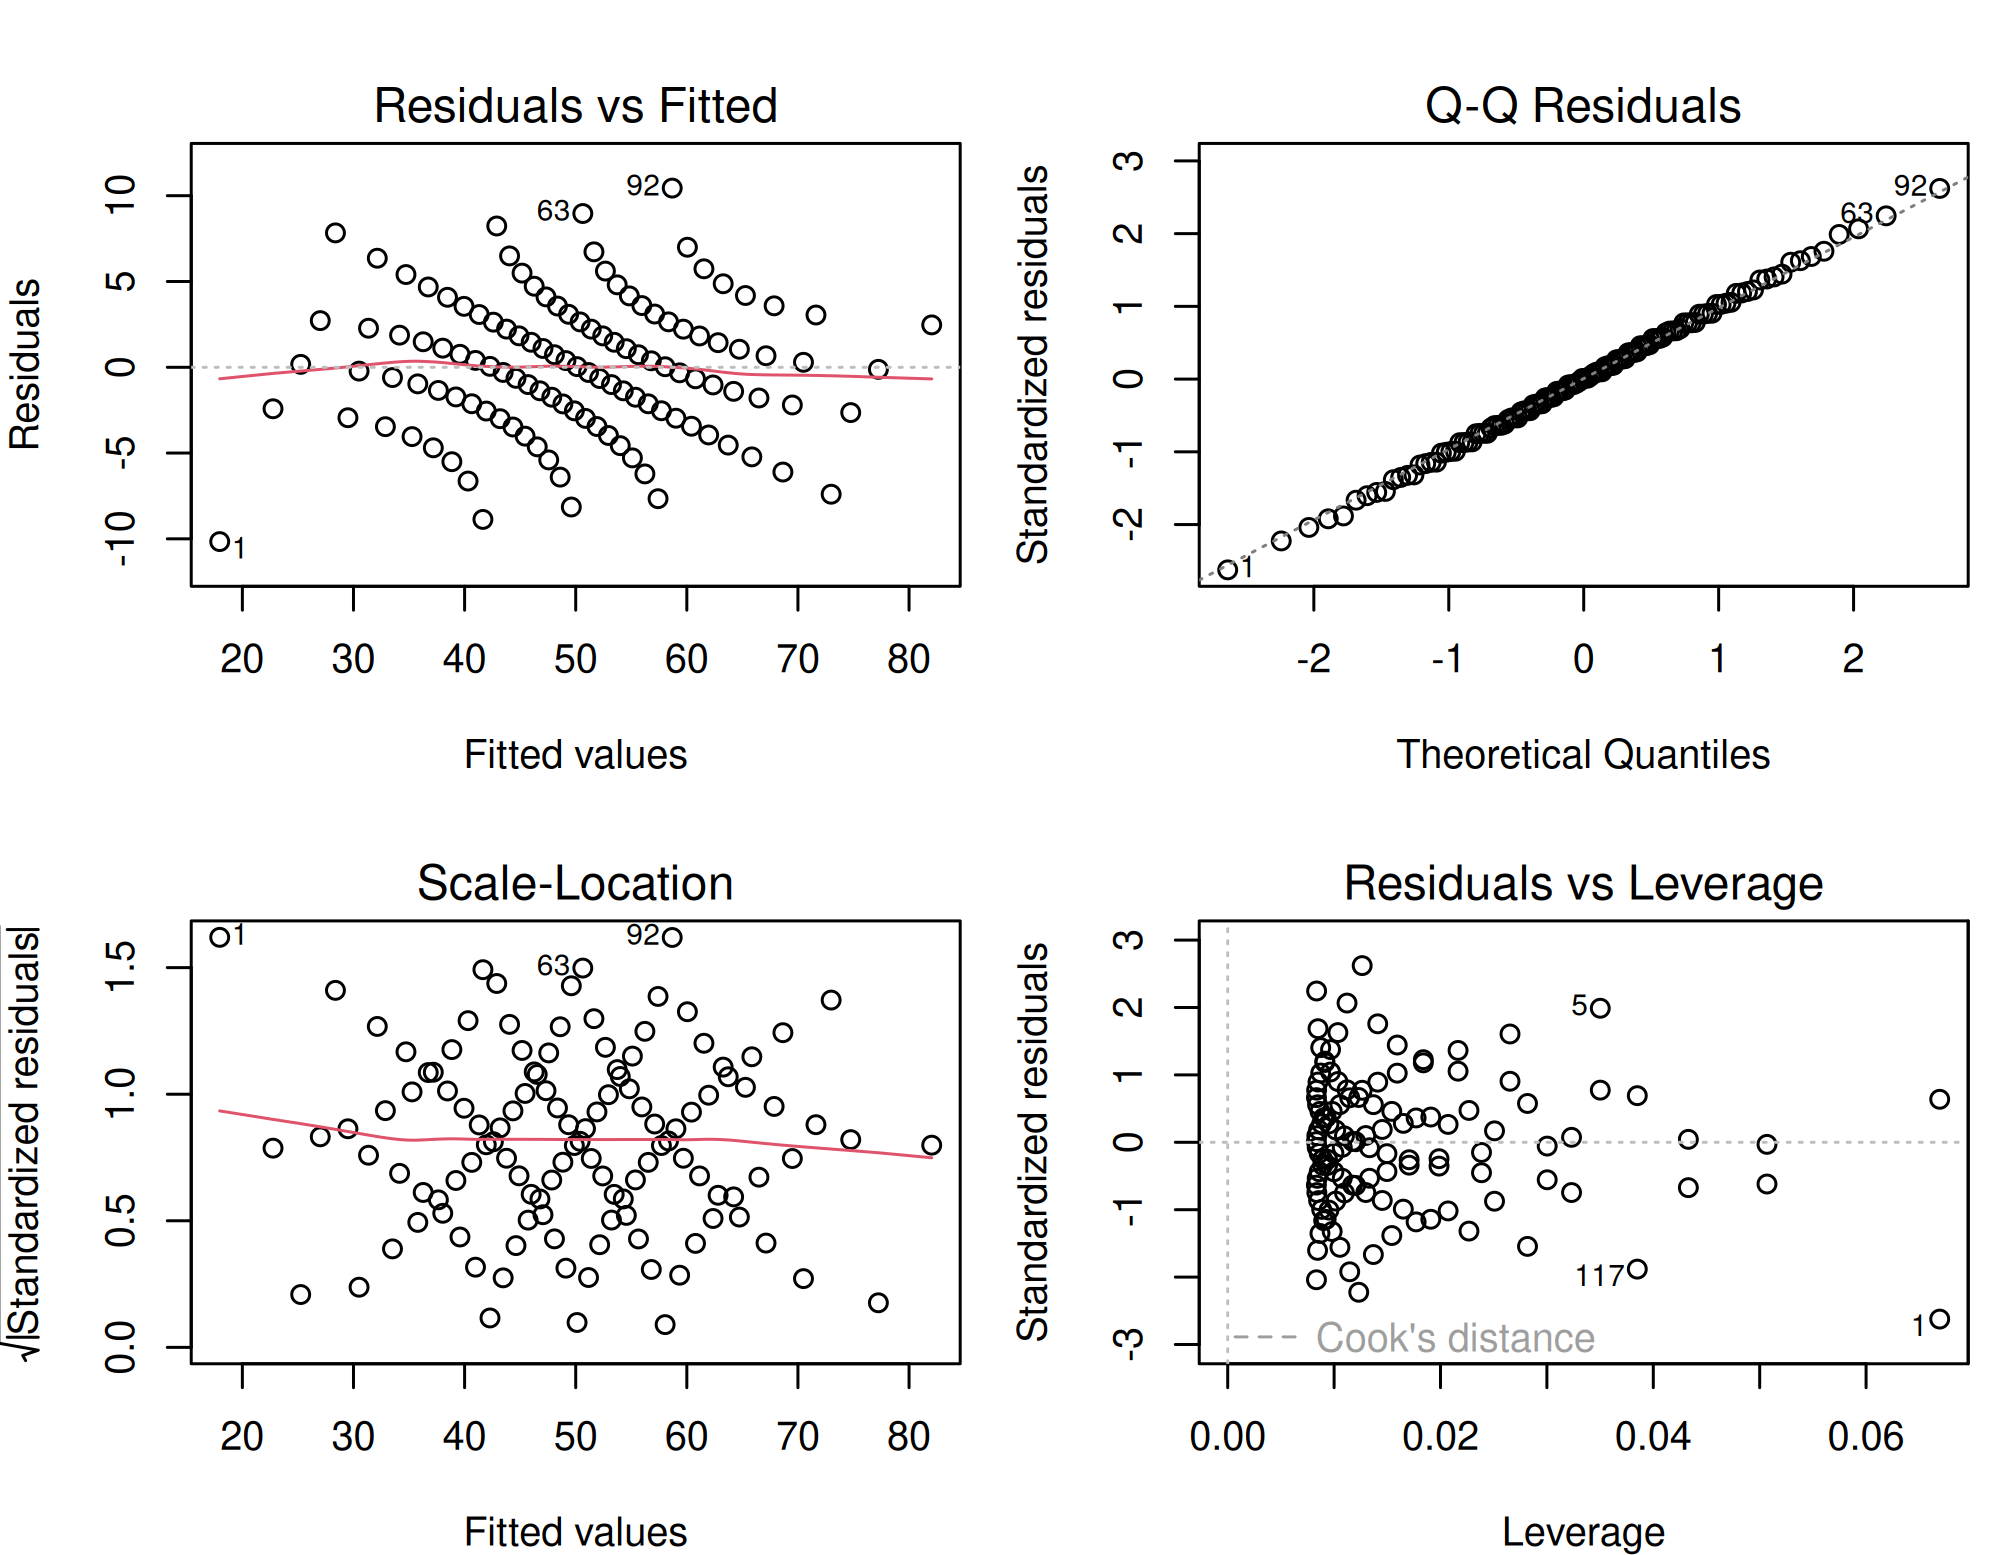
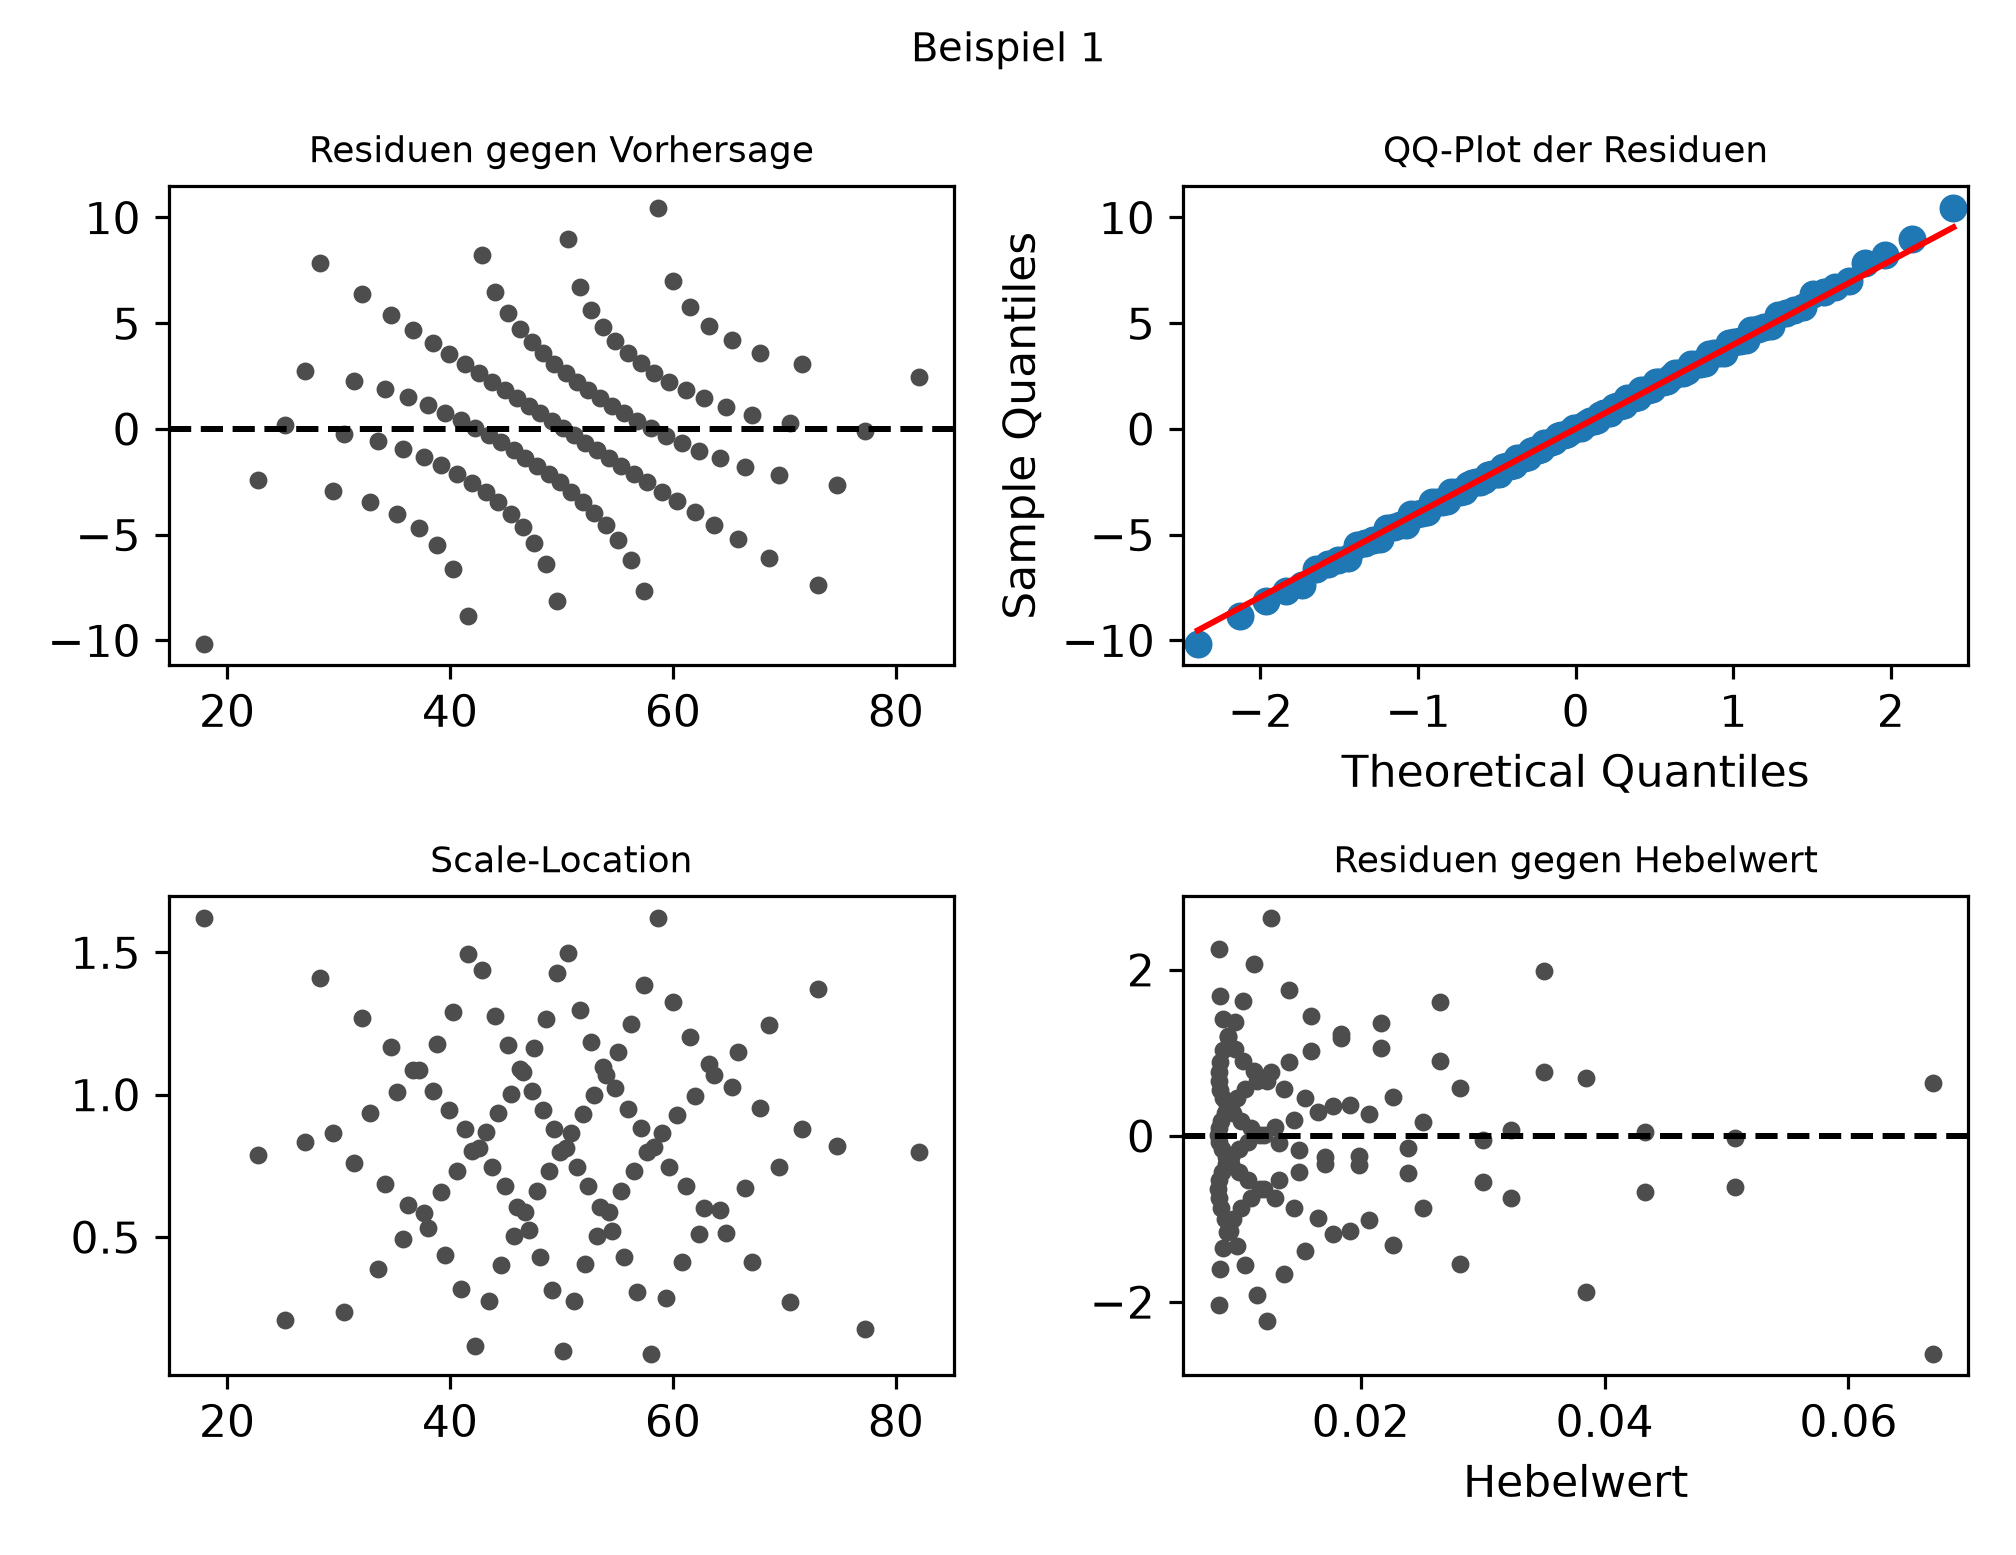
120 Beobachtungen, ein Prädiktor, ein sauber linearer Zusammenhang mit gleichmässiger Streuung. Dieses Beispiel ist der Referenzfall: So sehen die Plots aus, wenn nichts vorliegt.
Kein Hinweis auf ungleiche Streuung. Der grosse p-Wert ist hier die gute Nachricht.
Durbin-Watson
2.123
Um 2 herum, also unauffällig.
RESET p
0.289
Kein Hinweis auf eine fehlende Nichtlinearität.
Shapiro der Residuen p
praktisch 1 (R gibt 1 aus, Python 0.99999)
Unauffällig, und derart nahe an 1, weil die Störgrösse deterministisch aus Normalverteilungsquantilen gebaut ist.
grösste Cook-Distanz
0.247
Weit unter der Schwelle von 1.
grösster Hebelwert
0.0669
Der mittlere Hebel beträgt 0.0167, also 2 geteilt durch 120. Der grösste liegt beim Vierfachen, was bei 120 Punkten am Rand des Wertebereichs normal ist.
grösstes studentisiertes Residuum
-2.69
Unter 3, also unauffällig. Bei 120 Beobachtungen erwartet man einige Werte um 2.5.
Interpretation
Alle vier Plots zeigen das erwartete Bild: strukturlose Wolke, Punkte auf der QQ-Geraden, waagrechte Scale-Location-Linie, keine Punkte ausserhalb der Cook-Konturen. Das Modell darf gelesen werden.
Wichtig ist, dieses Bild einmal gesehen zu haben. Wer nur Verletzungen kennt, neigt dazu, in jedem Residuenplot ein Muster zu erkennen.
Frage und Datenlage
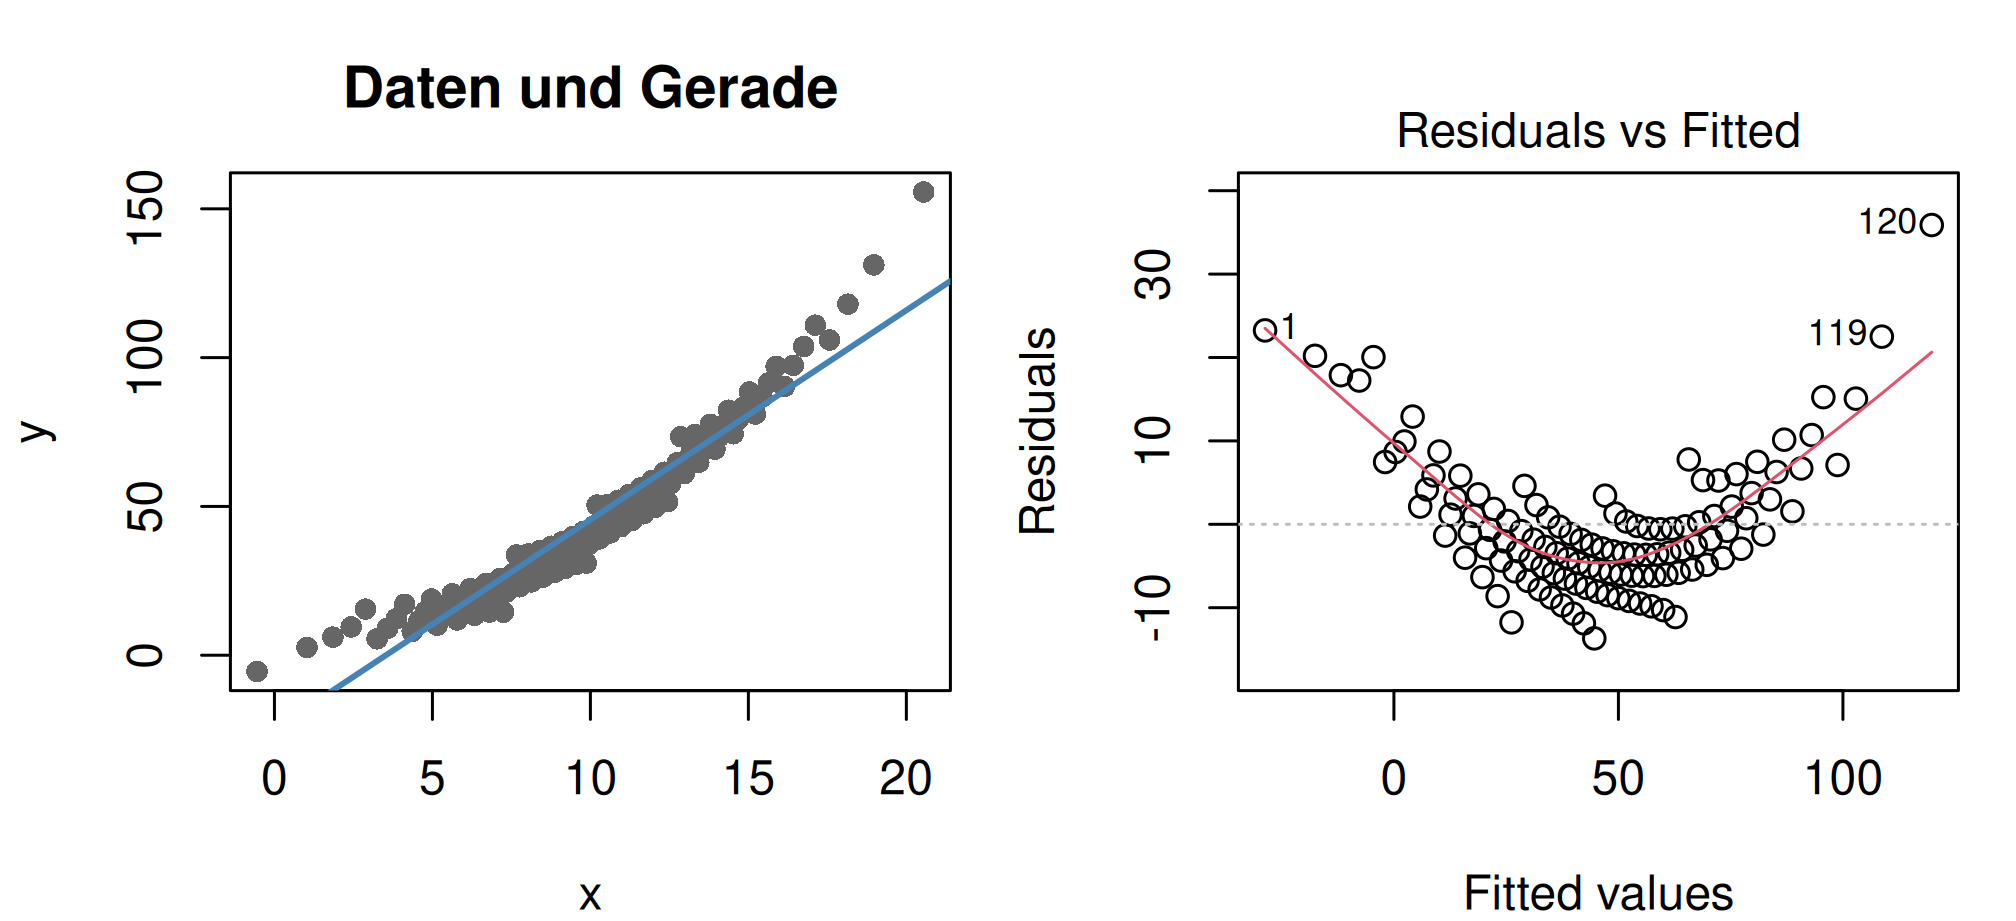
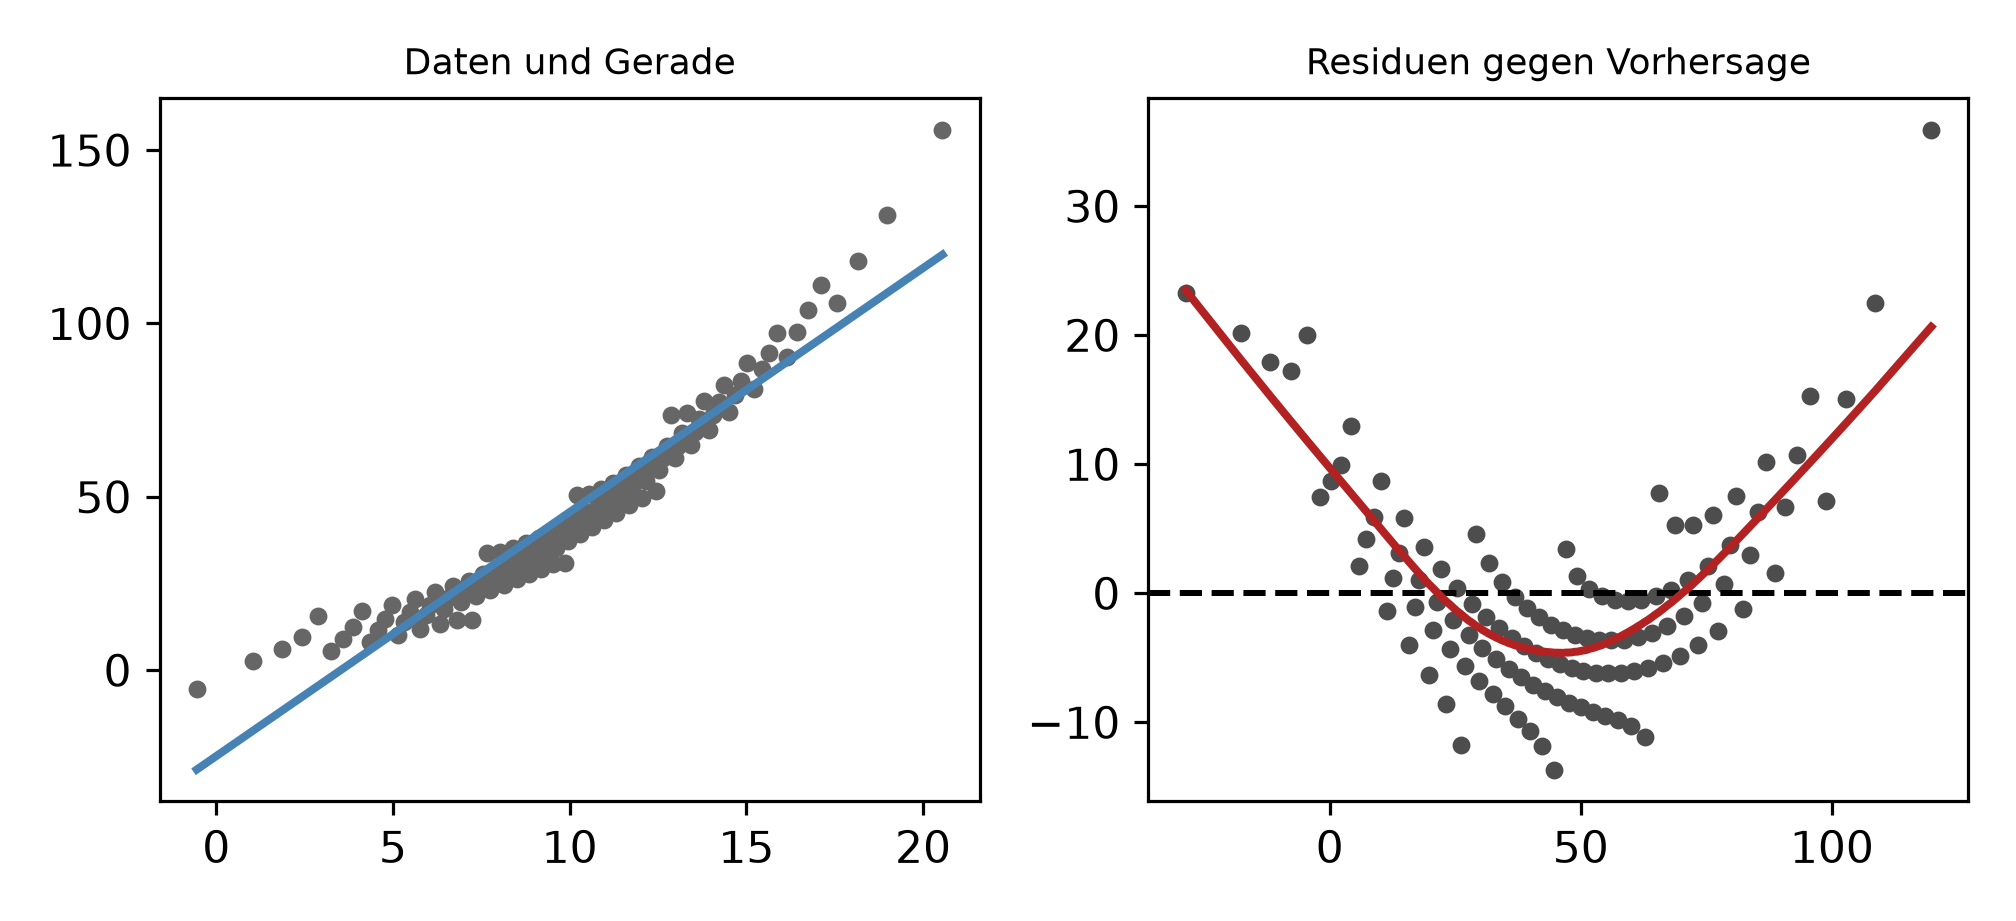
Derselbe Prädiktor, aber der Zusammenhang ist in Wahrheit quadratisch. Angepasst wird trotzdem eine Gerade.
Das falsche Modell hat das höhere R². Wer Modelle nach R² beurteilt, wählt hier die falsche Spezifikation.
Residualstreuung
4.01
8.25
Doppelt so gross. Diese Zahl verrät das Problem, R² nicht.
Breusch-Pagan p
0.315
0.522
Unauffällig. Der Test sucht ungleiche Streuung und findet keine, denn die Streuung ist ja gleichmässig. Er ist für dieses Problem blind.
Durbin-Watson
2.123
0.529
Deutlich auffällig, und zwar aus einem Grund, der Aufmerksamkeit verdient, siehe Kasten.
RESET p
0.289
1.1e-38 (R schreibt < 2.2e-16)
Der Test, der genau für diesen Fall gebaut ist. Er prüft, ob quadrierte Vorhersagewerte noch etwas erklären, und findet massiv etwas.
Shapiro der Residuen p
0.99999
2.8e-07
Ebenfalls auffällig, aber irreführend: Die Residuen sind nicht deshalb nicht normalverteilt, weil die Störgrösse es nicht wäre, sondern weil sie den systematischen Bogen enthalten.
Warum Durbin-Watson hier anschlägt, obwohl es keine Zeitreihe ist. Der Test misst, ob aufeinanderfolgende Residuen einander ähneln, und “aufeinanderfolgend” heisst: in der Reihenfolge der Zeilen. In diesen Daten sind die Zeilen nach x sortiert. Der Bogen im Residuenplot führt dann dazu, dass benachbarte Zeilen ähnliche Residuen haben, und genau das misst Durbin-Watson.
Praktisch heisst das zweierlei. Bei nach einem Prädiktor sortierten Daten ist ein kleiner Durbin-Watson-Wert ein Hinweis auf Krümmung, nicht auf Autokorrelation. Und umgekehrt: Wer echte Autokorrelation prüfen will, muss die Zeilen in ihrer zeitlichen Reihenfolge haben, sonst misst der Test etwas anderes.
Interpretation und Ergebnissatz
Die Lehre dieses Beispiels ist die Arbeitsteilung der Diagnosen: Breusch-Pagan schweigt, RESET schlägt Alarm, Durbin-Watson schlägt aus einem anderen Grund Alarm als vermutet, und R² zeigt in die falsche Richtung. Kein einzelnes Mass deckt alle Verletzungen ab.
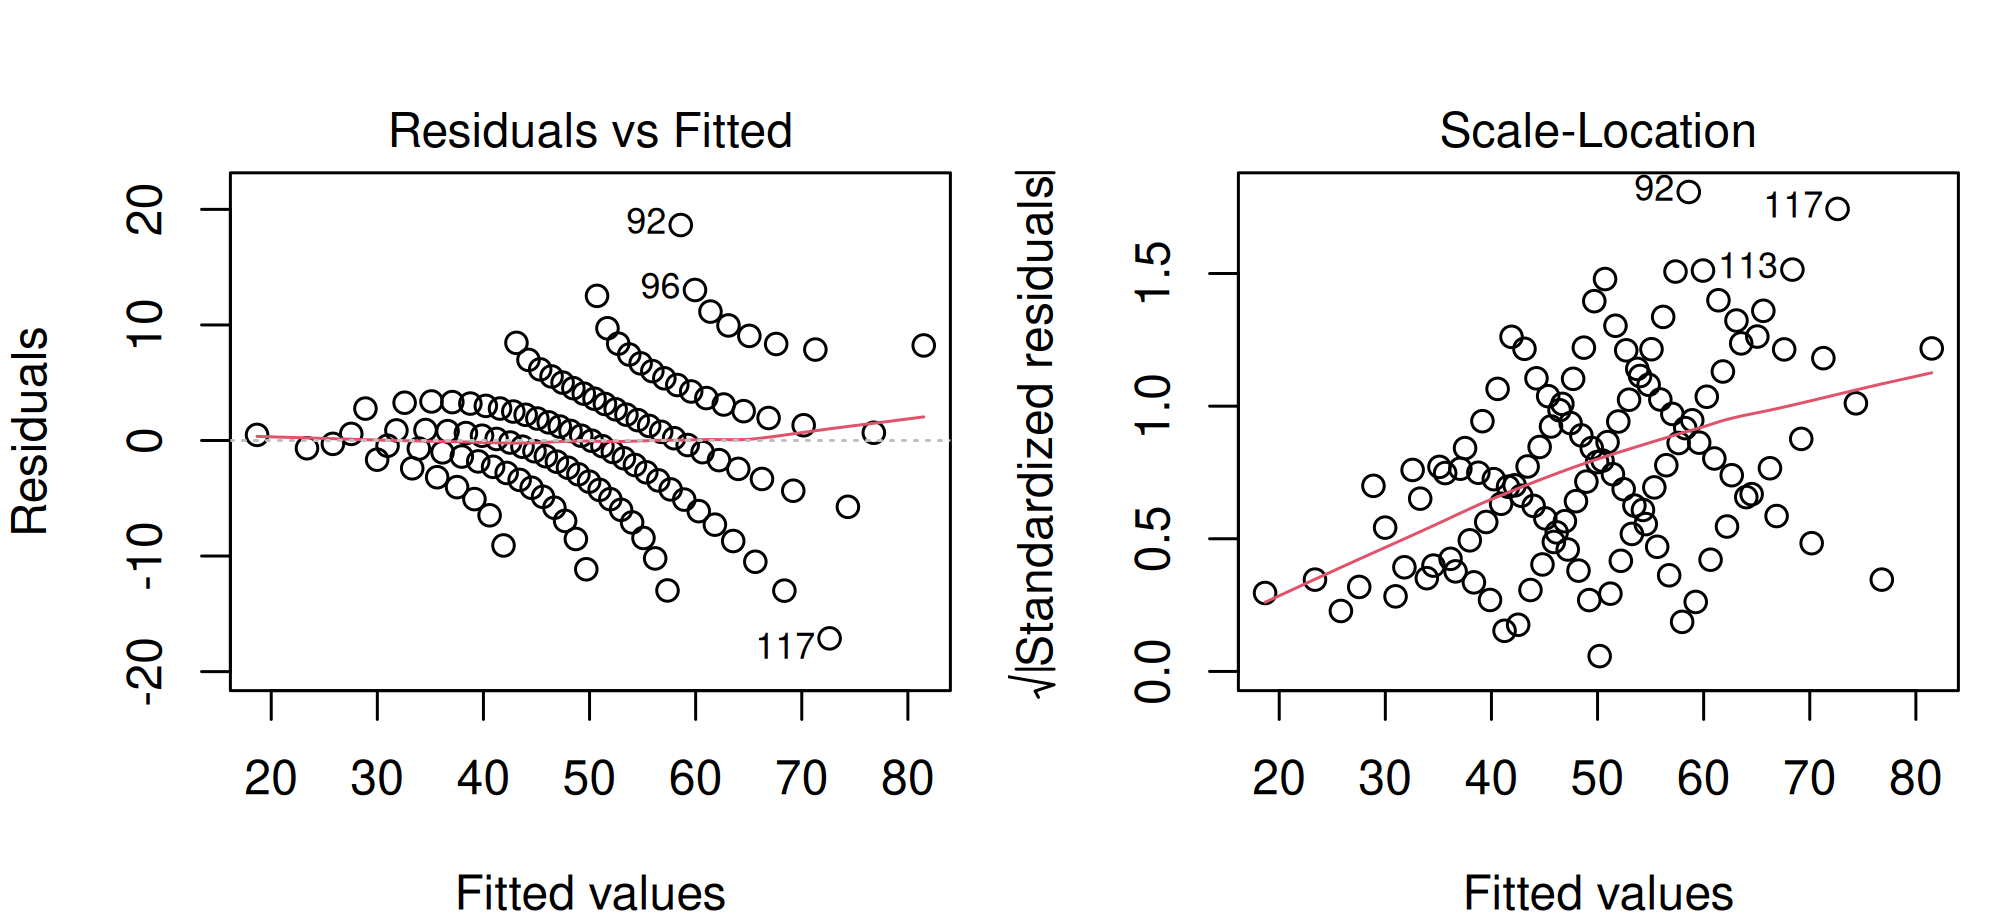
Der Residuenplot zeigt alles auf einen Blick: Die Residuen sind an den Rändern positiv und in der Mitte negativ, die Glättungslinie bildet einen deutlichen Bogen.
Das Vorgehen: einen quadratischen Term aufnehmen, transformieren oder ein anderes Modell wählen, und danach die Residuen erneut ansehen.
Ein rein lineares Modell beschreibt den Zusammenhang nicht angemessen. Der RESET-Test ist deutlich signifikant (F(1, 117) = 382.5, p < 0.001), und die Residuen zeigen einen ausgeprägten Bogen. Das höhere R² gegenüber dem korrekt spezifizierten Modell (0.921 gegenüber 0.902) ist kein Gütezeichen. Berichtet wird das Modell mit quadratischem Term.
Frage und Datenlage
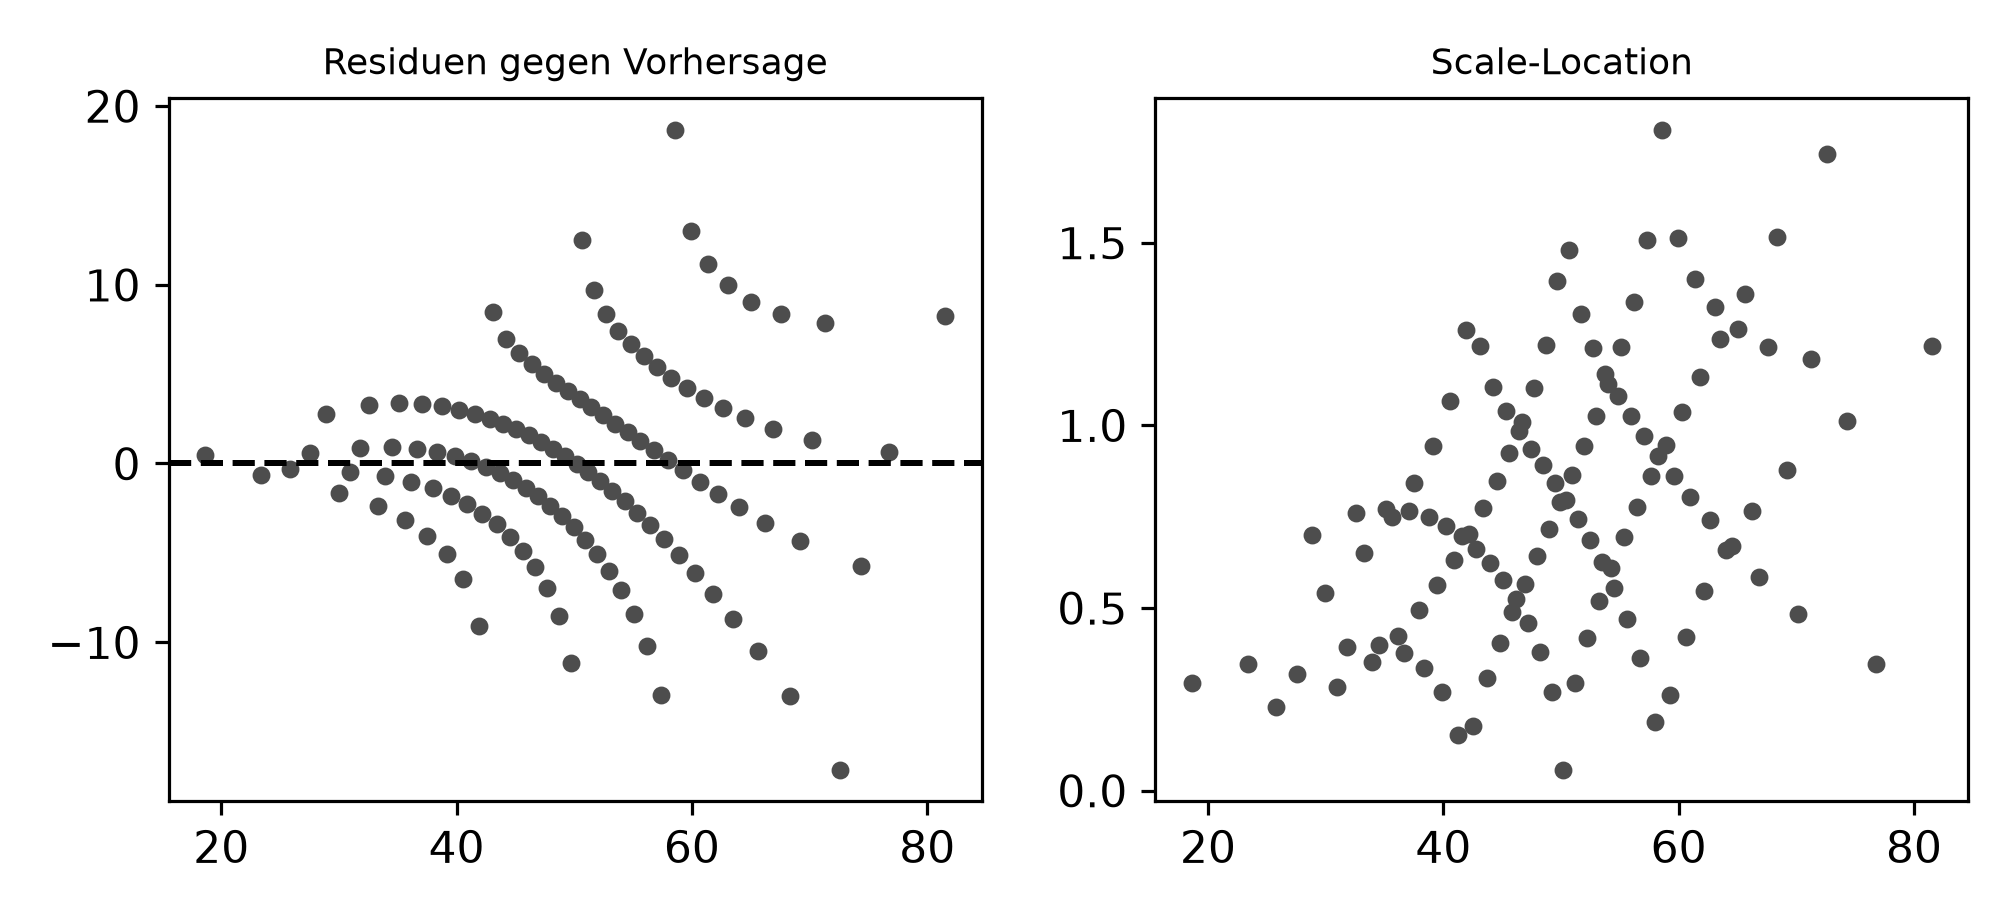
Der Zusammenhang ist geradlinig, aber die Streuung wächst mit x: Bei kleinen x-Werten liegen die Punkte eng an der Geraden, bei grossen weit auseinander. Das ist der häufigste Fall in wirtschaftlichen Daten, wo Beträge und ihre Schwankung gemeinsam wachsen.
modell_c <-lm(y ~ x, data = trichter)par(mfrow =c(1, 2), mar =c(4, 4, 3, 1))plot(modell_c, which =1)plot(modell_c, which =3)par(mfrow =c(1, 1))bptest(modell_c)
    studentized Breusch-Pagan test

data:  modell_c
BP = 16.283, df = 1, p-value = 5.455e-05
           Schätzwert  SE gewöhnlich  SE robust (HC3)
Intercept     20.3029         1.4183           1.1505
x              2.9777         0.1318           0.1389
Output Zeile für Zeile
Kennzahl
Wert hier
Wie er zu lesen ist
Breusch-Pagan p
0.0000546
Auffällig. Der Test, der für diesen Fall gebaut ist, findet ihn.
RESET p
0.934
Unauffällig, korrekt: Der Zusammenhang ist ja geradlinig.
Shapiro der Residuen p
0.620
Ebenfalls unauffällig. Die Residuen sind normalverteilt, nur nicht gleich stark streuend.
Steigung
2.978
Praktisch unverändert gegenüber Beispiel 1 (3.037).
Standardfehler gewöhnlich
0.132
Standardfehler robust (HC3)
siehe Ausgabe
Die interessante Gegenüberstellung: Der Schätzwert bleibt derselbe, nur die Unsicherheit wird anders beziffert.
Der Residuenplot zeigt den namensgebenden Trichter: Die Punkte fächern nach rechts auf. Der Scale-Location-Plot macht dasselbe deutlicher, weil er die Beträge aufträgt und die Glättungslinie dann sichtbar ansteigt statt waagrecht zu verlaufen.
Interpretation und Ergebnissatz
Ungleiche Streuung ist die harmloseste der Verletzungen, weil sie die Schätzwerte nicht verzerrt. Die Steigung von 2.98 ist so brauchbar wie im sauberen Fall. Verzerrt sind nur die Standardfehler, und damit Konfidenzintervalle und p-Werte.
Drei Wege stehen offen:
Weg
Wann er passt
Robuste Standardfehler (HC3)
der Standardweg; Schätzwerte bleiben, nur die Unsicherheit wird korrekt beziffert
Zielgrösse logarithmieren
wenn die Streuung proportional zum Niveau wächst; ändert aber die Bedeutung der Steigung
Gewichtete Regression
wenn die Streuungsstruktur bekannt ist
In R braucht der erste Weg das Zusatzpaket sandwich zusammen mit lmtest::coeftest(); in Python genügt cov_type="HC3" beim Anpassen.
Der Breusch-Pagan-Test zeigt ungleiche Streuung (LM = 16.28, p < 0.001), und der Residuenplot fächert nach rechts auf. Die Schätzwerte sind davon nicht betroffen; berichtet werden robuste Standardfehler nach HC3. Linearität (RESET p = 0.93) und Normalität der Residuen (Shapiro p = 0.62) sind erfüllt.
Frage und Datenlage
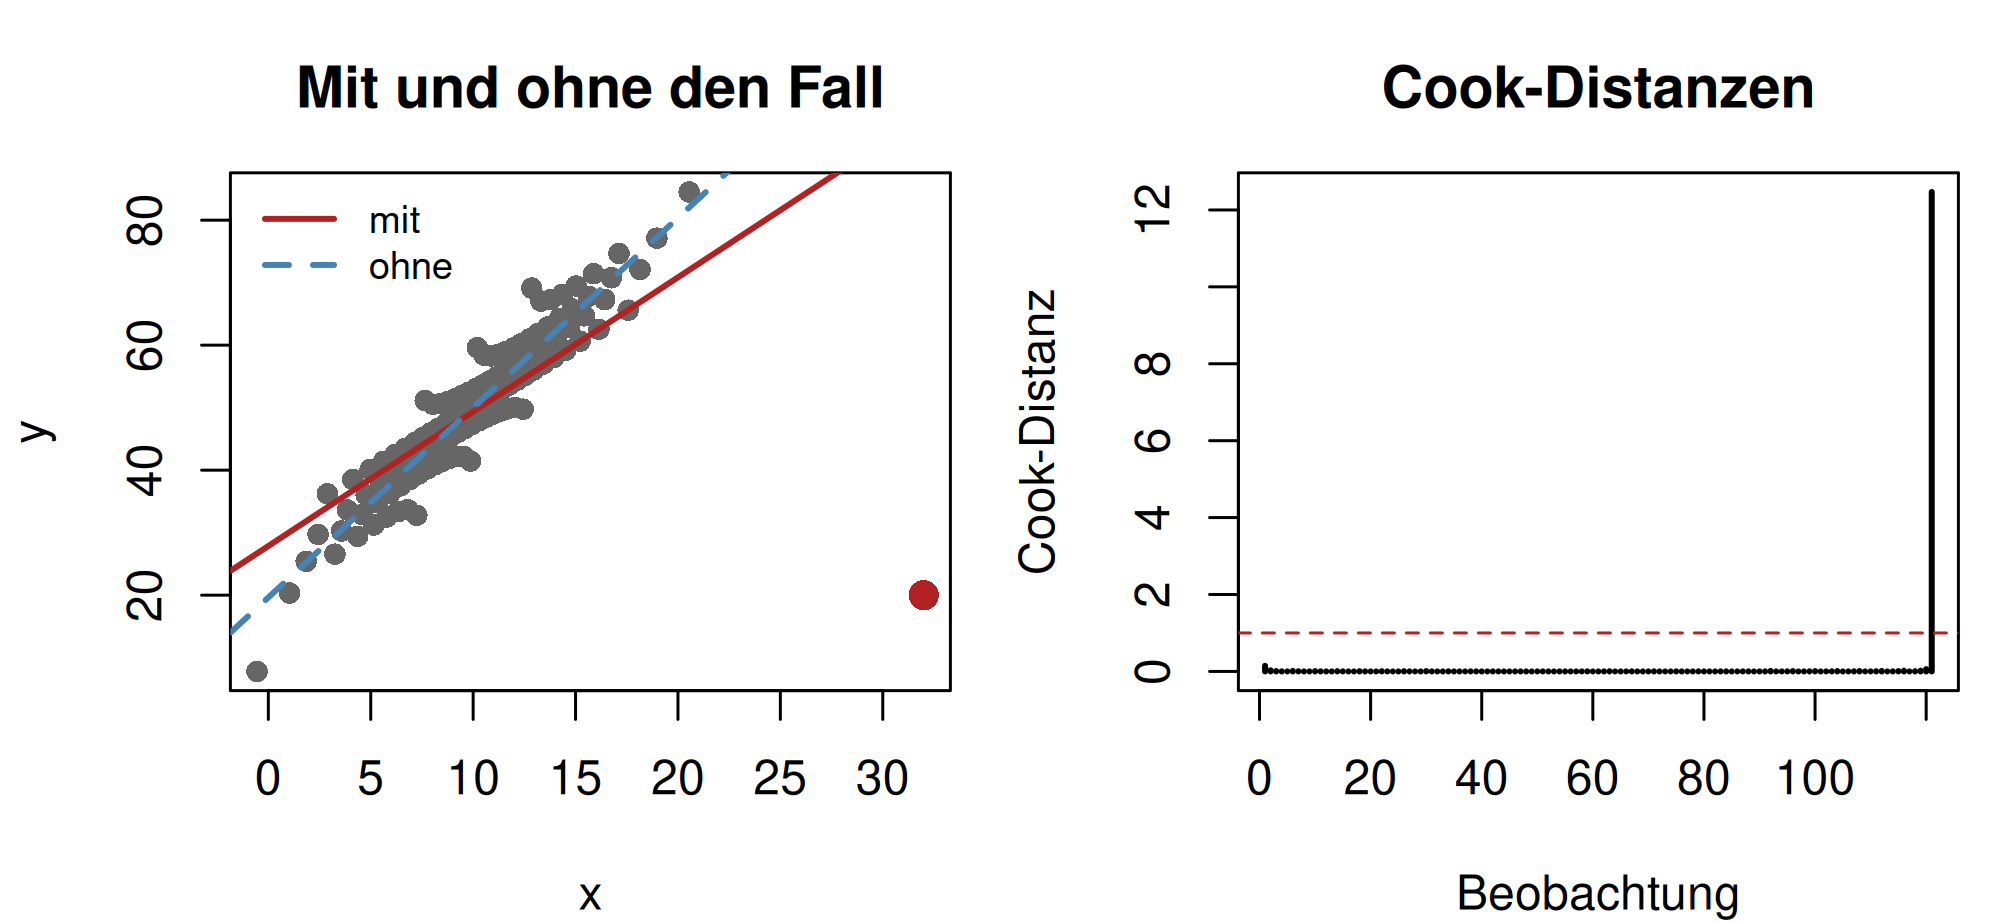
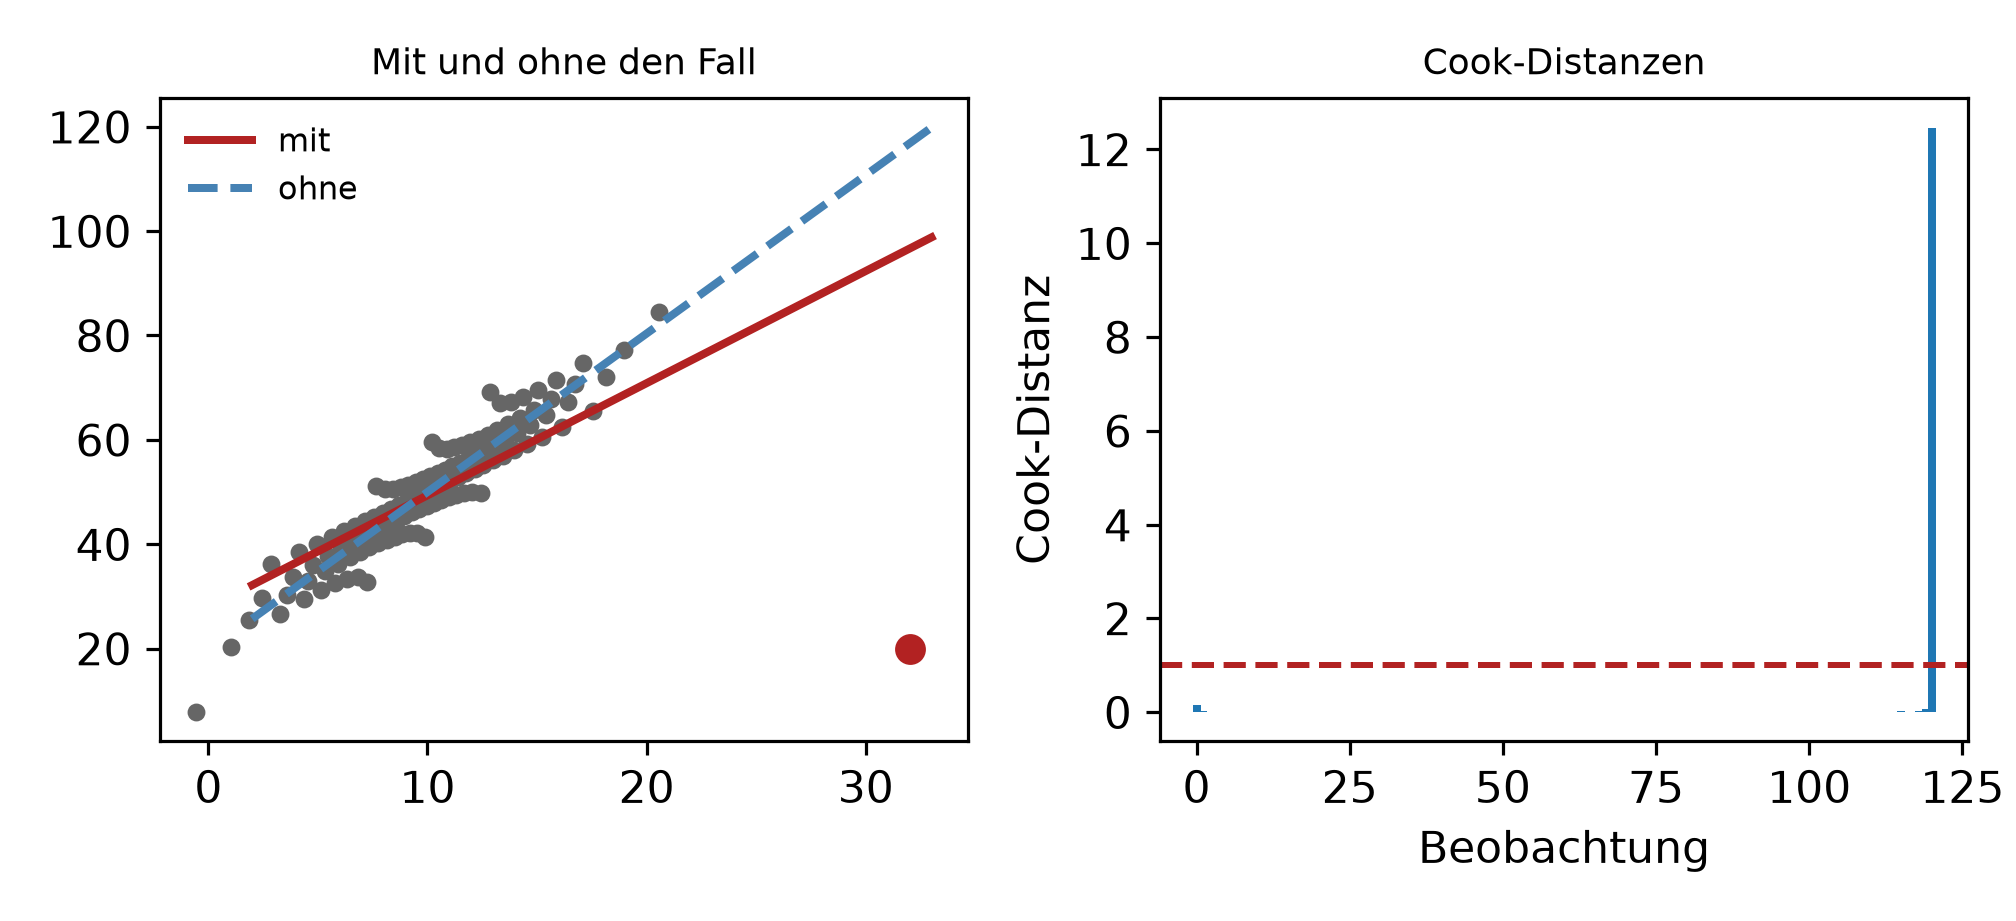
Die sauberen Daten aus Beispiel 1, ergänzt um eine einzige Beobachtung: x = 32, also weit rechts ausserhalb des beobachteten Bereichs von rund 2 bis 18, und y = 20, also weit unterhalb der Geraden.
print("Breusch-Pagan p =", het_breuschpagan(modell_d.resid, modell_d.model.exog)[1])
Breusch-Pagan p = 9.564024480342477e-07
print("RESET p =", linear_reset(modell_d, power=2, use_f=True).pvalue)
RESET p = 9.873700108167648e-28
Output Zeile für Zeile
Kennzahl
Ohne den Fall
Mit dem Fall
Wie das zu lesen ist
Steigung
3.037
2.149
Ein Punkt von 121 senkt die Steigung um knapp ein Drittel.
R²
0.9023
0.5413
Von 90 auf 54 Prozent.
Residualstreuung
4.01
8.85
Mehr als verdoppelt.
grösste Cook-Distanz
0.247
12.467
Die Schwelle liegt bei 1. Der Wert liegt eine Grössenordnung darüber, und die übrigen 120 Werte verschwinden im Diagramm optisch auf der Nulllinie.
grösster Hebelwert
0.0669
0.2083
Der mittlere Hebel beträgt 0.0165; dieser Punkt hat den 12.6-fachen Wert.
grösstes studentisiertes Residuum
-2.69
-21.48
Der Punkt liegt 21 Standardfehler unter seiner eigenen Vorhersage.
Breusch-Pagan p
0.315
0.0000010
Auffällig geworden, ohne dass sich an der Streuungsstruktur etwas geändert hätte.
RESET p
0.289
9.9e-28
Ebenfalls.
Ein einzelner Punkt lässt alle Tests anschlagen. Breusch-Pagan, RESET und Shapiro sind in Beispiel 1 unauffällig und hier alle drei hochsignifikant, obwohl sich an Streuungsstruktur, Linearität und Verteilung nichts geändert hat.
Daraus folgt eine Reihenfolge für die Diagnostik: zuerst nach einflussreichen Punkten sehen, dann die übrigen Tests lesen. Andernfalls behandelt man eine Krümmung oder eine Streuungsstruktur, die es gar nicht gibt.
Interpretation und Ergebnissatz
Hebel und Cook-Distanz messen Verschiedenes, und beide werden hier gebraucht. Der Hebel von 0.21 sagt: Der Punkt liegt weit aussen auf der x-Achse. Für sich genommen wäre das unproblematisch; ein weit aussen liegender Punkt auf der Linie der übrigen macht die Schätzung sogar genauer. Das studentisierte Residuum von -21.5 sagt: Er liegt zugleich weit von seiner Vorhersage entfernt. Erst die Kombination ergibt die Cook-Distanz von 12.5.
Was jetzt zu tun ist, ist keine statistische Frage:
Befund zur Ursache
Vorgehen
Erfassungsfehler
ausschliessen, Ausschluss und Begründung berichten
Gültig, aber ausserhalb der Fragestellung
ausschliessen, Grundgesamtheit enger fassen
Gültig, Ursache unklar
Ergebnis mit und ohne den Fall berichten
Eine von 121 Beobachtungen ist stark einflussreich (Cook-Distanz 12.5, Hebelwert 0.21 gegenüber einem mittleren Hebel von 0.017, studentisiertes Residuum -21.5). Sie senkt die Steigung von 3.04 auf 2.15 und R² von 0.90 auf 0.54. Zugleich werden Breusch-Pagan, RESET und der Shapiro-Test auf die Residuensignifikant, obwohl die übrigen 120 Beobachtungen unauffällig sind. Der Fall wurde als Messfehler ausgeschlossen; berichtet wird das Modell ohne ihn.
Verständnisfragen
Ein Modell hat R² = 0.92, ein konkurrierendes mit anderer Spezifikation R² = 0.90. Der Residuenplot des ersten zeigt einen Bogen. Welches ist besser?
Das zweite, trotz kleinerem R²
Richtig. R² misst erklärte Streuung, nicht Angemessenheit. Ein Modell mit übersehener Krümmung kann ein höheres R² haben als das korrekt spezifizierte, wie Beispiel 2 zeigt. Der Residuenplot und die Residualstreuung entscheiden.
Das erste, R² ist das Gütemass
Dann würde man systematisch die falsche Spezifikation wählen.
Nicht entscheidbar ohne p-Werte
Die p-Werte sind bei einem fehlspezifizierten Modell ohnehin nicht vertrauenswürdig.
Der Breusch-Pagan-Test ist unauffällig, der RESET-Test hochsignifikant. Was liegt vor?
Eine übersehene Nichtlinearität, keine ungleiche Streuung
Richtig. Die beiden Tests prüfen verschiedene Voraussetzungen. Breusch-Pagan sucht ungleiche Streuung, RESET sucht fehlende Terme im Modell. Dass der eine schweigt, sagt nichts über den anderen.
Ein Widerspruch, einer der beiden Tests muss falsch sein
Sie widersprechen sich nicht, sie beantworten verschiedene Fragen.
Ungleiche Streuung, die der Test übersehen hat
Möglich, aber der RESET-Test wäre dafür der falsche Anzeiger.
Eine Beobachtung hat einen Hebelwert von 0.21 bei einem mittleren Hebel von 0.017, aber ein studentisiertes Residuum von 0.3. Ist sie ein Problem?
Nein, sie liegt weit aussen und trotzdem auf der Linie der übrigen
Richtig. Hoher Hebel allein ist unproblematisch und macht die Schätzung sogar genauer. Gefährlich ist die Kombination aus hohem Hebel und grossem Residuum, und genau die misst die Cook-Distanz.
Ja, jeder Hebel über dem Dreifachen des Mittelwerts ist kritisch
Die Faustregel markiert Punkte, die man ansehen sollte, nicht solche, die man entfernen muss.
Ja, weil sie ausserhalb des Datenbereichs liegt
Ausserhalb des Bereichs liegt sie nicht, sie liegt an dessen Rand; und das ist zulässig.
Die Daten sind nach dem Prädiktor sortiert, und Durbin-Watson liefert 0.53. Was folgt daraus?
Ein Hinweis auf Krümmung, nicht auf Autokorrelation
Richtig. Durbin-Watson misst die Ähnlichkeit aufeinanderfolgender Zeilen. Bei nach x sortierten Daten führt ein Bogen im Residuenverlauf genau zu diesem Bild. Für echte Autokorrelation müssten die Zeilen zeitlich geordnet sein.
Die Beobachtungen sind voneinander abhängig
Das wäre der Schluss bei zeitlich geordneten Daten.
Der Test ist bei sortierten Daten nicht anwendbar
Anwendbar ist er, er misst nur etwas anderes als erwartet.