Lineare Algebra für die Hauptkomponentenanalyse

Multivariate Verfahren
R
Python
Matrizen als Abbildungen, Eigenwerte und Eigenvektoren und was die PCA daraus macht.

Kernideen

  • Eine Matrix ist eine Abbildung: Sie nimmt einen Punkt und verschiebt ihn.
  • Eigenvektoren sind die Richtungen, die diese Abbildung nicht dreht, sie werden nur gestreckt, und der Streckfaktor ist der Eigenwert.
  • Die Kovarianzmatrix ist die Abbildung, um die es in der PCA geht. Ihre Eigenvektoren sind die Hauptkomponenten, ihre Eigenwerte die Varianzen entlang dieser Richtungen.
  • Die Summe der Eigenwerte ist die Spur der Matrix und damit die Gesamtvarianz. Deshalb lässt sich “Anteil erklärter Varianz” überhaupt ausrechnen.
  • Eigenvektoren symmetrischer Matrizen stehen senkrecht aufeinander, deshalb sind Hauptkomponenten unkorreliert.
  • Ein Eigenwert von null bedeutet, dass eine Variable eine exakte Linearkombination der anderen ist.

Erklärung

Vorwissen: Korrelation und Distanzmasse. Diese Seite liefert den Unterbau für die Hauptkomponentenanalyse und die Faktorenanalyse.

Eine Matrix ist eine Abbildung

Ein Vektor ist ein Punkt, eine Matrix macht daraus einen anderen Punkt. Die Multiplikation \(A\mathbf{v}\) ist keine Zahlenschieberei, sondern eine geometrische Operation: Streckung, Drehung, Scherung oder eine Mischung davon.

Zwei Kennzahlen fassen eine solche Abbildung zusammen:

  • Die Determinante sagt, wie sich die Fläche (im Raum: das Volumen) ändert. Determinante 1 heisst flächentreu, Determinante 0 heisst, dass alles auf eine Linie zusammenfällt.
  • Die Spur ist die Summe der Diagonalelemente. Bei einer Kovarianzmatrix ist das die Summe der Varianzen, also die Gesamtvarianz.

Eigenvektoren und Eigenwerte

Die meisten Richtungen werden von einer Abbildung gedreht. Einige nicht, diese heissen Eigenvektoren:

\[A\mathbf{v} = \lambda \mathbf{v}\]

Der Vektor \(\mathbf{v}\) zeigt nach der Abbildung noch in dieselbe Richtung, nur um den Faktor \(\lambda\) gestreckt. Gefunden werden die Eigenwerte über

\[\det(A - \lambda I) = 0,\]

bei einer \(2\times 2\)-Matrix also über eine quadratische Gleichung, deren Koeffizienten Spur und Determinante sind:

\[\lambda^2 - \operatorname{spur}(A)\,\lambda + \det(A) = 0\]

Daraus folgen zwei Merksätze, die auf jeder Grösse gelten:

\[\sum_i \lambda_i = \operatorname{spur}(A) \qquad \prod_i \lambda_i = \det(A)\]

Was das mit der PCA zu tun hat

Die Kovarianzmatrix \(S\) ist symmetrisch und positiv semidefinit. Daraus folgt alles, was die PCA braucht:

Eigenschaft der Matrix Folge für die PCA
symmetrisch alle Eigenwerte sind reell
symmetrisch Eigenvektoren stehen senkrecht aufeinander → Hauptkomponenten sind unkorreliert
positiv semidefinit alle Eigenwerte sind \(\ge 0\) → es gibt keine negative Varianz
Spur = Gesamtvarianz \(\lambda_i / \sum \lambda_j\) ist der Anteil erklärter Varianz
Eigenwert \(= 0\) eine Variable ist eine exakte Linearkombination der anderen

Die PCA ist damit kein neues Verfahren, sondern die Eigenzerlegung der Kovarianz- oder Korrelationsmatrix, in Statistiksprache übersetzt.

Beispiele

Frage und Datenlage

Vier einfache \(2\times 2\)-Matrizen und derselbe Punkt \((1, 1)\). Was passiert?

Rechnung

A <- matrix(c(2, 1, 1, 3), nrow = 2)          # symmetrisch
streckung <- matrix(c(3, 0, 0, 0.5), nrow = 2)
drehung <- matrix(c(0, 1, -1, 0), nrow = 2)   # 90 Grad
scherung <- matrix(c(1, 0, 1.5, 1), nrow = 2)

punkte <- rbind(c(1, 0), c(0, 1), c(1, 1), c(1, -1), c(2, 1))
cbind(punkte, abgebildet = punkte %*% t(A))
     [,1] [,2] [,3] [,4]
[1,]    1    0    2    1
[2,]    0    1    1    3
[3,]    1    1    3    4
[4,]    1   -1    1   -2
[5,]    2    1    5    5
for (nm in c("A", "streckung", "drehung", "scherung")) {
  M <- get(nm)
  cat(sprintf("%-10s det = %5.2f  spur = %5.2f  (1,1) -> (%.2f, %.2f)\n",
              nm, det(M), sum(diag(M)),
              (M %*% c(1, 1))[1], (M %*% c(1, 1))[2]))
}
A          det =  5.00  spur =  5.00  (1,1) -> (3.00, 4.00)
streckung  det =  1.50  spur =  3.50  (1,1) -> (3.00, 0.50)
drehung    det =  1.00  spur =  0.00  (1,1) -> (-1.00, 1.00)
scherung   det =  1.00  spur =  2.00  (1,1) -> (2.50, 1.00)
quadrat <- rbind(c(0, 0), c(1, 0), c(1, 1), c(0, 1), c(0, 0))
bild <- quadrat %*% t(A)
ggplot() +
  geom_path(data = data.frame(quadrat), aes(X1, X2), linetype = "dashed") +
  geom_path(data = data.frame(bild), aes(X1, X2), linewidth = 0.9) +
  coord_equal() +
  labs(x = "", y = "", subtitle = "gestrichelt: Einheitsquadrat, durchgezogen: Bild unter A")
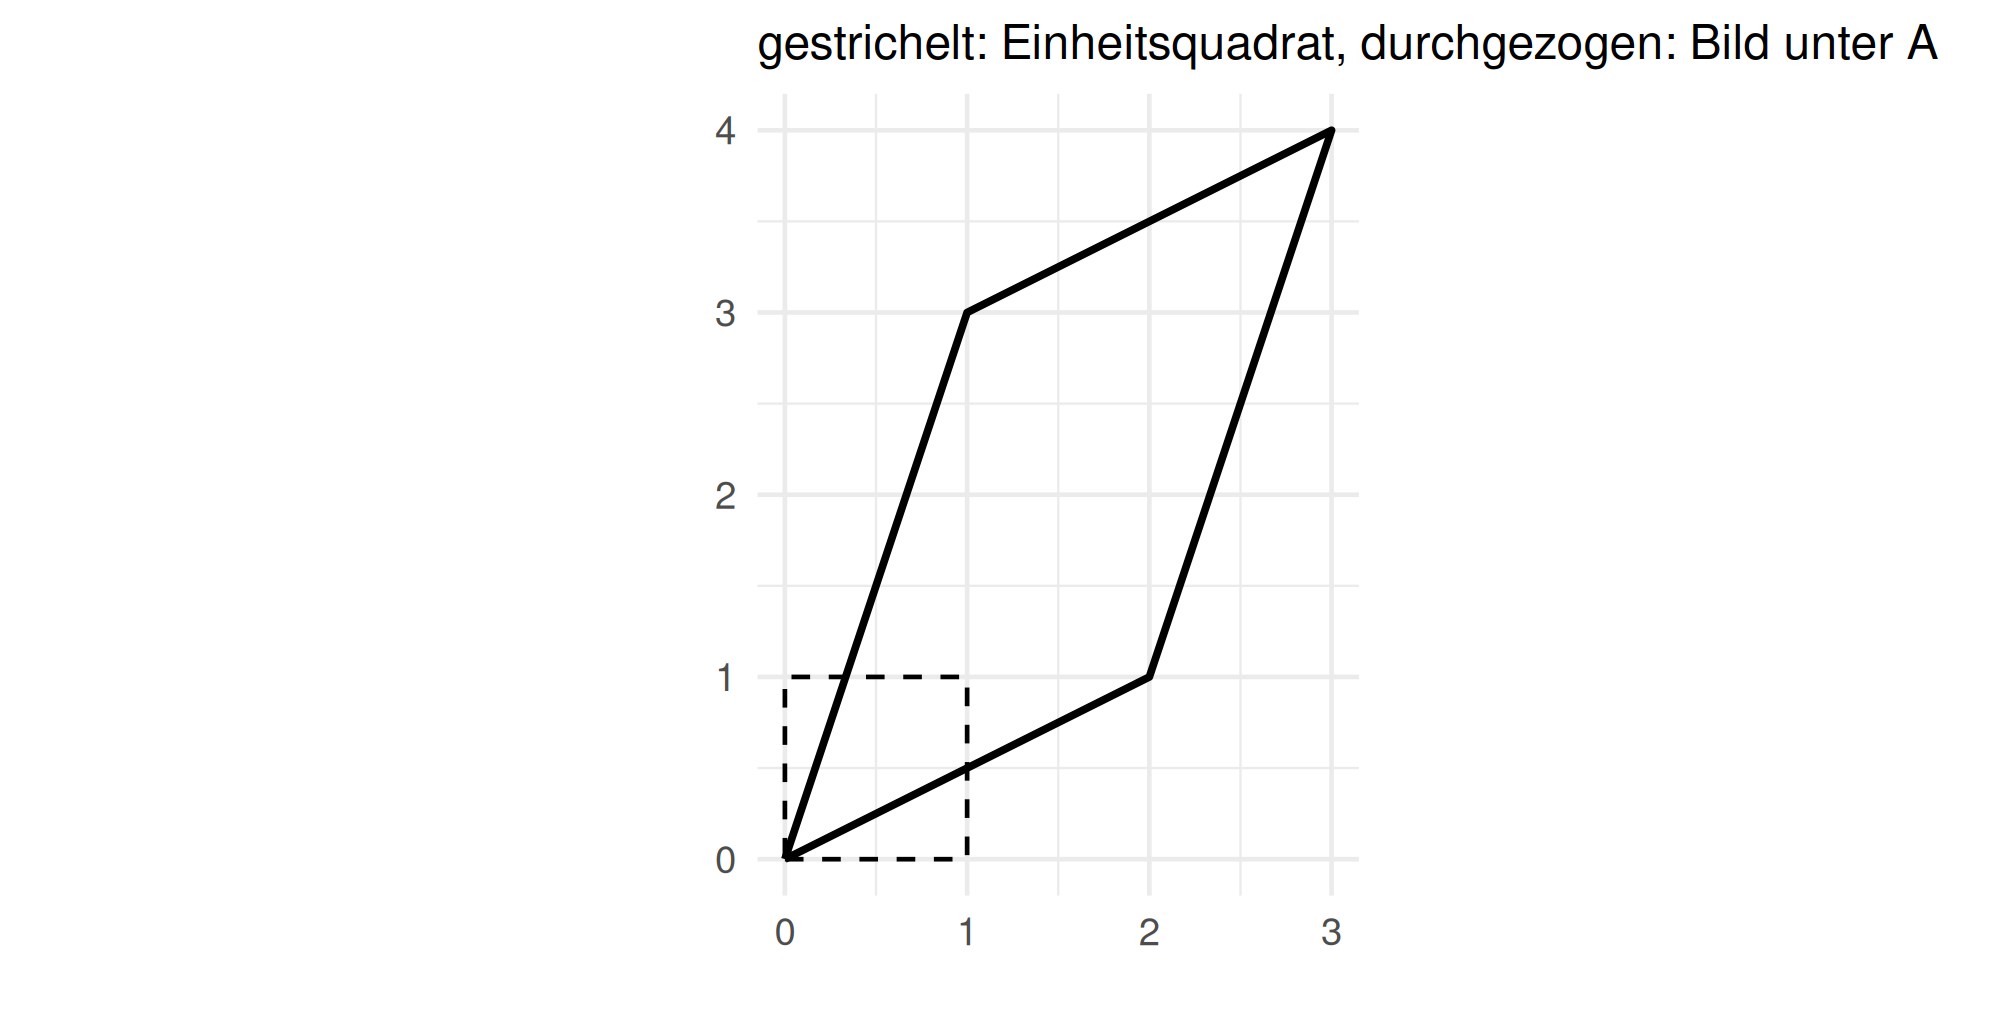
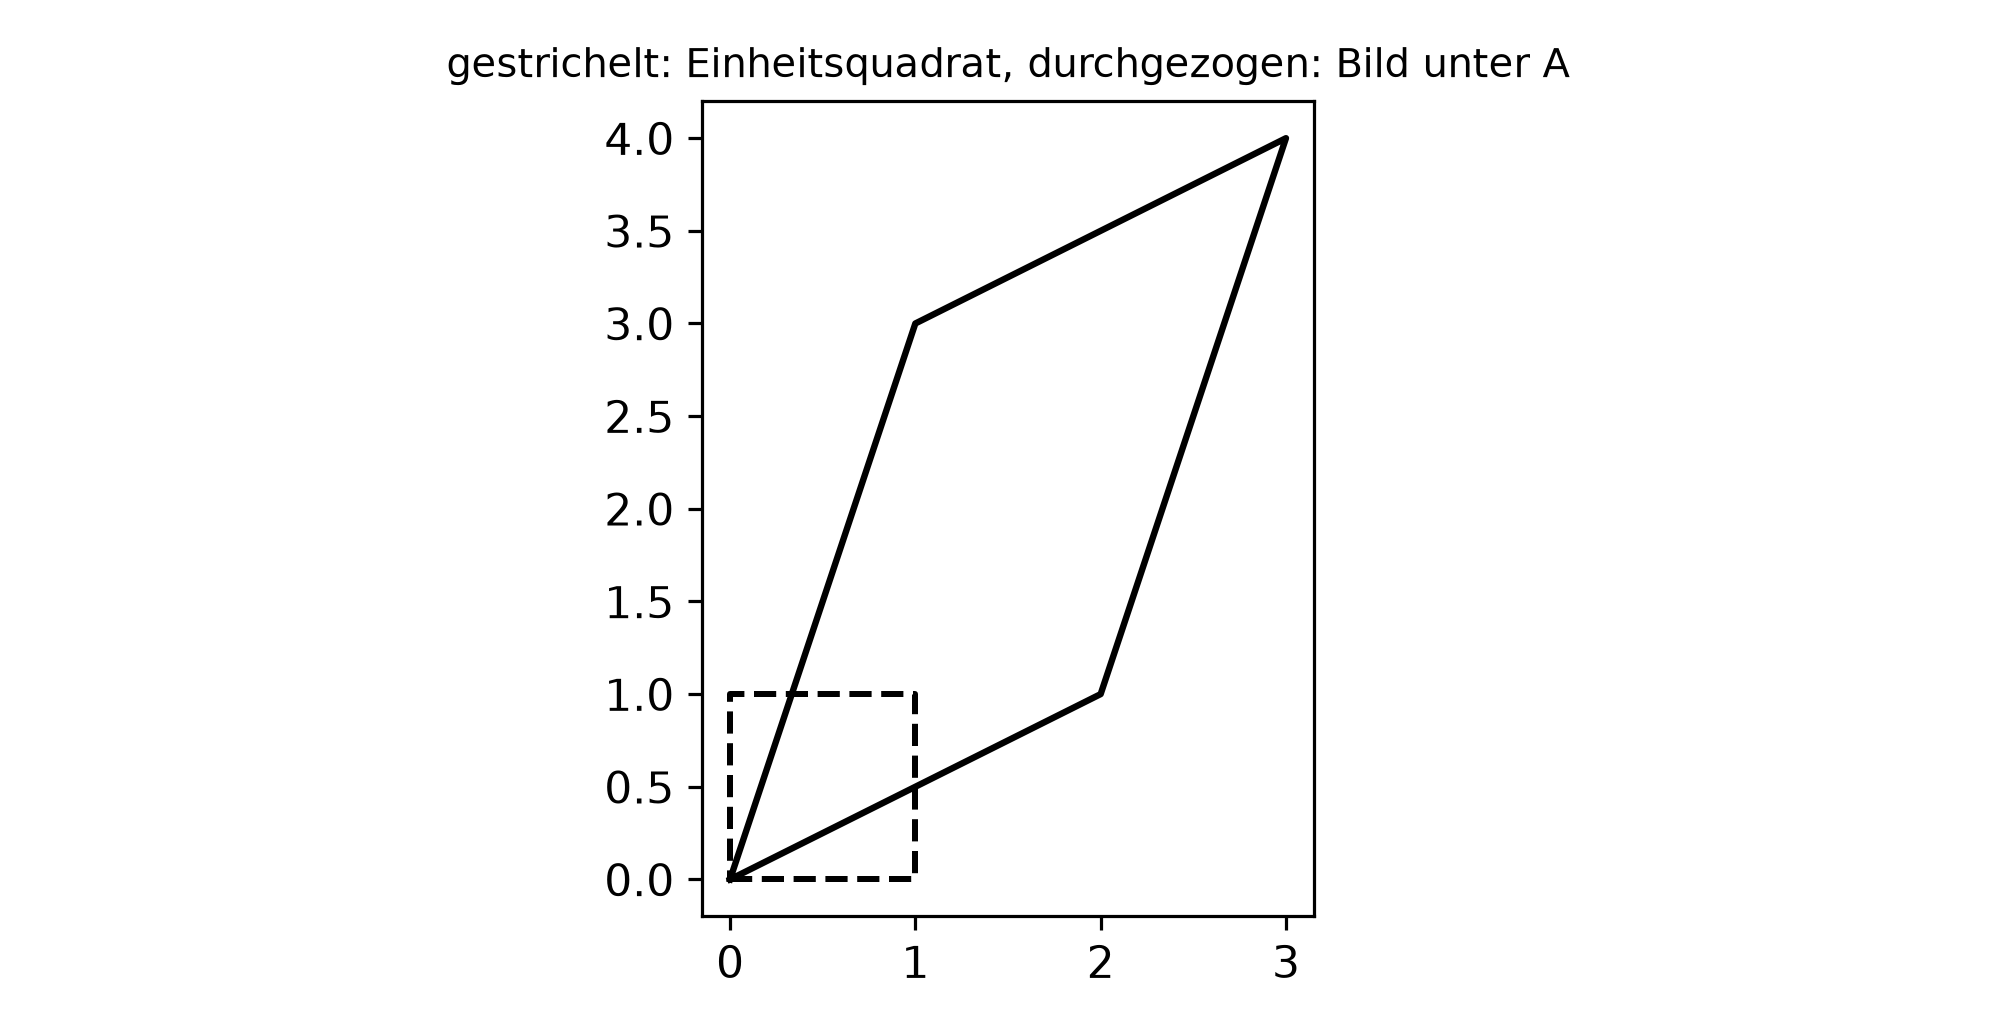
Abbildung 1: Beispiel 1: das Einheitsquadrat vor und nach der Abbildung.
A = np.array([[2., 1.], [1., 3.]])
streckung = np.array([[3., 0.], [0., 0.5]])
drehung = np.array([[0., -1.], [1., 0.]])
scherung = np.array([[1., 1.5], [0., 1.]])

punkte = np.array([[1., 0.], [0., 1.], [1., 1.], [1., -1.], [2., 1.]])
print(np.column_stack([punkte, punkte @ A.T]))
[[ 1.  0.  2.  1.]
 [ 0.  1.  1.  3.]
 [ 1.  1.  3.  4.]
 [ 1. -1.  1. -2.]
 [ 2.  1.  5.  5.]]
for nm, M in [("A", A), ("streckung", streckung),
              ("drehung", drehung), ("scherung", scherung)]:
    bild = M @ np.array([1., 1.])
    print(f"{nm:<10} det = {np.linalg.det(M):5.2f}  spur = {np.trace(M):5.2f}"
          f"  (1,1) -> ({bild[0]:.2f}, {bild[1]:.2f})")
A          det =  5.00  spur =  5.00  (1,1) -> (3.00, 4.00)
streckung  det =  1.50  spur =  3.50  (1,1) -> (3.00, 0.50)
drehung    det =  1.00  spur =  0.00  (1,1) -> (-1.00, 1.00)
scherung   det =  1.00  spur =  2.00  (1,1) -> (2.50, 1.00)
quadrat = np.array([[0., 0.], [1., 0.], [1., 1.], [0., 1.], [0., 0.]])
bild = quadrat @ A.T
fig, achse = plt.subplots(figsize=(7, 3.6))
achse.plot(quadrat[:, 0], quadrat[:, 1], "--", color="black")
achse.plot(bild[:, 0], bild[:, 1], lw=1.6, color="black")
achse.set_aspect("equal")
achse.set_title("gestrichelt: Einheitsquadrat, durchgezogen: Bild unter A",
                fontsize=10)
plt.tight_layout()
plt.show()
Abbildung 2: Beispiel 1: dieselbe Abbildung in Python.

Output Zeile für Zeile

Punkt Bild unter \(A\)
(1, 0) (2, 1)
(0, 1) (1, 3)
(1, 1) (3, 4)
(1, −1) (1, −2)
(2, 1) (5, 5)
Matrix Determinante Spur (1,1) wird zu
\(A\) 5.00 5.00 (3.00, 4.00)
Streckung 1.50 3.50 (3.00, 0.50)
Drehung 90° 1.00 0.00 (−1.00, 1.00)
Scherung 1.00 2.00 (2.50, 1.00)
Beobachtung Erklärung
Die Spalten von \(A\) sind die Bilder der Einheitsvektoren \((1,0) \to (2,1)\) und \((0,1) \to (1,3)\), genau die Spalten. So liest man eine Matrix: Jede Spalte sagt, wohin eine Achse wandert.
\((2,1) \to (5,5)\) und \((1,1) \to (3,4)\) Die Abbildung ist linear: doppelter Punkt, doppeltes Bild, und Summen bleiben Summen.
Determinante 5 heisst fünffache Fläche Das Einheitsquadrat wird zu einem Parallelogramm der Fläche 5, gut in der Grafik zu sehen.
Drehung und Scherung haben Determinante 1 Beide sind flächentreu. Die Drehung hat Spur 0, weil sie keine Richtung unverändert lässt, sie hat in der reellen Ebene gar keine Eigenvektoren.
Die Streckung ist die einfachste Abbildung Eine Diagonalmatrix streckt jede Achse für sich, ohne zu drehen. Die Achsen selbst sind hier die Eigenvektoren.

Und genau darauf läuft die Eigenzerlegung hinaus: Sie sucht das Koordinatensystem, in dem die Abbildung wie eine Diagonalmatrix aussieht, also ein reines Strecken ohne Drehung.

\[A = V \Lambda V^{\top}\]

\(V\) enthält die Eigenvektoren als Spalten (das neue Koordinatensystem), \(\Lambda\) die Eigenwerte auf der Diagonalen (die Streckfaktoren). Für eine Kovarianzmatrix heisst das: Dreh das Koordinatensystem so, dass die Variablen unkorreliert sind. Das ist die PCA.

Interpretation

Eine Matrix beschreibt, wohin Punkte wandern. Determinante und Spur fassen das zusammen, die Eigenzerlegung nimmt es auseinander.

Frage und Datenlage

Dieselbe Matrix \(A = \begin{pmatrix} 2 & 1 \\ 1 & 3\end{pmatrix}\). Die Eigenwerte über die quadratische Gleichung, die Eigenvektoren über Einsetzen und Nachrechnen und zum Schluss der Vergleich mit der eingebauten Funktion.

Rechnung

A <- matrix(c(2, 1, 1, 3), nrow = 2)

spur <- sum(diag(A)); determinante <- det(A)
diskriminante <- spur^2 - 4 * determinante
lambda1 <- (spur + sqrt(diskriminante)) / 2
lambda2 <- (spur - sqrt(diskriminante)) / 2
round(c(spur = spur, determinante = determinante,
        diskriminante = diskriminante,
        lambda1 = lambda1, lambda2 = lambda2), 6)
         spur  determinante diskriminante       lambda1       lambda2 
     5.000000      5.000000      5.000000      3.618034      1.381966 
# Zu jedem Eigenwert der Eigenvektor: (A - lambda I) v = 0 hat fuer eine
# 2x2-Matrix die Loesung v = (A12, lambda - A11), danach normiert.
for (lam in c(lambda1, lambda2)) {
  v <- c(A[1, 2], lam - A[1, 1]); v <- v / sqrt(sum(v^2))
  cat(sprintf("lambda = %.4f  v = (%.4f, %.4f)  A v = (%.4f, %.4f)  lambda v = (%.4f, %.4f)\n",
              lam, v[1], v[2], (A %*% v)[1], (A %*% v)[2], lam * v[1], lam * v[2]))
}
lambda = 3.6180  v = (0.5257, 0.8507)  A v = (1.9021, 3.0777)  lambda v = (1.9021, 3.0777)
lambda = 1.3820  v = (0.8507, -0.5257)  A v = (1.1756, -0.7265)  lambda v = (1.1756, -0.7265)
# Die beiden Merksaetze
round(c(summe_eigenwerte = lambda1 + lambda2, spur = spur,
        produkt_eigenwerte = lambda1 * lambda2, determinante = determinante), 6)
  summe_eigenwerte               spur produkt_eigenwerte       determinante 
                 5                  5                  5                  5 
# Und die eingebaute Funktion
zerlegung <- eigen(A)
round(zerlegung$values, 6)
[1] 3.618034 1.381966
round(vorzeichen_fest(zerlegung$vectors), 6)
         [,1]      [,2]
[1,] 0.525731  0.850651
[2,] 0.850651 -0.525731
# Senkrecht? Skalarprodukt der beiden Eigenvektoren
V <- vorzeichen_fest(zerlegung$vectors)
round(c(skalarprodukt = sum(V[, 1] * V[, 2])), 12)
skalarprodukt 
            0 
# Und die Rekonstruktion A = V Lambda V'
round(V %*% diag(zerlegung$values) %*% t(V), 6)
     [,1] [,2]
[1,]    2    1
[2,]    1    3
A = np.array([[2., 1.], [1., 3.]])

spur = np.trace(A)
determinante = np.linalg.det(A)
diskriminante = spur ** 2 - 4 * determinante
lambda1 = (spur + np.sqrt(diskriminante)) / 2
lambda2 = (spur - np.sqrt(diskriminante)) / 2
print({"spur": round(float(spur), 6), "determinante": round(float(determinante), 6),
       "diskriminante": round(float(diskriminante), 6),
       "lambda1": round(float(lambda1), 6), "lambda2": round(float(lambda2), 6)})
{'spur': 5.0, 'determinante': 5.0, 'diskriminante': 5.0, 'lambda1': 3.618034, 'lambda2': 1.381966}
for lam in [lambda1, lambda2]:
    v = np.array([A[0, 1], lam - A[0, 0]])
    v = v / np.sqrt((v ** 2).sum())
    print(f"lambda = {lam:.4f}  v = ({v[0]:.4f}, {v[1]:.4f})"
          f"  A v = ({(A @ v)[0]:.4f}, {(A @ v)[1]:.4f})"
          f"  lambda v = ({lam * v[0]:.4f}, {lam * v[1]:.4f})")
lambda = 3.6180  v = (0.5257, 0.8507)  A v = (1.9021, 3.0777)  lambda v = (1.9021, 3.0777)
lambda = 1.3820  v = (0.8507, -0.5257)  A v = (1.1756, -0.7265)  lambda v = (1.1756, -0.7265)
print({"summe_eigenwerte": round(float(lambda1 + lambda2), 6),
       "spur": round(float(spur), 6),
       "produkt_eigenwerte": round(float(lambda1 * lambda2), 6),
       "determinante": round(float(determinante), 6)})
{'summe_eigenwerte': 5.0, 'spur': 5.0, 'produkt_eigenwerte': 5.0, 'determinante': 5.0}
werte, V = eigen_absteigend(A)
print(np.round(werte, 6))
[3.618034 1.381966]
print(np.round(V, 6))
[[ 0.525731  0.850651]
 [ 0.850651 -0.525731]]
print({"skalarprodukt": round(float(V[:, 0] @ V[:, 1]), 12)})
{'skalarprodukt': 0.0}
print(np.round(V @ np.diag(werte) @ V.T, 6))
[[2. 1.]
 [1. 3.]]

Output Zeile für Zeile

Schritt Wert
Spur 5
Determinante 5
Diskriminante \(5^2 - 4\cdot 5\) 5
\(\lambda_1 = (5 + \sqrt{5})/2\) 3.618034
\(\lambda_2 = (5 - \sqrt{5})/2\) 1.381966
\(\lambda\) Eigenvektor \(v\) \(Av\) \(\lambda v\)
3.6180 (0.5257, 0.8507) (1.9021, 3.0777) (1.9021, 3.0777)
1.3820 (0.8507, −0.5257) (1.1756, −0.7265) (1.1756, −0.7265)
Beobachtung Erklärung
\(Av\) und \(\lambda v\) stimmen Stelle für Stelle überein Das ist die Definition, hier als Probe. Die Abbildung dreht diese beiden Richtungen nicht, sie streckt sie nur.
Summe der Eigenwerte = 5 = Spur Und das Produkt \(3.618 \cdot 1.382 = 5\) = Determinante. Zwei Kontrollen, die bei jeder Matrix funktionieren, nützlich, um ein Ergebnis zu prüfen, ohne es nachzurechnen.
Das Skalarprodukt der Eigenvektoren ist 0 Die beiden stehen senkrecht aufeinander. Das gilt für jede symmetrische Matrix und ist der Grund, weshalb Hauptkomponenten unkorreliert sind.
\(V \Lambda V^{\top}\) ergibt wieder \(A\) Die Zerlegung verliert nichts. Behält man nur die grössten Eigenwerte, wird daraus eine Näherung, genau das tut die PCA beim Weglassen von Komponenten.
\(\lambda_1 > \lambda_2\), aber beide positiv \(A\) ist positiv definit. Wäre ein Eigenwert negativ, könnte \(A\) keine Kovarianzmatrix sein.

Eigenvektoren sind nur bis aufs Vorzeichen bestimmt. Ist \(v\) ein Eigenvektor, so ist \(-v\) einer mit demselben Eigenwert. R und Python wählen nicht dieselbe Konvention, und auch dieselbe Software kann bei kleinsten Datenänderungen umspringen.

R eigen() Python np.linalg.eigh()
Reihenfolge absteigend aufsteigend
Vorzeichen LAPACK-abhängig LAPACK-abhängig

Auf dieser Seite legt deshalb die Hilfsfunktion vorzeichen_fest bzw. eigen_absteigend beides fest: absteigend sortiert, und die betragsmässig grösste Komponente jedes Vektors positiv.

Für die Auswertung heisst das: Ein Vorzeichenwechsel in einer Komponentenladung ist keine inhaltliche Aussage. Nur die relativen Vorzeichen innerhalb eines Eigenvektors sind interpretierbar.

Interpretation und Ergebnissatz

Die Matrix hat die Eigenwerte 3.618 und 1.382 mit den zugehörigen Eigenvektoren (0.526, 0.851) und (0.851, −0.526). Summe und Produkt der Eigenwerte reproduzieren Spur und Determinante, und die beiden Eigenvektoren stehen senkrecht aufeinander.

Frage und Datenlage

200 Personen mit Körpergrösse in Zentimetern und Gewicht in Kilogramm. Die PCA wird einmal von Hand aus der Kovarianzmatrix gerechnet und einmal mit der eingebauten Funktion.

Rechnung

n <- 200
Z <- normalmatrix(5150, n, 2)
groesse <- 172 + 9 * Z[, 1]
gewicht <- 70 + 0.55 * (groesse - 172) + 7 * Z[, 2]
D <- cbind(groesse = groesse, gewicht = gewicht)

round(rbind(mittel = colMeans(D), sd = apply(D, 2, sd)), 4)
        groesse gewicht
mittel 170.9779 69.8522
sd       9.7200  8.0371
S <- cov(D)
round(S, 4)
        groesse gewicht
groesse 94.4777 45.6142
gewicht 45.6142 64.5957
round(c(korrelation = cor(D)[1, 2]), 4)
korrelation 
     0.5839 
# Von Hand: quadratische Gleichung aus Spur und Determinante
spur <- sum(diag(S)); dt <- det(S)
l1 <- (spur + sqrt(spur^2 - 4 * dt)) / 2
l2 <- (spur - sqrt(spur^2 - 4 * dt)) / 2
round(c(spur = spur, determinante = dt, lambda1 = l1, lambda2 = l2,
        anteil1 = l1 / spur, anteil2 = l2 / spur), 4)
        spur determinante      lambda1      lambda2      anteil1      anteil2 
    159.0735    4022.2035     127.5356      31.5379       0.8017       0.1983 
v1 <- c(S[1, 2], l1 - S[1, 1]); v1 <- v1 / sqrt(sum(v1^2))
v2 <- c(S[1, 2], l2 - S[1, 1]); v2 <- v2 / sqrt(sum(v2^2))
round(rbind(v1 = v1, v2 = v2), 4)
     [,1]    [,2]
v1 0.8097  0.5868
v2 0.5868 -0.8097
round(c(winkel_grad = atan2(v1[2], v1[1]) * 180 / pi), 3)
winkel_grad 
     35.932 
# Die Scores: Daten zentriert und auf die Eigenvektoren projiziert
scores <- scale(D, center = TRUE, scale = FALSE) %*% cbind(v1, v2)
round(c(varianz_score1 = var(scores[, 1]), varianz_score2 = var(scores[, 2]),
        kovarianz = cov(scores)[1, 2]), 6)
varianz_score1 varianz_score2      kovarianz 
      127.5356        31.5379         0.0000 
round(c(summe_varianzen_roh = sum(apply(D, 2, var)), spur = spur), 4)
summe_varianzen_roh                spur 
           159.0735            159.0735 
# Und die eingebaute Funktion
pk <- prcomp(D)
round(pk$sdev^2, 4)
[1] 127.5356  31.5379
round(vorzeichen_fest(pk$rotation), 4)
           PC1     PC2
groesse 0.8097 -0.5868
gewicht 0.5868  0.8097
mitte <- colMeans(D)
ggplot(data.frame(D), aes(groesse, gewicht)) +
  geom_point(alpha = 0.45, size = 1.4) +
  annotate("segment", x = mitte[1], y = mitte[2],
           xend = mitte[1] + sqrt(l1) * v1[1], yend = mitte[2] + sqrt(l1) * v1[2],
           linewidth = 1, arrow = arrow(length = unit(0.18, "cm"))) +
  annotate("segment", x = mitte[1], y = mitte[2],
           xend = mitte[1] + sqrt(l2) * v2[1], yend = mitte[2] + sqrt(l2) * v2[2],
           linewidth = 1, arrow = arrow(length = unit(0.18, "cm"))) +
  coord_equal() +
  labs(x = "Körpergrösse (cm)", y = "Gewicht (kg)")
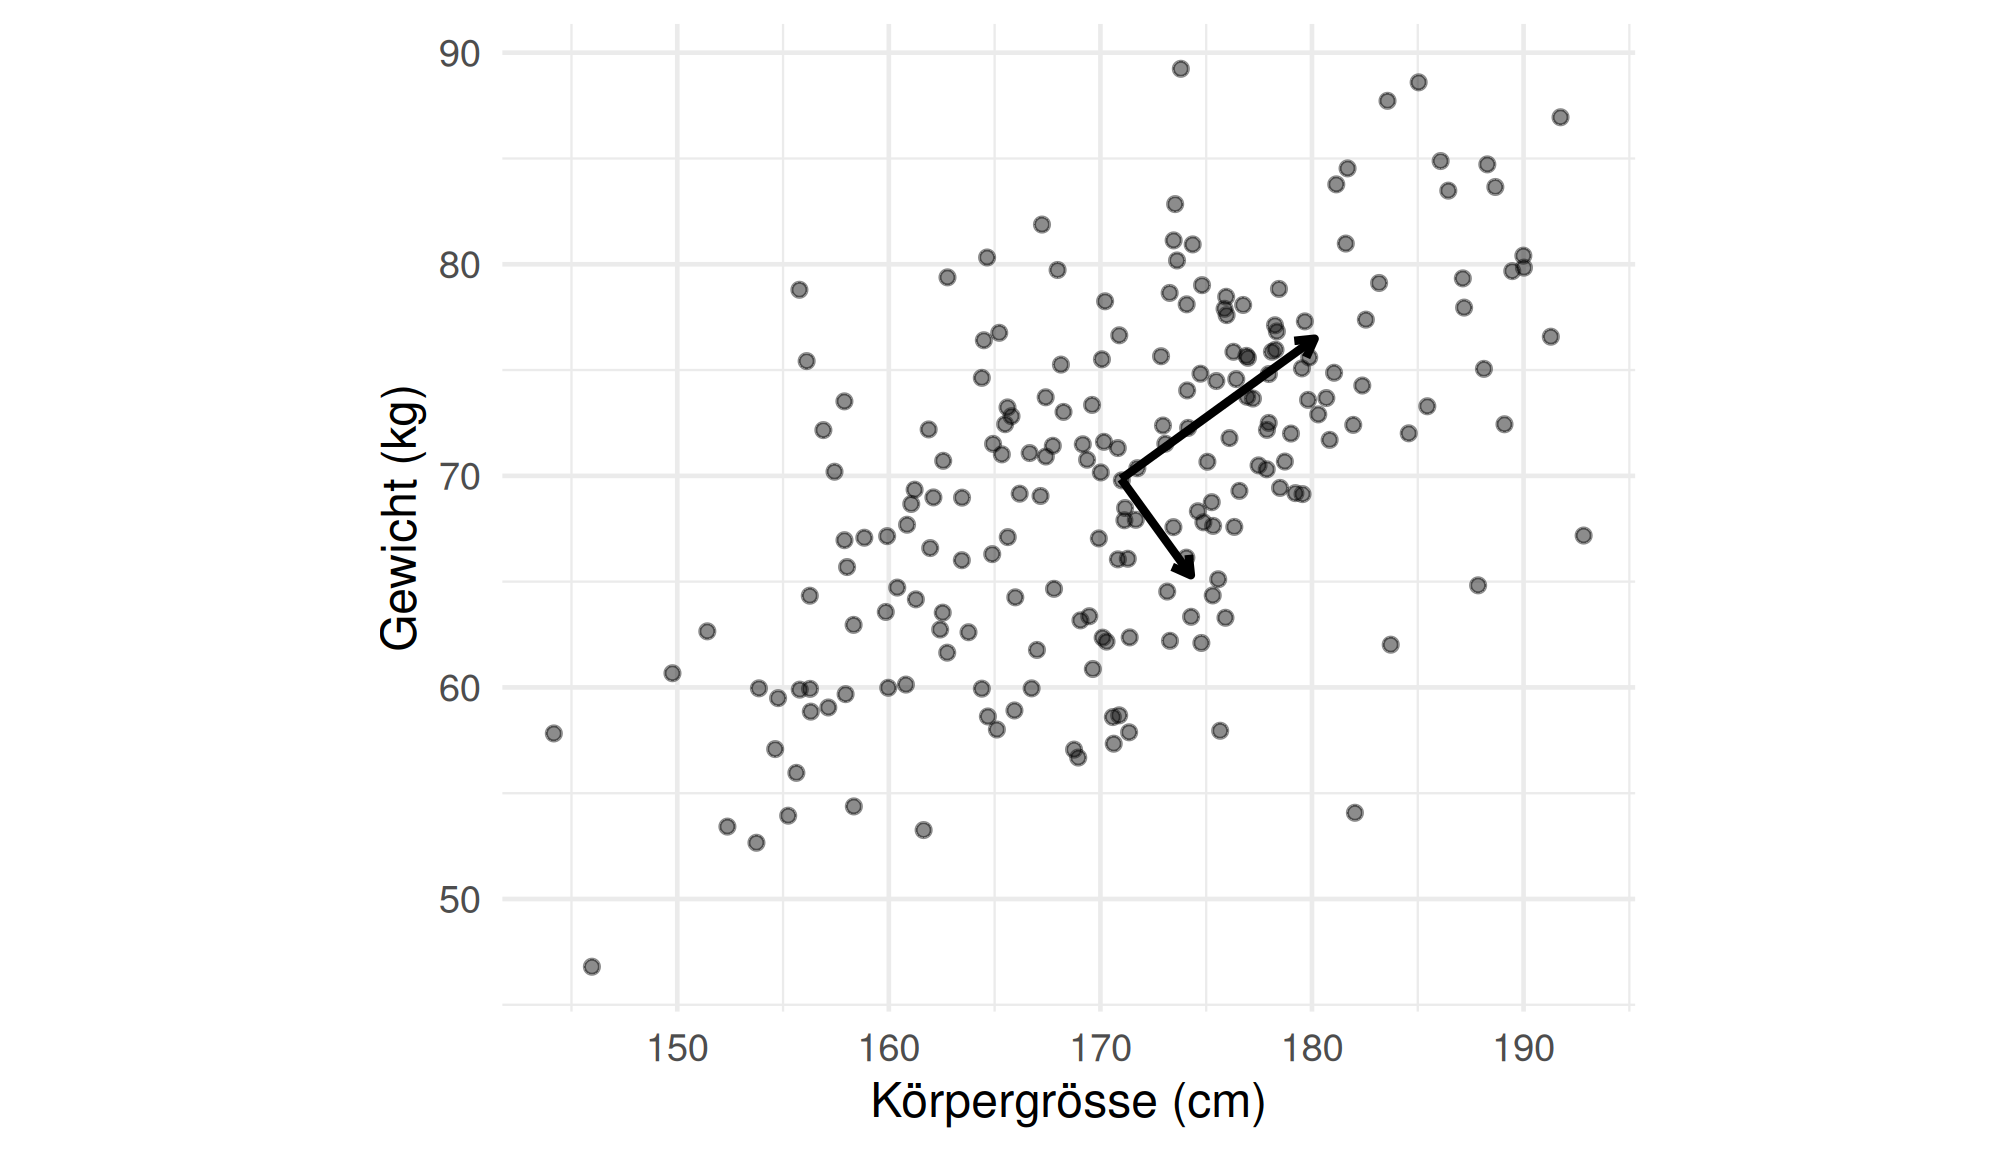
Abbildung 3: Beispiel 3: Streudiagramm mit den beiden Eigenvektoren, skaliert auf die Wurzel ihres Eigenwerts.
n = 200
Z = normalmatrix(5150, n, 2)
groesse = 172 + 9 * Z[:, 0]
gewicht = 70 + 0.55 * (groesse - 172) + 7 * Z[:, 1]
D = np.column_stack([groesse, gewicht])

print({"mittel": np.round(D.mean(axis=0), 4).tolist(),
       "sd": np.round(D.std(axis=0, ddof=1), 4).tolist()})
{'mittel': [170.9779, 69.8522], 'sd': [9.72, 8.0371]}
S = np.cov(D, rowvar=False)
print(np.round(S, 4))
[[94.4777 45.6142]
 [45.6142 64.5957]]
print({"korrelation": round(float(np.corrcoef(D, rowvar=False)[0, 1]), 4)})
{'korrelation': 0.5839}
spur = np.trace(S)
dt = np.linalg.det(S)
l1 = (spur + np.sqrt(spur ** 2 - 4 * dt)) / 2
l2 = (spur - np.sqrt(spur ** 2 - 4 * dt)) / 2
print({"spur": round(float(spur), 4), "determinante": round(float(dt), 4),
       "lambda1": round(float(l1), 4), "lambda2": round(float(l2), 4),
       "anteil1": round(float(l1 / spur), 4), "anteil2": round(float(l2 / spur), 4)})
{'spur': 159.0735, 'determinante': 4022.2035, 'lambda1': 127.5356, 'lambda2': 31.5379, 'anteil1': 0.8017, 'anteil2': 0.1983}
v1 = np.array([S[0, 1], l1 - S[0, 0]]); v1 /= np.sqrt((v1 ** 2).sum())
v2 = np.array([S[0, 1], l2 - S[0, 0]]); v2 /= np.sqrt((v2 ** 2).sum())
print(np.round(np.vstack([v1, v2]), 4))
[[ 0.8097  0.5868]
 [ 0.5868 -0.8097]]
print({"winkel_grad": round(float(np.degrees(np.arctan2(v1[1], v1[0]))), 3)})
{'winkel_grad': 35.932}
scores = (D - D.mean(axis=0)) @ np.column_stack([v1, v2])
print({"varianz_score1": round(float(scores[:, 0].var(ddof=1)), 6),
       "varianz_score2": round(float(scores[:, 1].var(ddof=1)), 6),
       "kovarianz": round(float(np.cov(scores, rowvar=False)[0, 1]), 6)})
{'varianz_score1': 127.535558, 'varianz_score2': 31.537898, 'kovarianz': 0.0}
print({"summe_varianzen_roh": round(float(D.var(axis=0, ddof=1).sum()), 4),
       "spur": round(float(spur), 4)})
{'summe_varianzen_roh': 159.0735, 'spur': 159.0735}
werte, V = eigen_absteigend(S)
print(np.round(werte, 4))
[127.5356  31.5379]
print(np.round(V, 4))
[[ 0.8097 -0.5868]
 [ 0.5868  0.8097]]
fig, achse = plt.subplots(figsize=(7, 4))
achse.scatter(groesse, gewicht, s=12, alpha=0.45, color="black")
m = D.mean(axis=0)
for lam, v in [(l1, v1), (l2, v2)]:
    achse.annotate("", xy=(m[0] + np.sqrt(lam) * v[0], m[1] + np.sqrt(lam) * v[1]),
                   xytext=(m[0], m[1]),
                   arrowprops=dict(arrowstyle="->", lw=1.4, color="black"))
achse.set_aspect("equal")
achse.set_xlabel("Körpergrösse (cm)")
achse.set_ylabel("Gewicht (kg)")
plt.tight_layout()
plt.show()
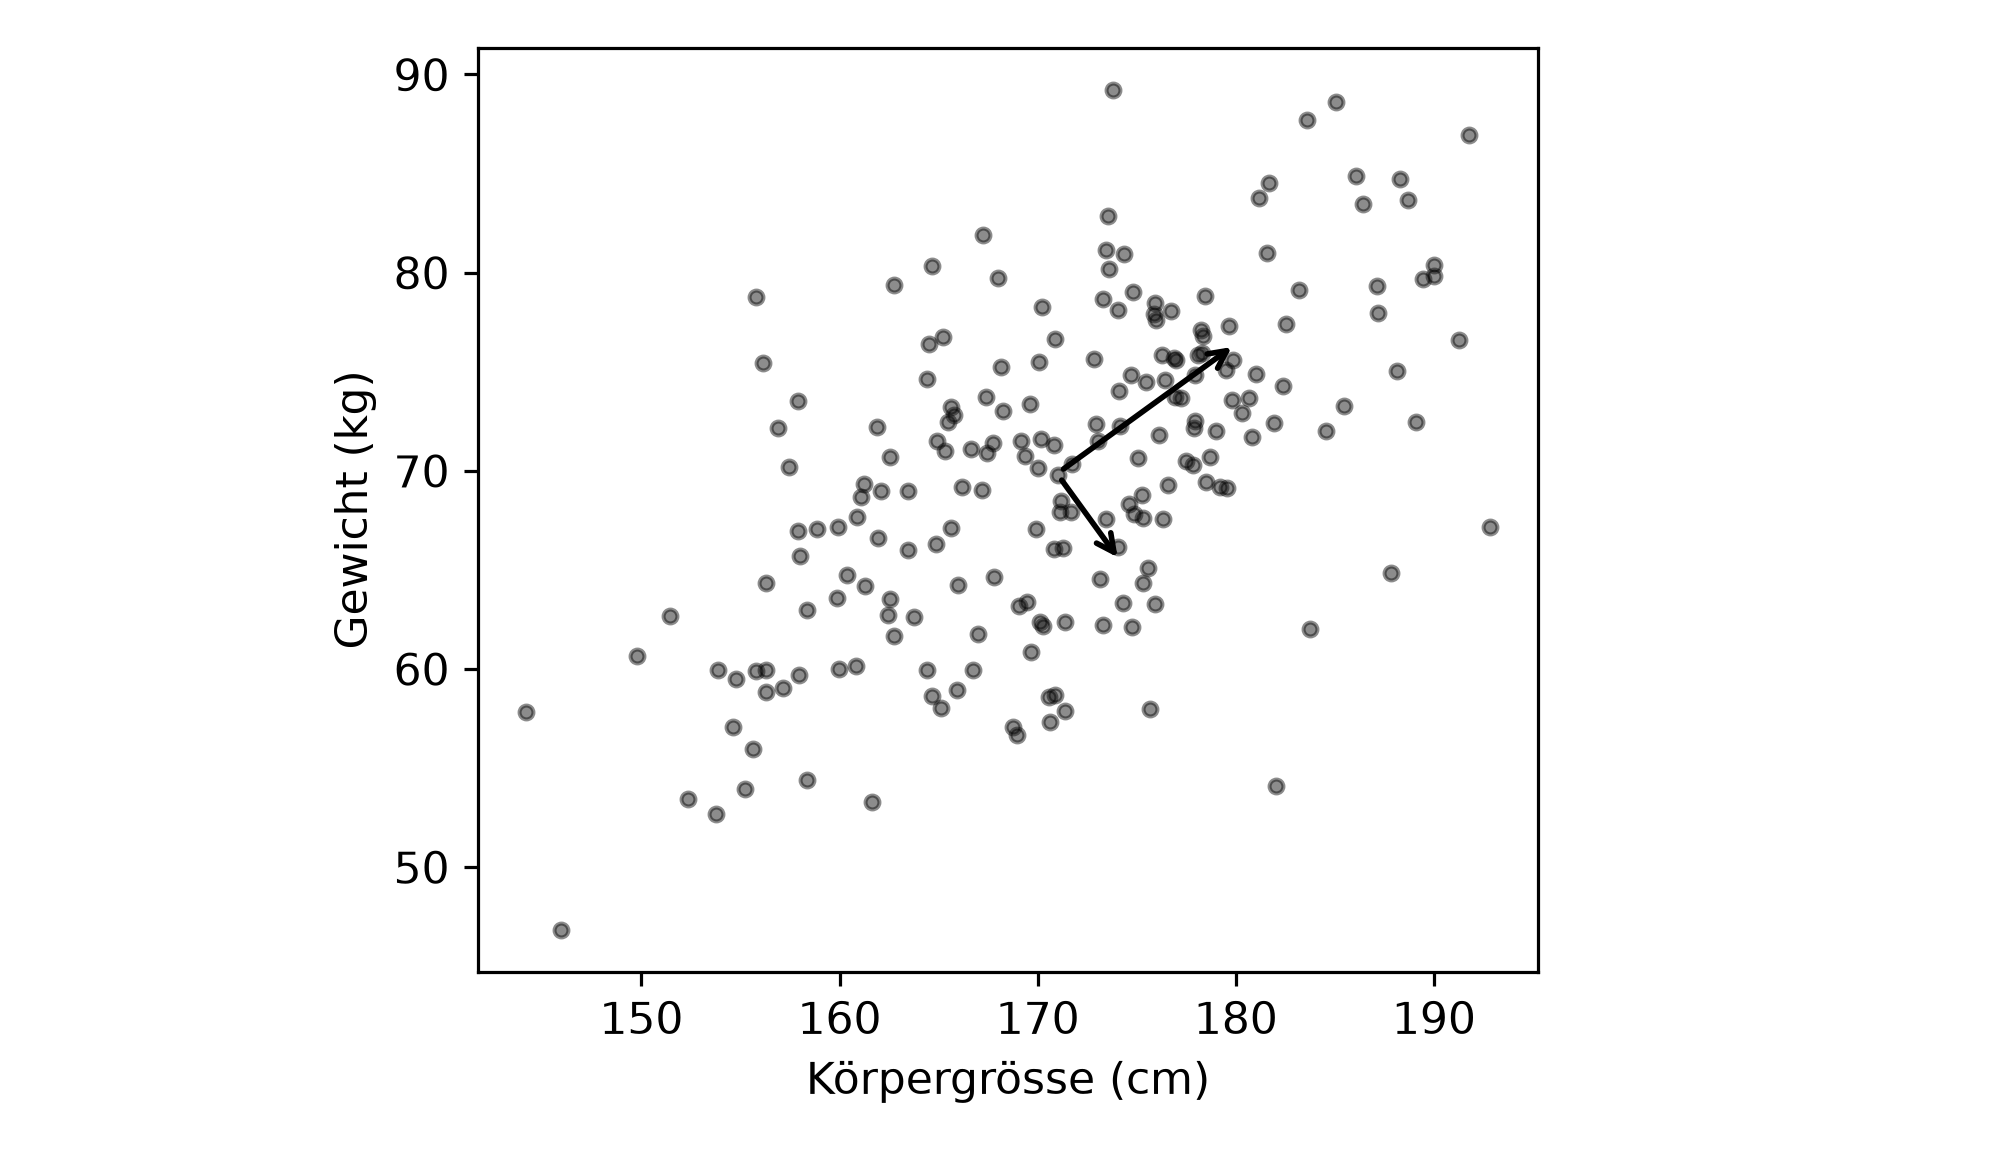
Abbildung 4: Beispiel 3: dieselbe Zerlegung in Python.

Output Zeile für Zeile

Körpergrösse Gewicht
Mittelwert 170.978 69.852
Standardabweichung 9.720 8.037

Kovarianzmatrix:

Grösse Gewicht
Grösse 94.478 45.614
Gewicht 45.614 64.596

Korrelation 0.584.

Grösse Wert
Spur (= Gesamtvarianz) 159.074
Determinante 4022.20
\(\lambda_1\) 127.536, Anteil 80.2 %
\(\lambda_2\) 31.538, Anteil 19.8 %
erster Eigenvektor (0.8097, 0.5868), Winkel 35.9°
zweiter Eigenvektor (0.5868, −0.8097)
Varianz der Scores 127.536 und 31.538
Kovarianz der Scores 0.000000
Summe der rohen Varianzen 159.074 = Spur
prcomp()$sdev^2 127.536 und 31.538
Beobachtung Erklärung
Die Eigenwerte sind die Varianzen der Scores 127.536 und 31.538, in beiden Rechnungen identisch. Das ist die gesamte Aussage der PCA: Der Eigenwert misst, wie stark die Daten in dieser Richtung streuen.
Die Kovarianz der Scores ist exakt null Weil die Eigenvektoren senkrecht aufeinander stehen. Die PCA erzeugt unkorrelierte Variablen aus korrelierten.
94.478 + 64.596 = 127.536 + 31.538 Die Gesamtvarianz wird nur umverteilt, nicht verändert. Deshalb ist “Anteil erklärter Varianz” eine sinnvolle Grösse.
Die erste Komponente zeigt in 35.9 Grad Nicht in 45 Grad, obwohl beide Ladungen positiv sind. Die Richtung wird von der grösseren Varianz der Körpergrösse (94.5 gegen 64.6) zur Grössenachse hin gezogen.
Die Handrechnung und prcomp() stimmen überein Bis auf die Vorzeichenkonvention. prcomp() ist keine Blackbox, sondern eigen(cov(D)), mit dem Unterschied, dass intern eine Singulärwertzerlegung verwendet wird, die numerisch stabiler ist.

Woran man die beiden Komponenten inhaltlich erkennt:

Komponente Ladungen Bedeutung
erste 0.810 und 0.587, beide positiv “allgemeine Körpergrösse”, wer gross ist, ist eher schwer
zweite 0.587 und −0.810 “schwer für seine Grösse”, der Gegensatz zwischen den beiden

Die erste Komponente ist fast immer ein Grösseneffekt, wenn alle Variablen positiv korreliert sind. Die interessanten Aussagen stecken meist in der zweiten.

Interpretation und Ergebnissatz

Die Eigenzerlegung der Kovarianzmatrix liefert die Eigenwerte 127.54 und 31.54, also 80.2 und 19.8 Prozent der Gesamtvarianz von 159.07. Die Scores auf den beiden Eigenvektoren haben genau diese Varianzen und sind unkorreliert; prcomp() reproduziert dasselbe Ergebnis.

Frage und Datenlage

Dieselben Daten, nur die Körpergrösse in Millimetern statt Zentimetern. Danach dieselben Daten standardisiert. Drei Rechnungen, drei Antworten.

Rechnung

# (1) Zentimeter -- wie in Beispiel 3
S_cm <- cov(D)
e_cm <- eigen(S_cm)
round(rbind(eigenwert = e_cm$values,
            anteil = e_cm$values / sum(e_cm$values)), 4)
              [,1]    [,2]
eigenwert 127.5356 31.5379
anteil      0.8017  0.1983
# (2) Millimeter: dieselbe Information, andere Zahl
D_mm <- cbind(groesse = D[, 1] * 10, gewicht = D[, 2])
S_mm <- cov(D_mm)
round(S_mm, 2)
        groesse gewicht
groesse 9447.77  456.14
gewicht  456.14   64.60
e_mm <- eigen(S_mm)
round(rbind(eigenwert = e_mm$values,
            anteil = e_mm$values / sum(e_mm$values)), 4)
               [,1]    [,2]
eigenwert 9469.8938 42.4736
anteil       0.9955  0.0045
# (3) Standardisiert, also die Korrelationsmatrix
R <- cor(D)
round(R, 4)
        groesse gewicht
groesse  1.0000  0.5839
gewicht  0.5839  1.0000
e_r <- eigen(R)
round(rbind(eigenwert = e_r$values,
            anteil = e_r$values / sum(e_r$values)), 4)
            [,1]   [,2]
eigenwert 1.5839 0.4161
anteil    0.7919 0.2081
round(vorzeichen_fest(e_r$vectors), 4)
       [,1]    [,2]
[1,] 0.7071  0.7071
[2,] 0.7071 -0.7071
round(c(summe_eigenwerte = sum(e_r$values), anzahl_variablen = ncol(D)), 4)
summe_eigenwerte anzahl_variablen 
               2                2 
# Die ersten Eigenvektoren im Vergleich
round(rbind(cm = vorzeichen_fest(e_cm$vectors)[, 1],
            mm = vorzeichen_fest(e_mm$vectors)[, 1],
            standardisiert = vorzeichen_fest(e_r$vectors)[, 1]), 4)
                 [,1]   [,2]
cm             0.8097 0.5868
mm             0.9988 0.0484
standardisiert 0.7071 0.7071
S_cm = np.cov(D, rowvar=False)
w_cm, V_cm = eigen_absteigend(S_cm)
print(np.round(np.vstack([w_cm, w_cm / w_cm.sum()]), 4))
[[127.5356  31.5379]
 [  0.8017   0.1983]]
D_mm = np.column_stack([D[:, 0] * 10, D[:, 1]])
S_mm = np.cov(D_mm, rowvar=False)
print(np.round(S_mm, 2))
[[9447.77  456.14]
 [ 456.14   64.6 ]]
w_mm, V_mm = eigen_absteigend(S_mm)
print(np.round(np.vstack([w_mm, w_mm / w_mm.sum()]), 4))
[[9469.8938   42.4736]
 [   0.9955    0.0045]]
R = np.corrcoef(D, rowvar=False)
print(np.round(R, 4))
[[1.     0.5839]
 [0.5839 1.    ]]
w_r, V_r = eigen_absteigend(R)
print(np.round(np.vstack([w_r, w_r / w_r.sum()]), 4))
[[1.5839 0.4161]
 [0.7919 0.2081]]
print(np.round(V_r, 4))
[[ 0.7071 -0.7071]
 [ 0.7071  0.7071]]
print({"summe_eigenwerte": round(float(w_r.sum()), 4),
       "anzahl_variablen": D.shape[1]})
{'summe_eigenwerte': 2.0, 'anzahl_variablen': 2}
print(np.round(np.vstack([V_cm[:, 0], V_mm[:, 0], V_r[:, 0]]), 4))
[[0.8097 0.5868]
 [0.9988 0.0484]
 [0.7071 0.7071]]

Output Zeile für Zeile

Rechnung \(\lambda_1\) \(\lambda_2\) Anteil 1 Anteil 2
Kovarianz, cm 127.54 31.54 80.2 % 19.8 %
Kovarianz, mm 9469.89 42.47 99.6 % 0.4 %
Korrelation 1.5839 0.4161 79.2 % 20.8 %

Erste Eigenvektoren:

Rechnung Ladung Grösse Ladung Gewicht
cm 0.8097 0.5868
mm 0.9988 0.0484
standardisiert 0.7071 0.7071
Beobachtung Erklärung
In Millimetern erklärt die erste Komponente 99.6 statt 80.2 Prozent Die Varianz der Grösse wird beim Wechsel auf Millimeter mit \(10^2 = 100\) multipliziert (9447.8 statt 94.5), die des Gewichts nicht. Die Komponente folgt der grössten Varianz und die ist jetzt fast nur noch die Grösse.
Der erste Eigenvektor kippt auf (0.999, 0.048) Die Komponente ist praktisch nur noch die Körpergrösse. Dieselben Daten, eine andere Einheit, eine völlig andere Antwort.
Die Korrelationsmatrix hat Eigenwerte, die sich zu 2 addieren Allgemein zur Anzahl der Variablen, weil jede standardisierte Variable die Varianz 1 hat. Daher das Kaiser-Kriterium “Eigenwert > 1”: eine Komponente soll mehr erklären als eine einzelne Variable.
Der erste Eigenvektor ist exakt (0.707, 0.707) Bei zwei standardisierten Variablen immer, unabhängig von der Korrelation, die Matrix ist dann symmetrisch in beiden Variablen. Die Eigenwerte \(1 \pm r\) hängen dagegen von der Korrelation ab: \(1 + 0.584 = 1.584\) und \(1 - 0.584 = 0.416\).
Die Anteile aus cm und aus der Korrelation liegen nahe beieinander 80.2 gegen 79.2 Prozent. Zufall dieses Datensatzes: Die beiden Standardabweichungen sind mit 9.72 und 8.04 ähnlich gross. Bei sehr ungleichen Streuungen klaffen sie weit auseinander.

Die Regel, die daraus folgt: Eine PCA auf der Kovarianzmatrix ist nur zulässig, wenn alle Variablen in derselben Einheit gemessen sind und Unterschiede in der Streuung inhaltlich gemeint sind, etwa mehrere Temperaturmessungen oder Preise in Franken.

Sobald Einheiten gemischt werden (Zentimeter, Kilogramm, Franken, Punkte), führt nur die Korrelationsmatrix zu einem sinnvollen Ergebnis, weil das Verfahren sonst schlicht die Variable mit der grössten Zahlenspanne findet.

Funktion Standardverhalten Standardisierung einschalten
R prcomp() Kovarianz scale. = TRUE
R princomp() Kovarianz cor = TRUE
Python sklearn.decomposition.PCA Kovarianz StandardScaler vorschalten

Alle drei standardisieren von sich aus nicht. Das ist der häufigste Fehler bei einer PCA.

Interpretation und Ergebnissatz

Der blosse Wechsel von Zentimetern auf Millimeter hebt den Anteil der ersten Komponente von 80.2 auf 99.6 Prozent und dreht ihren Eigenvektor von (0.810, 0.587) auf (0.999, 0.048). Auf der Korrelationsmatrix gerechnet ist das Ergebnis von der Einheit unabhängig: Eigenwerte 1.584 und 0.416, Summe gleich der Anzahl Variablen.

Frage und Datenlage

Drei Variablen, von denen die dritte einmal exakt und einmal fast exakt die Summe der beiden ersten ist. Was macht die Eigenzerlegung daraus?

Rechnung

n <- 200
Z <- normalmatrix(6160, n, 3)
x1 <- 100 + 15 * Z[, 1]
x2 <- 50 + 0.6 * (x1 - 100) + 9 * Z[, 2]
x3 <- x1 + x2                 # exakt abhaengig
x4 <- x1 + x2 + 0.5 * Z[, 3]  # fast abhaengig
x5 <- 50 + 8 * Z[, 3]         # unabhaengig

bericht <- function(name, D) {
  R <- cor(D)
  # Eigenwerte und Determinante einer Korrelationsmatrix sind theoretisch
  # nicht negativ; numerisch kann bei exakter Abhaengigkeit -1e-16 stehen.
  w <- pmax(eigen(R)$values, 0)
  cat(sprintf("%-10s Eigenwerte: %s | Summe %.4f | Rang %d | det %.6f\n",
              name, paste(sprintf("%.6f", w), collapse = "  "),
              sum(w), qr(R)$rank, abs(det(R))))
}
bericht("exakt", cbind(x1, x2, x3))
exakt      Eigenwerte: 2.675167  0.324833  0.000000 | Summe 3.0000 | Rang 2 | det 0.000000
bericht("fast", cbind(x1, x2, x4))
fast       Eigenwerte: 2.674740  0.324956  0.000304 | Summe 3.0000 | Rang 3 | det 0.000264
bericht("normal", cbind(x1, x2, x5))
normal     Eigenwerte: 1.690445  0.992690  0.316865 | Summe 3.0000 | Rang 3 | det 0.531727
# Der Varianzinflationsfaktor misst dasselbe aus Regressionssicht
vif_wert <- function(D, j) {
  modell <- lm(D[, j] ~ D[, -j])
  1 / (1 - summary(modell)$r.squared)
}
round(c(x1 = vif_wert(cbind(x1, x2, x4), 1), x2 = vif_wert(cbind(x1, x2, x4), 2),
        x4 = vif_wert(cbind(x1, x2, x4), 3)), 2)
     x1      x2      x4 
 730.07  509.19 2058.31 
round(c(x1 = vif_wert(cbind(x1, x2, x5), 1), x2 = vif_wert(cbind(x1, x2, x5), 2),
        x5 = vif_wert(cbind(x1, x2, x5), 3)), 2)
  x1   x2   x5 
1.85 1.88 1.02 
round(c(korr_x1_x2 = cor(x1, x2), korr_x4_x1 = cor(x4, x1),
        korr_x4_x2 = cor(x4, x2)), 4)
korr_x1_x2 korr_x4_x1 korr_x4_x2 
    0.6759     0.9304     0.8985 
n = 200
Z = normalmatrix(6160, n, 3)
x1 = 100 + 15 * Z[:, 0]
x2 = 50 + 0.6 * (x1 - 100) + 9 * Z[:, 1]
x3 = x1 + x2
x4 = x1 + x2 + 0.5 * Z[:, 2]
x5 = 50 + 8 * Z[:, 2]


def bericht(name, D):
    R = np.corrcoef(D, rowvar=False)
    w = np.maximum(np.linalg.eigvalsh(R)[::-1], 0)
    werte = "  ".join(f"{v:.6f}" for v in w)
    print(f"{name:<10} Eigenwerte: {werte} | Summe {w.sum():.4f}"
          f" | Rang {np.linalg.matrix_rank(R)} | det {abs(np.linalg.det(R)):.6f}")


bericht("exakt", np.column_stack([x1, x2, x3]))
exakt      Eigenwerte: 2.675167  0.324833  0.000000 | Summe 3.0000 | Rang 2 | det 0.000000
bericht("fast", np.column_stack([x1, x2, x4]))
fast       Eigenwerte: 2.674740  0.324956  0.000304 | Summe 3.0000 | Rang 3 | det 0.000264
bericht("normal", np.column_stack([x1, x2, x5]))
normal     Eigenwerte: 1.690445  0.992690  0.316865 | Summe 3.0000 | Rang 3 | det 0.531727
def vif_wert(D, j):
    y = D[:, j]
    X = np.column_stack([np.ones(len(D)), np.delete(D, j, axis=1)])
    b = np.linalg.lstsq(X, y, rcond=None)[0]
    r2 = 1 - ((y - X @ b) ** 2).sum() / ((y - y.mean()) ** 2).sum()
    return 1 / (1 - r2)


Df = np.column_stack([x1, x2, x4])
print({"x1": round(float(vif_wert(Df, 0)), 2), "x2": round(float(vif_wert(Df, 1)), 2),
       "x4": round(float(vif_wert(Df, 2)), 2)})
{'x1': 730.07, 'x2': 509.19, 'x4': 2058.31}
Dn = np.column_stack([x1, x2, x5])
print({"x1": round(float(vif_wert(Dn, 0)), 2), "x2": round(float(vif_wert(Dn, 1)), 2),
       "x5": round(float(vif_wert(Dn, 2)), 2)})
{'x1': 1.85, 'x2': 1.88, 'x5': 1.02}
print({"korr_x1_x2": round(float(np.corrcoef(x1, x2)[0, 1]), 4),
       "korr_x4_x1": round(float(np.corrcoef(x4, x1)[0, 1]), 4),
       "korr_x4_x2": round(float(np.corrcoef(x4, x2)[0, 1]), 4)})
{'korr_x1_x2': 0.6759, 'korr_x4_x1': 0.9304, 'korr_x4_x2': 0.8985}

Output Zeile für Zeile

Fall \(\lambda_1\) \(\lambda_2\) \(\lambda_3\) Summe Rang Determinante
\(x_3 = x_1 + x_2\) (exakt) 2.675167 0.324833 0.000000 3 2 0.000000
\(x_4 = x_1 + x_2 + \varepsilon\) (fast) 2.674740 0.324956 0.000304 3 3 0.000264
unabhängig 1.690445 0.992690 0.316865 3 3 0.531727

Varianzinflationsfaktoren:

Fall \(x_1\) \(x_2\) dritte Variable
fast abhängig 730.07 509.19 2058.31
unabhängig 1.85 1.88 1.02
Beobachtung Erklärung
Der dritte Eigenwert ist im exakten Fall null Es gibt eine Richtung, in der die Daten keine Streuung haben, alle 200 Punkte liegen auf einer Ebene im dreidimensionalen Raum. Die dritte Variable trägt keine neue Information.
Der Rang fällt von 3 auf 2 Der Rang zählt, wie viele Richtungen tatsächlich genutzt werden. Rang = Anzahl der Eigenwerte grösser null.
Die Determinante ist 0 Sie ist das Produkt der Eigenwerte. Ein Faktor null macht das Produkt null und eine Matrix mit Determinante null lässt sich nicht invertieren.
Im “fast”-Fall ist \(\lambda_3\) 0.000304 statt 0 Nicht null, aber fast. Die Determinante liegt bei 0.000264. Der Rang ist formal 3, praktisch aber 2.
Die VIF explodieren auf 730 bis 2058 Faustregel ist 10. Eine VIF von 2058 heisst: Der Standardfehler dieses Koeffizienten ist \(\sqrt{2058} \approx 45\) mal so gross wie ohne Kollinearität.
Die Summe der Eigenwerte ist immer 3 Bei jeder Korrelationsmatrix mit drei Variablen. Die Gesamtvarianz ist festgelegt; nur ihre Aufteilung ändert sich.
Die einzelnen Korrelationen sind unauffällig \(r(x_1, x_2) = 0.676\), \(r(x_4, x_1) = 0.930\). Hoch, aber nichts, was allein Alarm auslösen würde. Kollinearität steckt in der Kombination, nicht in einzelnen Paaren, die Korrelationsmatrix durchzusehen genügt nicht.

Dasselbe Problem, drei Sprachen:

Sicht Anzeichen Kennzahl
lineare Algebra eine Richtung ohne Streuung \(\lambda_{\min} \approx 0\)
Matrizenrechnung Matrix nicht invertierbar \(\det \approx 0\), Rang < \(p\)
Regression Koeffizienten instabil, riesige Standardfehler VIF \(> 10\)
PCA letzte Komponenten überflüssig kleine Eigenwerte

Für die PCA ist das kein Problem, sondern ihr Zweck. Sie verträgt kollineare Variablen problemlos und liefert genau die Antwort “die letzte Richtung ist überflüssig”. Für eine Regression ist dieselbe Lage ein ernstes Problem, weil sie die Matrix invertieren muss. Das ist einer der Gründe, eine PCA einer Regression vorzuschalten.

Interpretation und Ergebnissatz

Ist eine Variable die exakte Summe zweier anderer, hat die Korrelationsmatrix den Eigenwert null, den Rang 2 und die Determinante 0. Bei einer nur fast exakten Abhängigkeit bleibt ein Eigenwert von 0.0003 übrig, und die Varianzinflationsfaktoren steigen auf 730 bis 2058, während die einzelnen Korrelationen mit 0.68 bis 0.93 unauffällig aussehen.

Verständnisfragen

Was ist ein Eigenvektor einer Matrix?

Eine Richtung, die von der Abbildung nicht gedreht, sondern nur gestreckt wird
Richtig. Der Streckfaktor ist der Eigenwert; A mal v ergibt lambda mal v.
Der längste Vektor in der Matrix
Eigenvektoren werden normiert, ihre Länge ist beliebig wählbar.
Die erste Spalte der Matrix
Die Spalten sind die Bilder der Einheitsvektoren, nur bei einer Diagonalmatrix sind das die Eigenvektoren.

Die Kovarianzmatrix hatte die Spur 159.07 und die Eigenwerte 127.54 und 31.54. Was sagt der Vergleich?

Die Gesamtvarianz wird umverteilt, nicht verändert
Richtig, 127.54 plus 31.54 ergibt 159.07. Deshalb lässt sich ein Anteil erklärter Varianz angeben, hier 80.2 und 19.8 Prozent.
Die PCA hat Varianz hinzugefügt
Die Summe ist identisch; eine Drehung des Koordinatensystems kann keine Varianz erzeugen.
Die Eigenwerte sind zufällig nahe an der Spur
Die Gleichheit gilt exakt und für jede Matrix.

Warum sind Hauptkomponenten unkorreliert?

Weil die Eigenvektoren einer symmetrischen Matrix senkrecht aufeinander stehen
Richtig. Im Beispiel war die Kovarianz der beiden Scores exakt null, und das Skalarprodukt der Eigenvektoren ebenfalls.
Weil die Daten vorher standardisiert werden
Standardisierung ändert nichts an der Korrelation zwischen Variablen; im Beispiel wurde nicht standardisiert.
Weil die Stichprobe gross genug war
Es gilt exakt und bei jedem Stichprobenumfang.

Der Wechsel von Zentimetern auf Millimeter hob den Anteil der ersten Komponente von 80.2 auf 99.6 Prozent. Was folgt daraus?

Bei gemischten Einheiten muss die Korrelationsmatrix verwendet werden
Richtig. Auf der Kovarianzmatrix findet das Verfahren sonst nur die Variable mit der grössten Zahlenspanne. prcomp braucht dafür scale. gleich TRUE.
Millimeter sind die genauere Einheit und daher vorzuziehen
Die Information ist in beiden Fällen dieselbe, nur die Zahlen sind grösser.
Die PCA ist unbrauchbar
Sie ist brauchbar, sobald die Frage nach der Standardisierung bewusst entschieden wird.

Eine Korrelationsmatrix von drei Variablen hat die Eigenwerte 2.675, 0.325 und 0.000. Was bedeutet das?

Eine Variable ist eine exakte Linearkombination der beiden anderen
Richtig. Der Rang ist 2, die Determinante null, und die Matrix lässt sich nicht invertieren. Für eine Regression ist das fatal, für eine PCA ist es die gesuchte Antwort.
Die dritte Variable ist konstant
Dann wäre ihre Korrelation gar nicht definiert; hier streut sie sehr wohl, nur nicht unabhängig.
Die Stichprobe ist zu klein
Der Effekt hängt nicht am Stichprobenumfang, sondern an der exakten Abhängigkeit.

Die paarweisen Korrelationen lagen bei 0.68 bis 0.93, die Varianzinflationsfaktoren aber bei 730 bis 2058. Wie passt das zusammen?

Kollinearität steckt in der Kombination mehrerer Variablen, nicht in einzelnen Paaren
Richtig. Deshalb genügt es nicht, die Korrelationsmatrix durchzusehen; VIF oder der kleinste Eigenwert zeigen es.
Die VIF sind falsch berechnet
Sie folgen direkt aus dem Bestimmtheitsmass der Regression einer Variablen auf alle anderen, hier über 0.999.
Korrelationen über 0.9 sind immer unproblematisch
Sie sind bereits hoch; entscheidend ist aber die gemeinsame Abhängigkeit.

Verlinkte Ressourcen