Häufigkeiten

Deskriptive Statistik
EDA
R
Python
Absolute und relative Häufigkeiten, Kreuztabellen und ihre Darstellung.

Kernideen

  • Absolute Häufigkeit zählt, relative teilt durch \(n\) und macht Gruppen verschiedener Grösse vergleichbar, kumulierte summiert von unten auf.
  • Die kumulierte Häufigkeit setzt eine Ordnung voraus und ist bei nominalen Merkmalen sinnlos.
  • Die empirische Verteilungsfunktion ist die kumulierte Häufigkeit für alle Werte, sie bildet keine Klassen und enthält die vollständige Information.
  • Bei Kreuztabellen gibt es drei Prozentangaben (Zeile, Spalte, Gesamt), und sie beantworten verschiedene Fragen.
  • Die Klassenzahl eines Histogramms ist eine inhaltliche Entscheidung, keine technische Voreinstellung.
  • Stabdiagramm für Kategorien, Histogramm für klassierte Messwerte, die Verwechslung ist ein Fehler in der Aussage, keine Geschmacksfrage.
  • Bei ungleich breiten Klassen trägt die Fläche die Information, nicht die Höhe.

Erklärung

Vorwissen: Skalenniveaus, weil das Messniveau bestimmt, welche Zusammenfassung überhaupt zulässig ist und ob klassiert werden muss. Die Kennzahlen dazu stehen unter Lage- und Streuungsmasse.

Häufigkeiten: die erste Zusammenfassung

Ein Merkmal mit tausend Beobachtungen lässt sich nicht ansehen. Die Häufigkeitsverteilung reduziert es auf die Frage, wie oft jede Ausprägung vorkommt, und ist damit die einfachste Form der Verdichtung.

Variante Was sie beantwortet Setzt voraus
absolut \(n_j\) Wie viele? nichts
relativ \(h_j = n_j / n\) Welcher Anteil? nichts
kumuliert \(\sum_{i \le j} h_i\) Welcher Anteil erreicht höchstens diese Stufe? eine Ordnung der Ausprägungen

Die relative Häufigkeit macht Gruppen unterschiedlicher Grösse vergleichbar: Zwölf Ausfälle in einem Betrieb mit zwanzig Maschinen sind etwas anderes als zwölf in einem mit zweihundert.

Die empirische Verteilungsfunktion

Die kumulierte Häufigkeit, konsequent für alle Werte eines metrischen Merkmals gebildet, ergibt eine Funktion: Sie gibt zu jedem Wert an, welcher Anteil der Beobachtungen höchstens so gross ist. Weil die Daten endlich sind, springt sie an jedem beobachteten Wert und ist dazwischen konstant.

Aus ihr lässt sich jedes Quantil ablesen: Man geht auf der senkrechten Achse zum gewünschten Anteil und liest waagerecht ab. Diese Verbindung zwischen Häufigkeit und Kennzahl ist der Grund, warum die Verteilungsfunktion mehr ist als eine Darstellungsvariante.

Klassenbildung

Bei stetigen Merkmalen kommt fast jeder Wert nur einmal vor. Eine Auszählung brächte nichts, deshalb werden benachbarte Werte zu Klassen zusammengefasst. Die Klassenzahl verändert das Bild erheblich, und die gängigen Faustregeln liefern nur einen Startwert:

Regel Formel bei \(n = 300\)
Wurzelregel \(\sqrt{n}\) 17
Sturges \(1 + \log_2 n\) 9
Rice \(2 \sqrt[3]{n}\) 13

Sturges unterstellt annähernd normalverteilte Daten und liefert bei grossen oder schiefen Stichproben zu wenige Klassen. In R ist es trotzdem die Voreinstellung von hist(), allerdings nur als Vorschlag, den die Funktion auf “schöne” Werte rundet.

Stabdiagramm oder Histogramm

Beide zeigen Balken, meinen aber Verschiedenes.

Stabdiagramm Histogramm
Für nominale und ordinale Merkmale metrische Merkmale
Balken getrennt, mit Luft dazwischen stossen aneinander
Warum zwischen Bern und Chur liegt nichts der Wertebereich ist lückenlos
Information trägt die Höhe bei gleichen Klassen die Höhe, bei ungleichen die Fläche
Reihenfolge bei nominal beliebig, bei ordinal fest durch die Werte vorgegeben

Ein Balkendiagramm für ein stetiges Merkmal oder ein Histogramm für Kategorien ist keine Geschmacksfrage, sondern ein Fehler in der Aussage.

Beispiele

Frage und Datenlage

60 Zufriedenheitsangaben auf drei Stufen. Was sagen absolute, relative und kumulierte Häufigkeit jeweils?

Rechnung

table(zufriedenheit)                        # absolut: wie viele?
zufriedenheit
gering mittel   hoch 
    11     30     19 
round(prop.table(table(zufriedenheit)), 3)  # relativ: welcher Anteil?
zufriedenheit
gering mittel   hoch 
 0.183  0.500  0.317 
round(cumsum(prop.table(table(zufriedenheit))), 3)  # kumuliert
gering mittel   hoch 
 0.183  0.683  1.000 
# Der Modus: die haeufigste Auspraegung
names(which.max(table(zufriedenheit)))
[1] "mittel"
print(zufriedenheit.value_counts().reindex(stufen))
gering    11
mittel    30
hoch      19
Name: count, dtype: int64
print(zufriedenheit.value_counts(normalize=True).reindex(stufen).round(3))
gering    0.183
mittel    0.500
hoch      0.317
Name: proportion, dtype: float64
print(zufriedenheit.value_counts(normalize=True)
      .reindex(stufen).cumsum().round(3))
gering    0.183
mittel    0.683
hoch      1.000
Name: proportion, dtype: float64
print("Modus:", zufriedenheit.value_counts().idxmax())
Modus: mittel

Output Zeile für Zeile

Stufe absolut relativ kumuliert
gering 11 0.183 0.183
mittel 30 0.500 0.683
hoch 19 0.317 1.000
Summe 60 1.000
Ausgabe Wie sie zu lesen ist
absolut Die reine Auszählung. Ohne die Angabe von \(n\) ist sie nicht einzuordnen, 11 von 60 ist etwas anderes als 11 von 11 000.
relativ 18.3 Prozent geben eine geringe Zufriedenheit an. Diese Zahl ist mit einer anderen Erhebung vergleichbar, die absolute nicht.
kumuliert 68.3 Prozent geben höchstens “mittel” an. Der letzte Wert ist immer 1.000, ist er es nicht, fehlen Beobachtungen oder es gibt fehlende Werte.
Modus “mittel”. Bei nominalen Merkmalen das einzige zulässige Lagemass.

Die kumulierte Zeile ist nur bei geordneten Merkmalen sinnvoll. Bei einer Abteilungszugehörigkeit “68 Prozent gehören höchstens zur Verwaltung” zu schreiben, ist Unsinn und beide Programme rechnen es trotzdem klaglos aus, weil sie die Kategorien alphabetisch sortieren.

Der Schutz davor liegt im Datentyp: Ein geordneter Faktor beziehungsweise Categorical(ordered=True) hält die inhaltliche Reihenfolge fest, siehe Skalenniveaus.

Und die Reihenfolge der Stufen muss angegeben werden: Ohne levels = sortiert R alphabetisch, und dann steht “hoch” vor “mittel”.

Interpretation und Ergebnissatz

Die Hälfte der 60 Befragten gibt eine mittlere Zufriedenheit an (n = 30, 50.0 Prozent), 31.7 Prozent eine hohe und 18.3 Prozent eine geringe. Höchstens mittel zufrieden sind 68.3 Prozent.

Frage und Datenlage

200 Beschäftigte, zwei Merkmale: Abteilung (drei Ausprägungen) und Schichtarbeit (ja/nein). Die Frage: Hängen die beiden zusammen und welche Prozentangabe beantwortet das?

Rechnung

u2 <- lehmer(7715, 200)
abteilung <- ifelse(u2 < 0.4, "Produktion",
                    ifelse(u2 < 0.75, "Verwaltung", "Verkauf"))
anteil <- c(Produktion = 0.55, Verwaltung = 0.25, Verkauf = 0.35)
schicht <- ifelse(lehmer(7716, 200) < anteil[abteilung], "ja", "nein")

tab <- table(abteilung, schicht)
addmargins(tab)
            schicht
abteilung     ja nein Sum
  Produktion  46   33  79
  Verkauf     16   34  50
  Verwaltung  19   52  71
  Sum         81  119 200
round(prop.table(tab) * 100, 1)          # Gesamtanteile
            schicht
abteilung      ja nein
  Produktion 23.0 16.5
  Verkauf     8.0 17.0
  Verwaltung  9.5 26.0
round(prop.table(tab, margin = 1), 3)    # Zeilenanteile: je Abteilung
            schicht
abteilung       ja  nein
  Produktion 0.582 0.418
  Verkauf    0.320 0.680
  Verwaltung 0.268 0.732
round(prop.table(tab, margin = 2), 3)    # Spaltenanteile: je Schichtstatus
            schicht
abteilung       ja  nein
  Produktion 0.568 0.277
  Verkauf    0.198 0.286
  Verwaltung 0.235 0.437
test <- chisq.test(tab)
round(c(chi2 = test$statistic, df = test$parameter, p = test$p.value), 4)
chi2.X-squared          df.df              p 
       17.3641         2.0000         0.0002 
round(sqrt(test$statistic / (sum(tab) * (min(dim(tab)) - 1))), 3)   # Cramers V
X-squared 
    0.295 
u2 = lehmer(7715, 200)
abteilung = np.where(u2 < 0.4, "Produktion",
                     np.where(u2 < 0.75, "Verwaltung", "Verkauf"))
anteil = {"Produktion": 0.55, "Verwaltung": 0.25, "Verkauf": 0.35}
u3 = lehmer(7716, 200)
schicht = np.array(["ja" if u3[i] < anteil[abteilung[i]] else "nein"
                    for i in range(200)])

tab = pd.crosstab(abteilung, schicht, margins=True)
print(tab)
col_0       ja  nein  All
row_0                    
Produktion  46    33   79
Verkauf     16    34   50
Verwaltung  19    52   71
All         81   119  200
roh = pd.crosstab(abteilung, schicht)
print((roh / roh.values.sum() * 100).round(1))
col_0         ja  nein
row_0                 
Produktion  23.0  16.5
Verkauf      8.0  17.0
Verwaltung   9.5  26.0
print(roh.div(roh.sum(axis=1), axis=0).round(3))
col_0          ja   nein
row_0                   
Produktion  0.582  0.418
Verkauf     0.320  0.680
Verwaltung  0.268  0.732
print(roh.div(roh.sum(axis=0), axis=1).round(3))
col_0          ja   nein
row_0                   
Produktion  0.568  0.277
Verkauf     0.198  0.286
Verwaltung  0.235  0.437
chi2, p, dof, _ = stats.chi2_contingency(roh)
print({"chi2": round(chi2, 4), "df": dof, "p": round(p, 4)})
{'chi2': np.float64(17.3641), 'df': 2, 'p': np.float64(0.0002)}
print("Cramers V:",
      round(float(np.sqrt(chi2 / (roh.values.sum() * (min(roh.shape) - 1)))), 3))
Cramers V: 0.295

Output Zeile für Zeile

Die absolute Tabelle:

Schicht ja Schicht nein Summe
Produktion 46 33 79
Verkauf 16 34 50
Verwaltung 19 52 71
Summe 81 119 200

Und dieselbe Tabelle dreimal in Prozent:

Prozentart Bezugsgrösse Produktion / ja Beantwortet die Frage
Gesamt alle 200 23.0 % “Welcher Anteil aller Beschäftigten arbeitet in der Produktion und im Schichtbetrieb?”
Zeile die 79 der Produktion 58.2 % “Welcher Anteil der Produktion arbeitet Schicht?”
Spalte die 81 Schichtarbeitenden 56.8 % “Welcher Anteil der Schichtarbeitenden gehört zur Produktion?”
Beobachtung Erklärung
Drei Zahlen aus einer Zelle 23.0, 58.2 und 56.8 Prozent, alle korrekt und alle etwas anderes. Wer “58 Prozent” ohne Bezugsgrösse schreibt, lässt offen, welche Frage beantwortet wurde.
Für die Frage “hängt es zusammen” zählt die Zeilenprozentzeile Produktion 58.2 Prozent, Verkauf 32.0 Prozent, Verwaltung 26.8 Prozent. Wären die Merkmale unabhängig, stünde überall derselbe Anteil, nämlich die 40.5 Prozent der Randverteilung.
Die Randverteilungen 81 von 200 arbeiten Schicht (40.5 Prozent); 79, 50 und 71 verteilen sich auf die Abteilungen. Sie beschreiben jedes Merkmal für sich, nicht den Zusammenhang.
\(\chi^2\)(2) = 17.36, p < .001 Der Zusammenhang ist mit Zufall nicht vereinbar. Ausführlich unter Chi-Quadrat-Tests.
Cramers V = 0.295 Das Effektmass: 0 heisst kein Zusammenhang, 1 vollständiger. Ein mittlerer Zusammenhang.

Die Faustregel für die Wahl der Prozentart: Prozentuiert wird entlang der erklärenden Variablen. Wenn die Abteilung erklärt, ob jemand Schicht arbeitet, gehören die Zeilenprozente in die Tabelle, dann summiert sich jede Zeile auf 100 Prozent und die Zeilen sind untereinander vergleichbar.

Ein praktischer Test: Ändern sich die Prozentwerte, wenn man in einer Abteilung mehr Leute befragt? Bei Zeilenprozenten nicht, bei Gesamt- und Spaltenprozenten schon. Deshalb sind Zeilenprozente bei ungleich grossen Gruppen fast immer die richtige Wahl.

Interpretation und Ergebnissatz

Schichtarbeit ist in der Produktion deutlich häufiger als in den übrigen Abteilungen: 58.2 Prozent gegenüber 32.0 Prozent im Verkauf und 26.8 Prozent in der Verwaltung (\(\chi^2\)(2) = 17.36, p < .001, Cramers V = 0.30, n = 200).

Frage und Datenlage

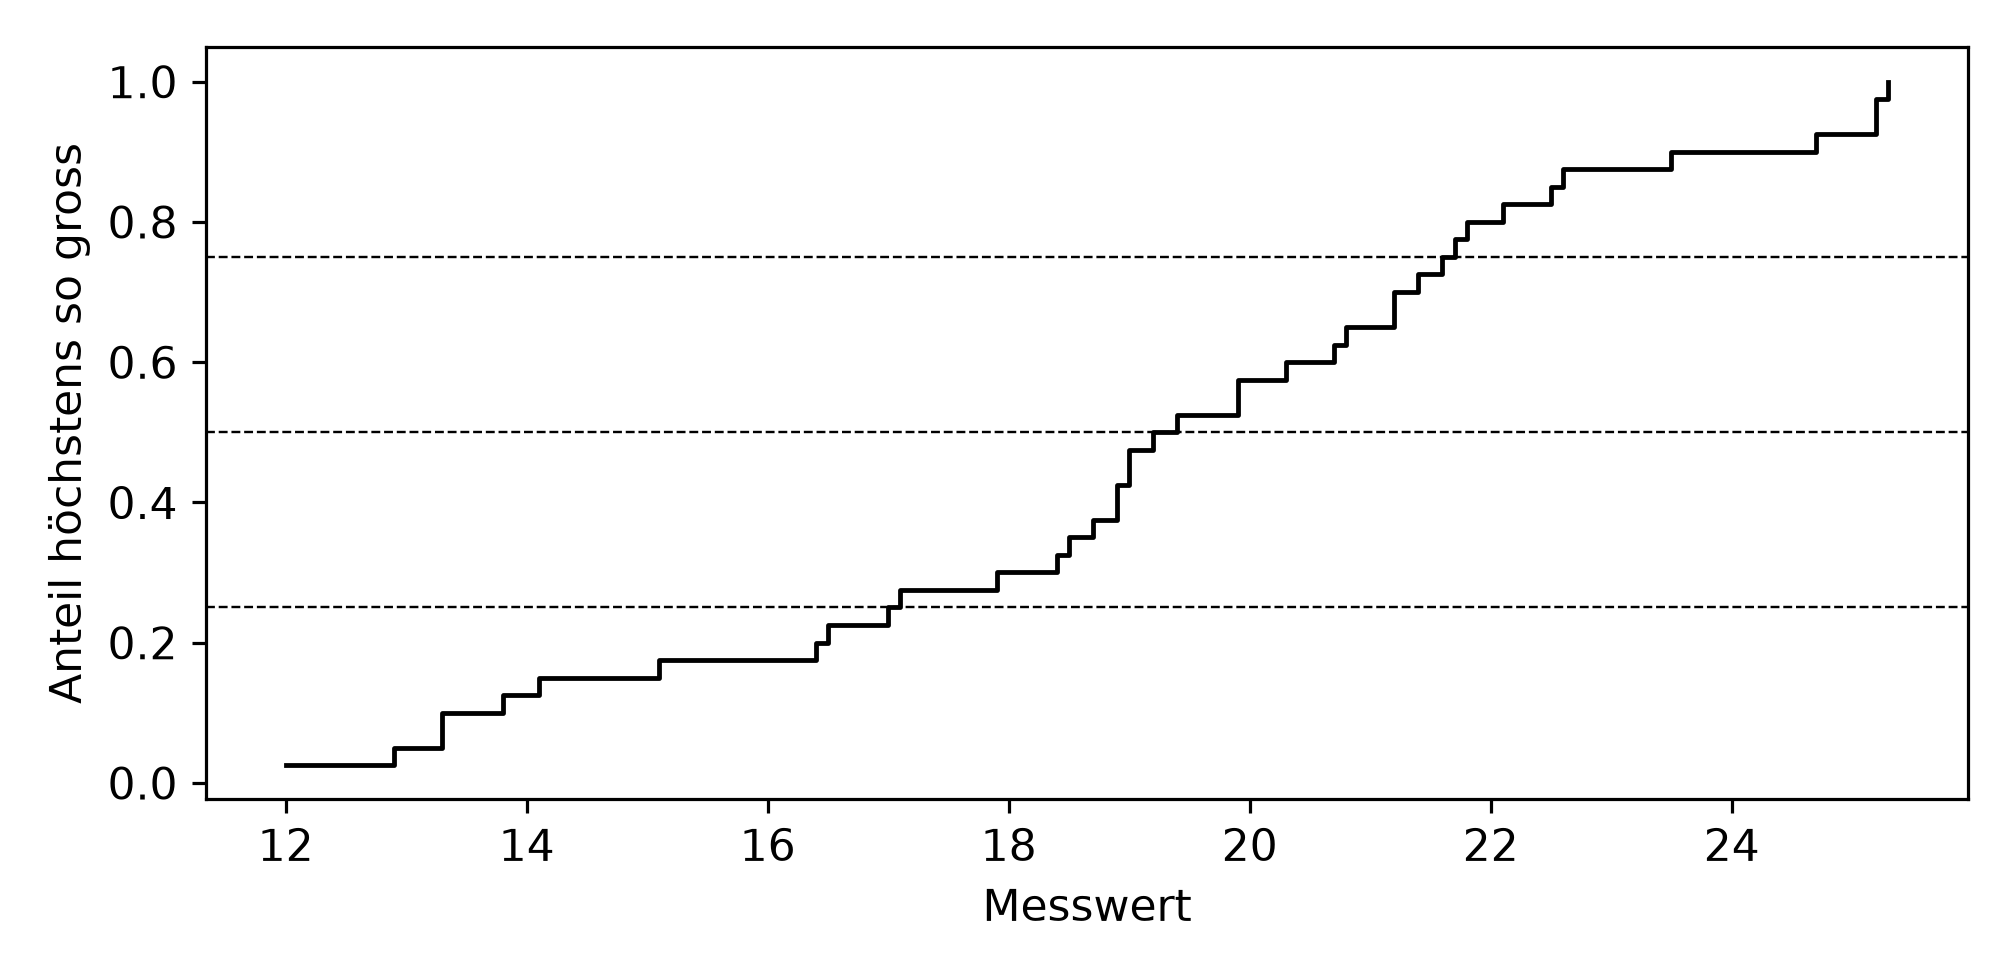
40 Messwerte. Die Verteilungsfunktion zeigt sie alle, ohne eine einzige Entscheidung über Klassen.

Rechnung

x <- round(normalwerte(7712, 40, 20, 4), 1)

ggplot(data.frame(x), aes(x)) +
  stat_ecdf(geom = "step", linewidth = 0.8) +
  geom_hline(yintercept = c(0.25, 0.5, 0.75), linetype = "dashed") +
  labs(x = "Messwert", y = "Anteil höchstens so gross")

round(c(n = length(x), minimum = min(x), q25 = quantile(x, 0.25),
        median = median(x), q75 = quantile(x, 0.75), maximum = max(x)), 2)
      n minimum q25.25%  median q75.75% maximum 
  40.00   12.00   17.08   19.30   21.63   25.30 
# Die Sprunghoehe ist immer 1/n, ausser bei Bindungen
round(1 / length(x), 3)
[1] 0.025
sum(duplicated(x))
[1] 6
Abbildung 1: Beispiel 3: empirische Verteilungsfunktion. Jeder Sprung entspricht einer Beobachtung.
x = np.round(normalwerte(7712, 40, 20, 4), 1)
sortiert = np.sort(x)
anteil = np.arange(1, len(x) + 1) / len(x)

fig, achse = plt.subplots(figsize=(7, 3.4))
_ = achse.step(sortiert, anteil, where="post", linewidth=1.2, color="black")
for hoehe in [0.25, 0.5, 0.75]:
    _ = achse.axhline(hoehe, linestyle="--", color="black", linewidth=0.6)
_ = achse.set_xlabel("Messwert")
_ = achse.set_ylabel("Anteil höchstens so gross")
plt.tight_layout()
plt.show()
Abbildung 2: Beispiel 3: dieselbe Treppenfunktion mit matplotlib.

q25, q50, q75 = np.quantile(x, [0.25, 0.5, 0.75])
print({"n": len(x), "minimum": x.min(), "q25": round(q25, 2),
       "median": round(q50, 2), "q75": round(q75, 2), "maximum": x.max()})
print("Sprunghöhe 1/n:", round(1 / len(x), 3))
print("Bindungen:", len(x) - len(np.unique(x)))

Output Zeile für Zeile

Grösse Wert
n 40
Minimum 12.0
\(Q_{25}\) rund 17.4
Median 19.30
\(Q_{75}\) rund 21.6
Maximum 25.3
Sprunghöhe \(1/n\) 0.025
Ausgabe Wie sie zu lesen ist
Die Kurve springt an jedem beobachteten Wert um 0.025 Bei 40 Beobachtungen trägt jede genau ein Vierzigstel bei. Kommt ein Wert doppelt vor, springt die Kurve dort um das Doppelte.
Die gestrichelten Linien bei 0.25, 0.5 und 0.75 schneiden die Kurve an den drei Quartilen. So liest man Quantile aus der Grafik ab, waagerecht hinein, senkrecht heraus.
Zwischen den Sprüngen ist die Kurve waagrecht Dort liegt keine Beobachtung. Ein langer waagrechter Abschnitt ist eine Lücke in den Daten.
Die Kurve beginnt bei 0 und endet bei 1 Immer. Das ist der Unterschied zu einem Histogramm, dessen Höhe von der Klassenbreite abhängt.

Warum diese Darstellung unterschätzt wird: Sie enthält die vollständige Information der Stichprobe, aus ihr lässt sich jeder einzelne Wert zurückgewinnen. Ein Histogramm kann das nicht, weil es die Werte innerhalb einer Klasse zusammenwirft.

Der Preis ist die Lesbarkeit: Die Form der Verteilung (schief, zweigipflig, symmetrisch) ist in einer Treppenkurve schwerer zu erkennen als in einem Histogramm. Ein steiler Abschnitt bedeutet viele Werte, ein flacher wenige, man liest also die Steigung statt der Höhe.

Für den Vergleich mehrerer Gruppen ist sie dagegen die bessere Wahl: Drei Treppenkurven übereinander sind lesbar, drei Histogramme nicht.

Interpretation

Wo eine Darstellung frei von willkürlichen Entscheidungen sein soll, ist die Verteilungsfunktion die richtige. Wo die Form gezeigt werden soll, das Histogramm und für beides braucht es Beispiel 4.

Frage und Datenlage

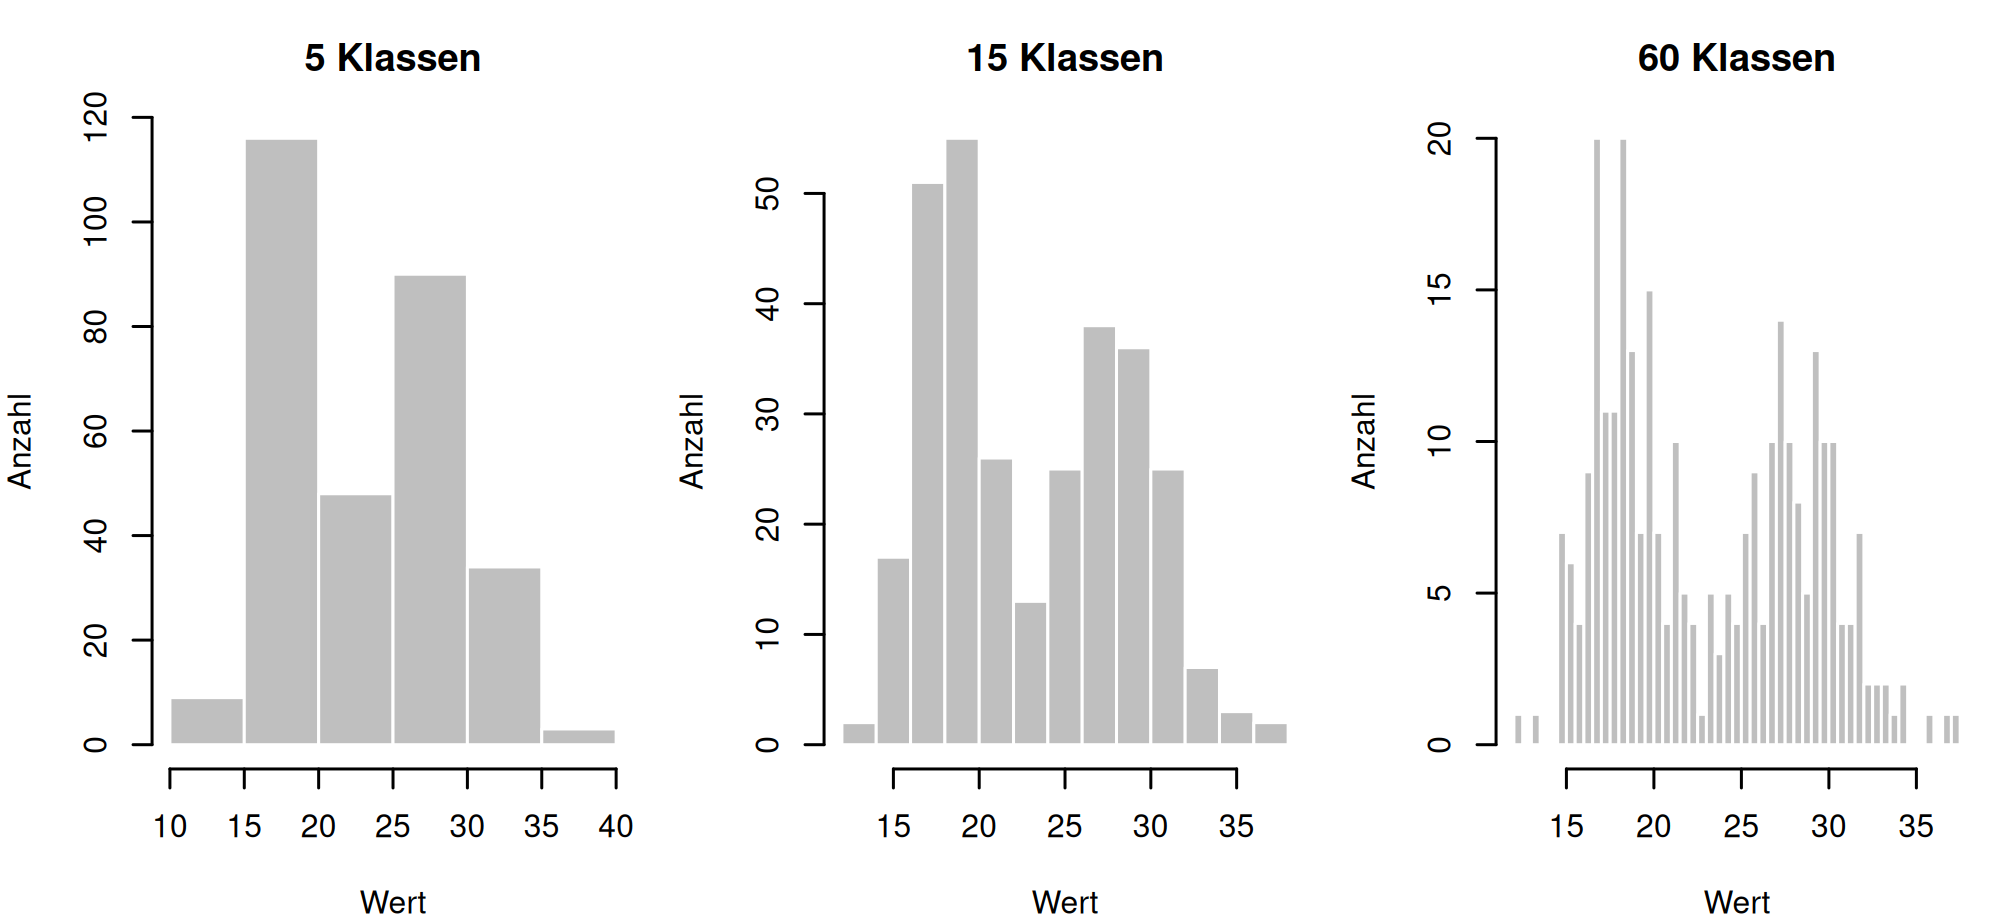
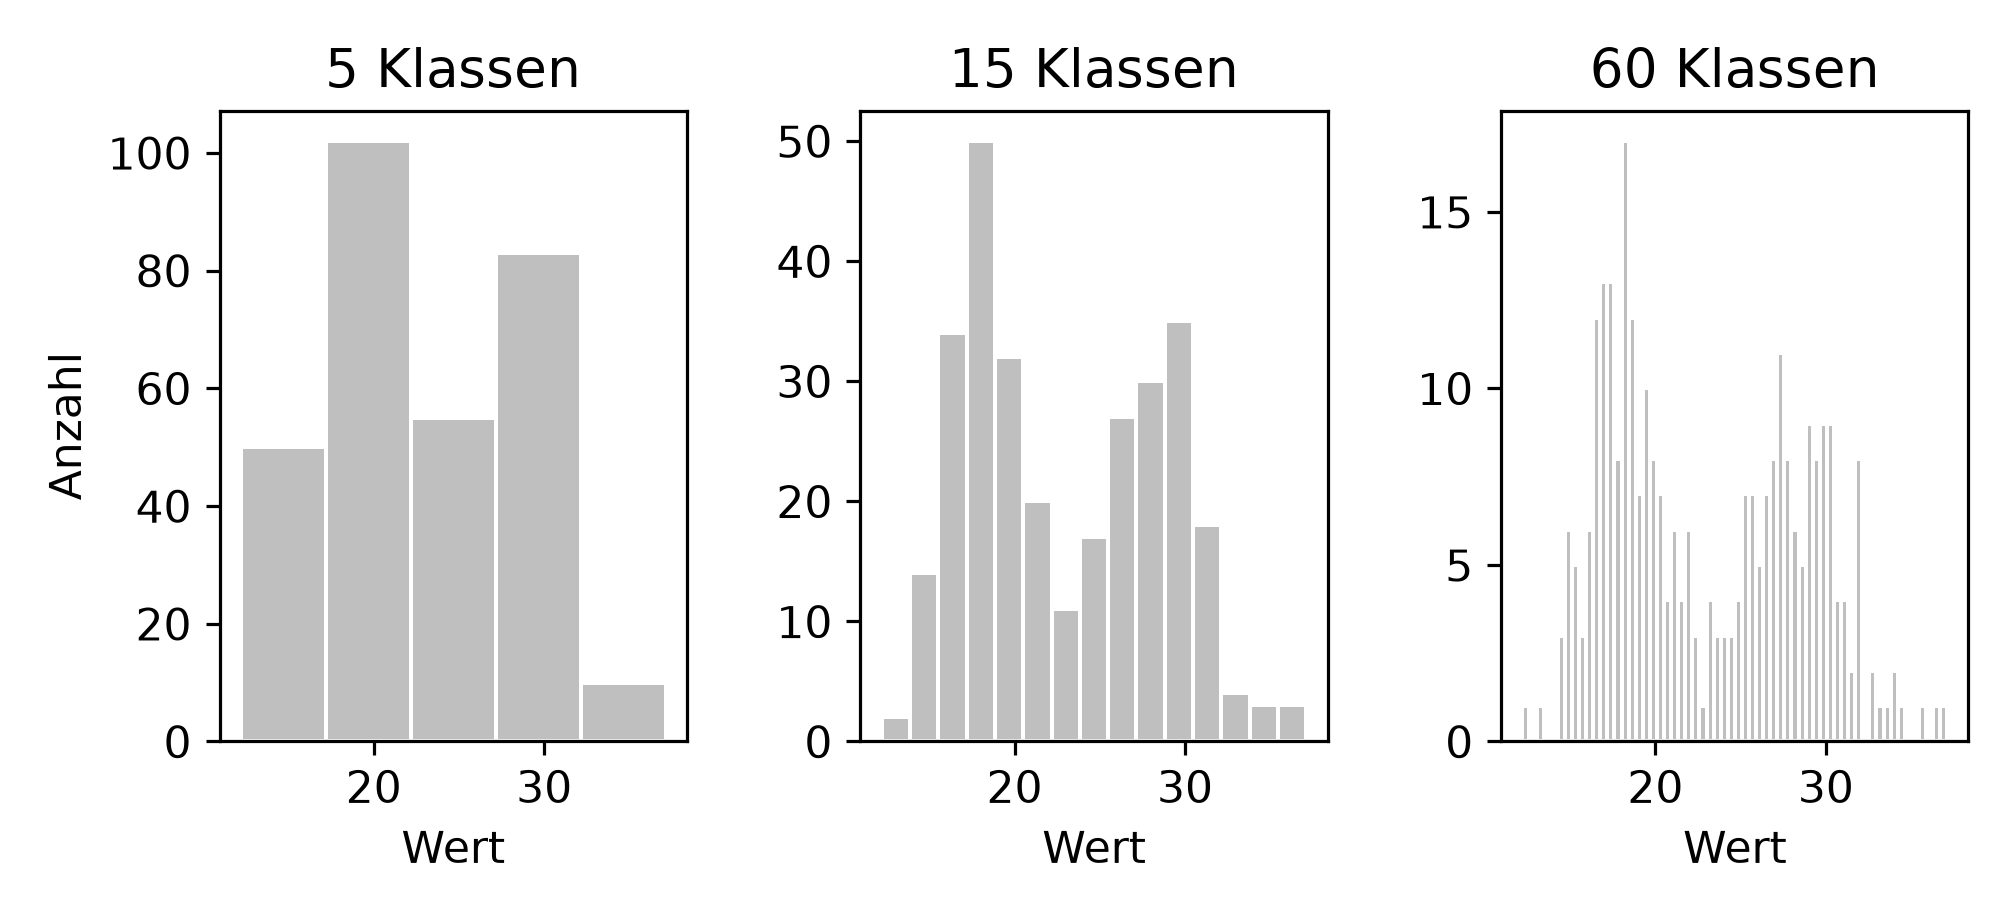
300 Werte aus zwei überlagerten Gruppen (Schwerpunkte bei 18 und 28). Dieselben Daten, dreimal gezeichnet.

Rechnung

par(mfrow = c(1, 3), mar = c(4, 4, 3, 1))
for (k in c(5, 15, 60)) {
  hist(werte, breaks = k, col = "grey75", border = "white",
       main = paste(k, "Klassen"), xlab = "Wert", ylab = "Anzahl")
}
par(mfrow = c(1, 1))

# Die Faustregeln im Vergleich
n <- length(werte)
round(c(n = n, wurzel = sqrt(n), sturges = 1 + log2(n),
        rice = 2 * n^(1 / 3),
        spannweite = diff(range(werte))), 1)
         n     wurzel    sturges       rice spannweite 
     300.0       17.3        9.2       13.4       24.9 
Abbildung 3: Beispiel 4: dieselben 300 Werte mit 5, 15 und 60 Klassen.
fig, achsen = plt.subplots(1, 3, figsize=(7, 3.2))
for achse, k in zip(achsen, [5, 15, 60]):
    _ = achse.hist(werte, bins=k, color="0.75", edgecolor="white")
    _ = achse.set_title(f"{k} Klassen")
    _ = achse.set_xlabel("Wert")
_ = achsen[0].set_ylabel("Anzahl")
plt.tight_layout()
plt.show()
Abbildung 4: Beispiel 4: dieselbe Gegenüberstellung mit matplotlib.

n = len(werte)
print({"n": n, "wurzel": round(np.sqrt(n), 1),
       "sturges": round(1 + np.log2(n), 1),
       "rice": round(2 * n ** (1 / 3), 1),
       "spannweite": round(werte.max() - werte.min(), 1)})

Output Zeile für Zeile

Klassenzahl Klassenbreite Was zu sehen ist
5 rund 5 Einheiten Ein einziger breiter Berg. Die beiden Gruppen sind weggeglättet, sie fallen in dieselben Klassen.
15 rund 1.7 Zwei Gipfel, klar getrennt. Das entspricht der Wahrheit.
60 rund 0.4 Ein zackiges Auf und Ab. Die zwei Gipfel sind noch erkennbar, aber jede einzelne Klasse enthält im Mittel nur fünf Werte, und deren Schwankung sieht aus wie Struktur.
Faustregel Wert bei \(n = 300\)
Wurzelregel \(\sqrt{n}\) 17.3
Sturges \(1 + \log_2 n\) 9.2
Rice \(2\sqrt[3]{n}\) 13.4
Beobachtung Erklärung
Die Regeln liegen zwischen 9 und 17 Und alle drei hätten hier funktioniert, die Zweigipfligkeit ist ab etwa 10 Klassen erkennbar.
Sturges liefert am wenigsten Die Regel leitet sich aus der Binomialverteilung ab und unterstellt annähernd normalverteilte Daten. Bei zweigipfligen oder schiefen Verteilungen glättet sie zu stark.
Keine Regel kennt die Daten Sie hängen alle nur an \(n\). Eine Regel, die auch die Streuung einbezieht, ist Freedman-Diaconis: Klassenbreite \(= 2 \cdot \text{IQR} / \sqrt[3]{n}\).
Die Voreinstellung ist nicht neutral R nimmt Sturges, matplotlib nimmt zehn Klassen. Wer die Voreinstellung übernimmt, hat die Entscheidung getroffen, ohne es zu merken.

Was daraus für die Praxis folgt: Die Klassenzahl wird variiert, bevor eine Grafik in einen Bericht kommt. Zeigt sich dieselbe Struktur bei 10, 15 und 25 Klassen, ist sie da. Verschwindet sie bei kleiner Änderung, war sie Zufall.

Und im Bericht gehört die gewählte Klassenzahl genannt, sobald sie von der Voreinstellung abweicht, genau wie jede andere Analyseentscheidung.

Interpretation und Ergebnissatz

Die 300 Messwerte verteilen sich zweigipflig mit Schwerpunkten bei rund 18 und 28 (Histogramm mit 15 Klassen). Bei fünf Klassen ist die Struktur nicht mehr erkennbar, bei sechzig überlagert Zufallsschwankung sie.

Frage und Datenlage

Zwei Fragen auf einmal: Wann welcher Diagrammtyp und was tun, wenn die Klassen verschieden breit sind?

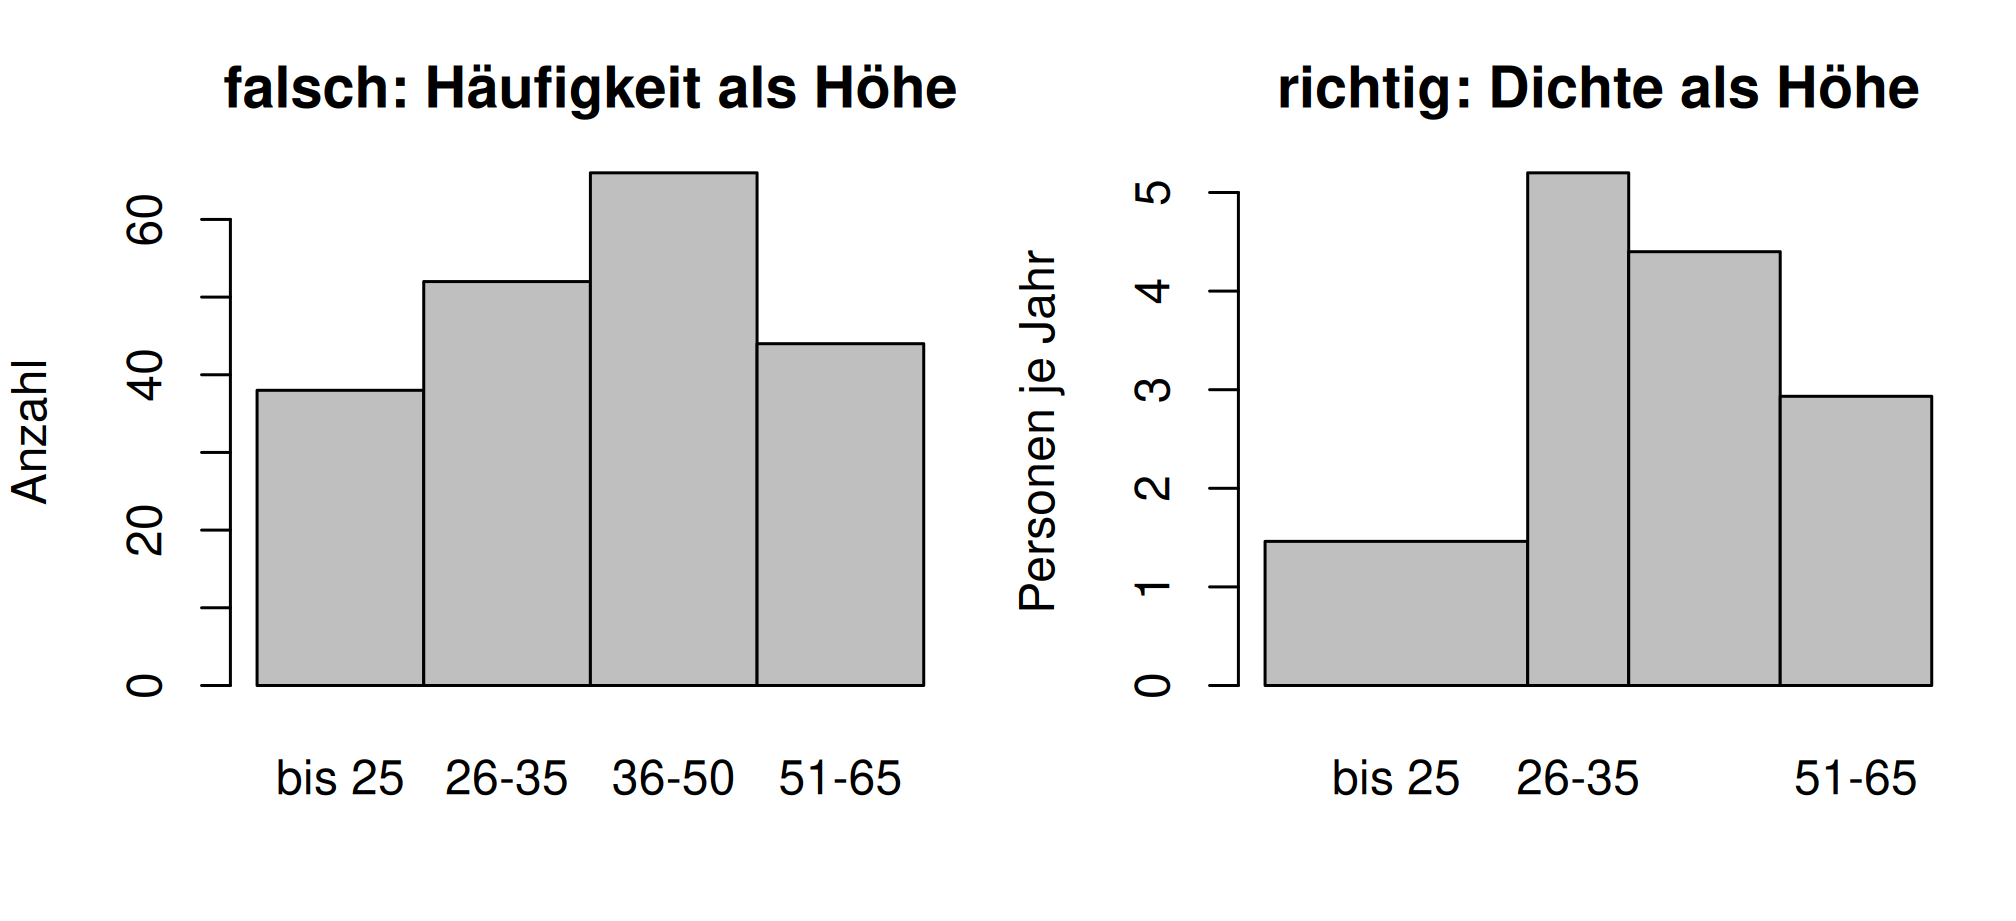
Die Altersverteilung einer Belegschaft in den üblichen, ungleich breiten Klassen: bis 25 (26 Jahre), 26 bis 35 (10 Jahre), 36 bis 50 (15 Jahre), 51 bis 65 (15 Jahre).

Rechnung

par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))
barplot(table(zufriedenheit), col = "grey75",
        main = "Stabdiagramm, ordinal", ylab = "Anzahl")
hist(werte, breaks = 15, col = "grey75", border = "white",
     main = "Histogramm, metrisch", xlab = "Wert", ylab = "Anzahl")
par(mfrow = c(1, 1))
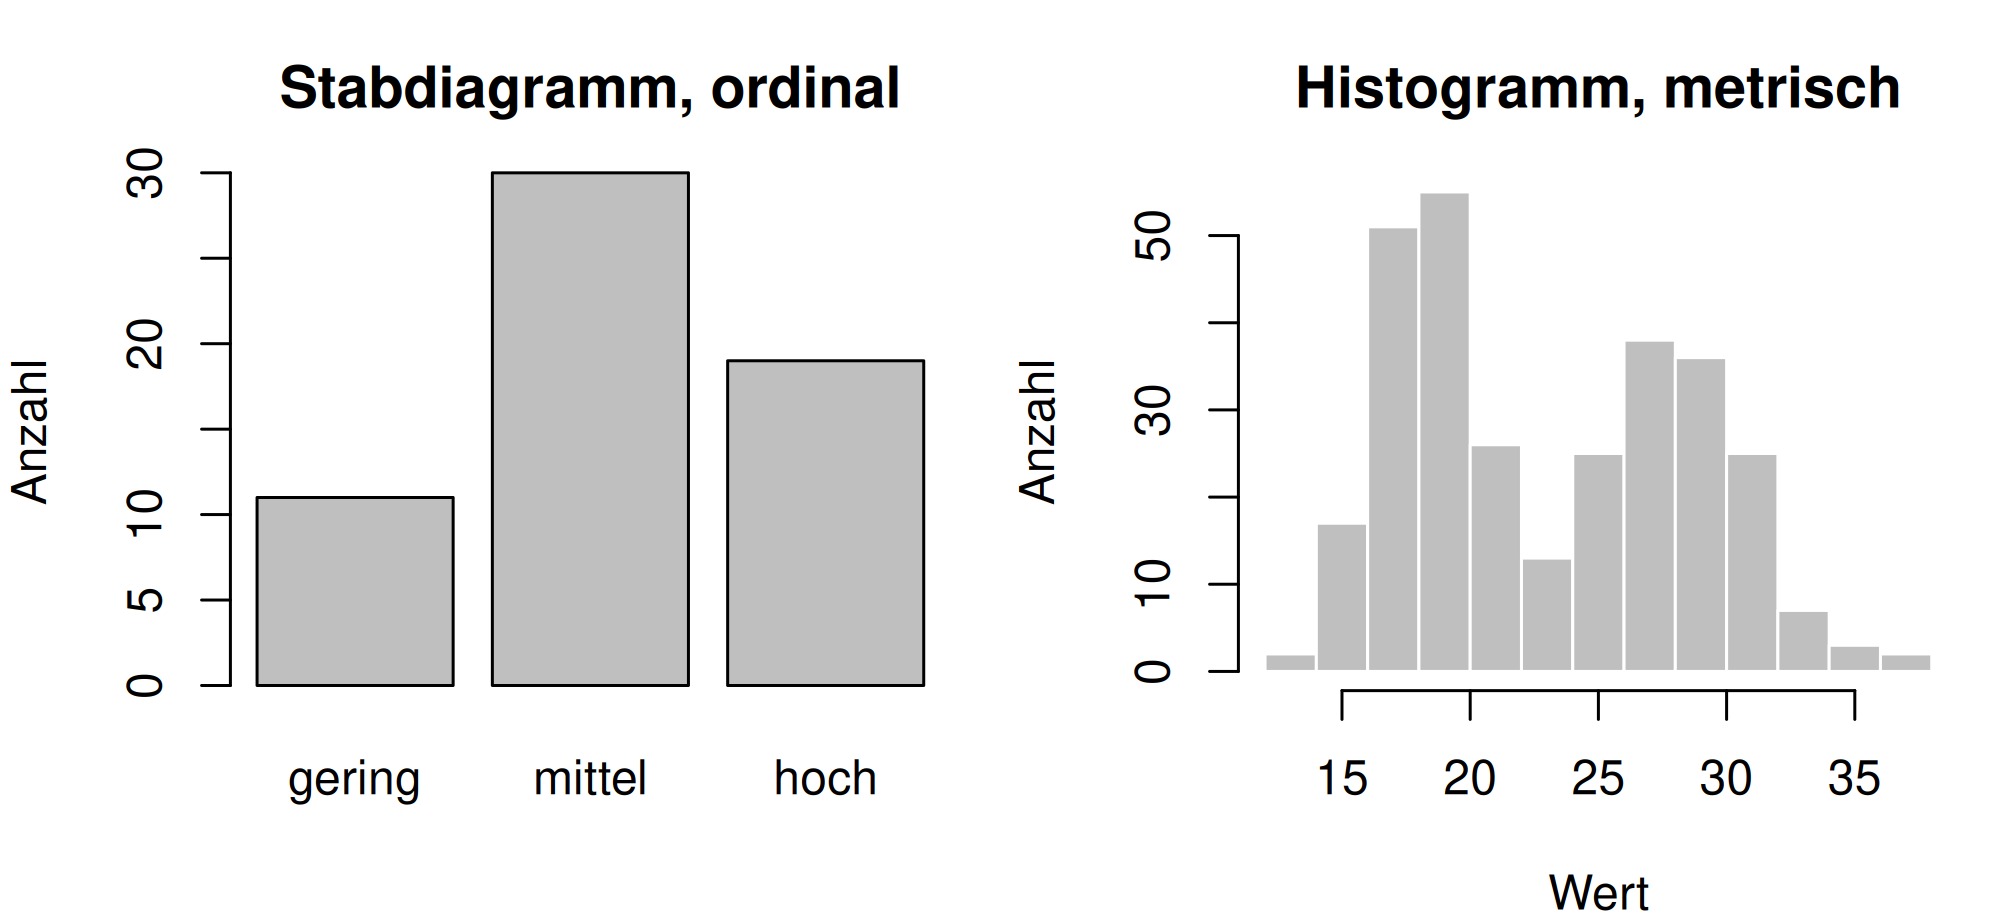
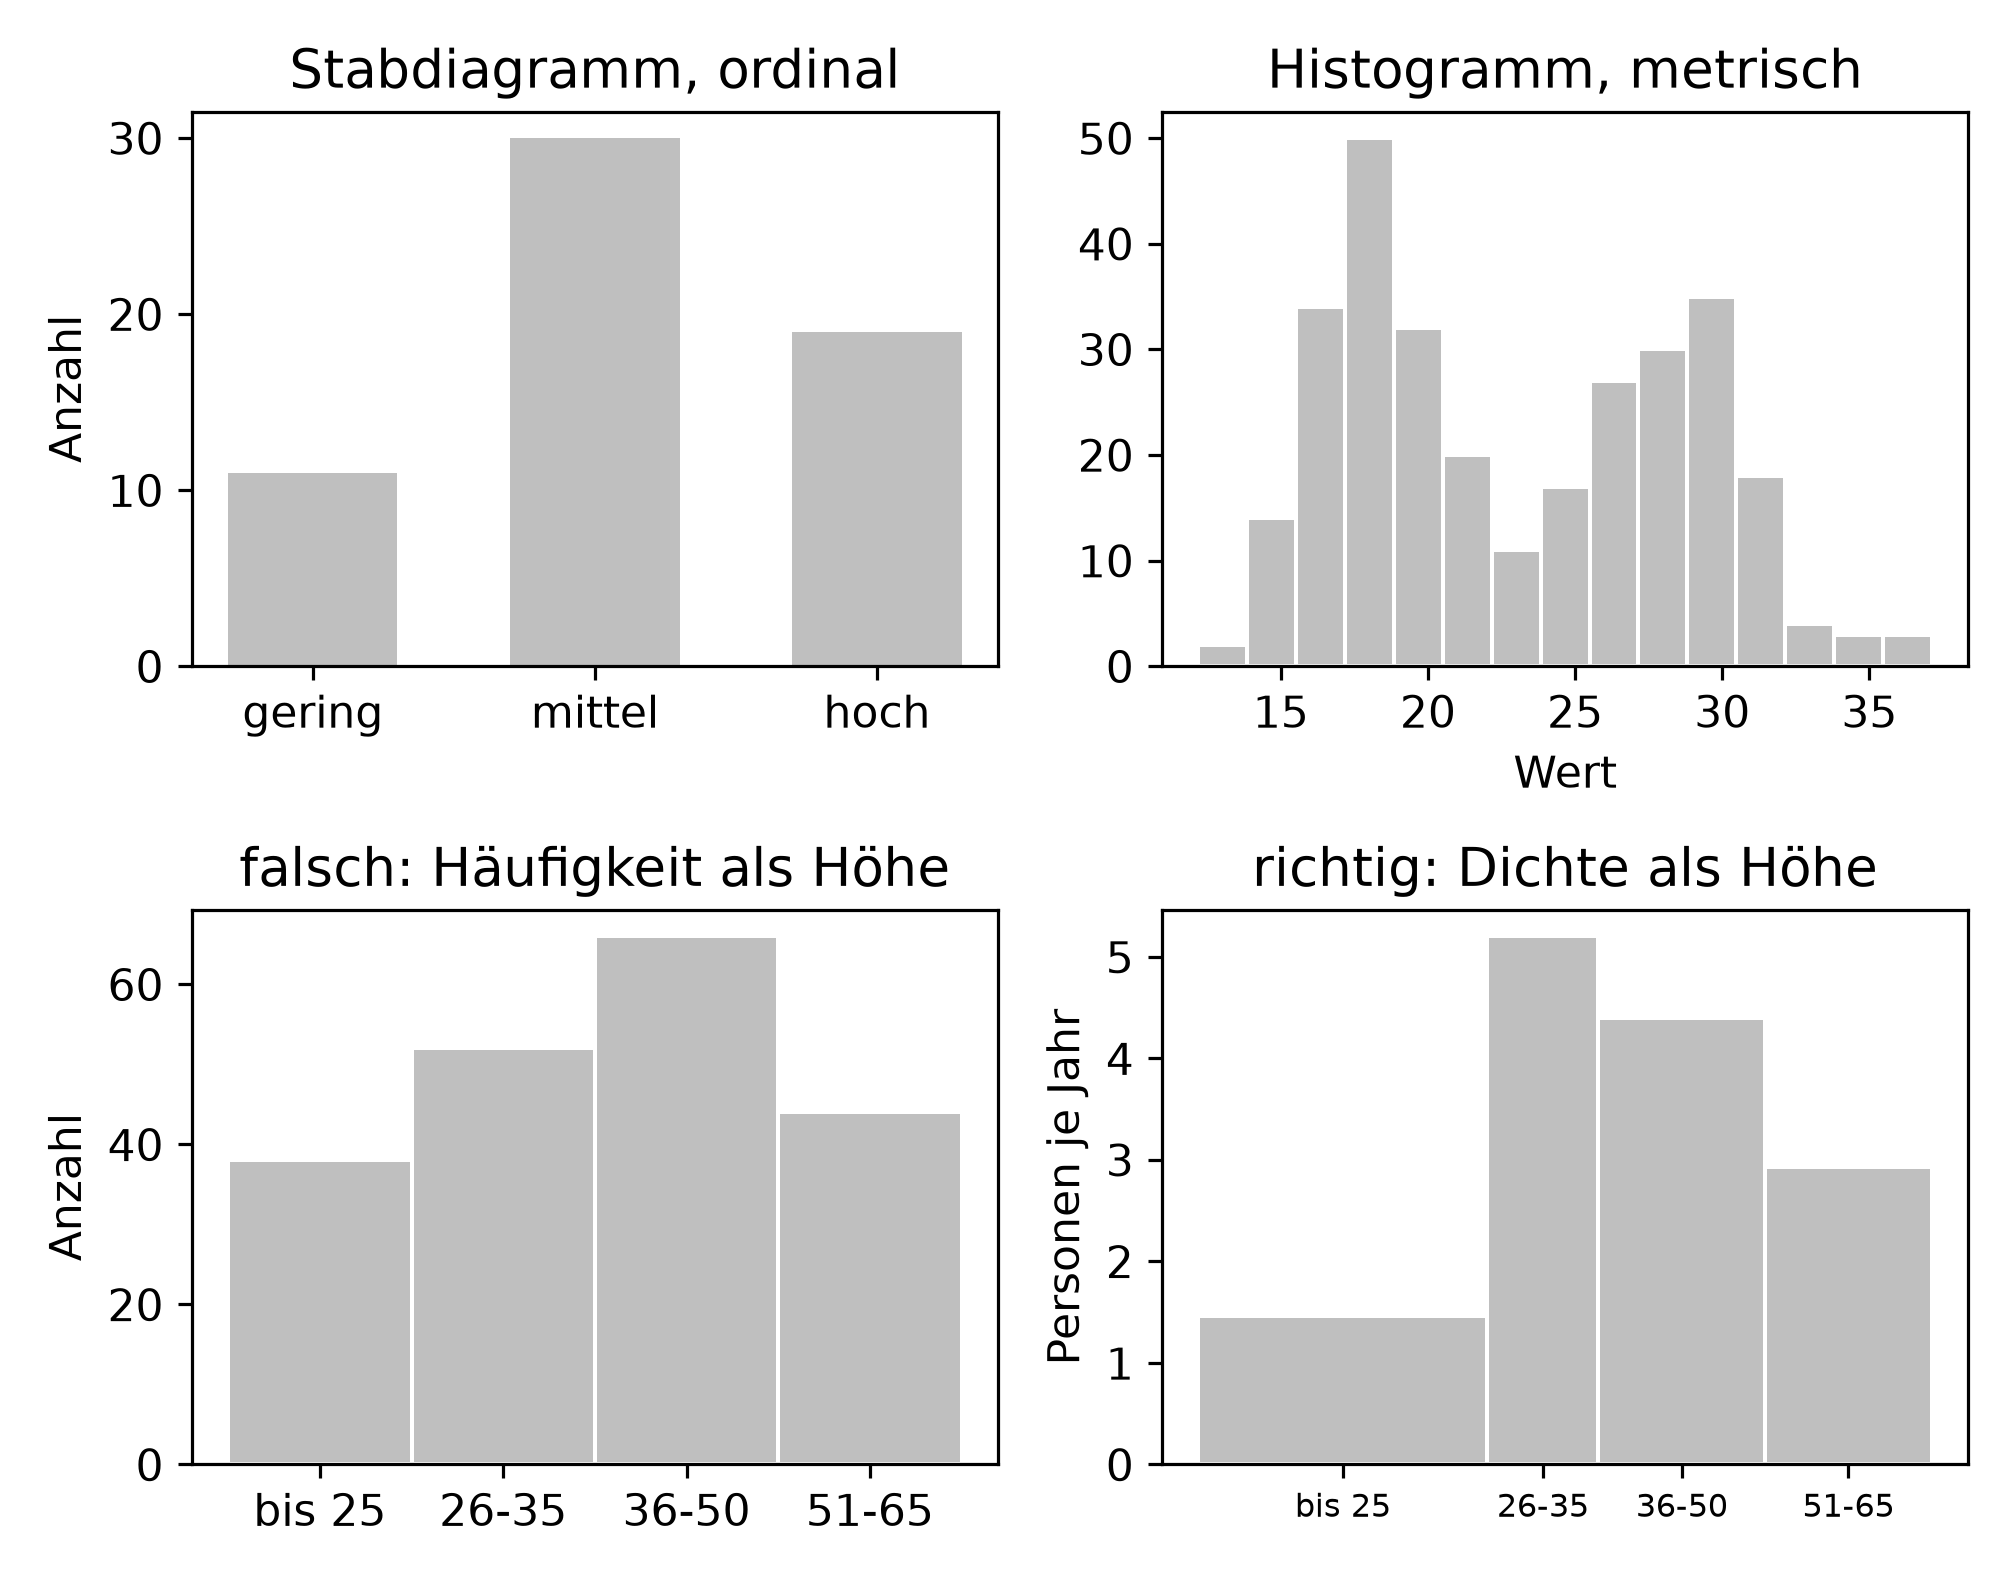
Abbildung 5: Beispiel 5: links Kategorien mit Abstand, rechts ein Kontinuum ohne Lücken.
klassen <- c("bis 25", "26-35", "36-50", "51-65")
anzahl <- c(38, 52, 66, 44)
breite <- c(26, 10, 15, 15)
dichte <- anzahl / breite

data.frame(klassen, anzahl, breite, dichte = round(dichte, 2))
  klassen anzahl breite dichte
1  bis 25     38     26   1.46
2   26-35     52     10   5.20
3   36-50     66     15   4.40
4   51-65     44     15   2.93
par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))
barplot(anzahl, names.arg = klassen, col = "grey75", space = 0,
        main = "falsch: Häufigkeit als Höhe", ylab = "Anzahl")
barplot(dichte, names.arg = klassen, col = "grey75", space = 0, width = breite,
        main = "richtig: Dichte als Höhe", ylab = "Personen je Jahr")
par(mfrow = c(1, 1))
Abbildung 6: Beispiel 5: ungleich breite Altersklassen. Links die reine Häufigkeit, rechts die Häufigkeitsdichte.
anzahl_z = zufriedenheit.value_counts().reindex(stufen)

klassen = ["bis 25", "26-35", "36-50", "51-65"]
anzahl = np.array([38, 52, 66, 44])
breite = np.array([26, 10, 15, 15])
dichte = anzahl / breite

print(pd.DataFrame({"klasse": klassen, "anzahl": anzahl, "breite": breite,
                    "dichte": dichte.round(2)}).to_string(index=False))

fig, achsen = plt.subplots(2, 2, figsize=(7, 5.5))
_ = achsen[0, 0].bar(list(anzahl_z.index), anzahl_z.values, color="0.75", width=0.6)
_ = achsen[0, 0].set_title("Stabdiagramm, ordinal")
_ = achsen[0, 0].set_ylabel("Anzahl")
_ = achsen[0, 1].hist(werte, bins=15, color="0.75", edgecolor="white")
_ = achsen[0, 1].set_title("Histogramm, metrisch")
_ = achsen[0, 1].set_xlabel("Wert")

_ = achsen[1, 0].bar(klassen, anzahl, color="0.75", width=1.0, edgecolor="white")
_ = achsen[1, 0].set_title("falsch: Häufigkeit als Höhe")
_ = achsen[1, 0].set_ylabel("Anzahl")
kanten = np.r_[0, np.cumsum(breite)]
_ = achsen[1, 1].bar(kanten[:-1], dichte, width=breite, align="edge",
                 color="0.75", edgecolor="white")
_ = achsen[1, 1].set_xticks(kanten[:-1] + breite / 2)
_ = achsen[1, 1].set_xticklabels(klassen, fontsize=8)
_ = achsen[1, 1].set_title("richtig: Dichte als Höhe")
_ = achsen[1, 1].set_ylabel("Personen je Jahr")
plt.tight_layout()
plt.show()
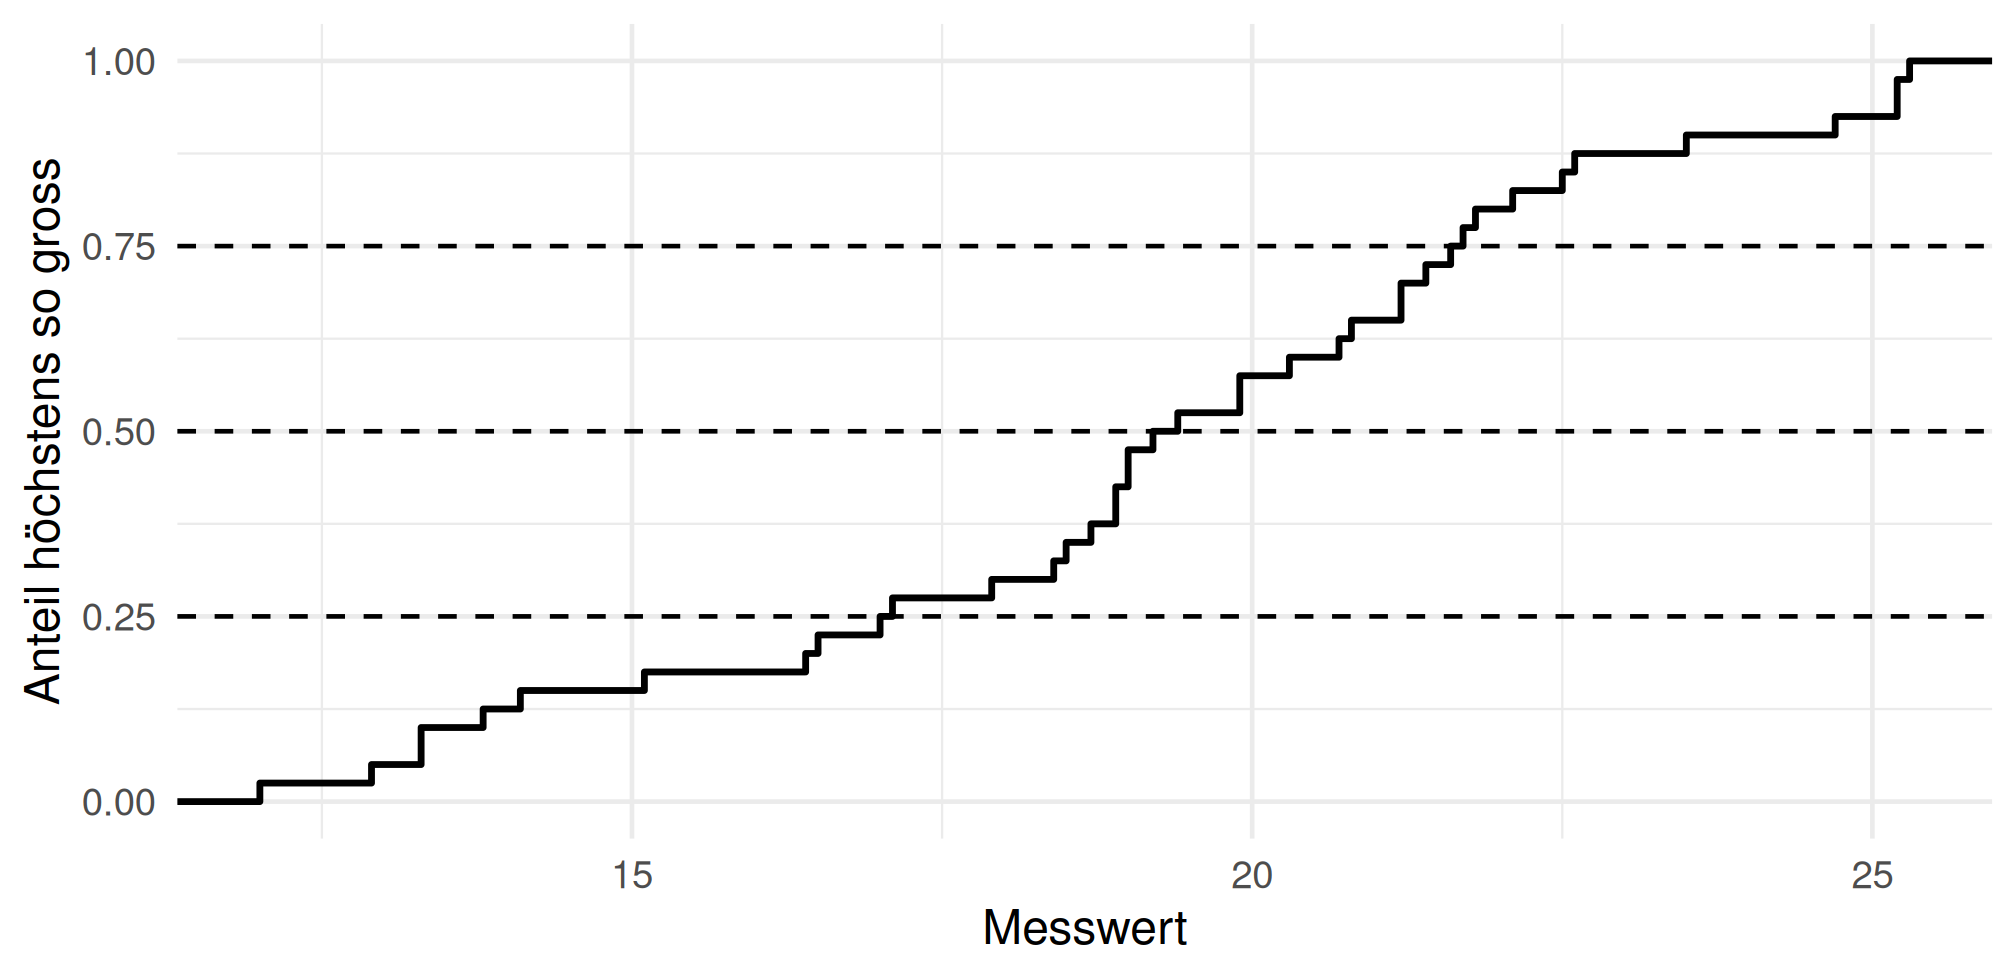
Abbildung 7: Beispiel 5: beide Gegenüberstellungen in Python.

Output Zeile für Zeile

Klasse Anzahl Breite (Jahre) Dichte (Personen je Jahr)
bis 25 38 26 1.46
26 bis 35 52 10 5.20
36 bis 50 66 15 4.40
51 bis 65 44 15 2.93
Beobachtung Erklärung
Nach Anzahl ist die Klasse 36 bis 50 die grösste 66 Personen.
Nach Dichte ist es die Klasse 26 bis 35 5.20 gegen 4.40 Personen je Jahrgang. Die Rangfolge kehrt sich um.
Die Klasse “bis 25” sieht in der falschen Darstellung mittelgross aus Mit 1.46 Personen je Jahrgang ist sie die mit Abstand dünnste, sie wirkt nur gross, weil sie 26 Jahrgänge zusammenfasst.
Die Fläche trägt die Information Breite mal Höhe ergibt wieder die Anzahl: \(26 \cdot 1.46 = 38\). Genau deshalb ist die Dichte die richtige Höhe.

Und die Unterscheidung der beiden Diagrammtypen:

Woran man es erkennt Stabdiagramm Histogramm
Abstand zwischen den Balken vorhanden keiner
Achsenbeschriftung Kategorienamen Zahlen mit Skala
Umordnen der Balken erlaubt (bei nominal) verboten

Ein verwandter Fehler, der noch häufiger vorkommt: Ein Stabdiagramm mit Balken, deren Achse nicht bei null beginnt. Bei einem Histogramm ist die abgeschnittene Achse ausgeschlossen, weil die Fläche die Information trägt; bei Balken wird sie regelmässig verwendet, um kleine Unterschiede gross aussehen zu lassen.

Die Regel: Balkenlängen werden verglichen, also beginnt die Achse bei null. Wer Unterschiede genauer zeigen will, nimmt einen Punktplot, dort vergleicht man Positionen, nicht Längen, und eine abgeschnittene Achse ist zulässig.

Interpretation und Ergebnissatz

Die Altersverteilung ist in ungleich breiten Klassen erhoben. Aufgetragen wird die Häufigkeitsdichte: Am stärksten besetzt ist die Klasse 26 bis 35 mit 5.2 Personen je Jahrgang, am schwächsten die Klasse bis 25 mit 1.5, obwohl diese in absoluten Zahlen nicht die kleinste ist.

Verständnisfragen

Eine Kreuztabelle nennt für die Zelle “Produktion und Schicht” die Zahl 58.2 Prozent. Worauf bezieht sie sich?

Auf die Beschäftigten der Produktion
Richtig, das ist der Zeilenanteil. Die Gesamtprozente wären 23.0, die Spaltenprozente 56.8, drei richtige Zahlen für dieselbe Zelle, die verschiedene Fragen beantworten.
Auf alle Beschäftigten
Das wären die Gesamtprozente.
Auf die Schichtarbeitenden
Das wären die Spaltenprozente.

Dieselben 300 Werte werden mit 5, 15 und 60 Klassen dargestellt. Was zeigt der Vergleich?

Mehr Klassen sind immer genauer
Bei sechzig geht die Struktur im Rauschen unter. Auflösung ist nicht dasselbe wie Erkenntnis.
Die zwei überlagerten Gruppen sind erst ab etwa zehn Klassen zu sehen
Richtig. Zu wenige Klassen glätten die Struktur weg, zu viele lassen Zufall wie Struktur aussehen.
Die Klassenzahl beeinflusst nur das Aussehen, nicht die Aussage
Sie beeinflusst genau die Aussage.

Warum ist die empirische Verteilungsfunktion unabhängig von der Klassenzahl?

Weil sie keine Klassen bildet, sondern an jedem beobachteten Wert springt
Richtig. Sie enthält damit die vollständige Information der Stichprobe und eignet sich, wenn eine Darstellung frei von willkürlichen Entscheidungen sein soll.
Weil sie immer 100 Klassen verwendet
Sie verwendet gar keine.
Weil sie nur für kleine Stichproben definiert ist
Sie ist für jede Stichprobengrösse definiert.

Eine Altersverteilung wird in den Klassen bis 25, 26 bis 35, 36 bis 50 und 51 bis 65 dargestellt. Was ist beim Zeichnen zu beachten?

Aufzutragen ist die Häufigkeitsdichte, nicht die Häufigkeit
Richtig. Die Klassen sind 26, 10, 15 und 15 Jahre breit. Trägt man die reinen Häufigkeiten als Höhe auf, kehrt sich die Rangfolge um: Nach Anzahl ist 36 bis 50 die grösste Klasse, nach Dichte 26 bis 35.
Die Klassen müssen gleich viele Personen enthalten
Das ist nicht nötig und meist gar nicht möglich.
Nichts Besonderes, ein Histogramm ist ein Histogramm
Bei ungleichen Klassenbreiten trägt die Fläche die Information, nicht die Höhe.

Woran erkennt man in einer fremden Grafik, ob ein Histogramm oder ein Stabdiagramm gemeint war?

An der Farbe der Balken
Die Farbe trägt keine solche Information.
Am Abstand zwischen den Balken und an der Achse
Richtig. Berühren sich die Balken über einer kontinuierlichen Achse, ist es ein Histogramm. Stehen sie getrennt über beschrifteten Kategorien, ein Stabdiagramm und dort darf man sie umordnen, im Histogramm nicht.
An der Anzahl der Balken
Beide können beliebig viele haben.

Eine Auswertung nennt “höchstens mittel: 68 Prozent” für die Abteilungen eines Betriebs. Was ist daran falsch?

Kumulierte Häufigkeiten setzen eine Ordnung voraus, die es hier nicht gibt
Richtig. Abteilungen sind nominal; ihre Reihenfolge in der Tabelle ist willkürlich, meist alphabetisch. Beide Programme rechnen die Summe trotzdem klaglos aus.
68 Prozent ist zu hoch für eine Kategorie
Die Höhe ist nicht das Problem.
Es fehlt die Angabe von n
Sie fehlt tatsächlich, aber der eigentliche Fehler liegt in der Kumulierung.

Verlinkte Ressourcen