Typische Fragestellungen: Rauschen aus einer Reihe entfernen, um den Verlauf zu sehen; eine schnelle Prognose für die nächsten Monate; eine Vergleichsgrundlage, gegen die sich ein aufwendigeres Modell beweisen muss.
Glättungsverfahren sind einfach, robust und oft überraschend gut. Ihr Kern ist ein gewichteter Mittelwert der Vergangenheit: Der gleitende Durchschnitt gewichtet alle Werte im Fenster gleich, die exponentielle Glättung gewichtet neuere Werte stärker.
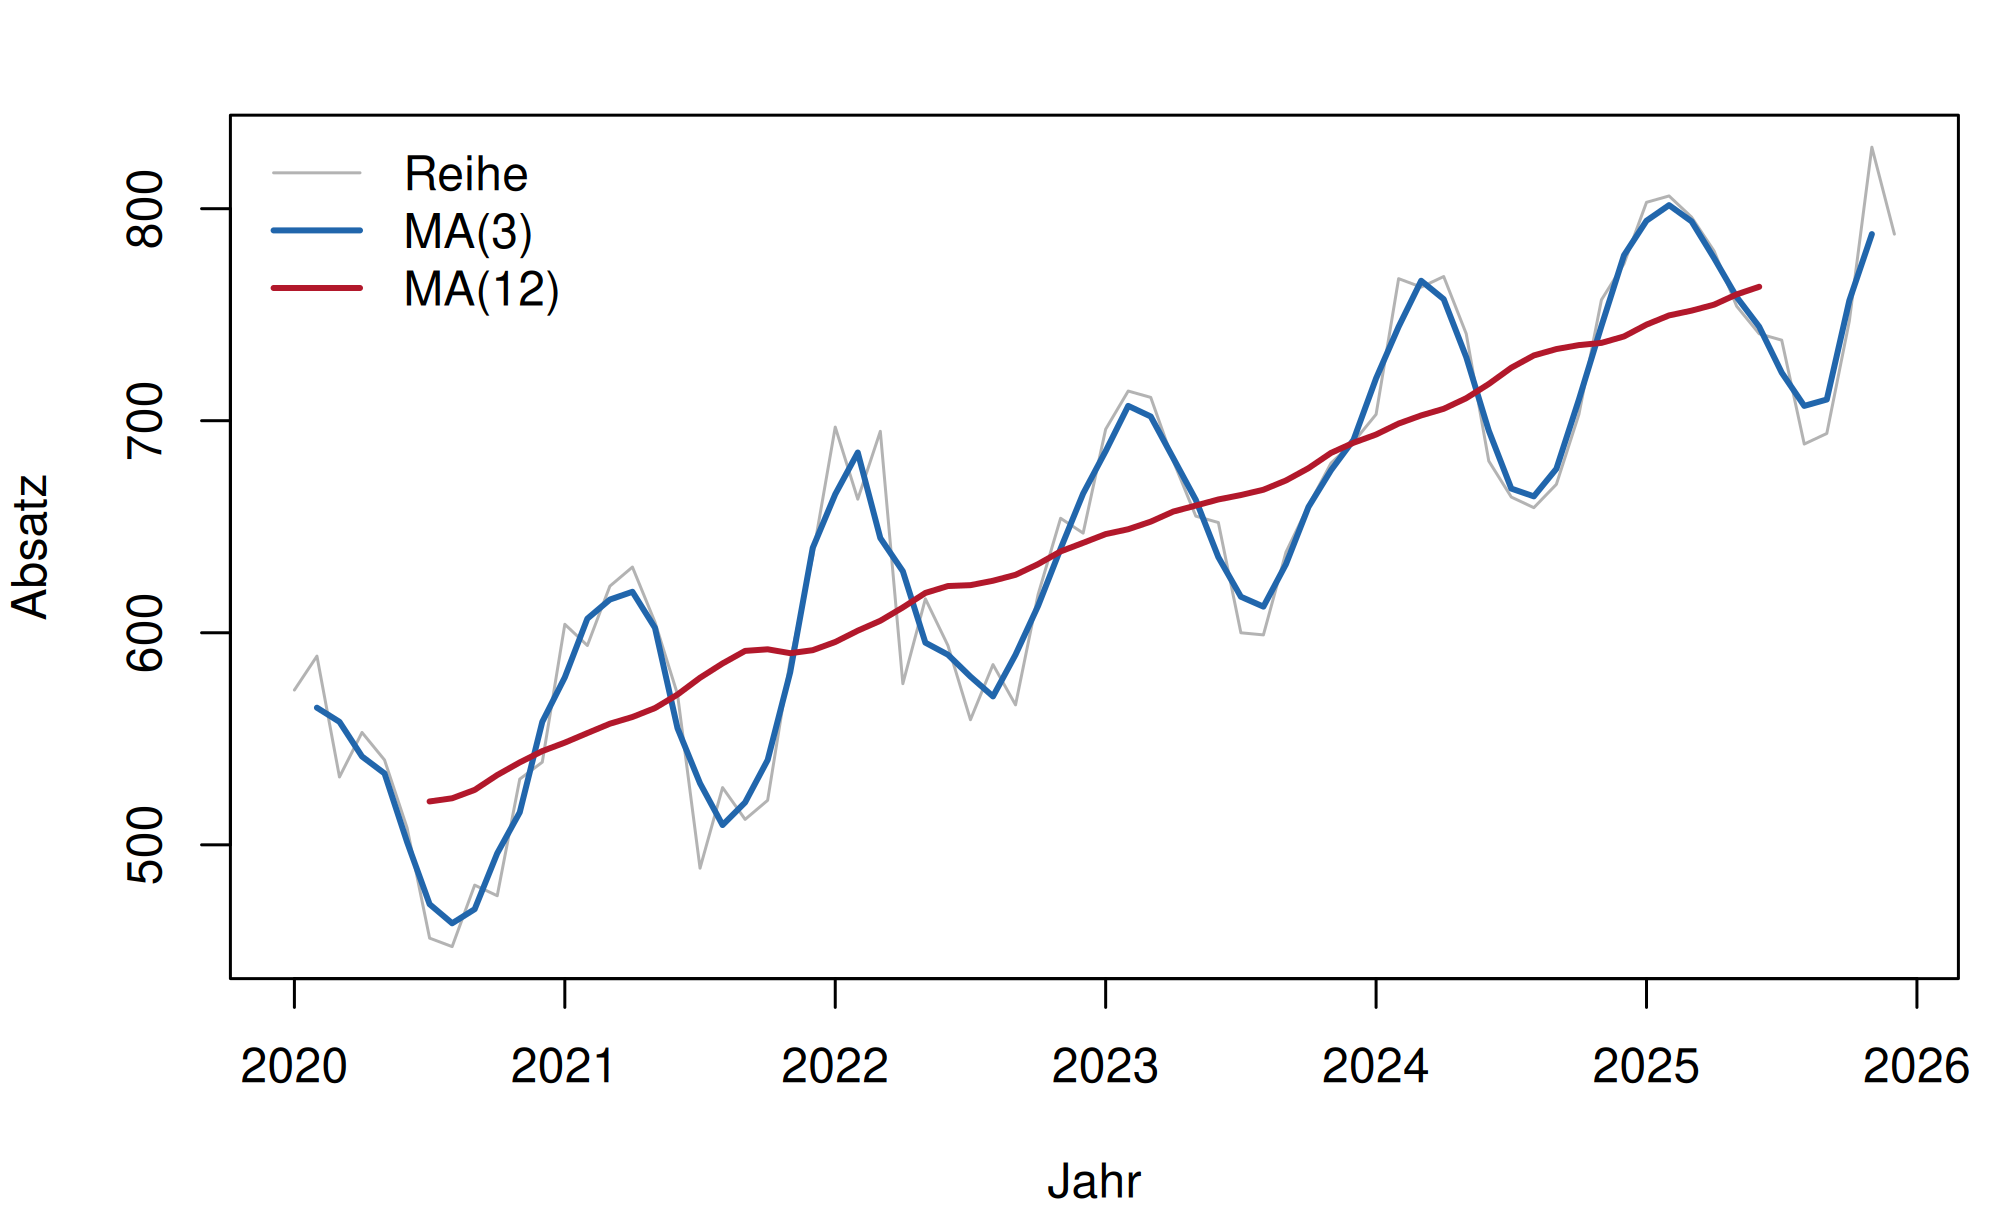
Das ist beschreibend, nicht prognostisch: Es braucht Werte aus der Zukunft und verkürzt die Reihe an beiden Enden. Für Saisonbereinigung ist die Fensterbreite die Periode, also 12 bei Monatsdaten.
Exponentielle Glättung. Hier wird nur die Vergangenheit verwendet, und ältere Werte zählen weniger:
Drei Unterschiede, über die man stolpert. R wählt mit ets() die Modellstruktur automatisch, in Python werden trend und seasonal von Hand gesetzt. Und initialization_method="estimated" gehört gesetzt, sonst verwendet statsmodels ein einfacheres Startverfahren mit anderen Ergebnissen. Und forecast() liefert nur die Punktprognose: Prognoseintervalle gibt es erst über ETSModel aus statsmodels.tsa.exponential_smoothing.ets oder über wiederholte simulate().
Beispiele
Alle Beispiele arbeiten mit derselben konstruierten Absatzreihe: 72 Monate ab Januar 2020 mit linearem Trend, Jahressaison und festem Rauschen. Die letzten zwölf Monate bleiben ungesehen; geschätzt wird auf den ersten 60. Das ist die einzige zulässige Aufteilung bei Zeitreihen: Getestet wird auf der Zukunft, nie auf herausgelosten Zeitpunkten.
Der gleitende Durchschnitt hat genau eine Einstellung: die Fensterbreite. Sie ist keine technische Nebensache, sondern die Entscheidung darüber, was man sehen will.
Trend und Saison. Die Streuung sinkt nur von 94.5 auf 90.0, weil die Saison den grössten Teil der Schwankung ausmacht und unberührt bleibt.
MA(12)
Rauschen und Saison vollständig
nur den Trend. Die Streuung fällt auf rund 72, was übrig bleibt, ist der Anstieg über sechs Jahre.
Ausgabe
Wie sie zu lesen ist
Fensterbreite = Periode
Der entscheidende Punkt: Ein Fenster von genau einer Periode mittelt jeden Monat des Jahres genau einmal und löscht die Saison damit exakt aus. Jede andere Breite lässt einen Rest stehen.
fehlende Werte: 2 und 11
Ein zentriertes Fenster braucht Nachbarn auf beiden Seiten. Bei MA(3) fehlt je einer am Rand, bei MA(12) je rund ein halbes Jahr.
Die fehlenden Werte am rechten Rand
sind der eigentliche Haken: Für die aktuellsten Monate gibt es keinen geglätteten Wert. Ein gleitender Durchschnitt prognostiziert nicht, er beschreibt.
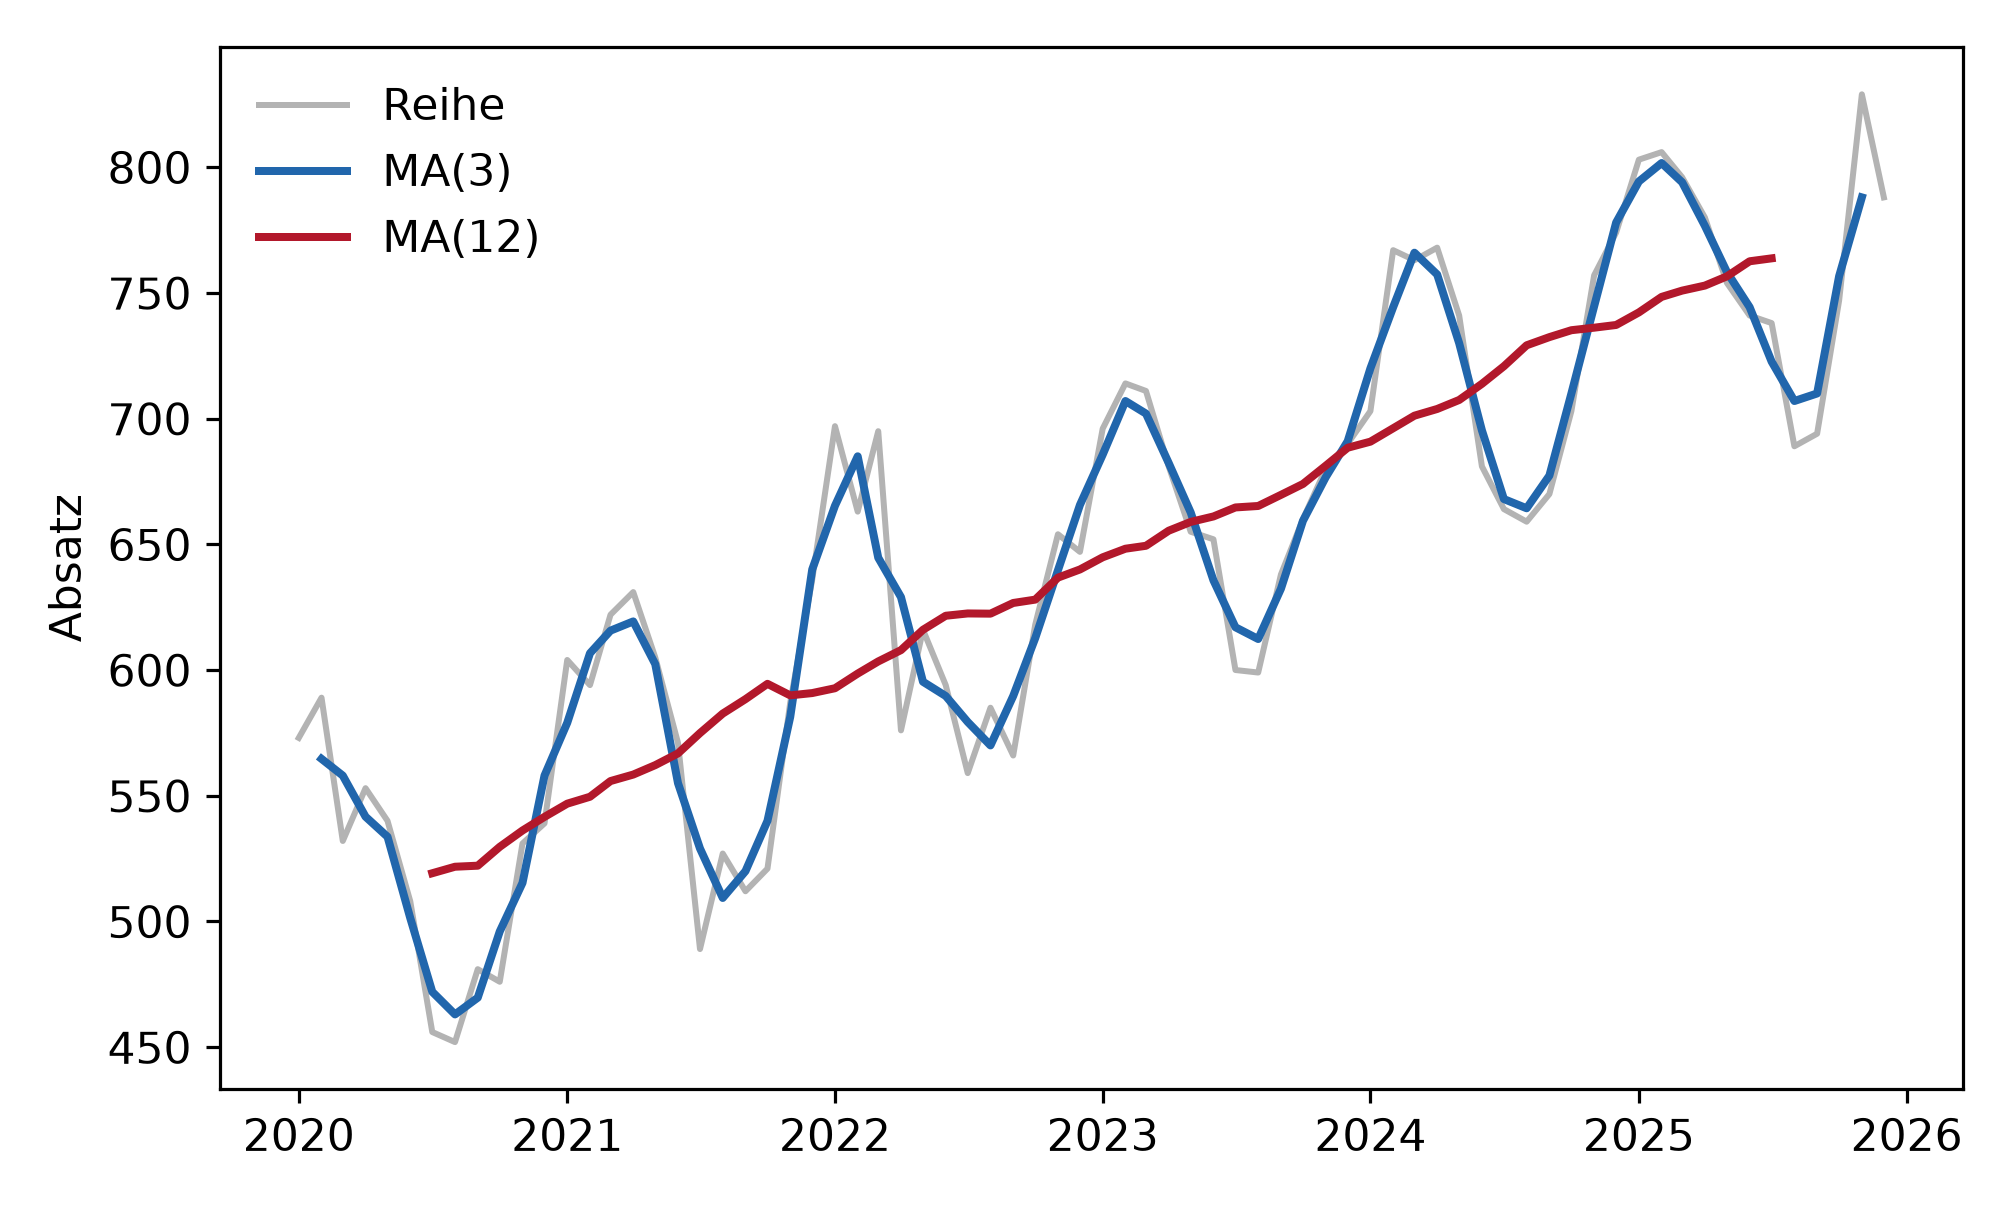
Bei gerader Fensterbreite gibt es ein Zentrierungsproblem: Ein Fenster über 12 Monate hat keinen mittleren Monat. R löst es in ma(order = 12) über ein doppeltes Mittel mit halbem Gewicht an den Enden und verliert dabei je sechs Werte an beiden Rändern, also zwölf. rolling(12, center=True) in Python legt das Fenster dagegen leicht asymmetrisch und verliert elf. Für die Betrachtung ändert das wenig, für exakte Vergleiche zwischen den Sprachen viel.
Interpretation
Wer den Trend sehen will, nimmt die Periodenlänge. Wer den Verlauf inklusive Saison glätten will, ein kurzes Fenster. Beides ist beschreibend; für Prognosen braucht es die exponentielle Glättung.
Frage und Datenlage
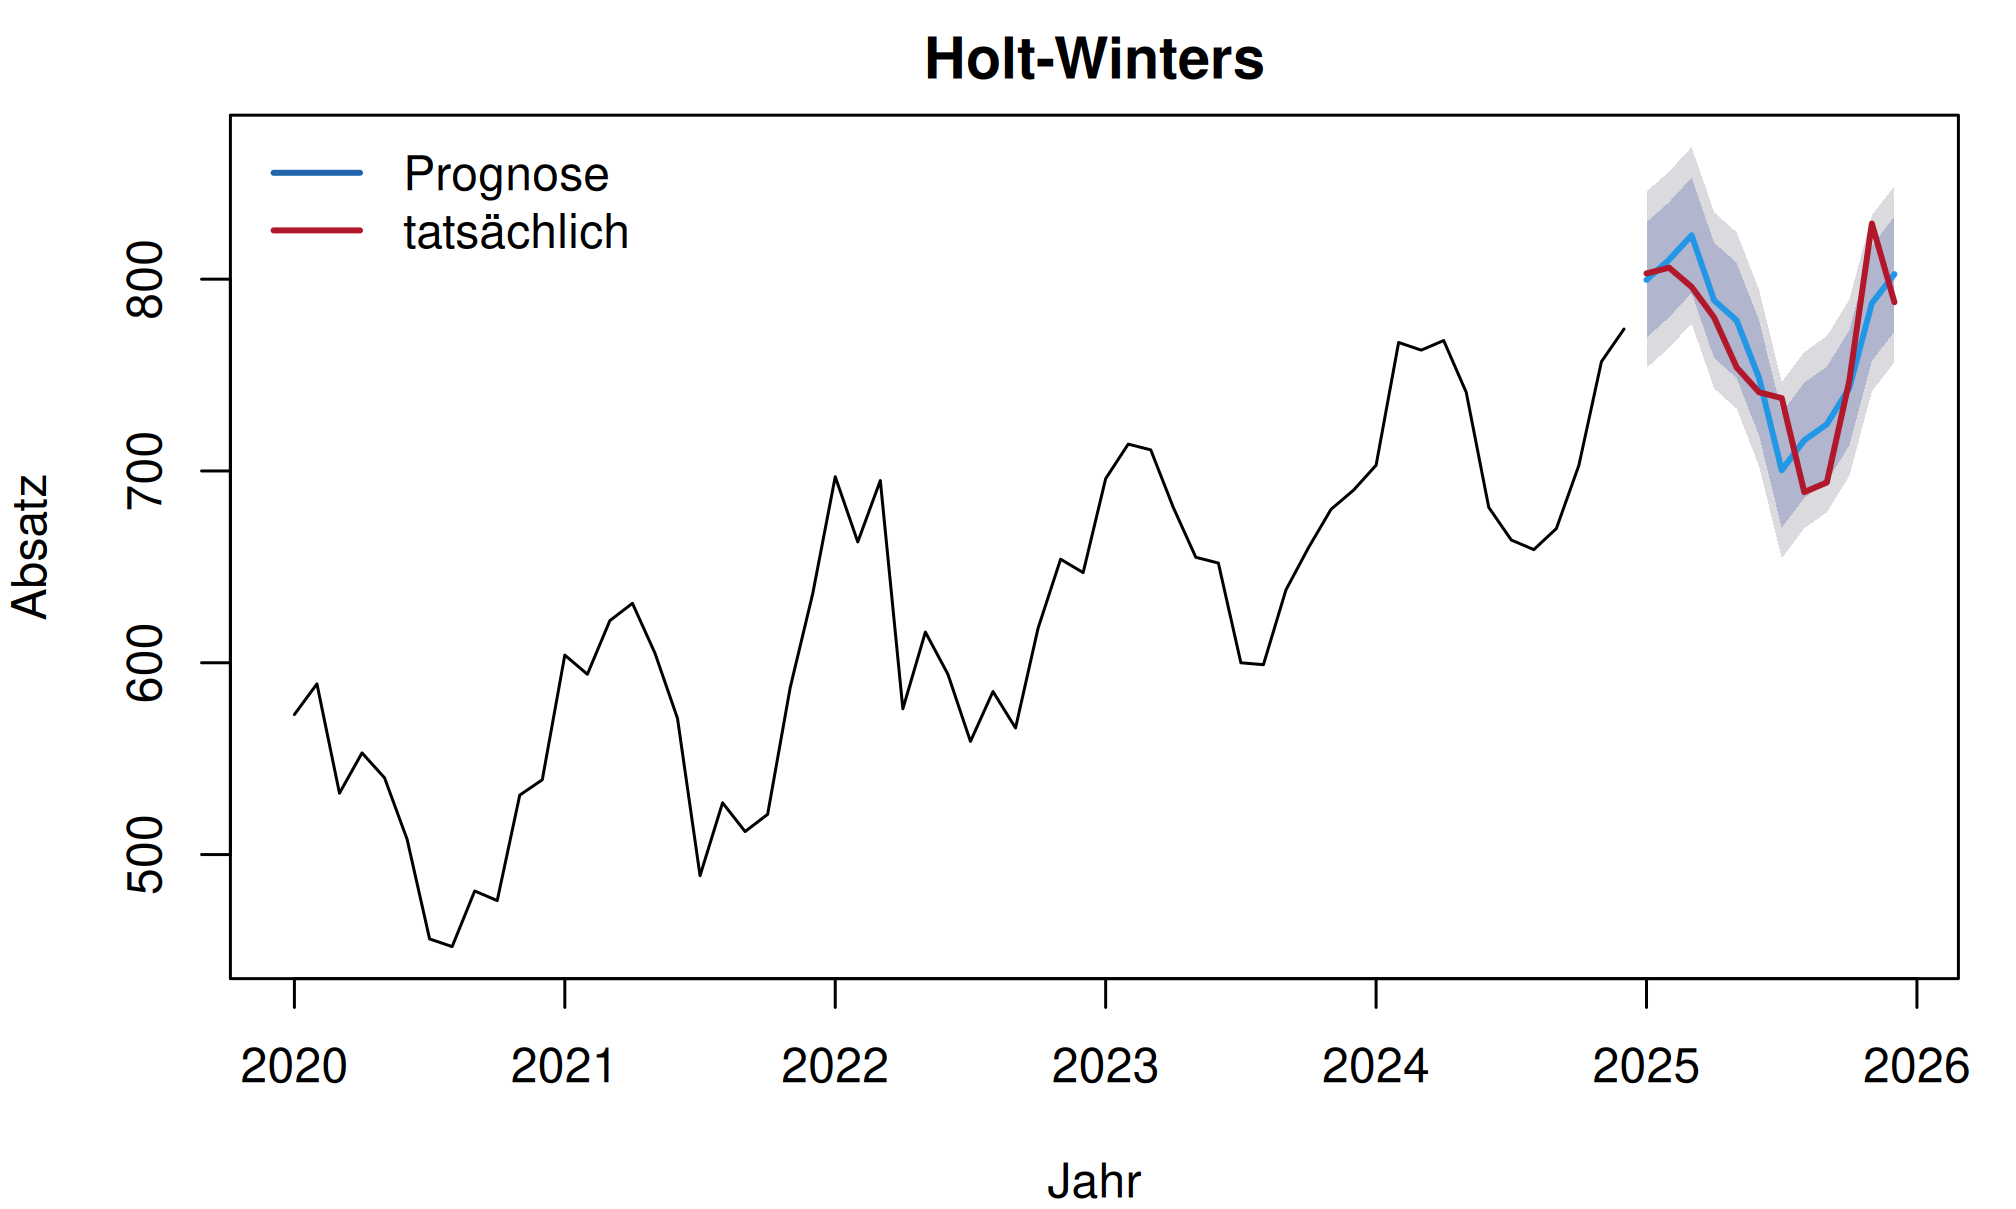
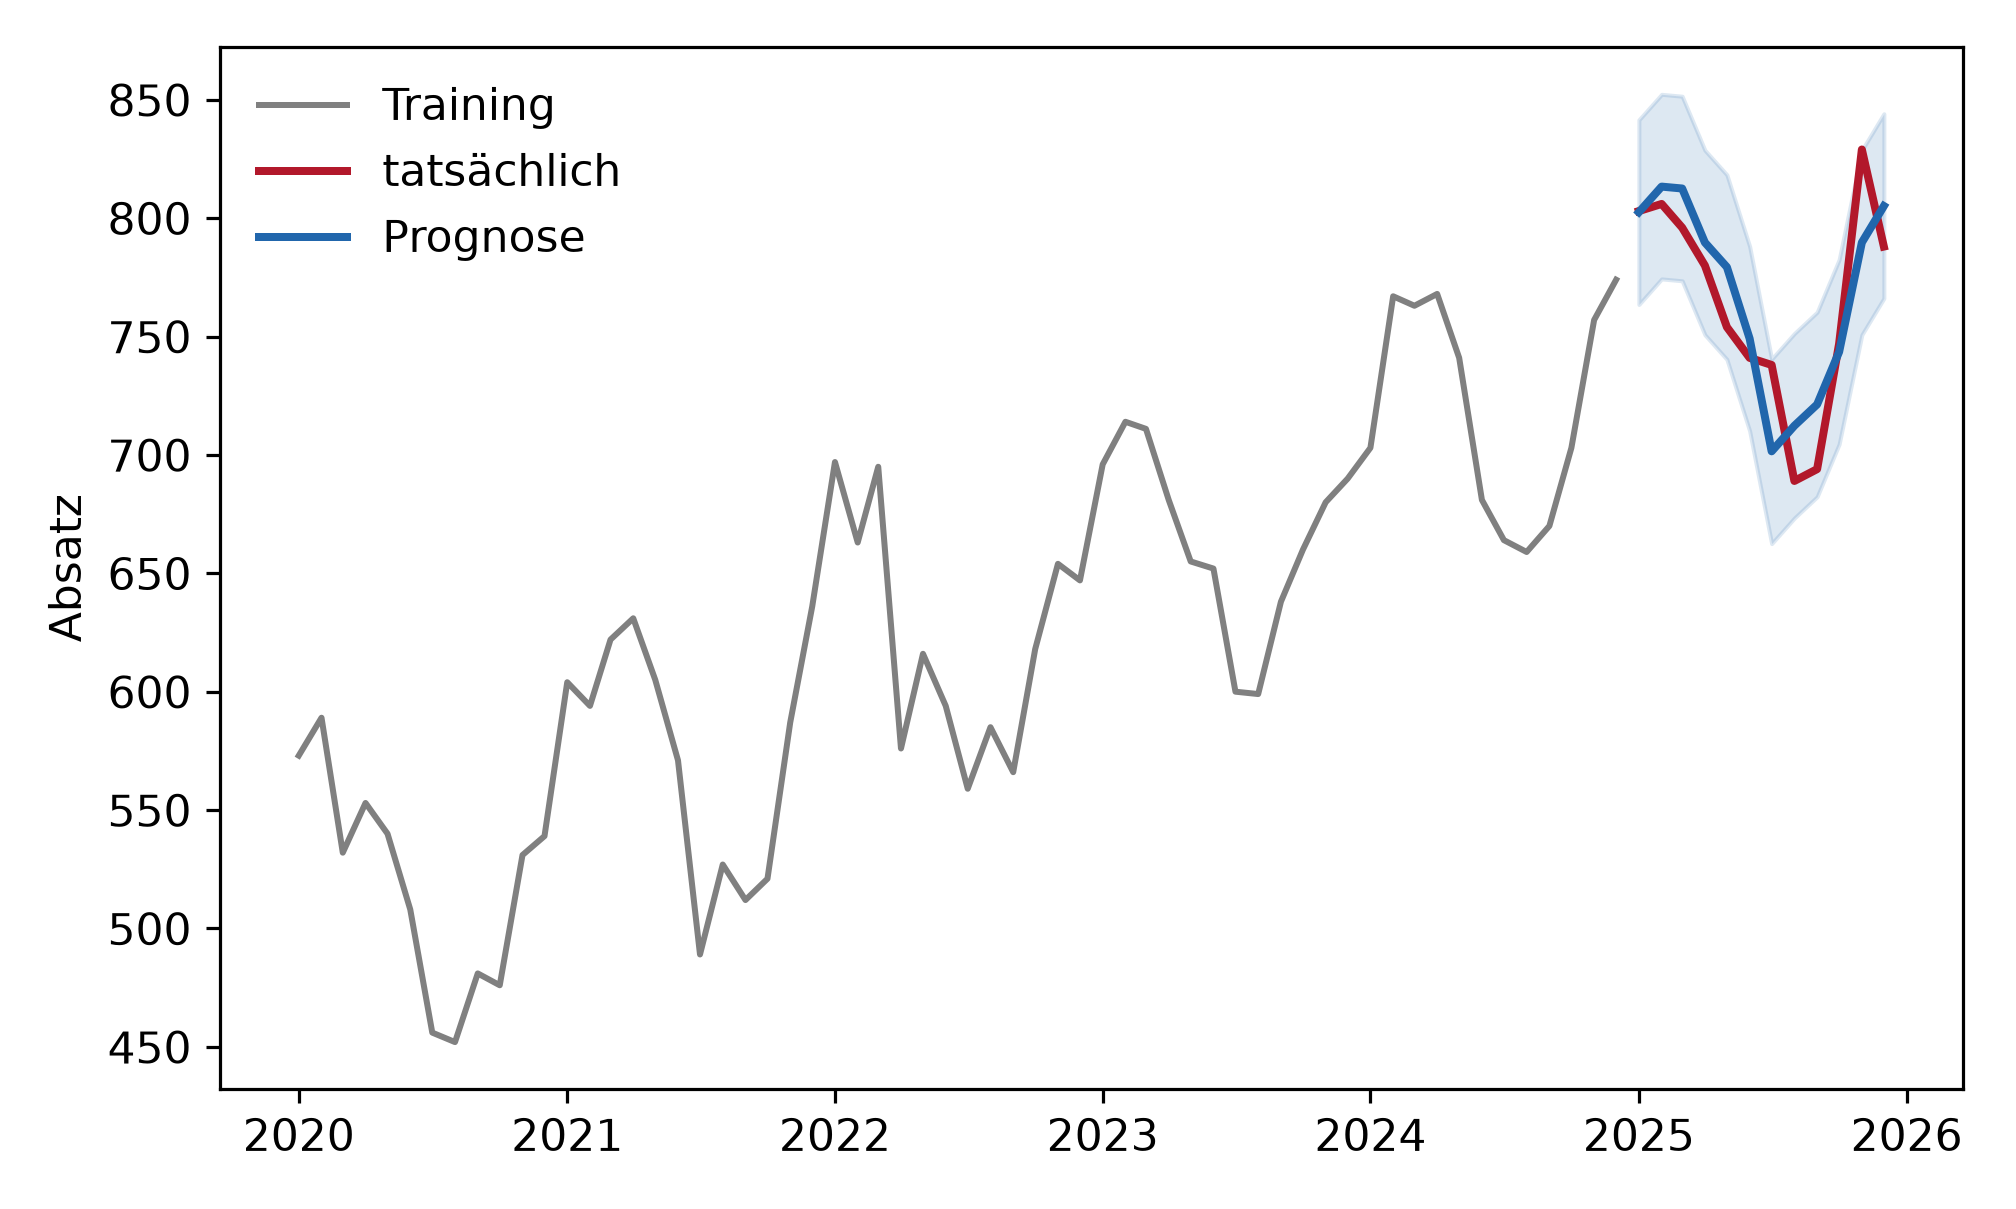
Ein Modell mit Niveau, Trend und Saison wird auf 60 Monaten geschätzt und prognostiziert die folgenden zwölf. Die tatsächlichen Werte sind bekannt, aber das Modell hat sie nicht gesehen.
fig, achse = plt.subplots()achse.plot(training, color="0.5", label="Training")achse.plot(test, color="#b2182b", lw=2, label="tatsächlich")achse.plot(prognose, color="#2166ac", lw=2, label="Prognose")# Die Holt-Winters-Umsetzung in statsmodels liefert keine analytischen# Prognoseintervalle. Das Band hier ist eine Naeherung aus der Streuung der# Residuen; exakte Intervalle liefert ETSModel oder simulate().band =1.96* modell_hw.resid.std(ddof=1)achse.fill_between(test.index, prognose - band, prognose + band, color="#2166ac", alpha=0.15)achse.set_ylabel("Absatz")achse.legend(frameon=False)plt.tight_layout()plt.show()
Abbildung 4: Beispiel 2: dieselbe Prognose in Python.
Die Prognose gegen die tatsächlichen Werte (Python-Ausgabe):
Monat
Prognose
tatsächlich
Fehler
2025-01
802.5
803
+0.5
2025-02
813.3
806
-7.3
2025-03
812.5
796
-16.5
2025-04
789.7
780
-9.7
2025-05
779.3
754
-25.3
2025-06
749.1
741
-8.1
2025-07
701.5
738
+36.5
2025-08
712.3
689
-23.3
2025-09
721.3
694
-27.3
2025-10
743.5
747
+3.5
2025-11
789.7
829
+39.3
2025-12
805.1
788
-17.1
(R schätzt die Glättungsparameter und die Startwerte leicht anders und kommt auf Prognosen von 799.7 bis 802.6 statt 802.5 bis 805.1. Siehe den Kasten unten.)
Kennzahl
Wert (Python / R)
Bedeutung
RMSE
21.60 / 23.28
Wurzel des mittleren quadratischen Fehlers, in Einheiten der Reihe. Weil quadriert wird, schlagen die beiden Ausreisser im Juli und November überproportional durch.
MAE
17.87 / 19.16
Mittlerer absoluter Fehler, ebenfalls in Einheiten der Reihe. Immer kleiner oder gleich dem RMSE; der Abstand zwischen beiden zeigt, wie ungleich die Fehler verteilt sind.
MAPE
2.37 / 2.54 %
Mittlerer absoluter prozentualer Fehler. Nur brauchbar, weil die Reihe weit von null entfernt liegt.
Residuenstreuung im Training
19.89
Fast identisch mit dem RMSE auf dem Testteil. Das ist das erwünschte Bild: Das Modell prognostiziert die ungesehenen Monate ungefähr so gut, wie es die gesehenen anpasst.
Fehler mit beiden Vorzeichen
+0.5 bis -27.3
Kein systematischer Versatz nach oben oder unten. Läge die Prognose durchgehend zu hoch, wäre der Trend falsch geschätzt.
Die Glättungsparameter fallen in Python auf null. Das Verfahren entscheidet also, dass Niveau, Trend und Saisonfigur gar nicht nachgeführt werden müssen und das ist richtig, denn die Reihe wurde mit einem festen Trend und einer festen Saisonfigur konstruiert. Aus Holt-Winters wird damit faktisch eine Regression mit Gerade und Saisondummies.
R lässt exakte Nullen nicht zu (die Optimierung läuft in den Grenzen 0.0001 bis 0.9999) und schätzt deshalb alle drei Parameter zu 0.0001. Zusätzlich bestimmt R die Startwerte anders, sichtbar an Initial states mit einem Niveau von 494.68 und einem Trend von 4.12, die den eingebauten 500 und 4 sehr nahe kommen. Daraus ergeben sich leicht andere Prognosen und ein etwas höherer Testfehler (RMSE 23.3 statt 21.6).
In echten Daten sind Werte nahe null ein Hinweis, dass ein einfacheres Modell genügt und Werte nahe eins einer, dass das Modell dem Rauschen folgt.
Interpretation und Ergebnissatz
Holt-Winters mit additivem Trend und additiver Saison (geschätzt auf 60 Monaten) prognostiziert die folgenden zwölf Monate mit einem RMSE von 21.6 und einem MAPE von 2.4 Prozent. Alle tatsächlichen Werte liegen im 95-Prozent-Prognoseintervall; die grössten Abweichungen betreffen Juli (+36.5) und November (+39.3).
Frage und Datenlage
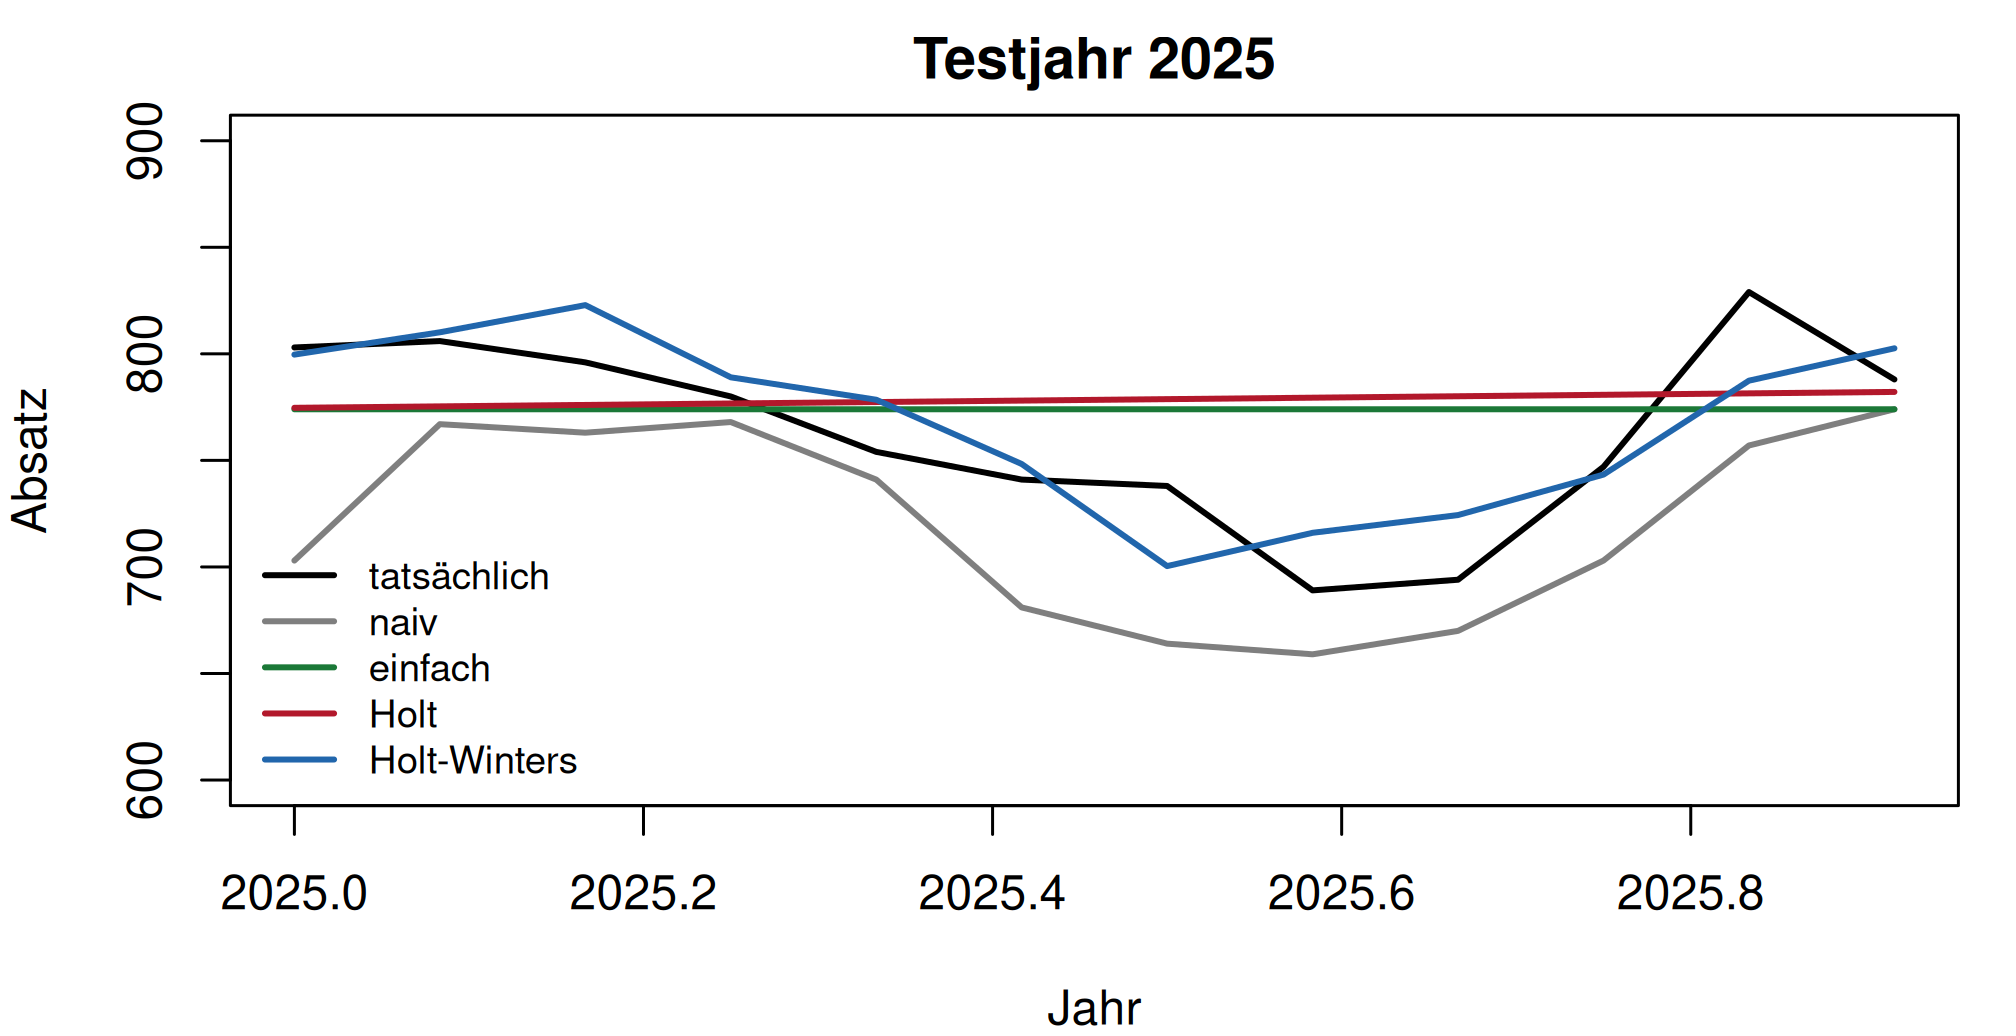
Eine Prognose ist nur so gut wie ihr Vergleich. Vier Kandidaten auf denselben Daten: die naive saisonale Prognose (der Wert von vor zwölf Monaten), die einfache exponentielle Glättung, Holt (Niveau und Trend) und Holt-Winters (zusätzlich Saison).
print("alpha der einfachen Glättung:",round(float(modell_ses.params["smoothing_level"]), 3))
alpha der einfachen Glättung: 1.0
Output Zeile für Zeile
Modell
RMSE (Python / R)
MAPE (Python / R)
Was es kann
naiv saisonal
50.65 / 50.65
5.58 / 5.58 %
Saison ja, Trend nein
einfache Glättung
43.54 / 43.54
4.92 / 4.92 %
nur ein Niveau
Holt
56.94 / 45.42
6.25 / 5.03 %
Niveau und Trend, keine Saison
Holt-Winters
21.60 / 23.28
2.37 / 2.54 %
Niveau, Trend und Saison
Die beiden Spalten unterscheiden sich genau dort, wo Parameter geschätzt werden müssen: Bei der naiven Prognose und der einfachen Glättung stimmen die Zahlen exakt überein, bei Holt und Holt-Winters nicht. Die Rangfolge ist in beiden Sprachen dieselbe.
Beobachtung
Erklärung
Holt-Winters ist mehr als doppelt so gut wie alles andere
Die Reihe hat Trend und Saison; nur ein Modell, das beides kennt, kann sie prognostizieren.
Holt ist schlechter als die einfache Glättung
In beiden Sprachen. Überraschend, aber erklärbar: Holt schreibt den Trend als Gerade fort und ignoriert die Saison, die Prognose läuft also mitten durch die Saisonzacken hindurch und verfehlt Hoch- wie Tiefpunkte. Die einfache Glättung liegt mit ihrer waagrechten Linie zufällig näher. Ein zusätzlicher Modellbestandteil verbessert nicht automatisch.
Die einfache Glättung schätzt \(\alpha = 1\)
Damit ist sie die naive Prognose “der letzte Wert”, die Vorhersage für alle zwölf Monate ist der Dezemberwert von 2024.
Die naive saisonale Prognose
ist der eigentliche Massstab: Sie kostet nichts und erreicht 5.58 Prozent MAPE. Ein Modell, das sie nicht deutlich schlägt, ist den Aufwand nicht wert.
Warum die naive Prognose in jeden Bericht gehört, und zwar als Zeile in derselben Tabelle: Ein RMSE von 21.6 sagt für sich genommen nichts. Erst der Vergleich mit den 50.7 der naiven saisonalen Prognose macht daraus die Aussage “das Modell halbiert den Fehler”.
Formalisiert wird das im MASE (Mean Absolute Scaled Error), dem Verhältnis des MAE zum MAE der naiven Prognose: Werte unter eins heissen besser als naiv. R gibt ihn in accuracy() mit aus.
Interpretation und Ergebnissatz
Holt-Winters mit additivem Trend und additiver Saison erreicht auf den letzten zwölf Monaten einen RMSE von 21.6 (MAPE 2.4 Prozent) gegenüber 50.7 (5.6 Prozent) bei der naiven saisonalen Prognose. Modelle ohne Saisonkomponente bleiben deutlich zurück (Holt: RMSE 56.9).
Frage und Datenlage
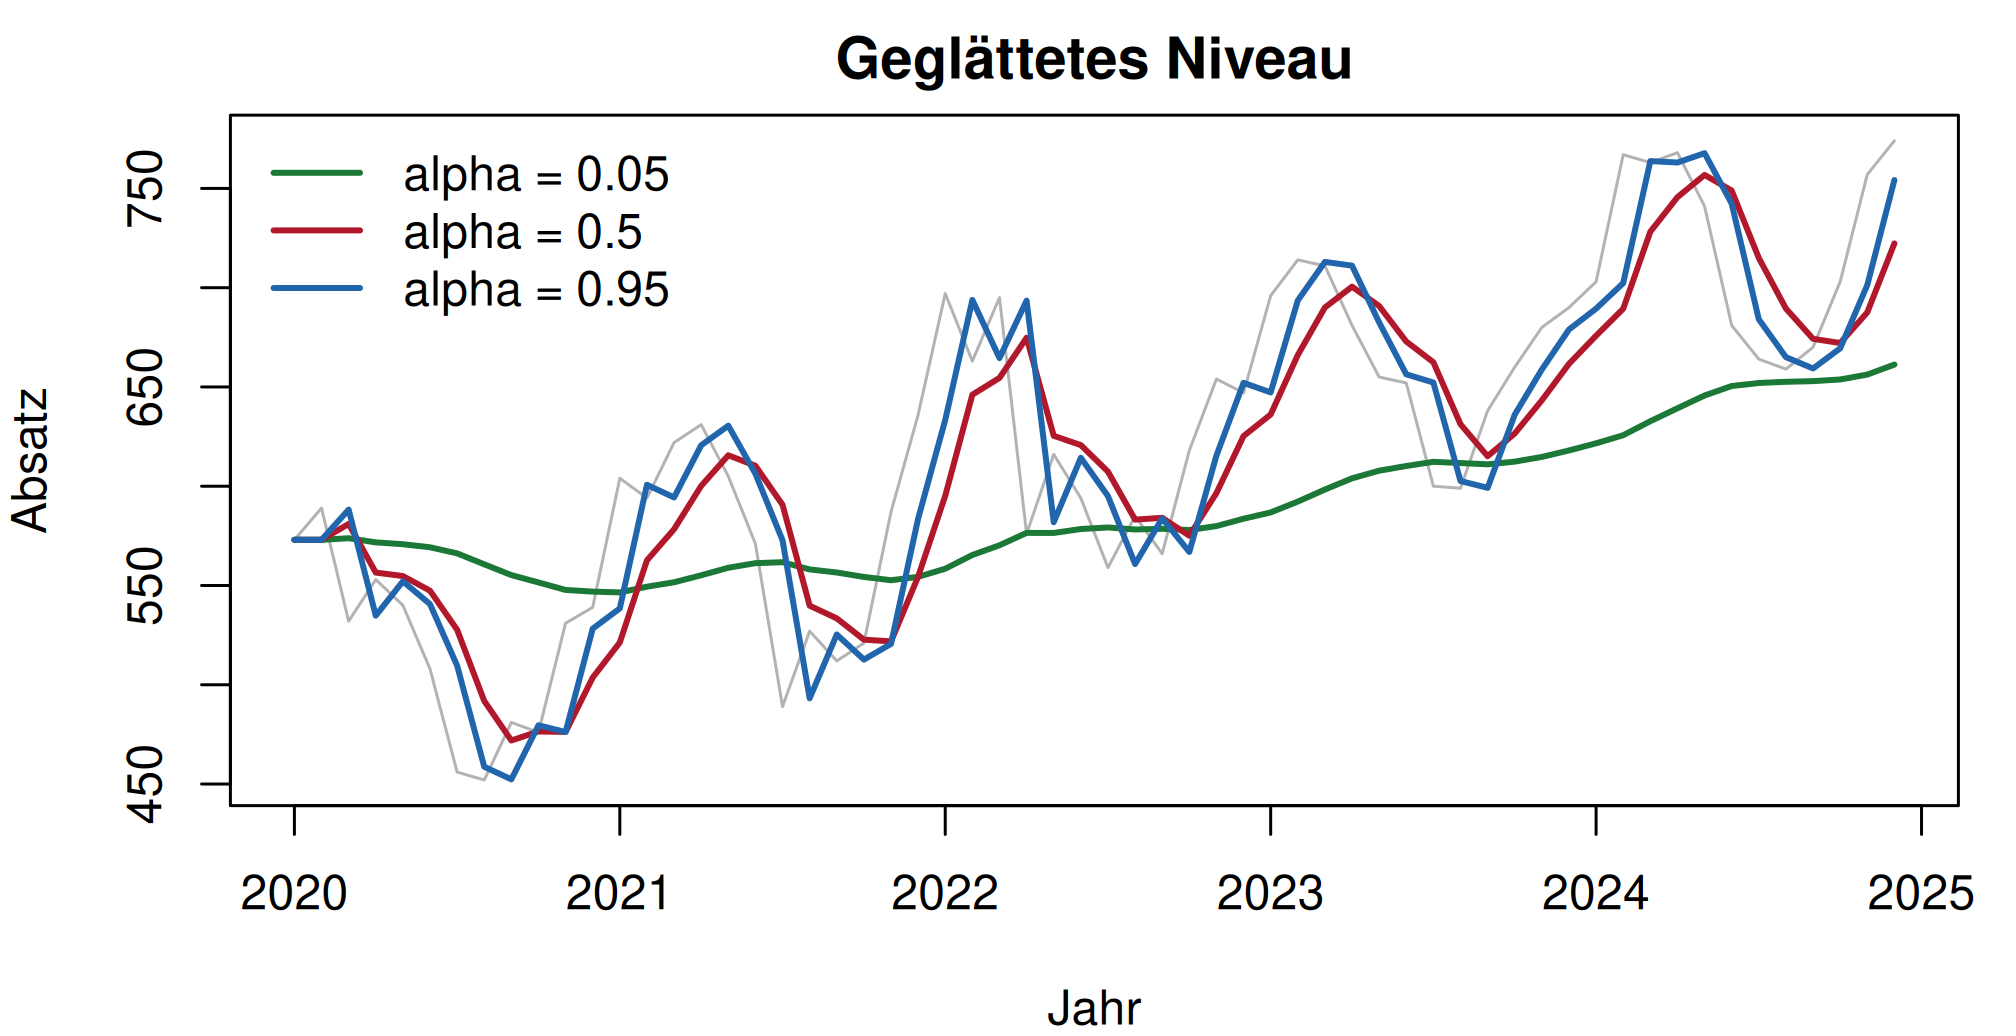
Der Glättungsparameter \(\alpha\) steuert, wie stark das Modell auf den jüngsten Wert reagiert. Was passiert, wenn man ihn selbst wählt statt ihn schätzen zu lassen?
Abbildung 6: Beispiel 4: dieselbe Glättung mit alpha = 0.05, 0.5 und 0.95.
for a in [0.05, 0.5, 0.95]: m = SimpleExpSmoothing(training, initialization_method="known", initial_level=float(training.iloc[0])).fit( smoothing_level=a, optimized=False)print(f"alpha = {a:<5}", masse(test.values, m.forecast(12).values))
Das Niveau folgt dem Trend viel zu träge und bleibt am Ende weit unter der Reihe. Der Fehler ist fünfmal so gross wie nötig.
0.5
45.10
37.56
Schon nahe am Optimum, die Kurve ist flach.
0.95
43.31
36.58
Minimal besser als der geschätzte Wert.
geschätzt (\(\alpha = 1\))
43.54
36.58
R und Python liefern hier identische Zahlen, weil \(\alpha\) vorgegeben ist und der Startwert in beiden Fällen auf den ersten Beobachtungswert gesetzt wurde.
Beobachtung
Erklärung
Ein kleines \(\alpha\) ist hier klar schlecht
Bei einer Reihe mit Trend muss das Niveau ständig nachgeführt werden. Mit \(\alpha = 0.05\) zählt der jüngste Wert nur zu fünf Prozent, und das geglättete Niveau hinkt Jahre hinterher.
Ein grosses \(\alpha\) ist hier fast optimal
Weil die Reihe stark steigt, ist “der letzte Wert” die beste Schätzung, die ein Modell ohne Trendkomponente abgeben kann.
Der geschätzte Wert ist \(\alpha = 1\)
Die Optimierung landet am Rand des zulässigen Bereichs. Das ist selbst ein Befund: Das Modell passt nicht. Eine einfache Glättung, die \(\alpha = 1\) wählt, sagt “ich kann nichts glätten”, die Reihe braucht eine Trendkomponente.
Die übliche Lehrbuchwarnung “\(\alpha\) nahe eins heisst, das Modell folgt dem Rauschen” gilt hier nicht und das zeigt, warum Faustregeln über Parameterwerte mit Vorsicht zu geniessen sind. Ein \(\alpha\) nahe eins bedeutet nur: Der jüngste Wert ist die beste verfügbare Information. Bei einer rauschenden Reihe ohne Trend ist das ein Warnzeichen, bei einer stark steigenden Reihe die richtige Antwort.
Deshalb wird \(\alpha\) geschätzt und nicht gesetzt: Die Programme minimieren den Fehler auf den Trainingsdaten. Und deshalb wird das Ergebnis gedeutet statt gegen eine Schwelle geprüft.
Interpretation
Ein von Hand gesetzter Parameter liegt fast immer daneben. Interessanter als sein Wert ist, was er über das Modell verrät, hier, dass die einfache Glättung für diese Reihe die falsche Wahl ist.
Frage und Datenlage
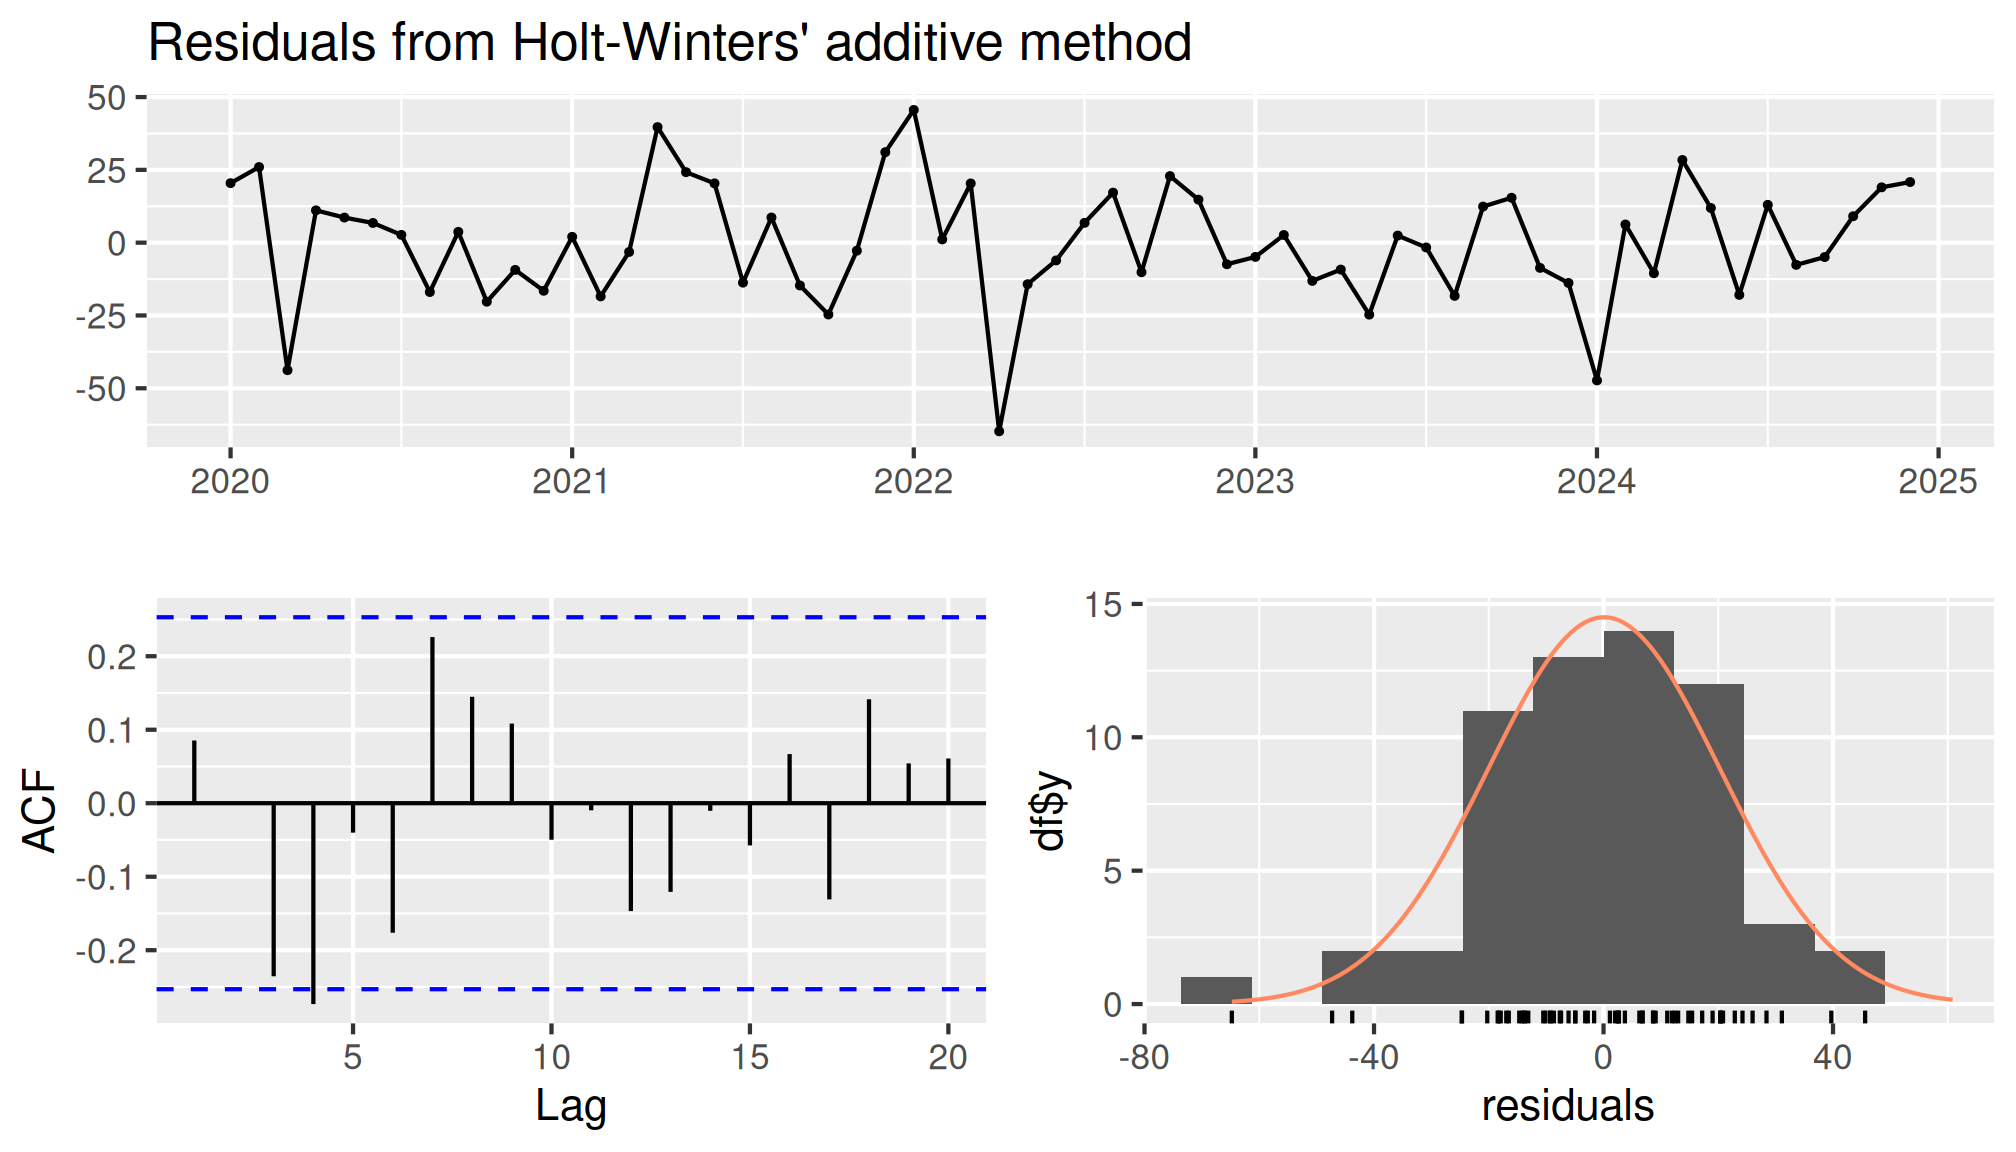
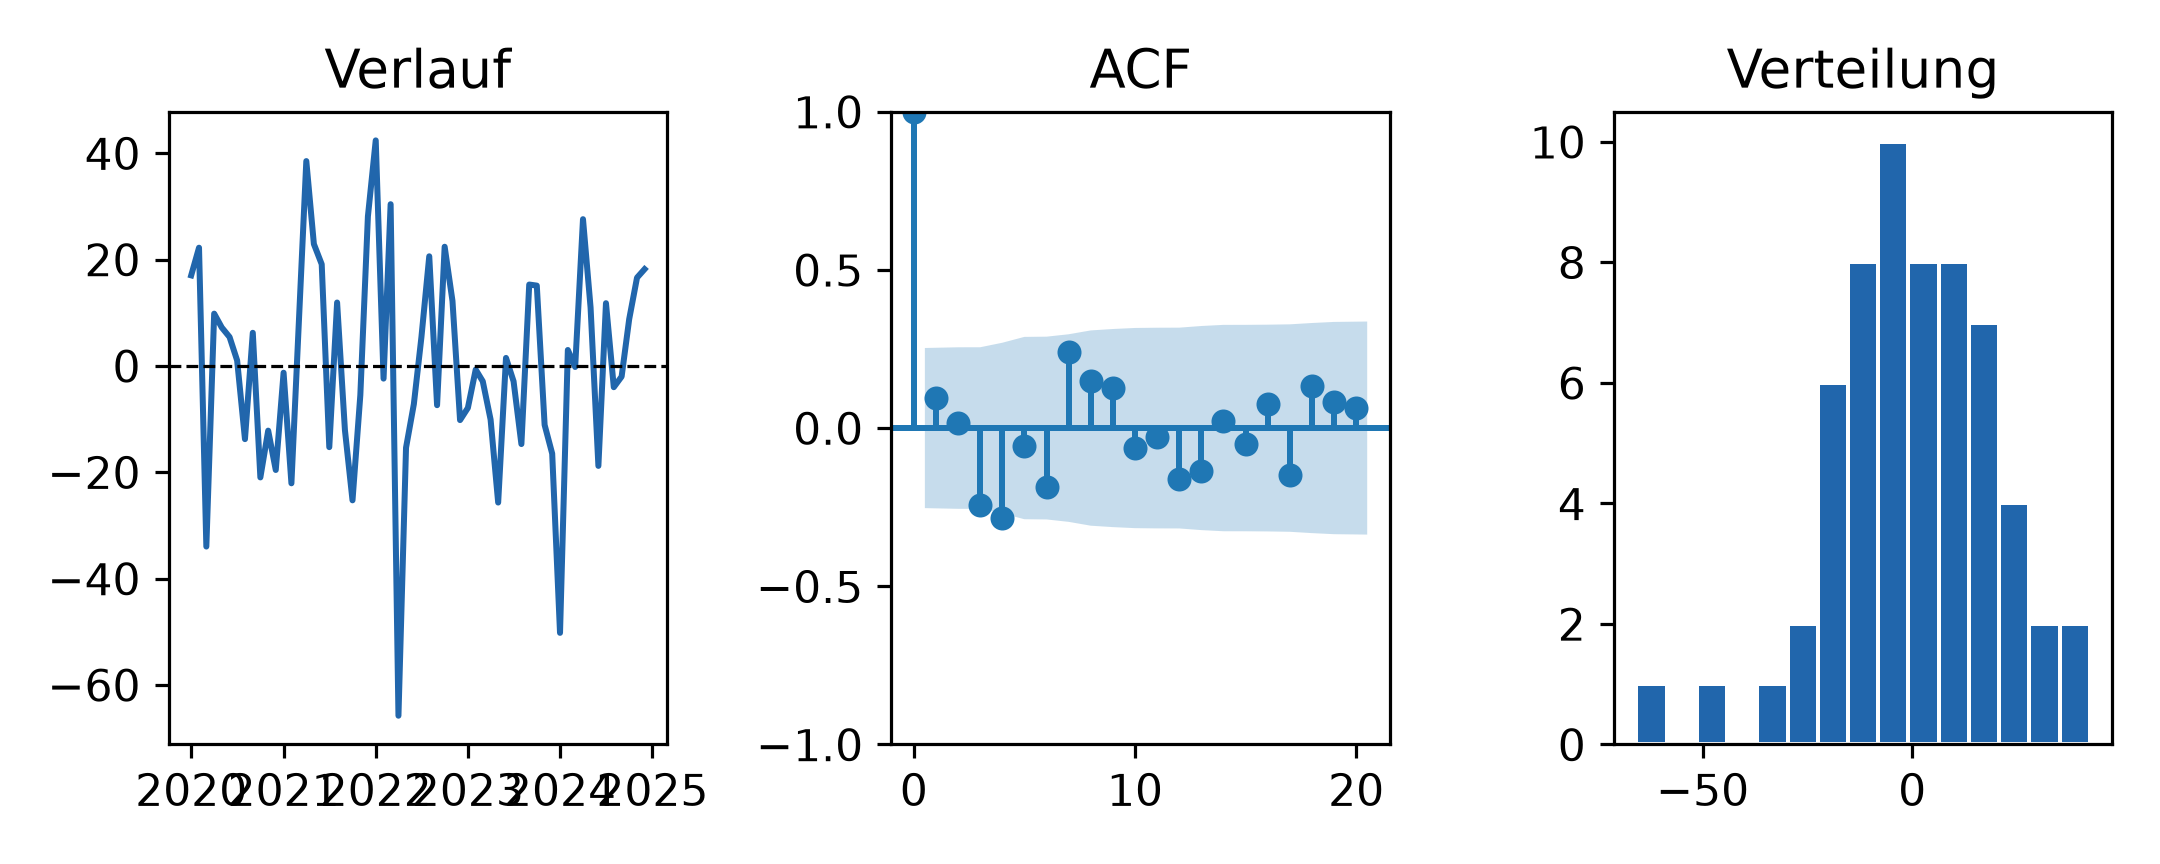
Der letzte Schritt jeder Zeitreihenmodellierung: Steckt in den Residuen noch Struktur? Wenn ja, hat das Modell etwas übersehen, und die Prognoseintervalle sind zu schmal.
Zusätzlich über andere Abstandszahlen (Python): p = 0.055 bei 6 Abständen und p = 0.077 bei 18.
Prüfpunkt
Befund
Wie er zu lesen ist
Ljung-Box
0.044 in Python, 0.086 in R
Der Test prüft, ob irgendeine der ersten zwölf Autokorrelationen von null verschieden ist. Die Nullhypothese lautet “keine Autokorrelation”; ein kleiner p-Wert heisst also, dass Struktur übrig ist. Hier: ein Grenzfall.
ACF der Residuen
ein bis zwei Balken knapp ausserhalb
Bei 20 angezeigten Abständen ist ein Ausreisser zufällig zu erwarten. Entscheidend ist, ob er an einer deutbaren Stelle liegt, etwa bei 12, was auf eine unerfasste Saison hinweisen würde.
Verlauf
schwankt um null, keine Trichterform
Keine wachsende Streuung, kein Muster.
Verteilung
ungefähr symmetrisch
Grundlage der Prognoseintervalle; starke Schiefe würde sie unbrauchbar machen.
Mittelwert der Residuen
nahe null
Ein deutlich von null verschiedener Mittelwert wäre ein systematischer Versatz.
Ein Grenzfall wie p = 0.044 trägt kein Urteil. Drei Gründe:
Der Test wird mit wachsender Reihenlänge empfindlich und findet dann auch praktisch bedeutungslose Autokorrelationen.
Die Anzahl geprüfter Abstände ist eine Wahl, hier ergeben 6, 12 und 18 Abstände p-Werte von 0.055, 0.044 und 0.077.
R und Python kommen auf verschiedene Teststatistiken (19.09 gegen 21.50) und damit auf 0.086 gegen 0.044, einmal über und einmal unter der Schwelle. Der Grund liegt in den leicht verschiedenen Modellanpassungen. Ein Befund, der an der Wahl der Umgebung kippt, ist kein Befund.
Was zählt, ist die Grafik: Liegt der auffällige Balken bei Abstand 12, fehlt Saison. Liegt er irgendwo, ist es Zufall. Und wenn wirklich Struktur übrig ist, ist ARIMA der nächste Schritt.
Interpretation und Ergebnissatz
Die Residuen des Modells schwanken ohne erkennbares Muster um null (Standardabweichung 19.9); der Ljung-Box-Test über zwölf Abstände liegt mit p = 0.04 bis 0.09 je nach Umgebung im Grenzbereich, ohne dass die ACF eine deutbare Struktur zeigt. Die Prognoseintervalle sind damit vertretbar.
Interpretationsfallen
Fehlermasse auf den Trainingsdaten sagen nichts. Das Modell hat diese Werte gesehen; bewertet wird auf dem Testteil.
Zufällige Aufteilung ist bei Zeitreihen falsch. Getestet wird auf der Zukunft, sonst nutzt das Modell Information, die es nicht haben dürfte.
Eine Prognose ohne Intervall ist unvollständig. Und das Intervall wächst mit dem Horizont, meist schneller als man erwartet.
Ein gleitender Durchschnitt prognostiziert nicht. Er ist beschreibend und braucht Werte aus der Zukunft.
MAPE ist tückisch. Bei Werten nahe null explodiert er, und er bestraft Überschätzung anders als Unterschätzung.
Alpha nahe eins ist keine gute Anpassung, sondern Folgen des Rauschens.
Glättung erklärt nichts. Sie beschreibt die Reihe aus sich selbst; für Ursachen braucht es Einflussgrössen.
Ergebnis berichten
Vorlage für den Ergebnissatz:
Die Reihe wurde mit [Verfahren] modelliert (geschätzt auf [Zeitraum], Test auf den folgenden [h] Perioden). Die Prognose erreicht einen RMSE von [Wert] und einen MAPE von [Wert] Prozent, gegenüber [Wert] beziehungsweise [Wert] bei der naiven saisonalen Prognose. Die Residuen zeigen im Ljung-Box-Test p = [p].
Genannt werden: Verfahren und Modellstruktur, Trainings- und Testzeitraum, Fehlermasse auf dem Testteil, der Vergleich mit einer naiven Prognose, das Ergebnis der Residuenprüfung und der Prognosehorizont mit Intervall.
Ein Modell erreicht auf den Trainingsdaten einen RMSE von 8 und auf dem Testteil von 45. Was folgt?
Das Modell ist an die Trainingsdaten angepasst und prognostiziert schlecht
Richtig. Der Testteil ist der einzige aussagekräftige Wert. Ein grosser Unterschied deutet auf ein zu reaktives Modell, etwa ein Alpha nahe eins.
Der Testteil ist zu kurz
Möglich, aber der Unterschied ist zu gross, um allein daran zu liegen.
Beide Werte gemeinsam beurteilen
Der Trainingswert trägt zur Beurteilung der Prognose nichts bei.
Warum darf man Zeitreihen nicht zufällig in Trainings- und Testdaten aufteilen?
Weil das Modell dann Werte aus der Zukunft kennt
Richtig. Liegen Testzeitpunkte zwischen Trainingszeitpunkten, nutzt das Modell Information, die zum Prognosezeitpunkt nicht vorlag. Der Fehler wird dadurch zu klein.
Weil die Reihenfolge für die Rechnung nötig ist
Auch das, aber der entscheidende Punkt ist die Information.
Weil die Stichprobe sonst zu klein wird
Die Grösse ändert sich nicht.
Ein gleitender Durchschnitt über zwölf Monate wird für eine Prognose verwendet. Was ist das Problem?
Er ist beschreibend und braucht Werte aus der Zukunft
Richtig. Ein zentrierter gleitender Durchschnitt mittelt um jeden Zeitpunkt herum, also auch über spätere Werte, und endet deshalb sechs Monate vor dem Reihenende.
Zwölf Monate sind ein zu langes Fenster
Die Fensterbreite ist hier nicht das Problem.
Er glättet die Saison weg
Das tut er, und für die Trendbetrachtung ist es gewollt.
Der Ljung-Box-Test auf den Residuen ergibt p = 0.003. Was heisst das?
In den Residuen steckt noch Abhängigkeit, das Modell hat etwas übersehen
Richtig. Die Folge sind zu schmale Prognoseintervalle. Zu prüfen ist, ob Saison, Trend oder eine Abhängigkeitsstruktur fehlt, die ein ARIMA-Modell erfassen würde.
Das Modell passt gut, der p-Wert ist klein
Die Richtung ist vertauscht: Die Nullhypothese lautet keine Autokorrelation.