Stetige Verteilungen

Verteilungen
Wahrscheinlichkeit
R
Python
Dichte, Verteilungsfunktion und die wichtigsten stetigen Modelle.

Kernideen

  • Bei stetigen Grössen hat jeder einzelne Wert die Wahrscheinlichkeit null; sinnvoll sind nur Aussagen über Intervalle.
  • An die Stelle der Wahrscheinlichkeitsfunktion tritt die Dichtefunktion. Ihre Werte sind keine Wahrscheinlichkeiten und dürfen grösser als eins sein, begrenzt ist die Fläche, nicht die Höhe.
  • Die Verteilungsfunktion \(F(x) = P(X \le x)\) liefert die Fläche und ist das Arbeitsmittel: Jede Intervallfrage ist eine Differenz zweier ihrer Werte.
  • Das dpqr-Schema gilt unverändert weiter, nur bedeutet d jetzt Dichte statt Wahrscheinlichkeit.
  • Aus gleichverteilten Zufallszahlen lässt sich über die Quantilfunktion jede Verteilung erzeugen.
  • Die Exponentialverteilung ist gedächtnislos und genau deshalb für Verschleiss die falsche Wahl.

Erklärung

Vorwissen: Zufallsvariablen und diskrete Verteilungen, vor allem Erwartungswert und das dpqr-Schema. Die Normalverteilung bekommt wegen ihrer Sonderrolle eine eigene Seite.

Warum jede Punktwahrscheinlichkeit null ist

Bei einem Würfel lässt sich fragen, wie wahrscheinlich eine Drei ist. Bei einer Körpergrösse lässt sich nicht sinnvoll fragen, wie wahrscheinlich exakt 1.80000… Meter sind. Zwischen zwei beliebigen Werten liegen unendlich viele weitere, und die Wahrscheinlichkeit jedes einzelnen ist null.

Sinnvoll sind nur Aussagen über Intervalle. Deshalb tritt an die Stelle der Wahrscheinlichkeitsfunktion die Dichtefunktion \(f(x)\):

\[P(a \le X \le b) = \int_a^b f(x)\,dx = F(b) - F(a)\]

Diskret Stetig
\(P(X = x)\) ist eine Wahrscheinlichkeit \(f(x)\) ist eine Dichte
Werte zwischen 0 und 1 Werte beliebig gross
Summe über alle Werte = 1 Fläche unter der Kurve = 1
\(F(x) = \sum_{t \le x} P(X = t)\) \(F(x) = \int_{-\infty}^{x} f(t)\,dt\)
\(F\) ist eine Treppe \(F\) ist glatt und steigt monoton

Das dpqr-Schema

Es gilt unverändert, nur mit anderer Bedeutung von d:

Präfix R Python (scipy.stats) Bedeutung
d dnorm(x) .pdf(x) Dichte an der Stelle x
p pnorm(q) .cdf(q) \(P(X \le q)\), die Fläche links
q qnorm(p) .ppf(p) der Wert, unter dem der Anteil p liegt
r rnorm(n) .rvs(n) n Zufallszahlen

p und q sind Umkehrungen voneinander. Das ist die Grundlage jeder Quantilrechnung und, wie Beispiel 3 zeigt, auch der Erzeugung von Zufallszahlen.

Die wichtigsten stetigen Modelle

Verteilung Parameter Erwartungswert Wofür
Gleichverteilung \(a\), \(b\) \(\frac{a+b}{2}\) Rundungsfehler, Ausgangspunkt für Simulationen
Exponential Rate \(\lambda\) \(1/\lambda\) Wartezeiten bei konstanter Rate
Normal \(\mu\), \(\sigma\) \(\mu\) Summen und Mittelwerte, siehe ZGWS
Weibull Form \(k\), Skala \(\lambda \Gamma(1 + 1/k)\) Ausfallzeiten mit Alterung
Log-normal \(\mu\), \(\sigma\) des Logarithmus \(e^{\mu + \sigma^2/2}\) Löhne, Preise, multiplikativ Entstehendes
t, Chi-Quadrat, F Freiheitsgrade Prüfverteilungen, siehe Hypothesentests

Die Exponentialverteilung ist das stetige Gegenstück zur Poissonverteilung aus diskrete Verteilungen: Zählt die eine die Ereignisse je Zeitraum, misst die andere die Zeit dazwischen.

Beispiele

Frage und Datenlage

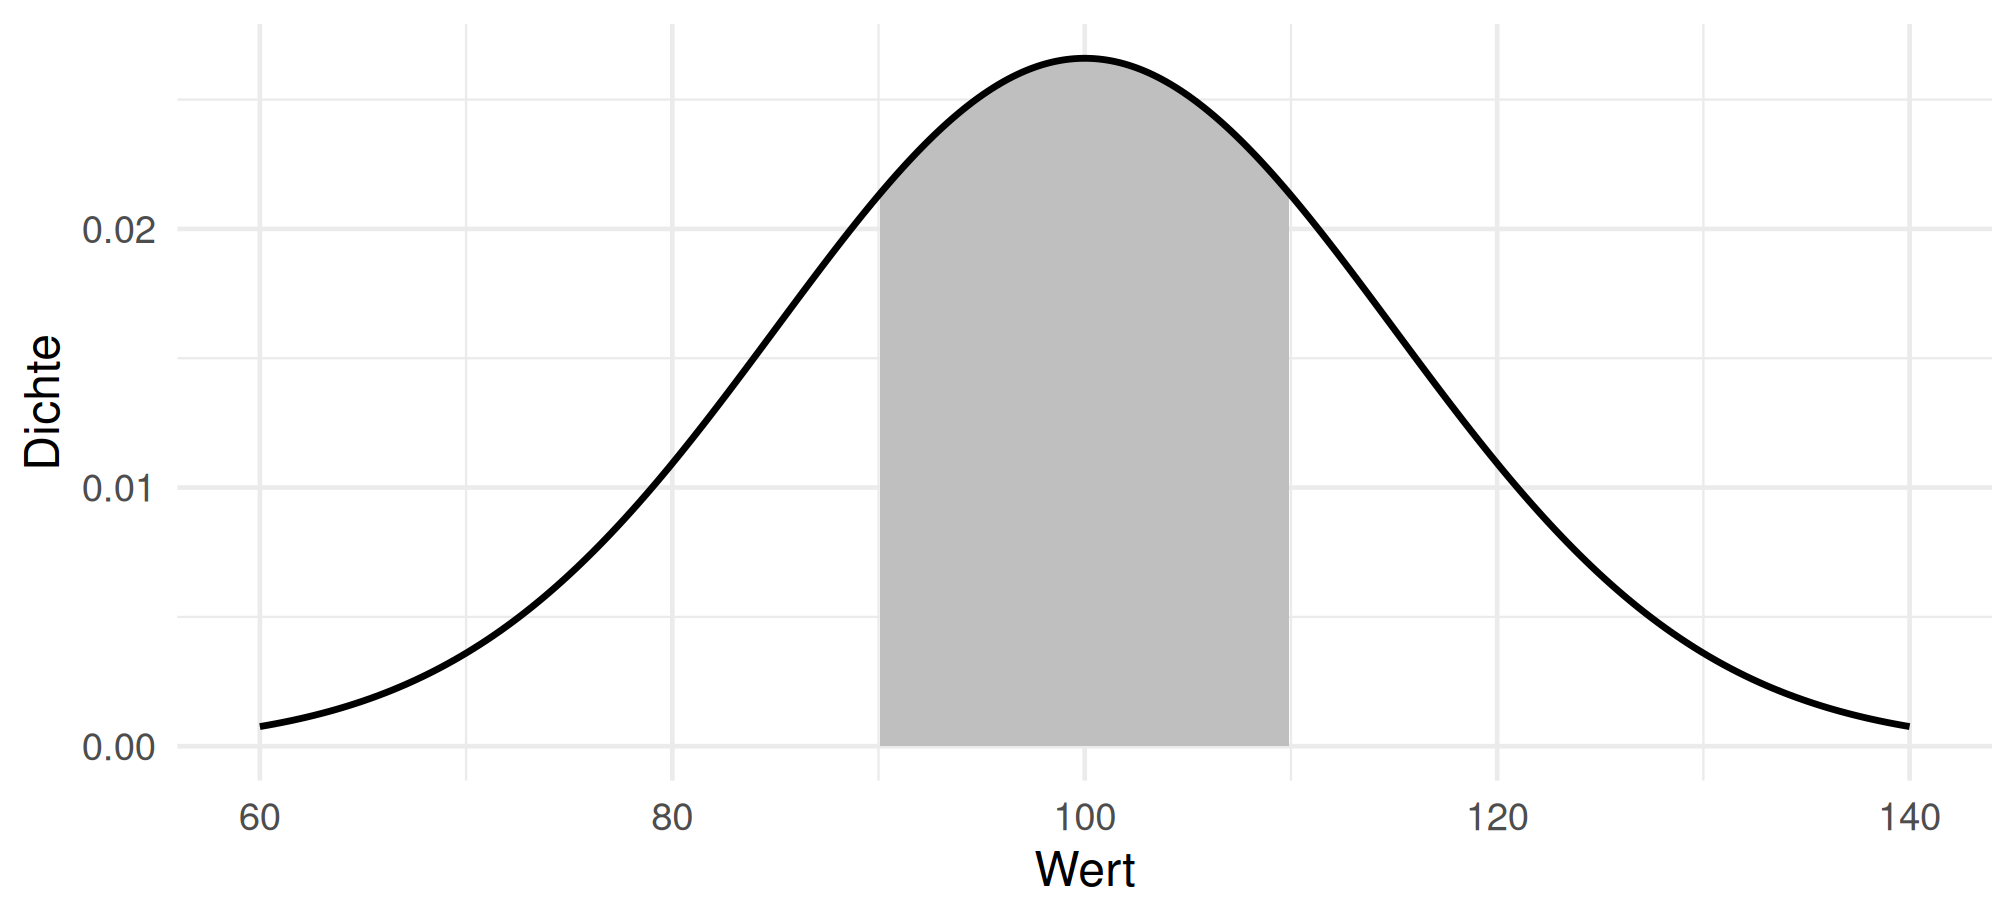
Ein IQ-Wert ist normalverteilt mit \(\mu = 100\) und \(\sigma = 15\). Wie wahrscheinlich ist ein Wert zwischen 90 und 110 und wie wahrscheinlich ist “genau 100”?

Rechnung

x <- seq(60, 140, length.out = 400)
d <- dnorm(x, mean = 100, sd = 15)
flaeche <- data.frame(x = x[x >= 90 & x <= 110], y = d[x >= 90 & x <= 110])

ggplot(data.frame(x, d), aes(x, d)) +
  geom_area(data = flaeche, aes(x, y), fill = "grey75") +
  geom_line(linewidth = 0.8) +
  labs(x = "Wert", y = "Dichte")

# Die Flaeche ueber die Verteilungsfunktion
round(pnorm(110, 100, 15) - pnorm(90, 100, 15), 4)
[1] 0.495
# Der Dichtewert bei 100 - keine Wahrscheinlichkeit
round(dnorm(100, 100, 15), 4)
[1] 0.0266
# Immer engere Intervalle um 100
round(c(
  breite_1 = pnorm(100.5, 100, 15) - pnorm(99.5, 100, 15),
  breite_0.1 = pnorm(100.05, 100, 15) - pnorm(99.95, 100, 15),
  breite_0 = pnorm(100, 100, 15) - pnorm(100, 100, 15)
), 6)
  breite_1 breite_0.1   breite_0 
  0.026591   0.002660   0.000000 
# Eine Dichte groesser als eins: Gleichverteilung auf einem schmalen Intervall
round(dunif(0.05, min = 0, max = 0.1), 2)
[1] 10
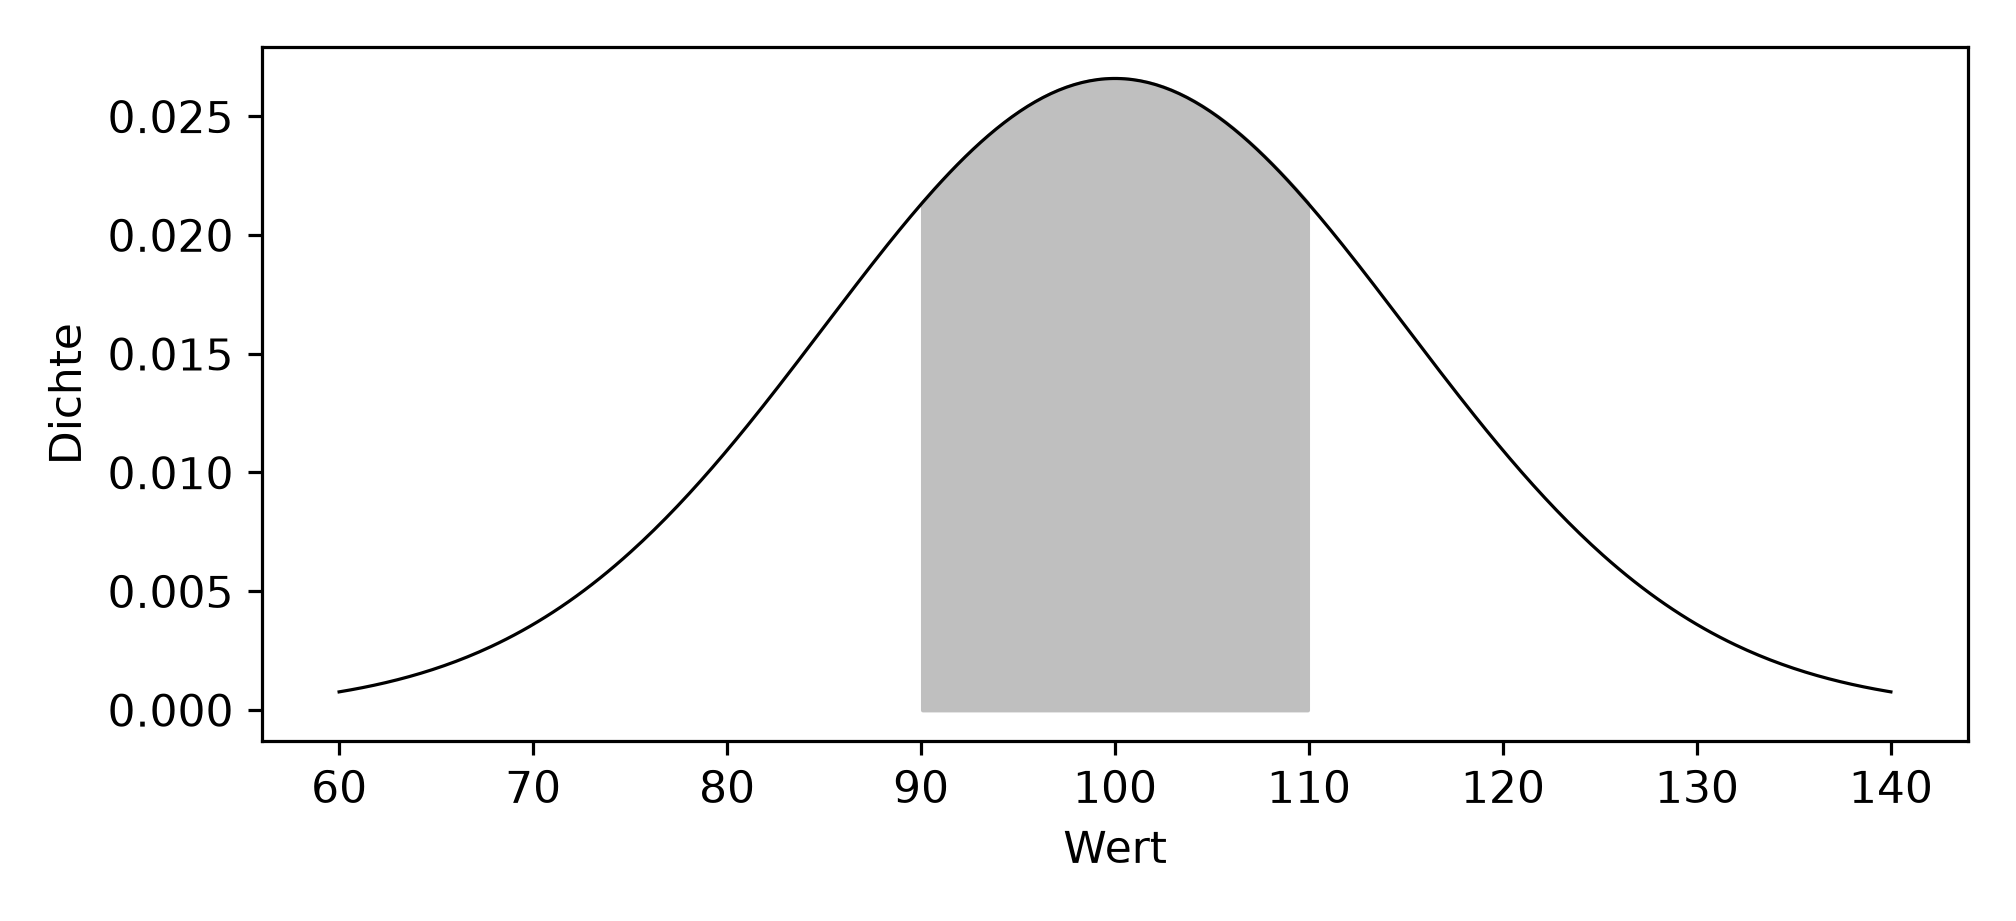
Abbildung 1: Beispiel 1: die Fläche unter der Dichte zwischen 90 und 110 ist die gesuchte Wahrscheinlichkeit.
x = np.linspace(60, 140, 400)
d = stats.norm.pdf(x, 100, 15)

fig, achse = plt.subplots(figsize=(7, 3.2))
maske = (x >= 90) & (x <= 110)
achse.fill_between(x[maske], d[maske], color="0.75")
achse.plot(x, d, lw=0.8, color="black")
achse.set_xlabel("Wert")
achse.set_ylabel("Dichte")
plt.tight_layout()
plt.show()
Abbildung 2: Beispiel 1: dieselbe Fläche in Python.
print(round(float(stats.norm.cdf(110, 100, 15)
                  - stats.norm.cdf(90, 100, 15)), 4))
0.495
print(round(float(stats.norm.pdf(100, 100, 15)), 4))
0.0266
for breite in [1, 0.1, 0]:
    unten, oben = 100 - breite / 2, 100 + breite / 2
    print(f"Breite {breite:5}:",
          round(float(stats.norm.cdf(oben, 100, 15)
                      - stats.norm.cdf(unten, 100, 15)), 6))
Breite     1: 0.026591
Breite   0.1: 0.00266
Breite     0: 0.0
print("Dichte der Gleichverteilung auf [0, 0.1]:",
      round(float(stats.uniform.pdf(0.05, loc=0, scale=0.1)), 2))
Dichte der Gleichverteilung auf [0, 0.1]: 10.0

Output Zeile für Zeile

Frage Rechnung Ergebnis
\(P(90 \le X \le 110)\) \(F(110) - F(90)\) 0.4950
Dichte bei 100 \(f(100)\) 0.0266
\(P(99.5 \le X \le 100.5)\) Intervall der Breite 1 0.02659
\(P(99.95 \le X \le 100.05)\) Breite 0.1 0.00266
\(P(X = 100)\) Breite 0 0.000000
Dichte der Gleichverteilung auf \([0, 0.1]\) 10.0
Beobachtung Erklärung
Die Dichte bei 100 beträgt 0.0266 Das ist keine Wahrscheinlichkeit. Wäre es eine, hiesse das “2.7 Prozent haben genau den IQ 100” und das ist falsch.
Die Intervallwahrscheinlichkeit schrumpft proportional zur Breite 0.02659 bei Breite 1, 0.00266 bei Breite 0.1, jeweils ungefähr \(f(100) \cdot \text{Breite}\). Das ist die Bedeutung der Dichte: Wahrscheinlichkeit je Einheit.
Bei Breite null bleibt genau null Kein Rundungsergebnis, sondern exakt. Deshalb sind \(P(X \le 100)\) und \(P(X < 100)\) bei stetigen Verteilungen identisch, anders als im diskreten Fall.
Die Dichte der Gleichverteilung auf \([0, 0.1]\) ist 10 Grösser als eins, und trotzdem korrekt: Die Fläche beträgt \(0.1 \cdot 10 = 1\). Begrenzt ist die Fläche, nicht die Höhe.

Die Faustregel, die daraus folgt: Eine Dichte hat eine Einheit, nämlich “je Einheit der Messgrösse”. Bei einer Körpergrösse in Metern ist sie “je Meter”; misst man in Zentimetern, wird sie hundertmal kleiner, ohne dass sich etwas geändert hätte.

Genau deshalb sind Dichtewerte zwischen zwei Verteilungen nur vergleichbar, wenn beide dieselbe Skala haben und deshalb liest man aus einem Dichteplot Formen und Verhältnisse ab, keine absoluten Zahlen.

Interpretation und Ergebnissatz

Rund 49.5 Prozent der Werte liegen zwischen 90 und 110. Die Wahrscheinlichkeit für einen exakten Wert ist bei einer stetigen Verteilung null; die Dichte von 0.027 an der Stelle 100 gibt die Wahrscheinlichkeit je Einheit an.

Frage und Datenlage

Vier Fragen an dieselbe Verteilung (\(\mu = 100\), \(\sigma = 15\)), die alle vier Präfixe brauchen.

Rechnung

# d: Dichte an einer Stelle
round(dnorm(115, 100, 15), 5)
[1] 0.01613
# p: Anteil unterhalb einer Schranke
round(pnorm(115, 100, 15), 4)
[1] 0.8413
# q: die Schranke zu einem Anteil - die Umkehrung von p
round(qnorm(0.8413, 100, 15), 3)
[1] 114.997
round(qnorm(c(0.025, 0.5, 0.975), 100, 15), 3)
[1]  70.601 100.000 129.399
# r: Zufallszahlen (hier deterministisch ueber die Quantilfunktion)
round(qnorm(lehmer(1234, 5), 100, 15), 2)
[1]  64.91  92.88  96.86 129.21  97.54
# Zwei typische Fragen
round(c(
  anteil_ueber_130 = 1 - pnorm(130, 100, 15),
  anteil_zwischen_85_115 = pnorm(115, 100, 15) - pnorm(85, 100, 15),
  wert_der_top_5_prozent = qnorm(0.95, 100, 15)
), 4)
      anteil_ueber_130 anteil_zwischen_85_115 wert_der_top_5_prozent 
                0.0228                 0.6827               124.6728 
print(round(float(stats.norm.pdf(115, 100, 15)), 5))
0.01613
print(round(float(stats.norm.cdf(115, 100, 15)), 4))
0.8413
print(round(float(stats.norm.ppf(0.8413, 100, 15)), 3))
114.997
print(np.round(stats.norm.ppf([0.025, 0.5, 0.975], 100, 15), 3))
[ 70.601 100.    129.399]
print(np.round(stats.norm.ppf(lehmer(1234, 5), 100, 15), 2))
[ 64.91  92.88  96.86 129.21  97.54]
print({"anteil_ueber_130": round(float(1 - stats.norm.cdf(130, 100, 15)), 4),
       "anteil_zwischen_85_115": round(float(stats.norm.cdf(115, 100, 15)
                                             - stats.norm.cdf(85, 100, 15)), 4),
       "wert_der_top_5_prozent": round(float(stats.norm.ppf(0.95, 100, 15)), 4)})
{'anteil_ueber_130': 0.0228, 'anteil_zwischen_85_115': 0.6827, 'wert_der_top_5_prozent': 124.6728}

Output Zeile für Zeile

Aufruf Ergebnis Frage, die er beantwortet
dnorm(115) 0.01613 Wie dicht liegen die Werte bei 115?
pnorm(115) 0.8413 Welcher Anteil liegt unter 115?
qnorm(0.8413) 114.997 Unter welchem Wert liegen 84.13 Prozent?
qnorm(c(0.025, 0.5, 0.975)) 70.6, 100.0, 129.4 Die Grenzen des mittleren 95-Prozent-Bereichs.
Anteil über 130 0.0228 \(1 - F(130)\), zwei Prozent.
Anteil zwischen 85 und 115 0.6827 Genau die 68-Prozent-Faustregel: \(\pm 1\sigma\).
Wert der obersten 5 Prozent 124.67 \(q(0.95)\).
Beobachtung Erklärung
qnorm(pnorm(115)) ergibt wieder 115 Bis auf Rundung (114.997, weil 0.8413 gerundet eingegeben wurde). Die beiden sind exakte Umkehrfunktionen.
Der mittlere 95-Prozent-Bereich ist 70.6 bis 129.4 Also \(100 \pm 1.96 \cdot 15\). Die 1.96 ist qnorm(0.975) und die meistverwendete Zahl der ganzen Statistik.
Für “mehr als” wird von eins abgezogen R bietet dafür lower.tail = FALSE, was bei sehr kleinen Wahrscheinlichkeiten genauer rechnet als 1 - pnorm(...).
Die “Zufallszahlen” hier sind keine Sie entstehen als qnorm() gleichverteilter Werte, genau das macht rnorm() intern auch. Beispiel 3 führt das aus.

Die Denkhilfe für p und q: p geht von der Achse nach oben (Wert hinein, Anteil heraus), q von der Achse nach links (Anteil hinein, Wert heraus). Wer sie verwechselt, merkt es meist an der Grössenordnung, ein Anteil liegt zwischen 0 und 1, ein Wert nicht.

Und der häufigste Fehler: In R heisst der zweite Parameter sd, in scipy heisst er scale, beides die Standardabweichung. Bei der Exponentialverteilung ist scale dagegen der Kehrwert der Rate. Das ist eine regelmässige Fehlerquelle beim Wechsel zwischen den Sprachen.

Interpretation

Vier Präfixe, vier Fragen, mehr braucht es für den Umgang mit einer stetigen Verteilung nicht. Das Schema gilt für jede der rund hundert Verteilungen, die R und scipy mitbringen.

Frage und Datenlage

Alle Beispieldaten dieser Sammlung entstehen aus einem einfachen Kongruenzgenerator, der gleichverteilte Zahlen zwischen 0 und 1 liefert. Wie wird daraus eine Normal- oder Exponentialverteilung?

Rechnung

u <- lehmer(2468, 3000)

normal <- qnorm(u, mean = 100, sd = 15)
exponential <- -log(u) / 0.5          # entspricht qexp(u, rate = 0.5)
gleich <- 25 + 50 * u

par(mfrow = c(1, 3), mar = c(4, 4, 3, 1))
hist(gleich, breaks = 40, col = "grey75", border = "white",
     main = "u selbst", xlab = "Wert")
hist(normal, breaks = 40, col = "grey75", border = "white",
     main = "normalverteilt", xlab = "Wert")
hist(exponential, breaks = 40, col = "grey75", border = "white",
     main = "exponentialverteilt", xlab = "Wert")
par(mfrow = c(1, 1))

# Drei einzelne Werte, durch alle drei Funktionen
beispiel <- c(0.1, 0.5, 0.9)
round(rbind(u = beispiel,
            normal = qnorm(beispiel, 100, 15),
            exponential = qexp(beispiel, rate = 0.5),
            gleich = 25 + 50 * beispiel), 4)
               [,1]     [,2]     [,3]
u            0.1000   0.5000   0.9000
normal      80.7767 100.0000 119.2233
exponential  0.2107   1.3863   4.6052
gleich      30.0000  50.0000  70.0000
# Stimmen die Kennzahlen?
round(rbind(
  gleich = c(mittel = mean(gleich), sd = sd(gleich),
             erwartet_mittel = 50, erwartet_sd = 50 / sqrt(12)),
  normal = c(mean(normal), sd(normal), 100, 15),
  exponential = c(mean(exponential), sd(exponential), 2, 2)
), 3)
             mittel     sd erwartet_mittel erwartet_sd
gleich       50.365 14.313              50      14.434
normal      100.324 14.729             100      15.000
exponential   1.942  1.945               2       2.000
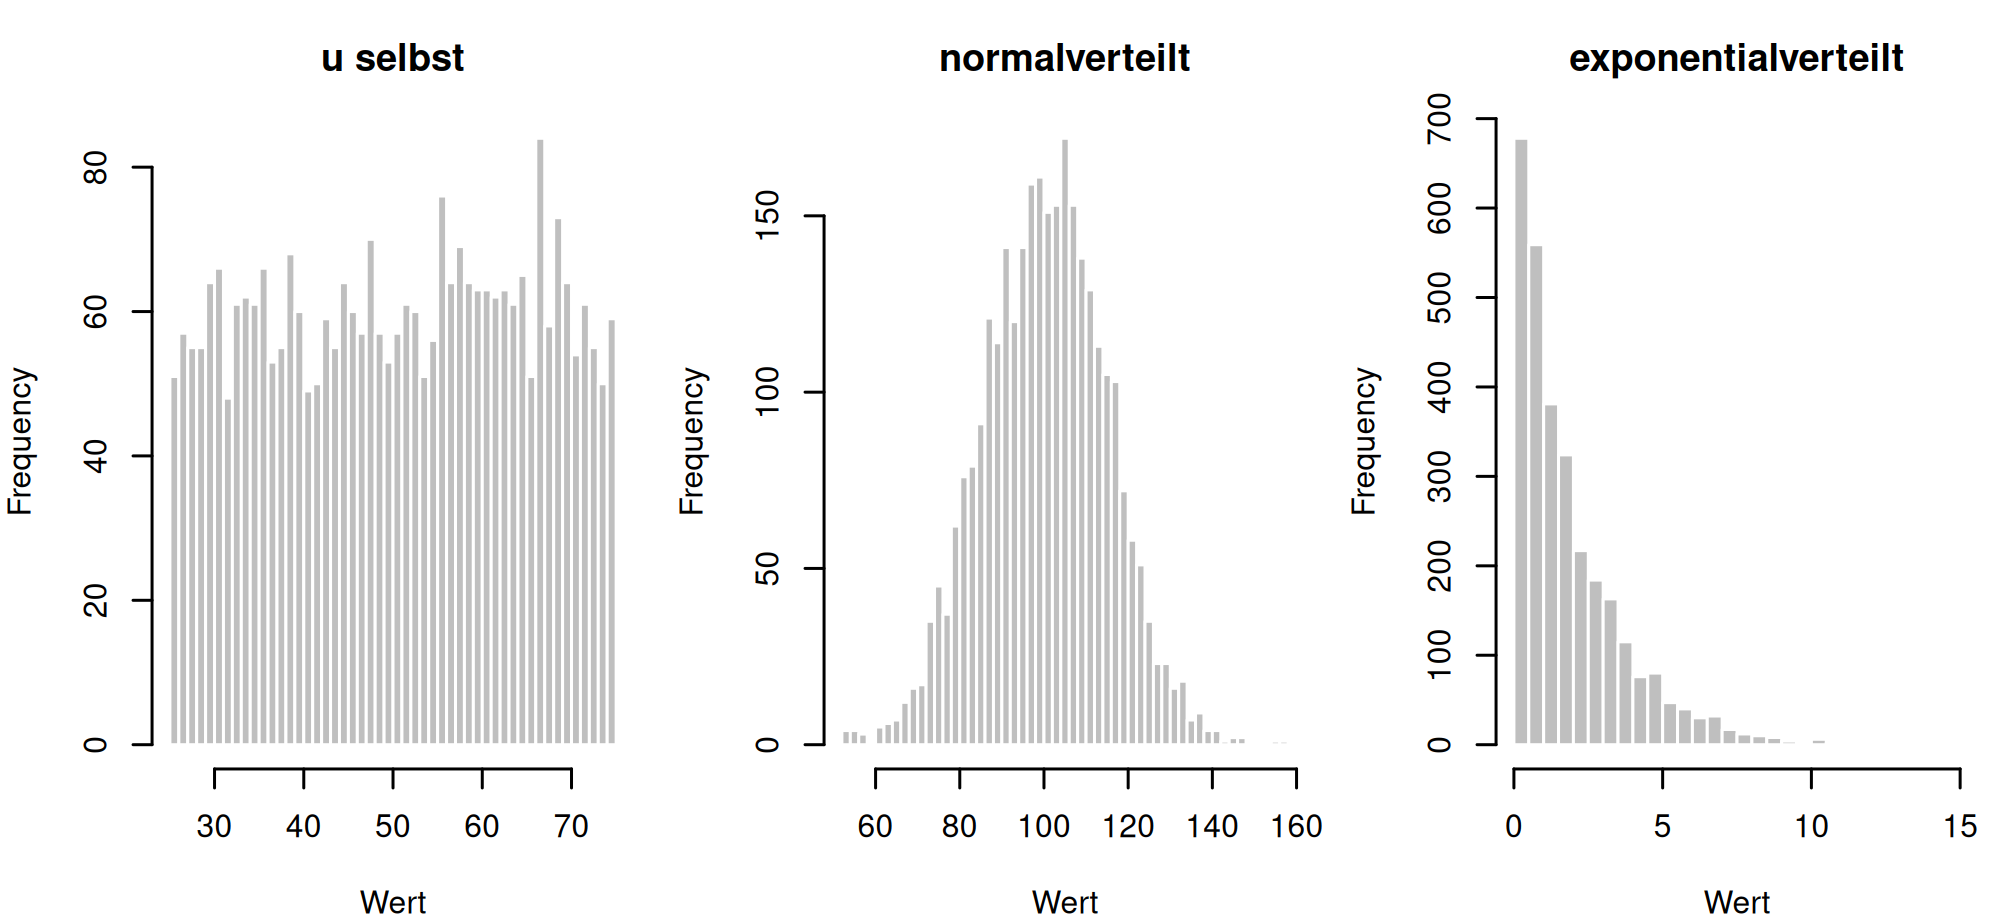
Abbildung 3: Beispiel 3: dieselben gleichverteilten Zahlen, durch drei Quantilfunktionen geschickt.
u = lehmer(2468, 3000)

normal = stats.norm.ppf(u, 100, 15)
exponential = -np.log(u) / 0.5
gleich = 25 + 50 * u

fig, achsen = plt.subplots(1, 3, figsize=(7, 3.2))
for achse, daten, titel in zip(achsen, [gleich, normal, exponential],
                               ["u selbst", "normalverteilt", "exponentialverteilt"]):
    achse.hist(daten, bins=40, color="0.75", edgecolor="white")
    achse.set_title(titel, fontsize=9)
    achse.set_xlabel("Wert")
plt.tight_layout()
plt.show()
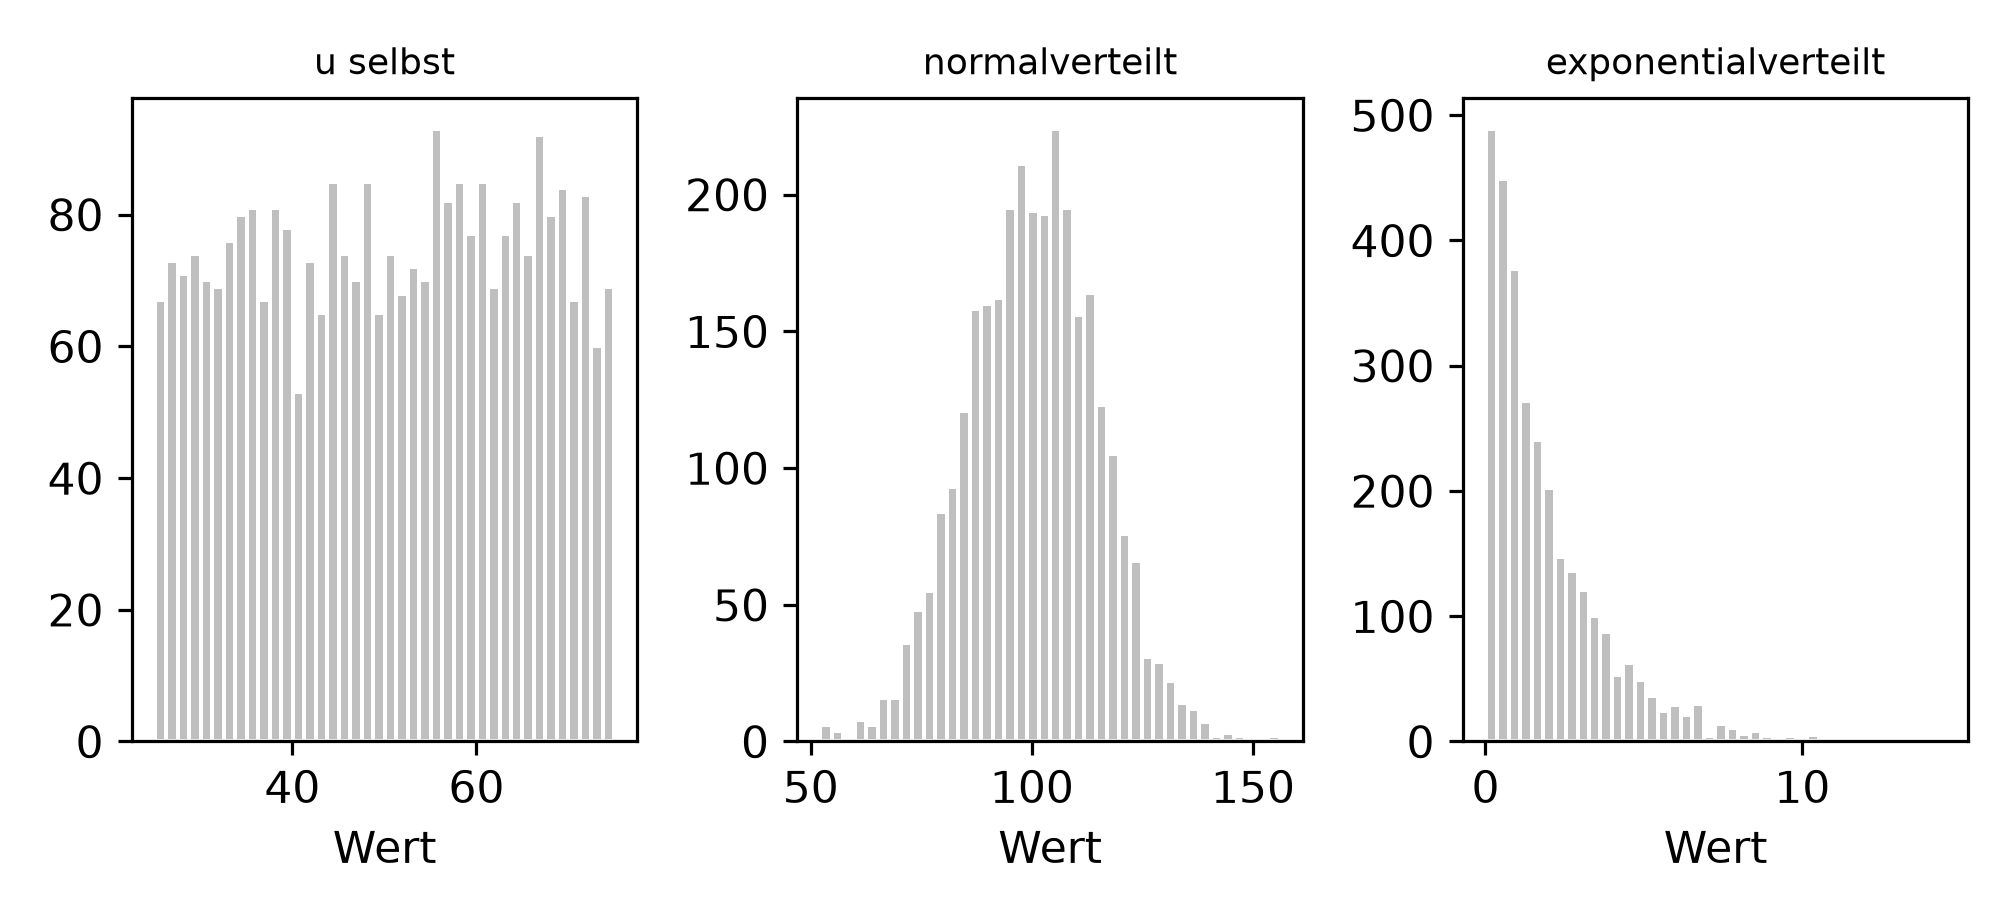
Abbildung 4: Beispiel 3: dieselbe Umformung in Python.
beispiel = np.array([0.1, 0.5, 0.9])
print(pd.DataFrame({
    "u": beispiel,
    "normal": stats.norm.ppf(beispiel, 100, 15),
    "exponential": stats.expon.ppf(beispiel, scale=1 / 0.5),
    "gleich": 25 + 50 * beispiel,
}).round(4).T)
                   0         1         2
u             0.1000    0.5000    0.9000
normal       80.7767  100.0000  119.2233
exponential   0.2107    1.3863    4.6052
gleich       30.0000   50.0000   70.0000
print(pd.DataFrame({
    "gleich": [gleich.mean(), gleich.std(ddof=1), 50, 50 / np.sqrt(12)],
    "normal": [normal.mean(), normal.std(ddof=1), 100, 15],
    "exponential": [exponential.mean(), exponential.std(ddof=1), 2, 2],
}, index=["mittel", "sd", "erwartet_mittel", "erwartet_sd"]).T.round(3))
              mittel      sd  erwartet_mittel  erwartet_sd
gleich        50.365  14.313             50.0       14.434
normal       100.324  14.729            100.0       15.000
exponential    1.942   1.945              2.0        2.000

Output Zeile für Zeile

Drei einzelne Werte, durch die drei Quantilfunktionen geschickt:

\(u\) 0.1 0.5 0.9
normal (\(\mu=100\), \(\sigma=15\)) 80.78 100.00 119.22
exponential (Rate 0.5) 0.2107 1.3863 4.6052
gleich auf \([25, 75]\) 30.0 50.0 70.0
Beobachtung Erklärung
\(u = 0.5\) ergibt immer den Median 100, 1.386 und 50. Das ist die Definition der Quantilfunktion.
Die Zahlen 0.1 und 0.9 sind symmetrisch in \(u\), die Ergebnisse nicht Bei der Normalverteilung schon (80.8 und 119.2 liegen gleich weit von 100), bei der Exponentialverteilung nicht (0.21 und 4.61). Die Schiefe entsteht in der Quantilfunktion.
Die Histogramme zeigen drei völlig verschiedene Formen Aus denselben 3 000 Zahlen.
Die Kennzahlen treffen die Erwartung Mittel und Standardabweichung liegen in allen drei Fällen nahe an den theoretischen Werten.

Das Verfahren heisst Inversionsmethode und beruht auf einer einzigen Tatsache: Ist \(U\) gleichverteilt auf \([0,1]\), dann hat \(F^{-1}(U)\) genau die Verteilung \(F\). Der Beweis ist eine Zeile:

\[P(F^{-1}(U) \le x) = P(U \le F(x)) = F(x)\]

Praktisch heisst das:

Verteilung Quantilfunktion von Hand
exponential, Rate \(\lambda\) \(-\ln(u) / \lambda\)
gleich auf \([a,b]\) \(a + (b-a)u\)
Weibull, Form \(k\), Skala \(\lambda\) \(\lambda(-\ln u)^{1/k}\)
normal keine geschlossene Form, deshalb qnorm()

Und genau darauf beruhen die Beispieldaten dieser Sammlung. Ein Kongruenzgenerator liefert die gleichverteilten Zahlen, und die Quantilfunktion macht daraus, was gebraucht wird, in R und Python identisch, was bei set.seed() und default_rng() nicht der Fall wäre.

Interpretation und Ergebnissatz

Aus 3 000 gleichverteilten Zufallszahlen entstehen über die jeweilige Quantilfunktion eine Normal-, eine Exponential- und eine Gleichverteilung. Die empirischen Kennzahlen entsprechen jeweils den theoretischen.

Frage und Datenlage

Ein Bauteil hat eine mittlere Lebensdauer von 10 Jahren. Wie wahrscheinlich ist es, dass es weitere drei Jahre hält, wenn es neu ist, und wenn es schon 20 Jahre gelaufen ist?

Zwei Modelle mit derselben mittleren Lebensdauer:

Modell Parameter
Exponential Rate 0.1
Weibull Form \(k = 2.5\), Skala 11.27

Rechnung

rate <- 0.1
k <- 2.5
skala <- 10 / gamma(1 + 1 / k)

round(c(skala = skala,
        mittel_weibull = skala * gamma(1 + 1 / k),
        sd_exponential = 1 / rate,
        sd_weibull = skala * sqrt(gamma(1 + 2 / k) - gamma(1 + 1 / k)^2),
        median_exponential = qexp(0.5, rate),
        median_weibull = qweibull(0.5, shape = k, scale = skala)), 3)
             skala     mittel_weibull     sd_exponential         sd_weibull 
            11.271             10.000             10.000              4.279 
median_exponential     median_weibull 
             6.931              9.734 
t <- seq(0, 30, by = 0.1)
par(mar = c(4, 4, 2, 1))
plot(t, 1 - pexp(t, rate), type = "l", lwd = 2, ylim = c(0, 1),
     xlab = "Jahre", ylab = "Anteil noch intakt")
lines(t, 1 - pweibull(t, shape = k, scale = skala), lwd = 2, lty = 2)
legend("topright", legend = c("Exponential", "Weibull"),
       lwd = 2, lty = c(1, 2), bty = "n")

# Wahrscheinlichkeit fuer weitere drei Jahre, je nach bisherigem Alter
for (alter in c(0, 5, 10, 20)) {
  p_exp <- (1 - pexp(alter + 3, rate)) / (1 - pexp(alter, rate))
  p_wei <- (1 - pweibull(alter + 3, k, skala)) /
    (1 - pweibull(alter, k, skala))
  cat(sprintf("nach %2d Jahren | Exponential %.4f | Weibull %.4f\n",
              alter, p_exp, p_wei))
}
nach  0 Jahren | Exponential 0.7408 | Weibull 0.9641
nach  5 Jahren | Exponential 0.7408 | Weibull 0.7457
nach 10 Jahren | Exponential 0.7408 | Weibull 0.5029
nach 20 Jahren | Exponential 0.7408 | Weibull 0.1730
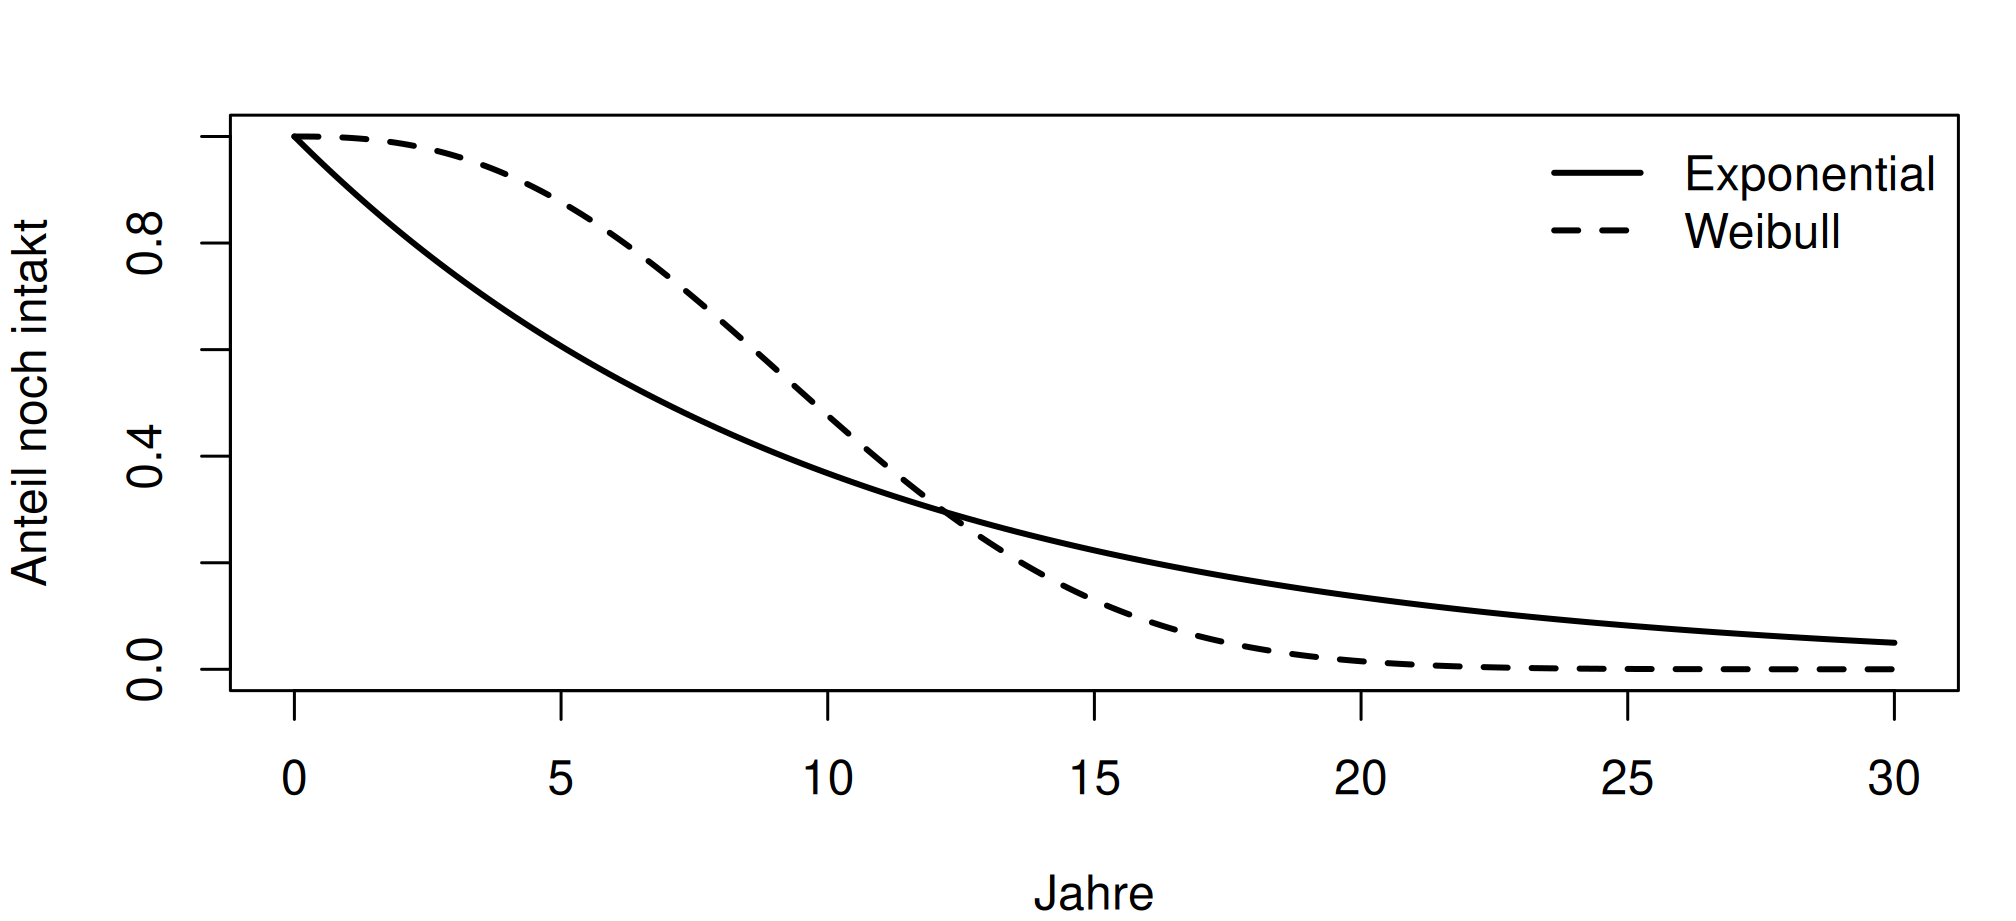
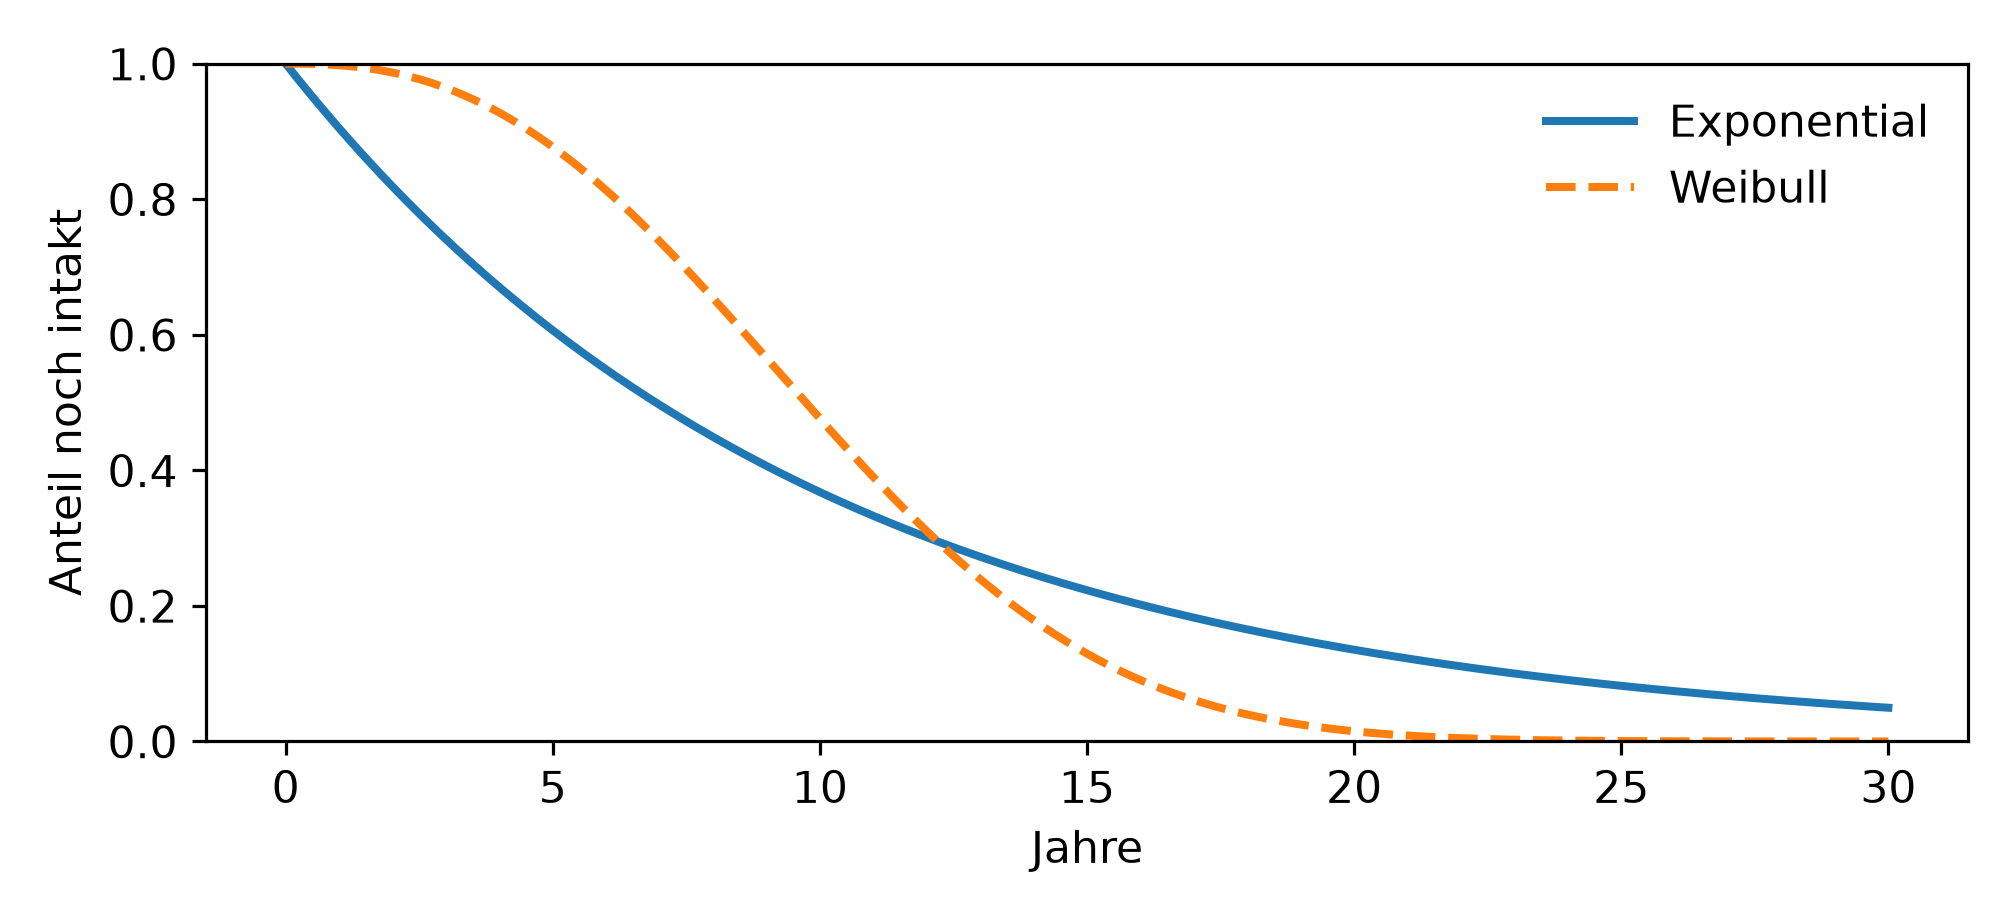
Abbildung 5: Beispiel 4: zwei Überlebensfunktionen mit identischer mittlerer Lebensdauer.
rate = 0.1
k = 2.5
skala = 10 / math.gamma(1 + 1 / k)

print({"skala": round(skala, 3),
       "mittel_weibull": round(skala * math.gamma(1 + 1 / k), 3),
       "sd_exponential": round(1 / rate, 3),
       "sd_weibull": round(skala * math.sqrt(math.gamma(1 + 2 / k)
                                             - math.gamma(1 + 1 / k) ** 2), 3),
       "median_exponential": round(float(stats.expon.ppf(0.5, scale=1 / rate)), 3),
       "median_weibull": round(float(stats.weibull_min.ppf(0.5, k,
                                                           scale=skala)), 3)})
{'skala': 11.271, 'mittel_weibull': 10.0, 'sd_exponential': 10.0, 'sd_weibull': 4.279, 'median_exponential': 6.931, 'median_weibull': 9.734}
t = np.arange(0, 30.1, 0.1)
fig, achse = plt.subplots(figsize=(7, 3.2))
achse.plot(t, stats.expon.sf(t, scale=1 / rate), lw=2, label="Exponential")
achse.plot(t, stats.weibull_min.sf(t, k, scale=skala), lw=2, ls="--",
           label="Weibull")
achse.set_ylim(0, 1)
(0.0, 1.0)
achse.set_xlabel("Jahre")
achse.set_ylabel("Anteil noch intakt")
achse.legend(frameon=False)
plt.tight_layout()
plt.show()
Abbildung 6: Beispiel 4: dieselbe Gegenüberstellung in Python.
for alter in [0, 5, 10, 20]:
    p_exp = (stats.expon.sf(alter + 3, scale=1 / rate)
             / stats.expon.sf(alter, scale=1 / rate))
    p_wei = (stats.weibull_min.sf(alter + 3, k, scale=skala)
             / stats.weibull_min.sf(alter, k, scale=skala))
    print(f"nach {alter:2d} Jahren | Exponential {p_exp:.4f}"
          f" | Weibull {p_wei:.4f}")
nach  0 Jahren | Exponential 0.7408 | Weibull 0.9641
nach  5 Jahren | Exponential 0.7408 | Weibull 0.7457
nach 10 Jahren | Exponential 0.7408 | Weibull 0.5029
nach 20 Jahren | Exponential 0.7408 | Weibull 0.1730

Output Zeile für Zeile

Kennzahl Exponential Weibull
mittlere Lebensdauer 10.0 10.0
Standardabweichung 10.0 4.28
Median 6.93 9.73

Und die eigentliche Frage, Wahrscheinlichkeit für weitere drei Jahre:

bisheriges Alter Exponential Weibull
0 Jahre (neu) 0.7408 0.9641
5 Jahre 0.7408 0.7457
10 Jahre 0.7408 0.5029
20 Jahre 0.7408 0.1730
Beobachtung Erklärung
Die Exponentialspalte ist konstant 0.7408 bei jedem Alter. Das ist die Gedächtnislosigkeit: \(P(T > s+t \mid T > s) = P(T > t)\). Ein zwanzig Jahre altes Bauteil ist so gut wie ein neues.
Die Weibullspalte fällt Von 0.96 auf 0.17. Ein gealtertes Bauteil hat eine schlechtere Aussicht, das ist Verschleiss.
Beide haben dieselbe mittlere Lebensdauer Und völlig verschiedene Aussagen über den Einzelfall. Der Mittelwert allein trägt die Entscheidung nicht.
Die Standardabweichungen unterscheiden sich um Faktor 2.3 10.0 gegen 4.28. Bei der Exponentialverteilung ist die Streuung immer gleich dem Mittelwert; die Weibull mit \(k > 1\) ist deutlich enger.
Der Median liegt bei Exponential unter dem Mittel 6.93 gegen 10, die Verteilung ist stark rechtsschief. Bei der Weibull mit 9.73 fast beim Mittelwert.

Wann die Gedächtnislosigkeit passt und wann nicht:

Passt Passt nicht
Zeit bis zum nächsten Anruf in einer Zentrale Lebensdauer eines Lagers, einer Batterie, eines Reifens
radioaktiver Zerfall alles mit Ermüdung, Korrosion, Abnutzung
Ausfälle durch äussere Störungen Ausfälle durch Alterung

Der Formparameter \(k\) der Weibullverteilung entscheidet:

\(k\) Bedeutung Ausfallrate
\(k < 1\) Frühausfälle fällt mit der Zeit
\(k = 1\) identisch mit der Exponentialverteilung konstant
\(k > 1\) Verschleiss steigt mit der Zeit

Daraus wird die berühmte Badewannenkurve: früh \(k < 1\), in der Mitte \(k = 1\), spät \(k > 1\). Mehr dazu unter Zensierung und Überlebensfunktion.

Interpretation und Ergebnissatz

Beide Modelle haben eine mittlere Lebensdauer von 10 Jahren, treffen aber gegensätzliche Aussagen über gealterte Bauteile: Nach 20 Jahren beträgt die Wahrscheinlichkeit für weitere drei Jahre unter der Exponentialannahme 74 Prozent, unter der Weibullannahme 17 Prozent. Für Verschleissteile ist die Exponentialverteilung nicht geeignet.

Verständnisfragen

Eine Dichtefunktion nimmt an einer Stelle den Wert 10 an. Ist das möglich?

Ja, denn die Dichte ist keine Wahrscheinlichkeit
Richtig. Sie gibt Wahrscheinlichkeit pro Einheit an. Bei einer Gleichverteilung zwischen 0 und 0.1 muss die Dichte 10 betragen, damit die Fläche eins ergibt. Beschränkt ist die Fläche, nicht die Höhe.
Nein, Wahrscheinlichkeiten liegen zwischen null und eins
Das gilt für Wahrscheinlichkeiten, und eine Dichte ist keine.
Nur bei diskreten Verteilungen
Dort gibt es gar keine Dichte, sondern eine Wahrscheinlichkeitsfunktion, und deren Werte sind tatsächlich begrenzt.

Warum sind bei einer stetigen Verteilung \(P(X \le 100)\) und \(P(X < 100)\) identisch?

Weil \(P(X = 100)\) exakt null ist
Richtig. Das Intervall der Breite null hat die Fläche null. Bei diskreten Verteilungen ist das anders, dort unterscheiden sich die beiden um genau \(P(X = 100)\).
Weil gerundet wird
Der Unterschied ist exakt null, nicht nur klein.
Sie sind nicht identisch
Bei stetigen Verteilungen doch.

Aus gleichverteilten Zufallszahlen \(u\) soll eine exponentialverteilte Grösse mit Rate 0.5 entstehen. Wie?

Über die Quantilfunktion, hier \(-\ln(u)/0.5\)
Richtig. Ist \(U\) gleichverteilt, hat \(F^{-1}(U)\) die Verteilung \(F\). Das ist die Inversionsmethode, und genau so entstehen die Beispieldaten dieser Sammlung.
Durch Multiplikation mit dem Erwartungswert
Das ergäbe wieder eine Gleichverteilung, nur anders skaliert.
Über die Dichtefunktion
Die Dichte ist der falsche Weg; gebraucht wird die Umkehrung der Verteilungsfunktion.

Ein Bauteil ist exponentialverteilt mit mittlerer Lebensdauer 10 Jahre. Wie verändert sich seine Restlebensdauer, nachdem es 20 Jahre gelaufen ist?

Gar nicht, sie ist dieselbe wie bei einem neuen Bauteil
Richtig. Das ist die Gedächtnislosigkeit der Exponentialverteilung. Für Verschleissteile ist sie deshalb die falsche Annahme; dort passt eine Weibullverteilung mit Formparameter über eins.
Sie sinkt, weil das Bauteil gealtert ist
Inhaltlich plausibel, aber das Modell sagt es nicht. Genau das ist die Kritik an der Annahme.
Sie steigt, weil es sich bewährt hat
Das gilt bei Formparametern unter eins, also bei Frühausfällen.

Zwei Modelle haben dieselbe mittlere Lebensdauer von 10 Jahren, aber Standardabweichungen von 10.0 und 4.3. Was folgt daraus für die Planung?

Der Mittelwert allein trägt die Entscheidung nicht
Richtig. Bei identischem Mittel sagen die beiden Modelle nach 20 Jahren 74 gegenüber 17 Prozent Restwahrscheinlichkeit voraus. Nötig sind Streuung und Verteilungsform, oder besser gleich ein Quantil.
Das Modell mit der kleineren Streuung ist besser
Welches passt, entscheidet die Sache, nicht die Streuung.
Die beiden Modelle sind gleichwertig
Sie stimmen nur im Erwartungswert überein.

Verlinkte Ressourcen