Typische Fragestellungen: Wie lange bleiben Mitglieder, bis wann fällt ein Bauteil aus, welcher Anteil ist nach zwölf Monaten noch ohne Rückfall. Gemeinsam ist ihnen eine Zeit bis zu einem Ereignis und ein Teil Beobachtungen, bei denen das Ereignis noch nicht eingetreten ist.
Der Kaplan-Meier-Schätzer ist beschreibend: Er schätzt die Kurve, ohne eine Verteilungsform zu unterstellen und ohne Einflussgrössen zu berücksichtigen. Er ist deshalb fast immer der erste Schritt und selten der letzte.
Ein einzelner metrischer Prädiktor soll gezeigt werden
Klassen bilden und je Klasse eine Kurve, oder Cox-Modell
Grundidee und Modell
Die Kurve entsteht Schritt für Schritt: An jedem Zeitpunkt, an dem ein Ereignis eintritt, wird der Anteil derjenigen berechnet, die diesen Zeitpunkt überstehen, und dieser Anteil multipliziert die bisherige Kurve.
Zeitpunkt, an dem mindestens ein Ereignis eintritt
\(d_i\)
Anzahl Ereignisse zu diesem Zeitpunkt
\(n_i\)
Anzahl unter Risiko, also noch beobachtet und ohne Ereignis
\(1 - d_i/n_i\)
bedingte Wahrscheinlichkeit, diesen Zeitpunkt zu überstehen
\(\prod\)
Produkt über alle Ereigniszeitpunkte bis \(t\)
Zensierte Beobachtungen tauchen nicht als Ereignis auf, verkleinern aber \(n_i\) für alle späteren Zeitpunkte. Genau dadurch fliesst ihre Information ein: Sie haben bis zu ihrem Ausscheiden mitgezählt. Die Kurve ist deshalb eine Treppenfunktion, die nur bei Ereignissen fällt.
Warum nicht einfach der Mittelwert der beobachteten Zeiten? Weil die zensierten Beobachtungen dann entweder wegfallen müssten, was systematisch die langen Verläufe entfernt und das Ergebnis zu pessimistisch macht oder als Ereigniszeiten gezählt würden, was sie zu kurz ansetzt. Der Produkt-Limit-Schätzer umgeht beides, indem er nur bedingte Wahrscheinlichkeiten verkettet.
Voraussetzungen und ihre Prüfung
Voraussetzung
Was sie bedeutet
Prüfung
Folge bei Verletzung
Vorgehen
Rechtszensierung
Bekannt ist, dass das Ereignis nach der Beobachtungszeit liegt
Kurve systematisch zu optimistisch oder zu pessimistisch
Ursachen der Zensierung berichten, Sensitivitätsrechnung
Unabhängige Beobachtungen
Ein Ereignis beeinflusst andere nicht
Erhebungsdesign
Konfidenzband zu schmal
Modelle für geschachtelte Daten
Gleiche Grundgesamtheit über die Zeit
Kein Zustrom mit anderem Risiko mitten in der Beobachtung
Aufnahmezeitpunkte prüfen
Kurve mischt verschiedene Populationen
nach Aufnahmekohorte trennen
Genügend unter Risiko am Kurvenende
Der rechte Teil beruht nicht auf wenigen Fällen
Risikotabelle ansehen
Kurvenende schwankt stark und wird überinterpretiert
Kurve abschneiden, wo die Zahl zu klein wird
Output lesen
R, survfit() und summary():
Grösse
Was sie sagt
Faustregel oder Falle
n
Anzahl Beobachtungen
nicht Anzahl Ereignisse
events
Anzahl eingetretener Ereignisse
trägt die Genauigkeit der Schätzung, nicht n
median
Zeitpunkt, an dem die Kurve 0.5 erreicht
NA, wenn die Kurve nie unter 0.5 fällt; das ist kein Fehler
0.95LCL, 0.95UCL
Konfidenzintervall für den Median
oft breit und nach oben offen
time
Zeitpunkte in summary(..., times = ...)
frei wählbar, sinnvoll an fachlich relevanten Marken
n.risk
Anzahl unter Risiko zu diesem Zeitpunkt
sinkt durch Ereignisse und Zensierungen
n.event
Ereignisse seit dem letzten Zeitpunkt
survival
geschätzter Anteil ohne Ereignis
die eigentliche Zahl zum Berichten
std.err
Standardfehler dieser Schätzung
wächst mit fallender Anzahl unter Risiko
lower 95% CI, upper 95% CI
Konfidenzintervall des Anteils
am Kurvenende sehr breit
Python, KaplanMeierFitter:
Zugriff
Was er liefert
Unterschied zu R
median_survival_time_
Median
R nennt ihn in der Zusammenfassung mit Intervall; Python gibt inf statt NA
survival_function_
die vollständige Treppenfunktion als Tabelle
in R über summary()
survival_function_at_times([...])
Anteile zu gewählten Zeitpunkten
Gegenstück zu times =
confidence_interval_
Konfidenzband über alle Zeitpunkte
in R Teil von summary()
event_table
Ereignisse, Zensierungen und Anzahl unter Risiko je Zeitpunkt
in R die Spalten n.risk und n.event
plot_survival_function()
Kurve samt Band
in R plot()
Die Konfidenzbänder unterscheiden sich zwischen den Paketen, und zwar sichtbar. R rechnet standardmässig auf der Log-Skala (conf.type = "log"), lifelines auf der Log-Log-Skala. Beide sind gebräuchlich, das Log-Log-Band bleibt zuverlässiger zwischen 0 und 1. Abweichungen in der zweiten Nachkommastelle sind deshalb normal und kein Rechenfehler; die Punktschätzung der Kurve ist in beiden Sprachen identisch.
Interpretationsfallen
Der Median ist keine mittlere Laufzeit. Er ist der Zeitpunkt, an dem die Kurve 0.5 erreicht, eine Aussage über die Kurve, nicht über einen Durchschnitt.
Kein Median ist kein Fehler. Fällt die Kurve nie unter 0.5, ist die Antwort “im Beobachtungszeitraum nicht erreicht”, und es gehört ein Anteil zu einem festen Zeitpunkt berichtet.
Das Kurvenende ist unzuverlässig. Dort stehen wenige Beobachtungen unter Risiko; ohne Risikotabelle ist die Kurve dort nicht lesbar.
Zensierte Fälle sind keine Ereignisse. Wer sie als solche zählt, unterschätzt die Laufzeit systematisch; wer sie weglässt, überschätzt sie.
Getrennte Kurven sind kein Test. Der optische Abstand ersetzt den Log-Rank-Test nicht.
Kaplan-Meier kontrolliert nichts. Unterschiede zwischen Gruppen können von ganz anderen Merkmalen kommen; dafür ist das Cox-Modell da.
Die Kurve gilt für die beobachtete Population. Über den Beobachtungszeitraum hinaus sagt sie nichts.
Ergebnis berichten
Vorlage für den Ergebnissatz:
Von [n] Beobachtungen traten [Ereignisse] Ereignisse ein, [zensiert] waren zum Stichtag zensiert. Der geschätzte Anteil ohne Ereignis beträgt nach [t] [Anteil] (95-Prozent-Intervall [unten] bis [oben], [n.risk] unter Risiko). Der Median liegt bei [Wert] beziehungsweise wurde im Beobachtungszeitraum nicht erreicht.
Genannt werden: n und Anzahl Ereignisse getrennt, Art und Zeitpunkt der Zensierung, Anteile zu fachlich begründeten Zeitpunkten mit Intervall, die Anzahl unter Risiko dazu, und der Median nur, wenn er geschätzt ist.
Beispiel 1 rechnet die Kurve an zehn Fällen von Hand nach. Die Beispiele 2 bis 5 arbeiten mit einem grösseren konstruierten Datensatz: 400 Fitnessabos, Monats- und Jahresverträge, Distanz zum Studio zwischen 0.5 und 15 Kilometern, und ein Kündigungsrisiko, das mit Monatsvertrag und mit der Distanz steigt. Der Stichtag liegt bei 24 Monaten.
Sieben Ereignisse, darunter zwei Paare, die auf denselben Zeitpunkt fallen und drei Zensierungen mittendrin. Damit sind alle Situationen vertreten, die der Schätzer zu behandeln hat.
Die Rechnung Schritt für Schritt. Jede Zeile ist ein Zeitpunkt, an dem etwas passiert:
\(t_i\)
unter Risiko \(n_i\)
Ereignisse \(d_i\)
zensiert
Faktor \(1 - d_i/n_i\)
\(\hat{S}(t_i)\)
2
10
1
0
\(1 - 1/10 = 0.900\)
$1 = $ 0.9000
3
9
2
0
\(1 - 2/9 = 0.7778\)
$0.900 = $ 0.7000
5
7
0
1
, (kein Ereignis)
0.7000 (unverändert)
6
6
1
0
\(1 - 1/6 = 0.8333\)
$0.700 = $ 0.5833
7
5
0
1
0.5833
8
4
2
0
\(1 - 2/4 = 0.500\)
$0.5833 = $ 0.2917
10
2
0
1
0.2917
12
1
1
0
\(1 - 1/1 = 0\)
0.0000
Daran lässt sich jeder Mechanismus des Verfahrens ablesen:
Beobachtung
Was sie zeigt
Bei \(t = 3\) ist \(d_i = 2\)
Zwei Ereignisse zum selben Zeitpunkt werden gemeinsam verrechnet, nicht nacheinander. Sonst wäre \(\frac{8}{9} \cdot \frac{7}{8}\) zu rechnen, was hier zufällig dasselbe ergibt, bei anderen Konstellationen aber nicht.
Bei \(t = 5\) fällt die Kurve nicht
Eine Zensierung ist kein Ereignis. Die Kurve bleibt waagrecht.
Aber \(n_i\) springt von 7 auf 6
Genau so wirkt die Zensierung: Der Fall zählt bis \(t = 5\) voll mit und verschwindet danach aus dem Nenner. Seine Information “hat mindestens 5 überlebt” ist damit vollständig genutzt.
Bei \(t = 8\) halbiert sich die Kurve
2 von 4 unter Risiko, der grösste Einzelschritt, obwohl vorher schon Zeitpunkte mit zwei Ereignissen vorkamen. Späte Schritte sind gross, weil der Nenner klein ist.
Bei \(t = 12\) erreicht die Kurve exakt null
Die letzte Beobachtung ist ein Ereignis. Wäre sie zensiert, endete die Kurve bei 0.2917 und bliebe dort, undefiniert, nicht null.
Median = 8
Der erste Zeitpunkt, an dem \(\hat{S}(t) \le 0.5\) gilt. Bei \(t = 6\) steht die Kurve auf 0.5833, bei \(t = 8\) auf 0.2917. Der Median ist also nicht der Zeitpunkt, an dem die Kurve 0.5 schneidet, bei einer Treppenfunktion gibt es diesen Schnitt oft gar nicht.
Das Konfidenzintervall wächst mit jedem Schritt: bei \(t = 2\) noch 0.47 bis 0.99, bei \(t = 8\) schon 0.05 bis 0.61. Der Grund steht in der Spalte \(n_i\), je weniger unter Risiko, desto unsicherer die Schätzung.
Für diesen kleinen Datensatz ist in R ausdrücklich conf.type = "log-log" gesetzt, damit die Bänder mit denen von lifelines übereinstimmen. Ohne diese Angabe rechnet R auf der Log-Skala und liefert andere Grenzen.
Interpretation und Ergebnissatz
Von 10 Beobachtungen traten 7 Ereignisse ein, 3 waren zensiert. Der geschätzte Anteil ohne Ereignis beträgt nach 6 Zeiteinheiten 0.58 (95-Prozent-Intervall 0.23 bis 0.82, 6 unter Risiko). Der Median liegt bei 8.
Frage und Datenlage
Bevor eine Kurve gezeichnet wird, gehört geklärt: Wie viele Ereignisse gibt es überhaupt, und wann wird zensiert? Von der Antwort hängt ab, ob die zentrale Annahme des Verfahrens plausibel ist.
Diese Zahl trägt die Genauigkeit der Schätzung, nicht die 400.
Zensiert (status = 0)
153, also 38.3 Prozent
Ein normaler Anteil. Über etwa 70 Prozent Zensierung wird die Kurve am rechten Ende wertlos.
Spanne der Zensierungszeiten
genau 24 bis 24
Der entscheidende Befund: Alle zensierten Fälle liegen exakt auf dem Stichtag.
Kreuztabelle
Jahresverträge häufiger zensiert (101 von 165) als Monatsverträge (52 von 235)
Kein Problem, sondern das erwartete Bild: Wer seltener kündigt, erreicht häufiger den Stichtag.
Warum die Spanne der Zensierungszeiten die wichtigste Zahl dieses Beispiels ist: Liegt jede Zensierung auf dem Stichtag, handelt es sich um administrative Zensierung, die Beobachtung endet, weil die Studie endet, und nicht weil mit dem Fall etwas passiert ist. Die Annahme “Zensierte haben dasselbe Risiko wie die weiter Beobachteten” ist dann von der Erhebung her begründet.
Wären die Zensierungen über den ganzen Zeitraum verstreut, hiesse das, dass Fälle mittendrin aus der Beobachtung fallen. Dann gehört die Frage nach dem Grund in die Auswertung: Wer aus einem Fitnessstudio wegzieht, ist unproblematisch; wer das Abo unbemerkt über eine andere Kette weiterführt, verzerrt die Kurve systematisch. Ausführlich unter Zensierung.
Interpretation
Die Zensierung ist hier rein administrativ, das Verfahren ist also anwendbar. Diese Feststellung gehört an den Anfang jeder Survival-Auswertung und in den Bericht.
Frage und Datenlage
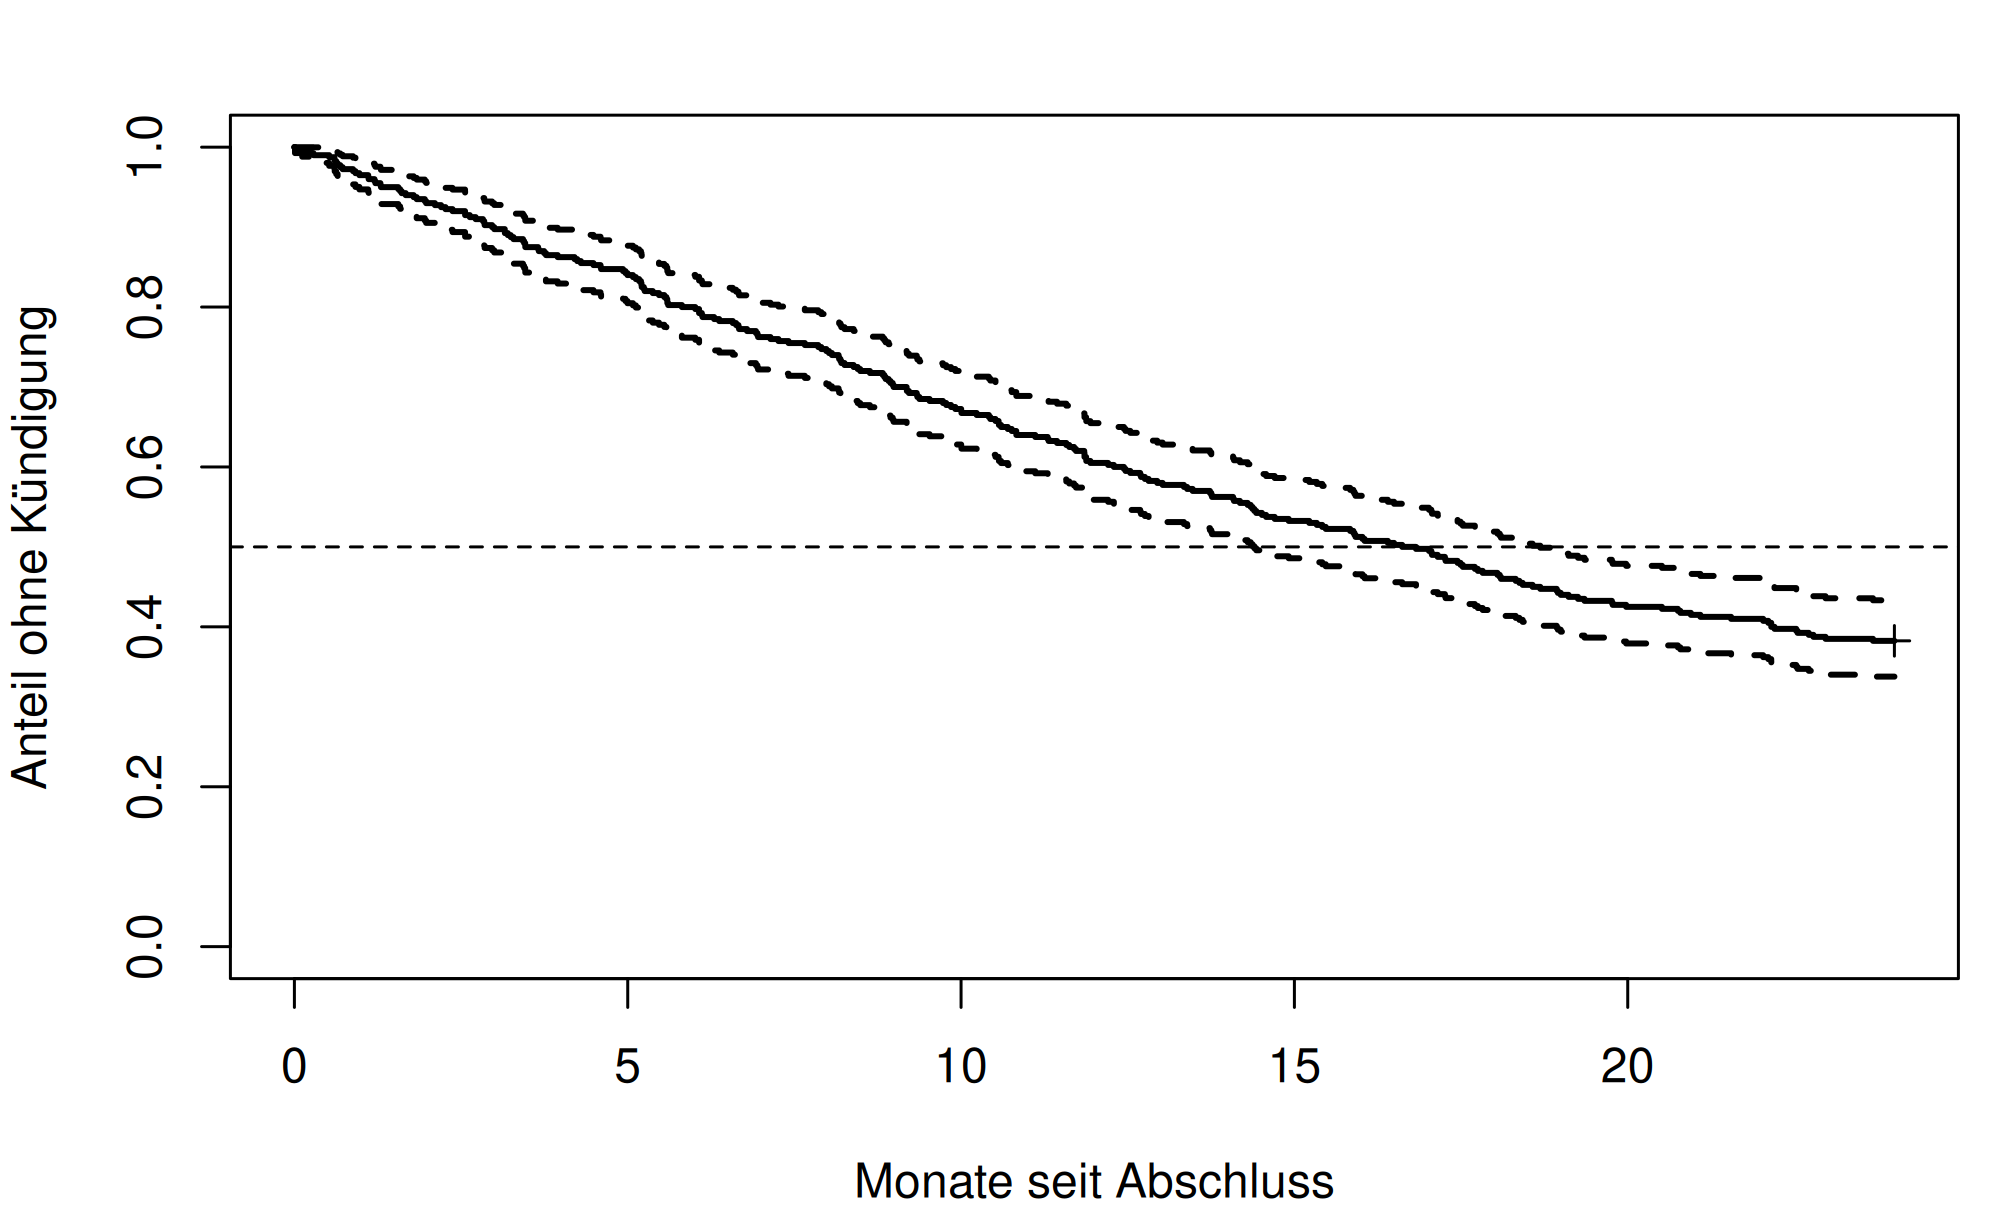
Die Kurve für alle 400 Abos, gelesen an fünf fachlich sinnvollen Zeitpunkten: nach 3, 6, 12, 18 und 24 Monaten.
zeitpunkte = [3, 6, 12, 18, 24]band = km.confidence_interval_survival_function_# je Zeitpunkt die letzte Stuetzstelle der Treppenfunktion vor oder auf tstuetzen = [band.index[band.index <= t][-1] for t in zeitpunkte]print(pd.DataFrame({"zeit": zeitpunkte,# unter Risiko zum Zeitpunkt t, wie R es zaehlt"n_risk": [int((abo["zeit"] >= t).sum()) for t in zeitpunkte],"S(t)": km.survival_function_at_times(zeitpunkte).round(3).values,"unten": band.iloc[:, 0].loc[stuetzen].round(3).values,"oben": band.iloc[:, 1].loc[stuetzen].round(3).values,}).to_string(index=False))
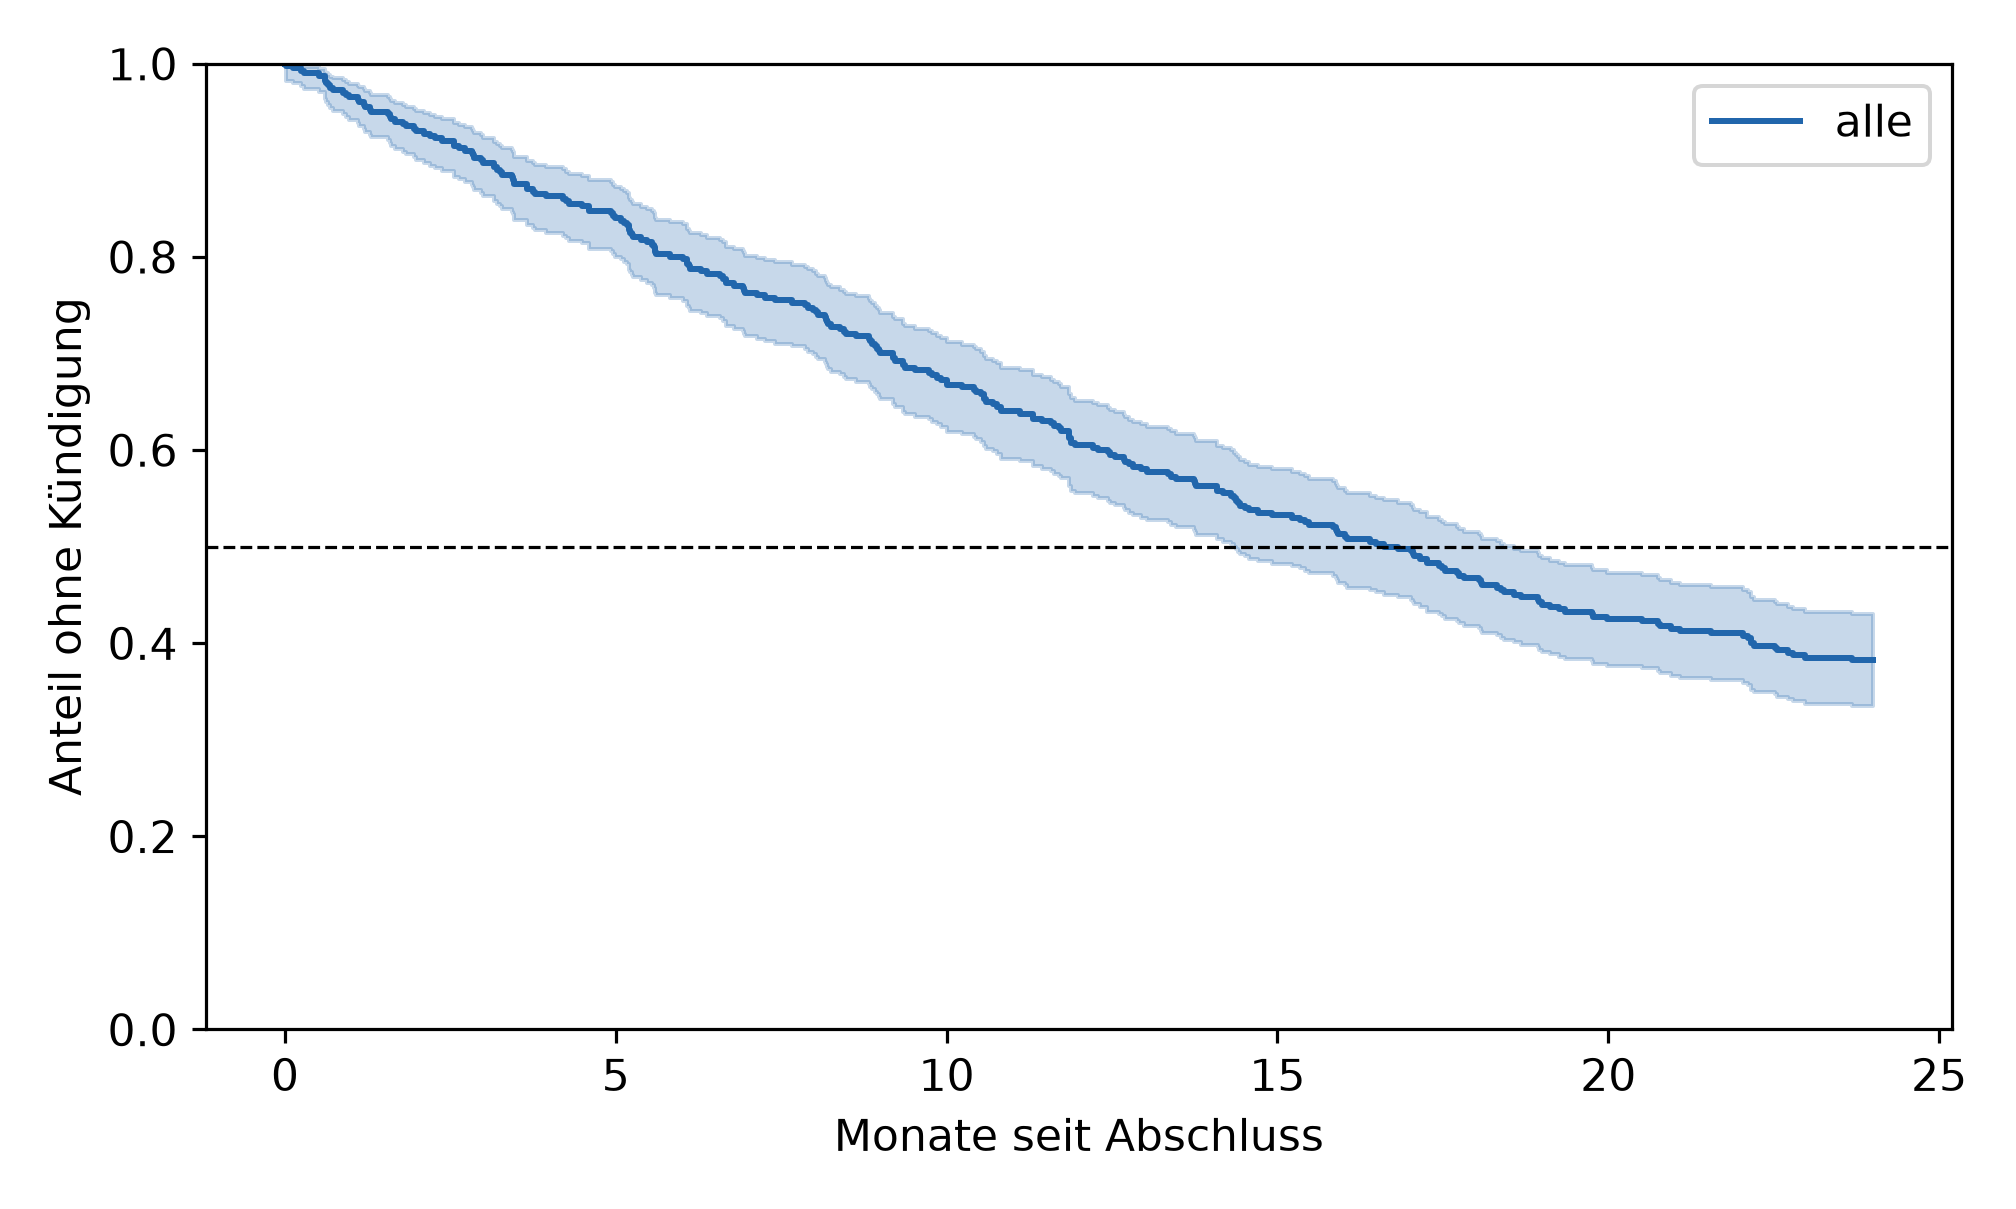
fig, achse = plt.subplots()km.plot_survival_function(ax=achse, ci_show=True, color="#2166ac")achse.axhline(0.5, linestyle="--", color="black", linewidth=0.8)achse.set_xlabel("Monate seit Abschluss")achse.set_ylabel("Anteil ohne Kündigung")achse.set_ylim(0, 1)
(0.0, 1.0)
plt.tight_layout()plt.show()
Abbildung 2: Beispiel 3: dieselbe Kurve mit lifelines.
Output Zeile für Zeile
Monat
unter Risiko
\(\hat{S}(t)\)
Band, R (log)
Band, Python (log-log)
3
359
0.898
0.868 bis 0.928
0.863 bis 0.923
6
320
0.800
0.762 bis 0.840
0.757 bis 0.836
12
242
0.605
0.559 bis 0.655
0.555 bis 0.651
18
187
0.468
0.421 bis 0.519
0.418 bis 0.515
24
153
0.383
0.338 bis 0.433
0.335 bis 0.430
Die beiden Bänder liegen um wenige Tausendstel auseinander, der oben erwähnte Unterschied zwischen Log- und Log-Log-Skala. Die Punktschätzung ist identisch.
Ausgabe
Wert hier
Bedeutung
\(\hat{S}(12) = 0.605\)
60.5 Prozent
Der geschätzte Anteil der Abos, die nach zwölf Monaten noch bestehen. Nicht “60.5 Prozent der Kündigungen sind noch offen” und nicht “60.5 Prozent Wahrscheinlichkeit für dieses eine Abo”, es ist eine Aussage über die Population.
Verlauf 0.898 → 0.800 → 0.605
in den ersten drei Monaten 10 Prozentpunkte, in den folgenden drei weitere 10, dann in sechs Monaten 20
Das Risiko ist am Anfang am höchsten und nimmt ab. Genau diesen Verlauf zeigt der steile Beginn der Kurve.
unter Risiko fällt 400 → 153
Die 153 am Schluss sind genau die zensierten Fälle: alle, die den Stichtag erreicht haben.
Median
16.62 Monate
Der Zeitpunkt, an dem die Kurve unter 0.5 fällt. Zwischen Monat 18 (0.468) und Monat 12 (0.605), was zur Tabelle passt.
Bandbreite
wächst von 0.060 auf rund 0.096
Nicht weil die Daten schlechter werden, sondern weil immer weniger Fälle die Schätzung tragen. Zusätzlich ist das Band um 0.5 herum von Natur aus am breitesten, dort ist die Varianz eines Anteils maximal.
Die Zeitpunkte in times = sind frei wählbar, und genau darin liegt eine stille Gefahr: Wer sie nach dem Blick auf die Kurve auswählt, berichtet das Ergebnis, das am besten aussieht. Sie gehören vorher festgelegt, aus der Sache heraus, hier etwa Quartals- und Jahresmarken, weil Verträge daran gebunden sind.
Interpretation und Ergebnissatz
Von 400 Abos wurden im Beobachtungszeitraum 247 gekündigt, 153 waren am Stichtag nach 24 Monaten noch aktiv. Der geschätzte Anteil ohne Kündigung beträgt nach zwölf Monaten 0.61 (95-Prozent-Intervall 0.56 bis 0.66, 242 unter Risiko) und nach 24 Monaten 0.38 (0.34 bis 0.43, 153 unter Risiko). Der Median der Laufzeit liegt bei 16.6 Monaten.
Frage und Datenlage
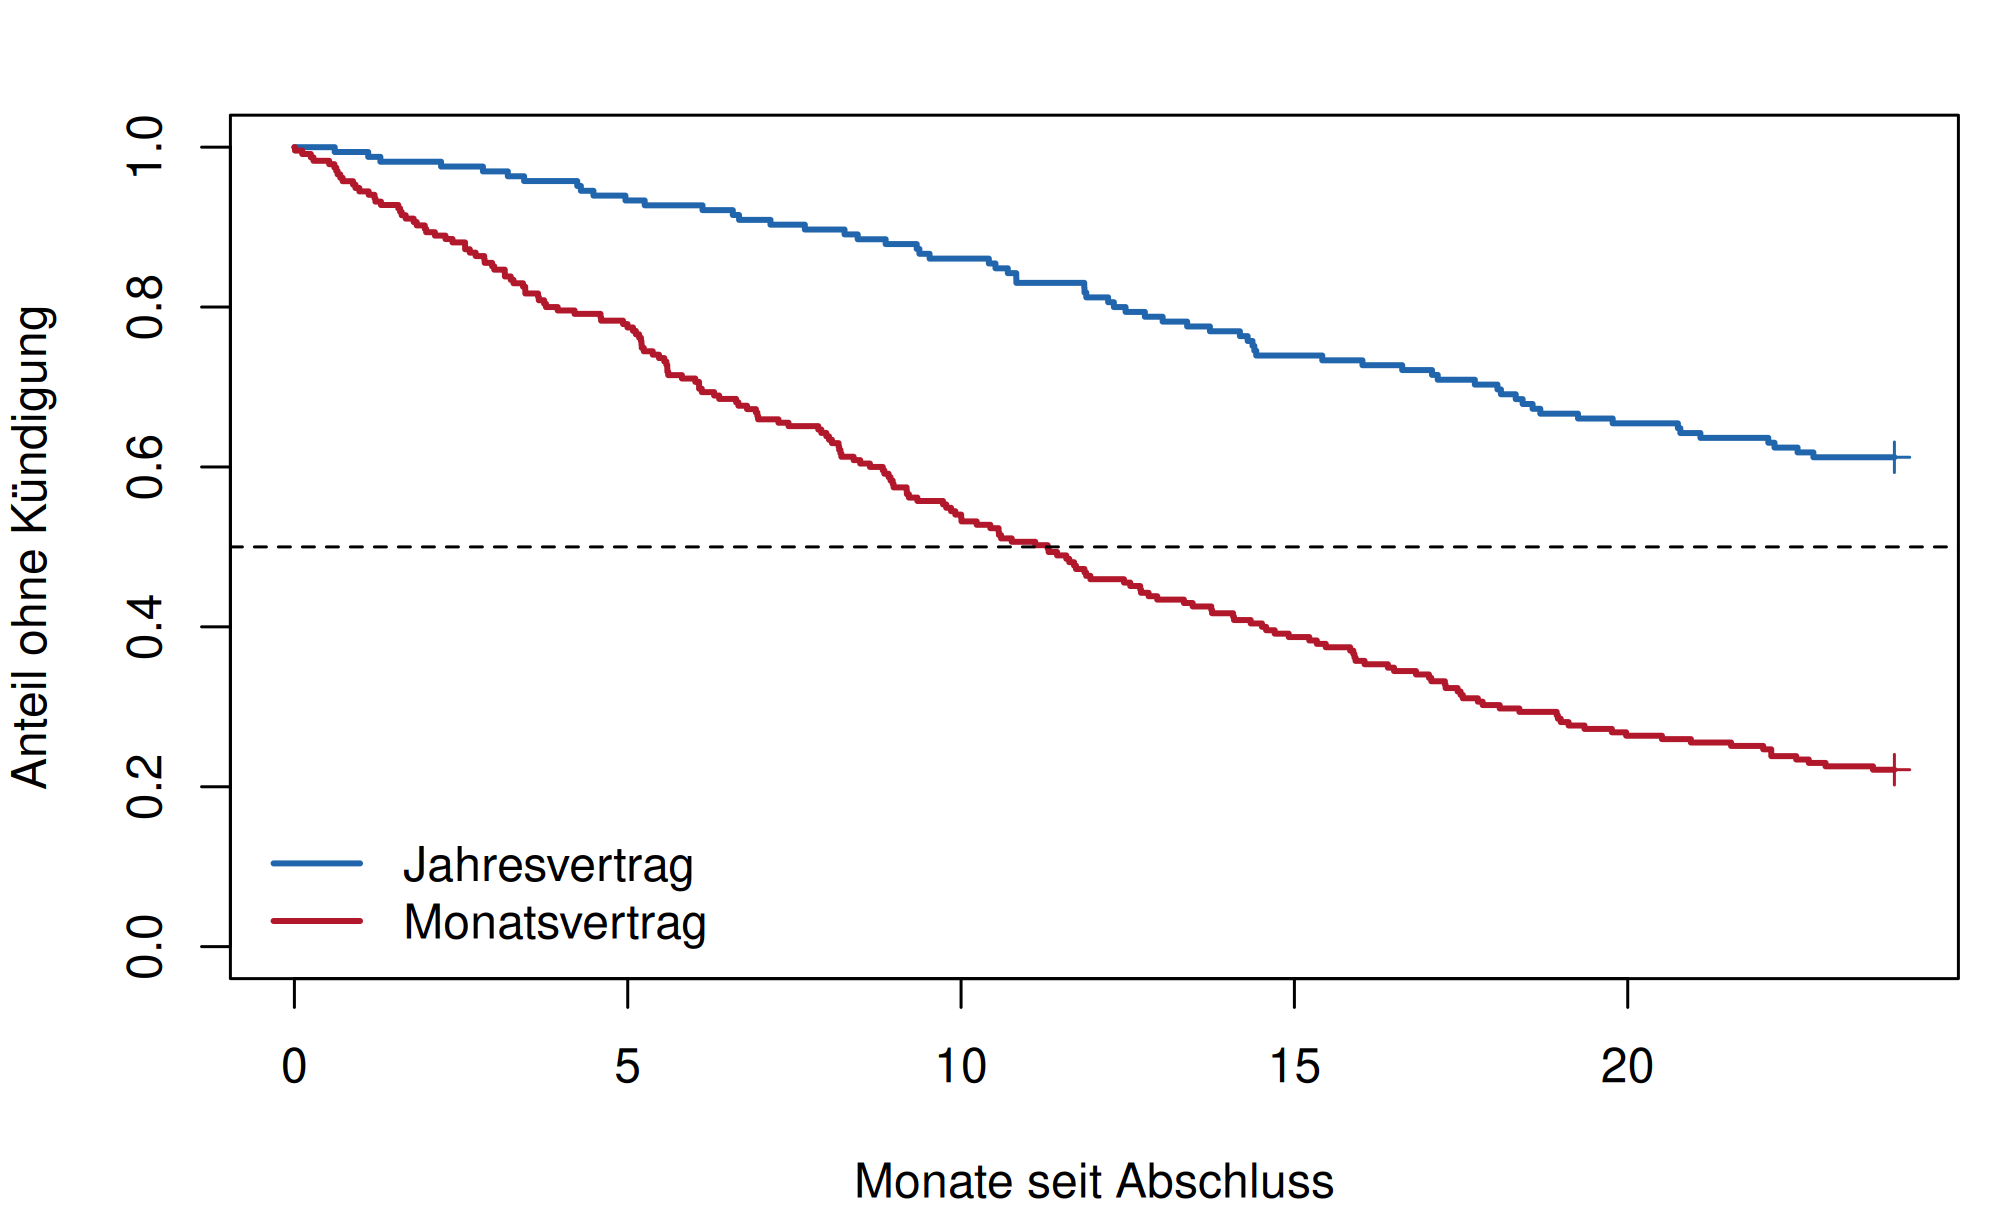
Getrennte Kurven für Monats- und Jahresverträge. Die Frage: Wie gross ist der Unterschied, und was darf man aus zwei getrennten Kurven schliessen?
kurve_gruppen <-survfit(Surv(zeit, status) ~ vertrag, data = abo)kurve_gruppen
Call: survfit(formula = Surv(zeit, status) ~ vertrag, data = abo)

                n events median 0.95LCL 0.95UCL
vertrag=Jahr  165     64     NA      NA      NA
vertrag=Monat 235    183   11.3    9.34    13.3
summary(kurve_gruppen, times =c(12, 24))
Call: survfit(formula = Surv(zeit, status) ~ vertrag, data = abo)

                vertrag=Jahr
 time n.risk n.event survival std.err lower 95% CI upper 95% CI
   12    134      31    0.812  0.0304        0.755        0.874
   24    101      33    0.612  0.0379        0.542        0.691

                vertrag=Monat
 time n.risk n.event survival std.err lower 95% CI upper 95% CI
   12    108     127    0.460  0.0325        0.400        0.528
   24     52      56    0.221  0.0271        0.174        0.281
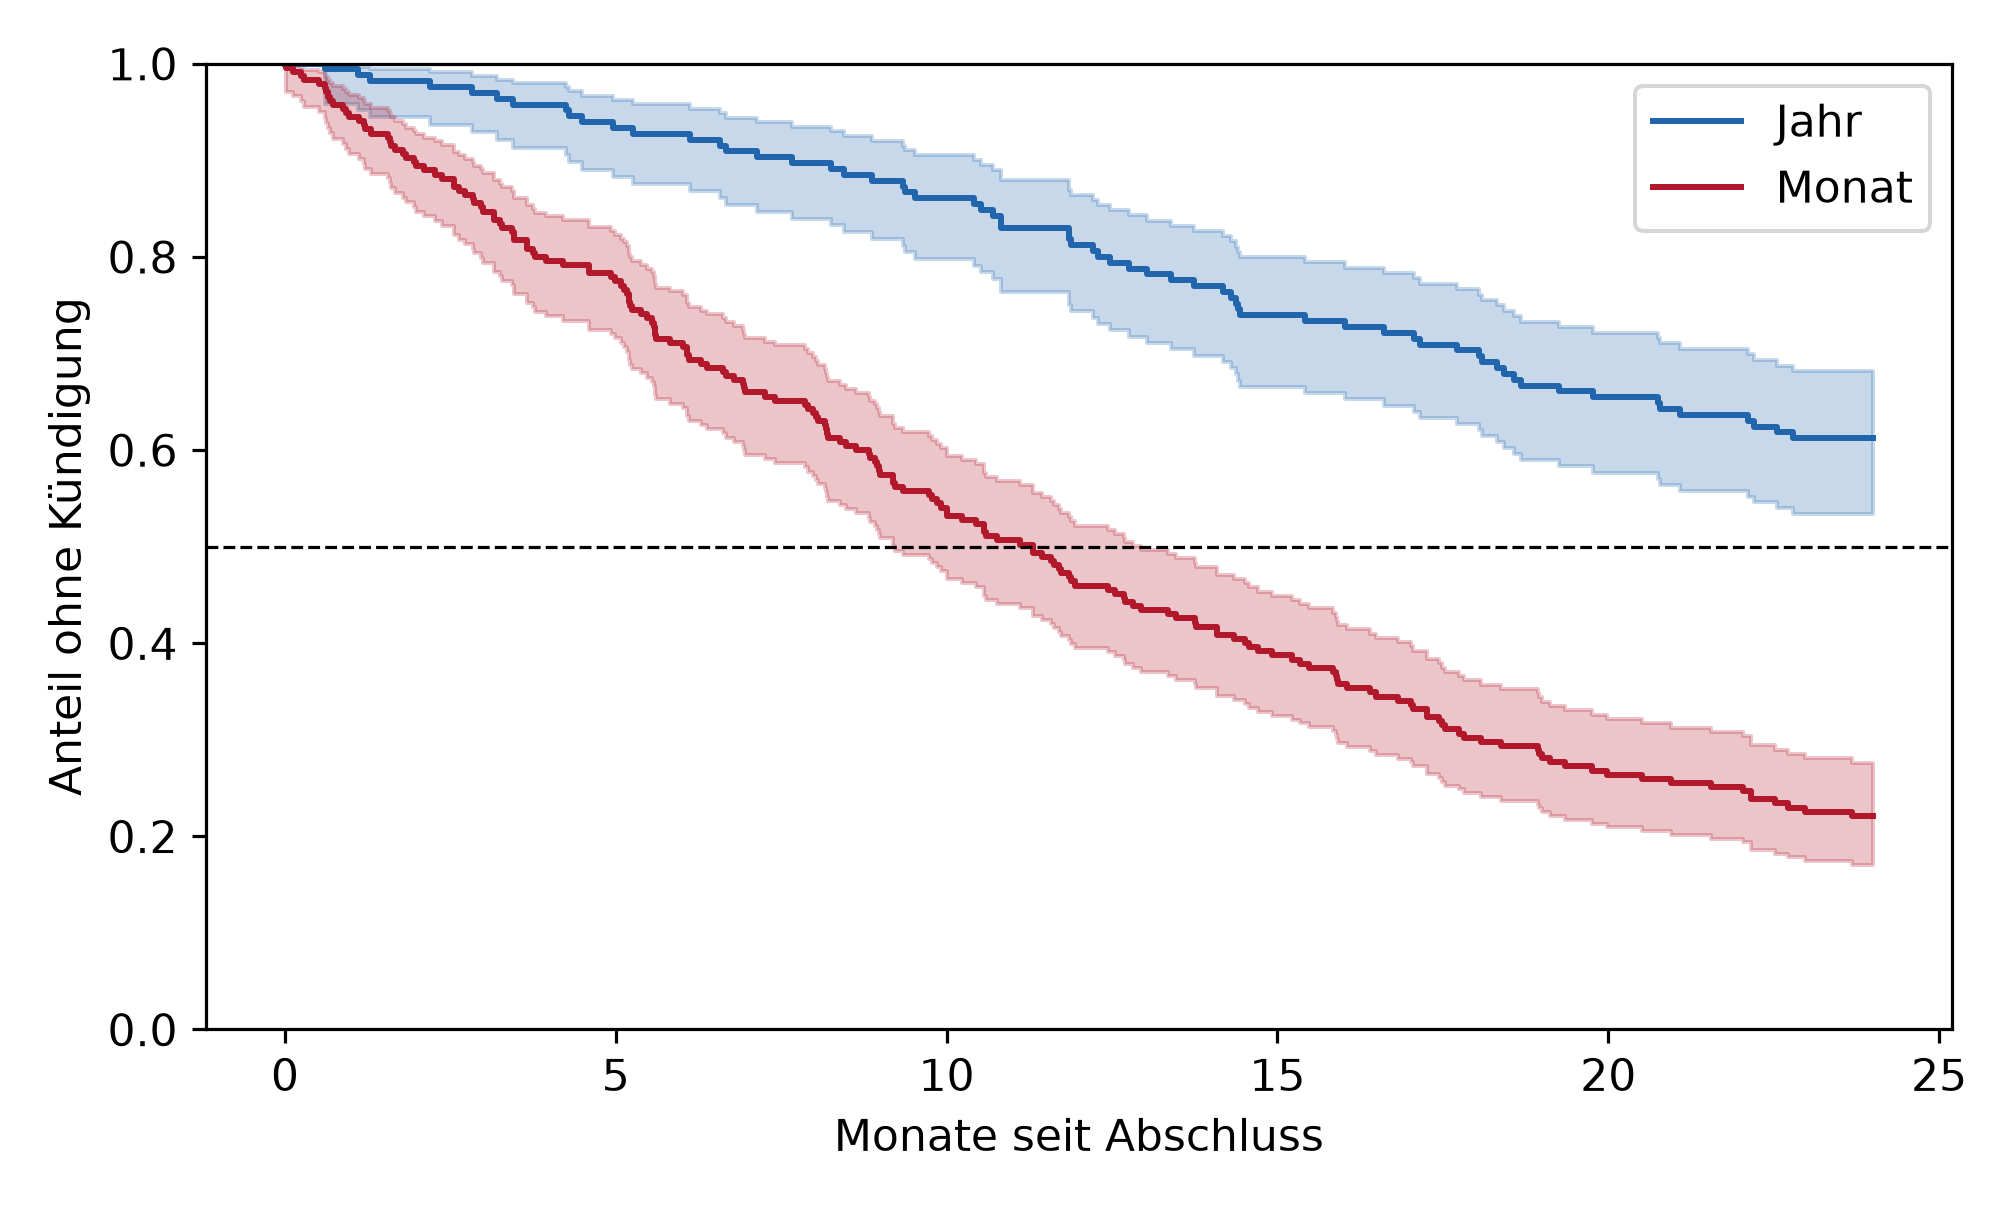
Abbildung 4: Beispiel 4: dieselben Gruppen mit lifelines.
Output Zeile für Zeile
Gruppe
n
Ereignisse
Median
\(\hat{S}(12)\)
\(\hat{S}(24)\)
Jahresvertrag
165
64 (39 %)
nicht erreicht
0.812
0.612
Monatsvertrag
235
183 (78 %)
11.30 Monate
0.460
0.221
Ausgabe
Wie sie zu lesen ist
Der Median der Jahresverträge fehlt
R gibt NA aus, Python inf. Beides heisst dasselbe: Die Kurve fällt im Beobachtungszeitraum nie unter 0.5, bei 24 Monaten steht sie noch bei 0.612. Ein Vergleich “11.3 gegen NA” ist deshalb nicht möglich; verglichen werden die Anteile zu festen Zeitpunkten.
\(\hat{S}(12)\): 0.812 gegen 0.460
Nach einem Jahr bestehen von den Jahresverträgen noch gut vier Fünftel, von den Monatsverträgen weniger als die Hälfte. Das ist die berichtbare Zahl.
\(\hat{S}(24)\): 0.612 gegen 0.221
Der Abstand bleibt bestehen und wächst sogar. Die Kurven laufen nicht wieder zusammen.
Ereignisanteile 39 gegen 78 Prozent
Dieselbe Aussage roh gezählt, allerdings ohne Berücksichtigung der Zeit; deshalb ist sie nur eine grobe Ergänzung, keine Alternative zur Kurve.
Drei Dinge, die dieses Bild nicht zeigt:
Ob der Unterschied statistisch gesichert ist. Der optische Abstand ist kein Nachweis; dafür ist der Log-Rank-Test zuständig.
Ob die Vertragsart die Ursache ist. Wer einen Jahresvertrag wählt, hat sich womöglich ohnehin schon für längeres Training entschieden. Die Vertragsart könnte also Folge derselben Absicht sein, die auch das Bleiben erklärt.
Ob andere Merkmale den Unterschied erzeugen. Wohnen Jahresvertragskunden näher am Studio, misst der Vergleich teilweise die Distanz. Genau dafür gibt es das Cox-Modell.
Interpretation und Ergebnissatz
Abos mit Monatsvertrag haben eine deutlich kürzere Laufzeit als solche mit Jahresvertrag: Nach zwölf Monaten bestehen noch 46.0 gegenüber 81.2 Prozent, nach 24 Monaten 22.1 gegenüber 61.2 Prozent. Der Median liegt bei Monatsverträgen bei 11.3 Monaten und wurde bei Jahresverträgen im Beobachtungszeitraum nicht erreicht (n = 235 beziehungsweise 165, 183 beziehungsweise 64 Kündigungen).
Frage und Datenlage
Eine Teilgruppe mit geringem Risiko: Jahresverträge von Personen, die weniger als fünf Kilometer entfernt wohnen. Was tut man, wenn die Kurve die Hälfte nie erreicht?
band = km_treue.confidence_interval_survival_function_zeitpunkte = [6, 12, 18, 24]stuetzen = [band.index[band.index <= t][-1] for t in zeitpunkte]print(pd.DataFrame({"zeit": zeitpunkte,"n_risk": [int((treue["zeit"] >= t).sum()) for t in zeitpunkte],"S(t)": km_treue.survival_function_at_times(zeitpunkte).round(3).values,"unten": band.iloc[:, 0].loc[stuetzen].round(3).values,"oben": band.iloc[:, 1].loc[stuetzen].round(3).values,}).to_string(index=False))
Von 400 bleiben 60 übrig. Die Teilgruppe ist klein, das ist der Preis jeder Aufteilung.
Ereignisse
23
Nur 23 Kündigungen tragen die ganze Kurve.
Median
NA in R, inf in Python
Kein Fehler, sondern die korrekte Aussage: Mehr als die Hälfte war am Stichtag noch dabei. Die Kurve endet bei 0.617 und wird nie tiefer beobachtet.
unter Risiko bei Monat 6
55
unter Risiko bei Monat 24
37
Das Kurvenende beruht auf gut einem Drittel der Ausgangsgruppe.
\(\hat{S}(24)\)
0.617
Rund 62 Prozent bestehen nach zwei Jahren noch.
Was statt eines Medians berichtet wird: ein Anteil zu einem festen, vorher gewählten Zeitpunkt, samt Intervall und Anzahl unter Risiko. Ein “Median grösser als 24” wäre irreführend präzise; die Daten sagen nur, dass er ausserhalb des Beobachtungsfensters liegt.
Wo die Kurve abgeschnitten gehört: dort, wo die Anzahl unter Risiko unter etwa zehn fällt. Bei 37 ist das hier nicht der Fall, weshalb die ganze Kurve gezeigt werden darf, mit Risikozahlen darunter. Fehlen diese Zahlen, ist eine Kaplan-Meier-Kurve nicht beurteilbar, denn ein Absturz von 0.4 auf 0.2 sieht bei 100 Fällen unter Risiko genauso aus wie bei zweien.
Interpretation und Ergebnissatz
Für Jahresverträge von Personen mit weniger als fünf Kilometern Anfahrt (n = 60, 23 Kündigungen) ist der Median im Beobachtungszeitraum nicht erreicht. Nach 24 Monaten bestehen noch 61.7 Prozent der Abos (37 unter Risiko).
Verständnisfragen
Eine Beobachtung wird nach fünf Monaten zensiert. Was macht der Kaplan-Meier-Schätzer damit?
Sie zählt bis Monat 5 mit und verschwindet danach aus der Anzahl unter Risiko
Richtig. Die Kurve fällt an dieser Stelle nicht, weil kein Ereignis vorliegt; der Nenner der späteren Faktoren wird aber kleiner. Genau so fliesst die Information “hat mindestens 5 überlebt” vollständig ein.
Sie wird als Ereignis nach fünf Monaten gezählt
Das würde die Laufzeit systematisch unterschätzen.
Sie wird aus der Analyse entfernt
Das würde die langen Verläufe entfernen und ebenfalls verzerren.
Der Median wird als NA beziehungsweise inf ausgegeben. Was heisst das?
Die Kurve fällt im Beobachtungszeitraum nie unter 0.5
Richtig. Mehr als die Hälfte hatte am Stichtag noch kein Ereignis. Berichtet wird dann ein Anteil zu einem festen Zeitpunkt, nicht ein “Median grösser als 24”.
Es liegt ein Rechenfehler vor
Es ist die korrekte Ausgabe für diesen Fall.
Zu viele Werte sind zensiert
Auch bei wenig Zensierung kann das auftreten, wenn das Risiko einfach niedrig ist.
\(\hat{S}(12) = 0.605\). Welche Aussage ist richtig?
Geschätzte 60.5 Prozent der Population haben nach zwölf Monaten noch kein Ereignis
Richtig. Es ist eine Aussage über die Population, aus der die Stichprobe stammt, mit dem angegebenen Konfidenzintervall.
60.5 Prozent der Beobachtungen sind noch unter Risiko
Das wäre die Spalte n.risk, und sie unterscheidet sich, weil auch Zensierungen die Anzahl unter Risiko senken.
Ein einzelnes Abo besteht mit 60.5 Prozent Wahrscheinlichkeit noch
Nur dann, wenn dieses Abo wie ein zufällig gezogenes aus derselben Population ist, was es meist nicht ist, weil man mehr über es weiss.
Zwei Kaplan-Meier-Kurven verlaufen deutlich getrennt. Was folgt daraus?
Ein beschreibender Unterschied, mehr nicht
Richtig. Ob er statistisch gesichert ist, klärt der Log-Rank-Test; ob er auf die Gruppenvariable zurückgeht oder auf andere Merkmale, klärt ein Cox-Modell.
Die Gruppenvariable verursacht den Unterschied
Aus getrennten Kurven folgt keine Ursache; die Gruppen können sich in vielem unterscheiden.
Der Unterschied ist signifikant
Der optische Abstand ist kein Test. Bei kleinen Gruppen können sich Kurven deutlich trennen, ohne dass ein Test etwas findet.
Warum gehört zu jeder Kaplan-Meier-Kurve die Anzahl unter Risiko?
Weil ein Kurvenabschnitt ohne sie nicht beurteilbar ist
Richtig. Ein Absturz von 0.4 auf 0.2 sieht bei 100 Fällen unter Risiko genauso aus wie bei zweien, bedeutet aber etwas völlig anderes. Das Konfidenzband zeigt dasselbe, wird aber leichter überlesen.
Weil sie die Anzahl der Ereignisse angibt
Sie sinkt sowohl durch Ereignisse als auch durch Zensierungen.
Weil sie zur Berechnung des Medians nötig ist
Der Median folgt aus der Kurve, nicht aus der Risikotabelle.