Typische Fragestellungen: Welche Dimensionen misst ein Fragebogen wirklich, lassen sich zwanzig Items zu drei Skalen zusammenfassen, misst eine Skala das, was sie messen soll.
Der Unterschied zur Hauptkomponentenanalyse ist nicht rechnerischer Feinschliff, sondern die Denkrichtung. Die Hauptkomponentenanalyse fasst beobachtete Variablen zusammen: Die Komponente ist eine Summe der Items. Die Faktorenanalyse unterstellt das Gegenteil: Es gibt nicht beobachtbare Grössen, und die Items sind deren Ausprägungen plus Eigenanteil. Wer nach Ursachen fragt, braucht die Faktorenanalyse; wer nur verdichten will, die Komponentenanalyse.
Ladung: wie stark Faktor \(k\) auf Item \(j\) wirkt
\(e_j\)
Eigenanteil des Items, alles Nichtgemeinsame samt Messfehler
Kommunalität
Anteil der Varianz von \(x_j\), den die Faktoren erklären, also die Summe der quadrierten Ladungen
Uniqueness
eins minus Kommunalität, der Eigenanteil
Der Unterschied zur Komponentenanalyse steckt genau in \(e_j\): Die Faktorenanalyse modelliert nur die gemeinsame Varianz und lässt den Eigenanteil ausdrücklich draussen. Deshalb sind ihre Ladungen in der Regel etwas kleiner, und deshalb ist sie das richtige Werkzeug, wenn Messfehler eine Rolle spielt.
Rotation löst ein Problem der Deutbarkeit: Die Lage der Faktoren im Raum ist nicht eindeutig bestimmt, man kann sie drehen, ohne die Anpassung zu ändern. Gedreht wird auf Einfachstruktur, also darauf, dass jedes Item möglichst nur auf einem Faktor hoch lädt. Orthogonale Rotation, etwa Varimax, hält die Faktoren unkorreliert; oblique Rotation, etwa Oblimin, erlaubt Korrelation zwischen ihnen. Bei inhaltlich verwandten Dimensionen ist oblique die realistischere Annahme.
Reihenfolge und Vorzeichen der Faktoren sind beliebig. Welcher Faktor als erster ausgegeben wird und ob seine Ladungen positiv oder negativ sind, ist eine Eigenschaft des Rechenverfahrens, keine des Fragebogens. Ein Faktor wird deshalb nie über seine Nummer benannt, sondern über die Items, die auf ihm laden.
Voraussetzungen und ihre Prüfung
Voraussetzung
Was sie bedeutet
Prüfung
Folge bei Verletzung
Vorgehen
Genügend Korrelation
Die Items hängen zusammen
Korrelationsmatrix, Bartlett-Test, KMO-Kriterium
Keine gemeinsamen Faktoren auffindbar
Items überarbeiten, Analyse abbrechen
Genügend Beobachtungen
Faustregel: mindestens fünf bis zehn je Item, nie unter 100
n zählen
Ladungen instabil, Struktur nicht reproduzierbar
mehr Daten, weniger Items
Genügend Items je Faktor
mindestens drei, besser vier
Struktur planen
Faktor nicht identifizierbar
Items ergänzen oder Faktoren zusammenlegen
Metrisch oder annähernd metrisch
Korrelationen sind sinnvoll interpretierbar
Skalenniveau, Verteilung der Items
Ladungen verzerrt
polychorische Korrelationen
Lineare Zusammenhänge
Ladungen beschreiben lineare Wirkung
Streudiagramme
Struktur wird verfehlt
Transformation
Keine extremen Ausreisser
Korrelationen nicht von Einzelfällen getrieben
Ausreisserdiagnostik
Faktoren richten sich auf Ausreisser aus
Ursachen prüfen
Output lesen
R, psych::fa():
Grösse
Was sie sagt
Faustregel oder Falle
loadings
Ladung je Item und Faktor nach Rotation
ab etwa 0.4 als bedeutsam, ab 0.3 erwähnenswert
communality
Anteil der Itemvarianz, den die Faktoren erklären
unter 0.3 heisst: Item passt nicht zur Struktur
uniquenesses
Eigenanteil, eins minus Kommunalität
hoch bei Items, die etwas Eigenes messen
SS loadings
Summe der quadrierten Ladungen je Faktor
Beitrag des Faktors, in Varianzeinheiten
Proportion Var
Anteil der Gesamtvarianz je Faktor
summiert über Faktoren die gemeinsame Varianz
Cor of factors
Korrelation zwischen den Faktoren
nur bei obliquer Rotation vorhanden
Mean item complexity
wie viele Faktoren ein Item durchschnittlich braucht
nahe 1 heisst gute Einfachstruktur
RMSEA, TLI, BIC
Anpassungsmasse
RMSEA unter 0.06 gilt als gut, aber vor allem bei bestätigenden Modellen aussagekräftig
Warnung Heywood case
eine Kommunalität über eins
Modell überparametrisiert; Faktorenzahl reduzieren
Python, FactorAnalyzer:
Zugriff
Was er liefert
Unterschied zu R
loadings_
Ladungsmatrix nach Rotation
Zeilen sind Items, wie in R
get_communalities()
Kommunalitäten
wie communality
get_factor_variance()
Summe der Ladungen, Anteil, kumuliert
in R Teil der Ausgabe von print
get_uniquenesses()
Eigenanteile
wie uniquenesses
phi_
Faktorkorrelationen bei obliquer Rotation
wie Cor of factors
keine Anpassungsmasse
RMSEA und Ähnliches fehlen
in R vorhanden
kein Abschneiden der Anzeige
Filterung selbst vornehmen
in R über cutoff =
Ein Unterschied in der Vorgabe: R verwendet in fa() standardmässig Oblimin, Python ohne Angabe keine Rotation. Ohne Rotation ist die Ladungsmatrix fast immer unlesbar, deshalb gehört sie ausdrücklich gesetzt.
Interpretationsfallen
Faktoren sind keine gemessenen Grössen. Sie sind Modellkonstrukte, deren Deutung von den Items kommt und nicht von der Rechnung.
Faktorenanalyse ist keine Komponentenanalyse. Die eine modelliert gemeinsame Varianz und Messfehler, die andere verdichtet beobachtete Varianz. Wer Ladungen der einen mit Komponenten der anderen vergleicht, vergleicht Verschiedenes.
Erklärte Varianz taugt nicht zur Faktorenwahl. Sie steigt mit jedem Faktor; entscheidend sind Screeplot, Parallelanalyse und Deutbarkeit.
Rotation ändert die Anpassung nicht. Sie verbessert nur die Lesbarkeit. Wer verschiedene Rotationen ausprobiert, bis eine These bestätigt ist, betreibt keine Analyse.
Ladungsschwellen sind Konvention. 0.3 oder 0.4 sind Faustregeln, keine Grenzen mit statistischer Bedeutung.
Ein Heywood-Fall ist ein Warnsignal, keine Formalie: Eine Kommunalität über eins ist unmöglich und heisst, dass das Modell zu gross ist.
Explorativ ist nicht bestätigend. Wer eine Struktur an denselben Daten findet und dort prüft, prüft nichts. Bestätigung braucht neue Daten und ein konfirmatorisches Modell.
Ergebnis berichten
Vorlage für den Ergebnissatz:
Eine explorative Faktorenanalyse ([Schätzmethode], [Rotation], n = [n], KMO = [Wert], Bartlett p = [p]) ergibt [Anzahl] Faktoren, die zusammen [Anteil] der Varianz erklären. Faktor 1 lädt hoch auf [Items] und wird als [Deutung] gelesen, Faktor 2 auf [Items] als [Deutung]. Die Faktoren korrelieren mit [Wert]. Item [Name] wurde wegen einer Kommunalität von [Wert] nicht berücksichtigt.
Genannt werden: Schätzmethode und Rotation, n, Eignungsmasse, Kriterium für die Faktorenzahl, die Ladungsmatrix mit Schwelle, Kommunalitäten, erklärte Varianz, Faktorkorrelationen und die inhaltliche Deutung jedes Faktors.
binäre oder stark abgestufte Items, Fähigkeitsmessung
Beispiele
Alle vier Beispiele arbeiten mit demselben konstruierten Datensatz: 400 Befragte, neun Items eines Zufriedenheitsfragebogens. Vier Items entstehen aus einem gemeinsamen Faktor Betreuung, vier aus einem Faktor Anlage, und ein Item zum Parkplatz misst etwas Eigenes. Weil die Wahrheit hier bekannt ist, lässt sich prüfen, ob das Verfahren sie findet.
Bevor Faktoren geschätzt werden, ist zu klären, ob die Korrelationsmatrix überhaupt gemeinsame Struktur enthält. Ohne Korrelationen gibt es nichts zusammenzufassen, und das Verfahren liefert trotzdem eine Lösung.
chi2, p = calculate_bartlett_sphericity(fragebogen)print(f"Bartlett: chi2 = {chi2:.1f}, p = {p:.3g}")
Bartlett: chi2 = 1600.9, p = 0
Output Zeile für Zeile
Ausgabe
Wert hier
Wie er zu lesen ist
Korrelationsmatrix
zwei Blöcke um 0.6 bis 0.7, sonst nahe null
Die vier Betreuungsitems korrelieren untereinander, die vier Anlageitems untereinander, quer darüber praktisch nicht. Genau diese Blockstruktur ist das, was die Faktorenanalyse in Faktoren übersetzt.
Parkplatz-Zeile
alle Werte unter 0.1
Das Item hängt mit keinem anderen zusammen.
KMO gesamt
0.824
Über 0.8 gilt als gut. Das Mass fragt, wie stark die Korrelation zweier Items durch die übrigen erklärt wird; hohe Werte heissen, dass gemeinsame Struktur vorliegt.
KMO je Item
acht Items zwischen 0.806 und 0.849, parkplatz bei 0.382
Unter 0.5 gilt als unbrauchbar. Das Item fällt schon hier auf, bevor überhaupt ein Faktor geschätzt ist.
Bartlett \(\chi^2\)
rund 1601 bei 36 Freiheitsgraden
Prüft die Nullhypothese, die Korrelationsmatrix sei die Einheitsmatrix.
Bartlett p
praktisch null
Die Matrix weicht von der Einheitsmatrix ab.
Beide Kennzahlen sind Eingangsprüfungen. Sie sagen, ob man anfangen darf, nicht ob das Ergebnis gut wird. Der Bartlett-Test ist dabei der schwächere von beiden: Bei n = 400 wird er praktisch immer signifikant, auch bei schwachen Korrelationen. Aussagekräftig ist vor allem, wenn er nichtsignifikant wird, denn dann ist die Analyse sinnlos.
Interpretation und Ergebnissatz
Die Korrelationsmatrix eignet sich für eine Faktorenanalyse (KMO = 0.82, Bartlett-Test auf Sphärizität \(\chi^2\)(36) = 1601, p < .001, n = 400).
Frage und Datenlage
Zwei Faktoren werden geschätzt und oblique rotiert. Die Frage: Findet das Verfahren die Struktur, die den Daten zugrunde liegt?
Die Ladungsmatrix (die Ladungen unter 0.3 sind in der Anzeige ausgeblendet, das ist eine Darstellungsentscheidung). R und Python stimmen in den Ladungen auf drei Stellen überein; die Kommunalitäten weichen um wenige Tausendstel ab, weil psych::fa() sie bei obliquer Rotation aus der Modellstruktur bestimmt und nicht als Summe der quadrierten Musterladungen. Angegeben sind die Python-Werte:
Item
Faktor mit den Betreuungsitems
Faktor mit den Anlageitems
Kommunalität
freundlich
0.833
0.003
0.693
beratung
0.834
-0.040
0.697
erreichbar
0.802
0.053
0.646
hilfsbereit
0.790
-0.013
0.625
geraete
0.004
0.795
0.632
sauberkeit
0.025
0.819
0.672
garderobe
0.000
0.752
0.566
platzangebot
-0.038
0.749
0.563
parkplatz
0.052
0.004
0.003
Grösse
Wert hier
Bedeutung
Ladung, etwa 0.833
Zusammenhang von Item und Faktor
Bei standardisierten Items ist sie die Korrelation zwischen Item und Faktor. Quadriert ergibt sie den erklärten Varianzanteil: \(0.833^2 \approx 0.69\).
Nebenladungen
alle unter 0.06
Einfachstruktur: Jedes Item lädt auf genau einem Faktor. Das ist der Idealfall, den die Rotation anstrebt.
Kommunalität
0.56 bis 0.70
Der von beiden Faktoren erklärte Varianzanteil eines Items. Hier ist es die quadrierte Hauptladung, weil die Nebenladung fast null ist.
Eigenanteil
eins minus Kommunalität
Bei freundlich bleiben 0.307 unerklärt: Messfehler plus alles, was nur dieses Item misst.
SS loadings
2.661 und 2.435
Summe der quadrierten Ladungen je Faktor, also sein Beitrag in Varianzeinheiten. Bei neun Items entspricht die Gesamtvarianz dem Wert 9.
Anteil
0.296 und 0.271
2.661 / 9 = 0.296. Zusammen erklären die beiden Faktoren 56.6 Prozent der Gesamtvarianz.
Faktorkorrelation
-0.099
Bei obliquer Rotation Teil des Ergebnisses. Nahe null heisst: Die beiden Dimensionen sind unabhängig, eine orthogonale Rotation hätte hier genauso gut gepasst.
Das Vorzeichen der Faktorkorrelation ist so wenig aussagekräftig wie das Vorzeichen einer Ladungsspalte: Kehrt man einen Faktor um, kehrt sich auch die Korrelation um. Interessant ist allein ihr Betrag.
Interpretation und Ergebnissatz
Die Rechnung hat die eingebaute Struktur gefunden. Die Deutung kommt aber nicht aus der Rechnung, sondern aus den Items: Der eine Faktor bündelt freundlich, beratung, erreichbar und hilfsbereit und lässt sich als Zufriedenheit mit der Betreuung lesen; der andere bündelt geraete, sauberkeit, garderobe und platzangebot und steht für die Zufriedenheit mit der Anlage.
Ein Faktor ohne inhaltliche Beschreibung ist kein Ergebnis, sondern eine Zahlenspalte.
Eine explorative Faktorenanalyse (Maximum-Likelihood-Schätzung, Oblimin-Rotation, n = 400, KMO = 0.82) ergibt zwei Faktoren, die zusammen 56.6 Prozent der Varianz erklären. Der erste Faktor lädt hoch auf die vier Items zur Betreuung (Ladungen 0.79 bis 0.83) und wird als Zufriedenheit mit der Betreuung gelesen, der zweite auf die vier Items zur Anlage (0.75 bis 0.82) als Zufriedenheit mit der Anlage. Die Faktoren korrelieren zu -0.10.
Frage und Datenlage
Ein Fragebogen enthält fast immer Items, die nicht zur gefundenen Struktur gehören. Woran erkennt man sie, und was macht man mit ihnen?
# Was passiert, wenn das Item entfernt wird?ohne <-fa(fragebogen[, names(fragebogen) !="parkplatz"],nfactors =2, rotate ="oblimin", fm ="ml")round(ohne$Vaccounted["Proportion Var", ], 3)
ohne = FactorAnalyzer(n_factors=2, rotation="oblimin", method="ml") \ .fit(fragebogen.drop(columns="parkplatz"))print("Anteil je Faktor ohne parkplatz:", np.round(ohne.get_factor_variance()[1], 3).tolist())
Anteil je Faktor ohne parkplatz: [0.332, 0.304]
Output Zeile für Zeile
Ausgabe
Wert hier
Wie er zu lesen ist
Kommunalität parkplatz
0.003
Die beiden Faktoren erklären 0.3 Prozent seiner Varianz. Praktisch nichts.
nächsthöhere Kommunalität
0.563 (platzangebot)
Der Abstand ist der eigentliche Befund: Das Item fällt nicht knapp durch, es gehört gar nicht dazu.
Ladungen parkplatz
0.052 und 0.004
Weit unter jeder üblichen Schwelle von 0.3 oder 0.4.
Anteile ohne das Item
steigen gegenüber 0.296 / 0.271
Kein inhaltlicher Gewinn. Die Anteile beziehen sich auf acht statt neun Items, also auf eine kleinere Gesamtvarianz. Wer nach dem Entfernen eines Items eine höhere erklärte Varianz meldet, meldet einen Rechenartefakt.
Interpretation und Ergebnissatz
Das Item misst etwas Eigenes, das mit den beiden gefundenen Dimensionen nichts zu tun hat. Das ist ein Befund, kein Fehler, die Zufriedenheit mit dem Parkplatz kann für die Befragten durchaus wichtig sein, sie ist nur keine Ausprägung von Betreuung oder Anlage.
Drei Wege sind vertretbar, einer nicht:
Vorgehen
Wann angemessen
Item entfernen
Es trägt zur Fragestellung nichts bei.
Als Einzelfrage stehen lassen
Es ist inhaltlich wichtig, geht aber in keine Skala ein.
Weitere Items zum Thema ergänzen
Es gibt eine dritte Dimension, für die bisher nur ein Item vorliegt.
Einer bestehenden Skala zuschlagen
Nie. Die Skala misst danach etwas Vermischtes, und ihre Zuverlässigkeit sinkt.
Das Item zum Parkplatz lädt auf keinen der beiden Faktoren (Ladungen 0.05 und 0.00, Kommunalität 0.003) und geht in keine Skala ein.
Frage und Datenlage
Die Faktorenzahl ist die wichtigste Entscheidung der ganzen Analyse, und sie wird nicht von der Rechnung getroffen. Drei Kriterien werden verglichen, inklusive eines Falls, in dem das bekannteste davon in die Irre führt.
print("über dem Zufallsniveau:", int((eigenwerte > zufall.mean(axis=0)).sum()))
über dem Zufallsniveau: 2
Output Zeile für Zeile
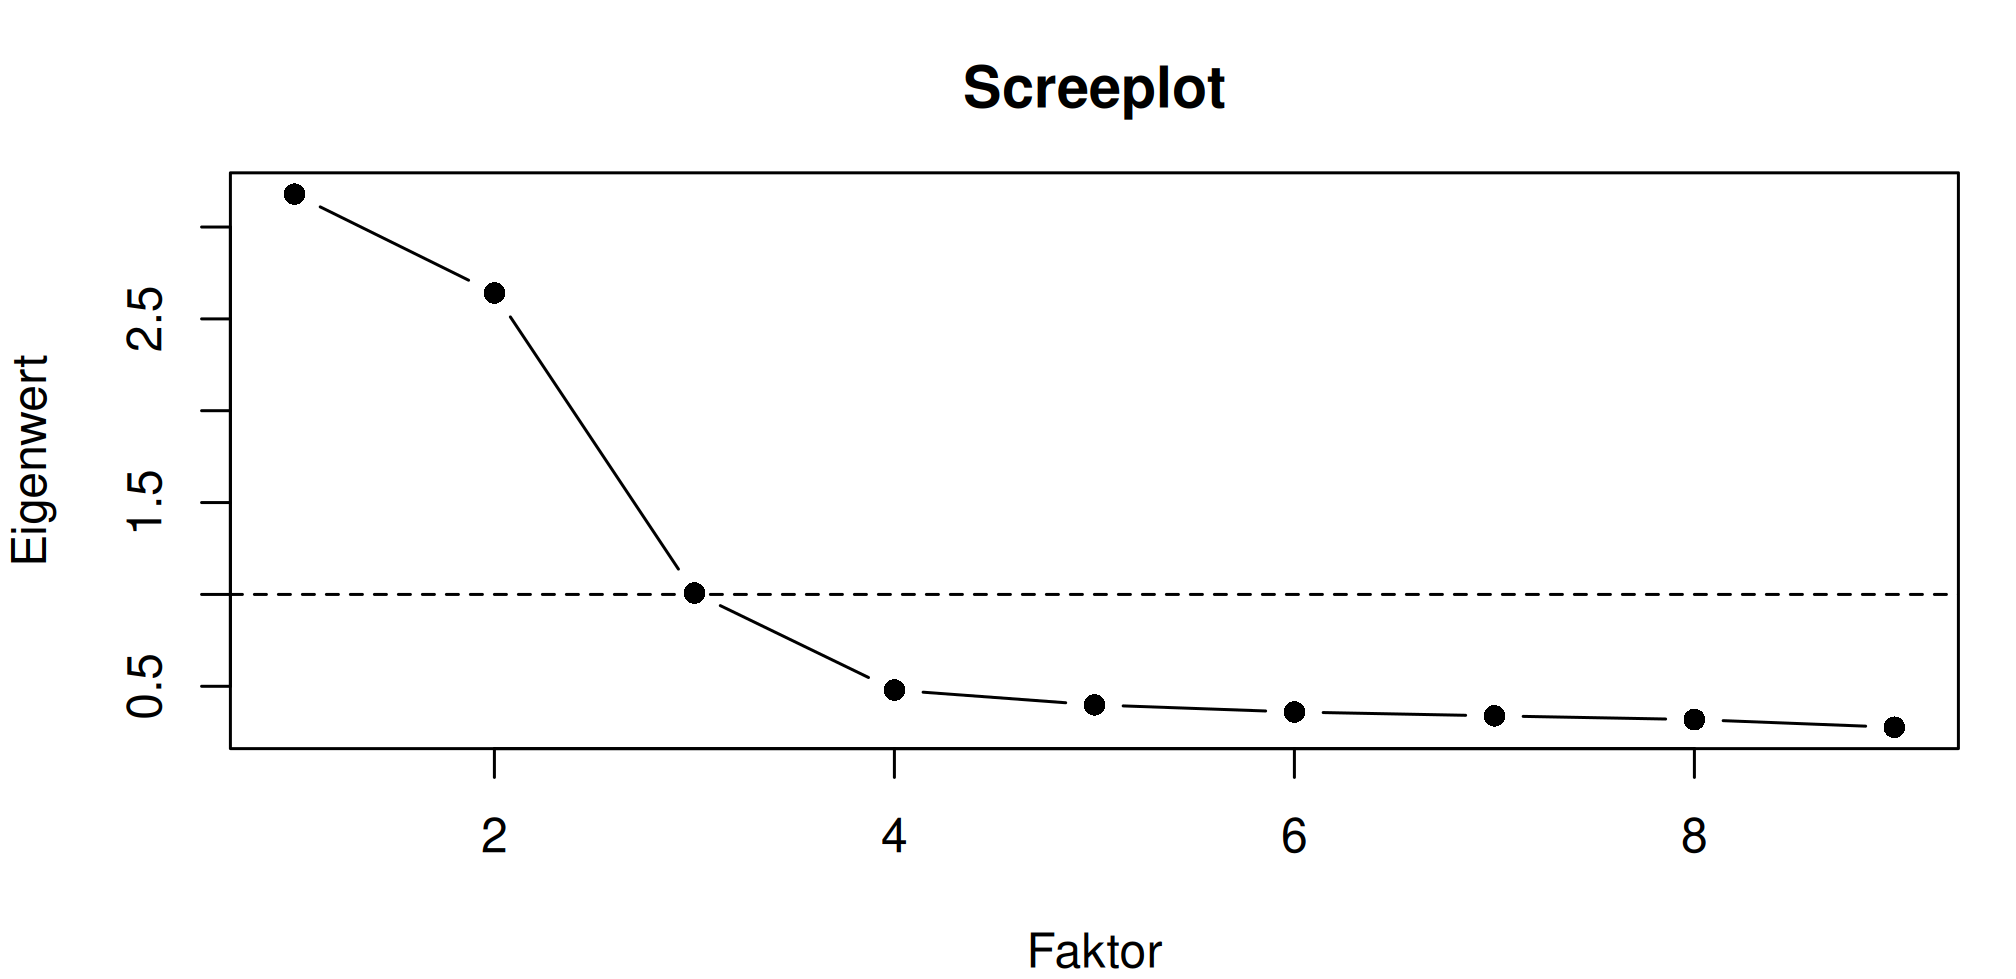
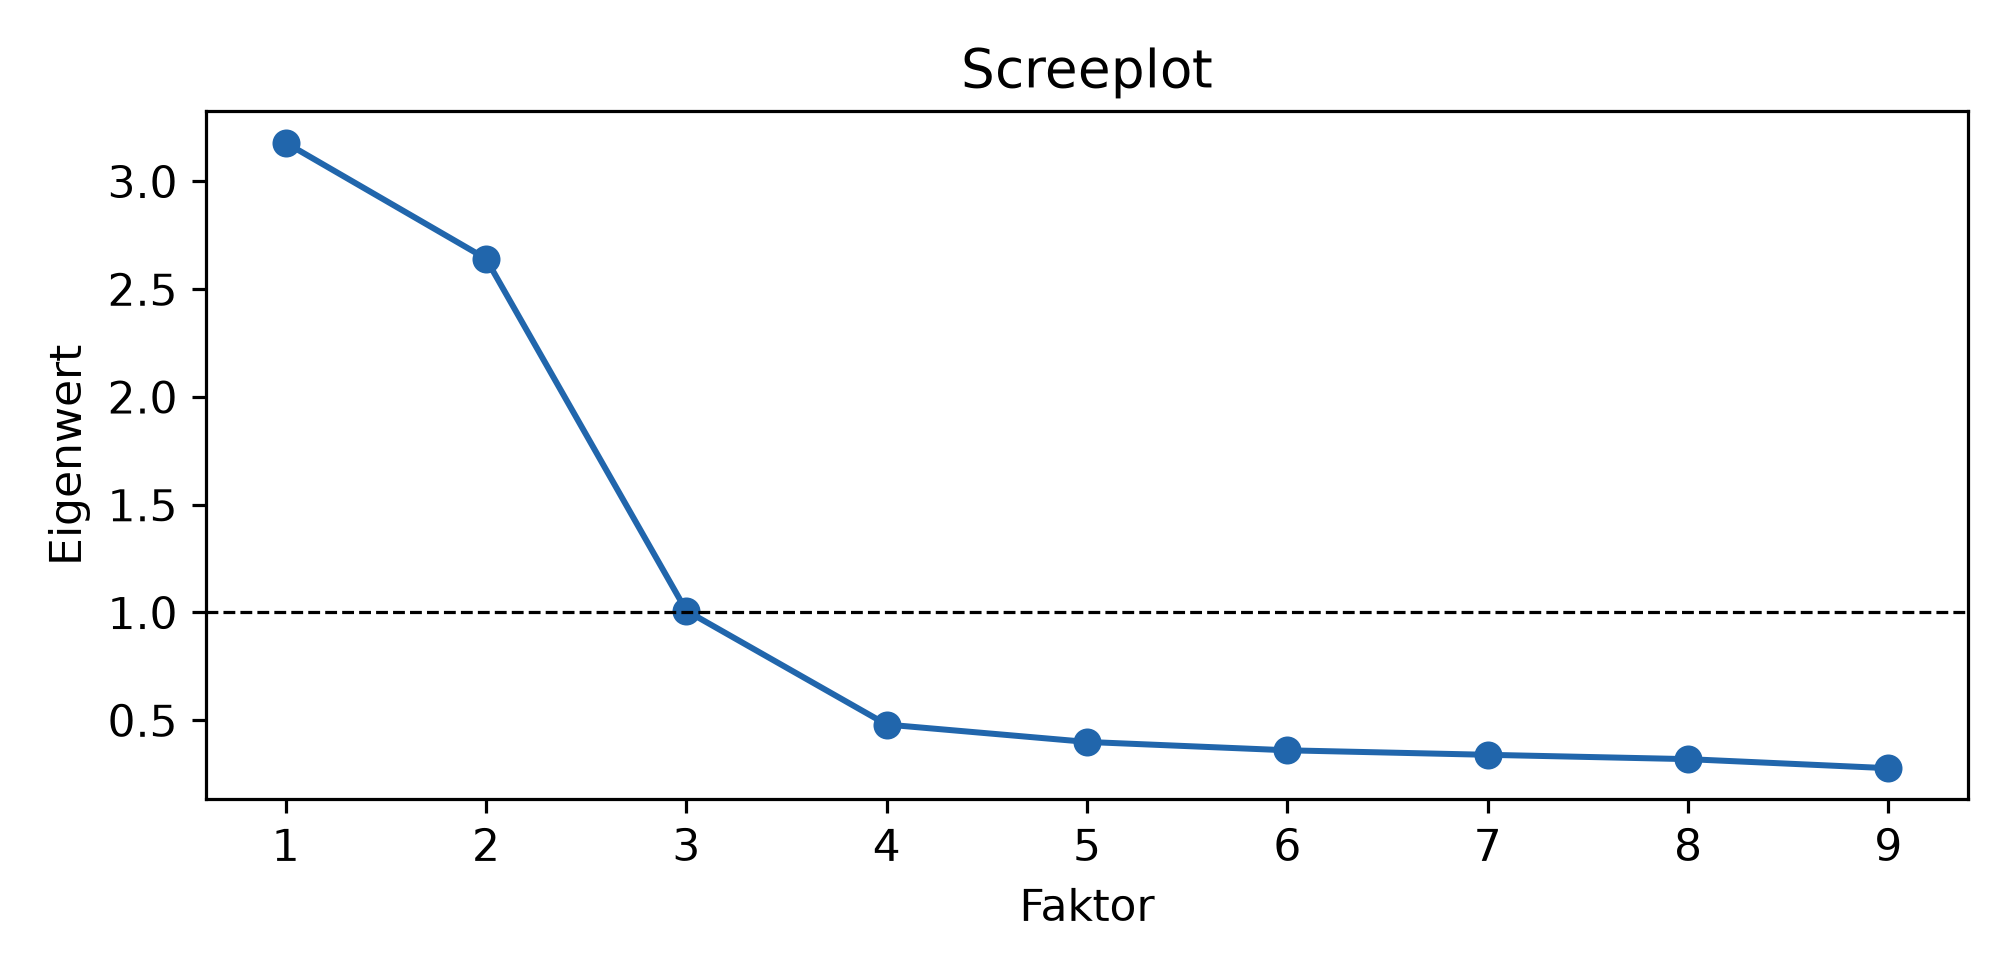
Die neun Eigenwerte der Korrelationsmatrix:
Rang
1
2
3
4
5
6
7
8
9
Eigenwert
3.179
2.641
1.007
0.479
0.399
0.360
0.339
0.319
0.277
Kriterium
Was es hier sagt
Bewertung
Kaiser (Eigenwert > 1)
3.179, 2.641 und 1.007 liegen über eins → drei Faktoren
Die Antwort ist falsch. Der dritte Eigenwert stammt vom Parkplatz-Item, das mit nichts korreliert: Ein völlig isoliertes Item hat immer einen Eigenwert nahe eins. Kaiser zählt es als Faktor, obwohl es nur eine Variable trägt.
Screeplot
Der Knick liegt nach dem zweiten Wert; von 2.641 auf 1.007 und dann auf 0.479
Zwei Faktoren. Der Knick ist deutlich, aber die Ablesung bleibt Augenmass.
Parallelanalyse
Zufallsdaten derselben Grösse liefern Eigenwerte um eins herum; nur die ersten beiden echten Werte liegen klar darüber
Zwei Faktoren, und dies ist die verlässlichste der drei Auskünfte.
Das Kaiser-Kriterium ist verbreitet und die schwächste der drei Regeln. Die Schwelle von eins bedeutet nur “der Faktor erklärt mehr als eine einzelne Variable” und genau diese Schwelle erreicht ein isoliertes Item von selbst, ohne irgendetwas zu bündeln. Die Parallelanalyse vergleicht dagegen mit dem, was reiner Zufall bei dieser Anzahl Items und Beobachtungen hervorbringt, und berücksichtigt damit die Grösse des Datensatzes.
Interpretation und Ergebnissatz
Die Faktorenzahl wurde über eine Parallelanalyse bestimmt (20 Ziehungen); zwei Faktoren liegen über dem Zufallsniveau. Das Kaiser-Kriterium legt drei Faktoren nahe, der dritte Eigenwert (1.007) stammt jedoch von einem Item ohne Korrelation zu den übrigen und trägt keinen deutbaren Faktor.
Frage und Datenlage
Wer der erklärten Varianz folgt, wählt zu viele Faktoren, denn sie steigt mit jedem zusätzlichen. Was dabei herauskommt, zeigt eine Lösung mit vier Faktoren auf denselben Daten.
print("Anteil je Faktor:",
      np.round(efa_viele.get_factor_variance()[1], 3).tolist())
Anteil je Faktor: [0.296, 0.173, 0.115, 0.023]
Output Zeile für Zeile
Die vier Ladungsspalten (Python-Werte):
Item
F1
F2
F3
F4
freundlich
0.845
0.078
-0.040
-0.097
beratung
0.830
-0.052
0.006
0.006
erreichbar
0.799
0.044
-0.041
0.100
hilfsbereit
0.787
-0.089
0.077
0.009
geraete
-0.008
0.611
0.098
0.338
sauberkeit
0.026
0.643
0.188
0.023
garderobe
-0.004
0.014
0.990
-0.009
platzangebot
-0.021
0.862
-0.026
-0.089
parkplatz
0.036
-0.102
-0.011
0.256
Anteil je Faktor: 0.296, 0.173, 0.115, 0.023 (R gibt 0.296, 0.186, 0.129, 0.031 aus, bei obliquer Rotation sind die Anteile nicht eindeutig definiert, weil sich die Faktoren überlappen dürfen).
Drei Warnzeichen, alle in diesen Zahlen sichtbar:
Zeichen
Beleg hier
Faktoren mit zu wenig Items
F3 wird von einem einzigen Item getragen (garderobe, 0.990), F4 von keinem einzigen mit einer Ladung über 0.4. Ein Faktor braucht mindestens drei tragende Items.
Winzige Varianzanteile
F4 erklärt 2 bis 3 Prozent. Der Zuwachs an erklärter Varianz ist nicht null, aber bedeutungslos.
Die klare Struktur zerfällt
Der Anlage-Faktor ist auf F2, F3 und F4 verteilt: garderobe ist herausgebrochen, geraete lädt zusätzlich mit 0.338 auf F4. In der Zweifaktorenlösung lagen alle vier sauber beieinander.
Eine Ladung von 0.990 bei einer Kommunalität nahe eins ist zudem die Vorstufe eines Heywood-Falls: Steigt die geschätzte Kommunalität über eins, ist sie inhaltlich unmöglich, und die Software warnt. R meldet das als Heywood case; psych::fa() gibt in solchen Lagen zusätzlich Hinweise auf eine “ultra-Heywood”-Lösung aus.
Interpretation und Ergebnissatz
Die Faktorenzahl wird nicht nach der erklärten Varianz gewählt. Herangezogen werden Parallelanalyse, Screeplot, die inhaltliche Deutbarkeit und die Forderung, dass jeder Faktor mindestens drei Items mit bedeutsamer Ladung trägt. Alle vier sprechen hier für zwei Faktoren.
Eine Lösung mit vier Faktoren erklärt zusammen rund 61 statt 57 Prozent der Varianz, erzeugt dabei aber zwei Faktoren mit weniger als drei tragenden Items und eine Ladung von 0.99 als Vorstufe eines Heywood-Falls. Berichtet wird die Zweifaktorenlösung.
Verständnisfragen
Wann ist die Faktorenanalyse der Hauptkomponentenanalyse vorzuziehen?
Wenn dahinterliegende, nicht beobachtbare Grössen unterstellt werden
Richtig. Die Faktorenanalyse modelliert gemeinsame Varianz und trennt den Eigenanteil ab, was bei Fragebogenitems mit Messfehler der passende Ansatz ist. Wer nur verdichten will, nimmt Komponenten.
Wenn mehr als zehn Variablen vorliegen
Die Anzahl entscheidet nicht.
Wenn die Variablen unkorreliert sind
Dann funktioniert keines der beiden Verfahren.
Ein Item hat eine Kommunalität von 0.003. Was heisst das?
Die Faktoren erklären praktisch nichts von seiner Varianz; es passt nicht zur Struktur
Richtig. Das Item misst etwas Eigenes. Es wird entfernt oder als Einzelfrage geführt, aber keiner Skala zugeschlagen.
Das Item ist unzuverlässig gemessen
Möglich, aber die Kommunalität unterscheidet Messfehler nicht von inhaltlicher Eigenständigkeit.
Es lädt auf allen Faktoren gleich stark
Das wäre eine hohe Kommunalität bei schlechter Einfachstruktur.
Der dritte Eigenwert beträgt 1.007. Das Kaiser-Kriterium spricht damit für drei Faktoren. Was ist davon zu halten?
Wenig; der Wert stammt von einem Item, das mit keinem anderen korreliert
Richtig. Ein isoliertes Item erreicht einen Eigenwert nahe eins von selbst, ohne etwas zu bündeln. Die Parallelanalyse erkennt das und bleibt bei zwei Faktoren.
Drei Faktoren sind zu schätzen, das Kriterium ist eindeutig
Die Eindeutigkeit der Schwelle sagt nichts über ihre Eignung.
Der Wert ist ein Rechenfehler
Er ist korrekt, nur seine Deutung als Faktor ist falsch.
Die Vier-Faktoren-Lösung erklärt mehr Varianz als die Zwei-Faktoren-Lösung. Ist sie deshalb besser?
Ja, mehr erklärte Varianz ist besser
Sie steigt mit jedem zusätzlichen Faktor, ganz unabhängig davon, ob er etwas bedeutet.
Nein, entscheidend sind Deutbarkeit und tragende Items je Faktor
Richtig. Ein Faktor mit einem einzigen Item ist kein Faktor. Herangezogen werden Parallelanalyse, Screeplot und die inhaltliche Beschreibbarkeit.
Das entscheidet der Bartlett-Test
Der prüft nur, ob überhaupt Korrelationen vorliegen.
Was ändert eine oblique Rotation gegenüber einer orthogonalen?
Sie erlaubt Korrelation zwischen den Faktoren
Richtig. Bei inhaltlich verwandten Dimensionen ist das die realistischere Annahme, und die Faktorkorrelation wird Teil des Ergebnisses. Die Anpassung an die Daten ändert sich dadurch nicht.
Sie verbessert die Anpassung des Modells
Rotation ändert die Anpassung nicht, nur die Lesbarkeit.
Sie erzwingt Einfachstruktur
Sie strebt sie an, erzwingen kann sie keine Rotation.