Bedingte Wahrscheinlichkeit und Bayes

Wahrscheinlichkeit
Bayes
Interpretation
R
Python
Bedingung, Unabhängigkeit, Satz von Bayes und der Basisratenfehler.

Kernideen

  • Eine Bedingung verkleinert den Grundraum: Gefragt ist nicht der Anteil an allen Fällen, sondern der Anteil innerhalb einer Teilmenge.
  • \(P(A \mid B)\) und \(P(B \mid A)\) sind verschiedene Zahlen, sie haben denselben Zähler und verschiedene Nenner.
  • Unabhängigkeit heisst, dass die Bedingung nichts ändert. Sie ist eine rechnerische Eigenschaft, keine inhaltliche Selbstverständlichkeit.
  • Disjunkt und unabhängig sind Gegensätze, keine Synonyme.
  • Der Satz von Bayes dreht die Bedingung um und braucht dafür die Basisrate.
  • Sensitivität und Spezifität gehören dem Test, der Vorhersagewert der Situation.
  • Dieselbe Logik gilt für Hypothesentests: Wie oft ein signifikanter Befund zutrifft, hängt davon ab, wie oft man mit einer richtigen Vermutung anfängt.

Erklärung

Vorwissen: Kombinatorik und Wahrscheinlichkeit, vor allem der Additionssatz und die Vorstellung, dass Wahrscheinlichkeit ein Anteil an allen möglichen Fällen ist. Diese Seite bereitet die Testtheorie in Hypothesentests: Grundlagen vor.

Die Frage, die alles verschiebt

Ein Test auf eine Krankheit ist “zu 95 Prozent zuverlässig”, das Ergebnis ist positiv. Wie wahrscheinlich ist die Krankheit? Die spontane Antwort lautet 95 Prozent. Sie ist, je nach Krankheit, um mehr als eine Grössenordnung daneben.

Der Grund ist, dass zwei verschiedene Grössen gleich klingen. Die eine ist eine Eigenschaft des Tests, die andere die Antwort auf die Frage der Patientin. Wer die beiden auseinanderhalten kann, hat den Kern dieses Themas.

Bedingte Wahrscheinlichkeit: der Grundraum schrumpft

Eine Bedingung verkleinert die Menge der betrachteten Fälle. Statt zu fragen, welcher Anteil aller Fälle eine Eigenschaft hat, fragt man nach dem Anteil innerhalb einer Teilmenge:

\[P(A \mid B) = \frac{P(A \cap B)}{P(B)}\]

Umgestellt ergibt dieselbe Formel den Multiplikationssatz:

\[P(A \cap B) = P(A \mid B) \cdot P(B) = P(B \mid A) \cdot P(A)\]

Die zweite Gleichheit ist bereits der ganze Satz von Bayes, man muss sie nur nach \(P(A \mid B)\) auflösen.

Unabhängigkeit heisst, dass die Bedingung nichts ändert

Begriff Bedeutung Formel
unabhängig Die Bedingung ändert nichts. \(P(A \mid B) = P(A)\), also \(P(A \cap B) = P(A) P(B)\)
disjunkt Beide können nicht zugleich eintreten. \(P(A \cap B) = 0\)

Disjunkt und unabhängig sind Gegensätze. Schliessen zwei Ereignisse einander aus und haben beide positive Wahrscheinlichkeit, dann sind sie maximal abhängig: Sobald das eine eingetreten ist, ist das andere ausgeschlossen. Die gemeinsame Wahrscheinlichkeit ist null, das Produkt der einzelnen aber positiv, die Bedingung für Unabhängigkeit ist verletzt.

Unabhängigkeit wird in Modellen ständig unterstellt, etwa bei der Binomialverteilung, und ist genau dort die Annahme, die am ehesten bricht.

Der Satz von Bayes dreht die Bedingung um

Beim Test ist bekannt, wie er sich bei Kranken verhält. Gesucht ist, wie es um jemanden steht, dessen Test positiv ausfiel:

\[P(K \mid +) = \frac{P(+ \mid K) \cdot P(K)}{P(+)}\]

Die Bestandteile haben Namen, und sie auseinanderzuhalten lohnt sich:

Grösse Bedeutung Eigenschaft von
Sensitivität \(P(+ \mid K)\) Anteil positiver Tests unter den Kranken dem Test
Spezifität \(P(- \mid G)\) Anteil negativer Tests unter den Gesunden dem Test
Prävalenz \(P(K)\) Anteil Kranker in der Bevölkerung der Situation
Positiver Vorhersagewert \(P(K \mid +)\) Anteil Kranker unter den positiv Getesteten beidem
Negativer Vorhersagewert \(P(G \mid -)\) Anteil Gesunder unter den negativ Getesteten beidem

Der Nenner ist die totale Wahrscheinlichkeit eines positiven Tests. Sie setzt sich aus zwei Wegen zusammen: richtig positiv bei Kranken und falsch positiv bei Gesunden.

\[P(+) = P(+ \mid K) \cdot P(K) + P(+ \mid G) \cdot P(G)\]

Beispiele

Frage und Datenlage

Ein Würfel, drei Fragen: Wie wahrscheinlich ist eine Sechs, wenn die Augenzahl gerade ist? Sind “gerade” und “grösser als 3” unabhängig? Und was ist mit “gerade” und “grösser als 4”?

Rechnung

augen <- 1:6

# Bedingte Wahrscheinlichkeit: der Grundraum schrumpft auf drei Faelle
p_gerade <- mean(augen %% 2 == 0)
p_sechs_und_gerade <- mean(augen == 6 & augen %% 2 == 0)

round(c(p_gerade = p_gerade,
        p_sechs_und_gerade = p_sechs_und_gerade,
        bedingt = p_sechs_und_gerade / p_gerade,
        unbedingt = 1 / 6), 4)
          p_gerade p_sechs_und_gerade            bedingt          unbedingt 
            0.5000             0.1667             0.3333             0.1667 
# Unabhaengigkeitspruefung fuer zwei Paare
pruefe <- function(a, b) {
  c(p_a = mean(a), p_b = mean(b), gemeinsam = mean(a & b),
    produkt = mean(a) * mean(b), bedingt = mean(a & b) / mean(b))
}

round(rbind(
  "gerade / groesser 3" = pruefe(augen %% 2 == 0, augen > 3),
  "gerade / groesser 4" = pruefe(augen %% 2 == 0, augen > 4)
), 4)
                    p_a    p_b gemeinsam produkt bedingt
gerade / groesser 3 0.5 0.5000    0.3333  0.2500  0.6667
gerade / groesser 4 0.5 0.3333    0.1667  0.1667  0.5000
augen = np.arange(1, 7)

p_gerade = float((augen % 2 == 0).mean())
p_sechs_und_gerade = float(((augen == 6) & (augen % 2 == 0)).mean())

print({"p_gerade": round(p_gerade, 4),
       "p_sechs_und_gerade": round(p_sechs_und_gerade, 4),
       "bedingt": round(p_sechs_und_gerade / p_gerade, 4),
       "unbedingt": round(1 / 6, 4)})
{'p_gerade': 0.5, 'p_sechs_und_gerade': 0.1667, 'bedingt': 0.3333, 'unbedingt': 0.1667}
def pruefe(a, b):
    return {"p_a": a.mean(), "p_b": b.mean(), "gemeinsam": (a & b).mean(),
            "produkt": a.mean() * b.mean(),
            "bedingt": (a & b).mean() / b.mean()}


print(pd.DataFrame([pruefe(augen % 2 == 0, augen > 3),
                    pruefe(augen % 2 == 0, augen > 4)],
                   index=["gerade / grösser 3",
                          "gerade / grösser 4"]).round(4))
                    p_a     p_b  gemeinsam  produkt  bedingt
gerade / grösser 3  0.5  0.5000     0.3333   0.2500   0.6667
gerade / grösser 4  0.5  0.3333     0.1667   0.1667   0.5000

Output Zeile für Zeile

Grösse Wert Wie er entsteht
\(P(\text{gerade})\) 0.5 drei von sechs
\(P(\text{Sechs} \cap \text{gerade})\) 0.1667 eine von sechs
\(P(\text{Sechs} \mid \text{gerade})\) 0.3333 \(0.1667 / 0.5\), eine von drei
\(P(\text{Sechs})\) unbedingt 0.1667

Die Bedingung hat die Wahrscheinlichkeit verdoppelt, weil nur noch drei Fälle in Frage kommen und einer davon die Sechs ist.

Und die Unabhängigkeitsprüfung:

Paar \(P(A)\) \(P(B)\) gemeinsam Produkt \(P(A \mid B)\) Urteil
gerade / grösser 3 0.5 0.5 0.3333 0.25 0.6667 abhängig
gerade / grösser 4 0.5 0.3333 0.1667 0.1667 0.5 unabhängig
Beobachtung Erklärung
“gerade” und “grösser 3” sind abhängig Von den drei Werten über 3 sind zwei gerade (4 und 6), also \(P(A \mid B) = 2/3\) statt \(1/2\).
“gerade” und “grösser 4” sind unabhängig Von den zwei Werten über 4 ist einer gerade (6), also \(P(A \mid B) = 1/2 = P(A)\). Die Bedingung ändert nichts.
Der Unterschied ist eine Zahl, keine Anschauung Beide Paare sehen inhaltlich gleich aus. Ob sie unabhängig sind, sagt allein die Rechnung.

Dieses Beispiel ist der ganze Begriff in drei Zeilen: Unabhängigkeit ist keine Eigenschaft, die man einer Situation ansieht. Sie ist eine Gleichung, die erfüllt ist oder nicht.

In der Praxis wird sie meistens unterstellt statt geprüft, bei der Binomialverteilung, beim t-Test, bei jeder Berechnung eines Standardfehlers. Und sie ist regelmässig die Annahme, die am ehesten bricht: bei wiederholten Messungen an derselben Person, bei Zeitreihen, bei Schulklassen oder Filialen.

Interpretation

Die Bedingung verdoppelt hier die Wahrscheinlichkeit. Wie stark sie wirkt, hängt daran, wie viel Information sie mitbringt und im Extremfall kehrt sie das Ergebnis um, wie Beispiel 3 zeigt.

Frage und Datenlage

Ein Test mit 95 Prozent Sensitivität und 98 Prozent Spezifität, eine Krankheit mit einem Prozent Prävalenz. Der Test ist positiv, wie wahrscheinlich ist die Krankheit?

Vor der Formel lohnt der Umweg über eine gedachte Bevölkerung von zehntausend Personen.

Rechnung

N <- 10000
sens <- 0.95
spez <- 0.98
praev <- 0.01

krank <- N * praev
gesund <- N - krank

richtig_positiv <- krank * sens
falsch_negativ <- krank - richtig_positiv
falsch_positiv <- gesund * (1 - spez)
richtig_negativ <- gesund - falsch_positiv

tafel <- rbind(
  krank = c(positiv = richtig_positiv, negativ = falsch_negativ,
            summe = krank),
  gesund = c(falsch_positiv, richtig_negativ, gesund),
  summe = c(richtig_positiv + falsch_positiv,
            falsch_negativ + richtig_negativ, N)
)
tafel
       positiv negativ summe
krank       95       5   100
gesund     198    9702  9900
summe      293    9707 10000
round(c(
  positiver_vorhersagewert = richtig_positiv / (richtig_positiv + falsch_positiv),
  negativer_vorhersagewert = richtig_negativ / (richtig_negativ + falsch_negativ),
  anteil_positiv_getestet = (richtig_positiv + falsch_positiv) / N
), 4)
positiver_vorhersagewert negativer_vorhersagewert  anteil_positiv_getestet 
                  0.3242                   0.9995                   0.0293 
N = 10000
sens, spez, praev = 0.95, 0.98, 0.01

krank = N * praev
gesund = N - krank

richtig_positiv = krank * sens
falsch_negativ = krank - richtig_positiv
falsch_positiv = gesund * (1 - spez)
richtig_negativ = gesund - falsch_positiv

print(pd.DataFrame({
    "positiv": [richtig_positiv, falsch_positiv,
                richtig_positiv + falsch_positiv],
    "negativ": [falsch_negativ, richtig_negativ,
                falsch_negativ + richtig_negativ],
    "summe": [krank, gesund, N],
}, index=["krank", "gesund", "summe"]))
        positiv  negativ    summe
krank      95.0      5.0    100.0
gesund    198.0   9702.0   9900.0
summe     293.0   9707.0  10000.0
print({
    "positiver_vorhersagewert":
        round(richtig_positiv / (richtig_positiv + falsch_positiv), 4),
    "negativer_vorhersagewert":
        round(richtig_negativ / (richtig_negativ + falsch_negativ), 4),
    "anteil_positiv_getestet":
        round((richtig_positiv + falsch_positiv) / N, 4),
})
{'positiver_vorhersagewert': 0.3242, 'negativer_vorhersagewert': 0.9995, 'anteil_positiv_getestet': 0.0293}

Output Zeile für Zeile

Test positiv Test negativ Summe
krank 95 5 100
gesund 198 9 702 9 900
Summe 293 9 707 10 000
Grösse Wert Wie er zu lesen ist
positiver Vorhersagewert $95 / 293 = $ 0.3242 Nur 32 Prozent der positiv Getesteten sind tatsächlich krank. Zwei Drittel der Alarme sind falsch.
negativer Vorhersagewert $9702 / 9707 = $ 0.9995 Ein negatives Ergebnis ist dagegen sehr verlässlich.
Anteil positiv Getesteter 293 / 10 000 = 2.93 % Fast dreimal so viele wie tatsächlich krank sind.
Beobachtung Erklärung
198 falsch positive gegen 95 richtig positive Obwohl der Test in beiden Richtungen gut ist.
Die Ursache steht in der Spalte “Summe” Zwei Prozent von 9 900 Gesunden sind mehr Menschen, als fünf Prozent Fehler bei 100 Kranken überhaupt ausmachen könnten. Die Grössenordnung der Gruppen entscheidet.
Die beiden Vorhersagewerte sind völlig verschieden 0.32 gegen 0.9995. Wer von “Zuverlässigkeit” spricht, ohne die Richtung zu nennen, sagt nichts.
Die Tafel enthält keine Wahrscheinlichkeit Nur Menschen. Genau das macht sie verständlich.

Die Empfehlung, die aus diesem Beispiel folgt: Wer die Rechnung in absoluten Häufigkeiten aufschreibt, hundert Kranke, zehntausend Gesunde, kommt schneller und mit weniger Fehlern zum Ziel als über die Formel. Auch im Gespräch mit Fachfremden ist das der überzeugendere Weg.

Der Aufbau ist immer derselbe:

  1. Eine runde Bevölkerungszahl wählen, gross genug für ganze Zahlen.
  2. Nach der Basisrate in zwei Gruppen teilen.
  3. Jede Gruppe nach dem Testergebnis teilen.
  4. Die gesuchte Zahl aus der passenden Spalte ablesen.

Schritt 4 ist der springende Punkt: Die Sensitivität liest man zeilenweise, den Vorhersagewert spaltenweise.

Interpretation und Ergebnissatz

Bei einer Prävalenz von einem Prozent und einem Test mit 95 Prozent Sensitivität und 98 Prozent Spezifität sind nur 32.4 Prozent der positiv Getesteten tatsächlich erkrankt (95 von 293). Ein negatives Ergebnis schliesst die Erkrankung dagegen mit 99.95 Prozent aus.

Frage und Datenlage

Derselbe Test in drei Situationen: Reihenuntersuchung in der Allgemeinbevölkerung, Untersuchung einer Risikogruppe, Abklärung bei begründetem Verdacht.

Rechnung

round(rbind(
  praevalenz = c(0.001, 0.005, 0.01, 0.05, 0.10, 0.30, 0.50),
  ppv = ppv(sens, spez, c(0.001, 0.005, 0.01, 0.05, 0.10, 0.30, 0.50)),
  npv = npv(sens, spez, c(0.001, 0.005, 0.01, 0.05, 0.10, 0.30, 0.50))
), 4)
             [,1]   [,2]   [,3]   [,4]   [,5]   [,6]   [,7]
praevalenz 0.0010 0.0050 0.0100 0.0500 0.1000 0.3000 0.5000
ppv        0.0454 0.1927 0.3242 0.7143 0.8407 0.9532 0.9794
npv        0.9999 0.9997 0.9995 0.9973 0.9944 0.9786 0.9515
# Ab welcher Praevalenz ist ein positiver Test mehrheitlich richtig?
round((1 - spez) / (sens + 1 - spez), 4)
[1] 0.0206
p <- seq(0.001, 0.3, length.out = 300)

par(mar = c(4, 4, 2, 1))
plot(p * 100, ppv(sens, spez, p) * 100, type = "l", lwd = 2, ylim = c(0, 100),
     xlab = "Prävalenz in Prozent", ylab = "Vorhersagewert in Prozent")
lines(p * 100, npv(sens, spez, p) * 100, lwd = 2, lty = 2)
abline(h = 50, lty = 3)
legend("right", legend = c("positiv", "negativ"), lwd = 2, lty = c(1, 2),
       bty = "n")
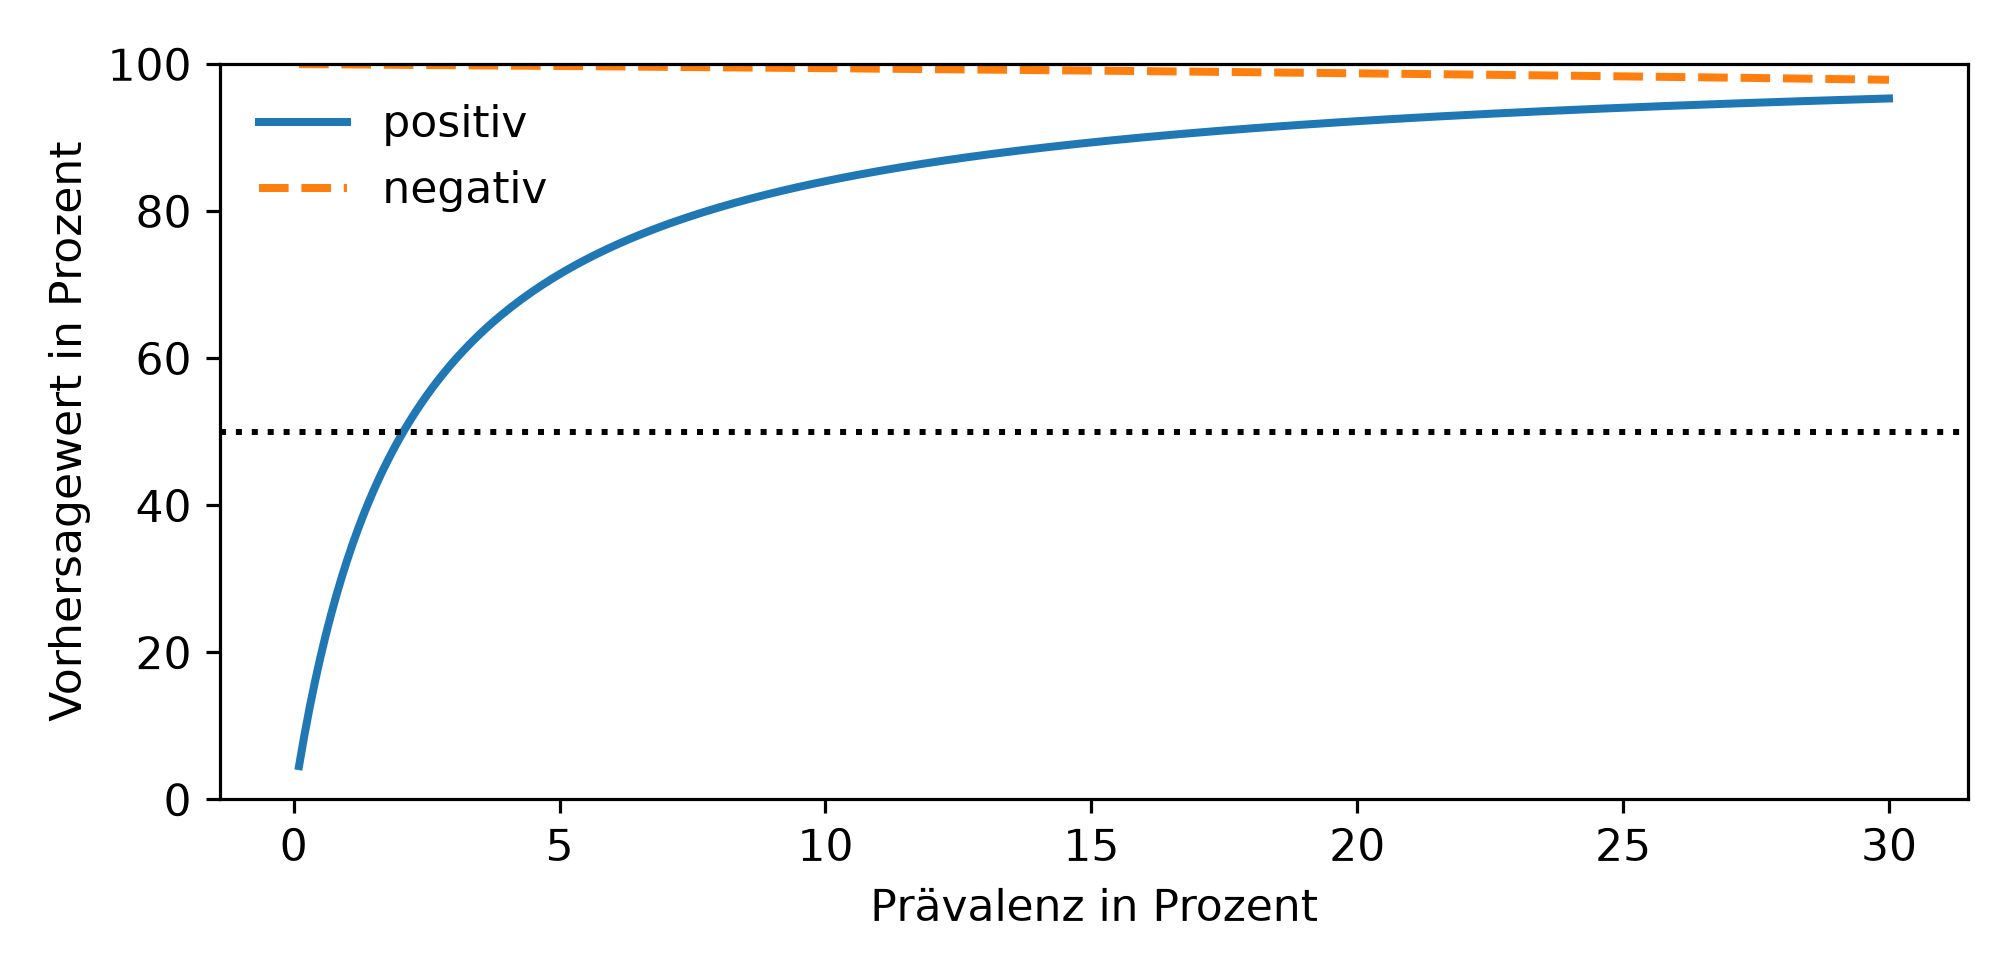
Abbildung 1: Beispiel 3: positiver und negativer Vorhersagewert desselben Tests bei wachsender Prävalenz.
stufen = np.array([0.001, 0.005, 0.01, 0.05, 0.10, 0.30, 0.50])
print(pd.DataFrame({"praevalenz": stufen,
                    "ppv": ppv(sens, spez, stufen),
                    "npv": npv(sens, spez, stufen)}).round(4).T)
                 0       1       2       3       4       5       6
praevalenz  0.0010  0.0050  0.0100  0.0500  0.1000  0.3000  0.5000
ppv         0.0454  0.1927  0.3242  0.7143  0.8407  0.9532  0.9794
npv         0.9999  0.9997  0.9995  0.9973  0.9944  0.9786  0.9515
print("Schwelle für PPV = 50 %:", round((1 - spez) / (sens + 1 - spez), 4))
Schwelle für PPV = 50 %: 0.0206
p = np.linspace(0.001, 0.3, 300)

fig, achse = plt.subplots(figsize=(7, 3.4))
achse.plot(p * 100, ppv(sens, spez, p) * 100, lw=2, label="positiv")
achse.plot(p * 100, npv(sens, spez, p) * 100, lw=2, ls="--", label="negativ")
achse.axhline(50, ls=":", color="black")
achse.set_ylim(0, 100)
(0.0, 100.0)
achse.set_xlabel("Prävalenz in Prozent")
achse.set_ylabel("Vorhersagewert in Prozent")
achse.legend(frameon=False)
plt.tight_layout()
plt.show()
Abbildung 2: Beispiel 3: dieselben beiden Kurven in Python.

Output Zeile für Zeile

Prävalenz 0.1 % 0.5 % 1 % 5 % 10 % 30 % 50 %
positiver Vorhersagewert 0.045 0.193 0.324 0.714 0.841 0.953 0.979
negativer Vorhersagewert 0.9999 0.9997 0.9995 0.9973 0.9944 0.979 0.952
Beobachtung Erklärung
Bei 0.1 Prozent Prävalenz sind 95 Prozent aller Alarme falsch Der positive Vorhersagewert beträgt 4.5 Prozent. Derselbe Test, dieselben Kenngrössen.
Die Schwelle für “mehrheitlich richtig” liegt bei 2.06 Prozent Aus \(\text{Sens} \cdot p = (1-\text{Spez})(1-p)\) aufgelöst. Darunter ist ein positives Ergebnis wahrscheinlicher falsch als richtig.
Die Kurve steigt anfangs steil und flacht dann ab Von 0.1 auf 5 Prozent Prävalenz steigt der Vorhersagewert von 4.5 auf 71 Prozent, von 30 auf 50 Prozent nur noch von 95 auf 98.
Der negative Vorhersagewert bewegt sich in die Gegenrichtung Von 0.9999 auf 0.952. Bei häufigen Krankheiten wird ein negatives Ergebnis weniger beruhigend.
Der Vorhersagewert ist keine Eigenschaft des Tests Er steht in keinem Beipackzettel, weil er von der Situation abhängt.

Warum nicht ungezielt getestet wird, folgt unmittelbar aus der Tabelle: Ein Screening in der Allgemeinbevölkerung erzeugt weit mehr falsch positive als richtig positive Befunde, mit allen Folgen an Beunruhigung, Nachuntersuchungen und deren eigenen Risiken.

Derselbe Test bei begründetem Verdacht ist dagegen aussagekräftig, weil die Vorauswahl die Prävalenz in der untersuchten Gruppe erhöht hat. Die Verdachtsdiagnose ist statistisch gesehen nichts anderes als eine Erhöhung der Basisrate.

Und die zweite Folgerung: Ein zweiter, unabhängiger Test nach einem positiven ersten startet mit einer Prävalenz von 32 Prozent statt einem Prozent. Deshalb sind gestufte Verfahren so wirksam.

Interpretation und Ergebnissatz

Derselbe Test liefert je nach Prävalenz positive Vorhersagewerte zwischen 4.5 Prozent (Reihenuntersuchung, Prävalenz 0.1 Prozent) und 97.9 Prozent (Prävalenz 50 Prozent). Ein positives Ergebnis ist erst ab einer Prävalenz von 2.1 Prozent mehrheitlich zutreffend.

Frage und Datenlage

Der Test soll verbessert werden, und das Budget reicht für eine der beiden Kenngrössen. Bei einer Prävalenz von einem Prozent: Was bringt mehr?

Rechnung

varianten <- rbind(
  ausgangslage = c(sens = 0.95, spez = 0.98),
  "Sensitivität auf 0.99" = c(0.99, 0.98),
  "Spezifität auf 0.99" = c(0.95, 0.99),
  "Spezifität auf 0.999" = c(0.95, 0.999),
  "beides perfekt bis auf Spezifität" = c(1.00, 0.98)
)

ergebnis <- data.frame(
  sens = varianten[, "sens"],
  spez = varianten[, "spez"],
  ppv = ppv(varianten[, "sens"], varianten[, "spez"], 0.01),
  npv = npv(varianten[, "sens"], varianten[, "spez"], 0.01)
)
round(ergebnis, 4)
                                  sens  spez    ppv    npv
ausgangslage                      0.95 0.980 0.3242 0.9995
Sensitivität auf 0.99             0.99 0.980 0.3333 0.9999
Spezifität auf 0.99               0.95 0.990 0.4897 0.9995
Spezifität auf 0.999              0.95 0.999 0.9056 0.9995
beides perfekt bis auf Spezifität 1.00 0.980 0.3356 1.0000
# Bei haeufiger Krankheit kehrt sich das Bild um
round(data.frame(
  ppv_praev_01 = ppv(varianten[, "sens"], varianten[, "spez"], 0.01),
  ppv_praev_50 = ppv(varianten[, "sens"], varianten[, "spez"], 0.50)
), 4)
                                  ppv_praev_01 ppv_praev_50
ausgangslage                            0.3242       0.9794
Sensitivität auf 0.99                   0.3333       0.9802
Spezifität auf 0.99                     0.4897       0.9896
Spezifität auf 0.999                    0.9056       0.9989
beides perfekt bis auf Spezifität       0.3356       0.9804
varianten = pd.DataFrame(
    [[0.95, 0.98], [0.99, 0.98], [0.95, 0.99], [0.95, 0.999], [1.00, 0.98]],
    columns=["sens", "spez"],
    index=["ausgangslage", "Sensitivität auf 0.99", "Spezifität auf 0.99",
           "Spezifität auf 0.999", "beides perfekt bis auf Spezifität"])

varianten["ppv"] = ppv(varianten["sens"], varianten["spez"], 0.01)
varianten["npv"] = npv(varianten["sens"], varianten["spez"], 0.01)
print(varianten.round(4))
                                   sens   spez     ppv     npv
ausgangslage                       0.95  0.980  0.3242  0.9995
Sensitivität auf 0.99              0.99  0.980  0.3333  0.9999
Spezifität auf 0.99                0.95  0.990  0.4897  0.9995
Spezifität auf 0.999               0.95  0.999  0.9056  0.9995
beides perfekt bis auf Spezifität  1.00  0.980  0.3356  1.0000
print(pd.DataFrame({
    "ppv_praev_01": ppv(varianten["sens"], varianten["spez"], 0.01),
    "ppv_praev_50": ppv(varianten["sens"], varianten["spez"], 0.50),
}).round(4))
                                   ppv_praev_01  ppv_praev_50
ausgangslage                             0.3242        0.9794
Sensitivität auf 0.99                    0.3333        0.9802
Spezifität auf 0.99                      0.4897        0.9896
Spezifität auf 0.999                     0.9056        0.9989
beides perfekt bis auf Spezifität        0.3356        0.9804

Output Zeile für Zeile

Bei einer Prävalenz von einem Prozent:

Variante Sensitivität Spezifität positiver Vorhersagewert
Ausgangslage 0.95 0.98 0.3242
Sensitivität auf 0.99 0.99 0.98 0.3333 (+0.9 Punkte)
Spezifität auf 0.99 0.95 0.99 0.4897 (+16.6 Punkte)
Spezifität auf 0.999 0.95 0.999 0.9056 (+58 Punkte)
Sensitivität auf 1.00 1.00 0.98 0.3356 (+1.1 Punkte)
Beobachtung Erklärung
Eine perfekte Sensitivität bringt nur 1.1 Punkte Selbst wenn der Test jeden Kranken findet, bleibt der Vorhersagewert bei 34 Prozent. Die falsch positiven Fälle verschwinden dadurch nicht.
Die Spezifität von 0.98 auf 0.99 bringt 16.6 Punkte Sie halbiert die falsch positiven von 198 auf 99.
Von 0.98 auf 0.999 bringt 58 Punkte Nur noch 10 statt 198 falsch positive.
Der Grund ist eine Multiplikation Die Sensitivität wirkt auf 100 Kranke, die Spezifität auf 9 900 Gesunde. Ein Prozentpunkt auf der grossen Gruppe bewegt hundertmal mehr Menschen.

Und bei einer Prävalenz von 50 Prozent:

Variante PPV bei 1 % PPV bei 50 %
Ausgangslage 0.3242 0.9794
Sensitivität auf 0.99 0.3333 0.9802
Spezifität auf 0.99 0.4897 0.9896

Dort spielt die Frage kaum noch eine Rolle, beide Gruppen sind gleich gross.

Die allgemeine Regel: Die Kenngrösse, die auf die grössere Gruppe wirkt, bestimmt das Ergebnis.

Situation Was zählt Warum
seltene Krankheit, Screening Spezifität die Gesunden sind die grosse Gruppe
häufige Krankheit, Abklärung ausgeglichen beide Gruppen ähnlich gross
Ausschluss wichtig (kein Fall darf durchrutschen) Sensitivität dann zählt der negative Vorhersagewert

Und die praktische Konsequenz: Bei Reihenuntersuchungen wird die Schwelle des Tests bewusst streng gesetzt, man kauft Spezifität, indem man Sensitivität opfert, weil die falsch positiven Fälle sonst das Verfahren unbrauchbar machen. Genau diesen Handel beschreibt die ROC-Kurve.

Interpretation und Ergebnissatz

Bei einer Prävalenz von einem Prozent steigert eine Erhöhung der Spezifität von 98 auf 99 Prozent den positiven Vorhersagewert von 32.4 auf 49.0 Prozent, während eine Erhöhung der Sensitivität von 95 auf 99 Prozent nur 0.9 Prozentpunkte bringt. Bei seltenen Ereignissen ist die Spezifität die entscheidende Kenngrösse.

Frage und Datenlage

Ein statistischer Test ist ein diagnostischer Test, nur mit anderen Namen:

Diagnostik Hypothesentest
krank es gibt wirklich einen Effekt
Test positiv das Ergebnis ist signifikant
Sensitivität Power \(1 - \beta\)
1 − Spezifität Signifikanzniveau \(\alpha\)
Prävalenz Anteil der untersuchten Vermutungen, die zutreffen
positiver Vorhersagewert Anteil der signifikanten Befunde, die zutreffen

Die Frage lautet also: Wie oft trifft ein signifikanter Befund zu?

Rechnung

alpha <- 0.05

faelle <- expand.grid(power = c(0.8, 0.5, 0.2),
                      anteil_wahr = c(0.5, 0.1, 0.02))
faelle$ppv <- ppv(faelle$power, 1 - alpha, faelle$anteil_wahr)
faelle$falsch_positiv_anteil <- 1 - faelle$ppv

round(faelle[order(-faelle$power, -faelle$anteil_wahr), ], 4)
  power anteil_wahr    ppv falsch_positiv_anteil
1   0.8        0.50 0.9412                0.0588
4   0.8        0.10 0.6400                0.3600
7   0.8        0.02 0.2462                0.7538
2   0.5        0.50 0.9091                0.0909
5   0.5        0.10 0.5263                0.4737
8   0.5        0.02 0.1695                0.8305
3   0.2        0.50 0.8000                0.2000
6   0.2        0.10 0.3077                0.6923
9   0.2        0.02 0.0755                0.9245
anteil <- seq(0.005, 0.6, length.out = 300)
par(mar = c(4, 4, 2, 1))
plot(anteil * 100, ppv(0.8, 1 - alpha, anteil) * 100, type = "l", lwd = 2,
     ylim = c(0, 100), xlab = "Anteil zutreffender Vermutungen in Prozent",
     ylab = "davon zutreffend, in Prozent")
lines(anteil * 100, ppv(0.5, 1 - alpha, anteil) * 100, lwd = 2, lty = 2)
lines(anteil * 100, ppv(0.2, 1 - alpha, anteil) * 100, lwd = 2, lty = 3)
abline(h = 50, col = "grey60")
legend("bottomright", legend = c("Power 0.8", "Power 0.5", "Power 0.2"),
       lwd = 2, lty = 1:3, bty = "n")
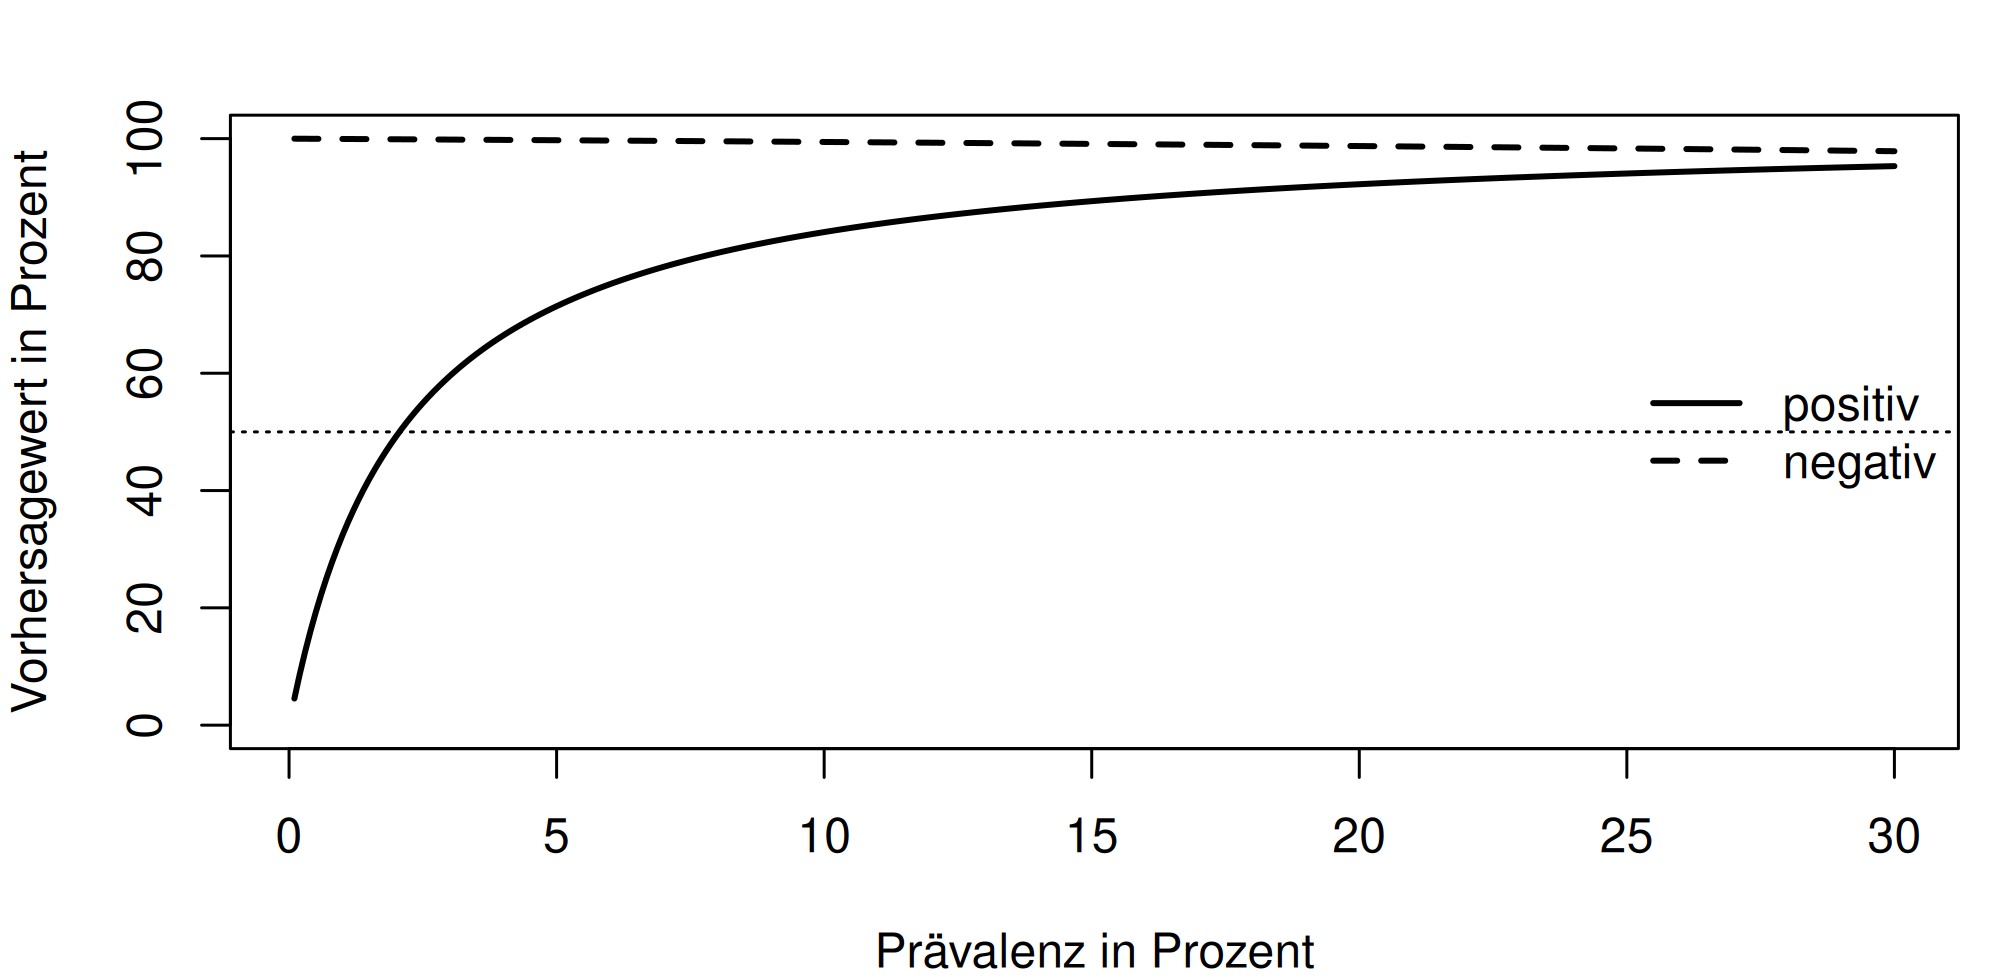
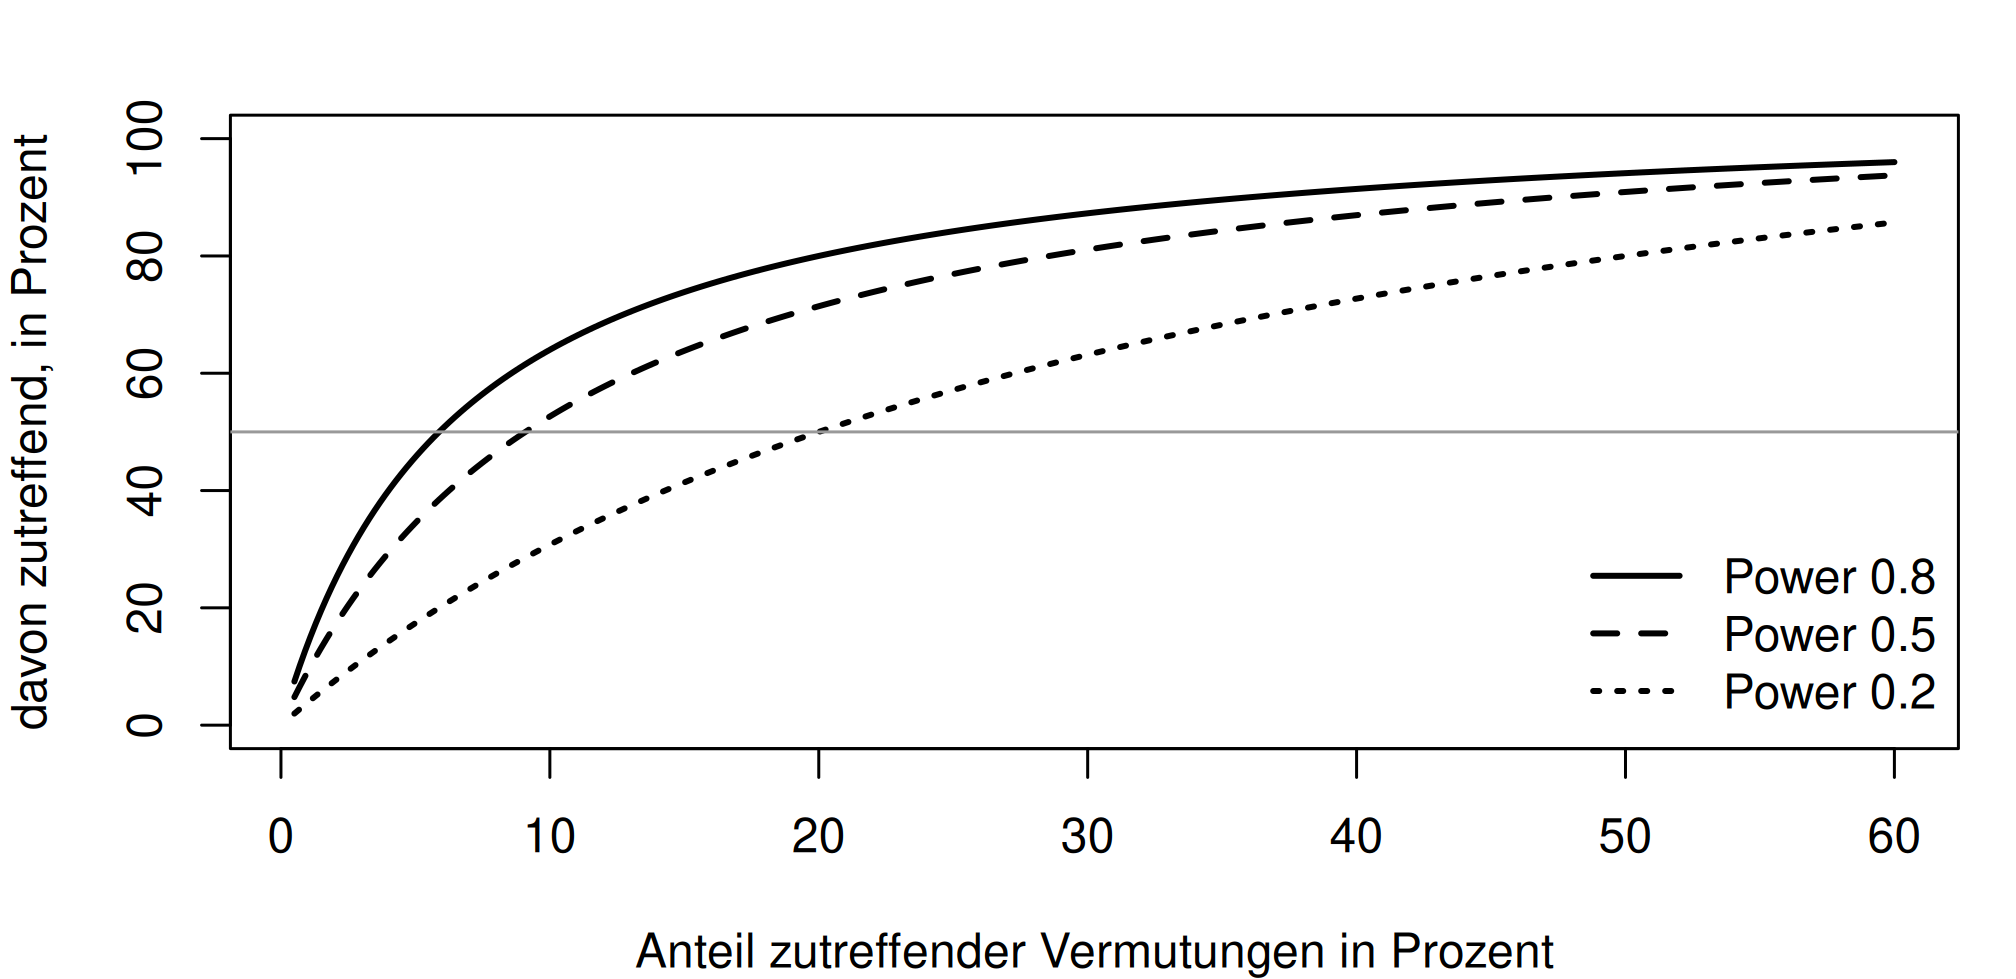
Abbildung 3: Beispiel 5: Anteil zutreffender Befunde unter den signifikanten, je nach Power und Anteil richtiger Vermutungen.
alpha = 0.05

zeilen = []
for power in [0.8, 0.5, 0.2]:
    for anteil_wahr in [0.5, 0.1, 0.02]:
        wert = ppv(power, 1 - alpha, anteil_wahr)
        zeilen.append({"power": power, "anteil_wahr": anteil_wahr,
                       "ppv": wert, "falsch_positiv_anteil": 1 - wert})
print(pd.DataFrame(zeilen).round(4).to_string(index=False))
 power  anteil_wahr    ppv  falsch_positiv_anteil
   0.8         0.50 0.9412                 0.0588
   0.8         0.10 0.6400                 0.3600
   0.8         0.02 0.2462                 0.7538
   0.5         0.50 0.9091                 0.0909
   0.5         0.10 0.5263                 0.4737
   0.5         0.02 0.1695                 0.8305
   0.2         0.50 0.8000                 0.2000
   0.2         0.10 0.3077                 0.6923
   0.2         0.02 0.0755                 0.9245
anteil = np.linspace(0.005, 0.6, 300)
fig, achse = plt.subplots(figsize=(7, 3.4))
for power, stil in zip([0.8, 0.5, 0.2], ["-", "--", ":"]):
    achse.plot(anteil * 100, ppv(power, 1 - alpha, anteil) * 100, lw=2,
               ls=stil, label=f"Power {power}")
achse.axhline(50, color="0.6")
achse.set_ylim(0, 100)
(0.0, 100.0)
achse.set_xlabel("Anteil zutreffender Vermutungen in Prozent")
achse.set_ylabel("davon zutreffend, in Prozent")
achse.legend(frameon=False, loc="lower right")
plt.tight_layout()
plt.show()
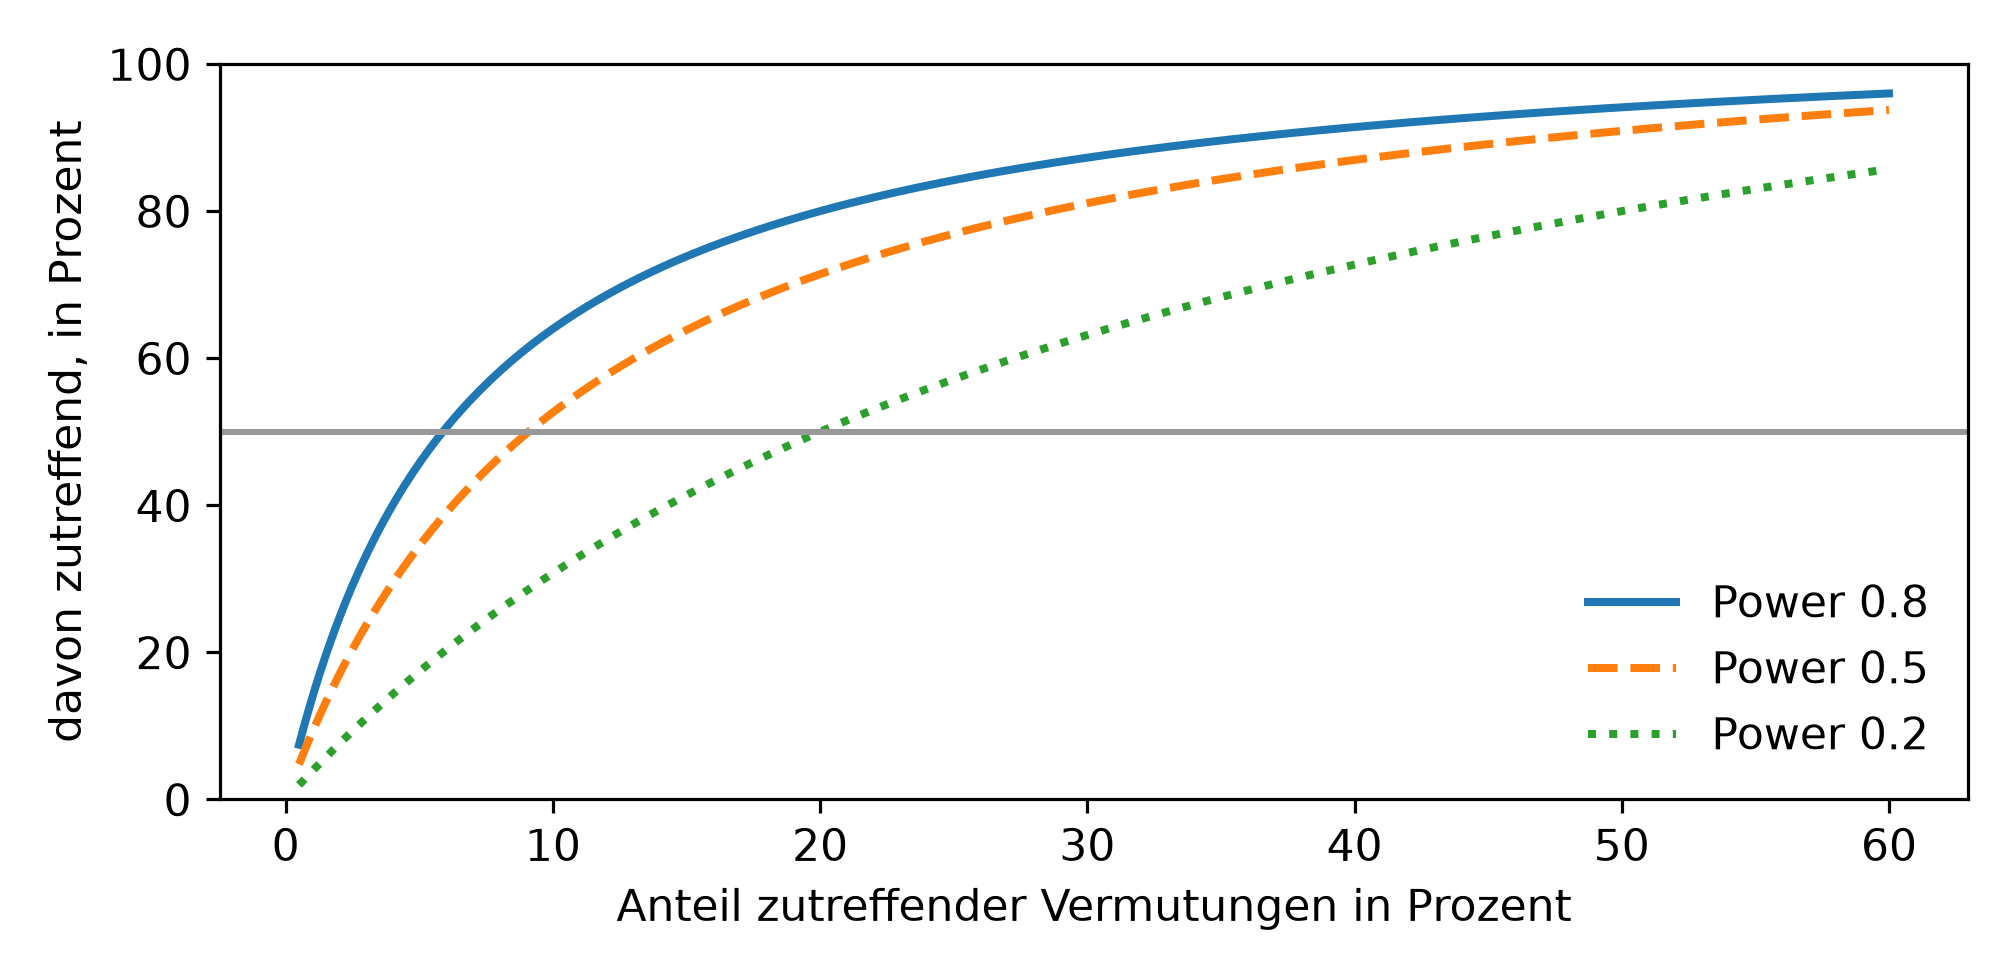
Abbildung 4: Beispiel 5: dieselben drei Kurven in Python.

Output Zeile für Zeile

Anteil der signifikanten Befunde, die tatsächlich zutreffen (bei \(\alpha = 0.05\)):

Anteil zutreffender Vermutungen 50 % 10 % 2 %
Power 0.8 0.941 0.640 0.246
Power 0.5 0.909 0.526 0.170
Power 0.2 0.800 0.308 0.076
Beobachtung Erklärung
Bei gut begründeten Vermutungen (50 Prozent) und guter Power treffen 94 Prozent der signifikanten Befunde zu. So soll es sein.
Bei explorativer Suche (2 Prozent) und schwacher Power sind 92 Prozent der signifikanten Befunde falsch.
Die Power wirkt wie die Sensitivität Sie erhöht die richtig positiven, ohne die falsch positiven zu senken.
Das Signifikanzniveau wirkt wie 1 − Spezifität Es begrenzt die falsch positiven und wirkt auf die grosse Gruppe der Fälle ohne Effekt.
Der Anteil zutreffender Vermutungen ist die Basisrate Und er steht in keiner Ausgabe. Er ist eine Eigenschaft des Forschungsfelds, nicht der Rechnung.

Was daraus für die Praxis folgt, und zwar unabhängig von jedem Wissenschaftsbetrieb:

Massnahme Wirkung
Hypothese vorher festlegen erhöht die Basisrate, die wirksamste Massnahme von allen
Power erhöhen (grössere Stichprobe) erhöht den Zähler, siehe Power
\(\alpha\) senken oder für multiple Vergleiche korrigieren senkt die falsch positiven, siehe multiples Testen
Replikation startet mit der Basisrate des Vorbefunds statt mit der des Felds

Und die Umkehrung, die den p-Wert richtig einordnet: Ein p von 0.04 heisst nicht, dass der Befund zu 96 Prozent zutrifft. Wie oft er zutrifft, hängt zusätzlich an der Power und an der Basisrate, genau wie beim medizinischen Test. Ausführlich unter Hypothesentests: Grundlagen.

Interpretation und Ergebnissatz

Bei einem Signifikanzniveau von 5 Prozent, einer Power von 0.8 und einem Anteil zutreffender Vermutungen von 2 Prozent treffen nur 24.6 Prozent der signifikanten Befunde tatsächlich zu. Der Anteil steigt auf 94.1 Prozent, wenn die Hälfte der untersuchten Vermutungen zutrifft.

Verständnisfragen

Warum ist die Wahrscheinlichkeit für Regen unter bewölkten Tagen etwas anderes als die für Bewölkung unter Regentagen?

Sie sind gleich, nur anders formuliert
Beide haben denselben Zähler, aber verschiedene Nenner. Das Ergebnis unterscheidet sich deutlich.
Geteilt wird durch verschieden grosse Gruppen
Richtig. Bewölkte Tage gibt es viel mehr als Regentage. Unter Regentagen ist fast immer Bewölkung, unter bewölkten Tagen längst nicht immer Regen.
Die eine ist bedingt, die andere nicht
Beide sind bedingt, nur in entgegengesetzter Richtung.

Zwei Ereignisse schliessen einander aus. Sind sie stochastisch unabhängig?

Ja, das ist dasselbe
Genau diese Verwechslung ist gemeint. Disjunkt und unabhängig sind verschiedene Begriffe.
Nein, sie sind maximal abhängig
Richtig. Ist das eine eingetreten, ist das andere ausgeschlossen. Die gemeinsame Wahrscheinlichkeit ist null, das Produkt der einzelnen aber positiv.
Das hängt von den Wahrscheinlichkeiten ab
Solange beide positiv sind, gilt die Aussage immer.

Ein Test hat 99 Prozent Sensitivität und 99 Prozent Spezifität, die Prävalenz beträgt 0.1 Prozent. Ein Ergebnis ist positiv. Wie wahrscheinlich ist die Erkrankung?

Rund 99 Prozent
Das ist die Sensitivität und damit die Wahrscheinlichkeit eines positiven Tests bei Erkrankten. Gefragt war die Gegenrichtung.
Rund 9 Prozent
Richtig. Von 100 000 Personen sind 100 erkrankt, davon 99 richtig positiv. Von den 99 900 Gesunden fällt ein Prozent falsch positiv aus, also 999. Damit sind 99 von 1 098 tatsächlich erkrankt.
Rund 50 Prozent
Zu hoch. Bei diesem Test läge die Marke erst bei einer Prävalenz von rund einem Prozent.

Warum verbessert bei einer seltenen Krankheit eine höhere Spezifität den Vorhersagewert stärker als eine höhere Sensitivität?

Weil die Gruppe der Gesunden viel grösser ist und den Nenner bestimmt
Richtig. Ein Prozentpunkt Spezifität bewegt bei 9 900 Gesunden 99 Personen, ein Prozentpunkt Sensitivität bei 100 Kranken eine. Im Beispiel bringt selbst eine perfekte Sensitivität nur 1.1 Prozentpunkte.
Weil die Spezifität wichtiger ist als die Sensitivität
Wichtiger ist keine von beiden grundsätzlich; es hängt an der Prävalenz.
Weil sie die Prävalenz erhöht
Die Prävalenz ist eine Eigenschaft der Situation und wird vom Test nicht verändert.

Ein Forschungsfeld untersucht überwiegend spekulative Vermutungen; nur zwei Prozent treffen zu. Bei einer Power von 0.8 und \(\alpha\) = 0.05: Welcher Anteil der signifikanten Befunde trifft zu?

Rund ein Viertel
Richtig, 24.6 Prozent. Von 1 000 Vermutungen treffen 20 zu, davon werden 16 gefunden; von den 980 falschen werden 49 fälschlich signifikant. Damit sind 16 von 65 Befunden richtig.
Rund 95 Prozent
Das wäre eins minus alpha und beantwortet eine andere Frage: wie oft ein Test bei fehlendem Effekt nicht anschlägt.
Rund 80 Prozent
Das ist die Power und damit die Wahrscheinlichkeit, einen vorhandenen Effekt zu finden, wieder die Gegenrichtung.

Verlinkte Ressourcen