Zwei unabhängige Gruppen vergleichen, Welch als Standardfall.
Alle Beispiele auf dieser Seite rechnen mit fest eingetragenen Zahlen. R und Python sehen also dieselben Daten und müssen dieselben Werte ausgeben; wo sie es nicht tun, liegt es an der Konvention der Funktion und nicht an der Stichprobe.
Kurzsteckbrief
Fragestellung
Unterscheiden sich die Mittelwerte zweier unabhängiger Gruppen?
Zielvariable
metrisch
Gruppen
genau zwei, unabhängig voneinander
Was die Methode liefert
Mittelwertdifferenz mit Konfidenzintervall, t-Statistik, Freiheitsgrade, p-Wert, Effektstärke
R-Funktion
t.test(wert ~ gruppe, data = df), Effektstärke mit effectsize::cohens_d()
Typische Fragestellungen: Unterscheiden sich zwei Maschinen in der gefertigten Dicke, zwei Standorte im Durchsatz, zwei Varianten einer Seite in der Verweildauer. Gemeinsam ist ihnen eine metrische Zielgrösse und genau zwei Gruppen, deren Beobachtungen nichts miteinander zu tun haben.
Der Standardfall ist die Welch-Variante, die ungleiche Varianzen zulässt. Sie kostet fast nichts an Schärfe, wenn die Varianzen tatsächlich gleich sind, und sie rettet das Ergebnis, wenn sie es nicht sind. Deshalb ist sie in R die Voreinstellung, und in Python wird sie mit correction=True angefordert. Ein vorgeschalteter Varianzvergleich zur Entscheidung zwischen den Varianten ist nicht nötig und verschlechtert die Fehlerkontrolle.
Verglichen wird die beobachtete Differenz der beiden Mittelwerte mit der Streuung, die man allein durch Zufall erwarten würde. Ist die Differenz gross gegenüber dieser Zufallsstreuung, spricht das gegen die Nullhypothese gleicher Erwartungswerte.
beobachtete Mittelwertdifferenz, die geschätzte Effektgrösse in der Einheit der Messung
\(s_1^2, s_2^2\)
Varianzen der beiden Gruppen
\(n_1, n_2\)
Gruppengrössen
Nenner
Standardfehler der Differenz
\(t\)
Differenz in Einheiten ihres eigenen Standardfehlers
Die Nullhypothese lautet, dass die beiden Erwartungswerte gleich sind. Unter ihr folgt \(t\) näherungsweise einer t-Verteilung. Bei der Welch-Variante werden die Freiheitsgrade aus den beiden Varianzen und Gruppengrössen berechnet und sind deshalb meist keine ganze Zahl.
Voraussetzungen und ihre Prüfung
Voraussetzung
Was sie bedeutet
Prüfung
Folge bei Verletzung
Vorgehen
Unabhängigkeit
Beobachtungen innerhalb und zwischen den Gruppen beeinflussen sich nicht
Erhebungsdesign
p-Werte zu optimistisch, das Verfahren ist nicht zu retten
passendes Modell für die Struktur, etwa gepaart oder Mehrebenen
Einzelne Werte bestimmen Mittelwert und Varianz nicht
Boxplot, Streudiagramm
Ergebnis hängt an wenigen Punkten
Ursache prüfen, robustes Verfahren, mit und ohne berichten
Gleiche Varianzen
Nur für die Student-Variante nötig
Boxplot, Varianzen vergleichen
Bei ungleichen Varianzen und ungleichen Gruppengrössen wird das Niveau verfehlt
Welch-Variante, also der Standardfall hier
Geprüft wird vor dem Test und mit den Augen, nicht mit einem zweiten Test. Ein Normalitätstest beantwortet die falsche Frage: bei kleinem n findet er auch grobe Abweichungen nicht, bei grossem n stört ihn jede belanglose Abweichung, obwohl gerade dort der zentrale Grenzwertsatz greift.
Output lesen
R, t.test():
Grösse
Was sie sagt
Faustregel oder Falle
Welch Two Sample t-test
die verwendete Variante
steht dort Two Sample t-test, wurde var.equal = TRUE gesetzt
t
Differenz in Einheiten ihres Standardfehlers
Betrag über etwa 2 heisst bei üblichem n signifikant
df
Freiheitsgrade
bei Welch meist keine ganze Zahl, das ist korrekt
p-value
Wahrscheinlichkeit dieser oder extremerer Daten bei gleichen Erwartungswerten
keine Aussage über die Grösse des Unterschieds
95 percent confidence interval
Intervall der Mittelwertdifferenz
die eigentlich interessante Zeile, in der Einheit der Messung
mean in group A, mean in group B
Gruppenmittelwerte
die Differenz daraus ist der Punktschätzer
alternative hypothesis
ein- oder zweiseitig
prüfen, dass nicht nachträglich einseitig getestet wurde
cohens_d
standardisierte Effektstärke
Anhaltspunkte: 0.2 klein, 0.5 mittel, 0.8 gross
Python, pg.ttest() liefert eine Tabelle mit einer Zeile:
Spalte
Was sie sagt
Unterschied zu R
T
t-Statistik
wie t
dof
Freiheitsgrade
wie df
alternative
Richtung der Alternativhypothese
wie in R
p_val
p-Wert
wie p-value
CI95
Konfidenzintervall der Differenz
in R eine eigene Zeile, hier ein Array in einer Zelle
cohen_d
Effektstärke
ohne Vorzeichen, R gibt sie vorzeichenbehaftet aus
power
erreichte Power für den beobachteten Effekt
in R nicht enthalten, und im Nachhinein nur eingeschränkt aussagekräftig
BF10
Bayes-Faktor
in R nicht enthalten; Werte über 3 gelten als Hinweis auf einen Unterschied
Die Schreibweise der Spalten hat sich mit pingouin 0.6 geändert: aus p-val, CI95% und cohen-d wurden p_val, CI95 und cohen_d. Code, der die alten Namen fest verdrahtet, bricht still oder mit KeyError. Auf dieser Seite fängt die Hilfsfunktion pg_wert() beide Schreibweisen ab.
Die Vorzeichen von t und Intervall hängen an der Reihenfolge der Gruppen. In R bestimmt die Faktorstufe die Reihenfolge, in Python die Reihenfolge der Argumente. Wer die Richtung berichtet, prüft sie am Vorzeichen und an den Gruppenmittelwerten.
Interpretationsfallen
Signifikanz ist keine Relevanz. Bei grossem n wird jeder noch so kleine Unterschied signifikant. Die Entscheidung fällt an der Differenz in ihrer Einheit und an der Effektstärke.
Nicht signifikant ist kein Beweis für Gleichheit. Wer Gleichheit zeigen will, braucht ein Äquivalenztestverfahren mit vorab festgelegter Toleranzgrenze.
[Zielgrösse] unterscheidet sich zwischen [Gruppe 1] (M = [Mittelwert], SD = [Streuung], n = [n1]) und [Gruppe 2] (M = [Mittelwert], SD = [Streuung], n = [n2]): Differenz [Schätzwert] [Einheit], 95-Prozent-Konfidenzintervall [unten] bis [oben], t([df]) = [t], p = [p], Cohens d = [d].
Immer genannt werden: beide Gruppenmittelwerte mit Streuung und Umfang, die Differenz mit Konfidenzintervall, Teststatistik mit Freiheitsgraden, p-Wert und Effektstärke, dazu die verwendete Variante (Welch oder Student) und die geprüften Voraussetzungen.
Eine Fertigung hat zwei Maschinen, die dasselbe Blechteil schneiden. Von jeder werden fünfzehn Teile vermessen, erfasst wird die Dicke in Millimetern. Die Frage lautet: Fertigen die beiden Maschinen im Mittel gleich dick, und falls nicht, wie gross ist der Unterschied?
Die Zielgrösse ist metrisch, es gibt genau zwei Gruppen, und die Teile stammen aus getrennten Läufen. Damit ist der t-Test für zwei unabhängige Stichproben das passende Verfahren.
Die Mittelwerte liegen bei 12.047 mm und 12.250 mm, die Standardabweichungen bei 0.164 mm und 0.246 mm. Maschine B streut also rund anderthalb Mal so stark, die Varianzen verhalten sich wie 1 zu 2.25. Genau dafür ist die Welch-Variante da: Der Unterschied in der Streuung wird nicht weggemittelt, sondern in den Freiheitsgraden berücksichtigt.
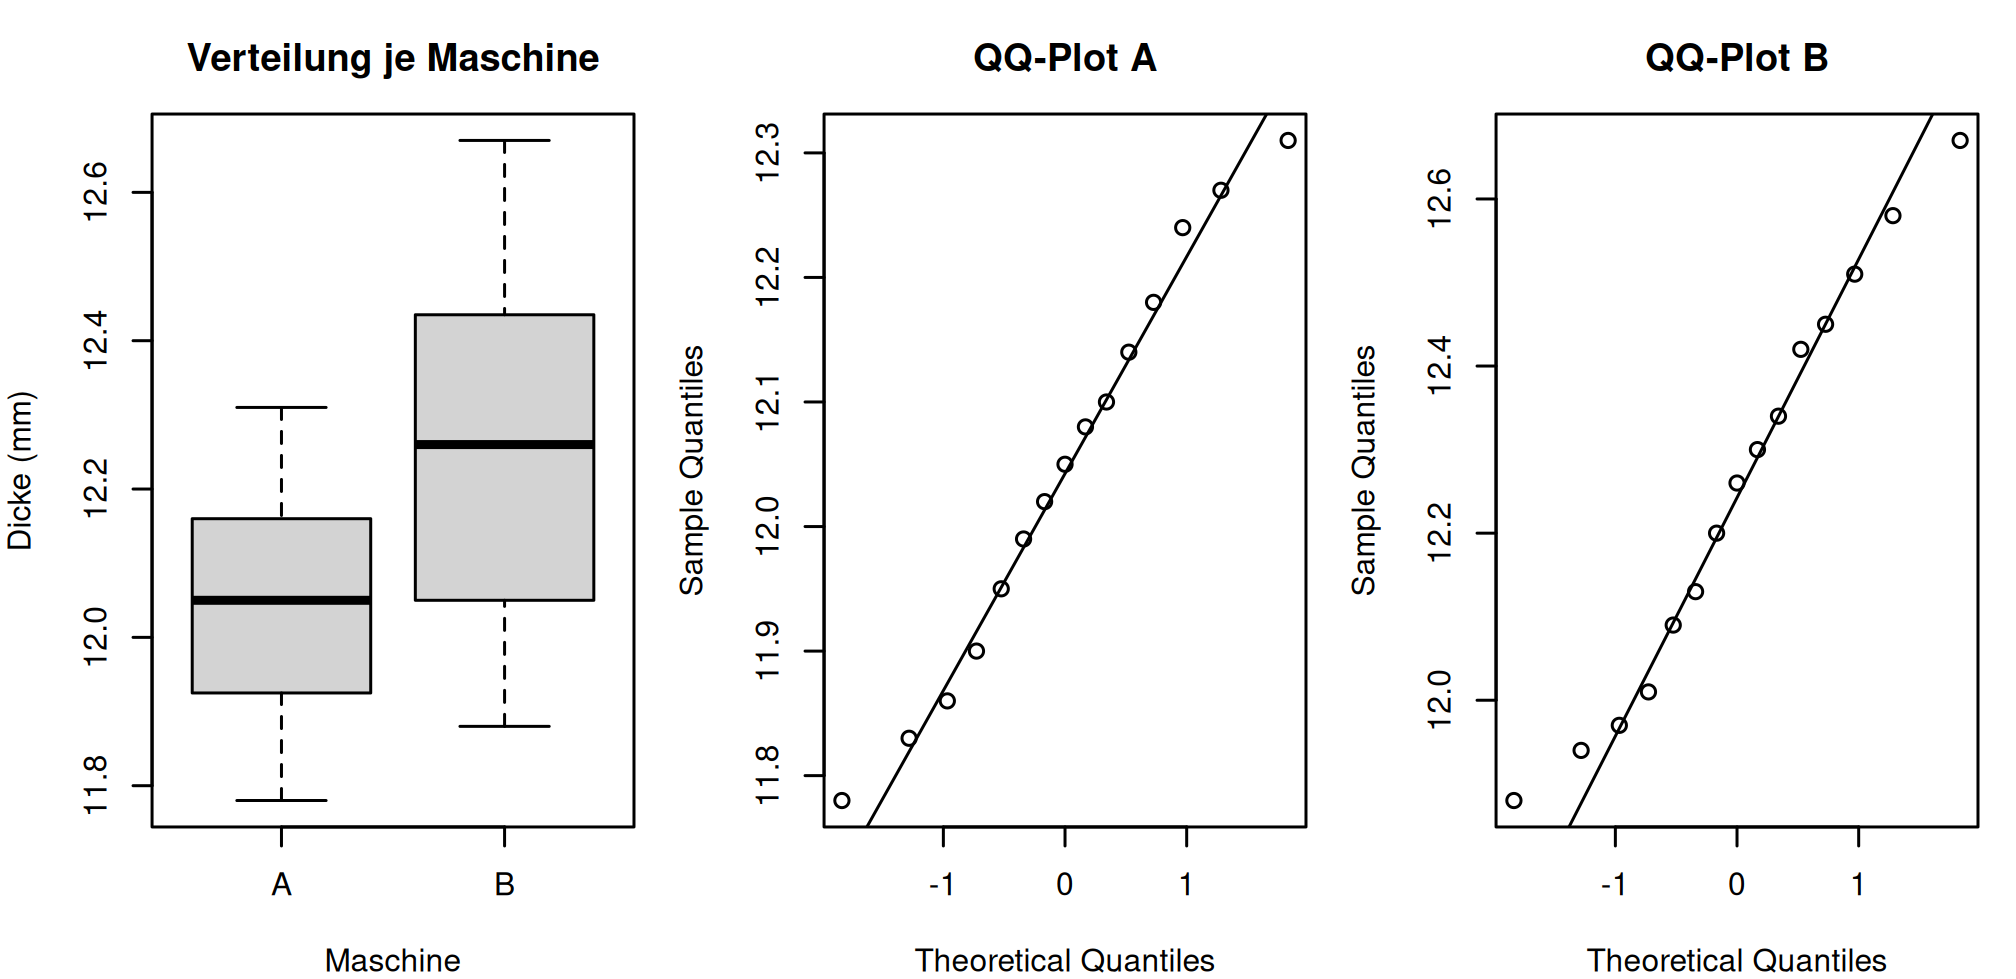
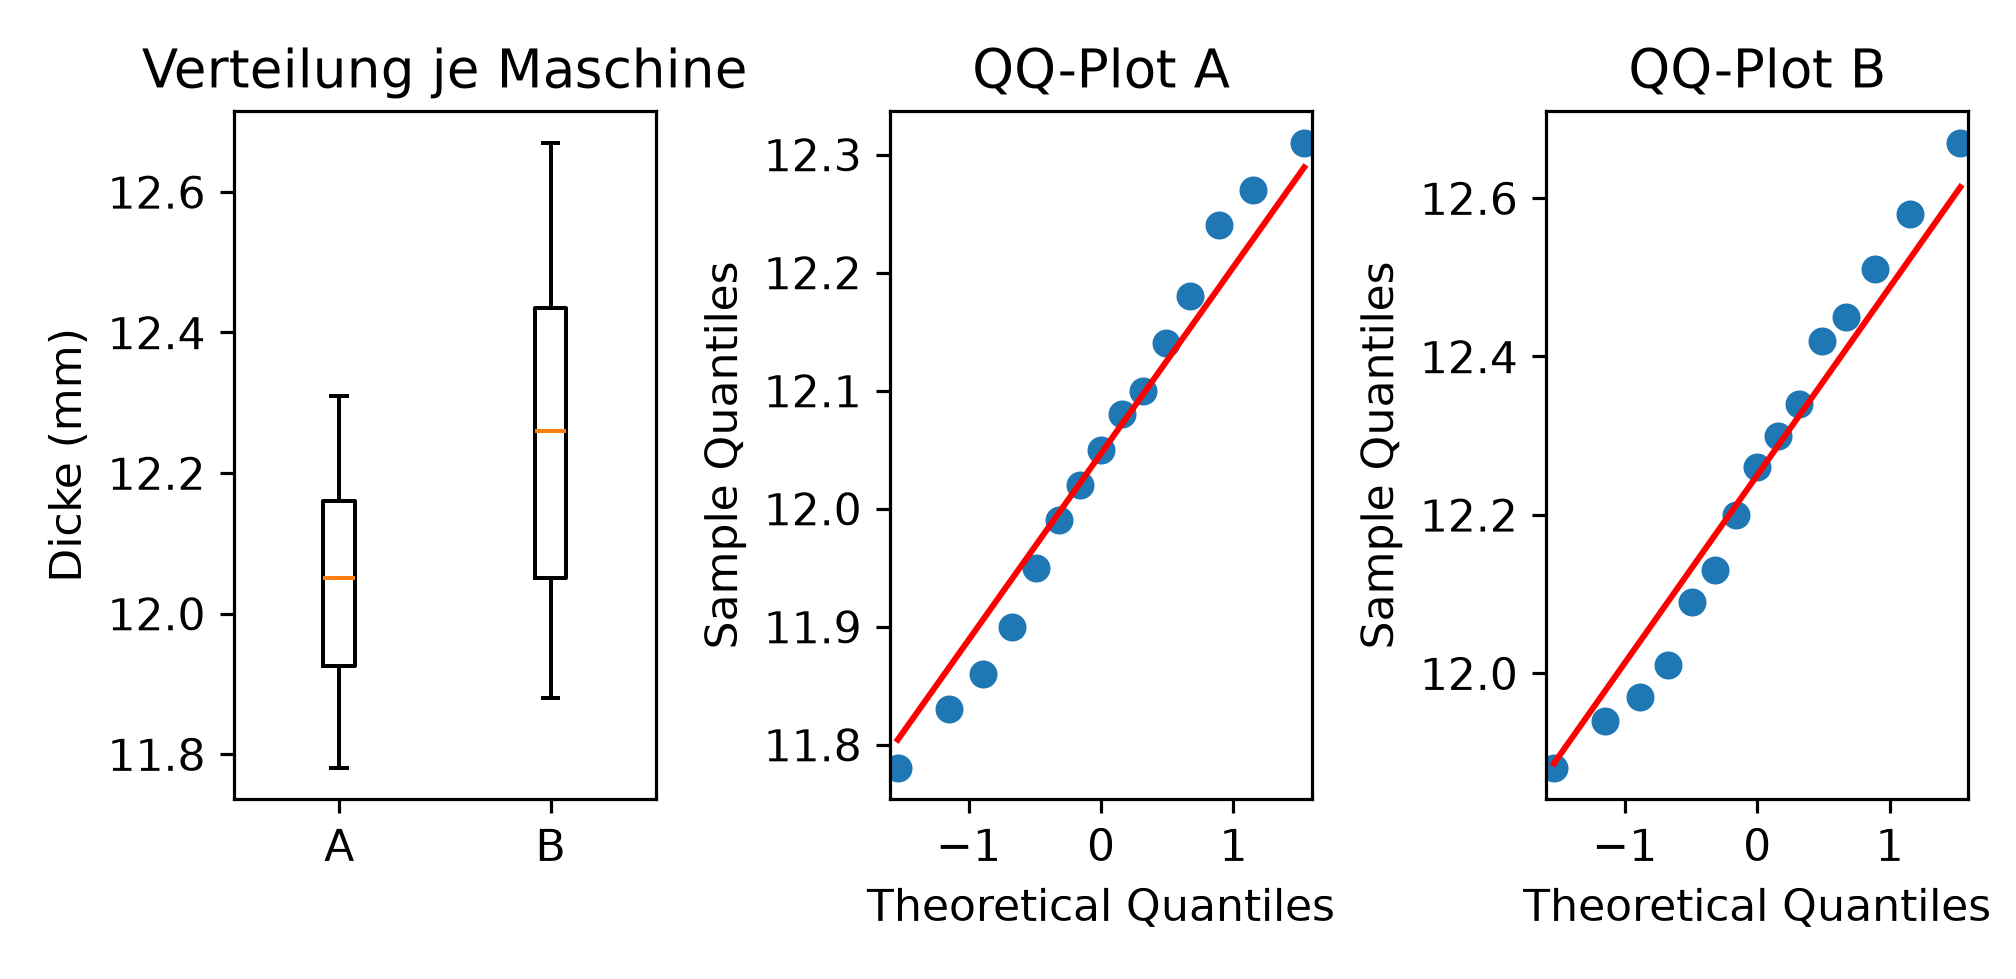
Die Boxplots zeigen zwei symmetrische Verteilungen ohne einzelne weit entfernte Punkte, und in beiden QQ-Plots liegen die Punkte nah an der Geraden. Die Voraussetzungen sind erfüllt.
    Welch Two Sample t-test

data:  wert by maschine
t = -2.6691, df = 24.385, p-value = 0.01332
alternative hypothesis: true difference in means between group A and group B is not equal to 0
95 percent confidence interval:
 -0.36043130 -0.04623536
sample estimates:
mean in group A mean in group B
       12.04667        12.25000
effectsize::cohens_d(wert ~ maschine, data = dicke)
Cohen's d |         95% CI
--------------------------
-0.97     | [-1.73, -0.21]

- Estimated using pooled SD.
Stünde dort Two Sample t-test, wäre versehentlich var.equal = TRUE gesetzt.
t
-2.669
Die Differenz ist 2.67 Standardfehler von null entfernt.
Das Vorzeichen ist negativ, weil A minus B gerechnet wird und A dünner fertigt. Es sagt nichts über die Stärke aus.
df
24.385
Freiheitsgrade nach Welch
Keine ganze Zahl, und das ist richtig so. Bei 15 und 15 Werten läge die Student-Variante bei glatten 28; Welch zieht wegen der ungleichen Varianzen etwas ab.
p-value
0.0133
Wahrscheinlichkeit, eine mindestens so grosse Differenz zu sehen, wenn beide Maschinen im Mittel gleich dick fertigen
Unter 0.05, also spricht das Ergebnis gegen die Nullhypothese. Es ist nicht die Wahrscheinlichkeit, dass die Maschinen gleich sind.
95 percent confidence interval
-0.360 bis -0.046
Bereich plausibler Werte für die Mittelwertdifferenz in Millimetern
Die interessanteste Zeile. Das Intervall enthält die Null nicht, und es sagt zugleich, dass der Unterschied irgendwo zwischen 0.05 mm und 0.36 mm liegt. Genauer wissen wir es bei fünfzehn Teilen je Maschine nicht.
mean in group A
12.047
Mittelwert Maschine A
mean in group B
12.250
Mittelwert Maschine B
Differenz 0.203 mm, das ist der Punktschätzer und die Mitte des Intervalls.
alternative hypothesis
not equal to 0
zweiseitig getestet
Beide Richtungen waren zugelassen, die Richtung wurde nicht nachträglich gewählt.
Cohen's d
-0.97
Differenz in Einheiten der gemeinsamen Streuung
Nach den üblichen Anhaltspunkten (0.2 klein, 0.5 mittel, 0.8 gross) ein grosser Effekt. Ein knapper p-Wert und ein grosser Effekt schliessen sich nicht aus: Der p-Wert hängt zusätzlich am Stichprobenumfang, die Effektstärke nicht.
power (nur Python)
0.731
Wahrscheinlichkeit, einen Effekt dieser Grösse bei diesem Umfang zu finden
Im Nachhinein berechnet und deshalb nur ein grober Hinweis. Geplant wird die Power vorab, siehe Power und Stichprobenumfang.
BF10 (nur Python)
4.30
Bayes-Faktor zugunsten eines Unterschieds
Die Daten sind rund viermal wahrscheinlicher unter der Annahme eines Unterschieds als unter der Annahme der Gleichheit. Ein moderater Hinweis, kein Beweis.
Der Vorzeichenvergleich zwischen den Sprachen: R gibt t = -2.669 und d = -0.97 aus, Python T = -2.669, aber cohen_d = 0.97 ohne Vorzeichen. pingouin berichtet den Betrag der Effektstärke. Die Richtung liest man an den Mittelwerten ab, nie am Vorzeichen von d allein.
Interpretation und Ergebnissatz
Praktisch bedeutsam ist nicht der p-Wert, sondern das Intervall. Läge die Toleranz der Fertigung bei 0.10 mm, dann wäre die Frage nicht beantwortet, sondern verschärft: Das Intervall reicht von 0.046 mm bis 0.360 mm und lässt Werte weit über der Toleranz zu. Läge die Toleranz bei 0.50 mm, wäre der Unterschied statistisch nachgewiesen und praktisch belanglos. Dieselbe Zahl, zwei gegenteilige Konsequenzen: Deshalb wird die Relevanzschwelle vor der Auswertung festgelegt.
Die gefertigte Dicke unterscheidet sich zwischen Maschine A (M = 12.047 mm, SD = 0.164, n = 15) und Maschine B (M = 12.250 mm, SD = 0.246, n = 15): Maschine A fertigt im Mittel 0.203 mm dünner, 95-Prozent-Konfidenzintervall 0.046 bis 0.360 mm, t(24.4) = -2.67, p = 0.013, Cohens d = -0.97 (Welch-Test, zweiseitig).
Frage und Datenlage
Dieselbe Fragestellung, aber nur zehn Teile je Maschine, und die Mittelwerte liegen diesmal nur sechs Hundertstel Millimeter auseinander. Das Beispiel zeigt, was ein nicht signifikantes Ergebnis aussagt und vor allem, was es nicht aussagt.
    Welch Two Sample t-test

data:  klein_a and klein_b
t = -0.78686, df = 15.057, p-value = 0.4436
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -0.2261825  0.1041825
sample estimates:
mean of x mean of y
   12.039    12.100
Die Differenz ist weniger als einen Standardfehler von null entfernt. Solche Abweichungen entstehen laufend rein zufällig.
df
15.057
Welch zieht hier von 18 möglichen Freiheitsgraden knapp drei ab, weil B rund anderthalb Mal so stark streut.
p-value
0.444
Weit über jedem üblichen Niveau. Die Daten sind mit gleichen Erwartungswerten gut vereinbar.
95 percent confidence interval
-0.226 bis 0.104
Die entscheidende Zeile. Das Intervall enthält die Null, reicht aber auf beiden Seiten weit über eine Toleranz von 0.10 mm hinaus.
cohen_d
0.35
Ein kleiner bis mittlerer Effekt wäre mit diesen Daten durchaus vereinbar.
power (nur Python)
rund 0.12
Bei diesem Umfang und diesem Effekt hätte der Test einen echten Unterschied nur in etwa einem von acht Fällen gefunden.
Interpretation und Ergebnissatz
Der häufigste Fehler an dieser Stelle ist der Satz “es gibt keinen Unterschied”. Die Daten sagen etwas anderes: Sie reichen nicht aus, um einen Unterschied nachzuweisen. Das Konfidenzintervall macht das sichtbar. Es lässt Abweichungen bis 0.23 mm in die eine und 0.10 mm in die andere Richtung zu, also genau den Bereich, der für die Fertigung interessant wäre.
Wer wirklich zeigen will, dass zwei Maschinen gleichwertig sind, braucht ein Äquivalenzverfahren mit vorab festgelegter Toleranz. Ein nicht signifikanter t-Test ist dafür kein Ersatz.
Die im Nachhinein berechnete Power beantwortet die Frage “wie wahrscheinlich wäre ein Fund gewesen” nur scheinbar, denn sie wird aus genau dem Effekt berechnet, den man gerade beobachtet hat. Nützlich ist sie vor der Erhebung, um den nötigen Umfang zu bestimmen.
Ein Unterschied in der gefertigten Dicke lässt sich nicht nachweisen (Welch-Test, t(15.1) = -0.79, p = 0.44, n = 10 je Maschine). Das 95-Prozent-Konfidenzintervall der Differenz reicht von -0.226 bis 0.104 mm und lässt Unterschiede in beide Richtungen zu; die Datenlage erlaubt keine Aussage über Gleichwertigkeit.
Frage und Datenlage
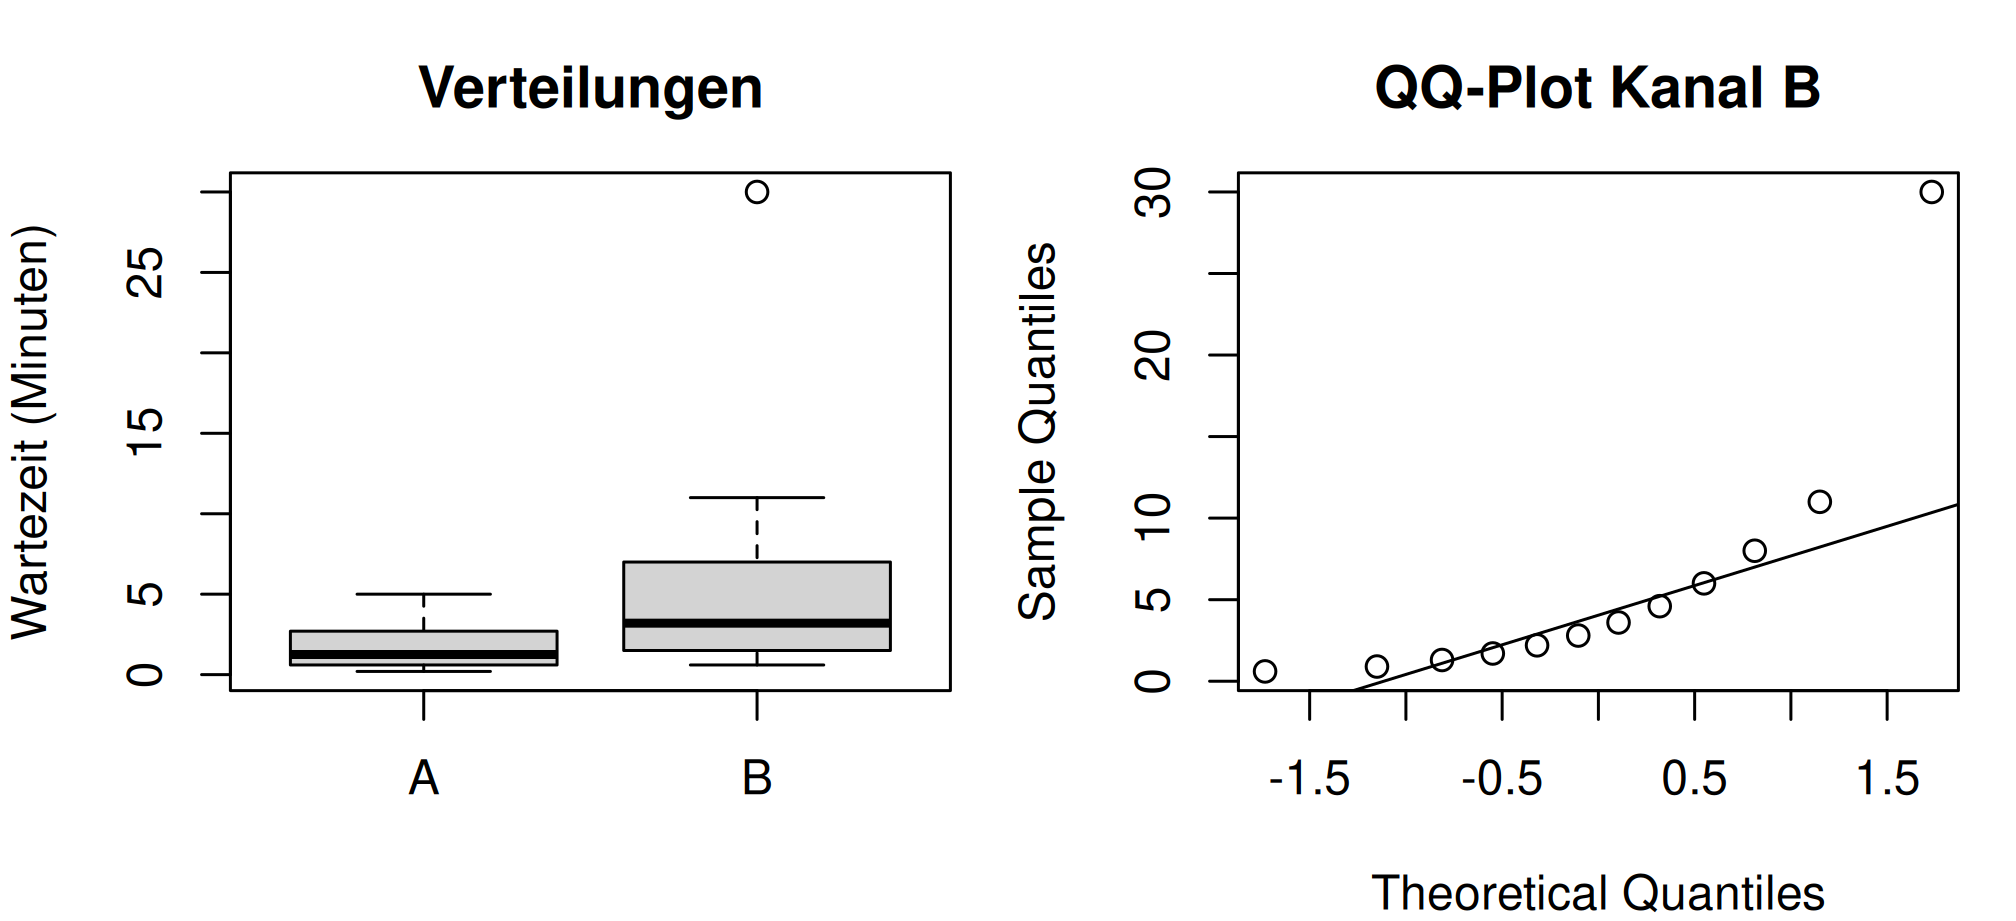
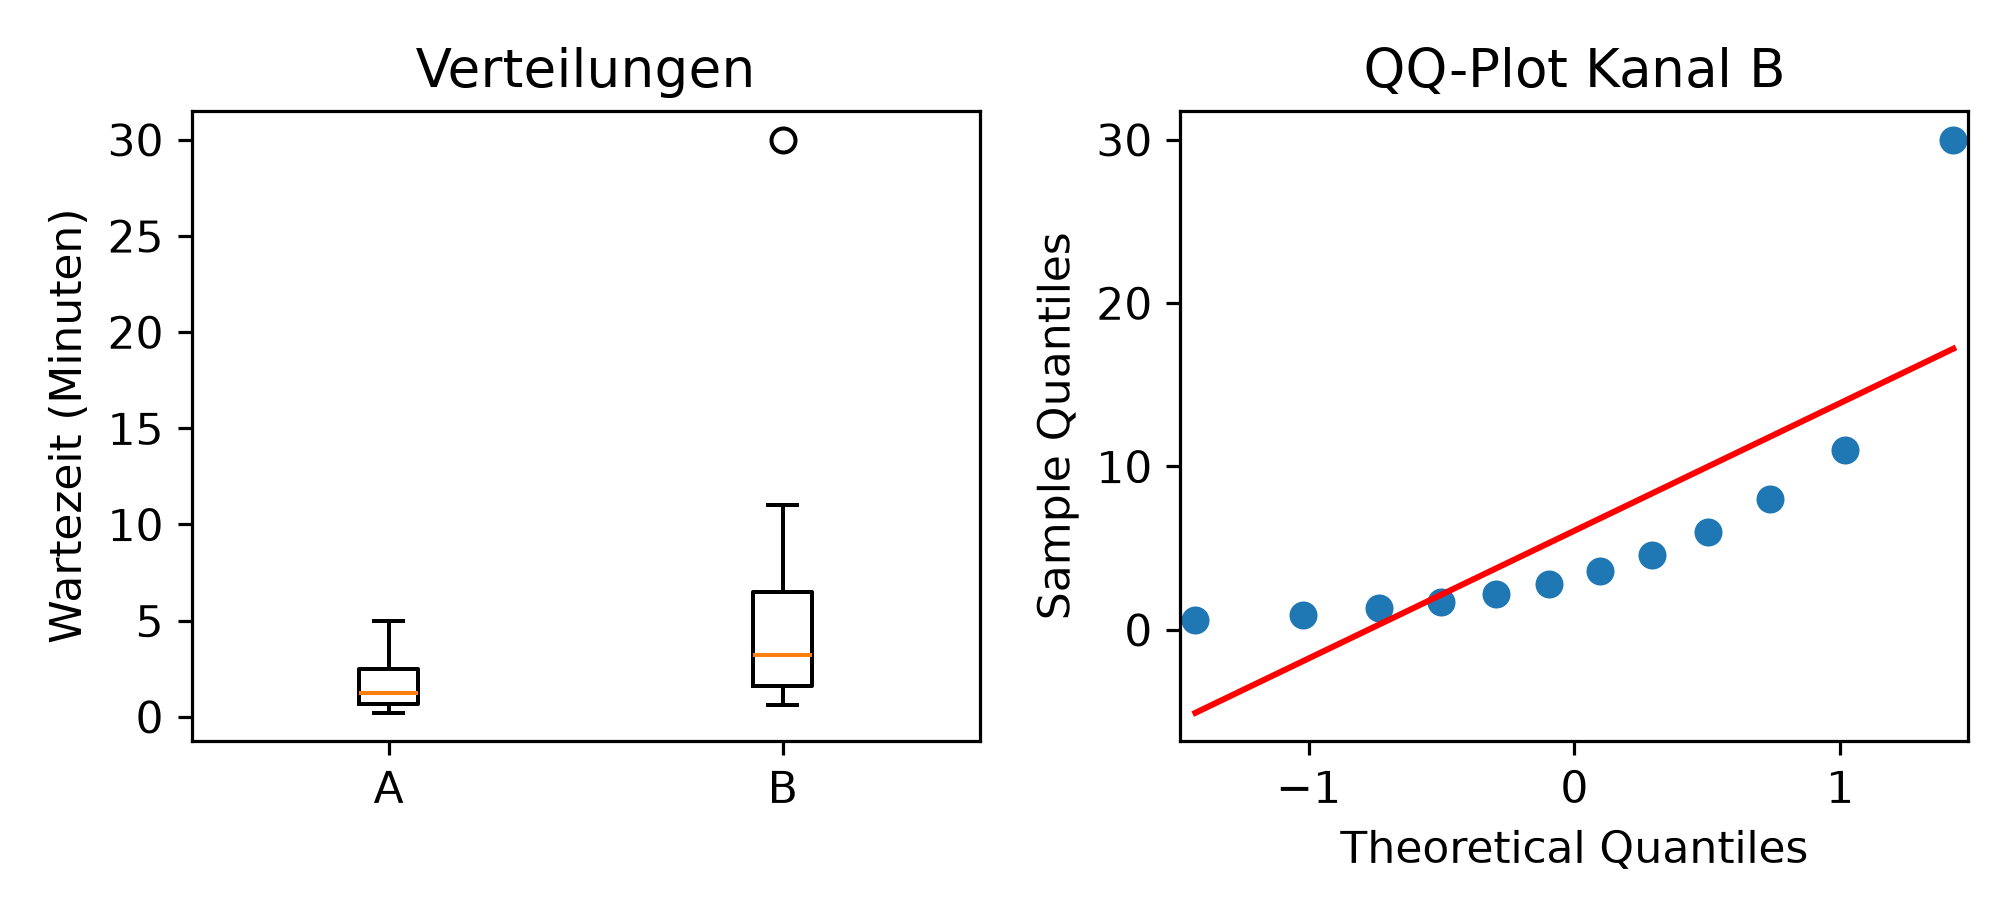
Ein Support vergleicht die Wartezeit bis zur ersten Antwort zwischen zwei Kanälen, je zwölf Anfragen, gemessen in Minuten. Wartezeiten sind fast immer rechtsschief: Viele Anfragen werden schnell beantwortet, wenige liegen lange liegen. Im Kanal B gibt es zusätzlich einen einzelnen Fall mit 30 Minuten.
Drei Befunde sprechen gegen den t-Test. Erstens klafft in Kanal B eine Lücke zwischen Mittelwert (6.06 Minuten) und Median (3.20 Minuten); der Mittelwert beschreibt hier keinen typischen Fall. Zweitens biegt der QQ-Plot am oberen Ende deutlich von der Geraden weg. Drittens beträgt die Standardabweichung in Kanal B 8.16 Minuten und damit mehr als der Mittelwert selbst, was fast immer auf einen dominierenden Einzelwert hindeutet. Bei zwölf Beobachtungen je Gruppe rettet der zentrale Grenzwertsatz das nicht mehr.
Rechnung
Gerechnet werden beide Verfahren nebeneinander, damit sichtbar wird, was auf dem Spiel steht.
    Welch Two Sample t-test

data:  kanal_a and kanal_b
t = -1.7764, df = 11.807, p-value = 0.1014
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -9.5001417  0.9751417
sample estimates:
mean of x mean of y
 1.795833  6.058333
wilcox.test(kanal_a, kanal_b)
    Wilcoxon rank sum exact test

data:  kanal_a and kanal_b
W = 37, p-value = 0.0449
alternative hypothesis: true location shift is not equal to 0
print("t-Test p =", round(pg_wert(pg.ttest(kanal_a, kanal_b, correction=True), "p-val"), 4))print("Mann-Whitney p =", round(pg_wert(pg.mwu(kanal_a, kanal_b), "p-val"), 4))
Output Zeile für Zeile
Ausgabe
Wert hier
Wie er zu lesen ist
t-Test t
-1.776
Die Differenz der Mittelwerte beträgt 4.26 Minuten, ihr Standardfehler aber 2.40 Minuten. Der Ausreisser hat den Nenner stärker aufgebläht als den Zähler.
t-Test df
11.807
Trotz 22 möglichen Freiheitsgraden bleiben knapp 12 übrig, weil B rund fünfmal so stark streut wie A.
t-Test p-value
0.101
Nicht signifikant.
t-Test Intervall
-9.50 bis 0.98 Minuten
So breit, dass es praktisch nichts ausschliesst.
Mann-Whitney W bzw. U_val
37
Die Rangstatistik, nicht in Minuten interpretierbar. In R heisst sie W, in pingouin U_val; gezählt wird gleich.
Mann-Whitney p-value
0.045 in R, 0.046 in Python
Knapp unter 0.05, also gegenteilige Entscheidung als beim t-Test. Die kleine Abweichung zwischen den Sprachen ist kein Fehler: R rechnet bei zwölf Werten ohne Bindungen die exakte Verteilung aus, pingouin verwendet die Normalapproximation.
Beide Tests rechnen mit denselben Daten und kommen zu verschiedenen Schlüssen. Der Rangtest sieht nur die Reihenfolge der Werte, und in der Reihenfolge liegt Kanal B durchgehend hinten. Der t-Test sieht dagegen die absoluten Abstände, und der Wert von 30 Minuten schlägt in der Streuung so stark durch, dass die Teststatistik einbricht.
Interpretation und Ergebnissatz
Entscheidend ist, dass die Wahl des Verfahrens vor dem Blick auf die p-Werte getroffen wird. Wer beide rechnet und nachträglich das passendere Ergebnis berichtet, hat kein Testniveau mehr, sondern eine Erzählung. Hier führen die Voraussetzungsprüfung und nichts anderes zum Rangtest.
ein Intervall für die Mittelwertdifferenz ohne Verteilungsannahme
Und in jedem Fall gehört der Ausreisser untersucht statt still entfernt: Ein Wert von 30 Minuten kann ein Erfassungsfehler sein, ein Feiertag oder genau der Fall, um den es eigentlich geht.
Wegen deutlich rechtsschiefer Verteilungen und eines Extremwerts bei kleinem Umfang wurde vorab rangbasiert verglichen. Die Wartezeit ist in Kanal B höher (Mann-Whitney, exakt, p = 0.045, n = 12 je Kanal; Median 1.25 gegenüber 3.20 Minuten). Auf einen Mittelwertvergleich wurde bewusst verzichtet.
Frage und Datenlage
Jetzt liegen aus jeder Maschine 5000 vermessene Teile vor, und der wahre Unterschied beträgt 0.03 mm, also weit unterhalb jeder Fertigungstoleranz. Um den Fall in beiden Sprachen exakt gleich zu halten, werden die Daten nicht zufällig gezogen, sondern als Quantile der Normalverteilung konstruiert. Beide Gruppen haben damit exakt dieselbe Streuung und unterscheiden sich um exakt 0.03 mm.
Ganzzahlig, weil beide Gruppen konstruktionsbedingt exakt dieselbe Varianz haben. Welch und Student fallen hier zusammen.
p-value
0.00018
Hochsignifikant.
Intervall
-0.046 bis -0.014 mm
Sehr eng. Der Unterschied ist präzise geschätzt und trotzdem winzig.
cohen_d
0.075
Weit unter dem Anhaltspunkt 0.2 für einen kleinen Effekt.
Interpretation und Ergebnissatz
Hier trennen sich statistische und praktische Bedeutung sauber. Der p-Wert misst, wie gut sich der Unterschied vom Zufall abheben lässt, und das hängt am Stichprobenumfang: Bei 5000 Teilen je Maschine wird auch ein Unterschied von drei Hundertstel Millimetern sichtbar. Cohens d und das Intervall in Millimetern messen dagegen, wie gross er ist, und diese Zahlen ändern sich mit dem Umfang nicht.
Der p-Wert allein reicht deshalb nie. Berichtet werden Differenz und Intervall in der Einheit der Messung, und die Relevanzschwelle steht vor der Auswertung fest.
Die Maschinen unterscheiden sich statistisch nachweisbar (Welch-Test, t(9998) = -3.75, p < 0.001, n = 5000 je Maschine). Der Unterschied beträgt 0.030 mm (95-Prozent-Konfidenzintervall 0.014 bis 0.046 mm, Cohens d = 0.08) und liegt damit weit unterhalb der Fertigungstoleranz; praktische Konsequenzen ergeben sich daraus nicht.
Verständnisfragen
Der Output zeigt df = 24.385. Ist das ein Fehler?
Nein, das ist die Welch-Korrektur
Richtig. Bei ungleichen Varianzen werden die Freiheitsgrade aus beiden Varianzen und Gruppengrössen geschätzt und sind dann keine ganze Zahl.
Ja, Freiheitsgrade sind immer ganzzahlig
Bei der Student-Variante ja, bei Welch nicht.
Ja, es fehlen Beobachtungen
Fehlende Werte würden die Gruppengrössen verringern, nicht zu Nachkommastellen führen.
In Beispiel 1 ist der p-Wert mit 0.013 knapp, Cohens d mit -0.97 aber gross. Wie passt das zusammen?
Der p-Wert hängt zusätzlich am Stichprobenumfang, die Effektstärke nicht
Richtig. Bei nur fünfzehn Teilen je Maschine ist der Standardfehler gross, also fällt der p-Wert knapp aus, obwohl der Unterschied gemessen an der Streuung erheblich ist.
Einer der beiden Werte muss falsch sein
Beide sind korrekt; sie messen Verschiedenes.
Ein grosses d erzwingt einen kleinen p-Wert
Nur bei festem Umfang. Mit wachsendem n sinkt der p-Wert, d bleibt gleich.
In Beispiel 3 liefert der t-Test p = 0.10 und der Rangtest p = 0.05. Wie wird entschieden?
Anhand der vorab geprüften Voraussetzungen, hier also rangbasiert
Richtig. Die Voraussetzungsprüfung entscheidet über das Verfahren, und zwar bevor irgendein p-Wert vorliegt.
Man berichtet den kleineren p-Wert
Das wäre eine Auswahl nach Ergebnis und zerstört die Fehlerkontrolle.
Man berichtet beide und überlässt die Wahl dem Leser
Beide zu zeigen ist als Sensitivitätsanalyse zulässig, aber das Hauptverfahren muss vorab benannt sein.
Zwei Gruppen mit je n = 2000 unterscheiden sich um 0.01 Einheiten, p < 0.001, Cohens d = 0.03. Was berichtet man?
Einen signifikanten Unterschied, das genügt
Es genügt nicht: der Leser erfährt nicht, dass der Unterschied praktisch bedeutungslos ist.
Den Unterschied mit Intervall und Effektstärke, samt Einordnung
Richtig. Der p-Wert zeigt nur, dass der Unterschied bei diesem Umfang vom Zufall unterscheidbar ist. Relevanz entscheidet die Grösse, hier praktisch null.
Gar nichts, das Ergebnis ist wertlos
Wertlos ist es nicht, es ist nur korrekt einzuordnen.
Vor dem Test wird ein Varianzvergleich gerechnet, und je nach dessen Ergebnis wird Student oder Welch gewählt. Was ist daran problematisch?
Die Entscheidung anhand derselben Daten verschlechtert die Fehlerkontrolle
Richtig. Das zweistufige Vorgehen hält das Niveau nicht ein. Welch grundsätzlich zu verwenden ist einfacher und in fast allen Lagen mindestens so gut.
Nichts, so ist es vorgesehen
Es war lange üblich und gilt heute als überholt.
Der Varianzvergleich ist zu konservativ
Das Problem liegt nicht in seiner Schärfe, sondern im datengetriebenen Wechsel des Verfahrens.
Das Konfidenzintervall der Differenz reicht von -0.05 bis 0.62 mm, die Toleranzgrenze der Fertigung liegt bei 0.10 mm. Was folgt?
Kein Unterschied, das Intervall enthält null
Formal nicht signifikant, aber die Aussage greift zu kurz.
Die Frage ist offen, und zwar in einem relevanten Bereich
Richtig. Das Intervall lässt Werte weit über der Toleranzgrenze zu. Nicht signifikant heisst hier nicht unbedenklich, sondern zu wenig Daten.
Der Unterschied liegt sicher unter der Toleranz
Das würde ein Intervall erfordern, das vollständig unterhalb von 0.10 liegt.