Konfusionsmatrix, Sensitivität, ROC und AUC richtig lesen.
Alle Beispiele rechnen mit deterministisch konstruierten Daten, damit R und Python dieselben Zahlen sehen. Die Hilfsfunktionen auc() und guete() stehen im Setup-Chunk und sind in beiden Sprachen gleich aufgebaut.
Kurzsteckbrief
Fragestellung
Wie gut trennt ein Modell zwei Klassen, und wie gut ist es für eine konkrete Entscheidung?
Eingang
vorhergesagte Wahrscheinlichkeiten oder Scores und die tatsächliche Klasse
Immer dann, wenn ein Modell eine binäre Zielgrösse vorhersagt und die Vorhersagen zu einer Entscheidung führen sollen. Die Bewertung zerfällt in zwei getrennte Fragen, die oft vermischt werden:
Frage
Womit beantwortet
Hängt von der Schwelle ab?
Wie gut trennt das Modell überhaupt?
ROC-Kurve, AUC
nein
Wie gut ist die Entscheidung bei dieser Schwelle?
Konfusionsmatrix und alles daraus
ja
Ein Modell mit hoher AUC kann bei einer schlecht gewählten Schwelle unbrauchbare Entscheidungen liefern, und umgekehrt sagt eine gute Konfusionsmatrix nichts darüber, ob eine andere Schwelle besser wäre.
Aus einer Schwelle und den vorhergesagten Wahrscheinlichkeiten entstehen vier Zahlen:
tatsächlich 1
tatsächlich 0
vorhergesagt 1
richtig positiv (TP)
falsch positiv (FP)
vorhergesagt 0
falsch negativ (FN)
richtig negativ (TN)
Alle Kennzahlen sind Verhältnisse aus diesen vier Zahlen. Entscheidend ist, in welche Richtung geteilt wird:
Kennzahl
Formel
Frage, die sie beantwortet
Genauigkeit
\((TP+TN)/n\)
Wie viele Fälle wurden richtig eingeordnet?
Sensitivität, Recall
\(TP/(TP+FN)\)
Von den tatsächlichen Ereignissen: wie viele wurden gefunden?
Spezifität
\(TN/(TN+FP)\)
Von den tatsächlichen Nicht-Ereignissen: wie viele wurden richtig durchgelassen?
PPV, Precision
\(TP/(TP+FP)\)
Von den Alarmen: wie viele waren echt?
NPV
\(TN/(TN+FN)\)
Von den Entwarnungen: wie viele waren richtig?
F1
harmonisches Mittel aus PPV und Sensitivität
ein Kompromiss zwischen Finden und Treffen
Sensitivität und PPV sehen ähnlich aus und verhalten sich völlig verschieden.Sensitivität teilt durch die tatsächlichen Ereignisse, PPV durch die Alarme. Die Sensitivität ist deshalb von der Häufigkeit des Ereignisses unabhängig, der PPV nicht. Bei seltenen Ereignissen bricht der PPV ein, obwohl Sensitivität und Spezifität unverändert gut bleiben. Das ist der Inhalt von Beispiel 2 und der häufigste Fehlschluss in diesem Gebiet.
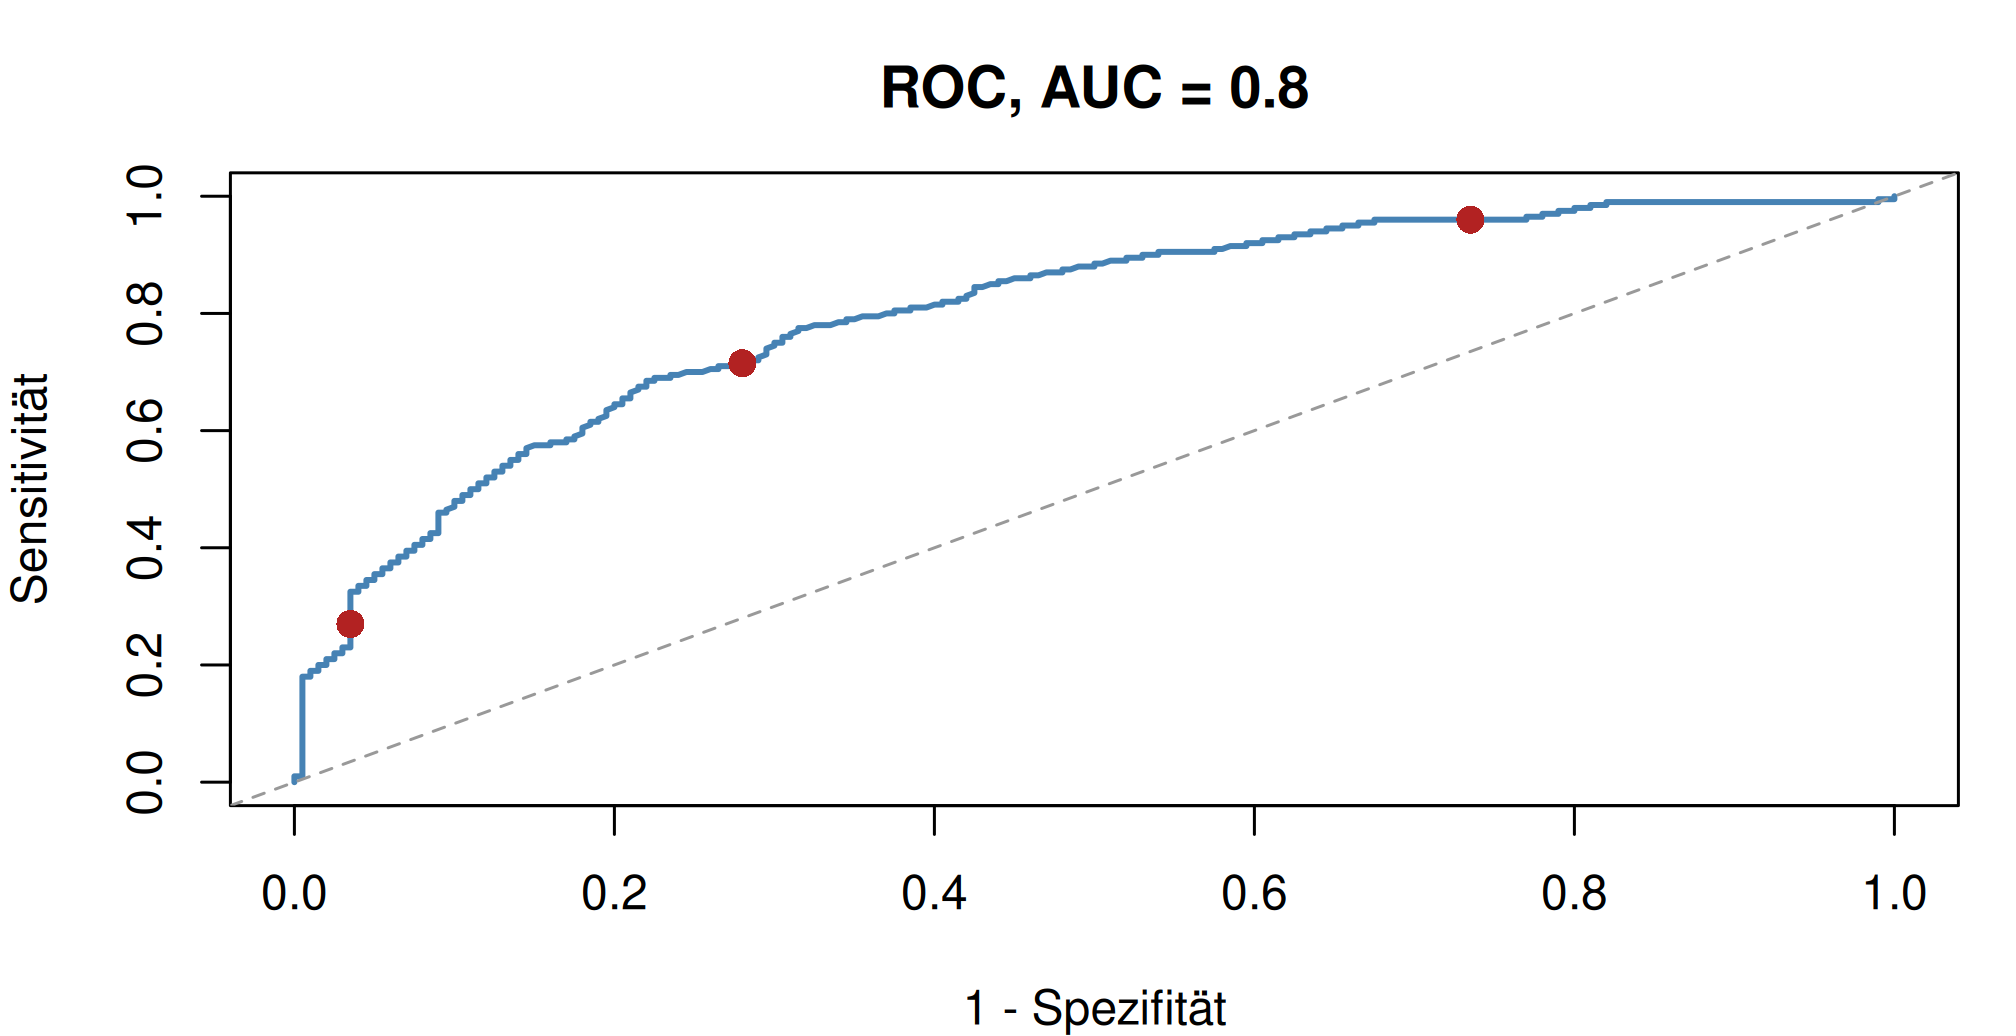
Die ROC-Kurve entsteht, indem die Schwelle von 1 bis 0 durchlaufen wird und für jede Sensitivität gegen 1 minus Spezifität aufgetragen wird. Die Fläche darunter, die AUC, hat eine anschauliche Bedeutung: Sie ist die Wahrscheinlichkeit, dass ein zufällig gewählter positiver Fall einen höheren Score bekommt als ein zufällig gewählter negativer. Bei 0.5 ist das Modell so gut wie Münzwurf, bei 1.0 trennt es perfekt.
Daraus folgt auch, wie sich die AUC ohne Zusatzpaket berechnen lässt: Sie ist die Mann-Whitney-U-Statistik geteilt durch die Anzahl aller Paarvergleiche, siehe nichtparametrische Tests.
Output lesen
Kennzahl
Anhaltspunkt
Falle
Genauigkeit
keiner, sie hängt an der Klassenverteilung
Bei 2 Prozent Ereignisanteil erreicht “immer nein” 98 Prozent
Sensitivität
je nach Anwendung
steigt immer, wenn die Schwelle sinkt
Spezifität
je nach Anwendung
steigt immer, wenn die Schwelle steigt
PPV
hängt an der Häufigkeit des Ereignisses
nicht zwischen Studien mit verschiedener Häufigkeit vergleichbar
F1
für unausgewogene Klassen brauchbarer als Genauigkeit
ignoriert die richtig negativen Fälle vollständig
AUC
0.5 ist Zufall, 0.7 bis 0.8 brauchbar, über 0.9 sehr gut
sagt nichts über die Kalibrierung und nichts über eine konkrete Schwelle
Interpretationsfallen
Genauigkeit ist bei seltenen Ereignissen wertlos. Sie wird von der häufigen Klasse dominiert.
PPV lässt sich nicht zwischen Anwendungen vergleichen. Er hängt an der Häufigkeit des Ereignisses, nicht nur an der Güte des Modells.
Eine hohe AUC bedeutet nicht, dass die Wahrscheinlichkeiten stimmen. Ein Modell kann perfekt trennen und trotzdem durchweg zu hohe Werte ausgeben. Trennschärfe und Kalibrierung sind zwei Eigenschaften.
Sensitivität und Spezifität lassen sich nicht gleichzeitig maximieren. Jede Schwellenverschiebung tauscht das eine gegen das andere.
An denselben Daten gemessen sind alle Kennzahlen zu gut, siehe Beispiel 4.
Die Schwelle 0.5 ist eine Konvention. Sie unterstellt gleich teure Fehler.
F1 ignoriert die richtig negativen Fälle. Bei Anwendungen, in denen korrekte Entwarnungen zählen, ist er das falsche Mass.
Ergebnis berichten
Vorlage:
Bei einer Schwelle von [Wert] erkennt das Modell [TP] der [TP+FN] Ereignisse (Sensitivität [Wert]) und stuft [FP] der [FP+TN] Nicht-Ereignisse falsch ein (Spezifität [Wert]). Von [TP+FP] Alarmen sind [TP] echt (PPV [Wert]). Die AUC beträgt [Wert], gemessen auf [Trainings- oder Testdaten].
Immer genannt werden: die Schwelle, die absolute Konfusionsmatrix, mindestens Sensitivität und PPV, die AUC, und auf welchen Daten gemessen wurde. Der letzte Punkt fehlt am häufigsten und entwertet die Angabe, wenn er fehlt.
400 Fälle, davon 200 mit Ereignis. Ein Modell sagt aus einem Merkmal die Wahrscheinlichkeit vorher. Bei der üblichen Schwelle von 0.5 entsteht die Konfusionsmatrix.
modell <-glm(ereignis ~ merkmal, family = binomial, data = daten)score <-predict(modell, type ="response")vorhersage <-as.integer(score >0.5)table(tatsaechlich = daten$ereignis, vorhergesagt = vorhersage)
Rund 72 Prozent aller Fälle richtig eingeordnet. Hier aussagekräftig, weil beide Klassen gleich häufig sind; in Beispiel 2 ist sie es nicht.
Sensitivität
0.7150
143/200
Von den 200 tatsächlichen Ereignissen wurden 143 gefunden, 57 übersehen.
Spezifität
0.7200
144/200
Von den 200 Nicht-Ereignissen wurden 144 richtig durchgelassen, 56 fälschlich alarmiert.
PPV
0.7186
143/199
Von den 199 Alarmen waren 143 echt.
NPV
0.7164
144/201
Von den 201 Entwarnungen waren 144 richtig.
F1
0.7168
harmonisches Mittel aus PPV und Sensitivität
Fasst Finden und Treffen zusammen, ignoriert aber die 144 richtigen Entwarnungen.
AUC
0.8004
Rangsumme der positiven Fälle
Greift man je einen zufälligen positiven und negativen Fall heraus, hat der positive in 80 Prozent der Fälle den höheren Score.
Dass hier alle fünf Verhältniszahlen um 0.72 liegen, ist kein Zufall, sondern eine Folge der ausgewogenen Klassen: Bei gleich vielen Ereignissen und Nicht-Ereignissen fallen Sensitivität und PPV zusammen. Beispiel 2 zeigt, was passiert, wenn das nicht so ist.
Interpretation und Ergebnissatz
Bei einer Schwelle von 0.5 erkennt das Modell 143 der 200 Ereignisse (Sensitivität 0.72) und stuft 56 der 200 Nicht-Ereignisse falsch ein (Spezifität 0.72). Von 199 Alarmen sind 143 echt (PPV 0.72). Die AUC beträgt 0.80, gemessen auf den Schätzdaten.
Frage und Datenlage
2000 Fälle, davon 40 mit Ereignis, also 2 Prozent. Ein Prüfverfahren erkennt 90 Prozent der Ereignisse (Sensitivität 0.90) und lässt 90 Prozent der Nicht-Ereignisse richtig durch (Spezifität 0.90). Beide Werte gelten gemeinhin als gut.
Die Frage lautet: Wenn das Verfahren Alarm schlägt, wie wahrscheinlich ist das Ereignis dann tatsächlich?
TP                  0.00
FP                  0.00
FN                 40.00
TN               1960.00
Genauigkeit         0.98
Sensitivitaet       0.00
Spezifitaet         1.00
PPV                  NaN
NPV                 0.98
F1                   NaN
dtype: float64
Output Zeile für Zeile
kein Alarm
Alarm
kein Ereignis
1764
196
Ereignis
4
36
Kennzahl
Wert hier
Wie er zu lesen ist
Sensitivität
0.900
Wie versprochen: 36 der 40 Ereignisse gefunden.
Spezifität
0.900
Ebenfalls wie versprochen: 1764 der 1960 richtig durchgelassen.
Genauigkeit
0.900
Sieht gut aus und ist wertlos, siehe unten.
PPV
0.155
Der eigentliche Befund. Von 232 Alarmen sind nur 36 echt. In 85 Prozent der Fälle ist der Alarm falsch.
NPV
0.998
Eine Entwarnung ist dagegen fast immer richtig.
F1
0.265
Bricht mit dem PPV ein, weil er ihn zur Hälfte enthält.
Genauigkeit bei “immer nein”
0.980
Wer schlicht nie Alarm schlägt, erreicht 98 Prozent Genauigkeit und damit mehr als das Prüfverfahren.
Warum der PPV einbricht, obwohl das Verfahren gut ist. Die 10 Prozent Fehlalarme beziehen sich auf 1960 Nicht-Ereignisse und ergeben 196 falsche Alarme. Die 90 Prozent Treffer beziehen sich auf 40 Ereignisse und ergeben 36 echte. Die falschen Alarme kommen aus einer 49-mal grösseren Grundmenge und überwiegen deshalb, obwohl ihre Rate niedriger ist.
Daraus folgt eine Faustregel: Bei seltenen Ereignissen braucht ein brauchbarer PPV eine sehr hohe Spezifität. Um hier auf einen PPV von 0.5 zu kommen, müsste die Spezifität auf 0.982 steigen, also die Fehlalarmrate von 10 auf 1.8 Prozent fallen.
Interpretation und Ergebnissatz
Zwei Konsequenzen für die Praxis. Erstens gehört die Genauigkeit bei unausgewogenen Klassen gar nicht erst in den Bericht; sie beschreibt hier nur, wie selten das Ereignis ist. Zweitens ist der PPV die Zahl, die für die betroffene Person zählt: Nicht “das Verfahren erkennt 90 Prozent”, sondern “wenn es anschlägt, liegt es in 85 Prozent der Fälle falsch”.
Deshalb ist ein PPV auch nicht zwischen Anwendungen übertragbar. Dasselbe Verfahren, angewendet auf eine Gruppe mit 20 statt 2 Prozent Ereignisanteil, käme auf einen PPV von 0.69.
Bei einer Häufigkeit von 2 Prozent erkennt das Verfahren 36 der 40 Ereignisse (Sensitivität 0.90) bei 196 Fehlalarmen unter 1960 Nicht-Ereignissen (Spezifität 0.90). Von 232 Alarmen sind 36 echt (PPV 0.155). Die Genauigkeit von 0.90 ist hier nicht aussagekräftig: Ein Verfahren, das nie Alarm schlägt, erreicht 0.98.
Frage und Datenlage
Die Daten aus Beispiel 1. Die Frage lautet: Was ändert sich, wenn die Schwelle verschoben wird, und wie beurteilt man das Modell unabhängig davon?
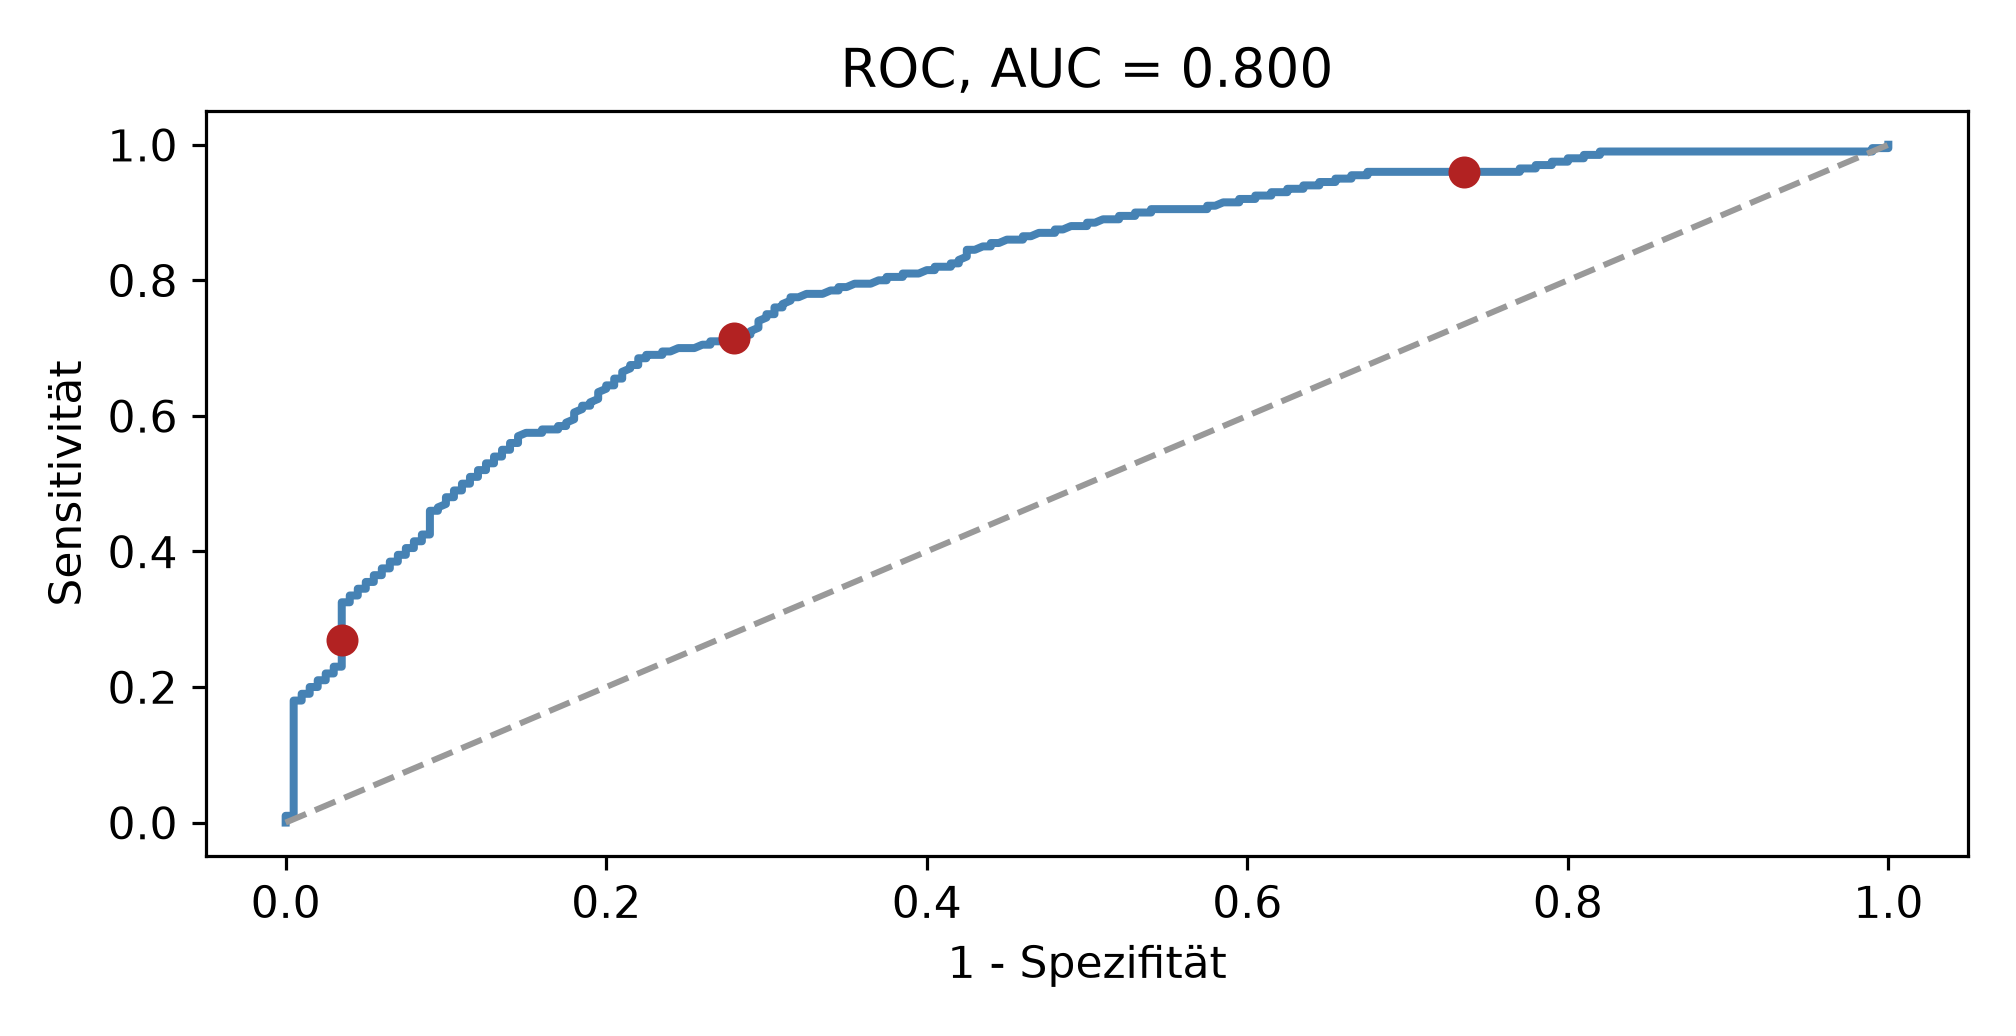
Abbildung 2: Beispiel 3: dieselbe Kurve in Python.
for s in (0.2, 0.35, 0.5, 0.65, 0.8): k = guete(daten["ereignis"], (score > s).astype(int))print(f"Schwelle {s}: Sens={k['Sensitivitaet']:.4f} "f"Spez={k['Spezifitaet']:.4f} PPV={k['PPV']:.4f} F1={k['F1']:.4f}")
Sensitivität und Spezifität bewegen sich gegenläufig. Von 0.20 auf 0.80 fällt die Sensitivität von 0.96 auf 0.27, während die Spezifität von 0.27 auf 0.97 steigt. Es gibt keine Schwelle, die beide gleichzeitig verbessert; jede Verschiebung ist ein Tausch.
Der PPV steigt mit der Schwelle. Wer selten Alarm schlägt, hat unter seinen Alarmen einen höheren Anteil echter Fälle. Von 0.57 auf 0.89, und das ist der Grund, warum ein hoher PPV allein kein Gütezeichen ist: Er lässt sich immer erkaufen, indem man weniger oft Alarm schlägt.
F1 ist bei 0.35 am höchsten, nicht bei 0.5. Wer nach F1 optimiert, landet also nicht bei der Voreinstellung. Ob F1 das richtige Kriterium ist, entscheidet die Anwendung.
Die AUC von 0.80 bleibt bei all dem unverändert, denn sie fasst die ganze Kurve zusammen. Sie beantwortet die Frage “wie gut trennt das Modell”, die Tabelle beantwortet die Frage “wie gut entscheidet es bei dieser Schwelle”.
Interpretation und Ergebnissatz
Das Modell trennt die beiden Klassen brauchbar (AUC 0.80). Bei einer Schwelle von 0.5 liegen Sensitivität und Spezifität bei je 0.72. Eine Senkung auf 0.35 erhöht die Sensitivität auf 0.87 zulasten der Spezifität (0.52) und maximiert F1 (0.74). Die Wahl richtet sich nach dem Kostenverhältnis der beiden Fehlerarten.
Frage und Datenlage
Die 400 Fälle werden geteilt: 200 zum Schätzen, 200 zum Prüfen. Verglichen werden zwei Modelle. Das eine nutzt nur das echte Merkmal, das andere zusätzlich zwanzig Merkmale, die nichts mit dem Ereignis zu tun haben.
Die Frage lautet: Welches Modell ist besser, und woran erkennt man das?
sparsam   AUC Training = 0.8096   AUC Test = 0.7911
          Genauigkeit Training = 0.7200   Test = 0.7150
vergleich(ueppig, "üppig")
üppig    AUC Training = 0.8886   AUC Test = 0.7388
          Genauigkeit Training = 0.8050   Test = 0.6850
Output Zeile für Zeile
Modell
AUC Training
AUC Test
Genauigkeit Training
Genauigkeit Test
nur das echte Merkmal
0.810
0.791
0.720
0.715
plus 20 wertlose Merkmale
0.889
0.739
0.805
0.685
Das üppige Modell ist auf den Trainingsdaten deutlich besser (AUC 0.889 gegen 0.810) und auf neuen Daten deutlich schlechter (0.739 gegen 0.791). Die zwanzig Zusatzmerkmale enthalten keinerlei Information über das Ereignis; sie sind deterministisch konstruiertes Rauschen. Das Modell hat gelernt, die zufälligen Muster der 200 Trainingsfälle nachzubilden.
Bemerkenswert ist auch die Grösse des Unterschieds beim sparsamen Modell: 0.810 gegen 0.791. Auch ein Modell mit zwei Parametern misst sich an den eigenen Daten etwas zu gut, nur eben wenig. Der Abstand zwischen Trainings- und Testwert wächst mit der Anzahl der Parameter.
Interpretation und Ergebnissatz
Daraus folgen zwei Regeln.
Jede berichtete Kennzahl braucht die Angabe, worauf sie gemessen wurde. Eine AUC von 0.89 ohne diesen Zusatz ist wertlos, weil sie an denselben Daten gemessen sein kann, mit denen das Modell gebaut wurde.
Modelle werden nicht an den Trainingsdaten verglichen. Wer das tut, wählt systematisch das komplexere Modell, denn mehr Parameter passen sich den vorliegenden Daten immer besser an. Der saubere Weg ist eine Trennung in Trainings- und Testdaten oder eine Kreuzvalidierung; für kleine Datensätze leisten AIC und BIC dasselbe auf rechnerischem Weg, siehe Modellauswahl.
Verglichen wurden zwei Modelle an einer Aufteilung in je 200 Trainings- und Testfälle. Das sparsame Modell erreicht auf den Testdaten eine AUC von 0.791, das um zwanzig wertlose Merkmale erweiterte nur 0.739, obwohl es auf den Trainingsdaten besser abschneidet (0.889 gegen 0.810). Berichtet werden die Testwerte des sparsamen Modells.
Verständnisfragen
Ein Prüfverfahren hat Sensitivität 0.90 und Spezifität 0.90. Das Ereignis tritt bei 2 Prozent auf. Wie oft liegt ein Alarm richtig?
In rund 15 Prozent der Fälle
Richtig. Die 10 Prozent Fehlalarme beziehen sich auf 98 Prozent der Fälle und ergeben viel mehr falsche als echte Alarme. Der PPV beträgt 0.155.
In 90 Prozent der Fälle
Das ist die Sensitivität, und die beantwortet die umgekehrte Frage: Von den Ereignissen, wie viele werden gefunden?
In 98 Prozent der Fälle
Das ist die Genauigkeit eines Verfahrens, das nie Alarm schlägt.
Ein Modell erreicht eine Genauigkeit von 0.98. Was folgt daraus?
Nichts, ohne die Klassenverteilung zu kennen
Richtig. Bei einem Ereignisanteil von 2 Prozent erreicht “immer nein” genau diesen Wert. Die Genauigkeit muss immer gegen diesen trivialen Vergleichswert gehalten werden.
Das Modell ist sehr gut
Nur wenn die Klassen einigermassen ausgewogen sind.
Das Modell ist überangepasst
Dafür bräuchte es einen Vergleich zwischen Trainings- und Testdaten.
Ein Modell hat auf den Trainingsdaten eine AUC von 0.89 und auf Testdaten 0.74, ein zweites 0.81 und 0.79. Welches ist besser?
Das zweite
Richtig. Entschieden wird an den Testdaten, und dort liegt das zweite vorn. Der grosse Abstand zwischen Trainings- und Testwert beim ersten ist das Kennzeichen der Überanpassung.
Das erste, es hat die höhere AUC
Die höhere AUC hat es nur auf den Daten, mit denen es gebaut wurde. Das ist kein Gütezeichen, sondern das erwartete Verhalten.
Beide gleich gut, die Unterschiede sind klein
0.74 gegen 0.79 ist ein spürbarer Unterschied, und die Richtung ist eindeutig.
Warum lässt sich ein hoher PPV immer erreichen?
Indem man die Schwelle anhebt und seltener Alarm schlägt
Richtig. Wer nur bei sehr hohen Scores Alarm schlägt, hat unter seinen wenigen Alarmen einen hohen Anteil echter Fälle. In Beispiel 3 steigt der PPV von 0.57 auf 0.89, während die Sensitivität von 0.96 auf 0.27 fällt.
Durch ein besseres Modell
Ein besseres Modell hilft, ist aber nicht nötig, um den PPV zu heben.
Gar nicht, der PPV hängt nur an den Daten
Er hängt an der Schwelle und an der Häufigkeit des Ereignisses.