ggplot2

ggplot2
Visualisierung
R
Python
Grammatik der Grafik, Ebenen, Skalen und Facetten in R.

Kernideen

  • Grammatik statt Diagrammtypen: Daten, Aesthetics, Geome, Skalen, Facetten, frei kombinierbar.
  • Eine Angabe innerhalb von aes() wird aus den Daten abgeleitet, ausserhalb ist sie ein fester Wert. Das ist der häufigste Anfängerfehler.
  • Geome folgen der Fragestellung und dem Skalenniveau, nicht dem Geschmack.
  • Facetten statt Farbe, sobald mehr als drei oder vier Gruppen im Spiel sind und mit gemeinsamen Achsen, sonst sind die Teilbilder nicht vergleichbar.
  • Die Skala ist Teil der Aussage, nicht ein Darstellungsdetail.
  • Beschriftung ist kein Nachtrag.

Erklärung

Vorwissen: Data Wrangling, weil ggplot2 einen aufgeräumten Data Frame im langen Format erwartet, und Skalenniveaus, weil das Messniveau bestimmt, welche Darstellung überhaupt zulässig ist. Die Wahl selbst steht unter Diagrammtyp wählen.

Warum nicht einfach ein Diagrammtyp

Übliche Programme bieten eine Liste von Diagrammtypen an: Balken, Linie, Kreis, Streuung. Wer etwas will, das nicht in der Liste steht, hat Pech. Und wer zwei Typen kombinieren will, etwa Punkte mit einer Ausgleichsgeraden, kämpft gegen das Werkzeug.

ggplot2 folgt einem anderen Gedanken. Eine Grafik entsteht aus Bausteinen, die sich frei kombinieren lassen. Ein Diagrammtyp ist dann nur eine bestimmte Kombination und kein eigener Befehl. Der Preis dafür ist, dass man die Bausteine kennen muss; der Gewinn ist, dass Sonderfälle aufhören, Sonderfälle zu sein.

Drei Bausteine genügen für den Anfang:

Baustein Was er festlegt
Daten Woher die Zahlen kommen
Aesthetics, aes() Welche Variable auf welche visuelle Eigenschaft abgebildet wird
Geom Mit welchen Objekten gezeichnet wird

Dazu kommen Skalen, Facetten, Statistiken und das Theme. Der Aufbau ist immer derselbe:

ggplot(daten, aes(x, y)) +      # Daten und Zuordnung
  geom_point() +                # womit gezeichnet wird
  scale_y_continuous(...) +     # wie Werte in Positionen übersetzt werden
  facet_wrap(~ gruppe) +        # Aufteilung in Teilbilder
  labs(title = "…") +           # Beschriftung
  theme_minimal()               # Aussehen

Geome nach Fragestellung

Welches Geom passt, hängt daran, was gezeigt werden soll und welches Skalenniveau die Merkmale haben.

Frage Geom Merkmale
Wie ist ein Merkmal verteilt? geom_histogram, geom_density ein metrisches
Wie hängen zwei Merkmale zusammen? geom_point zwei metrische
Wie unterscheiden sich Gruppen? geom_boxplot, geom_violin ein metrisches, ein kategoriales
Wie häufig ist eine Kategorie? geom_bar, geom_col ein kategoriales
Wie verläuft etwas über die Zeit? geom_line Zeit und ein metrisches

geom_bar zählt selbst, geom_col nimmt fertige Werte, das ist die Verwechslung, die am häufigsten zu einer leeren Grafik führt.

Der Datensatz dieser Seite

180 Maschinen mit Laufzeit in Stunden, Typ, Standort und Stromverbrauch. Der Verbrauch hängt konstruktionsgemäss von der Laufzeit ab, und Pressen brauchen zusätzlich 14 Einheiten. Die Daten sind deterministisch erzeugt, damit die R- und die Python-Fassung dieselben 180 Maschinen zeigen.

Beispiele

Frage und Datenlage

Was trägt jeder Baustein bei? Dazu wird die Grafik in drei Schritten gebaut: erst nur die Daten, dann die Zuordnung, dann das Geom.

Rechnung

str(maschinen)
'data.frame':   180 obs. of  4 variables:
 $ laufzeit : num  2.7 7.6 22 13.3 13.5 18.3 21.1 17.7 2.3 11 ...
 $ typ      : Factor w/ 3 levels "Drehbank","Fräse",..: 2 2 2 2 2 2 2 2 2 2 ...
 $ standort : chr  "Bern" "Bern" "Bern" "Bern" ...
 $ verbrauch: num  25.1 27.4 65.5 43.2 49.6 50.2 60.6 61.8 15.5 35 ...
round(c(laufzeit_min = min(maschinen$laufzeit),
        laufzeit_max = max(maschinen$laufzeit),
        verbrauch_min = min(maschinen$verbrauch),
        verbrauch_max = max(maschinen$verbrauch),
        korrelation = cor(maschinen$laufzeit, maschinen$verbrauch)), 3)
 laufzeit_min  laufzeit_max verbrauch_min verbrauch_max   korrelation 
        2.000        22.000         6.100        78.100         0.852 
ggplot(maschinen, aes(x = laufzeit, y = verbrauch))
Abbildung 1: Schritt 1: nur Daten und Zuordnung. Die Achsen stehen, gezeichnet ist nichts.
ggplot(maschinen, aes(x = laufzeit, y = verbrauch)) +
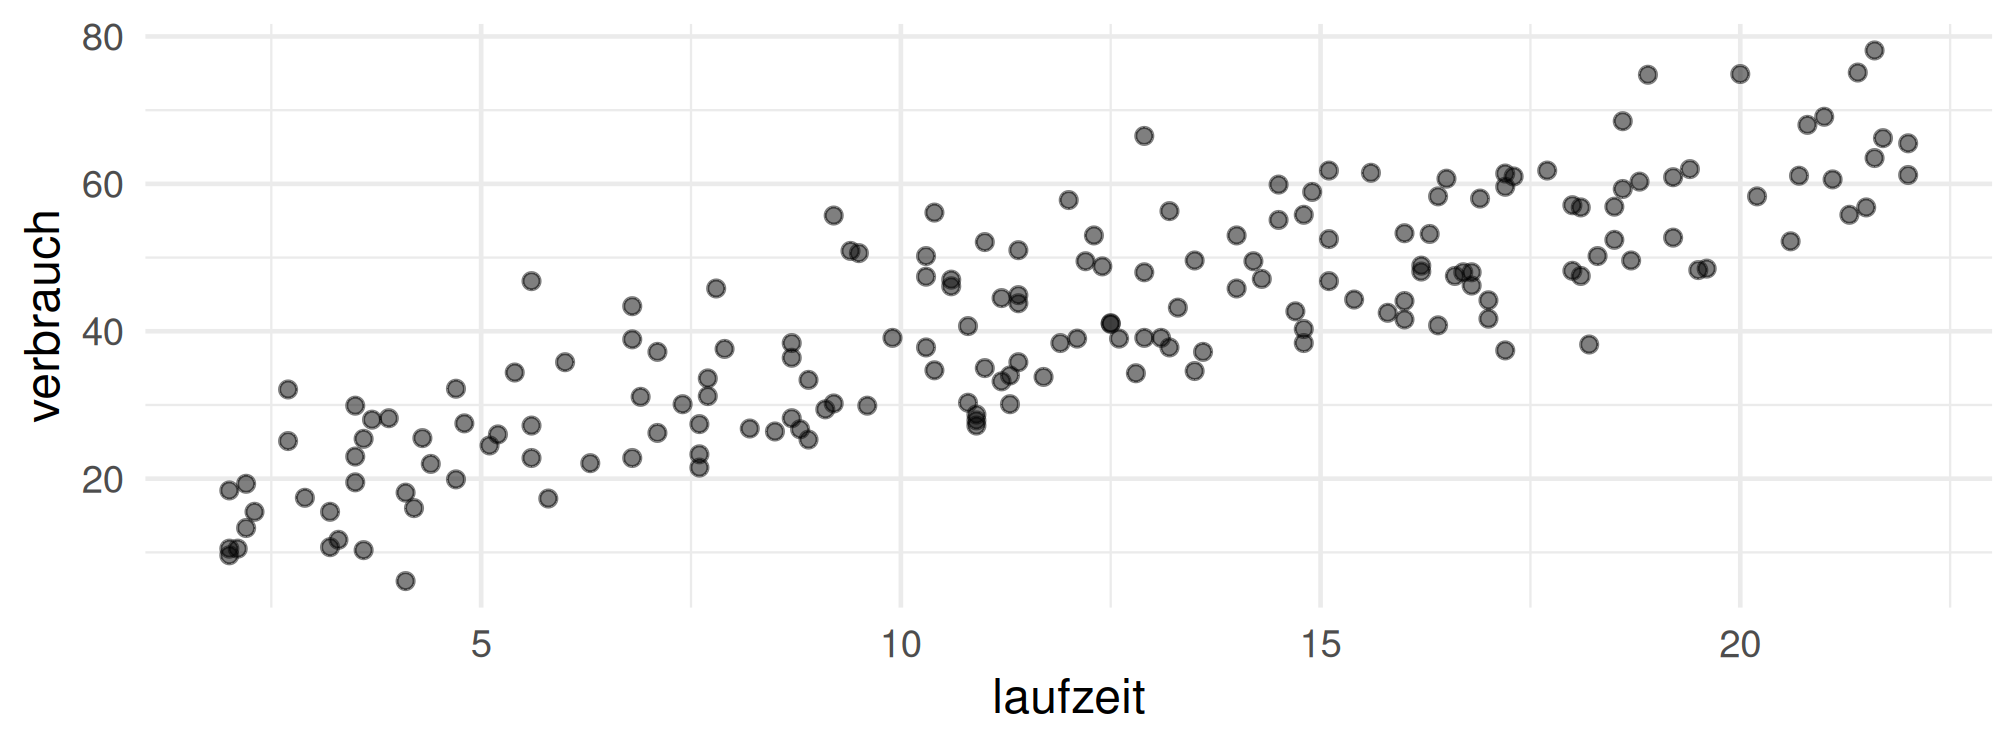
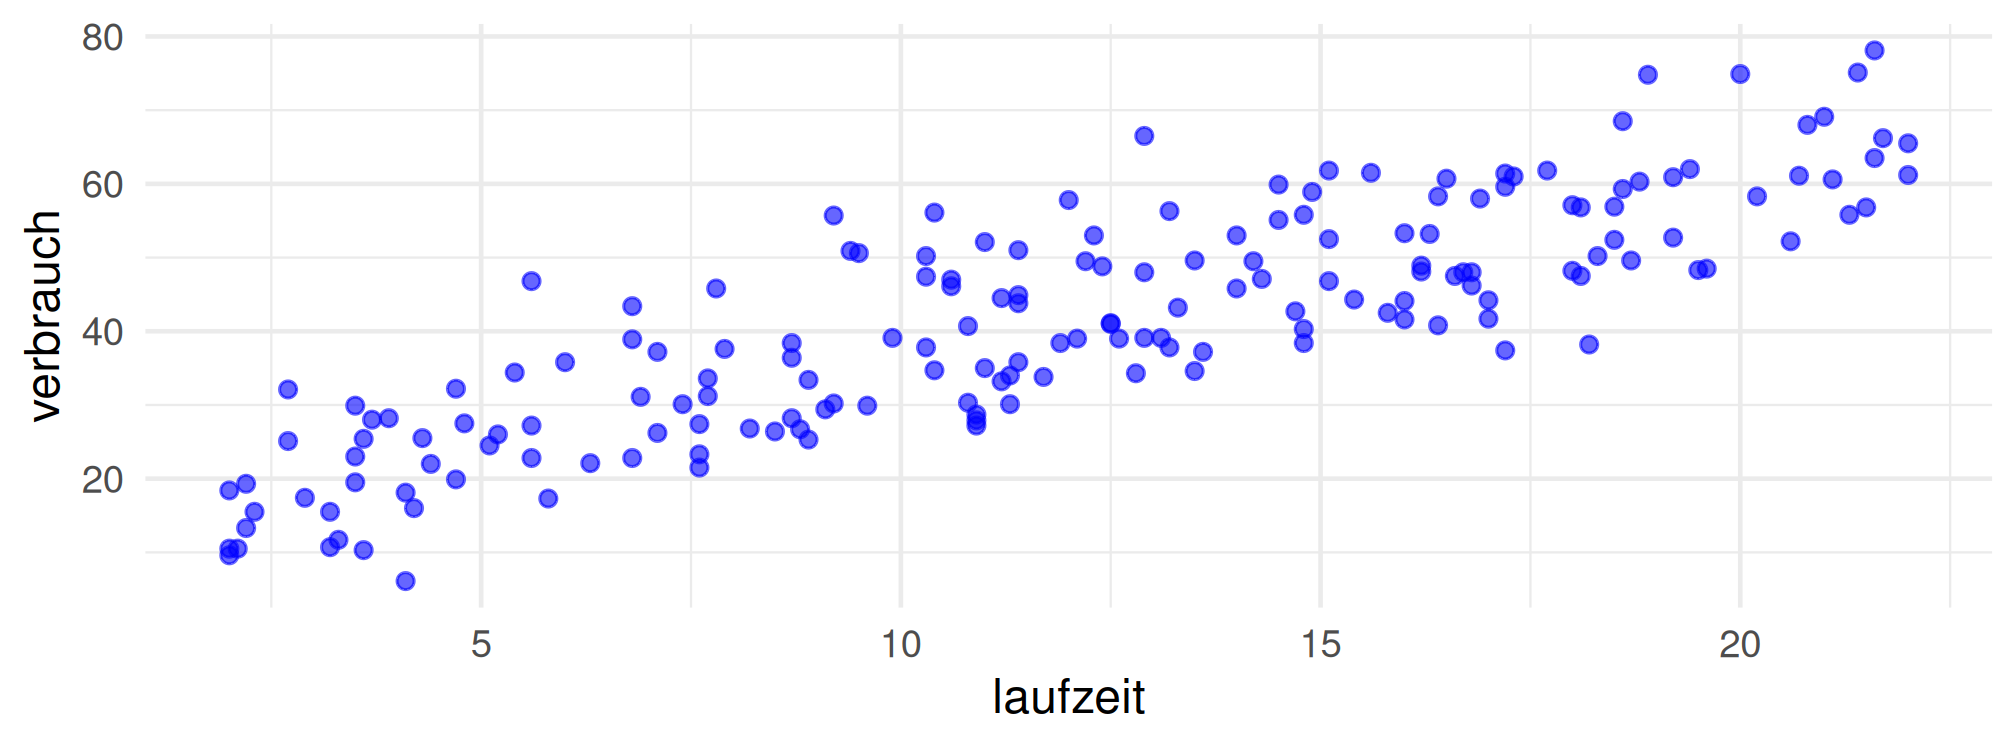
  geom_point(alpha = 0.5)
Abbildung 2: Schritt 2: ein Geom kommt dazu.
ggplot(maschinen, aes(x = laufzeit, y = verbrauch)) +
  geom_point(alpha = 0.5) +
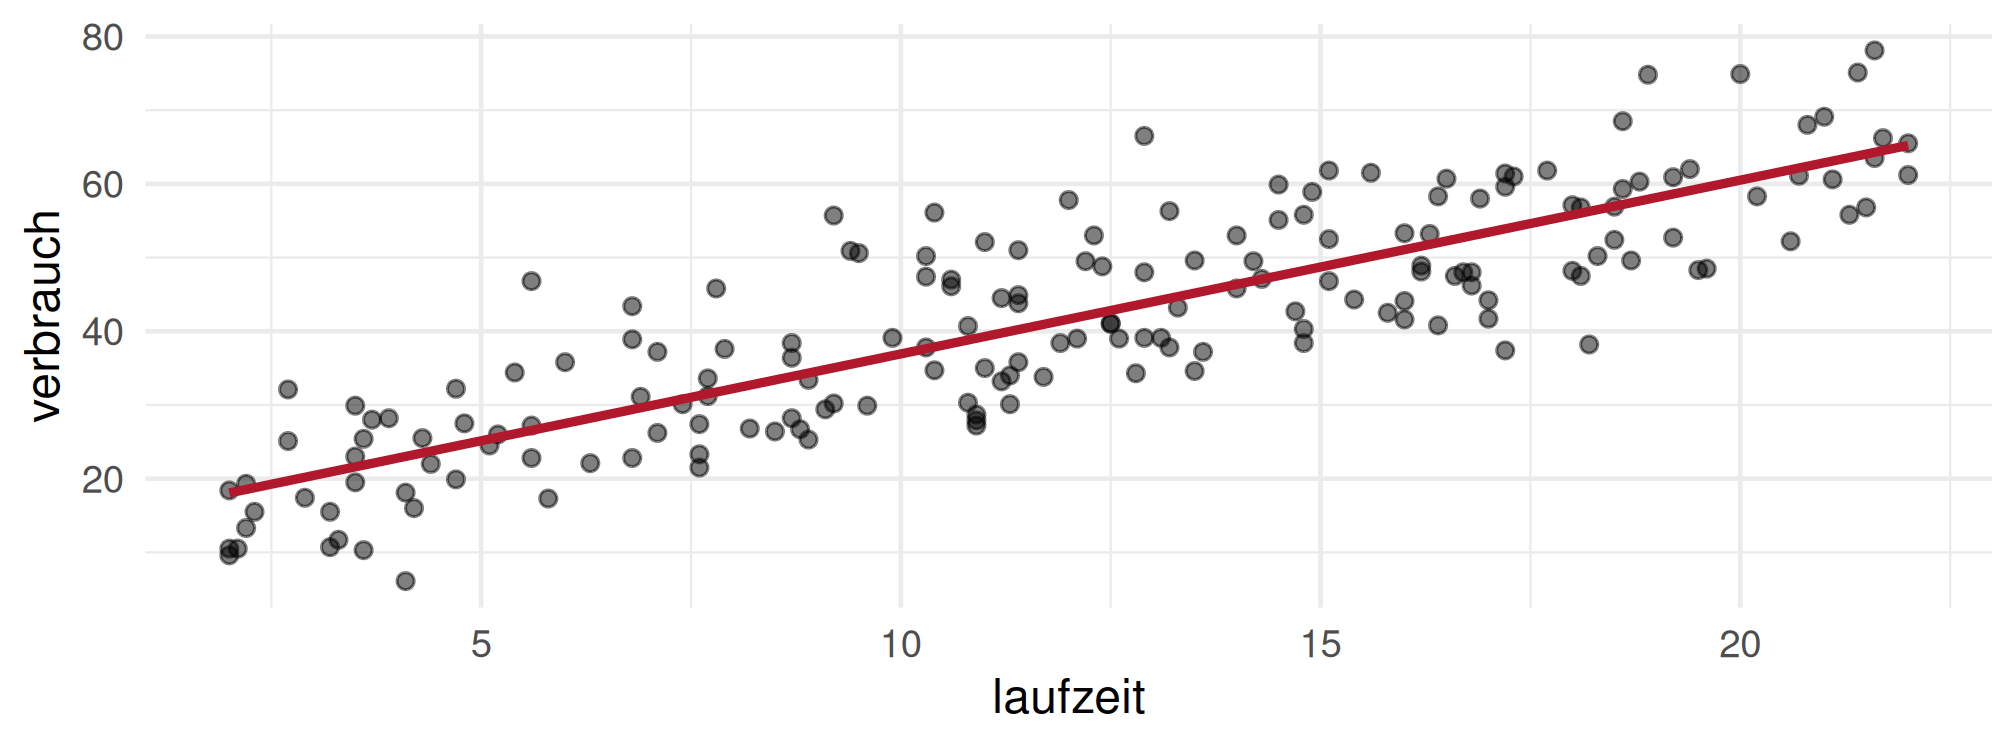
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "#b2182b")
Abbildung 3: Schritt 3: eine zweite Ebene darüber.
print(maschinen.dtypes)
laufzeit     float64
typ           object
standort      object
verbrauch    float64
dtype: object
print({"laufzeit_min": round(float(maschinen["laufzeit"].min()), 3),
       "laufzeit_max": round(float(maschinen["laufzeit"].max()), 3),
       "verbrauch_min": round(float(maschinen["verbrauch"].min()), 3),
       "verbrauch_max": round(float(maschinen["verbrauch"].max()), 3),
       "korrelation": round(float(maschinen["laufzeit"].corr(maschinen["verbrauch"])), 3)})
{'laufzeit_min': 2.0, 'laufzeit_max': 22.0, 'verbrauch_min': 6.1, 'verbrauch_max': 78.1, 'korrelation': 0.852}
fig, achse = plt.subplots(figsize=(7, 2.8))
_ = achse.scatter(maschinen["laufzeit"], maschinen["verbrauch"], s=14, alpha=0.5,
                  color="0.3")
k, d = np.polyfit(maschinen["laufzeit"], maschinen["verbrauch"], 1)
gitter = np.linspace(maschinen["laufzeit"].min(), maschinen["laufzeit"].max(), 2)
_ = achse.plot(gitter, k * gitter + d, lw=2, color="#b2182b")
_ = achse.set_xlabel("laufzeit")
_ = achse.set_ylabel("verbrauch")
plt.tight_layout()
plt.show()
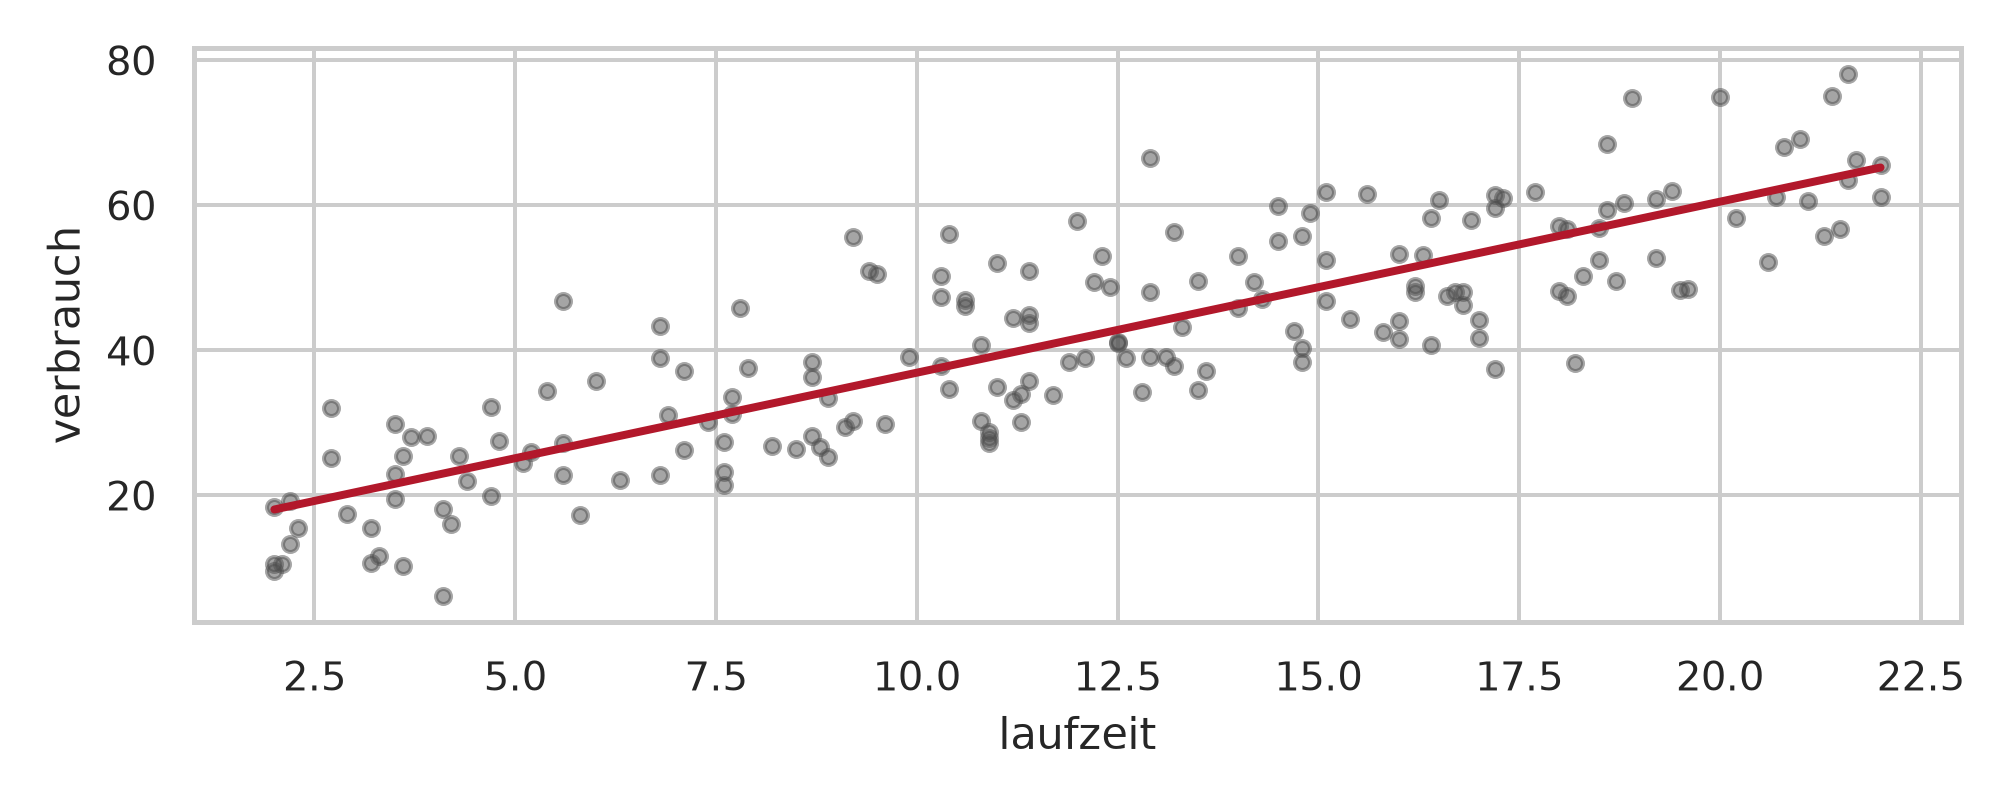
Abbildung 4: Dieselben drei Schritte in matplotlib, hier gibt es keine leere Zwischenstufe.
print({"steigung": round(float(k), 3), "achsenabschnitt": round(float(d), 2)})

Output Zeile für Zeile

Grösse Wert
Beobachtungen 180
Laufzeit 2.0 bis 22.0 Stunden
Verbrauch 6.1 bis 78.1
Korrelation Laufzeit / Verbrauch 0.852
Ausgleichsgerade Steigung 2.358, Achsenabschnitt 13.35
Beobachtung Erklärung
Der erste Aufruf zeichnet nichts Nur die Achsen. Daten und Zuordnung stehen fest, aber ohne Geom gibt es keine Objekte. Das ist kein Fehler, sondern die Grammatik: Zuordnung und Darstellung sind getrennt.
Erst geom_point() bringt Punkte Dieselbe Zuordnung könnte mit geom_line() Linien ergeben oder mit geom_hex() Sechsecke, ohne dass sich an aes() etwas ändert.
Die zweite Ebene liegt darüber geom_smooth() wird addiert, nicht ersetzt. Die Reihenfolge im Code ist die Reihenfolge im Bild.
Die geschätzte Steigung beträgt 2.358 Konstruiert waren 2.4. Die Abweichung kommt daher, dass die Pressen ihre zusätzlichen 14 Einheiten unabhängig von der Laufzeit haben und die Gerade das ausgleicht.
In matplotlib gibt es die leere Zwischenstufe nicht Dort erzeugt plt.subplots() die Achsen und jeder Zeichenbefehl fügt direkt Objekte hinzu. Der Unterschied ist nicht kosmetisch: In ggplot2 ist die Zuordnung ein eigenes Objekt, das wiederverwendet werden kann.

Was daraus folgt, wenn man in ggplot2 denkt: Die Frage lautet nicht “welches Diagramm”, sondern zweimal getrennt:

  1. Welche Variable kommt auf welchen Kanal? (aes)
  2. Womit wird gezeichnet? (geom)

Diese Trennung ist derselbe Gedanke wie die Kanalrangfolge unter Wahrnehmung und Kodierung, nur als Code.

Interpretation und Ergebnissatz

Der Datensatz umfasst 180 Maschinen mit Laufzeiten von 2.0 bis 22.0 Stunden und Verbrauchswerten von 6.1 bis 78.1; die Korrelation beträgt 0.852. Ohne Geom zeichnet ggplot2 nur die Achsen, Zuordnung und Darstellung sind getrennte Bausteine.

Frage und Datenlage

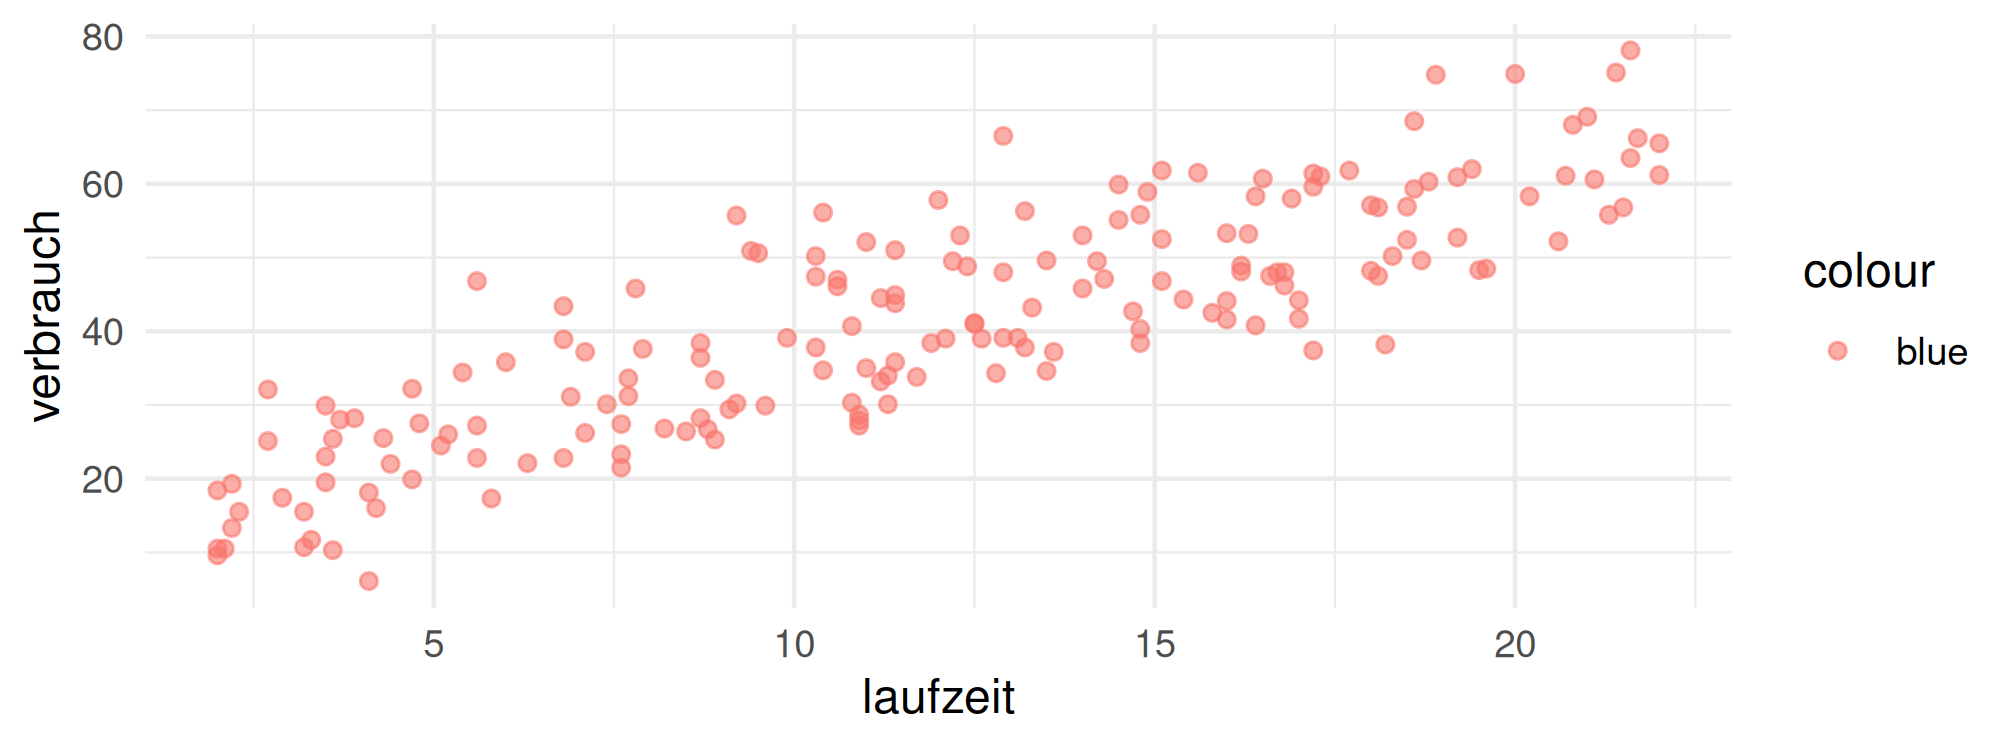
colour = "blue" innerhalb und ausserhalb von aes(), derselbe Text, zwei völlig verschiedene Ergebnisse. Das ist der häufigste Anfängerfehler.

Rechnung

ggplot(maschinen, aes(laufzeit, verbrauch, colour = "blue")) +
  geom_point(alpha = 0.6)
Abbildung 5: Innerhalb von aes(): ‘blue’ wird als Datenwert behandelt.
ggplot(maschinen, aes(laufzeit, verbrauch)) +
  geom_point(colour = "blue", alpha = 0.6)
Abbildung 6: Ausserhalb von aes(): ein fester Wert für alle Punkte.
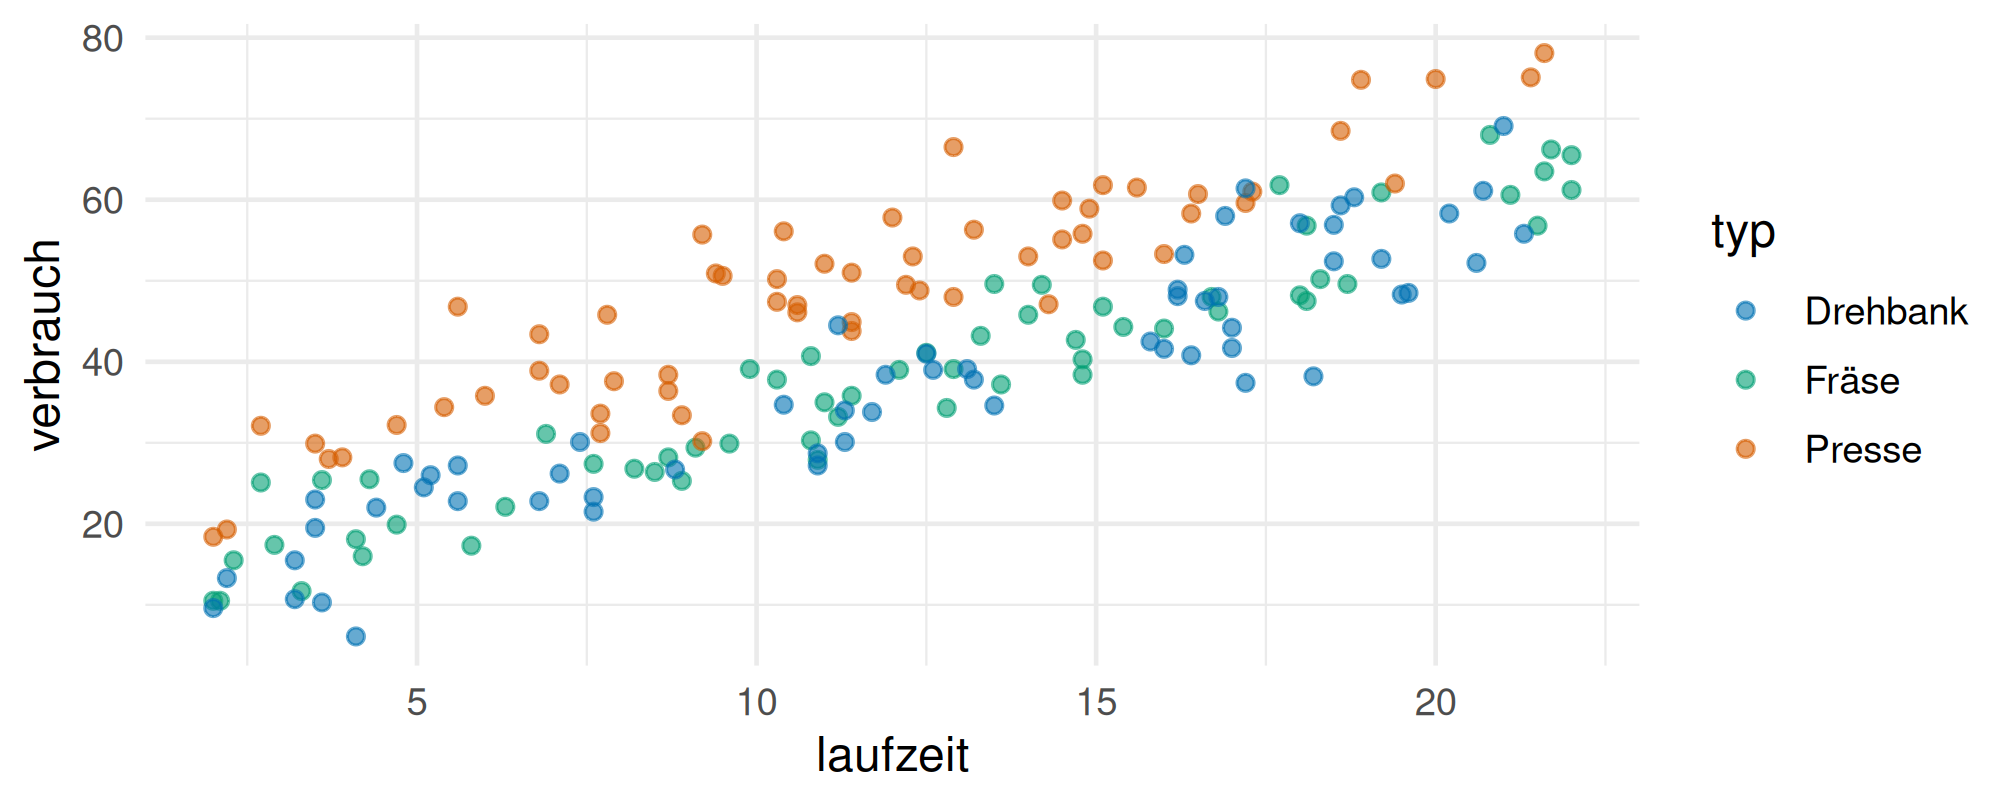
ggplot(maschinen, aes(laufzeit, verbrauch, colour = typ)) +
  geom_point(alpha = 0.6) +
  scale_colour_manual(values = c(Drehbank = "#0072B2", Fräse = "#009E73",
                                 Presse = "#D55E00"))
Abbildung 7: Sinnvoll zugeordnet: eine echte Variable auf die Farbe.
zusammenfassung <- maschinen |>
  group_by(typ) |>
  summarise(anzahl = n(), mittel = mean(verbrauch), sd = sd(verbrauch)) |>
  as.data.frame()
zusammenfassung$mittel <- round(zusammenfassung$mittel, 2)
zusammenfassung$sd <- round(zusammenfassung$sd, 2)
zusammenfassung
       typ anzahl mittel    sd
1 Drehbank     60  37.58 15.35
2    Fräse     60  38.09 15.23
3   Presse     60  48.65 13.68
farben = {"Drehbank": "#0072B2", "Fräse": "#009E73", "Presse": "#D55E00"}

fig, achsen = plt.subplots(1, 2, figsize=(7, 2.8))
_ = achsen[0].scatter(maschinen["laufzeit"], maschinen["verbrauch"],
                      s=14, alpha=0.6, color="blue")
_ = achsen[0].set_title("fester Wert: color=", fontsize=10)
for name, teil in maschinen.groupby("typ"):
    _ = achsen[1].scatter(teil["laufzeit"], teil["verbrauch"], s=14, alpha=0.6,
                          color=farben[name], label=name)
_ = achsen[1].legend(fontsize=7, frameon=False)
_ = achsen[1].set_title("zugeordnet: je Gruppe", fontsize=10)
for achse in achsen:
    _ = achse.set_xlabel("laufzeit")
    _ = achse.set_ylabel("verbrauch")
plt.tight_layout()
plt.show()
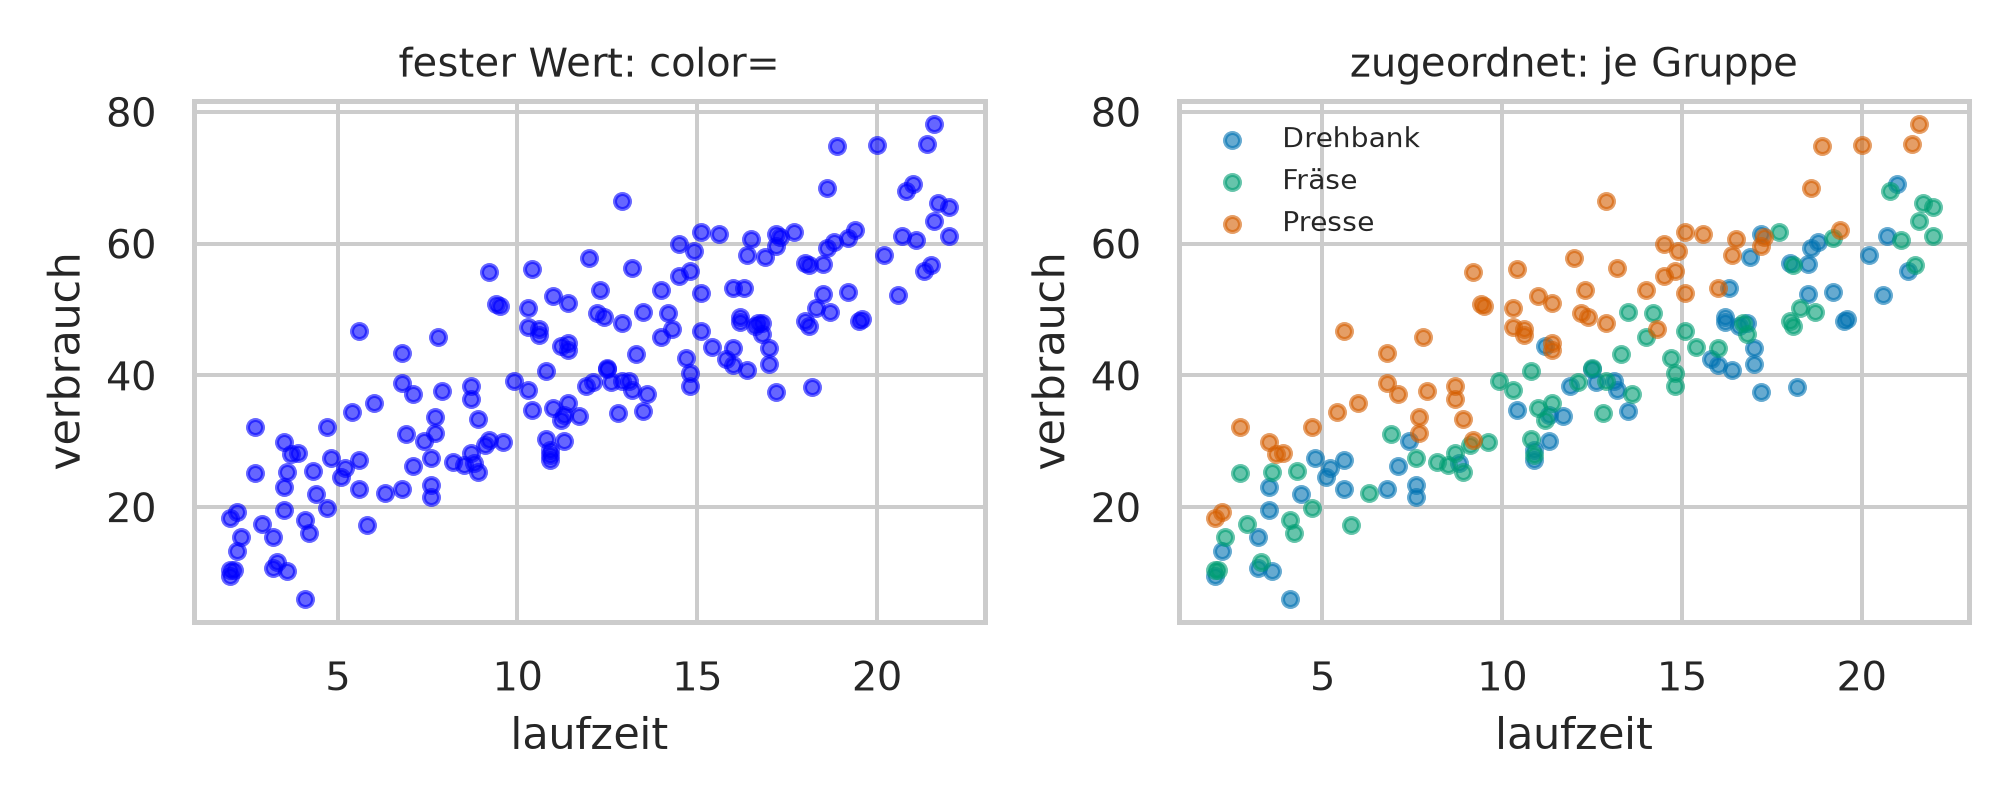
Abbildung 8: In matplotlib ist der Unterschied explizit: c= nimmt Daten, color= einen festen Wert.
print(maschinen.groupby("typ")["verbrauch"]
      .agg(anzahl="count", mittel="mean", sd="std").round(2))

Output Zeile für Zeile

Typ Anzahl Mittel SD
Drehbank 60 37.58 15.35
Fräse 60 38.10 15.23
Presse 60 48.65 13.68
Beobachtung Erklärung
colour = "blue" innerhalb von aes() ergibt rote Punkte und eine Legende ggplot2 behandelt "blue" als Datenwert: eine Variable, die für alle 180 Zeilen denselben Wert hat. Sie bekommt eine Skala, und die erste Farbe der Standardpalette ist Rot.
Ausserhalb wird es ein fester Wert Blaue Punkte, keine Legende. Nichts wird aus den Daten abgeleitet.
Die Faustregel steht in einem Satz Steht rechts vom = ein Spaltenname, gehört es in aes(); steht dort ein fester Wert, gehört es nach draussen.
Sinnvoll zugeordnet zeigt die Farbe den Typ Und dann trägt sie Information: Die Pressen liegen mit einem Mittel von 48.65 rund 10 Einheiten über den anderen beiden, die mit 37.58 und 38.10 fast gleich sind.
In matplotlib gibt es diesen Fehler nicht Dort sind color= (fest) und c= (aus Daten) verschiedene Argumente. Dafür muss man dort je Gruppe selbst schleifen, ggplot2 nimmt einem das ab.

Woran man den Fehler im Bild erkennt: Es erscheint eine Legende, die man nicht bestellt hat, mit genau einem Eintrag, der den Namen der Farbe trägt. Zweiter Hinweis: Die Farbe ist nicht die, die man geschrieben hat.

Interpretation und Ergebnissatz

Innerhalb von aes() wird colour = "blue" als Datenwert behandelt und erzeugt eine Legende mit einem Eintrag; ausserhalb ist es ein fester Wert. Sinnvoll zugeordnet zeigt die Farbe den Maschinentyp: Pressen verbrauchen im Mittel 48.65 gegenüber 37.58 und 38.10 bei den anderen beiden Typen.

Frage und Datenlage

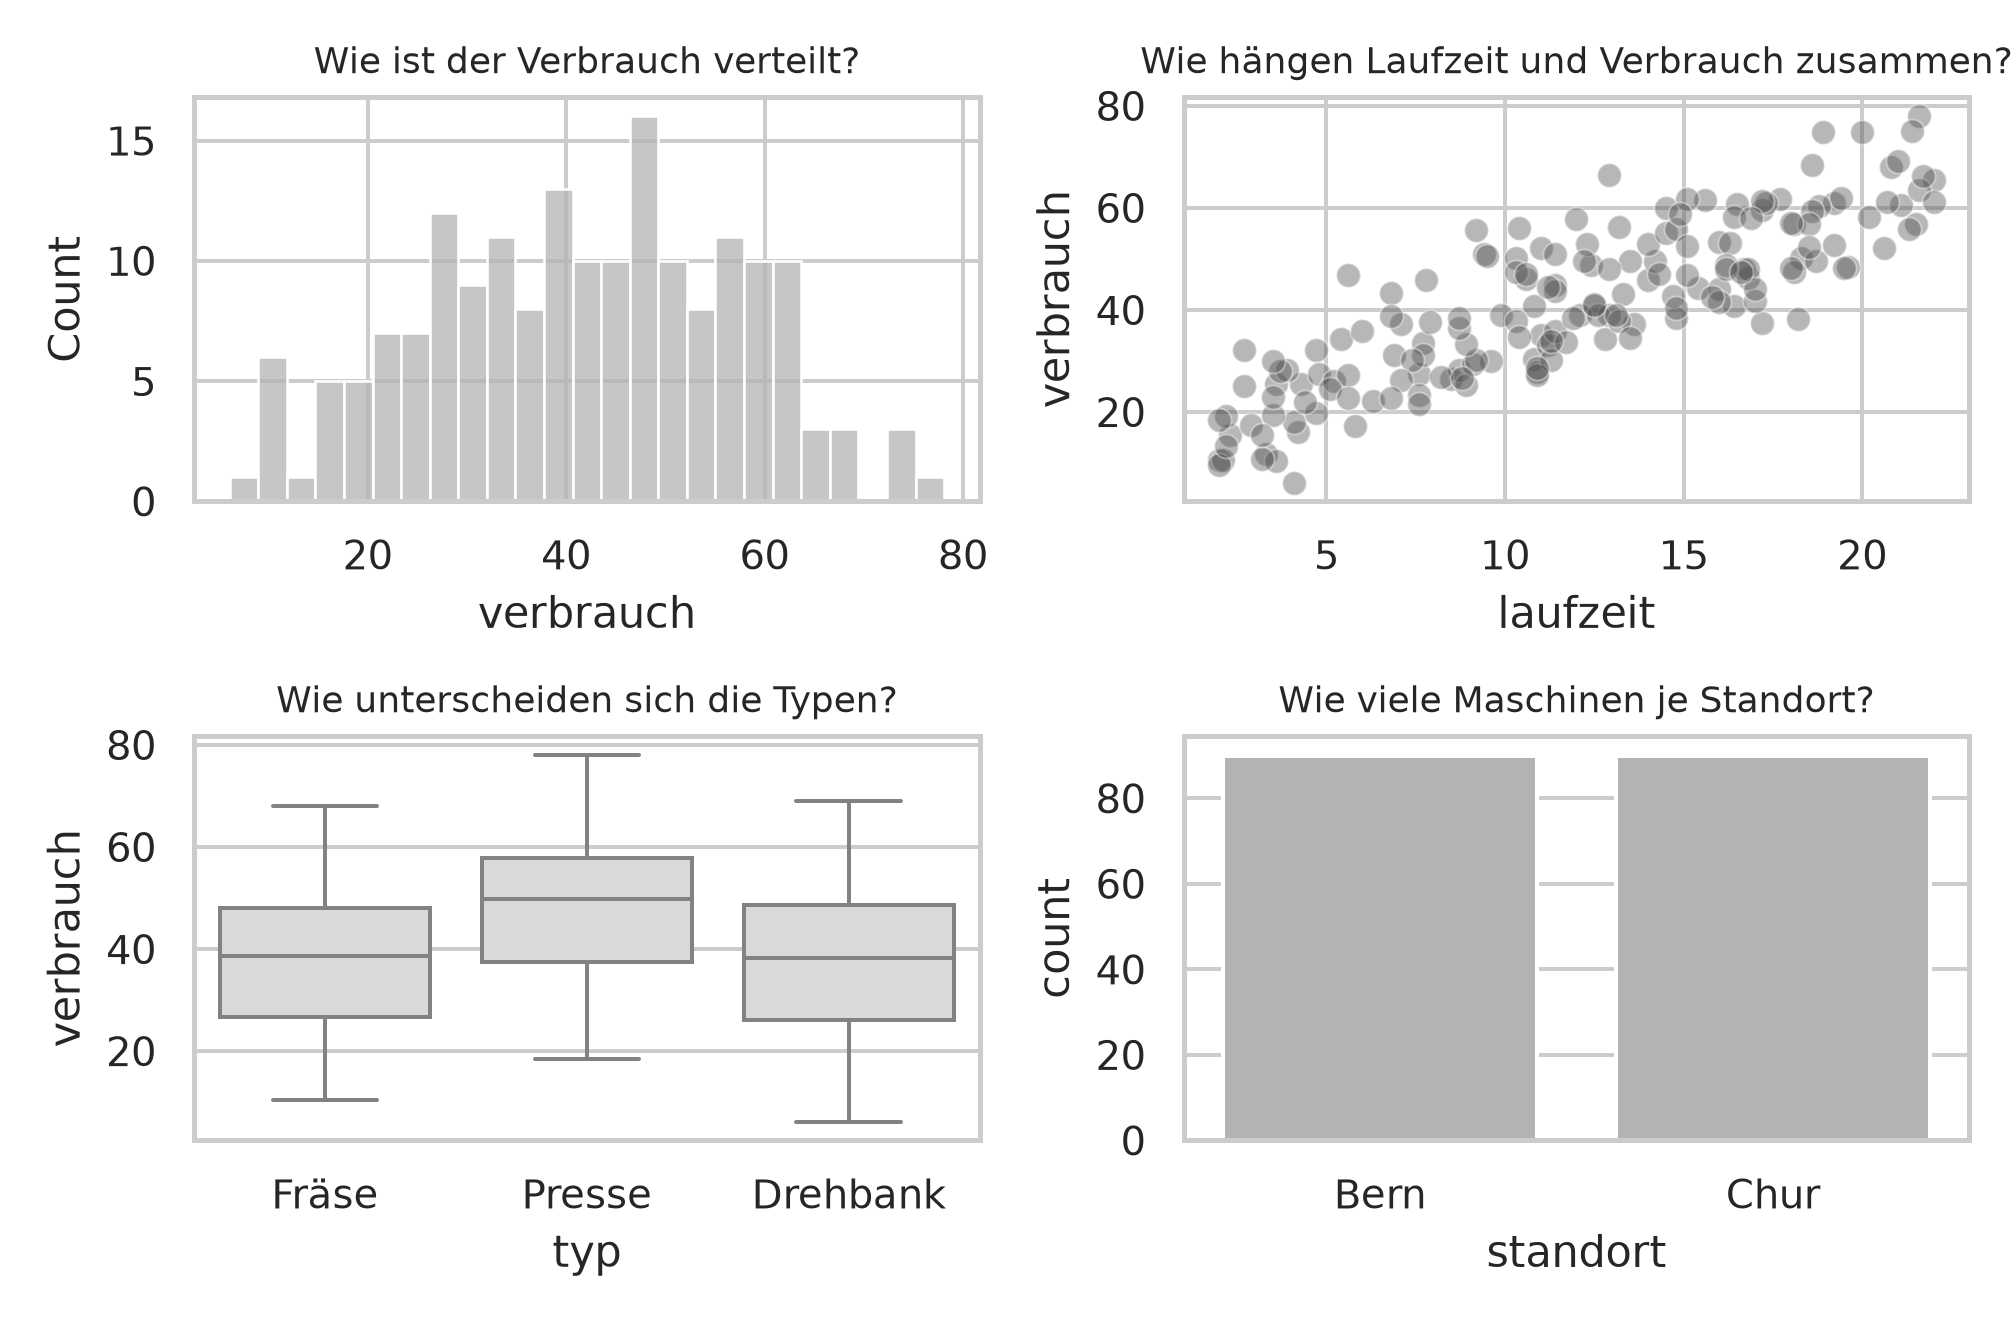
Derselbe Datensatz, vier Fragen, vier Geome. Jedes beantwortet genau eine und verbirgt die anderen.

Rechnung

p1 <- ggplot(maschinen, aes(verbrauch)) +
  geom_histogram(bins = 25, fill = "grey70", colour = "white") +
  labs(subtitle = "Wie ist der Verbrauch verteilt?")

p2 <- ggplot(maschinen, aes(laufzeit, verbrauch)) +
  geom_point(alpha = 0.4) +
  labs(subtitle = "Wie hängen Laufzeit und Verbrauch zusammen?")

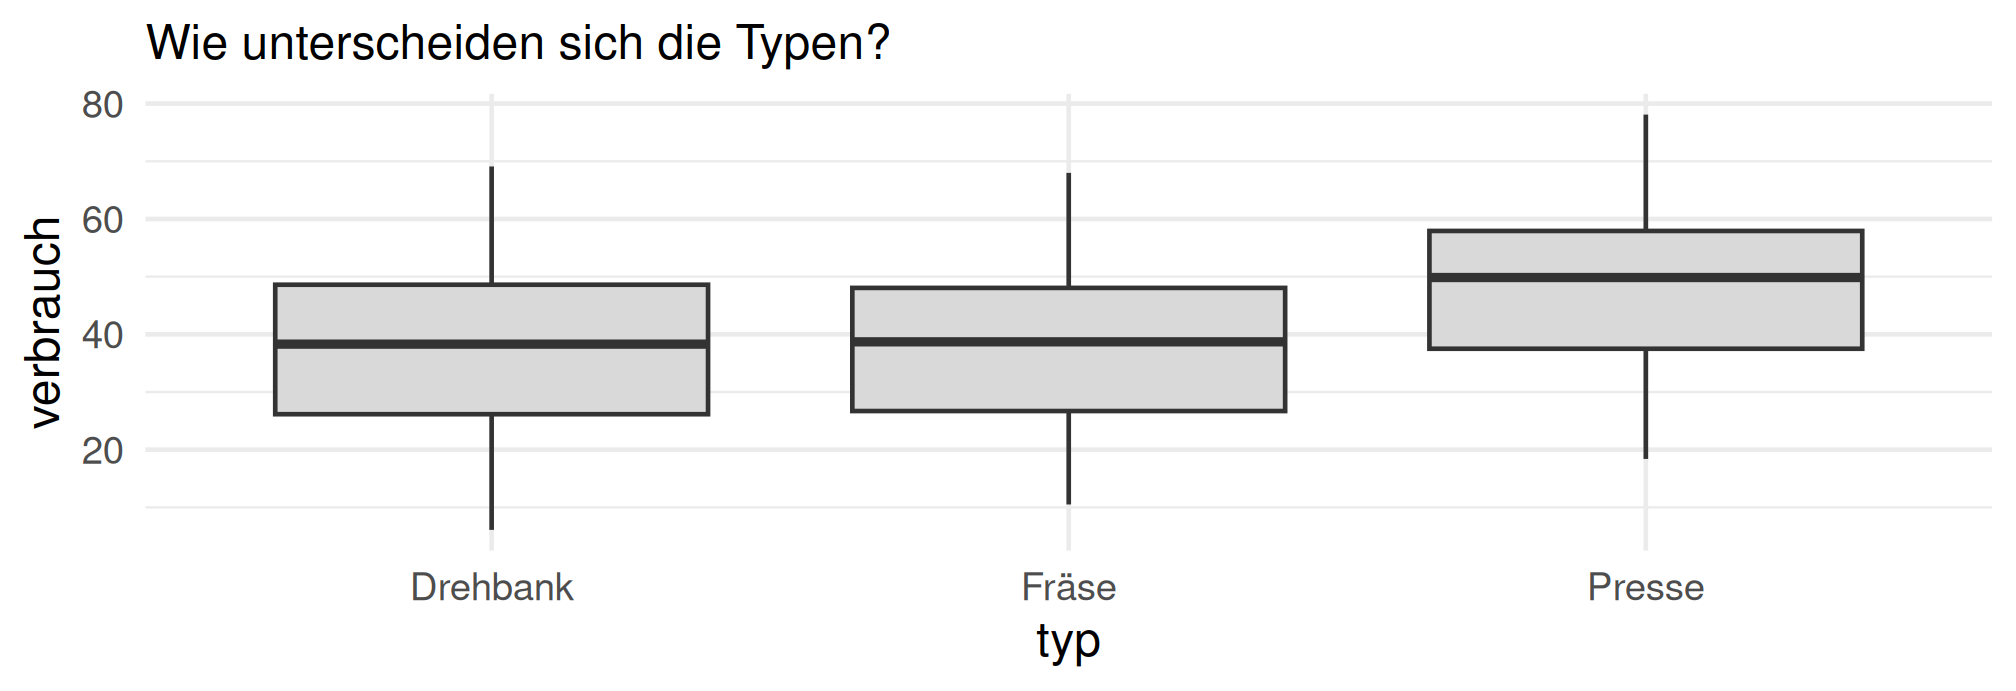
p3 <- ggplot(maschinen, aes(typ, verbrauch)) +
  geom_boxplot(fill = "grey85") +
  labs(subtitle = "Wie unterscheiden sich die Typen?")

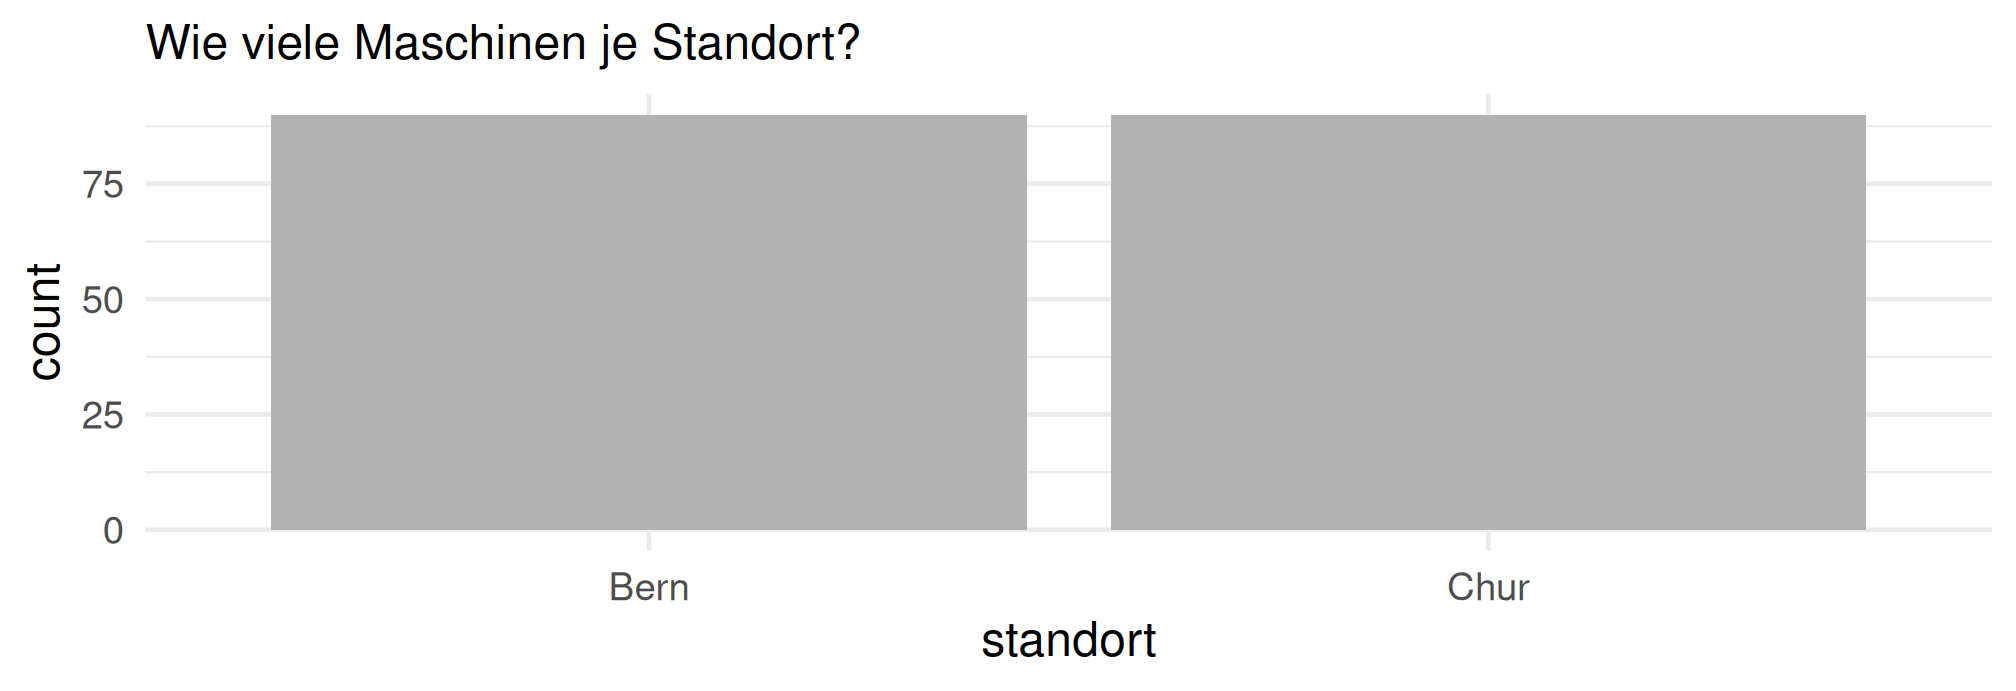
p4 <- ggplot(maschinen, aes(standort)) +
  geom_bar(fill = "grey70") +
  labs(subtitle = "Wie viele Maschinen je Standort?")

# Ohne Zusatzpaket: die vier Grafiken nacheinander
print(p1); print(p2); print(p3); print(p4)
Abbildung 9: Beispiel 3: Histogramm, Streudiagramm, Boxplot und Balken.
Abbildung 10: Beispiel 3: Histogramm, Streudiagramm, Boxplot und Balken.
Abbildung 11: Beispiel 3: Histogramm, Streudiagramm, Boxplot und Balken.
Abbildung 12: Beispiel 3: Histogramm, Streudiagramm, Boxplot und Balken.
round(c(median_verbrauch = median(maschinen$verbrauch),
        schiefe = mean((maschinen$verbrauch - mean(maschinen$verbrauch))^3) /
          sd(maschinen$verbrauch)^3), 3)
median_verbrauch          schiefe 
          41.650           -0.059 
table(maschinen$standort)

Bern Chur 
  90   90 
round(tapply(maschinen$verbrauch, maschinen$typ, median), 2)
Drehbank    Fräse   Presse 
   38.30    38.70    49.85 
fig, achsen = plt.subplots(2, 2, figsize=(7, 4.6))
_ = sns.histplot(maschinen["verbrauch"], bins=25, color="0.7",
                 ax=achsen[0, 0])
_ = achsen[0, 0].set_title("Wie ist der Verbrauch verteilt?", fontsize=9)
_ = sns.scatterplot(data=maschinen, x="laufzeit", y="verbrauch", alpha=0.4,
                    color="0.3", ax=achsen[0, 1])
_ = achsen[0, 1].set_title("Wie hängen Laufzeit und Verbrauch zusammen?",
                           fontsize=9)
_ = sns.boxplot(data=maschinen, x="typ", y="verbrauch", color="0.85",
                ax=achsen[1, 0])
_ = achsen[1, 0].set_title("Wie unterscheiden sich die Typen?", fontsize=9)
_ = sns.countplot(data=maschinen, x="standort", color="0.7", ax=achsen[1, 1])
_ = achsen[1, 1].set_title("Wie viele Maschinen je Standort?", fontsize=9)
plt.tight_layout()
plt.show()
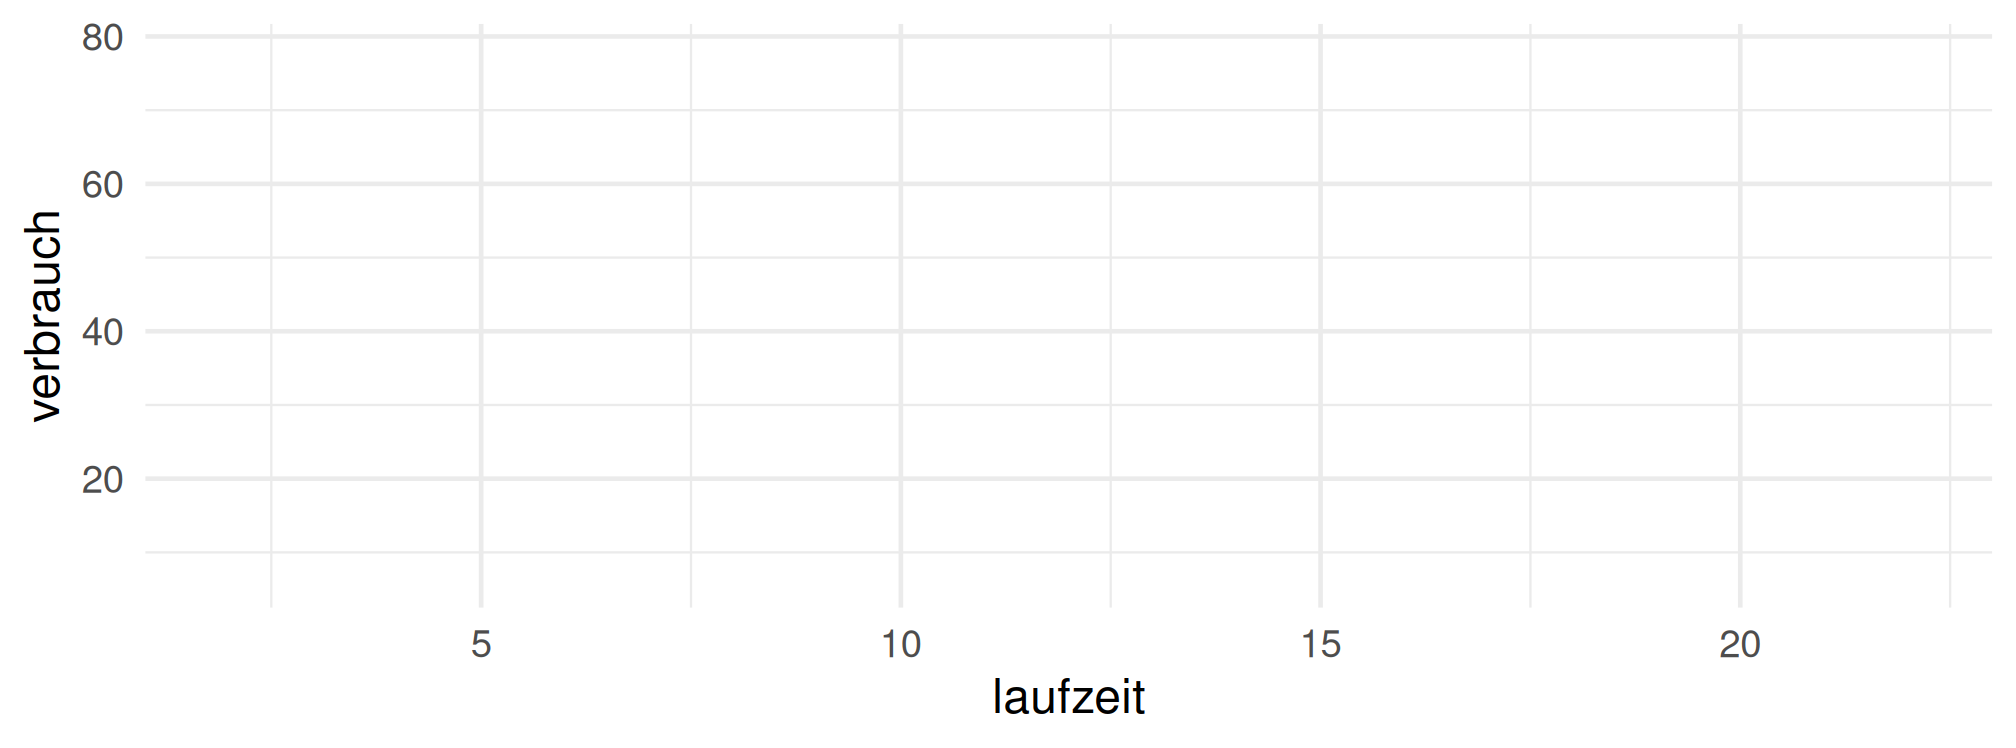
Abbildung 13: Beispiel 3: dieselben vier Fragen in seaborn.
print({"median_verbrauch": round(float(maschinen["verbrauch"].median()), 3),
       "schiefe": round(float(stats.skew(maschinen["verbrauch"])), 3)})
print(maschinen["standort"].value_counts().sort_index())
print(maschinen.groupby("typ")["verbrauch"].median().round(2))

Output Zeile für Zeile

Kennzahl Wert
Median Verbrauch 41.45
Schiefe 0.033
Maschinen je Standort Bern 90, Chur 90
Typ Median Verbrauch
Drehbank 36.45
Fräse 37.00
Presse 48.55
Beobachtung Erklärung
Das Histogramm zeigt eine nahezu symmetrische Verteilung Schiefe 0.033, Median 41.45 bei einem Mittelwert von 41.44. Es ist aber eine Mischung aus drei Typen, das Histogramm zeigt nur die Summe.
Das Streudiagramm zeigt den Zusammenhang Und nicht die Gruppen. Dass die Pressen systematisch höher liegen, ist dort als Verbreiterung der Wolke sichtbar, nicht als Struktur.
Der Boxplot zeigt die Gruppen Und nicht den Zusammenhang mit der Laufzeit. Mediane 36.45, 37.00 und 48.55.
Der Balken zählt selbst geom_bar braucht kein y: 90 und 90. Wer bereits fertige Werte hat, nimmt geom_col, die Verwechslung ist die häufigste Ursache für eine unerwartet leere Grafik.
Keines der vier Bilder ist falsch Jedes beantwortet seine Frage und verschweigt die anderen. Das Geom ist die Frage, nicht die Dekoration.

Mehrere ggplot-Objekte nebeneinander brauchen ein Zusatzpaket (patchwork, cowplot oder gridExtra). Steht keines zur Verfügung, wie in dieser Sammlung, gibt man die Grafiken einfach nacheinander aus. In matplotlib löst plt.subplots(2, 2) dasselbe ohne Zusatz.

Das ist einer der wenigen Punkte, an denen matplotlib bequemer ist als ggplot2.

Interpretation und Ergebnissatz

Dieselben 180 Maschinen beantworten vier Fragen mit vier Geomen: eine fast symmetrische Gesamtverteilung (Median 41.45, Schiefe 0.033), einen klaren Zusammenhang mit der Laufzeit, Typunterschiede mit Medianen von 36.45 bis 48.55 und eine gleichmässige Verteilung von 90 zu 90 auf die Standorte.

Frage und Datenlage

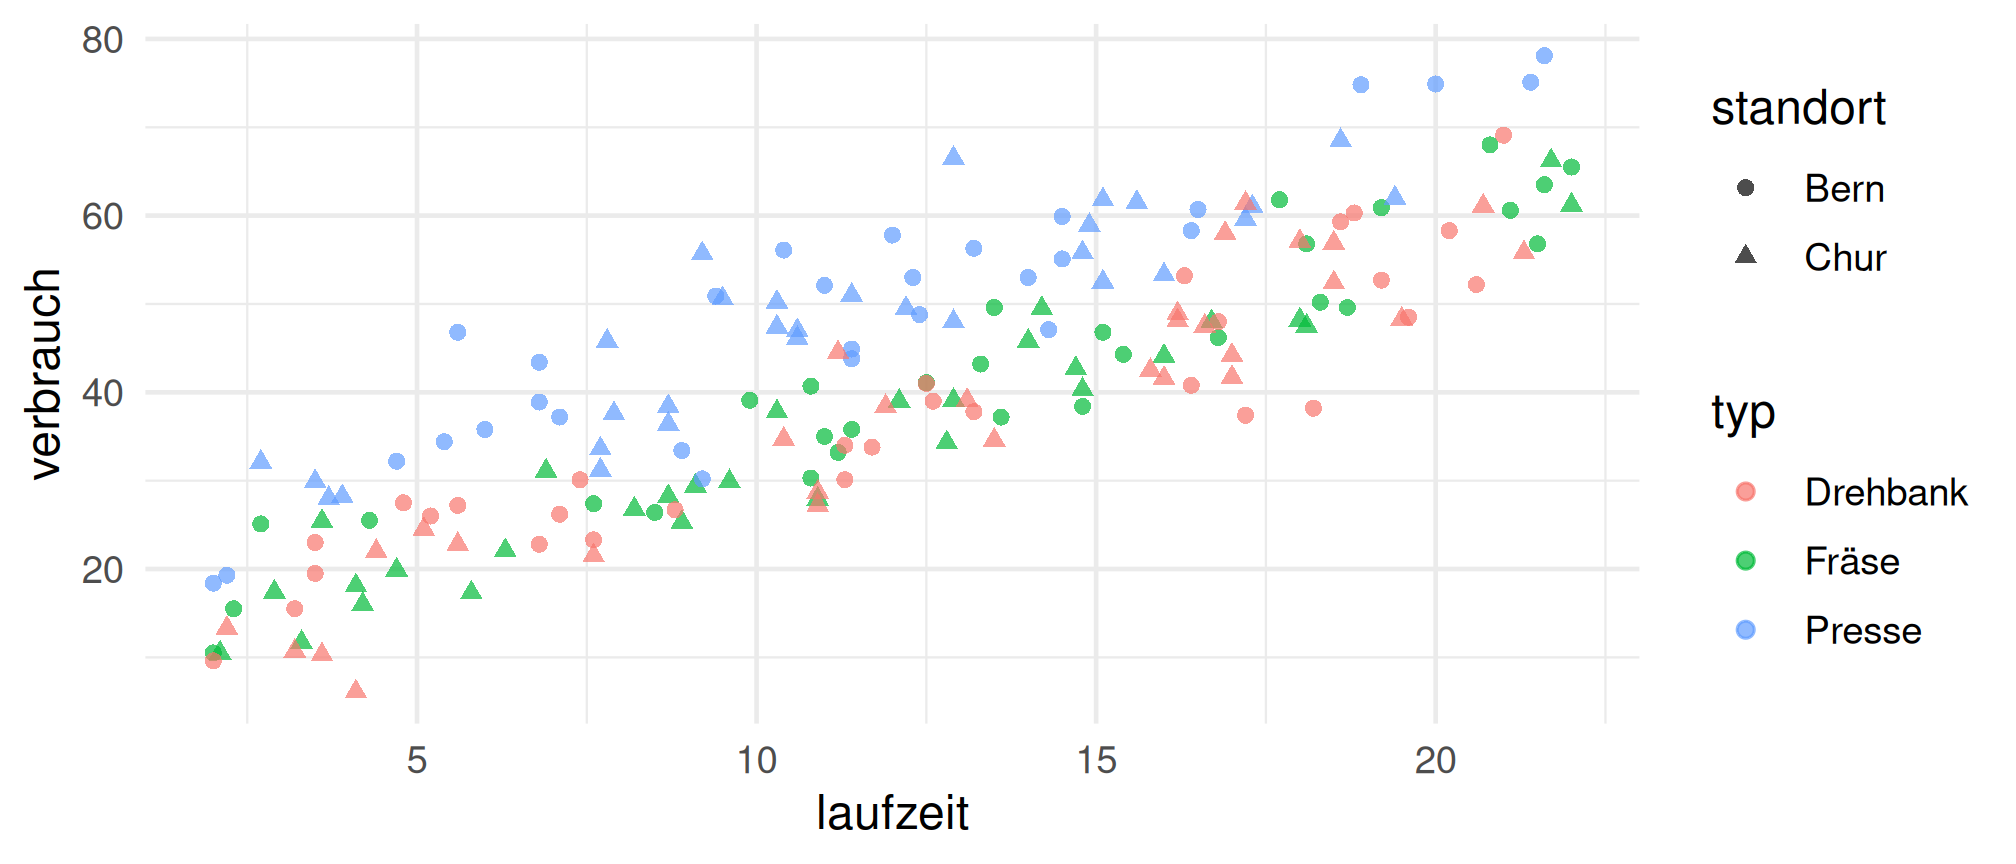
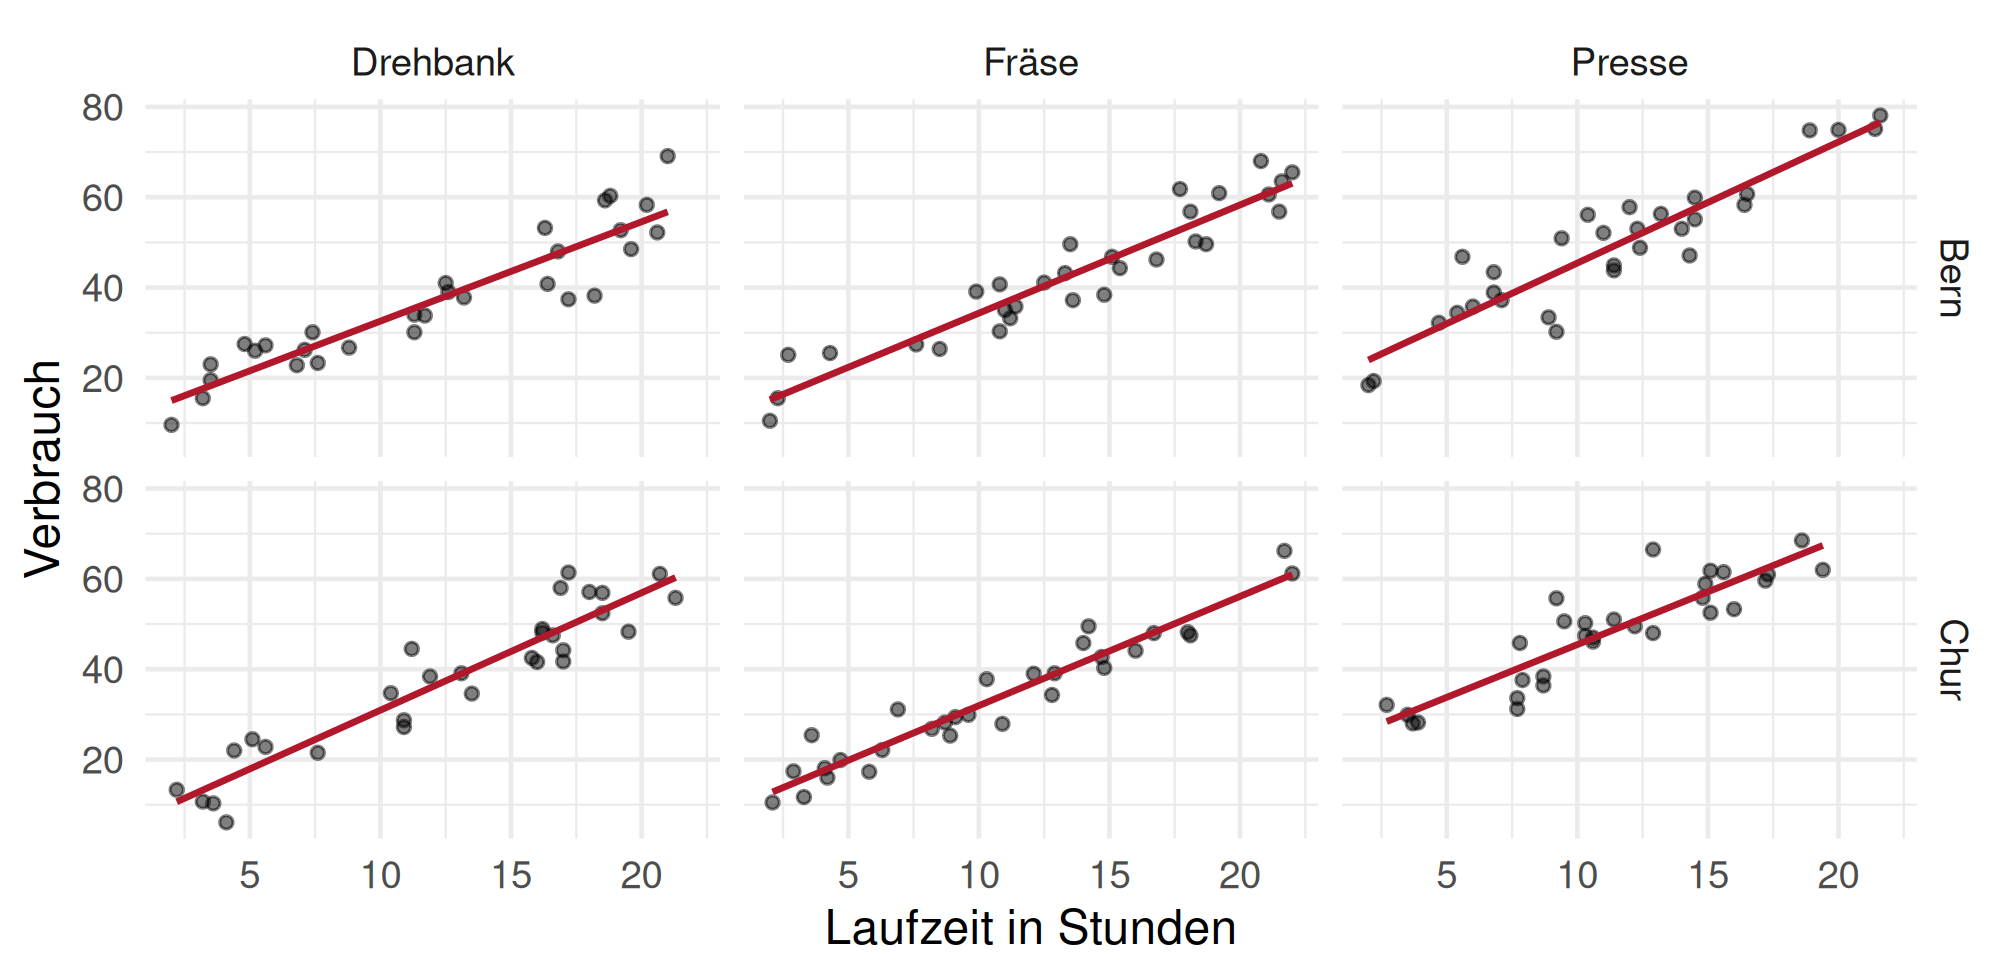
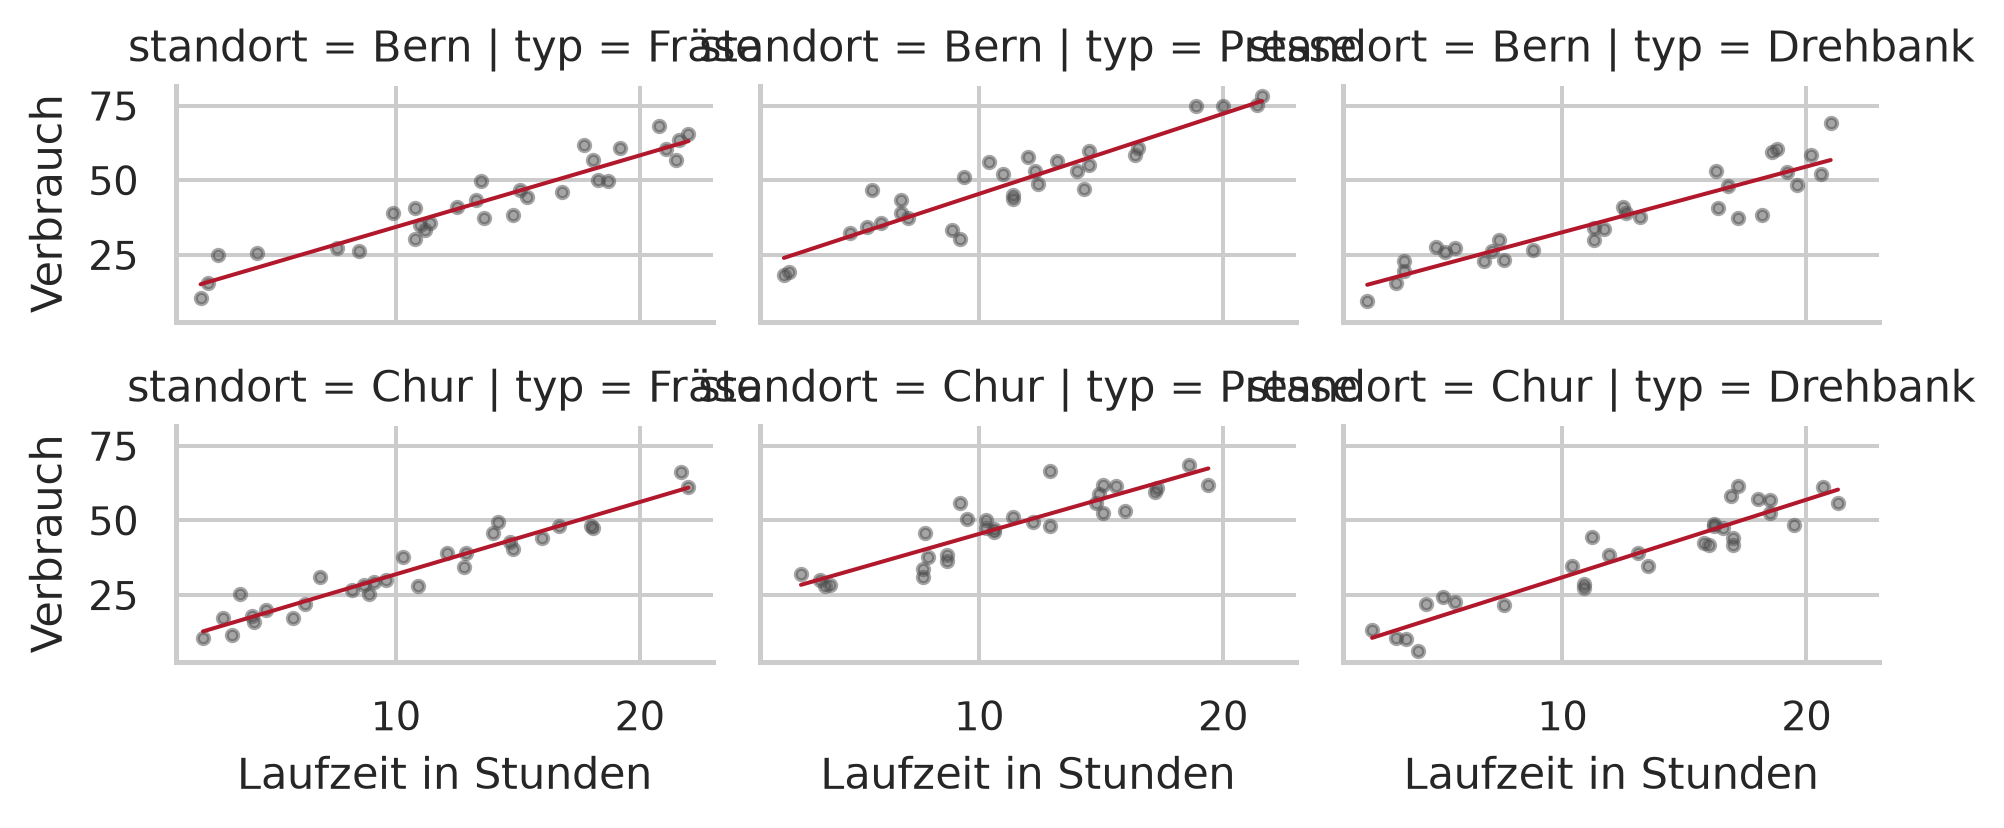
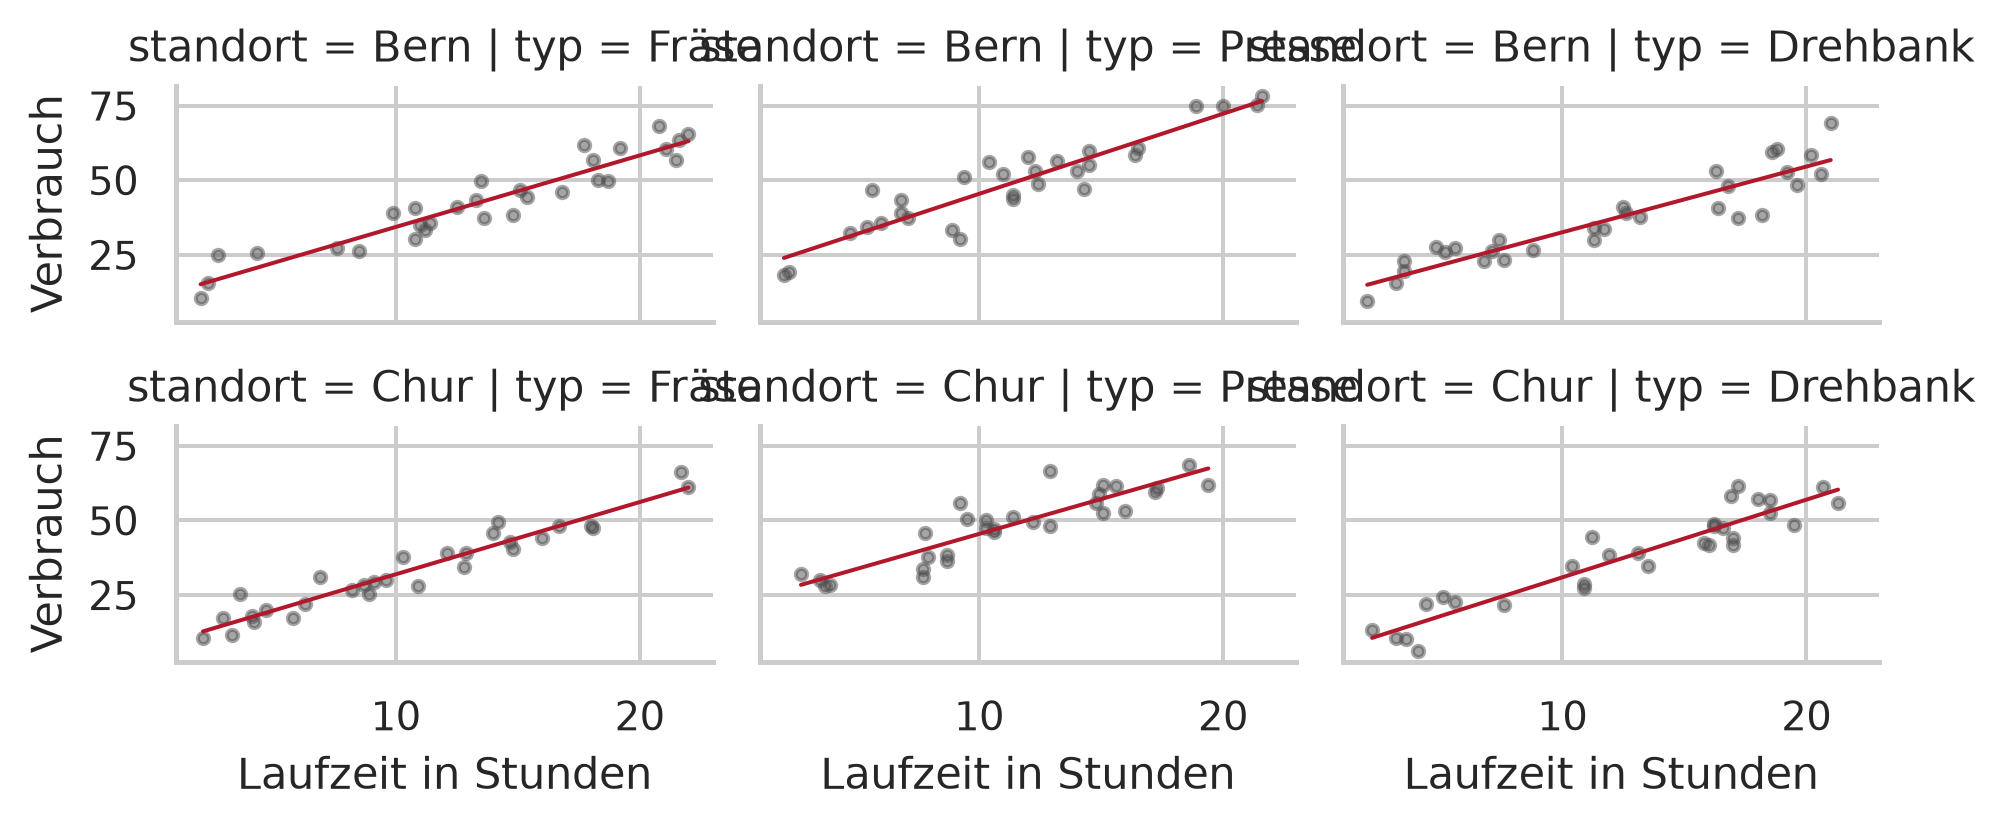
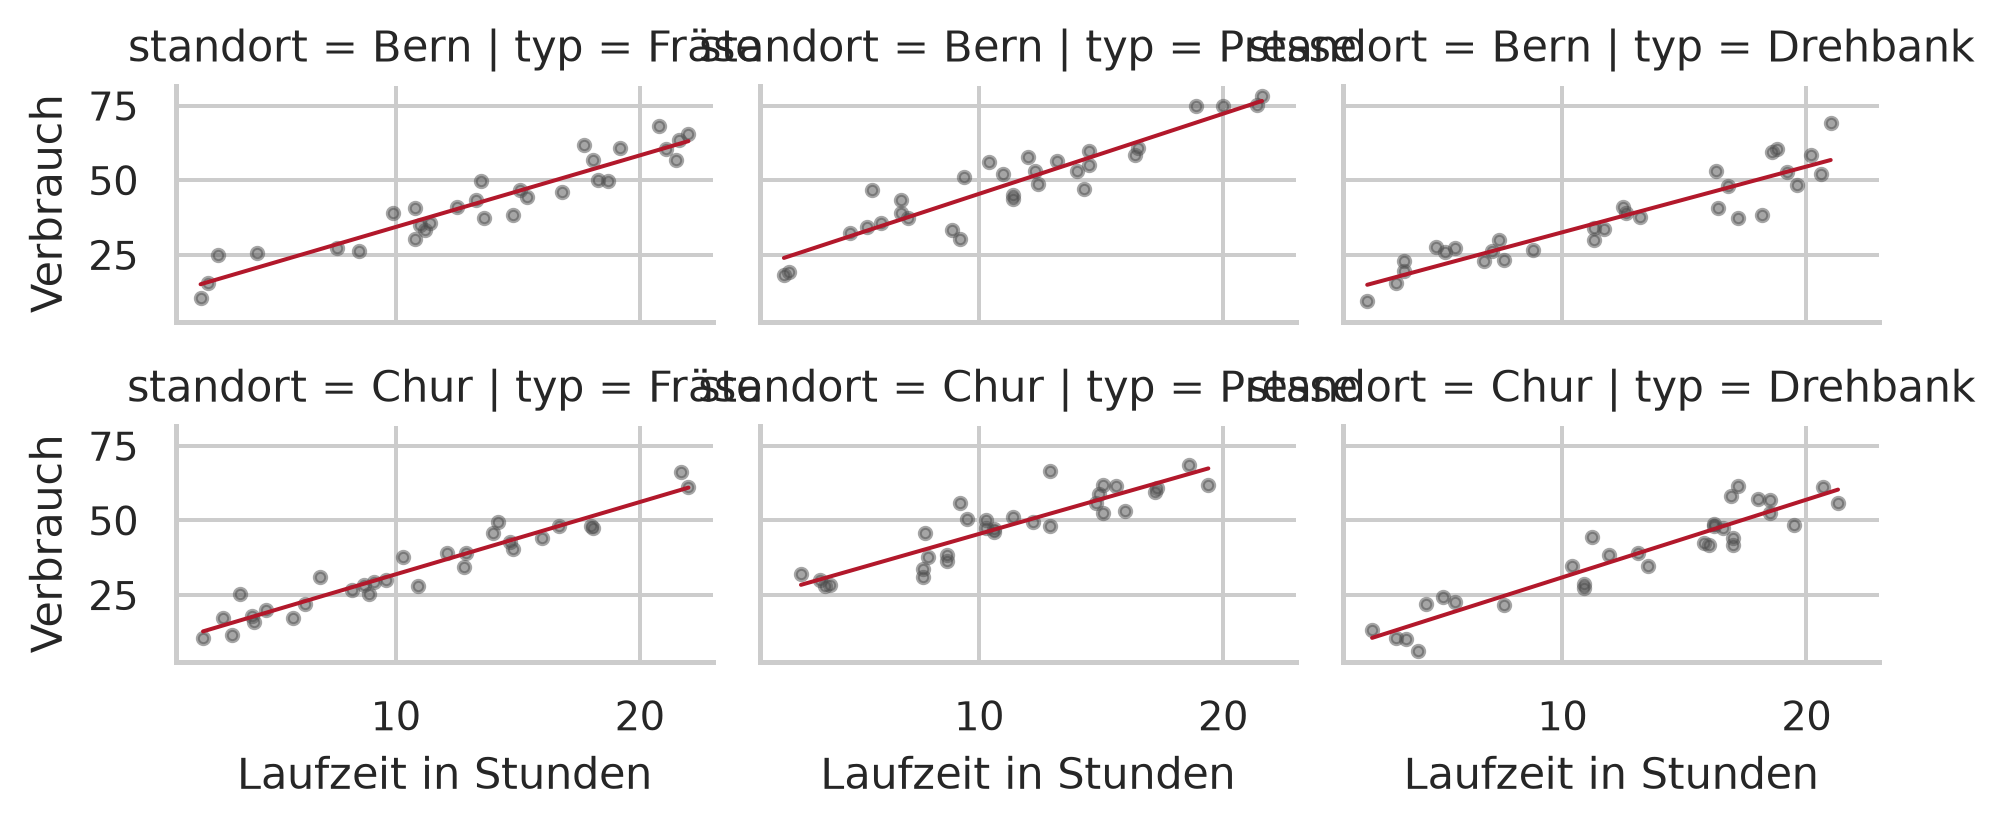
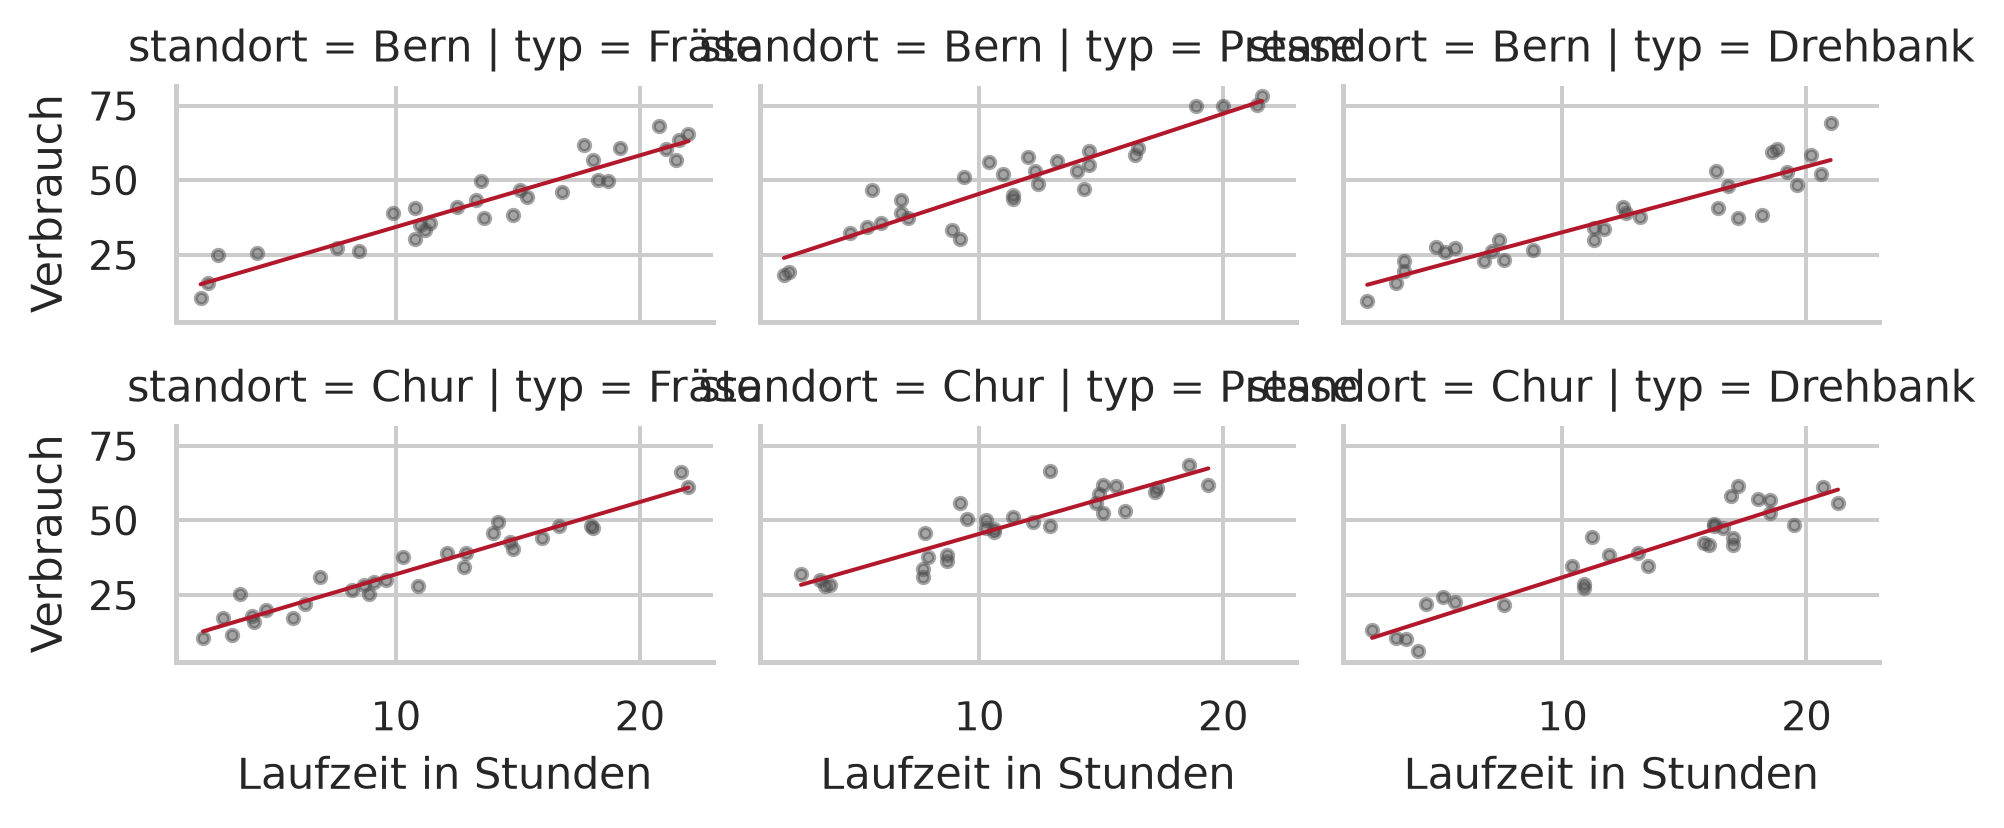
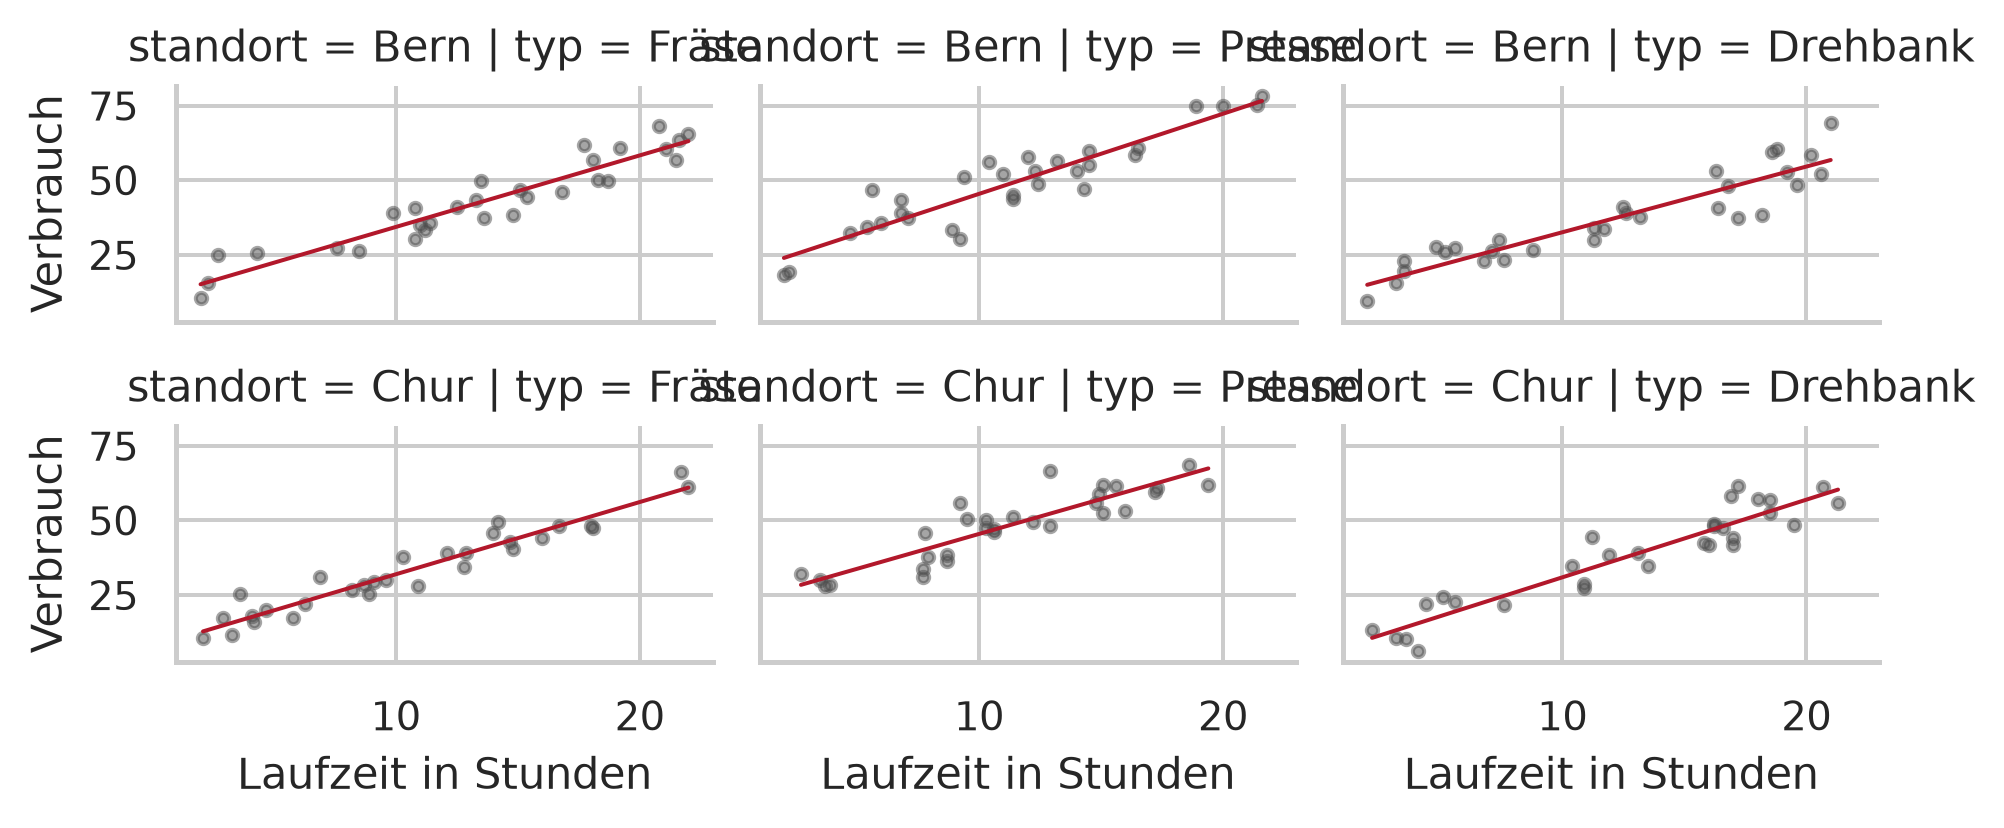
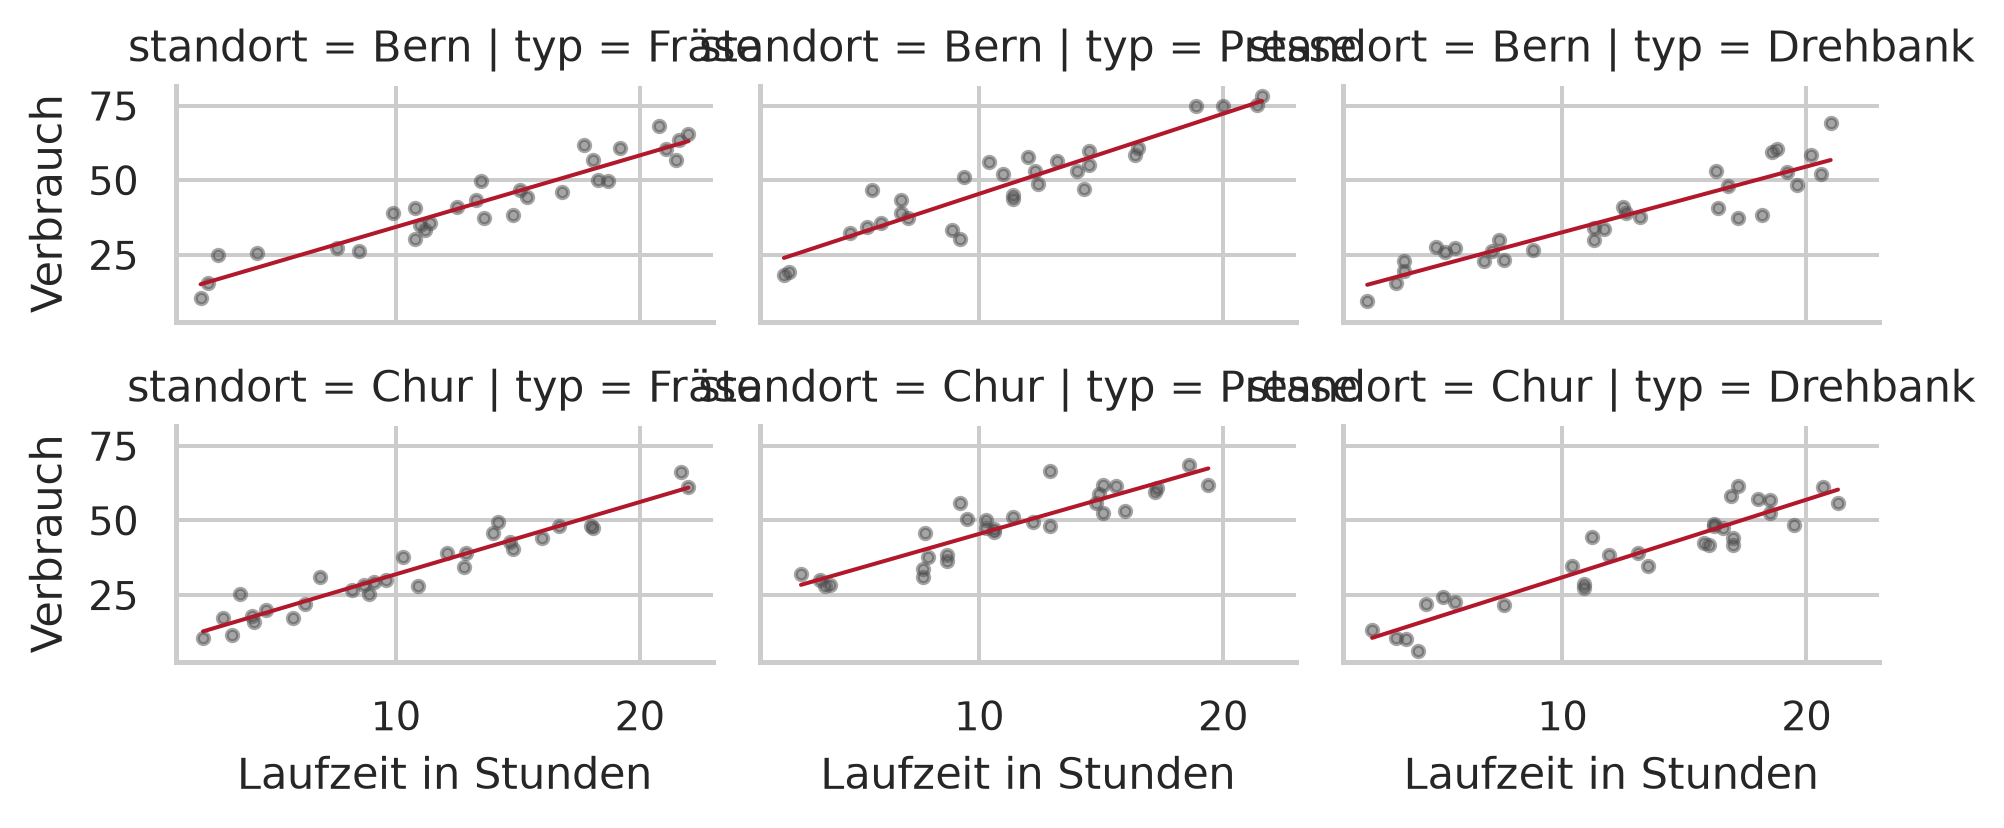
Der Zusammenhang zwischen Laufzeit und Verbrauch, aufgeteilt nach Typ und Standort. Einmal über Farbe, einmal über Facetten und die Frage, welche der beiden die sechs Gruppen lesbar macht.

Rechnung

ggplot(maschinen, aes(laufzeit, verbrauch, colour = typ, shape = standort)) +
  geom_point(alpha = 0.7)
Abbildung 14: Sechs Gruppen über Farbe und Form.
ggplot(maschinen, aes(laufzeit, verbrauch)) +
  geom_point(alpha = 0.5, size = 1.2) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE,
              colour = "#b2182b", linewidth = 0.8) +
  facet_grid(standort ~ typ) +
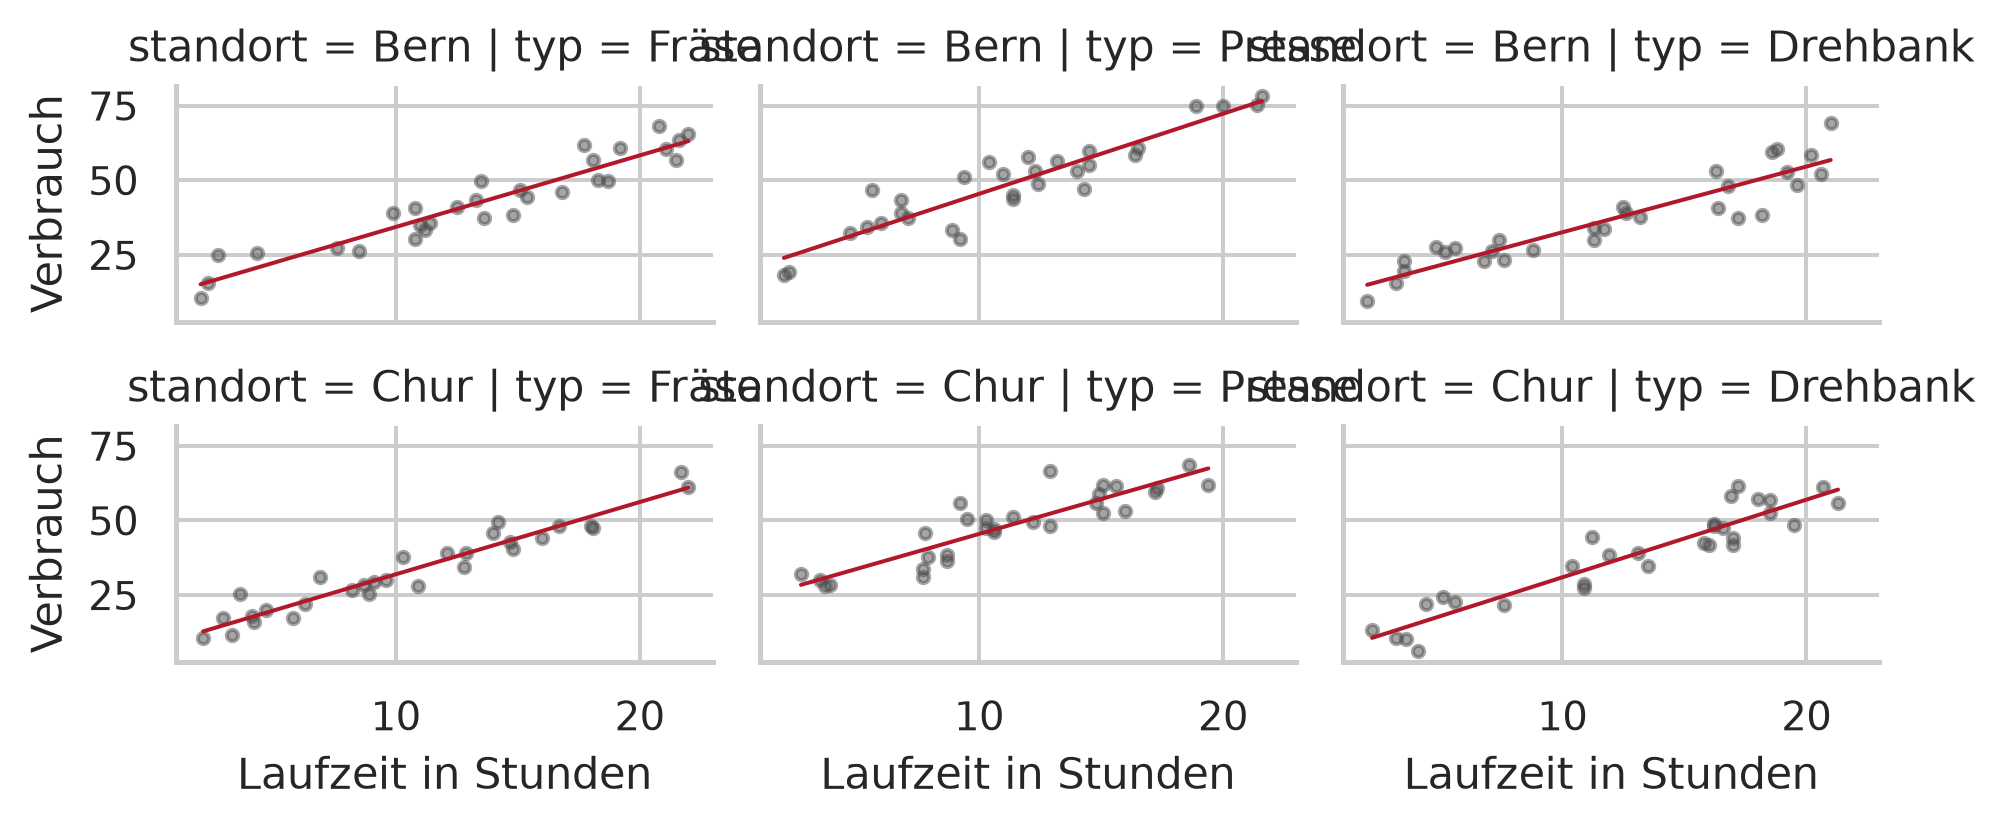
  labs(x = "Laufzeit in Stunden", y = "Verbrauch")
Abbildung 15: Dieselben sechs Gruppen als Facetten, mit gemeinsamen Achsen.
steigungen <- sapply(levels(maschinen$typ), function(tp) {
  teil <- maschinen[maschinen$typ == tp, ]
  unname(coef(lm(verbrauch ~ laufzeit, data = teil))[2])
})
round(steigungen, 3)
Drehbank    Fräse   Presse 
   2.384    2.457    2.534 
round(c(gesamt = unname(coef(lm(verbrauch ~ laufzeit, data = maschinen))[2])), 3)
gesamt 
 2.358 
round(with(maschinen, tapply(verbrauch, list(typ, standort), mean)), 2)
          Bern  Chur
Drehbank 37.04 38.13
Fräse    42.83 33.36
Presse   49.02 48.27
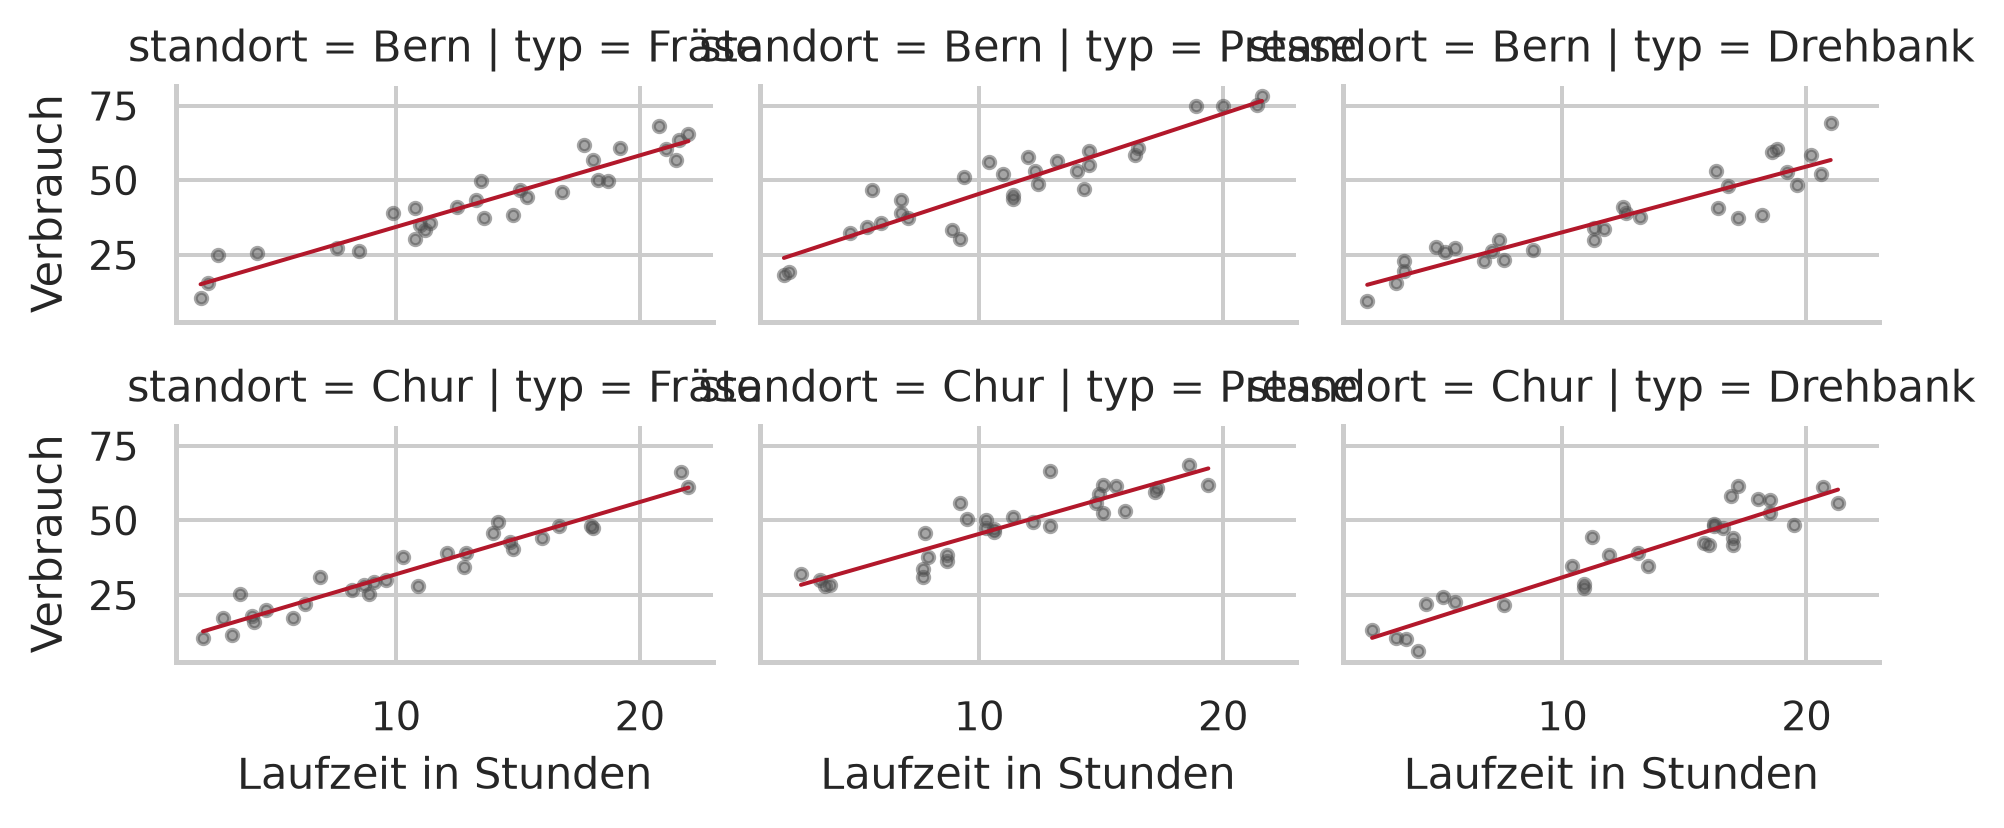
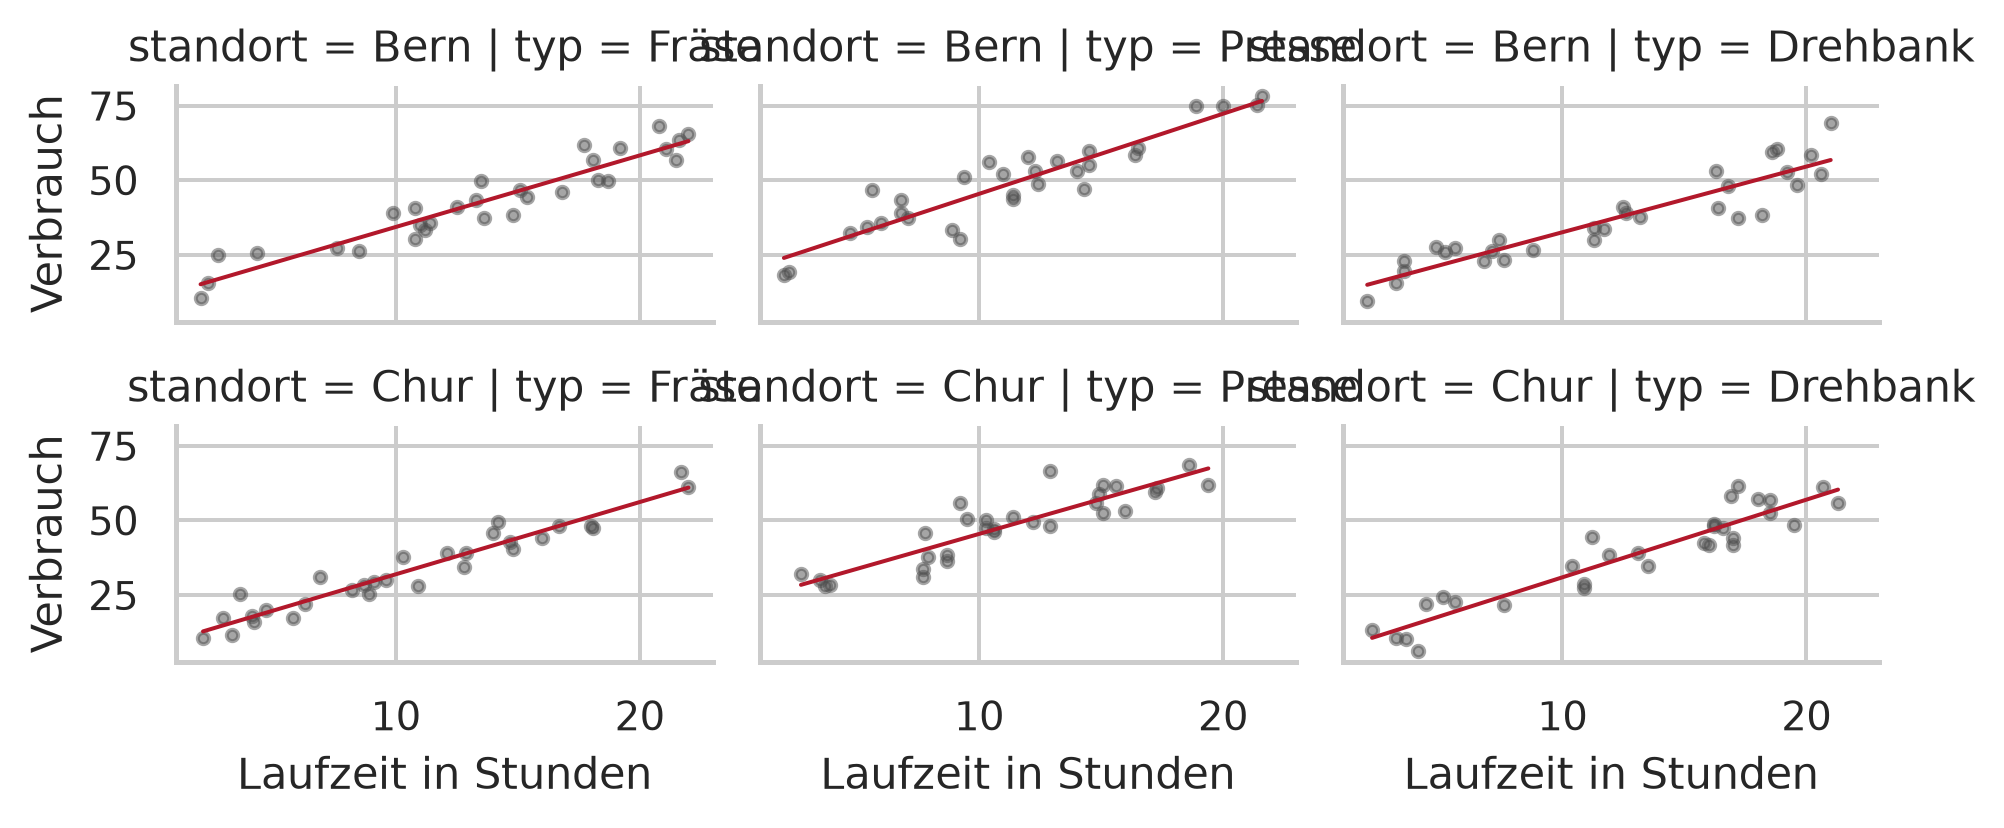
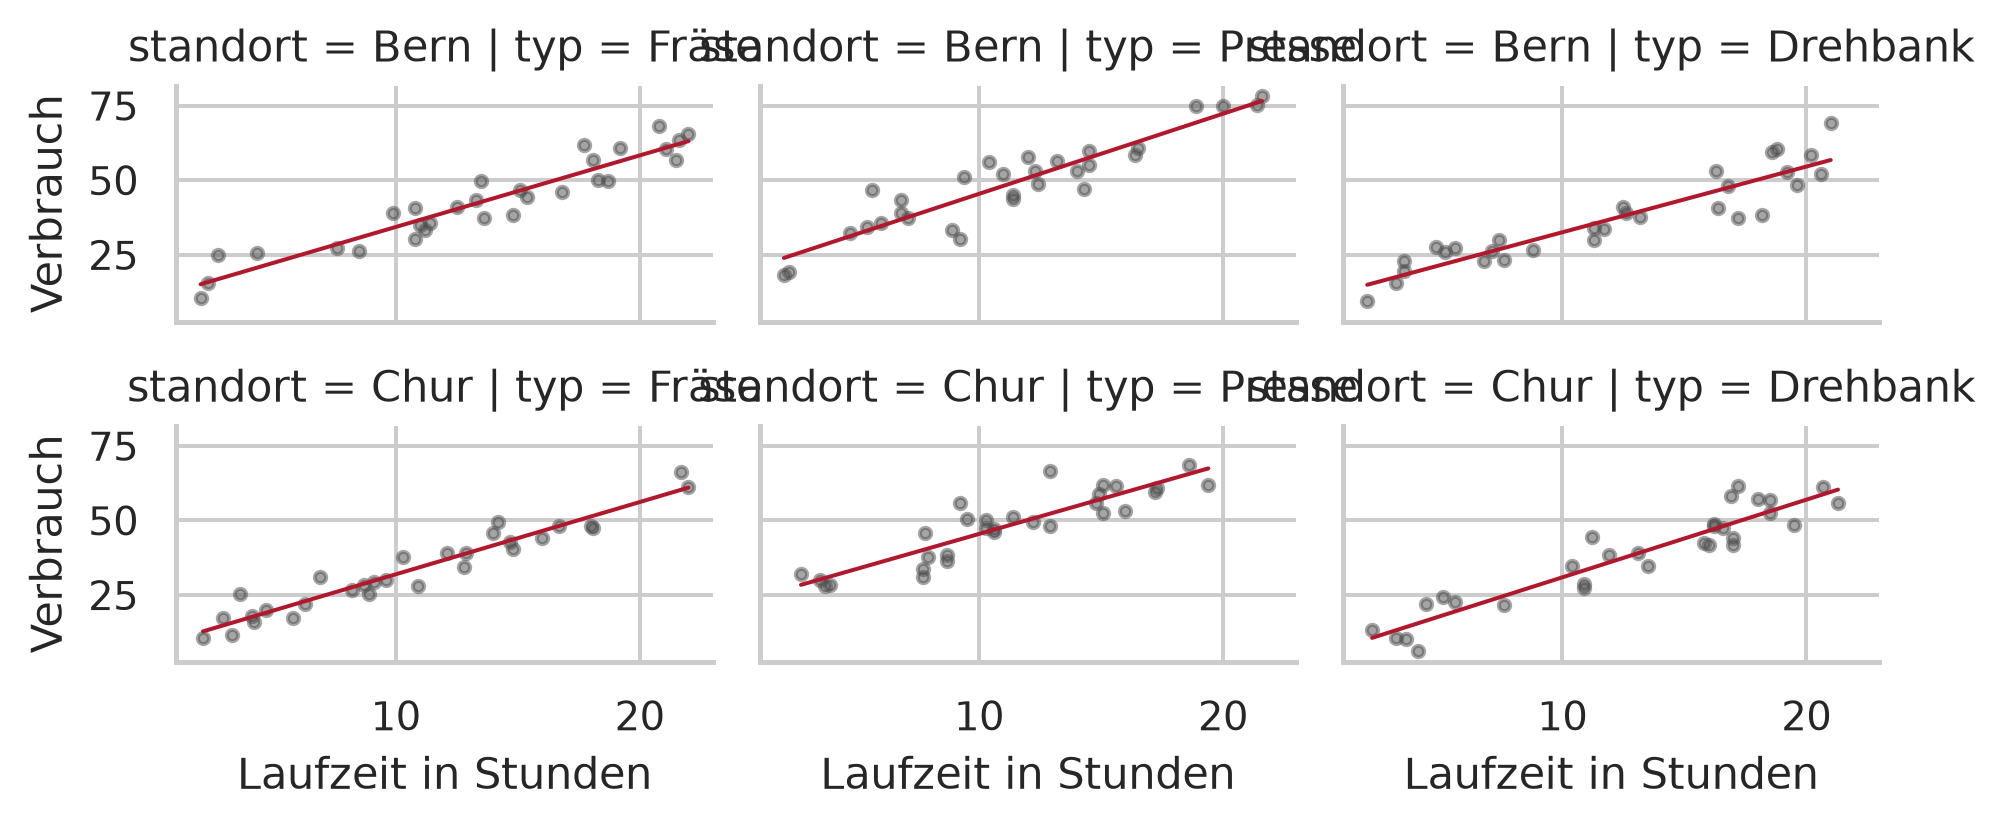
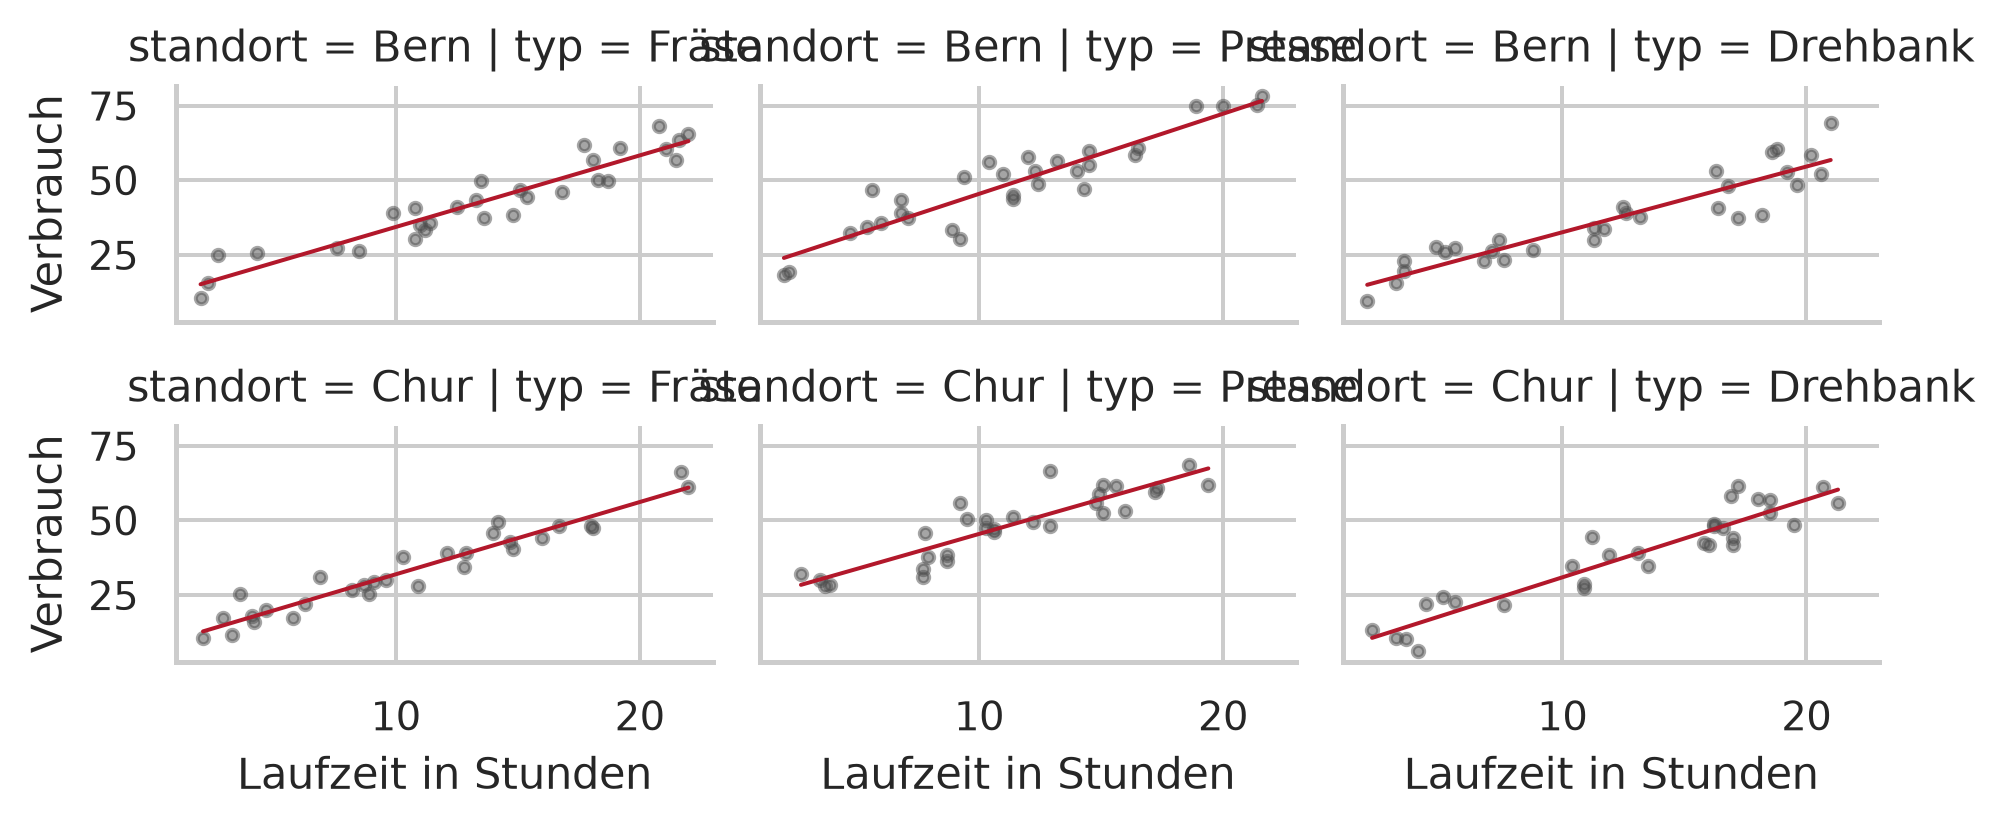
gitter = sns.FacetGrid(maschinen, row="standort", col="typ", height=1.5,
                       aspect=1.5)
_ = gitter.map_dataframe(sns.regplot, x="laufzeit", y="verbrauch",
                         scatter_kws={"s": 8, "alpha": 0.5, "color": "0.3"},
                         line_kws={"color": "#b2182b", "linewidth": 1},
                         ci=None)
Abbildung 16: Beispiel 4: dieselben Facetten in seaborn.
_ = gitter.set_axis_labels("Laufzeit in Stunden", "Verbrauch")
Abbildung 17: Beispiel 4: dieselben Facetten in seaborn.
plt.show()
Abbildung 18: Beispiel 4: dieselben Facetten in seaborn.
Abbildung 19: Beispiel 4: dieselben Facetten in seaborn.
steigungen = {tp: round(float(np.polyfit(teil["laufzeit"], teil["verbrauch"], 1)[0]), 3)
              for tp, teil in maschinen.groupby("typ")}

print(steigungen)

print({"gesamt": round(float(np.polyfit(maschinen["laufzeit"],
                                        maschinen["verbrauch"], 1)[0]), 3)})

print(maschinen.pivot_table(index="typ", columns="standort",
                            values="verbrauch", aggfunc="mean").round(2))

Output Zeile für Zeile

Typ Steigung je Stunde
Drehbank 2.384
Fräse 2.457
Presse 2.534
gesamt 2.358

Mittlerer Verbrauch je Typ und Standort:

Bern Chur
Drehbank 37.04 38.13
Fräse 42.83 33.36
Presse 49.02 48.27
Beobachtung Erklärung
Sechs Gruppen über Farbe und Form sind kaum zu trennen Drei Farben mal zwei Formen, und die Punkte überlagern sich. Das Auge muss zwei Kanäle gleichzeitig auflösen, beide vom unteren Ende der Rangfolge.
Die Facetten geben jeder Gruppe eigene Fläche Position statt Farbe, Rang 2 statt Rang 7, siehe Wahrnehmung und Kodierung.
Die gemeinsamen Achsen sind der Punkt Ohne sie wären die sechs Teilbilder sechs getrennte Grafiken. facet_grid setzt sie von sich aus gemeinsam; scales = "free" würde sie freigeben und die Vergleichbarkeit zerstören.
Die Steigungen sind in allen Typen fast gleich 2.384, 2.457, 2.534, konstruiert waren 2.4. Die Facetten zeigen das auf einen Blick.
Die Gesamtsteigung ist mit 2.358 kleiner als jede einzelne Weil die Pressen ihren Zuschlag unabhängig von der Laufzeit haben und die gemeinsame Gerade dadurch flacher wird. Ein kleiner Verwandter des Simpson-Paradox.
Ein Unterschied fällt erst in der Tabelle auf Fräsen in Bern liegen bei 42.83, in Chur bei 33.36, fast zehn Einheiten. Bei den anderen Typen ist der Standortunterschied unter 1.1.

facet_wrap gegen facet_grid:

Funktion Aufteilung Wann
facet_wrap(~ a) eine Variable, umgebrochen viele Stufen einer Variablen
facet_grid(a ~ b) Zeilen mal Spalten zwei Variablen, vollständige Kreuztabelle
facet_grid(. ~ b) nur Spalten wie facet_wrap, aber in einer Reihe

In Python heisst das sns.FacetGrid(row=, col=) oder sns.relplot(...).

Interpretation und Ergebnissatz

In allen drei Maschinentypen steigt der Verbrauch mit 2.384 bis 2.534 je Stunde fast gleich stark, während die gemeinsame Gerade mit 2.358 flacher ausfällt. Die Facetten mit gemeinsamen Achsen machen das sichtbar; über Farbe und Form kodiert sind die sechs Gruppen nicht mehr zu trennen.

Frage und Datenlage

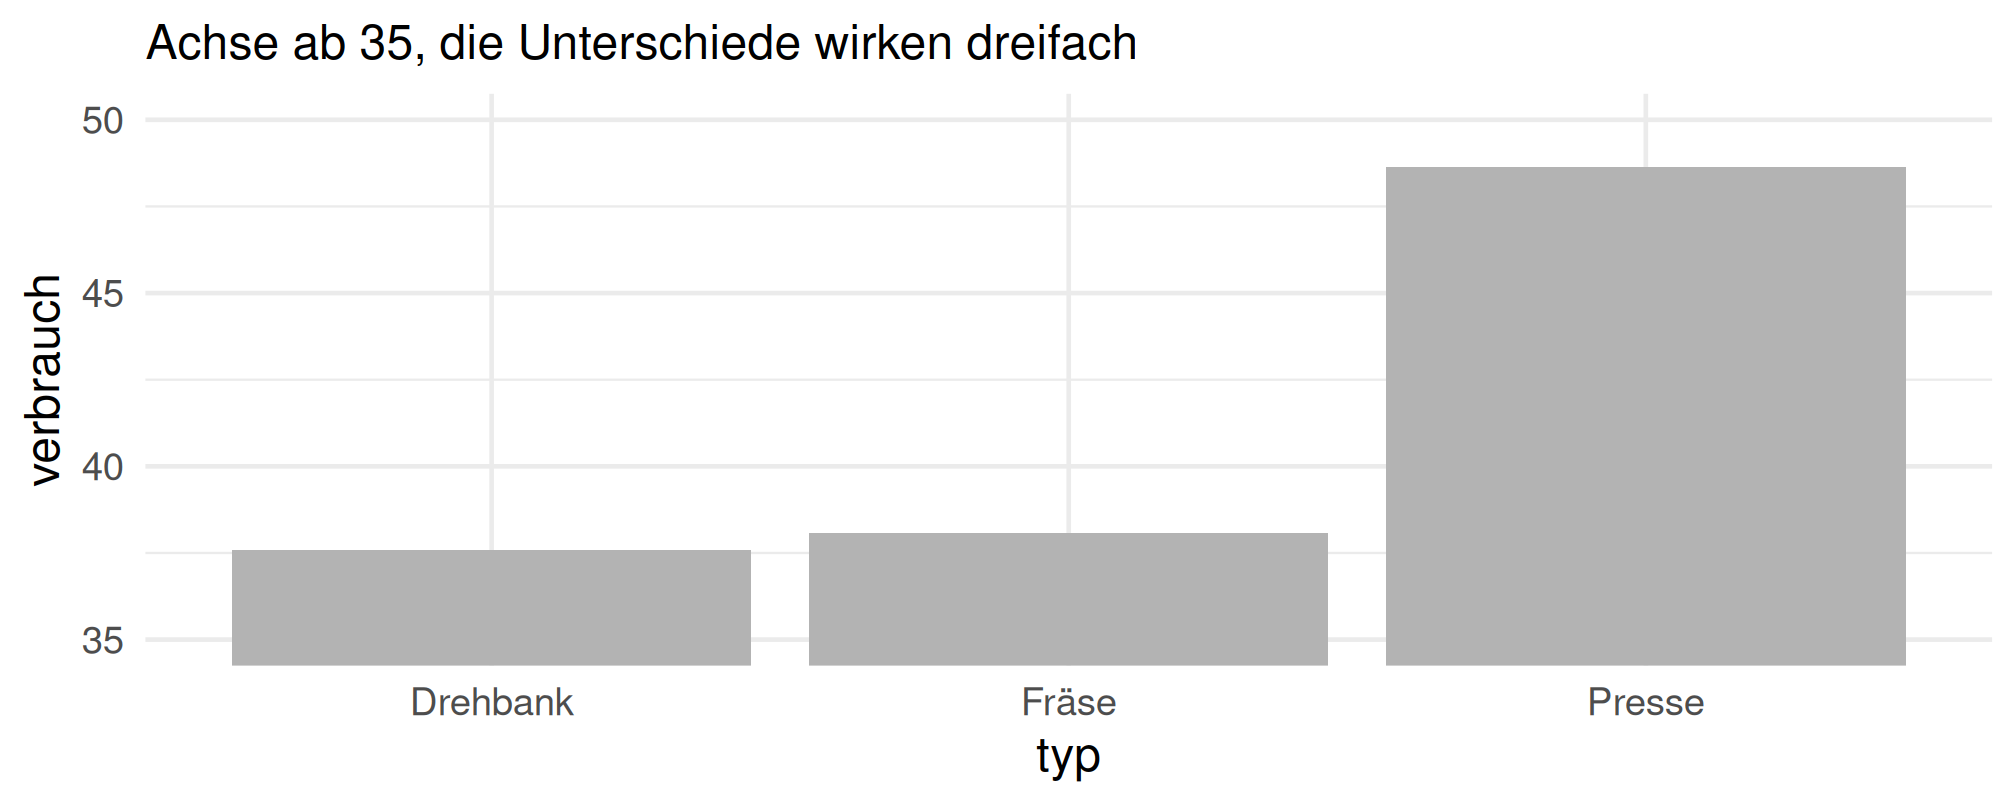
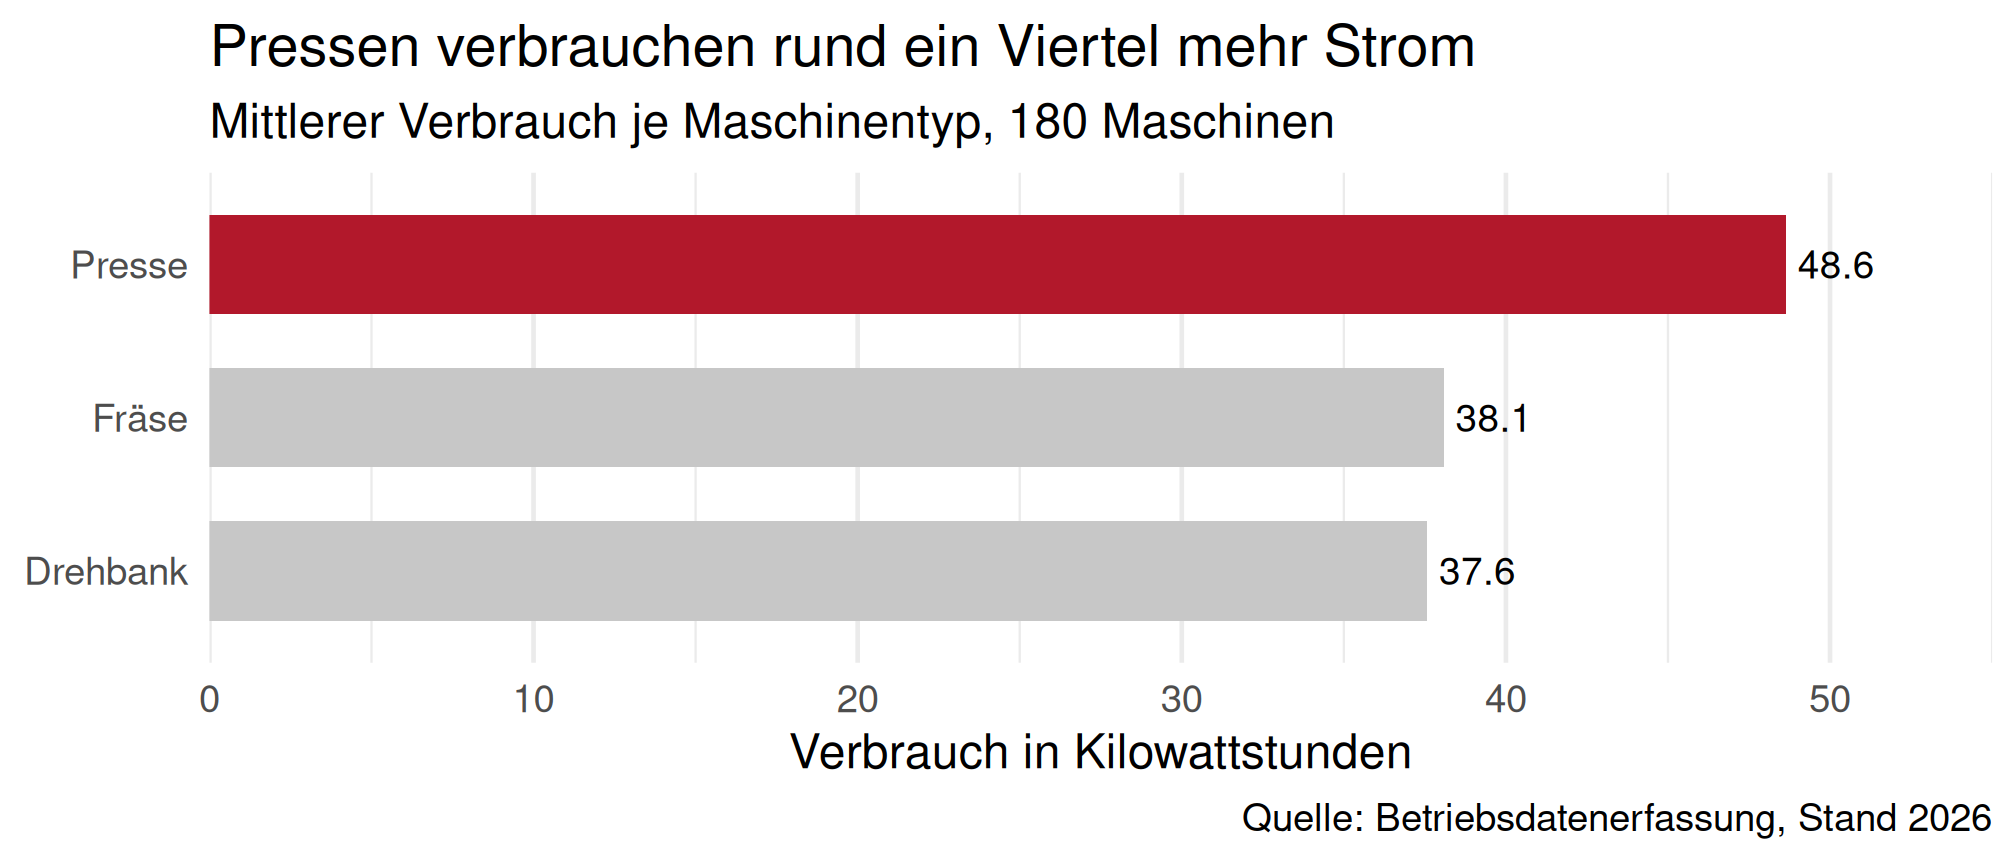
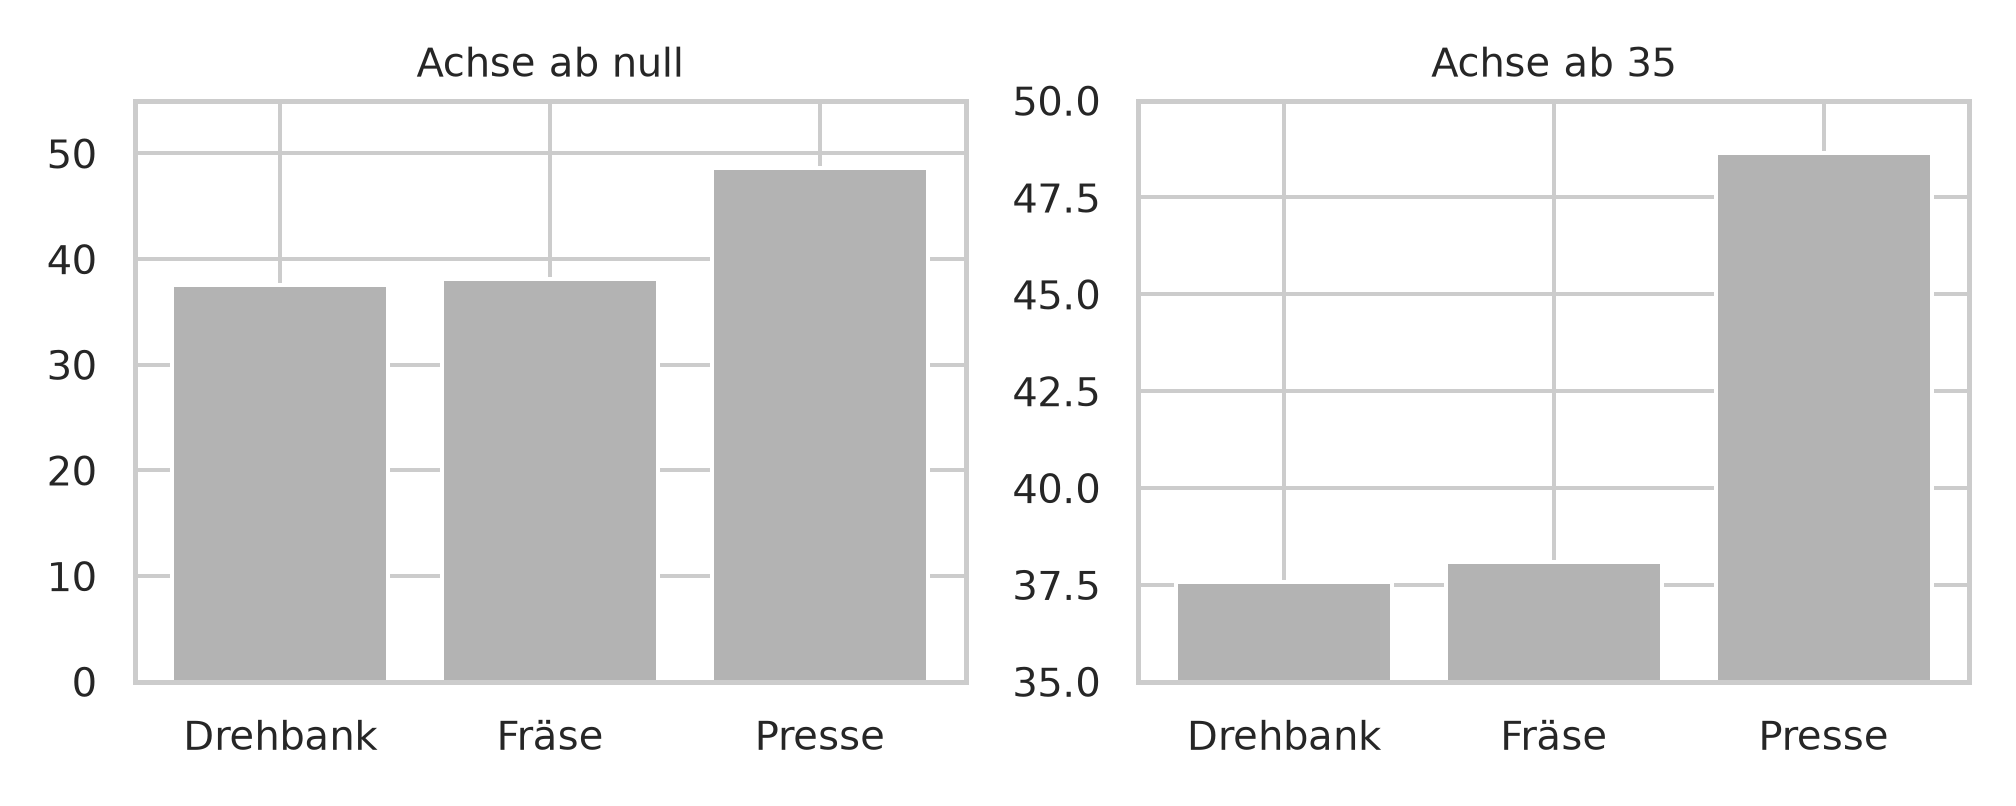
Die mittleren Verbrauchswerte je Typ als Balken, einmal mit Achse ab null, einmal ab 35. Dazu die fertige Fassung mit Beschriftung, wie sie in einen Bericht gehört.

Rechnung

mittel <- maschinen |>
  group_by(typ) |>
  summarise(verbrauch = mean(verbrauch)) |>
  as.data.frame()
mittel$verbrauch <- round(mittel$verbrauch, 2)
mittel
       typ verbrauch
1 Drehbank     37.58
2    Fräse     38.09
3   Presse     48.65
laengen <- mittel$verbrauch - 35
round(c(echtes_verhaeltnis = max(mittel$verbrauch) / min(mittel$verbrauch),
        ab_35_dargestellt = max(laengen) / min(laengen),
        verzerrung = (max(laengen) / min(laengen)) /
          (max(mittel$verbrauch) / min(mittel$verbrauch))), 2)
echtes_verhaeltnis  ab_35_dargestellt         verzerrung 
              1.29               5.29               4.09 
ggplot(mittel, aes(typ, verbrauch)) +
  geom_col(fill = "grey70") +
  coord_cartesian(ylim = c(35, 50)) +
  labs(subtitle = "Achse ab 35, die Unterschiede wirken dreifach")
Abbildung 20: Links Achse ab null, rechts ab 35, dieselben drei Zahlen.
ggplot(mittel, aes(reorder(typ, verbrauch), verbrauch)) +
  geom_col(aes(fill = typ == "Presse"), width = 0.65) +
  geom_text(aes(label = sprintf("%.1f", verbrauch)), hjust = -0.15, size = 3.4) +
  scale_fill_manual(values = c(`FALSE` = "#c7c7c7", `TRUE` = "#b2182b"),
                    guide = "none") +
  scale_y_continuous(limits = c(0, 55), expand = c(0, 0)) +
  coord_flip() +
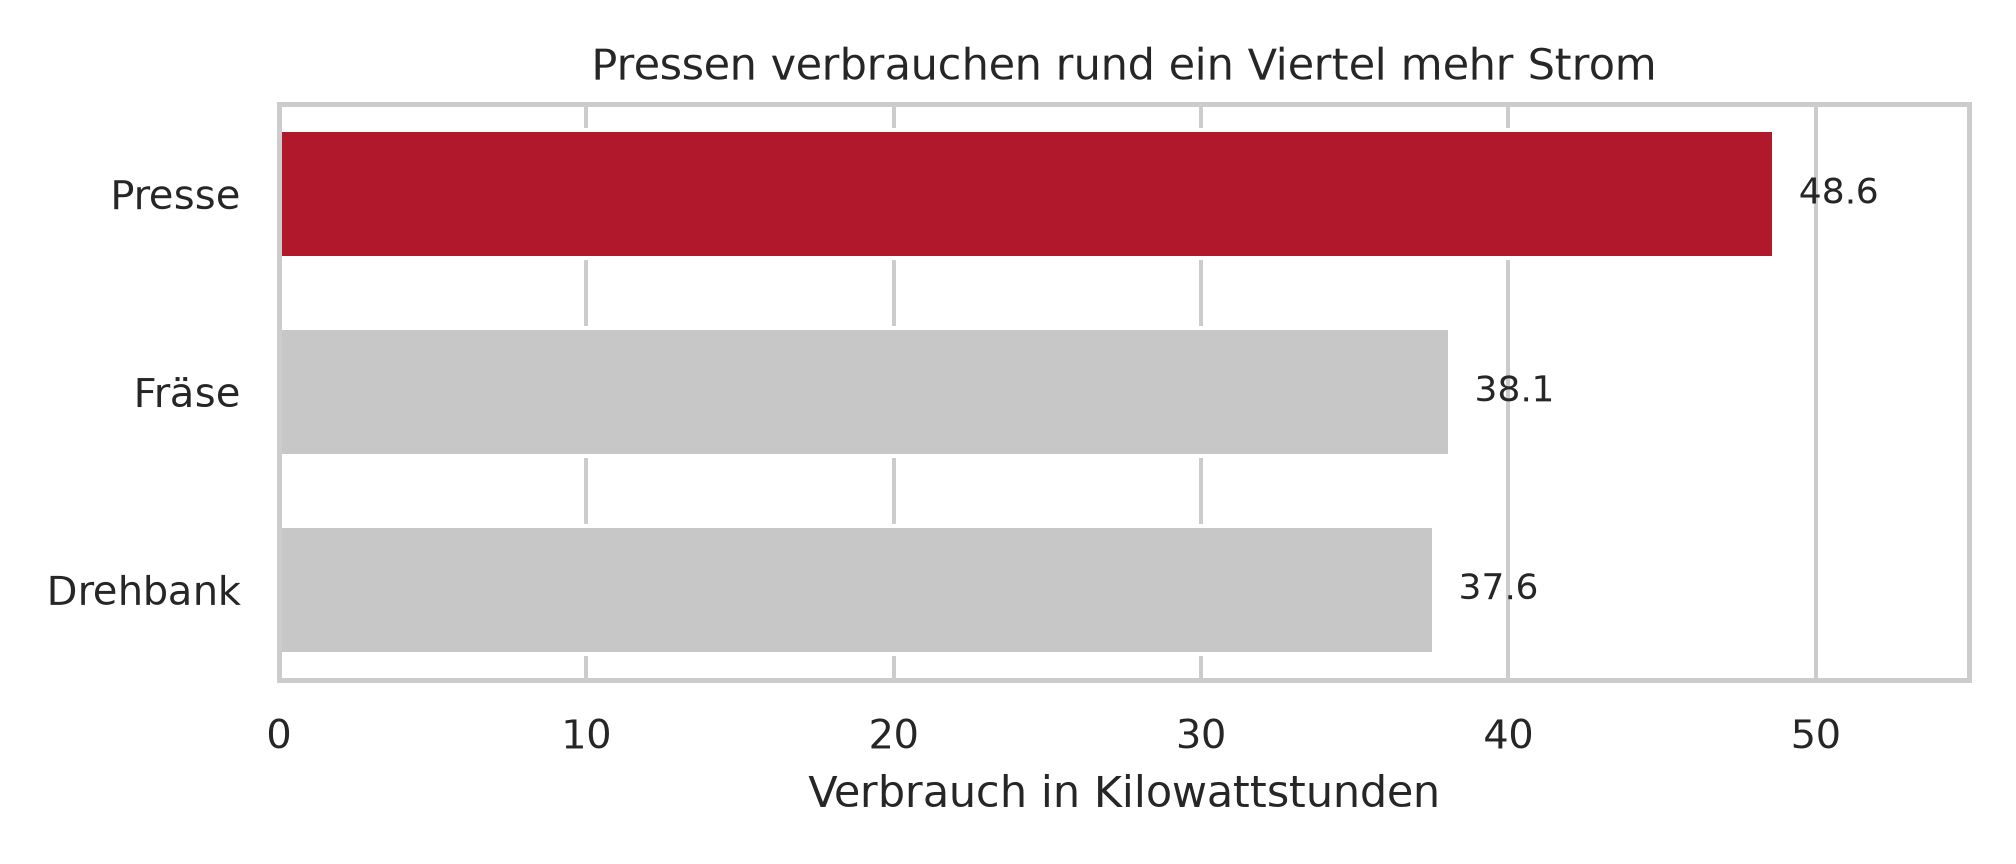
  labs(title = "Pressen verbrauchen rund ein Viertel mehr Strom",
       subtitle = "Mittlerer Verbrauch je Maschinentyp, 180 Maschinen",
       x = NULL, y = "Verbrauch in Kilowattstunden",
       caption = "Quelle: Betriebsdatenerfassung, Stand 2026") +
  theme(panel.grid.major.y = element_blank())
Abbildung 21: Die Fassung für den Bericht: Achse ab null, Akzent, Beschriftung.
mittel = maschinen.groupby("typ")["verbrauch"].mean().round(2)
Abbildung 22: Beispiel 5: dieselbe Gegenüberstellung in matplotlib.
print(mittel)
Abbildung 23: Beispiel 5: dieselbe Gegenüberstellung in matplotlib.
laengen = mittel - 35
Abbildung 24: Beispiel 5: dieselbe Gegenüberstellung in matplotlib.
print({"echtes_verhaeltnis": round(float(mittel.max() / mittel.min()), 2),
       "ab_35_dargestellt": round(float(laengen.max() / laengen.min()), 2),
       "verzerrung": round(float((laengen.max() / laengen.min())
                                 / (mittel.max() / mittel.min())), 2)})
Abbildung 25: Beispiel 5: dieselbe Gegenüberstellung in matplotlib.
fig, achsen = plt.subplots(1, 2, figsize=(7, 2.8))
Abbildung 26: Beispiel 5: dieselbe Gegenüberstellung in matplotlib.
_ = achsen[0].bar(mittel.index, mittel.to_numpy(), color="0.7")
_ = achsen[0].set_ylim(0, 55)
_ = achsen[0].set_title("Achse ab null", fontsize=10)
_ = achsen[1].bar(mittel.index, mittel.to_numpy(), color="0.7")
_ = achsen[1].set_ylim(35, 50)
_ = achsen[1].set_title("Achse ab 35", fontsize=10)
plt.tight_layout()
plt.show()
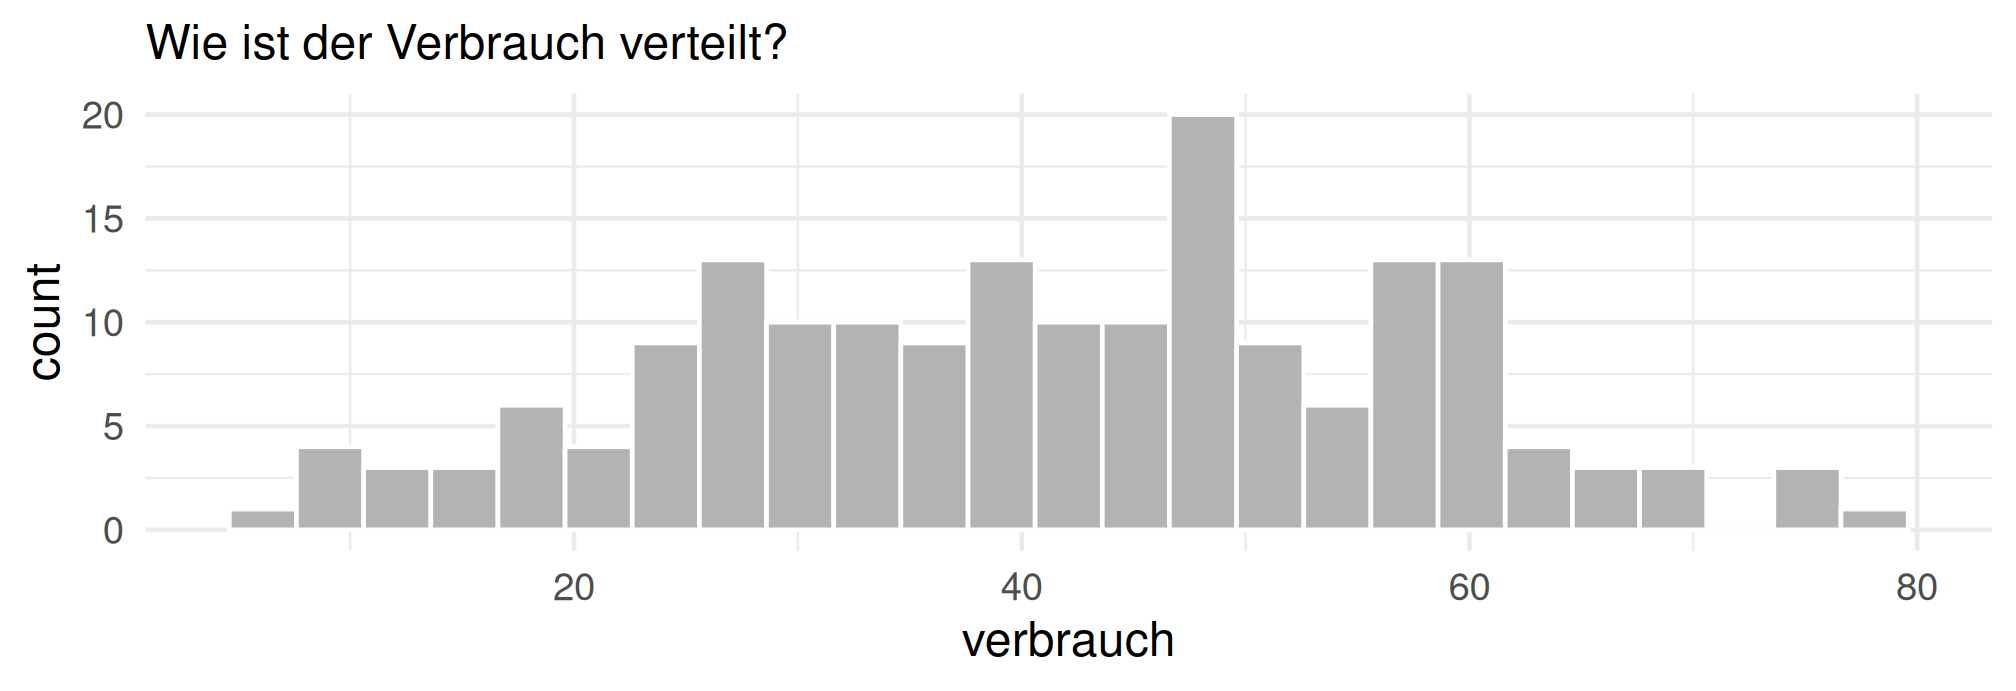
Abbildung 27: Beispiel 5: dieselbe Gegenüberstellung in matplotlib.
sortiert = mittel.sort_values()
farben = ["#b2182b" if name == "Presse" else "#c7c7c7" for name in sortiert.index]

fig, achse = plt.subplots(figsize=(7, 3))
_ = achse.barh(sortiert.index, sortiert.to_numpy(), color=farben, height=0.65)
for y, wert in enumerate(sortiert.to_numpy()):
    _ = achse.text(wert + 0.8, y, f"{wert:.1f}", va="center", fontsize=9)
_ = achse.set_xlim(0, 55)
_ = achse.set_title("Pressen verbrauchen rund ein Viertel mehr Strom")
_ = achse.set_xlabel("Verbrauch in Kilowattstunden")
_ = achse.grid(axis="y", visible=False)
plt.tight_layout()
plt.show()
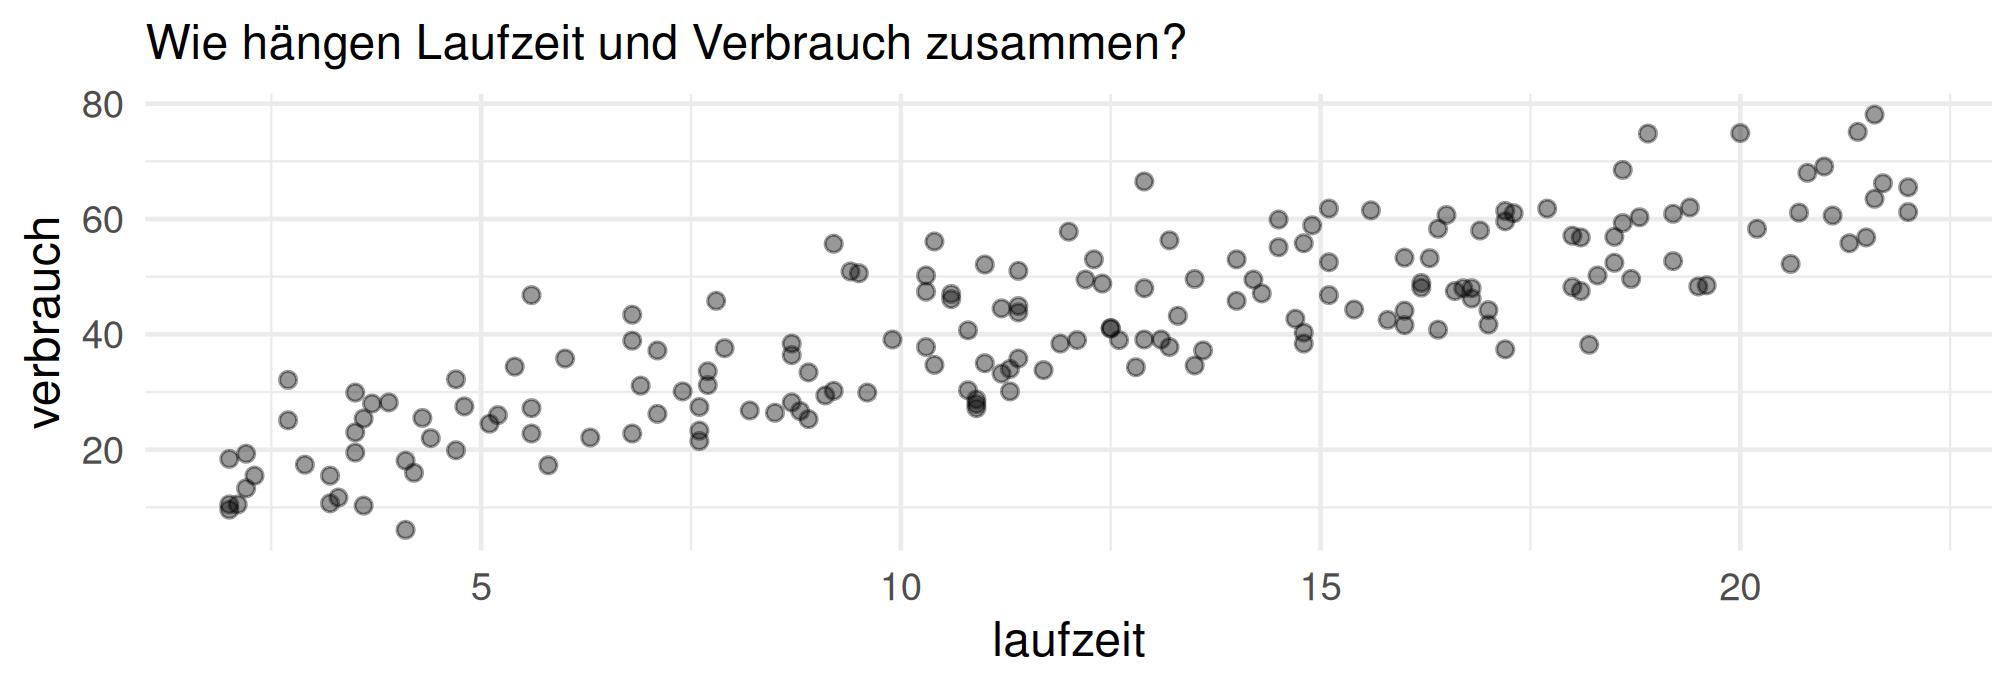
Abbildung 28: Die Fassung für den Bericht in matplotlib.

Output Zeile für Zeile

Typ mittlerer Verbrauch
Drehbank 37.58
Fräse 38.10
Presse 48.65
Kennzahl Wert
echtes Verhältnis Presse zu Drehbank 1.29
als Balkenlänge bei Achse ab 35 4.20
Verzerrung 3.24-fach
Beobachtung Erklärung
Pressen verbrauchen 29 Prozent mehr als Drehbänke 48.65 gegen 37.58. Das ist der Befund, und er ist deutlich genug.
Ab 35 gezeichnet sieht es nach Faktor 4.2 aus Eine Übertreibung um das 3.24-Fache. coord_cartesian(ylim = …) macht das mit einer Zeile, deshalb passiert es so leicht.
coord_cartesian schneidet, scale_y_continuous(limits =) wirft weg Der Unterschied ist wichtig: Letzteres entfernt Datenpunkte vor der Berechnung und verändert damit Glättungslinien und Statistiken.
Die Berichtsfassung sortiert, betont und beschriftet reorder() sortiert nach Wert, eine Akzentfarbe hebt die Pressen heraus, geom_text schreibt die Zahlen an und der Titel nennt die Aussage statt des Diagrammtyps.
expand = c(0, 0) entfernt den Rand unter null Sonst schwebt der Balken sichtbar über der Achse, was den Nullpunkt wieder unklar macht.

Die Beschriftungsteile, die labs() kennt:

Argument Inhalt
title die Aussage in einem Satz
subtitle Datengrundlage, Zeitraum, Fallzahl
x, y Merkmal und Einheit; NULL blendet aus, wenn die Kategorien selbsterklärend sind
caption Quelle und Stand

Vier Zeilen, die aus einer Ausgabe eine Abbildung machen. Mehr dazu unter Storytelling.

Interpretation und Ergebnissatz

Pressen verbrauchen im Mittel 48.65 gegenüber 37.58 bei Drehbänken, also das 1.29-Fache. Mit einer Achse ab 35 erscheinen die Balken im Verhältnis 4.20, eine Verzerrung um den Faktor 3.24.

Verständnisfragen

ggplot(daten, aes(x, y)) allein zeichnet nichts. Warum?

Ohne Geom gibt es keine Objekte, nur Achsen
Richtig. Zuordnung und Darstellung sind in der Grammatik getrennt: aes() legt fest, welche Variable auf welchen Kanal kommt, das Geom, womit gezeichnet wird.
Die Daten sind falsch formatiert
Bei falschem Format käme eine Fehlermeldung, keine leere Grafik mit korrekten Achsen.
Es fehlt ein print()
In einem Quarto-Chunk wird das Objekt automatisch ausgegeben.

geom_point(aes(colour = "blue")) erzeugt rote Punkte und eine Legende. Warum?

Innerhalb von aes() wird “blue” als Datenwert behandelt
Richtig. Es entsteht eine Variable mit einem einzigen Wert, die eine Skala und eine Legende bekommt; die erste Farbe der Standardpalette ist rot. Fester Wert gehört ausserhalb von aes().
“blue” ist kein gültiger Farbname
Er ist gültig; nur steht er an der falschen Stelle.
Die Standardpalette ist falsch eingestellt
Sie verhält sich wie vorgesehen.

Wann nimmt man geom_col statt geom_bar?

Wenn die Werte bereits berechnet vorliegen
Richtig. geom_bar zählt selbst und braucht nur ein x; geom_col nimmt fertige y-Werte. Die Verwechslung ist die häufigste Ursache für eine unerwartet leere Grafik.
Wenn die Balken waagrecht sein sollen
Dafür ist coord_flip() oder ein Tausch der Zuordnung zuständig.
geom_col ist die neuere Schreibweise für dasselbe
Die beiden tun Verschiedenes.

Sechs Gruppen sollen in einem Streudiagramm unterschieden werden. Farbe plus Form oder Facetten?

Facetten, weil sie Position statt Farbe verwenden
Richtig. Position auf getrennten Skalen ist Rang 2 der Kanalrangfolge, Farbton Rang 7. Wichtig sind dabei die gemeinsamen Achsen, sonst sind die Teilbilder nicht vergleichbar.
Farbe plus Form, das spart Platz
Platz wird gespart, Lesbarkeit verloren: Das Auge muss zwei schwache Kanäle gleichzeitig auflösen.
Beides zusammen, das ist am sichersten
Doppelte Kodierung derselben Information ist sinnvoll, hier geht es aber um zwei verschiedene Variablen.

Die mittleren Verbrauchswerte 37.58, 38.10 und 48.65 werden mit einer Achse ab 35 gezeichnet. Wie stark verzerrt das?

Um das 3.24-Fache: aus Verhältnis 1.29 wird 4.20
Richtig. Bei Balken kodiert die Länge die Menge, deshalb muss die Achse bei null beginnen.
Gar nicht, solange die Achse beschriftet ist
Die Beschriftung stimmt, der Eindruck nicht.
Um das Doppelte
Die Rechnung ergibt 4.20 geteilt durch 1.29.

Worin unterscheiden sich coord_cartesian(ylim = …) und scale_y_continuous(limits = …)?

coord_cartesian zoomt, scale_y_continuous entfernt Datenpunkte
Richtig. Beim zweiten werden Werte ausserhalb der Grenzen vor der Berechnung verworfen, was Glättungslinien und Statistiken verändert.
Sie sind gleichwertig
Optisch oft ähnlich, im Ergebnis nicht.
coord_cartesian funktioniert nur bei Balken
Es funktioniert bei jedem Geom.

Verlinkte Ressourcen