Typische Fragestellungen: Hält eine Fertigung das Sollmass ein, entspricht die Füllmenge der Deklaration, erreicht eine Bearbeitungszeit den vereinbarten Richtwert. Gemeinsam ist ihnen eine metrische Messgrösse, eine einzige Gruppe und ein von aussen vorgegebener Vergleichswert.
Entscheidend ist die Herkunft des Sollwerts. Er muss aus der Sache stammen, aus einer Norm, einer Spezifikation oder einer früheren, unabhängigen Messreihe. Ein aus denselben Daten abgeleiteter Wert macht den Test sinnlos, weil dann gegen den eigenen Mittelwert getestet wird.
Gemessen wird der Abstand zwischen Stichprobenmittelwert und Sollwert in Einheiten des Standardfehlers. Ist dieser Abstand grösser, als es der Zufall bei gültigem Sollwert erwarten lässt, spricht das gegen die Nullhypothese.
\[t = \frac{\bar{x} - \mu_0}{s/\sqrt{n}}\]
Bestandteil
Bedeutung
\(\bar{x}\)
Mittelwert der Stichprobe
\(\mu_0\)
vorgegebener Sollwert, die Nullhypothese
\(s\)
Standardabweichung der Stichprobe
\(n\)
Stichprobenumfang
\(s/\sqrt{n}\)
Standardfehler des Mittelwerts
Unter der Nullhypothese folgt \(t\) einer t-Verteilung mit \(n-1\) Freiheitsgraden. Der Test ist damit die Entscheidungsvariante desselben Sachverhalts, den das Konfidenzintervall als Spanne beschreibt: liegt der Sollwert ausserhalb des 95-Prozent-Intervalls, ist der zweiseitige Test auf dem 5-Prozent-Niveau signifikant.
Der Referenzwert stammt aus der Sache, nicht aus der Stichprobe
Herkunft klären
Der Test prüft nichts
anderen Referenzwert wählen
Keine extremen Ausreisser
Einzelne Werte bestimmen den Mittelwert nicht
Boxplot
Das Ergebnis hängt an wenigen Punkten
Ursache prüfen, mit und ohne berichten
Geprüft wird vor der Rechnung und mit den Augen: Boxplot für Ausreisser, QQ-Plot für die Verteilungsform, der Vergleich von Mittelwert und Median für die Schiefe. Ein Normalitätstest beantwortet die falsche Frage, weil er bei kleinem n zu wenig und bei grossem n zu viel findet.
Output lesen
R, t.test(x, mu = sollwert):
Grösse
Was sie sagt
Faustregel oder Falle
One Sample t-test
die Variante
prüfen, dass nicht versehentlich zwei Stichproben übergeben wurden
t
Abweichung vom Sollwert in Einheiten des Standardfehlers
Betrag über etwa 2 heisst bei üblichem n signifikant
df
Freiheitsgrade, hier n minus eins
ganzzahlig, anders als bei Welch
p-value
Wahrscheinlichkeit dieser oder extremerer Daten bei gültigem Sollwert
keine Aussage über die Grösse der Abweichung
95 percent confidence interval
Intervall für den wahren Mittelwert
nicht für die Differenz; der Sollwert wird daran gehalten
mean of x
Stichprobenmittelwert
die Differenz zum Sollwert ist die berichtete Effektgrösse
alternative hypothesis
Richtung
true mean is not equal to 500 nennt den tatsächlich geprüften Wert
Cohens d
standardisierte Abweichung
Anhaltspunkte: 0.2 klein, 0.5 mittel, 0.8 gross
Python, pg.ttest(x, sollwert) liefert eine Zeile mit T, dof, alternative, p_val, CI95, cohen_d, BF10 und power; die Schreibweise dieser Spalten hat sich zwischen den pingouin-Versionen geändert, weshalb die Beispiele hier die Spalten nachschlagen statt sie festzuschreiben. Zwei Unterschiede sind zu beachten: CI95% bezieht sich wie in R auf den Mittelwert selbst, nicht auf die Differenz zum Sollwert, und power bezieht sich auf den beobachteten Effekt, ist also im Nachhinein nur eingeschränkt aussagekräftig. Der Sollwert taucht in der Tabelle nicht auf und gehört deshalb ausdrücklich in den Bericht.
Interpretationsfallen
Nicht signifikant ist kein Nachweis der Übereinstimmung. Wer zeigen will, dass der Sollwert eingehalten wird, braucht einen Äquivalenztest.
Signifikanz ist keine Relevanz. Bei 5000 Messungen wird eine Abweichung von einem Hundertstel Millimeter signifikant. Die Toleranz entscheidet, nicht der p-Wert.
Das Intervall gilt dem Mittelwert, nicht den Einzelwerten. Für die Frage, wie viele Werkstücke innerhalb der Toleranz liegen, ist es das falsche Werkzeug.
Der Sollwert darf nicht aus den Daten stammen. Sonst wird gegen den eigenen Mittelwert getestet, und das Ergebnis ist immer nicht signifikant.
Einseitig nur mit vorab festgelegter Richtung. Nachträglich einseitig zu testen halbiert den p-Wert und verdoppelt die Rate falscher Alarme.
Ein t-Test ersetzt keine Prozessüberwachung. Er prüft eine Momentaufnahme; eine driftende Fertigung erkennt man an der zeitlichen Entwicklung.
Ergebnis berichten
Vorlage für den Ergebnissatz:
[Zielgrösse] weicht vom Sollwert [Sollwert] [Einheit] ab: M = [Mittelwert] [Einheit], Abweichung [Differenz] [Einheit], 95-Prozent-Konfidenzintervall [unten] bis [oben], t([df]) = [t], p = [p], Cohens d = [d], n = [n].
Genannt werden Sollwert und seine Herkunft, Mittelwert und Streuung, die Abweichung mit Konfidenzintervall, Teststatistik mit Freiheitsgraden, p-Wert, Effektstärke und n, dazu die geprüften Voraussetzungen und der Umgang mit auffälligen Werten.
Auf dem Etikett stehen 500 ml. Aus der laufenden Produktion werden zwanzig Flaschen ausgewogen. Die Frage lautet: Weicht die mittlere Abfüllmenge vom deklarierten Wert ab, und falls ja, um wie viel?
Der Sollwert von 500 ml stammt aus der Deklaration, also von aussen und nicht aus den Daten. Damit ist die Grundbedingung des Verfahrens erfüllt.
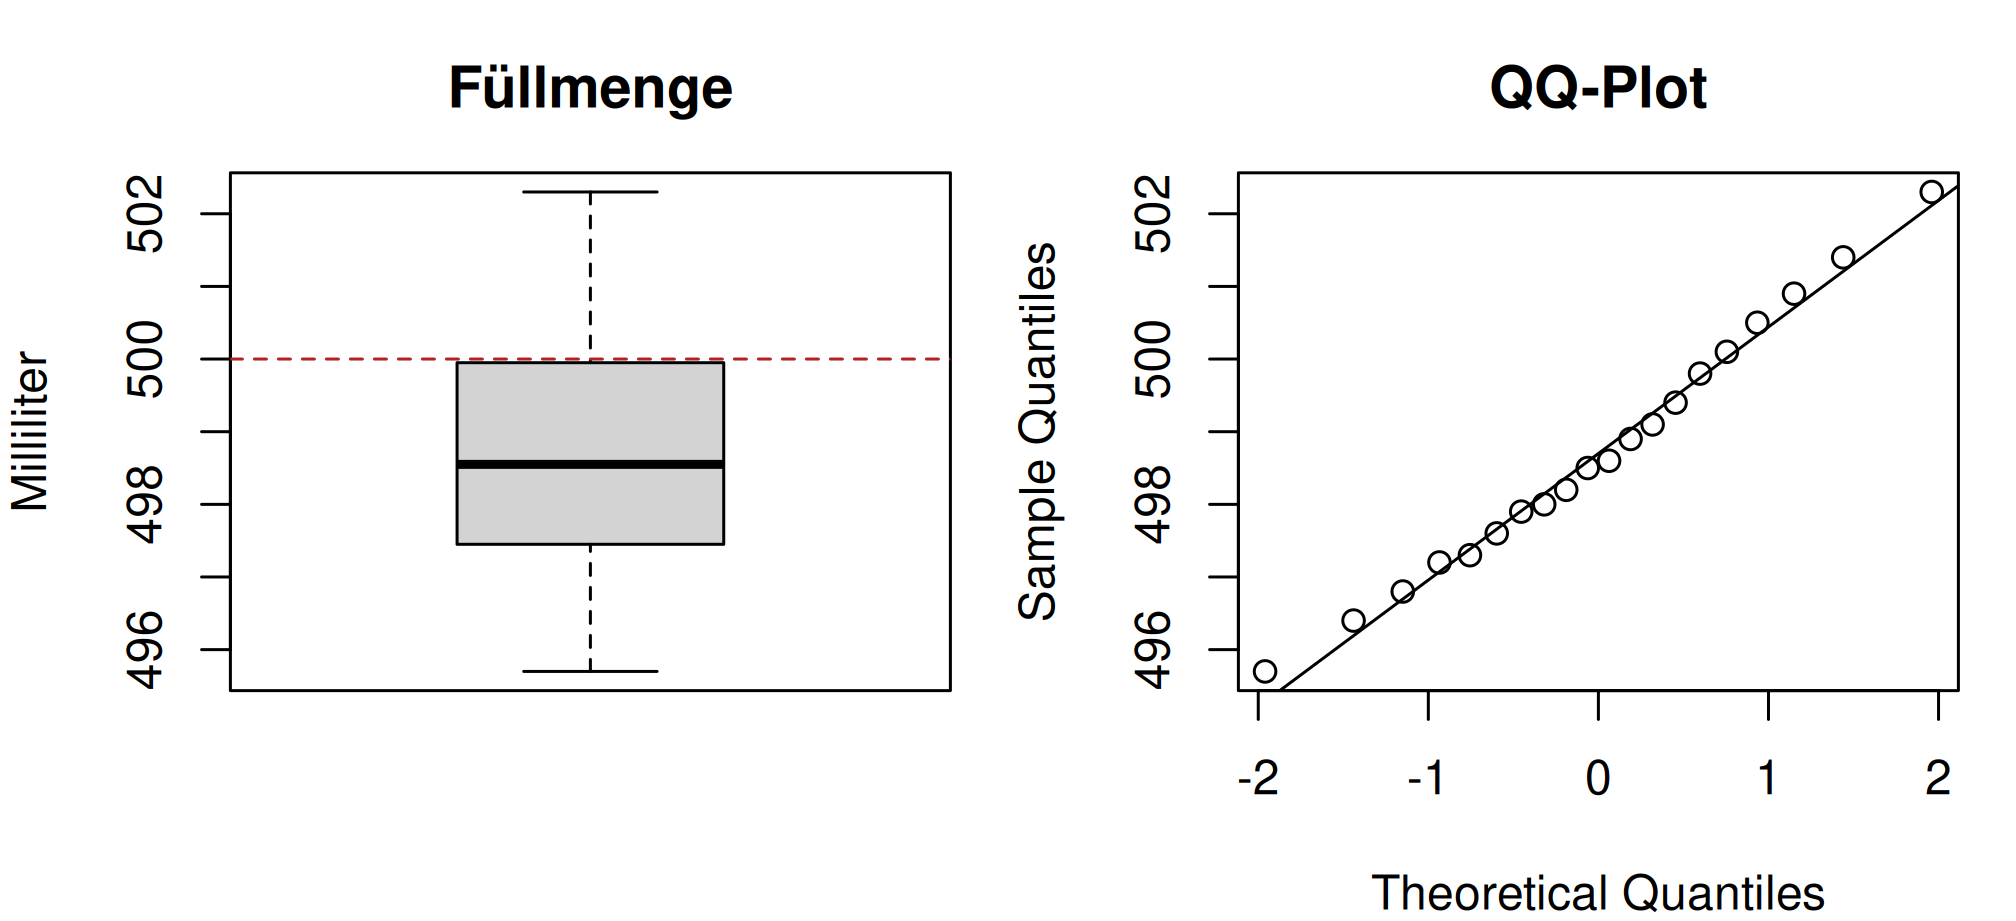
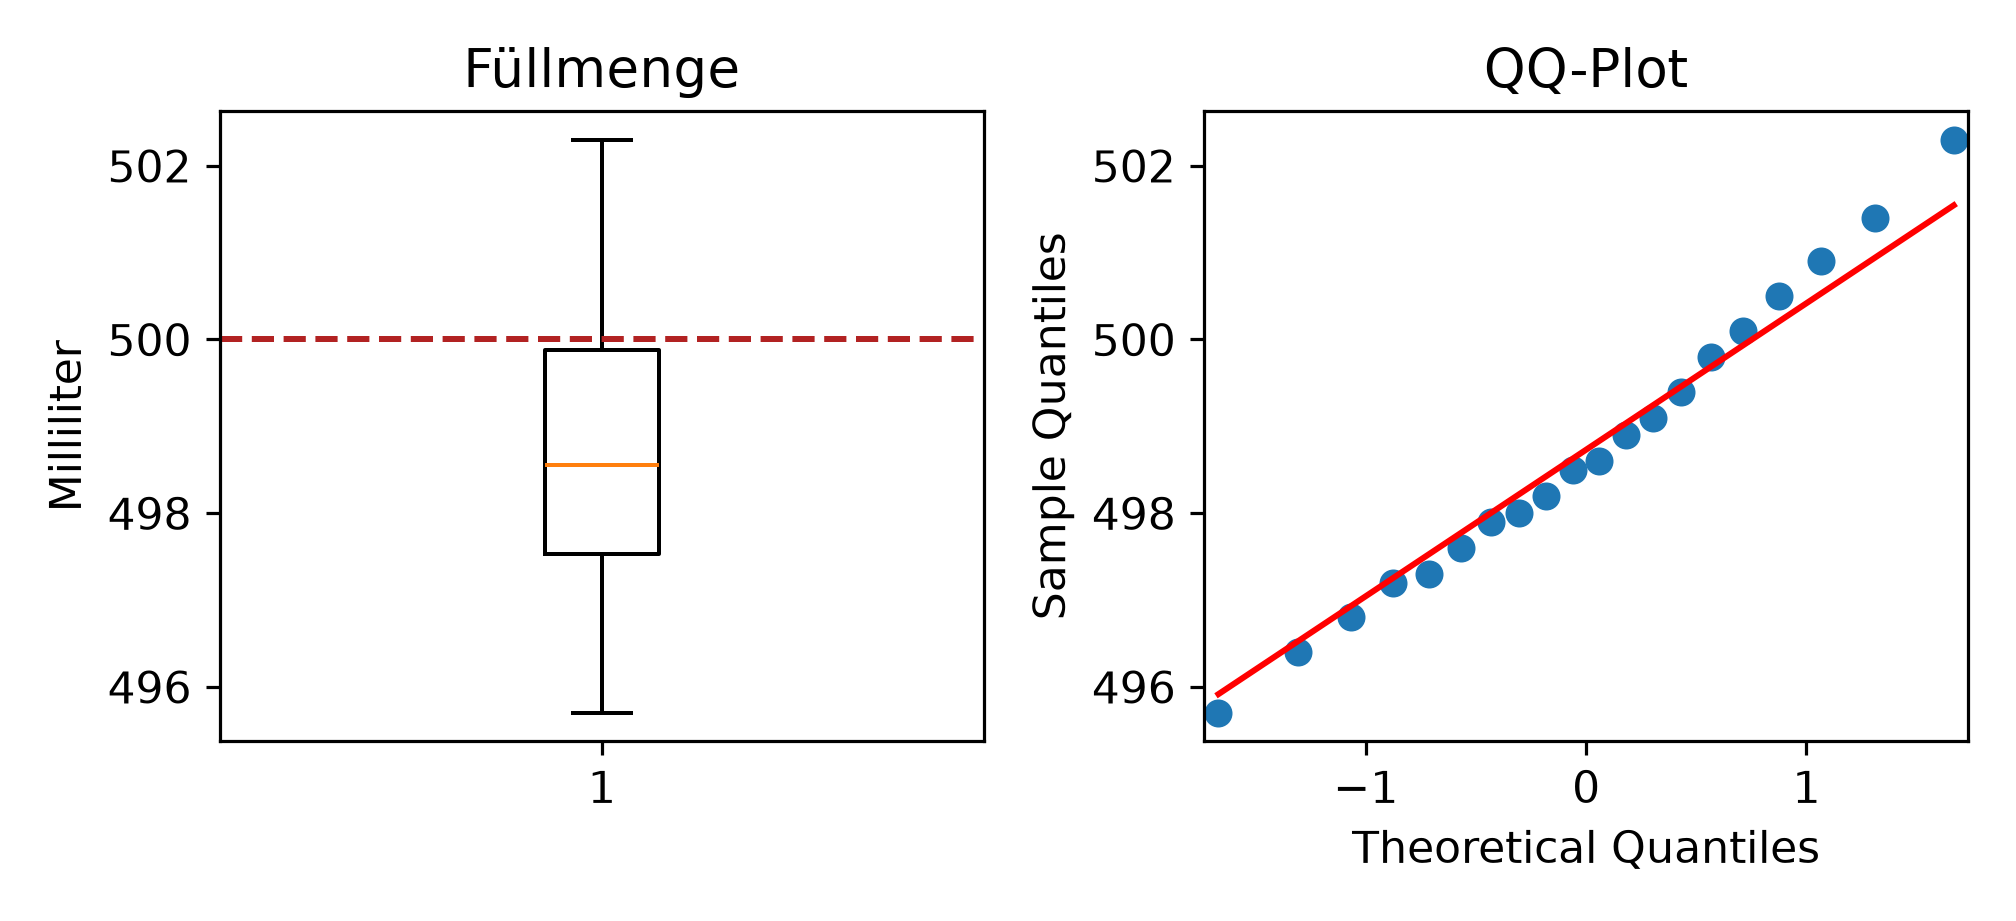
Der Mittelwert liegt bei 498.73 ml, der Median bei 498.55 ml. Beide liegen dicht beieinander, die Verteilung ist also nicht nennenswert schief, und im QQ-Plot liegen die Punkte nah an der Geraden. Der Boxplot zeigt keinen weit entfernten Einzelwert. Die gestrichelte Linie beim Sollwert macht schon hier sichtbar, worum es geht: Der Kasten liegt vollständig unterhalb von 500.
    One Sample t-test

data:  fuellmenge
t = -3.2814, df = 19, p-value = 0.003927
alternative hypothesis: true mean is not equal to 500
95 percent confidence interval:
 497.9199 499.5401
sample estimates:
mean of x
   498.73
effectsize::cohens_d(fuellmenge, mu =500)
Cohen's d |         95% CI
--------------------------
-0.73     | [-1.22, -0.23]

- Deviation from a difference of 500.
print(pg.ttest(fuellmenge, 500).round(4).T)
Output Zeile für Zeile
Ausgabe
Wert hier
Bedeutung
Wie er zu lesen ist
Variante
One Sample t-test
eine Gruppe gegen einen festen Wert
Stünde dort Two Sample, wäre versehentlich ein zweiter Vektor übergeben worden.
t
-3.281
Der Mittelwert liegt 3.28 Standardfehler unter dem Sollwert.
Das negative Vorzeichen sagt die Richtung: zu wenig in der Flasche.
df
19
Freiheitsgrade, n minus eins
Immer ganzzahlig, anders als beim Welch-Test für zwei Stichproben.
p-value
0.0039
Wahrscheinlichkeit einer mindestens so grossen Abweichung, wenn im Mittel tatsächlich 500 ml abgefüllt würden
Deutlich unter 0.05.
95 percent confidence interval
497.92 bis 499.54
Intervall für den wahren Mittelwert, nicht für die Differenz
Der Sollwert 500 liegt ausserhalb. Genau das ist der Grund für den signifikanten Test; ein p-Wert wird dafür gar nicht gebraucht.
mean of x
498.73
Stichprobenmittelwert
Die berichtete Abweichung ist 498.73 minus 500, also -1.27 ml.
alternative hypothesis
true mean is not equal to 500
zweiseitig, gegen 500 getestet
Diese Zeile ist die Kontrolle, dass der richtige Sollwert eingesetzt wurde.
Cohens d
-0.73
Abweichung in Einheiten der Streuung
Zwischen mittel und gross. Anders als die Zahl in Millilitern ist d von der Einheit unabhängig und damit über Messgrössen hinweg vergleichbar.
power (nur Python)
0.875
Trefferwahrscheinlichkeit für den beobachteten Effekt
Die Daten sind rund elfmal wahrscheinlicher unter einer Abweichung als unter exakter Einhaltung.
Das Konfidenzintervall bezieht sich in beiden Sprachen auf den Mittelwert selbst, nicht auf die Differenz zum Sollwert. Wer die Abweichung mit Intervall berichten will, zieht den Sollwert von beiden Grenzen ab: aus 497.92 bis 499.54 wird -2.08 bis -0.46 ml.
Interpretation und Ergebnissatz
Die Abfüllung liegt im Mittel 1.27 ml unter der Deklaration, und das Intervall sagt: plausibel sind Werte zwischen 0.46 und 2.08 ml zu wenig. Ob das zählt, entscheidet nicht der p-Wert, sondern die Vorgabe. Bei einer zulässigen Minusabweichung von 3 ml wäre die Sache unkritisch; bei 1 ml wäre sie es nicht, weil das Intervall bis 2.08 ml reicht.
Die Abfüllmenge unterschreitet die Deklaration von 500 ml (M = 498.73 ml, SD = 1.73, n = 20): Abweichung -1.27 ml, 95-Prozent-Konfidenzintervall -2.08 bis -0.46 ml, t(19) = -3.28, p = 0.004, Cohens d = -0.73. Boxplot und QQ-Plot zeigen keine Auffälligkeiten.
Frage und Datenlage
Nach einer Nachjustierung der Anlage werden zwölf Flaschen geprüft. Dieselbe Frage, derselbe Sollwert. Das Beispiel zeigt, was ein Nullbefund aussagt und was er nicht aussagt.
    One Sample t-test

data:  nachjustiert
t = 0.060903, df = 11, p-value = 0.9525
alternative hypothesis: true mean is not equal to 500
95 percent confidence interval:
 499.1215 500.9285
sample estimates:
mean of x
  500.025
Die Abweichung beträgt 0.025 ml, also ein Vierzigstel Milliliter.
t
0.061
Praktisch null. Solche Abweichungen entstehen laufend rein zufällig.
df
11
n minus eins.
p-value
0.953
So gross, wie ein p-Wert kaum werden kann. Die Daten sind mit exakter Einhaltung bestens vereinbar.
95 percent confidence interval
499.12 bis 500.93
Die entscheidende Zeile. Der Sollwert liegt bequem im Intervall, aber das Intervall ist 1.8 ml breit: Abweichungen bis knapp ein Milliliter in beide Richtungen bleiben vereinbar.
cohen_d
0.018
Vernachlässigbar.
power (nur Python)
0.050
Der Test hatte bei diesem Effekt und diesem Umfang praktisch keine Aussicht, etwas zu finden. Der Wert entspricht genau dem Signifikanzniveau, und das ist kein Zufall: Bei einem Effekt von praktisch null ist die Trefferwahrscheinlichkeit gleich der Rate falscher Alarme.
Interpretation und Ergebnissatz
Der Satz “die Anlage füllt korrekt ab” ist hier nicht gedeckt. Gedeckt ist: In diesen zwölf Flaschen ist keine Abweichung nachweisbar. Der Unterschied steht im Intervall, das Abweichungen bis 0.93 ml zulässt.
Wer den Nachweis der Einhaltung wirklich braucht, formuliert ihn umgekehrt: Man legt vorab eine Toleranz fest, etwa 1 ml, und zeigt mit einem Äquivalenztest, dass die Abweichung innerhalb dieser Grenzen liegt. Der gewöhnliche t-Test kann das grundsätzlich nicht, weil seine Nullhypothese die Übereinstimmung ist und eine Nullhypothese nie bewiesen wird.
Nach der Nachjustierung ist keine Abweichung von der Deklaration nachweisbar (M = 500.03 ml, SD = 1.42, n = 12; Abweichung 0.03 ml, 95-Prozent-Konfidenzintervall -0.88 bis 0.93 ml, t(11) = 0.06, p = 0.95). Das Intervall lässt Abweichungen bis rund 0.9 ml in beide Richtungen zu; ein Nachweis der Einhaltung ist damit nicht erbracht.
Frage und Datenlage
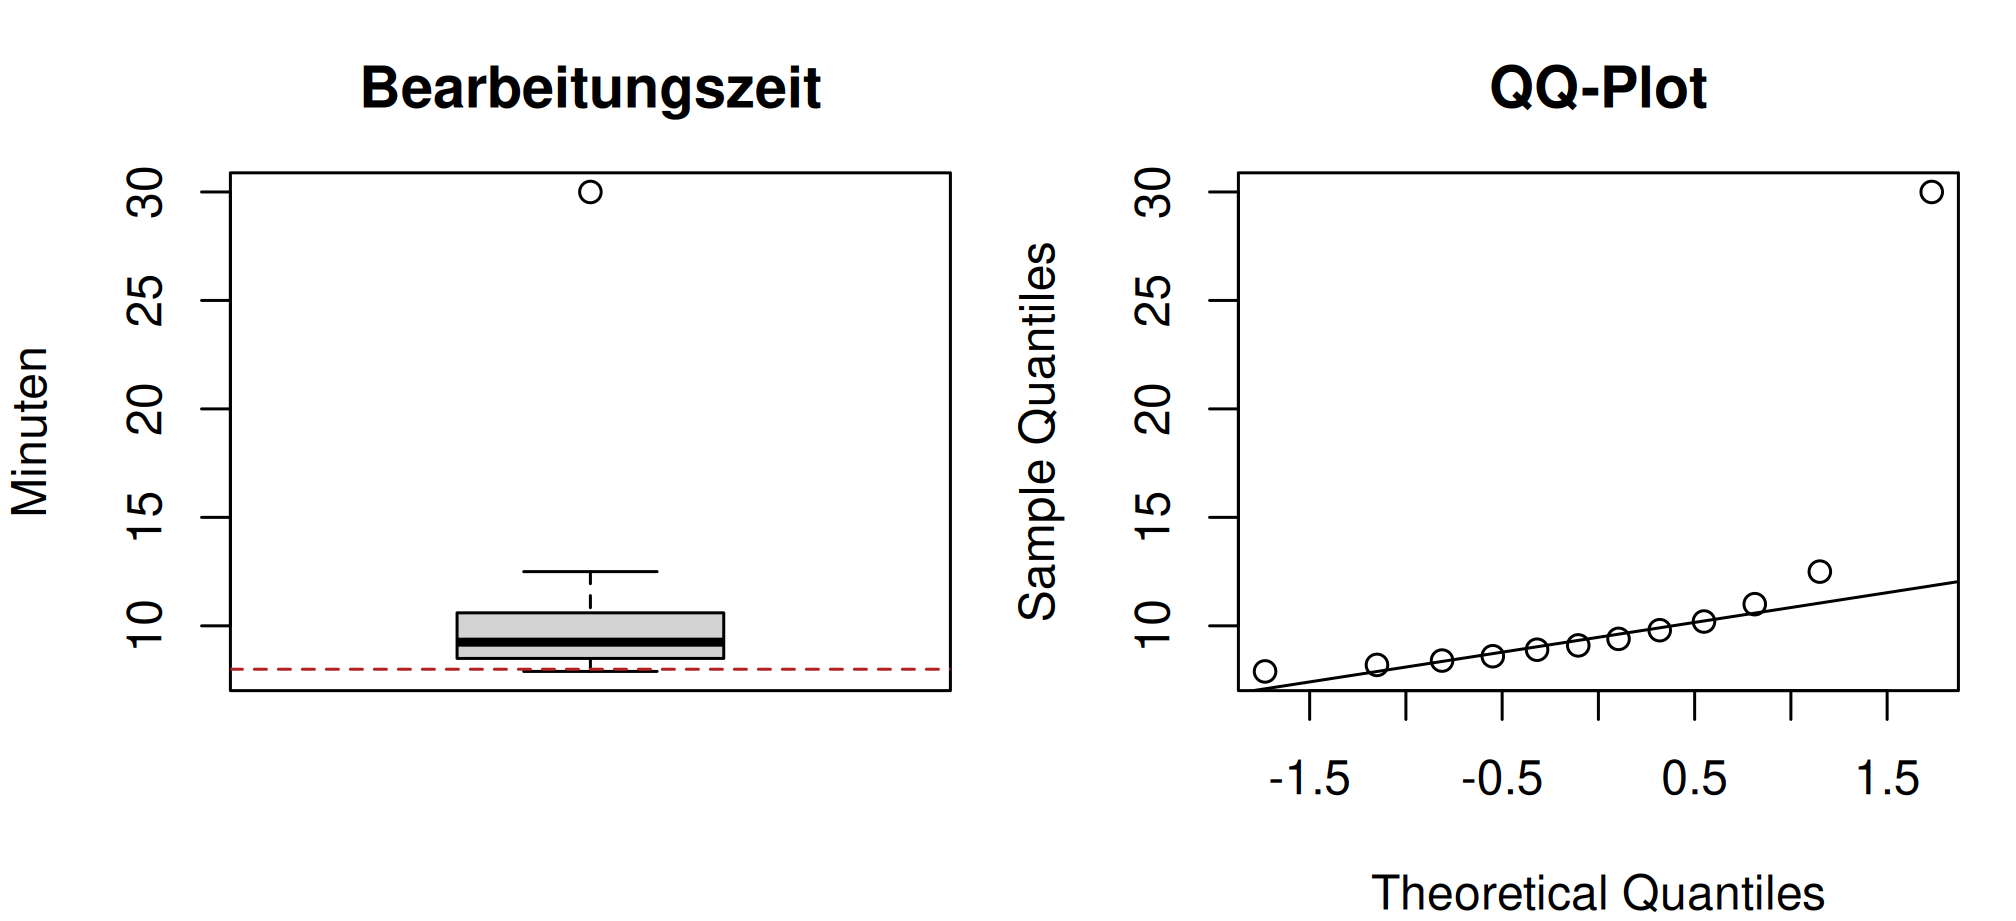
Eine Vereinbarung nennt acht Minuten als Richtwert für eine Bearbeitung. Zwölf Vorgänge werden gemessen. Bearbeitungszeiten sind fast immer rechtsschief, und in dieser Reihe steckt zusätzlich ein Vorgang mit 30 Minuten.
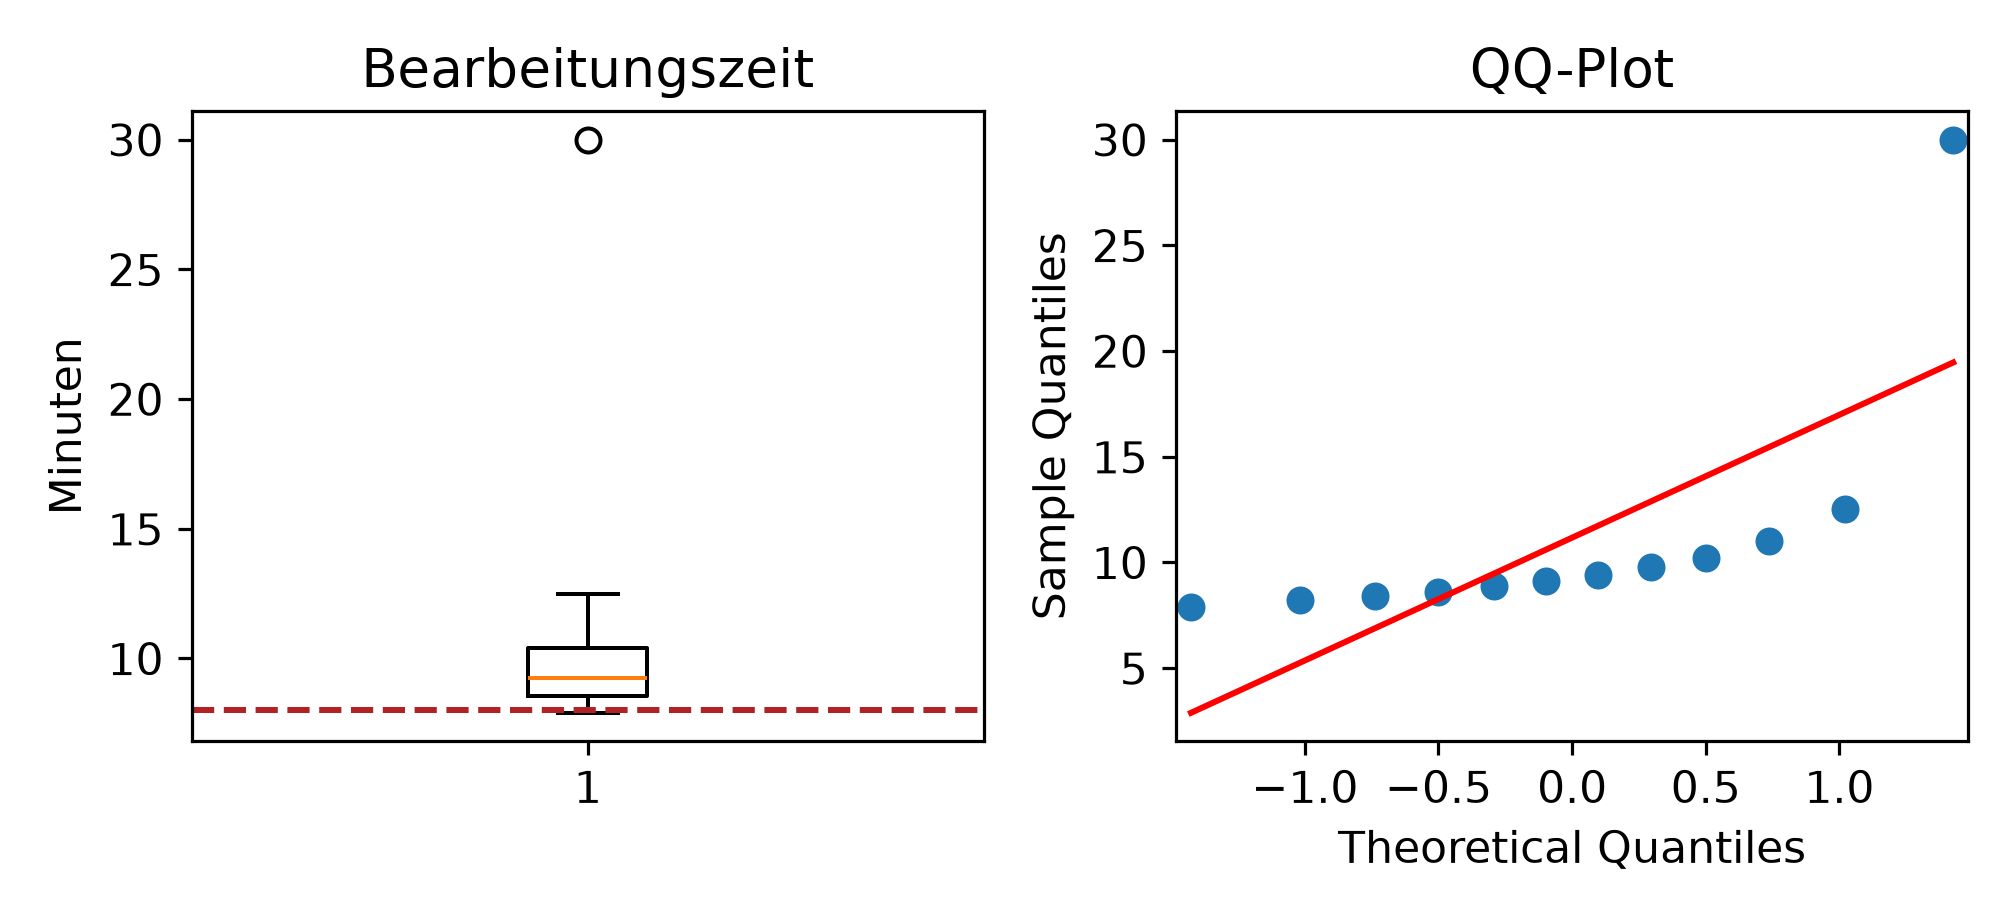
Mittelwert 11.17 Minuten, Median 9.25 Minuten, Standardabweichung 6.07. Die Streuung ist mehr als halb so gross wie der Mittelwert, und der QQ-Plot biegt am oberen Ende weit von der Geraden ab. Bei zwölf Werten hilft der zentrale Grenzwertsatz nicht mehr. Das Verfahren wird deshalb vor der Rechnung gewechselt.
Rechnung
Beide Verfahren stehen hier nebeneinander, damit sichtbar wird, was auf dem Spiel steht. Im Bericht erschiene nur der rangbasierte Test.
    One Sample t-test

data:  bearbeitung
t = 1.8066, df = 11, p-value = 0.09822
alternative hypothesis: true mean is not equal to 8
95 percent confidence interval:
  7.30877 15.02456
sample estimates:
mean of x
 11.16667
wilcox.test(bearbeitung, mu =8)
    Wilcoxon signed rank exact test

data:  bearbeitung
V = 77, p-value = 0.0009766
alternative hypothesis: true location is not equal to 8
t_wert, t_p = stats.ttest_1samp(bearbeitung, 8)v_wert, v_p = stats.wilcoxon(bearbeitung -8)print("t-Test t =", round(t_wert, 4), " p =", round(t_p, 4))print("Vorzeichen-Rangtest V =", v_wert, " p =", round(v_p, 6))
Output Zeile für Zeile
Ausgabe
Wert hier
Wie er zu lesen ist
t-Test mean of x
11.167
Der Mittelwert liegt über drei Minuten über dem Richtwert, sieht also nach einer klaren Überschreitung aus.
t-Test t
1.807
Und ist es trotzdem nicht: Der Standardfehler beträgt 1.75 Minuten, weil der eine Wert von 30 Minuten die Streuung aufbläht.
t-Test p-value
0.098
Nicht signifikant.
t-Test Intervall
7.31 bis 15.02
Fast acht Minuten breit und den Richtwert knapp einschliessend. Aus diesen Daten lässt sich über den Mittelwert nichts ableiten.
Rangtest V
1
Die Rangsumme jener Differenzen, die unter null liegen. Von zwölf Vorgängen lag nur einer unter acht Minuten, deshalb ist der Wert so klein.
Rangtest p-value
0.00098
Hochsignifikant, also die gegenteilige Entscheidung.
Zwei Verfahren, dieselben Daten, entgegengesetzte Schlüsse. Der Grund steht in der Datenreihe: Elf von zwölf Vorgängen dauern länger als acht Minuten. Der Rangtest sieht genau das. Der t-Test sieht stattdessen den Abstand des Mittelwerts zum Sollwert, geteilt durch eine Streuung, die ein einzelner Wert nach oben treibt.
Interpretation und Ergebnissatz
Die Entscheidung für den Rangtest fällt an der Voraussetzungsprüfung, nicht an den p-Werten. Wäre es umgekehrt, wäre das Testniveau verloren.
Ebenso wichtig ist, was berichtet wird: Nach einem Rangtest spricht man über die zentrale Tendenz, nicht über den Mittelwert. Der Median von 9.25 Minuten beschreibt den typischen Vorgang; der Mittelwert von 11.17 Minuten beschreibt keinen einzigen der zwölf gemessenen Vorgänge auch nur annähernd.
Der Wert von 30 Minuten gehört untersucht statt entfernt. Ein solcher Vorgang kann ein Erfassungsfehler sein, ein Sonderfall mit Rückfrage oder genau das Problem, um das es eigentlich geht.
Wegen deutlicher Rechtsschiefe und eines Extremwerts wurde vorab rangbasiert geprüft. Die Bearbeitungszeit überschreitet den Richtwert von acht Minuten (Vorzeichen-Rangtest, V = 1, p < 0.001, n = 12; Median 9.25 Minuten). Auf einen Mittelwertvergleich wurde bewusst verzichtet.
Frage und Datenlage
Eine automatische Kontrolle wiegt 4000 Flaschen. Die wahre mittlere Abweichung beträgt 0.15 ml, weit unterhalb jeder Toleranz. Damit beide Sprachen exakt dieselben Daten sehen, werden die Werte nicht gezogen, sondern als Quantile der Normalverteilung konstruiert.
gross <-500.15+2.0*qnorm(ppoints(4000))t.test(gross, mu =500)
    One Sample t-test

data:  gross
t = 4.7436, df = 3999, p-value = 2.173e-06
alternative hypothesis: true mean is not equal to 500
95 percent confidence interval:
 500.088 500.212
sample estimates:
mean of x
   500.15
Die Abweichung beträgt 0.15 ml, hier exakt bekannt.
t
4.744
Weit über der üblichen Schwelle von etwa 2.
df
3999
n minus eins.
p-value
0.0000022
Hochsignifikant.
95 percent confidence interval
500.088 bis 500.212
Nur zwölf Hundertstel Milliliter breit. Die Abweichung ist sehr präzise geschätzt und trotzdem winzig.
cohen_d
0.075
Weit unter dem Anhaltspunkt 0.2 für einen kleinen Effekt.
Interpretation und Ergebnissatz
Hier lässt sich der Unterschied zwischen den beiden Fragen “ist die Abweichung vom Zufall unterscheidbar” und “ist die Abweichung wichtig” sauber ablesen. Die erste beantwortet der p-Wert, und seine Antwort hängt am Stichprobenumfang: Bei 4000 Flaschen wird auch ein Fünfzehntel Milliliter sichtbar. Die zweite beantworten die Abweichung in Millilitern und Cohens d, und diese Zahlen ändern sich mit dem Umfang nicht.
Deshalb wird die Relevanzschwelle vor der Auswertung festgelegt. Wer sie erst danach sucht, findet sie so, dass sie zum Ergebnis passt.
Die Abfüllmenge weicht statistisch nachweisbar von der Deklaration ab (M = 500.15 ml, n = 4000, t(3999) = 4.74, p < 0.001). Die Abweichung beträgt 0.15 ml (95-Prozent-Konfidenzintervall 0.09 bis 0.21 ml, Cohens d = 0.08) und liegt damit weit innerhalb der zulässigen Toleranz; ein Eingriff in den Prozess ist daraus nicht abzuleiten.
Verständnisfragen
Das 95-Prozent-Konfidenzintervall für den Mittelwert reicht von 12.05 bis 12.31, der Sollwert ist 12. Was folgt für den zweiseitigen Test auf dem 5-Prozent-Niveau?
Er ist signifikant, der Sollwert liegt ausserhalb des Intervalls
Richtig. Intervall und Test sind zwei Darstellungen desselben Sachverhalts; ein p-Wert wird dafür nicht gebraucht.
Das lässt sich ohne p-Wert nicht sagen
Doch, die Beziehung gilt exakt.
Er ist nicht signifikant, weil 12 nahe an 12.05 liegt
Entscheidend ist, ob der Wert im Intervall liegt, nicht wie nahe er an der Grenze liegt.
Ein einzelner Ausreisser wird der Stichprobe hinzugefügt, und der p-Wert steigt von 0.01 auf 0.20. Wie kommt das?
Der Ausreisser zieht den Mittelwert zum Sollwert hin
Er zieht ihn hier sogar weiter weg.
Er vergrössert die Standardabweichung stärker als den Mittelwert
Richtig. Der Nenner der Teststatistik wächst schneller als der Zähler, und damit sinkt t. Ein einzelner Wert kann so ein klares Ergebnis auflösen.
Die Freiheitsgrade sinken
Sie steigen um eins, weil eine Beobachtung dazukommt.
Der Sollwert wird als Mittelwert derselben Messreihe berechnet, gegen die getestet wird. Was passiert?
Die Teststatistik ist null, das Ergebnis ist wertlos
Richtig. Zähler und Sollwert sind identisch, der Test prüft eine Aussage über sich selbst.
Der Test wird konservativ, aber bleibt gültig
Er ist nicht konservativ, sondern gegenstandslos.
Das Ergebnis ist immer signifikant
Das Gegenteil ist der Fall.
Bei n = 4000 ergibt sich p < 0.001 und eine Abweichung von 0.004 mm bei einer Toleranz von 0.5 mm. Was berichtet man?
Eine signifikante Abweichung vom Sollmass
Formal richtig und irreführend, wenn die Grösse fehlt.
Die Abweichung mit Intervall, dazu die Einordnung an der Toleranz
Richtig. Der Prozess ist statistisch von 12 unterscheidbar und praktisch innerhalb der Spezifikation. Beides gehört in denselben Satz.
Dass der Test bei grossem n unbrauchbar ist
Er tut genau, was er soll; die Einordnung leistet die Effektgrösse.