Zensierung und Überlebensfunktion

Survival-Analyse
Interpretation
R
Python
Was Zensierung bedeutet und wie die Überlebensfunktion zu lesen ist.

Kernideen

  • Zielgrösse ist eine Zeit bis zu einem Ereignis, nicht ein Wert. Jede Beobachtung besteht aus zwei Angaben: Zeit und Status.
  • Zensiert heisst: das Ereignis war am Ende der Beobachtung noch nicht eingetreten.
  • Eine zensierte Beobachtung ist Information, kein fehlender Wert.
  • Weglassen verzerrt stark nach unten; Mitzählen als Ereignis ebenfalls nach unten, aber aus einem anderen Grund.
  • Die Überlebensfunktion \(S(t)\) gibt den Anteil an, der zum Zeitpunkt \(t\) noch kein Ereignis hatte.
  • Die Hazard-Rate \(h(t)\) ist das momentane Risiko unter den bis dahin Ereignisfreien, keine Wahrscheinlichkeit und nicht auf 1 begrenzt.
  • Die zentrale Annahme, Zensierte haben dasselbe Risiko wie die weiter Beobachteten, ist in den Daten nicht prüfbar.

Erklärung

Vorwissen: Zufallsvariablen und bedingte Wahrscheinlichkeit, denn die Schätzung besteht aus einer Kette bedingter Wahrscheinlichkeiten. Wie man daraus eine Kurve schätzt, steht unter Kaplan-Meier.

Die Datenlage, die eigene Verfahren nötig macht

Gefragt ist die Zeit bis zu einem Ereignis: Kündigung, Ausfall, Reparatur, Rückfall. Jede Beobachtung besteht deshalb aus zwei Angaben, nicht aus einer:

Angabe Bedeutung
Zeit wie lange beobachtet wurde
Status ob das Ereignis in dieser Zeit eingetreten ist

Ohne den Status ist die Zeit nicht interpretierbar. Zwölf Monate können heissen “nach zwölf Monaten gekündigt” oder “seit zwölf Monaten dabei und noch nicht gekündigt”. Das sind völlig verschiedene Aussagen, und der Unterschied ist der Kern des Fachgebiets.

Zensierung ist Information

Eine Beobachtung heisst rechtszensiert, wenn die Beobachtung endet, bevor das Ereignis eintritt. Typische Gründe: Die Studie endet, der Vertrag läuft noch, die Person zieht weg.

Der entscheidende Punkt: Eine zensierte Beobachtung sagt nicht nichts, sondern etwas Halbes. Wer nach zwölf Monaten noch dabei ist, hat die ersten zwölf Monate überlebt, und genau diese Information nutzen die Verfahren der Überlebenszeitanalyse.

Der Normalfall ist Rechtszensierung. Daneben gibt es Linkszensierung, wenn nur bekannt ist, dass das Ereignis vor einem Zeitpunkt lag, und Intervallzensierung, wenn es zwischen zwei Untersuchungen eintrat. Beide brauchen andere Verfahren; die hier behandelten setzen Rechtszensierung voraus.

Zu unterscheiden ist Zensierung ausserdem von Trunkierung: Dort fehlen Beobachtungen vollständig, etwa weil sie erst ab einem bestimmten Alter in die Studie kommen. Zensierung heisst “teilweise beobachtet”, Trunkierung “gar nicht in den Daten”.

Die Voraussetzung, die niemand prüfen kann

Alle Verfahren setzen voraus, dass die Zensierung nichts über die Zeit bis zum Ereignis aussagt, dass also die Zensierten dasselbe Risiko haben wie die weiter Beobachteten. Das nennt man nicht informative Zensierung.

Diese Annahme lässt sich in den Daten nicht prüfen, denn dazu bräuchte man gerade die unbeobachteten Zeiten. Sie muss inhaltlich begründet werden:

  • Unbedenklich: administratives Studienende. Wer am Stichtag noch dabei ist, ist aus einem Grund zensiert, der nichts mit dem Kündigungsrisiko zu tun hat.
  • Bedenklich: Personen verlassen die Beobachtung, weil sie unzufrieden sind oder wegziehen. Dann sind die Zensierten gerade die mit höherem Risiko, und jede Schätzung ist zu optimistisch. Beispiel 3 rechnet das durch.

Wo die Annahme fraglich ist, gehört das in den Bericht, nicht in eine Fussnote.

Überlebensfunktion und Hazard-Rate

Zwei Funktionen beschreiben denselben Sachverhalt aus zwei Richtungen.

Die Überlebensfunktion \(S(t)\) ist der Anteil, der zum Zeitpunkt \(t\) noch kein Ereignis erlebt hat. Sie beginnt bei eins, fällt monoton und ist die Kurve, die man ansieht und berichtet. Aus ihr liest man Anteile zu bestimmten Zeitpunkten ab und den Median, also den Zeitpunkt, an dem die Kurve die Hälfte erreicht.

Die Hazard-Rate \(h(t)\) ist das momentane Risiko: die Rate, mit der das Ereignis eintritt, unter denen, die bis \(t\) noch dabei sind. Sie ist keine Wahrscheinlichkeit und liegt nicht zwischen null und eins. Sie ist die Grösse, die das Cox-Modell modelliert.

Der Zusammenhang ist eindeutig und in beide Richtungen umkehrbar:

\[S(t) = e^{-\int_0^t h(u)\, du}, \qquad h(t) = -\frac{d}{dt}\ln S(t)\]

Beide enthalten also dieselbe Information. Sie zeigen sie nur verschieden: Die Überlebensfunktion ist kumulativ und daher immer glatt und fallend, die Hazard-Rate ist lokal und macht sichtbar, wann das Risiko hoch ist.

Was man aus einer Überlebenskurve abliest

Grösse Wie Bemerkung
Anteil zu einem Zeitpunkt senkrecht bei \(t\) ablesen mit Konfidenzintervall berichten
Median waagrecht bei 0.5 ablesen nicht definiert, wenn die Kurve nie unter 0.5 fällt
Verlauf Steilheit der Kurve steil heisst hohes Risiko in diesem Abschnitt
Anzahl unter Risiko Tabelle unter der Kurve am Ende oft so klein, dass die Kurve nichts mehr aussagt

Der letzte Punkt ist der häufigste Interpretationsfehler: Das rechte Ende einer Überlebenskurve beruht meist auf wenigen Beobachtungen und schwankt entsprechend. Deshalb gehört die Zahl der noch unter Risiko stehenden Fälle zu jeder Darstellung.

Beispiele

Frage und Datenlage

Fünf Fälle, beobachtet über 10 Zeiteinheiten. Der dritte wird nach 5 Einheiten zensiert:

\[3,\; 4,\; 5^+,\; 8,\; 10\]

Die Frage: Wie viel weiss man über diesen dritten Fall, und wo landet dieses Wissen in der Rechnung?

Rechnung

zeit <- c(3, 4, 5, 8, 10)

# Drei Sichtweisen auf denselben Fall Nummer 3
weggelassen <- data.frame(zeit = zeit[-3], status = 1)
als_ereignis <- data.frame(zeit = zeit, status = c(1, 1, 1, 1, 1))
richtig <- data.frame(zeit = zeit, status = c(1, 1, 0, 1, 1))

for (name in c("weggelassen", "als_ereignis", "richtig")) {
  daten <- get(name)
  kurve <- survfit(Surv(zeit, status) ~ 1, data = daten)
  cat("\n---", name, "---\n")
  print(round(summary(kurve)$surv, 4))
  cat("Median:", summary(kurve)$table["median"], "\n")
}

--- weggelassen ---
[1] 0.75 0.50 0.25 0.00
Median: 6 

--- als_ereignis ---
[1] 0.8 0.6 0.4 0.2 0.0
Median: 5 

--- richtig ---
[1] 0.8 0.6 0.3 0.0
Median: 8 
zeit = np.array([3, 4, 5, 8, 10])

sichtweisen = {
    "weggelassen": (np.delete(zeit, 2), np.ones(4, dtype=int)),
    "als_ereignis": (zeit, np.ones(5, dtype=int)),
    "richtig": (zeit, np.array([1, 1, 0, 1, 1])),
}

for name, (t, s) in sichtweisen.items():
    km = KaplanMeierFitter().fit(t, s)
    print(f"--- {name} ---")
    print(km.survival_function_.round(4).T.to_string())
    print("Median:", km.median_survival_time_, "\n")
--- weggelassen ---
timeline     0.0   3.0   4.0   8.0   10.0
KM_estimate   1.0  0.75   0.5  0.25   0.0
Median: 4.0 

--- als_ereignis ---
timeline     0.0   3.0   4.0   5.0   8.0   10.0
KM_estimate   1.0   0.8   0.6   0.4   0.2   0.0
Median: 5.0 

--- richtig ---
timeline     0.0   3.0   4.0   5.0   8.0   10.0
KM_estimate   1.0   0.8   0.6   0.6   0.3   0.0
Median: 8.0 

Output Zeile für Zeile

Die drei Sichtweisen liefern drei verschiedene Kurven:

\(t\) weggelassen (n = 4) als Ereignis (n = 5) richtig zensiert (n = 5)
3 0.75 0.80 0.80
4 0.50 0.60 0.60
5 0.40 0.60 (fällt nicht)
8 0.25 0.20 0.30
10 0.00 0.00 0.00
Median 4 (R: 6) 5 8
Zeile Was sie zeigt
Bei \(t = 3\): 0.75 gegen 0.80 Wer den zensierten Fall streicht, rechnet mit vier statt fünf unter Risiko. Der erste Schritt fällt dadurch schon zu tief aus, der Fehler beginnt lange vor dem Zensierungszeitpunkt.
Bei \(t = 5\): die richtige Kurve fällt nicht Kein Ereignis, kein Schritt. Aber die Anzahl unter Risiko sinkt von 3 auf 2.
Bei \(t = 8\): 0.30 gegen 0.20 Der Schritt beträgt \(1 - 1/2 = 0.5\) statt \(1 - 1/3\): Weil nur noch zwei unter Risiko stehen, wiegt jedes Ereignis schwerer. So schlägt die Zensierung auf alle späteren Schritte durch.
Der Median: 4, 5 und 8 Drei Zahlen aus fünf Beobachtungen, je nach Behandlung eines einzigen Falls.
R gibt für “weggelassen” 6 statt 4 aus Kein Widerspruch, sondern eine Konvention: Erreicht die Kurve die 0.5 exakt und bleibt eine Weile dort, nimmt survfit() die Mitte des flachen Stücks, hier zwischen 4 und 8. Python nimmt den ersten Zeitpunkt mit \(\hat{S} \le 0.5\). Bei Reihen ohne exakten Treffer stimmen beide überein.

Was der zensierte Fall beiträgt, in einem Satz: Er zählt bis \(t = 5\) voll im Nenner mit und verschwindet danach. Damit ist genau die Information genutzt, die vorliegt, “hat mindestens 5 überlebt” und keine, die nicht vorliegt.

Die beiden Behelfslösungen tun jeweils zu viel: Weglassen behauptet, es habe diesen Fall nie gegeben; als Ereignis zählen behauptet, das Ereignis sei bei \(t = 5\) eingetreten.

Interpretation

Bei fünf Fällen wirkt der Unterschied wie ein Rechendetail. Beispiel 2 zeigt, wie gross er bei realistischen Zensierungsanteilen wird.

Frage und Datenlage

4000 Abos mit exponentialverteilter Laufzeit, Stichtag nach 24 Monaten. Weil die Daten konstruiert sind, ist der wahre Median bekannt: \(\ln(2)/\text{Rate}\). Verglichen werden zwei Fälle:

  • mässige Zensierung: Rate 0.035, wahrer Median 19.8 Monate, der Median liegt also vor dem Stichtag.
  • starke Zensierung: Rate 0.020, wahrer Median 34.7 Monate, der Median liegt hinter dem Stichtag.

Rechnung

vergleich <- function(saat, rate, stichtag = 24, n = 4000) {
  t <- exp_zeiten(saat, n, rate)
  zeit <- pmin(t, stichtag)
  status <- as.integer(t <= stichtag)
  km <- summary(survfit(Surv(zeit, status) ~ 1))$table["median"]
  c(anteil_zensiert = round(mean(status == 0), 2),
    wahrer_median = round(log(2) / rate, 1),
    nur_ereignisse = round(median(zeit[status == 1]), 1),
    alle_als_ereignis = round(median(zeit), 1),
    kaplan_meier = round(unname(km), 1))
}

rbind(maessig = vergleich(2027, 0.035),
      stark = vergleich(2028, 0.020))
        anteil_zensiert wahrer_median nur_ereignisse alle_als_ereignis
maessig            0.43          19.8           10.0              19.7
stark              0.63          34.7           10.3              24.0
        kaplan_meier
maessig         19.7
stark             NA
def vergleich(saat, rate, stichtag=24, n=4000):
    t = exp_zeiten(saat, n, rate)
    zeit = np.minimum(t, stichtag)
    status = (t <= stichtag).astype(int)
    km = KaplanMeierFitter().fit(zeit, status)
    return {
        "anteil_zensiert": round(float((status == 0).mean()), 2),
        "wahrer_median": round(np.log(2) / rate, 1),
        "nur_ereignisse": round(float(np.median(zeit[status == 1])), 1),
        "alle_als_ereignis": round(float(np.median(zeit)), 1),
        "kaplan_meier": round(float(km.median_survival_time_), 1),
    }


print(pd.DataFrame({"maessig": vergleich(2027, 0.035),
                    "stark": vergleich(2028, 0.020)}).T)
         anteil_zensiert  wahrer_median  ...  alle_als_ereignis  kaplan_meier
maessig             0.43           19.8  ...               19.7          19.7
stark               0.63           34.7  ...               24.0           inf

[2 rows x 5 columns]

Output Zeile für Zeile

mässige Zensierung starke Zensierung
Anteil zensiert 43 % 63 %
wahrer Median 19.8 34.7
nur die Gekündigten 10.0 10.3
alle Zeiten als Ereignis 19.7 24.0
Kaplan-Meier 19.7 nicht schätzbar
Zeile Was sie zeigt
Nur die Gekündigten: 10.0 und 10.3 Die schlimmste der drei Rechnungen, knapp die Hälfte beziehungsweise weniger als ein Drittel des wahren Werts. Und der Grund, warum sie so schlimm ist: Zensiert sind per Konstruktion gerade die Langläufer. Wer sie streicht, behält nur die kurzen Zeiten. Bemerkenswert ist auch, dass die Zahl in beiden Fällen fast gleich ist, obwohl die wahren Mediane um den Faktor 1.75 auseinanderliegen: Diese Rechnung misst vor allem den Stichtag, nicht die Laufzeit.
Alle als Ereignis, mässig: 19.7 Sieht gut aus und ist ein Zufall der Datenlage. Weil der Median deutlich vor dem Stichtag liegt, betrifft die falsche Behandlung nur Werte oberhalb des Medians, und den Median verschiebt das nicht. Bei einem Mittelwert wäre die Verzerrung sofort sichtbar.
Alle als Ereignis, stark: exakt 24.0 Hier bricht die Rechnung sichtbar zusammen. Über die Hälfte aller Zeiten wurde auf den Stichtag gesetzt, also ist der Median der Stichtag. Die Zahl sagt nur, wann die Beobachtung endete.
Kaplan-Meier, mässig: 19.7 gegen wahre 19.8 Ein Zehntel daneben, und das ist Stichprobenzufall, keine systematische Verzerrung.
Kaplan-Meier, stark: NA beziehungsweise inf Die ehrlichste Ausgabe der ganzen Tabelle. Die Kurve erreicht im Beobachtungszeitraum nie die Hälfte; der Median ist aus diesen Daten nicht schätzbar. Ein Verfahren, das hier eine Zahl nennt, erfindet sie.

Die Lehre ist nicht nur “Kaplan-Meier ist besser”, sondern auch: Ein Verfahren, das immer eine Zahl liefert, ist verdächtig. Bei starker Zensierung ist die richtige Antwort “nicht schätzbar”, und nur das korrekte Verfahren gibt sie.

Interpretation und Ergebnissatz

Bei 63 Prozent Zensierung ist der Median der Laufzeit aus diesen Daten nicht schätzbar; die Überlebenskurve erreicht im Beobachtungszeitraum von 24 Monaten nie 50 Prozent. Berichtet wird stattdessen der Anteil zum Stichtag.

Frage und Datenlage

Die zentrale Annahme in Aktion. 2000 Personen, von denen die Hälfte ein erhöhtes Risiko trägt (Rate 0.054 statt 0.020). Drei Auswertungen derselben Grundgesamtheit:

  1. Wahrheit: alle Zeiten vollständig beobachtet, keine Zensierung.
  2. Administrative Zensierung: Beobachtung endet für alle bei Monat 24.
  3. Informative Zensierung: zusätzlich steigen die Hochrisikopersonen irgendwann in den ersten sechs Monaten aus der Beobachtung aus, sie kündigen das Studio zwar nicht, melden sich aber ab und sind nicht mehr erreichbar.

Rechnung

n <- 2000
hoch <- lehmer(4141, n) < 0.5                    # halbe Gruppe mit hohem Risiko
rate_i <- 0.02 * exp(1.0 * hoch)
t <- -log(lehmer(4242, n)) / rate_i

# Hochrisikopersonen steigen irgendwann in den ersten sechs Monaten aus
ausstieg <- ifelse(hoch, 6 * lehmer(4343, n), Inf)

faelle <- list(
  wahr = list(zeit = t, status = rep(1L, n)),
  administrativ = list(zeit = pmin(t, 24), status = as.integer(t <= 24)),
  informativ = list(zeit = pmin(t, ausstieg, 24),
                    status = as.integer(t <= ausstieg & t <= 24))
)

par(mar = c(4, 4, 2, 1))
farben <- c("black", "#2166ac", "#b2182b")
for (i in seq_along(faelle)) {
  f <- faelle[[i]]
  kurve <- survfit(Surv(f$zeit, f$status) ~ 1)
  if (i == 1) {
    plot(kurve, conf.int = FALSE, col = farben[i], lwd = 2, xlim = c(0, 24),
         ylim = c(0, 1), xlab = "Monate", ylab = "S(t)")
  } else {
    lines(kurve, conf.int = FALSE, col = farben[i], lwd = 2)
  }
  s <- summary(kurve, times = c(12, 24))$surv
  cat(sprintf("%-14s zensiert %.2f  S(12) %.3f  S(24) %.3f  Median %s\n",
              names(faelle)[i], mean(f$status == 0), s[1], s[2],
              format(summary(kurve)$table["median"])))
}
wahr           zensiert 0.00  S(12) 0.668  S(24) 0.450  Median 20.71496
administrativ  zensiert 0.45  S(12) 0.668  S(24) 0.450  Median 20.71496
informativ     zensiert 0.74  S(12) 0.764  S(24) 0.588  Median NA
legend("bottomleft", legend = names(faelle), col = farben, lwd = 2, bty = "n")
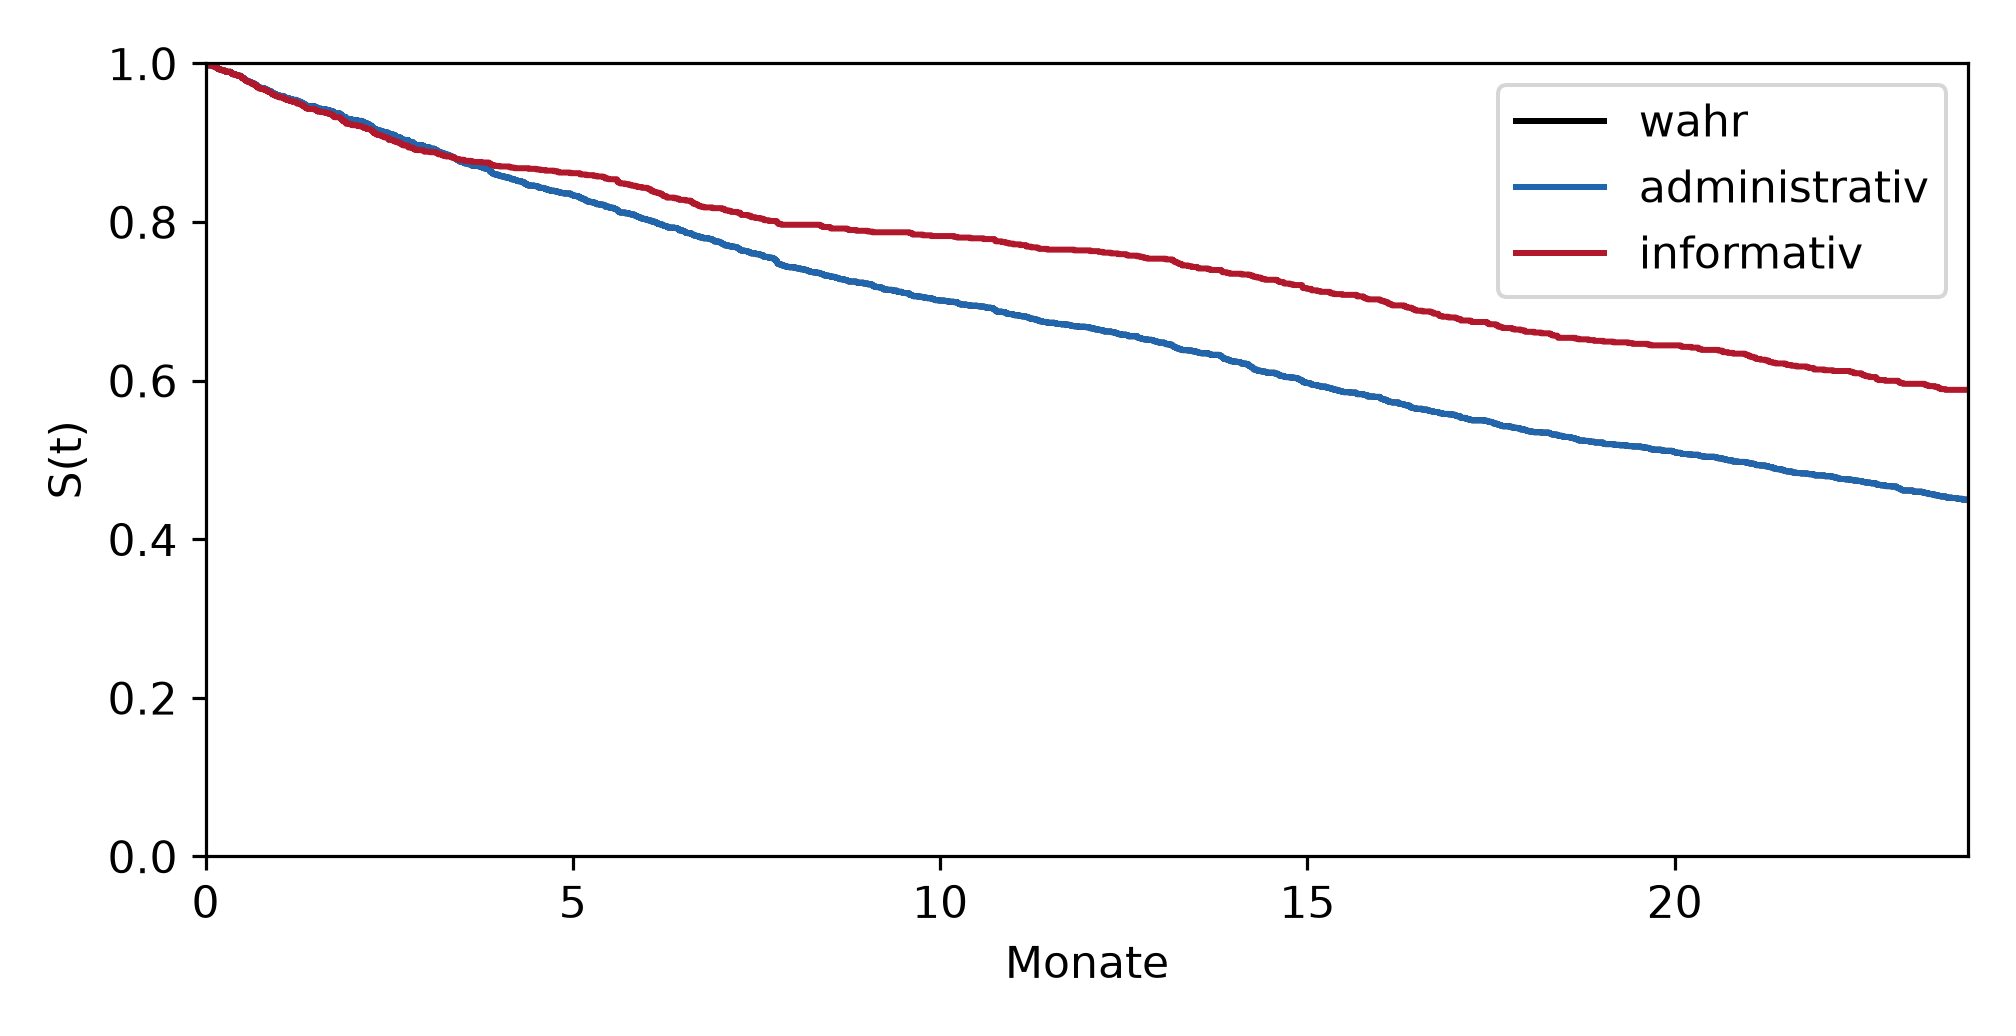
Abbildung 1: Beispiel 3: dieselbe Grundgesamtheit, drei Zensierungsmuster. Nur die informative Zensierung verschiebt die Kurve.
n = 2000
hoch = lehmer(4141, n) < 0.5
rate_i = 0.02 * np.exp(1.0 * hoch)
t = -np.log(lehmer(4242, n)) / rate_i

ausstieg = np.where(hoch, 6 * lehmer(4343, n), np.inf)

faelle = {
    "wahr": (t, np.ones(n, dtype=int)),
    "administrativ": (np.minimum(t, 24), (t <= 24).astype(int)),
    "informativ": (np.minimum(np.minimum(t, ausstieg), 24),
                   ((t <= ausstieg) & (t <= 24)).astype(int)),
}

fig, achse = plt.subplots(figsize=(7, 3.6))
for (name, (z, s)), farbe in zip(faelle.items(),
                                 ["black", "#2166ac", "#b2182b"]):
    km = KaplanMeierFitter().fit(z, s, label=name)
    km.plot_survival_function(ax=achse, ci_show=False, color=farbe)
    werte = km.survival_function_at_times([12, 24]).values
    print(f"{name:14s} zensiert {float((s == 0).mean()):.2f}"
          f"  S(12) {werte[0]:.3f}  S(24) {werte[1]:.3f}"
          f"  Median {km.median_survival_time_:.2f}")

achse.set_xlim(0, 24)
(0.0, 24.0)
achse.set_ylim(0, 1)
(0.0, 1.0)
achse.set_xlabel("Monate")
achse.set_ylabel("S(t)")
plt.tight_layout()
plt.show()
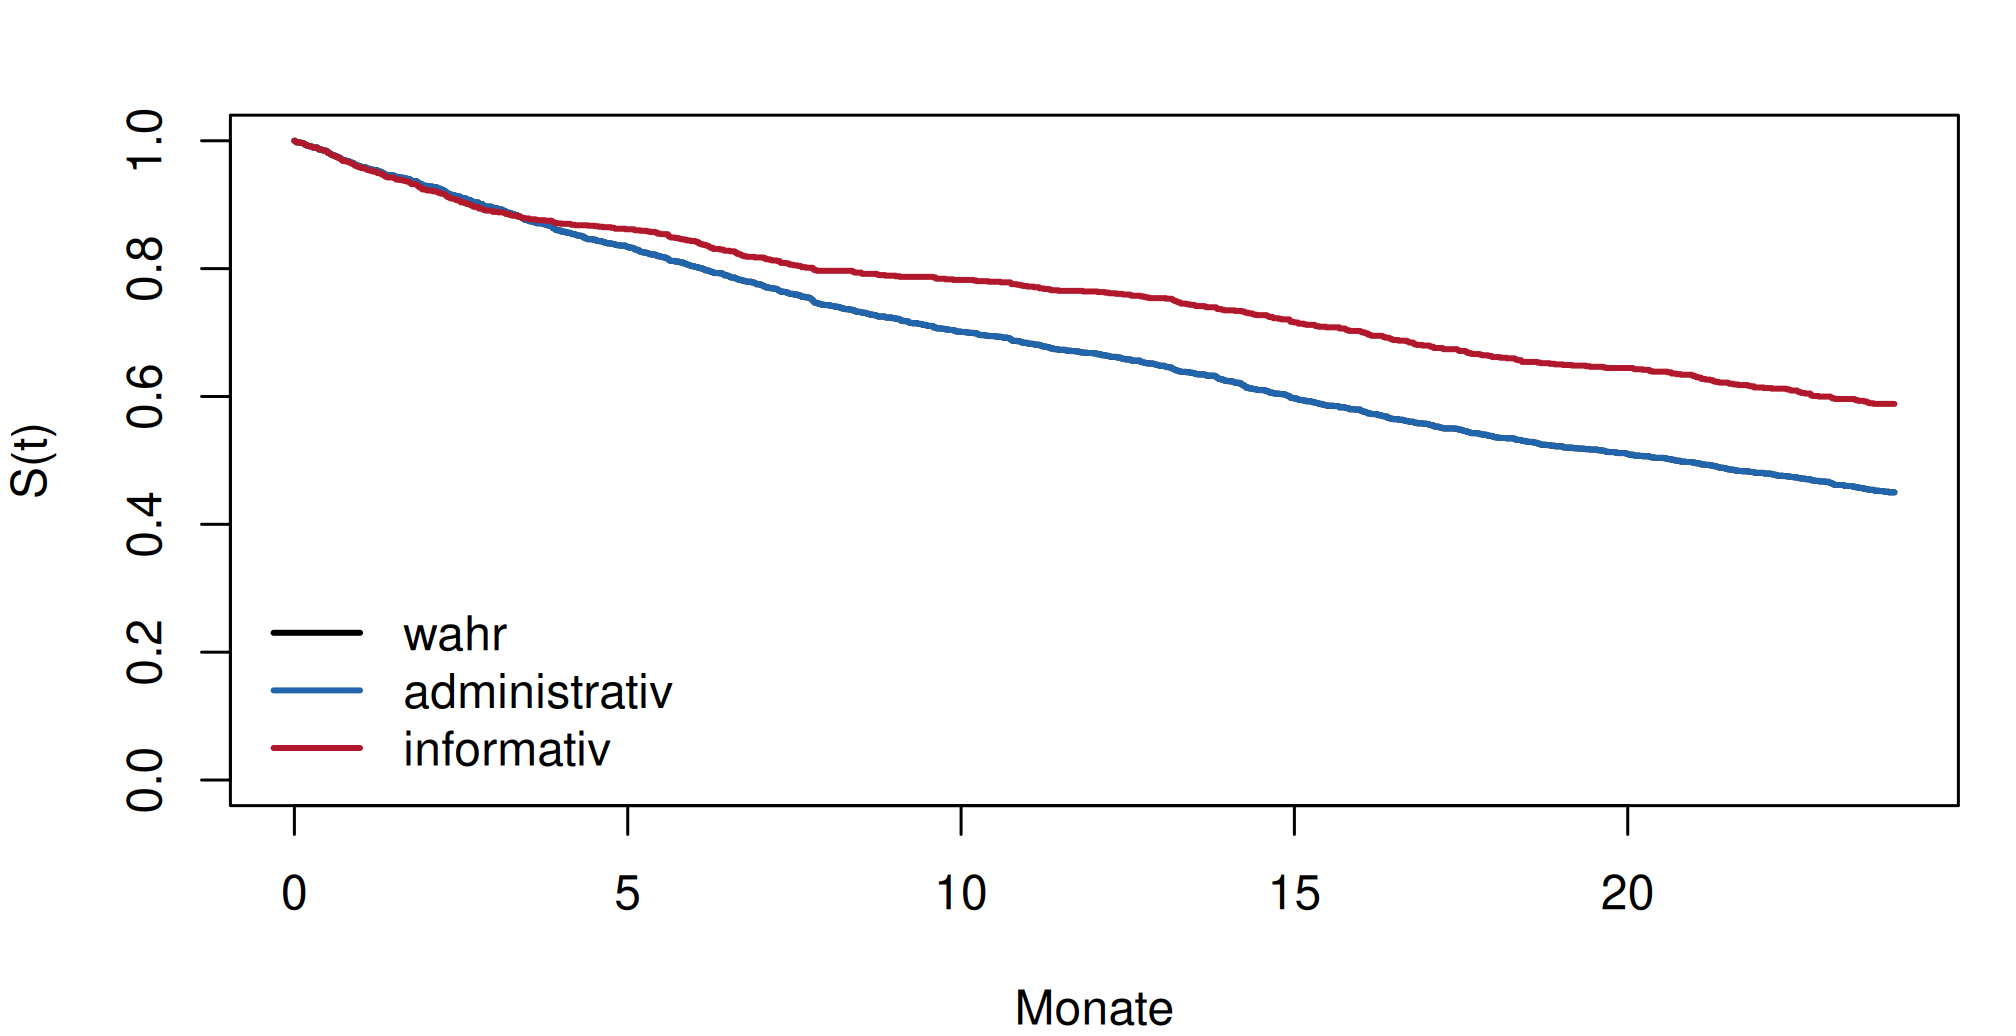
Abbildung 2: Beispiel 3: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

Auswertung Anteil zensiert \(\hat{S}(12)\) \(\hat{S}(24)\) Median
wahr (keine Zensierung) 0.00 0.668 0.450 20.70
administrativ 0.45 0.668 0.450 20.70
informativ 0.74 0.764 0.588 nicht erreicht
Beobachtung Deutung
Administrativ = wahr, auf drei Stellen Trotz 45 Prozent Zensierung liefert der Schätzer exakt die richtige Kurve. Das ist keine Näherung: Wenn die Zensierung nichts über das Risiko sagt, geht keine Information verloren. Genau dafür ist das Verfahren gebaut.
Informativ: \(\hat{S}(12) = 0.764\) statt 0.668 Zehn Prozentpunkte zu optimistisch. Und die Richtung ist kein Zufall: Ausgestiegen sind gerade die Hochrisikopersonen. Der Schätzer nimmt an, sie hätten ab dem Ausstieg das Risiko der Verbliebenen, was falsch ist, denn ihr Risiko war fast dreimal so hoch.
Informativ: Median nicht erreicht Aus 20.7 Monaten wird “über 24”. Wer nur diese Auswertung sieht, hat keinen Anhaltspunkt, dass etwas nicht stimmt.
Anteil zensiert 0.74 Der einzige Hinweis in den Zahlen und ein schwacher, denn eine hohe Zensierungsrate ist für sich genommen kein Fehler (Beispiel 2, Fall “stark”, hatte 63 Prozent bei völlig unbedenklicher Zensierung).

Was diesen Fall so unangenehm macht: Es gibt keinen Test, der ihn findet. Der Vergleich mit der Wahrheit ist hier nur möglich, weil die Daten konstruiert sind. In echten Daten sieht die verzerrte Kurve genauso plausibel aus wie die richtige.

Was hilft, ist ausschliesslich die Buchführung über die Zensierungsgründe:

Prüffrage Warum sie zählt
Wann wird zensiert? Alles am Stichtag → administrativ, unbedenklich. Über die Zeit verstreut → nachfragen.
Warum scheidet jemand aus? Der Grund muss erhoben werden. “Verzogen” ist meist harmlos, “abgemeldet ohne Angabe” nicht.
Unterscheiden sich Zensierte in beobachtbaren Merkmalen? Das beweist nichts, aber ein deutlicher Unterschied ist ein Warnzeichen.
Wie sähe das Ergebnis im Extremfall aus? Eine Sensitivitätsrechnung: einmal alle Zensierten als sofortiges Ereignis, einmal als nie eintretend. Das Ergebnis liegt zwischen diesen Schranken.

Interpretation und Ergebnissatz

26 Prozent der Beobachtungen endeten vor dem Stichtag, überwiegend durch Abmeldung ohne Angabe von Gründen. Da nicht auszuschliessen ist, dass diese Abmeldungen mit dem Kündigungsrisiko zusammenhängen, ist die geschätzte Kurve möglicherweise zu optimistisch; eine Sensitivitätsrechnung mit allen Zensierten als Ereignis ergibt einen Anteil von [Wert] nach zwölf Monaten als untere Schranke.

Frage und Datenlage

Die Hazard-Rate macht sichtbar, wann das Risiko hoch ist, die Überlebensfunktion nur, wie viel sich insgesamt angesammelt hat. Drei Verläufe, alle mit demselben Median von 20 Monaten:

Verlauf Hazard Sachbeispiel
konstant \(h(t) = 0.0347\) Ausfall ohne Alterung, rein zufällig
fallend \(h(t) \propto t^{-0.5}\) Frühausfälle: was die erste Zeit übersteht, hält
steigend \(h(t) \propto t^{1.0}\) Verschleiss: das Risiko wächst mit dem Alter

Rechnung

t <- seq(0.05, 36, by = 0.05)
median_soll <- 20

# Weibull: h(t) = (k/lambda) * (t/lambda)^(k-1), S(t) = exp(-(t/lambda)^k)
# lambda so waehlen, dass S(20) = 0.5 gilt
weibull_hazard <- function(t, k) {
  lambda <- median_soll / log(2)^(1 / k)
  (k / lambda) * (t / lambda)^(k - 1)
}
weibull_surv <- function(t, k) {
  lambda <- median_soll / log(2)^(1 / k)
  exp(-(t / lambda)^k)
}

formen <- c(fallend = 0.5, konstant = 1.0, steigend = 2.0)
farben <- c("#b2182b", "black", "#2166ac")

par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))
plot(NA, xlim = c(0, 36), ylim = c(0, 0.12), xlab = "Monate", ylab = "h(t)",
     main = "Hazard-Rate")
for (i in seq_along(formen)) lines(t, weibull_hazard(t, formen[i]),
                                   col = farben[i], lwd = 2)
legend("topleft", legend = names(formen), col = farben, lwd = 2, bty = "n")

plot(NA, xlim = c(0, 36), ylim = c(0, 1), xlab = "Monate", ylab = "S(t)",
     main = "Überlebensfunktion")
for (i in seq_along(formen)) lines(t, weibull_surv(t, formen[i]),
                                   col = farben[i], lwd = 2)
abline(h = 0.5, lty = 2); abline(v = median_soll, lty = 2)
par(mfrow = c(1, 1))

# Anteile zu drei Zeitpunkten
round(sapply(formen, function(k) weibull_surv(c(3, 12, 20, 36), k)), 3) |>
  `rownames<-`(c("t=3", "t=12", "t=20", "t=36"))
     fallend konstant steigend
t=3    0.765    0.901    0.985
t=12   0.585    0.660    0.779
t=20   0.500    0.500    0.500
t=36   0.395    0.287    0.106
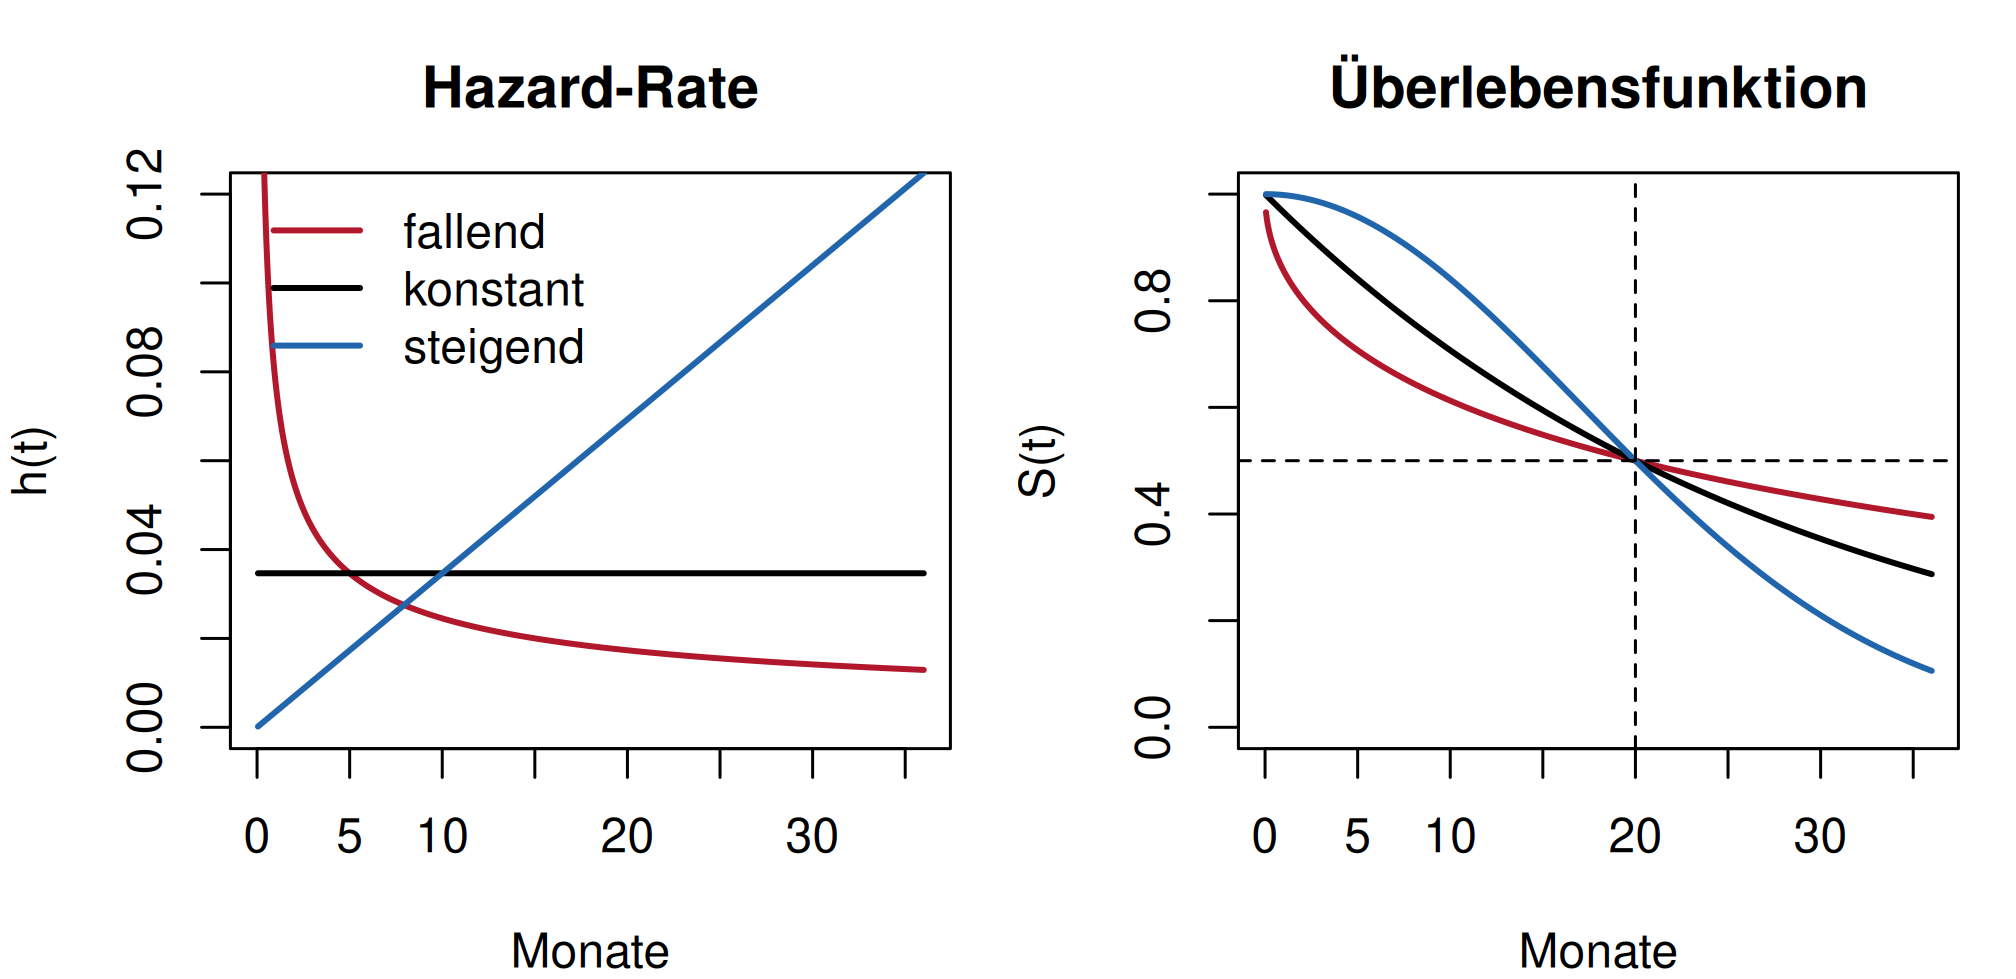
Abbildung 3: Beispiel 4: drei Weibull-Verläufe mit identischem Median. Links die Hazard-Rate, rechts die Überlebensfunktion.
t = np.arange(0.05, 36.05, 0.05)
median_soll = 20


def weibull_lambda(k):
    return median_soll / np.log(2) ** (1 / k)


def weibull_hazard(t, k):
    lam = weibull_lambda(k)
    return (k / lam) * (t / lam) ** (k - 1)


def weibull_surv(t, k):
    return np.exp(-(t / weibull_lambda(k)) ** k)


formen = {"fallend": 0.5, "konstant": 1.0, "steigend": 2.0}
farben = ["#b2182b", "black", "#2166ac"]

fig, achsen = plt.subplots(1, 2, figsize=(7, 3.4))
for (name, k), farbe in zip(formen.items(), farben):
    achsen[0].plot(t, weibull_hazard(t, k), color=farbe, lw=2, label=name)
    achsen[1].plot(t, weibull_surv(t, k), color=farbe, lw=2, label=name)
achsen[0].set_ylim(0, 0.12)
(0.0, 0.12)
achsen[0].set_title("Hazard-Rate")
achsen[0].set_ylabel("h(t)")
achsen[0].legend(frameon=False)
achsen[1].set_ylim(0, 1)
(0.0, 1.0)
achsen[1].set_title("Überlebensfunktion")
achsen[1].set_ylabel("S(t)")
achsen[1].axhline(0.5, ls="--", color="black", lw=0.8)
achsen[1].axvline(median_soll, ls="--", color="black", lw=0.8)
for achse in achsen:
    achse.set_xlabel("Monate")
plt.tight_layout()
plt.show()
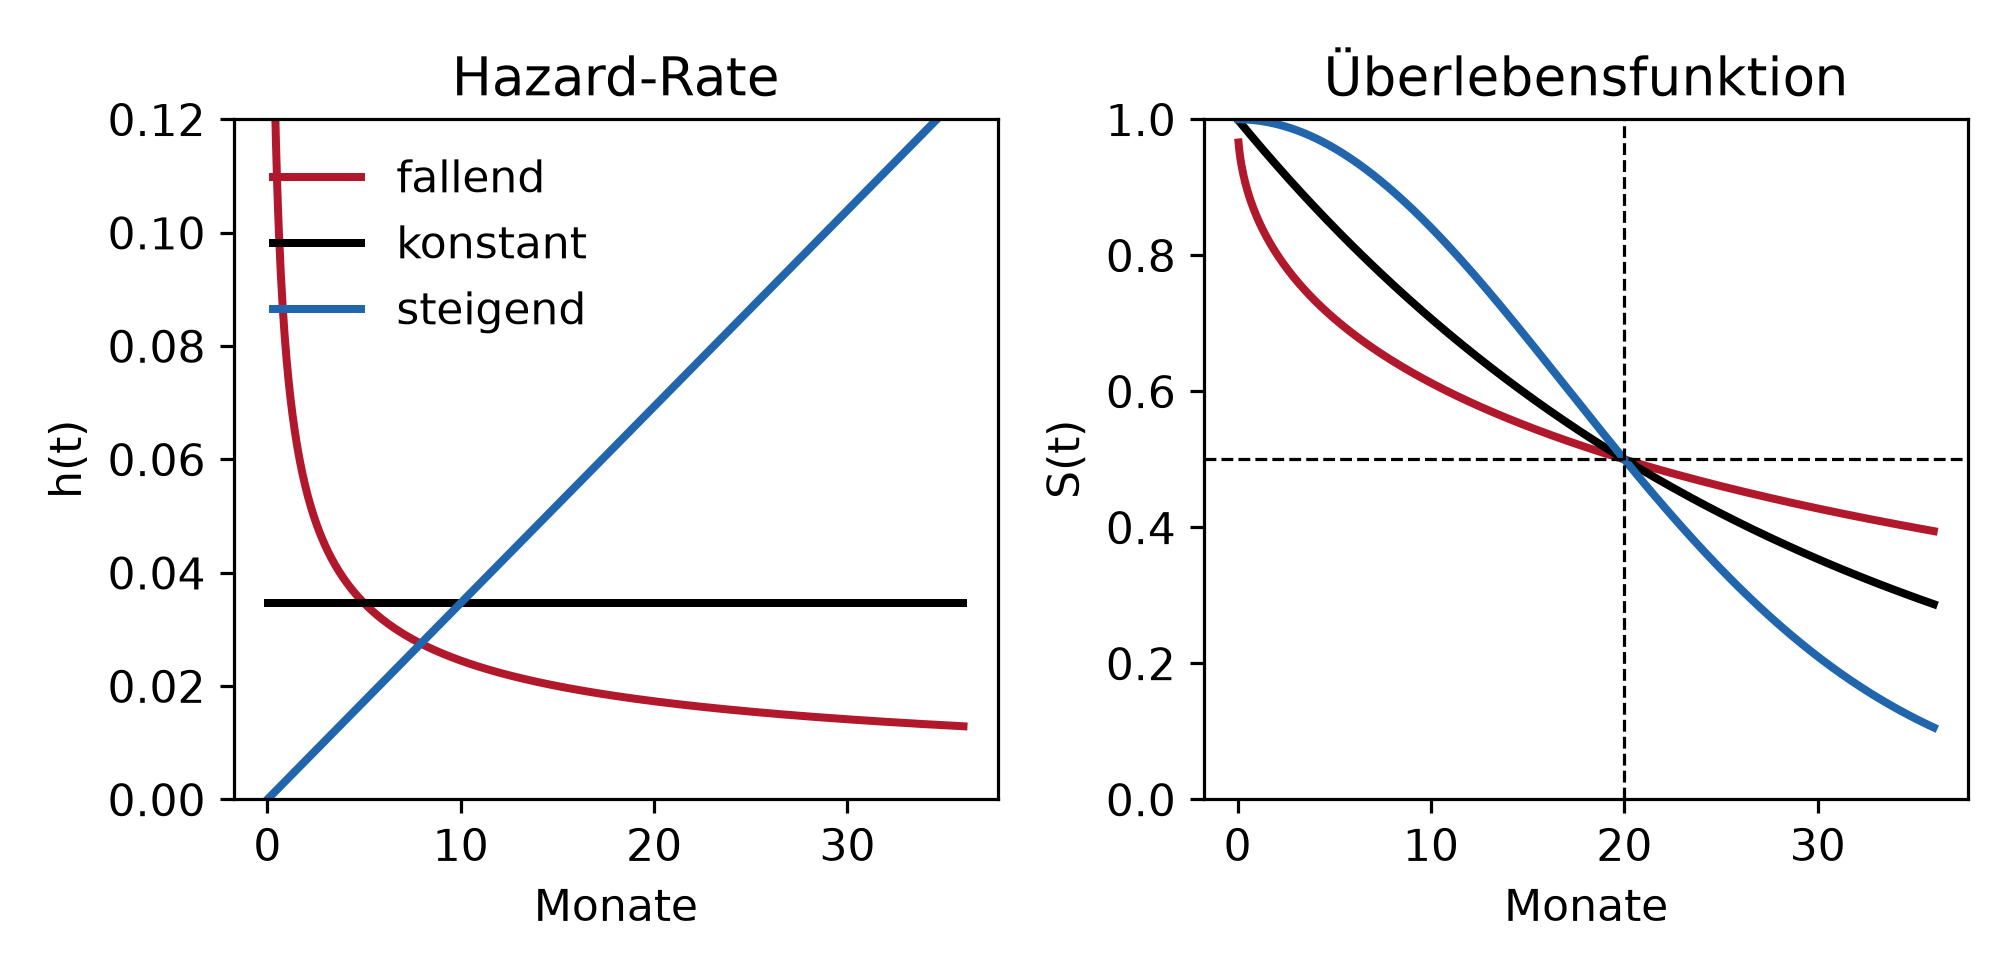
Abbildung 4: Beispiel 4: dieselben drei Verläufe in Python.
print(pd.DataFrame({name: weibull_surv(np.array([3, 12, 20, 36]), k).round(3)
                    for name, k in formen.items()},
                   index=["t=3", "t=12", "t=20", "t=36"]))
      fallend  konstant  steigend
t=3     0.765     0.901     0.985
t=12    0.585     0.660     0.779
t=20    0.500     0.500     0.500
t=36    0.395     0.287     0.106

Output Zeile für Zeile

Die Anteile ohne Ereignis, alle drei Verläufe mit Median 20:

Zeitpunkt fallend konstant steigend
\(t = 3\) 0.765 0.901 0.985
\(t = 12\) 0.585 0.660 0.779
\(t = 20\) 0.500 0.500 0.500
\(t = 36\) 0.395 0.287 0.106
Beobachtung Deutung
Alle drei bei \(t = 20\) auf 0.500 Der Median ist identisch. Wer nur ihn berichtet, berichtet drei völlig verschiedene Sachverhalte als dieselbe Zahl.
Bei \(t = 3\): 0.765 gegen 0.985 Nach drei Monaten sind im fallenden Fall bereits 23.5 Prozent ausgeschieden, im steigenden 1.5 Prozent. Ein Unterschied, der über jede Garantiezusage entscheidet.
Bei \(t = 36\): 0.395 gegen 0.106 Und danach kehrt sich das Verhältnis um: fast das Vierfache. Wer die frühe Phase übersteht, hält im fallenden Fall lange.
Die Hazard-Kurve links zeigt das unmittelbar: rot fällt steil ab, blau steigt linear. Die Überlebenskurven rechts sehen dagegen alle ähnlich aus, glatt und fallend.

Warum das für die Modellwahl entscheidend ist: Das Cox-Modell muss über die Form von \(h_0(t)\) nichts annehmen, es lässt sie frei und schätzt nur Verhältnisse. Genau deshalb ist es der Standardfall.

Ein parametrisches Modell (Weibull, Exponential, log-normal) legt die Form fest. Das bringt zwei Dinge: eine Extrapolation über den Beobachtungszeitraum hinaus und engere Intervalle, beides aber nur, wenn die unterstellte Form stimmt. Der Exponentialfall entspricht dem konstanten Verlauf oben, also \(k = 1\); ihn zu unterstellen heisst zu behaupten, das Risiko hänge nicht vom Alter ab. Für Verschleissteile ist das offensichtlich falsch.

Interpretation

Zu einer Überlebensanalyse gehören deshalb immer die Anteile zu mehreren Zeitpunkten, nicht nur der Median und, wo möglich, ein Blick auf den Verlauf der Hazard-Rate.

Verständnisfragen

Eine Auswertung entfernt alle zensierten Fälle und berechnet den Mittelwert der verbleibenden Zeiten. Was ist die Folge?

Der Mittelwert ist unverzerrt, nur die Stichprobe ist kleiner
Sie ist nicht nur kleiner, sondern systematisch ausgewählt.
Die Zeit wird unterschätzt, weil die Langläufer fehlen
Richtig. Zensiert sind gerade die Fälle, die lange kein Ereignis hatten. Wer sie entfernt, behält die kurzen Zeiten und verzerrt nach unten, im Beispiel auf die Hälfte des wahren Medians.
Die Zeit wird überschätzt
Beide Behelfslösungen verzerren nach unten, nur aus verschiedenen Gründen.

Bei 63 Prozent Zensierung gibt Kaplan-Meier für den Median NA aus. Ist das ein Mangel des Verfahrens?

Nein, es ist die einzig ehrliche Antwort
Richtig. Die Kurve erreicht im Beobachtungszeitraum nie 50 Prozent; der Median liegt ausserhalb dessen, was die Daten zeigen. Die Behelfsrechnung, die stattdessen “24 Monate” liefert, nennt nur den Stichtag.
Ja, ein Median lässt sich immer schätzen
Nur, wenn die Kurve die 50 Prozent auch erreicht.
Ja, bei mehr Beobachtungen käme eine Zahl heraus
Mehr Beobachtungen helfen nicht; nötig wäre eine längere Beobachtungszeit.

Warum ist die Annahme nicht informativer Zensierung in den Daten nicht prüfbar?

Weil dafür die unbeobachteten Zeiten der Zensierten nötig wären
Richtig. Die Frage lautet, ob die Zensierten dasselbe Risiko hatten; das liesse sich nur beantworten, wenn man ihre Ereigniszeiten kennte. Übrig bleiben die inhaltliche Begründung und eine Sensitivitätsrechnung.
Weil die Stichprobe dafür zu klein ist
Auch bei beliebig grosser Stichprobe fehlt genau diese Information.
Sie ist prüfbar, über einen Test auf gleiche Verteilung
Ein solcher Test vergleicht beobachtbare Merkmale, nicht die unbeobachteten Zeiten.

Hochrisikopersonen scheiden früh aus der Beobachtung aus. In welche Richtung verzerrt das die Kurve?

Sie wird zu optimistisch
Richtig. Der Schätzer unterstellt den Ausgeschiedenen ab dem Zensierungszeitpunkt das Risiko der Verbliebenen und das ist niedriger. Im Beispiel steigt der Anteil nach zwölf Monaten von 0.67 auf 0.76.
Sie wird zu pessimistisch
Das wäre der Fall, wenn gerade die Niedrigrisikopersonen ausschieden.
Gar nicht, Kaplan-Meier korrigiert das
Es korrigiert nur für Zensierung, die nichts über das Risiko aussagt.

Drei Verläufe haben denselben Median von 20 Monaten, aber nach drei Monaten Anteile von 0.77, 0.90 und 0.99 und nach 36 Monaten 0.40, 0.29 und 0.11. Was folgt daraus?

Der Median allein beschreibt eine Überlebenszeit unzureichend
Richtig. Dieselbe Kennzahl kann für sehr verschiedene Verläufe stehen. Berichtet werden deshalb Anteile zu mehreren, fachlich begründeten Zeitpunkten.
Einer der drei Verläufe ist falsch gerechnet
Alle drei sind korrekt; sie unterscheiden sich in der Form der Hazard-Rate.
Die Verläufe unterscheiden sich nur zufällig
Sie stammen aus drei verschiedenen Verteilungen und unterscheiden sich systematisch.

Eine Hazard-Rate beträgt 0.035 pro Monat. Was bedeutet das?

3.5 Prozent aller Personen erleben das Ereignis
Die Hazard-Rate ist keine Wahrscheinlichkeit über die ganze Gruppe.
Unter denen, die bis dahin kein Ereignis hatten, tritt es mit dieser Rate je Monat ein
Richtig. Die Hazard-Rate ist bedingt auf das Überleben bis zu diesem Zeitpunkt und beschreibt das momentane Risiko.
Nach einem Monat sind 96.5 Prozent noch dabei
Das ist ungefähr die Überlebensfunktion nach einem Monat, nicht die Hazard-Rate selbst.

Verlinkte Ressourcen