Eine Reihe ist stationär, wenn ihre statistischen Eigenschaften nicht davon abhängen, wann man hinschaut: konstanter Mittelwert, konstante Streuung, und eine Abhängigkeitsstruktur, die nur vom Abstand zweier Zeitpunkte abhängt, nicht von deren Lage.
Der Grund für die Wichtigkeit ist praktisch: Ein Modell lernt aus der Vergangenheit für die Zukunft. Wenn sich das Niveau laufend verschiebt, gibt es kein Niveau, das sich lernen liesse. Deshalb wird eine Reihe zuerst stationär gemacht und danach modelliert.
Drei typische Verletzungen und ihr Gegenmittel:
Verletzung
Erkennbar an
Gegenmittel
Trend
Niveau wandert
einmal differenzieren oder den Trend herausrechnen
Saison
wiederkehrendes Muster
saisonal differenzieren, Abstand gleich Periode
wachsende Streuung
Zacken werden höher
logarithmieren oder Wurzel ziehen
Zwei Arten von Trend
Diese Unterscheidung entscheidet über die Behandlung und wird häufig übersehen:
Im Bild sehen beide ähnlich aus. Der Unterschied zeigt sich erst in der Behandlung: Wer einen deterministischen Trend wegdifferenziert, erzeugt eine künstliche negative Abhängigkeit, siehe Beispiel 3.
Differenzieren
Differenzieren heisst, statt der Werte deren Veränderungen zu betrachten: \(\Delta y_t = y_t - y_{t-1}\). Aus einem linearen Trend wird damit ein konstantes Niveau. Saisonales Differenzieren nimmt den Abstand einer ganzen Periode: \(y_t - y_{t-12}\) bei Monatsdaten.
Die Faustregel: In der Praxis genügt fast immer eine Differenz, gelegentlich zwei, mehr praktisch nie. Und: Nimmt die Streuung durch das Differenzieren zu, war eine Differenz zu viel.
ACF und PACF
Beide beschreiben, wie stark ein Wert mit früheren Werten zusammenhängt, aber verschieden.
Die Autokorrelationsfunktion (ACF) gibt die Korrelation zwischen \(y_t\) und \(y_{t-k}\) für jeden Abstand \(k\). Sie enthält auch indirekte Wirkungen: Wenn heute mit gestern und gestern mit vorgestern zusammenhängt, zeigt die ACF auch bei Abstand zwei einen Wert, obwohl es keine direkte Verbindung gibt.
Die partielle Autokorrelationsfunktion (PACF) entfernt genau diese indirekten Wirkungen: Sie gibt die Korrelation zwischen \(y_t\) und \(y_{t-k}\), nachdem der Einfluss aller dazwischenliegenden Zeitpunkte herausgerechnet ist. Es ist dieselbe Idee wie der Unterschied zwischen einfacher und multipler Regression.
Die Konfidenzgrenzen in beiden Korrelogrammen liegen bei \(\pm 1.96/\sqrt{n}\), bei 120 Werten also bei ±0.179. Sie prüfen jeden Abstand einzeln; bei 24 angezeigten Abständen ist rund einer davon zufällig ausserhalb, siehe multiples Testen.
Tests auf Stationarität
Test
Nullhypothese
kleiner p-Wert heisst
ADF (Augmented Dickey-Fuller)
die Reihe ist nicht stationär (Einheitswurzel)
Beleg für Stationarität
KPSS
die Reihe ist stationär
Beleg gegen Stationarität
Diese Umkehrung ist die häufigste Verwechslung des ganzen Gebiets. Weil die beiden Tests entgegengesetzte Nullhypothesen haben, ergänzen sie sich: Erst wenn beide in dieselbe Richtung zeigen, ist die Sache klar.
Beispiele
Alle Beispiele arbeiten mit konstruierten Monatsreihen zu je 120 Werten ab Januar 2016. Weil die erzeugende Struktur bekannt ist, lässt sich prüfen, ob die Diagnose sie findet.
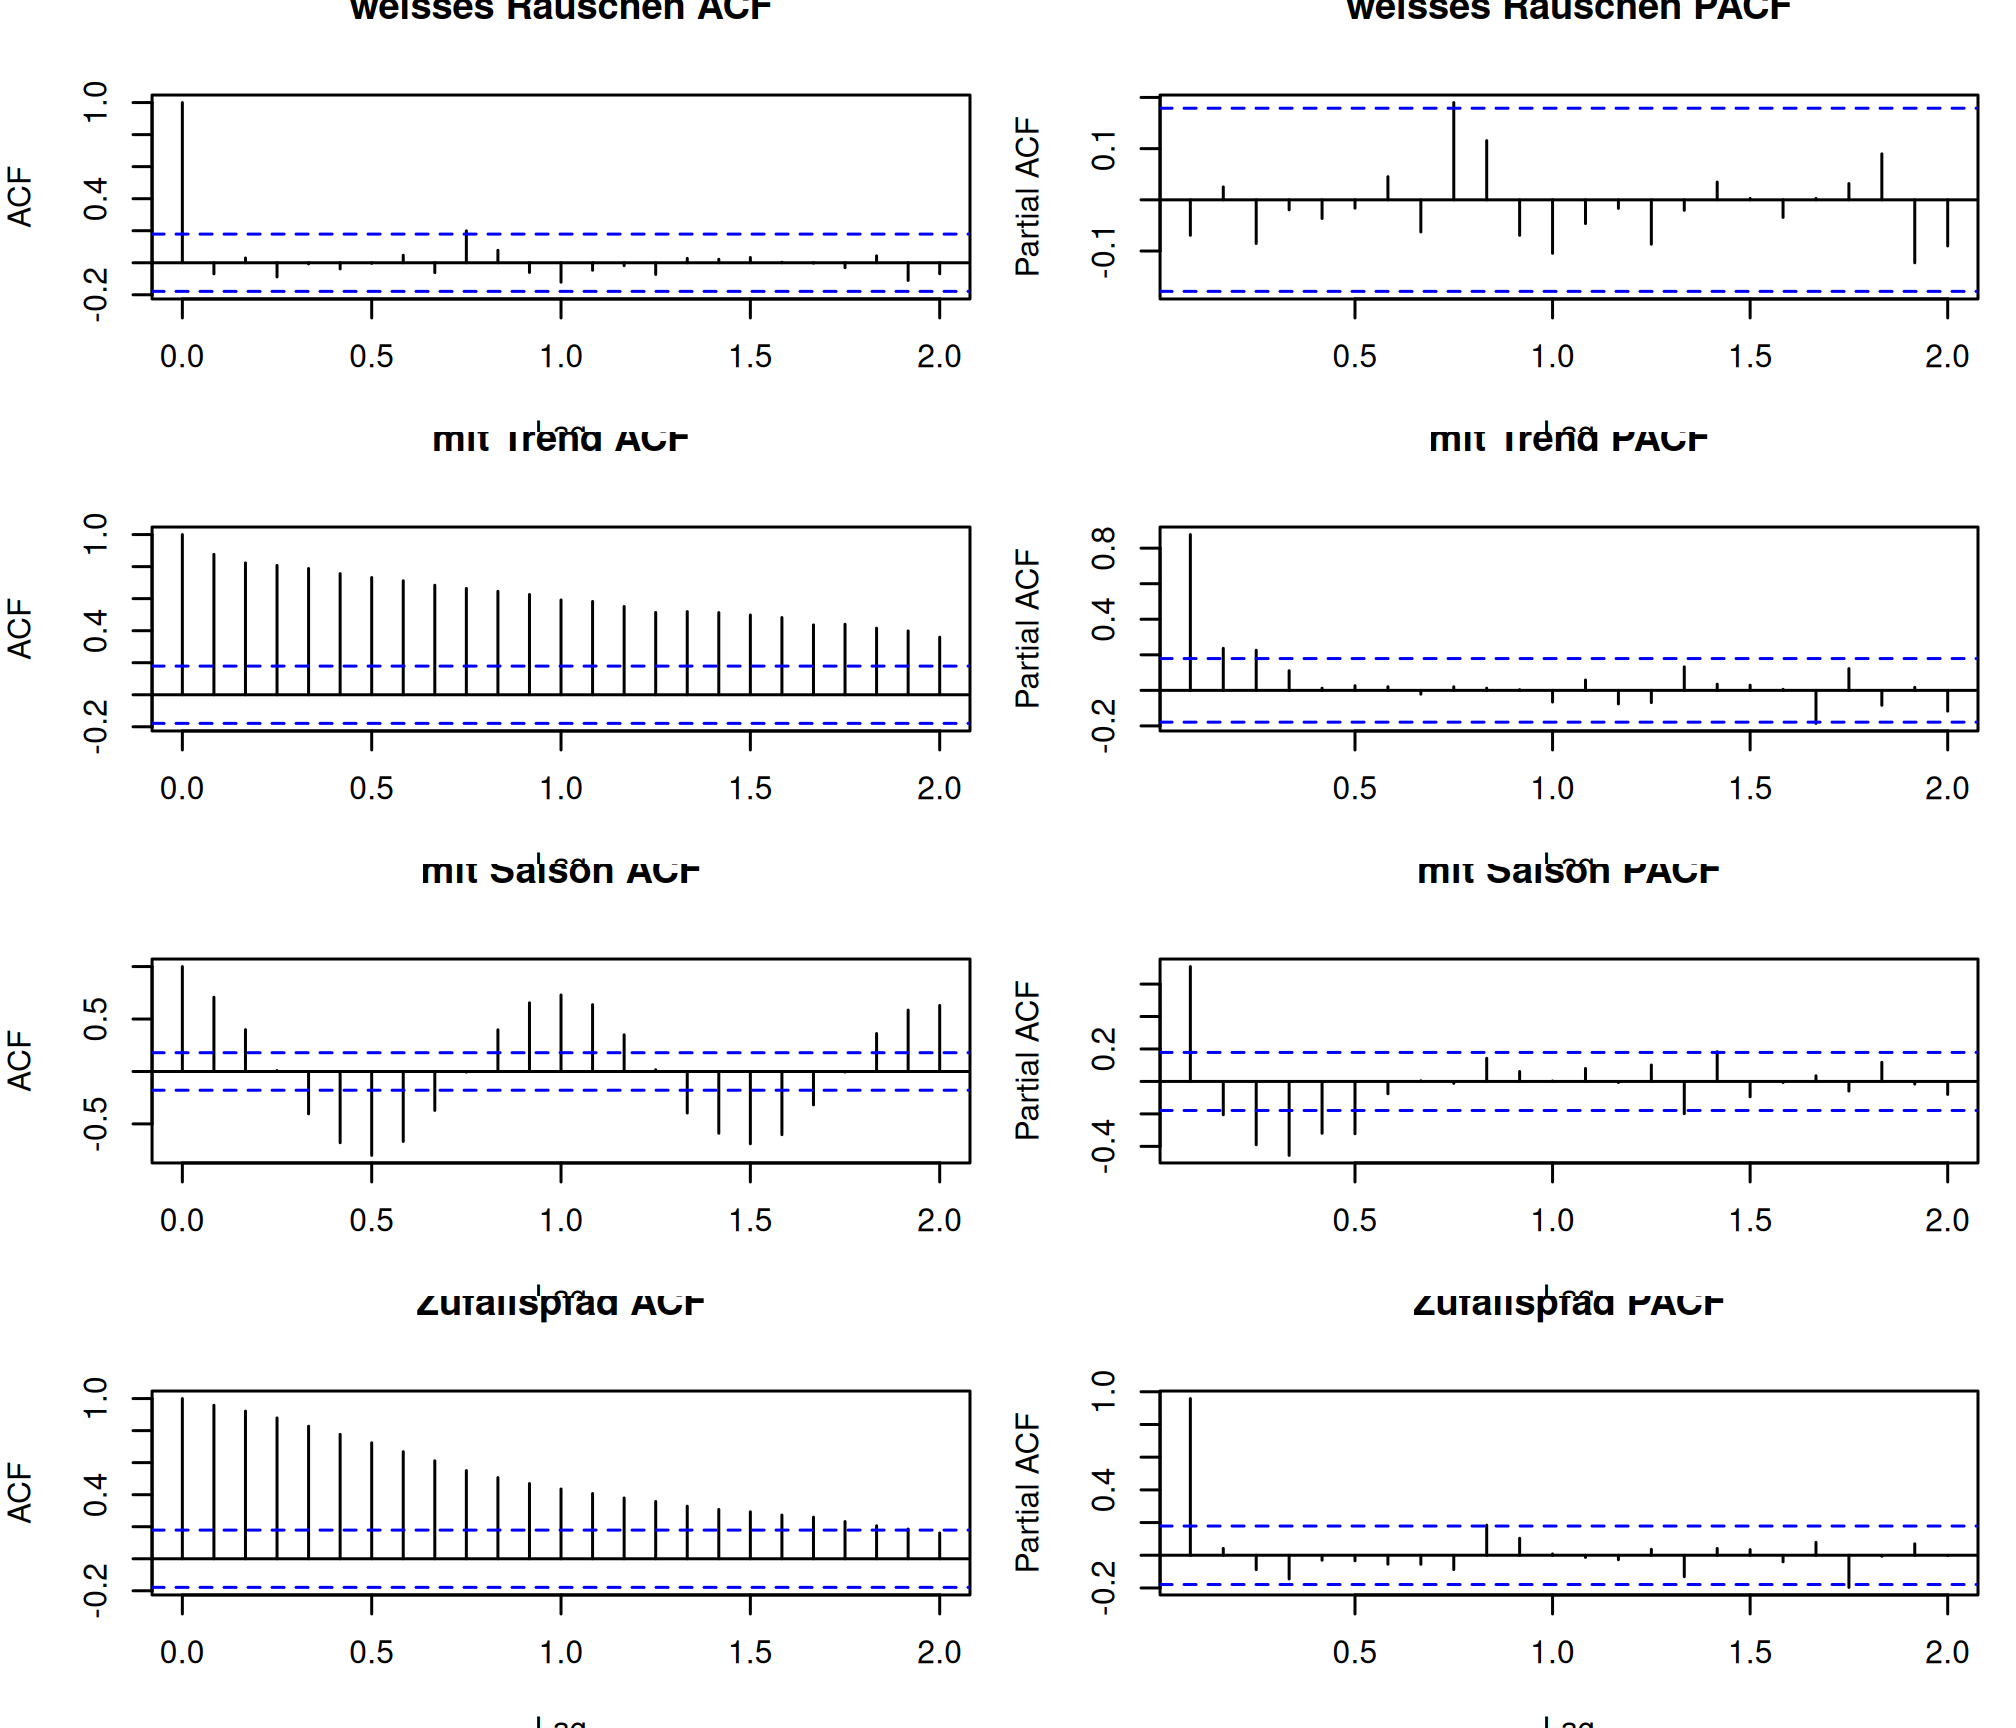
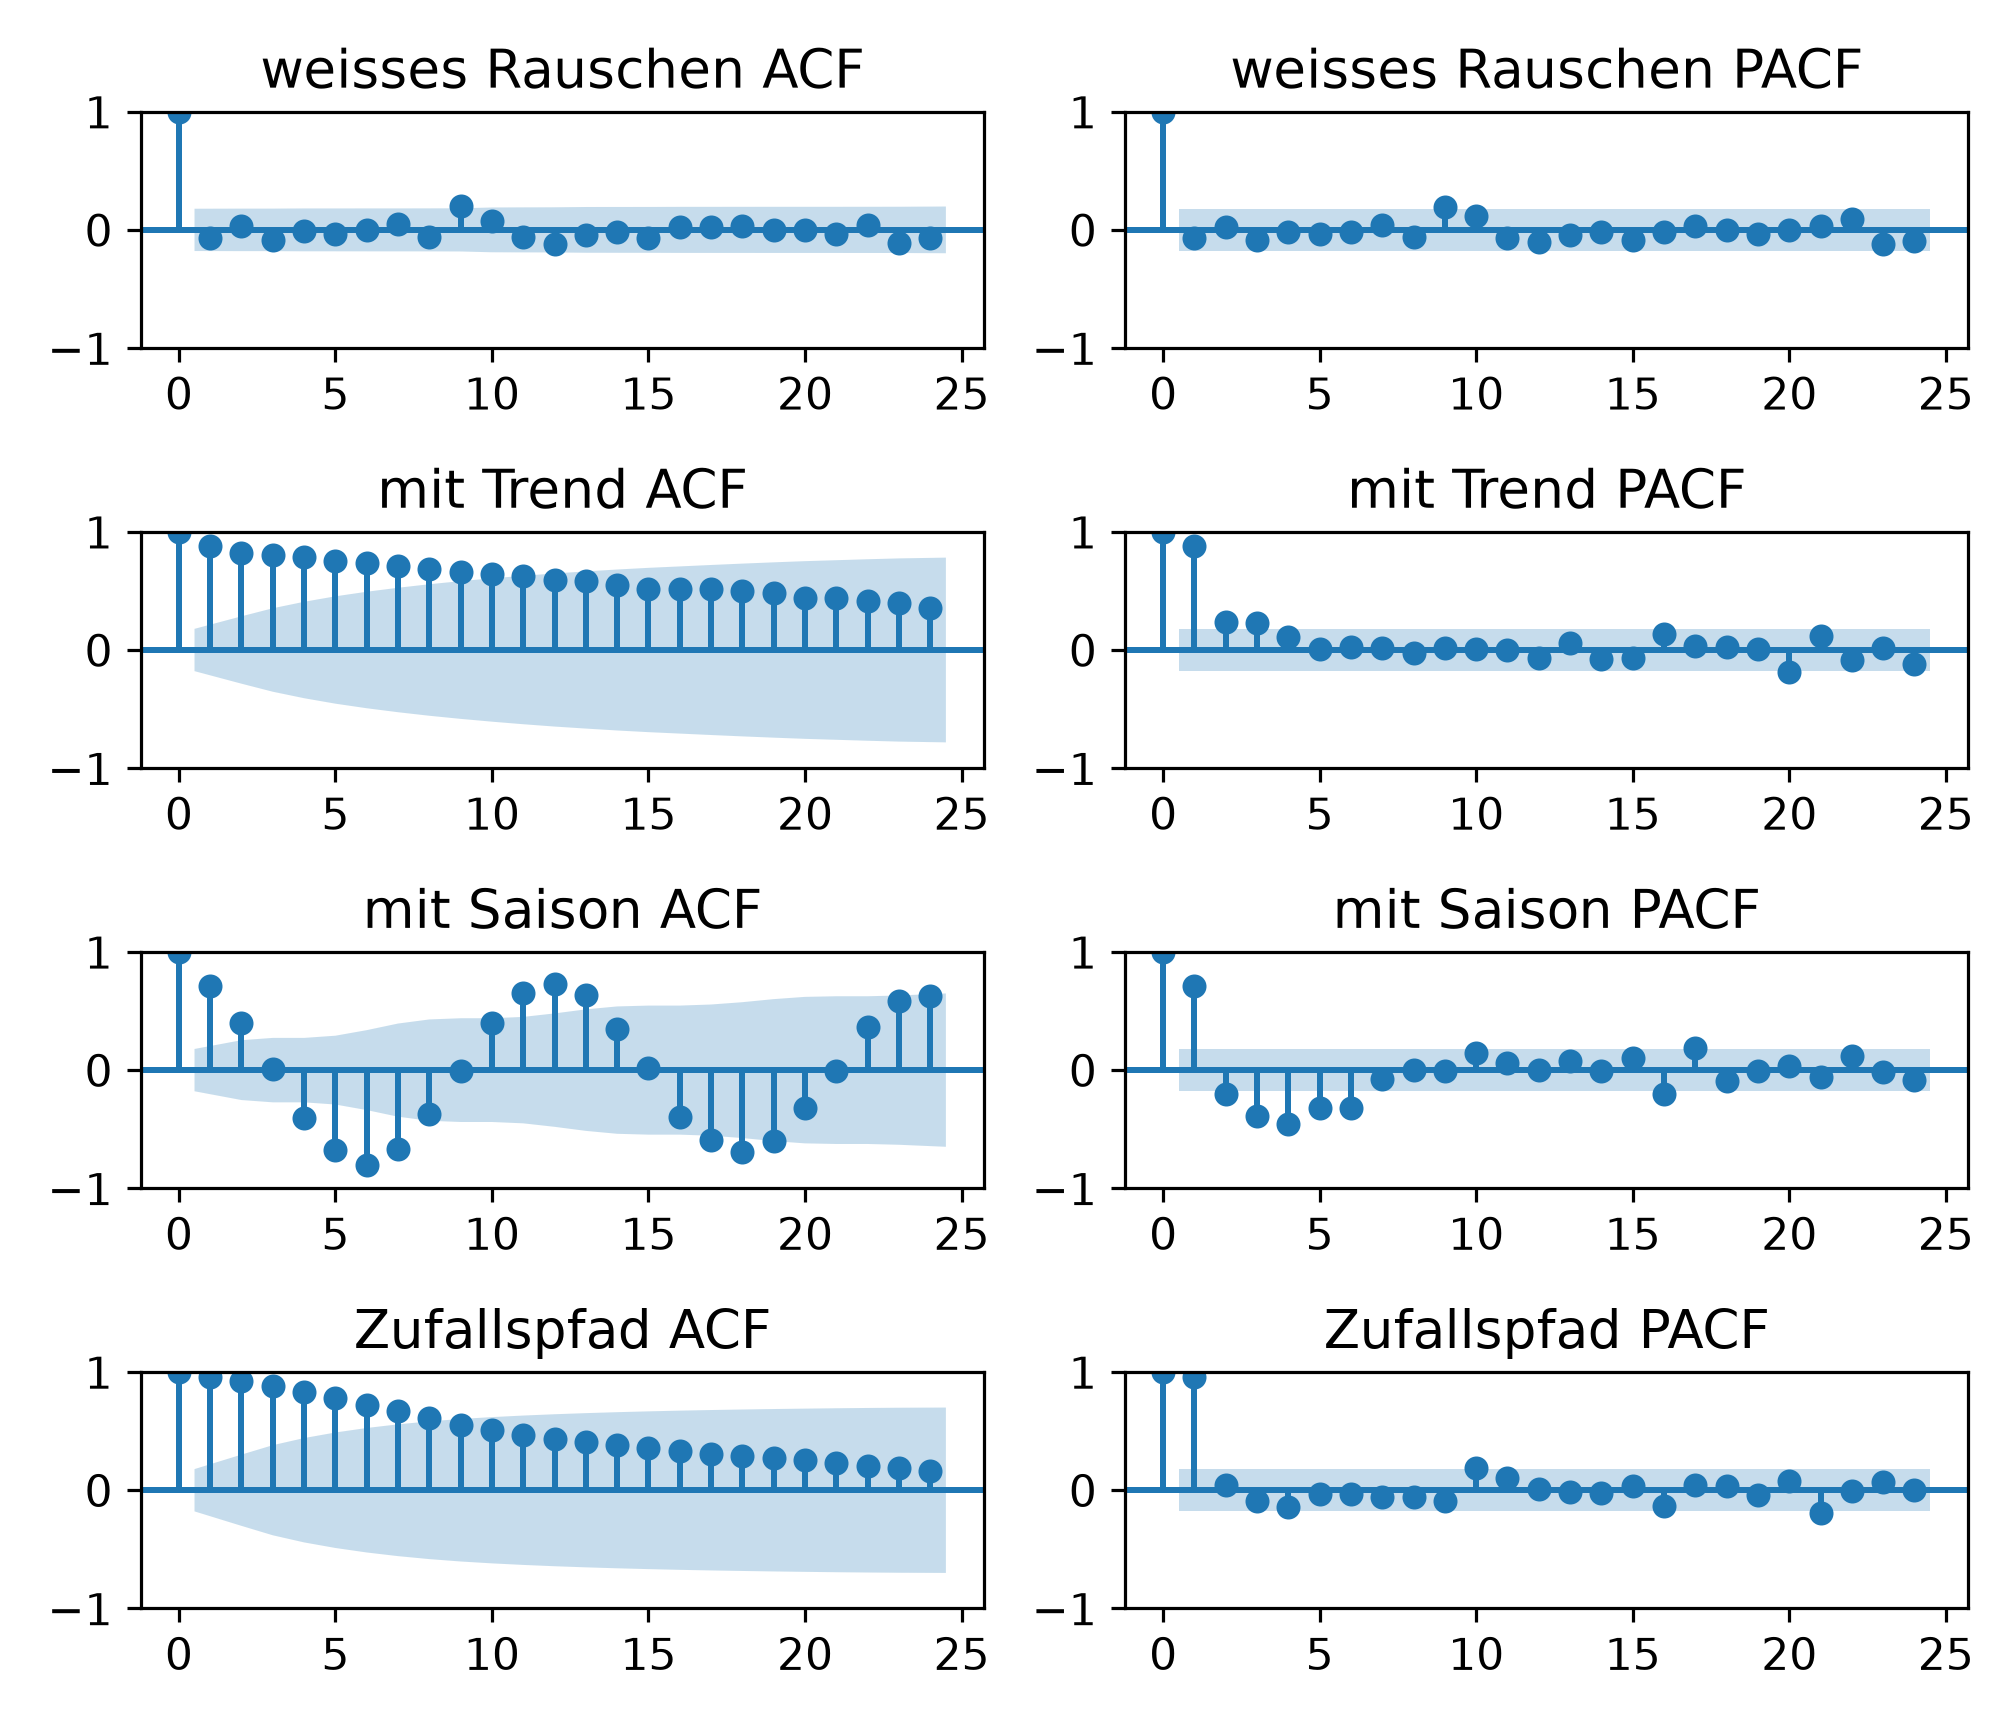
Vier Reihen mit bekannter Struktur: weisses Rauschen, ein deterministischer Trend, eine Jahressaison und ein Zufallspfad. Wie sehen ihre ACF und PACF aus?
Die ersten sechs Autokorrelationen (Konfidenzgrenze ±0.179):
Reihe
k=1
k=2
k=3
k=4
k=5
k=6
weisses Rauschen
-0.069
0.030
-0.089
-0.007
-0.039
-0.004
mit Trend
0.876
0.823
0.807
0.788
0.756
0.732
mit Saison
0.708
0.398
0.008
-0.404
-0.679
-0.800
Zufallspfad
0.958
0.922
0.879
0.827
0.776
0.724
Reihe
Muster
Diagnose
weisses Rauschen
alle Balken innerhalb der Grenzen, in ACF wie PACF
Nichts zu modellieren. Genau dieses Bild sollen die Residuen eines fertigen Modells zeigen.
mit Trend
ACF fällt sehr langsam ab und bleibt über zwanzig Abstände deutlich positiv; PACF hat einen grossen Wert bei k=1 (0.876) und wird danach klein
Das klassische Zeichen für Nichtstationarität. Die Reaktion ist differenzieren oder detrenden, nicht ein Modell mit vielen Ordnungen.
mit Saison
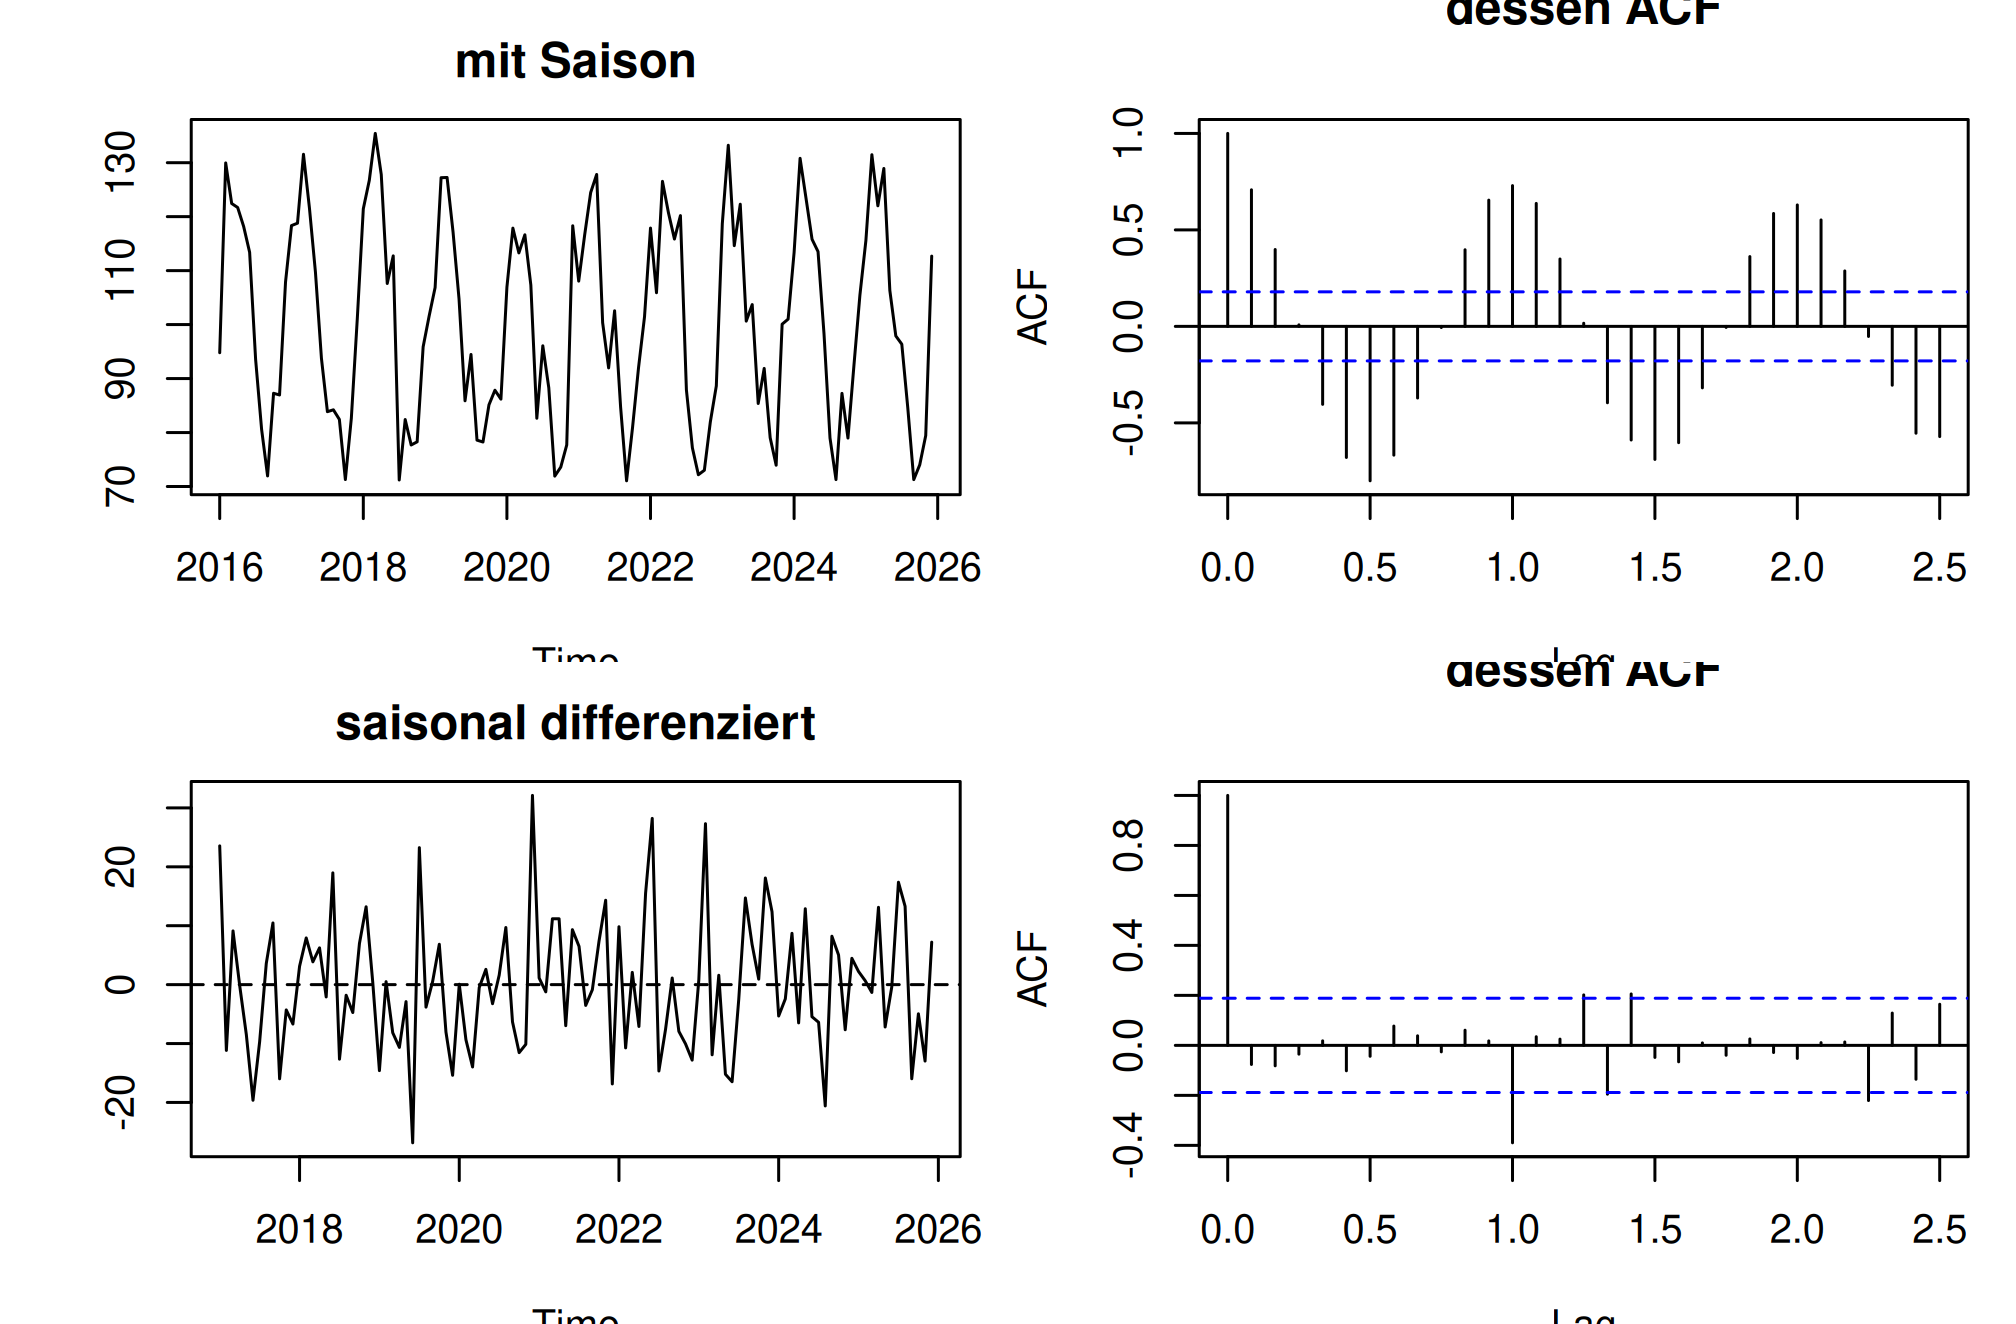
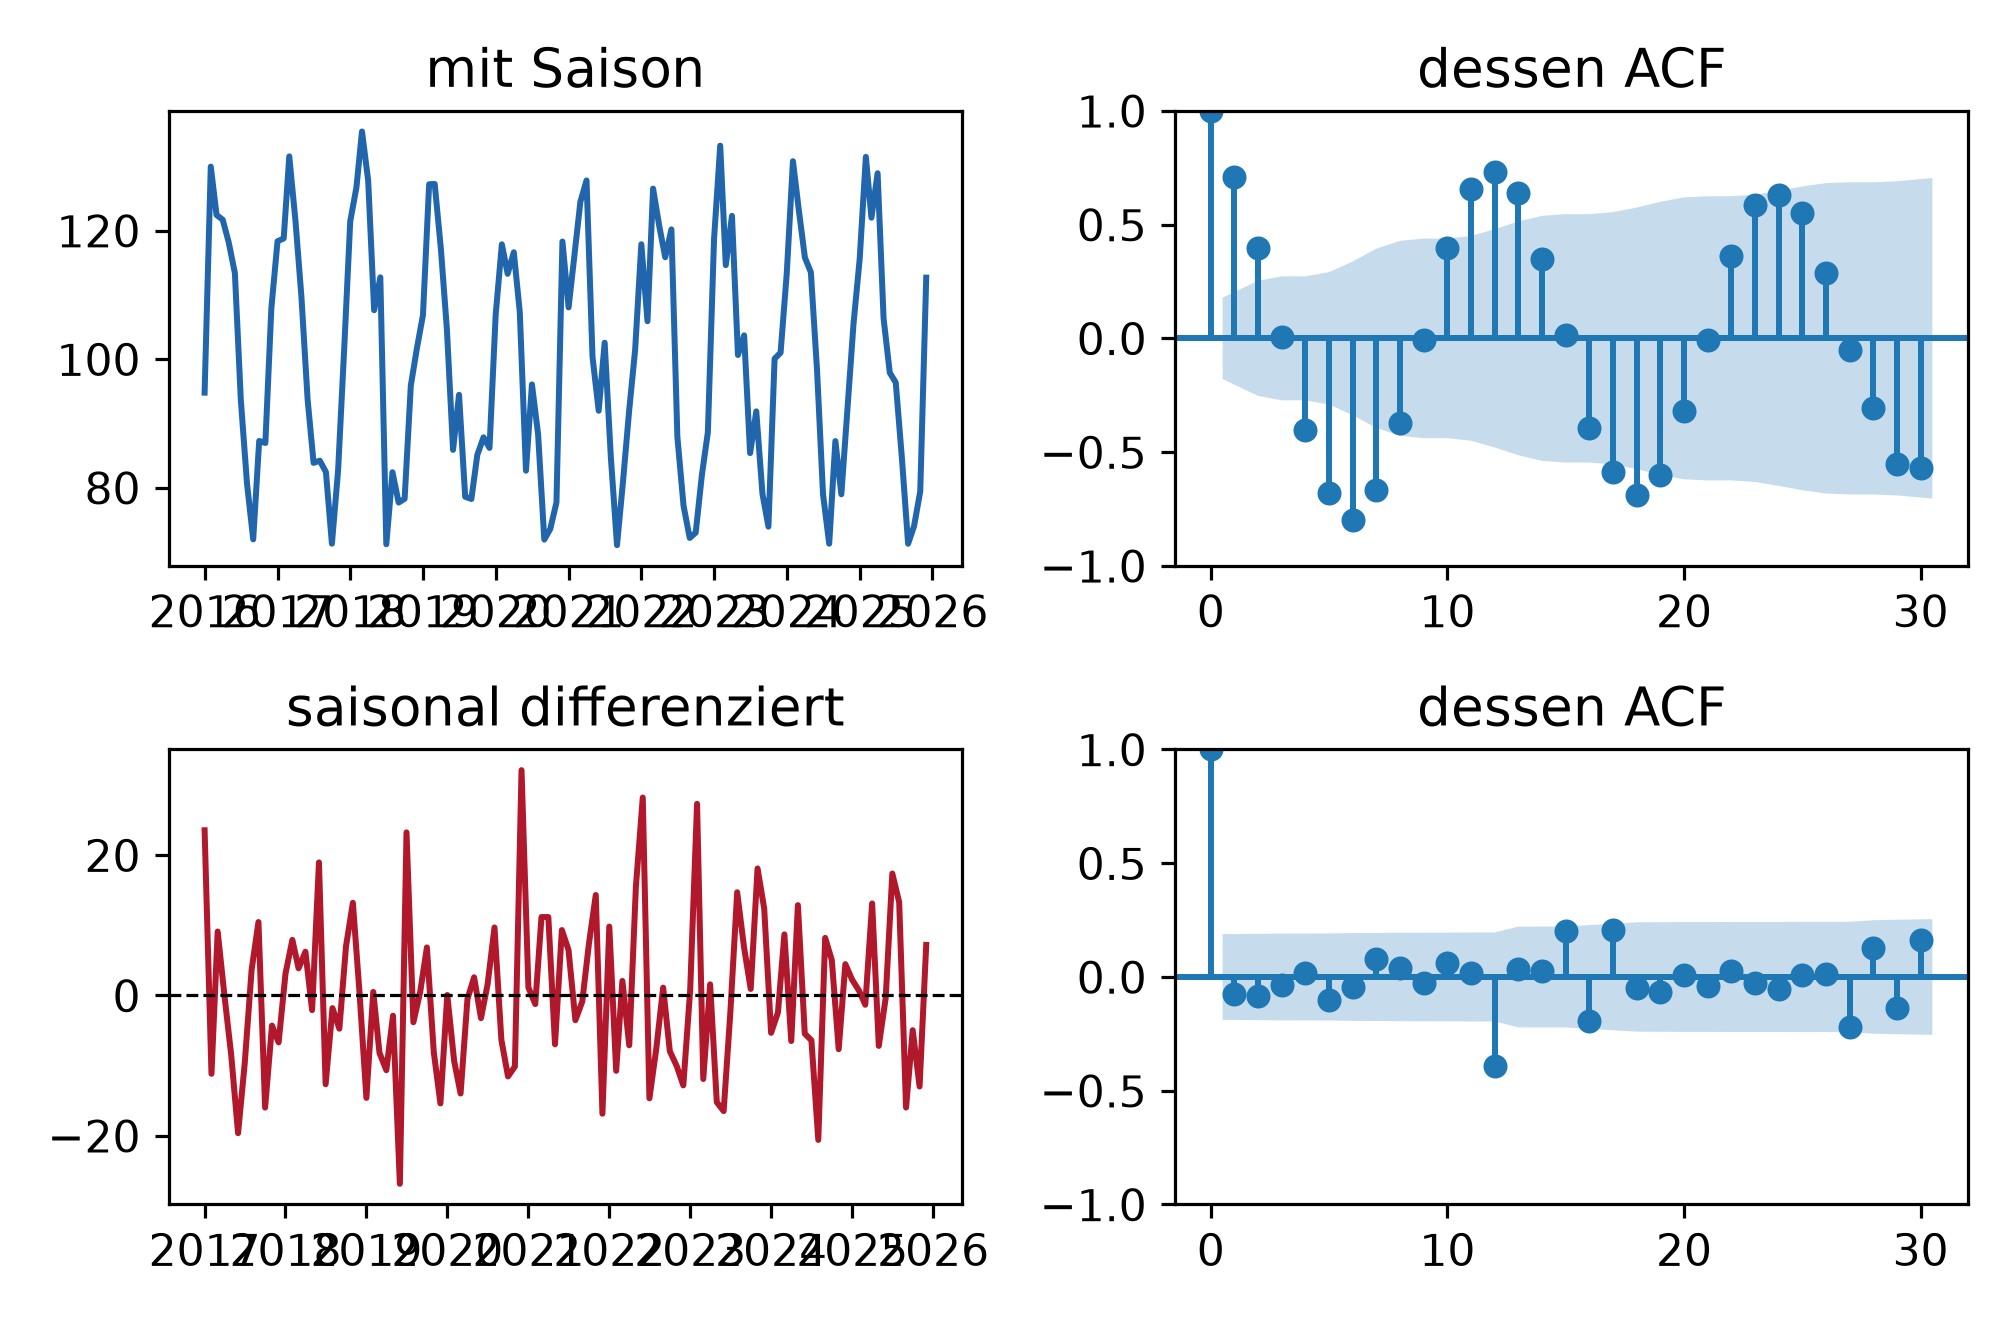
ACF schwingt: positiv bei k=1, durch null bei k=3, stark negativ bei k=6, wieder positiv bei k=12 (0.729) und k=24 (0.629)
Die Wellenform mit Spitzen bei Vielfachen der Periode ist die Signatur der Saison.
Zufallspfad
ACF fällt noch langsamer ab (0.958 bei k=1); PACF hat nur bei k=1 einen grossen Wert
Optisch fast identisch mit dem deterministischen Trend, der Unterschied wird erst in Beispiel 3 sichtbar.
Die Reihen mit Trend und der Zufallspfad sehen in ACF und PACF praktisch gleich aus. Beide zeigen eine langsam abfallende ACF und eine PACF mit einem einzigen grossen Wert bei k=1. Kein Korrelogramm der Welt unterscheidet die beiden. Das ist kein Mangel der Grafik, sondern eine echte Schwierigkeit und der Grund, warum Beispiel 3 nötig ist.
Interpretation
Die Korrelogramme beantworten zuverlässig die Frage “ist die Reihe stationär” und zeigen die Periodenlänge der Saison. Die Frage “welche Art von Trend” können sie nicht beantworten.
Frage und Datenlage
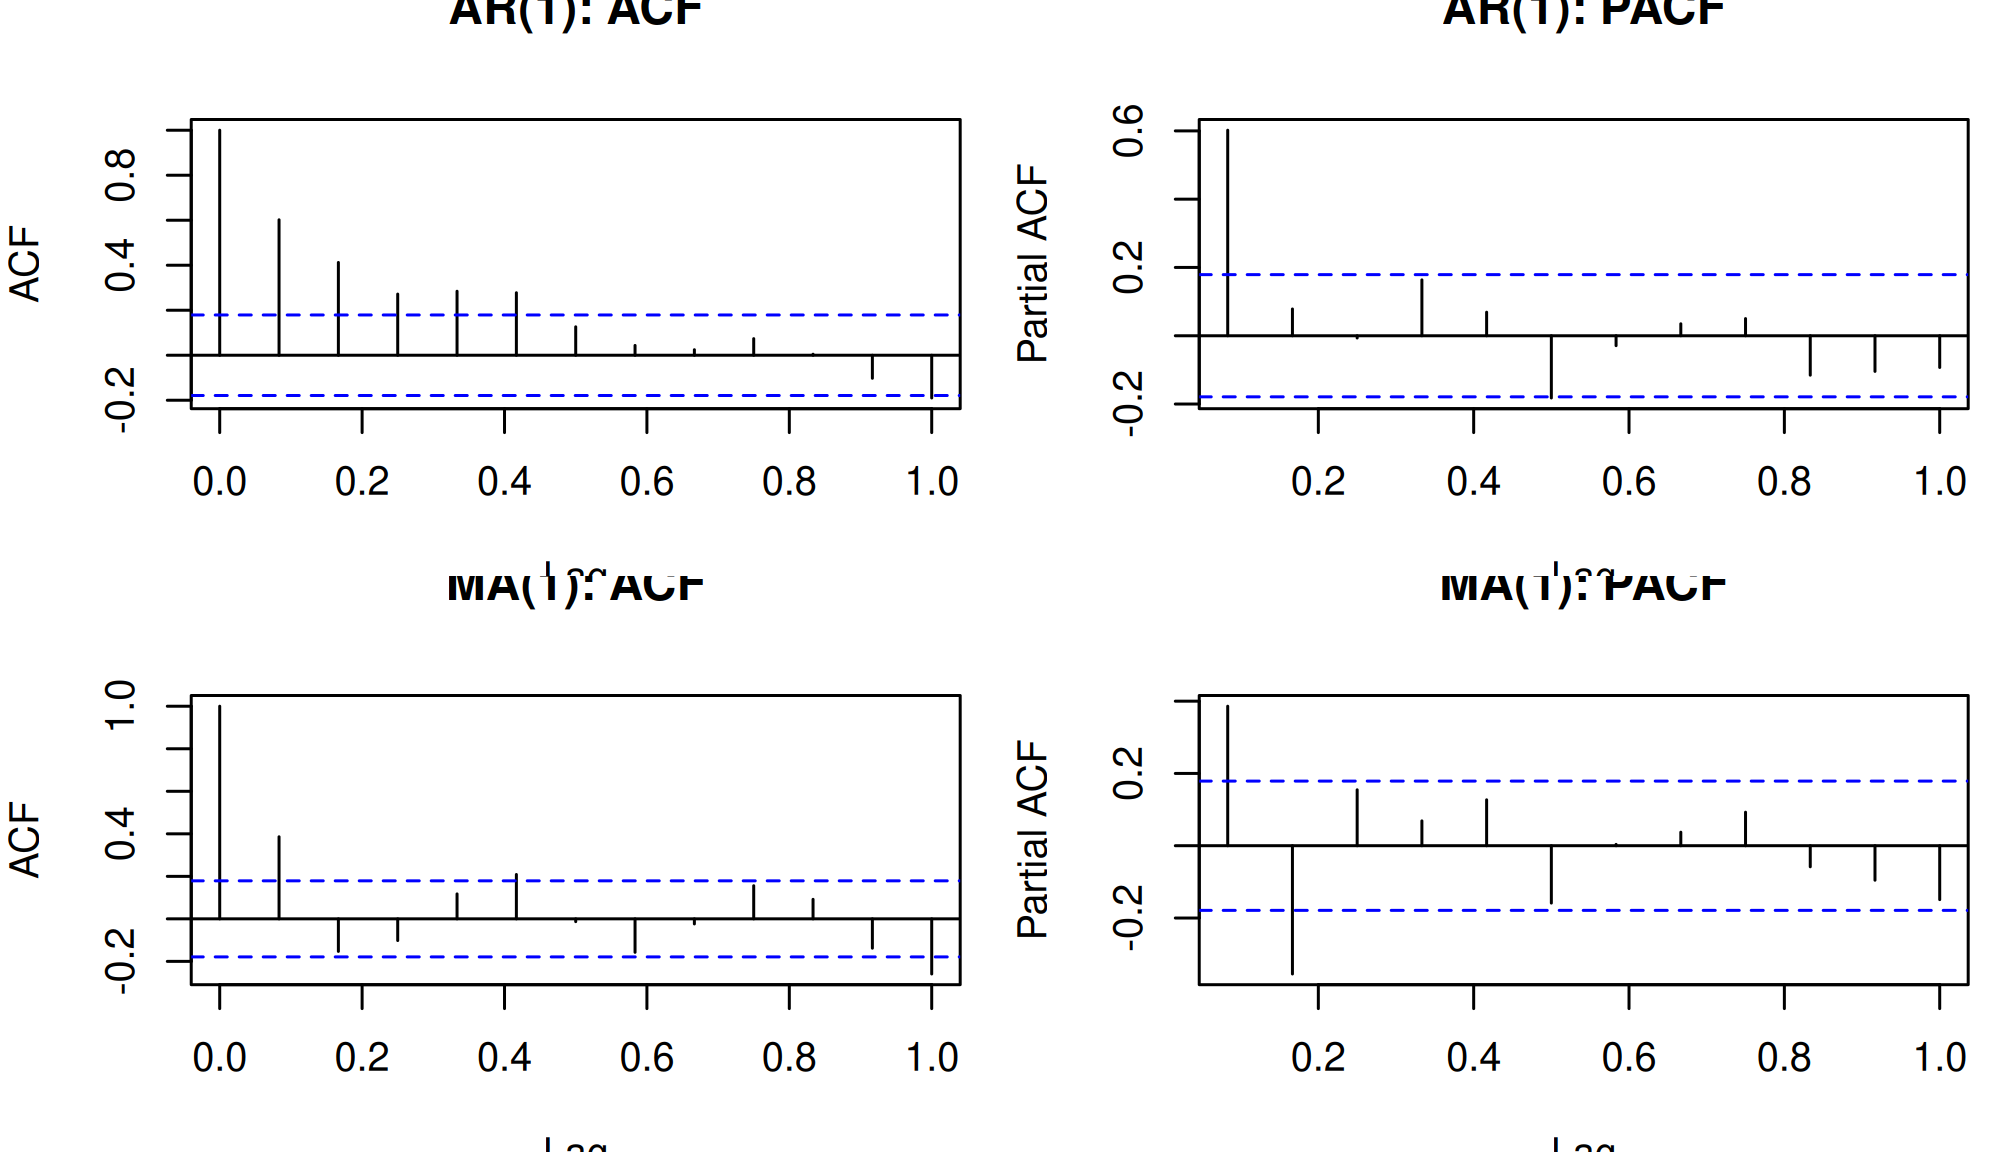
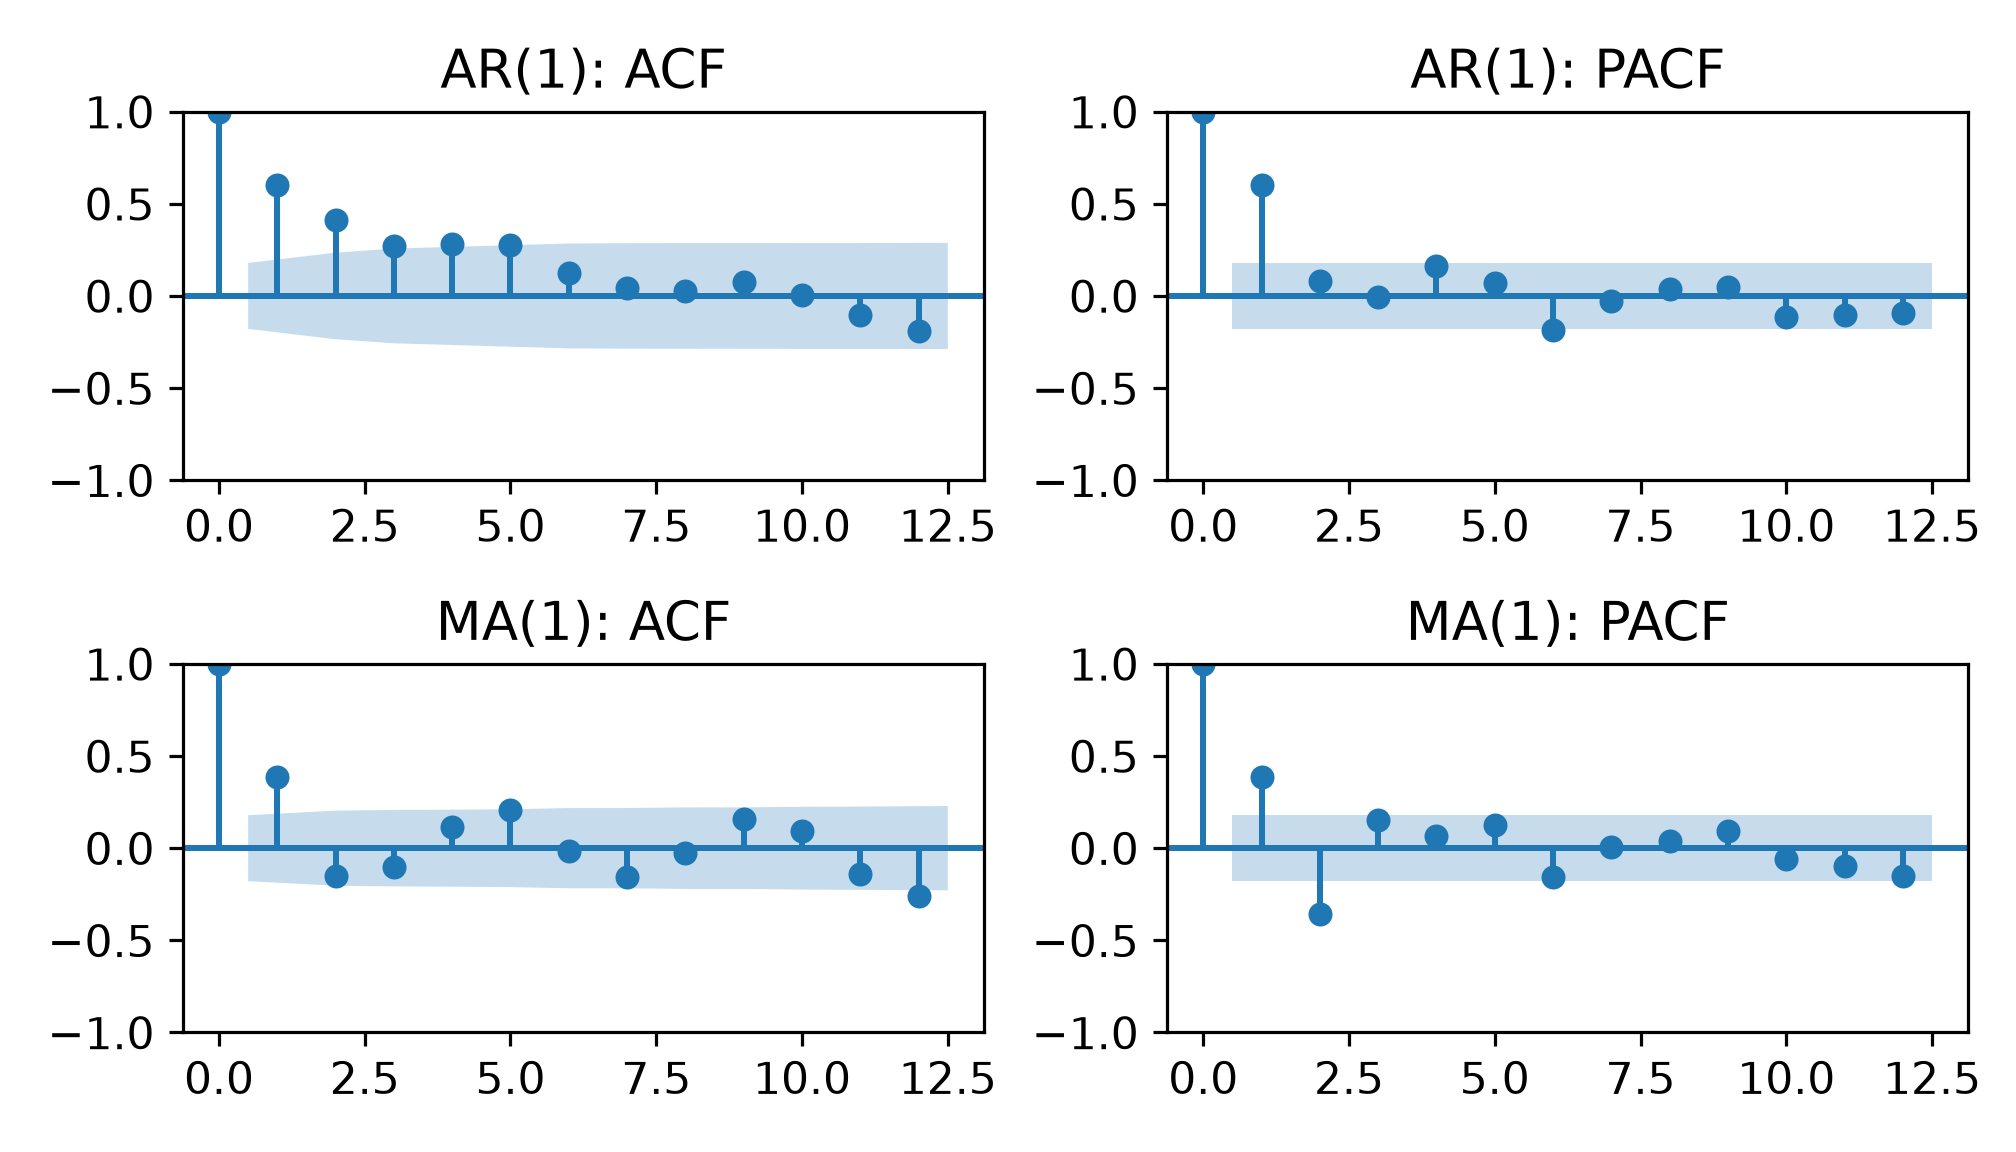
Der eigentliche Zweck von ACF und PACF ist die Wahl der Modellordnung. Dafür gibt es zwei Signaturen, die man auswendig kennen sollte. Verglichen werden ein AR(1)-Prozess (\(y_t = 0.7\, y_{t-1} + \varepsilon_t\)) und ein MA(1)-Prozess (\(y_t = \varepsilon_t + 0.8\, \varepsilon_{t-1}\)), beide aus demselben Rauschen erzeugt.
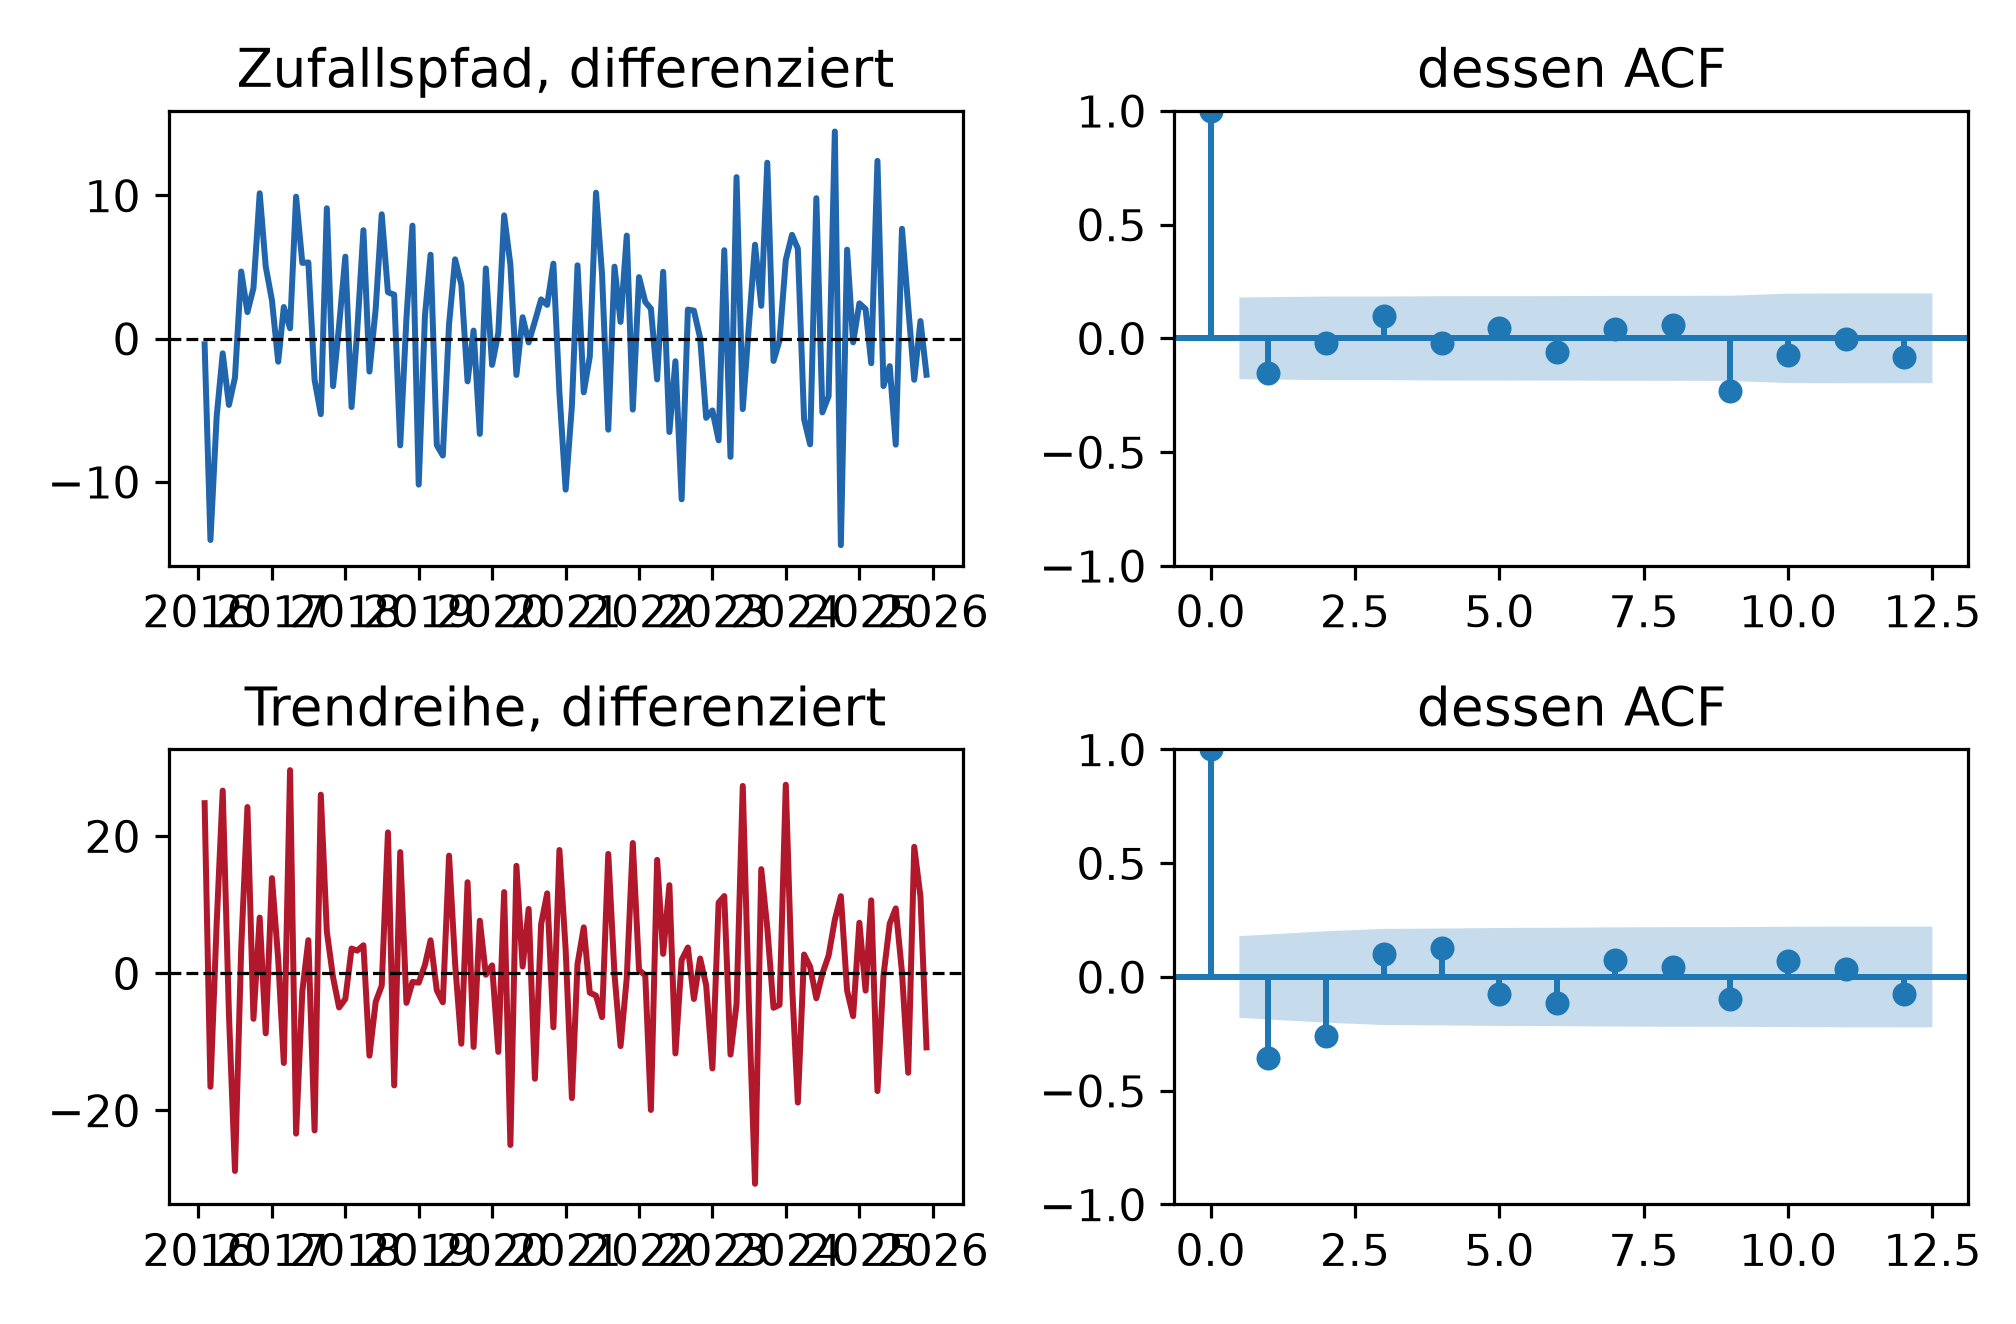
Abbildung 4: Beispiel 2: dieselben vier Korrelogramme in Python.
for name, reihe in [("ar1", ar1), ("ma1", ma1)]: a = acf(reihe, nlags=5)[1:6] p = pacf(reihe, nlags=5, method="ywm")[1:6]print(f"{name:5s} ACF "+" ".join(f"{w:6.3f}"for w in a))print(f"{'':5s} PACF "+" ".join(f"{w:6.3f}"for w in p))
Der Einfluss läuft über die Kette weiter: Heute wirkt auf morgen, morgen auf übermorgen. Deshalb ist auch bei Abstand 2 noch etwas messbar, obwohl keine direkte Verbindung besteht.
AR(1): PACF bricht nach k=1 ab (0.602, dann 0.078 und -0.007)
Die direkte Abhängigkeit besteht nur zum Vormonat. Genau das ist die Signatur.
MA(1): ACF bricht nach k=1 ab (0.386, dann -0.153 und -0.102, beide innerhalb ±0.179)
Ein MA(1)-Prozess teilt mit dem Vormonat eine Störung, mit dem Vorvormonat keine.
MA(1): PACF fällt allmählich mit wechselndem Vorzeichen (0.386, -0.355, 0.155)
Die Schätzungen treffen die eingebauten Werte nicht genau. Theoretisch müsste die ACF des AR(1) bei k=1 genau 0.7 betragen, gemessen werden 0.602; beim MA(1) wären \(0.8/(1+0.8^2) = 0.488\) zu erwarten, gemessen 0.386. Bei 120 Werten ist der Standardfehler einer Autokorrelation etwa 0.09, die Abweichungen liegen in dieser Grössenordnung.
Praktisch heisst das: Aus einem Korrelogramm liest man Muster, nicht Parameterwerte. Die Ordnung ist ablesbar, der Koeffizient wird geschätzt.
Interpretation und Ergebnissatz
Die PACF bricht nach dem ersten Abstand ab (0.60, danach innerhalb der Konfidenzgrenzen), während die ACF allmählich abfällt. Das spricht für ein AR(1)-Modell.
Frage und Datenlage
Zwei Reihen, die im Bild fast gleich aussehen: der Zufallspfad und die Reihe mit deterministischem Trend aus Beispiel 1. Beide sind nicht stationär. Werden sie gleich behandelt?
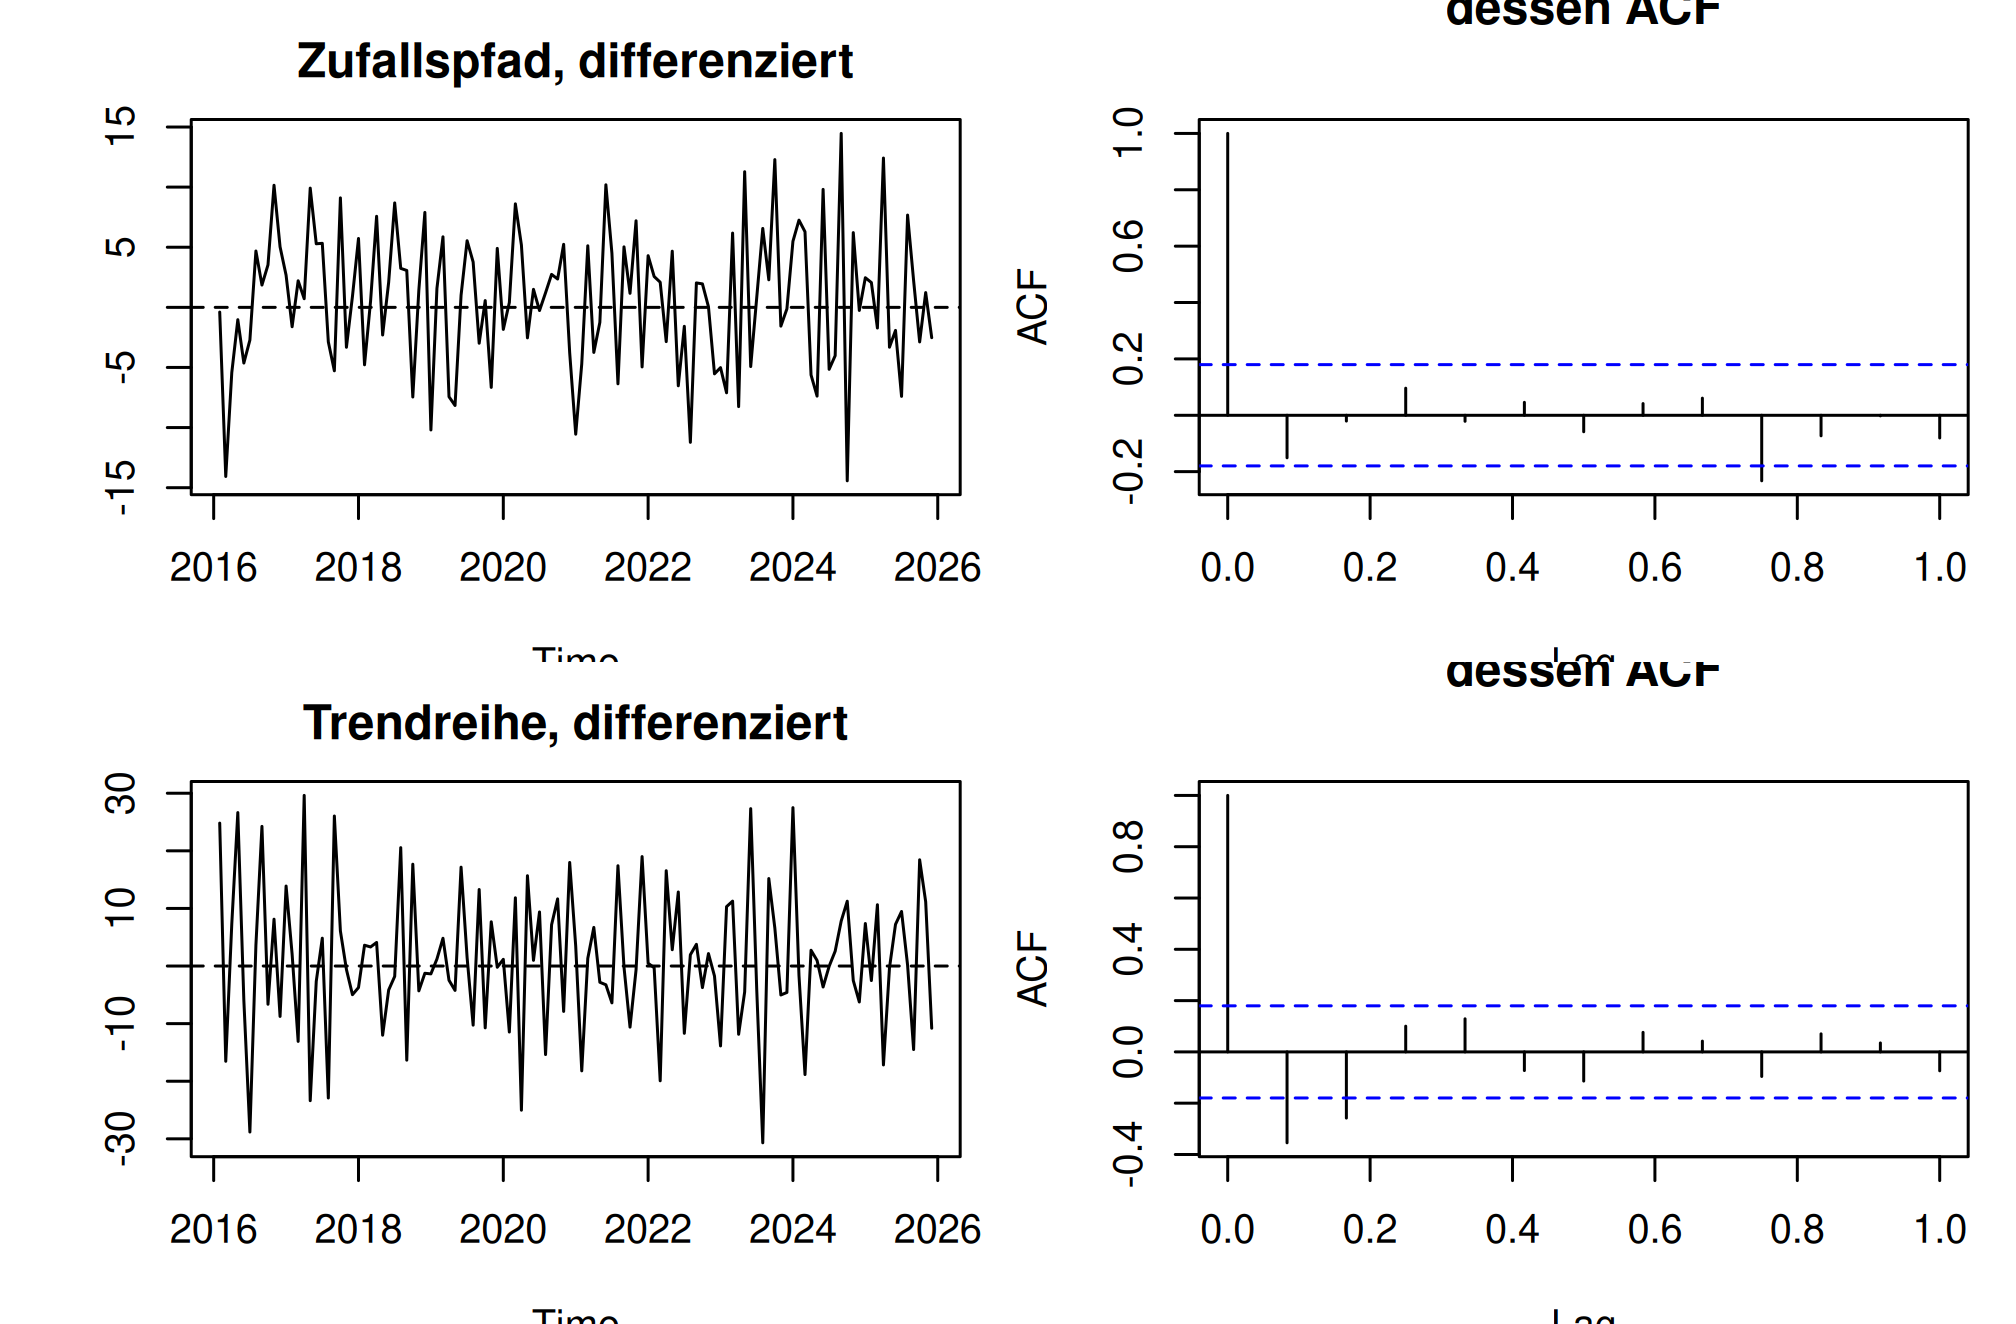
richtig: Streuung stark gesunken, ACF(1) innerhalb ±0.179, weisses Rauschen
Trendreihe, roh
29.75
0.876
nicht stationär
Trendreihe, differenziert
12.35
-0.354
überdifferenziert: ACF(1) deutlich negativ
Trendreihe, detrendet
9.28
0.099
richtig: kleinste Streuung, ACF(1) unauffällig
Trendreihe, zweimal differenziert
20.25
-0.518
doppelt überdifferenziert
Beobachtung
Erklärung
Der Zufallspfad wird durch eine Differenz zu weissem Rauschen
Er ist ja die kumulierte Summe von Rauschen; das Differenzieren macht sie wieder rückgängig. Die Streuung fällt von 26.5 auf 5.8.
Die Trendreihe wird durch Differenzieren schlechter
Ihre Störung ist bereits weisses Rauschen mit Streuung 10. Differenzieren erzeugt daraus \(\varepsilon_t - \varepsilon_{t-1}\), einen MA(1)-Prozess mit theoretischer ACF(1) von -0.5, gemessen -0.354. Die Streuung steigt von 9.3 (nach Detrending) auf 12.3, also um den Faktor \(\sqrt{2}\).
Detrending trifft es
Nach Herausrechnen der Geraden bleibt Streuung 9.28 und ACF(1) = 0.099, die eingebaute Störung, sauber zurückgewonnen.
Zweimal differenziert: ACF(1) = -0.518
Es wird noch schlimmer. Jede unnötige Differenz erzeugt zusätzliche negative Abhängigkeit, die das Modell dann mit MA-Termen wieder reparieren muss.
Die praktische Faustregel, weil man in echten Daten nicht weiss, welcher Trend vorliegt:
Streuung vor und nach dem Differenzieren vergleichen. Steigt sie, war es eine Differenz zu viel.
ACF(1) der differenzierten Reihe ansehen. Ein Wert nahe -0.5 ist das Kennzeichen der Überdifferenzierung.
Was beide Fälle unterscheidet, ist auch inhaltlich verschieden: Eine trendstationäre Reihe kehrt nach einer Störung zur Geraden zurück, ein Zufallspfad nicht. Wer eine Prognose über mehrere Perioden braucht, sollte das nicht dem Zufall überlassen, die Vorhersageintervalle unterscheiden sich drastisch.
Interpretation und Ergebnissatz
Der Zufallspfad wird durch eine einfache Differenz stationär (Streuung von 26.5 auf 5.8, ACF(1) = -0.15). Bei der Reihe mit deterministischem Trend führt dasselbe Vorgehen zur Überdifferenzierung (ACF(1) = -0.35, Streuung steigt von 9.3 auf 12.3); dort wird der Trend stattdessen durch eine Regression gegen die Zeit entfernt.
Frage und Datenlage
Zwei Tests mit entgegengesetzten Nullhypothesen, angewendet auf sechs Reihen. Die Frage: Was sagen sie, und wo hilft ihre Kombination?
kandidaten <-list("weisses Rauschen"= weiss,"mit Trend"= mit_trend,"Trend differenziert"=diff(mit_trend),"mit Saison"= mit_saison,"Saison saisonal diff"=diff(mit_saison, lag =12),"Zufallspfad"= zufallspfad,"Zufallspfad diff"=diff(zufallspfad))for (name innames(kandidaten)) { reihe <- kandidaten[[name]] adf <-suppressWarnings(adf.test(reihe)) kp <-suppressWarnings(kpss.test(reihe))cat(sprintf("%-22s ADF p = %.3f | KPSS p = %.3f\n", name, adf$p.value, kp$p.value))}
weisses Rauschen       ADF p = 0.010 | KPSS p = 0.100
mit Trend              ADF p = 0.010 | KPSS p = 0.010
Trend differenziert    ADF p = 0.010 | KPSS p = 0.100
mit Saison             ADF p = 0.010 | KPSS p = 0.100
Saison saisonal diff   ADF p = 0.010 | KPSS p = 0.100
Zufallspfad            ADF p = 0.199 | KPSS p = 0.010
Zufallspfad diff       ADF p = 0.010 | KPSS p = 0.100
kandidaten = {"weisses Rauschen": weiss,"mit Trend": mit_trend,"Trend differenziert": mit_trend.diff().dropna(),"mit Saison": mit_saison,"Saison saisonal diff": mit_saison.diff(12).dropna(),"Zufallspfad": zufallspfad,"Zufallspfad diff": zufallspfad.diff().dropna(),}for name, reihe in kandidaten.items():print(f"{name:22s} ADF p = {adfuller(reihe)[1]:.3f}"f" | KPSS p = {kpss(reihe, nlags='auto')[1]:.3f}")
weisses Rauschen       ADF p = 0.000 | KPSS p = 0.100
mit Trend              ADF p = 0.939 | KPSS p = 0.010
Trend differenziert    ADF p = 0.000 | KPSS p = 0.100
mit Saison             ADF p = 0.000 | KPSS p = 0.100
Saison saisonal diff   ADF p = 0.001 | KPSS p = 0.100
Zufallspfad            ADF p = 0.713 | KPSS p = 0.010
Zufallspfad diff       ADF p = 0.000 | KPSS p = 0.100
Output Zeile für Zeile
Reihe
ADF p, R
ADF p, Python
KPSS p
Urteil
weisses Rauschen
0.010
0.000
0.100
stationär, alle einig
mit Trend
0.010
0.939
0.010
hier widersprechen sich R und Python
Trend differenziert
0.010
0.000
0.100
stationär (aber überdifferenziert, siehe Beispiel 3)
mit Saison
0.010
0.000
0.100
stationär und das ist irreführend
Saison saisonal diff
0.010
0.001
0.100
stationär
Zufallspfad
0.199
0.713
0.010
nicht stationär, alle einig
Zufallspfad diff
0.010
0.000
0.100
stationär
Ausgabe
Wie sie zu lesen ist
kleines ADF p heisst stationär
Es verwirft die Nullhypothese “Einheitswurzel”.
grosses KPSS p heisst stationär
Es kann die Nullhypothese “stationär” nicht verwerfen. Umgekehrte Richtung.
Die Werte 0.100 und 0.010 wiederholen sich
Das sind die Ränder der Tabellen, aus denen beide Tests ihre p-Werte interpolieren. “0.010” heisst “höchstens 0.01”, “0.100” heisst “mindestens 0.1”. Die Programme geben dazu eine Warnung aus. R kappt auch die ADF-Werte an diesen Grenzen, weshalb dort so oft genau 0.010 steht.
Die Reihe mit Trend: R sagt stationär, Python nicht
Kein Fehler, sondern ein Unterschied in der Voreinstellung. adf.test() in R nimmt eine Regression mit Trendterm, es prüft also auf Trendstationarität und findet sie hier korrekt. adfuller() in Python nimmt voreingestellt nur eine Konstante (regression="c") und sieht den Trend als Nichtstationarität. Mit regression="ct" stimmen beide überein. Wer den Test berichtet, nennt die Regressionsvariante dazu.
Die Saisonreihe gilt allen Tests als stationär
Und formal haben sie recht: Eine rein saisonale Reihe hat konstanten Mittelwert über ganze Perioden und keine Einheitswurzel. Für die Modellierung ist sie trotzdem nicht brauchbar, die Saison muss weg.
Die wichtigste Lehre dieses Beispiels steht in der Zeile “mit Saison”: Beide Tests melden Stationarität, und die ACF aus Beispiel 1 zeigt eine unübersehbare Saisonstruktur mit Spitzen bei 12 und 24.
Die Tests prüfen nur die Einheitswurzel, also den stochastischen Trend. Sie sagen nichts über Saison, nichts über wachsende Streuung und nichts darüber, ob man richtig differenziert hat. Deshalb gilt die Rangfolge:
Die Grafik entscheidet, der Test bestätigt.
Zwei weitere Einschränkungen: Der ADF-Test hat bei kurzen Reihen wenig Schärfe und findet eine Einheitswurzel dann nicht, obwohl sie vorliegt. Und die Zeile “mit Trend” zeigt, wie stark das Ergebnis an den Voreinstellungen hängt, ein weiterer Grund, dem Bild mehr zu trauen als dem p-Wert.
Interpretation und Ergebnissatz
Die Reihe ist nicht stationär (ADF p = 0.20 in R beziehungsweise 0.71 in Python, KPSS p = 0.01). Nach einfacher Differenzenbildung sprechen beide Tests für Stationarität (ADF p < .001, KPSS p > 0.1), und die ACF der differenzierten Reihe zeigt keine Autokorrelation ausserhalb der Konfidenzgrenzen.
Frage und Datenlage
Die Saisonreihe aus Beispiel 1 besteht die Stationaritätstests, ist aber offensichtlich nicht brauchbar. Was leistet saisonales Differenzieren, \(y_t - y_{t-12}\)?
Der Monat und derselbe Monat im Vorjahr sind stark korreliert. Bei k=24 noch 0.629, die Saison hört nicht auf.
ACF(6) vorher: -0.800
Der Gegenmonat: Wo im Sommer ein Hoch ist, ist im Winter ein Tief.
ACF(12) nachher: -0.390
Vom starken positiven Wert bleibt ein deutlich negativer übrig. Das ist kein Fehler, sondern die bekannte Nebenwirkung: Saisonales Differenzieren erzeugt eine saisonale MA-Struktur, genau wie einfaches Differenzieren eine gewöhnliche. Sie wird in einem SARIMA-Modell durch einen Term \(Q = 1\) abgebildet.
ACF(1) nachher: -0.076
Innerhalb der Konfidenzgrenzen. Auf der kurzen Zeitskala ist nichts mehr übrig.
Streuung 18.70 → 11.28
Deutlich gesunken; das saisonale Differenzieren war also angebracht.
verlorene Werte
12
Die ersten zwölf Monate haben keinen Vorjahreswert. Bei einer kurzen Reihe ist das ein spürbarer Preis.
Die Reihenfolge, wenn beides nötig ist: Zuerst saisonal differenzieren, dann prüfen, ob noch eine gewöhnliche Differenz nötig ist. Oft erledigt das saisonale Differenzieren den Trend gleich mit, denn \(y_t - y_{t-12}\) entfernt auch einen linearen Trend bis auf eine Konstante.
Und die Warnung: Zwei Differenzen kosten 13 Beobachtungen und erzeugen zwei MA-Strukturen. Im Zweifel eine weniger.
Interpretation und Ergebnissatz
Die Reihe zeigt eine ausgeprägte Jahressaison (ACF bei k=12 gleich 0.73, bei k=24 gleich 0.63). Nach saisonalem Differenzieren mit Abstand 12 sinkt die Streuung von 18.7 auf 11.3, und ausserhalb der Konfidenzgrenzen bleibt nur der Wert bei k=12 von -0.39, der auf einen saisonalen MA-Term hinweist.
Verständnisfragen
Die ACF einer Reihe fällt über zwanzig Abstände hinweg nur langsam ab. Was ist zu tun?
Die Reihe ist nicht stationär; Trend entfernen
Richtig. Eine langsam abfallende ACF ist das klassische Zeichen. Ob differenziert oder detrendet wird, entscheidet sich danach, die ACF unterscheidet die beiden Trendarten nicht.
Ein Modell mit hoher Ordnung anpassen
Damit modelliert man den Trend mit vielen Parametern statt ihn zu entfernen.
Nichts, langsames Abfallen ist normal
Bei stationären Reihen fällt die ACF schnell ab.
Der ADF-Test ergibt p = 0.42. Was folgt?
Die Reihe ist stationär, der p-Wert ist gross
Die Richtung ist vertauscht: Beim ADF-Test lautet die Nullhypothese Nichtstationarität.
Nichtstationarität kann nicht verworfen werden
Richtig. Ein grosser p-Wert heisst hier: kein Beleg für Stationarität. Zusammen mit einer langsam abfallenden ACF spricht das für Differenzieren.
Der Test ist ungültig
Er ist gültig, nur schwach bei kurzen Reihen.
Nach dem Differenzieren steigt die Streuung von 9.3 auf 12.3 und die ACF beim ersten Abstand beträgt -0.35. Was heisst das?
Es wurde überdifferenziert
Richtig. Beide Zeichen zusammen sind das Kennzeichen: Differenzieren einer bereits stationären Reihe erzeugt eine künstliche MA(1)-Struktur mit einer ACF(1) nahe -0.5 und vergrössert die Streuung um etwa den Faktor Wurzel zwei.
Es muss ein zweites Mal differenziert werden
Das verschärft das Problem; im Beispiel sinkt die ACF(1) dann auf -0.52.
Die Reihe enthält einen Ausreisser
Möglich, erklärt aber nicht die systematisch negative Autokorrelation.
Die PACF bricht nach dem zweiten Abstand ab, die ACF fällt allmählich. Welches Modell?
AR(2)
Richtig. Eine abbrechende PACF bei \(k = p\) mit allmählich fallender ACF ist die Signatur eines AR(\(p\))-Prozesses; die Ordnung wird aus der PACF abgelesen.
MA(2)
Dort wäre es umgekehrt: Die ACF bricht ab, die PACF fällt allmählich.
ARMA(2,2)
Bei einem gemischten Prozess fallen beide allmählich ab und die Ordnung ist aus den Korrelogrammen nicht ablesbar.
ADF und KPSS melden für eine Reihe mit deutlicher Jahressaison beide Stationarität. Was folgt?
Die Tests prüfen nur die Einheitswurzel, nicht die Saison
Richtig. Formal haben sie recht, die Reihe hat konstanten Mittelwert über ganze Perioden. Für die Modellierung muss die Saison trotzdem weg, sichtbar wird sie in der ACF an den Spitzen bei Vielfachen der Periode.
Die Reihe ist damit modellierbar
Die Saisonstruktur ist unbehandelt.
Einer der beiden Tests muss falsch gerechnet sein
Beide sind korrekt und beantworten eine andere Frage als die gestellte.