Kombinatorik und Wahrscheinlichkeit

Wahrscheinlichkeit
R
Python
Zählprinzipien, Laplace-Wahrscheinlichkeit und die Rechenregeln.

Kernideen

  • Kombinatorik ist kein Selbstzweck, sondern die Rechenmaschine hinter dem Nenner.
  • Statt vier Formeln genügen zwei Fragen: wird zurückgelegt, und zählt die Reihenfolge?
  • Drei Zugänge zum Wahrscheinlichkeitsbegriff, Laplace, statistisch, axiomatisch, beantworten verschiedene Fragen und widersprechen einander nicht.
  • Der Additionssatz gilt in der einfachen Form nur für disjunkte Ereignisse.
  • Aufgaben mit “mindestens ein” rechnet man über das Gegenereignis.
  • Der Spielerfehlschluss: Der Anteil pendelt sich ein, weil frühe Abweichungen an Gewicht verlieren, nicht, weil sie ausgeglichen würden.

Erklärung

Vorwissen: Häufigkeiten für den Begriff der relativen Häufigkeit. Alles Weitere wird hier aufgebaut. Diese Seite ist der Übergang von der beschreibenden zur schliessenden Statistik.

Warum Abzählen der Anfang ist

Die Frage, wie wahrscheinlich etwas ist, lässt sich in einfachen Fällen durch Zählen beantworten: Wie viele Ergebnisse gibt es insgesamt, und wie viele davon sind die gesuchten? Beim Würfel sind es sechs und eines. Bei sechs Richtigen im Lotto sind es rund vierzehn Millionen und eines, und diese Zahl will berechnet und nicht abgezählt werden.

Die zwei Fragen vor jeder Formel

  1. Wird zurückgelegt? Kann dasselbe Element mehrfach gewählt werden?
  2. Spielt die Reihenfolge eine Rolle? Ist ABC etwas anderes als CBA?

Aus den Antworten ergeben sich die vier Standardfälle. Gezogen werden \(k\) aus \(n\) Elementen:

Zurücklegen Reihenfolge Anzahl Beispiel
ja ja \(n^k\) dreistelliger Zahlencode
nein ja \(\frac{n!}{(n-k)!}\) Podestplätze bei einem Rennen
nein nein \(\binom{n}{k} = \frac{n!}{k!\,(n-k)!}\) Lottozahlen
ja nein \(\binom{n+k-1}{k}\) Kugeln aus einer Urne, nur die Anzahl je Farbe zählt

Die dritte Zeile folgt aus der zweiten, und das erklärt, woher der Binomialkoeffizient kommt: Zieht man drei aus zehn mit Beachtung der Reihenfolge, gibt es \(10 \cdot 9 \cdot 8 = 720\) Möglichkeiten. Interessiert die Reihenfolge nicht, ist jede Auswahl dabei \(3! = 6\) mal gezählt worden, einmal je Anordnung. Also bleiben \(720 / 6 = 120\).

Drei Zugänge zum Wahrscheinlichkeitsbegriff

Zugang Wahrscheinlichkeit ist Setzt voraus Versagt bei
Laplace günstige durch mögliche Fälle alle Elementarereignisse gleich wahrscheinlich fehlender Symmetrie, etwa einem Maschinenausfall
statistisch Grenzwert der relativen Häufigkeit Wiederholbarkeit unter gleichen Bedingungen einmaligen Ereignissen
axiomatisch (Kolmogorow) eine Funktion mit drei Eigenschaften nichts , sagt dafür auch nicht, woher die Zahlen kommen

Die drei Axiome von Kolmogorow:

  1. \(P(A) \ge 0\) für jedes Ereignis
  2. \(P(\Omega) = 1\) für das sichere Ereignis
  3. \(P(A \cup B) = P(A) + P(B)\) für disjunkte Ereignisse

Alles Weitere, der Additionssatz, das Gegenereignis, die bedingte Wahrscheinlichkeit, folgt daraus.

Additionssatz und Gegenereignis

Der Additionssatz gilt in seiner einfachen Form nur für disjunkte Ereignisse. Überschneiden sie sich, wird der gemeinsame Teil zweimal gezählt und muss abgezogen werden:

\[P(A \cup B) = P(A) + P(B) - P(A \cap B)\]

Das Gegenereignis ist der zweite Griff. Aufgaben mit “mindestens ein” lassen sich fast immer leichter über “keiner” rechnen, weil dort nur ein einziges Produkt entsteht statt einer Summe vieler Fälle:

\[P(\text{mindestens eine Sechs}) = 1 - P(\text{keine Sechs}) = 1 - \left(\tfrac{5}{6}\right)^n\]

Beispiele

Frage und Datenlage

Zehn Elemente, drei werden gezogen. Vier Fragen, vier Zahlen und derselbe Ausgangspunkt.

Rechnung

n <- 10; k <- 3

round(c(
  mit_zuruecklegen_mit_anordnung = n^k,
  ohne_zuruecklegen_mit_anordnung = factorial(n) / factorial(n - k),
  ohne_zuruecklegen_ohne_anordnung = choose(n, k),
  mit_zuruecklegen_ohne_anordnung = choose(n + k - 1, k)
), 0)
  mit_zuruecklegen_mit_anordnung  ohne_zuruecklegen_mit_anordnung 
                            1000                              720 
ohne_zuruecklegen_ohne_anordnung  mit_zuruecklegen_ohne_anordnung 
                             120                              220 
# Die Herleitung des Binomialkoeffizienten, Schritt fuer Schritt
c(mit_anordnung = 10 * 9 * 8,
  anordnungen_je_auswahl = factorial(3),
  ohne_anordnung = 10 * 9 * 8 / factorial(3))
         mit_anordnung anordnungen_je_auswahl         ohne_anordnung 
                   720                      6                    120 
# Und die Grossenordnung im Lotto
c(sechs_aus_49 = choose(49, 6),
  wahrscheinlichkeit = 1 / choose(49, 6))
      sechs_aus_49 wahrscheinlichkeit 
      1.398382e+07       7.151124e-08 
n, k = 10, 3

print({"mit_zuruecklegen_mit_anordnung": n ** k,
       "ohne_zuruecklegen_mit_anordnung": math.perm(n, k),
       "ohne_zuruecklegen_ohne_anordnung": math.comb(n, k),
       "mit_zuruecklegen_ohne_anordnung": math.comb(n + k - 1, k)})
{'mit_zuruecklegen_mit_anordnung': 1000, 'ohne_zuruecklegen_mit_anordnung': 720, 'ohne_zuruecklegen_ohne_anordnung': 120, 'mit_zuruecklegen_ohne_anordnung': 220}
print({"mit_anordnung": 10 * 9 * 8,
       "anordnungen_je_auswahl": math.factorial(3),
       "ohne_anordnung": 10 * 9 * 8 // math.factorial(3)})
{'mit_anordnung': 720, 'anordnungen_je_auswahl': 6, 'ohne_anordnung': 120}
print({"sechs_aus_49": math.comb(49, 6),
       "wahrscheinlichkeit": 1 / math.comb(49, 6)})
{'sechs_aus_49': 13983816, 'wahrscheinlichkeit': 7.151123842018516e-08}

Output Zeile für Zeile

Zurücklegen Reihenfolge Formel Ergebnis Sachbeispiel
ja ja \(10^3\) 1 000 dreistelliger Zahlencode
nein ja \(10 \cdot 9 \cdot 8\) 720 Gold, Silber, Bronze aus zehn Läufern
nein nein \(\binom{10}{3}\) 120 eine dreiköpfige Arbeitsgruppe
ja nein \(\binom{12}{3}\) 220 drei Kugeln aus zehn Farben, nur die Anzahl je Farbe zählt
Beobachtung Erklärung
Die Zahlen fallen von 1 000 auf 120 Jede Einschränkung verkleinert den Ergebnisraum: kein Zurücklegen streicht Wiederholungen, keine Reihenfolge fasst Anordnungen zusammen.
\(720 / 6 = 120\) Die Herleitung in einer Zeile. Jede Dreierauswahl wurde \(3! = 6\) mal gezählt, einmal je Anordnung. So entsteht der Binomialkoeffizient.
Der vierte Fall ist der einzige, bei dem die Zahl steigt 220 gegen 120. Mit Zurücklegen kommen die Fälle “dreimal dieselbe Farbe” und “zweimal eine, einmal eine andere” dazu. Die Formel \(\binom{n+k-1}{k}\) wirkt willkürlich, ist aber der bekannte Trick mit \(k\) Kugeln und \(n-1\) Trennstrichen.
Sechs aus 49 13 983 816

Warum sich die zwei Fragen besser merken lassen als vier Formeln: Sie führen auch dann zum Ziel, wenn die Aufgabe nicht nach Lehrbuch aussieht.

Aufgabe Zurücklegen? Reihenfolge?
PIN mit vier Ziffern ja ja
Sitzordnung von acht Gästen nein ja
Auswahl von drei aus zwölf Bewerbungen nein nein
Wie viele Eissorten-Kombinationen bei drei Kugeln aus acht Sorten? ja nein

Die letzte Zeile ist die, bei der die meisten hängenbleiben und die einzige, bei der man die vierte Formel überhaupt braucht.

Interpretation

Die Kombinatorik liefert den Nenner der Laplace-Wahrscheinlichkeit. Alles Weitere ist Division.

Frage und Datenlage

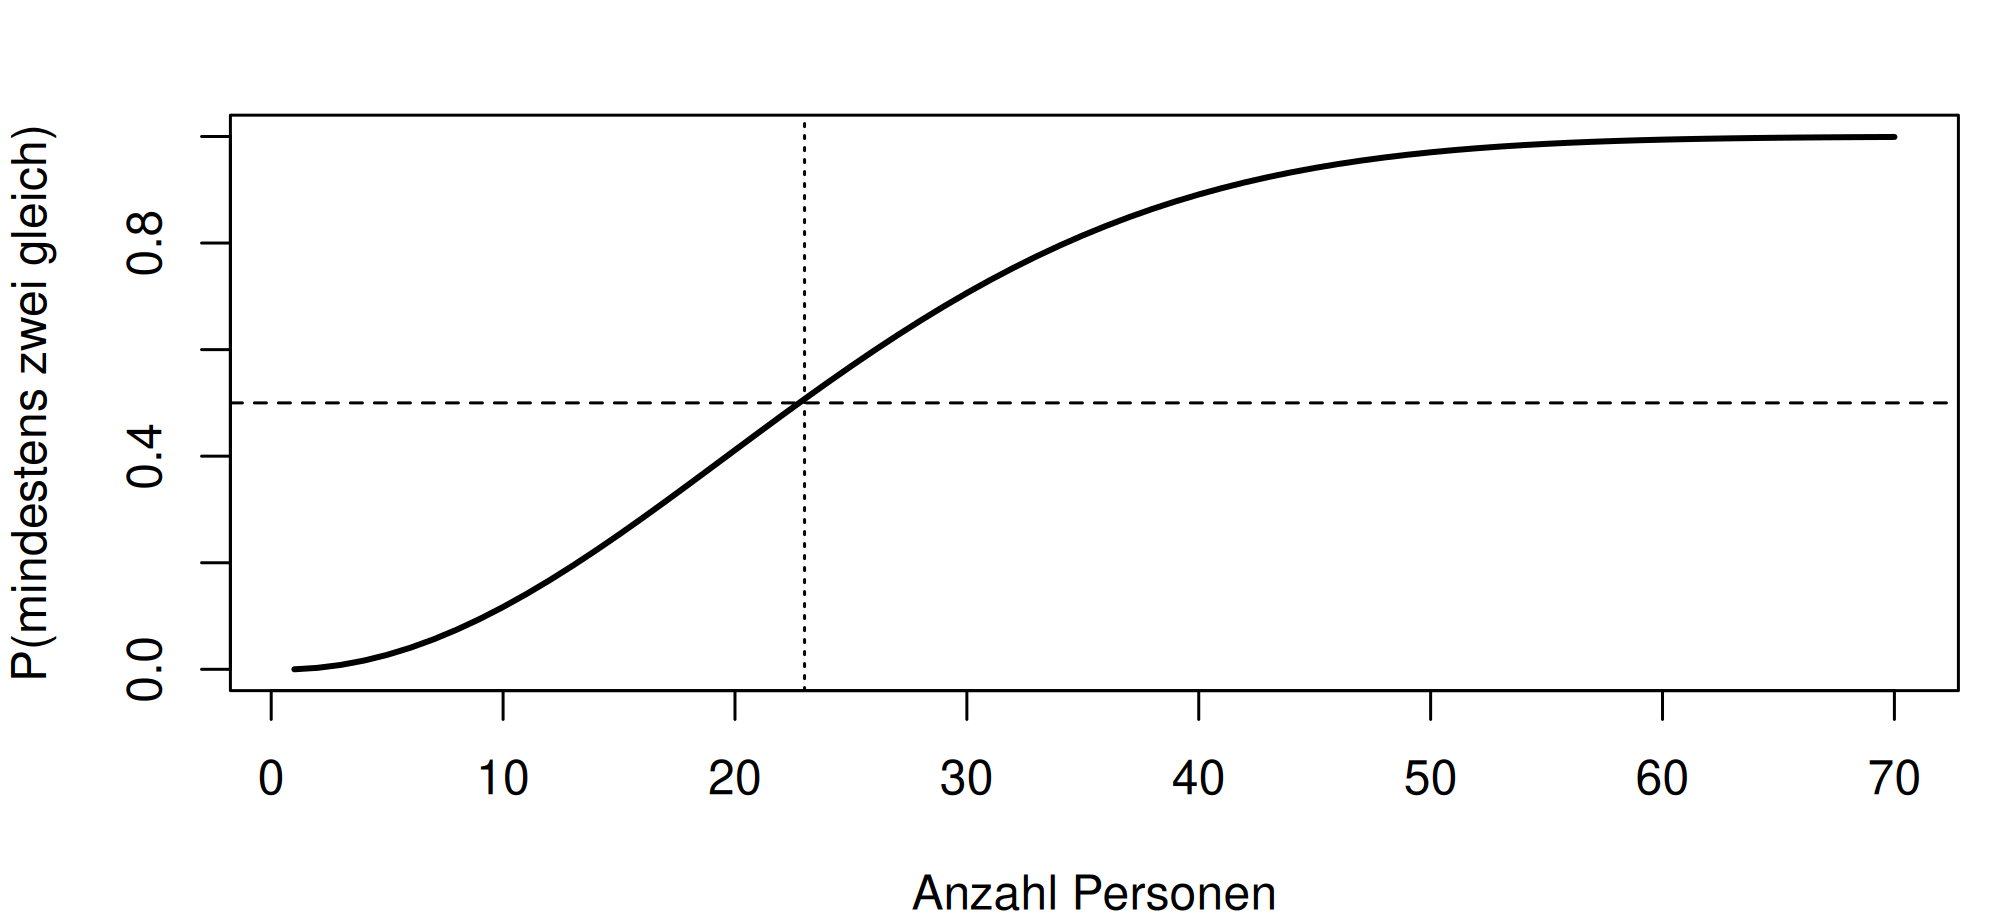
Wie viele Personen braucht es, damit zwei von ihnen mit mehr als 50 Prozent Wahrscheinlichkeit am selben Tag Geburtstag haben? Die spontane Schätzung liegt meist bei 180, der Hälfte von 365.

Gerechnet wird über das Gegenereignis: alle haben verschiedene Geburtstage.

Rechnung

p_geteilt <- function(m) 1 - prod((365 - seq_len(m) + 1) / 365)

stufen <- c(5, 10, 20, 23, 30, 50, 60, 70)
round(rbind(personen = stufen,
            wahrscheinlichkeit = sapply(stufen, p_geteilt)), 4)
                     [,1]    [,2]    [,3]    [,4]    [,5]    [,6]    [,7]
personen           5.0000 10.0000 20.0000 23.0000 30.0000 50.0000 60.0000
wahrscheinlichkeit 0.0271  0.1169  0.4114  0.5073  0.7063  0.9704  0.9941
                      [,8]
personen           70.0000
wahrscheinlichkeit  0.9992
# Gegenprobe durch Simulation: 20000 Gruppen zu je 23 Personen
N <- 20000; m <- 23
tage <- matrix(ganzzahlen(1357, N * m, 365), nrow = N, byrow = TRUE)
treffer <- apply(tage, 1, function(z) length(unique(z)) < m)
round(mean(treffer), 4)
[1] 0.5054
par(mar = c(4, 4, 2, 1))
plot(1:70, sapply(1:70, p_geteilt), type = "l", lwd = 2, ylim = c(0, 1),
     xlab = "Anzahl Personen", ylab = "P(mindestens zwei gleich)")
abline(h = 0.5, lty = 2); abline(v = 23, lty = 3)
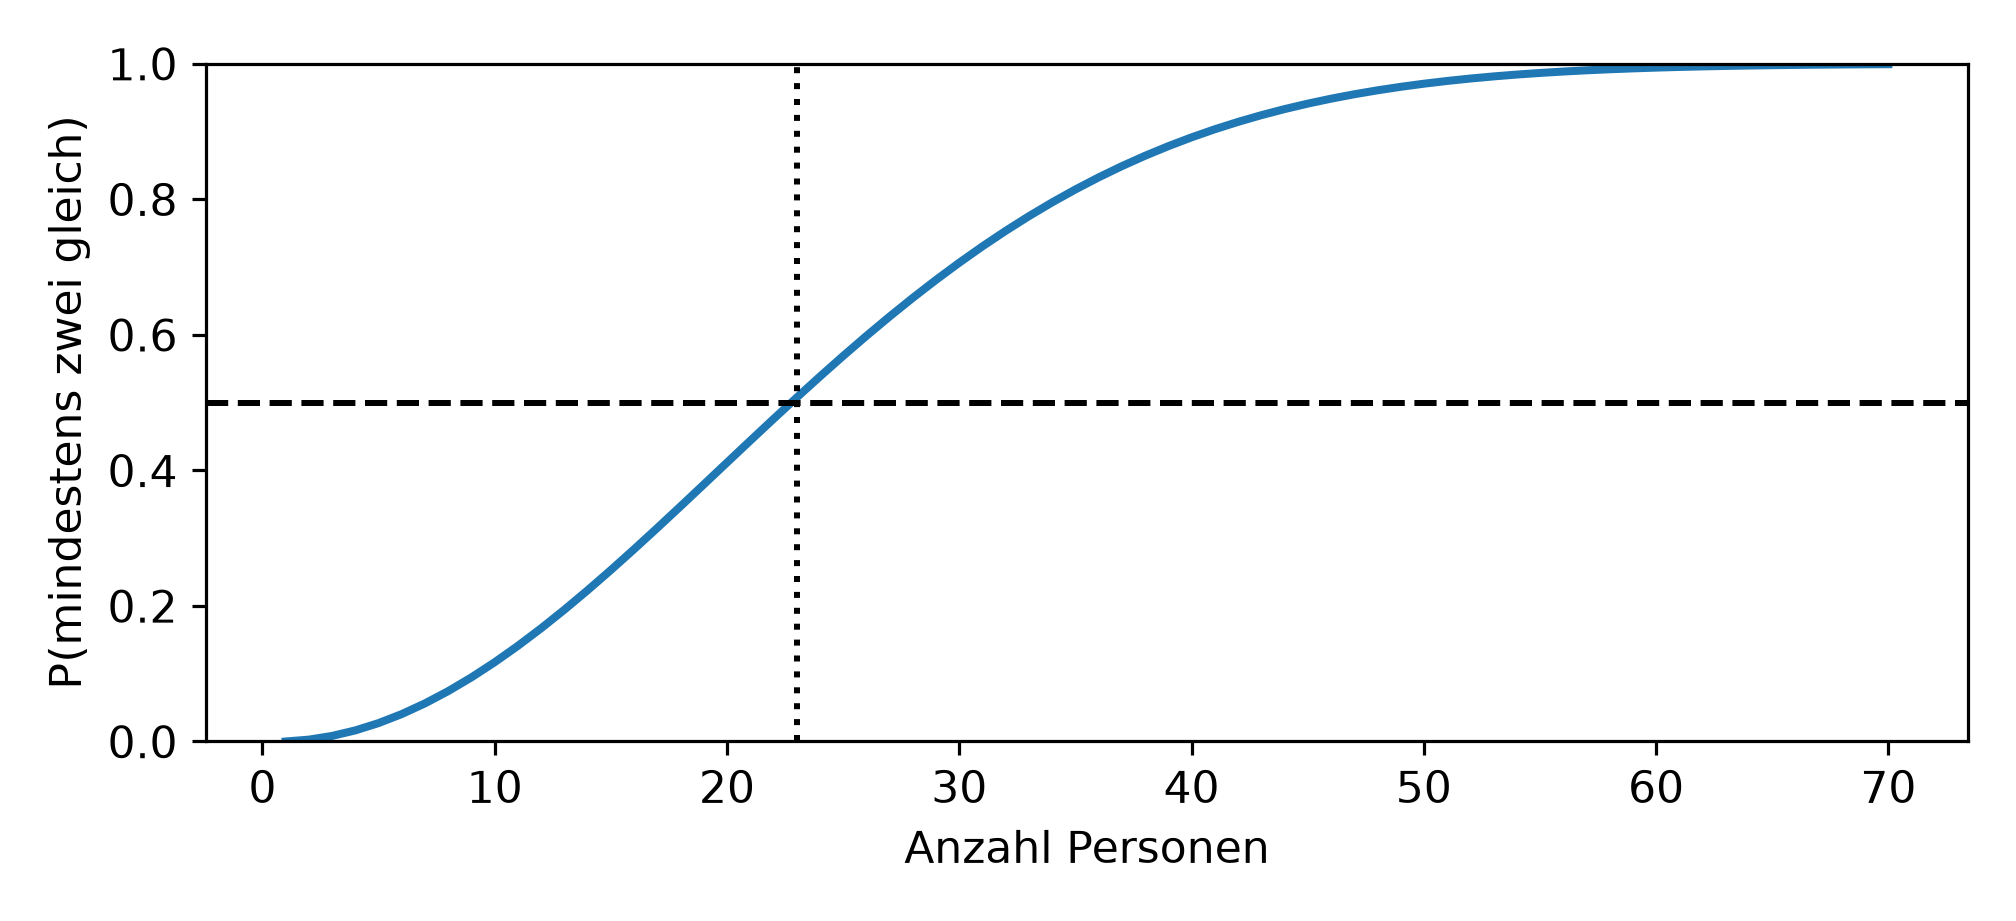
Abbildung 1: Beispiel 2: Wahrscheinlichkeit für mindestens einen gemeinsamen Geburtstag.
def p_geteilt(m):
    p = 1.0
    for i in range(m):
        p *= (365 - i) / 365
    return 1 - p


stufen = [5, 10, 20, 23, 30, 50, 60, 70]
print(pd.DataFrame({"personen": stufen,
                    "wahrscheinlichkeit": [p_geteilt(m) for m in stufen]})
      .round(4).T)
                         0        1        2  ...        5        6        7
personen            5.0000  10.0000  20.0000  ...  50.0000  60.0000  70.0000
wahrscheinlichkeit  0.0271   0.1169   0.4114  ...   0.9704   0.9941   0.9992

[2 rows x 8 columns]
N, m = 20000, 23
tage = ganzzahlen(1357, N * m, 365).reshape(N, m)
treffer = np.array([len(np.unique(z)) < m for z in tage])
print(round(float(treffer.mean()), 4))
0.5053
fig, achse = plt.subplots(figsize=(7, 3.2))
achse.plot(range(1, 71), [p_geteilt(m) for m in range(1, 71)], lw=2)
achse.axhline(0.5, ls="--", color="black")
achse.axvline(23, ls=":", color="black")
achse.set_ylim(0, 1)
(0.0, 1.0)
achse.set_xlabel("Anzahl Personen")
achse.set_ylabel("P(mindestens zwei gleich)")
plt.tight_layout()
plt.show()
Abbildung 2: Beispiel 2: dieselbe Kurve in Python.

Output Zeile für Zeile

Personen 5 10 20 23 30 50 60 70
Wahrscheinlichkeit 0.027 0.117 0.411 0.507 0.706 0.970 0.994 0.999

Simulation über 20 000 Gruppen zu je 23 Personen: 0.5054 (R) und 0.5053 (Python), eine einzige Gruppe wird unterschiedlich eingestuft, weil ein Zufallswert genau auf einer Tagesgrenze liegt und die beiden floor-Rundungen dort auseinandergehen.

Beobachtung Erklärung
Schon bei 23 Personen ist es wahrscheinlicher als nicht Nicht bei 180. Das ist das Überraschende an der Aufgabe.
Bei 50 Personen sind es 97 Prozent Und bei 70 praktisch sicher.
Die Rechnung geht über das Gegenereignis \(P = 1 - \frac{365}{365}\cdot\frac{364}{365}\cdot\ldots\), ein Produkt statt einer Summe über alle Fälle mit genau zwei, genau drei, … gleichen Geburtstagen.
Die Simulation bestätigt es 0.5054 gegen 0.5073. Der Standardfehler beträgt hier \(\sqrt{0.25/20000} = 0.0035\).

Warum die Intuition daneben liegt: Gefragt ist nicht “wer hat am selben Tag Geburtstag wie ich”, sondern “gibt es irgendein Paar”. Bei 23 Personen gibt es \(\binom{23}{2} = 253\) Paare und 253 Gelegenheiten, jede mit einer Wahrscheinlichkeit von \(1/365\).

Die Frage nach einer bestimmten Person ist eine ganz andere: Dafür bräuchte es 253 weitere Personen, um über 50 Prozent zu kommen.

Frage Anzahl Gelegenheiten benötigte Gruppengrösse
irgendein Paar gleich \(\binom{m}{2}\) 23
jemand hat wie ich Geburtstag \(m - 1\) 253

Dieselbe Verwechslung, “irgendwo” gegen “hier”, steckt hinter dem multiplen Testen: Bei zwanzig Tests findet man irgendwo einen signifikanten Befund, auch wenn keiner der einzelnen Tests auffällig wäre.

Interpretation und Ergebnissatz

In einer Gruppe von 23 Personen haben mit 50.7 Prozent Wahrscheinlichkeit mindestens zwei am selben Tag Geburtstag. Eine Simulation über 20 000 Gruppen ergibt 50.5 Prozent.

Frage und Datenlage

5 000 Würfe. Die relative Häufigkeit einer Sechs nähert sich \(1/6\), aber wie, und was bedeutet das für die nächste Sechs?

Rechnung

wuerfe <- ganzzahlen(2468, 5000, 6)
verlauf <- cumsum(wuerfe == 6) / seq_along(wuerfe)

ggplot(data.frame(wurf = seq_along(verlauf), anteil = verlauf),
       aes(wurf, anteil)) +
  geom_line(linewidth = 0.4) +
  geom_hline(yintercept = 1 / 6, linetype = "dashed") +
  coord_cartesian(ylim = c(0, 0.4)) +
  labs(x = "Anzahl Würfe", y = "relative Häufigkeit einer Sechs")

for (k in c(10, 100, 1000, 5000)) {
  cat(sprintf("nach %4d Würfen: %.4f | Abweichung %.4f | erwartete Streuung %.4f\n",
              k, verlauf[k], abs(verlauf[k] - 1 / 6),
              sqrt((1 / 6) * (5 / 6) / k)))
}
nach   10 Würfen: 0.3000 | Abweichung 0.1333 | erwartete Streuung 0.1179
nach  100 Würfen: 0.2500 | Abweichung 0.0833 | erwartete Streuung 0.0373
nach 1000 Würfen: 0.1500 | Abweichung 0.0167 | erwartete Streuung 0.0118
nach 5000 Würfen: 0.1648 | Abweichung 0.0019 | erwartete Streuung 0.0053
# Die laengste Serie ohne Sechs
laeufe <- rle(wuerfe == 6)
max(laeufe$lengths[!laeufe$values])
[1] 34
round(c(p_zehn_ohne_sechs = (5 / 6)^10), 4)
p_zehn_ohne_sechs 
           0.1615 
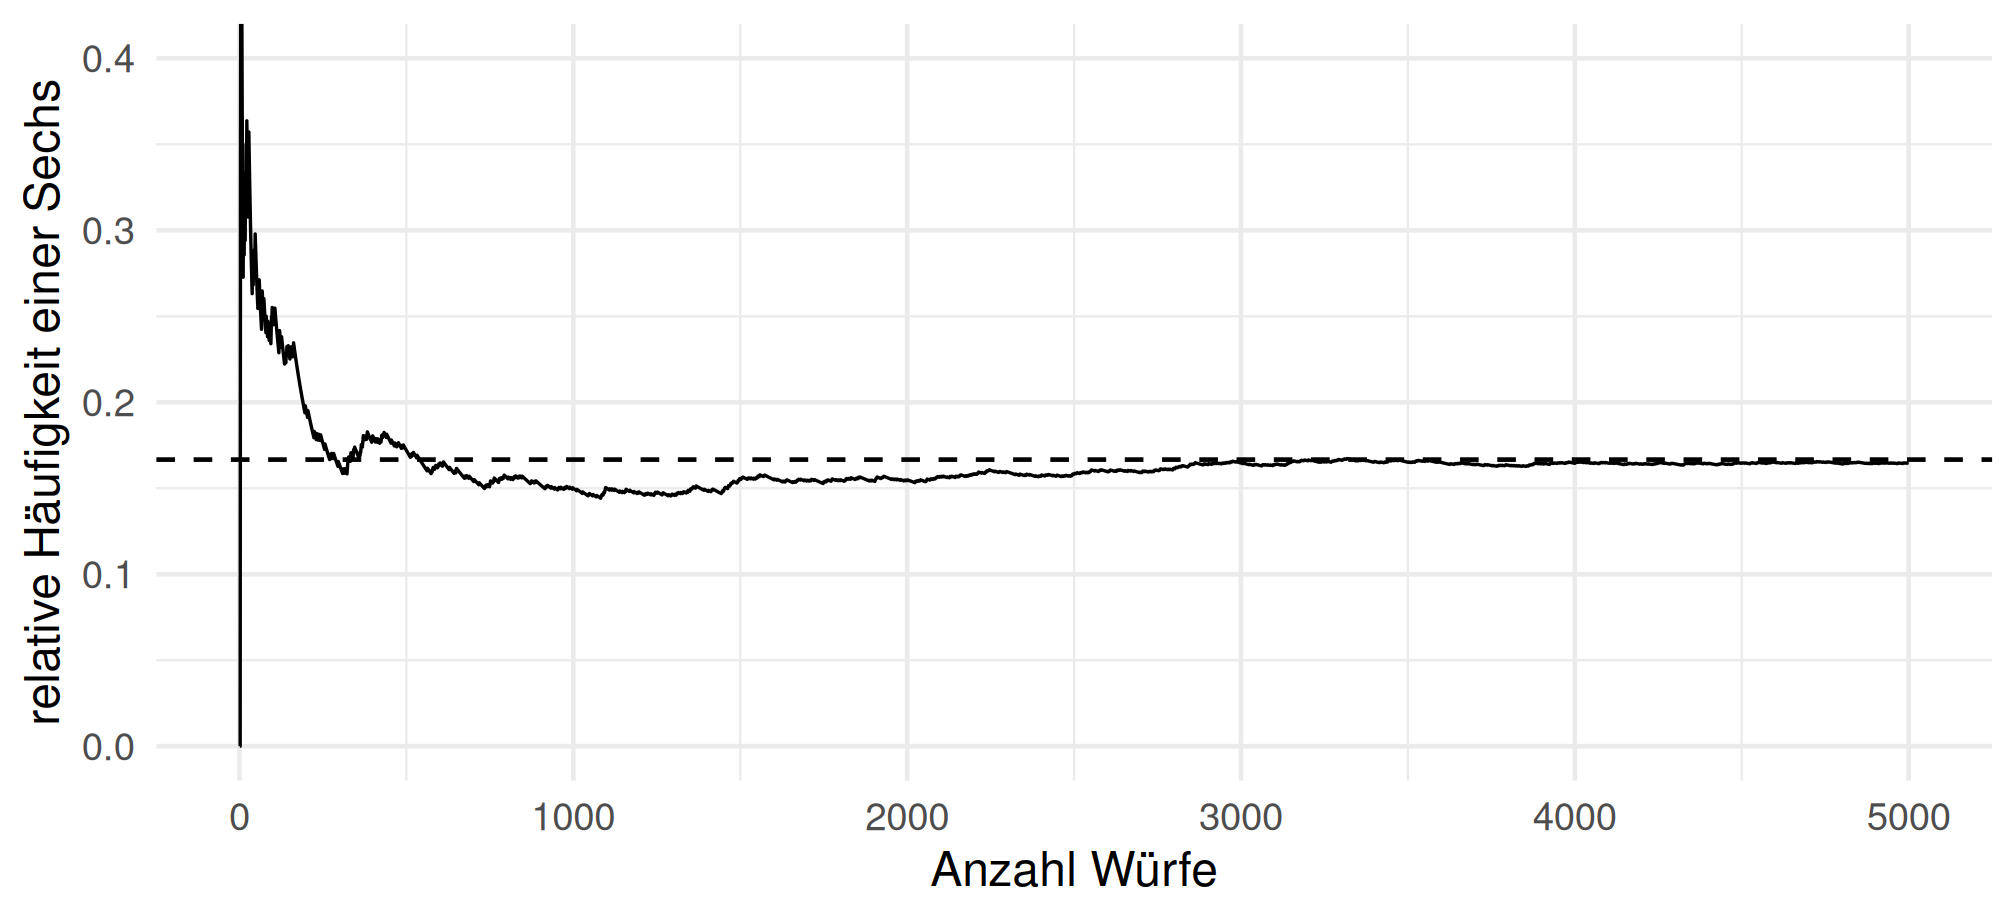
Abbildung 3: Beispiel 3: relative Häufigkeit einer Sechs über 5000 Würfe.
wuerfe = ganzzahlen(2468, 5000, 6)
verlauf = np.cumsum(wuerfe == 6) / np.arange(1, len(wuerfe) + 1)

fig, achse = plt.subplots(figsize=(7, 3.2))
achse.plot(np.arange(1, len(verlauf) + 1), verlauf, lw=0.5)
achse.axhline(1 / 6, ls="--", color="black")
achse.set_ylim(0, 0.4)
(0.0, 0.4)
achse.set_xlabel("Anzahl Würfe")
achse.set_ylabel("relative Häufigkeit einer Sechs")
plt.tight_layout()
plt.show()
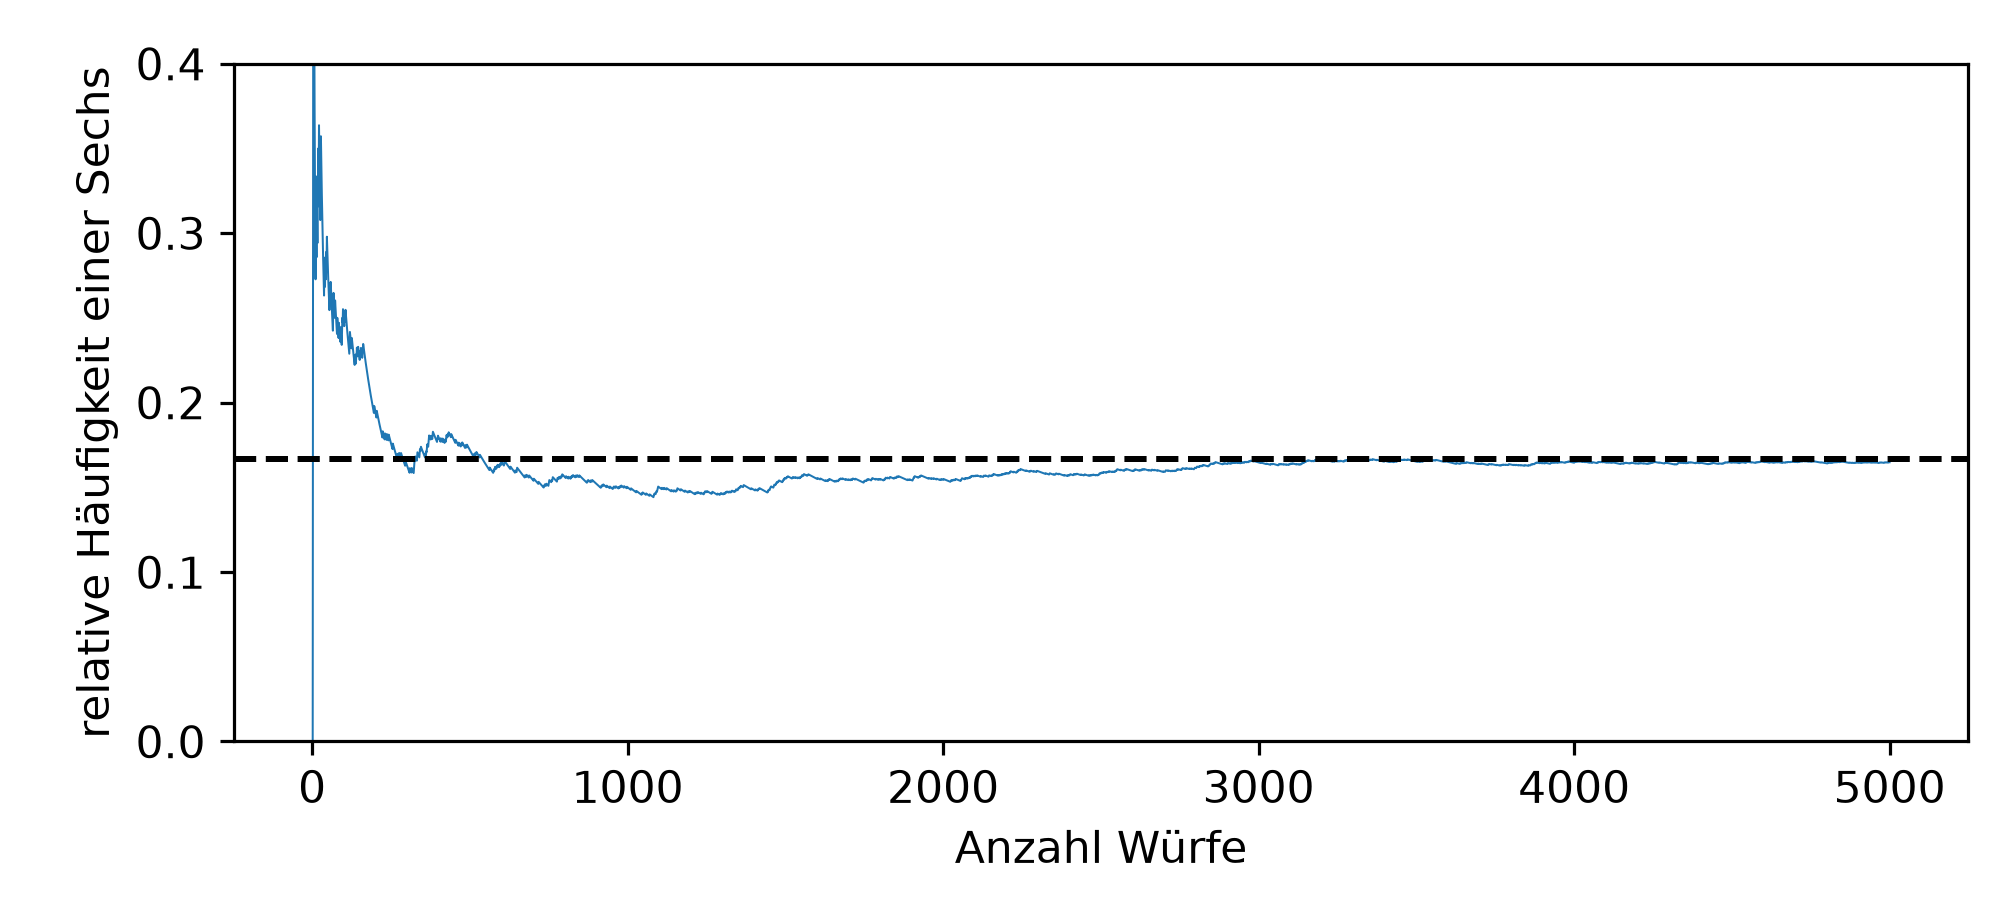
Abbildung 4: Beispiel 3: derselbe Verlauf in Python.
for k in [10, 100, 1000, 5000]:
    print(f"nach {k:4d} Würfen: {verlauf[k-1]:.4f}"
          f" | Abweichung {abs(verlauf[k-1] - 1/6):.4f}"
          f" | erwartete Streuung {np.sqrt((1/6) * (5/6) / k):.4f}")
nach   10 Würfen: 0.3000 | Abweichung 0.1333 | erwartete Streuung 0.1179
nach  100 Würfen: 0.2500 | Abweichung 0.0833 | erwartete Streuung 0.0373
nach 1000 Würfen: 0.1500 | Abweichung 0.0167 | erwartete Streuung 0.0118
nach 5000 Würfen: 0.1648 | Abweichung 0.0019 | erwartete Streuung 0.0053
laenge, aktuell = 0, 0
for wert in wuerfe:
    aktuell = 0 if wert == 6 else aktuell + 1
    laenge = max(laenge, aktuell)
print("längste Serie ohne Sechs:", laenge)
längste Serie ohne Sechs: 34
print("P(zehn Würfe ohne Sechs):", round((5 / 6) ** 10, 4))
P(zehn Würfe ohne Sechs): 0.1615

Output Zeile für Zeile

nach … Würfen relative Häufigkeit Abweichung von \(1/6\) erwartete Streuung \(\sqrt{pq/n}\)
10 0.3000 0.1333 0.1179
100 0.2500 0.0833 0.0373
1 000 0.1500 0.0167 0.0118
5 000 0.1648 0.0019 0.0053
Beobachtung Erklärung
Die Abweichung sinkt von 0.133 auf 0.002 Und zwar ungefähr wie \(1/\sqrt{n}\), die Spalte rechts zeigt die theoretische Streuung, die dieselbe Grössenordnung hat.
Bei 100 Würfen liegt die Abweichung noch bei 0.083 Das ist die Hälfte des wahren Werts. Wer aus hundert Würfen auf die Fairness eines Würfels schliessen will, hat wenig in der Hand.
Die längste Serie ohne Sechs dauert 34 Würfe In 5 000 Würfen. Solche Serien sind normal, nicht auffällig.
Zehn Würfe ohne Sechs haben die Wahrscheinlichkeit 0.1615 Also in etwa jeder sechsten Zehnerserie.

Was die Kurve nicht zeigt, und das ist der Punkt: Sie erreicht den Wert nie endgültig und kehrt auch nicht zu ihm zurück, weil eine Serie ohne Sechsen später “ausgeglichen” würde. Diese Vorstellung ist der Spielerfehlschluss.

Der Würfel hat kein Gedächtnis. Was geschieht, ist etwas anderes: Eine Abweichung von 5 Sechsen zu wenig wiegt bei 100 Würfen 5 Prozentpunkte und bei 5 000 Würfen ein Zehntel davon. Die Abweichung verschwindet nicht, sie verliert an Gewicht.

Rechnerisch: Die absolute Abweichung der Anzahl wächst mit \(\sqrt{n}\), die der relativen Häufigkeit sinkt mit \(1/\sqrt{n}\). Beides zugleich.

Interpretation und Ergebnissatz

Nach 5 000 Würfen liegt der beobachtete Anteil bei 0.1648 gegenüber dem erwarteten 0.1667. Die Abweichung sinkt mit der Wurzel der Wurfzahl; einzelne Serien von bis zu 34 Würfen ohne Sechs treten dabei auf und sind unauffällig.

Frage und Datenlage

Beim Würfel: \(A\) = gerade Zahl, \(B\) = Zahl grösser als vier. Wie wahrscheinlich ist \(A\) oder \(B\)?

Rechnung

augen <- 1:6

p_a <- mean(augen %% 2 == 0)        # 2, 4, 6
p_b <- mean(augen > 4)              # 5, 6
p_ab <- mean(augen %% 2 == 0 & augen > 4)   # nur die 6

round(c(p_a = p_a, p_b = p_b, p_schnitt = p_ab,
        korrekt = p_a + p_b - p_ab,
        ohne_abzug = p_a + p_b,
        abgezaehlt = mean(augen %% 2 == 0 | augen > 4)), 4)
       p_a        p_b  p_schnitt    korrekt ohne_abzug abgezaehlt 
    0.5000     0.3333     0.1667     0.6667     0.8333     0.6667 
# Welche Augenzahlen gehoeren dazu?
augen[augen %% 2 == 0 | augen > 4]
[1] 2 4 5 6
# Ein disjunkter Fall zum Vergleich: gerade oder gleich 5
round(c(disjunkt_summe = mean(augen %% 2 == 0) + mean(augen == 5),
        disjunkt_abgezaehlt = mean(augen %% 2 == 0 | augen == 5)), 4)
     disjunkt_summe disjunkt_abgezaehlt 
             0.6667              0.6667 
augen = np.arange(1, 7)

p_a = float((augen % 2 == 0).mean())
p_b = float((augen > 4).mean())
p_ab = float(((augen % 2 == 0) & (augen > 4)).mean())

print({"p_a": round(p_a, 4), "p_b": round(p_b, 4),
       "p_schnitt": round(p_ab, 4),
       "korrekt": round(p_a + p_b - p_ab, 4),
       "ohne_abzug": round(p_a + p_b, 4),
       "abgezaehlt": round(float(((augen % 2 == 0) | (augen > 4)).mean()), 4)})
{'p_a': 0.5, 'p_b': 0.3333, 'p_schnitt': 0.1667, 'korrekt': 0.6667, 'ohne_abzug': 0.8333, 'abgezaehlt': 0.6667}
print(augen[(augen % 2 == 0) | (augen > 4)])
[2 4 5 6]
print({"disjunkt_summe": round(float((augen % 2 == 0).mean()
                                     + (augen == 5).mean()), 4),
       "disjunkt_abgezaehlt": round(float(((augen % 2 == 0)
                                           | (augen == 5)).mean()), 4)})
{'disjunkt_summe': 0.6667, 'disjunkt_abgezaehlt': 0.6667}

Output Zeile für Zeile

Grösse Wert Welche Augenzahlen
\(P(A)\), gerade 0.5000 2, 4, 6
\(P(B)\), grösser 4 0.3333 5, 6
\(P(A \cap B)\) 0.1667 nur die 6
\(P(A) + P(B) - P(A \cap B)\) 0.6667 2, 4, 5, 6
\(P(A) + P(B)\) ohne Abzug 0.8333
abgezählt 0.6667 vier von sechs
Beobachtung Erklärung
Die Vereinigung enthält vier Augenzahlen 2, 4, 5 und 6. Also \(4/6 = 0.667\), wie die Formel sagt.
Ohne Abzug kommt 0.833 heraus Die Sechs wurde zweimal gezählt, einmal als gerade und einmal als grösser vier.
Beim disjunkten Paar stimmt die einfache Summe “gerade oder gleich 5”: \(0.5 + 0.1667 = 0.6667\), abgezählt ebenso. Dort ist \(P(A \cap B) = 0\).

Die Verallgemeinerung heisst Siebformel und wird schnell unhandlich. Bei drei Ereignissen:

\[P(A \cup B \cup C) = \sum P(A) - \sum P(A \cap B) + P(A \cap B \cap C)\]

Also: Einzelne addieren, Paare abziehen, Dreifachschnitt wieder addieren. Bei \(k\) Ereignissen sind es \(2^k - 1\) Terme mit wechselnden Vorzeichen.

Deshalb rechnet man ab drei Ereignissen praktisch immer über das Gegenereignis, Beispiel 5 zeigt, wie stark der Unterschied ist.

Interpretation und Ergebnissatz

Die Wahrscheinlichkeit für eine gerade Zahl oder eine Zahl über vier beträgt 2/3. Die einfache Summe der Einzelwahrscheinlichkeiten ergäbe 5/6, weil die Sechs zu beiden Ereignissen gehört und doppelt gezählt würde.

Frage und Datenlage

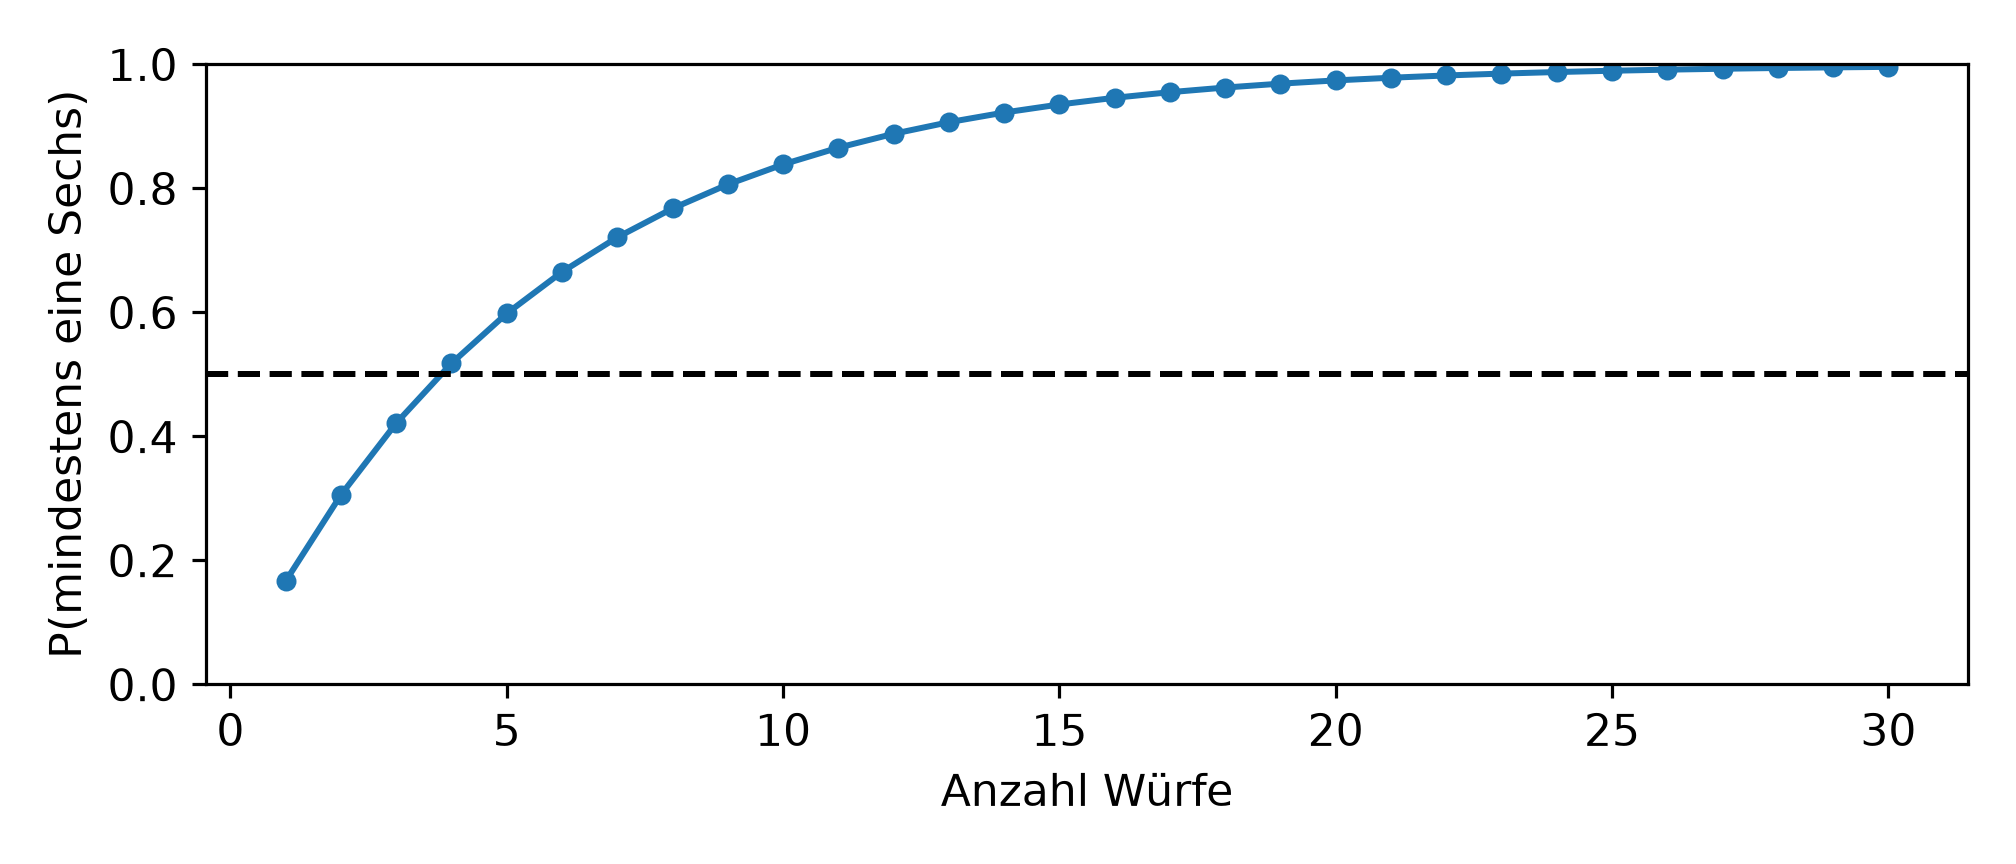
Wie wahrscheinlich ist mindestens eine Sechs bei \(n\) Würfen? Der direkte Weg summiert über “genau eine”, “genau zwei”, …, der Umweg braucht eine Potenz.

Rechnung

round(rbind(wuerfe = c(1, 2, 3, 6, 10, 25),
            mindestens_eine_sechs = 1 - (5 / 6)^c(1, 2, 3, 6, 10, 25)), 4)
                        [,1]   [,2]   [,3]   [,4]    [,5]    [,6]
wuerfe                1.0000 2.0000 3.0000 6.0000 10.0000 25.0000
mindestens_eine_sechs 0.1667 0.3056 0.4213 0.6651  0.8385  0.9895
# Der direkte Weg bei drei Wuerfen: ueber die Binomialverteilung
round(c(genau_eine = dbinom(1, 3, 1 / 6),
        genau_zwei = dbinom(2, 3, 1 / 6),
        genau_drei = dbinom(3, 3, 1 / 6),
        summe = sum(dbinom(1:3, 3, 1 / 6)),
        gegenereignis = 1 - (5 / 6)^3), 4)
   genau_eine    genau_zwei    genau_drei         summe gegenereignis 
       0.3472        0.0694        0.0046        0.4213        0.4213 
# Gegenprobe durch Simulation
versuche <- matrix(ganzzahlen(3690, 3 * 100000, 6), ncol = 3, byrow = TRUE)
round(mean(apply(versuche, 1, function(z) any(z == 6))), 4)
[1] 0.4208
par(mar = c(4, 4, 2, 1))
plot(1:30, 1 - (5 / 6)^(1:30), type = "b", pch = 16, ylim = c(0, 1),
     xlab = "Anzahl Würfe", ylab = "P(mindestens eine Sechs)")
abline(h = 0.5, lty = 2)
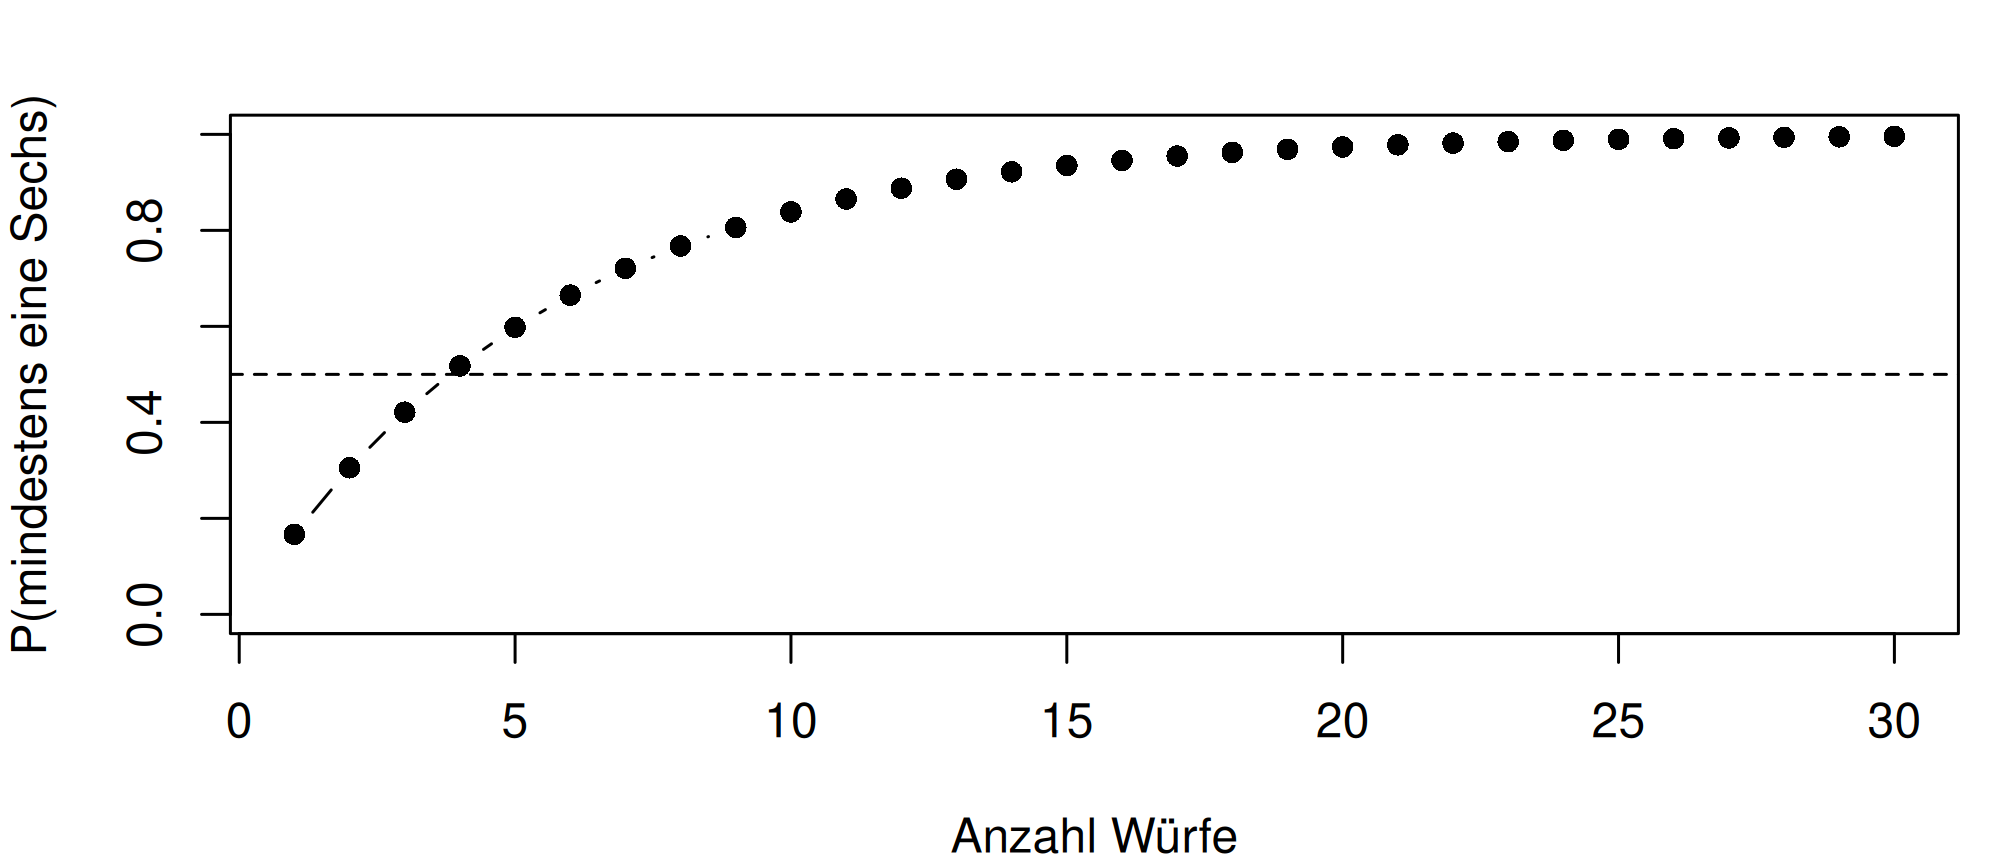
Abbildung 5: Beispiel 5: Wahrscheinlichkeit für mindestens eine Sechs, nach Anzahl Würfe.
from scipy import stats

anzahl = np.array([1, 2, 3, 6, 10, 25])
print(pd.DataFrame({"wuerfe": anzahl,
                    "mindestens_eine_sechs": 1 - (5 / 6) ** anzahl})
      .round(4).T)
                            0       1       2       3        4        5
wuerfe                 1.0000  2.0000  3.0000  6.0000  10.0000  25.0000
mindestens_eine_sechs  0.1667  0.3056  0.4213  0.6651   0.8385   0.9895
print({"genau_eine": round(float(stats.binom.pmf(1, 3, 1 / 6)), 4),
       "genau_zwei": round(float(stats.binom.pmf(2, 3, 1 / 6)), 4),
       "genau_drei": round(float(stats.binom.pmf(3, 3, 1 / 6)), 4),
       "summe": round(float(stats.binom.pmf([1, 2, 3], 3, 1 / 6).sum()), 4),
       "gegenereignis": round(1 - (5 / 6) ** 3, 4)})
{'genau_eine': 0.3472, 'genau_zwei': 0.0694, 'genau_drei': 0.0046, 'summe': 0.4213, 'gegenereignis': 0.4213}
versuche = ganzzahlen(3690, 3 * 100000, 6).reshape(100000, 3)
print(round(float((versuche == 6).any(axis=1).mean()), 4))
0.4208
fig, achse = plt.subplots(figsize=(7, 3))
schritte = np.arange(1, 31)
achse.plot(schritte, 1 - (5 / 6) ** schritte, "o-", ms=4)
achse.axhline(0.5, ls="--", color="black")
achse.set_ylim(0, 1)
(0.0, 1.0)
achse.set_xlabel("Anzahl Würfe")
achse.set_ylabel("P(mindestens eine Sechs)")
plt.tight_layout()
plt.show()
Abbildung 6: Beispiel 5: dieselbe Kurve in Python.

Output Zeile für Zeile

Würfe 1 2 3 6 10 25
\(P(\text{mindestens eine Sechs})\) 0.1667 0.3056 0.4213 0.6651 0.8385 0.9895

Und der Vergleich der beiden Wege bei drei Würfen:

Weg Rechnung Ergebnis
direkt 0.3472 + 0.0694 + 0.0046 0.4213
Gegenereignis \(1 - (5/6)^3\) 0.4213
Simulation (100 000 Versuche) 0.4208
Beobachtung Erklärung
Beide Wege ergeben dasselbe Wie sie müssen. Der direkte braucht drei Terme, der andere einen.
Bei zehn Würfen wären es zehn Terme Und bei 25 Würfen 25. Die Ersparnis wächst mit \(n\).
Bei sechs Würfen liegt die Wahrscheinlichkeit bei 0.665, nicht bei 1 Der naheliegende Fehlschluss “sechs Würfe, Wahrscheinlichkeit \(6 \cdot 1/6 = 1\)” addiert nicht disjunkte Ereignisse. Die Fälle mit mehreren Sechsen werden dabei mehrfach gezählt.
Die Kurve steigt nie auf genau 1 \((5/6)^n\) wird beliebig klein, aber nie null. Bei 25 Würfen fehlt noch ein Prozent.

Woran man erkennt, dass das Gegenereignis der richtige Weg ist: an den Wörtern “mindestens”, “wenigstens” und “irgendein”. Ihr Gegenteil ist immer ein einziger Fall, “keiner”, und bei unabhängigen Versuchen ist dessen Wahrscheinlichkeit ein Produkt.

Formulierung Gegenereignis Rechnung
mindestens ein Treffer kein Treffer \(1 - (1-p)^n\)
mindestens zwei Treffer keiner oder genau einer \(1 - (1-p)^n - n p (1-p)^{n-1}\)
alle Treffer mindestens einer daneben \(p^n\) direkt einfacher

Ab “mindestens zwei” verliert der Trick seinen Vorteil, dann ist die Binomialverteilung das passende Werkzeug.

Interpretation und Ergebnissatz

Die Wahrscheinlichkeit für mindestens eine Sechs beträgt bei drei Würfen 42.1 Prozent, gerechnet als \(1 - (5/6)^3\). Eine Simulation über 100 000 Versuche ergibt 42.1 Prozent.

Verständnisfragen

Ein Zahlenschloss hat vier Ringe mit je zehn Ziffern. Wie viele Einstellungen gibt es?

Zehntausend
Richtig, also zehn hoch vier. Jede Ziffer darf mehrfach vorkommen und die Position zählt, es wird also mit Zurücklegen und mit Anordnung gezogen.
5040, also 10 mal 9 mal 8 mal 7
Das wäre ohne Zurücklegen. Ein Zahlenschloss erlaubt aber 1111.
210, also 10 über 4
Das wäre ohne Zurücklegen und ohne Anordnung. Bei einem Schloss ist die Reihenfolge gerade entscheidend.

Warum ist die Zahl der Lottoziehungen 49 über 6 und nicht das Produkt 49 mal 48 mal 47 mal 46 mal 45 mal 44?

Weil Kugeln zurückgelegt werden
Sie werden gerade nicht zurückgelegt, deshalb sinken die Faktoren.
Weil die Reihenfolge der gezogenen Kugeln keine Rolle spielt
Richtig. Das Produkt zählt jede Auswahl so oft, wie sie sich anordnen lässt, also sechs Fakultät mal zu häufig. Der Binomialkoeffizient teilt das heraus.
Weil das Produkt zu gross zum Rechnen wäre
Rechnen liesse es sich problemlos, es beantwortet nur eine andere Frage.

In einer Gruppe von 23 Personen haben mit über 50 Prozent Wahrscheinlichkeit zwei am selben Tag Geburtstag. Warum wirkt das überraschend?

Weil man an die eigene Person denkt statt an alle Paare
Richtig. Bei 23 Personen gibt es 253 Paare. Die Frage “hat jemand wie ich Geburtstag” bräuchte 253 Personen für dieselbe Wahrscheinlichkeit.
Weil die Rechnung falsch ist
Sie lässt sich über das Gegenereignis exakt nachvollziehen, und eine Simulation über 20 000 Gruppen bestätigt sie.
Weil Geburtstage nicht gleichverteilt sind
Das stimmt zwar, macht die Wahrscheinlichkeit aber sogar noch etwas grösser.

Zehn Würfe brachten keine Sechs. Ist die nächste Sechs jetzt wahrscheinlicher?

Ja, der Ausgleich ist fällig
Das ist der Spielerfehlschluss. Der Würfel hat kein Gedächtnis.
Nein, die Wahrscheinlichkeit bleibt bei einem Sechstel
Richtig. Was sich ausgleicht, ist der Anteil, und zwar nicht durch Gegenbewegung, sondern weil frühe Abweichungen gegenüber der wachsenden Gesamtzahl an Gewicht verlieren. In 5 000 Würfen trat eine Serie von 34 Würfen ohne Sechs auf.
Nein, sie ist sogar kleiner, der Würfel ist wohl unfair
Zehn Würfe ohne Sechs haben eine Wahrscheinlichkeit von 16.2 Prozent und sind damit unauffällig.

Wie wahrscheinlich ist mindestens eine Sechs beim Wurf zweier Würfel?

2 von 6, also ein Drittel
Das addiert die beiden Einzelwahrscheinlich- keiten und zählt den Fall zweier Sechsen doppelt.
11 von 36
Richtig, über das Gegenereignis eins minus fünf Sechstel zum Quadrat, also 0.3056. Der Additionssatz kommt auf dasselbe, wenn man den Überschneidungsteil abzieht.
1 von 36
Das ist die Wahrscheinlichkeit für zwei Sechsen, nicht für mindestens eine.

Bei sechs Würfen beträgt die Wahrscheinlichkeit für mindestens eine Sechs 66.5 Prozent und nicht 100 Prozent. Warum?

Weil sechsmal ein Sechstel nur addiert werden dürfte, wenn die Ereignisse disjunkt wären
Richtig. Die Fälle mit mehreren Sechsen würden dabei mehrfach gezählt. Korrekt ist eins minus fünf Sechstel hoch sechs.
Weil der Würfel nicht fair ist
Er ist fair; die Rechnung ist der Fehler.
Weil sechs Würfe zu wenige sind
Auch bei 25 Würfen bleibt die Wahrscheinlichkeit unter eins, nämlich bei 98.95 Prozent.

Verlinkte Ressourcen