Shapiro und Kolmogorow-Smirnow, und warum Plots oft mehr zeigen.
Alle Beispiele rechnen mit deterministisch konstruierten Zahlen, damit R und Python dieselben Daten sehen und jeder Wert im Text nachprüfbar ist.
Kernideen
Ein Normalitätstest prüft die Nullhypothese “die Daten stammen aus einer Normalverteilung”. Ein grosser p-Wert ist kein Nachweis dieser Annahme, sondern nur das Ausbleiben eines Gegenbeweises.
Die Aussagekraft hängt fast vollständig am Stichprobenumfang, und zwar in beide Richtungen. Bei kleinem n findet der Test auch grobe Abweichungen nicht; bei grossem n verwirft er wegen Abweichungen, die keine Rolle spielen.
Genau das macht ihn als Entscheidungshilfe untauglich: Er schlägt dort an, wo es unwichtig ist, und schweigt dort, wo es darauf ankäme.
Die meisten Verfahren setzen ohnehin nicht normalverteilteDaten voraus, sondern normalverteilteResiduen oder Mittelwerte. Der zentrale Grenzwertsatz erledigt Letzteres mit wachsendem n von selbst.
Was stattdessen hilft: QQ-Plot, Histogramm, der Vergleich von Mittelwert und Median, und die Frage, wie empfindlich das geplante Verfahren überhaupt reagiert.
Erklärung
Was die Tests tun
Test
Grundidee
R
Python
Shapiro-Wilk
Vergleicht die geordneten Werte mit den unter Normalverteilung erwarteten; im Kern ein QQ-Plot als Zahl
shapiro.test(x)
stats.shapiro(x)
Kolmogorow-Smirnow
Grösster senkrechter Abstand zwischen empirischer und theoretischer Verteilungsfunktion
ks.test(x, "pnorm", mean, sd)
stats.kstest(x, "norm")
Anderson-Darling
Wie KS, gewichtet aber die Ränder stärker
nortest::ad.test(x)
stats.anderson(x)
Shapiro-Wilk ist der schärfste der drei und der übliche Standard. Der Kolmogorow-Smirnow-Test ist verbreiteter, als er es verdient: In der Form, in der er meist verwendet wird, werden Mittelwert und Streuung aus denselben Daten geschätzt, für die er dann prüft. Das macht ihn deutlich zu konservativ, wie Beispiel 2 zeigt.
Die Nullhypothese steht auf der falschen Seite
Bei einem Normalitätstest lautet die Nullhypothese, dass alles in Ordnung ist. Man möchte sie aber bestätigen, nicht verwerfen, und genau das kann ein Test grundsätzlich nicht. Ein p-Wert von 0.95 heisst nicht “normalverteilt”, er heisst “diese Daten sprechen nicht dagegen”.
Die Folge ist eine Fehlerlogik, die genau verkehrt herum läuft:
Umfang
Was passiert
Warum das falsch herum ist
klein, etwa n < 30
Der Test hat kaum Power und verwirft fast nie
Gerade hier wäre die Verteilungsform wichtig, weil der zentrale Grenzwertsatz noch nicht greift
gross, etwa n > 300
Der Test verwirft schon bei winzigen Abweichungen
Gerade hier ist die Verteilungsform fast egal, weil der zentrale Grenzwertsatz greift
Was die Verfahren wirklich voraussetzen
Ein verbreitetes Missverständnis ist, dass t-Test und Regression normalverteilte Rohdaten bräuchten. Das trifft nicht zu:
Wie oben; Varianzhomogenität ist meist das grössere Thema
Konfidenzintervall für den Mittelwert
die Verteilung des Mittelwerts
Wie beim t-Test
Wer also die Rohdaten auf Normalität testet, prüft in mehreren dieser Fälle die falsche Grösse.
Wie stattdessen vorgehen
Streudiagramm, Histogramm und Boxplot ansehen. Sie zeigen Schiefe, Mehrgipfligkeit und Ausreisser, und zwar mit ihrer Grössenordnung.
QQ-Plot lesen. Er zeigt nicht nur, dass etwas abweicht, sondern wie: an den Rändern, in der Mitte, einseitig oder symmetrisch.
Mittelwert und Median vergleichen. Klaffen sie auseinander, ist die Verteilung schief, und der Mittelwert beschreibt keinen typischen Fall mehr.
Fragen, wie empfindlich das Verfahren ist. Bei n = 200 je Gruppe ist ein t-Test gegen mässige Schiefe unempfindlich; bei n = 8 ist er es nicht.
Im Zweifel das robuste Verfahren wählen, also Rangtests oder Bootstrap, und die Wahl vorab festlegen.
Ein Normalitätstest darf durchaus berichtet werden, ergänzend und mit seinem Umfang. Was nicht tragfähig ist, ist die Entscheidungsregel “p über 0.05, also t-Test, sonst Rangtest”. Sie macht die Verfahrenswahl von einer Zahl abhängig, die vor allem den Stichprobenumfang widerspiegelt, und sie hält das Testniveau des nachfolgenden Verfahrens nicht ein, weil zweimal an denselben Daten entschieden wird.
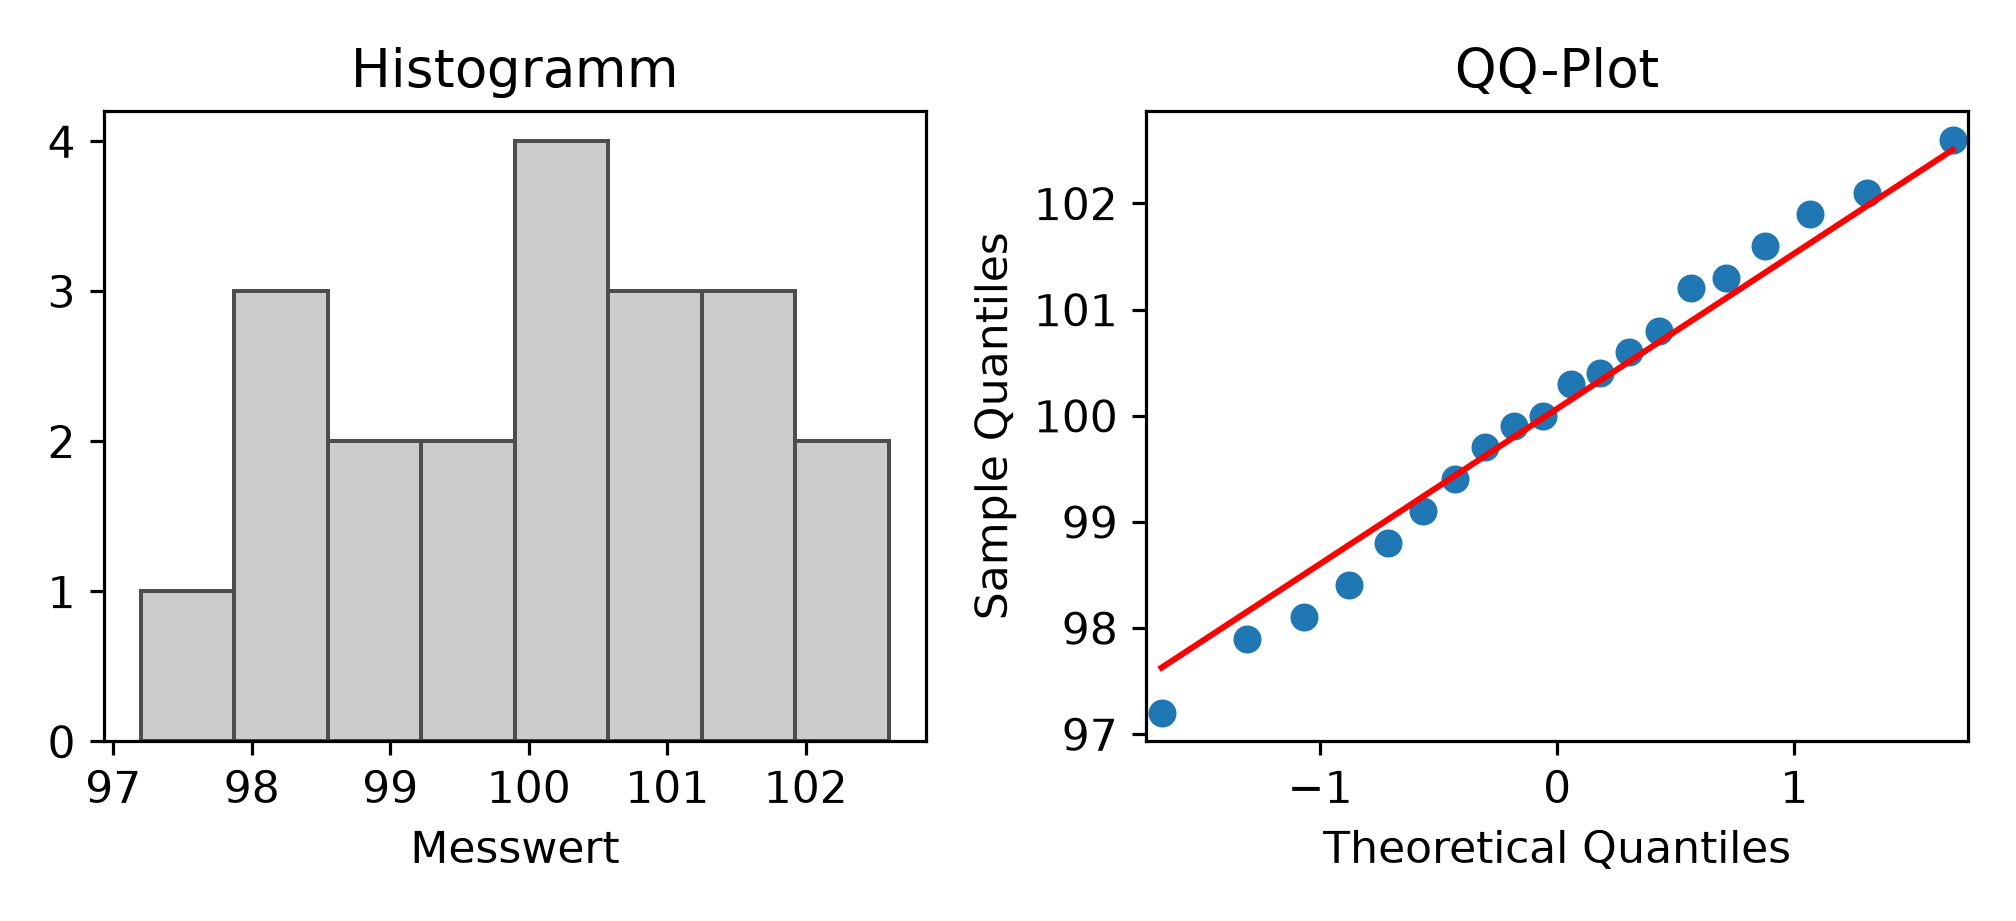
Abbildung 2: Beispiel 1: dieselbe Prüfung in Python.
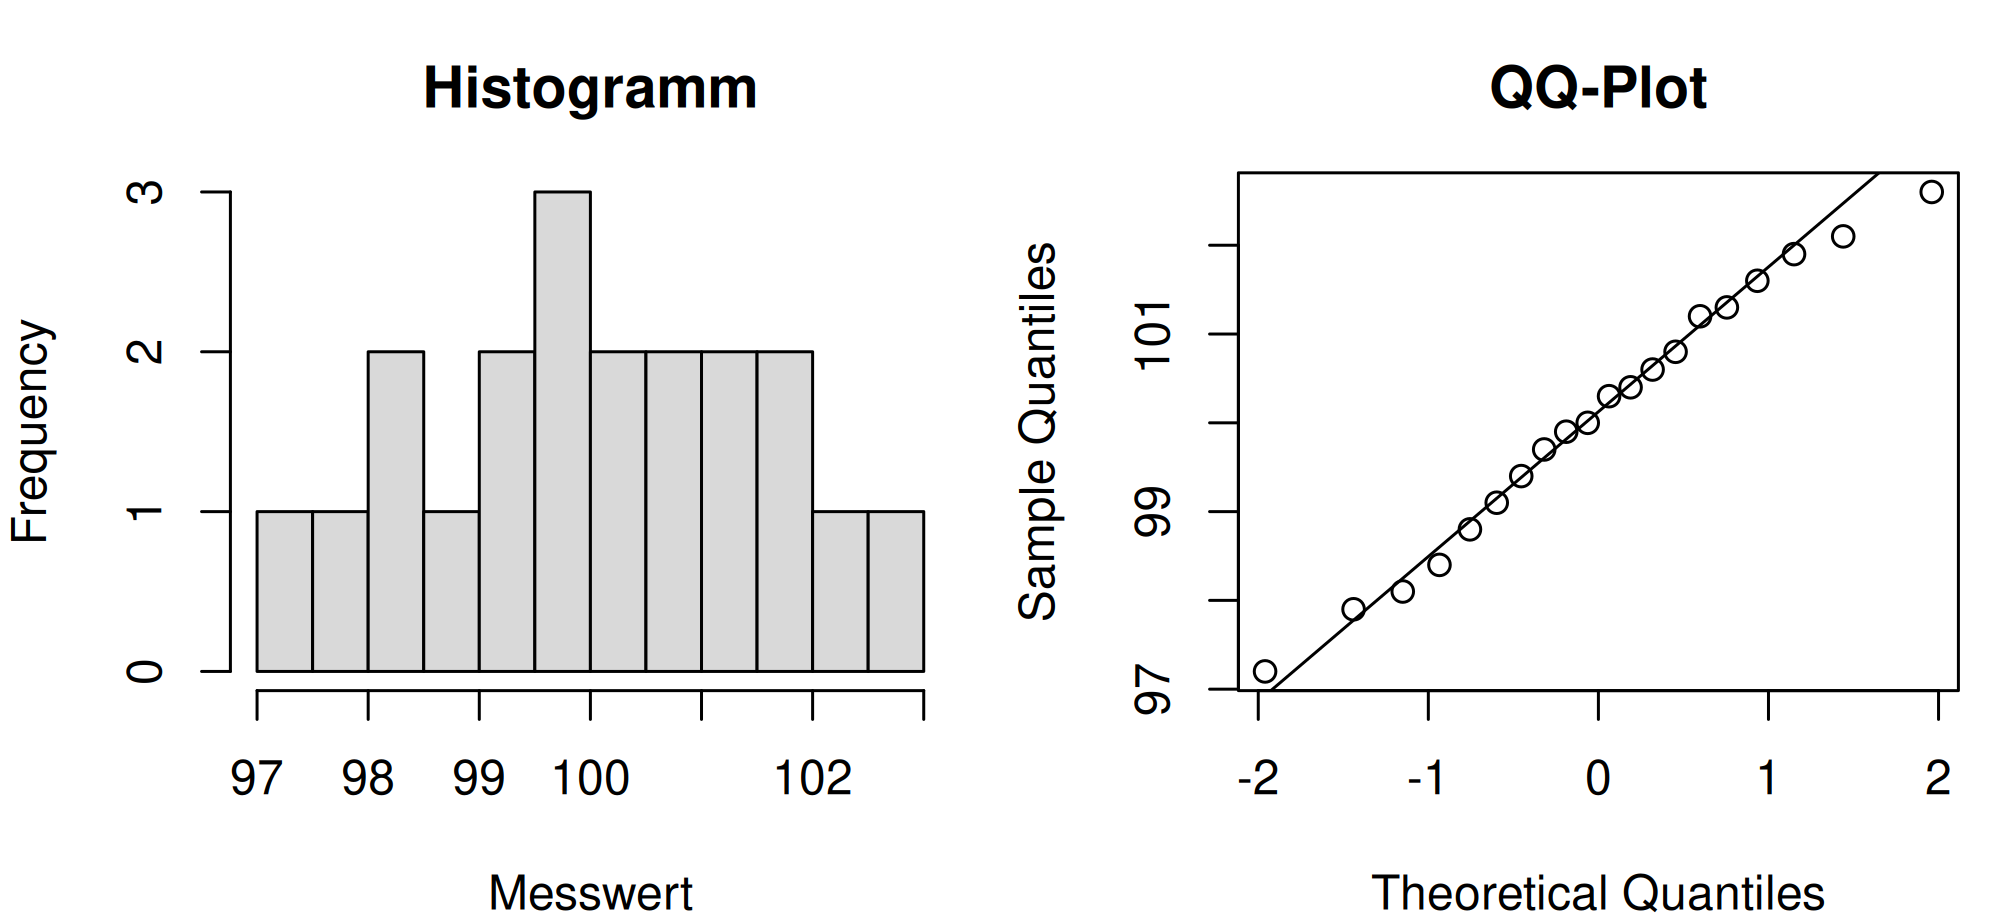
ergebnis = stats.shapiro(messwerte)print("Shapiro-Wilk W =", round(ergebnis.statistic, 4)," p =", round(ergebnis.pvalue, 4))
Shapiro-Wilk W = 0.9817 p = 0.9537
print("Mittelwert =", round(messwerte.mean(), 3)," Median =", round(np.median(messwerte), 3))
Mittelwert = 100.065 Median = 100.15
Output Zeile für Zeile
Ausgabe
Wert hier
Bedeutung
Wie er zu lesen ist
W
0.9817
Shapiro-Wilk-Statistik
Sie liegt zwischen 0 und 1; Werte nahe 1 bedeuten gute Übereinstimmung mit der Normalverteilung. W ist im Kern das Quadrat der Korrelation zwischen den Daten und den im QQ-Plot erwarteten Werten.
p-value
0.954
Wahrscheinlichkeit einer mindestens so grossen Abweichung, wenn die Daten normalverteilt wären
Kein Anlass zur Sorge. Aber eben auch kein Nachweis der Normalverteilung.
Mittelwert und Median
100.06 und 100.15
Lagemasse
Sie liegen praktisch übereinander, also ist die Verteilung nicht schief.
QQ-Plot
Punkte nah an der Geraden
Die eigentliche Prüfung. Sie zeigt zusätzlich, dass die Abweichungen klein und über den ganzen Bereich verteilt sind.
Interpretation
Der korrekte Satz lautet: “Die Daten sprechen nicht gegen eine Normalverteilung.” Nicht: “Die Daten sind normalverteilt.”
Der Unterschied ist bei n = 20 erheblich, denn der Test hätte selbst eine deutliche Schiefe wahrscheinlich nicht gefunden. Genau das zeigt Beispiel 3.
Frage und Datenlage
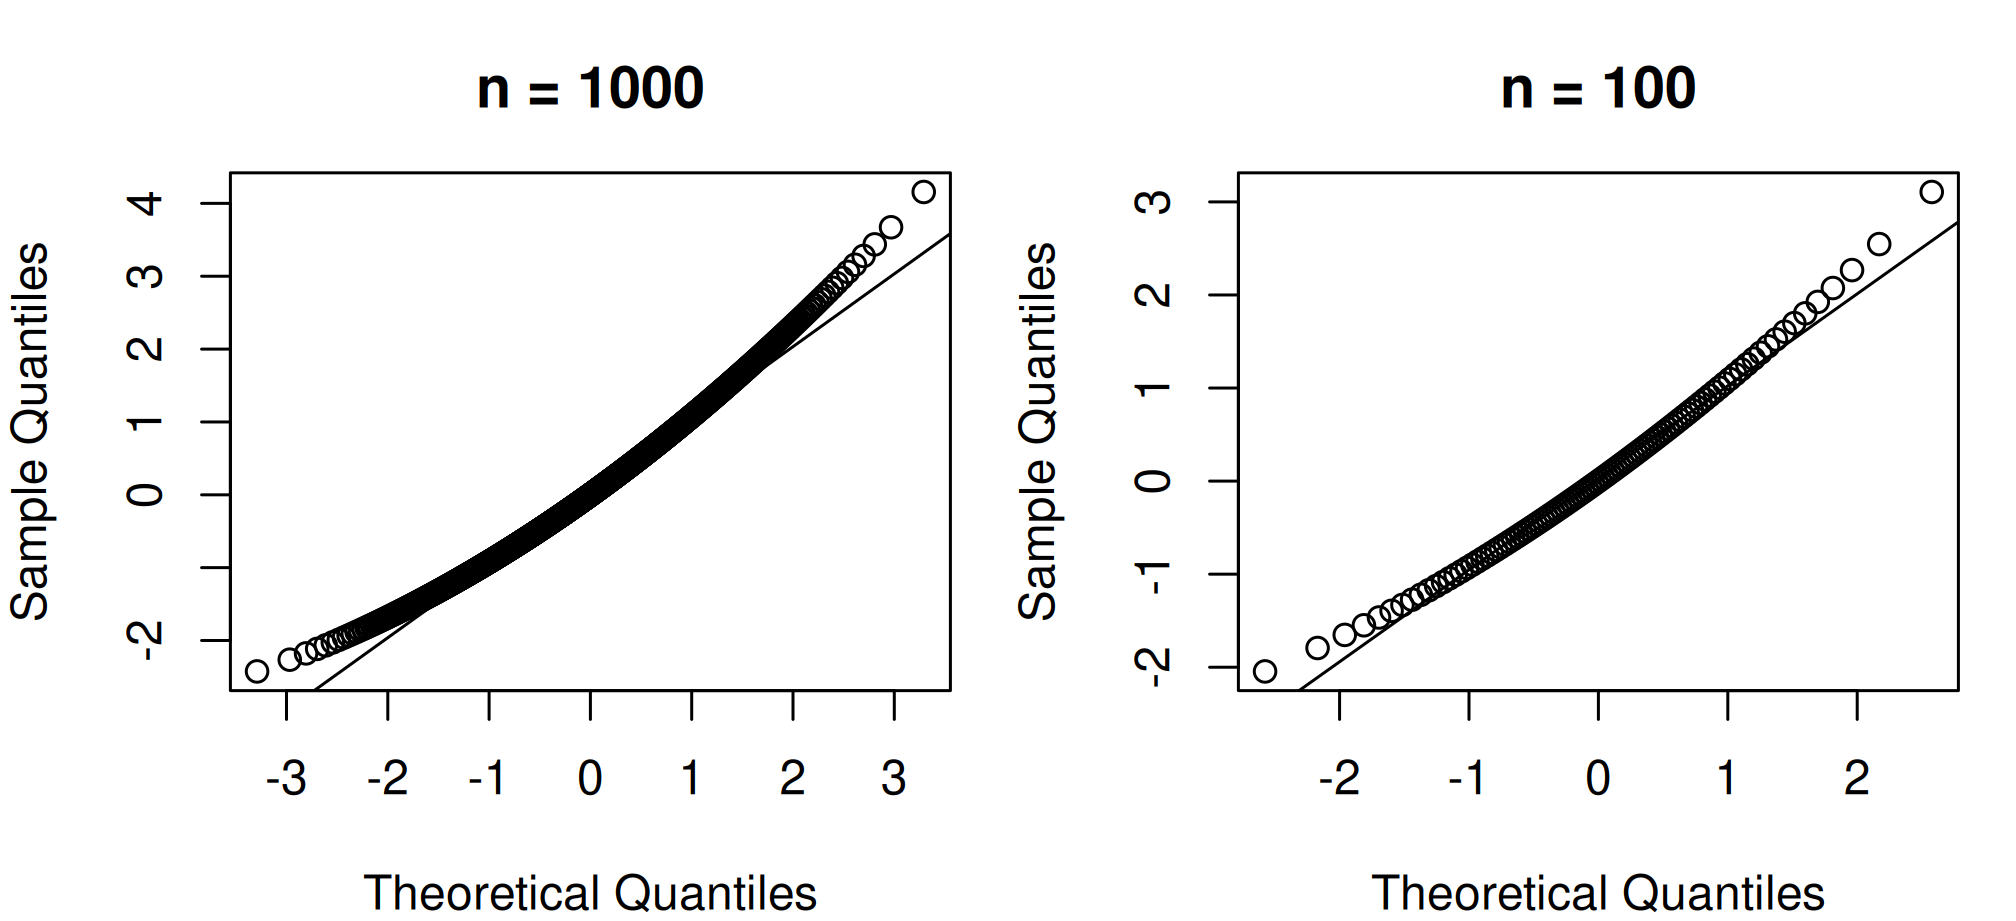
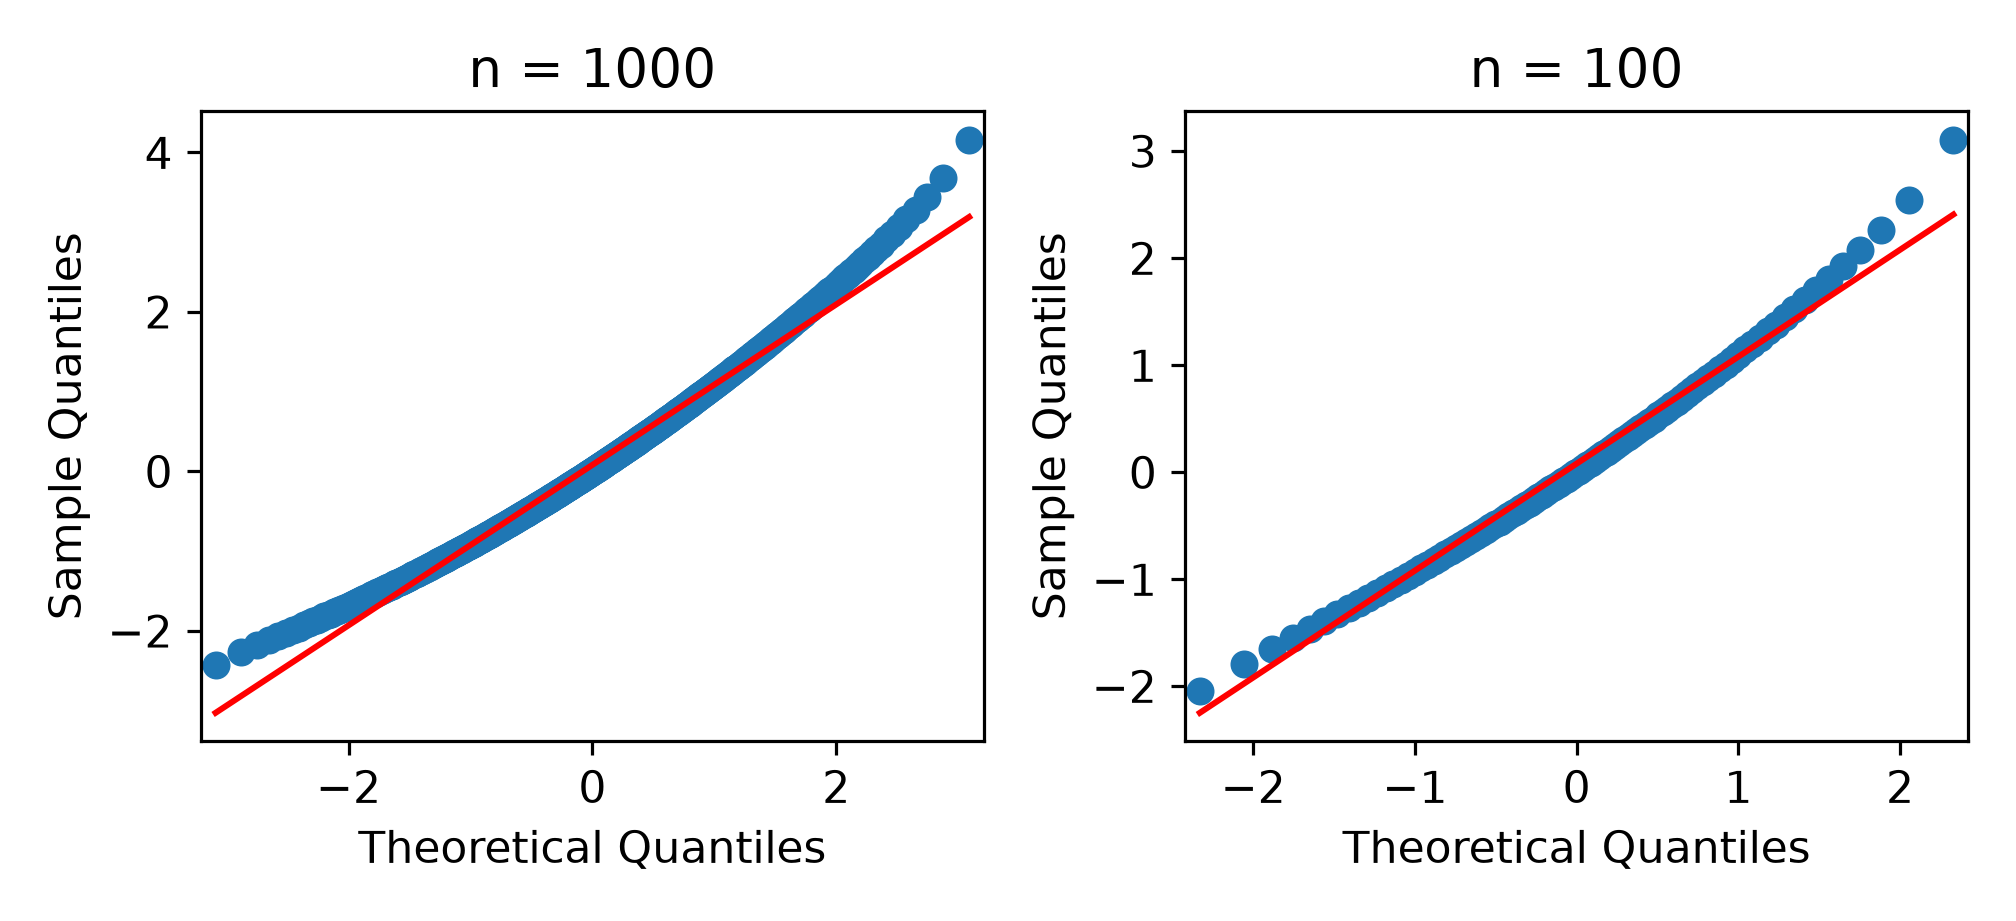
Tausend Werte mit einer leichten Rechtsschiefe. Die Schiefe beträgt 0.47 und ist damit so klein, dass sie für jedes übliche Verfahren belanglos wäre. Zusätzlich werden dieselben hundert Werte, also derselbe Verteilungstyp bei kleinerem Umfang, mitgerechnet.
Identisch. Beide Datensätze folgen exakt derselben Verteilungsform.
Shapiro W
0.9875
0.9881
Ebenfalls praktisch identisch. W misst die Abweichung und hängt kaum am Umfang.
Shapiro p-value
0.00000016
0.516
Und hier gehen sie auseinander: hochsignifikant gegen völlig unauffällig. Der Unterschied liegt allein am Stichprobenumfang.
Kolmogorow-Smirnow p-value (n = 1000)
0.250 in R, 0.245 in Python
Derselbe Datensatz, ein anderer Test, ein gegenteiliges Ergebnis. Die winzige Abweichung zwischen den Sprachen ruehrt daher, dass R die geschaetzten Parameter uebergeben bekommt und Python auf standardisierten Werten rechnet.
Zwei Lehren stecken darin.
Erstens entscheidet der Umfang, nicht die Verteilung. Dieselbe leichte Schiefe führt bei 1000 Werten zur Ablehnung und bei 100 Werten nicht. Wer die Verfahrenswahl an den p-Wert bindet, bindet sie in Wahrheit an den Umfang und ausgerechnet bei n = 1000 ist die Verteilungsform für einen t-Test völlig belanglos, weil der zentrale Grenzwertsatz längst greift.
Zweitens ist der Kolmogorow-Smirnow-Test in dieser Form zu schwach. Er schätzt Mittelwert und Streuung aus denselben Daten, für die er dann prüft, und passt sich der Verteilung damit teilweise an. Sein p-Wert von rund 0.25 ist kein Gegenbeweis zu Shapiro, sondern ein Zeichen mangelnder Schärfe. Wer KS verwendet, braucht die Lilliefors-Korrektur; einfacher ist es, Shapiro-Wilk zu nehmen.
Interpretation
Der QQ-Plot zeigt in beiden Fällen dasselbe Bild: eine leichte Krümmung an den Enden, die auf die Rechtsschiefe hinweist. Diese Darstellung ist umfangsunabhängig und beantwortet die Frage, um die es geht: wie stark weicht die Verteilung ab.
Die Werte weichen leicht von der Normalverteilung ab (Schiefe 0.47). Bei n = 1000 wird diese Abweichung vom Shapiro-Wilk-Test erkannt (W = 0.99, p < 0.001), bei n = 100 nicht (p = 0.52). Für die geplante Auswertung ist die Abweichung ohne Belang, weil der Mittelwert bei diesem Umfang praktisch normalverteilt ist.
Frage und Datenlage
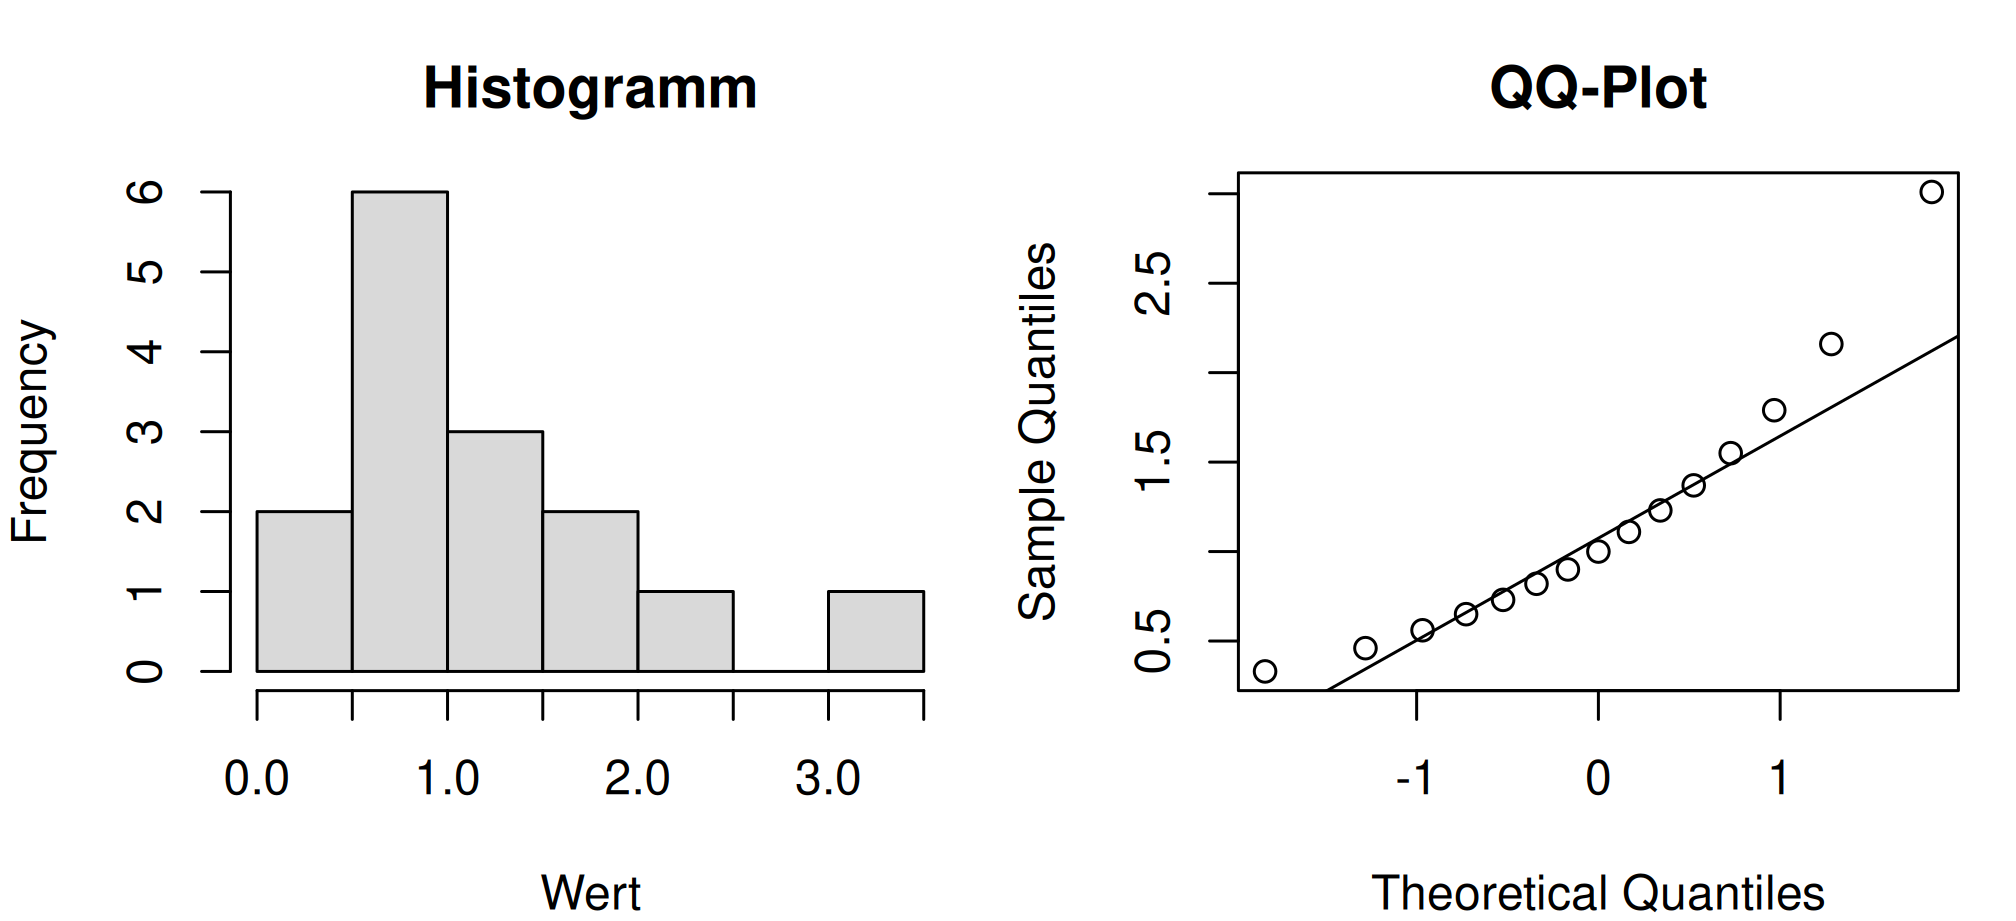
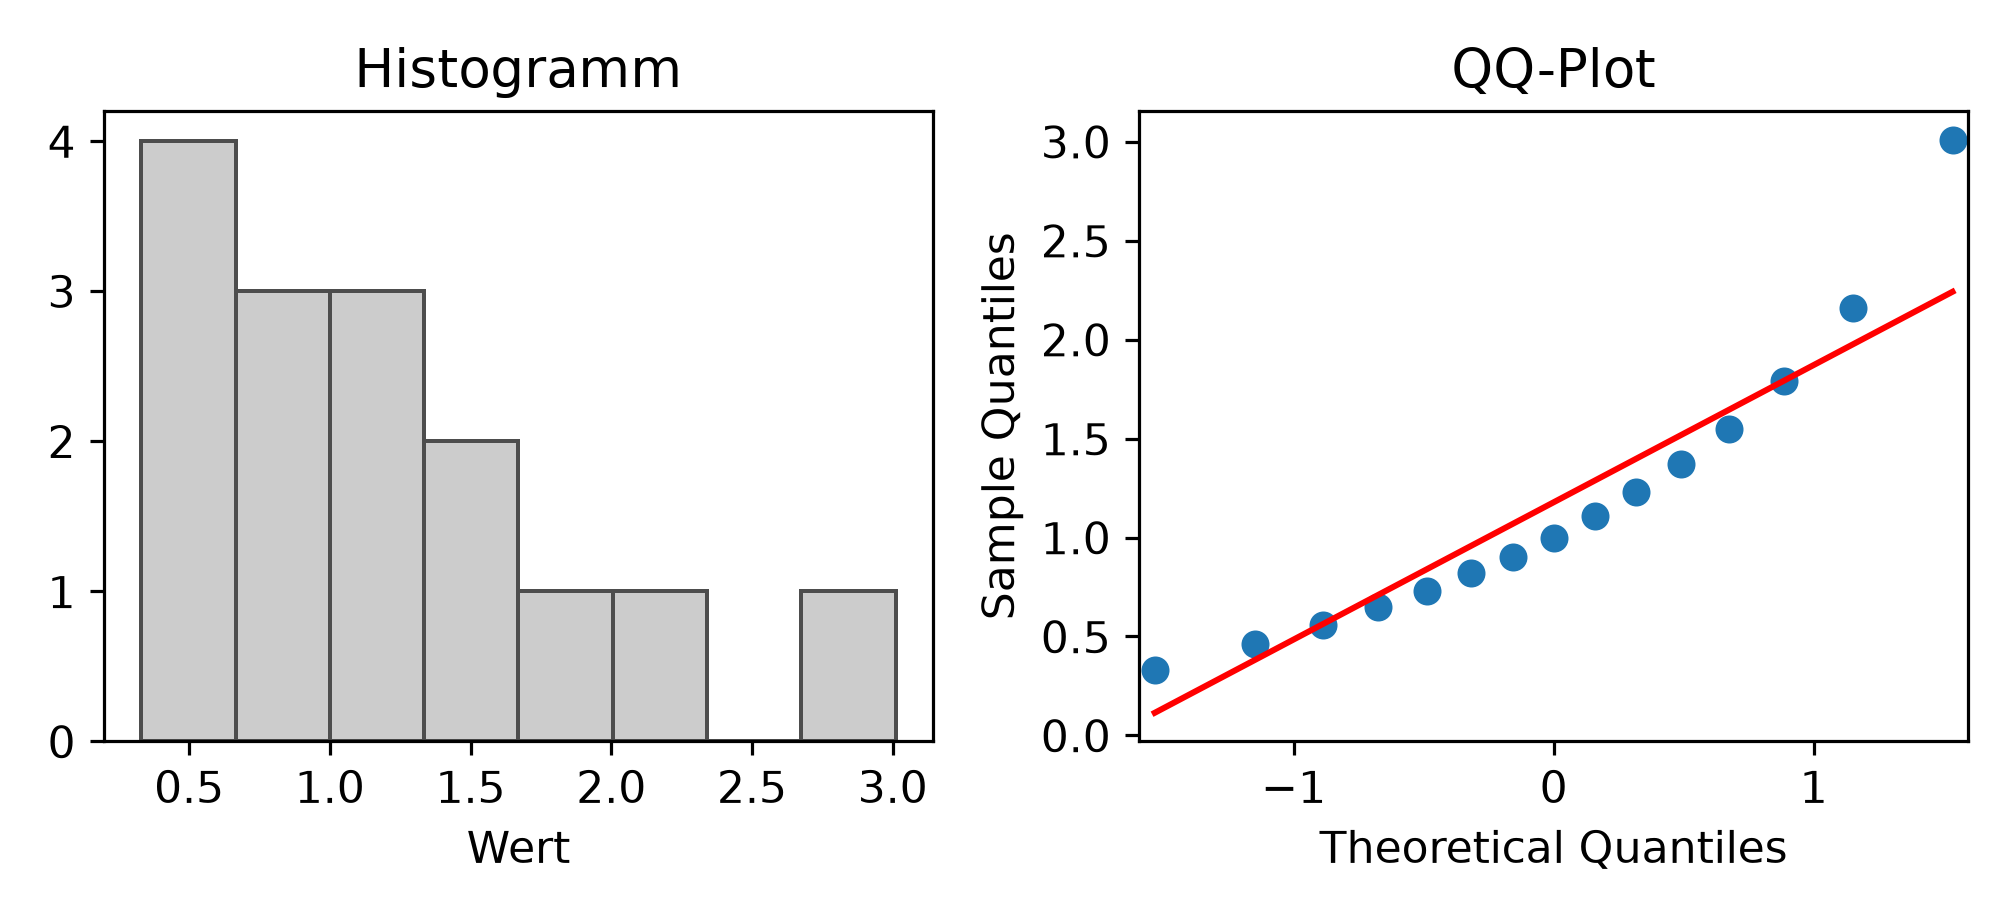
Fünfzehn Werte aus einer deutlich rechtsschiefen Verteilung. Die Schiefe beträgt 1.31 und ist damit fast dreimal so gross wie in Beispiel 2. Ausgerechnet hier, bei kleinem Umfang, wäre sie inhaltlich wichtig.
print("Mittelwert =", round(rechtsschief.mean(), 3)," Median =", round(np.median(rechtsschief), 3))
Mittelwert = 1.178 Median = 1.0
Output Zeile für Zeile
Ausgabe
Wert hier
Wie er zu lesen ist
Schiefe
+1.31
Deutlich rechtsschief, fast dreimal so stark wie in Beispiel 2.
Shapiro W
0.9018
Merklich unter 1, also durchaus eine Abweichung.
Shapiro p-value
0.101
Nicht signifikant. Bei fünfzehn Werten reicht die Power nicht, um selbst diese deutliche Schiefe nachzuweisen.
Mittelwert und Median
1.18 und 1.00
Sie klaffen um rund 18 Prozent auseinander. Das ist der schnellste Hinweis auf Schiefe und braucht keinen Test.
QQ-Plot
deutlicher Bogen
Die Punkte biegen am oberen Ende klar von der Geraden weg. Das Auge sieht, was der Test nicht findet.
Wer der Entscheidungsregel “p über 0.05, also t-Test” folgt, würde hier einen Mittelwertvergleich rechnen, bei fünfzehn deutlich schiefen Werten, also genau in der Lage, in der er unzuverlässig ist. Das ist der Kern des Problems: Der Test versagt dort, wo man ihn am dringendsten bräuchte.
Interpretation
Die Verteilung ist deutlich rechtsschief (Schiefe 1.31; Mittelwert 1.18 gegenüber Median 1.00), was im QQ-Plot und im Histogramm klar erkennbar ist. Der Shapiro-Wilk-Test wird bei n = 15 nicht signifikant (W = 0.90, p = 0.10), was allein an der geringen Power liegt. Die Auswertung erfolgt deshalb rangbasiert.
Frage und Datenlage
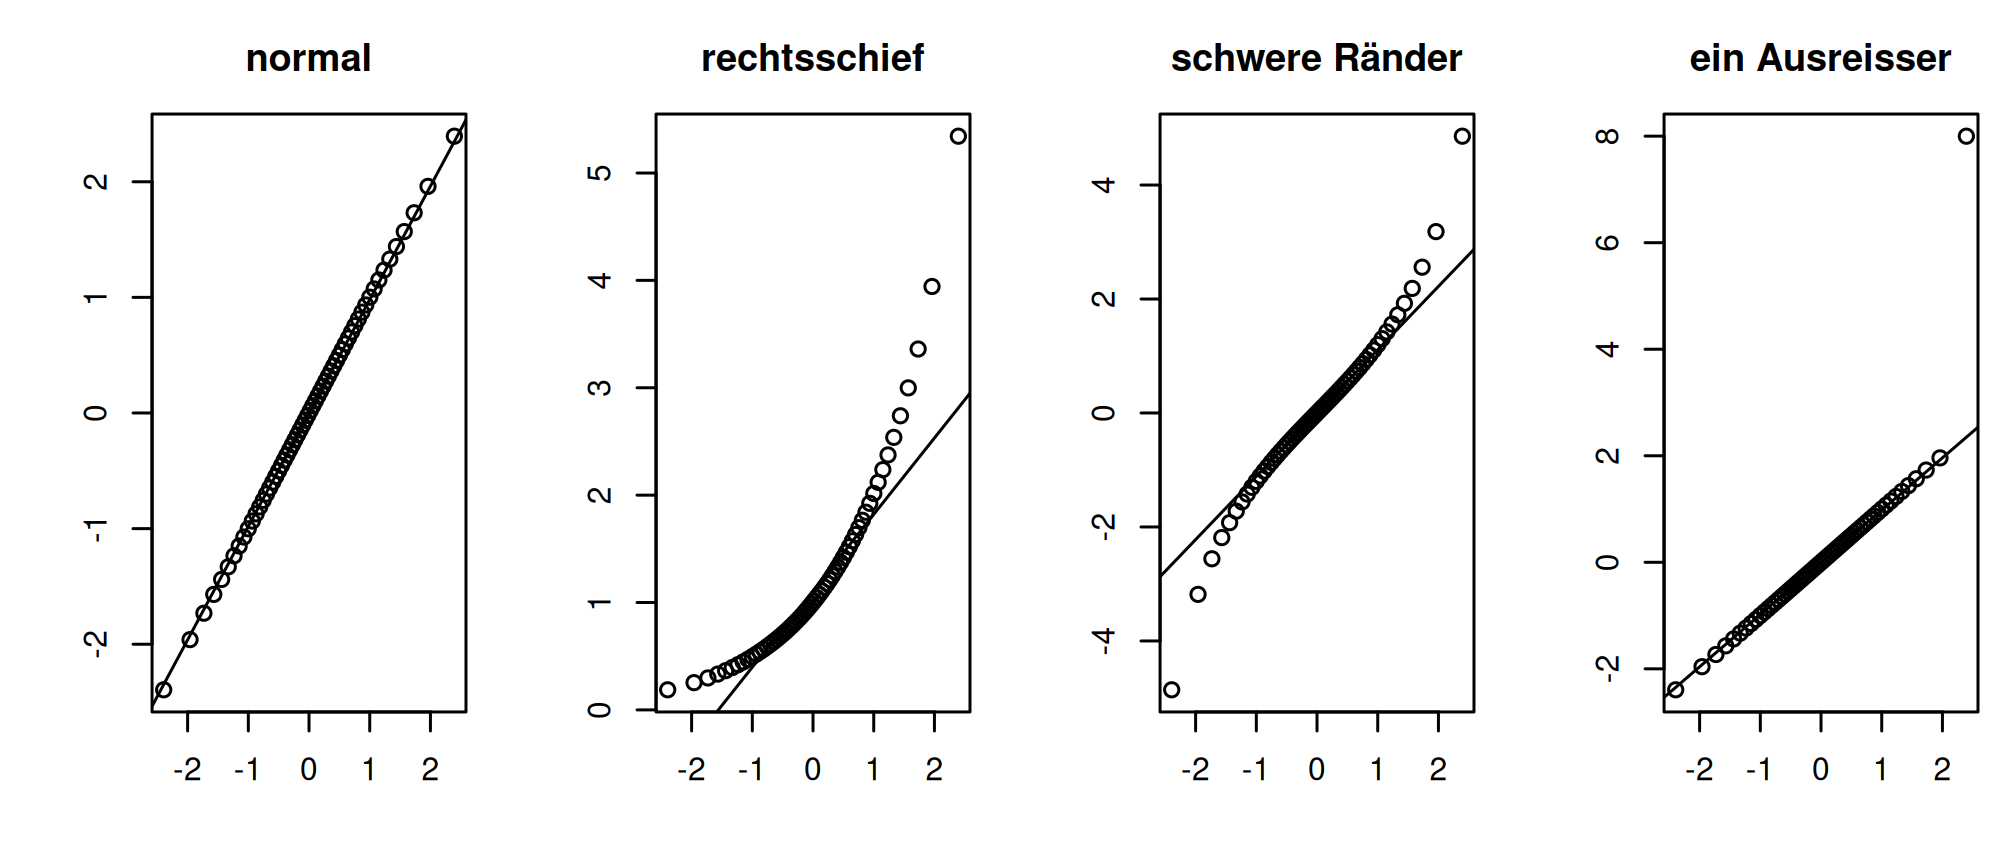
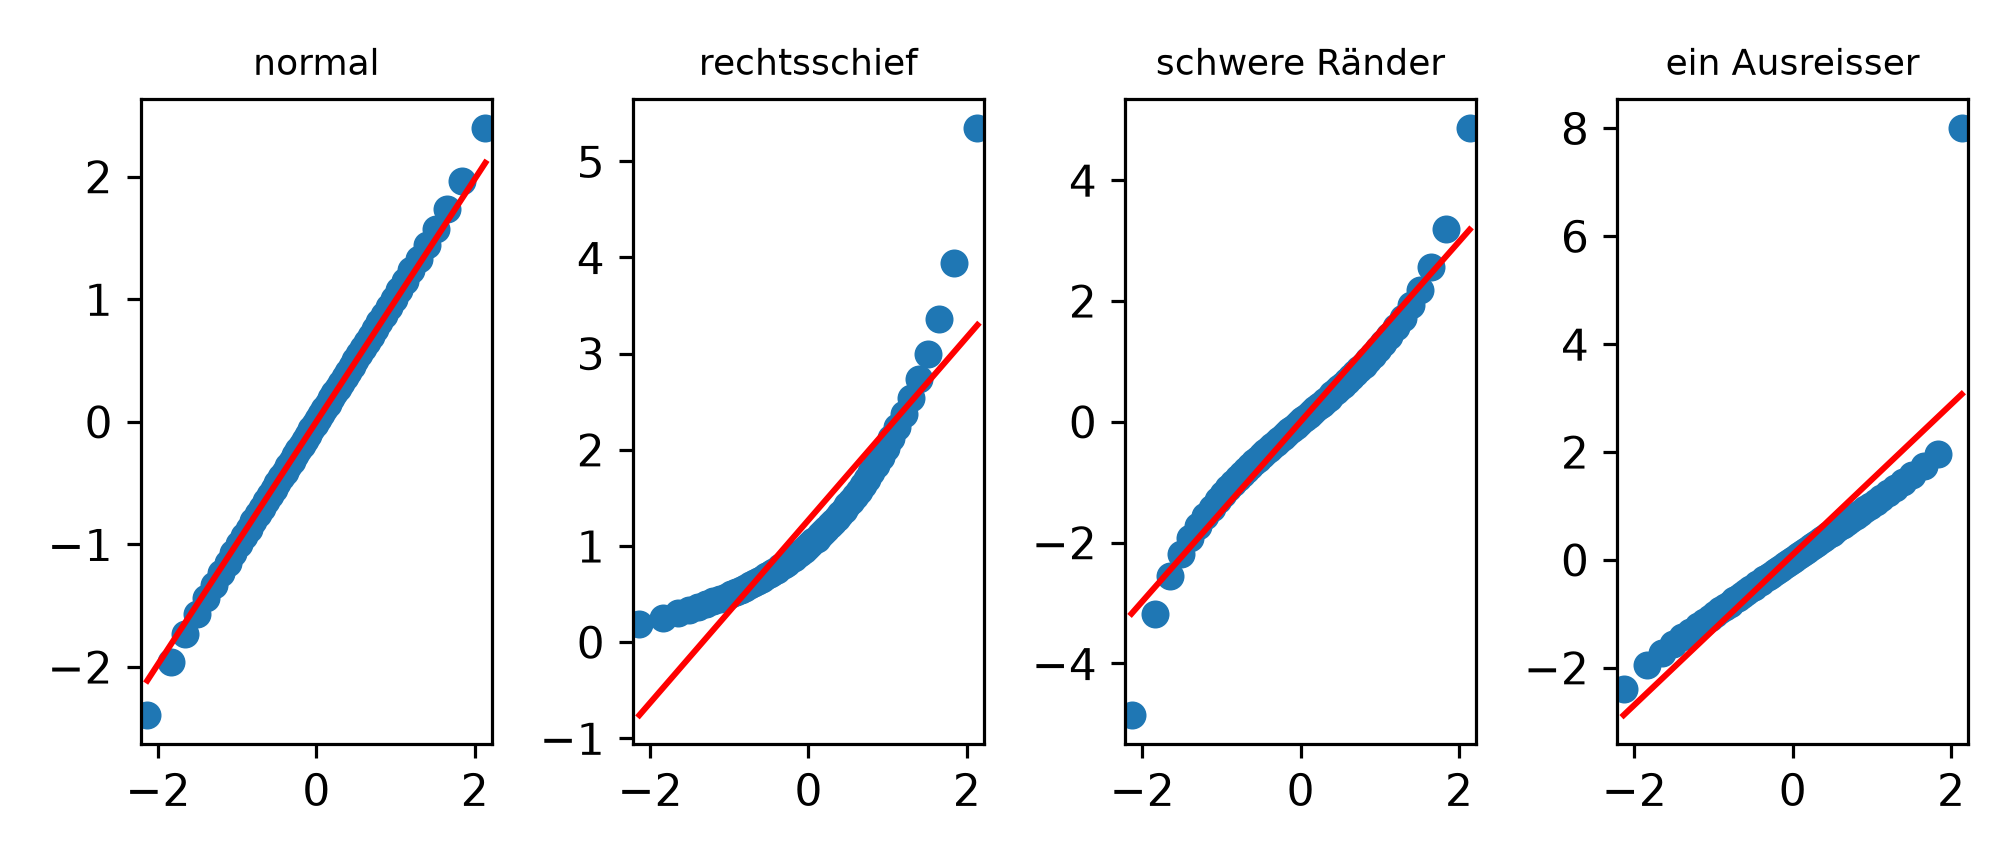
Vier Datensätze mit je sechzig Werten. Alle vier würde ein Normalitätstest mit einer einzigen Zahl beantworten. Der QQ-Plot beantwortet stattdessen die Frage, die weiterhilft: wie weicht die Verteilung ab?
Abbildung 8: Beispiel 4: dieselben vier Muster in Python.
for name, werte in muster.items():print(f"{name:16s} Shapiro p = {stats.shapiro(werte).pvalue:.5f}")
normal           Shapiro p = 1.00000
rechtsschief     Shapiro p = 0.00000
schwere Ränder   Shapiro p = 0.08801
ein Ausreisser   Shapiro p = 0.00000
Output Zeile für Zeile
Muster
Shapiro p
Bild im QQ-Plot
Was daraus folgt
normal
1.000
Punkte liegen auf der Geraden
Nichts zu tun.
rechtsschief
< 0.001
Punkte biegen am oberen Ende nach oben weg, unten liegen sie über der Geraden
Der Mittelwert beschreibt keinen typischen Fall. Logarithmieren oder rangbasiert vergleichen.
schwere Ränder
0.088
S-förmiger Verlauf: unten unter, oben über der Geraden
Extremwerte sind häufiger als bei einer Normalverteilung. Der t-Test verliert Schärfe; robuste Verfahren helfen.
ein Ausreisser
< 0.001
Punkte liegen auf der Geraden, ein einzelner weit rechts oben
Kein Verteilungsproblem, sondern ein Einzelfall. Ihn zu prüfen ist sinnvoller, als das Verfahren zu wechseln.
Die p-Werte fallen ausgerechnet dort verkehrt herum aus, wo es darauf ankommt.
Bei den schweren Rändern schlägt der Test nicht an (p = 0.088), obwohl genau diese Lage dem t-Test tatsächlich Schärfe kostet. Beim einzelnen Ausreisser schlägt er deutlich an (p < 0.001), obwohl hier ein Verfahrenswechsel die falsche Reaktion wäre: Das Problem ist eine Beobachtung, keine Verteilungsform. Wer der Regel “p klein, also Rangtest” folgt, wechselt also im falschen Fall das Verfahren und behält es im richtigen bei.
Der QQ-Plot unterscheidet die vier Lagen dagegen auf einen Blick, und jede verlangt eine andere Reaktion.
Der p-Wert von 1.000 im ersten Muster ist ein Nebeneffekt der Konstruktion: Die Daten sind exakt die Quantile der Normalverteilung, also normalverteilter als jede echte Stichprobe je sein könnte. In erhobenen Daten kommt ein solcher Wert nicht vor.
Interpretation
Genau deshalb steht auf den Methodenseiten dieser Sammlung durchgehend der QQ-Plot in der Voraussetzungsprüfung und nicht ein Normalitätstest. Der Plot kostet dieselbe Zeile Code und beantwortet die nützlichere Frage.
Verständnisfragen
Bei n = 1000 liefert Shapiro-Wilk p < 0.001, der QQ-Plot zeigt eine leichte Krümmung an den Enden. Was folgt für einen geplanten t-Test?
Nichts; bei diesem Umfang ist der Mittelwert praktisch normalverteilt
Richtig. Der zentrale Grenzwertsatz greift, und der t-Test setzt die Normalverteilung des Mittelwerts voraus, nicht die der Rohdaten. Der signifikante Test spiegelt vor allem den Umfang wider.
Der t-Test ist unzulässig, es muss rangbasiert getestet werden
Das wäre der Wechsel des Verfahrens aufgrund einer Zahl, die hier gerade keine inhaltliche Aussage trägt.
Die Daten müssen transformiert werden
Eine Transformation ändert die Fragestellung; sie ist bei starker Schiefe sinnvoll, nicht bei einer Abweichung dieser Grössenordnung.
Ein Shapiro-Test bei n = 15 liefert p = 0.10. Was ist die zulässige Aussage?
Die Daten sprechen nicht gegen eine Normalverteilung, mehr nicht
Richtig. Bei fünfzehn Werten hätte der Test selbst eine deutliche Schiefe wahrscheinlich nicht gefunden, wie Beispiel 3 zeigt. Ein grosser p-Wert ist kein Nachweis.
Die Daten sind normalverteilt
Eine Nullhypothese wird nie bewiesen, schon gar nicht mit geringer Power.
Die Daten sind nicht normalverteilt, p liegt nahe 0.05
Die Nähe zur Schwelle ist keine Zwischenkategorie.
Derselbe Datensatz liefert bei Shapiro-Wilk p < 0.001 und bei Kolmogorow-Smirnow p = 0.25. Wie ist das zu deuten?
Der KS-Test ist in dieser Form deutlich schwächer
Richtig. Er schätzt Mittelwert und Streuung aus denselben Daten, für die er prüft, und passt sich der Verteilung damit teilweise an. Ohne Lilliefors-Korrektur ist er zu konservativ.
Die beiden Tests prüfen verschiedene Verteilungen
Beide prüfen gegen die Normalverteilung.
Der grössere p-Wert ist der verlässlichere
Die Wahl nach dem angenehmeren Ergebnis ist keine Begründung.
Warum steht auf den Methodenseiten dieser Sammlung der QQ-Plot und nicht ein Normalitätstest in der Voraussetzungsprüfung?
Weil er zeigt, wie die Verteilung abweicht, und nicht nur, dass sie es tut
Richtig. Rechtsschiefe, schwere Ränder und ein einzelner Ausreisser erfordern drei verschiedene Reaktionen, und der p-Wert unterscheidet sie nicht.
Weil Normalitätstests unzuverlässig rechnen
Sie rechnen korrekt; das Problem liegt in der Fragestellung und in der Abhängigkeit vom Umfang.
Weil der QQ-Plot objektiver ist
Er verlangt im Gegenteil eine Beurteilung durch den Betrachter. Sein Vorteil ist der Informationsgehalt, nicht die Objektivität.