Normalverteilung und zentraler Grenzwertsatz

Verteilungen
Wahrscheinlichkeit
Interpretation
R
Python
Warum so viele Verfahren auf der Normalverteilung aufbauen.

Kernideen

  • Der zentrale Grenzwertsatz erklärt die Sonderrolle der Normalverteilung: Mittelwerte vieler unabhängiger Einflüsse werden normal, ganz gleich wie die Einzelwerte verteilt sind.
  • Nicht die Daten müssen normalverteilt sein, sondern die Schätzung.
  • Wie schnell die Annäherung gelingt, hängt von der Schiefe der Ausgangsverteilung ab, die Faustregel “\(n > 30\)” ist keine Konstante.
  • Die Streuung des Mittelwerts sinkt mit \(\sigma/\sqrt{n}\), nicht mit \(\sigma/n\).
  • Standardisierung übersetzt jeden Wert in Standardabweichungen und macht Verteilungen vergleichbar.
  • Die Faustregeln 68, 95 und 99.7 Prozent gelten nur für die Normalverteilung.

Erklärung

Vorwissen: stetige Verteilungen für Dichte und Verteilungsfunktion. Diese Seite ist die Grundlage für Konfidenzintervalle und alle Verfahren, die auf Mittelwerten beruhen. Wie sich Normalität grafisch prüfen lässt, steht unter QQ-Plots.

Der zentrale Grenzwertsatz

Summen und Mittelwerte vieler unabhängiger Einflüsse nähern sich einer Normalverteilung an, unabhängig davon, wie die einzelnen Grössen selbst verteilt sind. Genauer:

\[\bar{X}_n \approx \mathcal{N}\!\left(\mu,\ \frac{\sigma^2}{n}\right) \quad \text{für grosses } n\]

Drei Aussagen stecken darin, und alle drei werden gebraucht:

Aussage Bedeutung
die Form wird normal unabhängig von der Ausgangsverteilung
der Erwartungswert bleibt \(\mu\) der Mittelwert ist erwartungstreu
die Streuung wird \(\sigma/\sqrt{n}\) der Standardfehler

Ein häufiges Missverständnis: Der Satz sagt nichts darüber, dass die Ausgangsdaten normalverteilt würden. Normal wird die Verteilung der Mittelwerte, und zwar über gedachte Wiederholungen der Stichprobenziehung.

Deshalb lautet die Voraussetzung vieler Verfahren nicht “die Daten sind normalverteilt”, sondern “die Schätzung ist annähernd normalverteilt” und die zweite Bedingung ist viel leichter erfüllt als die erste.

Voraussetzungen, die man kennen muss

Der Satz gilt nicht immer:

Voraussetzung Was passiert ohne sie
unabhängige Beobachtungen Bei Abhängigkeit sinkt die effektive Stichprobengrösse; der Standardfehler ist zu klein.
endliche Varianz Bei Verteilungen ohne endliche Varianz (Cauchy) gilt der Satz nicht, der Mittelwert wird nicht genauer.
genügend grosses \(n\) Wie gross, hängt von der Schiefe ab. Bei symmetrischen Verteilungen genügen wenige Beobachtungen, bei stark schiefen braucht es hunderte.

Standardisierung und z-Werte

Verschiedene Merkmale haben verschiedene Einheiten und Grössenordnungen. Die Standardisierung übersetzt jeden Wert in die Anzahl Standardabweichungen, um die er vom Mittel abweicht:

\[z = \frac{x - \mu}{\sigma}\]

Danach hat jede Verteilung den Erwartungswert 0 und die Standardabweichung 1. Die Form ändert sich dabei nicht, eine schiefe Verteilung bleibt schief.

Die Faustregeln

Bereich Anteil bei Normalverteilung
\(\mu \pm 1\sigma\) 68.3 %
\(\mu \pm 2\sigma\) 95.4 %
\(\mu \pm 3\sigma\) 99.7 %

Diese Zahlen sind Eigenschaften der Normalverteilung, keine allgemeinen Regeln. Beispiel 4 zeigt, wie weit sie bei anderen Verteilungen danebenliegen.

Beispiele

Frage und Datenlage

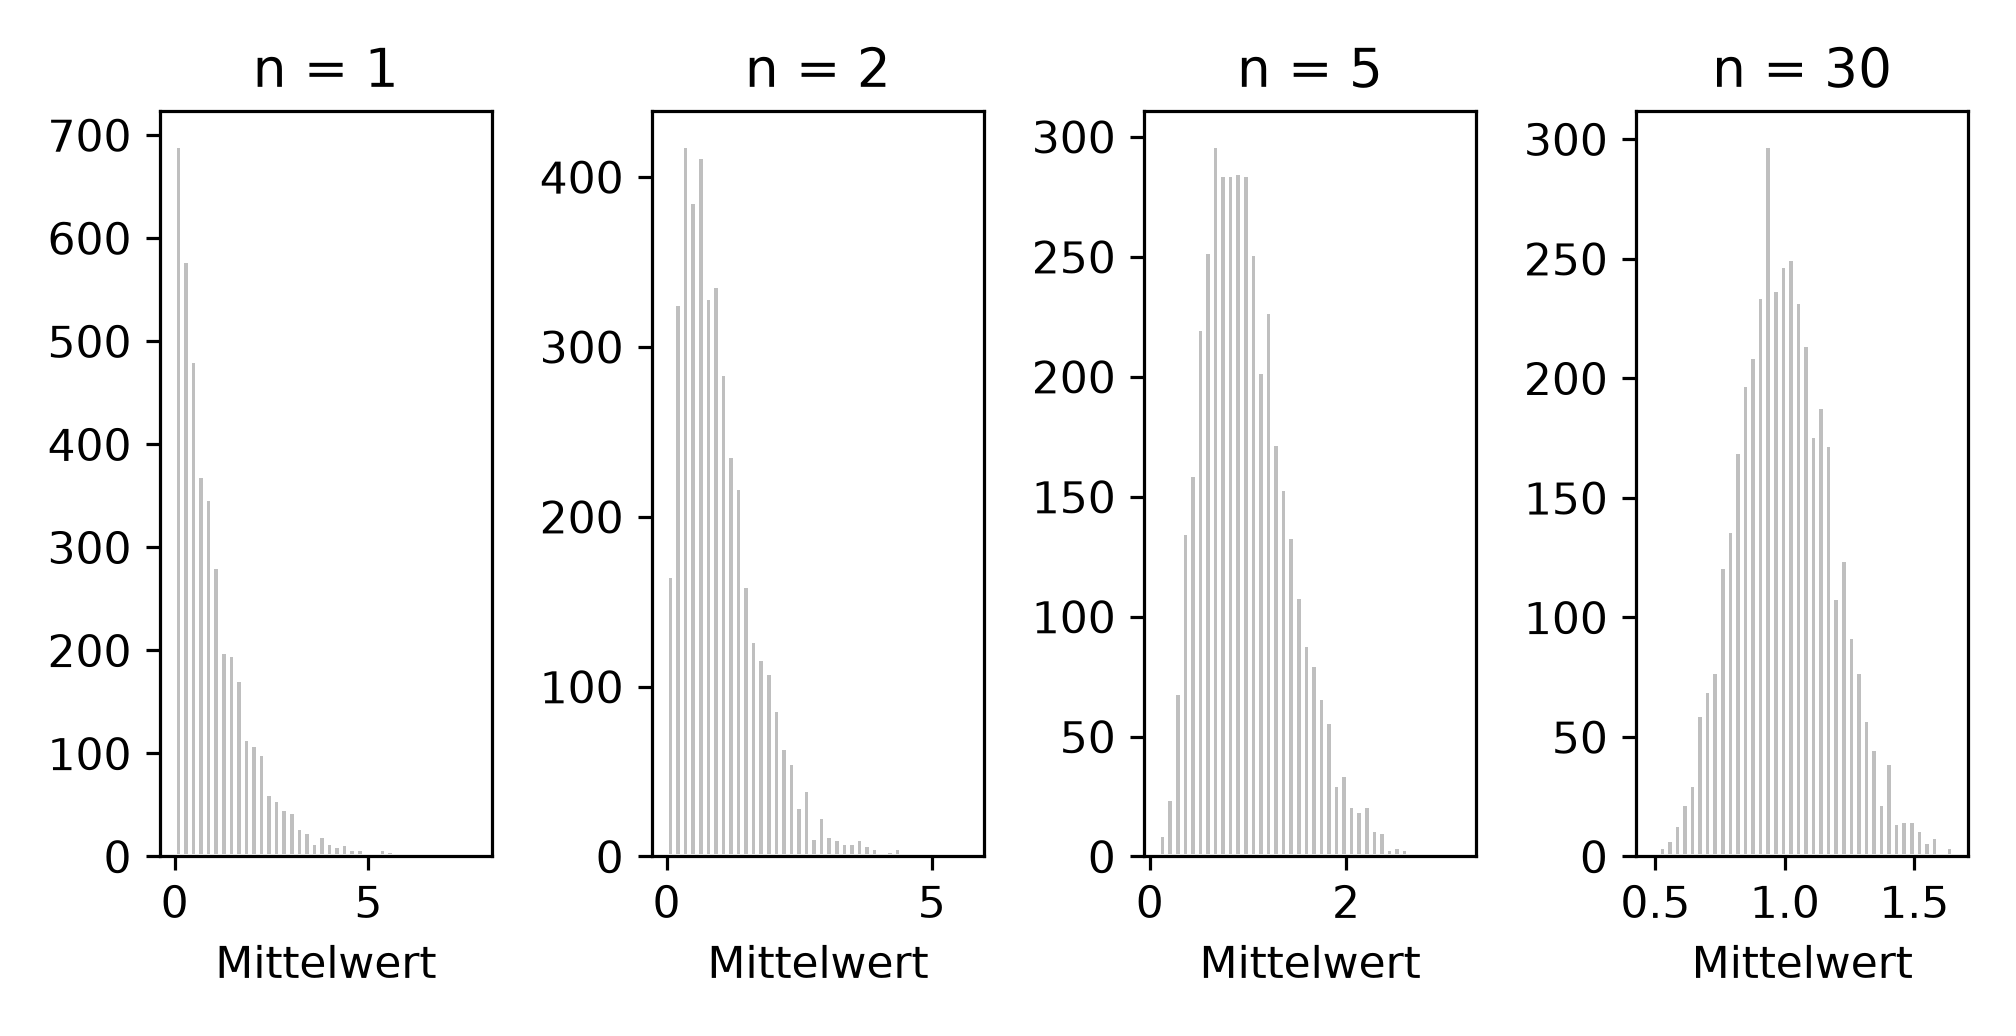
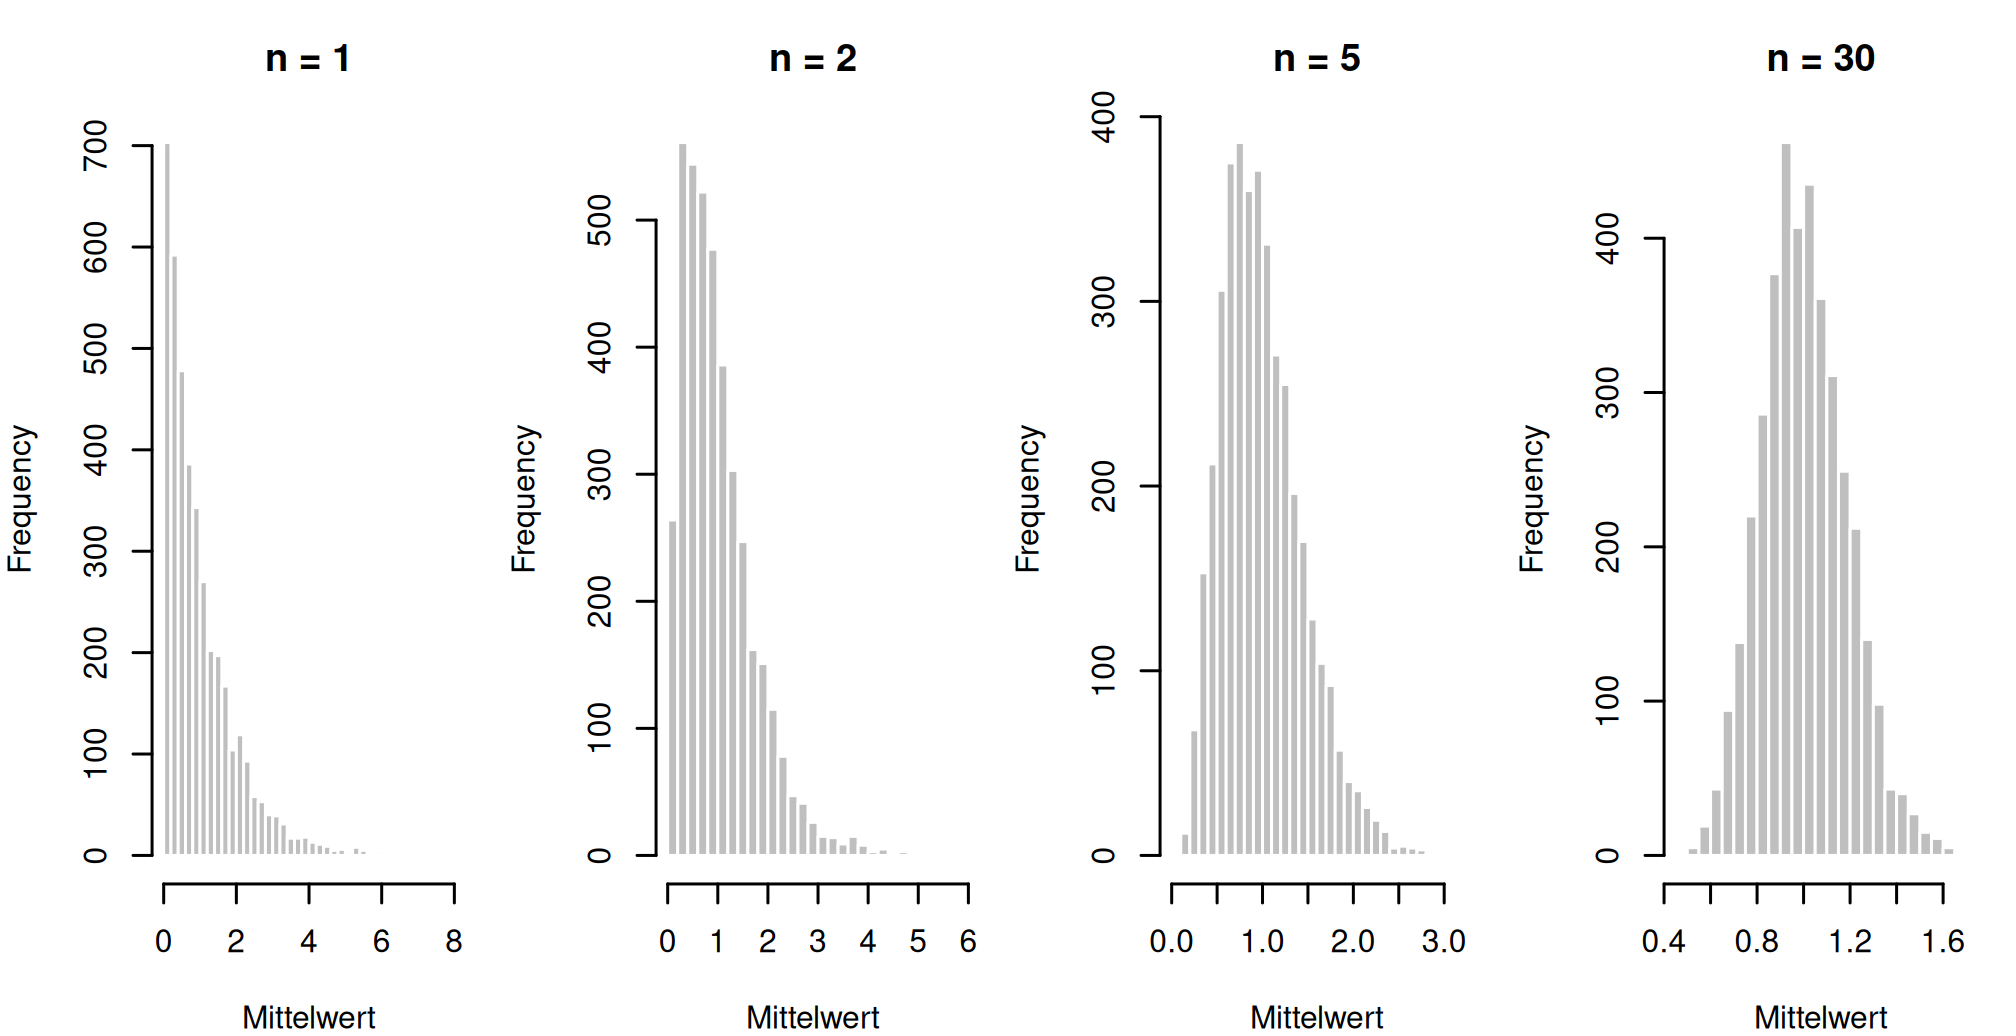
Eine Exponentialverteilung ist stark rechtsschief, so unnormal wie möglich. Was passiert mit den Mittelwerten, wenn man je 1, 2, 5 und 30 solcher Werte mittelt? Je 4 000 Wiederholungen.

Rechnung

par(mfrow = c(1, 4), mar = c(4, 4, 3, 1))
for (n in c(1, 2, 5, 30)) {
  m <- rowMeans(matrix(exp_werte(1010 + n, B * n), nrow = B, byrow = TRUE))
  hist(m, breaks = 40, col = "grey75", border = "white",
       main = paste("n =", n), xlab = "Mittelwert")
}
par(mfrow = c(1, 1))

for (n in c(1, 2, 5, 30)) {
  m <- rowMeans(matrix(exp_werte(1010 + n, B * n), nrow = B, byrow = TRUE))
  cat(sprintf("n = %2d | Mittel %.4f | SD %.4f | erwartet %.4f | Schiefe %.4f\n",
              n, mean(m), sd(m), 1 / sqrt(n), schiefe(m)))
}
n =  1 | Mittel 1.0080 | SD 0.9907 | erwartet 1.0000 | Schiefe 1.9242
n =  2 | Mittel 1.0027 | SD 0.7266 | erwartet 0.7071 | Schiefe 1.4500
n =  5 | Mittel 0.9966 | SD 0.4428 | erwartet 0.4472 | Schiefe 0.7792
n = 30 | Mittel 1.0040 | SD 0.1837 | erwartet 0.1826 | Schiefe 0.3082
Abbildung 1: Beispiel 1: von der schiefen Ausgangsverteilung zur Glocke, in vier Schritten.
fig, achsen = plt.subplots(1, 4, figsize=(7, 3.6))
for achse, n in zip(achsen, [1, 2, 5, 30]):
    m = exp_werte(1010 + n, B * n).reshape(B, n).mean(axis=1)
    achse.hist(m, bins=40, color="0.75", edgecolor="white")
    achse.set_title(f"n = {n}")
    achse.set_xlabel("Mittelwert")
plt.tight_layout()
plt.show()
Abbildung 2: Beispiel 1: dieselben vier Schritte in Python.
for n in [1, 2, 5, 30]:
    m = exp_werte(1010 + n, B * n).reshape(B, n).mean(axis=1)
    print(f"n = {n:2d} | Mittel {m.mean():.4f} | SD {m.std(ddof=1):.4f}"
          f" | erwartet {1 / np.sqrt(n):.4f} | Schiefe {stats.skew(m):.4f}")
n =  1 | Mittel 1.0080 | SD 0.9907 | erwartet 1.0000 | Schiefe 1.9242
n =  2 | Mittel 1.0027 | SD 0.7266 | erwartet 0.7071 | Schiefe 1.4500
n =  5 | Mittel 0.9966 | SD 0.4428 | erwartet 0.4472 | Schiefe 0.7792
n = 30 | Mittel 1.0040 | SD 0.1837 | erwartet 0.1826 | Schiefe 0.3082

Output Zeile für Zeile

n Mittelwert Streuung erwartet \(1/\sqrt{n}\) Schiefe theoretisch \(2/\sqrt{n}\)
1 1.0080 0.9907 1.0000 1.924 2.000
2 1.0027 0.7266 0.7071 1.450 1.414
5 0.9966 0.4428 0.4472 0.779 0.894
30 1.0040 0.1837 0.1826 0.308 0.365
Beobachtung Erklärung
Der Mittelwert bleibt bei 1.00 Bei jedem n. Der Mittelwert ist erwartungstreu, Mitteln verschiebt nichts.
Die Streuung folgt \(1/\sqrt{n}\) 0.99, 0.73, 0.44, 0.18 gegen 1.00, 0.71, 0.45, 0.18. Die Übereinstimmung ist der ganze zweite Teil des Satzes.
Die Schiefe halbiert sich bei Vervierfachung von n 1.92 → 0.78 von n=1 auf n=5, also \(\sqrt{5}\)-fach kleiner. Theoretisch gilt exakt \(2/\sqrt{n}\), und die Messwerte treffen das.
Bei n = 30 ist die Schiefe 0.31 Werte unter etwa 0.5 gelten als “annähernd symmetrisch”. Der Weg von 1.92 dorthin ist genau das, was der Satz behauptet.
Die Bilder zeigen es unmittelbar Bei n=1 ein abfallender Keil, bei n=30 eine Glocke mit leichter Rechtsschiefe.

Die Schiefe ist die richtige Kennzahl, um den Satz zu beobachten, besser als das blosse Ansehen der Histogramme. Sie ist null bei symmetrischen Verteilungen und misst genau das, was beim Mitteln verschwindet.

Die Formel \(\text{Schiefe}(\bar{X}_n) = \text{Schiefe}(X)/\sqrt{n}\) gilt allgemein. Sie ist auch die Antwort auf die Frage “wie gross muss n sein”: so gross, dass die Ausgangsschiefe geteilt durch \(\sqrt{n}\) klein genug ist. Beispiel 2 rechnet das für drei Ausgangsverteilungen durch.

Interpretation und Ergebnissatz

Mittelwerte aus je 30 exponentialverteilten Werten sind annähernd normalverteilt (Schiefe 0.31 gegenüber 1.92 bei den Einzelwerten). Die Streuung sinkt wie erwartet mit \(1/\sqrt{n}\) von 0.99 auf 0.18.

Frage und Datenlage

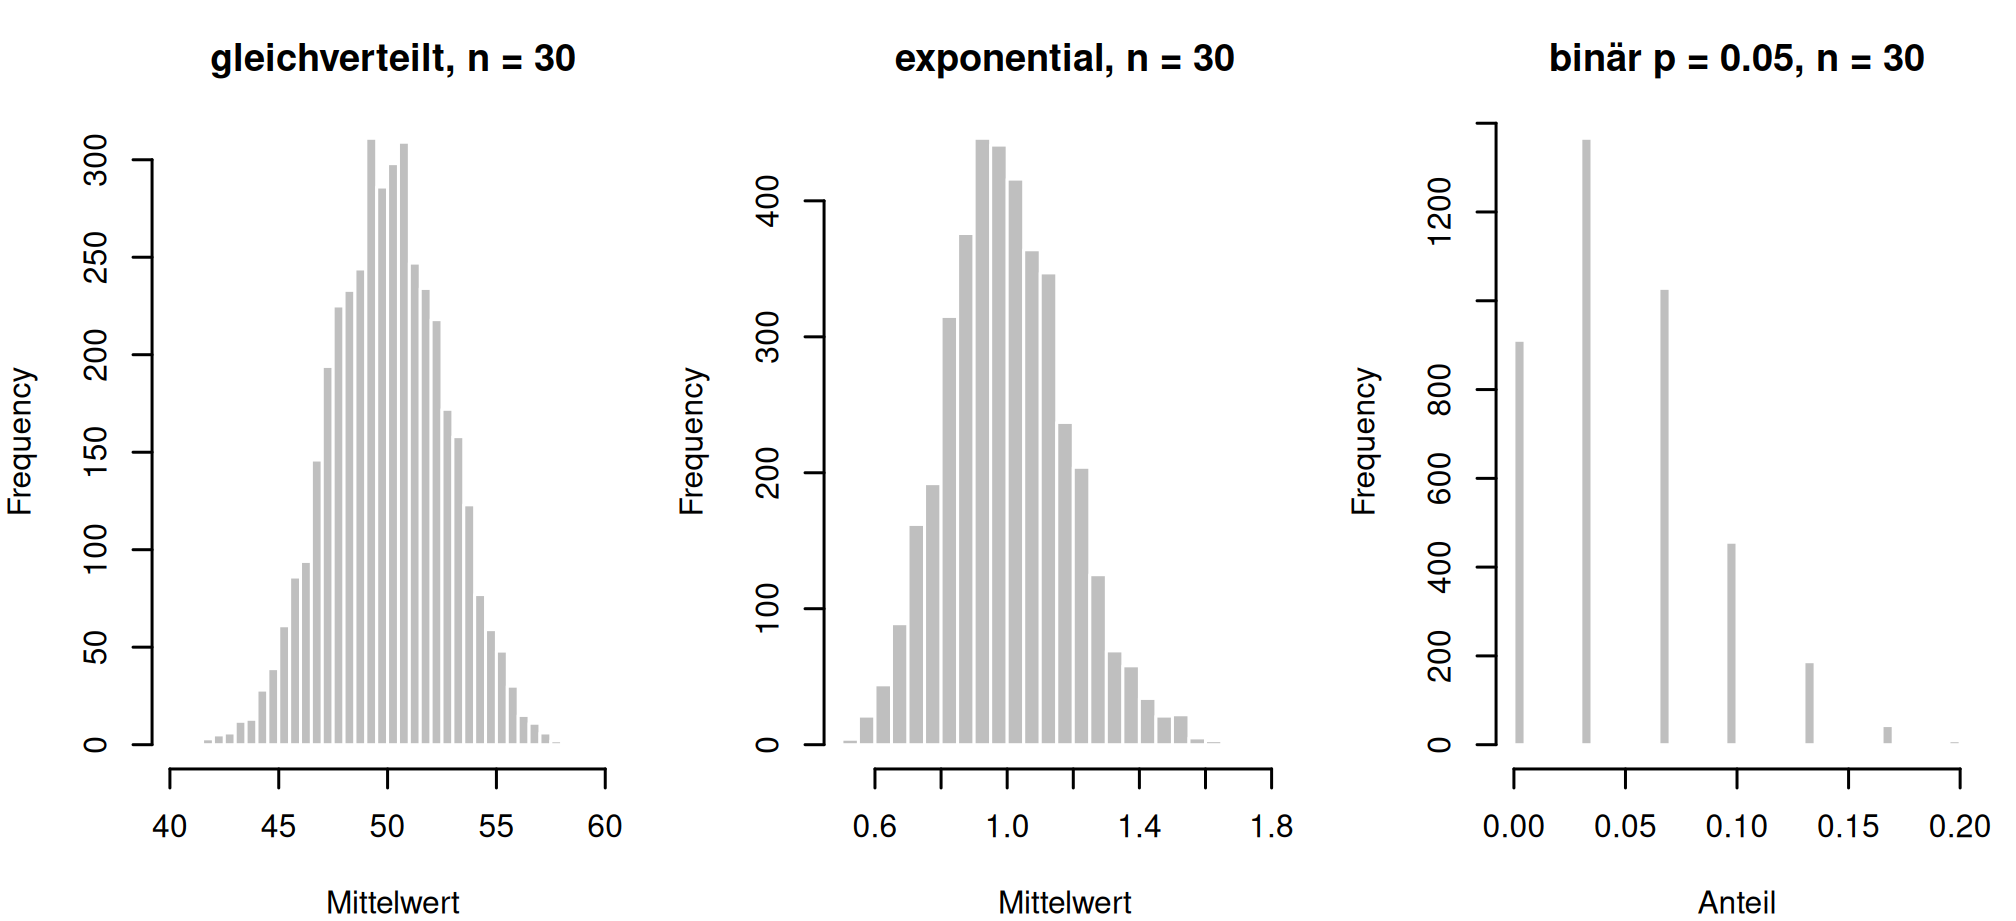
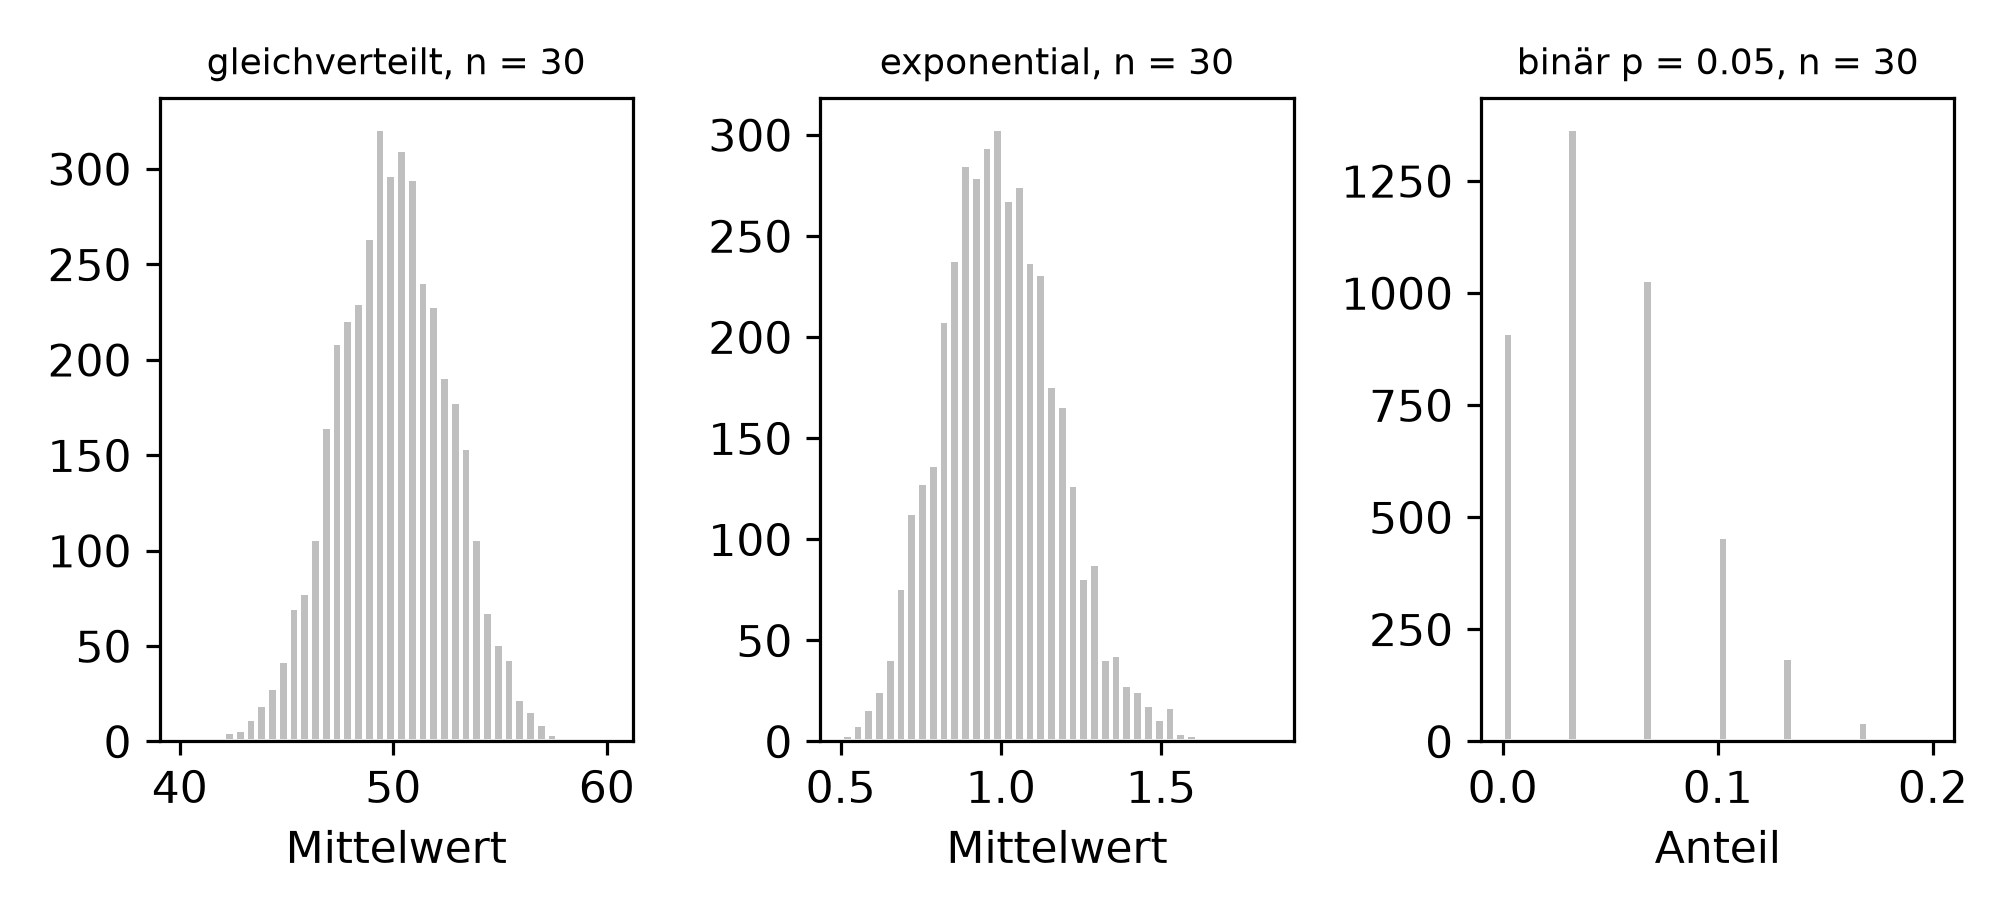
Die Faustregel “\(n > 30\)” steht in jedem Lehrbuch. Drei Ausgangsverteilungen zeigen, dass sie keine Konstante ist:

Verteilung Schiefe Beispiel
gleichverteilt 0 Messfehler mit fester Toleranz
exponential 2.0 Wartezeiten, Lebensdauern
binär mit \(p = 0.05\) 4.1 seltenes Ereignis, etwa eine Reklamationsquote

Rechnung

mittelwerte <- function(erzeuger, n, saat) {
  rowMeans(matrix(erzeuger(saat, B * n), nrow = B, byrow = TRUE))
}

gleich <- function(saat, anzahl) 25 + 50 * lehmer(saat, anzahl)
selten <- function(saat, anzahl) as.numeric(lehmer(saat, anzahl) < 0.05)

par(mfrow = c(1, 3), mar = c(4, 4, 3, 1))
hist(mittelwerte(gleich, 30, 2021), breaks = 40, col = "grey75",
     border = "white", main = "gleichverteilt, n = 30", xlab = "Mittelwert")
hist(mittelwerte(exp_werte, 30, 4070), breaks = 40, col = "grey75",
     border = "white", main = "exponential, n = 30", xlab = "Mittelwert")
hist(mittelwerte(selten, 30, 3060), breaks = 40, col = "grey75",
     border = "white", main = "binär p = 0.05, n = 30", xlab = "Anteil")
par(mfrow = c(1, 1))

cat("gleichverteilt, n =  5 : Schiefe",
    round(schiefe(mittelwerte(gleich, 5, 2021)), 4), "\n")
gleichverteilt, n =  5 : Schiefe -0.0148 
for (n in c(5, 30)) {
  cat(sprintf("exponential,   n = %2d : Schiefe %.4f (theoretisch %.4f)\n",
              n, schiefe(mittelwerte(exp_werte, n, 4040 + n)), 2 / sqrt(n)))
}
exponential,   n =  5 : Schiefe 0.8722 (theoretisch 0.8944)
exponential,   n = 30 : Schiefe 0.3539 (theoretisch 0.3651)
for (n in c(5, 30, 100)) {
  cat(sprintf("binär p=0.05,  n = %3d : Schiefe %.4f | n*p = %.2f\n",
              n, schiefe(mittelwerte(selten, n, 3030 + n)), 0.05 * n))
}
binär p=0.05,  n =   5 : Schiefe 1.8191 | n*p = 0.25
binär p=0.05,  n =  30 : Schiefe 0.7373 | n*p = 1.50
binär p=0.05,  n = 100 : Schiefe 0.4234 | n*p = 5.00
Abbildung 3: Beispiel 2: Mittelwerte aus je 30 Werten, drei Ausgangsverteilungen.
def mittelwerte(erzeuger, n, saat):
    return erzeuger(saat, B * n).reshape(B, n).mean(axis=1)


def gleich(saat, anzahl):
    return 25 + 50 * lehmer(saat, anzahl)


def selten(saat, anzahl):
    return (lehmer(saat, anzahl) < 0.05).astype(float)


fig, achsen = plt.subplots(1, 3, figsize=(7, 3.2))
for achse, (erz, saat, titel, xlabel) in zip(achsen, [
        (gleich, 2021, "gleichverteilt, n = 30", "Mittelwert"),
        (exp_werte, 4070, "exponential, n = 30", "Mittelwert"),
        (selten, 3060, "binär p = 0.05, n = 30", "Anteil")]):
    achse.hist(mittelwerte(erz, 30, saat), bins=40, color="0.75",
               edgecolor="white")
    achse.set_title(titel, fontsize=9)
    achse.set_xlabel(xlabel)
plt.tight_layout()
plt.show()
Abbildung 4: Beispiel 2: dieselbe Gegenüberstellung in Python.
print("gleichverteilt, n =  5 : Schiefe",
      round(float(stats.skew(mittelwerte(gleich, 5, 2021))), 4))
gleichverteilt, n =  5 : Schiefe -0.0148
for n in [5, 30]:
    s = stats.skew(mittelwerte(exp_werte, n, 4040 + n))
    print(f"exponential,   n = {n:2d} : Schiefe {s:.4f}"
          f" (theoretisch {2 / np.sqrt(n):.4f})")
exponential,   n =  5 : Schiefe 0.8722 (theoretisch 0.8944)
exponential,   n = 30 : Schiefe 0.3539 (theoretisch 0.3651)
for n in [5, 30, 100]:
    s = stats.skew(mittelwerte(selten, n, 3030 + n))
    print(f"binär p=0.05,  n = {n:3d} : Schiefe {s:.4f} | n*p = {0.05 * n:.2f}")
binär p=0.05,  n =   5 : Schiefe 1.8191 | n*p = 0.25
binär p=0.05,  n =  30 : Schiefe 0.7373 | n*p = 1.50
binär p=0.05,  n = 100 : Schiefe 0.4234 | n*p = 5.00

Output Zeile für Zeile

Ausgangsverteilung n Schiefe der Mittelwerte Beurteilung
gleichverteilt 5 -0.015 schon praktisch normal
exponential 5 0.872 noch deutlich schief
exponential 30 0.354 brauchbar
binär, \(p = 0.05\) 5 1.819 völlig unbrauchbar
binär, \(p = 0.05\) 30 0.737 immer noch schief
binär, \(p = 0.05\) 100 0.423 gerade so
Beobachtung Erklärung
Bei der Gleichverteilung genügen fünf Werte Sie ist bereits symmetrisch; es gibt keine Schiefe abzubauen. Die Faustregel von 30 ist hier weit übertrieben.
Bei der Exponentialverteilung reichen 30 Das ist der Fall, für den die Faustregel gemacht ist.
Bei seltenen Ereignissen versagt sie Mit \(p = 0.05\) und \(n = 30\) ist die Schiefe noch 0.74, höher als bei fünf exponentialverteilten Werten. Auch bei \(n = 100\) bleibt sie bei 0.42.
Der Grund steht in der Spalte \(n \cdot p\) Bei \(n = 30\) erwartet man 1.5 Ereignisse. Die häufigsten Beobachtungen sind 0, 1 und 2 Treffer, eine Verteilung mit drei praktisch relevanten Werten kann nicht glockenförmig sein.

Die brauchbare Faustregel für Anteile lautet deshalb nicht “n > 30”, sondern:

\[n \cdot p \ge 10 \quad \text{und} \quad n \cdot (1-p) \ge 10\]

Bei \(p = 0.05\) bedeutet das \(n \ge 200\). Bei \(p = 0.5\) genügen 20.

Und allgemein: Die Faustregel muss zur Schiefe der Ausgangsverteilung passen. Wer \(n\) sucht, kann rückwärts rechnen, soll die Schiefe der Mittelwerte unter 0.5 liegen, braucht es

\[n \ge \left(\frac{\text{Schiefe}(X)}{0.5}\right)^2\]

also 16 bei einer Ausgangsschiefe von 2 und 64 bei einer von 4.

Interpretation und Ergebnissatz

Wie gross \(n\) sein muss, hängt an der Schiefe der Ausgangsverteilung: Bei symmetrischen Verteilungen genügen fünf Beobachtungen, bei exponentialverteilten 30, bei einem Anteil von 5 Prozent auch 100 nicht (Schiefe der Mittelwerte 0.42). Für Anteile gilt stattdessen \(n \cdot p \ge 10\).

Frage und Datenlage

Ein IQ von 130 (Mittel 100, Standardabweichung 15) und eine Körpergrösse von 1.92 m (Mittel 1.78, Standardabweichung 0.07). Welcher Wert ist “aussergewöhnlicher”?

Rechnung

z_iq <- (130 - 100) / 15
z_groesse <- (1.92 - 1.78) / 0.07

round(c(z_iq = z_iq, z_groesse = z_groesse), 4)
     z_iq z_groesse 
        2         2 
# Gleicher z-Wert heisst gleicher Rang in der jeweiligen Verteilung
round(pnorm(c(z_iq, z_groesse)), 4)
[1] 0.9772 0.9772
# Und umgekehrt: welcher Wert entspricht dem 95. Perzentil?
round(c(z_95 = qnorm(0.95),
        iq_95 = 100 + qnorm(0.95) * 15,
        groesse_95 = 1.78 + qnorm(0.95) * 0.07), 4)
      z_95      iq_95 groesse_95 
    1.6449   124.6728     1.8951 
# Ein dritter Wert zum Vergleich: 40 Stunden Wochenarbeitszeit
# bei Mittel 42 und Standardabweichung 6
round(c(z = (40 - 42) / 6, perzentil = pnorm((40 - 42) / 6)), 4)
        z perzentil 
  -0.3333    0.3694 
z_iq = (130 - 100) / 15
z_groesse = (1.92 - 1.78) / 0.07

print({"z_iq": round(z_iq, 4), "z_groesse": round(z_groesse, 4)})
{'z_iq': 2.0, 'z_groesse': 2.0}
print([round(float(stats.norm.cdf(z)), 4) for z in (z_iq, z_groesse)])
[0.9772, 0.9772]
z95 = stats.norm.ppf(0.95)
print({"z_95": round(float(z95), 4),
       "iq_95": round(100 + z95 * 15, 4),
       "groesse_95": round(1.78 + z95 * 0.07, 4)})
{'z_95': 1.6449, 'iq_95': np.float64(124.6728), 'groesse_95': np.float64(1.8951)}
z_arbeit = (40 - 42) / 6
print({"z": round(z_arbeit, 4),
       "perzentil": round(float(stats.norm.cdf(z_arbeit)), 4)})
{'z': -0.3333, 'perzentil': 0.3694}

Output Zeile für Zeile

Merkmal Wert Mittel SD z Perzentil
IQ 130 100 15 2.000 97.72 %
Körpergrösse 1.92 m 1.78 m 0.07 m 2.000 97.72 %
Wochenarbeitszeit 40 h 42 h 6 h -0.333 36.94 %
Ausgabe Wie sie zu lesen ist
Beide z-Werte sind exakt 2.000 Die beiden Personen liegen an derselben relativen Position ihrer Verteilung, obwohl die Einheiten nichts miteinander zu tun haben. Das ist der Zweck der Standardisierung.
Perzentil 97.72 97.7 Prozent der Bevölkerung liegen darunter. Diese Übersetzung setzt allerdings voraus, dass die Verteilung normal ist, der z-Wert selbst nicht.
Der negative z-Wert -0.333 heisst: ein Drittel einer Standardabweichung unter dem Mittel.
Das 95. Perzentil entspricht \(z = 1.645\) Also IQ 124.7 und Körpergrösse 1.895 m. Die Umkehrung funktioniert genauso.

Zwei Dinge, die die Standardisierung nicht tut:

  1. Sie macht die Verteilung nicht normal. Ein z-Wert von 2 bei einer stark schiefen Verteilung bedeutet nicht das 97.7. Perzentil, die Umrechnung in Perzentile gilt nur bei Normalverteilung. Der z-Wert selbst ist immer berechenbar, seine Deutung als Perzentil nicht.
  2. Sie sagt nichts über Bedeutsamkeit. Ein z-Wert von 2 ist bei einem Blutwert alarmierend und bei einer Schuhgrösse belanglos.

Der praktische Nutzen liegt woanders: Standardisierte Variablen sind die Grundlage jedes Verfahrens, das Merkmale verschiedener Einheiten zusammenbringt, Distanzmasse, Hauptkomponentenanalyse, standardisierte Regressionskoeffizienten.

Interpretation und Ergebnissatz

Ein IQ von 130 und eine Körpergrösse von 1.92 m entsprechen beide einem z-Wert von 2.0 und damit dem 97.7. Perzentil ihrer jeweiligen Verteilung.

Frage und Datenlage

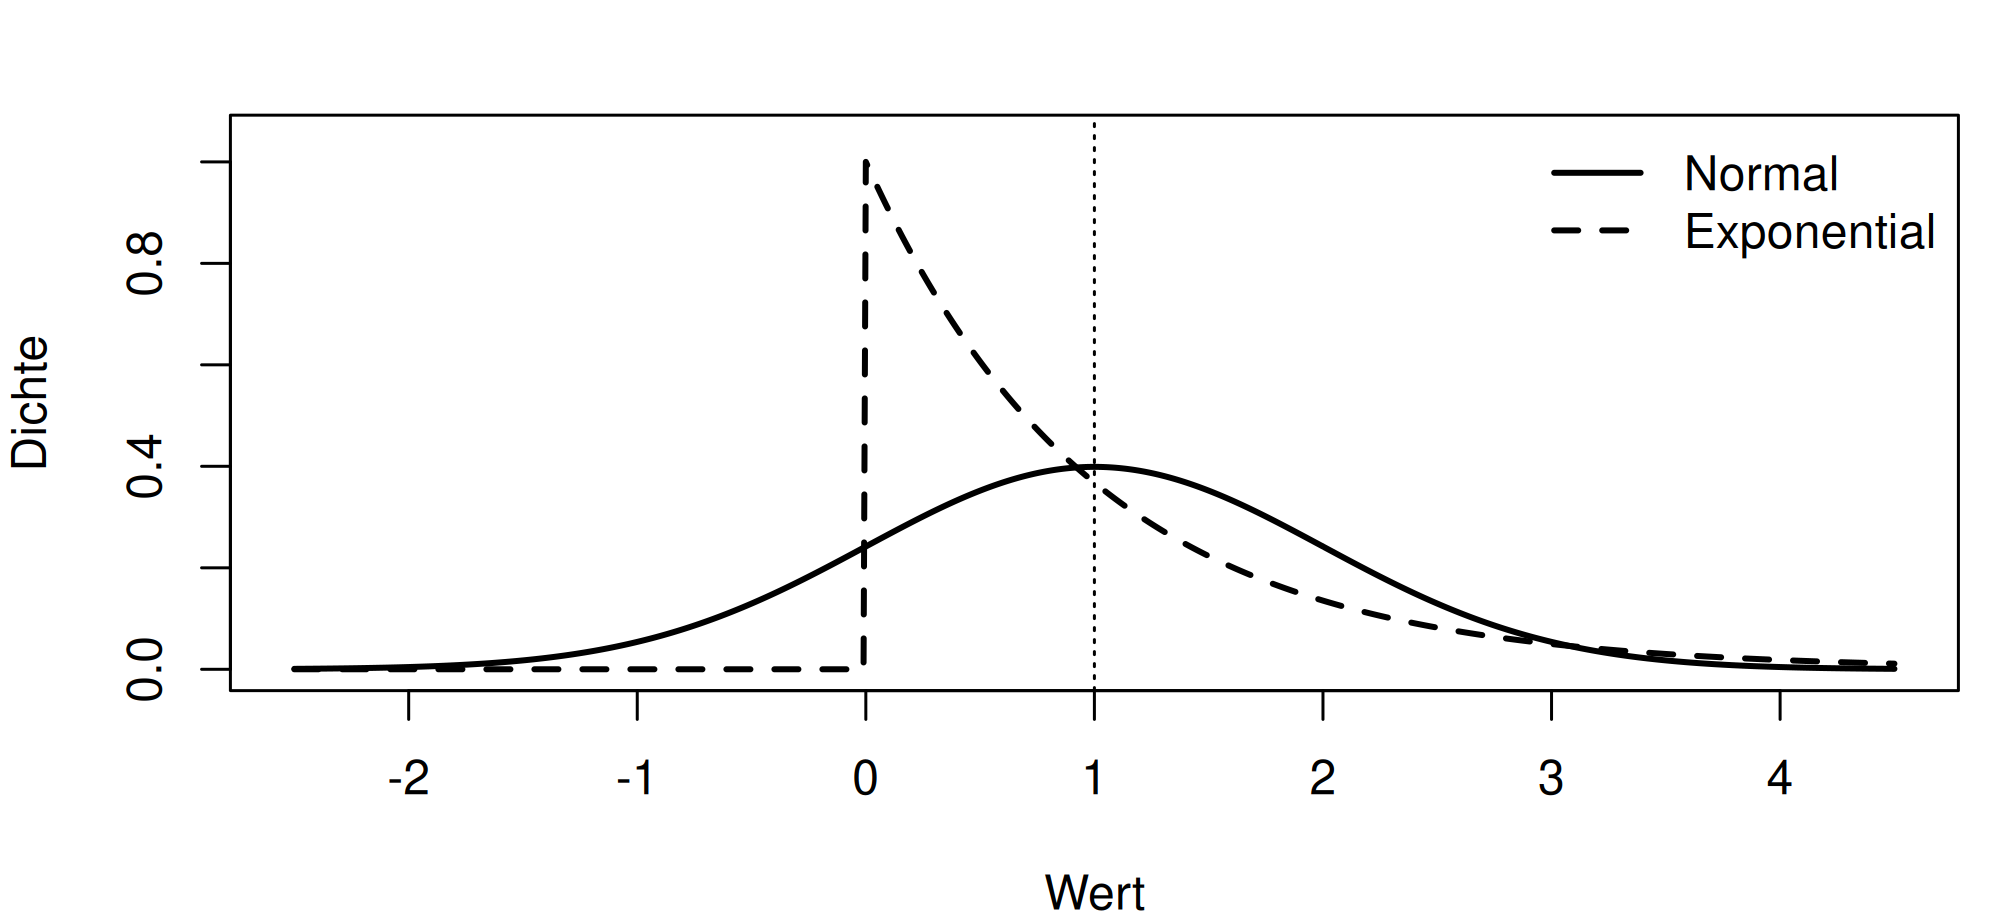
68, 95 und 99.7 Prozent, gelten diese Anteile allgemein oder nur für die Normalverteilung? Geprüft an 100 000 exponentialverteilten Werten mit Erwartungswert 1 und Standardabweichung 1.

Rechnung

theoretisch <- sapply(1:3, function(k) pnorm(k) - pnorm(-k))

ex <- exp_werte(5050, 100000)
empirisch <- sapply(1:3, function(k) mean(ex >= 1 - k & ex <= 1 + k))

round(rbind(normalverteilung = theoretisch, exponential = empirisch), 4)
                   [,1]   [,2]   [,3]
normalverteilung 0.6827 0.9545 0.9973
exponential      0.8665 0.9508 0.9818
gitter <- seq(-2.5, 4.5, by = 0.01)
par(mar = c(4, 4, 2, 1))
plot(gitter, dnorm(gitter, mean = 1, sd = 1), type = "l", lwd = 2,
     xlab = "Wert", ylab = "Dichte", ylim = c(0, 1.05))
lines(gitter, ifelse(gitter >= 0, dexp(gitter), 0), lwd = 2, lty = 2)
abline(v = 1, lty = 3)
legend("topright", legend = c("Normal", "Exponential"), lwd = 2,
       lty = c(1, 2), bty = "n")
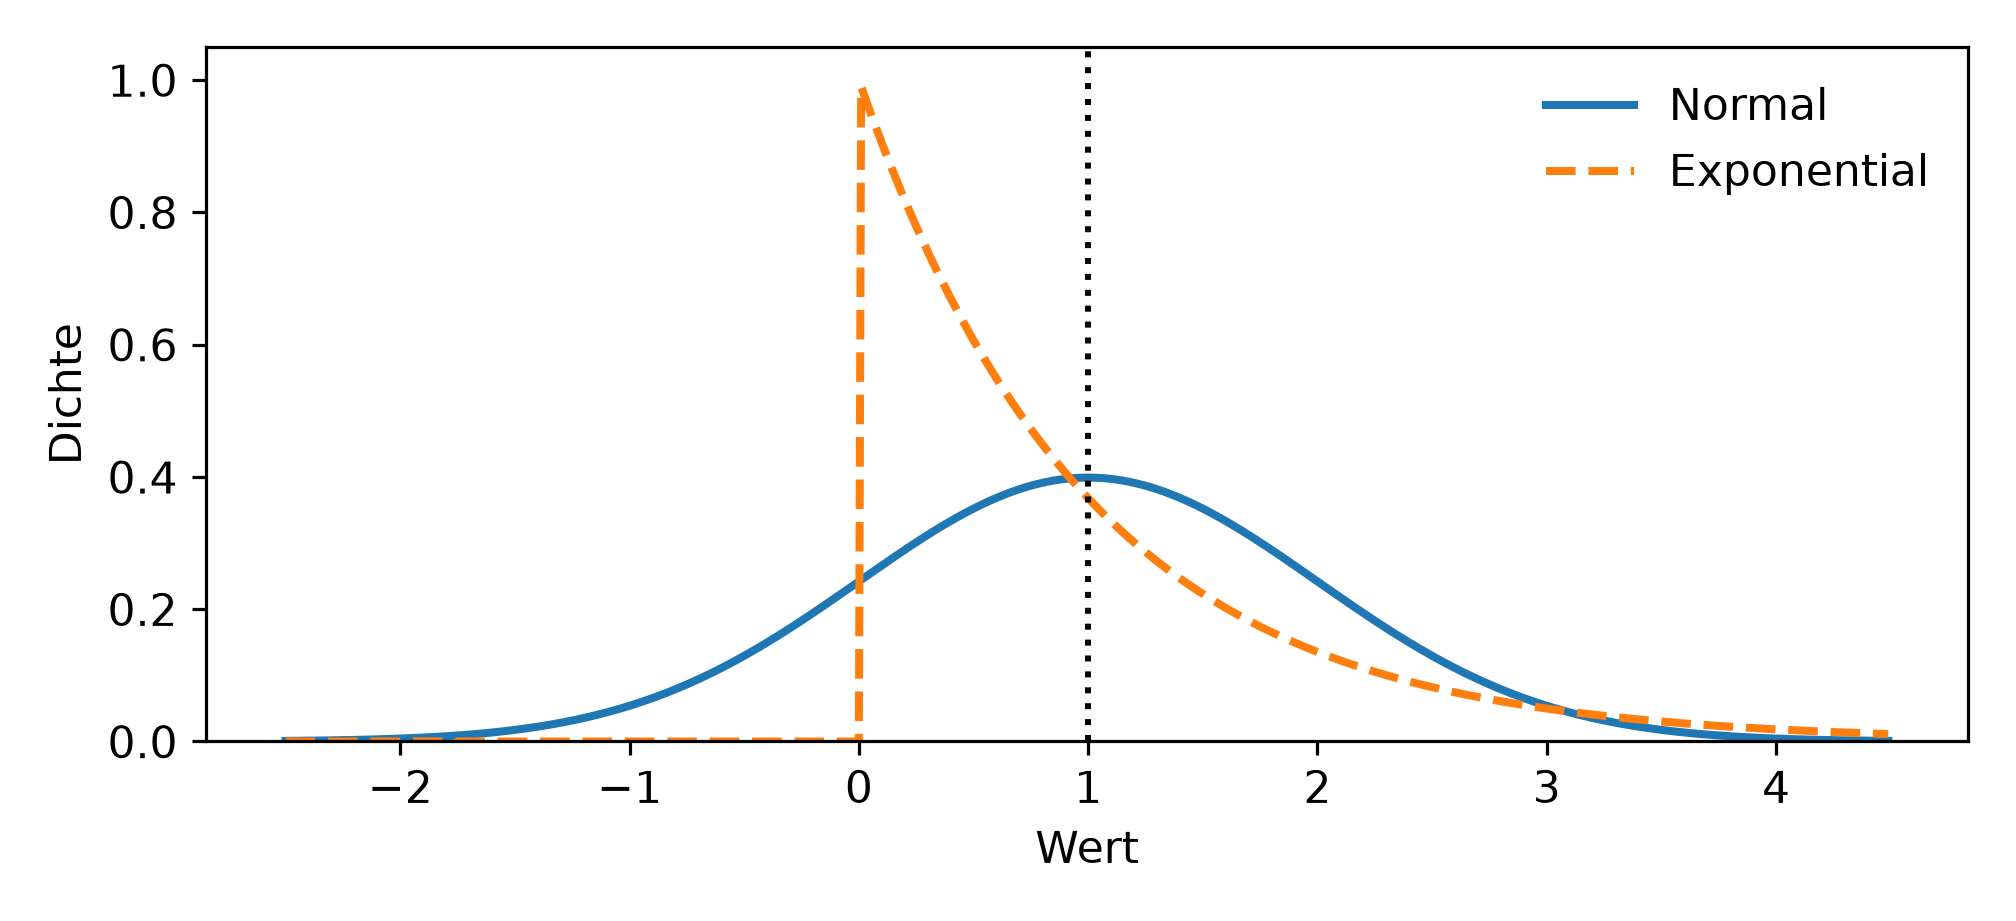
Abbildung 5: Beispiel 4: Normalverteilung und Exponentialverteilung, beide mit Mittel 1 und SD 1.
theoretisch = [stats.norm.cdf(k) - stats.norm.cdf(-k) for k in (1, 2, 3)]

ex = exp_werte(5050, 100000)
empirisch = [float(((ex >= 1 - k) & (ex <= 1 + k)).mean()) for k in (1, 2, 3)]

print(pd.DataFrame({"normalverteilung": np.round(theoretisch, 4),
                    "exponential": np.round(empirisch, 4)},
                   index=["1 SD", "2 SD", "3 SD"]).T)
                    1 SD    2 SD    3 SD
normalverteilung  0.6827  0.9545  0.9973
exponential       0.8665  0.9508  0.9818
gitter = np.arange(-2.5, 4.5, 0.01)
fig, achse = plt.subplots(figsize=(7, 3.2))
achse.plot(gitter, stats.norm.pdf(gitter, loc=1, scale=1), lw=2,
           label="Normal")
achse.plot(gitter, np.where(gitter >= 0, stats.expon.pdf(gitter), 0), lw=2,
           ls="--", label="Exponential")
achse.axvline(1, ls=":", color="black")
achse.set_ylim(0, 1.05)
(0.0, 1.05)
achse.set_xlabel("Wert")
achse.set_ylabel("Dichte")
achse.legend(frameon=False)
plt.tight_layout()
plt.show()
Abbildung 6: Beispiel 4: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

Bereich Normalverteilung Exponentialverteilung Differenz
\(\mu \pm 1\sigma\) 0.6827 0.8665 +18.4 Punkte
\(\mu \pm 2\sigma\) 0.9545 0.9508 -0.4 Punkte
\(\mu \pm 3\sigma\) 0.9973 0.9818 -1.6 Punkte
Beobachtung Erklärung
Beide Verteilungen haben Mittel 1 und SD 1 Die Kennzahlen stimmen exakt überein; die Form nicht.
Bei einer Standardabweichung liegen 87 statt 68 Prozent Weil die Exponentialverteilung ihre Masse links zusammendrängt: Der Bereich von 0 bis 2 enthält den grössten Teil.
Bei zwei Standardabweichungen stimmt es fast 95.08 gegen 95.45 Prozent. Ein Zufall der Zahlen, kein Prinzip.
Bei drei Standardabweichungen fehlen 1.6 Punkte Und die fehlen alle auf der rechten Seite: Die Exponentialverteilung hat einen langen Rand, den drei Standardabweichungen nicht abdecken.
Nach unten reichen zwei Standardabweichungen bereits unter null \(1 - 2 = -1\), und dort gibt es keine Werte. Bei einer schiefen, nach unten begrenzten Verteilung ist ein symmetrisches Intervall grundsätzlich unpassend.

Was allgemein gilt, ist viel schwächer. Die Ungleichung von Tschebyscheff sagt für jede Verteilung mit endlicher Varianz:

\[P(\lvert X - \mu \rvert \ge k\sigma) \le \frac{1}{k^2}\]

Also liegen mindestens 75 Prozent innerhalb von zwei und mindestens 89 Prozent innerhalb von drei Standardabweichungen. Das ist wahr und fast nutzlos, bei der Normalverteilung sind es 95.4 und 99.7 Prozent.

Die Lehre: Die Faustregeln sind sehr nützlich, wenn die Verteilung annähernd normal ist, und irreführend, wenn nicht. Ob sie es ist, zeigt ein QQ-Plot und für den Mittelwert einer genügend grossen Stichprobe ist sie es meist, auch wenn die Einzelwerte es nicht sind. Genau darauf beruhen die Konfidenzintervalle.

Interpretation und Ergebnissatz

Bei einer Exponentialverteilung mit Erwartungswert 1 und Standardabweichung 1 liegen 86.7 Prozent der Werte innerhalb einer Standardabweichung vom Mittel statt der bei Normalverteilung geltenden 68.3 Prozent. Die Faustregeln gelten nur bei annähernder Normalität.

Verständnisfragen

Der zentrale Grenzwertsatz besagt, dass …

die Daten bei genügend grosser Stichprobe normalverteilt werden
Die Daten ändern sich nicht. Eine schiefe Verteilung bleibt schief, egal wie viele Werte man erhebt.
die Verteilung der Mittelwerte sich einer Normalverteilung nähert
Richtig. Gemeint ist die Verteilung über gedachte Wiederholungen der Stichprobenziehung, nicht die Verteilung der Einzelwerte.
jede Verteilung eine Glockenform hat
Das wäre offensichtlich falsch.

Für einen Anteil von 5 Prozent ist die Verteilung des Stichprobenanteils auch bei n = 100 noch deutlich schief. Was folgt daraus?

Die Faustregel “n > 30” ist keine Konstante; für Anteile gilt \(n \cdot p \ge 10\)
Richtig. Bei p = 0.05 und n = 100 erwartet man fünf Ereignisse, und eine Verteilung mit wenigen praktisch relevanten Werten kann nicht glockenförmig sein. Nötig wären hier rund 200 Beobachtungen.
Der zentrale Grenzwertsatz gilt für Anteile nicht
Er gilt, nur langsamer.
Die Simulation ist fehlerhaft
Die gemessene Schiefe von 0.42 entspricht dem theoretischen Wert.

Zwei Merkmale mit völlig verschiedenen Einheiten haben beide einen z-Wert von 2.0. Was heisst das?

Beide Werte liegen an derselben relativen Position ihrer Verteilung
Richtig. Der z-Wert misst den Abstand vom Mittel in Standardabweichungen und ist deshalb einheitenfrei. Die Übersetzung in ein Perzentil setzt allerdings Normalverteilung voraus.
Beide Werte sind gleich gross
130 und 1.92 sind nicht gleich gross; nur ihre relative Lage stimmt überein.
Beide Merkmale sind normalverteilt
Der z-Wert lässt sich bei jeder Verteilung berechnen.

Eine Verteilung hat Mittel 1 und Standardabweichung 1, aber nur 86.7 Prozent der Werte liegen innerhalb einer Standardabweichung. Ist das möglich?

Ja, die 68-Prozent-Regel gilt nur für die Normalverteilung
Richtig. Mittel und Streuung sagen nichts über die Form. Allgemein gilt nur die Ungleichung von Tschebyscheff, und die ist viel schwächer.
Nein, das widerspricht der Definition der Standardabweichung
Die Standardabweichung ist definiert, ohne dass daraus Anteile folgen.
Nur bei diskreten Verteilungen
Das Beispiel ist stetig.

Die Streuung von Mittelwerten sinkt von 0.99 bei n = 1 auf 0.18 bei n = 30. Was für ein Zusammenhang ist das?

Sie sinkt mit der Wurzel aus n
Richtig: \(1/\sqrt{30} = 0.183\). Deshalb kostet eine Halbierung des Standardfehlers eine Vervierfachung der Stichprobe.
Sie sinkt linear mit n
Dann läge sie bei 0.033.
Sie sinkt zufällig
Der Zusammenhang ist exakt und folgt aus der Varianzrechnung für Summen unabhängiger Variablen.

Verlinkte Ressourcen