Bei einer Querschnittserhebung ist die Reihenfolge der Zeilen beliebig. Bei einer Zeitreihe trägt sie die Information: Der Wert von heute hängt mit dem von gestern zusammen. Damit fällt die Unabhängigkeitsannahme, auf der die meisten Verfahren dieser Sammlung beruhen.
Zwei praktische Folgen:
Folge
Warum
Standardfehler sind zu klein
Aufeinanderfolgende Werte enthalten teilweise dieselbe Information; die effektive Stichprobengrösse ist kleiner als \(n\).
Korrelationen sind irreführend
Zwei Reihen mit Trend korrelieren fast immer hoch, ohne jeden inhaltlichen Zusammenhang. Beispiel 5 rechnet das durch.
Die drei Bestandteile
Bestandteil
Was er beschreibt
Woran erkennbar
Trend
langfristige Richtung
die Reihe steigt oder fällt über Jahre
Saison
Muster mit fester Periode
dieselbe Form in jedem Jahr, Quartal, Wochentag
Rest
was übrig bleibt
soll strukturlos um null schwanken
Manche Reihen haben zusätzlich einen Zyklus: Auf und Ab ohne feste Periode, etwa Konjunkturwellen. Der Unterschied zur Saison ist die Vorhersagbarkeit der Länge, eine Saison kommt immer im Dezember, ein Zyklus irgendwann in den nächsten Jahren.
Additiv oder multiplikativ
Bei additiver Struktur bleibt die Saisonschwankung über die Jahre gleich gross, bei multiplikativer wächst sie mit dem Niveau.
Die Entscheidung fällt am Bild: Werden die Zacken mit steigendem Niveau höher, ist die Struktur multiplikativ. Eine Logarithmierung macht daraus eine additive, weil aus dem Produkt eine Summe wird:
\[\ln y_t = \ln T_t + \ln S_t + \ln R_t\]
Das ist der übliche Weg, weil danach alle Verfahren für additive Reihen anwendbar sind. Beispiel 4 zeigt es an Zahlen.
Die Zerlegung mit gleitenden Mitteln
Das klassische Verfahren (decompose() beziehungsweise seasonal_decompose()) arbeitet in drei Schritten:
Trend über ein zentriertes gleitendes Mittel der Periodenlänge. Bei gerader Periode wird es zweimal geglättet, damit es zentriert bleibt, bei zwölf Monaten also mit den Gewichten \(\tfrac{1}{2}, 1, \dots, 1, \tfrac{1}{2}\) geteilt durch 12.
Saison als Mittelwert der trendbereinigten Werte je Monat, anschliessend so verschoben, dass die Figur im Mittel null ergibt.
Rest als das, was nach Abzug von Trend und Saison bleibt.
Daraus folgen zwei Eigenschaften, die man kennen muss: Am Rand fehlt der Trend für je eine halbe Periode, und die Saisonfigur ist in jedem Jahr identisch. Genau diese Starrheit behebt STL, siehe Beispiel 3.
Was man aus der Zerlegung nicht ablesen darf
Die Zerlegung ist beschreibend. Sie sagt, wie sich die Reihe in Bestandteile aufteilen lässt, und nicht, warum. Insbesondere:
Ein Trend ist keine Ursache und keine Garantie für die Zukunft.
Die Saisonfigur ist ein Mittel über die beobachteten Jahre; ein einzelnes ungewöhnliches Jahr verzerrt sie.
Der Rest enthält alles, was das Verfahren nicht kennt, also auch echte Ereignisse wie einen Streik oder eine Preisänderung.
Aggregationsebene und Zeitraum
Beides entscheidet, was sichtbar ist. Tagesdaten zeigen Wochenmuster, die in Monatsdaten verschwinden. Ein Zeitraum von zwei Jahren erlaubt keine Aussage über Saisonalität, weil zwei Wiederholungen kein Muster belegen. Als Faustregel braucht eine Saisonschätzung mindestens drei, besser vier vollständige Perioden.
Umgekehrt kann eine zu feine Ebene Muster erzeugen, die inhaltlich nicht interessieren: Wer Tagesdaten auf Trend untersucht, kämpft mit Wochenenden und Feiertagen.
Beispiele
Die Beispiele 1 bis 3 arbeiten mit einer konstruierten Absatzreihe: 72 Monatswerte ab Januar 2020, ein linearer Trend von 500 mit 4 Einheiten Zuwachs je Monat, eine Jahressaison und ein Rest mit Streuung 20. Weil die Bestandteile bekannt sind, lässt sich prüfen, was die Zerlegung davon zurückgewinnt.
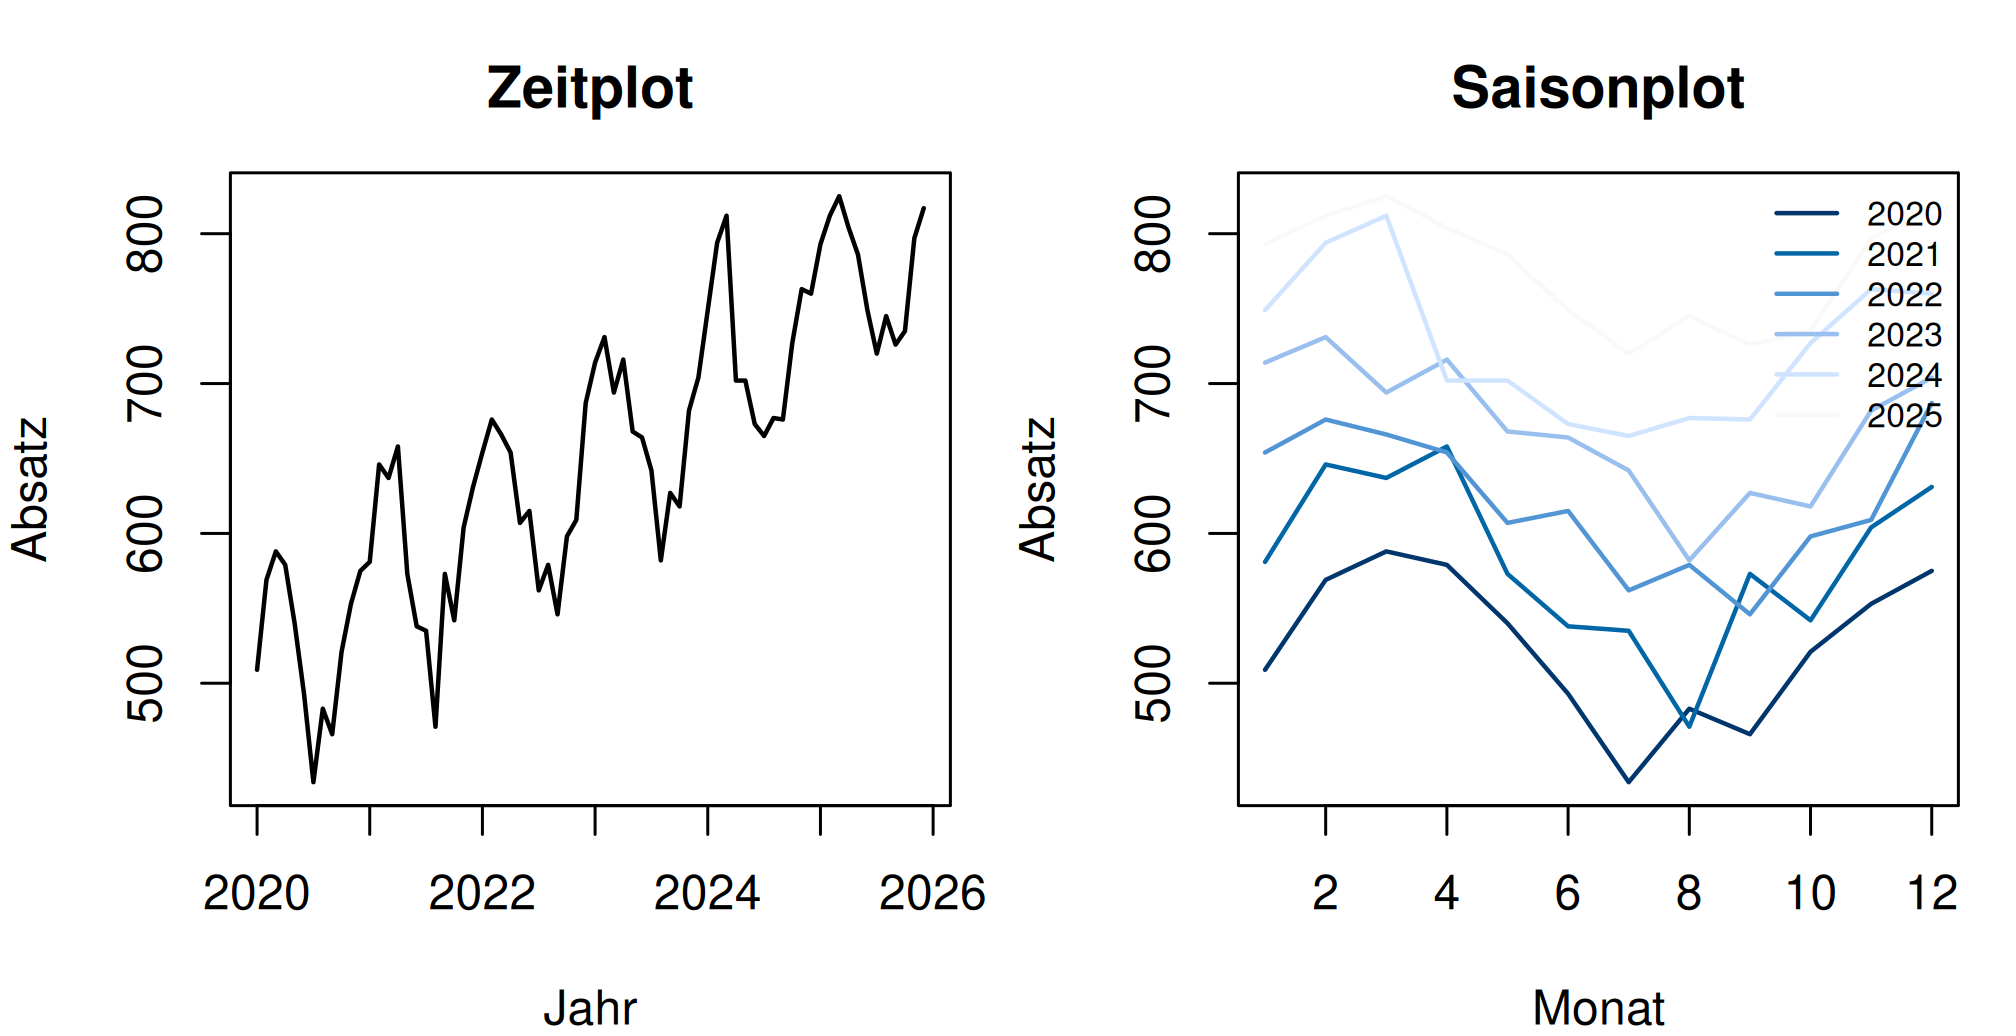
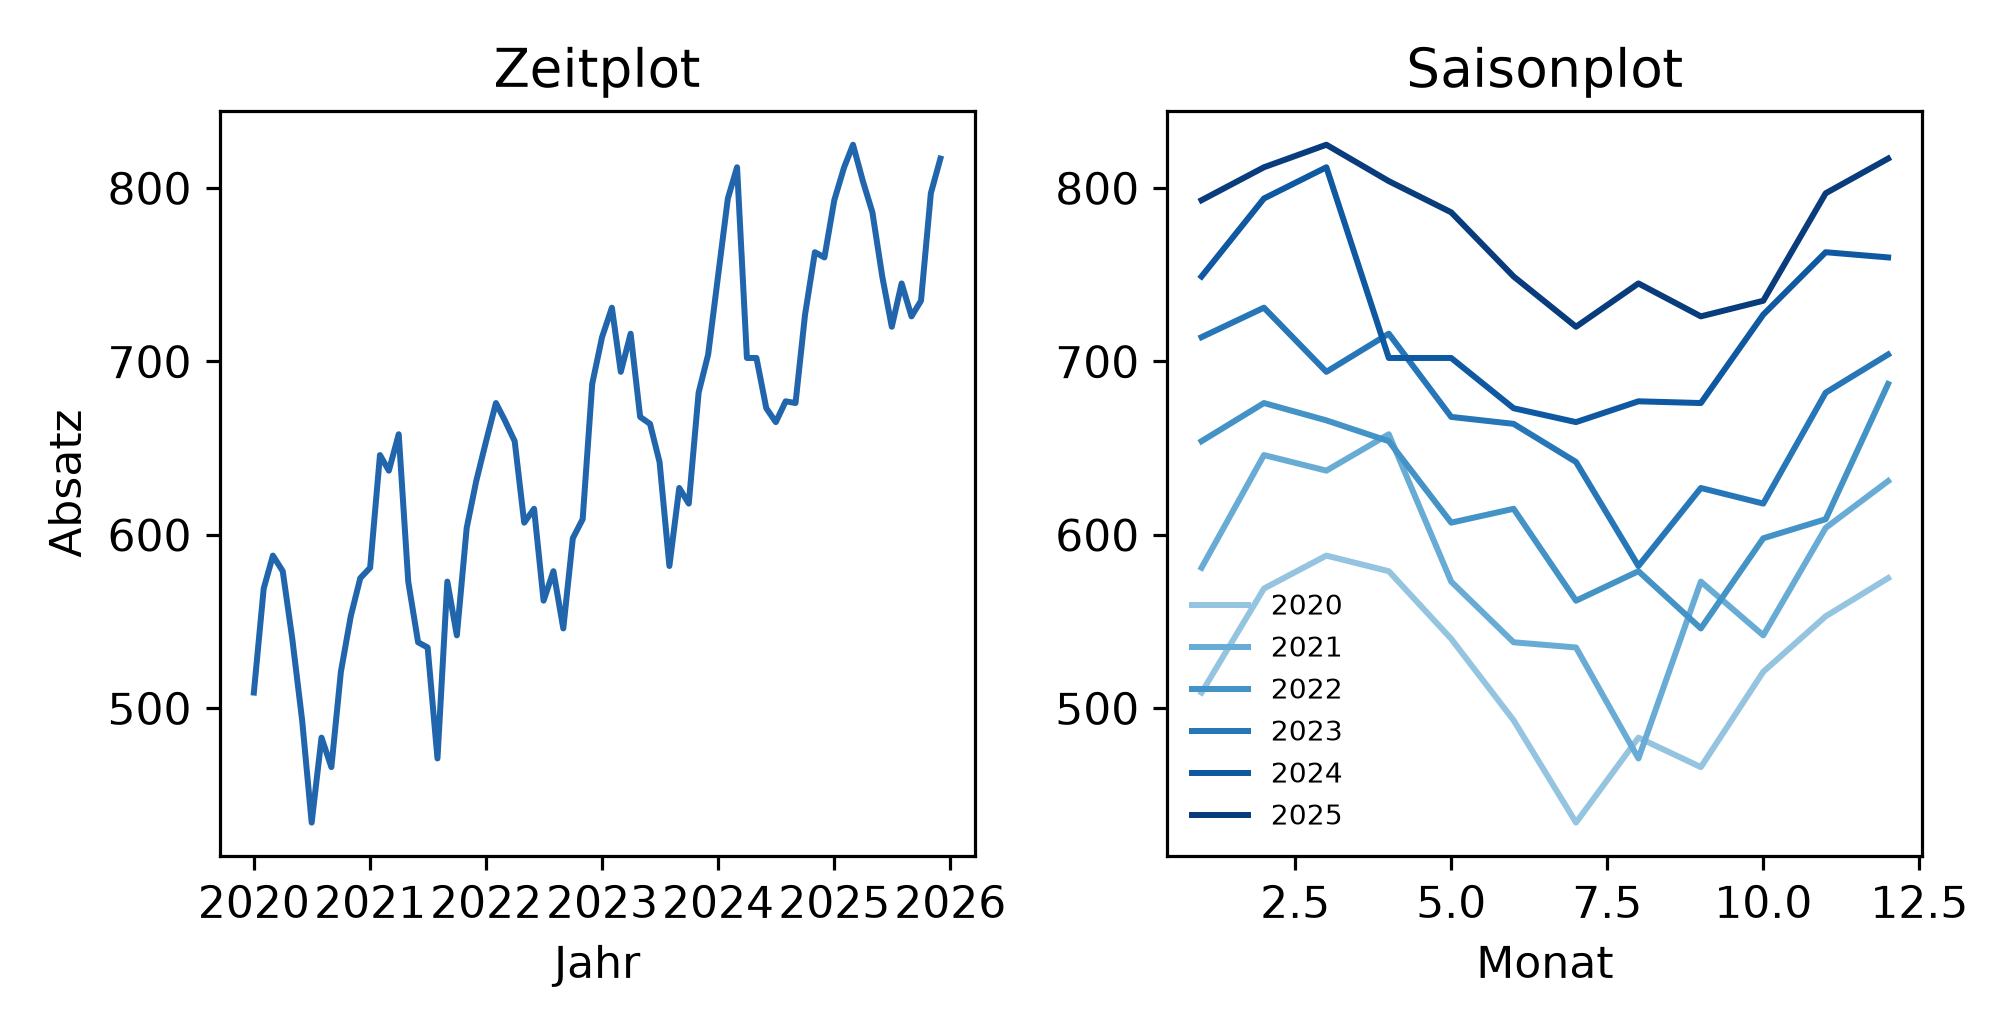
Vor jeder Rechnung steht der Zeitplot. Er beantwortet vier Fragen auf einmal: Gibt es einen Trend, gibt es Saison, ist die Struktur additiv oder multiplikativ, und gibt es Ausreisser oder Brüche?
Der Zeitplot steigt über sechs Jahre um rund 250 Einheiten; die Jahresmittel wachsen gleichmässig um etwa 50 je Jahr, also gut 4 je Monat.
Saison?
Ja, mit Jahresperiode
Im Saisonplot liegen alle sechs Linien parallel übereinander: dieselbe Form, nur nach oben verschoben. Das ist die klarste Art, Saisonalität zu sehen, im Zeitplot verdeckt der Trend sie leicht.
Additiv oder multiplikativ?
Additiv
Das Mittel steigt um 48 Prozent, die Spannweite schwankt dabei ohne Richtung um 150 herum (154, 187, 141, 149, 147, 105). Bei multiplikativer Struktur müsste sie mitwachsen, in Beispiel 4 tut sie das, von 179 auf 284.
Ausreisser oder Brüche?
Keine
Kein einzelner Punkt fällt aus dem Muster, kein Niveausprung.
Der Saisonplot ist die wichtigste Grafik dieses Beispiels. Im Zeitplot sind Trend und Saison überlagert und schwer zu trennen; legt man die Jahre übereinander, wird die Saisonfigur unmittelbar sichtbar und ebenso, ob sie sich über die Jahre verändert (Beispiel 3) oder ob ein einzelnes Jahr aus der Reihe fällt.
Interpretation
Alle Voraussetzungen für eine additive Zerlegung sind erfüllt: klarer Trend, stabile Saison, keine Brüche, sechs vollständige Perioden.
Frage und Datenlage
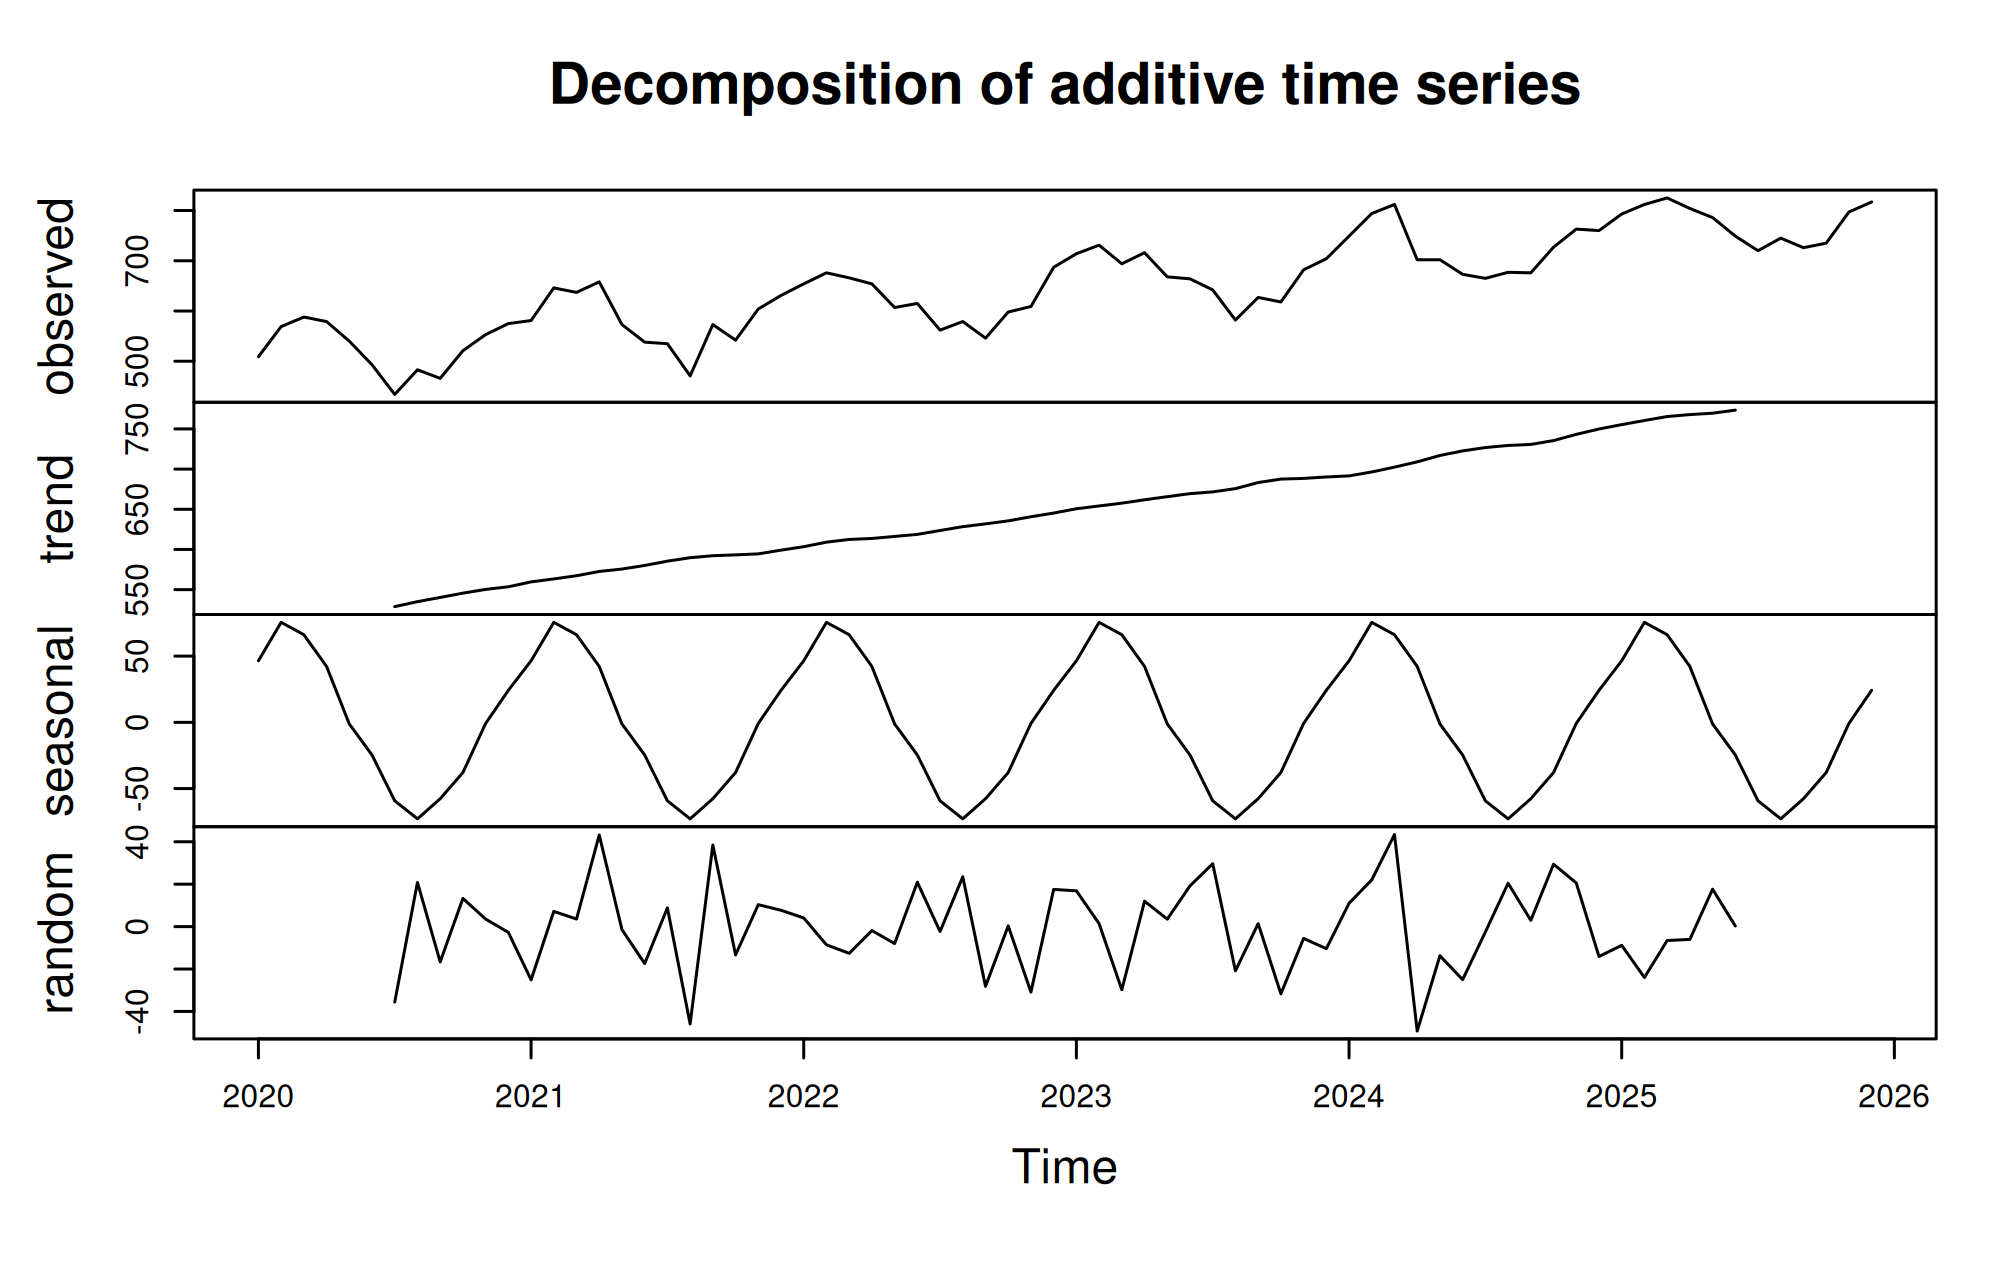
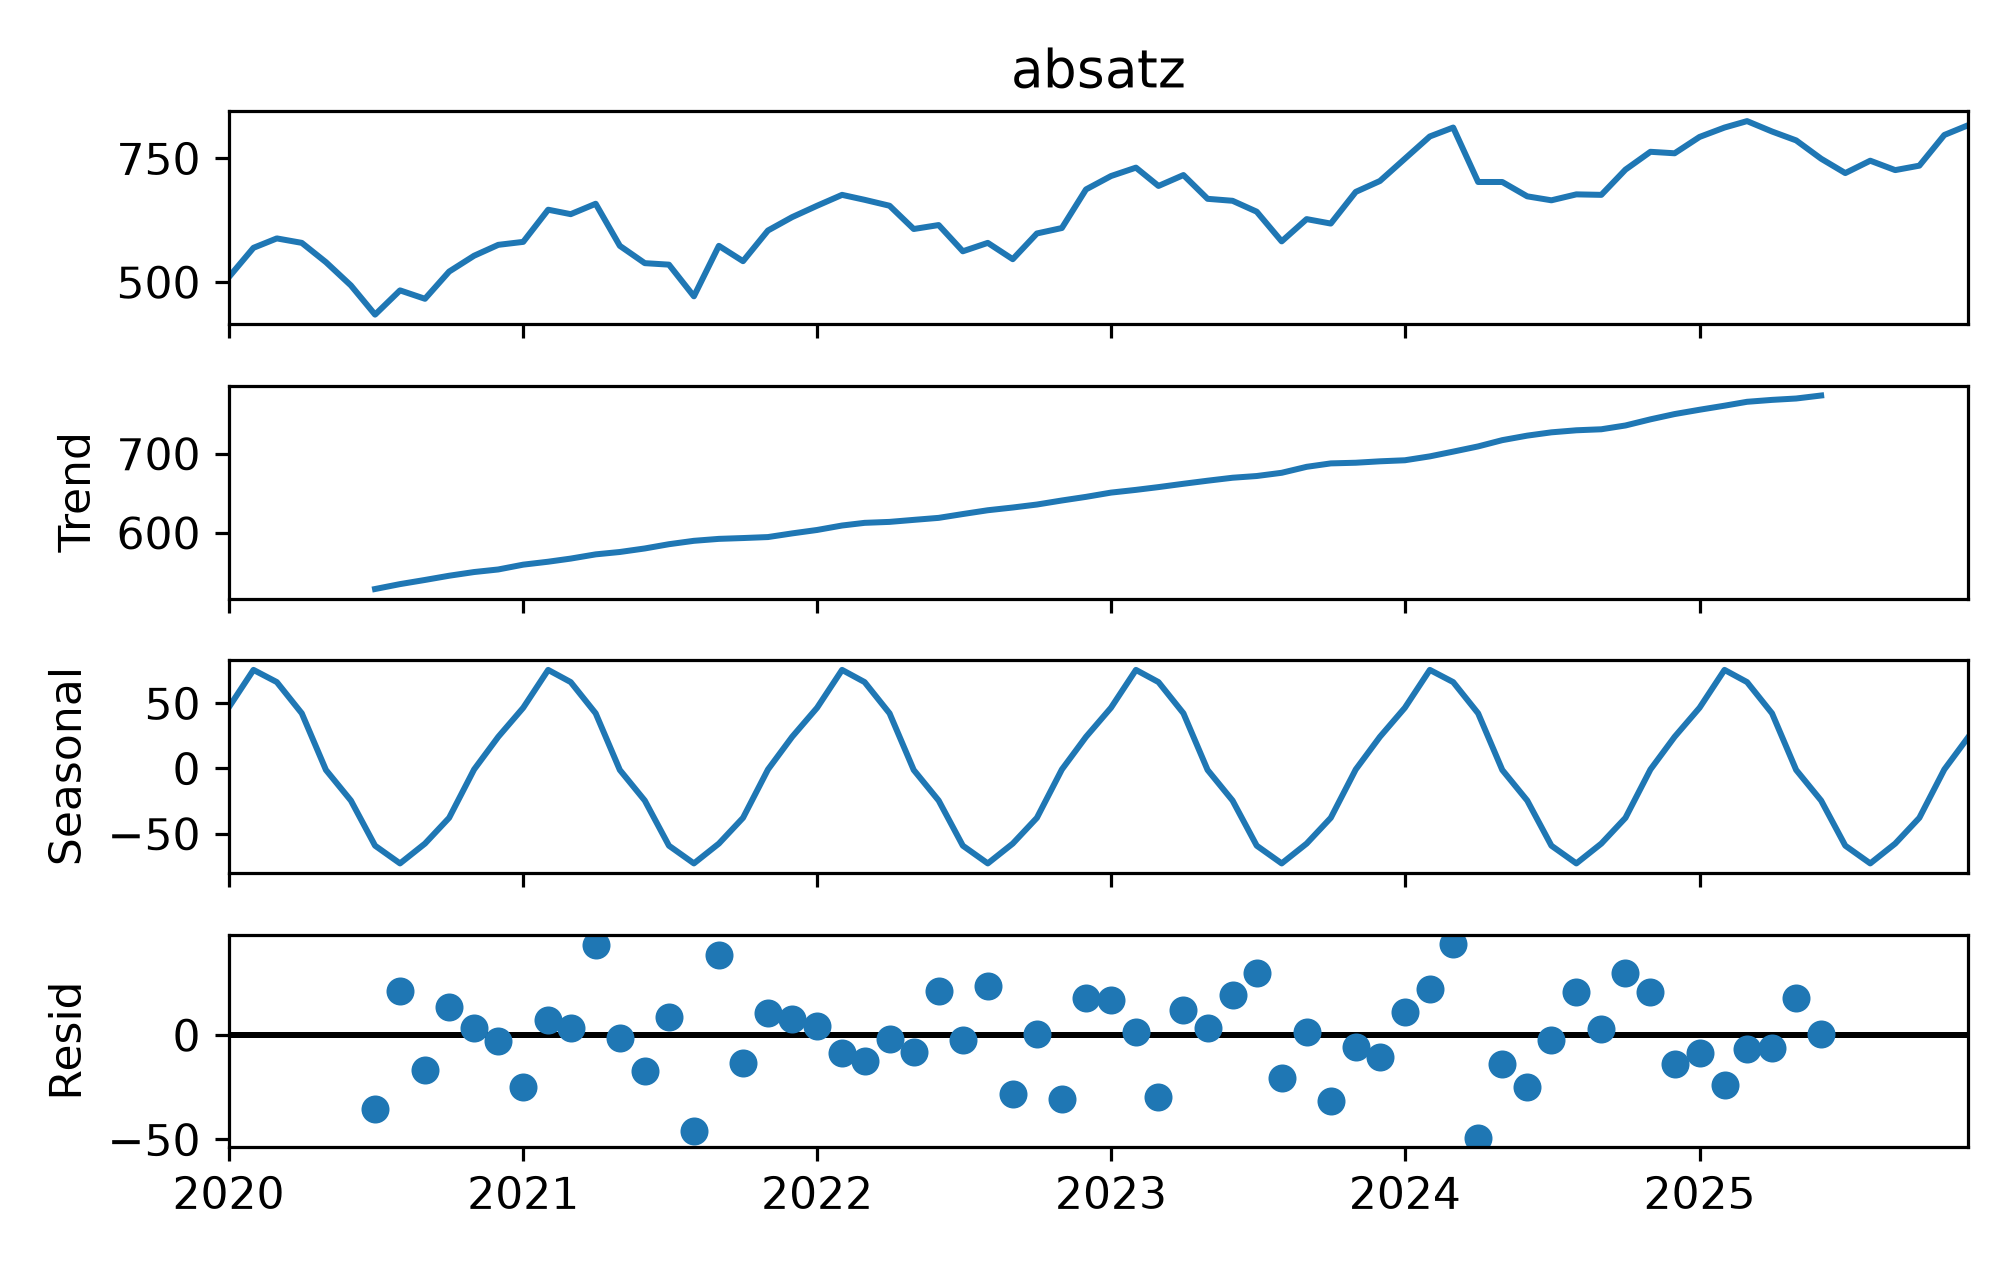
Was macht decompose() genau, und wie gut trifft es die eingebauten Bestandteile?
Die geschätzte Saisonfigur gegen die eingebauten Werte:
Monat
1
2
3
4
5
6
7
8
9
10
11
12
geschätzt
46.5
75.5
66.1
42.2
-1.2
-24.7
-59.3
-72.9
-57.7
-37.9
-0.8
24.2
eingebaut
51.7
64.5
60.0
39.5
8.3
-25.0
-51.7
-64.5
-60.0
-39.5
-8.3
25.0
Differenz
-5.2
11.0
6.1
2.7
-9.5
0.3
-7.6
-8.4
2.3
1.6
7.5
-0.8
Die Schwankung der Spannweite ist selbst lehrreich: Bei nur zwölf Werten je Jahr ist der Abstand zwischen Maximum und Minimum eine sehr unruhige Kennzahl. Was zählt, ist die Richtung über die Jahre, nicht der einzelne Wert.
Ausgabe
Wert hier
Wie er zu lesen ist
Trend bei \(t = 13\)
559.625, von Hand wie aus der Funktion
Das zentrierte gleitende Mittel über 13 Werte mit halbem Gewicht an den Enden. Die 13 Werte reichen von Juli 2020 bis Juli 2021, der Trendwert für Januar 2021 nutzt also ein halbes Jahr Zukunft.
fehlende Trendwerte
12
Sechs am Anfang, sechs am Ende. Bei einer Periode von 12 fehlt an jedem Rand eine halbe Periode. Deshalb taugt decompose() nicht zur Vorhersage, für den aktuellsten Monat gibt es keinen Trend.
Summe der Saisonfigur
0.000
Per Konstruktion. Die Figur wird so verschoben, dass sie sich über ein Jahr aufhebt; das Niveau steckt vollständig im Trend.
Abweichungen der Figur
bis zu 11 Einheiten
Die geschätzte Figur trifft die eingebaute nicht genau, bei sechs Wiederholungen und einem Rest mit Streuung 20 ist der Standardfehler je Monat etwa \(20/\sqrt{6} = 8.2\). Die Abweichungen liegen in dieser Grössenordnung.
Rest, Standardabweichung
20.685
Sehr nahe an der eingebauten 20. Die Zerlegung hat also im Wesentlichen alles gefunden, was es zu finden gab.
Die Abweichungen in der Saisonfigur sind kein Fehler des Verfahrens, sondern Stichprobenzufall. Sie sind aber ein Grund, eine Saisonfigur nicht auf die Nachkommastelle zu deuten: Dass der Februar mit 75.5 statt 64.5 geschätzt wird, heisst nicht, dass der Februar besonders stark ist, es heisst, dass sechs Februare für eine genaue Schätzung wenig sind.
Die Faustregel “mindestens drei, besser vier Perioden” ist eine Untergrenze für Erkennbarkeit, keine für Genauigkeit.
Interpretation und Ergebnissatz
Eine additive Zerlegung der Monatsreihe (72 Werte, Periode 12) ergibt einen gleichmässig steigenden Trend von rund 529 auf 773 und eine Saisonfigur mit Maximum im Februar (+75.5) und Minimum im August (-72.9). Der Rest streut mit einer Standardabweichung von 20.7 ohne erkennbares Muster.
Frage und Datenlage
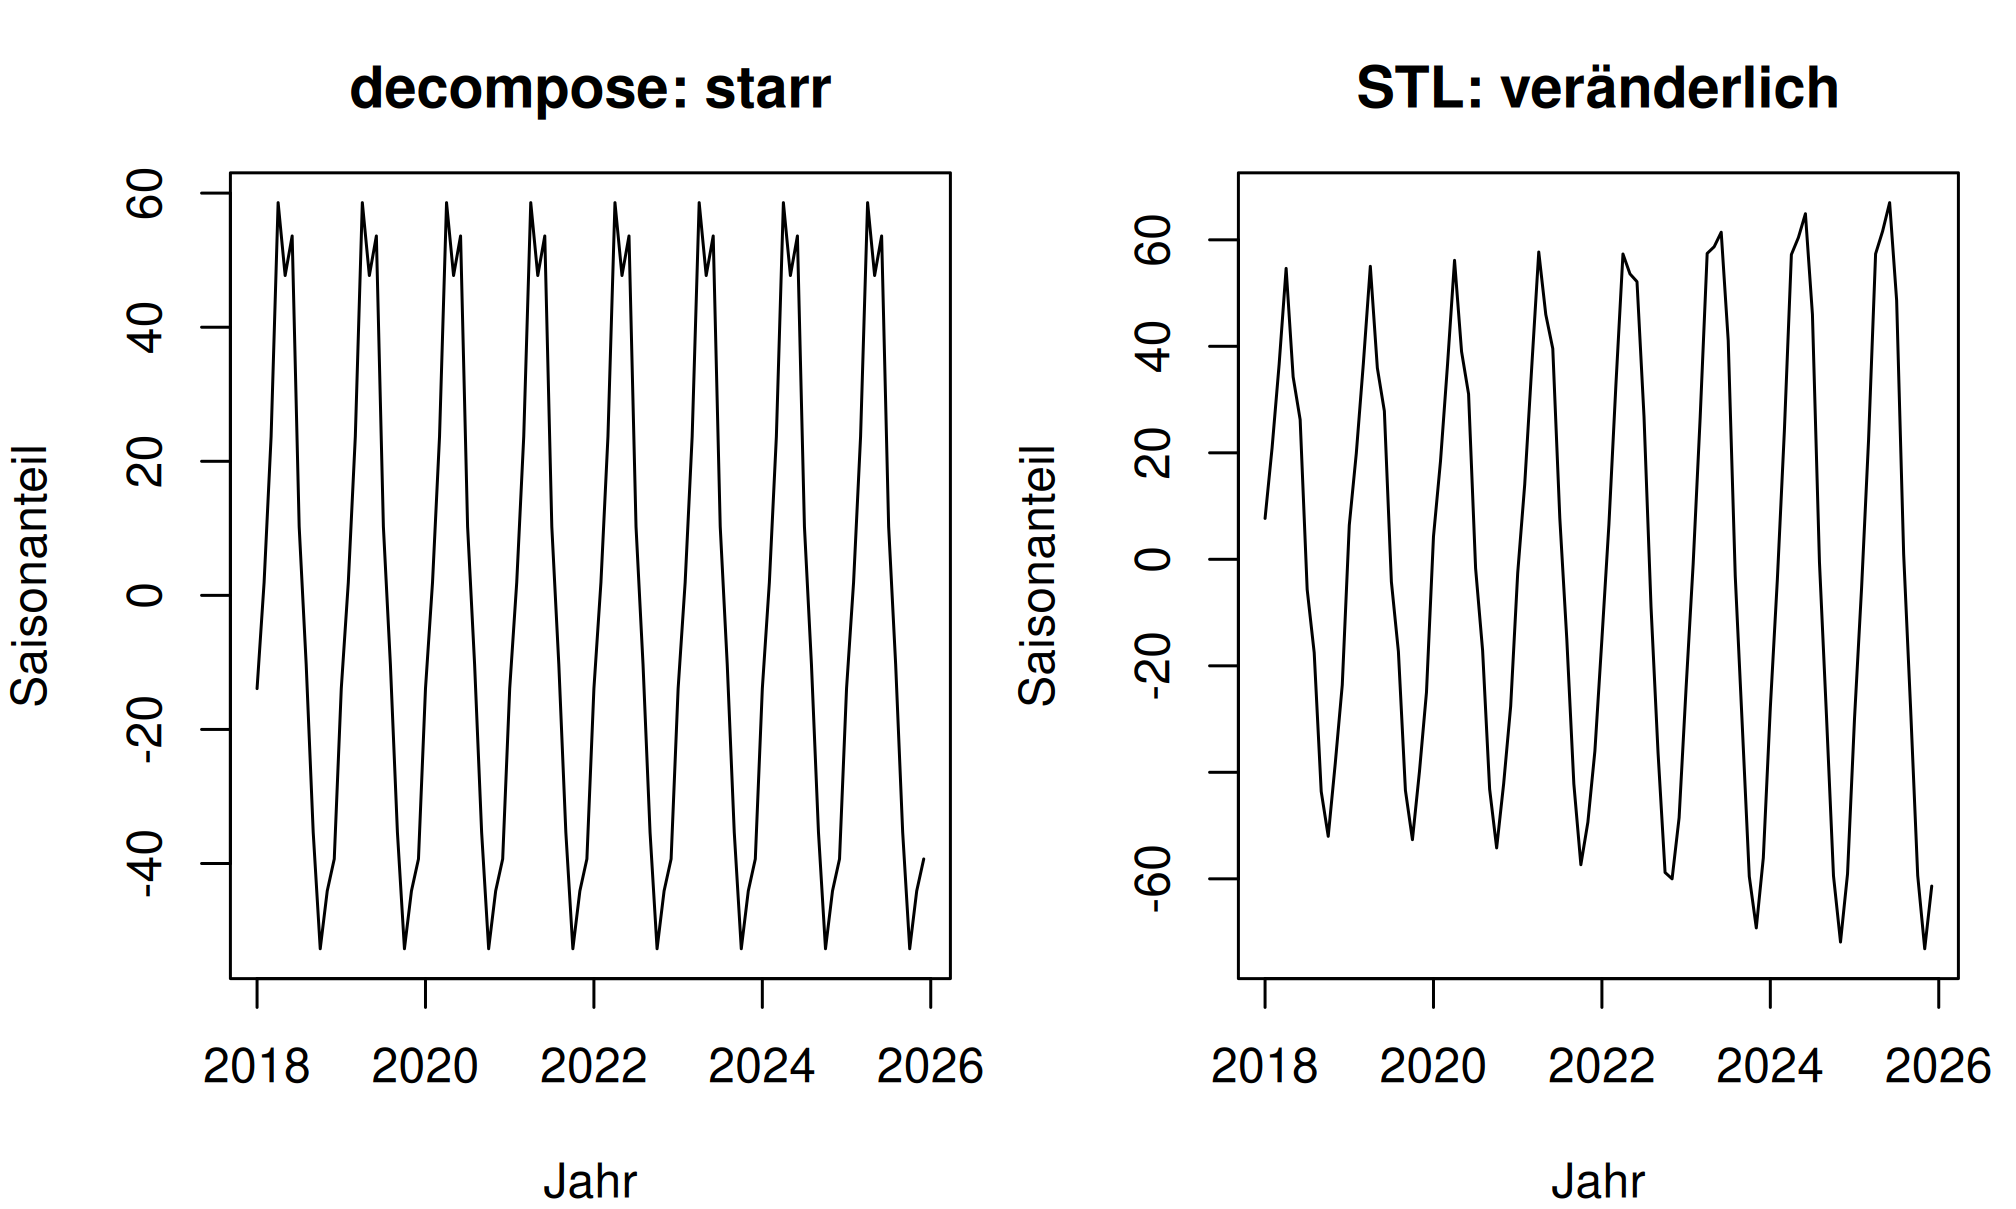
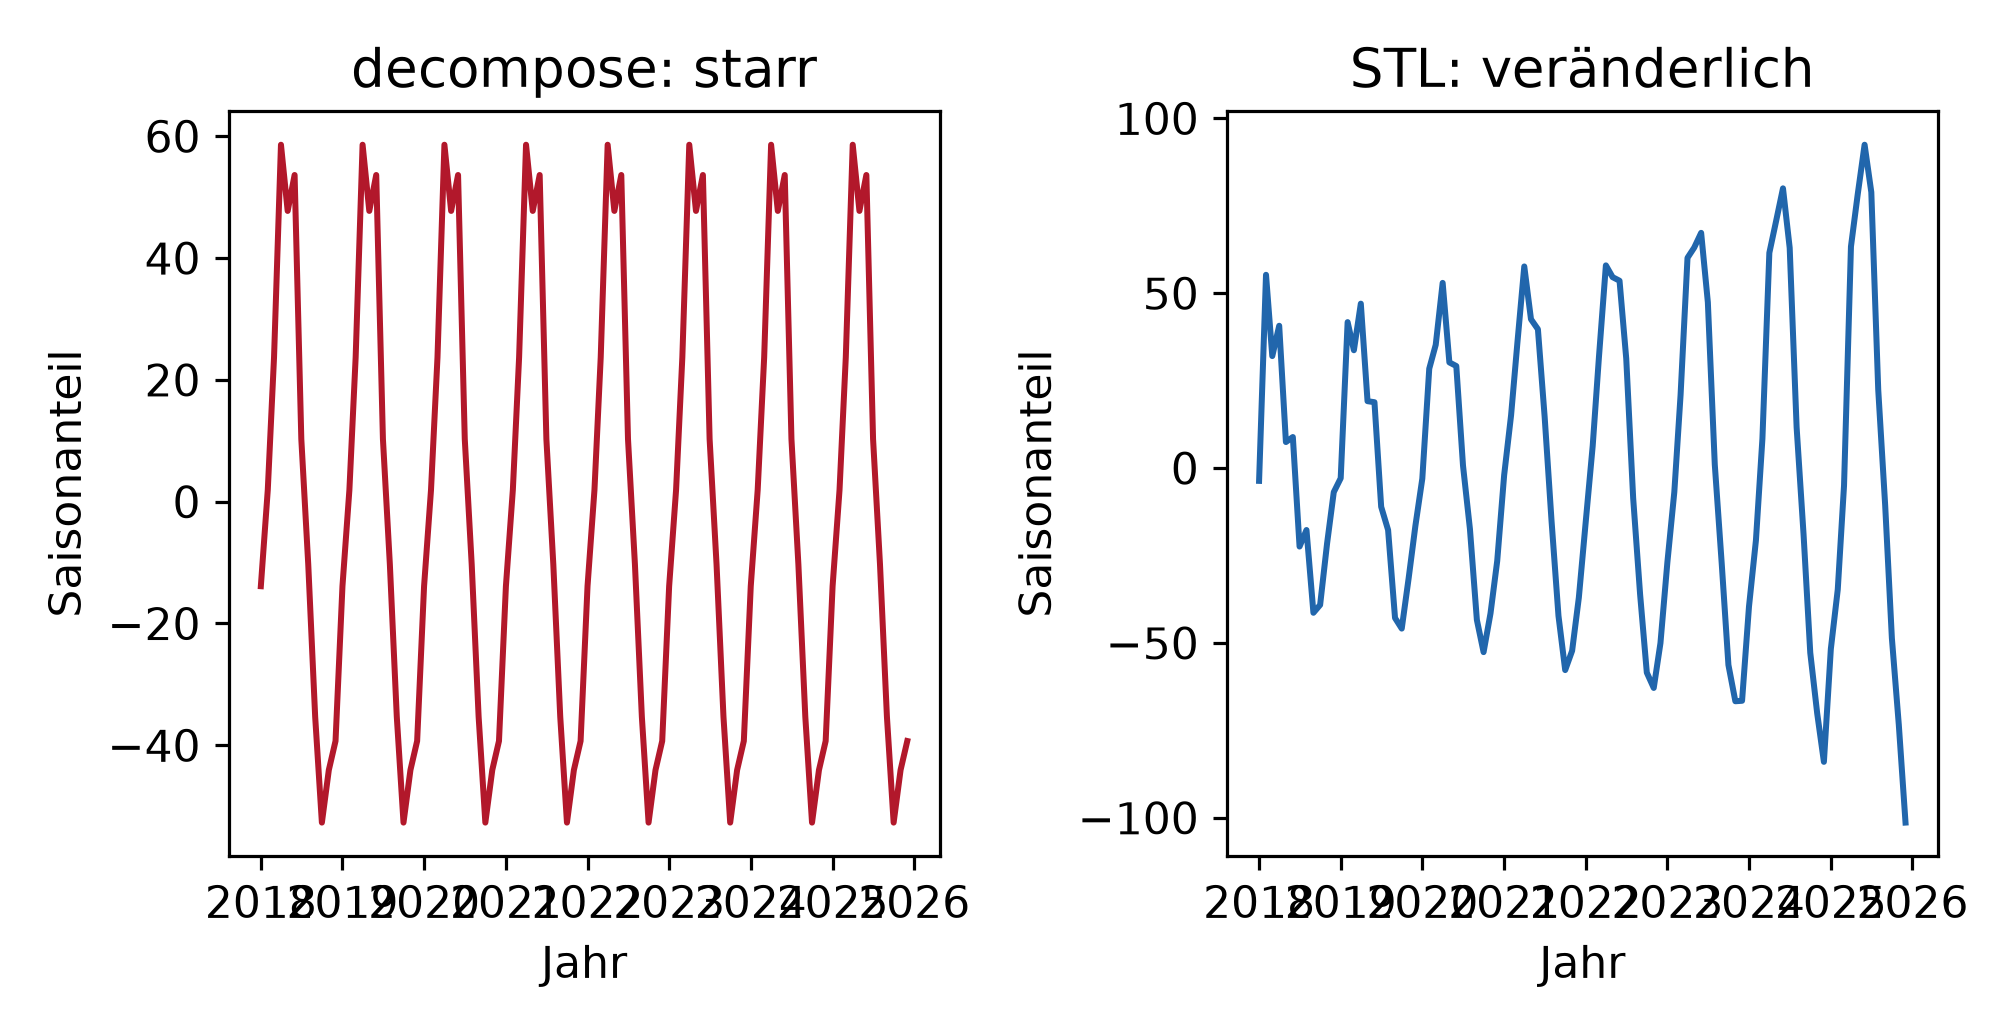
decompose() erzwingt in jedem Jahr dieselbe Saisonfigur. Was passiert, wenn sich die Saison über die Jahre tatsächlich verändert?
Konstruiert wird eine Reihe über acht Jahre, deren Saisonamplitude von rund 30 auf 90 wächst und deren Hochpunkt sich langsam verschiebt.
Die Spannweite der geschätzten Saisonfigur, Jahr für Jahr:
Jahr
2018
2019
2020
2021
2022
2023
2024
2025
decompose
111.3
111.3
111.3
111.3
111.3
111.3
111.3
111.3
STL, R
106.7
107.7
110.3
115.1
117.3
130.6
136.8
140.1
STL, Python
96.6
92.9
105.6
115.4
120.8
133.9
164.0
193.8
Ausgabe
Wert hier
Wie er zu lesen ist
decompose: achtmal 111.3
Nicht ähnlich, sondern identisch, die Figur wird einmal geschätzt und in jedem Jahr wiederholt. Der Wert ist der Mittelwert über acht Jahre und beschreibt kein einziges davon richtig.
STL: von rund 100 auf 140 bis 194 wachsend
Das Verfahren folgt der tatsächlichen Entwicklung.
R und Python weichen dabei ab
140.1 gegen 193.8 im letzten Jahr
Beide verwenden ein Glättungsfenster von 7 für die Saison, aber verschiedene Voreinstellungen für die inneren Iterationen und die Trendglättung. Das Fenster steuert, wie schnell sich die Figur ändern darf, R glättet hier stärker. Wer STL berichtet, nennt Fensterbreite und Umgebung dazu.
Rest sd decompose
21.24 in beiden
Rest sd STL
16.81 in R, 11.17 in Python
In beiden Fällen deutlich kleiner. Was decompose() nicht in die Saison stecken kann, landet im Rest, dort steht also Struktur, die keine sein sollte.
Damit ist auch die Diagnose beschrieben: Ein Rest, dessen Schwankungsbreite sich über die Jahre systematisch ändert, ist das Erkennungszeichen einer Saisonfigur, die nicht mehr passt. Bei decompose() wächst der Betrag des Rests gegen Ende der Reihe deutlich an, bei STL bleibt er ungefähr gleich.
Was STL zusätzlich kann und was es kostet. STL glättet Trend und Saison getrennt mit lokalen Regressionen; die Fensterbreite s.window beziehungsweise seasonal steuert, wie schnell sich die Saisonfigur ändern darf. Ein kleines Fenster folgt jedem Jahr, ein grosses nähert sich der starren Figur an; s.window = "periodic" in R erzwingt sie ganz.
Der Preis ist eine Entscheidung mehr und die Gefahr, mit einem zu kleinen Fenster Rauschen in die Saison zu ziehen. Mit robust = TRUE werden Ausreisser zudem heruntergewichtet, statt die Figur zu verbiegen.
Interpretation und Ergebnissatz
Die Saisonamplitude wächst über den Beobachtungszeitraum um rund 40 Prozent. Eine klassische Zerlegung mit starrer Saisonfigur bildet das nicht ab und verschiebt die Differenz in den Rest (Standardabweichung 21.2 gegenüber 16.8 bei STL mit s.window = 7); berichtet wird die STL-Zerlegung.
Frage und Datenlage
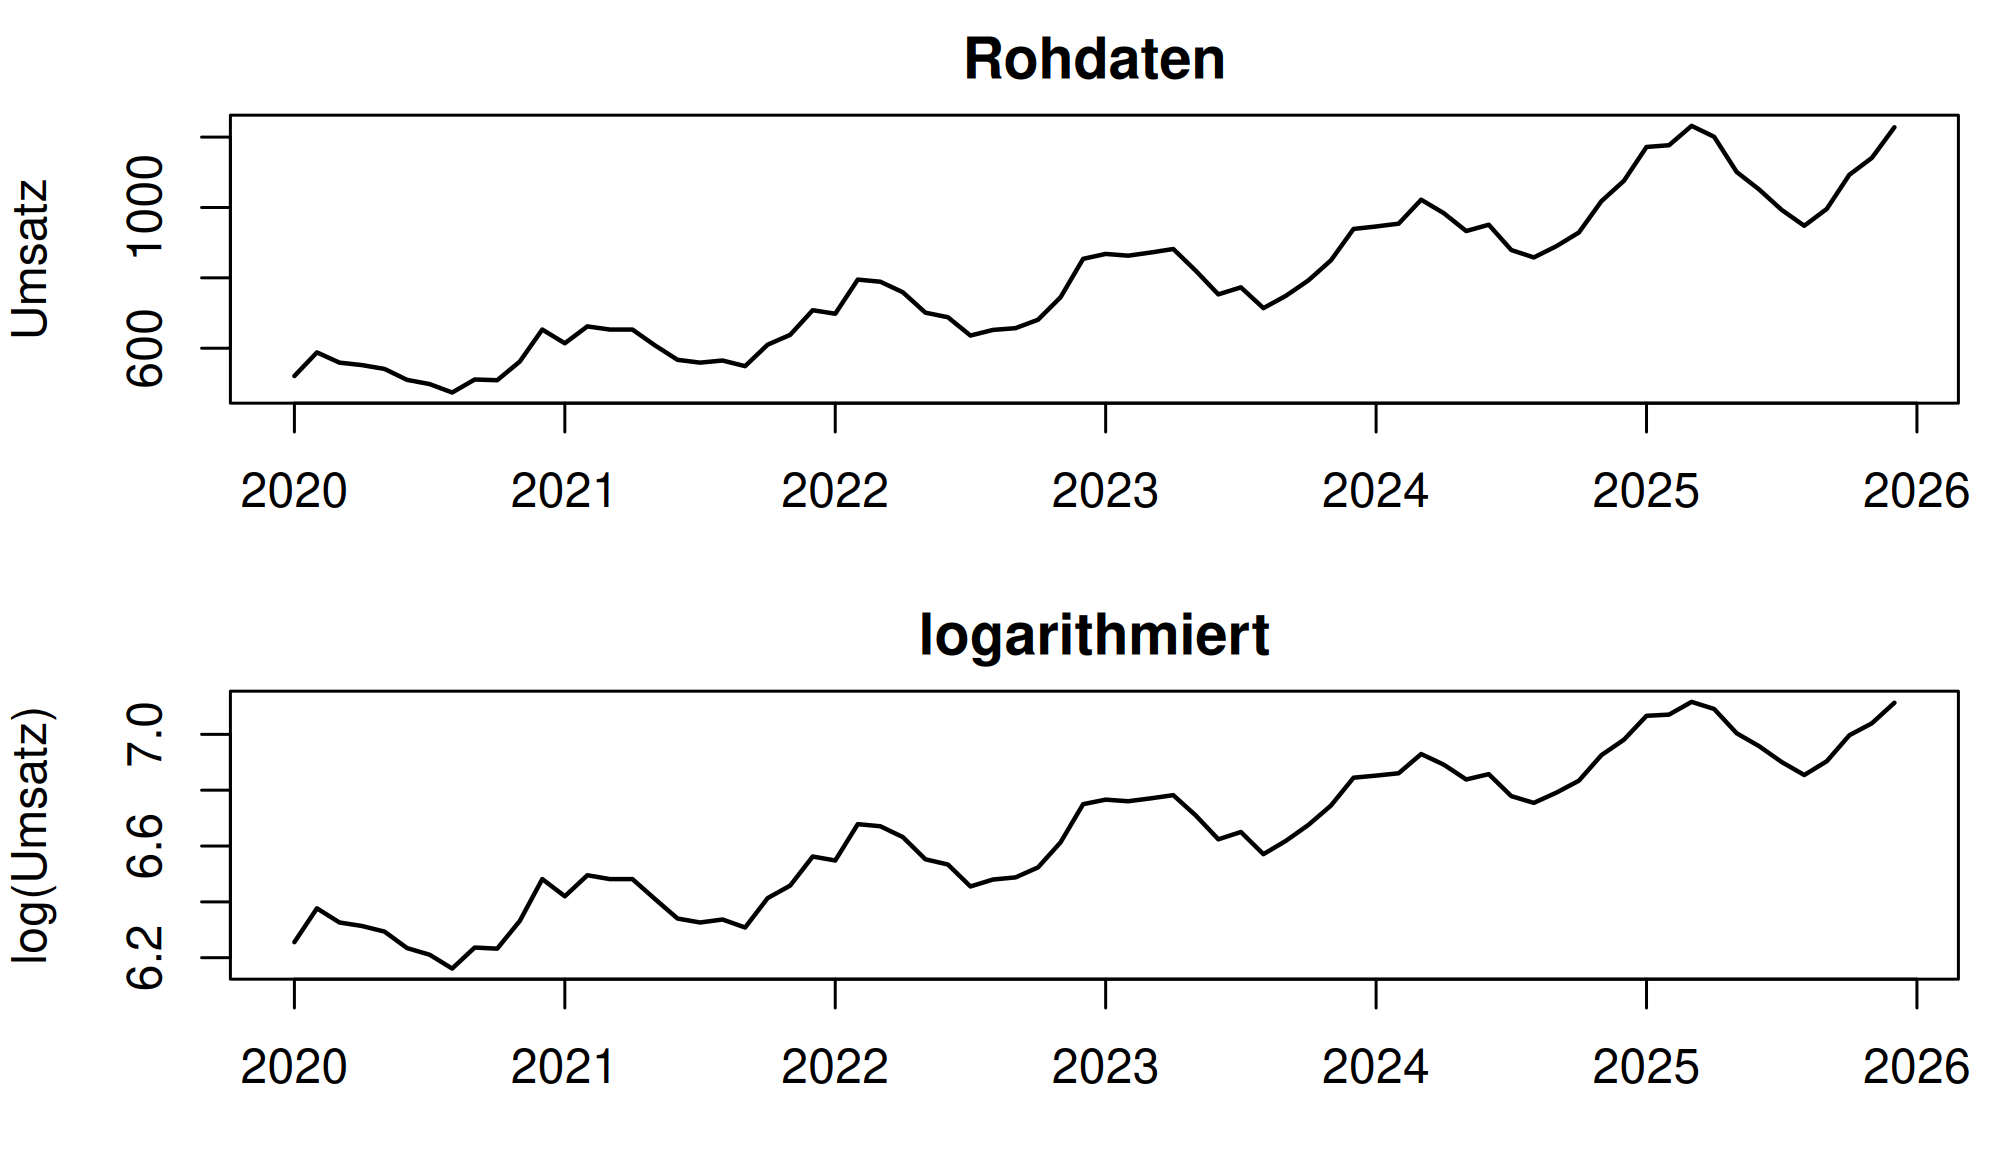
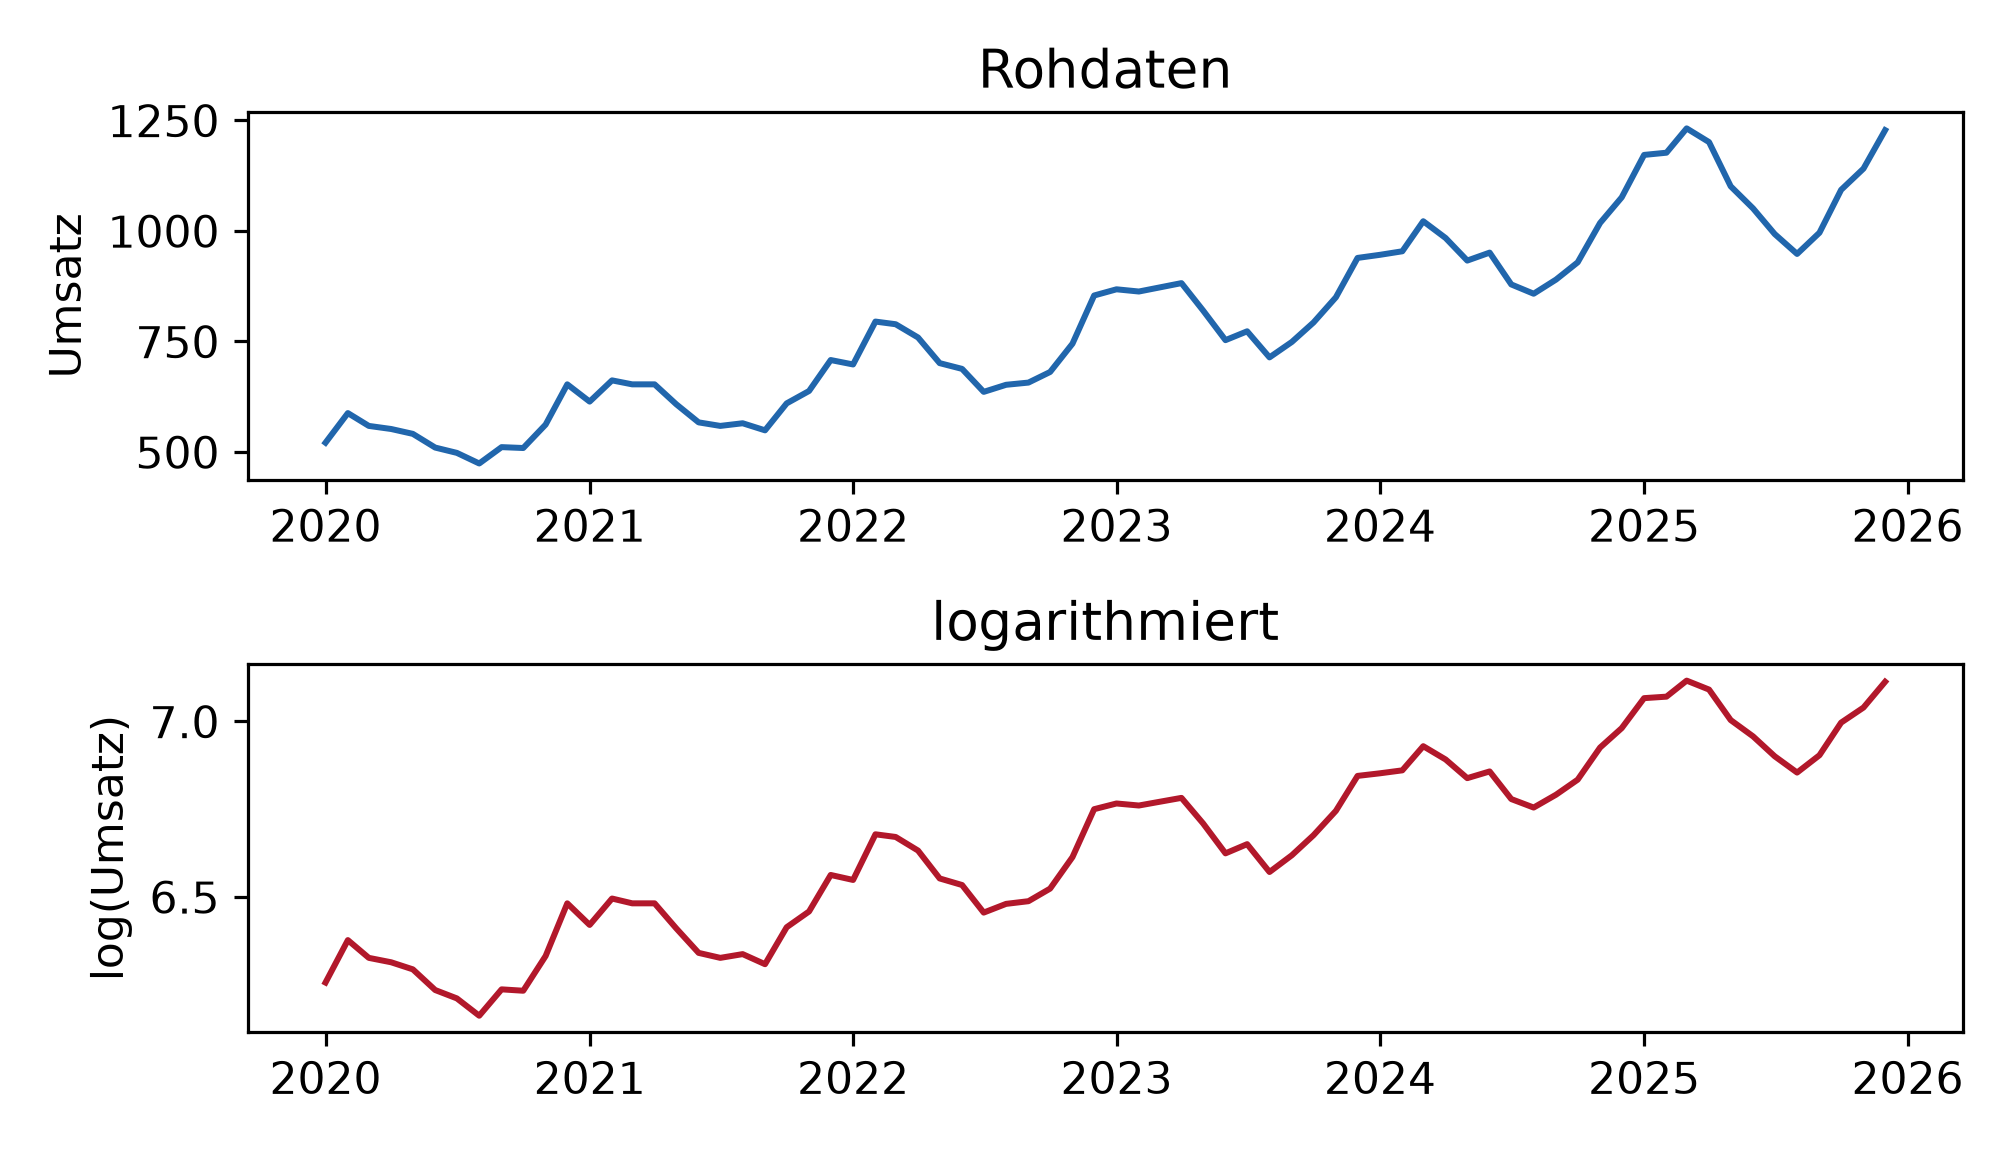
Eine Umsatzreihe, die um 1.2 Prozent je Monat wächst und deren Saisonschwankung prozentual konstant ist. Was tut eine additive Zerlegung damit, und was ändert der Logarithmus?
Die Zacken werden mit dem Niveau höher, das Erkennungszeichen multiplikativer Struktur. Der Umsatz steigt im selben Zeitraum von rund 520 auf 1200, also um den Faktor 2.3; die Spannweite um den Faktor 1.6.
Logarithmiert: zwischen 0.226 und 0.320, ohne Richtung
Nach dem Logarithmieren schwankt die Breite nur noch zufällig, statt zu wachsen. Genau das ist der Zweck: Aus einem konstanten Verhältnis wird eine konstante Differenz.
Rest sd additiv: 23.01
Auf der Skala der Rohdaten.
Rest sd multiplikativ: 0.0227
Ein Faktor, kein Betrag: Der Rest schwankt um 2.3 Prozent um den Wert 1.
Die beiden Reste sind nicht direkt vergleichbar, sie stehen auf verschiedenen Skalen. Vergleichbar wird es über die Struktur im Rest: Beim additiven Modell wächst der Betrag des Rests mit dem Niveau (Korrelation 0.20), beim multiplikativen nicht (-0.11).
Zwei Wege, dasselbe zu tun:
Weg
Rechnung
Wann
multiplikatives Modell
\(y_t = T_t \cdot S_t \cdot R_t\)
wenn die Software es anbietet und man auf der Originalskala bleiben will
logarithmieren, dann additiv
\(\ln y_t = \ln T_t + \ln S_t + \ln R_t\)
fast immer besser: Danach sind alle Verfahren für additive Reihen anwendbar, inklusive ARIMA
Der Preis des Logarithmierens ist die Rücktransformation. \(e^{\hat{y}}\) schätzt den Median, nicht den Mittelwert der Originalskala; für den Mittelwert braucht es eine Korrektur um \(e^{\sigma^2/2}\). Und Nullwerte sind nicht logarithmierbar.
Interpretation und Ergebnissatz
Die Saisonschwankung wächst mit dem Niveau (Spannweite je Jahr von 179 auf 284 bei einem Anstieg des Niveaus um den Faktor 2.3); nach Logarithmierung schwankt sie ohne Richtung zwischen 0.23 und 0.32. Modelliert wird deshalb die logarithmierte Reihe mit additiver Zerlegung.
Frage und Datenlage
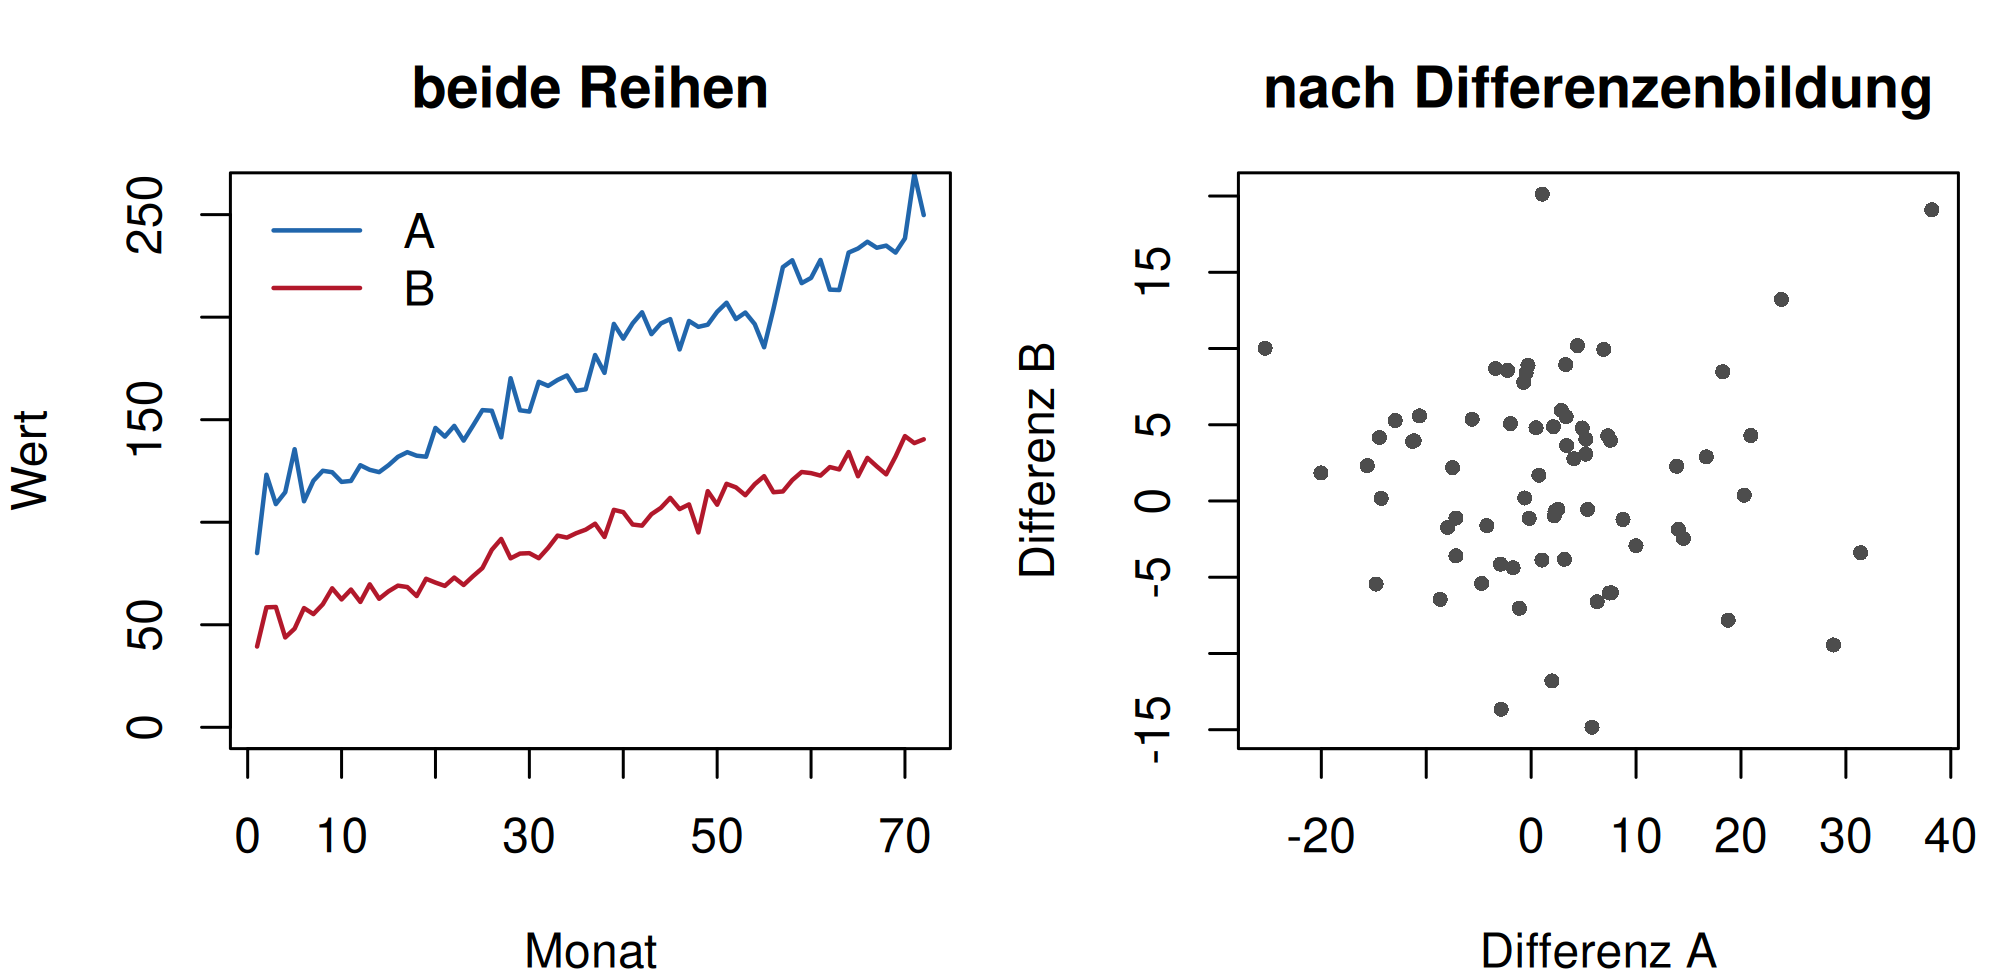
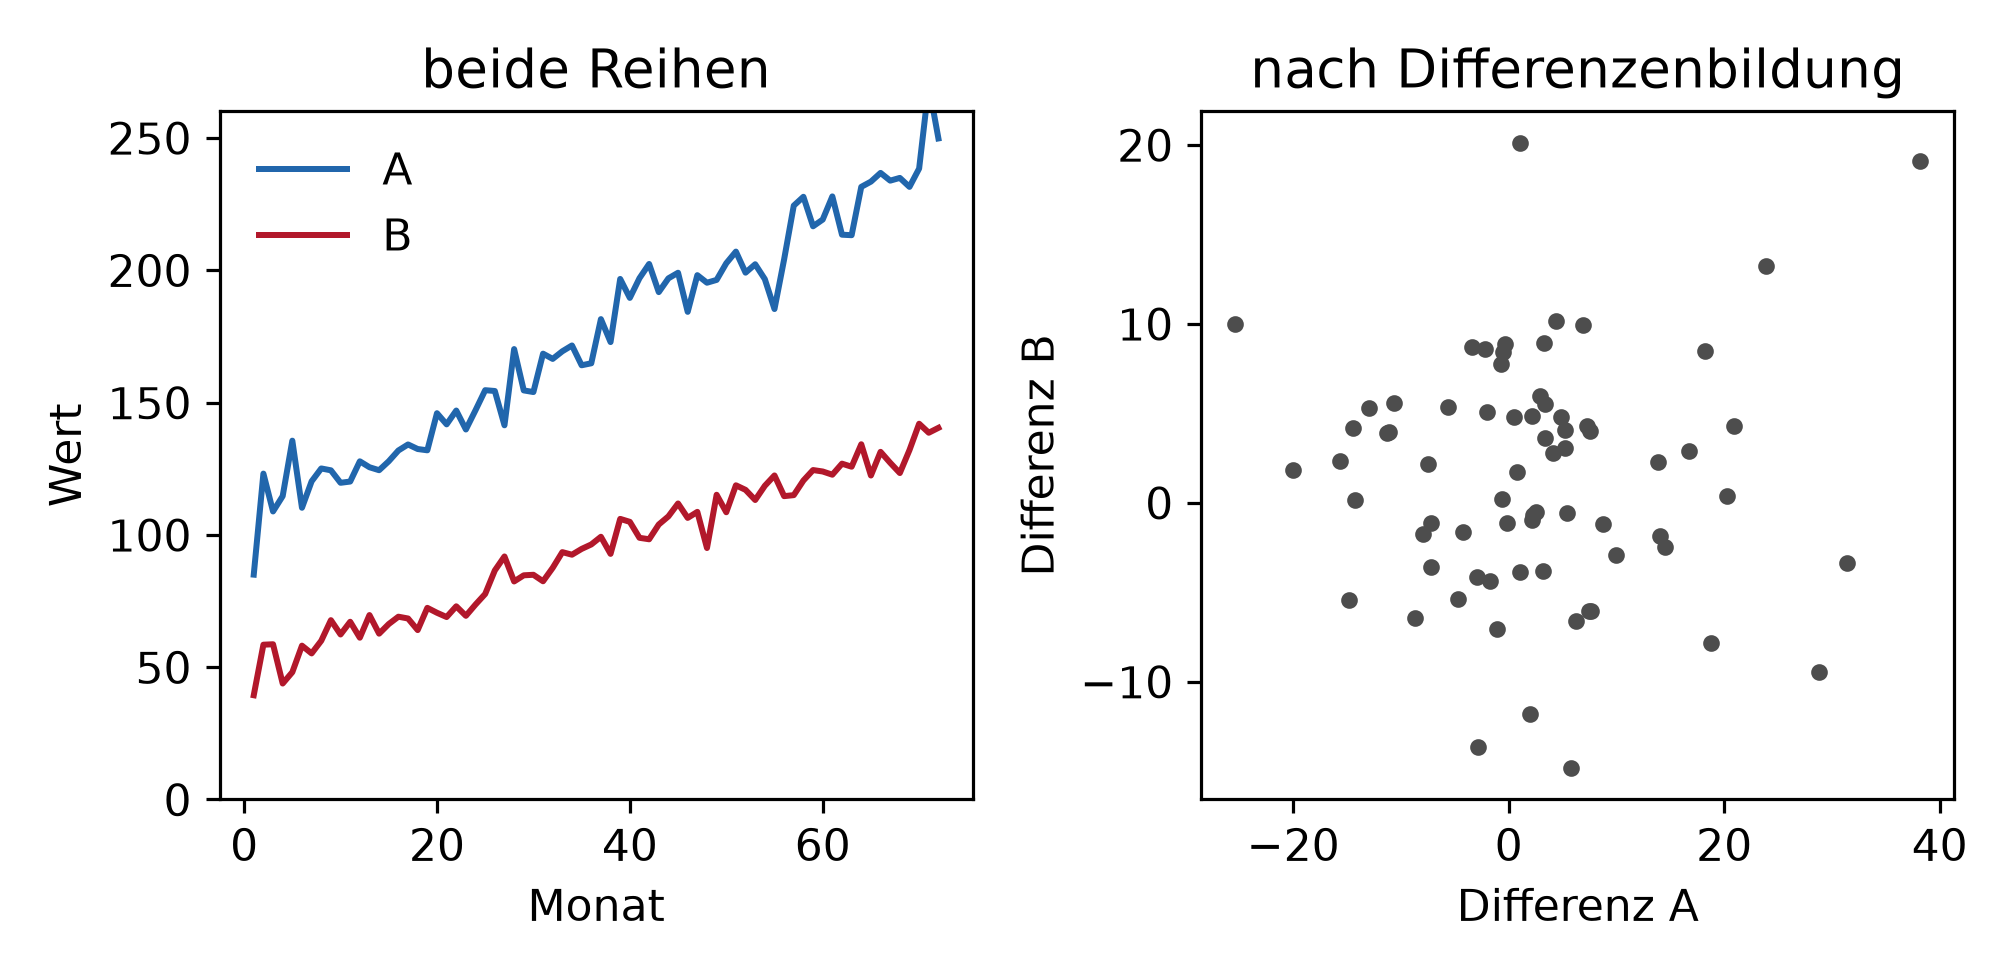
Zwei Reihen, die inhaltlich nichts miteinander zu tun haben. Beide steigen linear und enthalten unabhängiges Rauschen. Wie hoch ist ihre Korrelation?
Abbildung 10: Beispiel 5: dieselbe Gegenüberstellung in Python.
for name, x, y in [("roh", reihe_a, reihe_b), ("Differenzen", np.diff(reihe_a), np.diff(reihe_b))]: r, p = stats.pearsonr(x, y)print(f"{name:12s} r = {r: .4f} p = {p:.4f}")
roh          r =  0.9636   p = 0.0000
Differenzen  r =  0.0310   p = 0.7977
Output Zeile für Zeile
Rechnung
\(r\)
p
auf den Rohreihen
0.964
< .001
auf den Monatsdifferenzen
0.031
0.798
Ausgabe
Wie sie zu lesen ist
\(r = 0.964\) auf den Rohreihen
Ein Wert, der in jeder Querschnittsauswertung als sehr starker Zusammenhang gälte. Hier ist er vollständig durch die Konstruktion erzeugt: Beide Reihen steigen, also sind beide früh klein und spät gross. Die Korrelation misst nur das.
\(p < .001\)
Der Test macht es nicht besser, sondern schlimmer: Er verleiht dem Artefakt den Anschein von Verlässlichkeit. Seine Voraussetzung, unabhängige Beobachtungen, ist bei Zeitreihen verletzt, der p-Wert also ohnehin nicht gültig.
\(r = 0.031\) auf den Differenzen
Nach Entfernen des Trends bleibt nichts übrig. Das ist die richtige Antwort.
\(p = 0.798\)
Ebenfalls unauffällig.
Das rechte Streudiagramm
zeigt eine strukturlose Punktwolke, im Gegensatz zu den beiden parallel steigenden Linien links.
Warum die Differenzenbildung hilft:\(\Delta y_t = y_t - y_{t-1}\) entfernt einen linearen Trend vollständig, denn die konstante Steigung fällt beim Subtrahieren heraus. Was bleibt, sind die Abweichungen von Monat zu Monat und genau dort sitzt der Zusammenhang, wenn es einen gibt.
Warum das nicht die ganze Lösung ist: Auch differenzierte Reihen können gemeinsame Zyklen haben, und die Unabhängigkeitsannahme des Korrelationstests bleibt fraglich. Die saubere Behandlung von Zusammenhängen zwischen Zeitreihen läuft über Modelle, die die Autokorrelation ausdrücklich abbilden, siehe Stationarität und ARIMA.
Und der Sonderfall, in dem gerade der gemeinsame Trend echt ist, heisst Kointegration, dann ist das Differenzieren zu viel des Guten. Erkennbar daran, dass die Differenz der beiden Reihen selbst stationär ist.
Interpretation und Ergebnissatz
Zwischen den beiden Reihen besteht kein nachweisbarer Zusammenhang: Auf den Monatsdifferenzen beträgt die Korrelation 0.03 (p = .80, n = 71). Die Korrelation der Rohreihen von 0.96 geht vollständig auf den gemeinsamen Aufwärtstrend zurück und ist inhaltlich nicht deutbar.
Verständnisfragen
Eine Monatsreihe zeigt Saisonzacken, die mit dem steigenden Niveau immer höher werden. Was folgt für die Zerlegung?
Additive Zerlegung, sie ist der Standard
Sie unterstellt konstante Schwankungsbreite und passt hier nicht.
Multiplikative Zerlegung, oder additiv nach Logarithmierung
Richtig. Wenn die Schwankung mit dem Niveau wächst, ist die Struktur multiplikativ. Das Logarithmieren macht aus dem Produkt eine Summe und erlaubt danach alle Verfahren für additive Reihen.
Die Saison muss vorher entfernt werden
Das ist das Ergebnis der Zerlegung, nicht ihre Voraussetzung.
Im Rest der Zerlegung schwankt der Betrag über die Jahre systematisch: erst klein, später gross. Was heisst das?
Die Saisonfigur passt nicht mehr, weil sie sich verändert hat
Richtig. Was decompose() nicht in die starre Figur stecken kann, landet im Rest. STL erlaubt eine Saisonfigur, die sich langsam ändert, und halbiert im Beispiel die Reststreuung.
Das ist normal, der Rest enthält immer Muster
Er enthält Rauschen; ein systematisches Muster ist ein Befund.
Die Reihe ist zu kurz
Eine kurze Reihe erzeugt kein systematisch wachsendes Restmuster.
Warum fehlt der Trend aus decompose() an beiden Rändern der Reihe?
Weil ein zentriertes gleitendes Mittel eine halbe Periode Vergangenheit und Zukunft braucht
Richtig. Bei Periode 12 fehlen je sechs Werte. Deshalb liefert das Verfahren gerade für den aktuellsten Monat keinen Trend und taugt nicht zur Vorhersage.
Weil dort zu wenige Beobachtungen vorliegen
Die Beobachtungen sind da; es fehlen die Nachbarn, über die gemittelt wird.
Weil die Saison am Rand nicht bestimmbar ist
Die Saisonfigur wird über alle Jahre geschätzt und gilt auch am Rand.
Zwei Reihen mit deutlichem Aufwärtstrend korrelieren mit 0.96 bei p < .001. Was folgt?
Ein starker Zusammenhang zwischen den beiden Grössen
Der gemeinsame Trend genügt für eine hohe Korrelation, auch ohne jeden inhaltlichen Zusammenhang.
Nichts, solange der Trend nicht entfernt ist
Richtig. Auf den Monatsdifferenzen bleibt im Beispiel r = 0.03 übrig. Der p-Wert ist zusätzlich ungültig, weil er unabhängige Beobachtungen voraussetzt.
Die Korrelation ist falsch berechnet
Sie ist korrekt berechnet und trotzdem inhaltlich wertlos.
Die geschätzte Saisonfigur weicht für den Februar um 11 Einheiten von der tatsächlichen ab. Ist das ein Problem?
Nein, bei sechs Jahren ist das die normale Schätzunsicherheit
Richtig. Der Standardfehler je Monat ist etwa die Reststreuung geteilt durch die Wurzel aus der Anzahl Jahre, hier rund 8. Eine Saisonfigur ist deshalb nicht auf die Nachkommastelle deutbar.
Ja, die Zerlegung ist fehlerhaft
Sie rechnet korrekt; die Unsicherheit steckt in den Daten.
Ja, es hätte multiplikativ gerechnet werden müssen
Die Schwankungsbreite ist konstant; additiv ist richtig.