matplotlib

matplotlib
Visualisierung
Python
R
Figure und Axes, Achsen, Beschriftung und Export in Python.

Kernideen

  • Figure ist die Leinwand, Axes das Koordinatensystem darin, Axis die einzelne Achse. Die Ähnlichkeit der letzten beiden Namen ist eingebaut und muss gemerkt werden.
  • Es gibt zwei Bedienweisen. Der objektorientierte Weg ist der einzige, der bei mehreren Grafiken eindeutig bleibt.
  • plt.subplots() liefert Figure und Axes in einem Schritt und ist deshalb der übliche Einstieg.
  • Vier Grundtypen decken fast alles ab: Linie, Streuung, Balken, Histogramm.
  • Beim Export entscheiden dpi und bbox_inches darüber, ob die Grafik brauchbar ist.
  • matplotlib zeichnet, was man sagt, Gruppierung, Legende und Reihenfolge macht man selbst. Das ist der Unterschied zu ggplot2.

Erklärung

Vorwissen: NumPy und SciPy und pandas, weil die Daten von dort kommen. Wer ggplot2 kennt, hat den Vergleich im Kopf; der Unterschied im Denkansatz ist der rote Faden dieser Seite.

Die Begriffe

Begriff Was es ist
Figure das ganze Bild, samt Grösse und Auflösung
Axes ein einzelnes Koordinatensystem darin
Axis eine Achse, also x oder y

Die Verwechslung von Axes und Axis ist eingebaut und lässt sich nur merken: Ein Axes ist die Zeichenfläche, kein Strich. In dieser Sammlung heisst die Variable deshalb konsequent achse beziehungsweise achsen, nie ax.

Zwei Bedienweisen, und warum das verwirrt

Matplotlib lässt sich auf zwei Arten bedienen, und Codebeispiele im Netz mischen beide. Wer den Unterschied nicht kennt, kopiert Zeilen zusammen, die nicht zusammenpassen.

Weg Aufruf Wirkt auf
pyplot plt.scatter(...), plt.xlabel(...) die aktuelle Grafik, implizit
objektorientiert achse.scatter(...), achse.set_xlabel(...) genau das benannte Axes

Die Empfehlung gilt ohne Ausnahme, sobald mehr als eine Grafik im Spiel ist: der objektorientierte Weg. Nur so bleibt eindeutig, wohin gezeichnet wird, und nur so lassen sich Grafiken in Funktionen erzeugen und zurückgeben.

Ein Nebeneffekt, der in dieser Sammlung überall auftaucht: Jeder matplotlib-Aufruf gibt ein Objekt zurück, und in einem Quarto-Chunk wird das mitgedruckt. Deshalb steht im Code _ = achse.scatter(...).

Der Unterschied im Denkansatz

ggplot2 matplotlib
Gruppen aes(colour = typ) erzeugt Gruppen, Farben und Legende man schleift selbst über die Gruppen
Legende entsteht aus der Zuordnung entsteht aus label= plus legend()
Teilbilder facet_wrap() plt.subplots() und eigene Schleife
Statistik geom_smooth() rechnet mit selbst rechnen, etwa mit np.polyfit
Theme theme_minimal() plt.style.use() oder rcParams

Keines der beiden ist besser. ggplot2 nimmt einem Arbeit ab und schreibt dafür vor, wie die Daten aussehen müssen; matplotlib verlangt mehr Zeilen und lässt dafür alles zu.

Der Datensatz dieser Seite

150 Maschinen mit Laufzeit, Typ und Stromverbrauch, deterministisch erzeugt, damit die R- und die Python-Fassung dieselben Maschinen zeigen.

Beispiele

Frage und Datenlage

Derselbe Inhalt auf beide Arten. Und danach der Fall, in dem der Unterschied sichtbar wird: zwei Grafiken nacheinander.

Rechnung

str(maschinen)
'data.frame':   150 obs. of  3 variables:
 $ laufzeit : num  2.6 15.9 21 18.1 12.6 4.9 8.3 17.7 3.7 18.5 ...
 $ typ      : Factor w/ 3 levels "Drehbank","Fräse",..: 2 2 2 2 2 2 2 2 2 2 ...
 $ verbrauch: num  15 56 55 58.4 46.3 11.9 23.6 50.3 20.5 56.4 ...
round(c(laufzeit_min = min(maschinen$laufzeit),
        laufzeit_max = max(maschinen$laufzeit),
        verbrauch_min = min(maschinen$verbrauch),
        verbrauch_max = max(maschinen$verbrauch),
        korrelation = cor(maschinen$laufzeit, maschinen$verbrauch)), 4)
 laufzeit_min  laufzeit_max verbrauch_min verbrauch_max   korrelation 
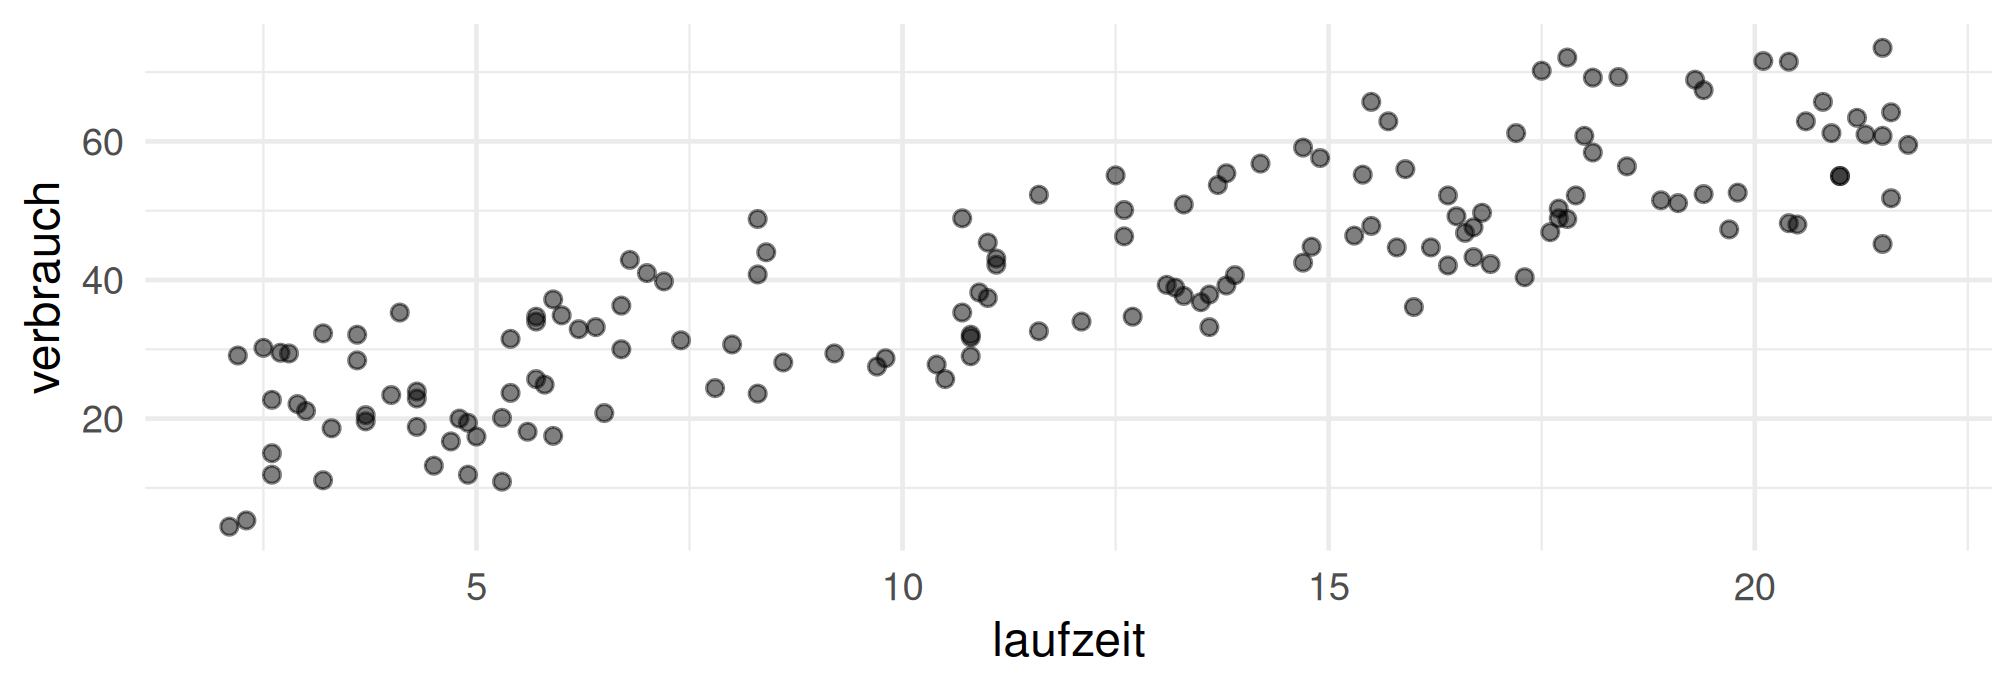
       2.1000       21.8000        4.4000       73.5000        0.8544 
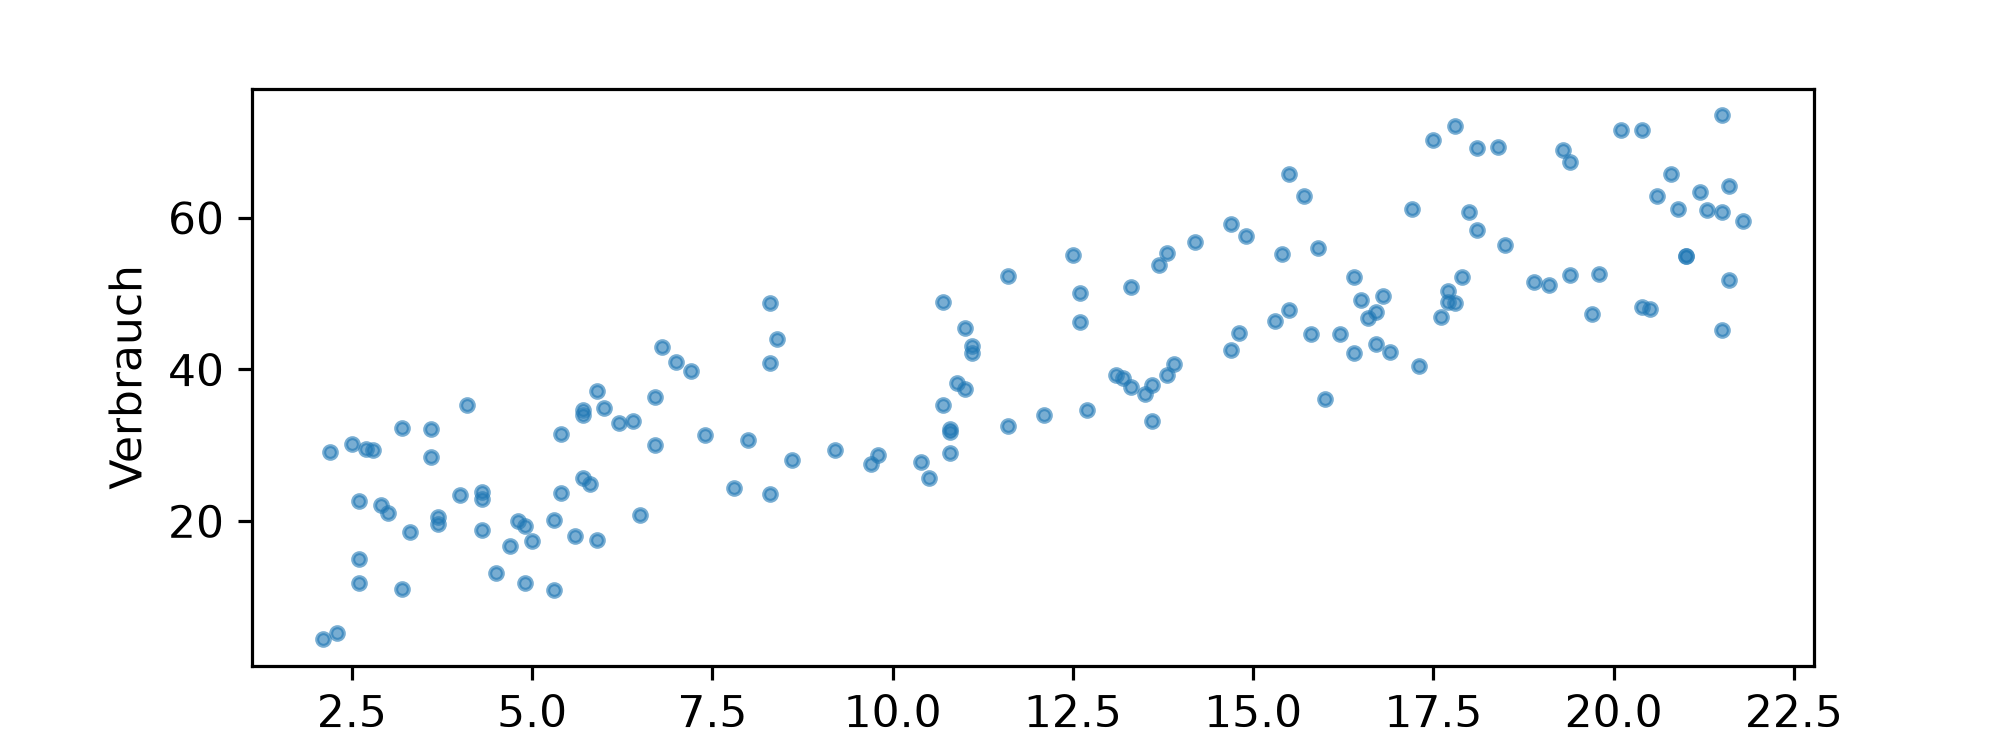
ggplot(maschinen, aes(laufzeit, verbrauch)) +
  geom_point(alpha = 0.6, size = 1.2) +
  labs(x = "Laufzeit in Stunden", y = "Verbrauch")
Abbildung 1: Beispiel 1: In ggplot2 stellt sich die Frage nicht, es gibt nur einen Weg.
print(maschinen.dtypes)
laufzeit     float64
typ           object
verbrauch    float64
dtype: object
print({"laufzeit_min": round(float(laufzeit.min()), 4),
       "laufzeit_max": round(float(laufzeit.max()), 4),
       "verbrauch_min": round(float(verbrauch.min()), 4),
       "verbrauch_max": round(float(verbrauch.max()), 4),
       "korrelation": round(float(np.corrcoef(laufzeit, verbrauch)[0, 1]), 4)})
{'laufzeit_min': 2.1, 'laufzeit_max': 21.8, 'verbrauch_min': 4.4, 'verbrauch_max': 73.5, 'korrelation': 0.8544}
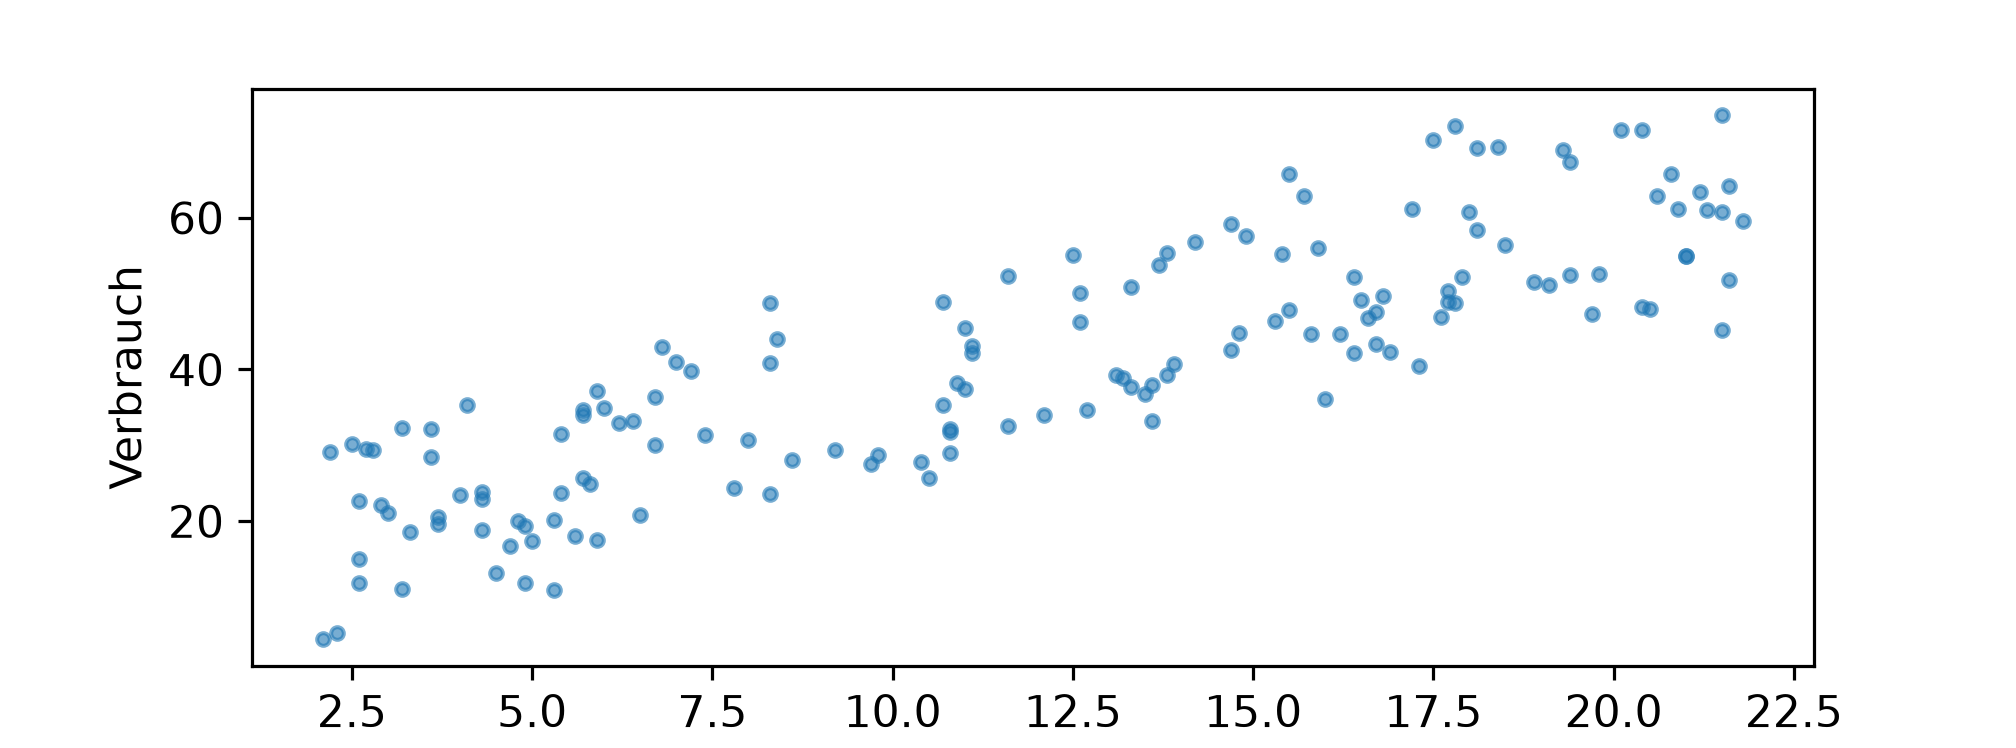
_ = plt.figure(figsize=(7, 2.6))
_ = plt.scatter(maschinen["laufzeit"], maschinen["verbrauch"], s=10, alpha=0.6)
_ = plt.xlabel("Laufzeit in Stunden")
_ = plt.ylabel("Verbrauch")
plt.show()
Abbildung 2: Der pyplot-Weg: kurz für einen Zwischenblick.
fig, achse = plt.subplots(figsize=(7, 2.6))
_ = achse.scatter(maschinen["laufzeit"], maschinen["verbrauch"], s=10, alpha=0.6)
_ = achse.set_xlabel("Laufzeit in Stunden")
_ = achse.set_ylabel("Verbrauch")
plt.show()
Abbildung 3: Derselbe Inhalt objektorientiert: es ist jederzeit eindeutig, wohin gezeichnet wird.
# Warum der Unterschied zaehlt: Welche Grafik ist "die aktuelle"?
fig_a, achse_a = plt.subplots(figsize=(3, 2))
fig_b, achse_b = plt.subplots(figsize=(3, 2))
print({"aktuelle_figur_ist_b": plt.gcf() is fig_b,
       "aktuelle_figur_ist_a": plt.gcf() is fig_a})
_ = achse_a.set_title("A")      # eindeutig
_ = plt.title("B")              # landet auf der zuletzt angelegten
print({"titel_a": achse_a.get_title(), "titel_b": achse_b.get_title()})
plt.close(fig_a)
plt.close(fig_b)

Output Zeile für Zeile

Grösse Wert
Beobachtungen 150
Laufzeit 2.1 bis 21.8 Stunden
Verbrauch 4.4 bis 73.5
Korrelation 0.8544
Prüfung Ergebnis
plt.gcf() is fig_b True
plt.gcf() is fig_a False
Titel auf achse_a “A”
Titel auf achse_b “B”
Beobachtung Erklärung
Beide Wege erzeugen dasselbe Bild Solange nur eine Grafik im Spiel ist, ist der pyplot-Weg kürzer und völlig in Ordnung.
Bei zwei Figuren zeigt plt.gcf() auf die zuletzt angelegte plt.title("B") landet deshalb auf fig_b, obwohl im Code davor achse_a bearbeitet wurde. Genau so entstehen Grafiken, in denen die Beschriftung im falschen Bild steht.
Der objektorientierte Weg benennt das Ziel achse_a.set_title("A") ist unabhängig davon, was zuletzt angelegt wurde.
In ggplot2 stellt sich die Frage gar nicht Dort ist eine Grafik ein Objekt, das man weitergibt. Es gibt keine “aktuelle Grafik”.
Die Variablen heissen hier achse, nicht ax Damit der Unterschied zu Axis beim Lesen präsent bleibt.

Die drei Zeilen, mit denen praktisch jede matplotlib-Grafik beginnt:

fig, achse = plt.subplots(figsize=(7, 4))
...
plt.tight_layout()
plt.show()

tight_layout() verhindert abgeschnittene Beschriftungen, der häufigste Schönheitsfehler beim Export.

Interpretation und Ergebnissatz

Der Datensatz umfasst 150 Maschinen mit Laufzeiten von 2.1 bis 21.8 Stunden und Verbrauchswerten von 4.4 bis 73.5 bei einer Korrelation von 0.8544. Bei zwei offenen Figuren wirkt jeder plt.-Aufruf auf die zuletzt angelegte, der objektorientierte Weg benennt das Ziel und bleibt eindeutig.

Frage und Datenlage

Was genau liefert plt.subplots(2, 2) zurück, und wie spricht man ein einzelnes Teilbild an?

Rechnung

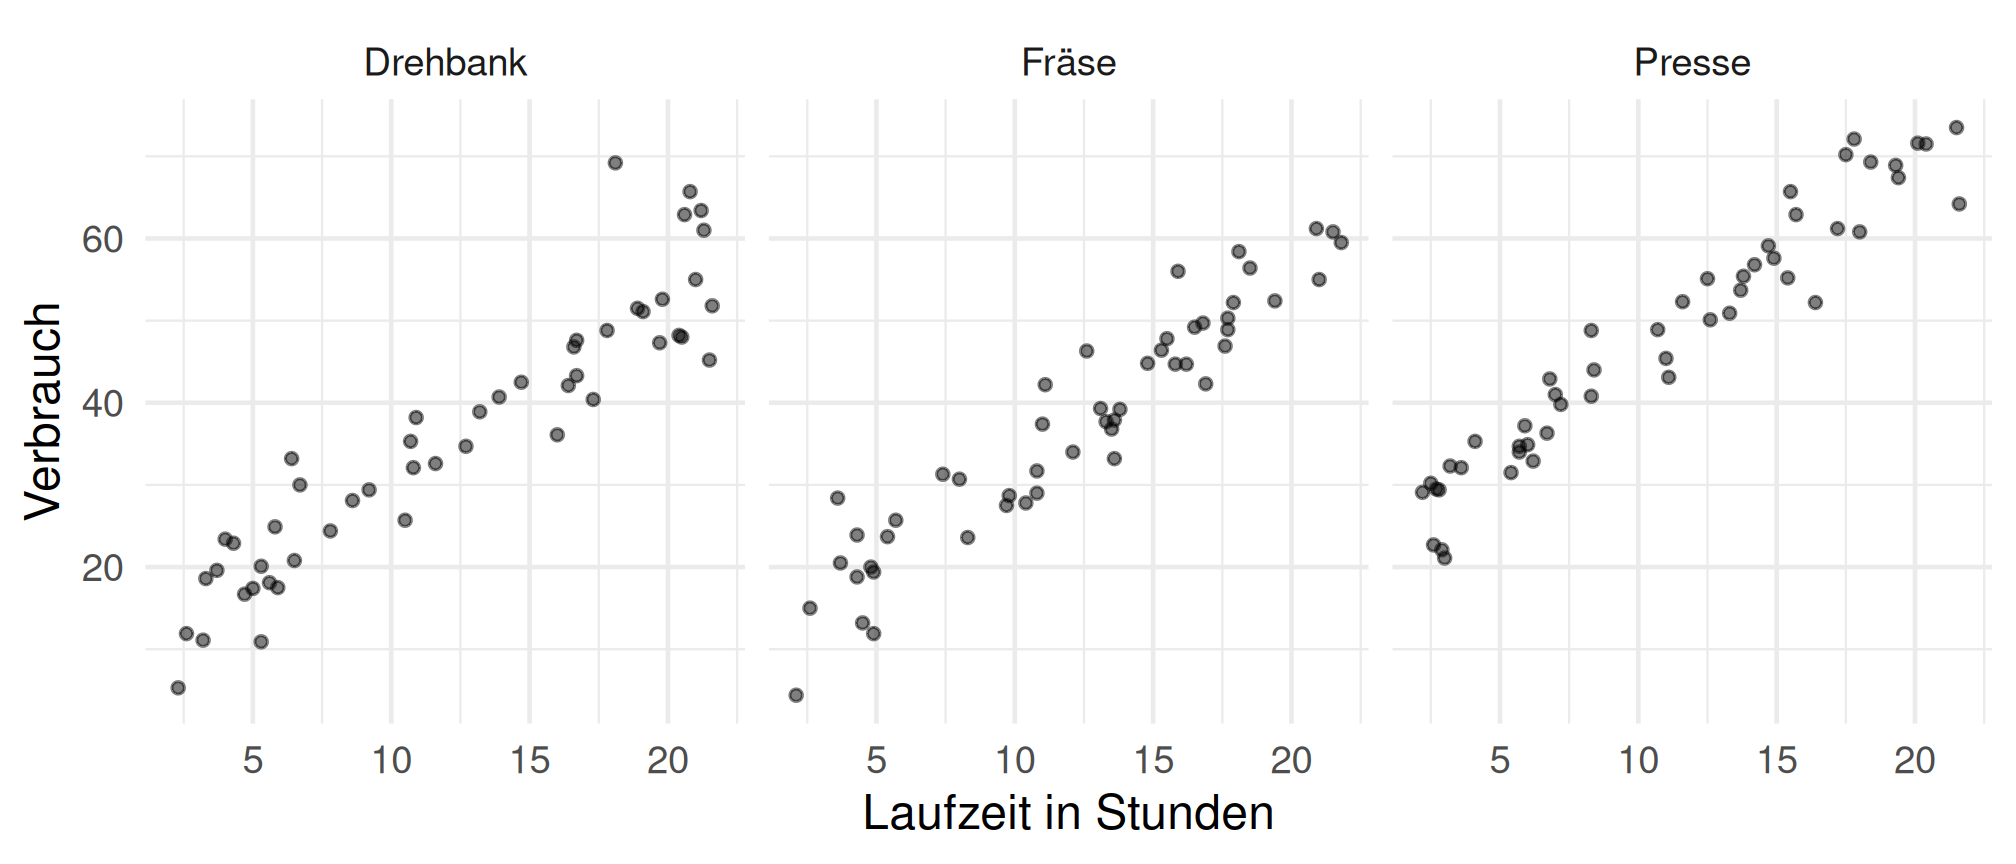
ggplot(maschinen, aes(laufzeit, verbrauch)) +
  geom_point(alpha = 0.5, size = 1.1) +
  facet_wrap(~ typ) +
  labs(x = "Laufzeit in Stunden", y = "Verbrauch")
Abbildung 4: Beispiel 2: In ggplot2 übernimmt facet_wrap die Aufteilung.
round(with(maschinen, tapply(verbrauch, typ, mean)), 2)
Drehbank    Fräse   Presse 
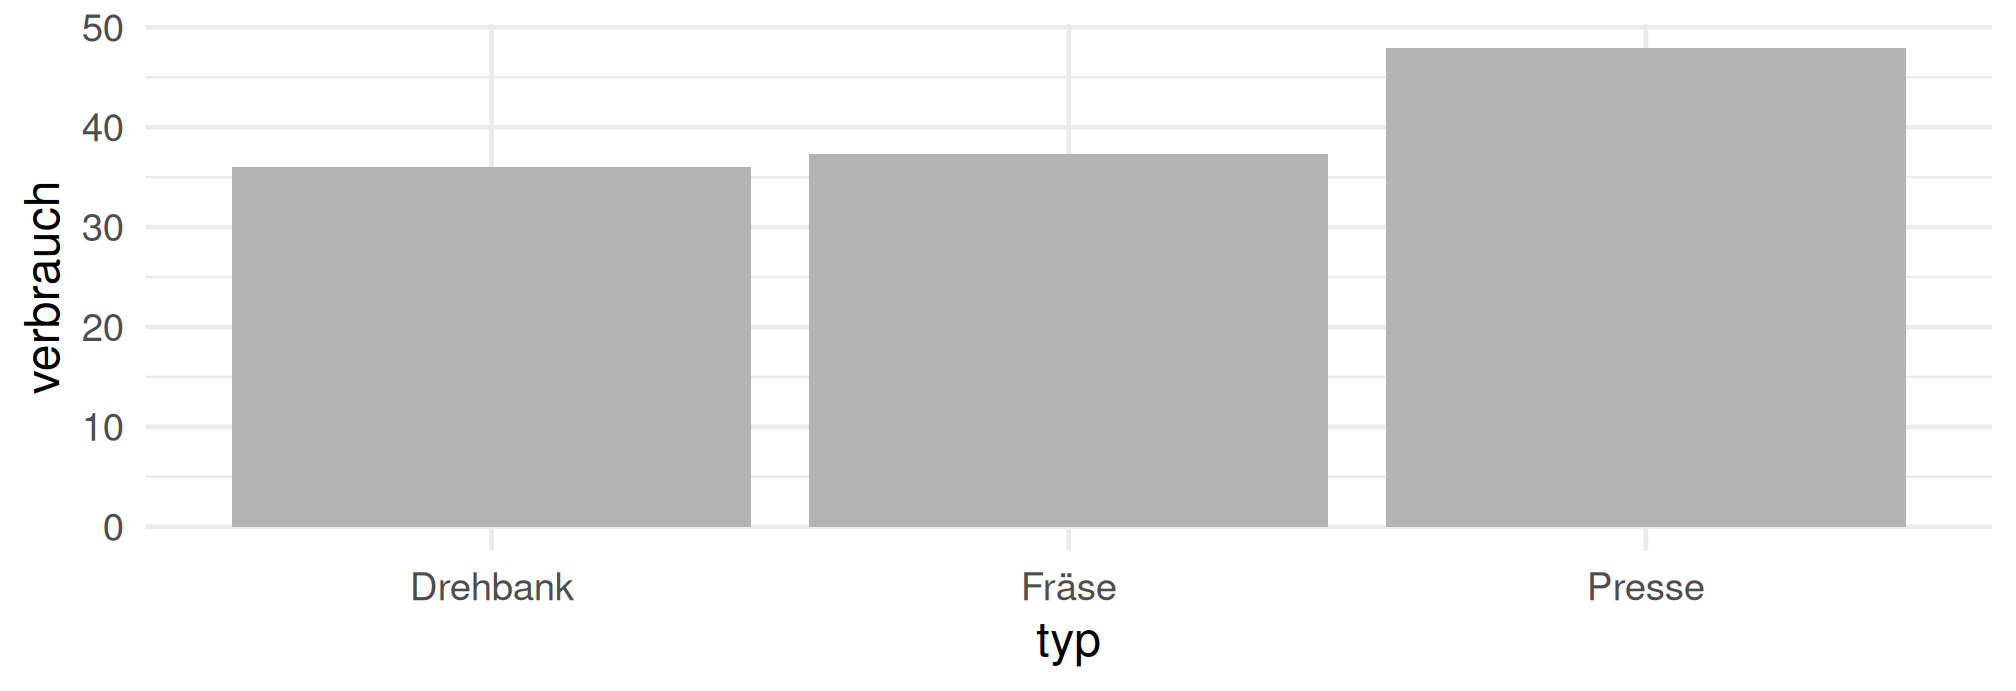
   36.06    37.34    47.95 
table(maschinen$typ)

Drehbank    Fräse   Presse 
      50       50       50 
fig, achsen = plt.subplots(2, 2, figsize=(7, 4))
print({"typ_figur": type(fig).__name__,
       "typ_achsen": type(achsen).__name__,
       "form": achsen.shape,
       "anzahl_axes": achsen.size,
       "typ_einzeln": type(achsen[0, 0]).__name__})
plt.close(fig)

# Bei einer einzigen Teilgrafik ist achsen KEIN Array
fig, achse = plt.subplots(figsize=(3, 2))
print({"einzeln_ist_array": isinstance(achse, np.ndarray),
       "typ": type(achse).__name__})
plt.close(fig)

# Mit squeeze=False bleibt es immer ein Gitter
fig, achsen = plt.subplots(1, 1, squeeze=False, figsize=(3, 2))
print({"mit_squeeze_false": achsen.shape})
plt.close(fig)
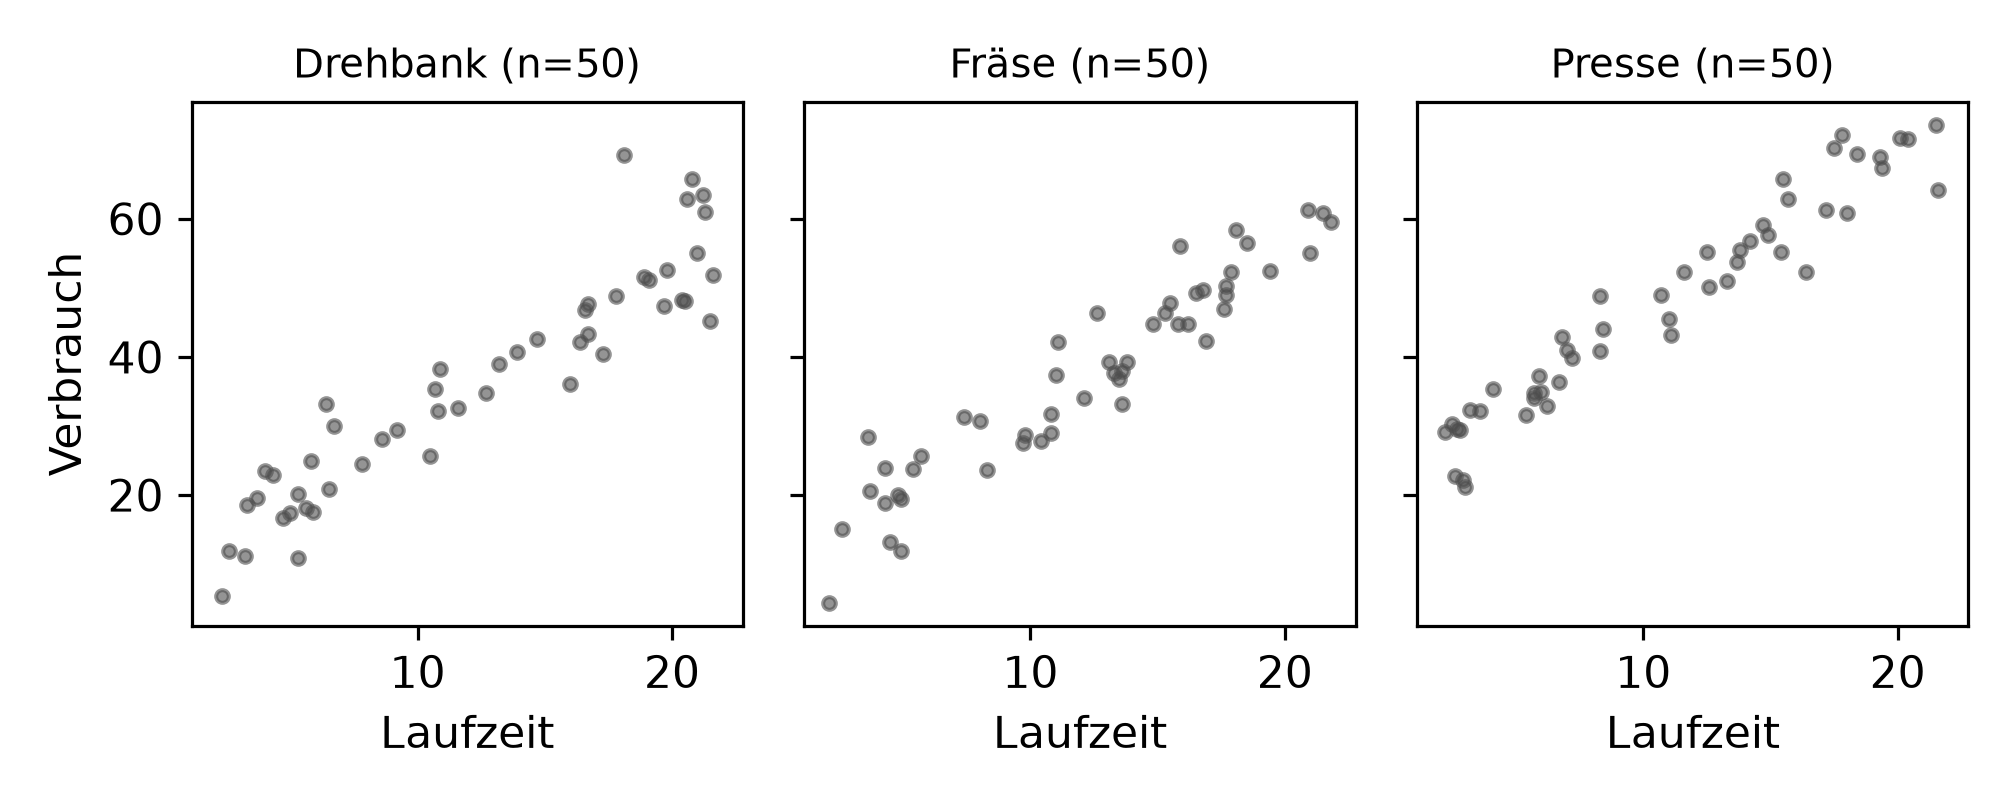
typen = ["Drehbank", "Fräse", "Presse"]
fig, achsen = plt.subplots(1, 3, figsize=(7, 2.8), sharex=True, sharey=True)
for achse, name in zip(achsen, typen):
    teil = maschinen[maschinen["typ"] == name]
    _ = achse.scatter(teil["laufzeit"], teil["verbrauch"], s=10, alpha=0.6,
                      color="0.3")
    _ = achse.set_title(f"{name} (n={len(teil)})", fontsize=10)
    _ = achse.set_xlabel("Laufzeit")
_ = achsen[0].set_ylabel("Verbrauch")
plt.tight_layout()
plt.show()
Abbildung 5: Beispiel 2: ein Teilbild je Maschinentyp, mit gemeinsamen Achsen.

print(maschinen.groupby("typ")["verbrauch"].mean().round(2))

Output Zeile für Zeile

Aufruf Rückgabe
plt.subplots(2, 2) Figure plus ein Array der Form (2, 2) mit 4 Axes
plt.subplots() Figure plus ein einzelnes Axes, kein Array
plt.subplots(1, 1, squeeze=False) Array der Form (1, 1)
Typ Anzahl mittlerer Verbrauch
Drehbank 50 36.06
Fräse 50 37.34
Presse 50 47.95
Beobachtung Erklärung
subplots(2, 2) liefert ein NumPy-Array Ansprechbar über achsen[0, 0] oder, flach durchlaufen, über achsen.ravel().
Bei einer einzigen Teilgrafik gibt es kein Array Das ist die Quelle eines häufigen Fehlers: Code, der mit achsen[0] arbeitet, bricht ab, sobald nur noch eine Teilgrafik übrig ist.
squeeze=False macht es einheitlich Wer eine Funktion schreibt, die mit beliebig vielen Teilbildern umgehen soll, setzt das und spart sich die Fallunterscheidung.
sharex und sharey sind das Gegenstück zu Facetten Ohne sie hat jedes Teilbild eigene Achsen und die Teilbilder sind nicht vergleichbar, derselbe Punkt wie unter Wahrnehmung, Beispiel 5.
Die Gruppierung macht man selbst Die Schleife über typen ist genau die Arbeit, die facet_wrap(~ typ) in ggplot2 abnimmt. Dafür lässt sich hier jedes Teilbild einzeln anders gestalten.

Nützliche Argumente von subplots:

Argument Wirkung
figsize=(b, h) Grösse in Zoll
sharex, sharey gemeinsame Achsen, für Vergleichbarkeit fast immer nötig
squeeze=False Rückgabe bleibt ein Gitter
gridspec_kw={"height_ratios": [2, 1]} ungleich hohe Zeilen, etwa Kurve oben und Residuen unten
constrained_layout=True Alternative zu tight_layout()

Interpretation und Ergebnissatz

plt.subplots(2, 2) liefert eine Figure und ein (2, 2)-Array mit vier Axes, plt.subplots() dagegen ein einzelnes Axes ohne Array, mit squeeze=False bleibt die Form einheitlich. Die drei Maschinentypen haben mittlere Verbrauchswerte von 36.06, 37.34 und 47.95 bei je 50 Maschinen.

Frage und Datenlage

Linie, Streuung, Balken, Histogramm, vier Aufrufe, die fast alles abdecken, je einmal in matplotlib und in ggplot2.

Rechnung

mittel <- aggregate(verbrauch ~ typ, data = maschinen, FUN = mean)
mittel$verbrauch <- round(mittel$verbrauch, 2)
mittel
       typ verbrauch
1 Drehbank     36.06
2    Fräse     37.34
3   Presse     47.95
print(ggplot(maschinen, aes(laufzeit, verbrauch)) + geom_point(alpha = 0.5))
print(ggplot(mittel, aes(typ, verbrauch)) + geom_col(fill = "grey70"))
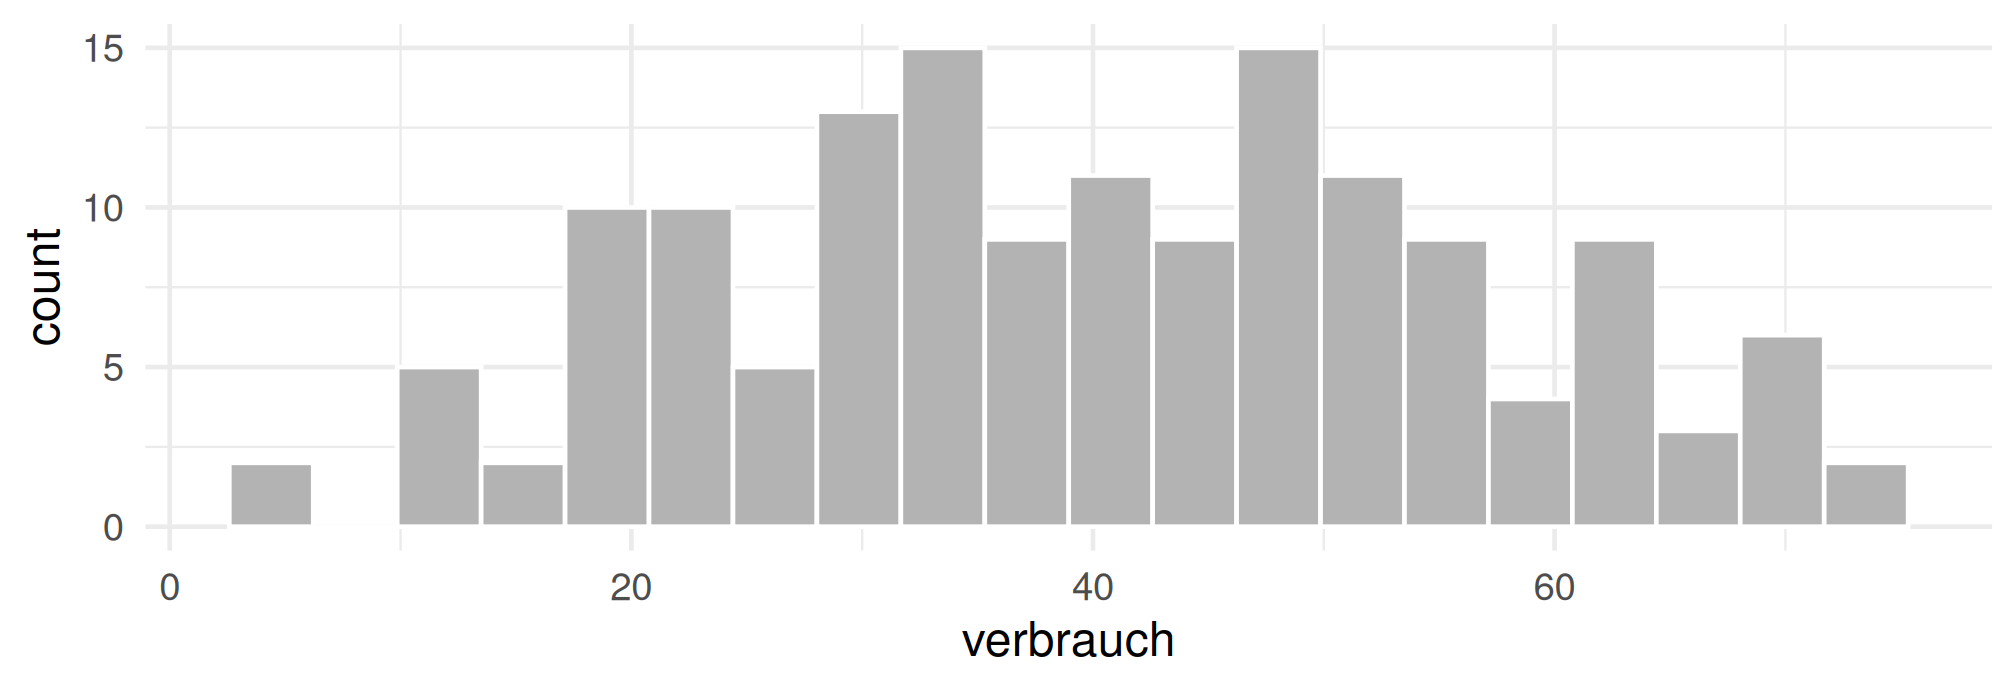
print(ggplot(maschinen, aes(verbrauch)) +
        geom_histogram(bins = 20, fill = "grey70", colour = "white"))
Abbildung 6: Beispiel 3: Streuung, Balken und Histogramm in ggplot2.
Abbildung 7: Beispiel 3: Streuung, Balken und Histogramm in ggplot2.
Abbildung 8: Beispiel 3: Streuung, Balken und Histogramm in ggplot2.
mittel = maschinen.groupby("typ")["verbrauch"].mean().round(2)
print(mittel)

# Fuer die Linie: Verbrauch nach Laufzeit in Stundenklassen
klassen = pd.cut(maschinen["laufzeit"], bins=range(2, 24, 2))
verlauf = maschinen.groupby(klassen, observed=True)["verbrauch"].mean()
print(verlauf.round(2))

fig, achsen = plt.subplots(2, 2, figsize=(7, 4.4))
_ = achsen[0, 0].plot(range(len(verlauf)), verlauf.to_numpy(), marker="o", lw=1.6,
                      color="0.3")
_ = achsen[0, 0].set_title("plot: Verlauf", fontsize=10)
_ = achsen[0, 1].scatter(maschinen["laufzeit"], maschinen["verbrauch"], s=8,
                         alpha=0.5, color="0.3")
_ = achsen[0, 1].set_title("scatter: Zusammenhang", fontsize=10)
_ = achsen[1, 0].bar(mittel.index, mittel.to_numpy(), color="0.7")
_ = achsen[1, 0].set_title("bar: Vergleich", fontsize=10)
_ = achsen[1, 1].hist(maschinen["verbrauch"], bins=20, color="0.7",
                      edgecolor="white")
_ = achsen[1, 1].set_title("hist: Verteilung", fontsize=10)
plt.tight_layout()
plt.show()
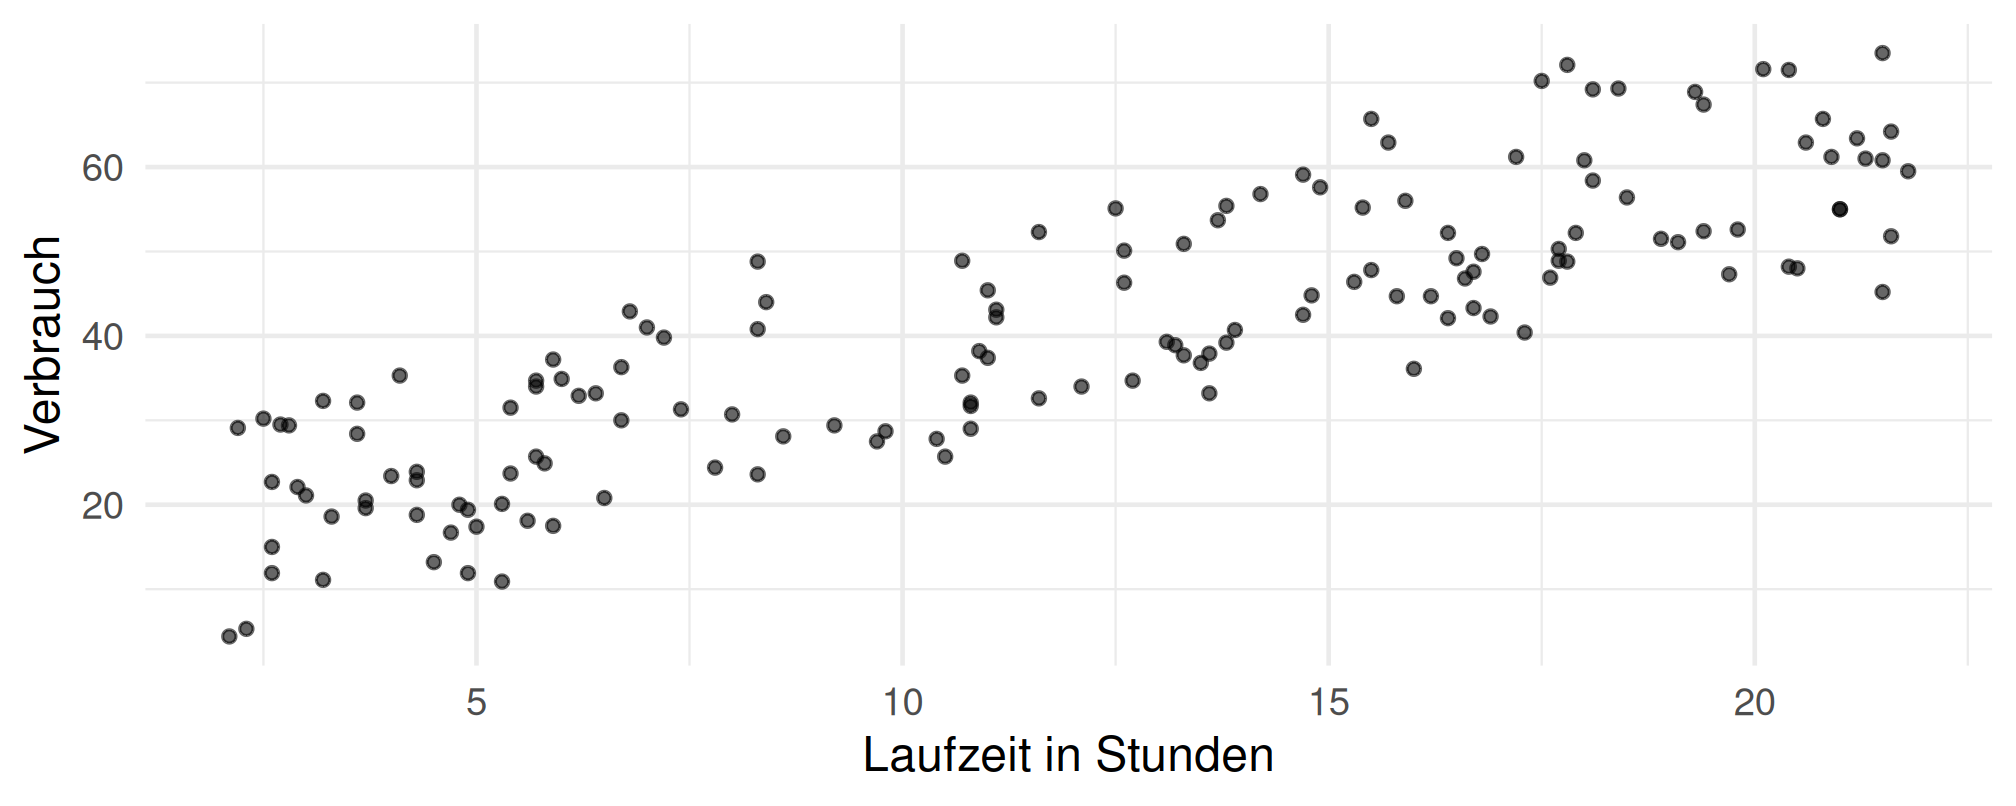
Abbildung 9: Beispiel 3: Linie, Streuung, Balken und Histogramm.
print({"anteil_ueber_50_prozent":
       round(float((maschinen["verbrauch"] > 50).mean() * 100), 1),
       "median": round(float(maschinen["verbrauch"].median()), 2),
       "schiefe": round(float(stats.skew(maschinen["verbrauch"])), 3)})

Output Zeile für Zeile

Typ mittlerer Verbrauch
Drehbank 36.06
Fräse 37.34
Presse 47.95
Kennzahl Wert
Anteil über 50 29.3 Prozent
Median 40.55
Schiefe 0.027
Aufruf Aufgabe ggplot2-Gegenstück
achse.plot(x, y) Verlauf geom_line()
achse.scatter(x, y) Zusammenhang geom_point()
achse.bar(x, h) Vergleich geom_col()
achse.hist(x, bins=) Verteilung geom_histogram()
Beobachtung Erklärung
plot verbindet die Punkte in der Reihenfolge der Daten Nicht nach x sortiert. Unsortierte Daten ergeben ein Gekritzel, das ist der häufigste Fehler bei plot.
bar erwartet fertige Höhen Wie geom_col. Ein Gegenstück zu geom_bar, das selbst zählt, gibt es nicht; dafür nimmt man value_counts() davor.
hist zählt dagegen selbst Und gibt die Klassengrenzen zurück, wenn man sie braucht.
Der Verbrauch ist fast symmetrisch verteilt Schiefe 0.027, Median 40.55. Knapp 29.3 Prozent liegen über 50.
Die Klassenbildung für den Verlauf macht man selbst pd.cut plus groupby. In ggplot2 übernähme das stat_summary().

Was matplotlib nicht von sich aus tut und wo die Zeilen hingehen, die man in ggplot2 spart:

Aufgabe matplotlib
nach Gruppen einfärben Schleife über die Gruppen
Legende label= je Aufruf, dann achse.legend()
Glättungslinie np.polyfit oder statsmodels, dann selbst zeichnen
Klassen bilden pd.cut und groupby
Achsen teilen sharex=, sharey=

Interpretation und Ergebnissatz

Vier Aufrufe decken die vier Aufgaben ab: plot für den Verlauf, scatter für den Zusammenhang, bar für den Vergleich der Mittelwerte 36.06, 37.34 und 47.95 und hist für die Verteilung, die mit einer Schiefe von 0.027 fast symmetrisch ist.

Frage und Datenlage

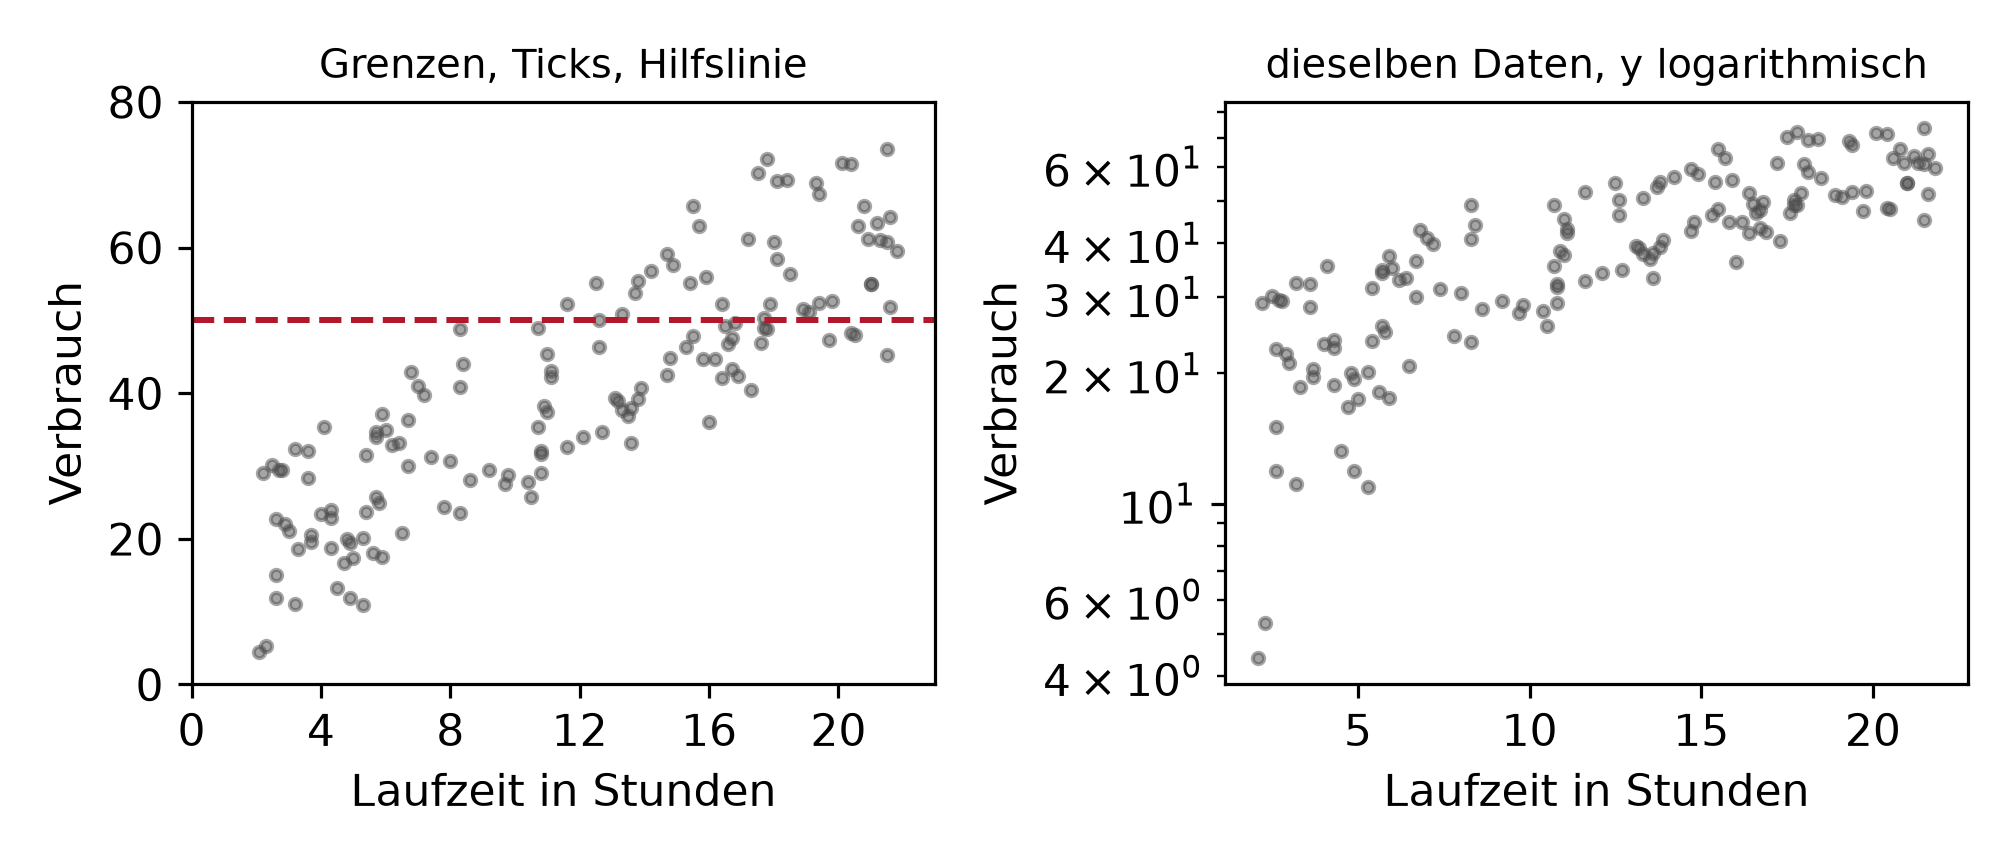
Die Achse ist der Ort, an dem aus Zahlen Positionen werden. Vier Eingriffe: Grenzen setzen, logarithmisch skalieren, Ticks bestimmen, eine Hilfslinie ziehen.

Rechnung

grenze <- 50
round(c(anteil_ueber_grenze = mean(maschinen$verbrauch > grenze) * 100,
        anzahl = sum(maschinen$verbrauch > grenze)), 1)
anteil_ueber_grenze              anzahl 
               29.3                44.0 
ggplot(maschinen, aes(laufzeit, verbrauch)) +
  geom_point(alpha = 0.5, size = 1.1) +
  geom_hline(yintercept = grenze, linetype = "dashed", colour = "#b2182b") +
  scale_x_continuous(breaks = seq(0, 22, 4)) +
  coord_cartesian(xlim = c(0, 23), ylim = c(0, 80)) +
  labs(x = "Laufzeit in Stunden", y = "Verbrauch")
Abbildung 10: Beispiel 4: dieselben Eingriffe in ggplot2.
grenze = 50
print({"anteil_ueber_grenze":
       round(float((maschinen["verbrauch"] > grenze).mean() * 100), 1),
       "anzahl": int((maschinen["verbrauch"] > grenze).sum())})

fig, achsen = plt.subplots(1, 2, figsize=(7, 3))
_ = achsen[0].scatter(maschinen["laufzeit"], maschinen["verbrauch"], s=8,
                      alpha=0.5, color="0.3")
_ = achsen[0].axhline(grenze, ls="--", color="#b2182b")
_ = achsen[0].set_xlim(0, 23)
_ = achsen[0].set_ylim(0, 80)
_ = achsen[0].set_xticks(range(0, 24, 4))
_ = achsen[0].set_title("Grenzen, Ticks, Hilfslinie", fontsize=10)

_ = achsen[1].scatter(maschinen["laufzeit"], maschinen["verbrauch"], s=8,
                      alpha=0.5, color="0.3")
_ = achsen[1].set_yscale("log")
_ = achsen[1].set_title("dieselben Daten, y logarithmisch", fontsize=10)
for achse in achsen:
    _ = achse.set_xlabel("Laufzeit in Stunden")
    _ = achse.set_ylabel("Verbrauch")
plt.tight_layout()
plt.show()
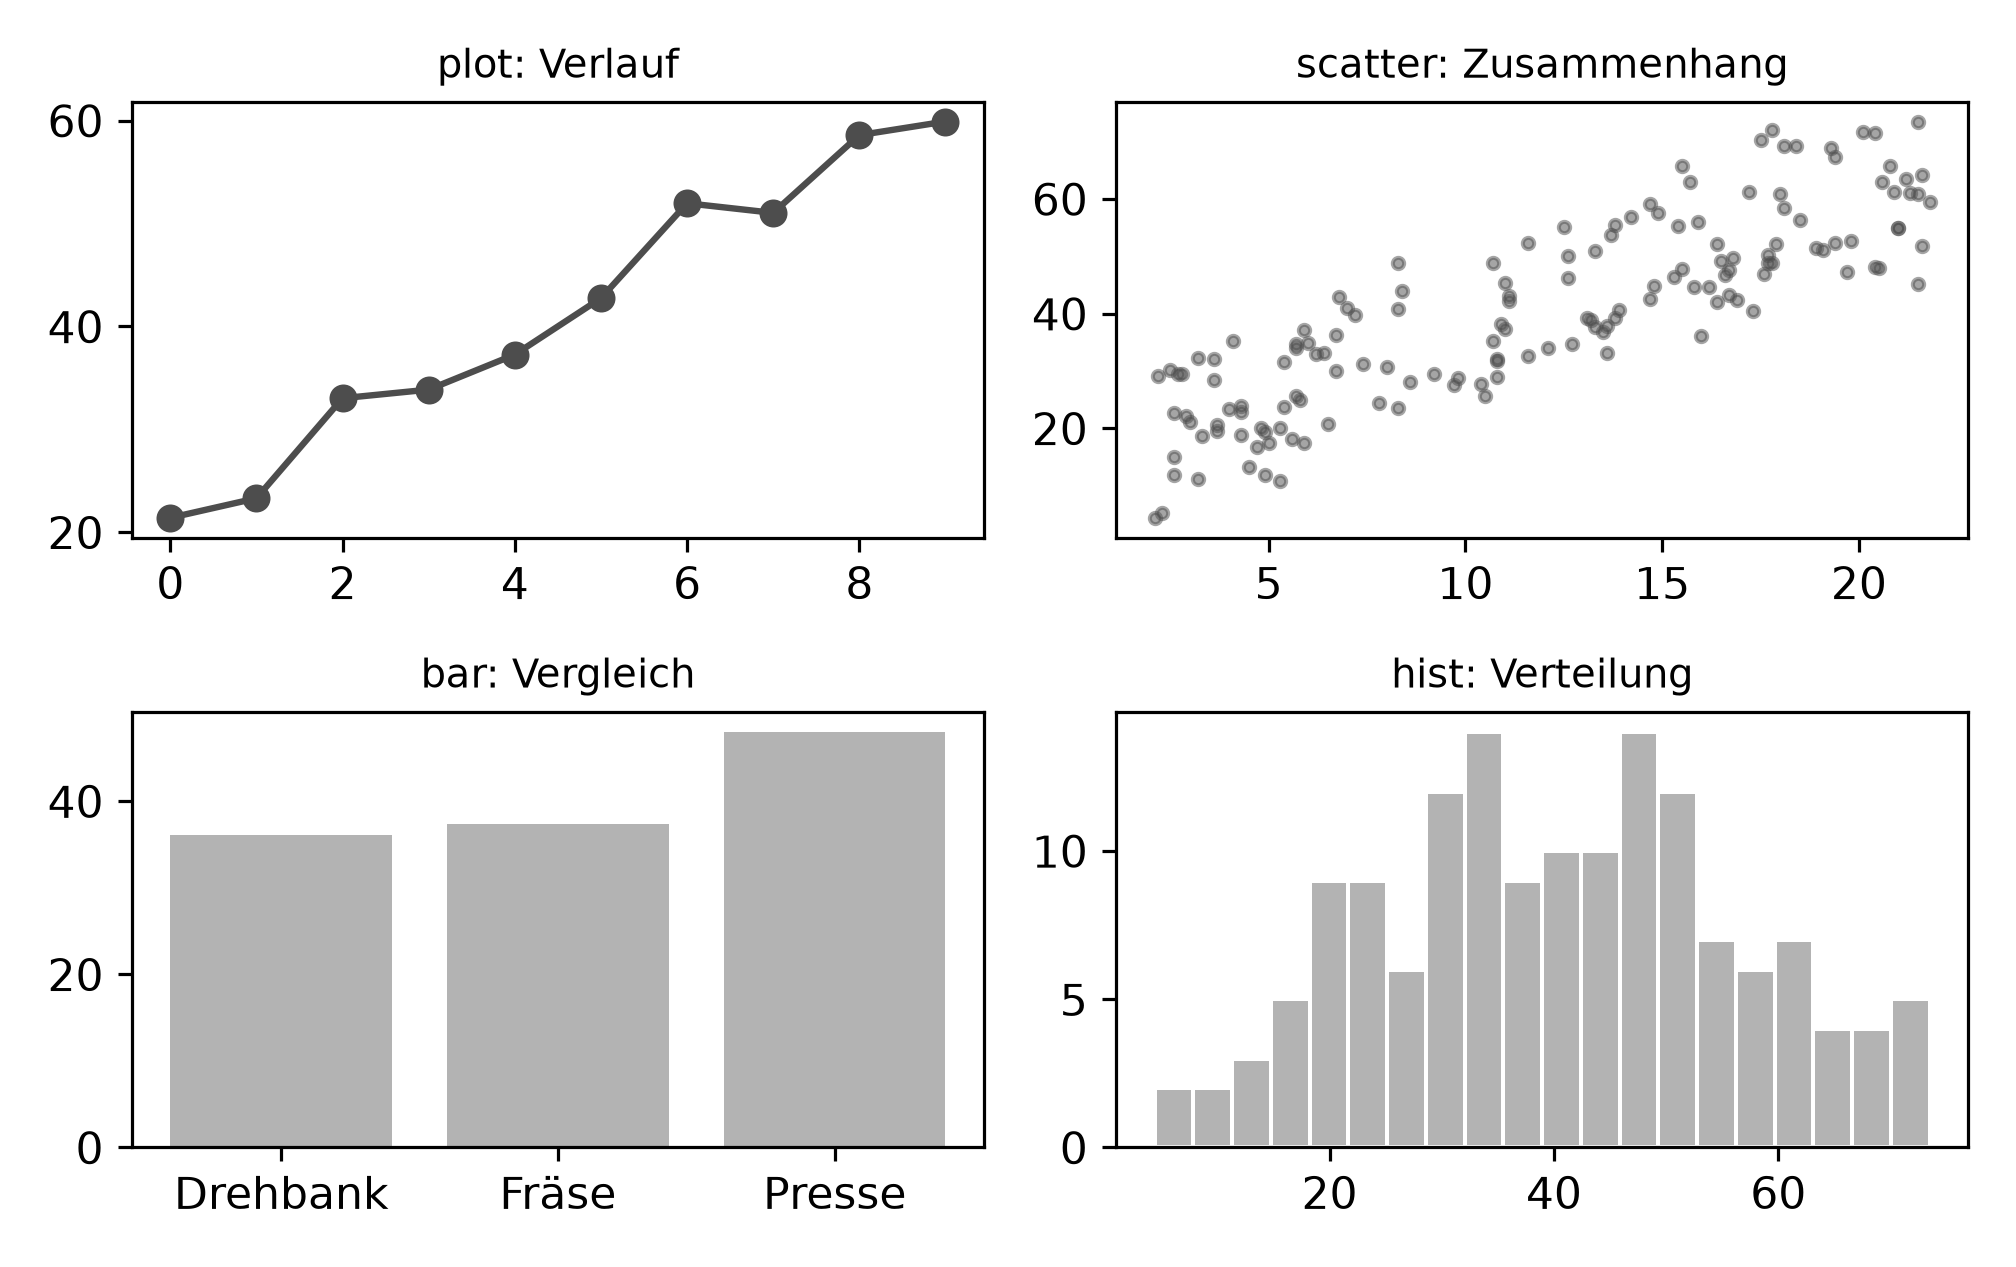
Abbildung 11: Beispiel 4: Grenzen, Ticks, Hilfslinie und logarithmische Achse.
# Was die logarithmische Achse mit den Abstaenden macht
punkte = np.array([5., 10., 20., 40., 80.])
print(pd.DataFrame({"wert": punkte,
                    "abstand_linear": np.r_[np.nan, np.diff(punkte)],
                    "abstand_logarithmisch": np.r_[np.nan, np.diff(np.log10(punkte))]
                    }).round(4).to_string(index=False))

Output Zeile für Zeile

Kennzahl Wert
Anteil über der Grenze von 50 29.3 Prozent
Anzahl Maschinen 44

Was die logarithmische Achse mit gleichen Verhältnissen macht:

Wert 5 10 20 40 80
Abstand linear 5 10 20 40
Abstand logarithmisch 0.3010 0.3010 0.3010 0.3010
Beobachtung Erklärung
Die Verdopplung hat auf der Log-Achse immer denselben Abstand 0.3010, also \(\log_{10} 2\). Das ist der Zweck: Gleiche Verhältnisse bekommen gleiche Strecken.
Linear wächst der Abstand von 5 auf 40 Dieselben Verdopplungen, achtfach verschiedene Strecken.
set_ylim in matplotlib entspricht coord_cartesian in ggplot2 Es zoomt, ohne Daten zu entfernen. Das ggplot2-Gegenstück scale_y_continuous(limits =) würde Punkte verwerfen.
axhline ist die schnellste Anmerkung Eine Grenzlinie plus die Zahl im Text sagt mehr als eine Legende. Hier: 44 von 150 Maschinen, also 29.3 Prozent, liegen darüber.
set_xticks verhindert unglückliche Automatik Bei Laufzeiten in Stunden sind Vierer-Schritte lesbarer als die automatischen 2.5er.

Wann eine logarithmische Achse richtig ist: wenn die Daten über mehrere Grössenordnungen laufen und Verhältnisse interessieren, Einkommen, Bevölkerungszahlen, Konzentrationen.

Wann nicht: bei Werten, die null oder negativ werden können, und wenn das Publikum die Achse nicht als logarithmisch erkennt. Eine Log-Achse ohne deutliche Beschriftung ist eine irreführende Darstellung, ein linearer Anstieg sieht dort flach aus.

Interpretation und Ergebnissatz

44 der 150 Maschinen, also 29.3 Prozent, liegen über der Grenze von 50. Auf einer logarithmischen Achse hat jede Verdopplung denselben Abstand von 0.3010, während er linear von 5 auf 40 wächst.

Frage und Datenlage

Aus der Rohgrafik wird eine Abbildung. Dazu kommen Titel, Einheit, Anmerkung und Quelle und dann die Frage, mit welchen Einstellungen sie gespeichert wird.

Rechnung

presse <- maschinen[maschinen$typ == "Presse", ]
andere <- maschinen[maschinen$typ != "Presse", ]
round(c(mittel_presse = mean(presse$verbrauch),
        mittel_andere = mean(andere$verbrauch),
        differenz = mean(presse$verbrauch) - mean(andere$verbrauch)), 2)
mittel_presse mittel_andere     differenz 
        47.95         36.70         11.26 
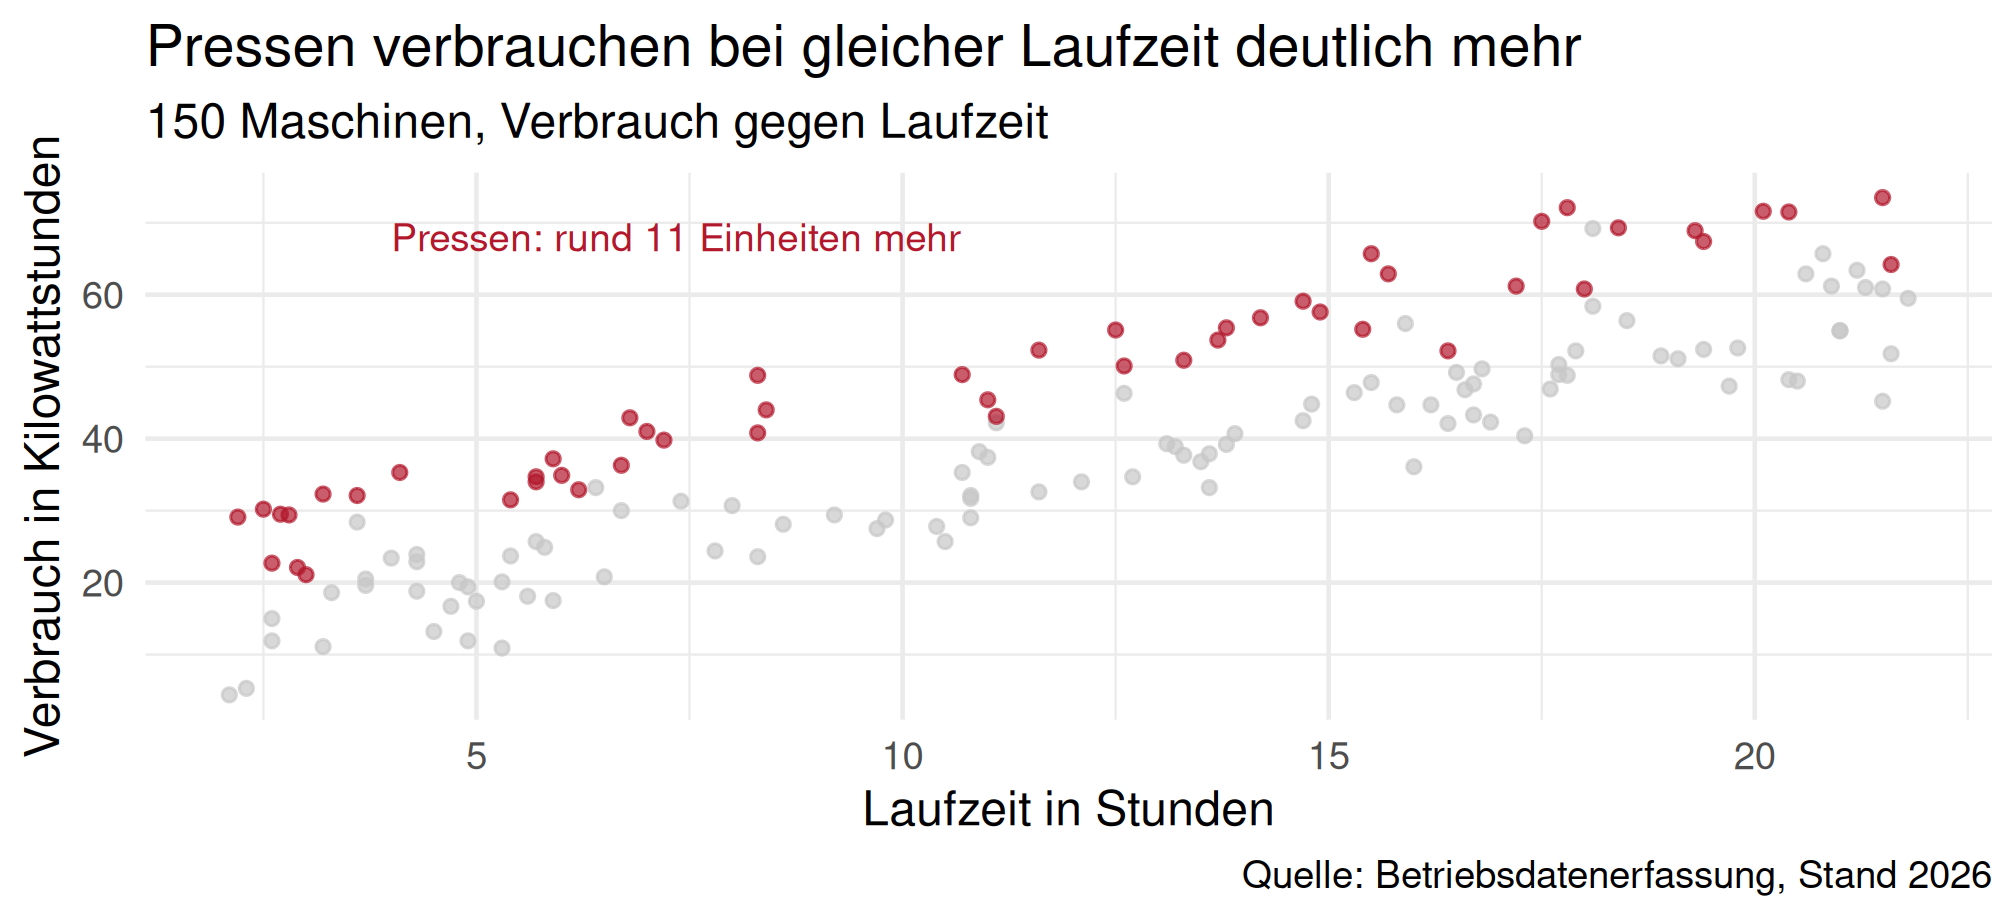
ggplot(maschinen, aes(laufzeit, verbrauch)) +
  geom_point(aes(colour = typ == "Presse"), alpha = 0.7, size = 1.3) +
  scale_colour_manual(values = c(`FALSE` = "#c7c7c7", `TRUE` = "#b2182b"),
                      guide = "none") +
  annotate("text", x = 4, y = 68, colour = "#b2182b", hjust = 0, size = 3.4,
           label = "Pressen: rund 11 Einheiten mehr") +
  labs(title = "Pressen verbrauchen bei gleicher Laufzeit deutlich mehr",
       subtitle = "150 Maschinen, Verbrauch gegen Laufzeit",
       x = "Laufzeit in Stunden", y = "Verbrauch in Kilowattstunden",
       caption = "Quelle: Betriebsdatenerfassung, Stand 2026")
Abbildung 12: Beispiel 5: die fertige Fassung in ggplot2.
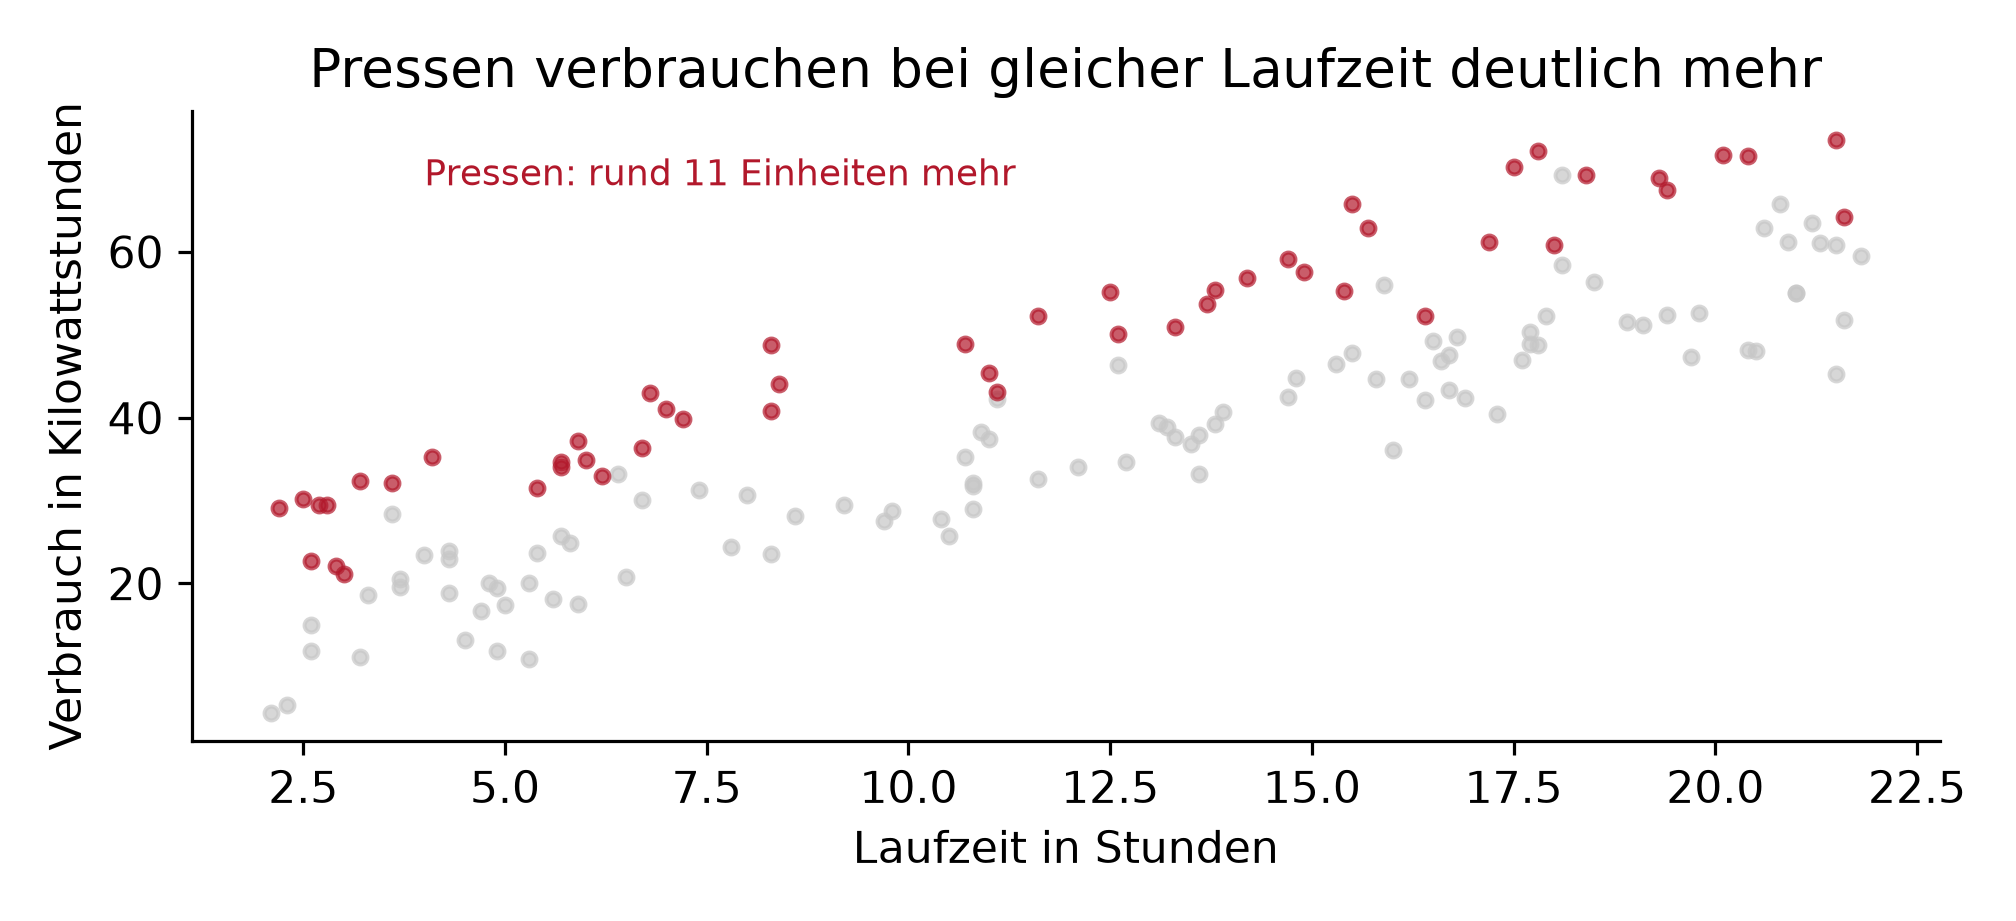
ist_presse = maschinen["typ"] == "Presse"
print({"mittel_presse": round(float(maschinen.loc[ist_presse, "verbrauch"].mean()), 2),
       "mittel_andere": round(float(maschinen.loc[~ist_presse, "verbrauch"].mean()), 2),
       "differenz": round(float(maschinen.loc[ist_presse, "verbrauch"].mean()
                                - maschinen.loc[~ist_presse, "verbrauch"].mean()), 2)})

fig, achse = plt.subplots(figsize=(7, 3.2))
_ = achse.scatter(maschinen.loc[~ist_presse, "laufzeit"],
                  maschinen.loc[~ist_presse, "verbrauch"],
                  s=12, alpha=0.7, color="#c7c7c7")
_ = achse.scatter(maschinen.loc[ist_presse, "laufzeit"],
                  maschinen.loc[ist_presse, "verbrauch"],
                  s=12, alpha=0.7, color="#b2182b")
_ = achse.annotate("Pressen: rund 11 Einheiten mehr", xy=(4, 68),
                   color="#b2182b", fontsize=9)
_ = achse.set_title("Pressen verbrauchen bei gleicher Laufzeit deutlich mehr")
_ = achse.set_xlabel("Laufzeit in Stunden")
_ = achse.set_ylabel("Verbrauch in Kilowattstunden")
_ = fig.text(0.01, -0.04, "Quelle: Betriebsdatenerfassung, Stand 2026",
             fontsize=7, color="0.4")
for rand in ("top", "right"):
    _ = achse.spines[rand].set_visible(False)
plt.tight_layout()
plt.show()
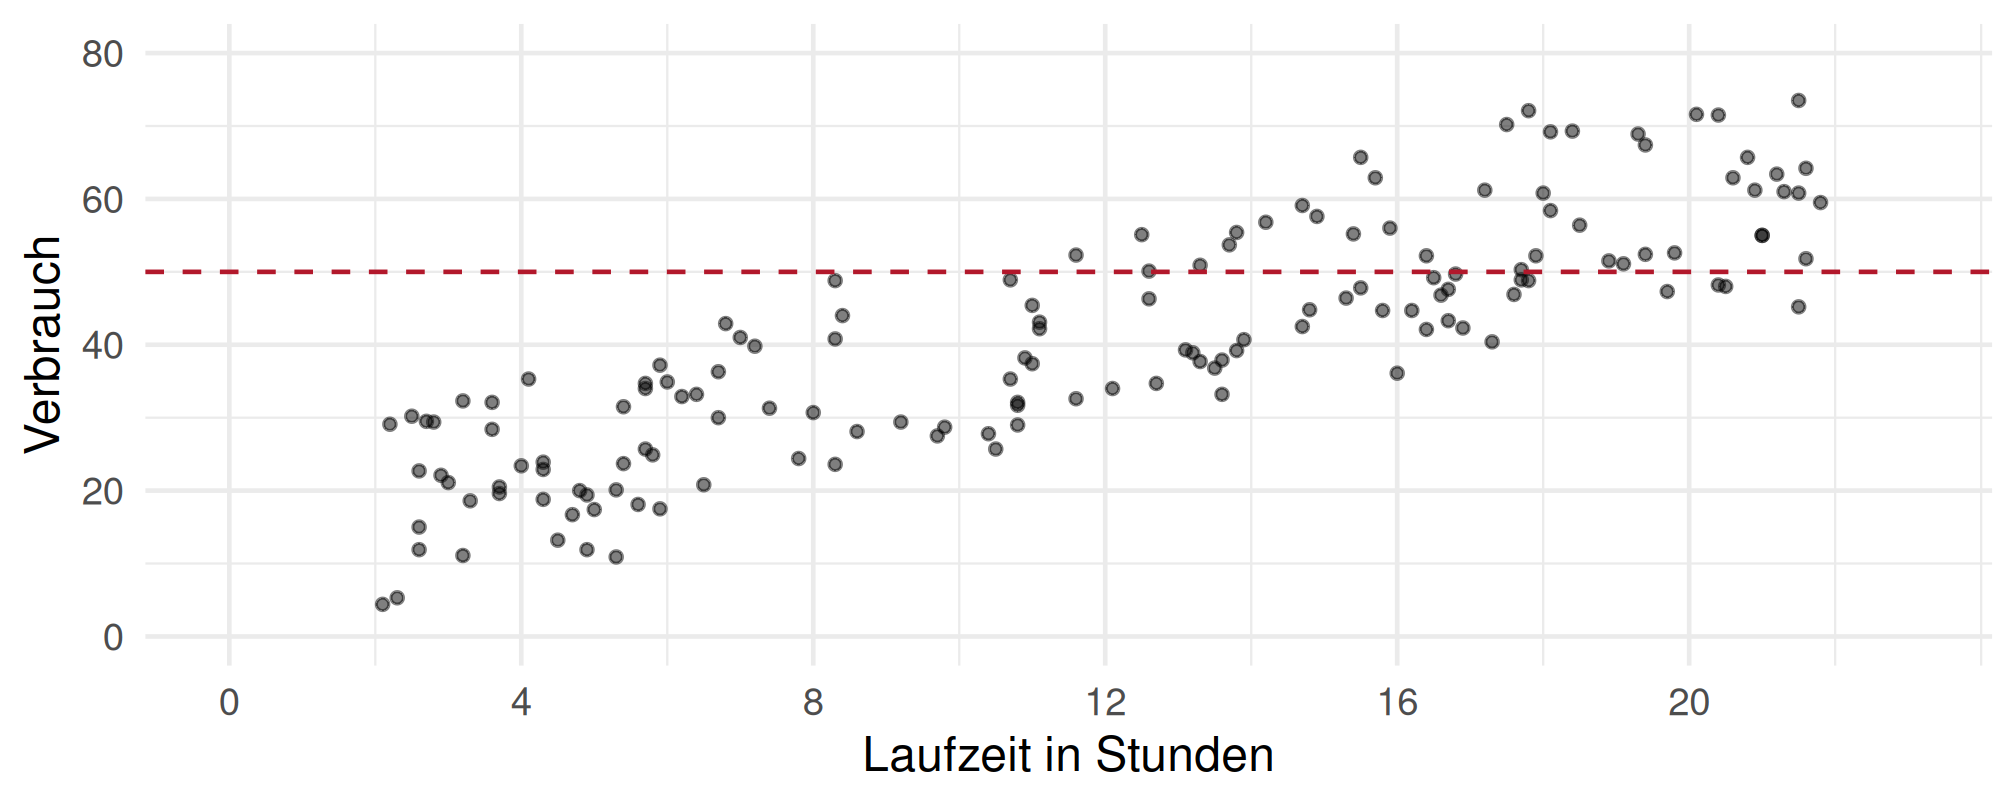
Abbildung 13: Beispiel 5: dieselbe fertige Fassung in matplotlib.
# Was die Exporteinstellungen bedeuten
einstellungen = pd.DataFrame({
    "zweck": ["Bildschirm", "Bericht (Druck)", "Folie", "Weiterverarbeitung"],
    "format": ["png", "png", "png", "pdf oder svg"],
    "dpi": [96, 300, 150, ", "],
    "bbox_inches": ["", "tight", "tight", "tight"]})
print(einstellungen.to_string(index=False))
             zweck       format dpi bbox_inches
        Bildschirm          png  96            
   Bericht (Druck)          png 300       tight
             Folie          png 150       tight
Weiterverarbeitung pdf oder svg  ,        tight
breite_zoll, hoehe_zoll = 7, 3.2
for dpi in (96, 150, 300):
    print(f"dpi {dpi:3d}: {int(breite_zoll * dpi)} x {int(hoehe_zoll * dpi)} Pixel")
dpi  96: 672 x 307 Pixel
dpi 150: 1050 x 480 Pixel
dpi 300: 2100 x 960 Pixel

Output Zeile für Zeile

Gruppe mittlerer Verbrauch
Pressen 47.95
übrige 36.70
Differenz 11.26

Exportgrössen bei 7 × 3.2 Zoll:

dpi Pixel
96 672 × 307
150 1050 × 480
300 2100 × 960
Beobachtung Erklärung
Der Titel nennt die Aussage Nicht “Streudiagramm Verbrauch gegen Laufzeit”. Die Zahl dazu, 11.26 Einheiten Unterschied, steht in der Anmerkung.
Die Anmerkung steht im Bild annotate in beiden Sprachen. Sie ersetzt einen Absatz Erklärtext darunter, den in fünf Sekunden niemand liest.
Die Einheit gehört an die Achse “Verbrauch in Kilowattstunden”, nicht “verbrauch”. Der Spaltenname aus der Datei ist keine Achsenbeschriftung.
Die Grafik hat zwei Farben, nicht drei Pressen rot, alle anderen grau. Die Unterscheidung Fräse/Drehbank trägt hier nichts zur Aussage bei.
bbox_inches="tight" ist beim Speichern fast immer nötig Sonst werden Titel und Achsenbeschriftung abgeschnitten, tight_layout() allein wirkt nur auf die Anzeige.
300 dpi ergeben 2100 × 960 Pixel Bei 7 Zoll Breite. Für den Druck ist das die Untergrenze; für den Bildschirm sind 96 bis 150 genug, und die Datei bleibt klein.

Der Exportbefehl mit den Argumenten, die zählen:

fig.savefig("abbildung.png", dpi=300, bbox_inches="tight",
            facecolor="white")
Argument Warum
dpi Auflösung; 300 für Druck, 150 für Folien
bbox_inches="tight" schneidet den Rand passend, nichts fehlt
facecolor="white" sonst ist der Hintergrund bei manchen Themes durchsichtig
format="pdf" Vektorformat, beliebig skalierbar, für Berichte die bessere Wahl

In R ist das Gegenstück ggsave("abbildung.png", breite, hoehe, dpi = 300).

Interpretation und Ergebnissatz

Pressen verbrauchen im Mittel 47.95 gegenüber 36.70 bei den übrigen Maschinen, also 11.26 Einheiten mehr. Die fertige Abbildung trägt diese Aussage im Titel, die Zahl in der Anmerkung und die Einheit an der Achse; beim Export sorgt bbox_inches="tight" dafür, dass nichts davon abgeschnitten wird.

Verständnisfragen

Worin unterscheiden sich Figure, Axes und Axis?

Figure ist das Bild, Axes die Zeichenfläche, Axis eine einzelne Achse
Richtig. Die Ähnlichkeit von Axes und Axis ist eingebaut; ein Axes ist trotz des Namens kein Strich, sondern ein ganzes Koordinatensystem.
Axes und Axis sind dasselbe, nur Einzahl und Mehrzahl
Das ist die naheliegende und falsche Deutung.
Figure und Axes sind dasselbe
Eine Figure kann viele Axes enthalten.

Zwei Figuren sind offen, dann folgt plt.title("B"). Wo landet der Titel?

Auf der zuletzt angelegten Figur
Richtig, plt. wirkt auf die aktuelle Figur, unabhängig davon, welches Axes im Code davor bearbeitet wurde. Genau deshalb ist der objektorientierte Weg eindeutig.
Auf beiden
pyplot wirkt immer nur auf eine.
Das führt zu einem Fehler
Es läuft fehlerfrei durch und landet nur am falschen Ort, das macht den Fehler so schwer zu finden.

plt.subplots(2, 2) und plt.subplots() geben Verschiedenes zurück. Was?

Einmal ein (2, 2)-Array mit vier Axes, einmal ein einzelnes Axes ohne Array
Richtig. Code, der mit achsen[0] arbeitet, bricht deshalb ab, sobald nur eine Teilgrafik übrig ist. squeeze=False macht die Form einheitlich.
Beide geben ein Array zurück, nur verschieden gross
Bei einer einzigen Teilgrafik wird die Dimension entfernt.
Beide geben ein einzelnes Axes zurück
Bei 2 mal 2 sind es vier.

Warum ergibt achse.plot(x, y) bei unsortierten Daten ein Gekritzel?

plot verbindet die Punkte in der Reihenfolge der Daten, nicht nach x
Richtig. Vor einem Linienplot gehört sort_values("x"), sonst springt die Linie hin und her.
plot ist nur für Zeitreihen gedacht
Es funktioniert für jede geordnete Grösse, verlangt aber, dass die Ordnung in den Daten steht.
Die Punkte sind zu dicht
Die Dichte ändert an der Reihenfolge nichts.

Auf einer logarithmischen y-Achse haben die Werte 5, 10, 20, 40 und 80 jeweils denselben Abstand von 0.3010. Warum?

Weil gleiche Verhältnisse gleiche Strecken bekommen; 0.3010 ist der Zehnerlogarithmus von 2
Richtig. Das ist der Zweck der Log-Achse: Sie macht aus Verdopplungen gleich lange Schritte.
Weil die Achse die Werte gleichmässig verteilt
Sie verteilt nicht die Werte, sondern ihre Logarithmen.
Das ist Zufall dieser Zahlenreihe
Es gilt für jede Folge mit konstantem Faktor.

Beim Speichern mit fig.savefig("bild.png") fehlt ein Teil der Achsenbeschriftung. Was hilft?

bbox_inches="tight"
Richtig. tight_layout() wirkt nur auf die Anzeige; beim Export bestimmt bbox_inches, wie der Rand beschnitten wird.
Eine höhere dpi-Zahl
Die ändert die Auflösung, nicht den Ausschnitt.
Eine kleinere Schrift
Behebt das Symptom manchmal, nicht die Ursache.

Verlinkte Ressourcen