Hypothesentests: Grundlagen

Hypothesentests
Schätzen
Interpretation
R
Python
Testlogik, Fehler erster und zweiter Art, p-Wert und was er nicht bedeutet.

Kernideen

  • Ein Test beantwortet nicht die Frage, die man stellt. Gefragt wird “wie gross ist der Effekt”, beantwortet wird “wie ungewöhnlich wären diese Daten, wenn es ihn nicht gäbe”.
  • Die Nullhypothese wird verworfen oder nicht verworfen. Angenommen wird sie nie, denn ein fehlender Nachweis ist kein Nachweis des Fehlens.
  • Der p-Wert ist eine Wahrscheinlichkeit für Daten unter einer Annahme, nicht für die Annahme. Die beiden Richtungen der Bedingung sind nicht vertauschbar.
  • Fehler erster und zweiter Art bewegen sich bei festem Stichprobenumfang gegenläufig. Beide zugleich zu senken geht nur über mehr Daten.
  • Wie gross ein p-Wert wird, hängt an drei Dingen gleichzeitig: Effektgrösse, Streuung und Stichprobenumfang. Er trennt sie nicht auf.
  • Ein berichtsfähiges Ergebnis besteht aus Schätzwert, Konfidenzintervall, Teststatistik mit Freiheitsgraden, p-Wert, Effektstärke und n.

Erklärung

Vorausgesetzt werden die Verteilung einer Zufallsvariablen, der zentrale Grenzwertsatz und das Prinzip des Schätzens mit Unsicherheit. Wer die Verteilung einer Schätzung nicht vor Augen hat, kann einen p-Wert nicht einordnen.

Die Umkehrung, mit der jeder Test arbeitet

Ein Test beantwortet nicht die Frage, die man eigentlich stellt. Interessant wäre “wie wahrscheinlich ist mein Effekt”, beantwortet wird “wie ungewöhnlich wären meine Daten, wenn es den Effekt nicht gäbe”. Dafür wird zuerst eine Gegenannahme formuliert, die Nullhypothese: kein Unterschied, kein Zusammenhang, kein Effekt. Sie ist präzise, weil sie einen einzigen Wert nennt, und genau deshalb lässt sich unter ihr rechnen.

Der Ablauf ist immer derselbe:

  1. Nullhypothese und Alternativhypothese festlegen, vor dem Blick in die Daten.
  2. Signifikanzniveau festlegen, üblicherweise 5 Prozent.
  3. Eine Teststatistik berechnen, die den beobachteten Effekt an der Streuung der Daten und am Stichprobenumfang misst.
  4. Die Verteilung dieser Statistik unter der Nullhypothese heranziehen und fragen, wie weit aussen der beobachtete Wert liegt.
  5. Entscheiden, und zwar nur über die Nullhypothese: verwerfen oder nicht verwerfen. Ein Annehmen der Nullhypothese gibt es nicht.

Die Alternativhypothese entscheidet, ob ein- oder zweiseitig getestet wird. Zweiseitig ist der Standardfall, es interessiert eine Abweichung in beide Richtungen. Einseitig testet nur, wer die Richtung vorher aus der Sache heraus festlegen kann, und halbiert damit den p-Wert. Die Richtung nach dem Blick auf die Daten zu wählen, ist keine Entscheidung, sondern eine Verschiebung des Niveaus.

Zwei Fehler, die sich nicht gemeinsam kleinmachen lassen

Nullhypothese ist wahr Nullhypothese ist falsch
verworfen Fehler erster Art, Wahrscheinlichkeit \(\alpha\) richtige Entscheidung, Wahrscheinlichkeit \(1-\beta\) (Power)
nicht verworfen richtige Entscheidung Fehler zweiter Art, Wahrscheinlichkeit \(\beta\)

Der Fehler erster Art ist ein falscher Alarm: ein Effekt wird berichtet, den es nicht gibt. Seine Rate legt man selbst fest, sie ist das Signifikanzniveau. Der Fehler zweiter Art ist ein übersehener Effekt. Seine Rate ergibt sich aus Effektgrösse, Streuung, Stichprobenumfang und Niveau, und sie ist bei kleinen Stichproben regelmässig grösser als 50 Prozent. Wer das Niveau senkt, um falsche Alarme zu vermeiden, erhöht damit direkt die Rate der übersehenen Effekte. Der einzige Weg, beide Fehler gleichzeitig zu senken, ist ein grösserer Stichprobenumfang, siehe Power.

Der p-Wert

Der p-Wert ist die Wahrscheinlichkeit, unter der Nullhypothese ein mindestens so extremes Ergebnis zu beobachten wie das vorliegende. Er ist damit eine Aussage über die Daten unter einer Annahme, nicht über die Annahme. Die beiden Richtungen der Bedingung sind nicht austauschbar: “die Daten sind unter der Nullhypothese unwahrscheinlich” ist nicht dasselbe wie “die Nullhypothese ist unwahrscheinlich”.

Wie gross ein p-Wert wird, hängt an drei Dingen gleichzeitig: an der Effektgrösse, an der Streuung und am Stichprobenumfang. Derselbe Effekt kann bei kleinem n weit von der Schwelle entfernt bleiben und bei grossem n deutlich darunter liegen. Deshalb ist ein p-Wert allein niemals eine Aussage über die Bedeutung eines Ergebnisses.

Was der Test nicht liefert, das Intervall aber schon

Ein Test liefert eine Ja-Nein-Entscheidung. Ein Konfidenzintervall liefert den Bereich der Effektgrössen, die mit den Daten vereinbar sind, und enthält die Testentscheidung als Nebenprodukt: schliesst das 95-Prozent-Intervall den Wert der Nullhypothese ein, ist der zweiseitige Test auf dem 5-Prozent-Niveau nicht signifikant.

Das Intervall sagt zusätzlich, ob ein nicht signifikantes Ergebnis “kein nennenswerter Effekt vorhanden” oder “nichts erkennbar, weil die Stichprobe zu klein ist” bedeutet. Diese beiden Fälle sehen im p-Wert identisch aus, und Beispiel 4 zeigt, wie weit sie inhaltlich auseinanderliegen.

Nach der Erhebung ist der Stichprobenumfang festgelegt, und eine niedrige Power lässt sich nicht mehr reparieren. Eine im Nachhinein aus dem beobachteten Effekt gerechnete Power ist zudem keine unabhängige Information, sondern eine Umrechnung des p-Werts. Nützlich ist die Rechnung nur vorher, mit einer aus der Sache begründeten Mindesteffektgrösse. Ausführlich steht das auf der Seite zu Power und Stichprobenumfang, Beispiel 3.
Beispiele

Frage und Datenlage

Ein Sollwert von 500 Gramm, zwölf gemessene Packungen. Statt einen fertigen Testaufruf zu verwenden, wird hier jeder Schritt einzeln gerechnet. Danach sieht man, was t.test() tut.

Rechnung

gewicht <- c(497.2, 501.8, 496.5, 499.1, 495.8, 500.4,
             494.9, 498.6, 496.1, 499.8, 495.2, 497.7)
sollwert <- 500

# Schritt 3: Teststatistik
n <- length(gewicht)
differenz <- mean(gewicht) - sollwert
standardfehler <- sd(gewicht) / sqrt(n)
t_wert <- differenz / standardfehler

# Schritt 4: Verteilung unter der Nullhypothese heranziehen
p_wert <- 2 * pt(-abs(t_wert), df = n - 1)
kritisch <- qt(0.975, df = n - 1)

round(c(mittel = mean(gewicht), differenz = differenz,
        standardfehler = standardfehler, t = t_wert,
        df = n - 1, kritischer_wert = kritisch, p = p_wert), 4)
         mittel       differenz  standardfehler               t              df 
       497.7583         -2.2417          0.6348         -3.5314         11.0000 
kritischer_wert               p 
         2.2010          0.0047 
# Zum Vergleich der fertige Aufruf
t.test(gewicht, mu = sollwert)

    One Sample t-test

data:  gewicht
t = -3.5314, df = 11, p-value = 0.004703
alternative hypothesis: true mean is not equal to 500
95 percent confidence interval:
 496.3612 499.1555
sample estimates:
mean of x 
 497.7583 
gewicht = np.array([497.2, 501.8, 496.5, 499.1, 495.8, 500.4,
                    494.9, 498.6, 496.1, 499.8, 495.2, 497.7])
sollwert = 500

n = len(gewicht)
differenz = gewicht.mean() - sollwert
standardfehler = gewicht.std(ddof=1) / np.sqrt(n)
t_wert = differenz / standardfehler
p_wert = 2 * stats.t.cdf(-abs(t_wert), df=n - 1)
kritisch = stats.t.ppf(0.975, df=n - 1)

print(f"Mittel = {gewicht.mean():.4f}  Differenz = {differenz:.4f}")
Mittel = 497.7583  Differenz = -2.2417
print(f"Standardfehler = {standardfehler:.4f}  t = {t_wert:.4f}  df = {n-1}")
Standardfehler = 0.6348  t = -3.5314  df = 11
print(f"kritischer Wert = {kritisch:.4f}  p = {p_wert:.6f}")
kritischer Wert = 2.2010  p = 0.004703
print(stats.ttest_1samp(gewicht, sollwert))
TtestResult(statistic=np.float64(-3.5313958840261623), pvalue=np.float64(0.004703285771418092), df=np.int64(11))

Output Zeile für Zeile

Schritt Grösse Wert hier Was er bedeutet
1 Nullhypothese Erwartungswert = 500 g Sie nennt einen einzigen Wert; nur deshalb lässt sich unter ihr rechnen.
2 Niveau 0.05 zweiseitig Vorab festgelegt, nicht nach dem Blick auf die Daten.
3 Mittelwert 497.7583
3 Differenz -2.2417 g Die Effektgrösse in der Einheit der Sache.
3 Standardfehler 0.6348 Wie stark der Mittelwert von Stichprobe zu Stichprobe schwankt.
3 t -3.5314 Die Differenz, gemessen in Standardfehlern. Das ist der ganze Trick: Eine Abweichung wird an ihrer eigenen Zufallsschwankung gemessen.
4 Freiheitsgrade 11 n minus eins.
4 kritischer Wert 2.2010 Ab diesem Betrag wird verworfen. Bei 11 Freiheitsgraden liegt er deutlich über den 1.96 der Normalverteilung.
4 p 0.0047 Die Fläche der t-Verteilung jenseits von ±3.5314.
5 Entscheidung verwerfen Der Betrag von t übersteigt den kritischen Wert, gleichbedeutend damit, dass p unter 0.05 liegt.

Die beiden letzten Zeilen sind zwei Formulierungen derselben Entscheidung. Der kritische Wert war vor dem Computer üblich, weil man ihn aus einer Tabelle ablas; der p-Wert enthält dieselbe Information feiner aufgelöst.

Interpretation und Ergebnissatz

Beachtenswert ist, was der p-Wert von 0.0047 nicht sagt: nicht, dass die Nullhypothese mit 99.5-prozentiger Wahrscheinlichkeit falsch ist, und nicht, dass der Effekt gross ist. Er sagt nur, dass Daten wie diese unter einem wahren Mittelwert von 500 g selten wären.

Was der Effekt taugt, steht in der Differenz von -2.24 g und ihrem Intervall.

Das mittlere Füllgewicht unterschreitet den Sollwert von 500 g (M = 497.76 g, SD = 2.20, n = 12): Differenz -2.24 g, t(11) = -3.53, p = 0.005.

Frage und Datenlage

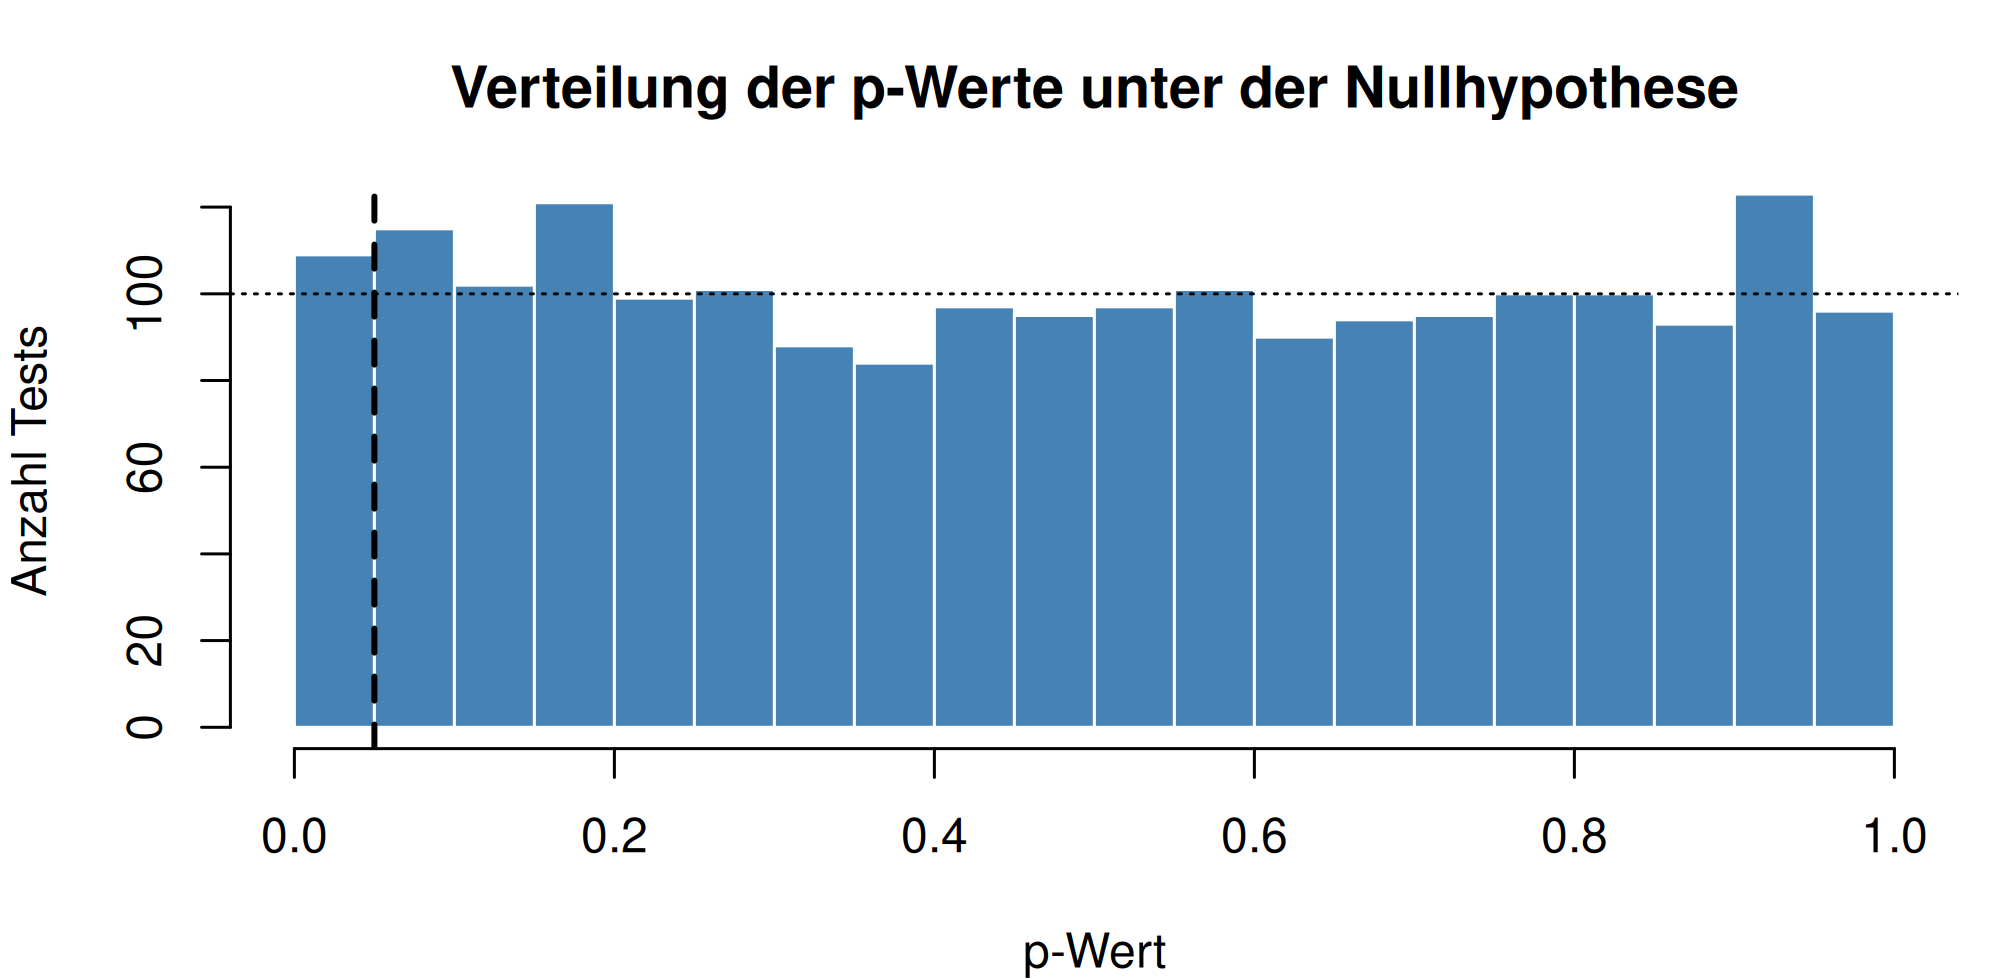
Wenn die Nullhypothese stimmt, gibt es nichts zu finden. Trotzdem liefert jeder Test einen p-Wert. Wie sind diese p-Werte verteilt?

Simuliert werden 2000 Vergleiche zweier Gruppen zu je 30 Werten aus derselben Verteilung. Ein Unterschied besteht also konstruktionsbedingt nicht.

Rechnung

B <- 2000
n_gruppe <- 30

werte <- normalwerte(2026, B * 2 * n_gruppe, mittel = 100, streuung = 15)
alle <- matrix(werte, nrow = B, ncol = 2 * n_gruppe, byrow = TRUE)

p_werte <- apply(alle, 1, function(zeile) {
  t.test(zeile[1:n_gruppe], zeile[(n_gruppe + 1):(2 * n_gruppe)],
         var.equal = TRUE)$p.value
})

par(mar = c(4, 4, 3, 1))
hist(p_werte, breaks = seq(0, 1, by = 0.05), col = "steelblue",
     border = "white", main = "Verteilung der p-Werte unter der Nullhypothese",
     xlab = "p-Wert", ylab = "Anzahl Tests")
abline(v = 0.05, lty = 2, lwd = 2)
abline(h = B / 20, lty = 3)

round(c(anteil_unter_0.10 = mean(p_werte < 0.10),
        anteil_unter_0.05 = mean(p_werte < 0.05),
        anteil_unter_0.01 = mean(p_werte < 0.01),
        median = median(p_werte)), 4)
anteil_unter_0.10 anteil_unter_0.05 anteil_unter_0.01            median 
           0.1120            0.0545            0.0085            0.4946 
Abbildung 1: Beispiel 2: 2000 p-Werte aus Daten ohne echten Unterschied.
B, n_gruppe = 2000, 30

werte = normalwerte(2026, B * 2 * n_gruppe, mittel=100, streuung=15)
alle = werte.reshape(B, 2 * n_gruppe)
p_werte = stats.ttest_ind(alle[:, :n_gruppe], alle[:, n_gruppe:], axis=1).pvalue

fig, achse = plt.subplots(figsize=(7, 3.4))
achse.hist(p_werte, bins=np.arange(0, 1.01, 0.05),
           color="steelblue", edgecolor="white")
achse.axvline(0.05, linestyle="--", linewidth=2, color="black")
achse.axhline(B / 20, linestyle=":", color="black")
achse.set_title("Verteilung der p-Werte unter der Nullhypothese")
achse.set_xlabel("p-Wert")
achse.set_ylabel("Anzahl Tests")
plt.tight_layout()
plt.show()
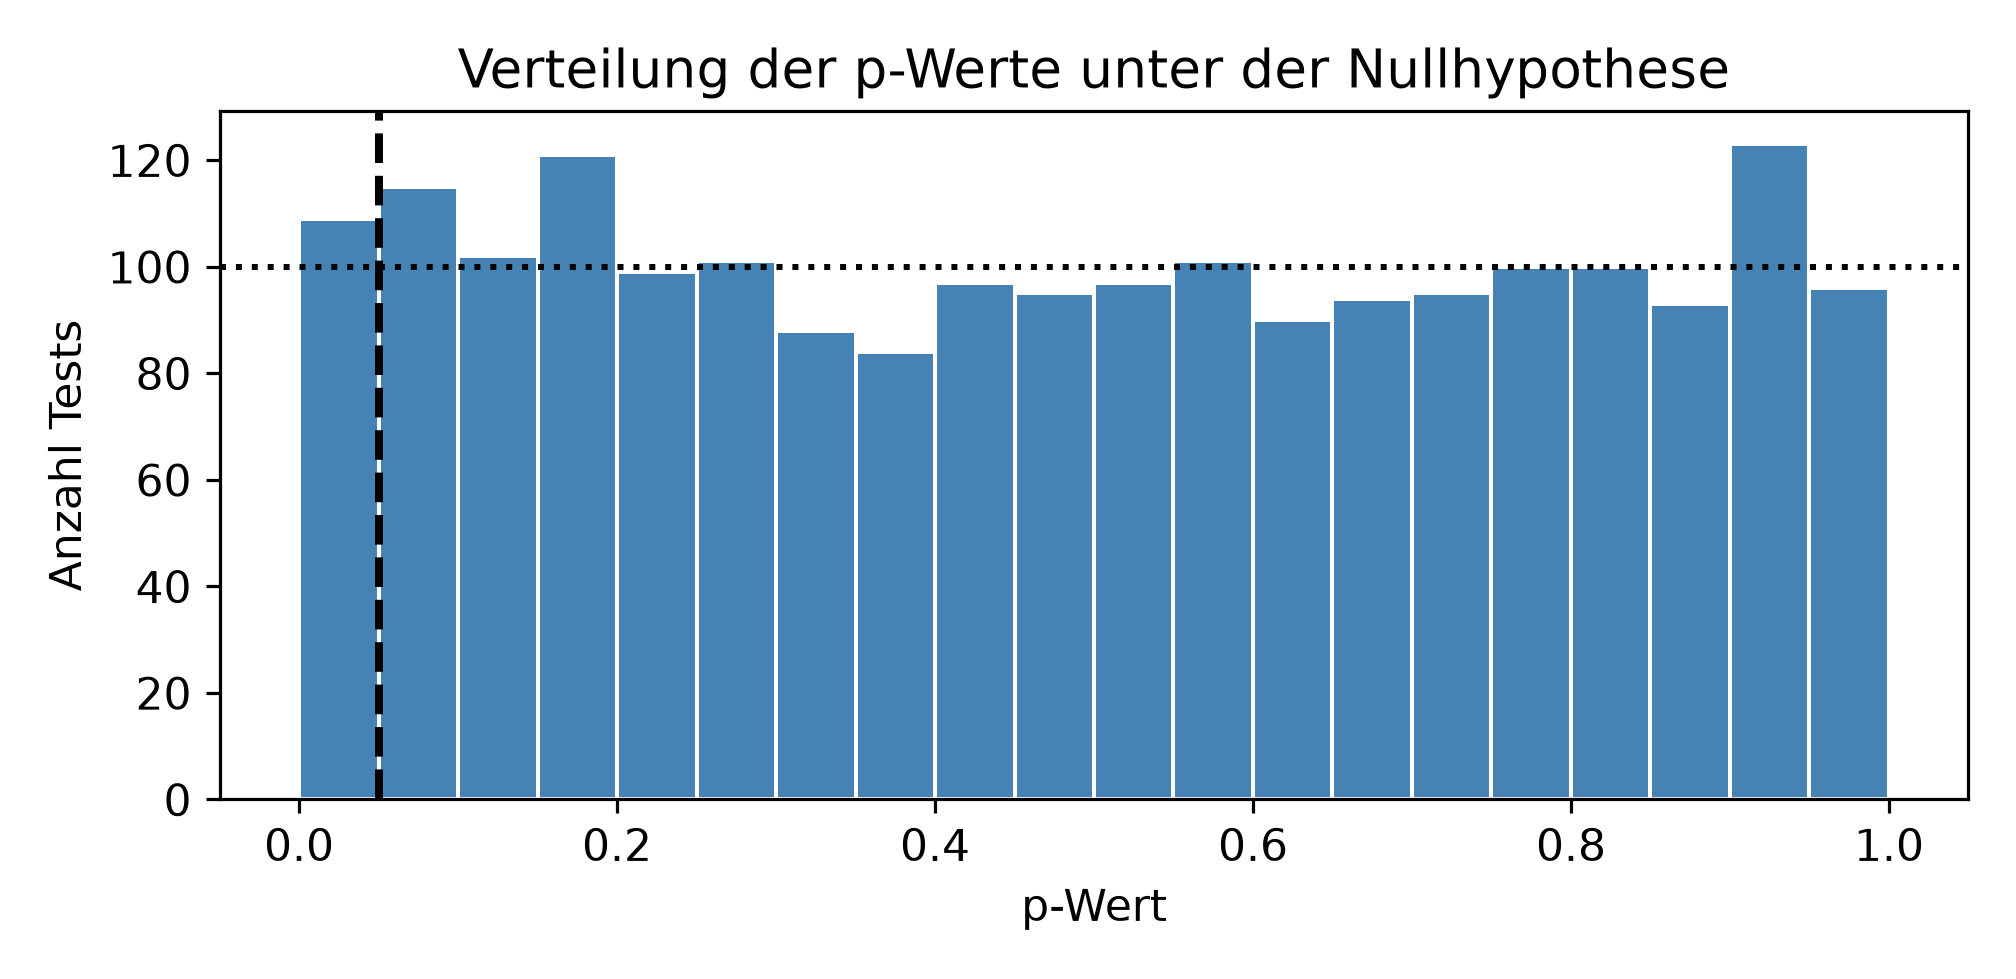
Abbildung 2: Beispiel 2: dieselbe Simulation in Python.
print("Anteil unter 0.10:", round(float((p_werte < 0.10).mean()), 4))
Anteil unter 0.10: 0.112
print("Anteil unter 0.05:", round(float((p_werte < 0.05).mean()), 4))
Anteil unter 0.05: 0.0545
print("Anteil unter 0.01:", round(float((p_werte < 0.01).mean()), 4))
Anteil unter 0.01: 0.0085
print("Median:", round(float(np.median(p_werte)), 4))
Median: 0.4946

Output Zeile für Zeile

Ausgabe Wert hier Erwartet Wie er zu lesen ist
Anteil unter 0.10 0.1120 0.10
Anteil unter 0.05 0.0545 0.05 Von 2000 Tests ohne jeden echten Unterschied sind 109 signifikant. Das ist kein Fehler des Verfahrens, sondern seine Zusage.
Anteil unter 0.01 0.0085 0.01
Median 0.4946 0.50
Histogramm rund 100 Tests je Klasse 100 Flach. Unter der Nullhypothese ist der p-Wert gleichverteilt zwischen 0 und 1.

Die Gleichverteilung ist der Kern. Sie bedeutet: Ein p-Wert von 0.03 ist unter der Nullhypothese genauso wahrscheinlich wie einer von 0.83. Nichts an einem einzelnen kleinen p-Wert beweist, dass etwas vorliegt.

Daraus folgt unmittelbar das Problem des mehrfachen Testens. Wer zwanzig Fragen an denselben Datensatz stellt, erhält im Mittel einen signifikanten Befund, auch wenn keiner existiert. Genau das rechnet die Seite zum multiplen Testen durch.

Und es erklärt, warum das Niveau eine Rate ist und keine Eigenschaft des einzelnen Ergebnisses: Es begrenzt, wie oft man sich auf lange Sicht irrt, nicht ob man sich diesmal geirrt hat.

Interpretation

Die 109 signifikanten Ergebnisse dieser Simulation sind ununterscheidbar von echten Befunden. Sie haben kleine p-Werte, ordentliche t-Werte und Konfidenzintervalle, die die Null nicht enthalten. Nur weil hier die Wahrheit bekannt ist, weiss man, dass sie falsch sind.

In der Praxis schützt davor nur eines: die Fragestellung vorab festzulegen und Befunde aus einer ungeplanten Suche als vorläufig zu kennzeichnen.

Frage und Datenlage

Die Behauptung “schliesst das 95-Prozent-Intervall den Wert der Nullhypothese ein, ist der Test auf dem 5-Prozent-Niveau nicht signifikant” lässt sich nachrechnen. Dazu wird derselbe Datensatz gegen verschiedene Sollwerte getestet.

Rechnung

intervall <- t.test(gewicht)$conf.int
round(as.numeric(intervall), 4)
[1] 496.3612 499.1555
sollwerte <- c(495, 496, 496.3612, 497.7583, 499.1555, 499.2, 501)
vergleich <- data.frame(
  sollwert = sollwerte,
  p = sapply(sollwerte, function(mu) t.test(gewicht, mu = mu)$p.value)
)
vergleich$signifikant <- vergleich$p < 0.05
vergleich$im_intervall <- vergleich$sollwert >= intervall[1] &
                          vergleich$sollwert <= intervall[2]
round_df <- vergleich
round_df$p <- round(round_df$p, 4)
round_df
  sollwert      p signifikant im_intervall
1 495.0000 0.0012        TRUE        FALSE
2 496.0000 0.0182        TRUE        FALSE
3 496.3612 0.0500       FALSE         TRUE
4 497.7583 1.0000       FALSE         TRUE
5 499.1555 0.0500        TRUE        FALSE
6 499.2000 0.0442        TRUE        FALSE
7 501.0000 0.0003        TRUE        FALSE
se = gewicht.std(ddof=1) / np.sqrt(len(gewicht))
halb = stats.t.ppf(0.975, len(gewicht) - 1) * se
intervall = (gewicht.mean() - halb, gewicht.mean() + halb)
print("Intervall:", np.round(intervall, 4))
Intervall: [496.3612 499.1555]
sollwerte = np.array([495, 496, 496.3612, 497.7583, 499.1555, 499.2, 501])
p = np.array([stats.ttest_1samp(gewicht, mu).pvalue for mu in sollwerte])

print(pd.DataFrame({
    "sollwert": sollwerte,
    "p": p.round(4),
    "signifikant": p < 0.05,
    "im_intervall": (sollwerte >= intervall[0]) & (sollwerte <= intervall[1]),
}).to_string(index=False))
 sollwert      p  signifikant  im_intervall
 495.0000 0.0012         True         False
 496.0000 0.0182         True         False
 496.3612 0.0500        False          True
 497.7583 1.0000        False          True
 499.1555 0.0500         True         False
 499.2000 0.0442         True         False
 501.0000 0.0003         True         False

Output Zeile für Zeile

Das 95-Prozent-Intervall lautet 496.3612 bis 499.1555.

Sollwert p signifikant im Intervall
495.00 0.0011 ja nein
496.00 0.0182 ja nein
496.3612 0.0500 nein ja
497.7583 1.0000 nein ja
499.1555 0.0500 ja nein
499.2000 0.0442 ja nein
501.0000 0.0003 ja nein

Die beiden Spalten rechts sind immer gegenläufig, und zwar exakt. Die Intervallgrenzen sind genau die Sollwerte, bei denen der p-Wert 0.05 beträgt.

Die beiden fett gesetzten Zeilen zeigen das an der Grenze: Beide haben einen p-Wert von 0.0500, entscheiden sich aber verschieden. Das ist kein Widerspruch, sondern eine Folge der Rundung, die Sollwerte wurden auf vier Stellen gekürzt und liegen damit minimal innerhalb beziehungsweise ausserhalb der exakten Grenze. Genau an der Grenze ist die Entscheidung willkürlich, und das ist ein Argument gegen die Schwelle als solche. Beim Sollwert 497.7583, dem Stichprobenmittelwert, ist p genau 1: Die Daten sind mit dieser Annahme so gut vereinbar, wie es überhaupt geht.

Das Konfidenzintervall ist die Menge aller nicht verworfenen Nullhypothesen. Diese Sichtweise ist der kürzeste Weg zum Verständnis beider Begriffe: Ein Intervall ist kein zusätzliches Werkzeug neben dem Test, sondern der Test, angewendet auf alle denkbaren Sollwerte gleichzeitig.

Praktisch heisst das, dass der p-Wert Information wegwirft. Er sagt “verworfen” oder “nicht verworfen” für einen Wert; das Intervall sagt es für alle.

Interpretation

Wer das Intervall berichtet, hat den Test damit mitberichtet, aber nicht umgekehrt. Das ist der Grund für die Empfehlung, in erster Linie Schätzwerte mit Intervallen zu berichten und den p-Wert als Beigabe.

Frage und Datenlage

Zwei Untersuchungen zum selben Sachverhalt, mit fast identischen p-Werten:

n je Gruppe beobachtetes \(d\) p
Studie A 40 0.44 0.053
Studie B 4000 0.045 0.044

Nach der üblichen Lesart ist A “nicht signifikant” und B “signifikant”. Was sagen die Daten wirklich?

Rechnung

studie <- function(n, d) {
  se_d <- sqrt(2 / n)
  t_wert <- d / se_d
  p <- 2 * pt(-abs(t_wert), df = 2 * n - 2)
  se_ki <- sqrt(2 / n + d^2 / (4 * n))
  c(n = n, d = d, t = t_wert, p = p,
    unten = d - 1.96 * se_ki, oben = d + 1.96 * se_ki)
}

round(rbind(A = studie(40, 0.44), B = studie(4000, 0.045)), 4)
     n     d      t      p   unten   oben
A   40 0.440 1.9677 0.0527 -0.0035 0.8835
B 4000 0.045 2.0125 0.0442  0.0012 0.0888
def studie(n, d):
    se_d = np.sqrt(2 / n)
    t_wert = d / se_d
    p = 2 * stats.t.cdf(-abs(t_wert), df=2 * n - 2)
    se_ki = np.sqrt(2 / n + d ** 2 / (4 * n))
    return {"n": n, "d": d, "t": t_wert, "p": p,
            "unten": d - 1.96 * se_ki, "oben": d + 1.96 * se_ki}


print(pd.DataFrame([studie(40, 0.44), studie(4000, 0.045)],
                   index=["A", "B"]).round(4))
      n      d       t       p   unten    oben
A    40  0.440  1.9677  0.0527 -0.0035  0.8835
B  4000  0.045  2.0125  0.0442  0.0012  0.0888

Output Zeile für Zeile

n \(d\) t p Intervall für \(d\)
A 40 0.440 1.968 0.0527 -0.004 bis 0.884
B 4000 0.045 2.013 0.0442 0.001 bis 0.089

Die p-Werte liegen fünf Tausendstel auseinander, auf verschiedenen Seiten der Schwelle. Die Intervalle sagen etwas völlig anderes:

Studie A ist unentschieden. Ihr Intervall reicht von praktisch null bis zu einem sehr grossen Effekt von 0.88. Ausgeschlossen ist so gut wie nichts. Der Satz “kein Effekt nachweisbar” ist richtig, der Satz “kein Effekt vorhanden” wäre grob falsch.

Studie B belegt einen sehr kleinen Effekt. Ihr Intervall reicht von 0.001 bis 0.089 und schliesst damit alles über 0.09 aus. Ein Effekt liegt vor, und er ist mit Sicherheit winzig.

Wer nur die p-Werte liest, kommt zum genau umgekehrten Eindruck: A sieht nach “nichts gefunden” aus und B nach “Effekt bestätigt”.

Interpretation und Ergebnissatz

Die beiden Fallen dieses Beispiels sind die häufigsten überhaupt:

Falle Was fehlt
“Nicht signifikant heisst kein Effekt” das Intervall, das zeigt, wie viel noch möglich ist
“Signifikant heisst bedeutsam” die Effektstärke, die zeigt, wie wenig es ist

Beide verschwinden, sobald Intervall und Effektstärke mitberichtet werden. Genau deshalb steht in der Ergebnisvorlage jeder Methodenseite dieser Sammlung nicht nur der p-Wert.

Studie A findet keinen nachweisbaren Unterschied (\(d\) = 0.44, 95-Prozent-Konfidenzintervall -0.00 bis 0.88, p = 0.053, n = 40 je Gruppe); das Intervall lässt Effekte bis in den grossen Bereich zu, ein Ausschluss ist damit nicht erbracht. Studie B findet einen nachweisbaren, aber sehr kleinen Unterschied (\(d\) = 0.045, 0.00 bis 0.09, p = 0.044, n = 4000 je Gruppe).

Verständnisfragen

Ein Test wird mit \(\alpha\) = 0.01 statt 0.05 gerechnet. Was passiert?

Falsche Alarme werden seltener, übersehene Effekte häufiger
Richtig. Die Schwelle rückt nach aussen, also wird die Nullhypothese seltener verworfen, unabhängig davon, ob sie stimmt. Der Preis für weniger Fehler erster Art sind mehr Fehler zweiter Art.
Beide Fehlerarten werden seltener
Das geht bei gleichem Stichprobenumfang nicht, die beiden Raten bewegen sich gegenläufig.
Das Ergebnis wird zuverlässiger, weil der Effekt grösser sein muss
Der wahre Effekt ändert sich nicht. Nur die Schwelle ändert sich, ab der man ihn berichtet.

Ein Test ergibt p = 0.42. Was darf man schliessen?

Dass die Gruppen gleich sind
Ein fehlender Nachweis ist kein Nachweis der Gleichheit. Möglicherweise ist die Stichprobe zu klein.
Nur, dass die Daten mit der Nullhypothese vereinbar sind
Richtig. Wie grosse Effekte die Daten noch zulassen, zeigt allein das Konfidenzintervall, und das gehört deshalb immer mitberichtet.
Dass die Nullhypothese mit 58 Prozent Wahrscheinlichkeit falsch ist
Der p-Wert ist keine Wahrscheinlichkeit für eine Hypothese, in keiner Rechenrichtung.

Zwei Untersuchungen betrachten denselben Effekt. A: n = 40, p = 0.053, Konfidenzintervall des standardisierten Unterschieds -0.00 bis 0.88. B: n = 4000, p = 0.044, Intervall 0.00 bis 0.09. Was ist die richtige Lesart?

B zeigt den stärkeren Effekt, weil p kleiner ist
Der p-Wert vergleicht keine Effektgrössen. B hat vor allem mehr Beobachtungen.
A lässt auch grosse Effekte zu, B belegt einen kleinen
Richtig. In A ist das Intervall breit, es ist kaum etwas ausgeschlossen. In B ist es eng und liegt knapp über null: Der Effekt ist gesichert, aber winzig.
A ist wertlos, weil nicht signifikant
A ist unentschieden, und das ist ein Ergebnis. Wertlos wäre die Aussage nur, wenn man das Intervall verschweigt.

Von 2000 Tests auf Daten ohne jeden Unterschied sind 109 signifikant. Was folgt daraus?

Nichts Ungewöhnliches; das entspricht dem Niveau von 5 Prozent
Richtig. Unter der Nullhypothese ist der p-Wert gleichverteilt, also fallen rund 5 Prozent unter die Schwelle. Das Niveau begrenzt diese Rate, es schliesst falsche Alarme nicht aus.
Die Simulation ist fehlerhaft
109 von 2000 sind 5.45 Prozent, also genau im erwarteten Bereich.
Der t-Test ist unzuverlässig
Er hält sein Versprechen exakt ein. Das Versprechen lautet nur nicht, was viele darin lesen.

Verlinkte Ressourcen