Typische Fragestellungen: Kundensegmente bilden, Maschinen nach Betriebsmuster gruppieren, Messreihen in Zustandsklassen einteilen. Gemeinsam ist ihnen, dass Gruppen gesucht und nicht bekannt sind, und dass alle Variablen metrisch sind.
k-Means teilt die Beobachtungen so auf, dass die Summe der quadrierten Abstände zu den Gruppenzentren minimal wird. Das Verfahren ist schnell und funktioniert bei kompakten, ähnlich grossen Gruppen sehr gut. Es hat drei Eigenschaften, die man kennen muss: Die Anzahl Gruppen wird vorgegeben, das Ergebnis hängt von den Startwerten ab, und die Gruppenform ist implizit kugelig.
Situation
Stattdessen
Anzahl Gruppen unbekannt und Struktur soll sichtbar werden
Zentrum der Gruppe \(j\), der Mittelwert ihrer Mitglieder
\(\lVert x_i - \mu_j \rVert^2\)
quadrierte euklidische Distanz zum Zentrum
Der Algorithmus wechselt zwei Schritte ab, bis sich nichts mehr ändert: Jede Beobachtung wird dem nächsten Zentrum zugeordnet, dann wird jedes Zentrum als Mittelwert seiner Mitglieder neu berechnet. Das findet garantiert ein lokales Minimum, aber nicht garantiert das beste. Deshalb wird das Verfahren mit mehreren Startwerten wiederholt, und die beste Lösung gewinnt: in R über nstart, in Python über n_init.
Weil quadrierte euklidische Distanzen minimiert werden, sind zwei Dinge eingebaut: Die Gruppen werden tendenziell kugelig und ähnlich gross, und die Standardisierung entscheidet über das Ergebnis, siehe Distanzmasse.
eine Gruppe mit einem oder zwei Fällen deutet auf Ausreisser
centers
Zentren in den Einheiten der übergebenen Daten
bei standardisierten Daten in Standardabweichungen, also zurückrechnen für den Bericht
cluster
Gruppennummer je Beobachtung
die Nummerierung ist beliebig und wechselt zwischen Läufen
tot.withinss
Summe der quadrierten Abstände innerhalb der Gruppen
sinkt zwangsläufig mit steigendem k
betweenss
Streuung zwischen den Gruppen
totss
Gesamtstreuung
betweenss / totss ist der erklärte Anteil
iter
Anzahl Durchläufe bis zur Konvergenz
Warnung did not converge
Abbruch vor Konvergenz
iter.max erhöhen
Python, KMeans:
Zugriff
Was er liefert
Unterschied zu R
labels_
Gruppenzuordnung
wie cluster, aber nullbasiert
cluster_centers_
Zentren
wie centers
inertia_
Summe der quadrierten Abstände innerhalb der Gruppen
wie tot.withinss
n_iter_
Anzahl Durchläufe
wie iter
kein betweenss
selbst berechnen als Gesamtstreuung minus inertia_
in R enthalten
n_init
Anzahl Startwerte
wie nstart; die Voreinstellung hat sich zwischen den Versionen geändert, deshalb ausdrücklich setzen
Die Gruppennummern bedeuten nichts. Gruppe 1 in einem Lauf kann Gruppe 3 im nächsten sein, und R und Python nummerieren dieselbe Aufteilung fast immer verschieden. Für den Bericht werden die Gruppen nach einem inhaltlichen Merkmal umsortiert und benannt. Jede Aussage der Form “Gruppe 2 kauft mehr” ist ohne diese Benennung wertlos.
Interpretationsfallen
k-Means findet immer Gruppen. Auch in Daten ohne Struktur. Dass eine Lösung vorliegt, sagt nichts darüber, ob es Gruppen gibt.
Die Streuung innerhalb sinkt mit k. Sie taugt deshalb nicht zur Wahl von k, siehe Clustergüte.
Gruppennummern sind beliebig. Sie wechseln zwischen Läufen; jede Aussage über “Gruppe 2” braucht eine inhaltliche Beschreibung.
Ohne Standardisierung entscheidet die Einheit. Der häufigste stille Fehler.
Zentren in Standardabweichungen sind nicht berichtbar. Für den Bericht werden sie in die ursprünglichen Einheiten zurückgerechnet.
Kugelige Gruppen sind eine Annahme. Bei anderen Formen liegt das Verfahren falsch, ohne es anzuzeigen.
Ein Clustering ist keine Erklärung. Es beschreibt Ähnlichkeit in den gewählten Variablen; wer andere Variablen wählt, bekommt andere Gruppen.
Ausreisser verzerren Zentren. Ein einzelner extremer Punkt kann eine eigene Gruppe erzwingen und die übrigen verschieben.
Ergebnis berichten
Vorlage für den Ergebnissatz:
Ein k-Means-Clustering auf [Variablen], standardisiert, mit k = [k] und [Anzahl] Startwerten (n = [n]) ergibt Gruppen der Grössen [Grössen]. Die Zentren liegen bei [Werte in Originaleinheiten]; die Aufteilung erklärt [Anteil] der Gesamtstreuung. Die Wahl von k stützt sich auf [Kriterium].
Genannt werden: verwendete Variablen und Standardisierung, k und dessen Begründung, Anzahl Startwerte, Gruppengrössen, Zentren in Originaleinheiten, erklärter Streuungsanteil, ein Gütemass wie die Silhouette und eine inhaltliche Beschreibung jeder Gruppe.
Die ersten vier Beispiele arbeiten mit demselben konstruierten Datensatz: 270 Kunden mit den Merkmalen Besuche und Umsatz, aufgeteilt in drei eingebaute Gruppen von 120, 90 und 60 Personen. Weil die Wahrheit bekannt ist, lässt sich prüfen, ob das Verfahren sie findet.
Die euklidische Distanz addiert beide Quadrate. Der Beitrag der Besuche verschwindet dabei vollständig, k-Means würde ohne Standardisierung praktisch nur nach Umsatz trennen.
Zentren ohne Standardisierung
13.2 / 1426, 7.5 / 923, 3.1 / 2216
Die Grenzen verlaufen praktisch senkrecht zur Umsatzachse. Dass die Besuchszahlen trotzdem verschieden sind, liegt nur daran, dass Umsatz und Besuche in diesen Daten zusammenhängen, nicht daran, dass die Besuche mitgerechnet hätten.
Kreuztabelle ohne Standardisierung
241 von 270 richtig zugeordnet
Mit Standardisierung sind es 263 (Beispiel 2). Vor allem die grösste eingebaute Gruppe zerfällt: 21 ihrer Mitglieder landen bei den Gelegenheitskunden, weil ihr Umsatz zufällig tiefer liegt.
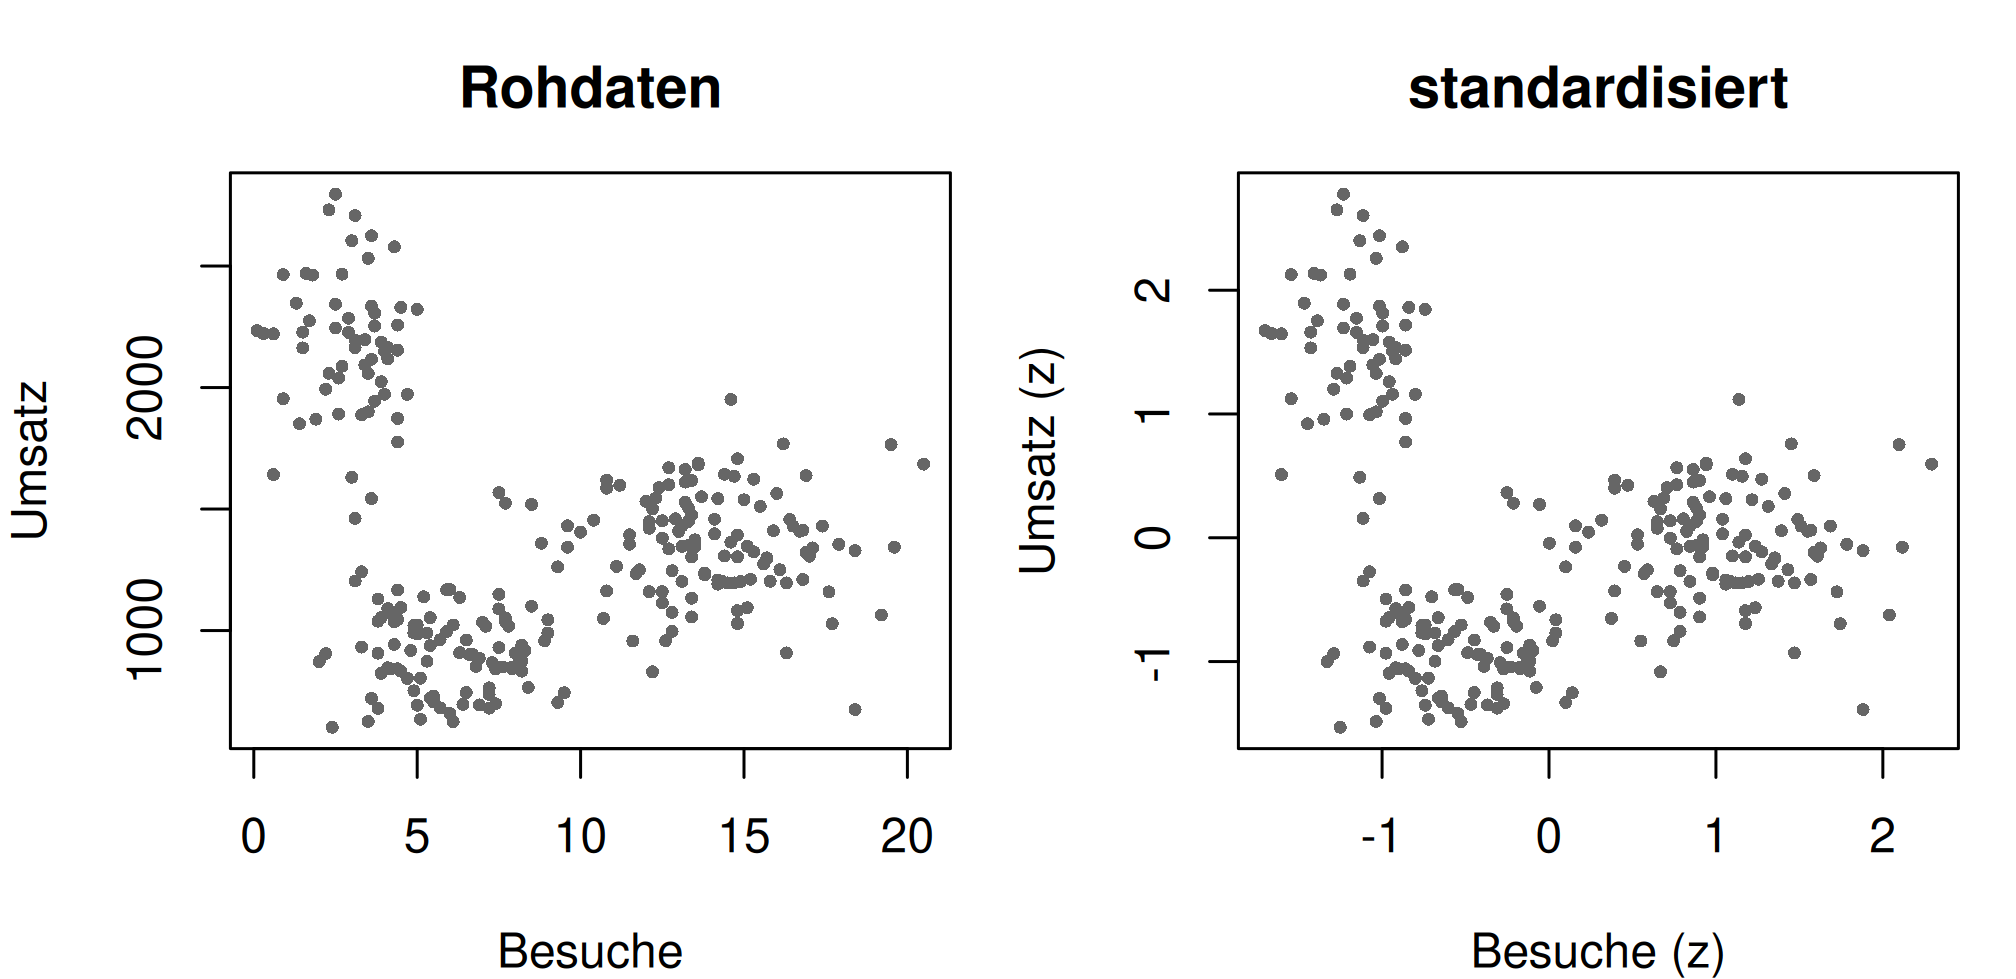
Linkes Bild
eine gestreckte Wolke
Die Achsen sind nicht vergleichbar, Abstände darin auch nicht.
Rechtes Bild
drei erkennbare Punktwolken
Erst hier zählen beide Merkmale gleich viel.
Standardisierung ist bei k-Means keine Kosmetik, sondern Teil der Modellentscheidung. Sie legt fest, dass beide Merkmale gleich wichtig sein sollen. Wer bewusst anders gewichten will, kann das tun, aber dann als begründete Entscheidung und nicht als Nebenwirkung der Masseinheit.
Interpretation
Die Wahl der Skalierung gehört in den Methodenteil jedes Berichts. Verwendet wird hier die z-Standardisierung: von jedem Wert wird der Mittelwert abgezogen und durch die Standardabweichung geteilt. Weiteres dazu unter Distanzmasse.
Frage und Datenlage
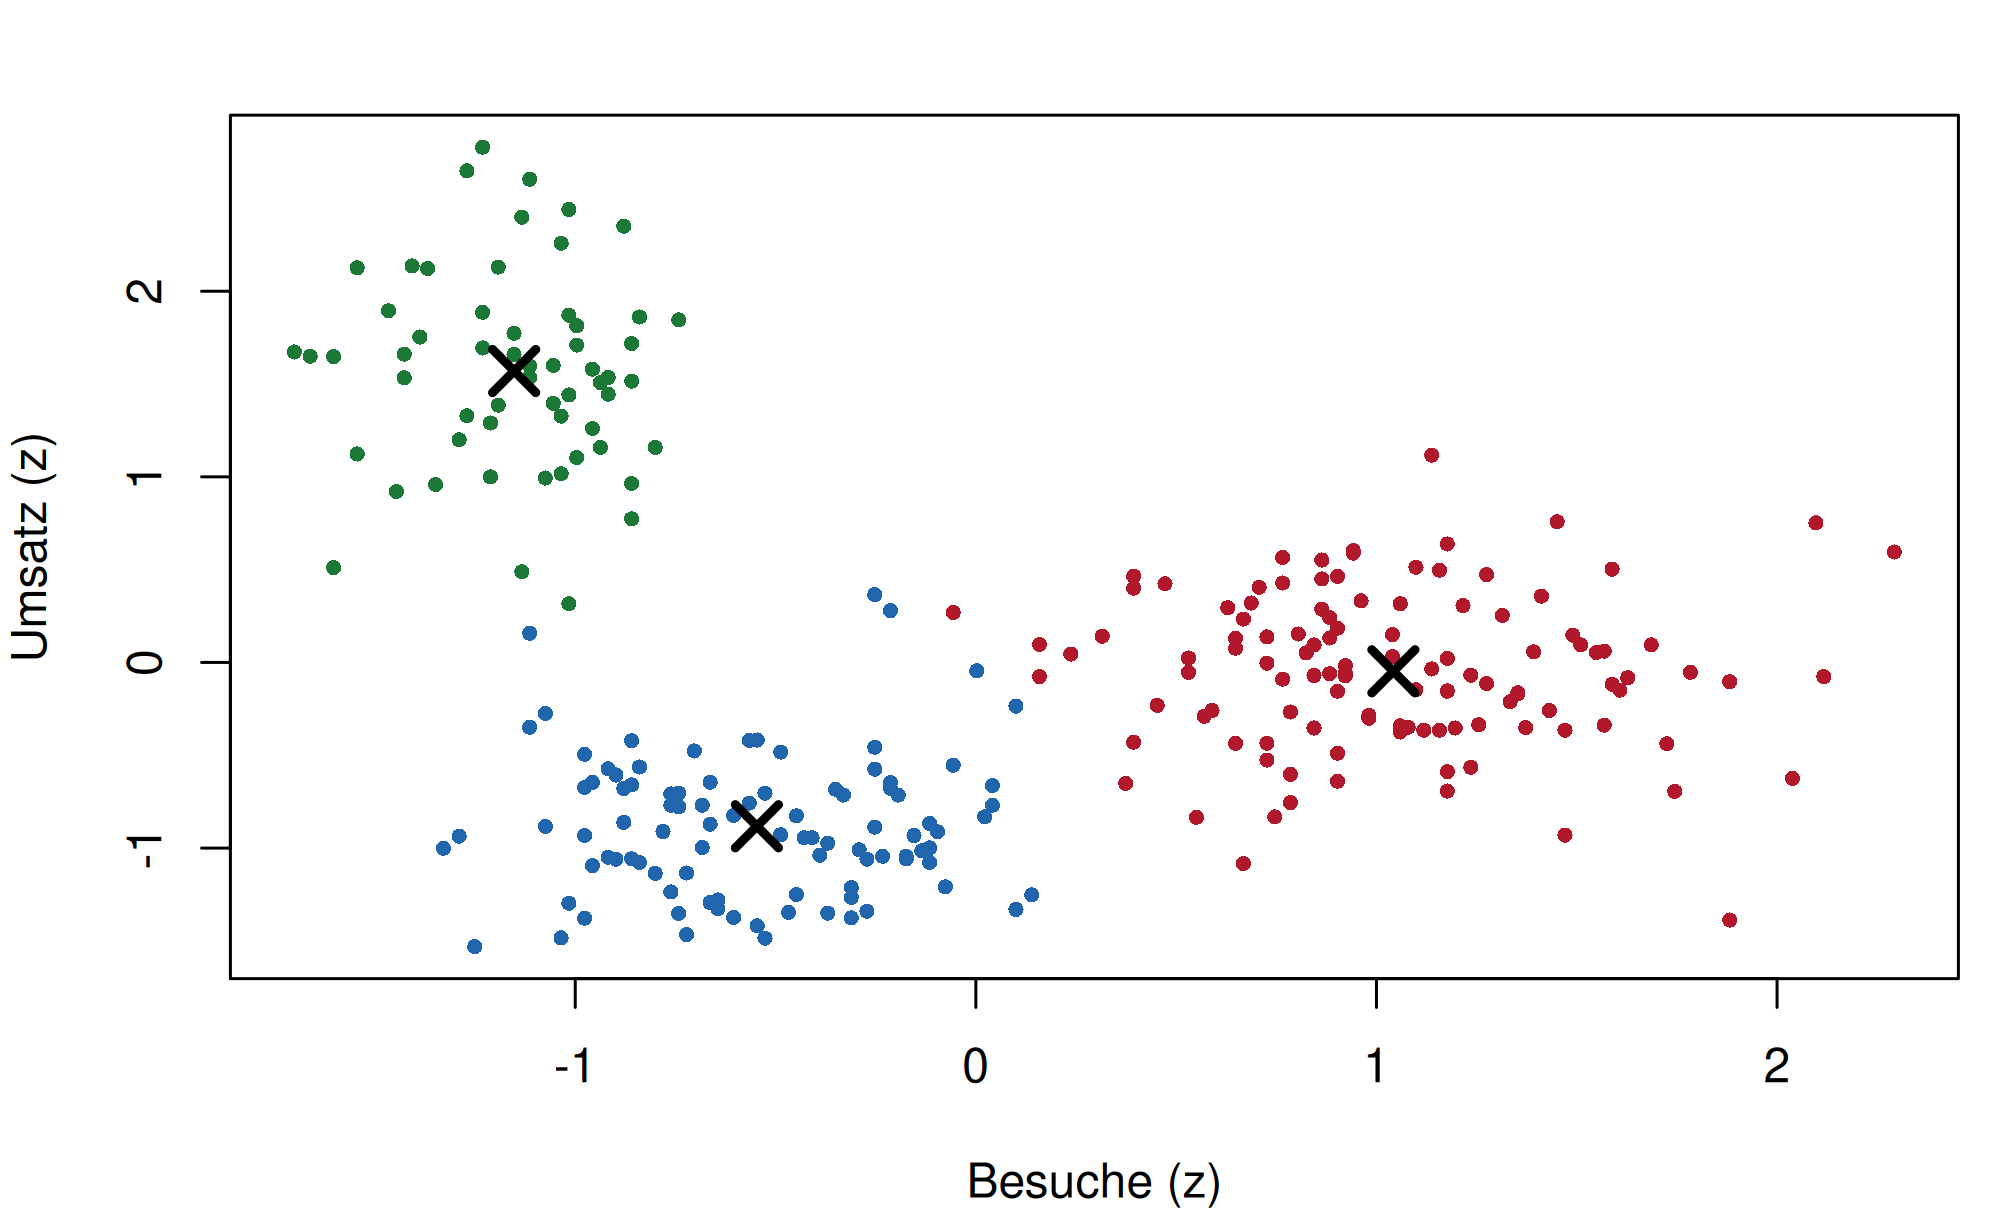
Drei Gruppen, 25 Startwerte, standardisierte Daten. Findet das Verfahren die eingebaute Struktur?
Die drei Zentren, zurückgerechnet in die ursprünglichen Einheiten:
Grösse
Zentrum Besuche
Zentrum Umsatz
standardisiert (Besuche / Umsatz)
115
14.1
1358
1.044 / -0.048
97
6.0
932
-0.548 / -0.884
58
2.9
2182
-1.155 / 1.573
Ausgabe
Wert hier
Bedeutung
Gruppengrössen
115, 97, 58
Die eingebauten Gruppen waren 120, 90 und 60 gross. Die Abweichung entsteht an den Rändern, wo sich die Wolken berühren.
within
88.594 in Python, 88.266 in R
Summe der quadrierten Abstände jeder Beobachtung zu ihrem Zentrum. Die Einheit ist die standardisierte Skala, ein absoluter Vergleich mit anderen Datensätzen ist damit sinnlos. Zur Differenz siehe den Kasten unten.
between
451.406 / 449.734
Streuung zwischen den Zentren.
totss
540 / 538
Die Gesamtstreuung. within und between addieren sich genau zu diesem Wert.
Anteil between/totss
0.836 in beiden Sprachen
83.6 Prozent der Streuung liegen zwischen den Gruppen. Eine Kennzahl, kein Gütesiegel: Sie steigt mit jedem zusätzlichen k.
Kreuztabelle
263 von 270 richtig
Fünf Kunden der grössten Gruppe und zwei der kleinsten landen in der mittleren. Genau die Randfälle also, die im Bild zwischen zwei Wolken liegen.
Warum R und Python hier um 0.4 Prozent auseinanderliegen:scale() in R teilt durch die Stichproben-Standardabweichung mit dem Nenner \(n-1\), StandardScaler in Python durch die mit dem Nenner \(n\). Die standardisierten Daten unterscheiden sich damit um den Faktor\(\sqrt{n/(n-1)}\), alle quadrierten Abstände um \(n/(n-1) = 270/269 = 1.0037\), genau das Verhältnis von 88.594 zu 88.266.
Die Aufteilung selbst ist identisch, denn eine gemeinsame Streckung aller Abstände ändert nichts daran, welches Zentrum das nächste ist. Alle Verhältnisse, Anteil, Silhouette, Zentren in Originaleinheiten, stimmen deshalb überein. Nur die absoluten Streuungswerte nicht, was ein weiteres Argument dafür ist, sie nie ohne ihren Bezugswert zu berichten.
Interpretation und Ergebnissatz
Die zurückgerechneten Zentren sind das, was ein Clustering überhaupt erst zu einem Ergebnis macht:
Gruppe
n
Besuche
Umsatz
Beschreibung
Stammkunden
115
14.1
1358
kommen oft, geben pro Jahr solide aus
Gelegenheitskunden
97
6.0
932
kommen selten, geben wenig aus
Grosseinkäufer
58
2.9
2182
kommen fast nie, kaufen dann aber viel
Die dritte Gruppe ist der interessante Befund: Wer nur auf den Umsatz geschaut hätte, hätte sie für die beste Kundengruppe gehalten; wer nur auf die Besuche geschaut hätte, für die schlechteste. Erst beide Merkmale zusammen beschreiben sie.
Ein k-Means-Clustering auf Besuchen und Umsatz, z-standardisiert, mit k = 3 und 25 Startwerten (n = 270) ergibt Gruppen von 115, 97 und 58 Kunden. Die Zentren liegen bei 14.1 Besuchen und 1358 Franken, 6.0 Besuchen und 932 Franken sowie 2.9 Besuchen und 2182 Franken; die Aufteilung erklärt 83.6 Prozent der Gesamtstreuung.
Frage und Datenlage
Die naheliegende Idee, k so zu wählen, dass die Streuung innerhalb der Gruppen klein wird, führt zuverlässig in die Irre. Die Rechnung zeigt, warum.
(Python-Ausgabe. R liefert dieselben Anteile, aber within-Werte, die um den im vorigen Beispiel erklärten Faktor 1.0037 tiefer liegen; ab k = 5 findet es ausserdem eine leicht andere Aufteilung, weil dort mehrere fast gleich gute Lösungen existieren, siehe Beispiel 4.)
Drei Dinge stehen in dieser Tabelle:
Beobachtung
Was folgt
within sinkt immer
Bei k = n wäre sie null, denn jede Beobachtung wäre ihr eigenes Zentrum. Die Kennzahl kann k nicht begründen, sie zeigt nur an, dass mehr Zentren näher liegen.
Der Zugewinn bricht nach k = 3 ein
Von 2 auf 3 kommen 31 Prozentpunkte dazu, von 3 auf 4 nur noch 3. Das ist der Knick, den die Ellenbogenmethode sucht.
Die Silhouette hat ein Maximum bei k = 3
Anders als within steigt sie nicht mechanisch mit k, sondern fällt wieder. Deshalb ist sie das brauchbarere Kriterium; ausführlich unter Clustergüte.
Der Blick auf die kleinste Gruppe ergänzt das um ein praktisches Argument: Ab k = 5 entstehen Gruppen von 27 Kunden, die inhaltlich kaum mehr von ihren Nachbarn zu unterscheiden sind.
Interpretation und Ergebnissatz
Die Wahl von k stützt sich auf den Verlauf der Streuung innerhalb der Gruppen (deutlicher Knick nach k = 3), auf die mittlere Silhouettenbreite (Maximum bei k = 3 mit 0.63) und auf die inhaltliche Beschreibbarkeit der Gruppen.
Frage und Datenlage
k-Means findet ein lokales Minimum, nicht zwingend das beste. Wie stark das ins Gewicht fällt, hängt davon ab, wie klar die Struktur ist, hier verglichen für k = 3 und k = 5.
def vergleiche(k): werte = [KMeans(n_clusters=k, n_init=1, random_state=i).fit(skaliert).inertia_for i inrange(20)]return {"k": k, "bester": round(min(werte), 3),"schlechtester": round(max(werte), 3),"abstand_prozent": round(100* (max(werte) -min(werte)) /min(werte), 1),"verschiedene": len({round(w, 3) for w in werte})}print(pd.DataFrame([vergleiche(3), vergleiche(5)]).to_string(index=False))
 k  bester  schlechtester  abstand_prozent  verschiedene
 3  88.594         88.615              0.0             2
 5  61.189         70.405             15.1            15
for k in (3, 5):print(f"k = {k} mit 25 Startwerten:",round(KMeans(n_clusters=k, n_init=25, random_state=2026).fit(skaliert).inertia_, 3))
k = 3 mit 25 Startwerten: 88.594
k = 5 mit 25 Startwerten: 61.145
Output Zeile für Zeile
k
bester Lauf
schlechtester Lauf
Abstand
verschiedene Lösungen
3 (Python)
88.594
88.615
0.0 %
2
3 (R)
88.266
88.266
0.0 %
1
5 (Python)
61.189
70.405
15.1 %
15
5 (R)
60.863
72.342
18.9 %
13
Dass die beiden Sprachen bei k = 5 verschiedene Zahlen zeigen, ist hier kein Störgeräusch, sondern die Aussage selbst: Bei k = 5 hängt das Ergebnis so stark vom Startwert ab, dass schon eine andere Reihenfolge der Startpunkte eine andere Lösung liefert. Bei k = 3 stimmen beide auf die zweite Nachkommastelle überein.
Beobachtung
Was sie bedeutet
Bei k = 3 spielt der Startwert keine Rolle
Zwanzig Einzelläufe finden praktisch dieselbe Lösung. Wo die Struktur eindeutig ist, führt jeder Weg dorthin.
Bei k = 5 landen zwanzig Läufe auf 13 bis 15 verschiedenen Lösungen
Der schlechteste hat 15 bis 19 Prozent mehr Streuung innerhalb der Gruppen als der beste. Wer einmal rechnet und das Ergebnis berichtet, berichtet ein zufälliges Zwischenergebnis.
Mit 25 Startwerten wird in beiden Fällen das Minimum gefunden
Die Software rechnet 25-mal und behält die beste Lösung. Der Aufwand ist bei dieser Datengrösse vernachlässigbar.
Der Zusammenhang lohnt es sich zu merken: Instabilität gegenüber Startwerten ist selbst ein Hinweis darauf, dass k zu gross gewählt ist. Wo es echte Gruppen gibt, findet das Verfahren sie fast immer; wo es willkürlich teilt, hängt das Ergebnis vom Zufall ab.
Interpretation
nstart beziehungsweise n_init wird immer ausdrücklich gesetzt. Die Voreinstellung ist in beiden Sprachen niedrig, in R genau eins und hat sich in Python zwischen den Versionen geändert. Ein Wert von 25 ist üblich und praktisch immer ausreichend.
Frage und Datenlage
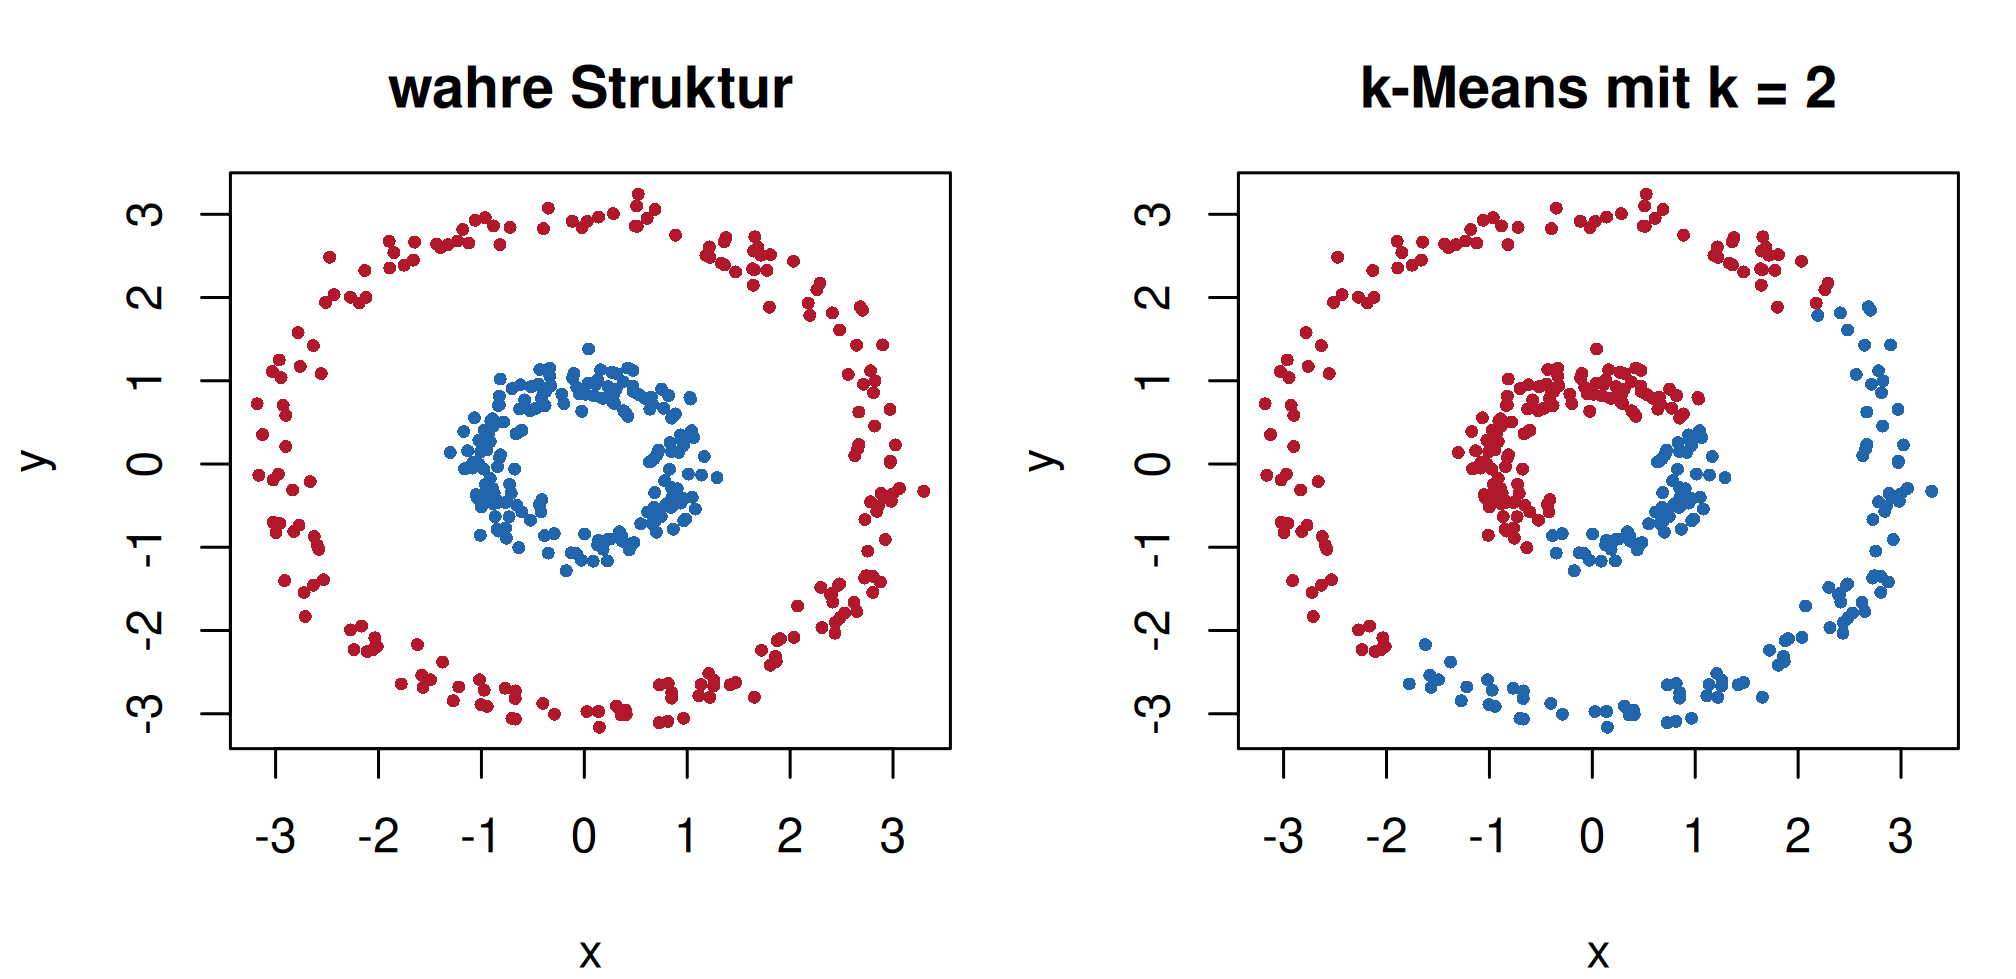
Ein Datensatz mit zwei ineinander liegenden Ringen: 200 Punkte auf einem Kreis mit Radius 1, 200 auf einem mit Radius 3. Die Struktur ist für das Auge offensichtlich. Was macht k-Means daraus?
Die Kreuztabelle der gefundenen gegen die wahren Gruppen:
aussen
innen
gefundene Gruppe 1
102
72
gefundene Gruppe 2
98
128
Ausgabe
Wert hier
Wie er zu lesen ist
Kreuztabelle
jede Zeile enthält beide Ringe
Vollständiges Versagen. Wären die Gruppen erkannt, stünde in jeder Zeile eine Null. Hier ist die Aufteilung fast eine Halbierung nach Zufall.
Anteil erklärt
0.336
Niedriger als bei den Kundendaten, aber nicht auffällig niedrig. Für sich genommen liest sich der Wert wie ein mässiges, nicht wie ein falsches Ergebnis.
Silhouette
0.321
Ebenfalls mittelmässig, nicht alarmierend. Werte um 0.3 werden gelegentlich als “schwache Struktur” gedeutet und genau das ist die Falle.
Keine Kennzahl zeigt diesen Fehler an. k-Means hat getan, was es tun soll: die Abstandssumme minimiert. Der Raum wird dabei zwangsläufig durch gerade Linien in Bereiche geteilt, und ein Ring lässt sich so nicht von einem anderen trennen, ganz gleich, wie gross k gewählt wird.
Erkennbar ist der Fall nur im Bild.
Interpretation und Ergebnissatz
Das Vorgehen: Vor dem Clustering die Daten ansehen, bei zwei oder drei Dimensionen direkt, bei mehr über die ersten Hauptkomponenten. Zeigen sich langgezogene, ringförmige oder verschachtelte Formen, ist ein dichtebasiertes Verfahren wie DBSCAN die passende Wahl, oder ein hierarchisches mit Single-Linkage, das kettenförmige Strukturen zusammenfasst.
k-Means mit k = 2 trennt die beiden ringförmigen Gruppen nicht (jede gefundene Gruppe enthält Punkte aus beiden Ringen, Silhouette 0.32). Für diese Struktur wird ein dichtebasiertes Verfahren verwendet.
Verständnisfragen
Nach dem Erhöhen von k von 3 auf 6 sinkt die Streuung innerhalb der Gruppen von 88.6 auf 52.1. Ist die Lösung mit sechs Gruppen besser?
Ja, geringere Streuung heisst bessere Anpassung
Die Streuung sinkt zwangsläufig mit jedem zusätzlichen k, bis sie bei k gleich n null ist.
Nein, die Kennzahl kann k nicht begründen
Richtig. Herangezogen werden der Knick im Verlauf, die Silhouette (die hier bei k = 3 ihr Maximum hat) und die inhaltliche Beschreibbarkeit der Gruppen samt einer Mindestgrösse.
Das entscheidet der erklärte Anteil der Streuung
Der ist dieselbe Kennzahl in anderer Form und steigt ebenfalls mit k.
Zwei Läufe mit identischen Daten liefern verschiedene Gruppennummern für dieselben Kunden. Ist das ein Fehler?
Nein, die Nummerierung ist beliebig
Richtig. Nur die Aufteilung zählt. Für Berichte werden die Gruppen nach einem inhaltlichen Merkmal sortiert und benannt, damit sie über Läufe hinweg wiedererkennbar sind.
Ja, das Verfahren ist instabil
Instabilität zeigt sich in unterschiedlichen Aufteilungen, nicht in vertauschten Nummern.
Ja, es fehlt ein Startwert
Ein fester Startwert macht die Nummerierung reproduzierbar, sie bleibt aber inhaltlich bedeutungslos.
Zwanzig Läufe mit je einem Startwert liefern bei k = 3 zwei praktisch identische Lösungen, bei k = 5 aber fünfzehn verschiedene. Was lässt sich daraus ablesen?
Dass drei Gruppen in den Daten stecken und fünf nicht
Richtig. Wo echte Struktur vorliegt, führt fast jeder Startwert dorthin. Instabilität gegenüber Startwerten ist selbst ein Hinweis, dass k zu gross gewählt ist.
Dass bei k = 5 zu wenige Läufe gerechnet wurden
Mehr Startwerte finden zwar das Minimum, ändern aber nichts daran, dass die Aufteilung willkürlich ist.
Dass die Daten nicht standardisiert waren
Sie waren es; die Standardisierung betrifft die Gewichtung der Merkmale, nicht die Startwerte.
Ein Datensatz enthält zwei ineinander liegende ringförmige Gruppen. k-Means mit k gleich zwei liefert eine Silhouette von 0.32. Was ist passiert?
Der Raum wurde geradlinig geteilt, die Ringe wurden zerschnitten
Richtig. k-Means minimiert Abstände zu Zentren und erzeugt dadurch geradlinig begrenzte Bereiche. Ringförmige Strukturen kann es grundsätzlich nicht finden; die Kennzahlen zeigen das nicht an, sie sehen bloss mittelmässig aus.
Die Daten waren nicht standardisiert
Standardisierung ändert an der Form der Gruppen nichts.
k war zu klein gewählt
Auch mit grösserem k entstehen geradlinig begrenzte Stücke, keine Ringe.
Warum werden die Zentren für den Bericht zurückgerechnet?
Weil sie in Standardabweichungen nicht deutbar sind
Richtig. Ein Zentrum bei 1.04 Standardabweichungen sagt niemandem etwas; 14.1 Besuche und 1358 Franken Umsatz beschreiben das Segment.
Weil die Standardisierung das Ergebnis verfälscht
Sie ist notwendig für die Gruppierung, nur nicht für die Darstellung.
Weil die Zentren sonst nicht vergleichbar sind
Vergleichbar sind sie in beiden Skalen; deutbar nur in der ursprünglichen.