Storytelling mit Daten

Storytelling
Kommunikation
Visualisierung
R
Python
Aufbau, Betonung und Text als Teil der Grafik.

Kernideen

  • Eine Grafik ohne Text ist eine Behauptung ohne Satz.
  • Der Fünf-Sekunden-Test prüft, ob die Aussage ankommt.
  • Reihenfolge erzeugt Bedeutung: Ausgangslage, Spannung, Auflösung.
  • Betonen heisst zurücknehmen und wie stark betont wird, lässt sich ausrechnen.
  • Zwei gleichzeitig steigende Kurven belegen keine Wirkung. Dafür braucht es eine Vergleichsgruppe.
  • Wie sicher eine Prognose aussieht, entscheidet die Modellwahl, nicht die Daten.
  • Die Handlungsempfehlung gehört dazu, sonst bleibt die Grafik folgenlos.

Erklärung

Vorwissen: Zielbild und Publikum für die Entscheidung, die gestützt werden soll, und Wahrnehmung und Kodierung für die Mittel der Betonung.

Der Fünf-Sekunden-Test

Die schnellste und härteste Prüfung: Man zeigt jemandem die Grafik fünf Sekunden lang, nimmt sie weg und fragt, was er gesehen hat.

Drei mögliche Antworten, drei verschiedene Befunde:

  • Die Aussage kommt zurück. Die Grafik funktioniert.
  • Eine andere Aussage kommt zurück. Die Betonung liegt falsch: das Auge wurde von etwas anderem gefangen als von der Botschaft.
  • Nur eine Beschreibung kommt zurück (“ein paar Balken, blau”). Es fehlt die Führung; niemand weiss, worauf zu achten ist.

Der Test funktioniert auch allein: Grafik anzeigen, Bildschirm für fünf Sekunden ansehen, wegdrehen und den Satz aufschreiben, den man mitgenommen hat.

Text ist Teil der Grafik

Die verbreitetste Sparmassnahme am falschen Ort ist, den Text wegzulassen. Vier Textelemente tragen Bedeutung:

Element Aufgabe Häufiger Fehler
Titel die Aussage in einem Satz beschreibt nur, was zu sehen ist
Achsenbeschriftung was gemessen wird, in welcher Einheit fehlt oder nennt den Spaltennamen aus der Datei
Annotation erklärt die eine auffällige Stelle fehlt, obwohl die Stelle die Aussage trägt
Quelle und Stand Nachvollziehbarkeit fehlt, sobald die Grafik weitergereicht wird

Eine Annotation direkt an der Stelle, um die es geht, ersetzt eine halbe Seite Erklärtext darunter. Sie ist auch der Grund, warum Legenden oft überflüssig sind: Wer die Serien direkt beschriftet, spart dem Auge den Weg zur Legende und zurück.

Reihenfolge erzeugt Bedeutung

Eine Folge von Grafiken erzählt etwas, das eine einzelne nicht kann. Das bewährte Muster hat drei Teile:

  1. Ausgangslage. Was war der Stand, den alle kennen? Diese Grafik darf langweilig sein, sie stellt den gemeinsamen Boden her.
  2. Spannung. Was ist anders als erwartet? Hier liegt die eigentliche Beobachtung, und hier gehört die stärkste Betonung hin.
  3. Auflösung. Was folgt daraus, und was ist zu tun? Ohne diesen Teil bleibt die Beobachtung folgenlos.

Wer nur eine Grafik hat, baut dieselbe Struktur in Titel, Annotation und Bildunterschrift ein.

Betonen heisst zurücknehmen

Betonung entsteht nicht dadurch, dass etwas lauter wird, sondern dadurch, dass alles andere leiser wird. Die Mittel, in der Reihenfolge ihrer Wirksamkeit:

  • alles Nebensächliche in Grau, das Wichtige in einer Farbe
  • die relevante Serie dicker, die übrigen dünn
  • die Kernzahl direkt beschriften, statt sie ablesen zu lassen
  • Zierrat entfernen, siehe Wahrnehmung und Kodierung

Wer alles betont, betont nichts. Mehr als ein Akzent je Grafik ist fast immer einer zu viel. Beispiel 1 rechnet aus, wie viel das ausmacht.

Die Aussage muss die Daten decken

Storytelling verführt zum Zuspitzen, und genau da entstehen die Fehler, die später teuer werden. Drei Grenzen:

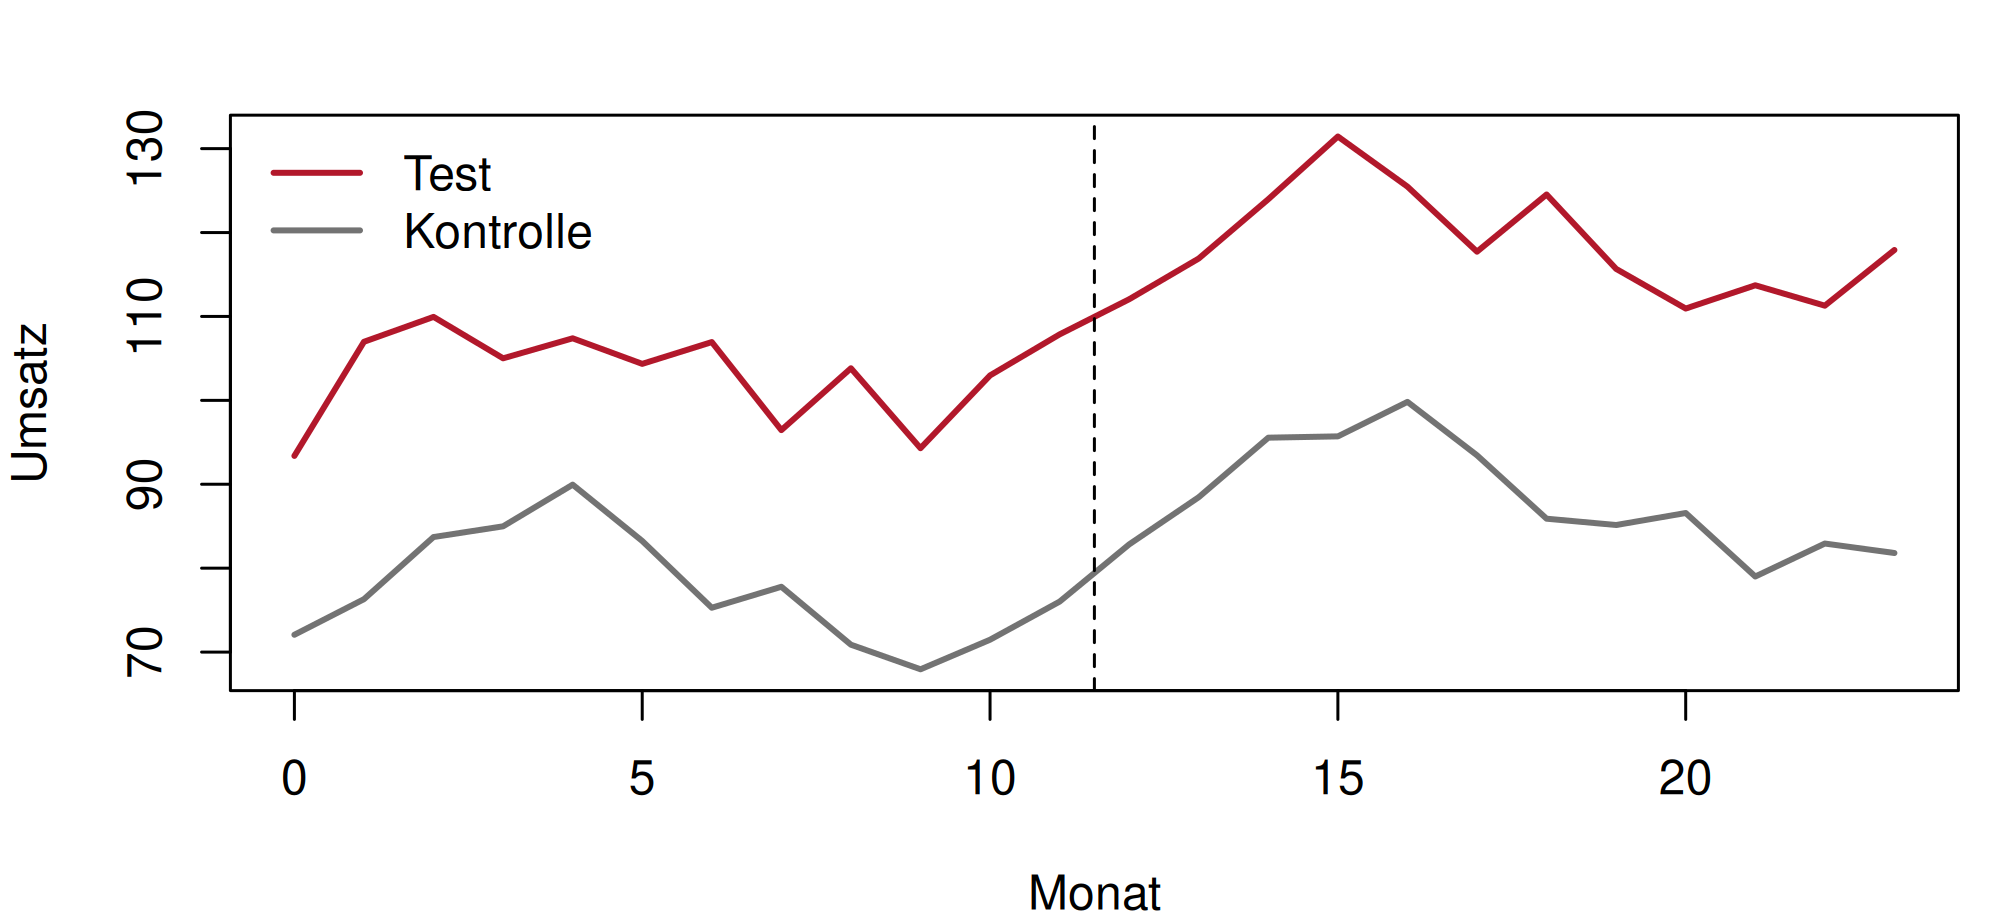
  • Kein Kausalsatz ohne Grundlage. “Die Kampagne hat den Umsatz gesteigert” braucht mehr als zwei Kurven, die gleichzeitig steigen, Beispiel 2.
  • Keine Sicherheit vortäuschen. Wo Unsicherheit besteht, gehört sie in die Grafik: Konfidenzband, Fehlerbalken oder wenigstens ein Satz, Beispiel 5.
  • Kein Ausschnitt ohne Begründung. Der gewählte Zeitraum darf nicht die Aussage tragen, siehe irreführende Darstellungen.

Was am Ende dasteht

Eine brauchbare Abgabe beantwortet vier Fragen, und zwar sichtbar in der Grafik oder unmittelbar daneben:

  1. Worum geht es (Titel mit Aussage)
  2. Woran ist das zu sehen (Betonung, Annotation)
  3. Wie sicher ist es (Unsicherheit, Stichprobenumfang, Zeitraum)
  4. Was folgt daraus (Empfehlung oder offene Frage)

Beispiele

Frage und Datenlage

Acht Serien, eine davon ist die Aussage. Einmal alle in kräftigen Farben, einmal sieben grau und eine rot. Gemessen wird das visuelle Gewicht jeder Serie: Pfadlänge mal Linienstärke mal Kontrast zum Hintergrund.

Rechnung

Z <- normalmatrix(5151, 8, 24)
zeit <- 0:23
niveau <- seq(40, 110, length.out = 8)
reihen <- niveau + Z * 5
ziel <- 4                                  # die Serie, um die es geht
reihen[ziel, ] <- reihen[ziel, ] + seq(0, 25, length.out = 24)

bunt <- c("#1f77b4", "#ff7f0e", "#2ca02c", "#d62728",
          "#9467bd", "#8c564b", "#e377c2", "#17becf")
mit_akzent <- rep(neutral, 8); mit_akzent[ziel] <- akzent
dicke_bunt <- rep(1.5, 8)
dicke_akzent <- rep(1.0, 8); dicke_akzent[ziel] <- 2.5

pfadlaenge <- function(y) {
  dx <- diff(zeit) / (max(zeit) - min(zeit))
  dy <- diff(y) / (max(reihen) - min(reihen))
  sum(sqrt(dx^2 + dy^2))
}

gewichte <- function(pal, dicke) {
  sapply(1:8, function(i) pfadlaenge(reihen[i, ]) * dicke[i] *
           kontrast(pal[i], "#FFFFFF"))
}

for (nm in c("alles bunt", "ein Akzent")) {
  g <- if (nm == "alles bunt") gewichte(bunt, dicke_bunt) else
    gewichte(mit_akzent, dicke_akzent)
  cat(sprintf("%-12s Zielserie %6.2f, Mittel der übrigen %5.2f, Verhältnis %5.2f\n",
              nm, g[ziel], mean(g[-ziel]), g[ziel] / mean(g[-ziel])))
}
alles bunt   Zielserie  14.66, Mittel der übrigen 10.12, Verhältnis  1.45
ein Akzent   Zielserie  33.40, Mittel der übrigen  3.13, Verhältnis 10.66
round(c(pfadlaenge_ziel = pfadlaenge(reihen[ziel, ]),
        pfadlaenge_uebrige = mean(sapply((1:8)[-ziel],
                                         function(i) pfadlaenge(reihen[i, ])))), 3)
   pfadlaenge_ziel pfadlaenge_uebrige 
             1.946              1.854 
par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))
matplot(zeit, t(reihen), type = "l", lty = 1, lwd = dicke_bunt, col = bunt,
        xlab = "Monat", ylab = "Wert", main = "alles bunt")
matplot(zeit, t(reihen), type = "l", lty = 1, lwd = dicke_akzent,
        col = mit_akzent, xlab = "Monat", ylab = "Wert", main = "ein Akzent")
par(mfrow = c(1, 1))
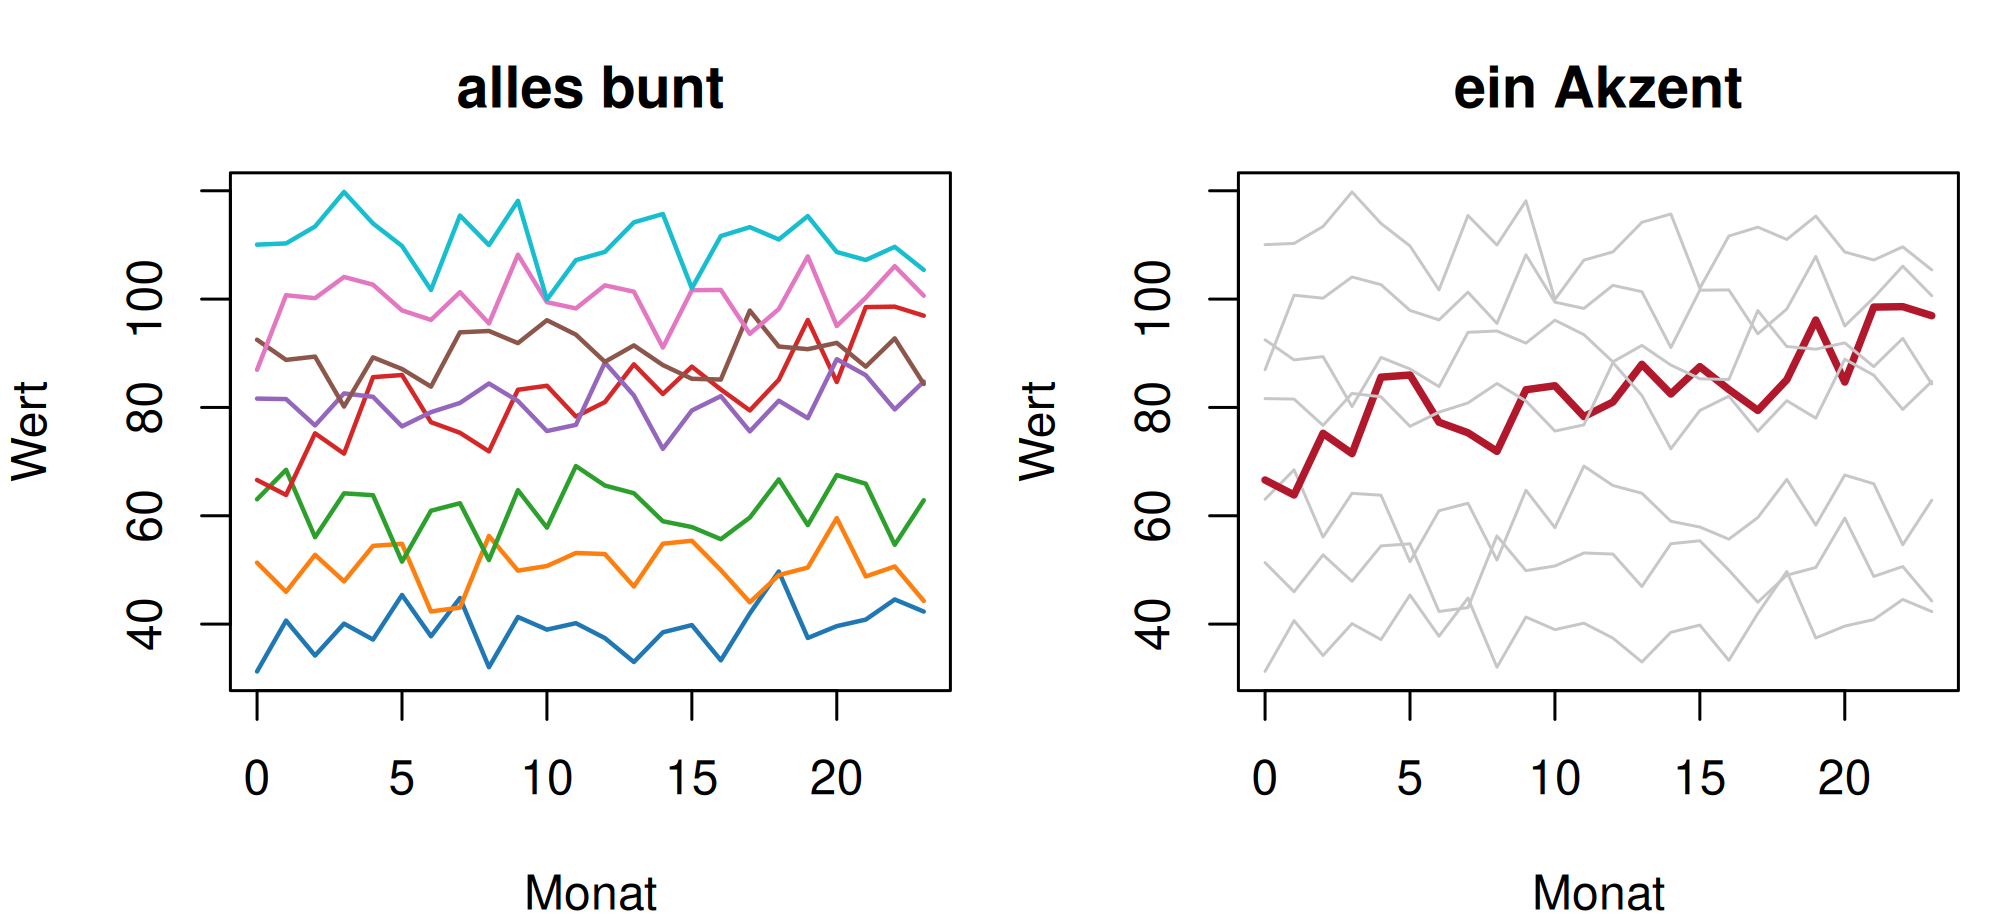
Abbildung 1: Beispiel 1: links alles bunt, rechts ein Akzent.
Z = normalmatrix(5151, 8, 24)
zeit = np.arange(24)
niveau = np.linspace(40, 110, 8)
reihen = niveau[:, None] + Z * 5
ziel = 3
reihen[ziel] = reihen[ziel] + np.linspace(0, 25, 24)

bunt = ["#1f77b4", "#ff7f0e", "#2ca02c", "#d62728",
        "#9467bd", "#8c564b", "#e377c2", "#17becf"]
mit_akzent = [NEUTRAL] * 8
mit_akzent[ziel] = AKZENT
dicke_bunt = [1.5] * 8
dicke_akzent = [1.0] * 8
dicke_akzent[ziel] = 2.5


def pfadlaenge(y):
    dx = np.diff(zeit) / (zeit.max() - zeit.min())
    dy = np.diff(y) / (reihen.max() - reihen.min())
    return float(np.sum(np.sqrt(dx ** 2 + dy ** 2)))


def gewichte(pal, dicke):
    return np.array([pfadlaenge(reihen[i]) * dicke[i] * kontrast(pal[i], "#FFFFFF")
                     for i in range(8)])


for nm, pal, dicke in [("alles bunt", bunt, dicke_bunt),
                       ("ein Akzent", mit_akzent, dicke_akzent)]:
    g = gewichte(pal, dicke)
    rest = np.delete(g, ziel)
    print(f"{nm:<12} Zielserie {g[ziel]:6.2f}, Mittel der übrigen {rest.mean():5.2f},"
          f" Verhältnis {g[ziel] / rest.mean():5.2f}")
alles bunt   Zielserie  14.66, Mittel der übrigen 10.12, Verhältnis  1.45
ein Akzent   Zielserie  33.40, Mittel der übrigen  3.13, Verhältnis 10.66
print({"pfadlaenge_ziel": round(pfadlaenge(reihen[ziel]), 3),
       "pfadlaenge_uebrige":
           round(float(np.mean([pfadlaenge(reihen[i])
                                for i in range(8) if i != ziel])), 3)})
{'pfadlaenge_ziel': 1.946, 'pfadlaenge_uebrige': 1.854}
fig, achsen = plt.subplots(1, 2, figsize=(7, 3.2))
for achse, (titel, pal, dicke) in zip(achsen,
                                      [("alles bunt", bunt, dicke_bunt),
                                       ("ein Akzent", mit_akzent, dicke_akzent)]):
    for i in range(8):
        _ = achse.plot(zeit, reihen[i], lw=dicke[i], color=pal[i])
    _ = achse.set_title(titel)
    _ = achse.set_xlabel("Monat")
    _ = achse.set_ylabel("Wert")
plt.tight_layout()
plt.show()
Abbildung 2: Beispiel 1: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

Fassung Gewicht der Zielserie Mittel der übrigen Verhältnis
alles bunt 14.66 10.12 1.45
ein Akzent 33.40 3.13 10.66

Pfadlänge der Zielserie 1.946, Mittel der übrigen 1.854.

Beobachtung Erklärung
Die Zielserie hat schon von sich aus etwas mehr Gewicht Verhältnis 1.45 in der bunten Fassung. Sie steigt, ist also länger, 1.946 gegen 1.854. Die Daten helfen ein wenig mit.
Mit einem Akzent steigt das Verhältnis auf 10.66 Also mehr als das Siebenfache. Und der grössere Teil davon kommt vom Zurücknehmen, nicht vom Hervorheben: Das Mittel der übrigen fällt von 10.12 auf 3.13.
Die Zielserie selbst gewinnt Faktor 2.3 33.40 gegen 14.66, durch Farbe und Linienstärke. Die übrigen verlieren Faktor 3.2. Beide Richtungen zusammen ergeben den Gesamteffekt.
Die Rechnung ist ein Modell, keine Messung des Blicks Pfadlänge mal Stärke mal Kontrast ist eine grobe Näherung für “wie viel Tinte fällt auf”. Sie genügt, um zwei Entwürfe zu vergleichen.
Acht kräftige Farben verteilen die Aufmerksamkeit gleichmässig Und gleichmässig verteilte Aufmerksamkeit ist genau das Gegenteil einer Aussage.

Die Reihenfolge beim Gestalten folgt daraus: zuerst alles zurücknehmen, dann genau eine Sache hervorheben. Wer umgekehrt anfängt, landet bei einer Grafik, in der drei Dinge wichtig aussehen.

Schritt Wirkung im Beispiel
alles grau Mittel der übrigen 10.12 → 3.13
Zielserie färben und verdicken Zielserie 14.66 → 33.40
zusammen Verhältnis 1.45 → 10.66

Interpretation und Ergebnissatz

In der bunten Fassung hat die Zielserie das 1.45-Fache des mittleren visuellen Gewichts der übrigen, mit einem Akzent das 10.66-Fache. Zwei Drittel dieses Gewinns entstehen dadurch, dass die anderen Serien zurückgenommen werden, nicht dadurch, dass die Zielserie hervorgehoben wird.

Frage und Datenlage

Eine Kampagne läuft ab Monat 12 in der Testregion. Der Umsatz steigt danach um 14.7 Prozent. Die Frage ist, was davon der Kampagne zuzuschreiben ist und dafür braucht es die Kontrollregion, in der nichts passiert ist.

Rechnung

Z <- normalmatrix(6262, 2, 24)
monat <- 0:23
saison <- 8 * sin(2 * pi * monat / 12)
test <- 100 + 1.0 * monat + saison + Z[1, ] * 4
kontrolle <- 70 + 1.0 * monat + saison + Z[2, ] * 4

vor <- 1:12; nach <- 13:24
for (nm in c("test", "kontrolle")) {
  x <- get(nm)
  cat(sprintf("%-10s vorher %7.2f  nachher %7.2f  Zuwachs %+7.2f  relativ %+6.1f Prozent\n",
              nm, mean(x[vor]), mean(x[nach]), mean(x[nach]) - mean(x[vor]),
              100 * (mean(x[nach]) / mean(x[vor]) - 1)))
}
test       vorher  103.28  nachher  118.47  Zuwachs  +15.18  relativ  +14.7 Prozent
kontrolle  vorher   77.47  nachher   88.10  Zuwachs  +10.63  relativ  +13.7 Prozent
dd <- (mean(test[nach]) - mean(test[vor])) -
  (mean(kontrolle[nach]) - mean(kontrolle[vor]))
round(c(differenz_von_differenzen = dd,
        korrelation = cor(test, kontrolle)), 4)
differenz_von_differenzen               korrelation 
                   4.5559                    0.8109 
# Derselbe Effekt als Modell, mit Standardfehler
lang <- data.frame(
  wert = c(test, kontrolle),
  ist_test = rep(c(1, 0), each = 24),
  ist_nach = rep(c(rep(0, 12), rep(1, 12)), 2))
modell <- lm(wert ~ ist_test * ist_nach, data = lang)
round(summary(modell)$coefficients["ist_test:ist_nach", ], 4)
  Estimate Std. Error    t value   Pr(>|t|) 
    4.5559     3.6632     1.2437     0.2202 
par(mar = c(4, 4, 2, 1))
matplot(monat, cbind(test, kontrolle), type = "l", lty = 1, lwd = 2,
        col = c(akzent, "grey45"), xlab = "Monat", ylab = "Umsatz")
abline(v = 11.5, lty = 2)
legend("topleft", c("Test", "Kontrolle"), col = c(akzent, "grey45"),
       lty = 1, lwd = 2, bty = "n")
Abbildung 3: Beispiel 2: Testregion und Kontrollregion, Kampagnenstart in Monat 12.
Z = normalmatrix(6262, 2, 24)
monat = np.arange(24)
saison = 8 * np.sin(2 * np.pi * monat / 12)
test = 100 + 1.0 * monat + saison + Z[0] * 4
kontrolle = 70 + 1.0 * monat + saison + Z[1] * 4

vor, nach = slice(0, 12), slice(12, 24)
for nm, x in [("test", test), ("kontrolle", kontrolle)]:
    print(f"{nm:<10} vorher {x[vor].mean():7.2f}  nachher {x[nach].mean():7.2f}"
          f"  Zuwachs {x[nach].mean() - x[vor].mean():+7.2f}"
          f"  relativ {100 * (x[nach].mean() / x[vor].mean() - 1):+6.1f} Prozent")

dd = ((test[nach].mean() - test[vor].mean())
      - (kontrolle[nach].mean() - kontrolle[vor].mean()))
print({"differenz_von_differenzen": round(float(dd), 4),
       "korrelation": round(float(np.corrcoef(test, kontrolle)[0, 1]), 4)})

y = np.concatenate([test, kontrolle])
ist_test = np.concatenate([np.ones(24), np.zeros(24)])
ist_nach = np.tile(np.concatenate([np.zeros(12), np.ones(12)]), 2)
X = np.column_stack([np.ones(48), ist_test, ist_nach, ist_test * ist_nach])
b = np.linalg.lstsq(X, y, rcond=None)[0]
rest = y - X @ b
s2 = (rest ** 2).sum() / (48 - 4)
se = np.sqrt(s2 * np.linalg.inv(X.T @ X)[3, 3])
print({"schaetzwert": round(float(b[3]), 4), "standardfehler": round(float(se), 4),
       "t": round(float(b[3] / se), 4),
       "p": round(float(2 * stats.t.sf(abs(b[3] / se), 44)), 4)})

fig, achse = plt.subplots(figsize=(7, 3.2))
_ = achse.plot(monat, test, lw=2, color=AKZENT, label="Test")
_ = achse.plot(monat, kontrolle, lw=2, color="0.45", label="Kontrolle")
_ = achse.axvline(11.5, ls="--", color="black")
_ = achse.legend(frameon=False, loc="upper left")
_ = achse.set_xlabel("Monat")
_ = achse.set_ylabel("Umsatz")
plt.tight_layout()
plt.show()
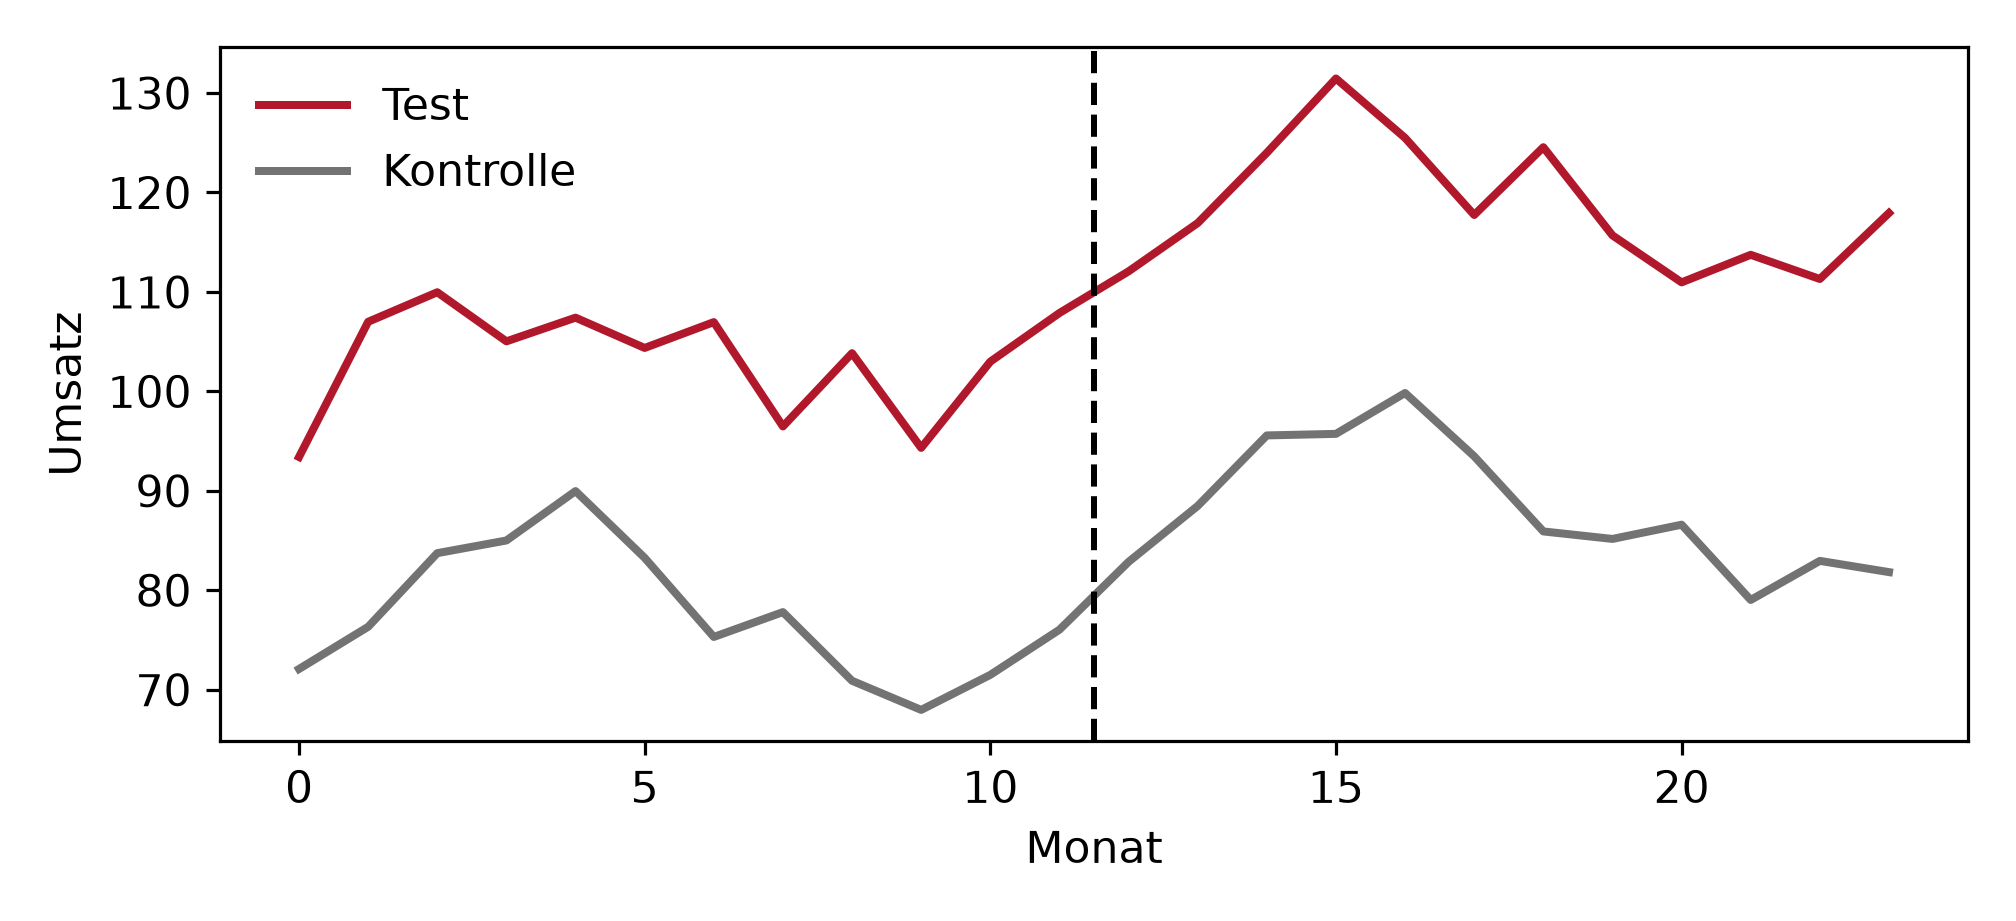
Abbildung 4: Beispiel 2: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

Region vorher nachher Zuwachs relativ
Test 103.28 118.47 +15.18 +14.7 %
Kontrolle 77.47 88.10 +10.63 +13.7 %
Kennzahl Wert
Differenz von Differenzen +4.56
Standardfehler 3.663
t 1.244
p 0.2202
Korrelation Test / Kontrolle 0.8109
Beobachtung Erklärung
Die Testregion wächst um 14.7 Prozent Zeigt man nur diese Kurve, ist die Geschichte fertig: “Die Kampagne wirkt.”
Die Kontrollregion wächst um 13.7 Prozent Ohne Kampagne. Der grösste Teil des Zuwachses hat also nichts mit der Massnahme zu tun, sondern mit Trend und Saison.
Es bleibt eine Differenz von +4.56 Das ist die einzige Zahl, die überhaupt der Kampagne zugeschrieben werden könnte, nicht +15.18.
Und selbst die ist nicht belegt Standardfehler 3.663, t = 1.24, p = 0.22. Bei 48 Beobachtungen reicht das nicht.
Die beiden Regionen korrelieren mit 0.81 Genau deshalb taugt die Kontrollregion als Vergleich: Sie macht Trend und Saison mit, nur die Kampagne nicht.

Die Titel, die hier möglich sind:

Titel zulässig?
“Die Kampagne steigert den Umsatz um 15 Prozent” nein, der Vergleich fehlt
“Die Kampagne steigert den Umsatz um 4.6 Punkte” nein, der Effekt ist nicht belegt
“Umsatz nach der Kampagne um 15 Prozent höher” zulässig, aber irreführend ohne die Kontrollkurve
Kein nachweisbarer Kampagneneffekt: Die Vergleichsregion wächst gleich stark ja

Der letzte Titel ist der unbequemste und der einzige, der hält. Er ist auch der nützlichere: Er verhindert, dass die Kampagne aufgrund eines Scheineffekts wiederholt wird.

Interpretation und Ergebnissatz

Die Testregion wächst nach der Kampagne um 14.7 Prozent, die Kontrollregion ohne Kampagne um 13.7 Prozent. Die Differenz von Differenzen beträgt +4.56 mit einem Standardfehler von 3.66 (t = 1.24, p = 0.22) und ist damit nicht belegt.

Frage und Datenlage

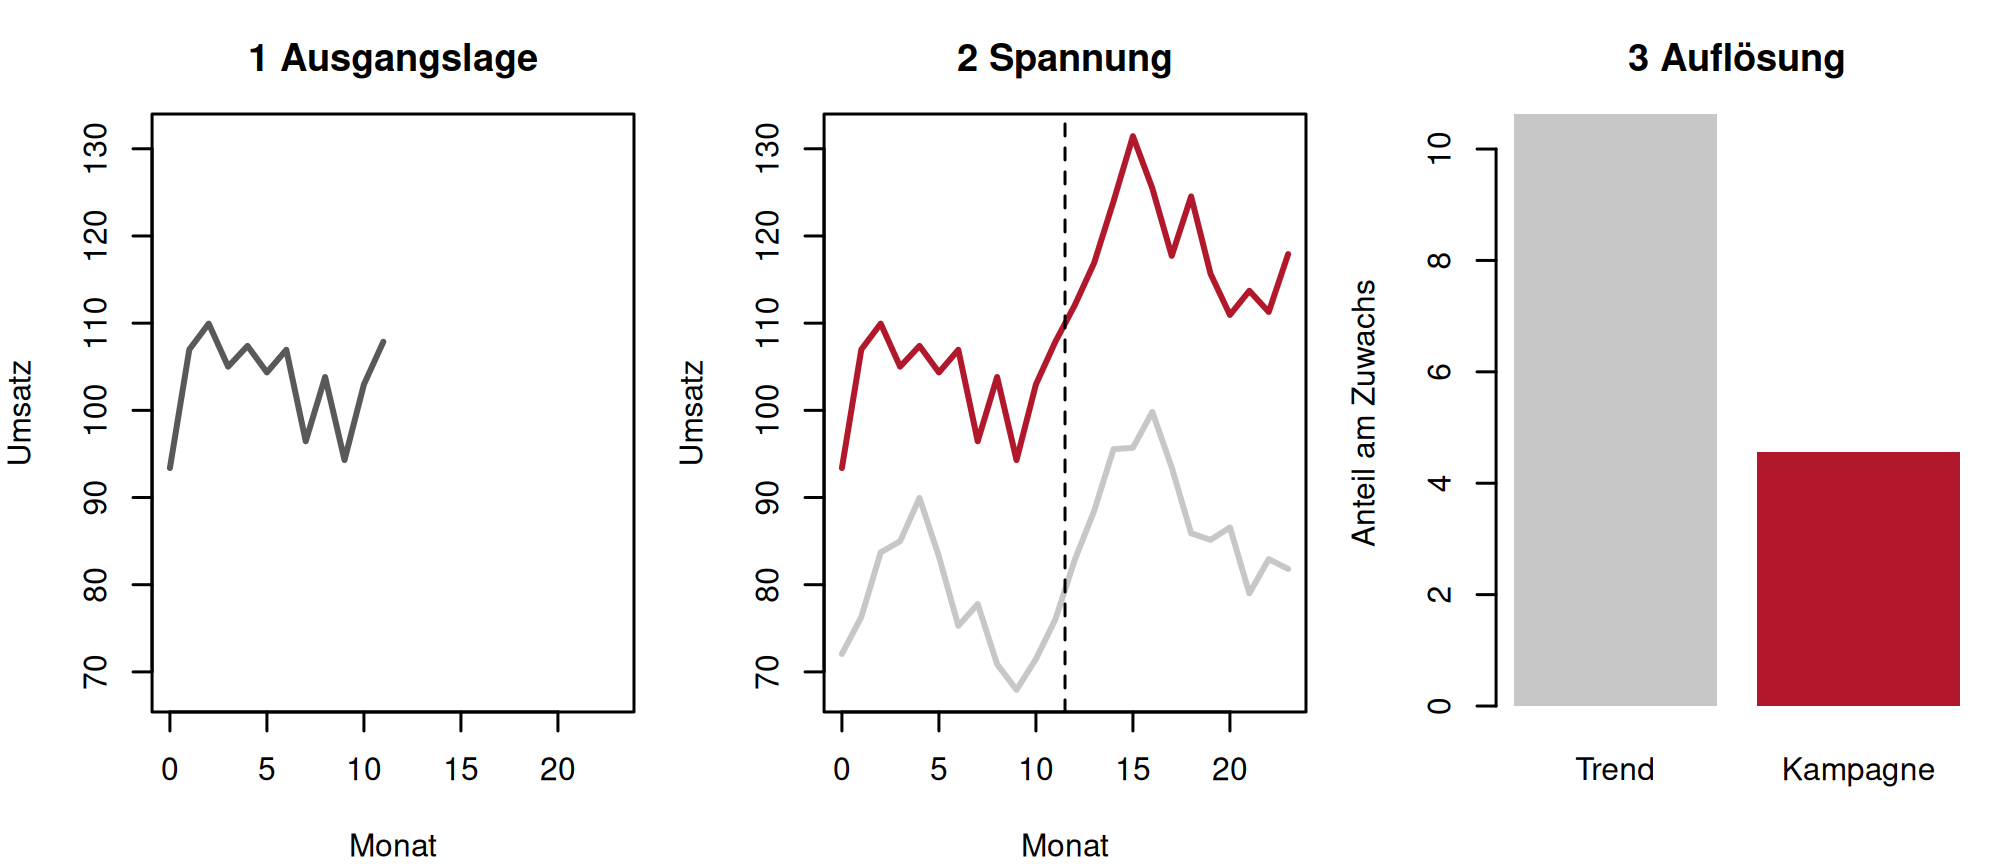
Dieselben Kampagnendaten, aber als Folge von drei Grafiken erzählt. Jede beantwortet genau eine Frage, und jede hat ihre eigene Kennzahl.

Rechnung

schritt <- data.frame(
  schritt = c("1 Ausgangslage", "2 Spannung", "3 Auflösung"),
  frage = c("Wie lief es bisher?",
            "Was ist nach der Kampagne passiert?",
            "Was folgt daraus?"),
  kennzahl = c(mean(test[vor]),
               mean(test[nach]) - mean(test[vor]),
               dd),
  einheit = c("Umsatz im Mittel", "Zuwachs", "davon der Kampagne zuschreibbar"))
schritt$kennzahl <- round(schritt$kennzahl, 2)
schritt
         schritt                               frage kennzahl
1 1 Ausgangslage                 Wie lief es bisher?   103.28
2     2 Spannung Was ist nach der Kampagne passiert?    15.18
3    3 Auflösung                   Was folgt daraus?     4.56
                          einheit
1                Umsatz im Mittel
2                         Zuwachs
3 davon der Kampagne zuschreibbar
round(c(anteil_der_dem_trend_zuzuschreiben_ist =
          (1 - dd / (mean(test[nach]) - mean(test[vor]))) * 100), 1)
anteil_der_dem_trend_zuzuschreiben_ist 
                                    70 
par(mfrow = c(1, 3), mar = c(4, 4, 3, 1))
plot(monat[vor], test[vor], type = "l", lwd = 2, col = "grey35",
     xlim = c(0, 23), ylim = range(c(test, kontrolle)),
     xlab = "Monat", ylab = "Umsatz", main = "1 Ausgangslage")
matplot(monat, cbind(test, kontrolle), type = "l", lty = 1, lwd = 2,
        col = c(akzent, neutral), xlab = "Monat", ylab = "Umsatz",
        main = "2 Spannung")
abline(v = 11.5, lty = 2)
barplot(c(Trend = mean(test[nach]) - mean(test[vor]) - dd, Kampagne = dd),
        col = c(neutral, akzent), border = NA, ylab = "Anteil am Zuwachs",
        main = "3 Auflösung")
par(mfrow = c(1, 1))
Abbildung 5: Beispiel 3: dieselbe Geschichte in drei Schritten.
schritt = pd.DataFrame({
    "schritt": ["1 Ausgangslage", "2 Spannung", "3 Auflösung"],
    "frage": ["Wie lief es bisher?",
              "Was ist nach der Kampagne passiert?",
              "Was folgt daraus?"],
    "kennzahl": [test[vor].mean(),
                 test[nach].mean() - test[vor].mean(),
                 dd],
    "einheit": ["Umsatz im Mittel", "Zuwachs",
                "davon der Kampagne zuschreibbar"]})
schritt["kennzahl"] = schritt["kennzahl"].round(2)
print(schritt.to_string(index=False))

zuwachs = test[nach].mean() - test[vor].mean()
print({"anteil_der_dem_trend_zuzuschreiben_ist":
       round(float((1 - dd / zuwachs) * 100), 1)})

fig, achsen = plt.subplots(1, 3, figsize=(7, 3))
_ = achsen[0].plot(monat[:12], test[:12], lw=2, color="0.35")
_ = achsen[0].set_xlim(0, 23)
_ = achsen[0].set_ylim(min(test.min(), kontrolle.min()),
                       max(test.max(), kontrolle.max()))
_ = achsen[0].set_title("1 Ausgangslage")
_ = achsen[1].plot(monat, test, lw=2, color=AKZENT)
_ = achsen[1].plot(monat, kontrolle, lw=2, color=NEUTRAL)
_ = achsen[1].axvline(11.5, ls="--", color="black")
_ = achsen[1].set_title("2 Spannung")
_ = achsen[2].bar(["Trend", "Kampagne"], [zuwachs - dd, dd],
                  color=[NEUTRAL, AKZENT])
_ = achsen[2].set_title("3 Auflösung")
_ = achsen[2].set_ylabel("Anteil am Zuwachs")
for achse in achsen[:2]:
    _ = achse.set_xlabel("Monat")
    _ = achse.set_ylabel("Umsatz")
plt.tight_layout()
plt.show()
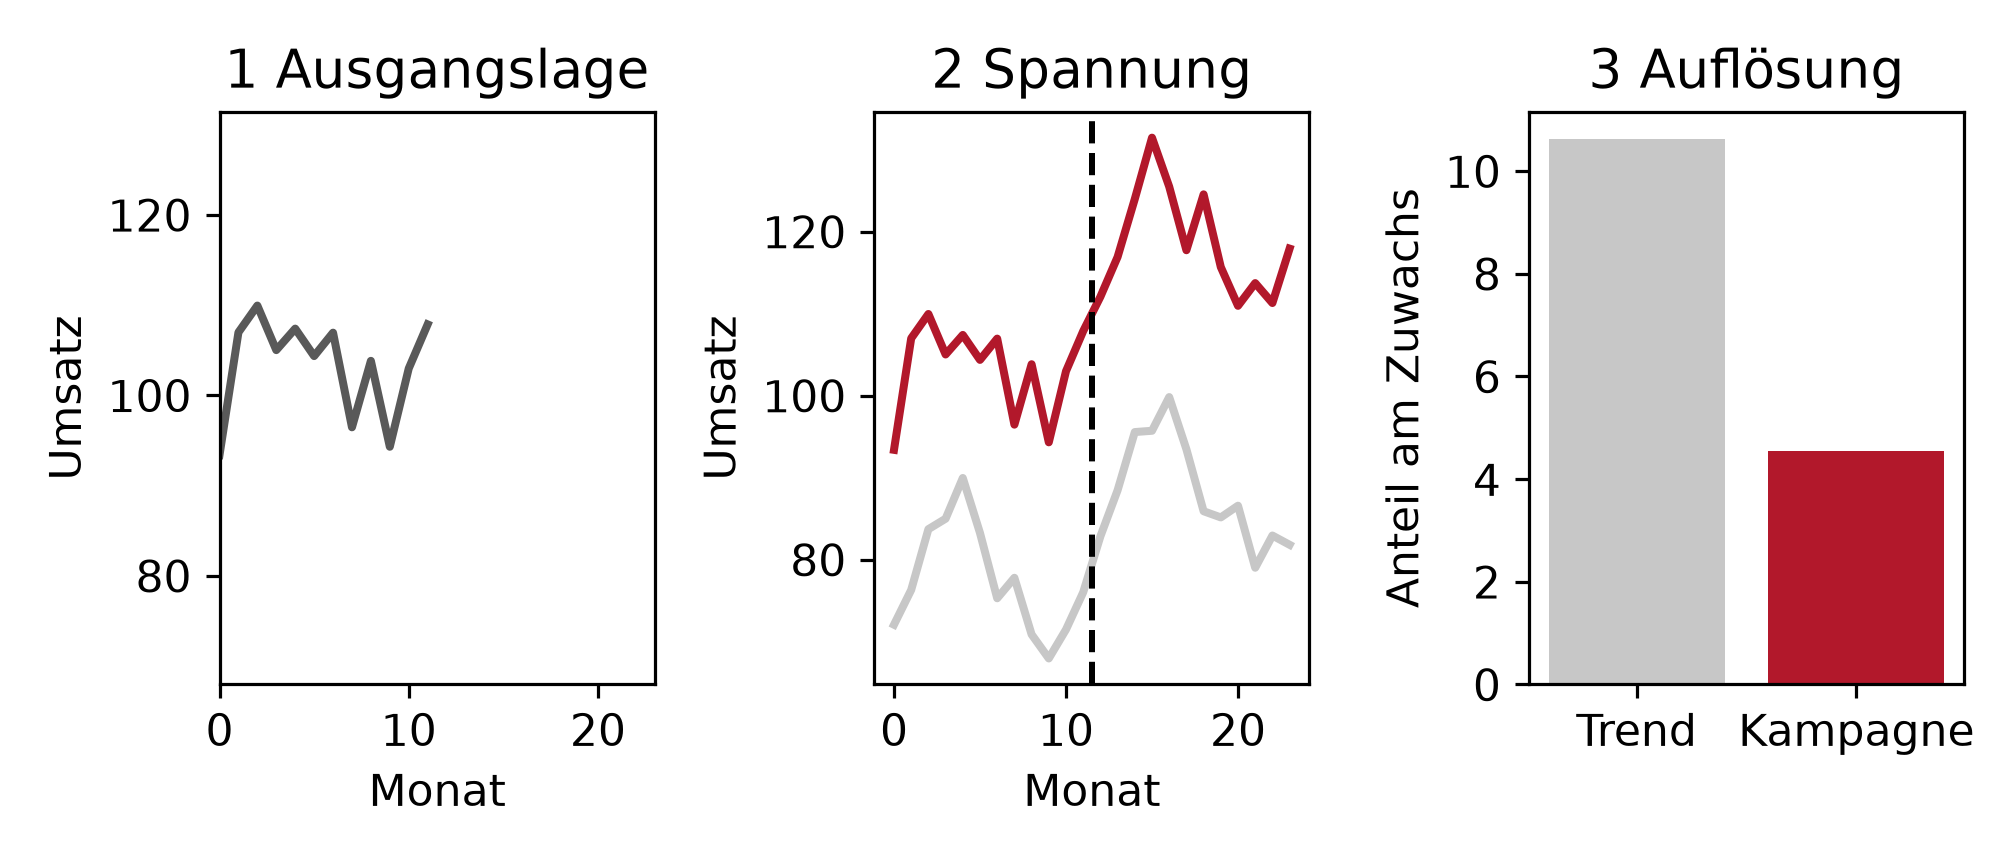
Abbildung 6: Beispiel 3: dieselben drei Schritte in Python.

Output Zeile für Zeile

Schritt Frage Kennzahl Einheit
1 Ausgangslage Wie lief es bisher? 103.28 Umsatz im Mittel
2 Spannung Was ist nach der Kampagne passiert? +15.18 Zuwachs
3 Auflösung Was folgt daraus? +4.56 davon der Kampagne zuschreibbar

Dem allgemeinen Trend zuzuschreiben: 70.0 Prozent des Zuwachses.

Beobachtung Erklärung
Jeder Schritt hat genau eine Zahl 103.28, dann +15.18, dann +4.56. Wer eine Folge baut, prüft daran, ob die Schritte wirklich verschiedene Aussagen tragen.
Der erste Schritt ist absichtlich langweilig Nur die Testregion vor der Kampagne. Er stellt den gemeinsamen Boden her, damit der zweite überhaupt als Überraschung wirken kann.
Der zweite bringt die Kontrollkurve ins Bild Das ist der Moment der Spannung: Die zweite Kurve macht dieselbe Bewegung mit.
Der dritte zerlegt den Zuwachs 70 Prozent Trend, 30 Prozent möglicher Kampagneneffekt und der ist statistisch nicht belegt.
Die Reihenfolge lässt sich nicht umstellen Der dritte Schritt ist ohne den zweiten unverständlich, der zweite ohne den ersten wirkungslos. Das unterscheidet eine Folge von drei Einzelgrafiken.

Wenn nur eine Grafik zur Verfügung steht, wandert dieselbe Struktur in die Textelemente:

Teil der Geschichte Ort in der Grafik
Ausgangslage Achsenbereich und Zeitraum, der den Vorher-Zustand mitzeigt
Spannung die Betonung, Farbe, Strichstärke, Annotation
Auflösung der Titel, der die Zahl nennt

Konkret hier: Titel “70 Prozent des Zuwachses gehen auf den allgemeinen Trend”, beide Kurven gezeigt, die Kampagnenlinie markiert.

Interpretation und Ergebnissatz

Die Geschichte zerfällt in drei Schritte mit je einer Kennzahl: ein Ausgangsniveau von 103.28, ein Zuwachs von +15.18 und ein davon der Kampagne zuschreibbarer Anteil von +4.56. Damit gehen 70.0 Prozent des Zuwachses auf den allgemeinen Trend.

Frage und Datenlage

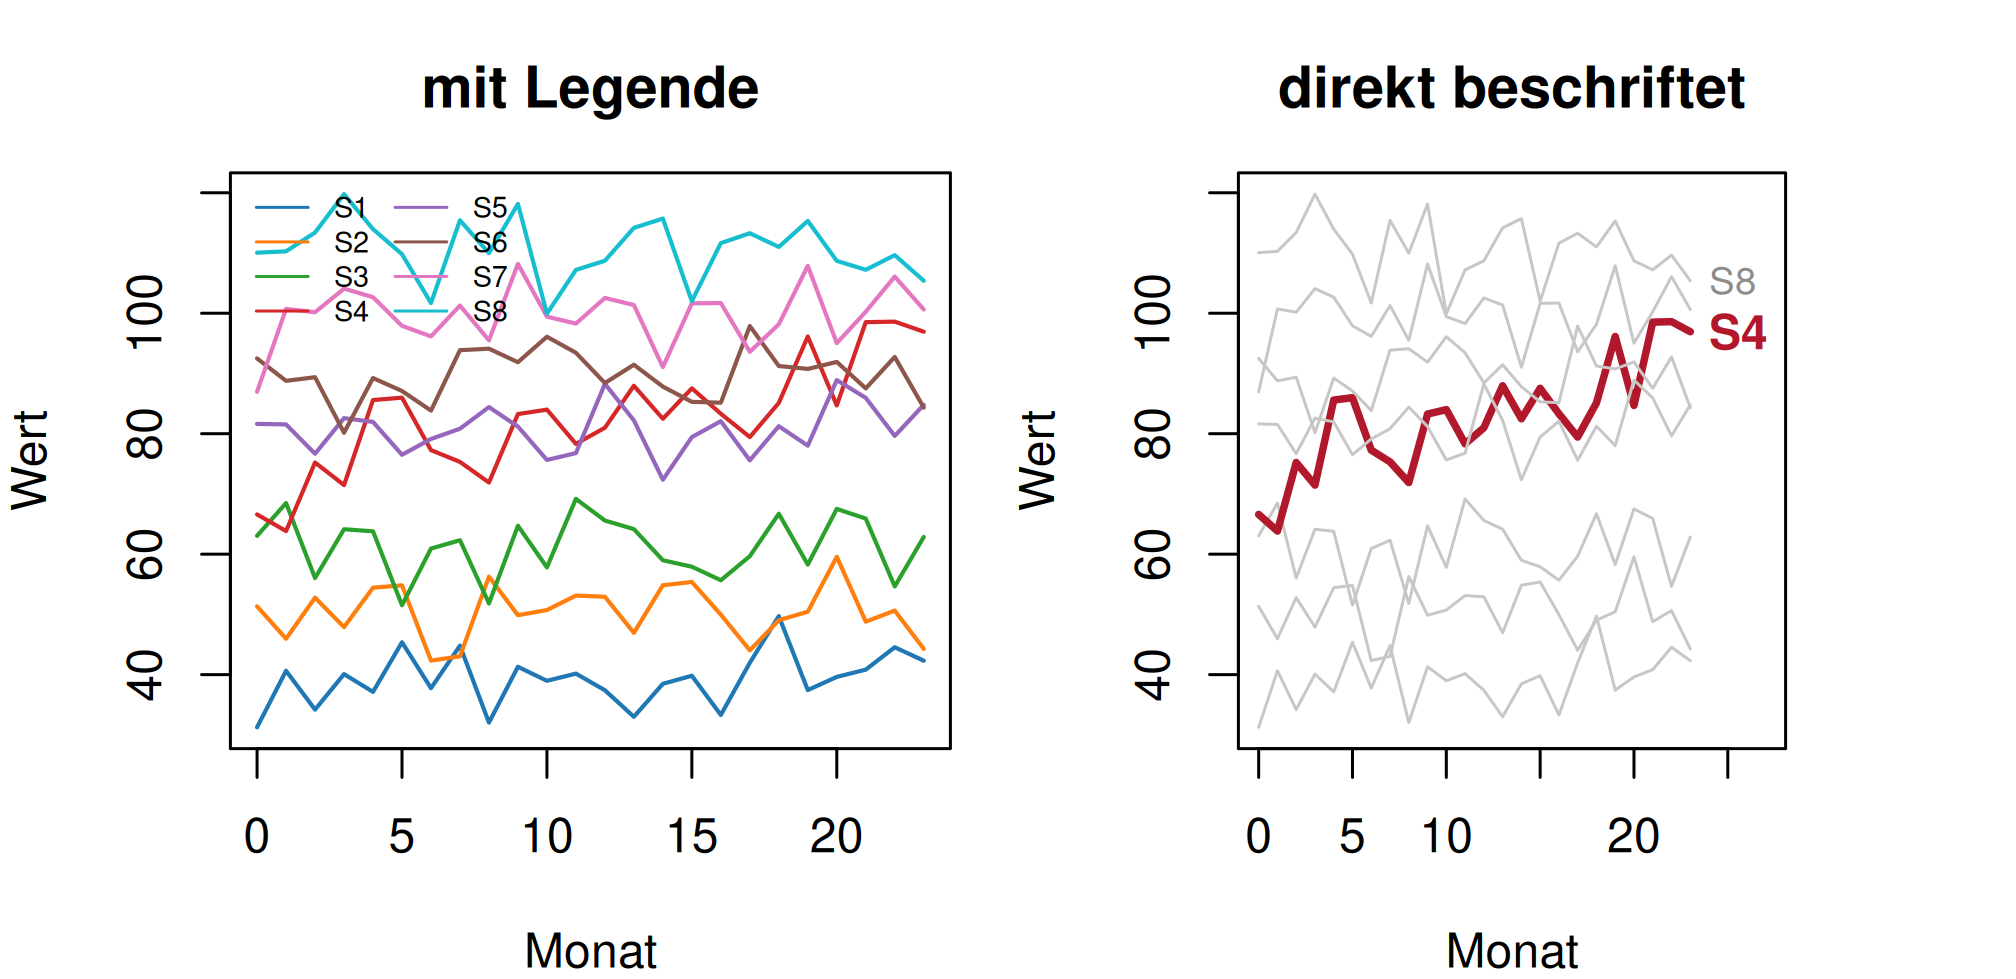
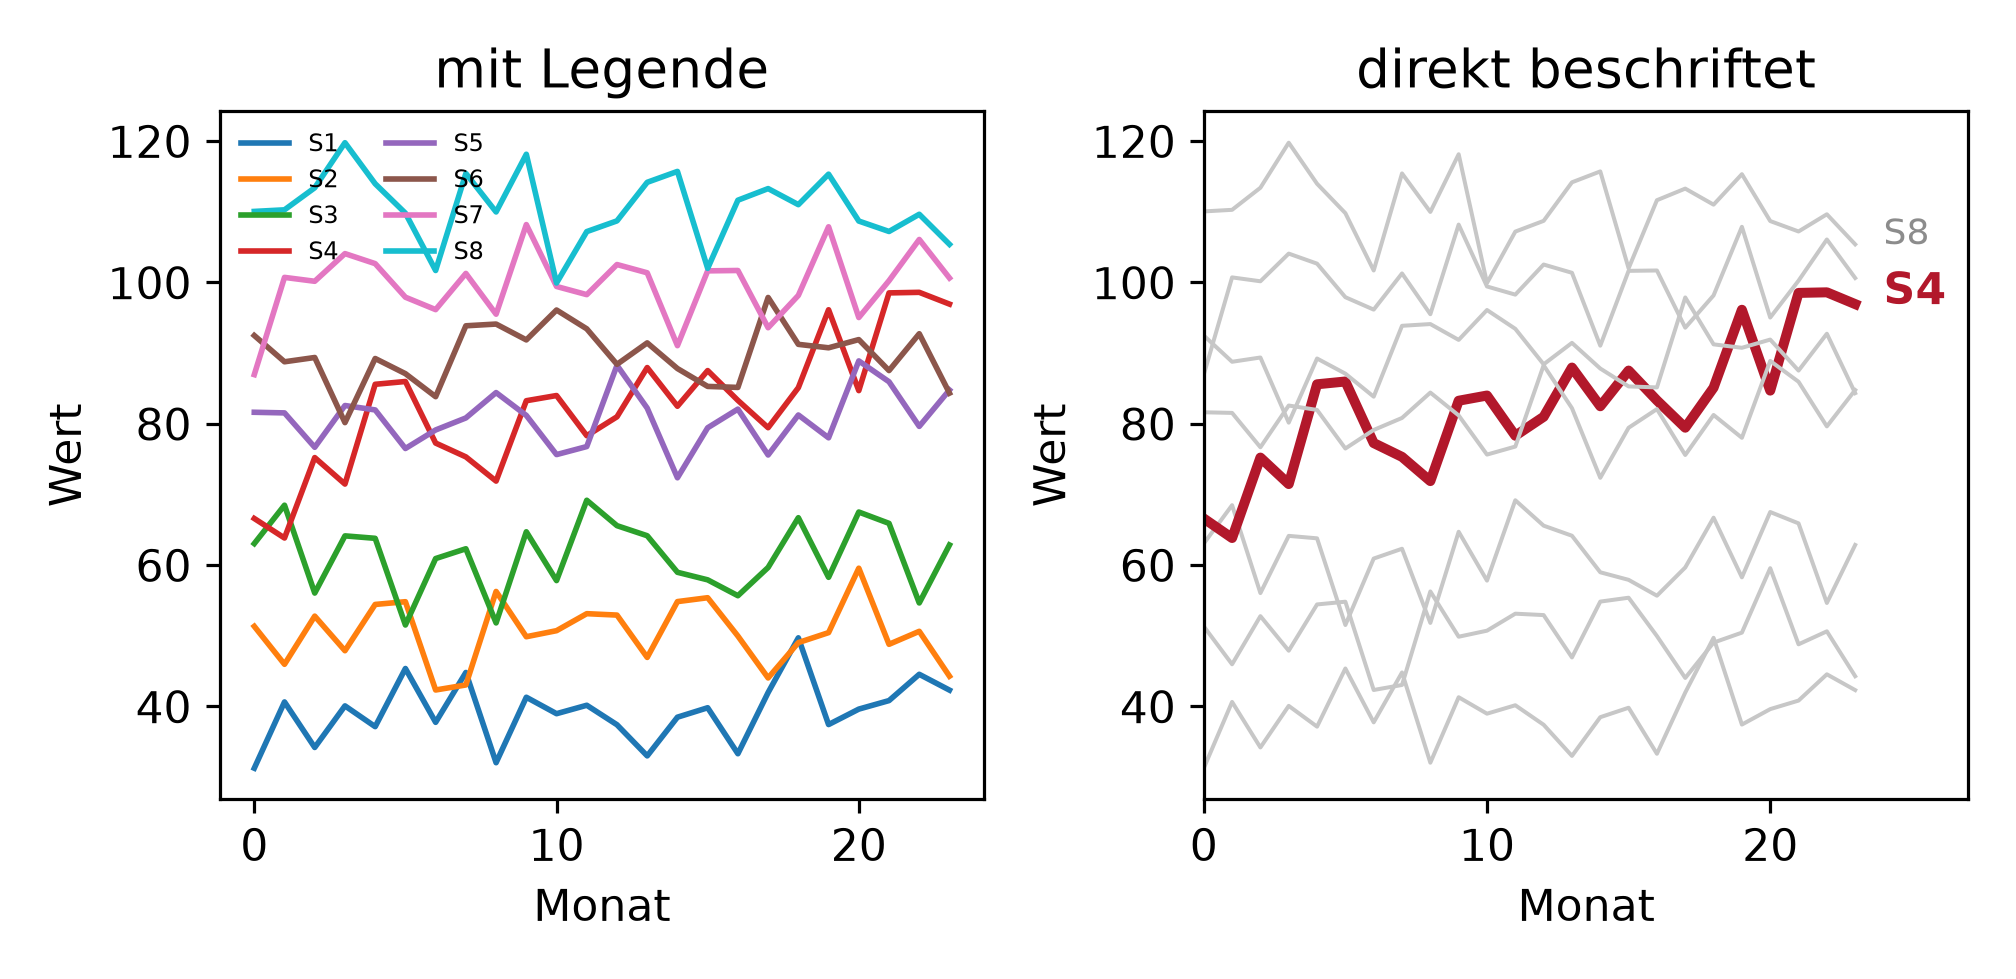
Acht Serien, einmal über eine Legende erschlossen und einmal direkt beschriftet. Gezählt wird, wie oft das Auge zwischen Grafik und Legende hin und her muss und wie weit der Weg ist.

Rechnung

n_serien <- 8
c(serien = n_serien,
  blickwechsel_mit_legende = 2 * n_serien,
  blickwechsel_direkt = 0)
                  serien blickwechsel_mit_legende      blickwechsel_direkt 
                       8                       16                        0 
# Wie weit ist der Weg? Legende rechts aussen, Serien ueber die Flaeche verteilt
endwerte <- reihen[, 24]
legendenposition <- 1.15                      # rechts neben der Zeichenflaeche
relativ_y <- (endwerte - min(reihen)) / (max(reihen) - min(reihen))
legenden_y <- seq(0.95, 0.55, length.out = n_serien)
weg <- sqrt((legendenposition - 1)^2 + (legenden_y - relativ_y)^2)
round(c(mittlerer_weg = mean(weg), laengster_weg = max(weg),
        summe_hin_und_zurueck = 2 * sum(weg)), 3)
        mittlerer_weg         laengster_weg summe_hin_und_zurueck 
                0.396                 0.839                 6.330 
par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))
matplot(zeit, t(reihen), type = "l", lty = 1, lwd = 1.4, col = bunt,
        xlab = "Monat", ylab = "Wert", main = "mit Legende")
legend("topleft", legend = paste0("S", 1:8), col = bunt, lty = 1, cex = 0.6,
       bty = "n", ncol = 2)

par(mar = c(4, 4, 3, 4))
matplot(zeit, t(reihen), type = "l", lty = 1, lwd = dicke_akzent,
        col = mit_akzent, xlab = "Monat", ylab = "Wert",
        main = "direkt beschriftet", xlim = c(0, 27))
text(24, reihen[ziel, 24], paste0("S", ziel), col = akzent, adj = 0, font = 2)
text(24, reihen[8, 24], "S8", col = "grey55", adj = 0, cex = 0.8)
par(mfrow = c(1, 1))
Abbildung 7: Beispiel 4: links mit Legende, rechts direkt beschriftet.
n_serien = 8
print({"serien": n_serien, "blickwechsel_mit_legende": 2 * n_serien,
       "blickwechsel_direkt": 0})

endwerte = reihen[:, -1]
legendenposition = 1.15
relativ_y = (endwerte - reihen.min()) / (reihen.max() - reihen.min())
legenden_y = np.linspace(0.95, 0.55, n_serien)
weg = np.sqrt((legendenposition - 1) ** 2 + (legenden_y - relativ_y) ** 2)
print({"mittlerer_weg": round(float(weg.mean()), 3),
       "laengster_weg": round(float(weg.max()), 3),
       "summe_hin_und_zurueck": round(float(2 * weg.sum()), 3)})

fig, achsen = plt.subplots(1, 2, figsize=(7, 3.4))
for i in range(8):
    _ = achsen[0].plot(zeit, reihen[i], lw=1.4, color=bunt[i], label=f"S{i + 1}")
_ = achsen[0].legend(fontsize=6, ncol=2, frameon=False, loc="upper left")
_ = achsen[0].set_title("mit Legende")
for i in range(8):
    _ = achsen[1].plot(zeit, reihen[i], lw=dicke_akzent[i], color=mit_akzent[i])
_ = achsen[1].set_xlim(0, 27)
_ = achsen[1].text(24, reihen[ziel, -1], f"S{ziel + 1}", color=AKZENT,
                   fontweight="bold")
_ = achsen[1].text(24, reihen[7, -1], "S8", color="0.55", fontsize=9)
_ = achsen[1].set_title("direkt beschriftet")
for achse in achsen:
    _ = achse.set_xlabel("Monat")
    _ = achse.set_ylabel("Wert")
plt.tight_layout()
plt.show()
Abbildung 8: Beispiel 4: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

Grösse mit Legende direkt beschriftet
Blickwechsel, um alle Serien zuzuordnen 16 0
mittlerer Weg je Zuordnung (Anteil der Bildbreite) 0.229
längster Weg 0.514
Weglänge insgesamt, hin und zurück 3.669
Beobachtung Erklärung
Acht Serien kosten 16 Blickwechsel Einmal hin zur Legende, einmal zurück, je Serie. Jeder davon ist eine Gelegenheit, die Spur zu verlieren.
Der längste Weg beträgt halbe Bildbreite Für die Serie, die am weitesten von ihrem Legendeneintrag entfernt verläuft. Die Zuordnung geschieht dabei über den Farbton, den ungenauesten Kanal.
Direkt beschriftet fallen alle Wege weg Der Name steht am Ende der Linie. Es gibt nichts zuzuordnen.
Die rechte Fassung beschriftet nur zwei Serien Die Zielserie und die oberste. Die übrigen brauchen keinen Namen, weil sie nur den Wertebereich zeigen. Weglassen ist hier Teil der Antwort.
Eine Legende bleibt sinnvoll, wenn Linien sich kreuzen Dann ist am Ende der Linie kein Platz. Meistens ist das ein Hinweis, dass zu viele Serien in einer Grafik sind, siehe Wahrnehmung, Beispiel 4.

Die Zahlen sind ein Modell, kein Blickmessgerät. Die Weglängen entstehen aus der Geometrie der Grafik und nicht aus einer Studie. Sie taugen zum Vergleich zweier Entwürfe, nicht als absolute Grösse.

Der robuste Teil der Aussage steht ohne Rechnung fest: Null Blickwechsel sind weniger als sechzehn.

Interpretation und Ergebnissatz

Acht Serien über eine Legende zu erschliessen kostet 16 Blickwechsel mit einem mittleren Weg von 0.229 Bildbreiten und einem längsten von 0.514. Bei direkter Beschriftung entfallen alle Wege; im Beispiel genügen zwei beschriftete Serien statt acht Legendeneinträge.

Frage und Datenlage

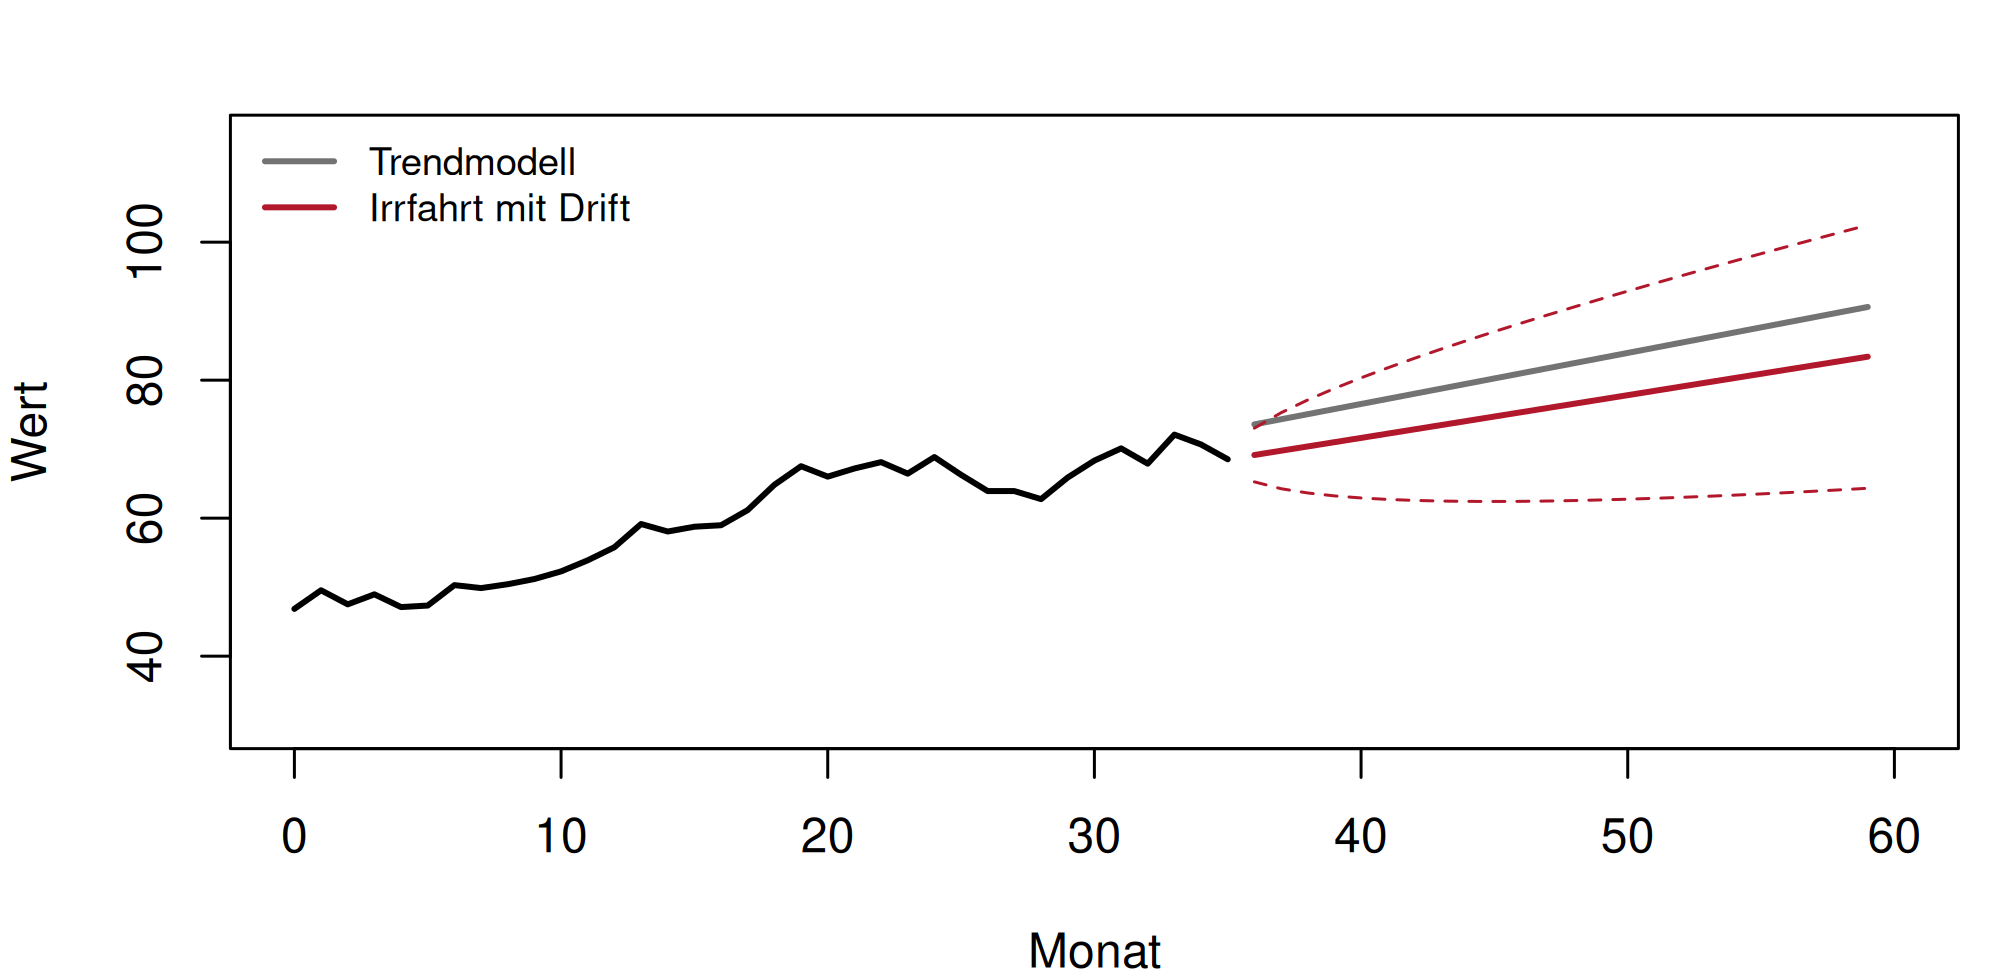
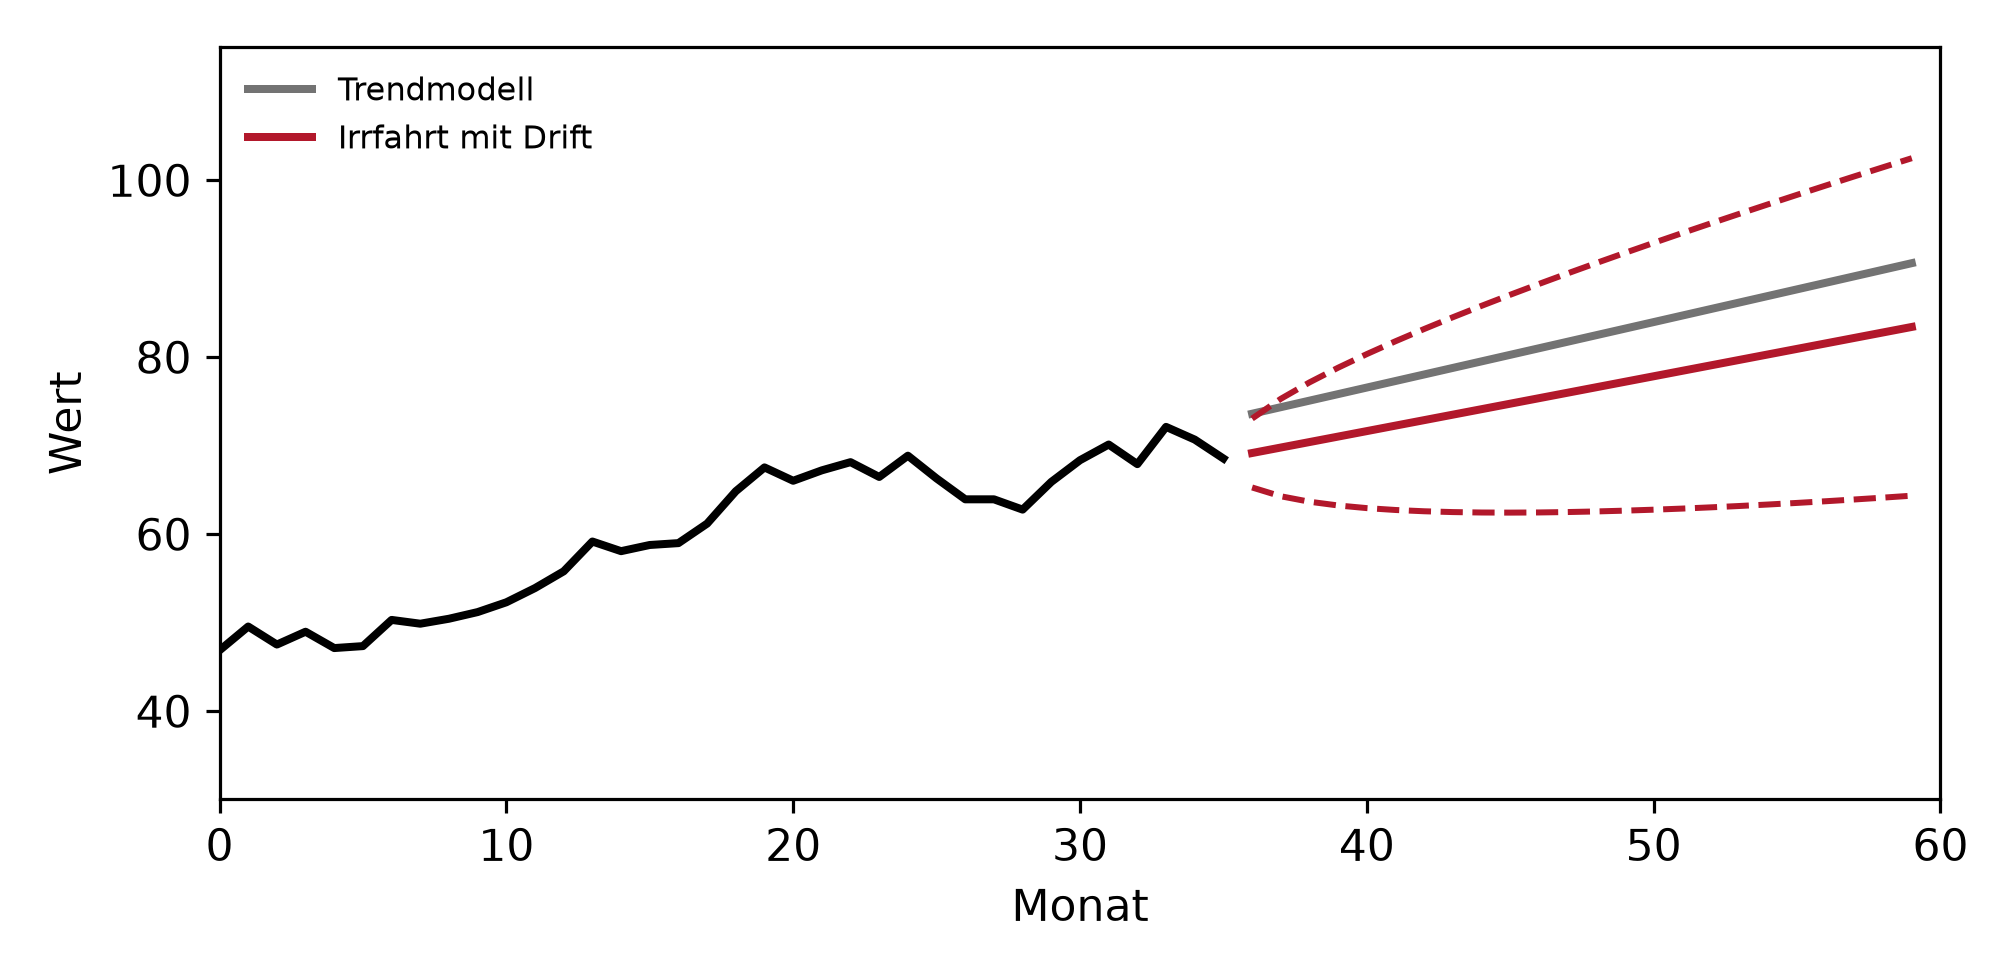
36 Monate Verlauf, Prognose auf bis zu 24 Monate. Zwei Modelle, dieselben Daten: eine lineare Trendregression und eine Irrfahrt mit Drift. Wie unterscheiden sich die Intervalle?

Rechnung

n <- 36
reihe <- 50 + 0.8 * (0:(n - 1)) + cumsum(qnorm(lehmer(7373, n)) * 2)
x <- 0:(n - 1)

modell <- lm(reihe ~ x)
s <- summary(modell)$sigma
xb <- mean(x); sxx <- sum((x - xb)^2)
aenderungen <- diff(reihe)
drift <- mean(aenderungen); sd_aenderung <- sd(aenderungen)

round(c(trend_steigung = unname(coef(modell)[2]), trend_reststreuung = s,
        irrfahrt_drift = drift, irrfahrt_sd = sd_aenderung), 3)
    trend_steigung trend_reststreuung     irrfahrt_drift        irrfahrt_sd 
             0.740              2.886              0.619              1.986 
for (h in c(1, 6, 12, 24)) {
  x0 <- n - 1 + h
  a <- qt(0.975, n - 2) * s * sqrt(1 + 1 / n + (x0 - xb)^2 / sxx)
  b <- 1.96 * sd_aenderung * sqrt(h)
  cat(sprintf("Horizont %2d: Trend +-%6.2f   Irrfahrt +-%6.2f   Faktor %5.2f\n",
              h, a, b, b / a))
}
Horizont  1: Trend +-  6.20   Irrfahrt +-  3.89   Faktor  0.63
Horizont  6: Trend +-  6.34   Irrfahrt +-  9.53   Faktor  1.50
Horizont 12: Trend +-  6.56   Irrfahrt +- 13.48   Faktor  2.05
Horizont 24: Trend +-  7.11   Irrfahrt +- 19.07   Faktor  2.68
round(c(letzter_wert = reihe[n],
        prognose_trend_h24 = unname(coef(modell)[1] + coef(modell)[2] * (n - 1 + 24)),
        prognose_irrfahrt_h24 = reihe[n] + drift * 24), 2)
         letzter_wert    prognose_trend_h24 prognose_irrfahrt_h24 
                68.53                 90.61                 83.40 
zukunft <- (n - 1) + 1:24
par(mar = c(4, 4, 2, 1))
plot(x, reihe, type = "l", lwd = 2, xlim = c(0, n + 24),
     ylim = c(30, 115), xlab = "Monat", ylab = "Wert")
lines(zukunft, coef(modell)[1] + coef(modell)[2] * zukunft, col = "grey45", lwd = 2)
lines(zukunft, reihe[n] + drift * (1:24), col = akzent, lwd = 2)
lines(zukunft, reihe[n] + drift * (1:24) + 1.96 * sd_aenderung * sqrt(1:24),
      col = akzent, lty = 2)
lines(zukunft, reihe[n] + drift * (1:24) - 1.96 * sd_aenderung * sqrt(1:24),
      col = akzent, lty = 2)
legend("topleft", c("Trendmodell", "Irrfahrt mit Drift"),
       col = c("grey45", akzent), lty = 1, lwd = 2, bty = "n", cex = 0.8)
Abbildung 9: Beispiel 5: dieselbe Reihe, zwei Prognosemodelle.
n = 36
x = np.arange(n)
reihe = 50 + 0.8 * x + np.cumsum(stats.norm.ppf(lehmer(7373, n)) * 2)

k, d = np.polyfit(x, reihe, 1)
rest = reihe - (k * x + d)
s = np.sqrt((rest ** 2).sum() / (n - 2))
xb = x.mean()
sxx = ((x - xb) ** 2).sum()
aenderungen = np.diff(reihe)
drift = aenderungen.mean()
sd_aenderung = aenderungen.std(ddof=1)

print({"trend_steigung": round(float(k), 3), "trend_reststreuung": round(float(s), 3),
       "irrfahrt_drift": round(float(drift), 3),
       "irrfahrt_sd": round(float(sd_aenderung), 3)})

for h in (1, 6, 12, 24):
    x0 = n - 1 + h
    a = stats.t.ppf(.975, n - 2) * s * np.sqrt(1 + 1 / n + (x0 - xb) ** 2 / sxx)
    b = 1.96 * sd_aenderung * np.sqrt(h)
    print(f"Horizont {h:2d}: Trend +-{a:6.2f}   Irrfahrt +-{b:6.2f}"
          f"   Faktor {b / a:5.2f}")

print({"letzter_wert": round(float(reihe[-1]), 2),
       "prognose_trend_h24": round(float(k * (n - 1 + 24) + d), 2),
       "prognose_irrfahrt_h24": round(float(reihe[-1] + drift * 24), 2)})

zukunft = (n - 1) + np.arange(1, 25)
fig, achse = plt.subplots(figsize=(7, 3.4))
_ = achse.plot(x, reihe, lw=2, color="black")
_ = achse.plot(zukunft, k * zukunft + d, lw=2, color="0.45", label="Trendmodell")
mitte = reihe[-1] + drift * np.arange(1, 25)
rand = 1.96 * sd_aenderung * np.sqrt(np.arange(1, 25))
_ = achse.plot(zukunft, mitte, lw=2, color=AKZENT, label="Irrfahrt mit Drift")
_ = achse.plot(zukunft, mitte + rand, ls="--", color=AKZENT)
_ = achse.plot(zukunft, mitte - rand, ls="--", color=AKZENT)
_ = achse.set_xlim(0, n + 24)
_ = achse.set_ylim(30, 115)
_ = achse.legend(frameon=False, loc="upper left", fontsize=8)
_ = achse.set_xlabel("Monat")
_ = achse.set_ylabel("Wert")
plt.tight_layout()
plt.show()
Abbildung 10: Beispiel 5: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

Modell Parameter
Trendregression Steigung 0.740, Reststreuung 2.886
Irrfahrt mit Drift Drift 0.619, SD der Änderungen 1.986
Horizont Trend ± Irrfahrt ± Faktor
1 Monat 6.20 3.89 0.63
6 Monate 6.34 9.53 1.50
12 Monate 6.56 13.48 2.05
24 Monate 7.11 19.07 2.68

Letzter beobachteter Wert 68.53; Prognose auf 24 Monate: Trend 90.61, Irrfahrt 83.40.

Beobachtung Erklärung
Das Trendintervall wächst kaum Von ±6.20 auf ±7.11 über 24 Monate, also um 15 Prozent. Das Modell behauptet, in zwei Jahren fast so sicher zu sein wie im nächsten Monat.
Das Irrfahrtintervall wächst mit der Wurzel Von ±3.89 auf ±19.07, also um den Faktor 4.9. Bei einer Reihe, die wandert, ist das die angemessene Aussage.
Bei 24 Monaten ist es 2.68-mal so breit Und die Punktprognosen liegen 7.2 auseinander (90.61 gegen 83.40).
Die Daten wurden als Trend plus Irrfahrt erzeugt Die Irrfahrtvariante ist hier also die ehrlichere. Die Trendregression unterstellt, dass die Abweichungen um die Gerade unabhängig sind, das sind sie nicht.
Kurzfristig ist das Trendintervall sogar zu breit Faktor 0.63 bei einem Monat. Das falsche Modell irrt in beide Richtungen, nur eben nicht dort, wo es auffällt.

Wie sicher eine Grafik aussieht, ist eine Modellentscheidung. Beide Prognosebänder sind korrekt gerechnet; sie beantworten nur verschiedene Fragen über die Welt.

Wenn die Reihe … passendes Modell Intervall wächst
um einen festen Trend schwankt Trendregression kaum
wandert (Irrfahrt, Random Walk) Drift plus √h mit der Wurzel
saisonal ist SARIMA oder Holt-Winters je nach Struktur

Die Prüfung, welches zutrifft, steht unter Stationarität und ACF/PACF. Wer das überspringt und die Standardregression nimmt, bekommt ein schmales Band und damit eine Grafik, die mehr behauptet, als sie weiss.

Interpretation und Ergebnissatz

Über 24 Monate wächst das Prognoseintervall der Trendregression nur von ±6.20 auf ±7.11, das der Irrfahrt mit Drift von ±3.89 auf ±19.07, am Ende ist es 2.68-mal so breit. Beide sind korrekt gerechnet; die Wahl des Modells entscheidet, wie sicher die Grafik aussieht.

Verständnisfragen

Im Fünf-Sekunden-Test nennt die Testperson eine andere Aussage als die beabsichtigte. Was ist der nächste Schritt?

Den Titel deutlicher formulieren
Hilft manchmal, behebt aber nicht die Ursache.
Die Betonung prüfen: Was zieht das Auge zuerst an?
Richtig. Wenn eine andere Aussage ankommt, führt die Gestaltung dorthin. Meist ist etwas Nebensächliches farbig, gross oder oben links, wo der Blick beginnt.
Mehr Erklärtext darunter schreiben
Text unter der Grafik wird in fünf Sekunden nicht gelesen.

Eine Grafik zeigt zwei gleichzeitig steigende Kurven, der Titel lautet “Die Kampagne wirkt”. Was ist das Problem?

Der Titel behauptet eine Ursache, die die Grafik nicht zeigt
Richtig. Im Beispiel wuchs die Kontrollregion ohne Kampagne um 13.7 Prozent, die Testregion um 14.7, der zurechenbare Rest von +4.56 war mit p = 0.22 nicht belegt.
Zwei Kurven in einer Grafik sind zu viel
Zwei Kurven sind unproblematisch.
Es fehlt die Legende
Möglicherweise, aber das ist nicht der inhaltliche Fehler.

Acht Serien werden alle kräftig eingefärbt, eine davon ist die Aussage. Was bringt der Wechsel auf grau plus einen Akzent?

Das visuelle Gewicht der Zielserie steigt vom 1.45- auf das 10.66-Fache der übrigen
Richtig, und zwei Drittel davon kommen vom Zurücknehmen der anderen Serien, nicht vom Hervorheben der einen.
Nichts, die Daten sind dieselben
Die Daten schon, die Führung des Blicks nicht.
Die Zielserie wird doppelt so auffällig
Sie selbst gewinnt Faktor 2.3; der Gesamteffekt entsteht erst zusammen mit dem Zurücknehmen.

Warum ist eine Legende für acht Serien ungünstig?

Sie kostet 16 Blickwechsel, und die Zuordnung läuft über den Farbton
Richtig, einmal hin und einmal zurück je Serie. Direkte Beschriftung spart alle Wege; im Beispiel genügten zwei Beschriftungen statt acht Legendeneinträgen.
Legenden sind grundsätzlich zu vermeiden
Bei sich kreuzenden Linien, wo am Linienende kein Platz ist, bleiben sie sinnvoll.
Acht Einträge passen nicht ins Bild
Sie passen; das Problem ist die Zuordnungsarbeit.

Eine Prognose über 24 Monate hat bei der Trendregression ein Intervall von ±7.11, bei der Irrfahrt ±19.07. Welches ist richtig?

Das hängt davon ab, ob die Reihe um einen Trend schwankt oder wandert
Richtig. Beide sind korrekt gerechnet und beantworten verschiedene Fragen über die Welt. Die Daten hier wurden als Trend plus Irrfahrt erzeugt, also ist die zweite die ehrlichere.
Das schmalere, weil es mehr Information nutzt
Ein schmales Band ist kein Qualitätsmerkmal, sondern eine Behauptung.
Das breitere, Vorsicht ist immer besser
Kurzfristig war das Trendband mit Faktor 0.63 sogar breiter; pauschale Vorsicht ersetzt die Modellwahl nicht.

Eine Geschichte wird in drei Grafiken erzählt. Wie erkennt man, ob die Folge trägt?

Jeder Schritt hat genau eine eigene Kennzahl, und die Reihenfolge lässt sich nicht umstellen
Richtig. Im Beispiel: Ausgangsniveau 103.28, Zuwachs +15.18, davon zurechenbar +4.56. Der dritte Schritt ist ohne den zweiten unverständlich.
Alle drei zeigen dieselben Daten aus verschiedenen Blickwinkeln
Das allein ergibt drei Einzelgrafiken, noch keine Folge.
Die letzte Grafik ist die auffälligste
Die stärkste Betonung gehört in den Spannungsteil, nicht zwingend ans Ende.

Verlinkte Ressourcen