Lage- und Streuungsmasse

Deskriptive Statistik
Interpretation
R
Python
Mittelwert, Median, Quartile, Standardabweichung und ihre Robustheit.

Kernideen

  • Lage und Streuung gehören zusammen. Ein Mittelwert ohne Streuungsmass ist eine halbe Information.
  • Lagemasse: Modus, Median, arithmetisches Mittel, welches zulässig ist, entscheidet das Skalenniveau.
  • Robuste Masse (Median, IQR) ignorieren extreme Werte, empfindliche (Mittel, Standardabweichung) nutzen alle.
  • Quantile beantworten Anteilsfragen direkt: Das \(p\)-Quantil ist der Wert, unter dem ein Anteil \(p\) liegt.
  • Der Abstand zwischen Mittel und Median verrät die Schiefe, auch ohne Bild.
  • Im Nenner der Varianz steht \(n-1\), und das hat einen nachrechenbaren Grund.
  • R und NumPy rechnen verschieden: sd() teilt durch \(n-1\), np.std() voreingestellt durch \(n\).
  • Der Boxplot bündelt fünf Kennzahlen und zeigt die Form nicht.

Erklärung

Lage und Streuung beantworten zwei verschiedene Fragen: wo liegt die Verteilung, und wie breit ist sie. Zwei Datensätze mit identischem Mittelwert können völlig verschiedene Sachverhalte beschreiben, wenn ihre Streuung sich unterscheidet.

Die Lagemasse und das Skalenniveau

Lagemass ab Skalenniveau robust was es beschreibt
Modus nominal ja die häufigste Ausprägung
Median ordinal ja der Wert in der Mitte der sortierten Reihe
Arithmetisches Mittel metrisch nein der Schwerpunkt der Werte

Der Median teilt die sortierte Reihe in zwei gleich grosse Hälften. Bei ungerader Anzahl ist er der mittlere Wert, bei gerader das Mittel der beiden mittleren. Das arithmetische Mittel

\[\bar{x} = \frac{1}{n}\sum_{i=1}^{n} x_i\]

ist dagegen der Schwerpunkt: Die Summe der Abweichungen vom Mittel ist immer null. Genau diese Eigenschaft macht es empfindlich, denn ein weit entfernter Wert zieht den Schwerpunkt mit sich wie ein langer Hebel.

Daraus wird eine Merkregel, die sich rückwärts anwenden lässt. Wer nur zwei Zahlen hat und die Form nicht sieht, kann sie vergleichen:

Beobachtung Form der Verteilung typisches Beispiel
Mittel grösser als Median rechtsschief, langer Rand nach rechts Löhne, Wartezeiten, Schadenshöhen
Mittel kleiner als Median linksschief, langer Rand nach links Prüfungsergebnisse bei leichter Prüfung
Mittel gleich Median symmetrisch Messfehler um einen Sollwert

Quantile

Das \(p\)-Quantil ist der Wert, unterhalb dessen ein Anteil \(p\) der Beobachtungen liegt. Der Median ist damit das 0.5-Quantil; die Quartile teilen die Daten in vier Viertel.

Ein Detail, über das man sonst stolpert: Es gibt neun verschiedene Definitionen, wie zwischen zwei Beobachtungen interpoliert wird. R verwendet standardmässig Typ 7 und NumPy und pandas rechnen mit derselben linearen Interpolation, sodass beide Sprachen hier ohne Zutun dasselbe Ergebnis liefern.

Die Streuungsmasse

Auch hier gibt es die robuste und die empfindliche Familie.

Mass Formel robust Eigenschaften
Spannweite Maximum minus Minimum nein nutzt nur zwei Werte, wächst systematisch mit \(n\), das instabilste Mass
Interquartilsabstand \(Q_3 - Q_1\) ja umfasst die mittleren fünfzig Prozent, ignoriert die äusseren Viertel vollständig
Varianz \(s^2 = \frac{1}{n-1}\sum(x_i - \bar{x})^2\) nein in quadrierten Einheiten, deshalb nicht direkt lesbar
Standardabweichung \(s = \sqrt{s^2}\) nein zurück in der Einheit der Daten; das Mass, das berichtet wird
Variationskoeffizient \(v = s / \bar{x}\) nein macht Grössenordnungen vergleichbar; nur bei positiven Verhältnisskalen sinnvoll

Warum im Nenner \(n-1\) steht

Die Formel teilt nicht durch die Anzahl der Werte, sondern durch eins weniger. Das wirkt wie ein Schreibfehler und hat einen Grund.

Gemessen werden die Abweichungen vom geschätzten Mittel, also von dem Mittel, das aus genau diesen Daten stammt. Dieses Mittel liegt zwangsläufig mitten in den Daten drin. Es gibt keine Zahl, um die die Werte enger streuen als um ihren eigenen Mittelwert; jeder andere Bezugspunkt, auch der wahre Mittelwert der Grundgesamtheit, ergäbe eine grössere Abweichungssumme.

Wer also durch \(n\) teilt, misst die Streuung um den günstigsten aller möglichen Bezugspunkte und erhält deshalb systematisch einen zu kleinen Wert. Die Korrektur um eins gleicht das aus. Sie heisst Bessel-Korrektur, und Beispiel 4 rechnet sie nach.

Der Sprachunterschied, der daraus folgt

R rechnet immer mit \(n-1\), NumPy standardmässig mit \(n\). pandas verhält sich wie R. Wer die Sprachen mischt, bekommt für dieselben Daten zwei verschiedene Standardabweichungen.

Gesteuert wird das in Python über den Parameter ddof, delta degrees of freedom. Er gibt an, wie viel im Nenner von \(n\) abgezogen wird: ddof=0 teilt durch \(n\), ddof=1 durch \(n-1\). Der Name nennt also nicht das Ergebnis, sondern die Grösse des Abzugs, und das ist der Grund, warum er beim ersten Lesen nichts sagt.

Der Boxplot und seine Anatomie

Der Boxplot bündelt die robuste Familie in einem Bild. Die Box reicht von \(Q_1\) bis \(Q_3\), der Strich darin ist der Median. Die Antennen gehen bis zum am weitesten entfernten Wert, der noch innerhalb von \(1.5 \times \text{IQR}\) ab dem jeweiligen Quartil liegt, alles darüber hinaus wird als Punkt gezeichnet.

Die 1.5-Regel ist eine Konvention, kein Test. Sie markiert Werte, die einen zweiten Blick verdienen; sie beweist nicht, dass ein Wert falsch ist. Bei normalverteilten Daten fallen rund 0.7 Prozent der Beobachtungen darunter, in grossen Stichproben also regelmässig einige, ohne dass irgendetwas schiefgelaufen wäre.

Beispiele

Frage und Datenlage

Sechs Messwerte: 12, 14, 15, 15, 18, 21. Was passiert mit Mittel und Median, wenn ein siebter Wert von 470 dazukommt, etwa durch einen Tippfehler oder einen echten Extremfall?

Rechnung

x <- c(12, 14, 15, 15, 18, 21)

rbind(
  "ohne Ausreisser" = c(mittel = mean(x), median = median(x),
                        sd = sd(x), iqr = IQR(x)),
  "mit Ausreisser"  = c(mittel = mean(c(x, 470)), median = median(c(x, 470)),
                        sd = sd(c(x, 470)), iqr = IQR(c(x, 470)))
) |> round(2)
                mittel median     sd iqr
ohne Ausreisser  15.83     15   3.19   3
mit Ausreisser   80.71     15 171.68   5
x = np.array([12, 14, 15, 15, 18, 21])
x_gross = np.append(x, 470)


def kennzahlen(werte):
    q1, q3 = np.quantile(werte, [0.25, 0.75])
    return {"mittel": werte.mean(), "median": np.median(werte),
            "sd": werte.std(ddof=1), "iqr": q3 - q1}


print(pd.DataFrame([kennzahlen(x), kennzahlen(x_gross)],
                   index=["ohne Ausreisser", "mit Ausreisser"]).round(2))
                 mittel  median      sd  iqr
ohne Ausreisser   15.83    15.0    3.19  3.0
mit Ausreisser    80.71    15.0  171.68  5.0

Output Zeile für Zeile

Mittel Median Standardabweichung IQR
ohne Ausreisser 15.83 15.0 3.19 3.00
mit Ausreisser 80.71 15.0 171.68 5.00
Faktor 5.1 1.00 53.8 1.67
Beobachtung Erklärung
Das Mittel verfünffacht sich Der eine Wert von 470 trägt allein \(470/7 = 67\) zum Mittel bei, mehr als die sechs anderen zusammen.
Der Median bleibt exakt bei 15 Er zählt nur ab, wie viele Werte links und rechts liegen. Ob ein Wert knapp oder weit rechts liegt, ist ihm gleich. Bei sieben statt sechs Werten rückt er von der Mitte zweier Werte auf den vierten, hier zufällig derselbe.
Die Standardabweichung verfünfzigfacht sich Noch empfindlicher als das Mittel, weil sie die Abweichung quadriert: \((470 - 80.7)^2\) ist rund 151 000 und beherrscht die Summe vollständig.
Der IQR steigt von 3.0 auf 5.0 Er umfasst nur die mittleren fünfzig Prozent; der Extremwert selbst liegt weit ausserhalb. Dass er sich überhaupt ändert, liegt nur daran, dass aus sechs Werten sieben werden und die Quartile dadurch auf andere Rangpositionen fallen.

Der Vergleich der beiden Faktoren ist die eigentliche Lehre: 53.8 gegen 1.67. Wer eine Streuung berichtet, entscheidet damit implizit, wie stark einzelne Extremwerte durchschlagen sollen.

Und daraus folgt die Praxisregel: Sobald eine Verteilung schief ist oder Ausreisser enthält, beschreibt das robuste Paar (Median, IQR) den typischen Fall besser. Genau darum werden Löhne und Immobilienpreise als Median berichtet.

Interpretation

Der Ausreisser ist damit nicht erklärt, nur seine Wirkung. Ob 470 ein Tippfehler, ein Sonderfall oder ein echter Messwert ist, entscheidet die Sache, nicht die Statistik. Was nicht geht: ihn stillschweigend entfernen.

Frage und Datenlage

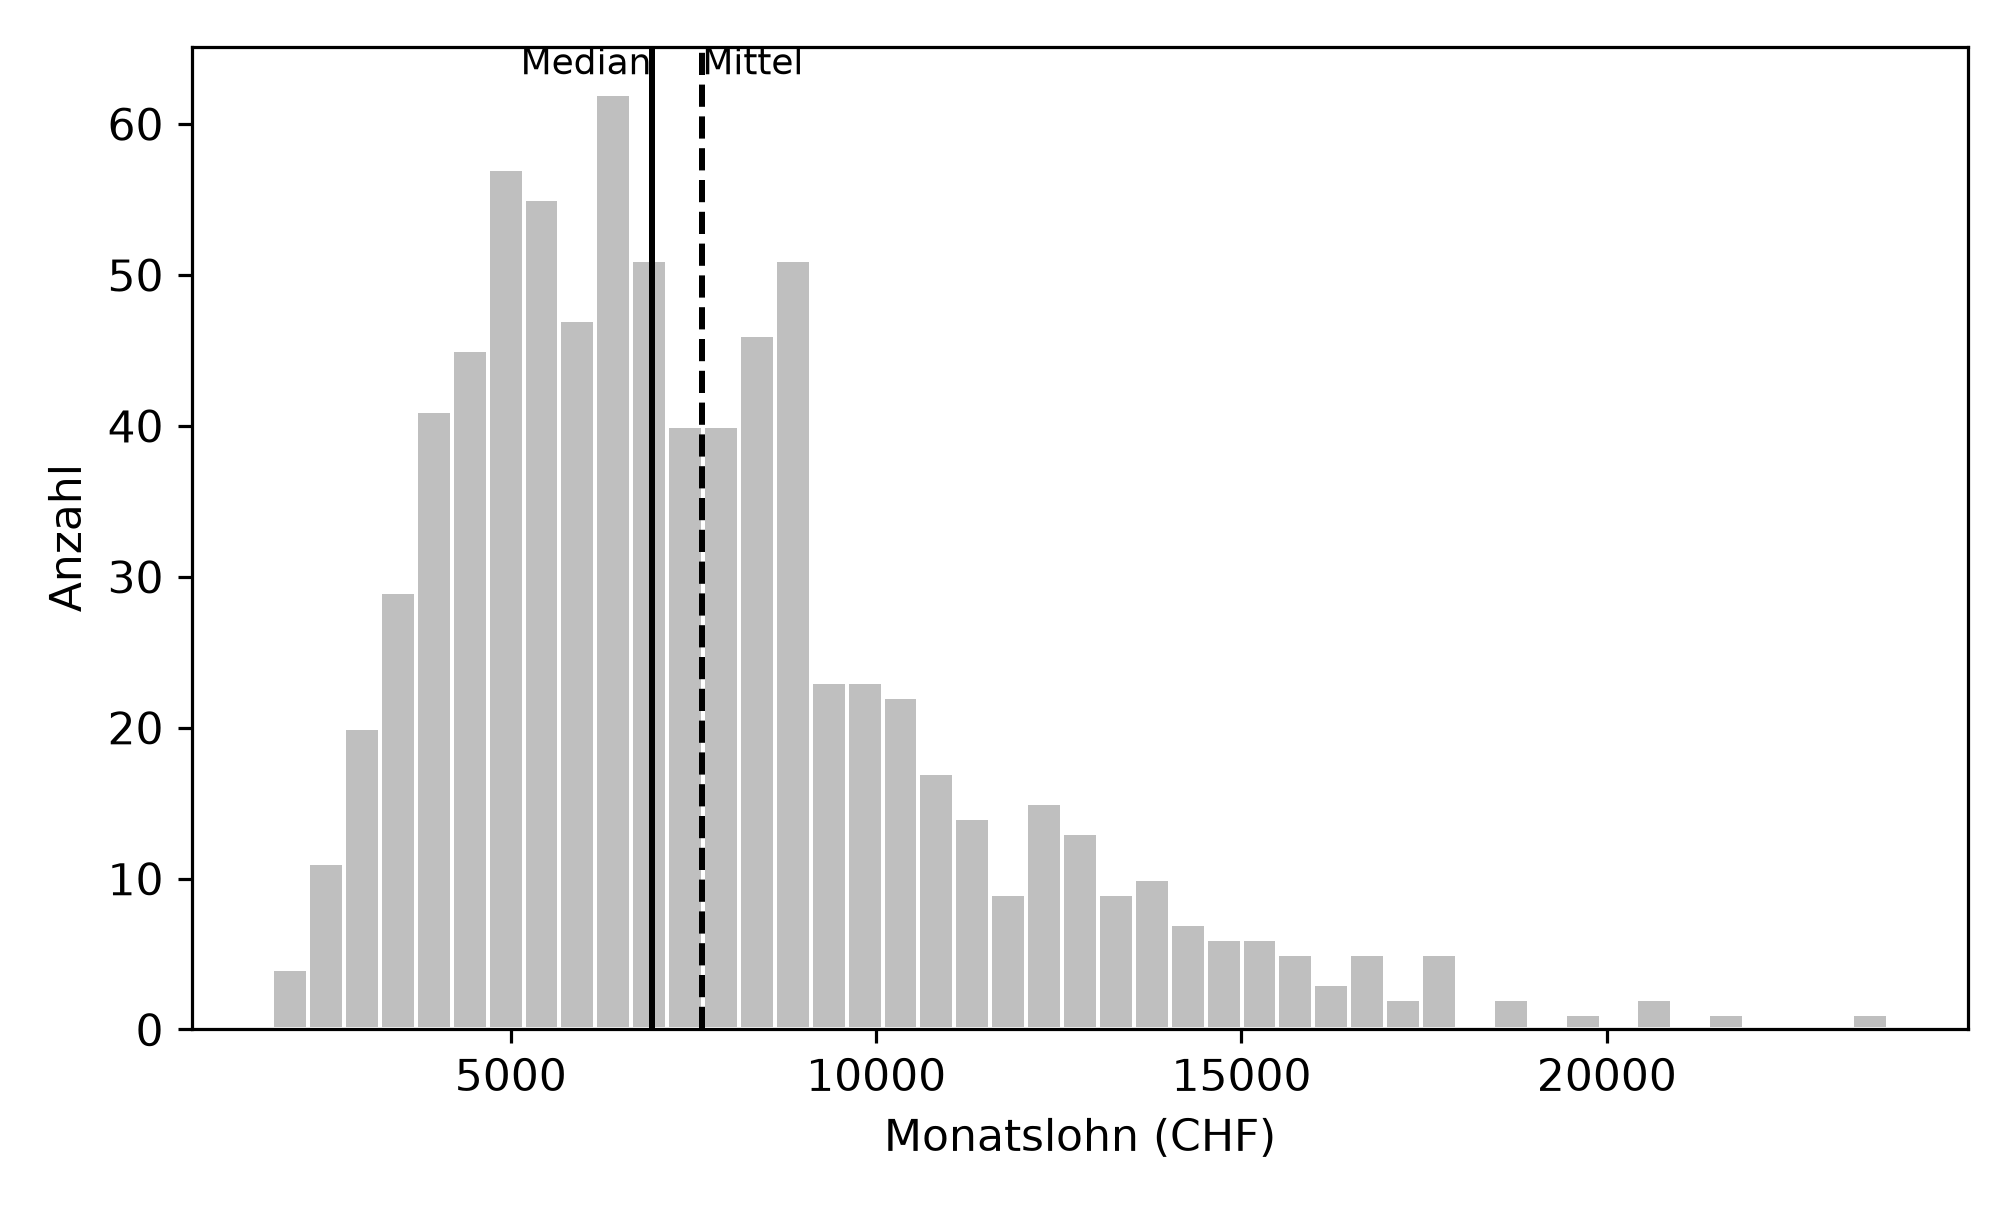
800 konstruierte Monatslöhne mit dem typischen Verlauf: viele im mittleren Bereich, einzelne sehr hohe. Was macht das mit Mittel und Median?

Rechnung

ggplot(data.frame(lohn = loehne), aes(lohn)) +
  geom_histogram(bins = 45, fill = "grey75", colour = "white") +
  geom_vline(xintercept = median(loehne)) +
  geom_vline(xintercept = mean(loehne), linetype = "dashed") +
  annotate("text", x = median(loehne), y = Inf, label = "Median",
           vjust = 1.6, hjust = 1.1, size = 3.5) +
  annotate("text", x = mean(loehne), y = Inf, label = "Mittel",
           vjust = 1.6, hjust = -0.1, size = 3.5) +
  labs(x = "Monatslohn (CHF)", y = "Anzahl")

round(c(minimum = min(loehne), q25 = quantile(loehne, 0.25),
        median = median(loehne), mittel = mean(loehne),
        q75 = quantile(loehne, 0.75), q90 = quantile(loehne, 0.90),
        maximum = max(loehne)), 1)
minimum q25.25%  median  mittel q75.75% q90.90% maximum 
 1736.0  5132.8  6927.0  7621.1  9112.0 12380.3 23844.0 
round(c(spannweite = diff(range(loehne)), iqr = IQR(loehne),
        sd = sd(loehne), vk = sd(loehne) / mean(loehne)), 3)
spannweite        iqr         sd         vk 
 22108.000   3979.250   3420.327      0.449 
Abbildung 1: Beispiel 2: rechtsschiefe Verteilung. Der lange rechte Rand zieht das Mittel über den Median.
fig, achse = plt.subplots()
_ = achse.hist(loehne, bins=45, color="0.75", edgecolor="white")
_ = achse.axvline(np.median(loehne), color="black")
_ = achse.axvline(loehne.mean(), color="black", linestyle="--")
_ = achse.annotate("Median", (np.median(loehne), achse.get_ylim()[1]),
               ha="right", va="top", fontsize=9)
_ = achse.annotate("Mittel", (loehne.mean(), achse.get_ylim()[1]),
               ha="left", va="top", fontsize=9)
_ = achse.set_xlabel("Monatslohn (CHF)")
_ = achse.set_ylabel("Anzahl")
plt.tight_layout()
plt.show()
Abbildung 2: Beispiel 2: dieselbe Verteilung mit matplotlib.

q25, q75, q90 = np.quantile(loehne, [0.25, 0.75, 0.90])
print(pd.Series({"minimum": loehne.min(), "q25": q25,
                 "median": np.median(loehne), "mittel": loehne.mean(),
                 "q75": q75, "q90": q90, "maximum": loehne.max()}).round(1))

print(pd.Series({
    "spannweite": loehne.max() - loehne.min(),
    "iqr": q75 - q25,
    "sd": loehne.std(ddof=1),           # ddof=1 entspricht sd() in R
    "vk": loehne.std(ddof=1) / loehne.mean(),
}).round(3))

Output Zeile für Zeile

Kennzahl Wert Was sie sagt
Minimum 1 736
\(Q_{25}\) rund 5 200 Ein Viertel verdient weniger.
Median 6 927 Die Hälfte verdient weniger, die Hälfte mehr. Das ist der typische Lohn.
Mittel 7 621 Rund 700 Franken höher, der Abstand ist die Schiefe.
\(Q_{75}\) rund 9 200
\(Q_{90}\) 12 380 Zehn Prozent verdienen mehr als das.
Maximum 23 844 Das Dreieinhalbfache des Medians.
Streuungsmass Wert Wie er zu lesen ist
Spannweite 22 108 Beschreibt nur die beiden Extremwerte, sonst nichts. Bei 8000 statt 800 Löhnen wäre sie grösser, ohne dass sich an der Verteilung etwas geändert hätte.
IQR 3 979 Die mittleren fünfzig Prozent liegen in einem Band von rund 4000 Franken. Das ist die brauchbare Aussage.
Standardabweichung 3 420 Kleiner als der IQR, bei einer symmetrischen Verteilung wäre sie kleiner als die Hälfte davon. Der Vergleich der beiden ist selbst ein Schiefemass.
Variationskoeffizient 0.449 Die Streuung beträgt 45 Prozent des Mittelwerts. Damit lässt sich diese Lohnverteilung mit einer aus einem anderen Land oder einer anderen Währung vergleichen.

Warum das Mittel überhaupt höher liegt, im Bild abgelesen: Die Masse der Löhne liegt links, aber einzelne sehr hohe Werte ziehen sich weit nach rechts. Der Median zählt nur ab; das Mittel ist ein Schwerpunkt, und ein weit entfernter Wert wirkt darin wie ein langer Hebel. Deshalb rutscht das Mittel dorthin, wo der Rand länger ausläuft, während der Median stehen bleibt.

Die Differenz von 694 Franken ist die kompakteste Beschreibung der Schiefe, die es gibt und sie steht in jeder Lohnstatistik zum Ablesen bereit.

Interpretation und Ergebnissatz

Der Medianlohn beträgt 6 927 Franken (IQR 3 979, n = 800). Die Verteilung ist rechtsschief: Das arithmetische Mittel liegt mit 7 621 Franken rund zehn Prozent darüber, und zehn Prozent der Löhne überschreiten 12 380 Franken.

Frage und Datenlage

Ein Hersteller garantiert, dass 90 Prozent der Bauteile eine Toleranz von höchstens 0.4 mm einhalten. Welche Kennzahl prüft diese Zusage und welche nicht?

Dazu die kleinen Werte aus Beispiel 1, an denen sich die Interpolation zeigen lässt.

Rechnung

quantile(x, probs = c(0.25, 0.5, 0.75))
  25%   50%   75% 
14.25 15.00 17.25 
# Wie kommt 14.25 zustande? Typ 7 interpoliert linear zwischen den Rängen
sortiert <- sort(x)
position <- 1 + 0.25 * (length(x) - 1)          # Rangposition des 25%-Quantils
c(position = position,
  unten = sortiert[floor(position)],
  oben = sortiert[ceiling(position)],
  anteil = position - floor(position))
position    unten     oben   anteil 
    2.25    14.00    15.00     0.25 
print(np.quantile(x, [0.25, 0.5, 0.75]))

sortiert = np.sort(x)
position = 1 + 0.25 * (len(x) - 1)
print({"position": position,
       "unten": int(sortiert[int(np.floor(position)) - 1]),
       "oben": int(sortiert[int(np.ceil(position)) - 1]),
       "anteil": round(position - np.floor(position), 2)})

Output Zeile für Zeile

Die drei Quartile der Werte 12, 14, 15, 15, 18, 21:

Quantil Wert
\(Q_{25}\) 14.25
\(Q_{50}\) (Median) 15.00
\(Q_{75}\) 17.25
Schritt Rechnung Ergebnis
Rangposition \(1 + 0.25 \cdot (6 - 1)\) 2.25
Nachbarn zweiter Wert = 14, dritter Wert = 15
Interpolation \(14 + 0.25 \cdot (15 - 14)\) 14.25
Frage Antwort Warum
Prüft das 0.9-Quantil die Zusage? Ja Es ist genau der Wert, unter dem 90 Prozent der Beobachtungen liegen, und lässt sich unmittelbar mit den 0.4 mm vergleichen.
Prüft der Mittelwert sie? Nein Er sagt nichts darüber, wie viele Teile unter einer Schranke liegen. Ein kleines Mittel ist mit vielen Ausreissern vereinbar.
Prüft die Standardabweichung sie? Nein Sie beschreibt die Streubreite insgesamt. Auf einen Anteil lässt sich daraus nur schliessen, wenn man zusätzlich eine Verteilungsform unterstellt und genau das will man bei einer Garantiezusage nicht.

Warum 14.25 und nicht 14? Weil das 25-Prozent-Quantil bei sechs Werten zwischen den Rängen liegt. Es gibt neun gebräuchliche Konventionen, wie dann interpoliert wird; R nimmt Typ 7, und NumPy sowie pandas rechnen genauso.

Bei anderen Werkzeugen ist das nicht garantiert: Excel, SPSS und SQL-Datenbanken verwenden teils andere Typen, und bei kleinen Stichproben kommen dann sichtbar verschiedene Zahlen heraus. Bei \(n\) in den Hunderten ist der Unterschied vernachlässigbar.

Interpretation

Quantile sind das direkte Werkzeug für Anteilsfragen, Garantiezusagen, Service-Level, Grenzwerte. Der Umweg über Mittel und Streuung braucht immer eine zusätzliche Annahme.

Frage und Datenlage

Die Behauptung: Die Division durch \(n\) unterschätzt die Varianz systematisch, die durch \(n-1\) trifft sie im Mittel. Das lässt sich nachrechnen, mit 20 000 Stichproben zu je fünf Werten aus einer Grundgesamtheit mit bekannter Varianz \(\sigma^2 = 25\).

Rechnung

# 20000 Stichproben zu je 5 Werten, sigma = 5, also sigma^2 = 25
alle <- matrix(normalwerte(3311, 20000 * 5, 100, 5), nrow = 20000, byrow = TRUE)

durch_n <- mean(apply(alle, 1, function(v) mean((v - mean(v))^2)))
durch_n_1 <- mean(apply(alle, 1, var))          # var() teilt durch n - 1

round(c(wahr = 25, geteilt_durch_n = durch_n,
        geteilt_durch_n_1 = durch_n_1,
        verhaeltnis = durch_n / 25), 3)
             wahr   geteilt_durch_n geteilt_durch_n_1       verhaeltnis 
           25.000            20.203            25.254             0.808 
# Der Faktor ist kein Zufall
round((5 - 1) / 5, 3)
[1] 0.8
alle = normalwerte(3311, 20000 * 5, 100, 5).reshape(20000, 5)

durch_n = ((alle - alle.mean(axis=1, keepdims=True)) ** 2).mean(axis=1).mean()
durch_n_1 = alle.var(axis=1, ddof=1).mean()

print({"wahr": 25,
       "geteilt_durch_n": round(float(durch_n), 3),
       "geteilt_durch_n_1": round(float(durch_n_1), 3),
       "verhaeltnis": round(float(durch_n) / 25, 3)})
print("(n - 1) / n =", round((5 - 1) / 5, 3))

Output Zeile für Zeile

Grösse Wert
wahre Varianz \(\sigma^2\) 25.00
Mittel über 20 000 Stichproben, geteilt durch \(n\) 20.20
Mittel über 20 000 Stichproben, geteilt durch \(n-1\) 25.25
Verhältnis 20.20 zu 25 0.808
\((n-1)/n\) bei \(n = 5\) 0.800
Beobachtung Erklärung
Die Variante mit \(n\) liegt um 19 Prozent zu tief Und zwar nicht zufällig: Das Verhältnis 0.808 trifft den theoretischen Wert \((n-1)/n = 0.8\) auf ein Prozent genau. Die Unterschätzung ist also exakt vorhersagbar.
Die Variante mit \(n-1\) trifft 25.25 gegenüber 25.00. Die Restabweichung von einem Prozent ist Stichprobenzufall über die 20 000 Wiederholungen.
Bei \(n = 5\) ist der Fehler gross Ein Fünftel des Nenners macht viel aus.
Bei \(n = 500\) wäre er 0.2 Prozent Deshalb spielt die Frage bei grossen Stichproben praktisch keine Rolle und deshalb ist sie trotzdem wichtig, weil kleine Stichproben der Normalfall sind, in dem man sie braucht.

Der Sprachunterschied in einer Zeile:

Aufruf Nenner Ergebnis für 12, 14, 15, 15, 18, 21
sd(x) in R \(n-1\) 3.1885
np.std(x) \(n\) 2.9107
np.std(x, ddof=1) \(n-1\) 3.1885
pd.Series(x).std() \(n-1\) 3.1885

Abweichend verhält sich also nur NumPy selbst. Beispiel 5 zeigt es an den Zahlen.

Interpretation und Ergebnissatz

Die Division durch \(n\) unterschätzt die Varianz bei \(n = 5\) systematisch um den Faktor \((n-1)/n = 0.8\); die Bessel-Korrektur gleicht das aus. In der Simulation über 20 000 Stichproben ergibt sich 20.20 gegenüber 25.25, bei einer wahren Varianz von 25.

Frage und Datenlage

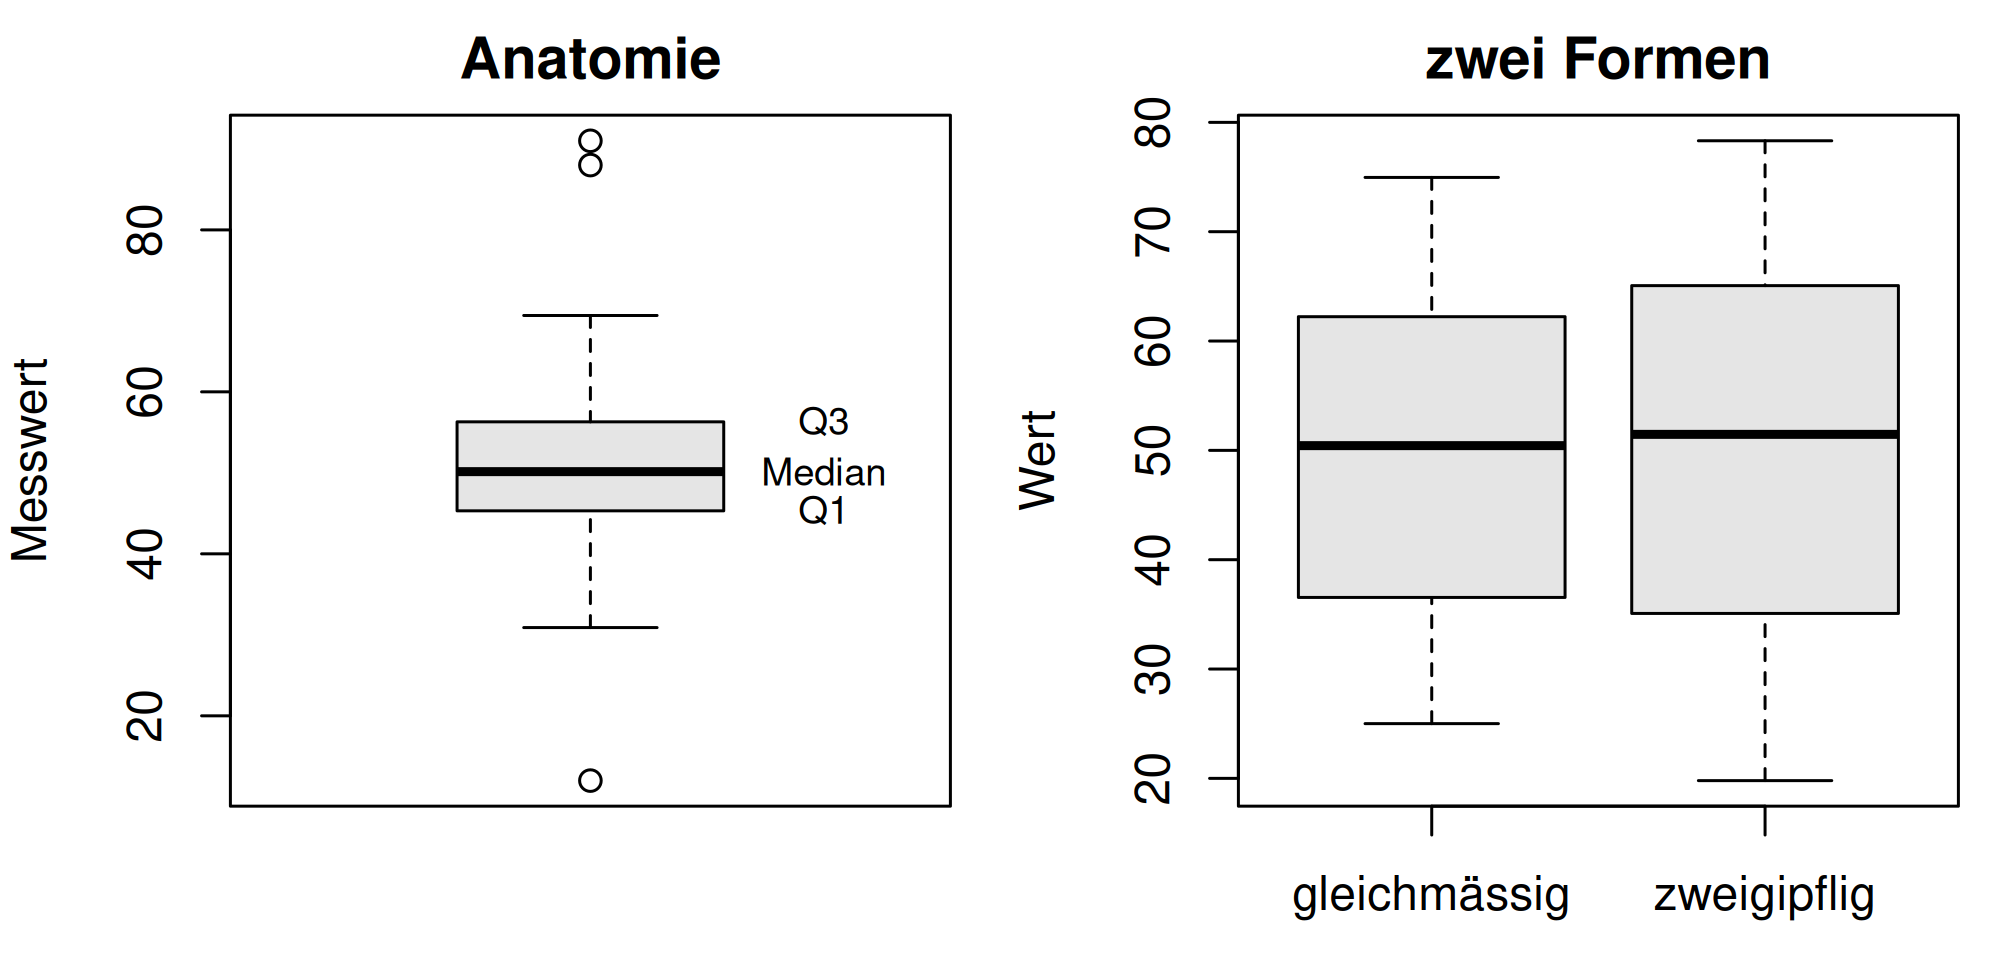
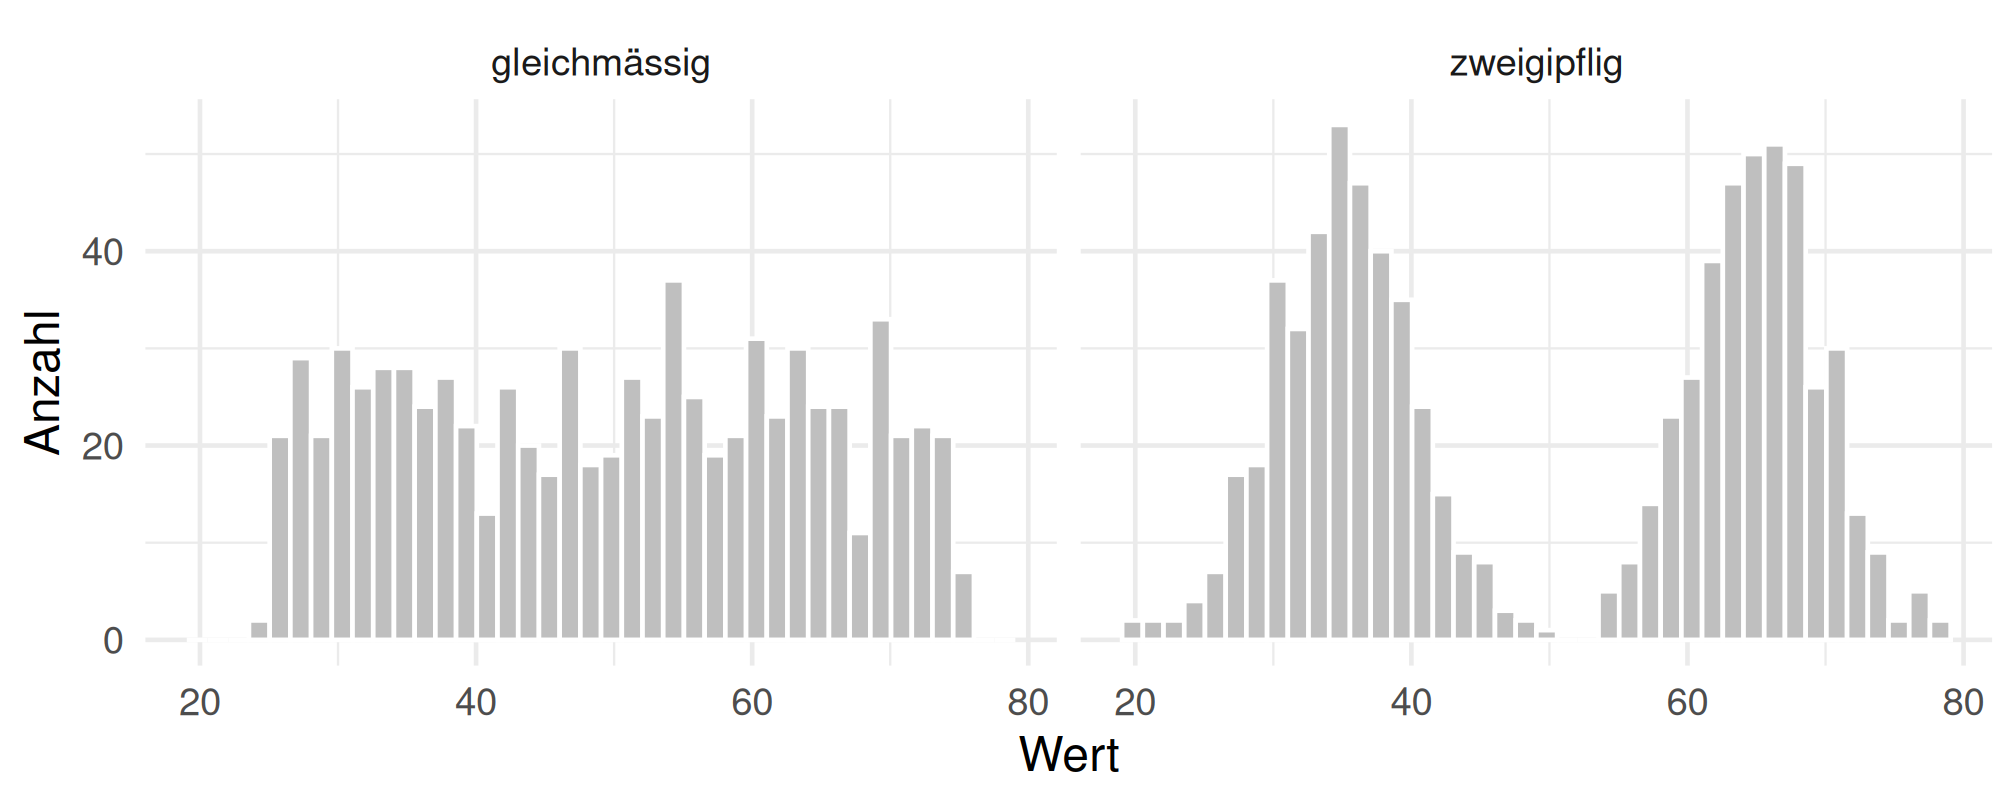
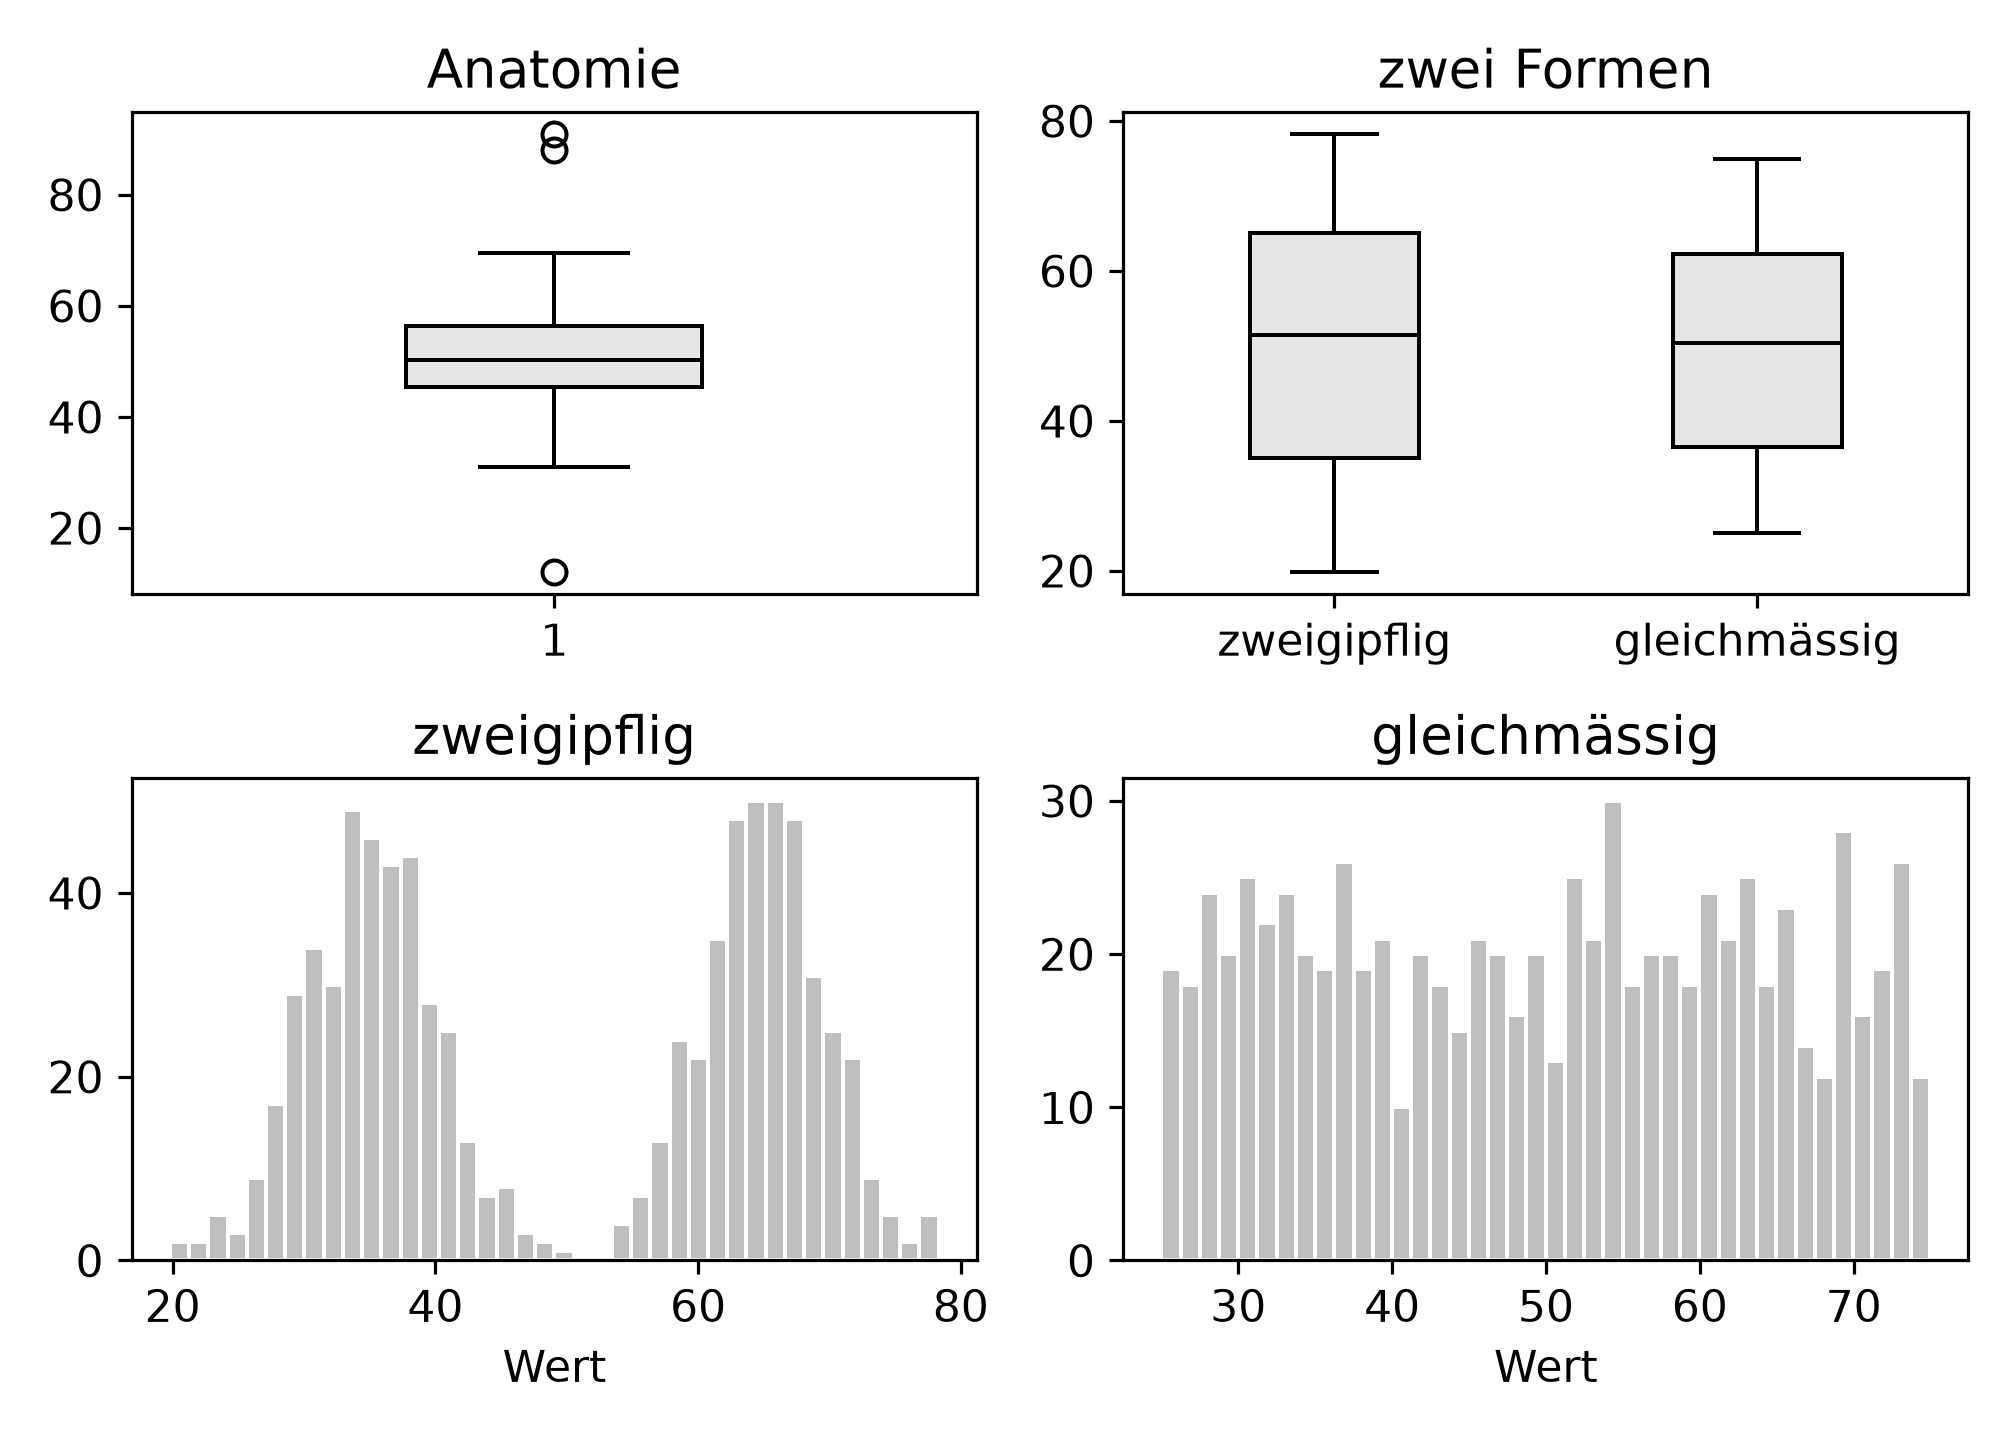
Zwei Verteilungen mit fast identischen Boxplots: eine zweigipflige (zwei Wolken um 35 und 65) und eine gleichmässige zwischen 25 und 75. Was zeigt der Boxplot, was nicht?

Rechnung

werte <- c(normalwerte(4411, 120, 50, 8), 88, 91, 12)
kennz <- quantile(werte, c(0.25, 0.5, 0.75))
iqr <- kennz[3] - kennz[1]

zweigipflig <- c(normalwerte(5511, 400, 35, 5), normalwerte(5512, 400, 65, 5))
gleichmaessig <- 25 + 50 * lehmer(5513, 800)
dat <- data.frame(
  wert = c(zweigipflig, gleichmaessig),
  form = rep(c("zweigipflig", "gleichmässig"), each = 800)
)

par(mfrow = c(1, 2), mar = c(3, 4, 2, 1))
boxplot(werte, main = "Anatomie", ylab = "Messwert", col = "grey90")
text(1.35, kennz, labels = c("Q1", "Median", "Q3"), cex = 0.8)
boxplot(wert ~ form, data = dat, main = "zwei Formen", xlab = "", ylab = "Wert",
        col = "grey90")
par(mfrow = c(1, 1))

round(c(q1 = kennz[1], median = kennz[2], q3 = kennz[3], iqr = iqr,
        grenze_unten = kennz[1] - 1.5 * iqr,
        grenze_oben = kennz[3] + 1.5 * iqr), 2)
          q1.25%       median.50%           q3.75%          iqr.75% 
           45.31            50.15            56.30            10.99 
grenze_unten.25%  grenze_oben.75% 
           28.83            72.78 
sort(werte[werte < kennz[1] - 1.5 * iqr | werte > kennz[3] + 1.5 * iqr])
[1] 12 88 91
Abbildung 3: Beispiel 5: links die Anatomie des Boxplots, rechts zwei fast gleiche Boxplots zu sehr verschiedenen Verteilungen.
ggplot(dat, aes(wert)) +
  geom_histogram(bins = 40, fill = "grey75", colour = "white") +
  facet_wrap(~ form) +
  labs(x = "Wert", y = "Anzahl")
Abbildung 4: Beispiel 5: erst das Histogramm macht die zwei Gipfel sichtbar.
werte = np.append(normalwerte(4411, 120, 50, 8), [88, 91, 12])
q1, med, q3 = np.quantile(werte, [0.25, 0.5, 0.75])
iqr = q3 - q1

zweigipflig = np.concatenate([normalwerte(5511, 400, 35, 5),
                              normalwerte(5512, 400, 65, 5)])
gleichmaessig = 25 + 50 * lehmer(5513, 800)

fig, achsen = plt.subplots(2, 2, figsize=(7, 5))
_ = achsen[0, 0].boxplot(werte, whis=1.5, widths=0.35, patch_artist=True,
                     boxprops={"facecolor": "0.9"},
                     medianprops={"color": "black"})
_ = achsen[0, 0].set_title("Anatomie")
_ = achsen[0, 1].boxplot([zweigipflig, gleichmaessig], widths=0.4,
                     patch_artist=True, boxprops={"facecolor": "0.9"},
                     medianprops={"color": "black"})
_ = achsen[0, 1].set_xticklabels(["zweigipflig", "gleichmässig"])
_ = achsen[0, 1].set_title("zwei Formen")
for achse, daten, titel in zip(achsen[1], [zweigipflig, gleichmaessig],
                               ["zweigipflig", "gleichmässig"]):
    _ = achse.hist(daten, bins=40, color="0.75", edgecolor="white")
    _ = achse.set_title(titel)
    _ = achse.set_xlabel("Wert")
plt.tight_layout()
plt.show()
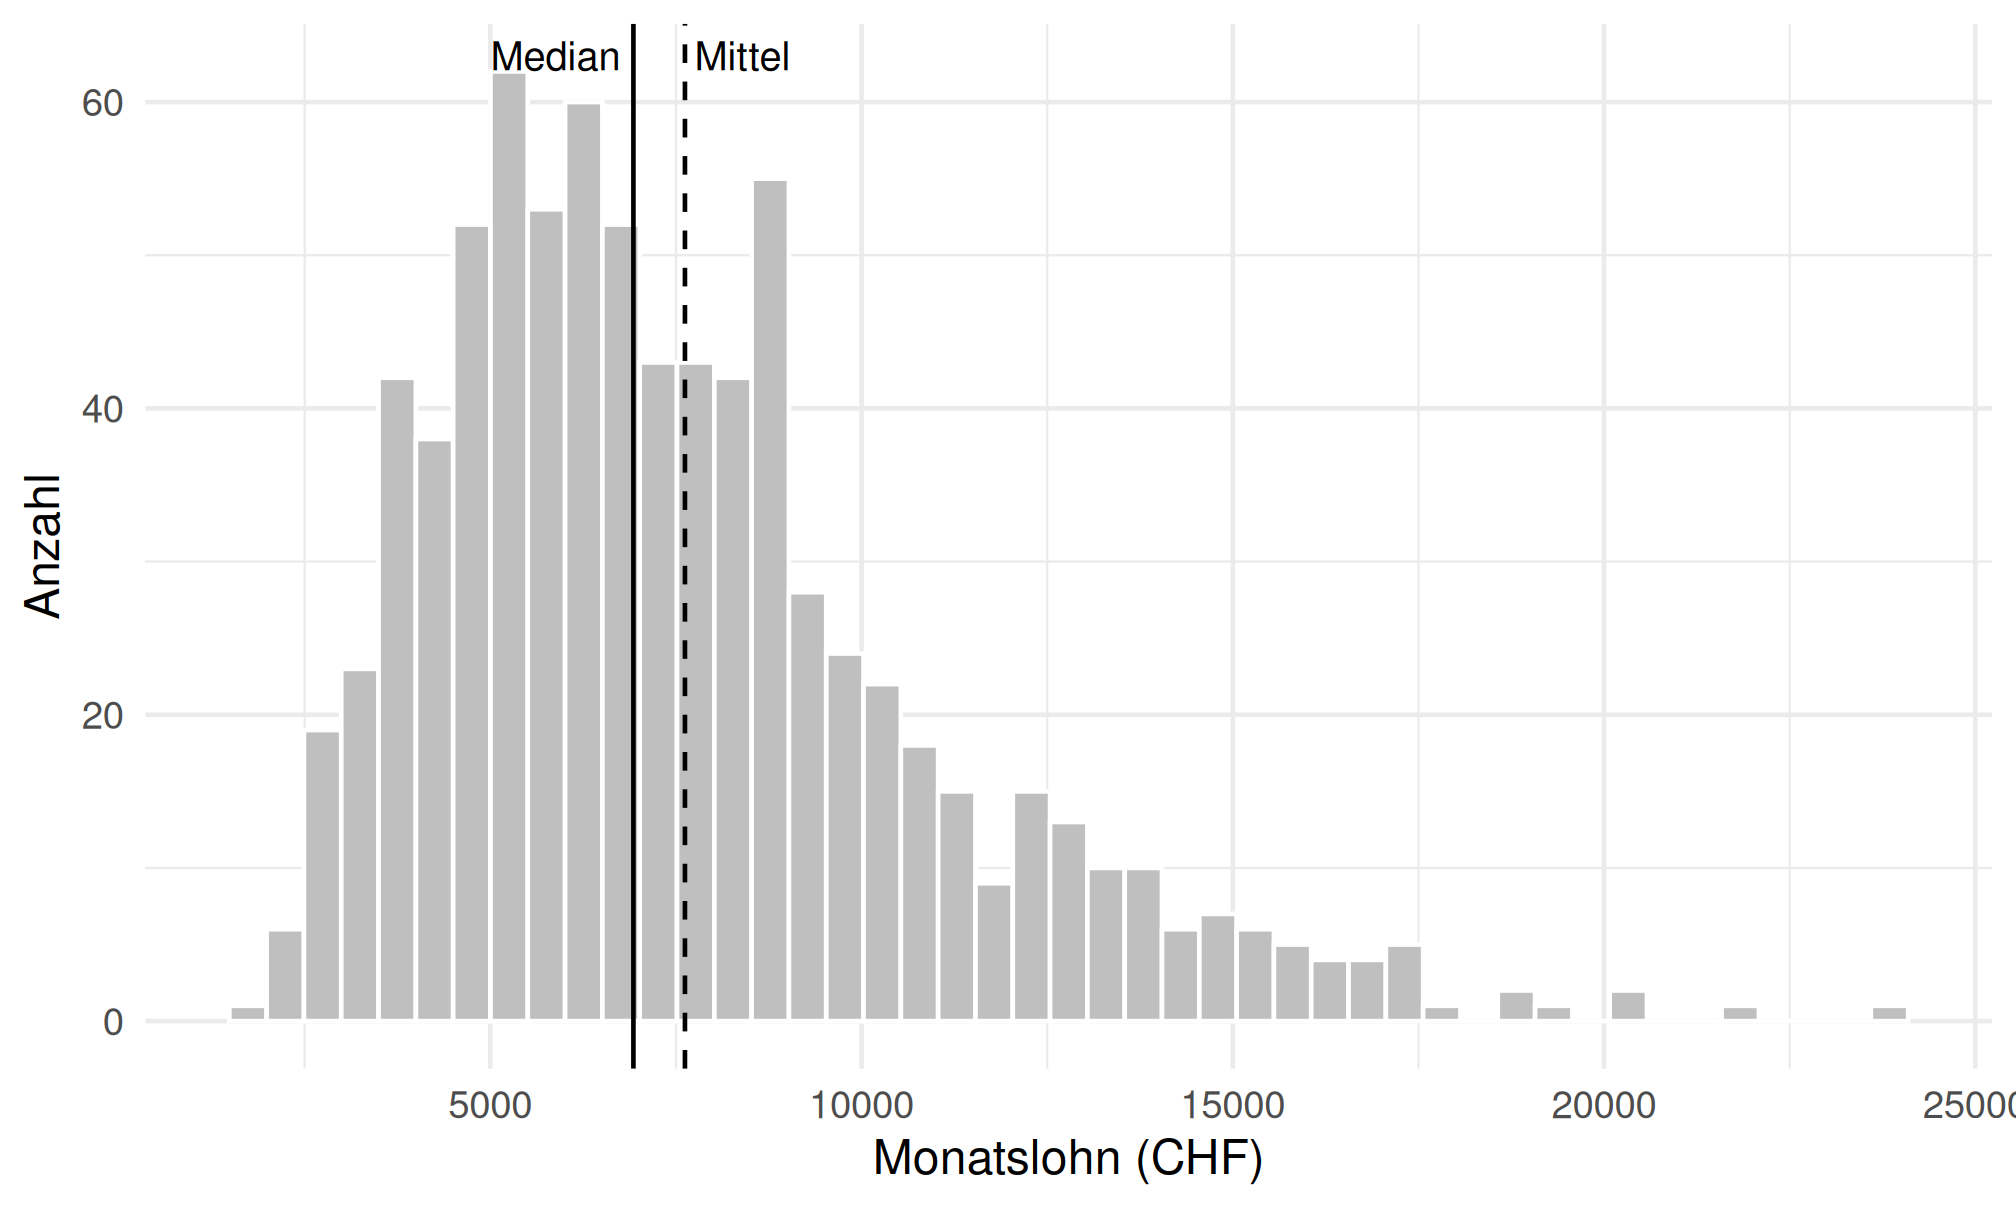
Abbildung 5: Beispiel 5: oben die Boxplots, unten dieselben Daten als Histogramm.

print({"q1": round(q1, 2), "median": round(med, 2), "q3": round(q3, 2),
       "iqr": round(iqr, 2),
       "grenze_unten": round(q1 - 1.5 * iqr, 2),
       "grenze_oben": round(q3 + 1.5 * iqr, 2)})
print("Ausreisser:",
      np.round(np.sort(werte[(werte < q1 - 1.5 * iqr)
                             | (werte > q3 + 1.5 * iqr)]), 1))

for name, daten in [("zweigipflig", zweigipflig),
                    ("gleichmässig", gleichmaessig)]:
    a, b = np.quantile(daten, [0.25, 0.75])
    print(f"{name:14s} Median {np.median(daten):6.2f}  Q1 {a:6.2f}"
          f"  Q3 {b:6.2f}  SD {daten.std(ddof=1):5.2f}")

Output Zeile für Zeile

Die Anatomie an 123 Werten:

Grösse Wert Bedeutung
\(Q_1\) 45.31 untere Kante der Box
Median 50.15 Strich in der Box
\(Q_3\) 56.30 obere Kante
IQR 10.99 Höhe der Box
Grenze unten $45.31 - 1.5 = $ 28.83
Grenze oben $56.30 + 1.5 = $ 72.78
markierte Werte 12, 88, 91 genau die drei absichtlich eingebauten

Die Antennen enden nicht an diesen Grenzen, sondern am letzten tatsächlichen Wert davor. Das ist der häufigste Lesefehler: Die Antennenlänge ist ein Datenwert, kein gerechneter Grenzwert.

Und die beiden Formen im Vergleich:

Median \(Q_1\) \(Q_3\) SD
zweigipflig 51.46 35.10 65.06 15.82
gleichmässig 50.43 36.55 62.22 14.45
Beobachtung Deutung
Die Mediane liegen einen Punkt auseinander Aus zwei Boxplots nebeneinander wäre kein Unterschied ablesbar.
Quartile und SD unterscheiden sich um wenige Prozent Alle fünf Kennzahlen des Boxplots sind praktisch gleich.
Die Histogramme zeigen etwas völlig anderes Zwei getrennte Gipfel gegen eine flache Wanne. Der Boxplot kann das nicht zeigen, weil er nur fünf Zahlen kennt.
Der Median 51.46 bei der zweigipfligen Verteilung liegt in der Lücke zwischen den Gipfeln, an einer Stelle, an der praktisch keine Beobachtung liegt. Eine “typische” Beobachtung ist er damit nicht.

Deshalb gehört zum Boxplot immer ein zweiter Blick auf die Verteilung, Histogramm, Dichtekurve oder bei kleinen Stichproben schlicht die einzelnen Punkte.

Seine Stärke ist der Gruppenvergleich: zwanzig Boxplots nebeneinander sind lesbar, zwanzig Histogramme nicht. Seine Schwäche ist die Form einer einzelnen Verteilung.

Interpretation und Ergebnissatz

Der markierte Wert liegt mehr als das Anderthalbfache des Interquartilsabstands über dem oberen Quartil (Grenze 72.78 bei \(Q_3\) = 56.30 und IQR = 10.99). Das ist eine Konvention zum Hinsehen und kein Test.

Was beim Berichten festzuhalten ist

  • Lagemass und Streuungsmass, nie eines allein.
  • Bei schiefen Daten Median und IQR, bei symmetrischen Mittel und Standardabweichung.
  • Die Stichprobengrösse dazu, denn ohne \(n\) ist keine Streuungsangabe einzuordnen.
  • Ausreisser nicht stillschweigend entfernen, sondern benennen.
  • Beim Sprachwechsel an ddof denken.

Verständnisfragen

Eine Auswertung von 200 Wohnungsmieten meldet ein Mittel von 2140 Franken und einen Median von 1680 Franken. Was folgt daraus?

Es liegt ein Rechenfehler vor
Nein, beide Masse dürfen weit auseinanderliegen. Genau dieser Abstand ist die Information.
Die Verteilung ist rechtsschief
Richtig. Das Mittel liegt über dem Median, also zieht ein langer rechter Rand mit wenigen sehr teuren Wohnungen den Schwerpunkt nach oben.
Die Hälfte der Mieten liegt über 2140 Franken
Das gilt für den Median, nicht für das Mittel. Über 1680 Franken liegt die Hälfte, über 2140 deutlich weniger.
Die Stichprobe ist zu klein
Der Umfang sagt über die Schiefe nichts aus. 200 Beobachtungen sind für diese Aussage reichlich.

Ein Ausreisser lässt die Standardabweichung um den Faktor 54 steigen, den IQR um den Faktor 1.17. Woran liegt der Unterschied?

Die Standardabweichung quadriert die Abweichungen, der IQR ignoriert die äusseren Viertel
Richtig. Ein Wert weit draussen geht quadriert in die Summe ein und beherrscht sie; für die Quartile zählt er nur als eine Beobachtung von vielen.
Die Standardabweichung ist falsch berechnet
Beide sind korrekt; sie messen verschiedene Dinge.
Der IQR ist ungenauer
Er ist unempfindlicher, was hier ein Vorteil und bei symmetrischen Daten ein Nachteil ist: Dort nutzt er nur die Hälfte der Information.

Ein Hersteller garantiert, dass 90 Prozent der Bauteile eine Toleranz von höchstens 0.4 mm haben. Welche Kennzahl prüft diese Zusage direkt?

Das 0.9-Quantil der gemessenen Abweichungen
Richtig. Es ist genau der Wert, unter dem 90 Prozent der Beobachtungen liegen, und lässt sich unmittelbar mit 0.4 mm vergleichen.
Der Mittelwert der Abweichungen
Er sagt nichts darüber, wie viele Teile unter einer bestimmten Schranke liegen. Ein kleines Mittel ist mit vielen Ausreissern vereinbar.
Die Standardabweichung
Sie beschreibt die Streubreite insgesamt. Auf einen Anteil lässt sich daraus nur schliessen, wenn man zusätzlich eine Verteilungsform unterstellt.

Dieselben zehn Messwerte werden in R mit sd(x) und in Python mit np.std(x) ausgewertet. Das R-Ergebnis ist grösser. Woran liegt das?

NumPy teilt ohne Angabe durch \(n\), R durch \(n-1\)
Richtig. Der kleinere Nenner in R ergibt den grösseren Wert. Mit np.std(x, ddof=1) stimmen beide überein und pandas verhält sich von sich aus wie R.
R rundet anders
Die Abweichung entsteht nicht beim Runden, sondern im Nenner der Formel. Sie ist bei kleinem n deutlich sichtbar.
Die Werte wurden unterschiedlich eingelesen
Möglich wäre das, hier ist es aber nicht die Ursache. Der Unterschied tritt auch bei identischen Zahlen auf.

Warum wird bei der Varianz überhaupt durch \(n-1\) geteilt und nicht durch \(n\)?

Damit das Ergebnis grösser wird
Das ist die Folge, nicht der Grund. Die Frage ist, warum die Vergrösserung berechtigt ist.
Weil um das eigene Mittel gerechnet wird und die Streuung sonst systematisch zu klein ausfällt
Richtig. Die Werte streuen um ihren eigenen Mittelwert enger als um jeden anderen Bezugspunkt; die Unterschätzung beträgt genau den Faktor \((n-1)/n\).
Weil ein Wert für den Mittelwert verbraucht wurde und deshalb einer fehlt
Das ist die übliche Kurzformel und als Merkhilfe brauchbar, aber sie erklärt nicht, warum daraus eine Unterschätzung folgt.

Zwei Maschinen produzieren Wellen. Maschine A hat eine Standardabweichung von 0.8 mm bei einem Mitteldurchmesser von 40 mm, Maschine B eine von 2.0 mm bei 200 mm. Welche arbeitet relativ gesehen genauer?

Maschine A, weil 0.8 kleiner ist als 2.0
Der Vergleich der absoluten Streuung übersieht, dass die Teile ganz verschieden gross sind.
Maschine B
Richtig. Der Variationskoeffizient beträgt bei A 0.8/40 = 2 Prozent, bei B 2.0/200 = 1 Prozent. Gemessen an der Teilegrösse streut B halb so stark.
Das lässt sich ohne die Stichprobengrössen nicht sagen
Für den Vergleich der Streuung genügen Mittel und Standardabweichung. Der Umfang beträfe die Genauigkeit der Schätzung, nicht den Vergleich selbst.

Zwei Gruppen haben nahezu identische Boxplots. Was lässt sich daraus schliessen?

Die Verteilungen sind gleich
Nein. Der Boxplot zeigt fünf Kennzahlen, und die können übereinstimmen, während die Form völlig verschieden ist.
Median, Quartile und Spannweite stimmen ungefähr überein, über die Form sagt das nichts
Richtig. In Beispiel 5 unterscheiden sich die Mediane um einen Punkt, während eine der Verteilungen zweigipflig ist und die andere flach.
Eine der beiden Gruppen enthält Ausreisser
Ausreisser wären als einzelne Punkte sichtbar. Hier ist gerade das Fehlen von Unterschieden das Auffällige.

Verlinkte Ressourcen