Ein Prädiktor, Steigung und Achsenabschnitt, Bestimmtheitsmass und Residuen.
Alle Beispiele rechnen mit fest eingetragenen Zahlen. R und Python schätzen dasselbe Modell auf denselben Daten und müssen deshalb dieselben Koeffizienten ausgeben; die Ausgaben unterscheiden sich nur in Anordnung und Benennung.
Kurzsteckbrief
Fragestellung
Wie verändert sich eine metrische Zielgrösse, wenn eine einzelne Einflussgrösse steigt, und wie gut lässt sie sich daraus vorhersagen?
Zielvariable
metrisch
Prädiktoren
genau einer, metrisch oder zweistufig kategorial
Was die Methode liefert
Achsenabschnitt und Steigung mit Konfidenzintervall und p-Wert, Bestimmtheitsmass, Residualstreuung, Residuen für die Diagnostik
R-Funktion
lm(y ~ x, data = df), gelesen mit summary() und confint()
Python-Funktion
smf.ols("y ~ x", data=df).fit(), gelesen mit .summary()
Typische Fragestellungen: Verbrauch aus Laufzeit, Miete aus Fläche, Ertrag aus Düngermenge. Gemeinsam ist ihnen eine metrische Zielgrösse, eine einzige Einflussgrösse und ein Zusammenhang, der im beobachteten Bereich annähernd geradlinig verläuft.
Der Unterschied zur Korrelation ist die Richtung. Die Korrelation beschreibt symmetrisch, wie eng zwei Grössen zusammenhängen. Die Regression legt fest, welche Grösse vorhergesagt wird, und liefert dafür eine Gleichung mit Einheiten.
Sie passt nicht in diesen Fällen:
Situation
Stattdessen
Mehrere Einflussgrössen, oder eine soll kontrolliert werden
Gesucht ist die Gerade, die möglichst nah an allen Punkten liegt. Nah heisst: die Summe der quadrierten senkrechten Abstände zwischen beobachteten und vorhergesagten Werten ist minimal. Quadriert wird, damit sich Abweichungen nach oben und unten nicht aufheben und grosse Abweichungen stärker zählen.
\[y_i = \beta_0 + \beta_1 x_i + \varepsilon_i\]
Bestandteil
Bedeutung
\(y_i\)
beobachteter Wert der Zielvariable
\(\beta_0\)
Achsenabschnitt, erwarteter Wert von \(y\) bei \(x = 0\)
\(\beta_1\)
Steigung, erwartete Änderung von \(y\) je Einheit von \(x\)
\(x_i\)
Wert des Prädiktors
\(\varepsilon_i\)
Residuum, der nicht erklärte Rest, mit Erwartungswert null und konstanter Varianz
Geschätzt wird mit der Methode der kleinsten Quadrate; es gibt eine geschlossene Lösung, also kein Iterieren und keine Konvergenzprobleme. Die geschätzte Gerade geht immer durch den Punkt der beiden Mittelwerte.
Bei genau einem Prädiktor gilt zusätzlich: das Bestimmtheitsmass ist exakt das Quadrat der Korrelation zwischen \(x\) und \(y\), und der p-Wert der Steigung ist derselbe wie der des Pearson-Korrelationstests. Beide Verfahren beantworten dieselbe Frage in verschiedener Sprache.
Voraussetzungen und ihre Prüfung
Voraussetzung
Was sie bedeutet
Prüfung
Folge bei Verletzung
Vorgehen
Linearität
Der Zusammenhang ist im beobachteten Bereich geradlinig
Streudiagramm, Residuen gegen Vorhersage
Steigung ist ein Kompromiss über verschiedene Bereiche und beschreibt keinen davon richtig
Transformation, Polynomterm, Bereich einschränken
Unabhängigkeit
Beobachtungen beeinflussen sich nicht
Erhebungsdesign, bei zeitlicher Ordnung Durbin-Watson
Standardfehler zu klein, p-Werte zu optimistisch
Zeitreihen- oder Mehrebenenmodell
Homoskedastizität
Streuung der Residuen ist über den Vorhersagebereich konstant
Residuenplot, Breusch-Pagan-Test
Schätzwerte bleiben brauchbar, Standardfehler und Intervalle nicht
robuste Standardfehler, Transformation
Normalverteilte Residuen
Residuen streuen annähernd normal
QQ-Plot
betrifft Tests und Intervalle bei kleinem n
Transformation, Bootstrap
Keine einflussreichen Einzelfälle
Kein einzelner Punkt bestimmt die Gerade
Cook-Distanz, Hebelwerte, Streudiagramm
Steigung hängt an einer Beobachtung
Fall prüfen, Modell mit und ohne ihn berichten
Die Voraussetzungen betreffen die Residuen, nicht die Rohdaten. Weder \(x\) noch \(y\) müssen normalverteilt sein; eine rechtsschiefe Zielgrösse ist kein Grund zur Sorge, solange die Residuen es nicht sind.
Output lesen
R, summary(modell):
Grösse
Was sie sagt
Faustregel oder Falle
Call
die geschätzte Formel
prüfen, ob Ziel- und Einflussgrösse nicht vertauscht sind
Residuals
Minimum, Quartile, Median der Residuen
Median deutlich neben null deutet auf Schieflage
(Intercept) Estimate
erwarteter Wert von y bei x gleich null
nur deutbar, wenn null im Datenbereich sinnvoll ist
Estimate des Prädiktors
Steigung, erwartete Änderung je Einheit
in den Einheiten der Variablen
Std. Error
Unsicherheit der Schätzung
wächst mit der Streuung, sinkt mit n und mit der Spannweite von x
t value
Estimate durch Std. Error
Betrag über etwa 2 heisst bei üblichem n signifikant
Pr(>|t|)
p-Wert für die Nullhypothese, dass der Koeffizient null ist
für die Steigung identisch mit dem Pearson-Korrelationstest
Residual standard error
typische Abweichung einer Vorhersage in der Einheit von y
die praktisch nützlichste Gütezahl
Freiheitsgrade
n minus 2
zwei geschätzte Parameter
Multiple R-squared
Anteil der erklärten Streuung
bei einem Prädiktor exakt das Quadrat der Korrelation
Adjusted R-squared
um die Parameterzahl korrigiert
kann negativ werden, wenn der Prädiktor nichts erklärt
F-statistic mit p-Wert
Gesamttest des Modells
bei einem Prädiktor gleichwertig zum t-Test der Steigung
confint()
Konfidenzintervall je Koeffizient
schliesst es null ein, ist der Koeffizient nicht signifikant
Python, modell.summary(), mit den Unterschieden zu R:
Grösse
Was sie sagt
Unterschied zu R
coef, std err, t, P>|t|
wie in R
nur andere Bezeichnung
[0.025 0.975]
Konfidenzintervall
steht direkt in der Tabelle, in R braucht es confint()
R-squared, Adj. R-squared
wie in R
identisch berechnet
Df Residuals, Df Model
Freiheitsgrade
in eigenen Zeilen statt im Fliesstext
AIC, BIC, Log-Likelihood
Kennzahlen für Modellvergleiche
in R über AIC(modell)
Omnibus, Jarque-Bera, Skew, Kurtosis
Normalität der Residuen
in R nicht enthalten, dort der QQ-Plot
Durbin-Watson
Autokorrelation der Residuen
Werte um 2 sind unauffällig
kein Residual standard error
fehlt in der Tabelle
über np.sqrt(modell.mse_resid)
Interpretationsfallen
Der Achsenabschnitt ist meist keine Aussage. Er beschreibt den Fall \(x = 0\), und der liegt oft ausserhalb der Daten. Wer ihn deuten will, zentriert den Prädiktor.
Ein hohes R² heisst nicht, dass das Modell stimmt. Beispiel 3 zeigt das Gegenteil. Angemessenheit beantworten die Residuen, nicht das Bestimmtheitsmass.
Ein niedriges R² heisst nicht, dass das Modell falsch ist. Bei stark streuenden Daten kann ein korrekt spezifiziertes Modell wenig Streuung erklären und die Steigung trotzdem gut schätzen.
Die Steigung ist keine Kausalität. Sie beschreibt, wie sich \(y\) mit \(x\) ändert, nicht warum. Eine dritte, nicht erhobene Grösse kann beides treiben, siehe Korrelation.
Vertauschen ändert das Ergebnis. Die Regression von \(y\) auf \(x\) ist nicht die Umkehrung der Regression von \(x\) auf \(y\), weil jeweils andere Abstände minimiert werden. Die Korrelation dagegen ist symmetrisch.
Vorhersagen nur im beobachteten Bereich. Ausserhalb ist die Linearität nicht geprüft; die Zahl kommt trotzdem und sieht genauso aus.
Konfidenzband und Vorhersageband sind zweierlei. Das schmale Band gilt dem Mittelwert bei gegebenem \(x\), das breite einer einzelnen künftigen Beobachtung.
Ergebnis berichten
Vorlage für den Ergebnissatz:
Eine einfache lineare Regression von [Zielvariable] auf [Prädiktor] ergibt eine Steigung von [Schätzwert] [Einheit] je [Einheit des Prädiktors] (95-Prozent-Konfidenzintervall [unten] bis [oben], t([Freiheitsgrade]) = [t], p = [p]). Das Modell erklärt [R²] der Streuung, die typische Abweichung einer Vorhersage beträgt [Residualstreuung] [Einheit] (n = [n]).
Immer genannt werden Steigung in ihrer Einheit, Konfidenzintervall, Teststatistik mit Freiheitsgraden, p-Wert, R², Residualstreuung und n, dazu welche Voraussetzungen geprüft wurden und mit welchem Ergebnis.
Abgrenzung zu verwandten Methoden
Methode
Wann diese statt der einfachen linearen Regression
Von 24 Anlagen liegen die Betriebsstunden einer Woche und der Verbrauch in Litern vor. Gefragt ist, um wie viele Liter der Verbrauch je zusätzlicher Betriebsstunde steigt, und wie genau sich der Verbrauch aus der Laufzeit vorhersagen lässt.
Beide Grössen sind metrisch, es gibt genau einen Prädiktor, und die Richtung steht fest: Die Laufzeit erklärt den Verbrauch, nicht umgekehrt. Das ist die Standardsituation der einfachen linearen Regression.
Rechnerisch nötig, inhaltlich hier ohne Aussage: Die kleinste beobachtete Laufzeit beträgt 3.2 Stunden, für den Stillstand liegen keine Daten vor.
laufzeit Estimate
2.854
Steigung in Litern je Betriebsstunde
Die zentrale Zahl. Eine Stunde mehr Laufzeit geht im Mittel mit 2.85 Litern mehr Verbrauch einher.
Std. Error der Steigung
0.286
Unsicherheit dieser Schätzung
Rund ein Zehntel der Steigung. Sie sinkt mit mehr Beobachtungen und mit einer breiteren Spanne der Laufzeiten.
t value der Steigung
9.980
Schätzwert geteilt durch Standardfehler
Die Steigung ist knapp zehn Standardfehler von null entfernt.
Pr(>|t|) der Steigung
1.25e-09
p-Wert für “die wahre Steigung ist null”
Praktisch ausgeschlossen. Der Wert des Achsenabschnitts (p = 0.00034) wird meistens gar nicht getestet, weil die Hypothese “y ist null bei x gleich null” selten interessiert.
confint() bzw. [0.025 0.975]
2.261 bis 3.447
plausibler Bereich für die Steigung
Die aussagekräftigste Zeile: Der wahre Effekt liegt vermutlich zwischen 2.3 und 3.4 Litern je Stunde. Diese Spanne, nicht der p-Wert, entscheidet über die praktische Nutzbarkeit.
Residual standard error
6.106 auf 22 Freiheitsgraden
typische Abweichung einer Vorhersage in Litern
Wer den Verbrauch aus der Laufzeit vorhersagt, liegt typischerweise um rund 6 Liter daneben. Die praktisch nützlichste Gütezahl, weil sie in der Einheit der Messung steht.
Freiheitsgrade
22
n minus 2
24 Beobachtungen, zwei geschätzte Parameter.
Multiple R-squared
0.8191
Anteil erklärter Streuung
Rund 82 Prozent der Verbrauchsunterschiede gehen auf die Laufzeit zurück.
Adjusted R-squared
0.8109
um die Parameterzahl korrigiert
Bei einem Prädiktor kaum verschieden. Der Abstand wächst mit der Zahl der Prädiktoren.
F-statistic
99.60 auf 1 und 22 df, p = 1.25e-09
Gesamttest des Modells
Bei genau einem Prädiktor redundant: F ist exakt das Quadrat des t-Werts (9.98² = 99.6), und die p-Werte sind identisch.
Bestimmtheitsmass und Korrelation
Bei einem Prädiktor ist R² exakt das Quadrat der Korrelation. Das lässt sich direkt nachrechnen und ist der beste Merksatz gegen die Verwechslung der beiden Zahlen.
Die Korrelation beträgt 0.905, ihr Quadrat 0.8191, und genau das steht als R² im Modell. Wichtig ist der Unterschied in der Bedeutung: r = 0.905 ist ein Mass für die Enge des Zusammenhangs ohne Einheit, R² = 0.82 ein Anteil an der Streuung. Die Steigung von 2.854 Litern je Stunde sagt dagegen etwas über die Grösse des Effekts, und die drei Zahlen sind nicht ineinander überführbar, ohne die Streuungen zu kennen.
par(mfrow =c(1, 3), mar =c(4, 4, 3, 1))plot(anlagen$laufzeit, anlagen$verbrauch, pch =16, col ="grey30",xlab ="Laufzeit (h)", ylab ="Verbrauch (l)", main ="Daten und Gerade")abline(modell, col ="steelblue", lwd =2)plot(modell, which =1)plot(modell, which =2)par(mfrow =c(1, 1))bptest(modell)
    studentized Breusch-Pagan test

data:  modell
BP = 0.00024274, df = 1, p-value = 0.9876
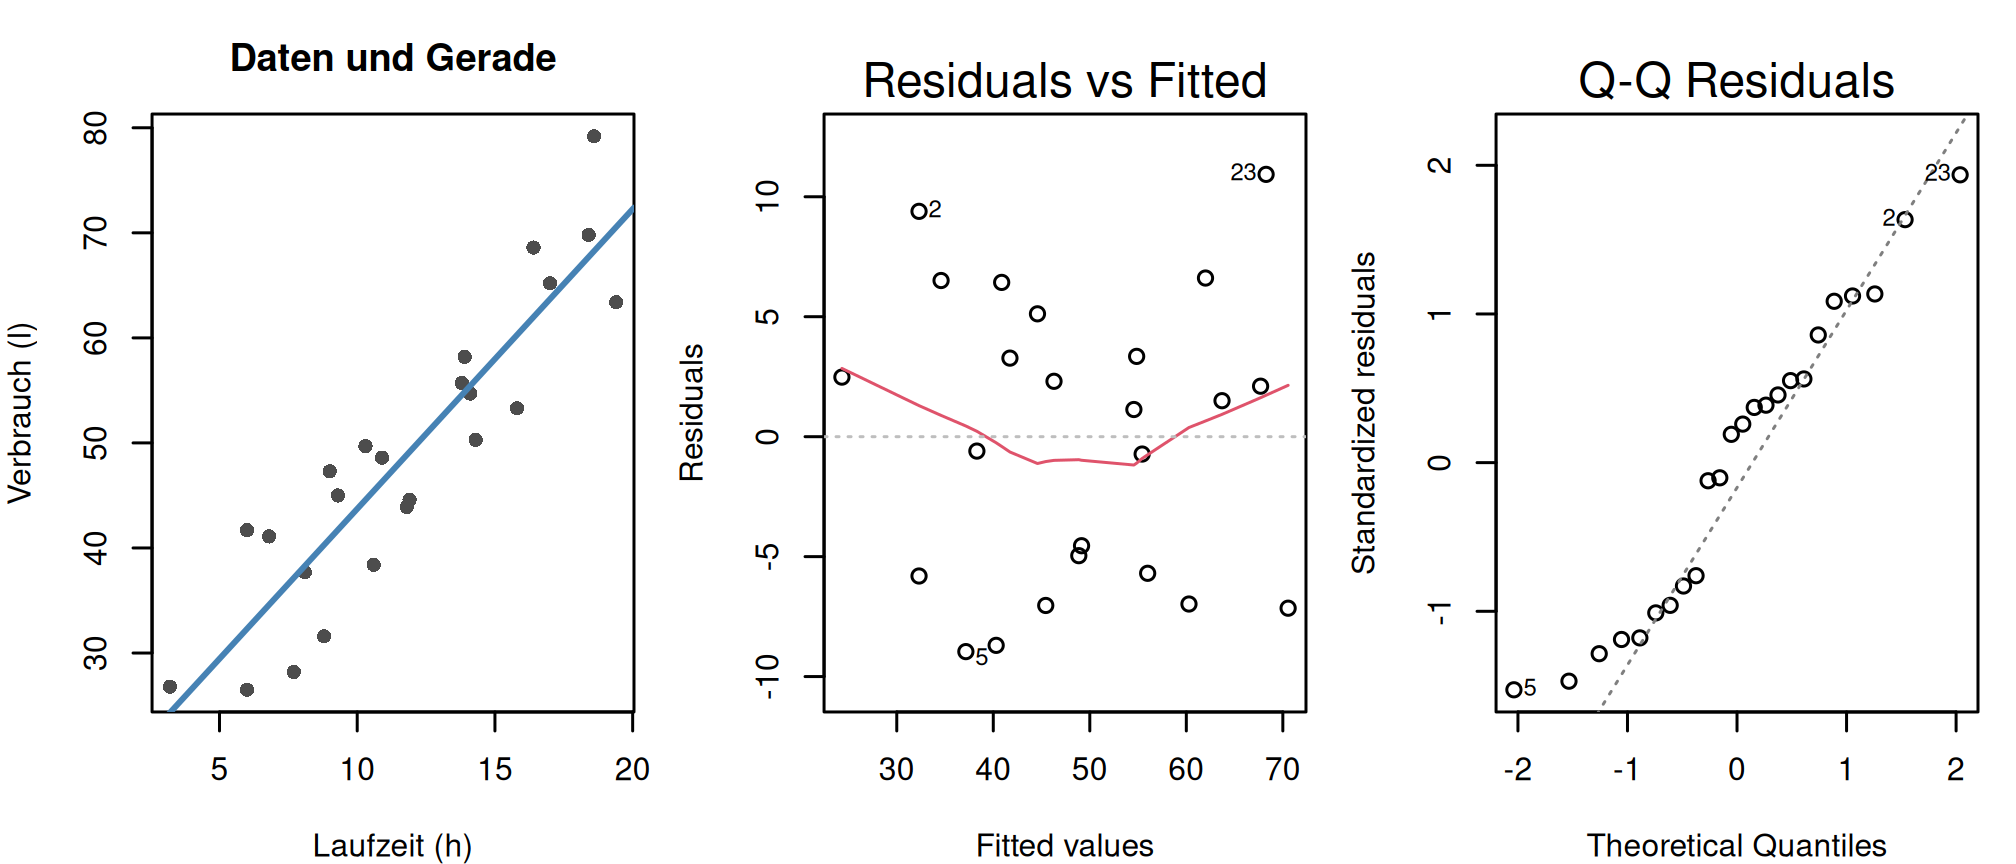
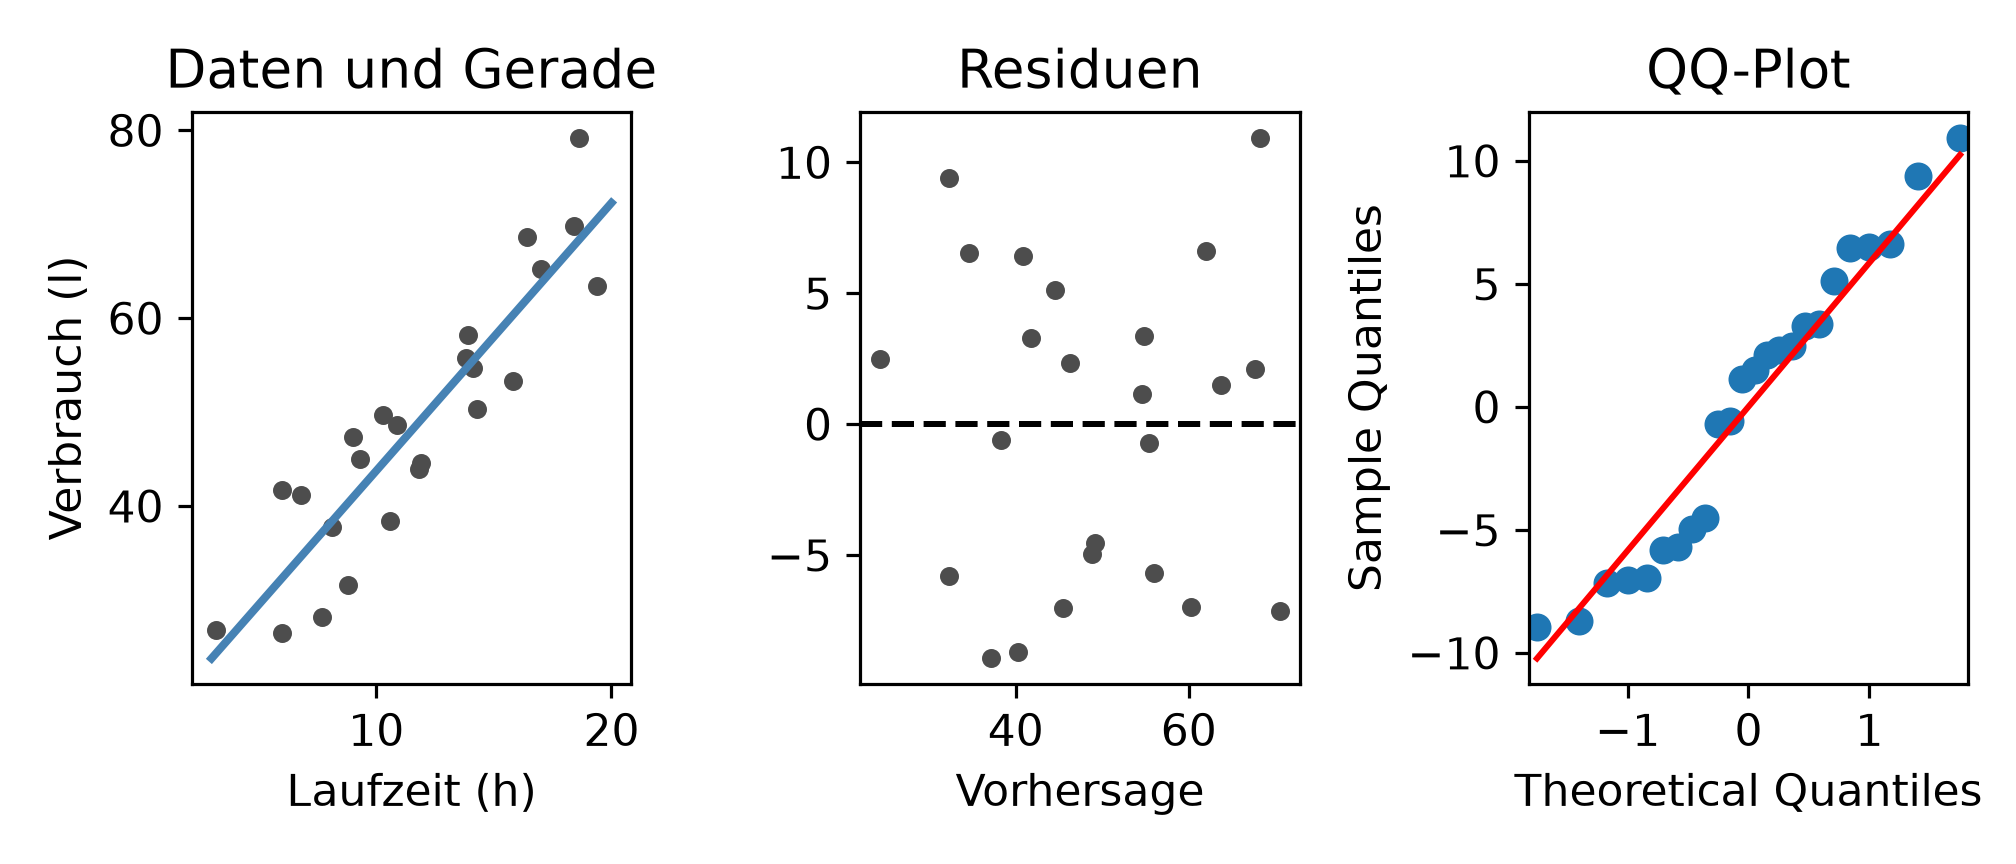
Abbildung 1: Beispiel 1: Streudiagramm mit Gerade, Residuen gegen Vorhersage, QQ-Plot der Residuen.
Links steigen die Punkte gleichmässig an, ohne Bogen. In der Mitte streuen die Residuen strukturlos um die Nulllinie, und der Streubereich bleibt von links nach rechts etwa gleich breit. Rechts liegen die Punkte nah an der Geraden. Der Breusch-Pagan-Test bestätigt das mit einem p-Wert von 0.988: kein Hinweis auf ungleiche Streuung. Ein grosser p-Wert ist hier die gute Nachricht, weil die Nullhypothese die konstante Streuung ist.
Interpretation und Ergebnissatz
Drei Zahlen tragen die Aussage, und sie beantworten drei verschiedene Fragen. Die Steigung von 2.854 Litern je Stunde beantwortet “wie stark”. Das Intervall von 2.26 bis 3.45 beantwortet “wie sicher”. Die Residualstreuung von 6.1 Litern beantwortet “wie brauchbar für eine einzelne Vorhersage”. Ein Modell kann bei allen drei Fragen unterschiedlich gut abschneiden, und der p-Wert beantwortet keine davon.
Der Verbrauch steigt mit der Betriebszeit: Je zusätzlicher Betriebsstunde nimmt er im Mittel um 2.85 Liter zu (95-Prozent-Konfidenzintervall 2.26 bis 3.45, t(22) = 9.98, p < 0.001). Das Modell erklärt 82 Prozent der Streuung, die typische Abweichung einer Vorhersage beträgt 6.1 Liter (n = 24). Residuen und Streudiagramm zeigen keine Auffälligkeiten.
Frage und Datenlage
Aus derselben Halle liegen für 20 Tage die Hallentemperatur in Grad Celsius und der Tagesverbrauch vor. Die Vermutung lautet, dass wärmere Tage den Verbrauch treiben. Das Beispiel zeigt, wie ein Nullbefund aussieht und was er nicht bedeutet.
Rechnerisch steigt der Verbrauch um knapp einen Liter je Grad. Der Wert allein sagt nichts, solange die Unsicherheit fehlt.
Std. Error
1.375
Grösser als die Steigung selbst. Damit ist die Schätzung von reinem Rauschen nicht zu unterscheiden.
t value
0.706
Weniger als ein Standardfehler Abstand zur Null.
Pr(>|t|)
0.489
Ein Wert dieser Grösse entsteht bei fehlendem Zusammenhang in rund der Hälfte aller Stichproben.
Konfidenzintervall
-1.919 bis 3.859
Die wichtigste Zeile. Das Intervall enthält die Null, ist aber fast sechs Liter je Grad breit: Ein deutlicher Effekt in beide Richtungen bleibt mit diesen Daten vereinbar.
Multiple R-squared
0.0269
Nicht einmal drei Prozent der Streuung sind erklärt.
Adjusted R-squared
-0.0271
Negativ, und das ist kein Fehler. Das korrigierte Mass zieht für jeden Parameter etwas ab; erklärt der Prädiktor weniger, als ein zufälliger Prädiktor im Mittel erklären würde, rutscht es unter null. Ein sicheres Zeichen dafür, dass der Prädiktor nichts beiträgt.
Residual standard error
14.163 auf 18 Freiheitsgraden
Die Vorhersage aus der Temperatur ist kaum besser als der blosse Mittelwert des Verbrauchs.
F-statistic
0.498, p = 0.489
Wie erwartet identisch mit dem t-Test der Steigung.
Interpretation und Ergebnissatz
Der Nullbefund erlaubt genau eine Aussage: In diesen Daten ist kein Zusammenhang erkennbar. Er erlaubt nicht die Aussage, dass keiner existiert. Der Unterschied steht im Konfidenzintervall, das Effekte bis zu 3.9 Litern je Grad weiterhin zulässt. Bei 20 Beobachtungen und einer Temperaturspanne von nur acht Grad ist das kein Wunder: Die Genauigkeit der Steigung hängt nicht nur an n, sondern auch an der Spannweite des Prädiktors.
Wer diesen Zusammenhang ernsthaft prüfen will, erhebt mehr Tage und vor allem Tage mit stärker unterschiedlichen Temperaturen.
Für die Hallentemperatur ergibt sich kein nachweisbarer Zusammenhang mit dem Tagesverbrauch (Steigung 0.97 Liter je Grad, 95-Prozent-Konfidenzintervall -1.92 bis 3.86, t(18) = 0.71, p = 0.49, R² = 0.03, n = 20). Das Intervall lässt Effekte in beide Richtungen zu; ein Einfluss ist damit nicht ausgeschlossen, sondern unbelegt.
Frage und Datenlage
An 24 Werkzeugen wurde die Laufzeit in tausend Stunden und der Verschleiss in Mikrometern gemessen. Verschleiss wächst bei vielen Prozessen überproportional, weil eine bereits abgenutzte Schneide schneller weiter abnutzt. Genau dieser Fall ist gefährlich, weil er sich in den Kennzahlen gut versteckt.
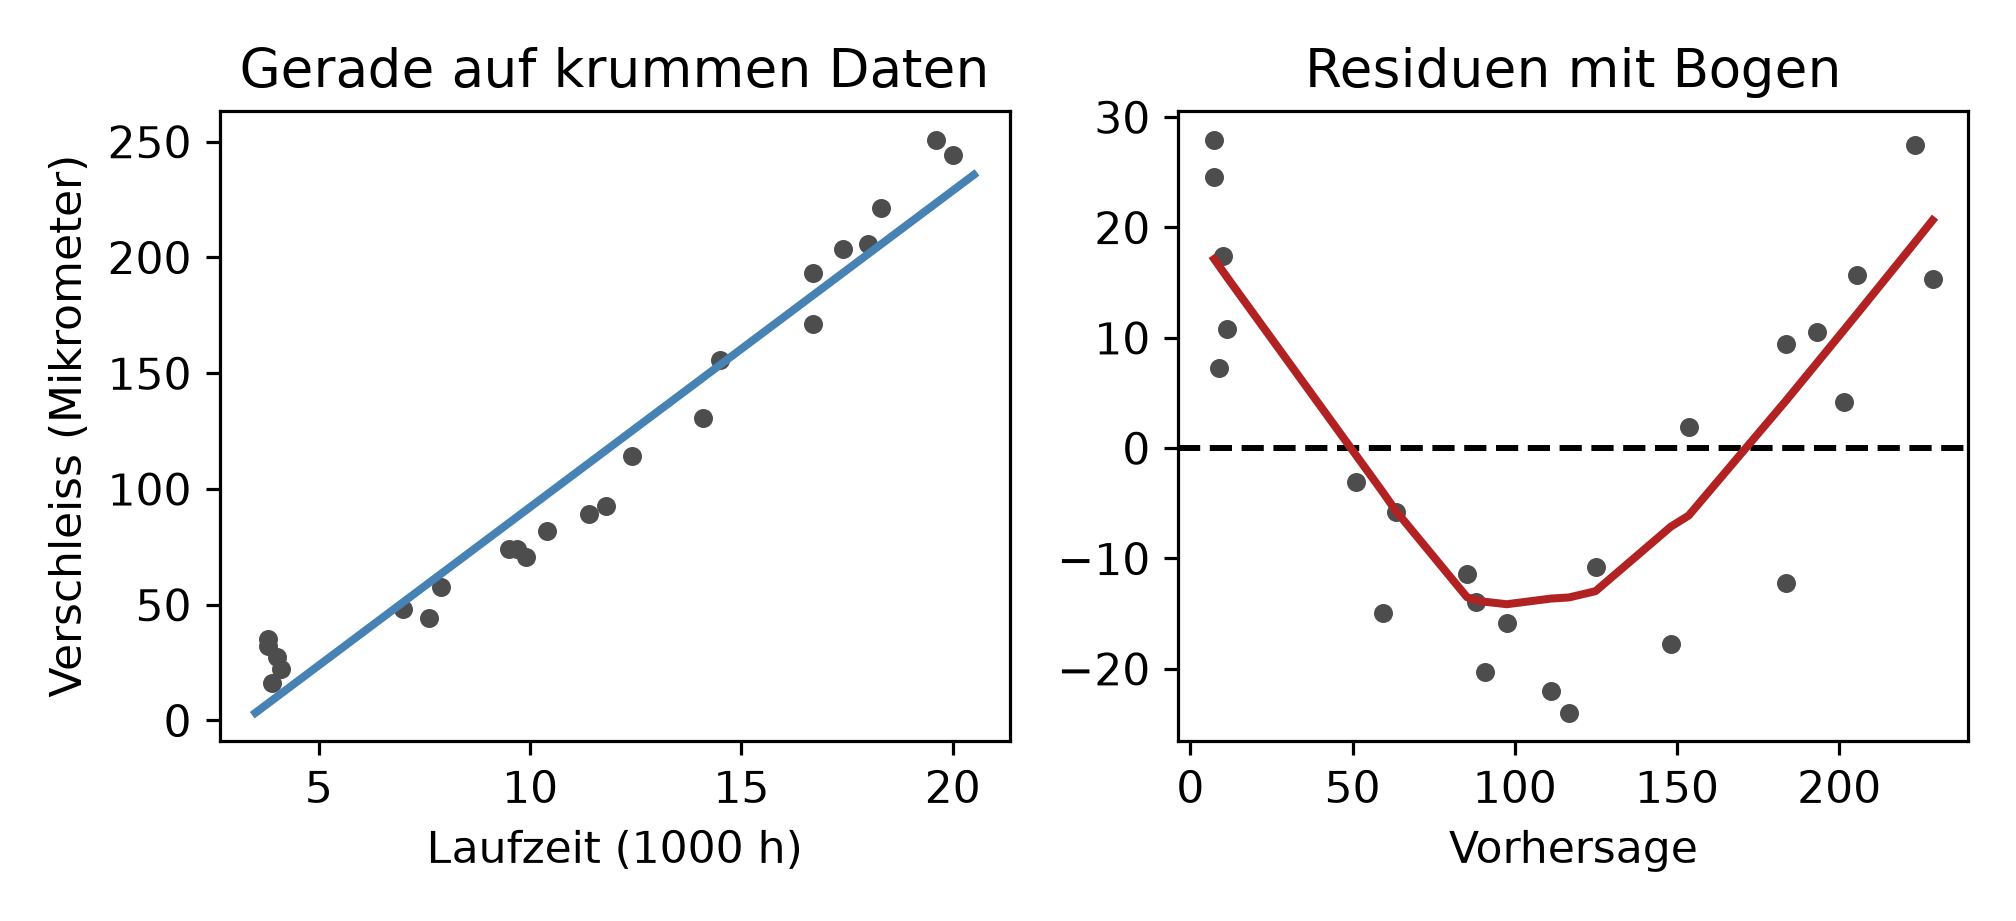
Abbildung 4: Beispiel 3: dieselbe Gegenüberstellung in Python.
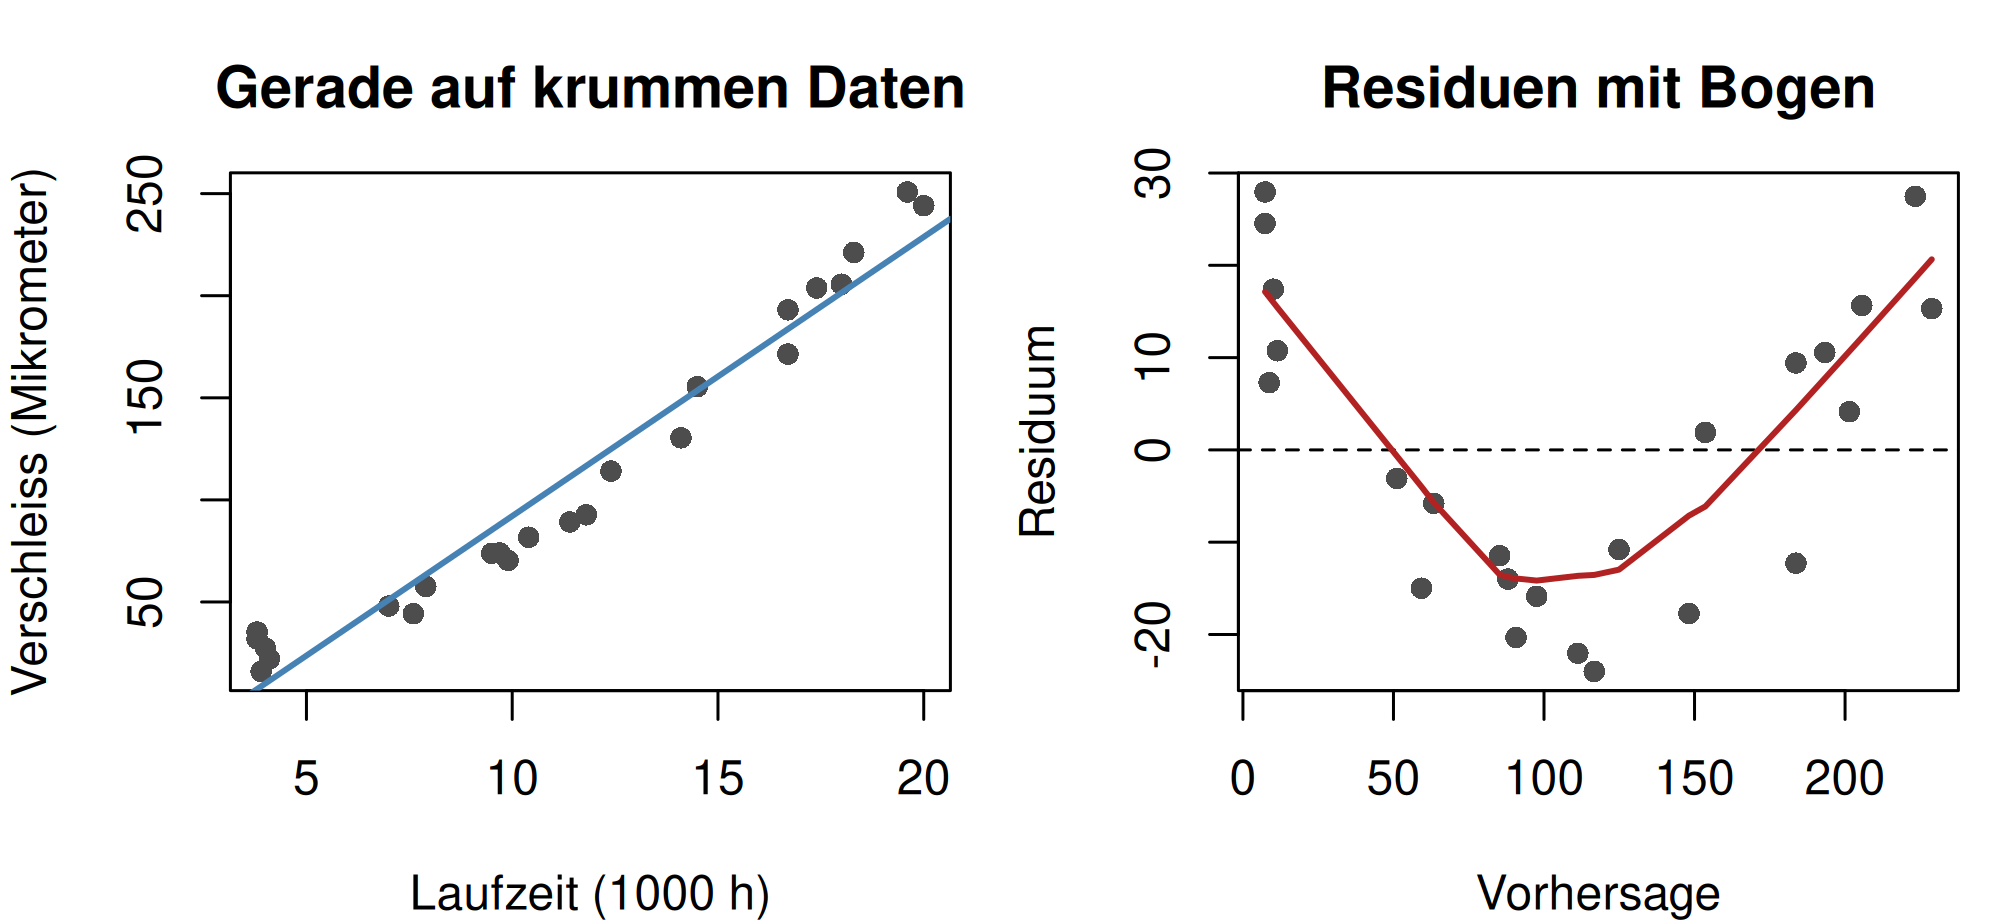
Der Residuenplot zeigt das Muster, das eine übersehene Krümmung immer erzeugt: Die Residuen sind an beiden Rändern positiv und in der Mitte negativ, die Glättungslinie bildet einen deutlichen Bogen. Im linken Bild ist zu sehen, warum: Die Gerade liegt bei kleinen und grossen Laufzeiten über den Punkten und im mittleren Bereich darunter.
Die Residualstreuung sinkt auf weniger als die Hälfte, und der Achsenabschnitt wird physikalisch sinnvoll. Am R² wäre der Unterschied kaum aufgefallen: 0.95 gegen 0.99 sieht nach Feinschliff aus, ist aber der Unterschied zwischen falschem und passendem Modell.
Bemerkenswert im korrigierten Modell: Der lineare Term ist mit p = 0.97 völlig unbedeutend, der quadratische mit p < 0.001 hochsignifikant. Der lineare Term bleibt trotzdem im Modell. Polynomterme werden von unten aufgebaut und nicht einzeln nach p-Werten entfernt, sonst hängt das Ergebnis am willkürlich gewählten Nullpunkt der x-Achse.
Interpretation und Ergebnissatz
Die Lehre aus diesem Beispiel: Kennzahlen erkennen das Problem nicht. R² war hoch, der p-Wert winzig, und beides blieb auch dann so, als das Modell nachweislich falsch war. Erkannt wird die Fehlspezifikation am Residuenplot und an der Plausibilitätsprüfung des Achsenabschnitts. Deshalb wird der Residuenplot angesehen, bevor irgendeine Zahl berichtet wird.
Ein rein lineares Modell beschreibt den Zusammenhang nicht angemessen; die Residuen zeigen eine deutliche Krümmung und der Achsenabschnitt ist negativ. Berichtet wird das Modell mit quadratischem Term (R² = 0.99, Residualstreuung 7.4 Mikrometer, n = 24); der quadratische Koeffizient beträgt 0.593 Mikrometer je (1000 h)² (p < 0.001).
Frage und Datenlage
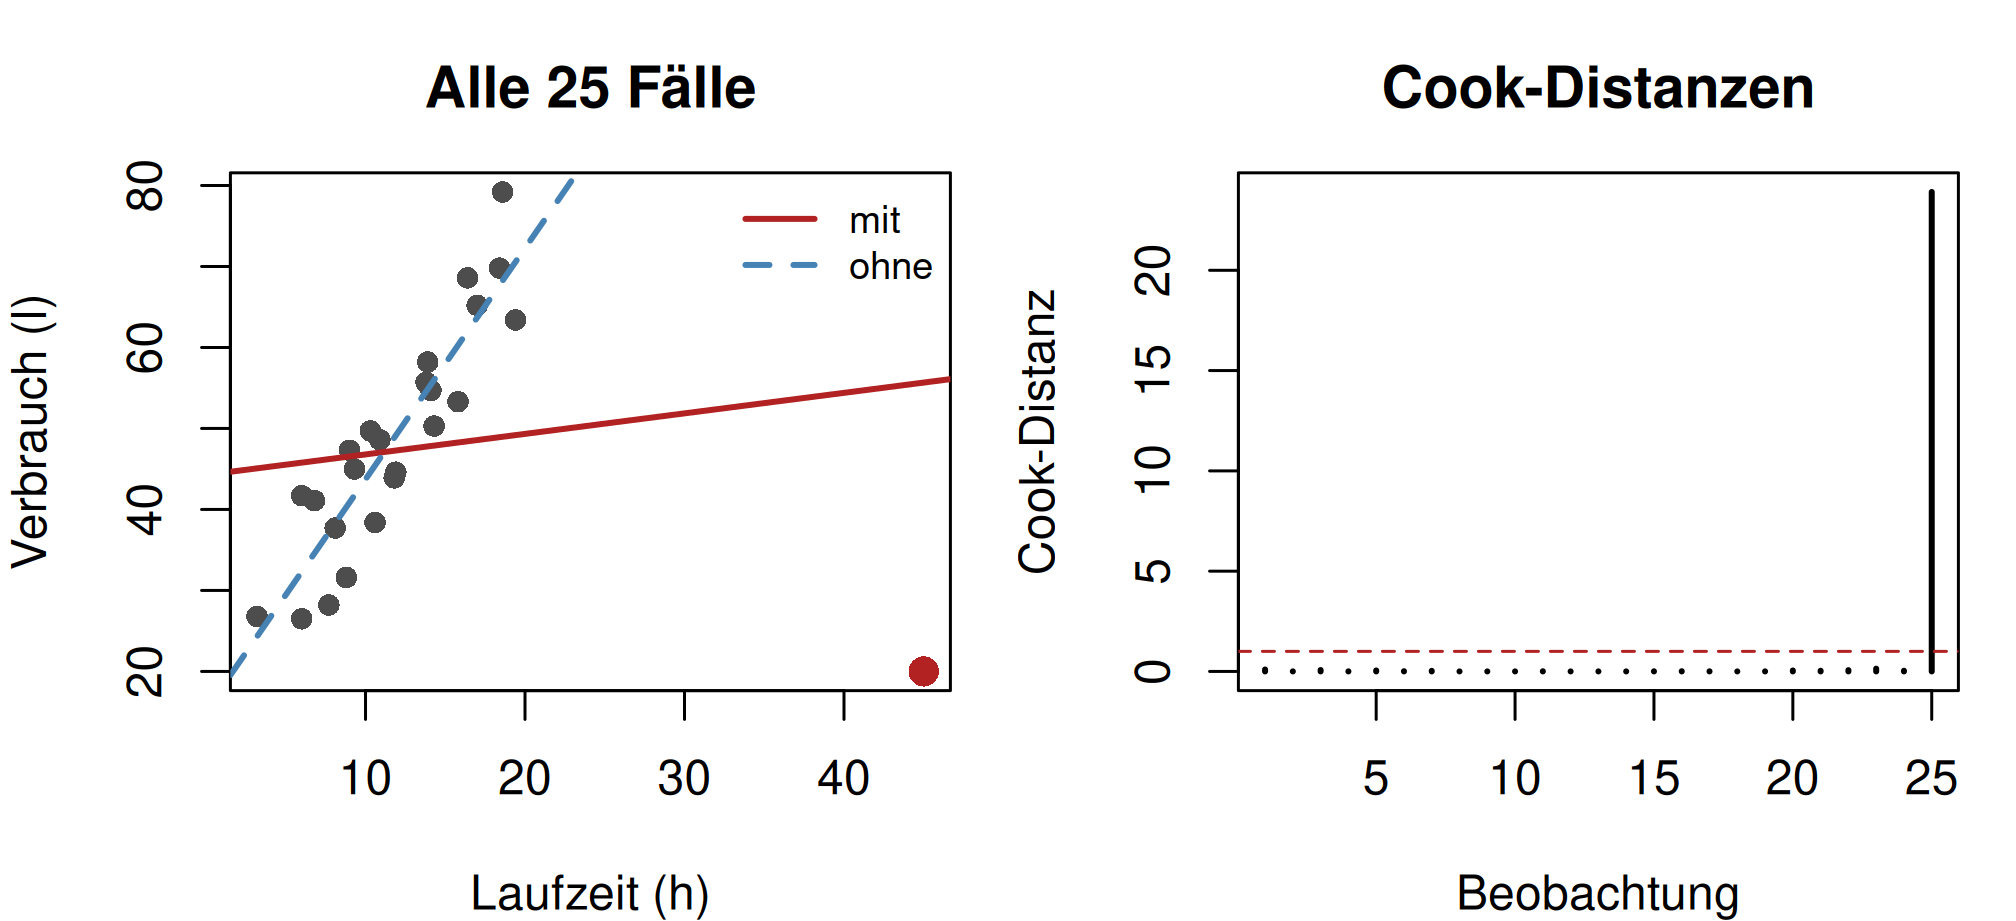
Zu den 24 Anlagen aus Beispiel 1 kommt eine weitere hinzu: 45 Betriebsstunden bei nur 20 Litern Verbrauch. Der Wert stammt aus einer Anlage, deren Zähler in der Woche ausgefallen war. Er liegt weit rechts ausserhalb der übrigen Laufzeiten und weit unter der Geraden.
Der Effekt verschwindet fast vollständig. Eine einzige von 25 Beobachtungen dreht die inhaltliche Aussage um.
Std. Error
0.286
0.387
Auch die Unsicherheit steigt.
Pr(>|t|)
< 0.001
0.519
Aus einem hochsignifikanten Befund wird ein Nullbefund.
Konfidenzintervall
2.26 bis 3.45
-0.55 bis 1.05
Die beiden Intervalle überschneiden sich nicht einmal.
Multiple R-squared
0.8191
0.0183
Von 82 Prozent auf unter 2 Prozent.
Cook-Distanz des Falls
23.906
Sie misst, wie stark sich alle Vorhersagen ändern, wenn genau dieser Punkt weggelassen wird. Werte über 1 gelten als auffällig; 23.9 ist eine Grössenordnung darüber.
Hebelwert des Falls
0.711
Der Hebel misst, wie extrem der x-Wert liegt. Der Durchschnitt beträgt hier 0.08 (zwei Parameter geteilt durch 25 Beobachtungen); dieser Punkt hat fast den neunfachen Wert.
Hebel und Cook-Distanz sind nicht dasselbe. Ein Punkt mit hohem Hebel liegt weit aussen auf der x-Achse, richtet aber keinen Schaden an, solange er auf der Linie der übrigen liegt. Gefährlich wird die Kombination: extremer x-Wert und Abweichung nach oben oder unten. Genau die misst die Cook-Distanz.
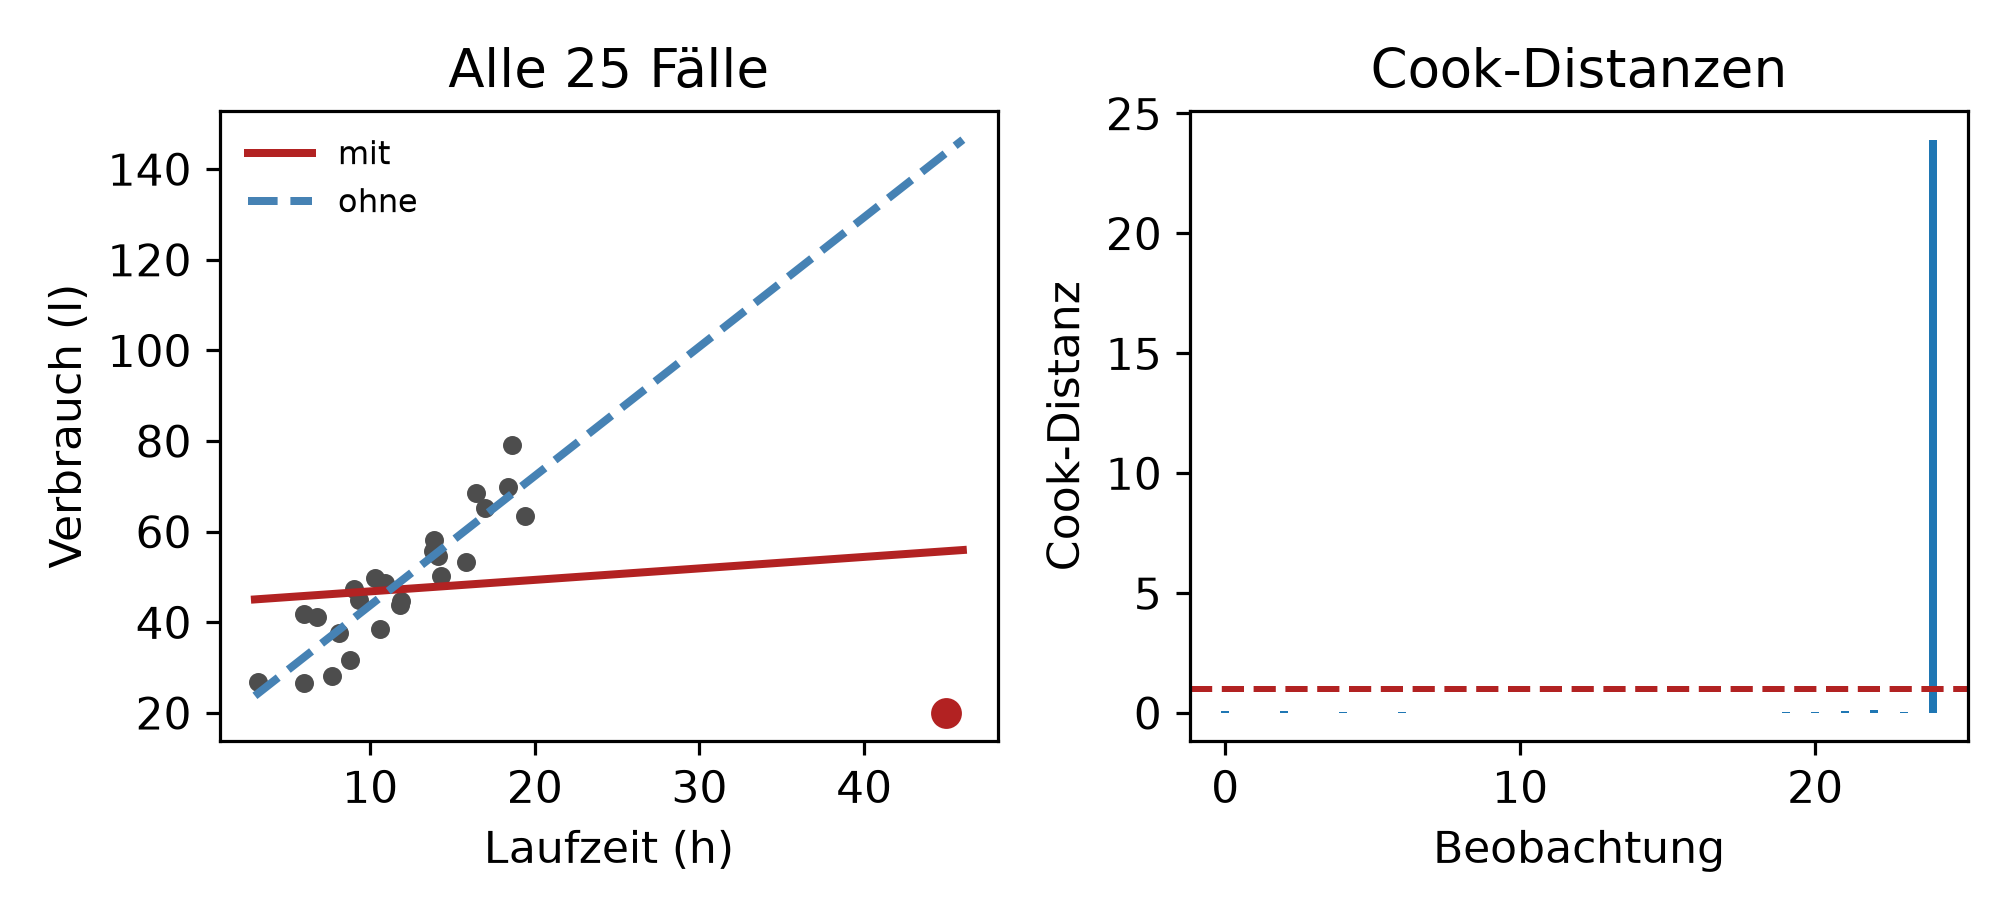
Abbildung 6: Beispiel 4: dieselbe Gegenüberstellung in Python.
Im linken Bild ist zu sehen, wie der eine Punkt die Gerade zu sich herunterzieht. Rechts ragt seine Cook-Distanz so weit über die Schwelle von 1 hinaus, dass die übrigen 24 Werte optisch auf der Nulllinie verschwinden.
Interpretation und Ergebnissatz
Entscheidend ist, was jetzt nicht passiert: Der Punkt wird nicht kommentarlos gelöscht, weil er stört. Die Reihenfolge lautet erstens Ursache klären, zweitens entscheiden, drittens beides berichten.
Befund zur Ursache
Vorgehen
Nachweislicher Messfehler, hier der ausgefallene Zähler
Fall ausschliessen, Ausschluss und Begründung im Bericht nennen
Gültiger, aber andersartiger Betriebszustand
getrennt modellieren oder als zusätzliche Variable aufnehmen
Gültiger Wert, Ursache unklar
Modell mit und ohne den Fall berichten und die Abhängigkeit offenlegen
Im Beispiel ist die Ursache bekannt, der Fall fliegt heraus, und der Bericht sagt das ausdrücklich. Wäre die Ursache unbekannt geblieben, müsste im Bericht stehen, dass die gesamte Aussage an einer einzigen Beobachtung hängt.
Von 25 Anlagen wurde eine ausgeschlossen, deren Verbrauchszähler nachweislich ausgefallen war (45 Betriebsstunden bei 20 Litern; Cook-Distanz 23.9, Hebelwert 0.71). Ohne sie steigt der Verbrauch je Betriebsstunde um 2.85 Liter (95-Prozent-Konfidenzintervall 2.26 bis 3.45, p < 0.001, R² = 0.82, n = 24); unter Einschluss des Falls wäre die Steigung auf 0.25 Liter gefallen und nicht mehr nachweisbar gewesen (p = 0.52).
Verständnisfragen
Ein Modell liefert R² = 0.95, der Residuenplot zeigt einen deutlichen Bogen. Was folgt?
Das Modell ist gut, R² ist hoch
R² misst erklärte Streuung, nicht Angemessenheit. Ein falsches Modell kann viel Streuung erklären, siehe Beispiel 3.
Das Modell ist falsch spezifiziert, trotz hohem R²
Richtig. Der Bogen zeigt eine übersehene Krümmung. Die Steigung ist ein Kompromiss und stimmt in keinem Bereich; Vorhersagen an den Rändern liegen daneben.
Die Daten enthalten Ausreisser
Ausreisser zeigen sich als einzelne weit entfernte Punkte, nicht als durchgehendes Muster.
In Beispiel 2 gibt R ein Adjusted R-squared von -0.0271 aus. Ist das ein Rechenfehler?
Nein, das korrigierte Mass kann negativ werden
Richtig. Es zieht für jeden geschätzten Parameter etwas ab. Erklärt der Prädiktor weniger, als ein beliebiger Prädiktor im Mittel erklären würde, rutscht der Wert unter null. Das ist ein deutliches Zeichen dafür, dass er nichts beiträgt.
Ja, ein Anteil kann nicht negativ sein
Das gewöhnliche R² ist ein Anteil und liegt zwischen 0 und 1. Das korrigierte ist ein Schätzer und nicht auf diesen Bereich beschränkt.
Ja, die Daten müssen fehlerhaft sein
Die Daten sind in Ordnung, nur der Prädiktor ist es nicht.
Die Cook-Distanz einer Beobachtung beträgt 23.9, ihr Hebelwert 0.71. Was ist der Unterschied zwischen beiden Zahlen?
Der Hebel misst, wie extrem der x-Wert liegt, die Cook-Distanz, wie stark der Punkt das Ergebnis verändert
Richtig. Ein Punkt mit hohem Hebel ist harmlos, solange er auf der Linie der übrigen liegt. Gefährlich ist die Kombination aus extremem x-Wert und Abweichung von der Geraden, und genau die misst die Cook-Distanz.
Beide messen dasselbe in verschiedener Skalierung
Dann könnte es keinen Punkt mit hohem Hebel und kleiner Cook-Distanz geben, den gibt es aber.
Der Hebel bezieht sich auf y, die Cook-Distanz auf x
Genau umgekehrt gedacht: Der Hebel hängt allein an den x-Werten.
In Beispiel 1 beträgt R² 0.82 und die Residualstreuung 6.1 Liter. Welche der beiden Zahlen sagt mehr über die Nutzbarkeit einer einzelnen Vorhersage?
Die Residualstreuung, weil sie in Litern angegeben ist
Richtig. Sie sagt unmittelbar, um wie viel eine Vorhersage typischerweise danebenliegt. Ob 6 Liter viel oder wenig sind, entscheidet der Anwendungsfall.
R², weil es die Modellgüte misst
R² ist relativ zur Gesamtstreuung. Bei sehr unterschiedlichen Laufzeiten wird es hoch, ohne dass die einzelne Vorhersage genauer würde.
Beide gleichermassen
Sie hängen zusammen, beantworten aber verschiedene Fragen: R² den Anteil erklärter Streuung, die Residualstreuung den typischen Fehler.
Der Achsenabschnitt beträgt 15.2 Liter, die kleinste beobachtete Laufzeit 3.2 Stunden. Was darf berichtet werden?
Bei stillstehender Anlage werden 15.2 Liter verbraucht
Der Wert null liegt ausserhalb des beobachteten Bereichs; für ihn ist das Modell nicht geprüft.
Der Achsenabschnitt ist ein Rechenwert und hier nicht inhaltlich deutbar
Richtig. Wer eine deutbare Zahl braucht, zentriert die Laufzeit, dann beschreibt der Achsenabschnitt den Verbrauch bei mittlerer Laufzeit.
Der Wert ist ein Hinweis auf einen Modellfehler
Er ist weder falsch noch auffällig, nur ausserhalb des Bereichs, für den Daten vorliegen. Auffällig wäre er erst, wenn er unmöglich ist, wie der negative Verschleiss in Beispiel 3.
Der p-Wert der Steigung beträgt 1.25e-09, der p-Wert des Pearson-Korrelationstests für dieselben Daten ebenfalls. Zufall?
Nein, bei einem Prädiktor sind die beiden Tests identisch
Richtig. Der t-Test der Steigung und der Pearson-Korrelationstest prüfen dieselbe Nullhypothese und liefern dieselbe Teststatistik. Gleiches gilt für den F-Test des Gesamtmodells, dessen Wert genau das Quadrat des t-Werts ist.
Ja, das ist eine zufällige Übereinstimmung
Sie tritt bei jedem Datensatz mit einem Prädiktor auf.
Nein, weil beide Verfahren Normalverteilung voraussetzen
Die gemeinsame Voraussetzung erklärt nicht, warum die Zahlen exakt gleich sind.