Wilcoxon, Mann-Whitney und Kruskal-Wallis als Ausweichverfahren.
Alle Beispiele rechnen mit fest eingetragenen Zahlen, damit R und Python dieselben Daten sehen und jeder Wert im Text nachprüfbar ist. Wo sich die Ausgaben trotzdem unterscheiden, liegt es an der Behandlung von Bindungen; das wird bei Beispiel 1 ausführlich erklärt.
Kurzsteckbrief
Fragestellung
Unterscheiden sich Gruppen, ohne dass Mittelwerte und Normalverteilung vorausgesetzt werden?
Zielvariable
metrisch oder ordinal
Was die Methoden liefern
Teststatistik, p-Wert, Effektmasse auf Rangbasis; in R zusätzlich eine geschätzte Verschiebung mit Konfidenzintervall
R-Funktionen
wilcox.test() für eine und zwei Stichproben sowie gepaart, kruskal.test() für mehr als zwei Gruppen
Python-Funktionen
pg.mwu(), pg.wilcoxon(), pg.kruskal(), alternativ stats.mannwhitneyu(), stats.wilcoxon(), stats.kruskal()
Die Namensgebung ist eine häufige Fehlerquelle. Mann-Whitney-U und Wilcoxon-Rangsummentest sind dasselbe Verfahren für zwei unabhängige Gruppen; U und W lassen sich ineinander umrechnen. Der Wilcoxon-Vorzeichen-Rangtest dagegen ist ein anderes Verfahren, für eine Stichprobe oder gepaarte Daten. In R heissen beide wilcox.test(), und nur das Argument paired unterscheidet sie. In Python sind es zwei Funktionen: mwu() und wilcoxon().
Wann diese Methode, wann nicht
Typische Anlässe: eine ordinale Zielgrösse wie eine Bewertungsskala, eine kleine und deutlich schiefe Stichprobe, oder einzelne Extremwerte, an denen ein Mittelwertvergleich scheitert.
Ein Rangtest ersetzt die Rohwerte durch ihre Reihenfolge. Damit verliert er die Abstände zwischen den Werten und gewinnt Unempfindlichkeit gegenüber Ausreissern und Verteilungsform. Beides gehört zusammen: Was ihn robust macht, ist genau das, was ihm die Aussage über Grössen nimmt.
Mehrere Einflussgrössen sollen berücksichtigt werden
Regression, gegebenenfalls mit transformierter Zielgrösse
Gruppen unterscheiden sich vor allem in der Streuung
kein Rangtest; die Frage ist eine andere, siehe Interpretationsfallen
Grundidee und Modell
Alle Werte werden gemeinsam sortiert und durch ihren Rang ersetzt. Getestet wird dann, ob sich die Ränge zwischen den Gruppen anders verteilen, als es der Zufall erwarten liesse.
Beim Mann-Whitney-U-Test zählt man dazu, wie oft ein Wert der einen Gruppe einen Wert der anderen übertrifft:
Anzahl der Paarvergleiche, die die erste Gruppe gewinnt, Gleichstände zählen halb
\(n_1 n_2\)
Anzahl aller Paarvergleiche
\(U / (n_1 n_2)\)
Anteil gewonnener Vergleiche; bei Gleichheit der Gruppen liegt er bei 0.5
Daraus folgt die korrekte Nullhypothese: Ein zufällig gezogener Wert der einen Gruppe ist genauso oft grösser wie kleiner als ein zufällig gezogener Wert der anderen. Das ist nicht dasselbe wie “die Mediane sind gleich”, auch wenn es oft so verkürzt wird; die beiden Aussagen fallen nur zusammen, wenn die Verteilungen dieselbe Form haben.
Der Vorzeichen-Rangtest arbeitet auf den Differenzen zum Sollwert oder zwischen den beiden Messungen. Er rangiert deren Beträge und summiert die Ränge der positiven Differenzen zu \(V\) beziehungsweise \(W\). Nur wenn positive und negative Abweichungen gleich häufig und gleich gross sind, liegt diese Summe in der Mitte.
Kruskal-Wallis verallgemeinert den Mann-Whitney-Test auf mehr als zwei Gruppen und ist die Rangvariante der Varianzanalyse.
Voraussetzungen und ihre Prüfung
Rangtests sind nicht voraussetzungsfrei. Sie brauchen weniger, nicht nichts.
Voraussetzung
Was sie bedeutet
Prüfung
Folge bei Verletzung
Unabhängigkeit
Beobachtungen beeinflussen sich nicht, Gruppen sind getrennt erhoben
Erhebungsdesign
p-Wert wertlos; bei gepaarten Daten den Vorzeichen-Rangtest verwenden
Mindestens ordinale Skala
Die Werte lassen sich sinnvoll in eine Reihenfolge bringen
Exakte Verteilung nicht mehr gültig, die Programme weichen auf Näherungen aus
Für die Aussage über Mediane: gleiche Verteilungsform
Nur dann ist der Test ein Medianvergleich
Verteilungen nebeneinander zeichnen
Der Test bleibt gültig, aber die Deutung als Medianvergleich nicht
Die letzte Zeile ist die, die am häufigsten übersehen wird. Sie betrifft nicht die Gültigkeit des Tests, sondern die Formulierung des Ergebnisses.
Output lesen
R, wilcox.test() und kruskal.test():
Grösse
Was sie sagt
Faustregel oder Falle
W bei zwei unabhängigen Gruppen
die U-Statistik der ersten Gruppe
trotz des Buchstabens W dasselbe wie Mann-Whitneys U
V bei einer Stichprobe oder gepaart
Rangsumme der positiven Differenzen
nicht mit W verwechseln; die beiden Verfahren sind verschieden
Kruskal-Wallis chi-squared
Teststatistik
folgt näherungsweise einer Chi-Quadrat-Verteilung
df
Freiheitsgrade bei Kruskal-Wallis
Anzahl Gruppen minus eins
p-value
Wahrscheinlichkeit einer mindestens so ungleichen Rangverteilung
keine Aussage über die Grösse des Unterschieds
exact test im Titel
R hat die Verteilung abgezählt
die genaueste Variante; sie ist nur bei kleinen Stichproben möglich
test with continuity correction im Titel
R hat genähert
tritt bei grossen Stichproben auf und wenn Bindungen die Abzählung verhindern
Warnung cannot compute exact p-value with ties
Bindungen verhindern die Abzählung
R weicht dann auf die Normalapproximation aus und sagt es
Warnung with zeroes
Differenzen von genau null
diese Paare werden entfernt, das wirksame n sinkt, siehe Beispiel 2
conf.int = TRUE
geschätzte Verschiebung mit Intervall
die einzige Grössenangabe, die das Verfahren liefert, siehe Beispiel 4
Python, pingouin:
Spalte
Was sie sagt
Unterschied zu R
U_val bzw. W_val
Teststatistik
dieselbe Grösse wie in R, andere Bezeichnung
p_val
p-Wert
Bindungen werden anders behandelt, siehe Beispiel 2
RBC
rangbiseriale Korrelation
in R nicht enthalten; Effektmass zwischen -1 und 1
CLES
Common Language Effect Size
in R nicht enthalten; Wahrscheinlichkeit, dass ein zufälliger Wert der ersten Gruppe grösser ist
keine Verschiebungsschätzung
fehlt
in R über conf.int = TRUE
Interpretationsfallen
Ein Rangtest vergleicht nicht automatisch Mediane. Er vergleicht, wie oft ein Wert der einen Gruppe grösser ist. Nur bei gleicher Verteilungsform ist das gleichbedeutend mit einem Medianvergleich.
Nichtparametrisch heisst nicht voraussetzungsfrei.Unabhängigkeit bleibt zwingend, und die Skala muss mindestens ordinal sein.
Ein signifikanter Rangtest sagt nichts über die Grösse. Die Rangsumme ist nicht in der Einheit der Messung deutbar. Dafür gibt es die Verschiebung mit Intervall, RBC oder CLES.
Bindungen sind kein Randproblem. Bei einer Skala von 1 bis 7 ist fast jeder Wert mehrfach vorhanden; damit fällt die exakte Verteilung weg, und die Programme rechnen unterschiedlich weiter.
Der Rangtest ist keine Reparatur für schlechte Daten. Er hilft gegen Schiefe und Ausreisser, nicht gegen fehlende Werte, falsche Zuordnung oder ein ungeeignetes Design.
Nach Kruskal-Wallis braucht es Post-hoc-Vergleiche mit Korrektur, genau wie nach einer Varianzanalyse; der Gesamttest sagt nur, dass sich irgendwo etwas unterscheidet.
Bei erfüllten Voraussetzungen ist der t-Test schärfer. Der Verzicht kostet rund fünf Prozent Effizienz; wer grundsätzlich rangbasiert testet, verschenkt sie ohne Not.
Ergebnis berichten
Vorlage für den Ergebnissatz:
[Zielgrösse] unterscheidet sich zwischen [Gruppe 1] (Median [Wert], n = [n1]) und [Gruppe 2] (Median [Wert], n = [n2]): [Testname], [Statistik], p = [p]. Die geschätzte Verschiebung beträgt [Wert] [Einheit] (95-Prozent-Konfidenzintervall [unten] bis [oben]).
Genannt werden: das Verfahren mit seinem vollen Namen, die Teststatistik, der p-Wert, die Gruppengrössen, ein Lagemass je Gruppe (Median statt Mittelwert), ein Effektmass und der Grund, warum rangbasiert getestet wurde. Der letzte Punkt fehlt am häufigsten und ist der wichtigste: Ohne ihn steht der Verdacht im Raum, dass erst der t-Test gerechnet und dann gewechselt wurde.
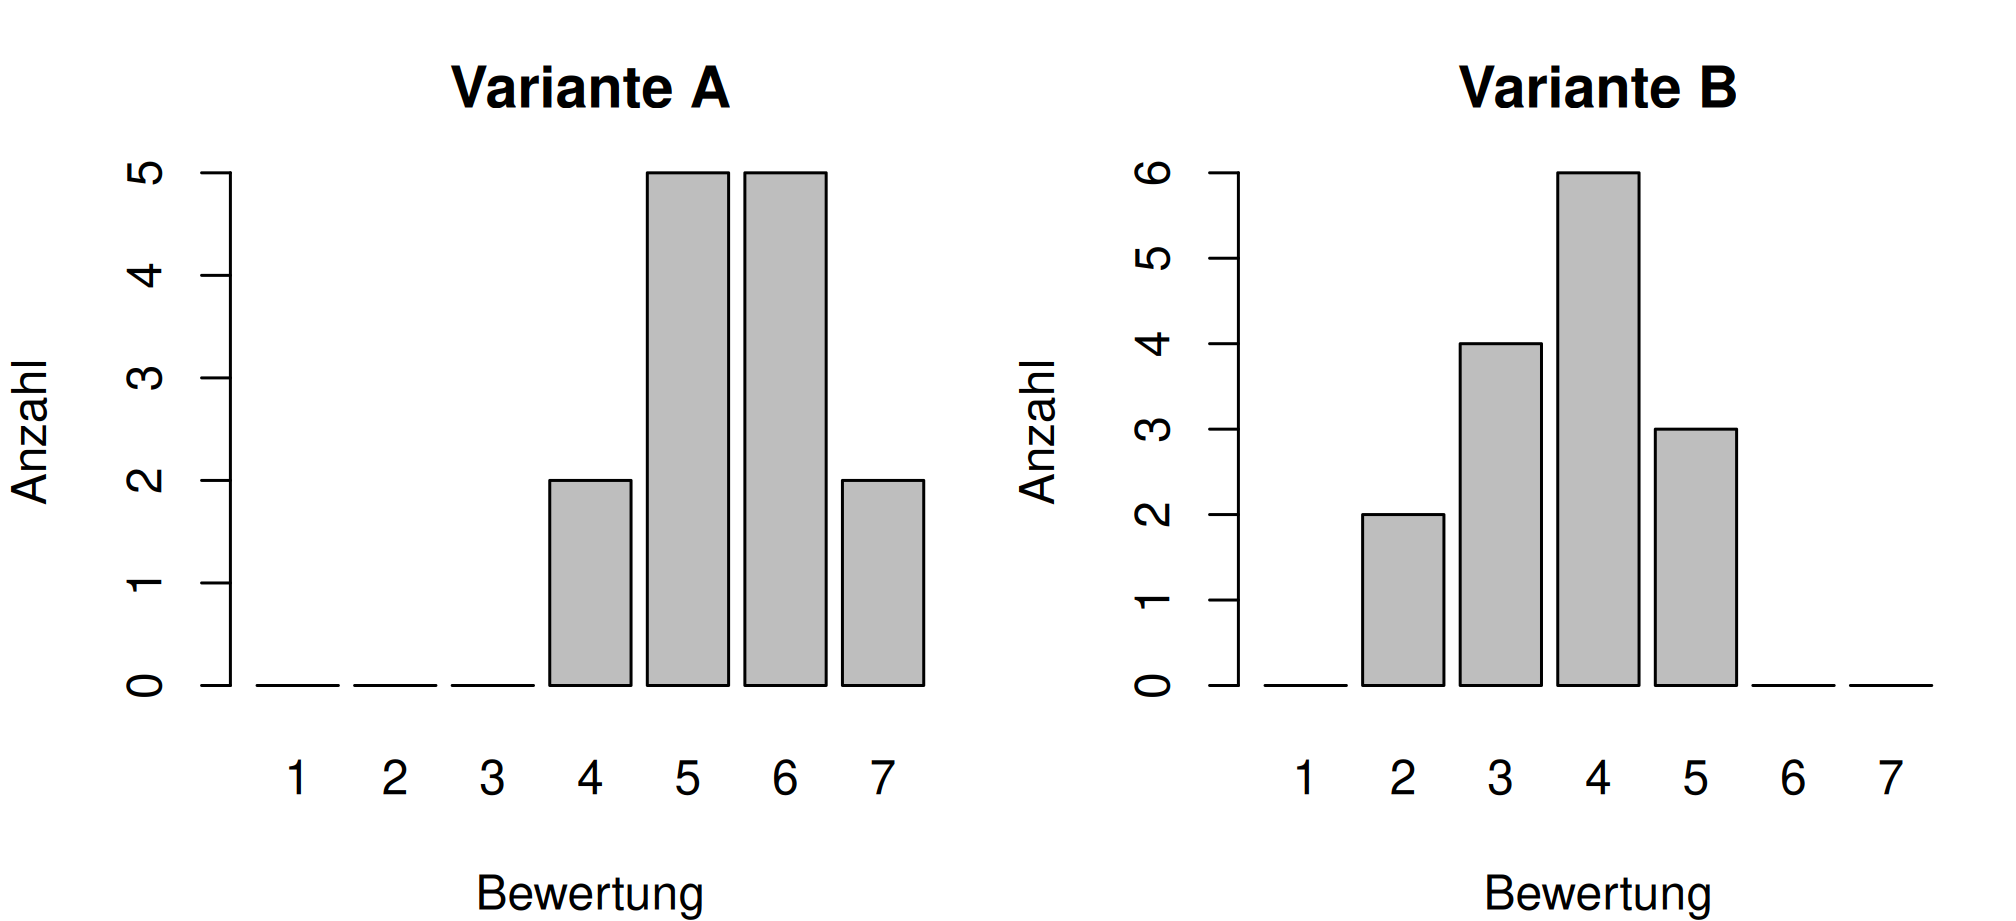
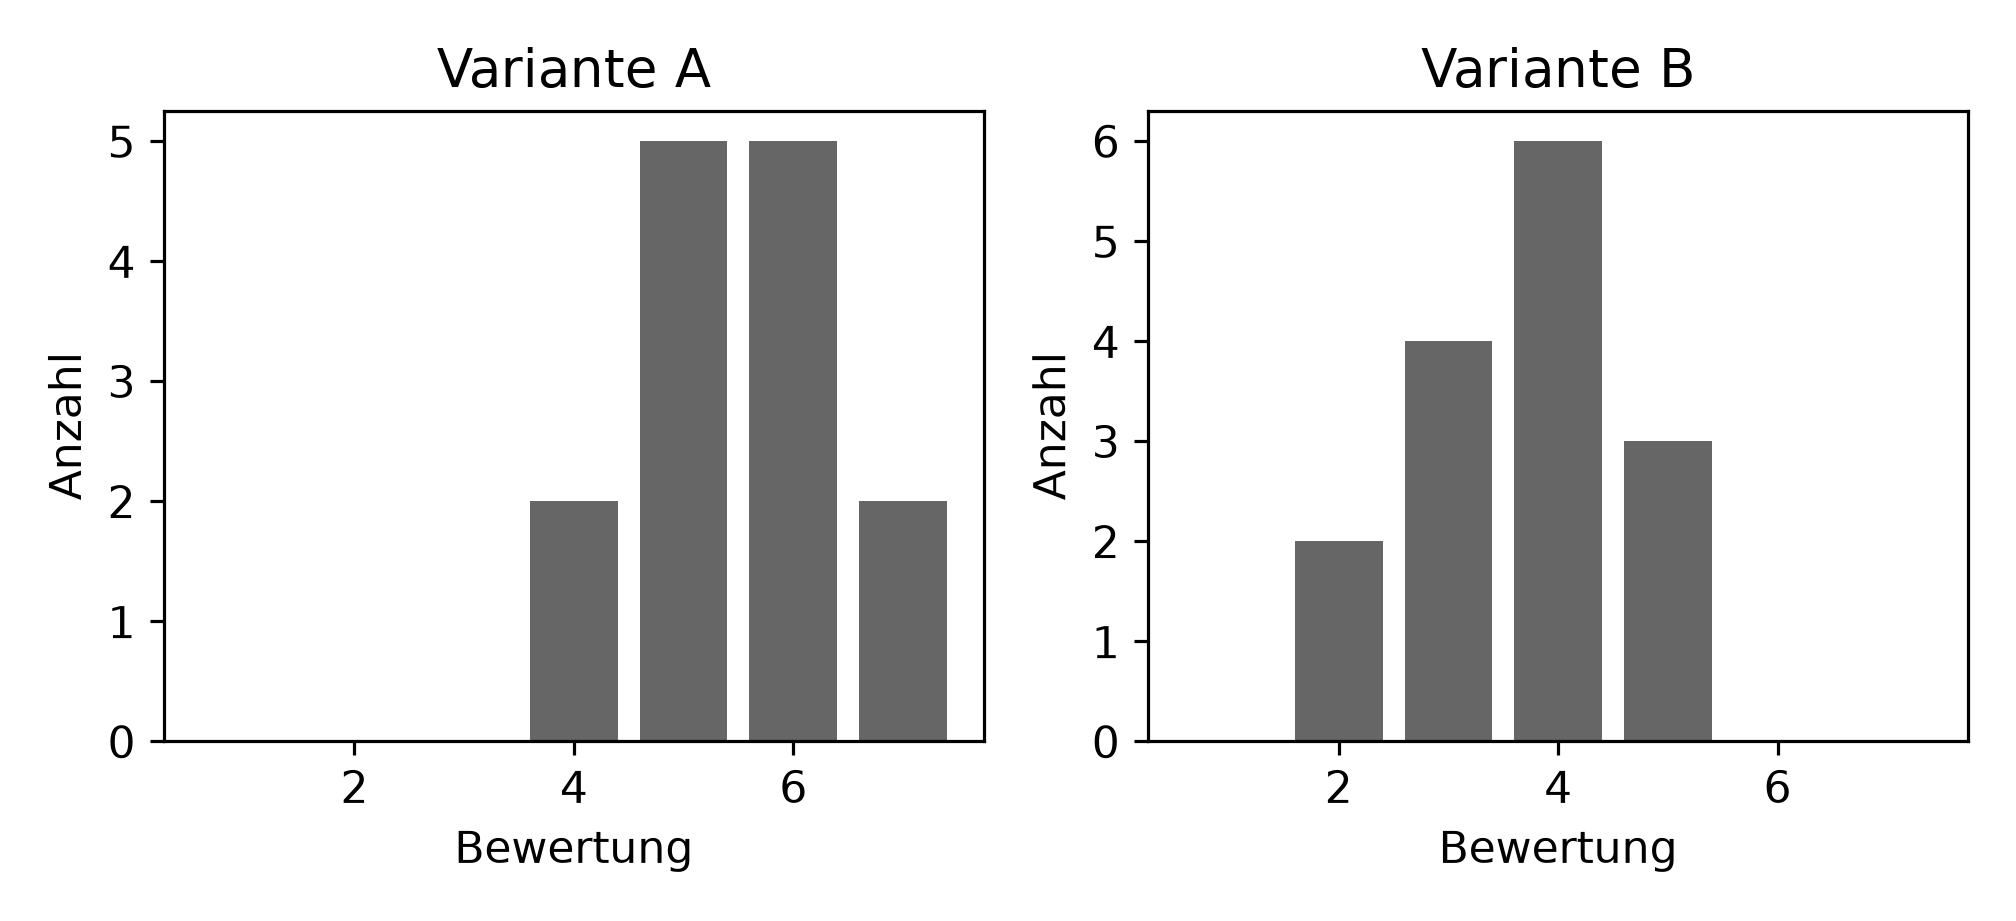
Zwei Betreuungsvarianten werden von Kundinnen und Kunden auf einer Skala von 1 bis 7 bewertet, 14 Personen für Variante A und 15 für Variante B. Die Frage lautet: Wird A besser bewertet als B?
Die Zielgrösse ist ordinal. Der Abstand zwischen 5 und 6 muss nicht derselbe sein wie zwischen 6 und 7, und ein Mittelwert von 5.5 beschreibt keine tatsächlich vergebene Note. Damit ist der Rangtest nicht Ausweichverfahren, sondern erste Wahl.
  variante   n  median  min  max
0        A  14     5.5    4    7
1        B  15     4.0    2    5
Variante A liegt bei einem Median von 5.5 mit Werten von 4 bis 7, Variante B bei 4.0 mit Werten von 2 bis 5. Die beiden Verteilungen haben eine ähnliche Form, sie sind gegeneinander verschoben. Das ist der Fall, in dem die Deutung als Medianvergleich zulässig ist.
Bindungen gibt es reichlich: Bei 29 Personen und sieben möglichen Werten kommt jede Note mehrfach vor. Genau daran entscheidet sich, ob ein Programm die exakte Verteilung abzählt oder näherungsweise rechnet, und die beiden Sprachen entscheiden das verschieden.
    Wilcoxon rank sum exact test

data:  variante_a and variante_b
W = 190.5, p-value = 5.774e-05
alternative hypothesis: true location shift is not equal to 0
R nennt das Verfahren nach Wilcoxon, gemeint ist derselbe Test wie Mann-Whitneys U. exact heisst, dass R die Verteilung der Teststatistik abgezählt und nicht genähert hat.
W bzw. U_val
190.5
Anzahl der gewonnenen Paarvergleiche
Von 14 mal 15 = 210 Vergleichen gewinnt A 190.5, wobei Gleichstände halb zählen. Bei Gleichheit der Varianten läge der Wert bei 105. Die halbe Zahl zeigt an, dass es Gleichstände gibt.
p-value in R
0.00005774
Wahrscheinlichkeit einer mindestens so ungleichen Rangverteilung bei gleichen Varianten
Deutlich unter 0.05.
p_val in Python
0.000142
dasselbe, anders gerechnet
Rund zweieinhalbmal so gross wie in R, siehe den Kasten unten. An der Entscheidung ändert es nichts.
RBC (nur Python)
0.814
rangbiseriale Korrelation
Sie ergibt sich direkt aus U: 190.5 von 210 Vergleichen gewonnen entspricht 0.814 auf einer Skala von -1 bis 1.
CLES (nur Python)
0.907
Common Language Effect Size
Die anschaulichste Zahl der ganzen Ausgabe: Greift man zufällig je eine Person aus beiden Gruppen heraus, bewertet die aus Gruppe A in rund 91 Prozent der Fälle besser.
Warum R und Python hier verschiedene p-Werte zeigen. Beide rechnen richtig, sie wählen nur ein anderes Verfahren für dieselbe Frage.
R zählt die exakte Verteilung der Teststatistik ab und kommt auf 0.00005774. scipy und pingouin schalten bei Bindungen auf die Normalapproximation um und kommen auf 0.000142. Der Unterschied ist ein Faktor von rund 2.5 und trotzdem belanglos, weil beide Werte weit unter jeder Schwelle liegen.
Bei einem Ergebnis nahe 0.05 wäre er das nicht. Deshalb gehört ins Protokoll, mit welchem Programm und welcher Einstellung gerechnet wurde. Wer beide Sprachen verwendet und abweichende p-Werte sieht, prüft bei Rangtests zuerst, ob Bindungen vorliegen: Die halbe Stelle in W = 190.5 ist bereits der Hinweis darauf.
Interpretation und Ergebnissatz
Der p-Wert beantwortet nur, ob der Unterschied vom Zufall unterscheidbar ist. Die Grösse steht in CLES und, falls verlangt, in der Verschiebungsschätzung aus Beispiel 4.
Berichtet werden Mediane, nicht Mittelwerte. Ein Mittelwert von 5.5 auf einer Skala mit sieben Stufen unterstellt, dass die Abstände zwischen den Stufen gleich gross sind, und genau das ist bei einer Bewertungsskala nicht gesichert.
Variante A wird besser bewertet als Variante B (Mann-Whitney-U-Test, U = 190.5, p < 0.001; Mediane 5.5 gegenüber 4.0, n = 14 und 15). Die Common Language Effect Size beträgt 0.91: Eine zufällig gewählte Person aus Gruppe A bewertet in rund neun von zehn Fällen besser als eine zufällig gewählte aus Gruppe B. Rangbasiert getestet wurde wegen der ordinalen Skala.
Frage und Datenlage
Zwölf Personen bewerten ihre Beschwerden vor und nach einer Massnahme auf einer Skala von 0 bis 10. Dieselben Personen, zwei Messungen: Das ist der Vorzeichen-Rangtest auf den Differenzen, nicht der Mann-Whitney-Test.
Keine einzige Person hat sich verschlechtert. Das ist der ganze Befund; der Test quantifiziert nur noch, wie unwahrscheinlich das bei Wirkungslosigkeit wäre.
V bzw. W_val
0
Rangsumme der positiven Differenzen
Null, weil es keine positiven Differenzen gibt. Der kleinstmögliche Wert.
p-value
0.001953 in R, 0.002 in Python
Hier stimmen beide Sprachen überein, anders als in Beispiel 1.
Nulldifferenzen
zwei
Personen ohne Veränderung
Sie werden aus der Rechnung entfernt. Das wirksame n sinkt von 12 auf 10, und beide Programme rechnen dann auf derselben Grundlage.
RBC (nur Python)
-1.0
rangbiseriale Korrelation
Der Extremwert. Alle von null verschiedenen Differenzen zeigen in dieselbe Richtung.
CLES (nur Python)
0.156
Common Language Effect Size
Ein zufällig gewählter Nachher-Wert ist nur in 16 Prozent der Vergleiche höher als ein zufällig gewählter Vorher-Wert.
Nulldifferenzen verschwinden aus der Rechnung. Beide Personen ohne Veränderung werden vor dem Test entfernt, weil ihre Differenz kein Vorzeichen hat. Das wirksame n sinkt damit von 12 auf 10.
Das ist mehr als eine Formalie. Die Aussage “hat sich nicht verändert” ist ein Befund, und der Test verwertet ihn nicht. Bei zwei von zwölf Fällen ist das verkraftbar; wären es sechs, wäre der Vorzeichen-Rangtest das falsche Verfahren. Dann gehört die Richtung der Veränderung als kategoriale Grösse ausgewertet, etwa mit einem Vorzeichentest oder über die Häufigkeiten “besser, gleich, schlechter”.
Anders als in Beispiel 1 stimmen R und Python hier überein: Beide rechnen nach dem Entfernen der Nullen mit der exakten Verteilung. Ob das gelingt, hängt an den Daten und nicht an der Sprache, und deshalb lohnt der Blick auf die Testbezeichnung in der R-Ausgabe. Steht dort exact test, wurde abgezählt; steht dort test with continuity correction, wurde genähert.
Interpretation und Ergebnissatz
Die zwei Personen ohne Veränderung verschwinden im Test vollständig. Das wirksame n sinkt damit von 12 auf 10, und die Information “keine Veränderung” wird gar nicht verwertet. Bei vielen Nulldifferenzen ist das ein ernstes Problem, und dann gehört ein anderes Verfahren gewählt, etwa ein Vorzeichentest oder eine Auswertung der Veränderungsrichtung als kategoriale Grösse.
Die Beschwerden gehen nach der Massnahme zurück (Wilcoxon-Vorzeichen-Rangtest für verbundene Stichproben, V = 0, p = 0.004; Mediane 7.0 vor und 5.0 nach der Massnahme, n = 12). Zehn Personen verbesserten sich, zwei blieben unverändert, keine verschlechterte sich; die beiden unveränderten Fälle gehen nicht in den Test ein. Rangbasiert ausgewertet wurde wegen der ordinalen Skala.
Frage und Datenlage
Drei Schulungsvarianten werden von je zehn Personen auf einer Skala von 1 bis 10 bewertet. Die Frage lautet: Unterscheiden sich die Varianten?
    Pairwise comparisons using Wilcoxon rank sum exact test

data:  schulung$bewertung and schulung$variante

  A       B
B 0.00022 -
C 0.76048 0.00019

P value adjustment method: holm
variante
A    6.0
B    8.0
C    6.0
Name: bewertung, dtype: float64
Output Zeile für Zeile
Ausgabe
Wert hier
Bedeutung
Wie er zu lesen ist
Kruskal-Wallis chi-squared bzw. H
18.738
Teststatistik
Sie misst, wie ungleich sich die Ränge auf die drei Gruppen verteilen.
df
2
Freiheitsgrade
Anzahl Gruppen minus eins.
p-value
0.000085
Irgendwo unterscheiden sich die Varianten.
Mediane
6.0 / 8.0 / 6.0
Lagemass je Gruppe
Hier deutet sich bereits an, wo der Unterschied sitzt: B liegt höher, A und C liegen gleich.
Paarweise p-Werte (nur R)
B gegen A 0.00022, C gegen B 0.00019, C gegen A 0.76
Post-hoc nach Holm
Erst diese Zeilen beantworten die eigentliche Frage: B unterscheidet sich von beiden anderen, A und C nicht voneinander.
Der Aufbau ist derselbe wie bei der Varianzanalyse: Der Gesamttest sagt nur, dass es irgendwo einen Unterschied gibt. Ohne Post-hoc-Vergleiche bleibt das Ergebnis inhaltlich leer, und ohne Korrektur für multiples Testen wären die paarweisen p-Werte zu optimistisch.
Die Holm-Korrektur ist dabei der Bonferroni-Korrektur vorzuziehen: Sie hält dasselbe Niveau ein, verwirft aber häufiger. pingouin liefert für Kruskal-Wallis keine Post-hoc-Vergleiche mit; in Python ist dafür scikit-posthocs mit dem Dunn-Test üblich.
Interpretation und Ergebnissatz
Die Bewertungen unterscheiden sich zwischen den drei Varianten (Kruskal-Wallis, H(2) = 18.74, p < 0.001, n = 10 je Variante). Variante B wird höher bewertet (Median 8.0) als A und C (je Median 6.0), die sich untereinander nicht unterscheiden; paarweise Vergleiche nach Holm korrigiert.
Frage und Datenlage
Die Daten aus Beispiel 1. Der Test hat gezeigt, dass sich die Varianten unterscheiden. Dieses Beispiel beantwortet die zweite Frage: um wie viel?
Das ist der Punkt, an dem Rangtests oft aufhören und deshalb den Ruf haben, nur p-Werte zu liefern. Das stimmt nicht: R schätzt die Verschiebung zwischen den beiden Verteilungen samt Konfidenzintervall, wenn man es verlangt.
    Wilcoxon rank sum exact test

data:  variante_a and variante_b
W = 190.5, p-value = 5.774e-05
alternative hypothesis: true location shift is not equal to 0
97.7 percent confidence interval:
 1 3
sample estimates:
difference in location
                     2
# pingouin und scipy liefern keine Verschiebungsschaetzung. Sie ist der Median# aller paarweisen Differenzen, der Hodges-Lehmann-Schaetzer, und laesst sich# in einer Zeile nachbauen.paardifferenzen = np.subtract.outer(variante_a, variante_b).ravel()print("Hodges-Lehmann-Schätzer:", np.median(paardifferenzen))
Der Hodges-Lehmann-Schätzer, also der Median aller 210 paarweisen Differenzen. Nicht die Differenz der Mediane, auch wenn beide hier zufällig übereinstimmen.
97.7 percent confidence interval
1 bis 3
Intervall für diese Verschiebung
Die Verschiebung liegt plausibel zwischen einem und drei Skalenpunkten. Auf einer Skala von 1 bis 7 ist das viel. Zur Prozentzahl siehe den Kasten unten.
CLES
0.907
Wahrscheinlichkeit, dass A besser bewertet
Braucht keine Einheit und ist deshalb auch Laien erklärbar.
RBC
0.814
rangbiseriale Korrelation
Anhaltspunkte wie bei einer Korrelation: 0.1 klein, 0.3 mittel, 0.5 gross.
Warum dort 97.7 Prozent steht und nicht 95. Das Intervall entsteht aus den 210 paarweisen Differenzen, und diese sind bei einer siebenstufigen Skala nur ganze Zahlen. Ein Intervall lässt sich deshalb nicht beliebig fein einstellen: R nimmt die nächstgelegene erreichbare Grenze und schreibt ehrlich dazu, welches Niveau dabei herauskommt. Angefordert waren 95 Prozent, erreichbar waren 97.7.
Das ist kein Fehler, sondern eine Eigenschaft aller exakten Verfahren auf diskreten Daten. Berichtet wird das tatsächlich erreichte Niveau, nicht das angeforderte.
Der Hodges-Lehmann-Schätzer ist nicht die Differenz der Mediane. Er ist der Medianaller paarweisen Differenzen zwischen den beiden Gruppen. Bei gleicher Verteilungsform liegen beide nah beieinander, bei verschiedener können sie deutlich auseinanderfallen. Berichtet wird der Wert, den das Verfahren liefert, und zwar unter seinem Namen.
Interpretation und Ergebnissatz
Mit diesen drei Zahlen ist der Bericht vollständig: Der p-Wert sagt, dass der Unterschied vom Zufall unterscheidbar ist. Die Verschiebung mit Intervall sagt, wie gross er in Skalenpunkten ist. CLES übersetzt ihn in eine Aussage, die ohne Statistikkenntnisse verständlich ist.
Genau diese Kombination sollte auch beim t-Test stehen: Teststatistik, Effektgrösse in der Einheit der Sache, standardisiertes Effektmass. Rangtests sind darin nicht schlechter, sie werden nur seltener so berichtet.
Variante A wird um geschätzte 2 Skalenpunkte besser bewertet als Variante B (Hodges-Lehmann-Schätzer, Konfidenzintervall 1 bis 3 bei einem erreichten Niveau von 97.7 Prozent; Mann-Whitney-U-Test, U = 190.5, p < 0.001, n = 14 und 15). Die Common Language Effect Size beträgt 0.91.
Verständnisfragen
R meldet cannot compute exact p-value with ties. Was ist zu tun?
Nichts, ausser den Umstand im Bericht zu erwähnen
Richtig. Die Meldung ist ein Hinweis, kein Fehler: R weicht auf die Normalapproximation aus. Bei ordinalen Skalen sind Bindungen unvermeidlich. Wichtig ist nur, dass man weiss, welches Verfahren gerechnet wurde, denn Python entscheidet hier anders.
Die Bindungen durch kleine Zufallswerte auflösen
Das erfindet Information, die nicht erhoben wurde, und macht das Ergebnis vom Zufallsgenerator abhängig.
Auf den t-Test wechseln
Der Wechsel des Verfahrens aufgrund einer Warnung ist keine inhaltliche Begründung.
Zwei Gruppen haben denselben Median, der Mann-Whitney-Test ist trotzdem signifikant. Widerspruch?
Nein, der Test vergleicht nicht Mediane, sondern wie oft ein Wert grösser ist
Richtig. Seine Nullhypothese lautet, dass ein zufällig gezogener Wert der einen Gruppe genauso oft grösser wie kleiner ist als einer der anderen. Bei verschieden geformten Verteilungen kann das verletzt sein, obwohl die Mediane übereinstimmen.
Ja, dann muss ein Rechenfehler vorliegen
Der Fall tritt regelmässig auf, sobald die Verteilungen verschiedene Formen haben.
Ja, der Test ist dann ungültig
Er ist gültig; nur die verkürzte Deutung als Medianvergleich ist es nicht.
Warum ist CLES = 0.91 für einen Bericht oft nützlicher als U = 190.5?
Weil CLES ohne Statistikkenntnisse verständlich ist
Richtig. “Eine zufällig gewählte Person aus A bewertet in neun von zehn Fällen besser” ist eine Aussage, die jeder versteht. U = 190.5 ist ohne die Gruppengrössen nicht einmal einzuordnen.
Weil CLES genauer ist
Beide beruhen auf denselben Paarvergleichen; CLES ist U geteilt durch die Anzahl aller Vergleiche.
Weil U von der Stichprobengrösse unabhängig ist
Genau umgekehrt: U wächst mit den Gruppengrössen, CLES nicht.
Die Voraussetzungen des t-Tests sind erfüllt. Spricht etwas dagegen, trotzdem rangbasiert zu testen?
Ja, der Rangtest ist dann etwas weniger scharf
Richtig. Bei normalverteilten Daten liegt die Effizienz des Rangtests bei rund 95 Prozent des t-Tests. Man verschenkt also einen kleinen Teil der Aussagekraft, und man verliert die Aussage über Mittelwerte in ihrer Einheit.
Nein, Rangtests sind immer die sichere Wahl
Sicherer gegen verletzte Voraussetzungen, ja; kostenlos ist das aber nicht.
Ja, Rangtests sind bei grossem n nicht anwendbar
Sie sind es, und die Normalapproximation wird mit wachsendem n sogar besser.