Konfidenzintervalle ohne Verteilungsannahme, auch für Kennzahlen ohne Formel.
Der Bootstrap zieht zufällig, und Zufallszahlen unterscheiden sich zwischen R und Python. Damit die Zahlen auf dieser Seite in beiden Sprachen übereinstimmen, kommt ein einfacher Generator zum Einsatz, der in beiden gleich rechnet. In der Praxis nimmt man die eingebauten Generatoren und setzt einen Seed.
Kurzsteckbrief
Fragestellung
Wie unsicher ist eine Kennzahl, wenn keine Formel dafür existiert oder ihre Voraussetzungen verletzt sind?
Eingang
eine Stichprobe und eine beliebige Kennzahl
Was die Methode liefert
Standardfehler, Konfidenzintervall und die ganze Verteilung der Kennzahl
R-Funktion
von Hand mit sample(), oder boot::boot() und boot::boot.ci()
Python-Funktion
von Hand mit np.random.choice(), oder scipy.stats.bootstrap()
Der Bootstrap ist die Antwort auf zwei Fragen, für die die klassische Statistik keine gute hat.
Erstens: Kennzahlen ohne Formel. Für den Mittelwert gibt es einen Standardfehler, für den Median, den getrimmten Mittelwert, ein Verhältnis zweier Grössen oder den Unterschied zweier Korrelationen nicht ohne Weiteres. Der Bootstrap liefert ihn für jede Kennzahl, die sich ausrechnen lässt.
Zweitens: verletzte Verteilungsannahmen. Bei stark schiefen Daten ist das t-Intervall symmetrisch, obwohl die Verteilung des Mittelwerts es nicht ist. Der Bootstrap bildet die Schiefe ab, siehe Beispiel 1.
Situation
Stattdessen
Voraussetzungen erfüllt, Kennzahl mit Formel
das klassische Konfidenzintervall; es ist schneller und braucht keinen Zufall
Sehr kleine Stichprobe
kein Bootstrap; er kann nur wiederverwenden, was vorhanden ist, siehe Beispiel 4
Es geht um extreme Quantile oder das Maximum
ungeeignet, aus demselben Grund
Abhängige Daten, etwa Zeitreihen
Blockbootstrap statt gewöhnlichem Ziehen
Es geht um einen Test statt um ein Intervall
Permutationstest, ein verwandtes Verfahren mit anderer Ziehung
Grundidee und Modell
Die klassische Statistik fragt: Wie würde meine Kennzahl schwanken, wenn ich die Erhebung viele Male wiederholte? Beantwortet wird das über eine Verteilungsannahme und eine Formel.
Der Bootstrap beantwortet dieselbe Frage anders: Er behandelt die vorliegende Stichprobe als Ersatz für die Grundgesamtheit und zieht daraus wiederholt neue Stichproben, mit Zurücklegen und in derselben Grösse.
Schritt
Was passiert
1
Aus den \(n\) Werten werden \(n\) Werte mit Zurücklegen gezogen. Manche kommen mehrfach vor, andere gar nicht.
2
Für diese Ziehung wird die Kennzahl berechnet.
3
Schritte 1 und 2 werden \(B\)-mal wiederholt, üblicherweise 1000 bis 10 000 Mal.
4
Die \(B\) Werte bilden die Bootstrap-Verteilung der Kennzahl.
5
Ihre Standardabweichung ist der Standardfehler, ihre Quantile ergeben das Intervall.
Das Zurücklegen ist wesentlich: Ohne es wäre jede Ziehung identisch mit der Ausgangsstichprobe. Im Mittel enthält eine Bootstrap-Ziehung rund 63 Prozent der ursprünglichen Werte, den Rest mehrfach.
Die entscheidende Annahme lautet: Die Stichprobe ist repräsentativ für die Grundgesamtheit. Der Bootstrap ersetzt die Verteilungsannahme durch diese Annahme, er macht das Verfahren also nicht voraussetzungsfrei, sondern tauscht eine Voraussetzung gegen eine andere.
Daraus folgt unmittelbar seine Grenze: Was in der Stichprobe nicht vorkommt, kann er nicht erfinden. Bei kleinen Stichproben ist diese Grenze eng, siehe Beispiel 4.
Die Intervallvarianten
Variante
Wie sie rechnet
Wann
Perzentil
die 2.5- und 97.5-Prozent-Quantile der Bootstrap-Verteilung
einfach, verständlich, für die meisten Fälle ausreichend
Basic
spiegelt die Quantile am beobachteten Wert
wenn die Verzerrung gering ist
BCa
korrigiert Verzerrung und Schiefe
die genaueste Variante, in boot.ci() und scipy.stats.bootstrap() enthalten
Studentisiert
verwendet einen bootstrapten Standardfehler je Ziehung
am genauesten, aber rechenaufwendig
Auf dieser Seite steht das Perzentilintervall im Vordergrund, weil sich daran das Verfahren am besten erklären lässt. Für einen Bericht ist BCa vorzuziehen.
Output lesen
Grösse
Was sie sagt
Falle
Bootstrap-Standardfehler
Standardabweichung der \(B\) Kennzahlwerte
ersetzt die Formel, nicht die Interpretation
Verzerrung (bias)
Bootstrap-Mittel minus beobachteter Wert
kleine Werte sind normal; grosse deuten auf eine ungeeignete Kennzahl oder zu wenig Daten
Perzentilintervall
Quantile der Bootstrap-Verteilung
bei starker Verzerrung zu optimistisch
\(B\)
Anzahl Wiederholungen
zu klein macht das Ergebnis vom Zufall abhängig, siehe Beispiel 3
Seed
Startwert des Generators
gehört ins Protokoll, sonst ist das Ergebnis nicht reproduzierbar
Interpretationsfallen
Der Bootstrap erzeugt keine neuen Daten. Er nutzt die vorhandenen mehrfach. Bei acht Beobachtungen bleibt es bei acht verschiedenen Werten.
Er repariert keine verzerrte Stichprobe. Ist die Erhebung schief, ist es das Ergebnis auch.
Er ist bei kleinem n nicht besser als die Formel, oft schlechter.
Das Intervall hängt vom Seed ab. Bei zu kleinem \(B\) merklich, siehe Beispiel 3.
Für Maxima und extreme Quantile ist er ungeeignet, weil die Bootstrap-Verteilung den beobachteten Wertebereich nie verlässt.
Bei abhängigen Daten braucht es einen Blockbootstrap. Gewöhnliches Ziehen zerstört die zeitliche Struktur und liefert zu schmale Intervalle.
Ergebnis berichten
Für [Kennzahl] ergibt sich [Wert] (95-Prozent-Bootstrap-Konfidenzintervall [unten] bis [oben], Perzentilmethode, B = [Anzahl] Ziehungen, Seed [Wert]).
Genannt werden: die Kennzahl, die Intervallvariante, \(B\), der Seed und der Grund, warum der Bootstrap statt einer Formel verwendet wurde. Die letzten beiden fehlen am häufigsten.
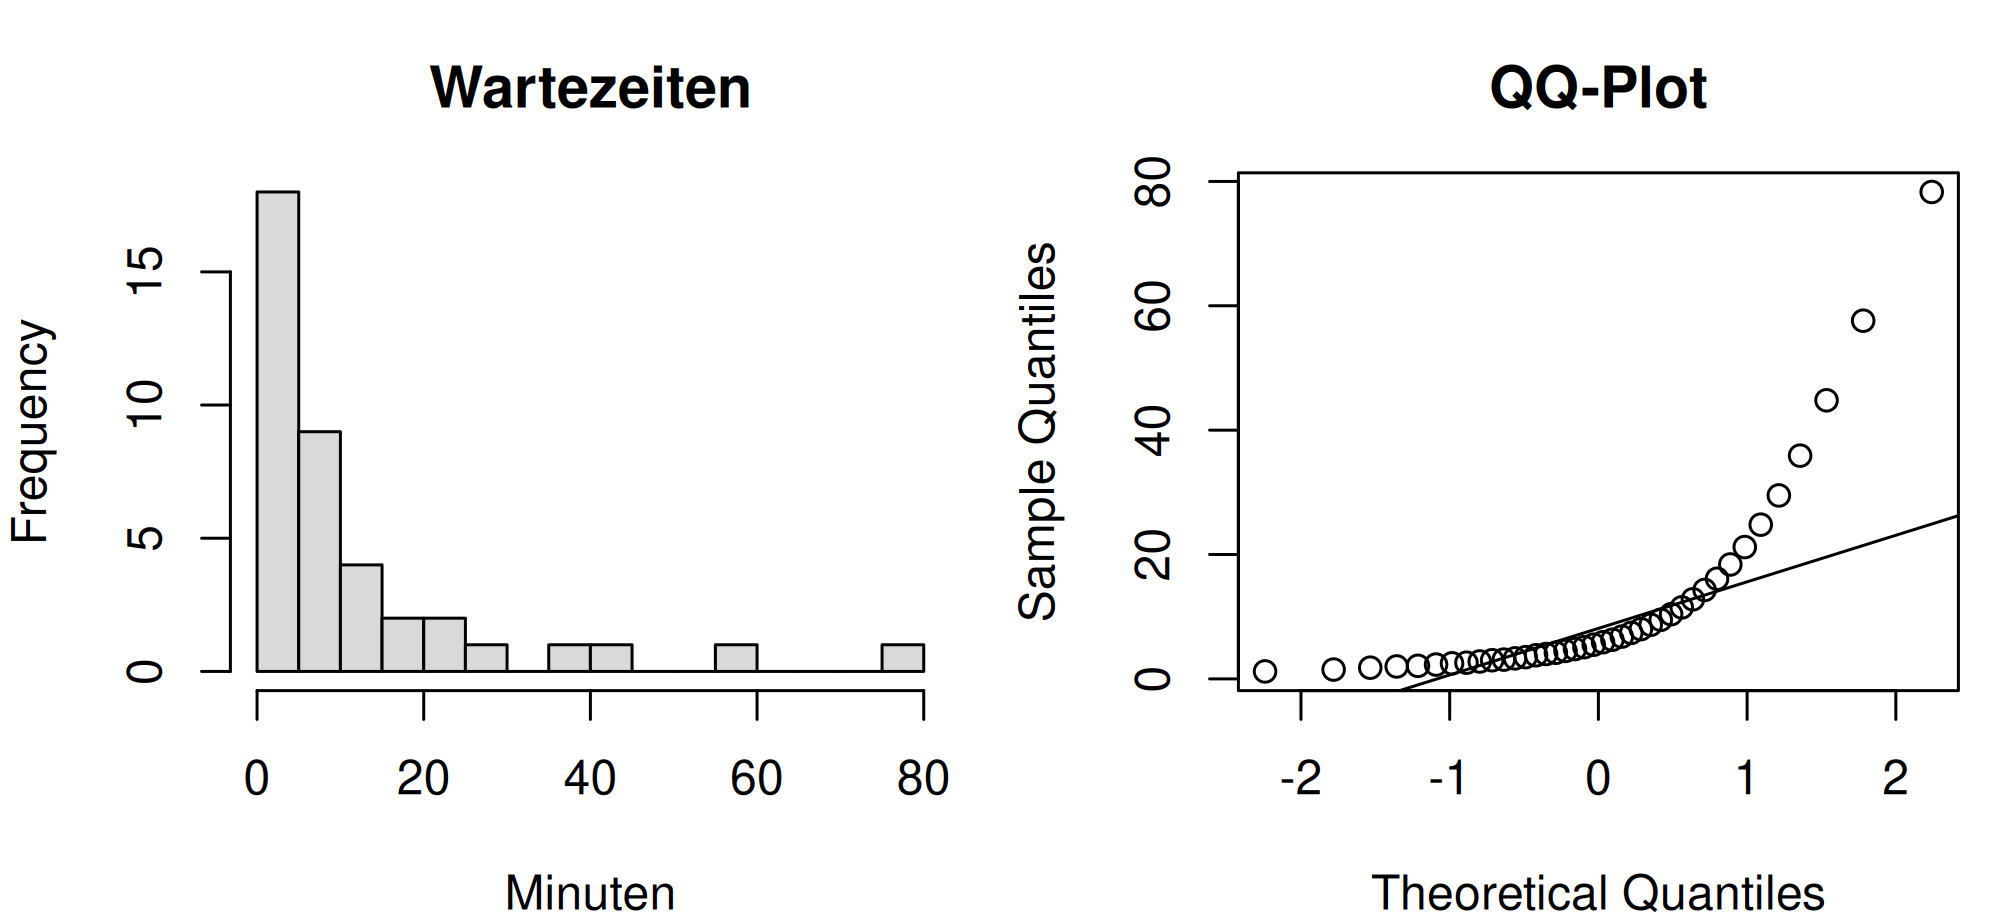
Vierzig Wartezeiten in Minuten, deutlich rechtsschief: Der Median liegt bei 5.7 Minuten, der Mittelwert bei 12.3, der grösste Wert bei 78.3. Gesucht ist ein Konfidenzintervall für den Mittelwert.
n = 40 Mittel = 12.295 Median = 5.7 SD = 16.389 Schiefe = 2.5706
Die Schiefe beträgt 2.57, der Mittelwert liegt mehr als doppelt so hoch wie der Median, und der QQ-Plot biegt am oberen Ende weit von der Geraden ab. Bei 40 Beobachtungen wirkt der zentrale Grenzwertsatz zwar schon, aber nicht so weit, dass die Verteilung des Mittelwerts symmetrisch wäre.
Bootstrap-Mittel minus beobachteter Wert. Klein gegenüber dem Standardfehler von 2.54, also unbedenklich.
Bootstrap-Standardfehler
2.544
Zum Vergleich: die Formel liefert \(s/\sqrt{n}\) = 16.389/6.325 = 2.591. Die beiden liegen nah beieinander.
Perzentilintervall
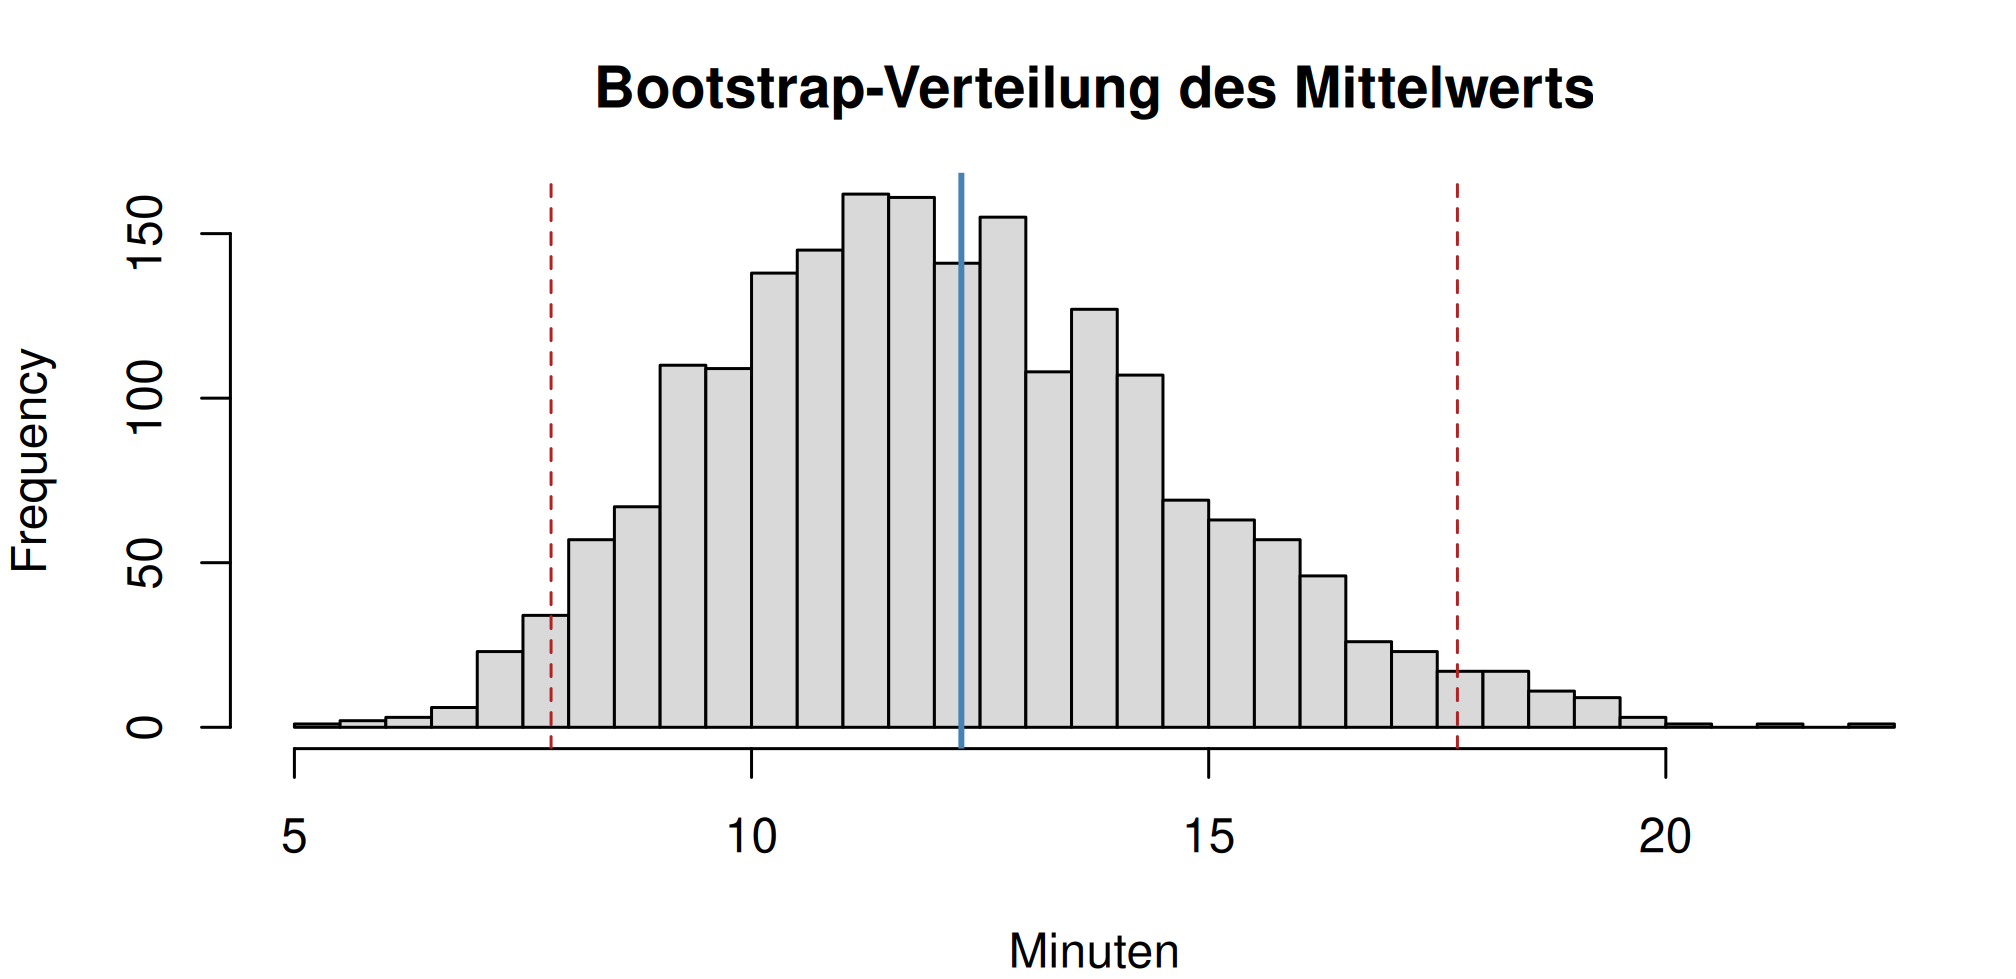
7.807 bis 17.721
t-Intervall
7.054 bis 17.537
Der aufschlussreiche Vergleich steht in den letzten beiden Zeilen. Beide Intervalle sind ähnlich breit, aber verschieden platziert:
untere Grenze
obere Grenze
Abstand nach unten
Abstand nach oben
t-Intervall
7.054
17.537
-5.241
+5.241
Bootstrap
7.807
17.721
-4.488
+5.426
Das t-Intervall ist exakt symmetrisch, weil die Formel es so konstruiert. Das Bootstrap-Intervall ist es nicht: Es reicht 4.49 Minuten nach unten und 5.43 nach oben. Genau das erwartet man bei rechtsschiefen Daten, denn der Mittelwert kann durch einzelne grosse Werte weiter nach oben als nach unten wandern.
Interpretation und Ergebnissatz
Der Bootstrap bildet hier eine Eigenschaft ab, die die Formel gar nicht abbilden kann. Bei n = 40 ist der Unterschied noch moderat; bei n = 15 wäre er erheblich, und dann wäre das t-Intervall an der unteren Grenze deutlich zu weit.
Zugleich zeigt der Vergleich, dass die Formel nicht falsch ist: Die Standardfehler stimmen fast überein (2.54 gegen 2.59). Der Gewinn liegt in der Form des Intervalls, nicht in seiner Breite.
Die mittlere Wartezeit beträgt 12.3 Minuten (95-Prozent-Bootstrap-Konfidenz- intervall 7.8 bis 17.7 Minuten, Perzentilmethode, B = 2000). Der Bootstrap wurde wegen der deutlichen Rechtsschiefe (Schiefe 2.57) verwendet; das klassische t-Intervall wäre mit 7.1 bis 17.5 symmetrisch und würde die Schiefe der Verteilung nicht abbilden.
Frage und Datenlage
Für den Median gibt es keinen einfachen Standardfehler, für den getrimmten Mittelwert ebenso wenig. Der Bootstrap braucht keine Formel, sondern nur eine Rechenvorschrift.
Halb so grosser Standardfehler, deutlich schmaleres Intervall, und inhaltlich die Zahl, die einen typischen Fall beschreibt.
getrimmt 10 %
8.397
1.984
5.59 bis 13.27
Der Kompromiss: Die äussersten 10 Prozent auf jeder Seite werden weggelassen, der Rest gemittelt.
Für keine der beiden unteren Zeilen gibt es eine Standardformel. Der Bootstrap liefert sie ohne Zusatzaufwand, weil ihm gleichgültig ist, welche Kennzahl er berechnet.
Das Intervall des Medians ist auffällig grobkörnig: Seine Grenzen sind 3.90 und 8.75, also Mittelwerte benachbarter beobachteter Werte. Das liegt daran, dass der Median einer Ziehung immer einer der vorhandenen Werte ist oder das Mittel zweier davon. Die Bootstrap-Verteilung ist deshalb diskret, und bei kleinen Stichproben wird das zum Problem, siehe Beispiel 4.
Interpretation und Ergebnissatz
Die Tabelle macht auch eine inhaltliche Entscheidung sichtbar. Welche der drei Kennzahlen berichtet wird, ist keine statistische Frage: Der Mittelwert zählt, wenn es um die Gesamtbelastung geht (alle Wartezeiten zusammen), der Median, wenn es um den typischen Fall geht.
Die mediane Wartezeit beträgt 5.7 Minuten (95-Prozent-Bootstrap-Konfidenz- intervall 3.9 bis 8.8 Minuten, Perzentilmethode, B = 2000). Berichtet wird der Median statt des Mittelwerts, weil die Verteilung stark rechtsschief ist und der Mittelwert von 12.3 Minuten keinen typischen Fall beschreibt.
Frage und Datenlage
\(B\) ist frei wählbar. Zu wenige Ziehungen machen das Ergebnis vom Zufall abhängig, zu viele kosten nur Rechenzeit. Wo liegt die Grenze?
for (b inc(200, 1000, 2000)) { v <-rowMeans(ziehungen(warten, b))cat(sprintf(" B = %5d: %.4f bis %.4f\n", b,quantile(v, 0.025), quantile(v, 0.975)))}
  B =   200: 7.5031 bis 17.6306
  B =  1000: 7.6320 bis 18.0444
  B =  2000: 7.8073 bis 17.7205
cat("\nEinfluss der Saat (B = 2000):\n")
Einfluss der Saat (B = 2000):
for (saat inc(1, 42, 12345)) { v <-rowMeans(ziehungen(warten, 2000, saat = saat))cat(sprintf(" Saat %6d: %.4f bis %.4f\n", saat,quantile(v, 0.025), quantile(v, 0.975)))}
  Saat      1: 7.8121 bis 17.4978
  Saat     42: 7.8073 bis 17.7205
  Saat  12345: 7.9123 bis 17.7652
print("Einfluss von B (Mittelwert, Saat 42):")
Einfluss von B (Mittelwert, Saat 42):
for b in (200, 1000, 2000): v = ziehungen(warten, b).mean(axis=1) unten, oben = np.percentile(v, [2.5, 97.5])print(f" B = {b:5d}: {unten:.4f} bis {oben:.4f}")
  B =   200: 7.5031 bis 17.6306
  B =  1000: 7.6320 bis 18.0444
  B =  2000: 7.8073 bis 17.7205
print("\nEinfluss der Saat (B = 2000):")
Einfluss der Saat (B = 2000):
for saat in (1, 42, 12345): v = ziehungen(warten, 2000, saat=saat).mean(axis=1) unten, oben = np.percentile(v, [2.5, 97.5])print(f" Saat {saat:6d}: {unten:.4f} bis {oben:.4f}")
  Saat      1: 7.8121 bis 17.4978
  Saat     42: 7.8073 bis 17.7205
  Saat  12345: 7.9123 bis 17.7652
Output Zeile für Zeile
B
Intervall
Wie das zu lesen ist
200
7.503 bis 17.631
Die untere Grenze liegt 0.30 Minuten neben dem Wert bei B = 2000.
1000
7.632 bis 18.044
Die obere Grenze weicht um 0.32 ab.
2000
7.807 bis 17.721
Saat bei B = 2000
Intervall
Schwankung
1
7.812 bis 17.498
42
7.807 bis 17.721
12345
7.912 bis 17.765
rund 0.27 Minuten Spanne an der oberen Grenze
Bei B = 2000 schwanken die Grenzen je nach Seed noch um rund 0.3 Minuten. Ob das stört, hängt davon ab, wie genau berichtet wird: Für eine Angabe “7.8 bis 17.7” ist es relevant, für “rund 8 bis 18” nicht.
Faustregeln für B. Für Standardfehler genügen 1000 Ziehungen. Für Perzentilintervalle sind 2000 bis 5000 üblich, weil die Quantile an den Rändern der Verteilung liegen und dort weniger Werte zur Verfügung stehen. Für BCa oder für sehr genaue Angaben sind 10 000 angebracht.
Rechenzeit ist selten das Argument: 10 000 Ziehungen aus 40 Werten sind eine Sache von Sekundenbruchteilen. Auf dieser Seite steht B = 2000, weil die Rechnung im Build für jede Seite neu läuft.
Interpretation und Ergebnissatz
Der Seed gehört ins Protokoll. Nicht weil das Ergebnis dadurch richtiger würde, sondern weil eine Bootstrap-Angabe ohne Seed nicht reproduzierbar ist: Wer sie nachrechnet, bekommt andere Grenzen und weiss nicht, ob das an einem Fehler liegt oder am Zufall.
Frage und Datenlage
Nur die ersten acht Wartezeiten: 1.2 bis 2.6 Minuten. Gesucht ist ein Konfidenzintervall für den Median. Der Bootstrap läuft anstandslos durch und liefert etwas, das nicht brauchbar ist.
Die ganze Verteilung besteht aus 22 verschiedenen Zahlen. Von einer glatten Verteilung, deren Quantile man ablesen könnte, kann keine Rede sein.
Maximum der Bootstrap-Verteilung
2.600
Genau das Maximum der Daten. Der Bootstrap kann keinen Wert erzeugen, der nicht beobachtet wurde.
Das letzte ist der grundsätzliche Punkt: Die Bootstrap-Verteilung lebt ausschliesslich innerhalb der beobachteten Werte. Bei acht Beobachtungen sind das acht Zahlen, und aus deren Kombinationen entstehen 22 mögliche Mediane.
Zwei Regeln folgen daraus.
Der Bootstrap braucht genügend Daten. Als grobe Untergrenze gelten 20 bis 30 Beobachtungen, für Kennzahlen an den Verteilungsrändern deutlich mehr. Bei kleinen Stichproben ist eine Formel mit Verteilungsannahme meist die bessere Wahl, auch wenn ihre Annahme unsicher ist.
Für Extremwerte ist er grundsätzlich ungeeignet. Ein Konfidenzintervall für das Maximum wäre nach oben durch das beobachtete Maximum begrenzt, was offensichtlich falsch ist. Dasselbe gilt abgeschwächt für hohe Quantile wie das 95-Prozent-Quantil.
Interpretation und Ergebnissatz
Der Bootstrap warnt nicht. Er liefert für acht Beobachtungen ebenso bereitwillig ein Intervall wie für achthundert, und das Ergebnis sieht in beiden Fällen gleich aus. Die Prüfung, ob genug Daten vorliegen, muss deshalb vorher stattfinden.
Ein nützlicher Blick: die Anzahl verschiedener Werte in der Bootstrap-Verteilung. Sind es wenige Dutzend, ist die Verteilung zu grobkörnig, um Quantile daraus abzulesen.
Für die acht Werte wurde kein Bootstrap-Intervall berechnet. Die Bootstrap-Verteilung des Medians nimmt nur 22 verschiedene Werte an und ist nach oben durch den grössten beobachteten Wert begrenzt; ein daraus abgeleitetes Intervall wäre irreführend. Berichtet wird stattdessen die Spannweite der Beobachtungen.
Verständnisfragen
Warum wird beim Bootstrap mit Zurücklegen gezogen?
Ohne Zurücklegen wäre jede Ziehung identisch mit der Ausgangsstichprobe
Richtig. Zieht man \(n\) aus \(n\) ohne Zurücklegen, erhält man immer dieselben Werte in anderer Reihenfolge, und jede Kennzahl wäre identisch. Erst das Zurücklegen erzeugt Variation.
Um die Stichprobe zu vergrössern
Die Ziehung hat dieselbe Grösse wie das Original; neue Information entsteht nicht.
Weil die Grundgesamtheit unendlich gross ist
Das Zurücklegen bildet das ab, ist aber nicht der Grund für die Notwendigkeit.
Das t-Intervall lautet 7.05 bis 17.54, das Bootstrap-Intervall 7.81 bis 17.72. Woher kommt der Unterschied?
Das t-Intervall ist konstruktionsbedingt symmetrisch, das Bootstrap- Intervall bildet die Rechtsschiefe ab
Richtig. Bei schiefen Daten ist die Verteilung des Mittelwerts ebenfalls schief. Der Bootstrap reicht 4.5 Minuten nach unten und 5.4 nach oben, die Formel zwingend gleich weit in beide Richtungen.
Eines der beiden ist falsch gerechnet
Beide sind korrekt; sie beruhen auf verschiedenen Annahmen.
Der Bootstrap hat zu wenige Ziehungen verwendet
Der Unterschied in der Symmetrie bleibt auch bei sehr grossem B bestehen.
Eine Bootstrap-Verteilung aus 2000 Ziehungen nimmt nur 22 verschiedene Werte an. Was folgt daraus?
Die Stichprobe ist zu klein für den Bootstrap
Richtig. Die Bootstrap-Verteilung entsteht aus Kombinationen der beobachteten Werte. Wenige verschiedene Ergebnisse bedeuten, dass zu wenige Ausgangswerte vorliegen, und die Quantile werden dann grobkörnig und unzuverlässig.
B ist zu klein gewählt
Mehr Ziehungen erzeugen keine neuen Werte, sondern nur häufigere Wiederholungen derselben 22.
Die Kennzahl ist ungeeignet
Der Median ist eine sinnvolle Kennzahl; das Problem liegt am Umfang.
Warum eignet sich der Bootstrap nicht für ein Konfidenzintervall des Maximums?
Weil die Bootstrap-Verteilung den beobachteten Wertebereich nie verlässt
Richtig. Das Maximum jeder Ziehung ist höchstens so gross wie das grösste beobachtete. Die obere Intervallgrenze wäre dadurch immer das beobachtete Maximum, was als Schätzung offensichtlich zu klein ist.
Weil das Maximum keine stetige Kennzahl ist
Stetigkeit ist nicht das Problem; der Median ist ebenfalls nicht stetig und funktioniert bei genügend Daten.
Weil zu viele Ziehungen nötig wären
Auch mit beliebig vielen Ziehungen bleibt die Grenze bestehen.