Die Konzeptseite zur Korrelation erklärt, was ein Korrelationskoeffizient misst. Diese Seite behandelt den Test dazu und die Wahl zwischen den drei Verfahren.
Wann diese Methode, wann nicht
Typische Fragestellungen: Hängt der Absatz mit der Temperatur zusammen, die Bearbeitungszeit mit der Auftragsgrösse, die Zufriedenheit mit der Wartezeit? Gemeinsam ist ihnen, dass keine der beiden Grössen als Zielgrösse ausgezeichnet ist. Sobald eine vorhergesagt werden soll, ist die Regression das passende Verfahren.
Situation
Stattdessen
Eine Grösse soll aus der anderen vorhergesagt werden
keiner der drei Koeffizienten; das Streudiagramm ansehen und ein Modell wählen
Es geht um Übereinstimmung, nicht um Zusammenhang
Bland-Altman-Verfahren oder Intraklassenkorrelation
Die letzte Zeile trennt zwei Dinge, die oft verwechselt werden. Zwei Messgeräte, von denen eines konstant 5 Einheiten zu viel anzeigt, korrelieren perfekt und stimmen trotzdem nie überein.
Grundidee und Modell
Alle drei Koeffizienten messen Zusammenhang auf einer Skala von -1 bis +1, aber sie messen Verschiedenes.
Koeffizient
Was er misst
Grundlage
Pearson \(r\)
Stärke des linearen Zusammenhangs
Produkte der standardisierten Abweichungen vom Mittelwert
Spearman \(\rho\)
Stärke des monotonen Zusammenhangs
Pearson-Korrelation der Ränge
Kendall \(\tau\)
Anteil gleichgerichteter Paare
Vergleich aller Paare: Steigen beide Werte gemeinsam?
Getestet wird bei allen dreien dieselbe Nullhypothese: In der Grundgesamtheit besteht kein Zusammenhang, der Koeffizient ist null. Für Pearson läuft der Test über
\[t = r \sqrt{\frac{n-2}{1-r^2}}\]
mit \(n-2\) Freiheitsgraden. Daraus folgt eine nützliche Einsicht: Ob ein gegebenes \(r\)signifikant wird, hängt allein am Stichprobenumfang. Bei \(n = 10\) braucht es \(r > 0.63\), bei \(n = 500\) genügt \(r > 0.09\).
Das Konfidenzintervall entsteht nicht direkt aus dieser Formel, sondern über die Fisher-z-Transformation, weil die Verteilung von \(r\) nahe -1 und +1 stark schief ist. Deshalb liegt das Intervall auch nicht symmetrisch um \(r\).
Voraussetzungen und ihre Prüfung
Voraussetzung
Gilt für
Prüfung
Folge bei Verletzung
Unabhängige Beobachtungspaare
alle drei
Erhebungsdesign
p-Wert wertlos; bei Zeitreihen ist die Voraussetzung fast nie erfüllt
Linearer Zusammenhang
Pearson
Streudiagramm
\(r\) unterschätzt einen vorhandenen Zusammenhang, siehe Beispiel 2
p-Wert und Intervall werden unzuverlässig, besonders bei kleinem n
Keine einflussreichen Ausreisser
Pearson stark, Spearman kaum
Streudiagramm
ein einzelner Punkt kann \(r\) von 0.3 auf 0.96 heben, siehe Beispiel 3
Das Streudiagramm steht vor jeder Korrelationsrechnung. Kein Korrelationskoeffizient kann die Form des Zusammenhangs beschreiben, und mehrere völlig verschiedene Punktwolken können denselben Wert liefern.
Output lesen
R, cor.test():
Grösse
Was sie sagt
Faustregel oder Falle
t
Teststatistik bei Pearson
folgt aus \(r\) und \(n\); sie enthält keine zusätzliche Information
df
Freiheitsgrade
\(n-2\)
p-value
Wahrscheinlichkeit eines mindestens so grossen Betrags bei fehlendem Zusammenhang
sagt nichts über die Stärke
95 percent confidence interval
Intervall für den wahren Koeffizienten
die aussagekräftigste Zeile; sie ist bei kleinem n erschreckend breit
sample estimates: cor
der Koeffizient selbst
die Zahl, um die es eigentlich geht
S bei Spearman
Summe der quadrierten Rangdifferenzen
nicht direkt deutbar; \(\rho\) steht darunter
T oder z bei Kendall
Teststatistik
je nach Variante und Stichprobengrösse
Warnung Cannot compute exact p-value with ties
Bindungen in den Rängen
R weicht auf eine Näherung aus; bei Spearman und Kendall häufig
kein Konfidenzintervall bei Spearman und Kendall
fehlt in R
über Bootstrap zu bekommen; pingouin gibt eines aus
Python, pg.corr() liefert eine Zeile:
Spalte
Was sie sagt
Unterschied zu R
n
Anzahl vollständiger Paare
in R nicht ausgegeben
r
Koeffizient
wie cor
CI95
Konfidenzintervall
auch für Spearman und Kendall, anders als in R
p-val bzw. p_val
p-Wert
wie p-value
BF10
Bayes-Faktor bei Pearson
in R nicht enthalten
power
erreichte Power
in R nicht enthalten
Interpretationsfallen
Korrelation ist keine Kausalität. Der Satz ist abgegriffen und trotzdem der häufigste Fehler. Eine dritte, nicht erhobene Grösse kann beide treiben.
\(r = 0\) heisst nicht “kein Zusammenhang”. Es heisst “kein linearer Zusammenhang”. Eine perfekte Parabel liefert \(r\) nahe null.
Signifikant heisst nicht stark. Bei \(n = 500\) wird \(r = 0.1\)signifikant und erklärt ein Prozent der Streuung.
\(r\) ist kein Prozentwert. Erst \(r^2\) ist ein Anteil. Von \(r = 0.5\) auf \(r = 0.7\) verdoppelt sich der erklärte Anteil beinahe.
Ausreisser bestimmen \(r\). Ein einzelner Punkt weit ausserhalb kann eine Korrelation erzeugen oder verschwinden lassen.
Eingeschränkte Wertebereiche senken \(r\). Wer nur Werte aus einem schmalen Ausschnitt erhebt, misst eine kleinere Korrelation als in der ganzen Grundgesamtheit vorhanden ist.
Gemischte Gruppen erzeugen Scheinkorrelationen. Zwei Teilgruppen ohne internen Zusammenhang ergeben zusammen eine deutliche Korrelation, wenn sie in beiden Grössen verschoben liegen. Deshalb das Streudiagramm.
Bei Zeitreihen ist die Unabhängigkeit verletzt. Zwei beliebige steigende Reihen korrelieren hoch, ohne dass ein Zusammenhang besteht.
Ergebnis berichten
Vorlage für den Ergebnissatz:
[Grösse 1] und [Grösse 2] hängen zusammen: \(r\) = [Wert], 95-Prozent-Konfidenzintervall [unten] bis [oben], t([df]) = [t], p = [p], n = [n]. Der Zusammenhang erklärt [r²] der Streuung.
Genannt werden: das verwendete Verfahren und warum es gewählt wurde, der Koeffizient mit Konfidenzintervall, Teststatistik mit Freiheitsgraden, p-Wert und n. Dazu gehört die Feststellung, dass das Streudiagramm angesehen wurde, und bei Ausschlüssen die Begründung.
Bei genau einem Prädiktor sind der Pearson-Korrelationstest und der t-Test der Steigung in der einfachen linearen Regressionderselbe Test: gleiche Teststatistik, gleiche Freiheitsgrade, gleicher p-Wert. Sie unterscheiden sich nur darin, was sie zusätzlich ausgeben.
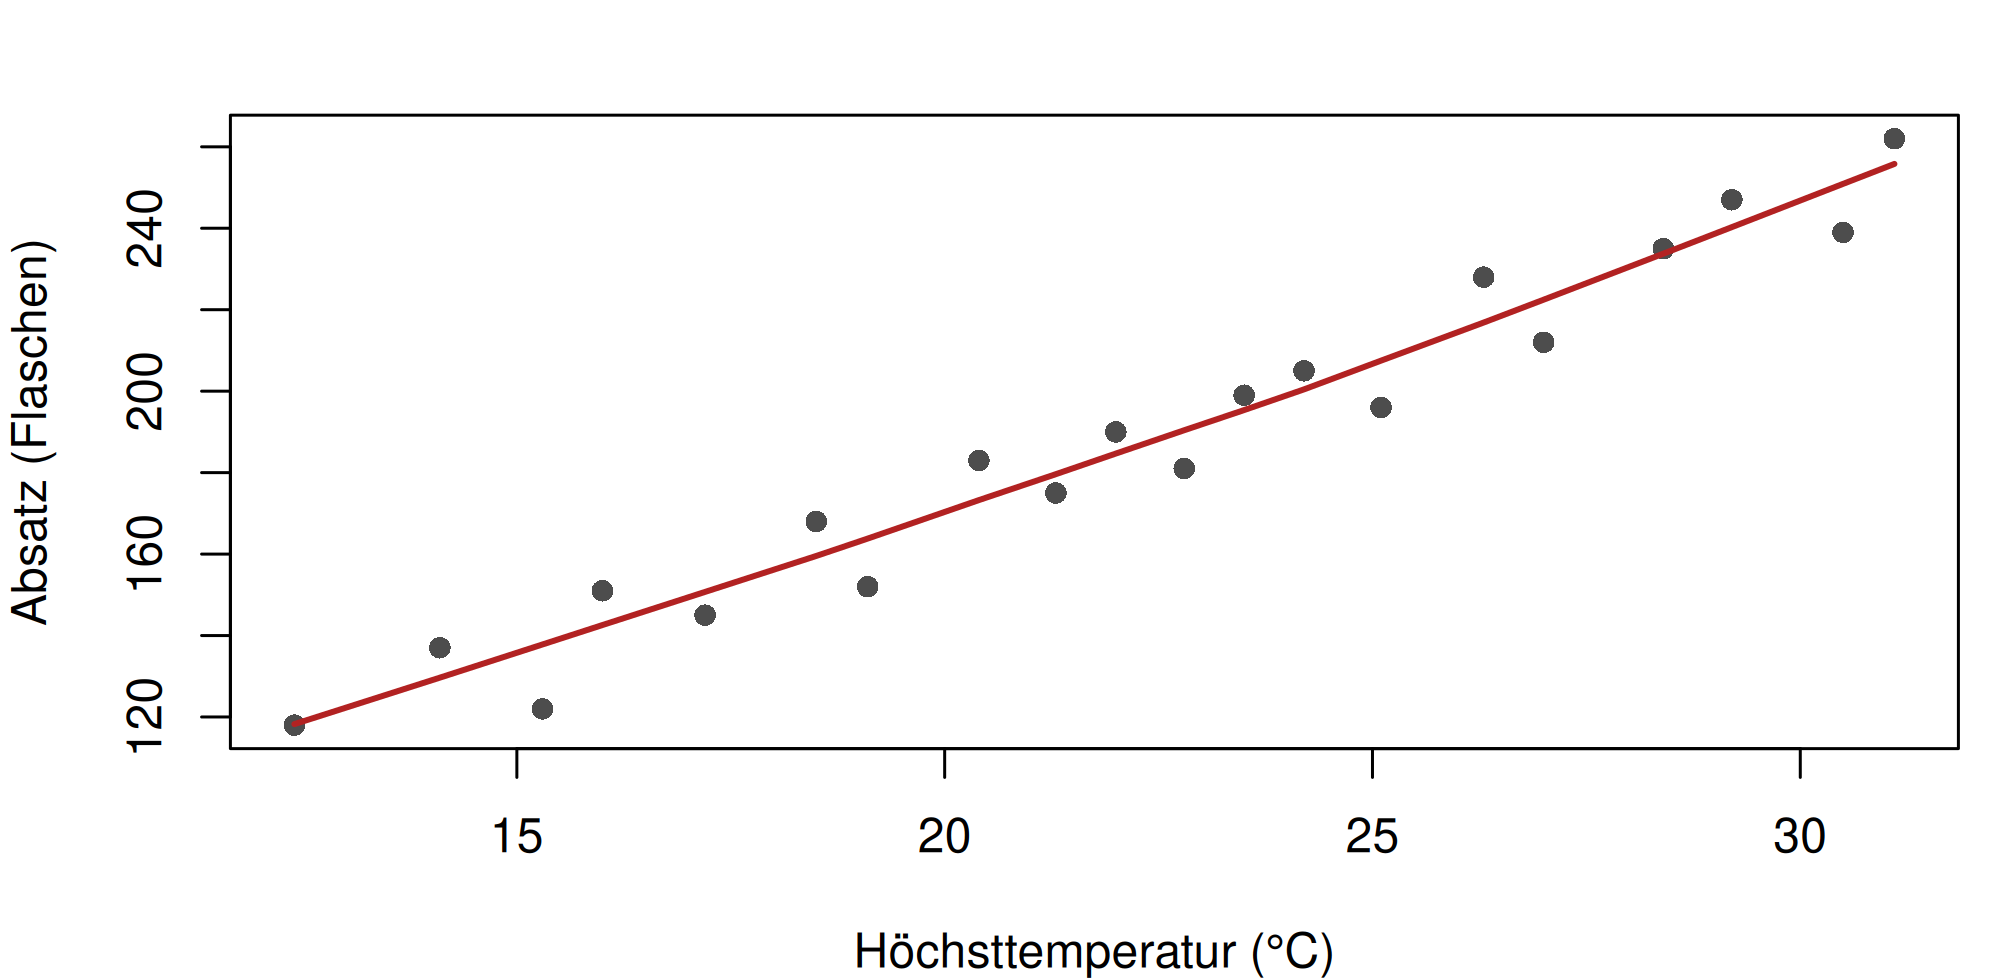
An zwanzig Tagen wurden die Höchsttemperatur in Grad Celsius und der Absatz von Kaltgetränken in Flaschen erfasst. Die Frage lautet: Hängen die beiden Grössen zusammen, und wie eng?
Es soll nichts vorhergesagt werden, und keine der beiden Grössen ist ausgezeichnet. Damit ist der Korrelationstest passend und nicht die Regression.
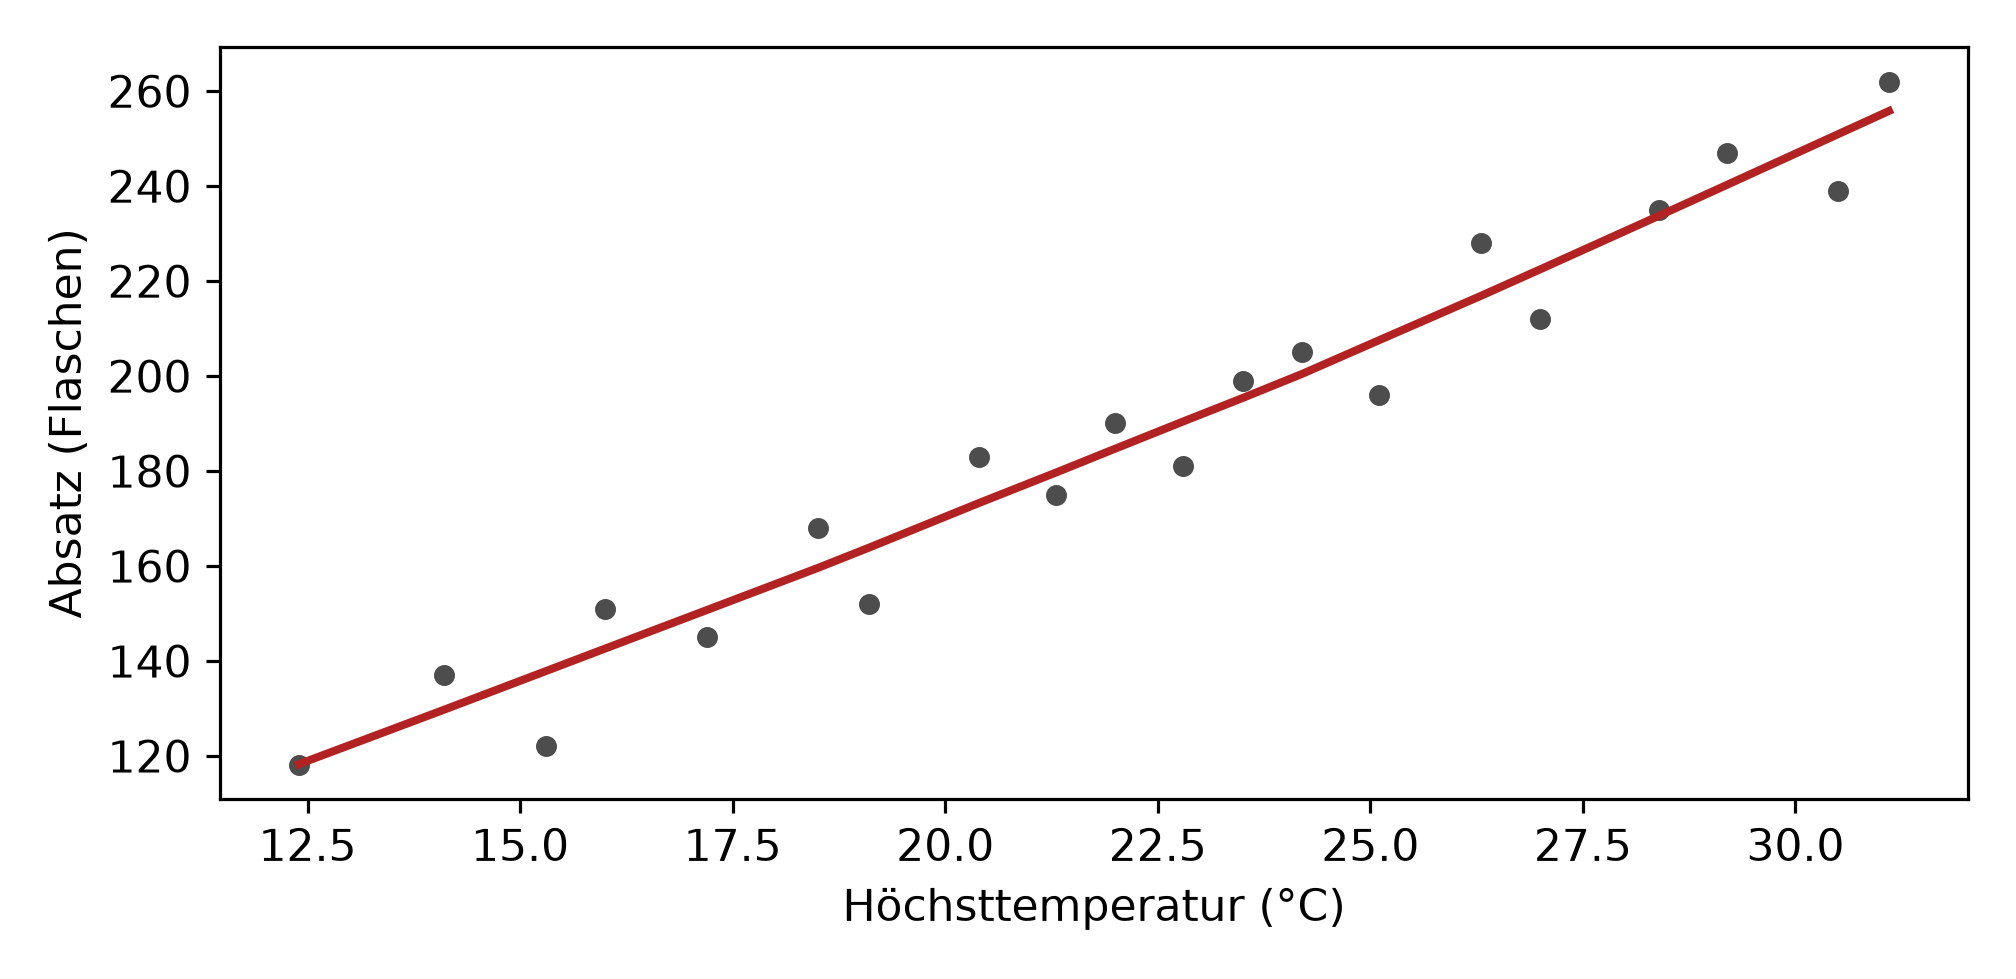
Abbildung 2: Beispiel 1: dieselbe Darstellung in Python.
Die Punkte steigen gleichmässig an, die Glättungslinie verläuft praktisch gerade, und es gibt keinen Punkt weit ausserhalb der Wolke. Der Zusammenhang ist linear, damit ist Pearson das passende Verfahren.
    Pearson's product-moment correlation

data:  temperatur and absatz
t = 19.396, df = 18, p-value = 1.635e-13
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.9413081 0.9910098
sample estimates:
      cor
0.9769019
print(pg.corr(temperatur, absatz).round(4).T)
            pearson
n                20
r            0.9769
CI95   [0.94, 0.99]
p_val           0.0
BF10      1.855e+10
power           1.0
Output Zeile für Zeile
Ausgabe
Wert hier
Bedeutung
Wie er zu lesen ist
cor bzw. r
0.977
Pearson-Korrelation
Ein sehr enger linearer Zusammenhang. Werte über 0.9 sind in erhobenen Daten selten und meist ein Hinweis darauf, dass beide Grössen von derselben Ursache getrieben werden.
t
19.396
Teststatistik
Sie folgt allein aus \(r\) und \(n\) und enthält keine zusätzliche Information.
df
18
Freiheitsgrade
\(n-2\), also 20 minus 2.
p-value
1.6e-13
Wahrscheinlichkeit eines mindestens so grossen Betrags ohne Zusammenhang
Praktisch ausgeschlossen.
95 percent confidence interval
0.941 bis 0.991
Intervall für den wahren Koeffizienten
Die aussagekräftigste Zeile. Beachten Sie die Unsymmetrie: von 0.977 sind es 0.036 nach unten und nur 0.014 nach oben. Das liegt an der Fisher-z-Transformation und daran, dass \(r\) bei 1 endet.
\(r^2\)
0.954
Anteil gemeinsamer Streuung
Rund 95 Prozent der Absatzschwankung gehen mit der Temperatur einher. Diese Zahl steht in keiner der beiden Ausgaben und muss selbst gebildet werden.
power (nur Python)
nahe 1
Bei diesem Effekt und n = 20 hätte der Test kaum etwas übersehen können.
Interpretation und Ergebnissatz
Der Zusammenhang ist eng, und trotzdem sagt er nichts über Ursachen. Denkbar ist, dass Wärme den Durst treibt; ebenso denkbar ist, dass an warmen Tagen mehr Menschen unterwegs sind und deshalb mehr gekauft wird. Die Korrelation ist symmetrisch und kennt keine Richtung.
Wer eine Aussage in Flaschen je Grad braucht, ist beim Korrelationstest falsch. Der Koeffizient hat keine Einheit; die Steigung liefert die Regression.
Höchsttemperatur und Absatz hängen eng zusammen: \(r\) = 0.98, 95-Prozent-Konfidenzintervall 0.94 bis 0.99, t(18) = 19.40, p < 0.001, n = 20. Der Zusammenhang erklärt rund 95 Prozent der gemeinsamen Streuung. Das Streudiagramm zeigt einen linearen Verlauf ohne auffällige Punkte. Über die Richtung der Wirkung lässt sich daraus nichts ableiten.
Frage und Datenlage
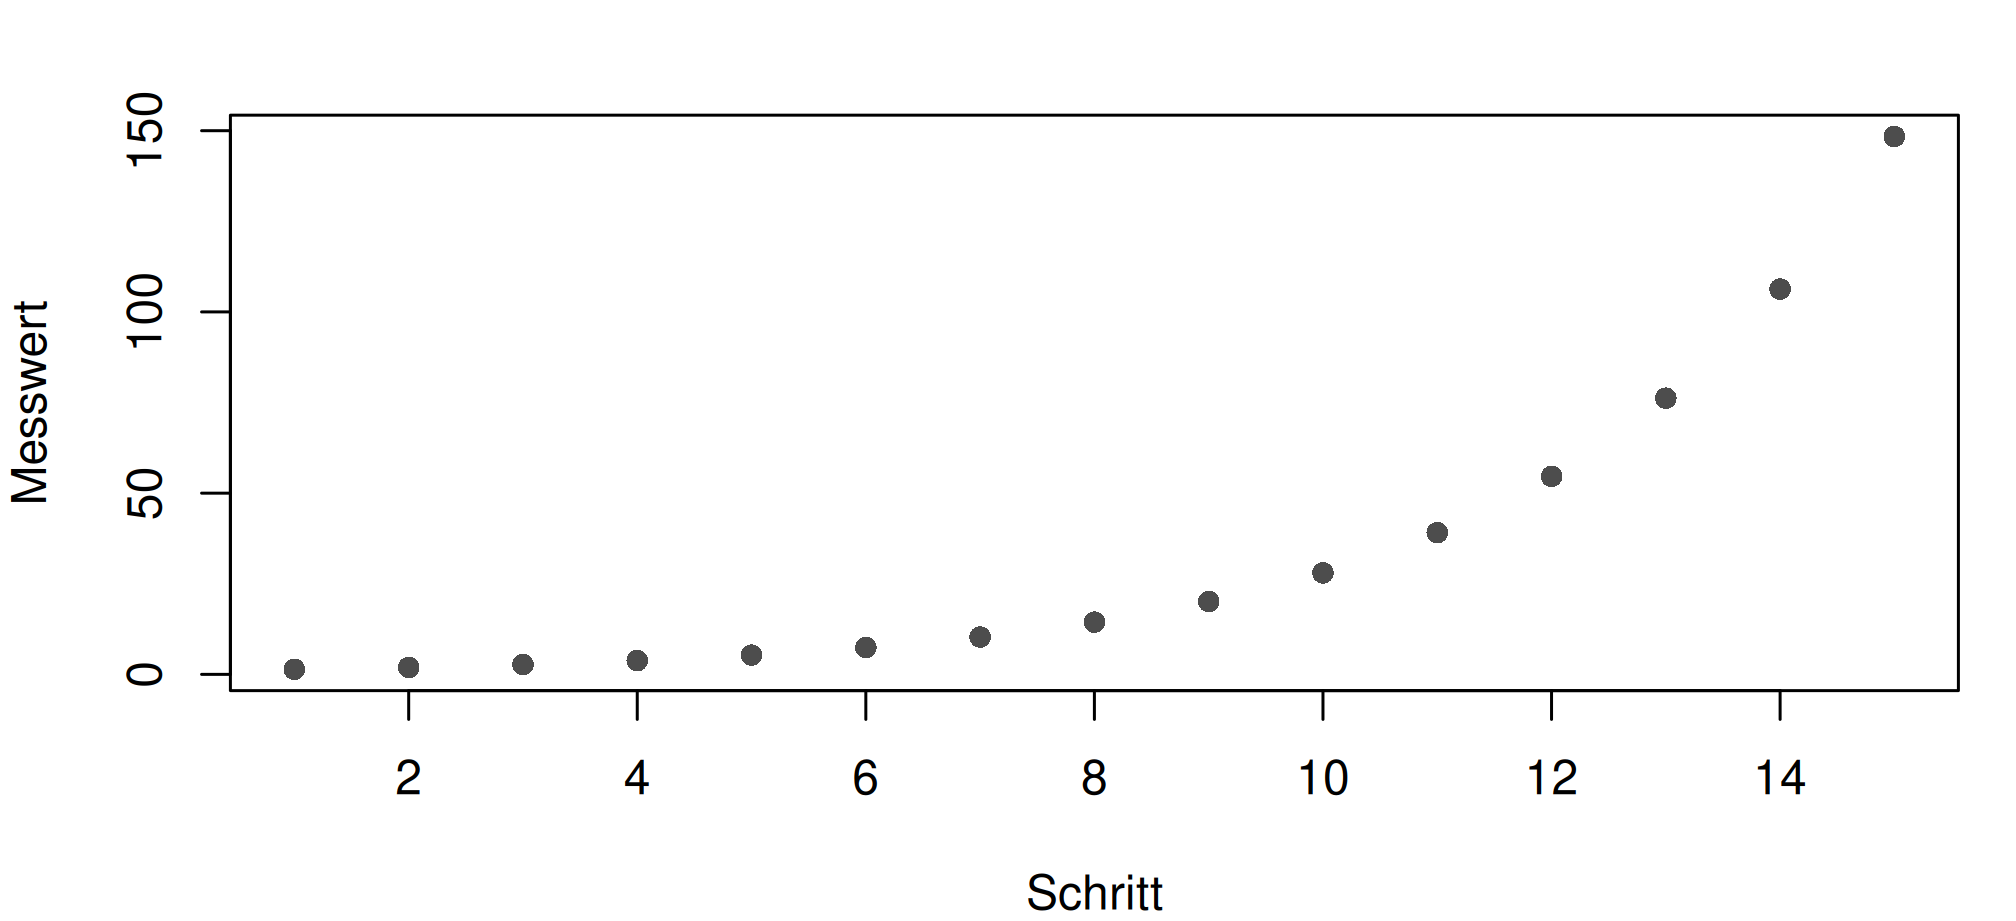
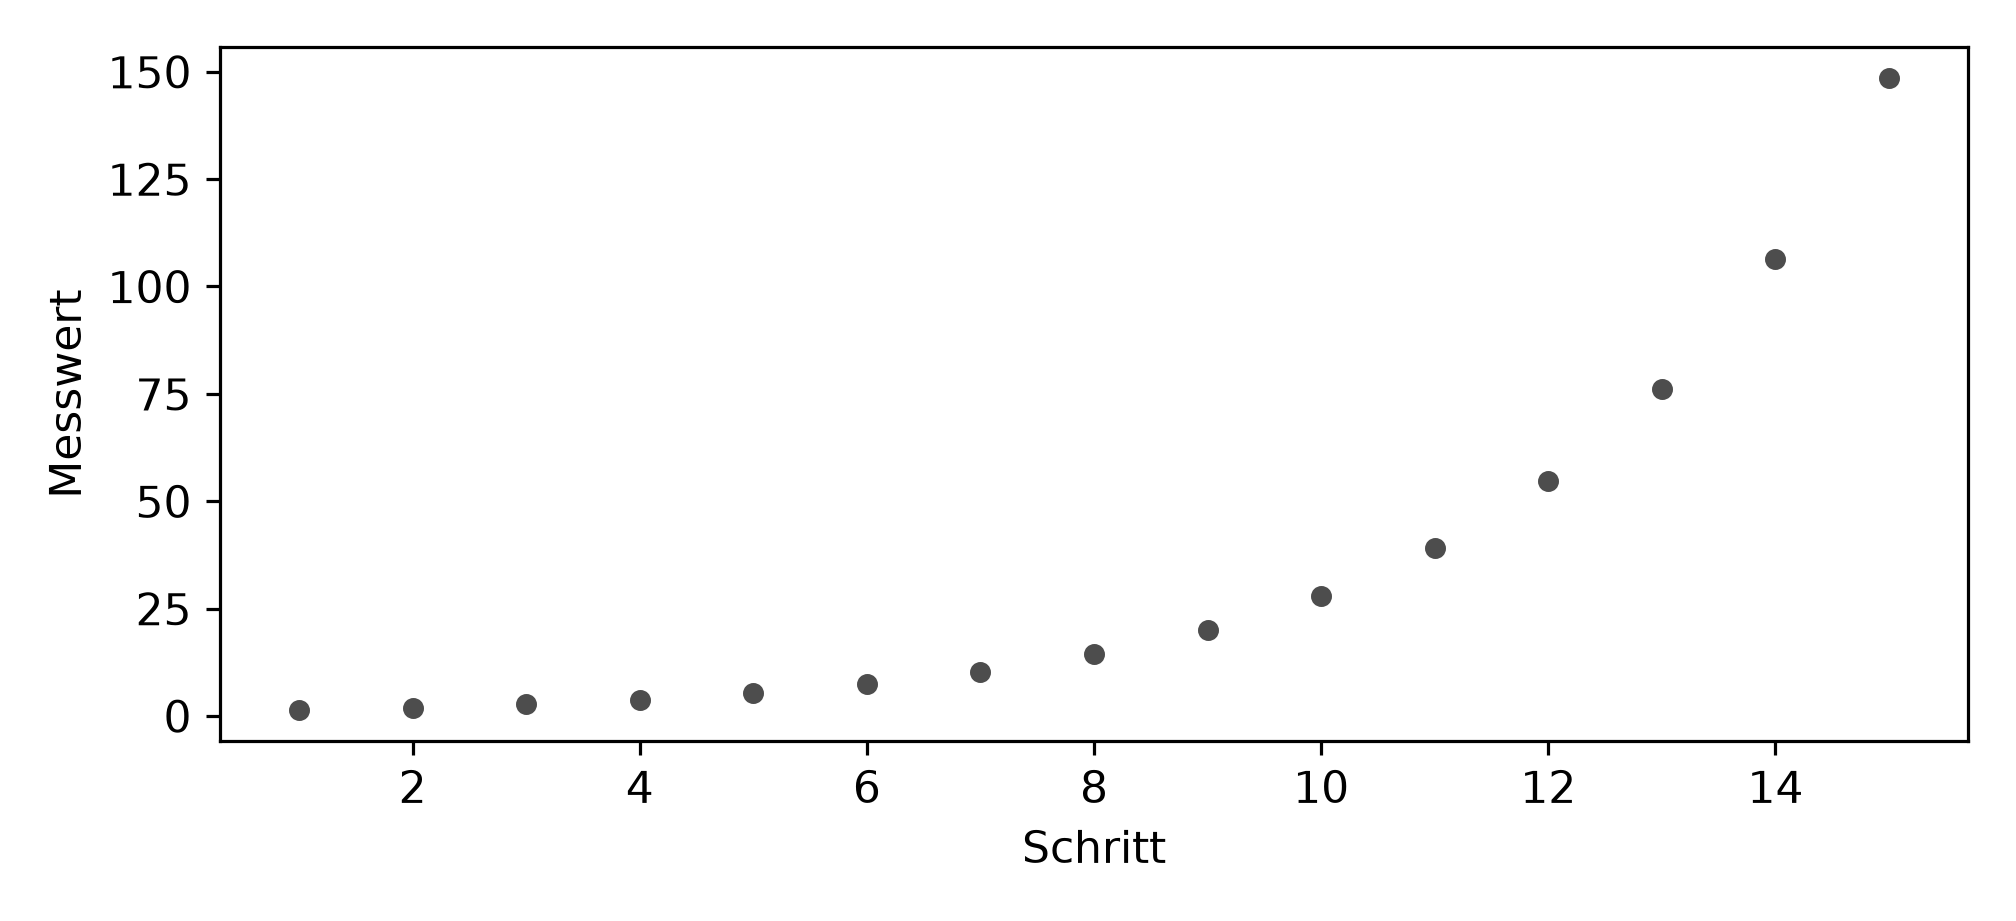
Fünfzehn Messungen eines Wachstumsvorgangs: Der Wert verdoppelt sich in gleichmässigen Abständen. Der Zusammenhang ist perfekt monoton und deutlich gekrümmt. Das Beispiel zeigt, warum die Wahl zwischen Pearson und Spearman keine Geschmacksfrage ist.
    Pearson's product-moment correlation

data:  schritt and messwert
t = 6.1142, df = 13, p-value = 3.695e-05
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.6248274 0.9530902
sample estimates:
      cor
0.8613825
cor.test(schritt, messwert, method ="spearman")
    Spearman's rank correlation rho

data:  schritt and messwert
S = 1.2434e-13, p-value < 2.2e-16
alternative hypothesis: true rho is not equal to 0
sample estimates:
rho
  1
Abbildung 3: Beispiel 2: perfekt monoton, aber nicht linear.
Abbildung 4: Beispiel 2: dieselbe Darstellung in Python.
for art in ("pearson", "spearman", "kendall"): zeile = pg.corr(schritt, messwert, method=art).round(4)print(f"{art:9s} r = {float(zeile['r'].iloc[0]):+.4f}")
pearson   r = +0.8614
spearman  r = +1.0000
kendall   r = +1.0000
Output Zeile für Zeile
Koeffizient
Wert hier
Wie er zu lesen ist
Pearson \(r\)
0.861
Sieht nach einem starken, aber unvollkommenen Zusammenhang aus. Der Eindruck ist falsch.
Pearson \(r^2\)
0.742
Es fehlen scheinbar 26 Prozent der Streuung. Tatsächlich fehlt nichts: Was \(r\) nicht erfasst, ist die Krümmung, nicht Zufall.
Spearman \(\rho\)
1.000
Perfekt. Jeder Schritt liefert einen höheren Wert als der vorige, mehr verlangt ein monotoner Zusammenhang nicht.
Spearman S
1.24e-13
Die Summe der quadrierten Rangdifferenzen. Sie ist rechnerisch null, weil die Rangfolgen identisch sind; R gibt einen winzigen Rundungsrest aus statt einer glatten Null.
Kendall \(\tau\)
1.000
Ebenfalls perfekt. Von allen 105 Paaren steigt keines gegenläufig.
Der Vergleich macht den Unterschied greifbar. Pearson misst, wie gut die Punkte auf einer Geraden liegen; sie tun es nicht, also bleibt \(r\) unter 1. Spearman und Kendall messen, ob die Reihenfolge übereinstimmt; sie tut es vollständig, also erreichen beide den Höchstwert.
Hier wäre es falsch, einfach Spearman zu berichten und zufrieden zu sein. Die interessante Erkenntnis ist die Form: Der Vorgang wächst nicht linear, sondern exponentiell. Eine Korrelation von 1.000 verdeckt das eher, als sie es zeigt. Wer die Form braucht, logarithmiert die Zielgrösse und rechnet dann weiter; nach dem Logarithmieren wäre auch Pearsons \(r\) praktisch 1.
Interpretation und Ergebnissatz
Zwischen Schritt und Messwert besteht ein perfekt monotoner Zusammenhang (Spearman\(\rho\) = 1.00, n = 15). Pearsons \(r\) beträgt 0.86 und unterschätzt den Zusammenhang, weil der Verlauf gekrümmt ist; das Streudiagramm zeigt exponentielles Wachstum. Für die weitere Auswertung wurde der Messwert logarithmiert.
Frage und Datenlage
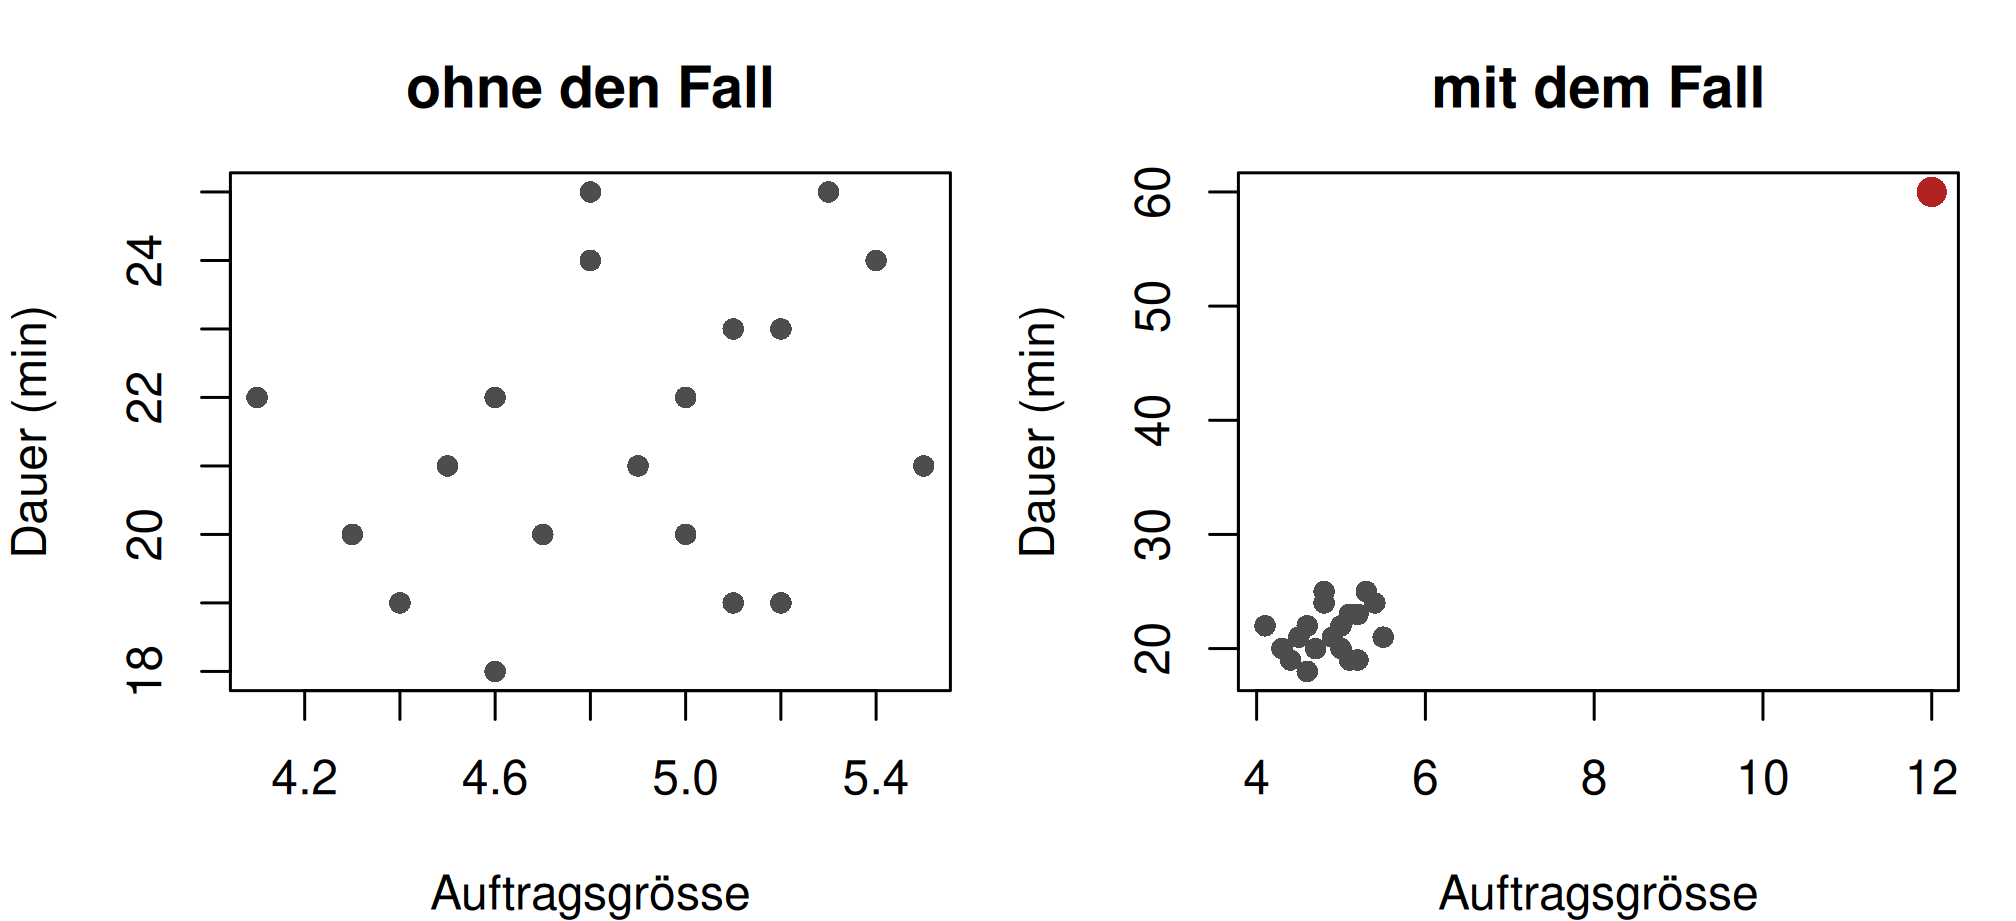
Neunzehn Betriebe, erfasst sind die durchschnittliche Auftragsgrösse und die Bearbeitungsdauer. Ein zwanzigster Betrieb kommt hinzu, der in beiden Grössen weit ausserhalb liegt.
    Spearman's rank correlation rho

data:  groesse_mit and dauer_mit
S = 801.22, p-value = 0.08258
alternative hypothesis: true rho is not equal to 0
sample estimates:
      rho
0.3975777
Abbildung 5: Beispiel 3: dieselben 19 Punkte, einmal ohne und einmal mit dem zwanzigsten.
Eine einzige zusätzliche Beobachtung hebt die Korrelation von schwach auf nahezu perfekt.
Konfidenzintervall
-0.19 bis 0.66
0.90 bis 0.99
Die beiden Intervalle überschneiden sich nicht einmal.
t
1.255
14.984
p-value
0.226
1.3e-11
Aus einem Nullbefund wird ein hochsignifikantes Ergebnis.
\(r^2\)
0.085
0.926
Von 8 auf 93 Prozent erklärte Streuung.
Spearman \(\rho\) (mit dem Fall)
0.398
Der Rangkoeffizient bleibt bei 0.40 und ist mit p = 0.08 nicht signifikant. Für ihn ist der Ausreisser einfach der grösste von zwanzig Werten, nicht ein zwanzigfach entfernter.
Der Grund steckt in der Formel: Pearsons \(r\) arbeitet mit Abweichungen vom Mittelwert, und ein Punkt, der in beiden Grössen weit aussen liegt, liefert ein riesiges Produkt. Er bestimmt damit den Zähler fast allein. Der Rangkoeffizient sieht nur, dass dieser Betrieb in beiden Reihen den letzten Platz belegt, und das zählt genauso viel wie jeder andere Platz.
Interpretation und Ergebnissatz
Der Punkt wird nicht gelöscht, weil er stört, und er wird nicht behalten, weil er ein schönes Ergebnis liefert. Er wird geprüft:
Befund
Vorgehen
Erfassungsfehler, etwa Minuten und Stunden vermischt
ausschliessen, Begründung berichten
Anderer Betriebstyp, der nicht zur Fragestellung gehört
ausschliessen, Grundgesamtheit im Bericht enger fassen
Gültiger, seltener Fall
beide Ergebnisse berichten und offenlegen, dass die Aussage an einer Beobachtung hängt
In jedem Fall gehört ein rangbasierter Koeffizient daneben. Wenn Pearson und Spearman weit auseinanderliegen, ist das ein Warnsignal, und zwar unabhängig davon, welcher der beiden gerade das gewünschte Ergebnis liefert.
In den 19 vergleichbaren Betrieben besteht kein nachweisbarer Zusammenhang zwischen Auftragsgrösse und Bearbeitungsdauer (\(r\) = 0.29, 95-Prozent-Konfidenzintervall -0.19 bis 0.66, t(17) = 1.26, p = 0.23). Ein zwanzigster Betrieb liegt in beiden Grössen weit ausserhalb und hebt \(r\) auf 0.96; Spearmans \(\rho\) bleibt mit 0.40 unauffällig. Der Fall wurde als andersartiger Betriebstyp ausgeschlossen.
Frage und Datenlage
500 Beobachtungen, ein schwacher, aber echter Zusammenhang. Damit beide Sprachen exakt dieselben Daten sehen, werden sie nicht gezogen, sondern aus Quantilen der Normalverteilung konstruiert.
            pearson
n               500
r            0.2326
CI95   [0.15, 0.31]
p_val           0.0
BF10      5.495e+04
power        0.9996
Output Zeile für Zeile
Ausgabe
Wert hier
Wie er zu lesen ist
cor bzw. r
0.233
Ein schwacher Zusammenhang.
t
5.337
df
498
\(n-2\).
p-value
1.4e-07
Hochsignifikant.
95 percent confidence interval
0.15 bis 0.31
Anders als bei kleinem n ist das Intervall schmal: Der schwache Zusammenhang ist präzise geschätzt.
\(r^2\)
0.054
Und hier steht die eigentliche Antwort: Gemeinsam erklären die beiden Grössen 5 Prozent der Streuung. 95 Prozent gehen auf anderes zurück.
Derselbe Koeffizient von 0.233 wäre bei n = 20 mit p = 0.32 ein glatter Nullbefund gewesen. Der p-Wert misst also nicht die Stärke des Zusammenhangs, sondern wie gut man ihn bei diesem Umfang vom Zufall unterscheiden kann.
Interpretation und Ergebnissatz
Ob 5 Prozent erklärte Streuung viel oder wenig sind, entscheidet die Sache. Für eine Vorhersage im Einzelfall ist es zu wenig; für die Beschreibung eines Zusammenhangs in einer grossen Grundgesamtheit kann es genügen.
Die brauchbarste Angabe für einen Bericht ist deshalb nicht der p-Wert, sondern \(r\) mit Intervall und \(r^2\). Sie beantworten die Frage, um die es geht: wie stark, und wie sicher ist diese Angabe?
Zwischen den beiden Merkmalen besteht ein schwacher, aber statistisch nachweisbarer Zusammenhang (\(r\) = 0.23, 95-Prozent-Konfidenzintervall 0.15 bis 0.31, t(498) = 5.34, p < 0.001, n = 500). Er erklärt rund 5 Prozent der gemeinsamen Streuung; für Aussagen im Einzelfall ist er zu schwach.
Verständnisfragen
Pearsons \(r\) beträgt 0.86, Spearmans \(\rho\) beträgt 1.00. Was folgt daraus?
Der Zusammenhang ist perfekt monoton, aber nicht linear
Richtig. Spearman misst die Übereinstimmung der Rangfolgen und erreicht 1, wenn jeder Schritt einen höheren Wert liefert. Pearson misst die Nähe zu einer Geraden und bleibt darunter, sobald der Verlauf gekrümmt ist.
Einer der beiden Werte muss falsch sein
Beide sind korrekt; sie messen Verschiedenes.
Die Daten enthalten Ausreisser
Ausreisser senken eher Spearman relativ zu Pearson, nicht umgekehrt.
Ein Datensatz liefert \(r\) = 0.29 und p = 0.23. Nach Hinzufügen einer einzigen Beobachtung liefert er \(r\) = 0.96 und p < 0.001. Was ist zu tun?
Den Fall prüfen und das Ergebnis mit und ohne ihn berichten
Richtig. Welche der beiden Zahlen berichtet wird, entscheidet die Klärung der Ursache, nicht das Ergebnis. Wenn die Ursache offenbleibt, gehören beide Werte in den Bericht.
Die Beobachtung entfernen, sie ist offensichtlich fehlerhaft
Weit aussen liegend heisst nicht fehlerhaft. Ohne Klärung ist das Entfernen eine Manipulation des Ergebnisses.
Das Ergebnis mit allen zwanzig Beobachtungen berichten, mehr Daten sind besser
Eine Aussage, die vollständig an einer von zwanzig Beobachtungen hängt, ist keine belastbare Aussage.
Bei n = 500 ist \(r\) = 0.23 hochsignifikant. Wie stark ist der Zusammenhang?
Schwach: er erklärt rund 5 Prozent der Streuung
Richtig. Die Stärke liest man an \(r\) und \(r^2\), nicht am p-Wert. Der p-Wert sagt nur, dass der Zusammenhang bei diesem Umfang vom Zufall unterscheidbar ist.
Stark, sonst wäre er nicht hochsignifikant
Signifikanz hängt an \(r\)und an n. Bei 500 Beobachtungen genügt bereits \(r\) = 0.09.
Mittel, 0.23 liegt zwischen 0 und 0.5
Die Einordnung über \(r\) allein unterschlägt, dass \(r\) kein Anteil ist; erst \(r^2\) ist einer.
Warum liegt das Konfidenzintervall für \(r\) = 0.977 nicht symmetrisch um diesen Wert?
Weil \(r\) bei 1 endet und die Verteilung dort schief ist
Richtig. Das Intervall entsteht über die Fisher-z-Transformation, die den Bereich von -1 bis 1 auf die ganze Zahlengerade streckt. Zurückgerechnet ergibt das ein unsymmetrisches Intervall, und zwar umso deutlicher, je näher \(r\) an 1 liegt.
Weil die Stichprobe zu klein ist
Die Unsymmetrie bleibt auch bei grossem n, sie wird nur weniger sichtbar, weil das Intervall schrumpft.
Weil ein Rechenfehler vorliegt
Ein symmetrisches Intervall wäre hier der Fehler, denn es könnte über 1 hinausreichen.