Typische Fragestellungen: Welche Merkmale erhöhen das Kündigungsrisiko, wie wirkt eine Behandlung bei gleichem Alter, welchen Beitrag hat die Distanz zum Studio, wenn die Vertragsart konstant gehalten wird.
Das Cox-Modell ist der Schritt vom Vergleich zum Effektmass. Es liefert je Prädiktor ein Hazard Ratio, also einen Faktor, um den sich das momentane Risiko ändert, und kann dabei mehrere Grössen gleichzeitig berücksichtigen. Es heisst semiparametrisch, weil es den zeitlichen Verlauf des Grundrisikos offenlässt und nur die Verhältnisse zwischen den Beobachtungen modelliert.
Das Modell zerlegt das Risiko in zwei Teile: einen zeitlichen Verlauf, der für alle gleich ist, und einen Faktor, der von den Prädiktoren abhängt und über die Zeit konstant bleibt.
Hazard-Rate bei Prädiktorwerten \(x\): momentanes Risiko, keine Wahrscheinlichkeit
\(h_0(t)\)
Grundrisiko über die Zeit, bleibt unspezifiziert und wird nicht geschätzt
\(\beta_j\)
Effekt von \(x_j\) auf den logarithmierten Hazard
\(e^{\beta_j}\)
Hazard Ratio: Faktor, um den sich das Risiko je Einheit von \(x_j\) ändert, bei konstant gehaltenen übrigen Prädiktoren
\(e^{\beta_1 x_1 + \dots}\)
gemeinsamer Faktor aller Prädiktoren
Geschätzt wird über die partielle Likelihood, die nur die Reihenfolge der Ereignisse nutzt: Zu jedem Ereigniszeitpunkt wird gefragt, wie wahrscheinlich es war, dass gerade diese Beobachtung das Ereignis hatte, gegeben wer zu diesem Zeitpunkt unter Risiko stand. Das Grundrisiko kürzt sich dabei heraus, und genau deshalb muss es nie geschätzt werden.
Was “proportional” heisst. Zwei Beobachtungen mit verschiedenen Prädiktorwerten haben Hazard-Kurven, die zu jedem Zeitpunkt im selben Verhältnis stehen. Steigt und fällt das Grundrisiko im Lauf der Zeit, tun das beide Kurven gemeinsam; ihr Abstand auf der Log-Skala bleibt konstant. Genau diese Annahme macht ein einzelnes Hazard Ratio überhaupt erst sinnvoll und genau sie wird in Beispiel 4 verletzt.
Ein Hazard Ratio von 2 bedeutet: doppeltes momentanes Risiko. Es bedeutet nicht doppelt so schnell, nicht halbe Laufzeit und nicht doppelte Wahrscheinlichkeit.
Voraussetzungen und ihre Prüfung
Voraussetzung
Was sie bedeutet
Prüfung
Folge bei Verletzung
Vorgehen
Proportionale Hazards
Das Hazard Ratio ist über die Zeit konstant
cox.zph() beziehungsweise proportional_hazard_test(), dazu die Residuenplots
Ein einzelnes Hazard Ratio ist irreführend, weil es über verschiedene Zeiträume mittelt
Faustregel: mindestens etwa zehn Ereignisse je geschätztem Koeffizienten
Ereignisse zählen
Überanpassung, zu enge Intervalle
Modell verkleinern
Output lesen
R, summary(coxph(...)):
Grösse
Was sie sagt
Faustregel oder Falle
n, number of events
Beobachtungen und Ereignisse
die Ereigniszahl trägt die Genauigkeit
coef
geschätztes \(\beta_j\), Effekt auf den log-Hazard
Vorzeichen zeigt die Richtung
exp(coef)
Hazard Ratio
1 heisst kein Effekt, über 1 höheres Risiko
se(coef)
Standardfehler auf der log-Skala
Intervalle werden dort gebildet und dann exponiert
z, Pr(>|z|)
Wald-Test je Koeffizient
prüft nur diesen Koeffizienten
lower .95, upper .95
Konfidenzintervall des Hazard Ratio
enthält es 1, ist der Effekt nicht signifikant
Concordance
Anteil richtig geordneter Paare
0.5 ist Zufall, ab etwa 0.7 brauchbar
Likelihood ratio test
Gesamttest gegen das Nullmodell
Gegenstück zum F-Test der linearen Regression
Wald test, Score (logrank) test
zwei weitere Gesamttests
bei grossem n praktisch gleich; der Score-Test ist bei einem kategorialen Prädiktor der Log-Rank-Test
cox.zph()
Prüfung der Proportionalität
kleiner p-Wert heisst Annahme verletzt, nicht Modell bestätigt
Python, CoxPHFitter.print_summary():
Grösse
Was sie sagt
Unterschied zu R
coef, exp(coef)
wie in R
identisch
se(coef), z, p
wie in R
identisch
coef lower 95%, exp(coef) lower 95%
Intervalle auf beiden Skalen
R zeigt nur die exponierten Grenzen
-log2(p)
p-Wert als Bits
in R nicht enthalten
Concordance
wie in R
identisch
Partial AIC
Kennzahl für Modellvergleiche
in R über AIC(modell)
log-likelihood ratio test
Gesamttest
wie in R
Drei Unterschiede in der Handhabung:
In Python müssen kategoriale Prädiktoren selbst als Indikatorvariablen vorliegen, R übernimmt das über Faktoren.
Die Referenzkategorie ist in R die erste Faktorstufe, in Python die mit dem Wert null; die Richtung des Hazard Ratio hängt daran.
Die Prüfung der Proportionalität verwendet verschiedene Zeittransformationen: cox.zph() in R standardmässig eine Kaplan-Meier-Transformation, proportional_hazard_test() in Python das, was man in time_transform angibt. Die p-Werte weichen deshalb ab, ohne dass einer falsch wäre.
Interpretationsfallen
Hazard Ratio ist kein Zeitverhältnis. Ein Faktor 2 bedeutet doppeltes momentanes Risiko, nicht halbe Laufzeit.
Hazard Ratio ist keine Wahrscheinlichkeit. Es ist ein Verhältnis von Raten und kann beliebig über eins liegen.
Ein einzelnes Hazard Ratio setzt Proportionalität voraus. Ohne diese Prüfung ist die Zahl ein Mittel über Zeiträume, die sich unterscheiden können.
Ein signifikanter Test auf Proportionalität bestätigt nicht das Modell, er weist auf eine Verletzung hin. Umgekehrt beweist ein grosser p-Wert die Annahme nicht, er widerlegt sie nur nicht.
Je Einheit ist nicht je Spannweite. Bei metrischen Prädiktoren gehört der Effekt für einen fachlich sinnvollen Abstand berichtet.
Bei konstant gehaltenen anderen Prädiktoren heisst: unter den aufgenommenen. Eine nicht erhobene gemeinsame Ursache bleibt unsichtbar; ein Hazard Ratio ist keine Kausalaussage.
Konkordanz ist keine Signifikanz. Ein Modell kann signifikante Effekte und eine Konkordanz nahe 0.5 haben.
Die Ereigniszahl begrenzt das Modell, nicht die Fallzahl. Mit 40 Ereignissen sind vier Prädiktoren zu viel.
Ergebnis berichten
Vorlage für den Ergebnissatz:
In einem Cox-Modell mit [Prädiktoren] ist [Prädiktor] mit dem Risiko assoziiert: Hazard Ratio [Wert] (95-Prozent-Konfidenzintervall [unten] bis [oben], p = [p]), bei konstant gehaltenen übrigen Prädiktoren. Das Modell beruht auf [n] Beobachtungen mit [Ereignisse] Ereignissen; die Konkordanz beträgt [Wert]. Die Annahme proportionaler Hazards wurde geprüft [Ergebnis].
Immer genannt werden: Hazard Ratio mit Konfidenzintervall und p-Wert je Prädiktor, n und Ereigniszahl getrennt, Konkordanz, das Ergebnis der Proportionalitätsprüfung und bei metrischen Prädiktoren die Einheit, auf die sich das Hazard Ratio bezieht.
Verteilungsform begründet, Vorhersage über den Beobachtungszeitraum hinaus
Modelle mit zeitabhängigen Effekten
Proportionalität verletzt und der Effekt selbst interessiert
Frailty-Modelle
geschachtelte oder wiederholte Ereignisse je Person
Beispiele
Die Beispiele 1 bis 3 und 5 arbeiten mit dem Abo-Datensatz aus Kaplan-Meier: 400 Fitnessabos, Vertragsart und Distanz zum Studio als Einflussgrössen, Stichtag nach 24 Monaten. Eingebaut sind ein Faktor\(e^{0.85} = 2.34\) für den Monatsvertrag und \(e^{0.045} = 1.046\) je Kilometer. Beispiel 4 verwendet den Datensatz mit kreuzenden Kurven aus dem Log-Rank-Test.
Auf dieser Skala wird gerechnet, und dort ist der Effekt additiv. Berichtet wird die exponierte Fassung.
exp(coef) = 3.060
Monatsverträge haben das rund Dreifache des momentanen Kündigungsrisikos
Bei gleicher Distanz. Das ist der Kern des Modells: Der Vergleich gilt zwischen zwei Personen, die sich nur in der Vertragsart unterscheiden.
Intervall 2.294 bis 4.082
schliesst die 1 nicht ein
Es ist nicht symmetrisch um 3.06, weil es auf der Log-Skala gebildet und dann exponiert wird: \(e^{1.1184 \pm 1.96 \cdot 0.1470}\).
exp(coef) = 1.048 für die Distanz
4.8 Prozent mehr Risiko je Kilometer
Je Einheit klein, aber die Einheit ist hier winzig gegenüber der Spannweite.
Distanz über die Spannweite
\(e^{0.0467 \cdot 14.5} = 1.97\)
Zwischen der nächsten und der entferntesten Person liegt fast der Faktor 2. Das ist die berichtbare Grösse, nicht die 1.048.
z und p
7.61 und 2.96
Wald-Tests je Koeffizient, jeweils gegen die Nullhypothese \(\beta = 0\), also HR = 1.
Konkordanz
0.663
Von allen Paaren, deren Reihenfolge bestimmbar ist, ordnet das Modell 66 Prozent richtig. 0.5 wäre Zufall. Ein brauchbarer, kein guter Wert und das bei zwei Prädiktoren, die den Prozess tatsächlich erzeugt haben.
Likelihood-Ratio-Test
\(\chi^2\)(2) = 80.9, p < .001
Der Gesamttest gegen das Nullmodell, das Gegenstück zum F-Test der linearen Regression.
Die Schätzungen treffen die eingebauten Werte nicht genau, und das ist lehrreich: Eingebaut waren \(e^{0.85} = 2.34\) und \(e^{0.045} = 1.046\); geschätzt werden 3.06 und 1.048. Die Distanz ist praktisch getroffen, die Vertragsart deutlich überschätzt.
Der Grund ist nicht Zufall, sondern eine Eigenschaft des Modells: Die Daten wurden aus einer Exponentialverteilung mit individueller Rate erzeugt, das Cox-Modell schätzt aber unter der Annahme, dass alle Unterschiede zwischen Personen in den Prädiktoren stehen. Nicht modellierte Heterogenität lässt Hazard Ratios über die Zeit schrumpfen und wird vom Modell teilweise in den stärksten Prädiktor gezogen. Bei einer einzelnen Stichprobe ist das nicht von Zufall zu unterscheiden, der Punkt ist, dass die 3.06 mit ihrem Intervall 2.29 bis 4.08 die Modellschätzung ist und nicht der wahre Erzeugungsparameter.
Interpretation und Ergebnissatz
In einem Cox-Modell mit Vertragsart und Distanz ist der Monatsvertrag mit einem erhöhten Kündigungsrisiko verbunden: Hazard Ratio 3.06 (95-Prozent-Konfidenzintervall 2.29 bis 4.08, p < .001), bei konstant gehaltener Distanz. Je fünf zusätzliche Kilometer steigt das Risiko um den Faktor 1.26 (1.08 bis 1.48). Das Modell beruht auf 400 Beobachtungen mit 247 Kündigungen; die Konkordanz beträgt 0.66.
Frage und Datenlage
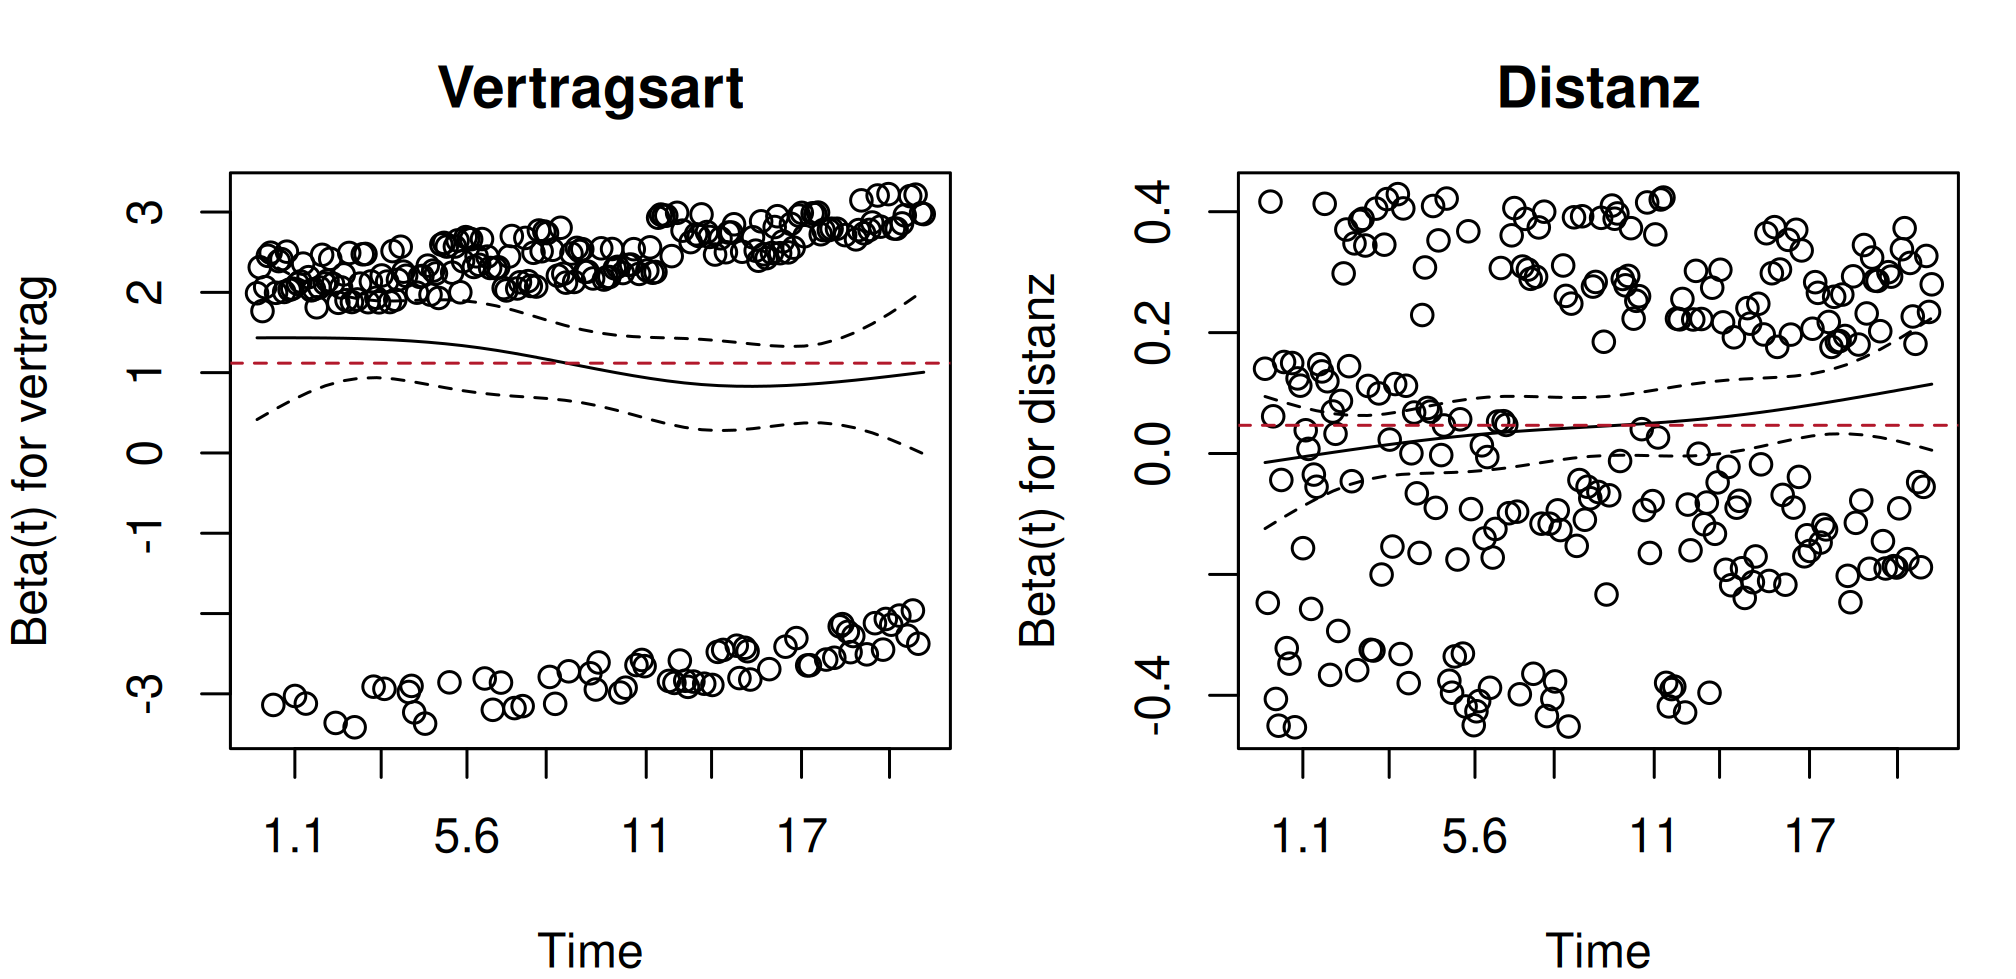
Ein Hazard Ratio ist nur dann eine sinnvolle Zahl, wenn es über die Zeit konstant ist. Geprüft wird das über die Schoenfeld-Residuen: Hängt der geschätzte Effekt vom Zeitpunkt ab?
        chisq df     p
vertrag  1.66  1 0.197
distanz  3.71  1 0.054
GLOBAL   5.74  2 0.057
par(mfrow =c(1, 2), mar =c(4, 4, 3, 1))plot(pruefung[1], main ="Vertragsart")abline(h =coef(modell)[1], col ="#b2182b", lty =2)plot(pruefung[2], main ="Distanz")abline(h =coef(modell)[2], col ="#b2182b", lty =2)par(mfrow =c(1, 1))
Abbildung 1: Beispiel 2: Schoenfeld-Residuen je Prädiktor. Ein waagrechter Verlauf spricht für proportionale Hazards.
<lifelines.StatisticalResult: proportional_hazard_test>
    time_transform = rank
 null_distribution = chi squared
degrees_of_freedom = 1
             model = <lifelines.CoxPHFitter: fitted with 400 total observations, 153 right-censored observations>
         test_name = proportional_hazard_test

---
               test_statistic      p  -log2(p)
distanz                4.2288 0.0397    4.6532
monatsvertrag          2.1248 0.1449    2.7865
ereignisse =int(abo["status"].sum())print("Ereignisse:", ereignisse,"| je geschätztem Koeffizienten:", round(ereignisse /2, 1))
Ereignisse: 247 | je geschätztem Koeffizienten: 123.5
Output Zeile für Zeile
Prädiktor
p (R, cox.zph)
p (Python, Rang-Transformation)
Monatsvertrag
0.197
0.145
Distanz
0.054
0.040
global
0.057
Ausgabe
Wie sie zu lesen ist
Was der Test prüft
Ob die Schoenfeld-Residuen mit der Zeit korrelieren. Ein Residuum je Ereignis und Prädiktor sagt, ob die Person, die zu diesem Zeitpunkt das Ereignis hatte, einen höheren oder tieferen Prädiktorwert hatte als vom Modell erwartet. Steigen oder fallen diese Abweichungen systematisch, ändert sich der Effekt über die Zeit.
Vertragsart, p = 0.15 bis 0.20
Kein Hinweis auf eine Verletzung. Der grosse p-Wert bestätigt die Annahme nicht, er widerlegt sie nur nicht.
Distanz, p = 0.040 in Python und 0.054 in R
Ein Grenzfall, und ein doppelt lehrreicher: Derselbe Sachverhalt fällt in der einen Umgebung unter die 5-Prozent-Schwelle und in der anderen darüber.
Was mit dem Grenzfall zu tun ist
Nicht reflexartig das Modell verwerfen. Der Test wird mit wachsender Ereigniszahl empfindlich; bei 247 Ereignissen werden auch winzige, praktisch bedeutungslose Zeittrends signifikant. Entscheidend ist das Bild: Fällt die Residuenkurve über den Beobachtungszeitraum um einen Betrag, der die Deutung ändern würde, oder schwankt sie nur leicht um die waagrechte Linie des geschätzten Koeffizienten?
Ereignisse je Koeffizient
247 / 2 = 123.5
R und Python geben hier verschiedene p-Werte aus, und beide haben recht: Der Test hängt davon ab, gegen welche Funktion der Zeit die Residuen korreliert werden. cox.zph() verwendet standardmässig eine Kaplan-Meier-Transformation, proportional_hazard_test() das in time_transform Angegebene, oben "rank". Wer den Test berichtet, nennt die Transformation dazu.
Ein Test, der auf die Wahl der Zeitachse reagiert, ist ohnehin ein Anlass, das Ergebnis nicht als Ja-Nein-Entscheidung zu behandeln. Der Residuenplot bleibt das wichtigere Werkzeug.
Interpretation
Für die Vertragsart ist die Annahme unauffällig, für die Distanz grenzwertig. Berichtet wird beides zusammen mit der verwendeten Transformation. Beispiel 3 zeigt, was zu tun ist, wenn eine Verletzung eindeutig ist.
Frage und Datenlage
Was passiert, wenn eine Variable ins Modell kommt, die mit dem Risiko nichts zu tun hat? Aufgenommen wird die durchschnittliche Trainingsdauer in Minuten, konstruiert ohne jeden Zusammenhang zur Kündigung.
Sie sinkt leicht. Anders als das \(R^2\) der linearen Regression steigt die Konkordanz nicht automatisch mit jedem Prädiktor, sie kann sich verschlechtern, wenn eine Variable nur Rauschen beisteuert.
Partial AIC
2683.93
2685.78
Steigt um 1.85. Das Informationskriterium bestraft den zusätzlichen Parameter stärker, als der minimale Gewinn an Likelihood ihn rechtfertigt: Das kleinere Modell ist vorzuziehen. Siehe Modellauswahl.
Hazard Ratios der übrigen
3.060 / 1.0478
3.063 / 1.0480
Praktisch unverändert. Das ist zu erwarten, weil die neue Variable mit den bestehenden nicht korreliert, im Gegensatz zu Beispiel 5.
Ausgabe
Wie sie zu lesen ist
HR = 0.9984
Rechnerisch ein winziger Schutzeffekt: 0.16 Prozent weniger Risiko je Minute.
Intervall 0.9904 bis 1.0065
Enthält die 1 und zwar mit reichlich Abstand auf beiden Seiten. Das ist die eigentliche Aussage: Die Daten sind mit allem zwischen einem Prozent Schutz und 0.65 Prozent Risiko je Minute vereinbar.
p = .697
Kein Nachweis eines Effekts. Kein Nachweis der Abwesenheit eines Effekts, den liefert das enge Intervall, nicht der p-Wert.
Bei einem metrischen Prädiktor ist das Intervall je Einheit irreführend eng. Über die Spannweite von rund 60 Minuten gerechnet, lässt es Faktoren zwischen \(0.9904^{60} = 0.56\) und \(1.0065^{60} = 1.48\) zu, also von “halbiert das Risiko” bis “erhöht es um die Hälfte”. Ein enges Intervall je Einheit heisst nicht, dass die Variable ausgeschlossen ist.
Interpretation und Ergebnissatz
Die durchschnittliche Trainingsdauer ist nicht mit dem Kündigungsrisiko assoziiert (Hazard Ratio 0.998 je Minute, 95-Prozent-Konfidenzintervall 0.990 bis 1.007, p = .70). Die Aufnahme in das Modell verschlechtert Konkordanz (0.663 auf 0.659) und Partial AIC (2683.9 auf 2685.8); berichtet wird das Modell ohne diesen Prädiktor.
Frage und Datenlage
Der Kernfall. Zwei Gruppen zu je 250 Fällen aus dem Log-Rank-Test: Gruppe A hat in den ersten sechs Monaten ein hohes Risiko und danach ein sehr niedriges, Gruppe B durchgehend ein mittleres. Die Kurven kreuzen sich. Was macht das Cox-Modell daraus?
       chisq df      p
gruppe  89.9  1 <2e-16
GLOBAL  89.9  1 <2e-16
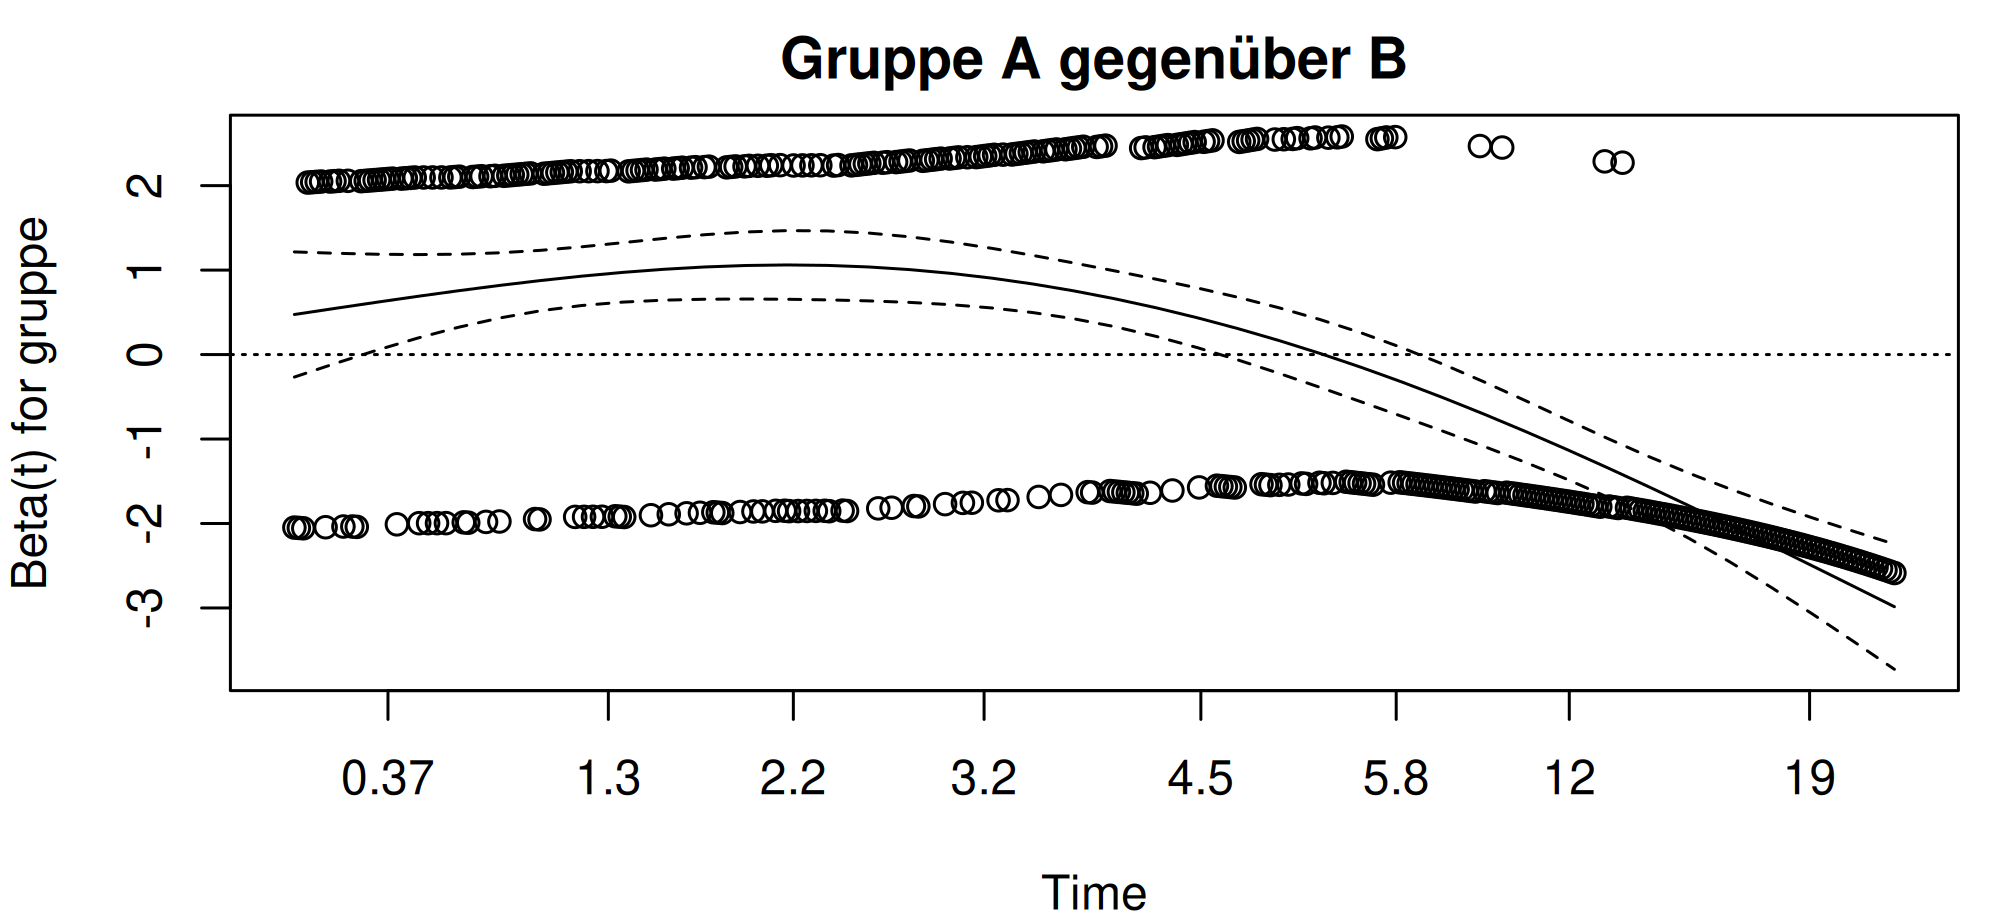
par(mar =c(4, 4, 2, 1))plot(pruefung_c, main ="Gruppe A gegenüber B")abline(h =0, lty =3)# Getrennt nach Zeitabschnittfrueh_teil <-transform(kreuz, z =pmin(zeit, 6),s =as.integer(status ==1& zeit <=6))spaet_teil <-subset(kreuz, zeit >6)round(c(bis_6 =exp(coef(coxph(Surv(z, s) ~ gruppe, data = frueh_teil))),ab_6 =exp(coef(coxph(Surv(zeit, status) ~ gruppe, data = spaet_teil)))), 3)
bis_6.gruppeA  ab_6.gruppeA
        2.199         0.040
Abbildung 2: Beispiel 4: Schoenfeld-Residuen bei verletzter Annahme, der Effekt fällt sichtbar mit der Zeit.
print(f"Hazard Ratio Monate 6 bis 24: {hr_spaet:.3f}")
Hazard Ratio Monate 6 bis 24: 0.040
Output Zeile für Zeile
Modell
Hazard Ratio (A gegenüber B)
95-Prozent-Intervall
p
Gesamter Zeitraum
0.994
0.806 bis 1.225
.952
Monate 0 bis 6
2.199
< .001
Monate 6 bis 24
0.040
< .001
Prüfung auf Proportionalität: \(\chi^2\) = 90.8, p < .001.
Beobachtung
Erklärung
Das Gesamtmodell schätzt HR = 0.99
Also “kein Unterschied”. Das ist keine Mittelung im Sinne eines vernünftigen Kompromisses, sondern eine Zahl, die keinen der beiden Zeiträume beschreibt.
Abschnittsweise: 2.20 und 0.04
Früh hat A mehr als das Doppelte des Risikos, später ein Fünfundzwanzigstel. Zwischen den beiden Zahlen liegt ein Faktor von 55.
Der Test auf Proportionalität
\(\chi^2\) = 90.8 bei einem Prädiktor, unübersehbar. Hier ist das kein Grenzfall wie in Beispiel 2.
Die Schoenfeld-Residuen
fallen im Bild deutlich von oben nach unten, statt um eine Waagrechte zu schwanken. Das ist die Verletzung, sichtbar statt getestet.
Konfidenzintervall des Gesamtmodells
0.81 bis 1.23
Warum das gefährlicher ist als ein einfach falscher Wert: Das Gesamtmodell liefert eine unauffällige Ausgabe. Kein Wert ist absurd, das Intervall ist eng, der p-Wert klar. Nichts an dieser Tabelle deutet auf ein Problem hin, die Verletzung ist nur über den Test und den Residuenplot zu sehen. Deshalb ist die Prüfung der Proportionalität kein optionaler Zusatz, sondern Teil der Rechnung.
Und warum die abschnittsweisen Zahlen hier keine Berichtsergebnisse sind: Die Grenze bei sechs Monaten stammt aus der Konstruktion des Beispiels. Wer sie nach dem Blick auf die Daten wählt, hat einen an den Daten optimierten Schnitt gesetzt.
Drei zulässige Wege bei verletzter Proportionalität:
Weg
Wann
Stratifizieren nach der betroffenen Variablen
ihr Effekt interessiert nicht, sie ist nur eine Störgrösse, siehe Beispiel 5
Zeitabhängigen Effekt aufnehmen (tt() in R, CoxTimeVaryingFitter)
der Wechsel des Effekts ist selbst das Ergebnis
Zeitabschnitte getrennt schätzen
die Grenze ist aus der Sache heraus begründet, nicht aus den Daten
Was nicht geht: ein einzelnes Hazard Ratio berichten und die Verletzung in einer Fussnote erwähnen.
Interpretation und Ergebnissatz
Die Annahme proportionaler Hazards ist für die Gruppenzugehörigkeit deutlich verletzt (\(\chi^2\) = 90.8, p < .001, Rang-Transformation); die Schoenfeld-Residuen fallen über den Beobachtungszeitraum. Ein einzelnes Hazard Ratio (0.99, 0.81 bis 1.23) beschreibt keinen der beiden Zeiträume. Berichtet werden getrennte Schätzungen für die postoperative Phase bis Monat 6 (HR 2.20) und die Zeit danach (HR 0.04).
Frage und Datenlage
Angenommen, nur der Effekt der Distanz interessiert, und die Vertragsart ist lediglich eine Störgrösse, deren Proportionalität zweifelhaft ist. Dann wird nach ihr stratifiziert: Jede Schicht bekommt ihr eigenes Grundrisiko \(h_0(t)\), und die übrigen Effekte werden über die Schichten hinweg gemeinsam geschätzt.
1.0478 gegen 1.0472. Der Effekt der Distanz ist über beide Vertragsarten hinweg derselbe, deshalb kostet die Schichtung hier fast nichts an Genauigkeit.
Für die Vertragsart gibt es kein Hazard Ratio mehr
Und das ist keine Panne, sondern der Zweck. Jede Schicht hat ihr eigenes, frei geformtes Grundrisiko; ein Verhältnis zwischen den Schichten wird gar nicht erst unterstellt und daher auch nicht geschätzt.
Die Zahl der geschätzten Parameter sinkt von 2 auf 1
Die partielle Likelihood wird nur noch innerhalb der Schichten gebildet: Verglichen wird jede Person zum Ereigniszeitpunkt nur mit denen der eigenen Schicht.
Der Handel in einem Satz: Man kauft Robustheit gegen eine verletzte Proportionalität und bezahlt mit dem Effektmass für die geschichtete Variable.
Drei praktische Folgen:
Stratifizieren lohnt sich nur für Störgrössen. Ist die Variable die eigentliche Frage, ist ein zeitabhängiger Effekt der richtige Weg.
Zu viele Schichten zerlegen die Risikomengen. Bei zehn Schichten mit je zwei Ereignissen bleibt kaum Information übrig.
Metrische Variablen müssen dafür in Klassen zerlegt werden, mit allen Nachteilen willkürlicher Grenzen.
Interpretation und Ergebnissatz
In einem nach Vertragsart stratifizierten Cox-Modell steigt das Kündigungsrisiko je Kilometer Anfahrt um den Faktor 1.047 (95-Prozent-Konfidenzintervall 1.015 bis 1.080, p = .003), je fünf Kilometer also um 1.26. Für die Vertragsart wird kein Hazard Ratio geschätzt; sie geht als Schicht mit eigenem Grundrisiko ein.
Verständnisfragen
Ein Hazard Ratio beträgt 3.06 mit Intervall 2.29 bis 4.08. Was heisst das?
Das momentane Risiko ist etwa dreimal so hoch, bei konstant gehaltenen übrigen Prädiktoren
Richtig. Das Intervall schliesst die eins nicht ein, der Effekt ist also von null verschieden. Über Laufzeiten sagt die Zahl direkt nichts.
Die Laufzeit drittelt sich
Das folgt nicht; der Zusammenhang zwischen Hazard Ratio und Median hängt von der Verteilungsform ab.
Die Wahrscheinlichkeit für das Ereignis ist 3.06
Wahrscheinlichkeiten sind höchstens eins; ein Hazard Ratio ist keine Wahrscheinlichkeit.
Warum ist das Konfidenzintervall 2.29 bis 4.08 nicht symmetrisch um 3.06?
Weil es auf der Log-Skala gebildet und dann exponiert wird
Richtig. Gerechnet wird \(e^{\beta \pm 1.96 \cdot SE}\); die Exponentialfunktion streckt oben und staucht unten. Auf der Log-Skala ist das Intervall symmetrisch.
Weil die Verteilung der Laufzeiten schief ist
Die Schiefe der Laufzeiten spielt hier keine Rolle.
Weil gerundet wurde
Der Unterschied ist zu gross für einen Rundungseffekt.
cox.zph() liefert für einen Prädiktor p = 0.004. Was folgt?
Der Prädiktor hat einen signifikanten Effekt
Das ist eine andere Frage, die der Wald-Test beantwortet.
Sein Effekt ändert sich über die Zeit, ein einzelnes Hazard Ratio genügt nicht
Richtig. Der Test prüft die Annahme proportionaler Hazards. Bei Verletzung wird stratifiziert, ein zeitabhängiger Effekt aufgenommen oder nach Zeitabschnitten berichtet und zwar mit einer vorab begründeten Grenze.
Das Modell ist insgesamt schlecht angepasst
Die Anpassung kann gut sein; verletzt ist eine bestimmte Annahme über einen bestimmten Prädiktor.
Ein Cox-Modell schätzt für eine Gruppenvariable HR = 0.99 mit Intervall 0.81 bis 1.23, während die abschnittsweisen Schätzungen 2.20 und 0.04 lauten. Was ist passiert?
Die Proportionalität ist verletzt; die 0.99 beschreibt keinen der Zeiträume
Richtig. Der Effekt kehrt sich über die Zeit um, und das Modell mittelt ihn zu einer Zahl, die nirgends gilt. Am Ergebnis selbst ist das nicht zu sehen, nur am Test und am Residuenplot.
Die abschnittsweisen Modelle sind überangepasst
Sie beruhen auf 249 beziehungsweise 111 Ereignissen; das ist reichlich.
Das Gesamtmodell ist präziser, weil es alle Daten nutzt
Präzision nützt nichts, wenn die geschätzte Grösse die falsche ist.
Ein Modell mit vier Prädiktoren beruht auf 400 Beobachtungen, von denen 32 ein Ereignis hatten. Was ist das Problem?
Acht Ereignisse je Koeffizient sind zu wenig
Richtig. Die Genauigkeit hängt an der Ereigniszahl, nicht an der Fallzahl. Die Faustregel von rund zehn Ereignissen je Koeffizienten ist hier verletzt, Intervalle sind zu eng und die Schätzung instabil.
Kein Problem, 400 Beobachtungen sind ausreichend
Die 368 Zensierten tragen zur Schätzung der Koeffizienten nur begrenzt bei.
Die Zensierungsrate ist zu hoch für ein Cox-Modell
Hohe Zensierung ist normal; entscheidend ist die absolute Ereigniszahl.
Wird nach einer Variablen stratifiziert, entfällt für sie das Hazard Ratio. Warum?
Weil jede Schicht ein eigenes, frei geformtes Grundrisiko bekommt
Richtig. Zwischen den Schichten wird kein festes Verhältnis unterstellt, also gibt es auch keines zu schätzen. Das ist der Preis für die Robustheit gegen eine verletzte Proportionalität.
Weil die Variable aus dem Modell entfernt wurde
Sie ist weiterhin enthalten und bestimmt, mit wem eine Person verglichen wird.
Weil sie nicht signifikant war
Mit Signifikanz hat die Entscheidung nichts zu tun.