Typische Fragestellungen: Verbrauch vor und nach einer Wartung, Blutdruck vor und nach einer Behandlung, Bearbeitungszeit mit zwei Werkzeugen an denselben Werkstücken. Gemeinsam ist ihnen, dass jede Messung einen festen Partner hat.
Die Paarung ist keine Formalität, sondern der Kern des Verfahrens. Sie entfernt die Unterschiede zwischen den Objekten aus der Rechnung. Wenn Maschinen sich stark voneinander unterscheiden, aber alle durch dieselbe Massnahme gleichmässig gewinnen, verschwindet dieser Gewinn im ungepaarten Vergleich in der Streuung zwischen den Maschinen. Rechnerisch ist der gepaarte Test ein Einstichproben-t-Test auf den Differenzen gegen null.
Die Paarung ist verletzt; Zuordnung klären oder ungepaart rechnen
Grundidee und Modell
Aus je zwei Messungen wird eine Differenz gebildet, und diese Differenzen werden gegen null geprüft. Alles, was ein Objekt dauerhaft auszeichnet, kürzt sich dabei heraus.
\[d_i = y_{i,\text{nachher}} - y_{i,\text{vorher}}, \qquad t = \frac{\bar{d}}{s_d/\sqrt{n}}\]
Bestandteil
Bedeutung
\(d_i\)
Differenz beim \(i\)-ten Objekt
\(\bar{d}\)
mittlere Differenz, der berichtete Effekt
\(s_d\)
Standardabweichung der Differenzen, nicht der Einzelmessungen
\(n\)
Anzahl Paare, nicht Anzahl Messwerte
\(s_d/\sqrt{n}\)
Standardfehler der mittleren Differenz
Die Nullhypothese lautet, dass die mittlere Differenz null ist. Voraussetzungen betreffen deshalb die Differenzen, nicht die Ausgangswerte: die Einzelmessungen dürfen beliebig verteilt sein, solange ihre Differenzen es nicht sind.
Voraussetzungen und ihre Prüfung
Voraussetzung
Was sie bedeutet
Prüfung
Folge bei Verletzung
Vorgehen
Feste Zuordnung
Jede Messung hat genau einen Partner, die Reihenfolge stimmt
Datenstruktur prüfen, Identifikator mitführen
Die Differenzen sind Unsinn, und niemand sieht es dem Ergebnis an
mittlere Differenz in Einheiten ihres Standardfehlers
beruht auf der Streuung der Differenzen
df
Anzahl Paare minus eins
nicht Anzahl Messwerte minus zwei
p-value
Wahrscheinlichkeit dieser oder extremerer Differenzen bei wahrer Null
keine Aussage über die Grösse
95 percent confidence interval
Intervall der mittleren Differenz
die berichtenswerte Zeile, in der Einheit der Messung
mean difference
Punktschätzer der mittleren Differenz
Vorzeichen hängt an der Reihenfolge der Argumente
alternative hypothesis
Richtung
true mean difference is not equal to 0
Cohens d (paired)
Effektstärke auf Basis der Differenzen
fällt deutlich grösser aus als die ungepaarte Variante; beide Fassungen nie vermischen
Python, pg.ttest(..., paired=True) liefert dieselben Grössen in einer Zeile: Teststatistik, Freiheitsgrade, p-Wert, Konfidenzintervall, Effektstärke, dazu Bayes-Faktor und Power. Die Spaltennamen haben sich zwischen den pingouin-Versionen geändert, weshalb die Beispiele hier die Spalten nachschlagen statt sie festzuschreiben. Zwei Unterschiede zu R: cohen-d wird von pingouin für gepaarte Daten anders normiert als von effectsize in R, weshalb die beiden Zahlen abweichen können; welche Fassung verwendet wurde, gehört deshalb in den Bericht. Und CI95% bezieht sich auf die mittlere Differenz, was hier die interessierende Grösse ist.
Interpretationsfallen
Die Paarung ist eine Eigenschaft der Erhebung, keine Wahl der Auswertung. Gepaarte Daten ungepaart zu rechnen verschenkt Schärfe, ungepaarte Daten gepaart zu rechnen ist schlicht falsch.
Freiheitsgrade richtig lesen. Sie ergeben sich aus der Anzahl Paare, nicht aus der Anzahl Messwerte.
Die Effektstärke ist nicht mit der ungepaarten vergleichbar. Für gepaarte Daten wird an der Streuung der Differenzen normiert, was systematisch grössere Werte ergibt.
Vorzeichen prüfen. Ob eine Verbesserung positiv oder negativ erscheint, hängt allein an der Reihenfolge der Argumente.
Voraussetzungen gelten den Differenzen.Schiefe Ausgangswerte sind unkritisch, solange die Differenzen symmetrisch streuen.
Regression zur Mitte. Werden Objekte wegen extremer Ausgangswerte ausgewählt, fallen die zweiten Messungen schon aus statistischen Gründen weniger extrem aus. Ohne Kontrollgruppe ist ein solcher Effekt kein Beleg für die Wirkung der Massnahme.
Ergebnis berichten
Vorlage für den Ergebnissatz:
[Zielgrösse] verändert sich zwischen [Zeitpunkt 1] (M = [Mittelwert], SD = [Streuung]) und [Zeitpunkt 2] (M = [Mittelwert], SD = [Streuung]) um [mittlere Differenz] [Einheit] (95-Prozent-Konfidenzintervall [unten] bis [oben], t([df]) = [t], p = [p], Cohens d = [d], n = [Paare]).
Genannt werden beide Messzeitpunkte mit Mittelwert und Streuung, die mittlere Differenz mit Konfidenzintervall, Teststatistik mit Freiheitsgraden, p-Wert, Effektstärke samt ihrer Fassung und die Anzahl vollständiger Paare.
Fünfzehn Personen bearbeiten dieselbe Aufgabe zweimal, einmal vor und einmal nach einer Schulung. Gemessen wird die Reaktionszeit in Millisekunden. Die Frage lautet: Hat sich die Reaktionszeit verändert, und um wie viel?
Entscheidend ist die Struktur der Daten: Es sind nicht dreissig unabhängige Messungen, sondern fünfzehn Personen mit je zwei Werten. Personen unterscheiden sich stark voneinander, und genau dieser Unterschied interessiert hier nicht. Der gepaarte Test entfernt ihn, indem er nur mit den Differenzen je Person rechnet.
Voraussetzungen prüfen
Geprüft wird nicht die Verteilung der Messwerte, sondern die der Differenzen. Das ist der häufigste Missgriff auf dieser Seite.
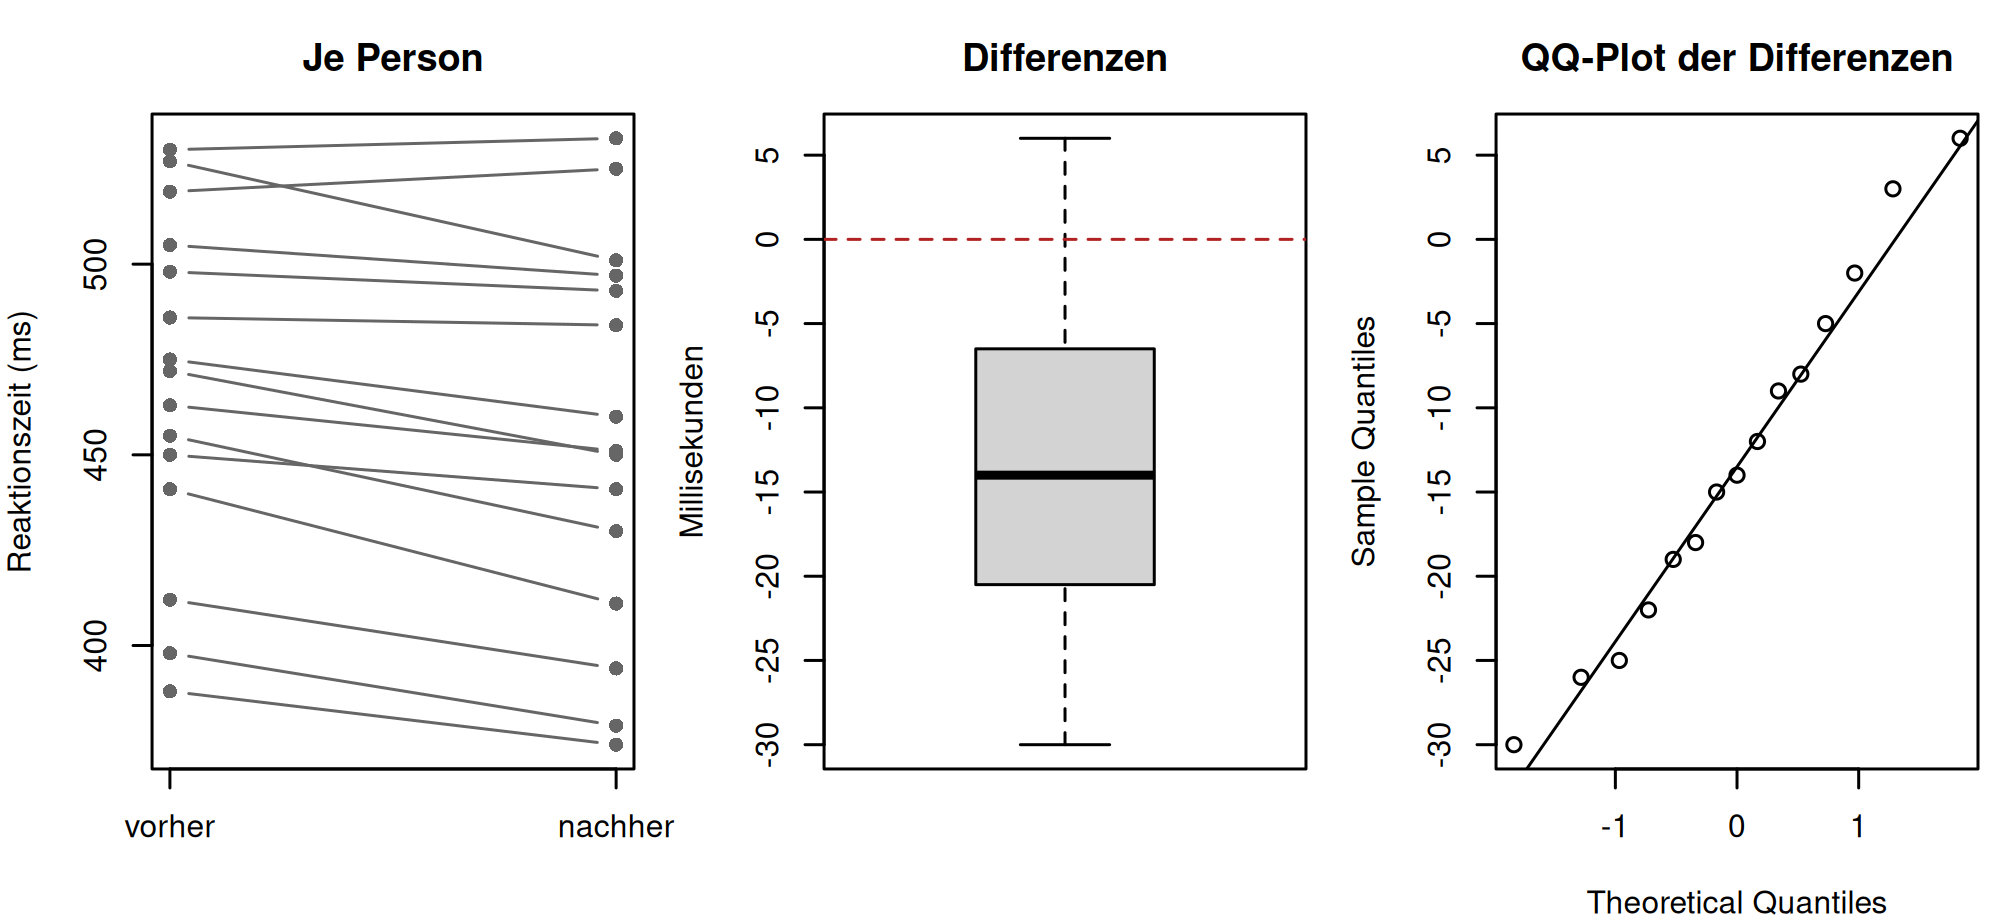
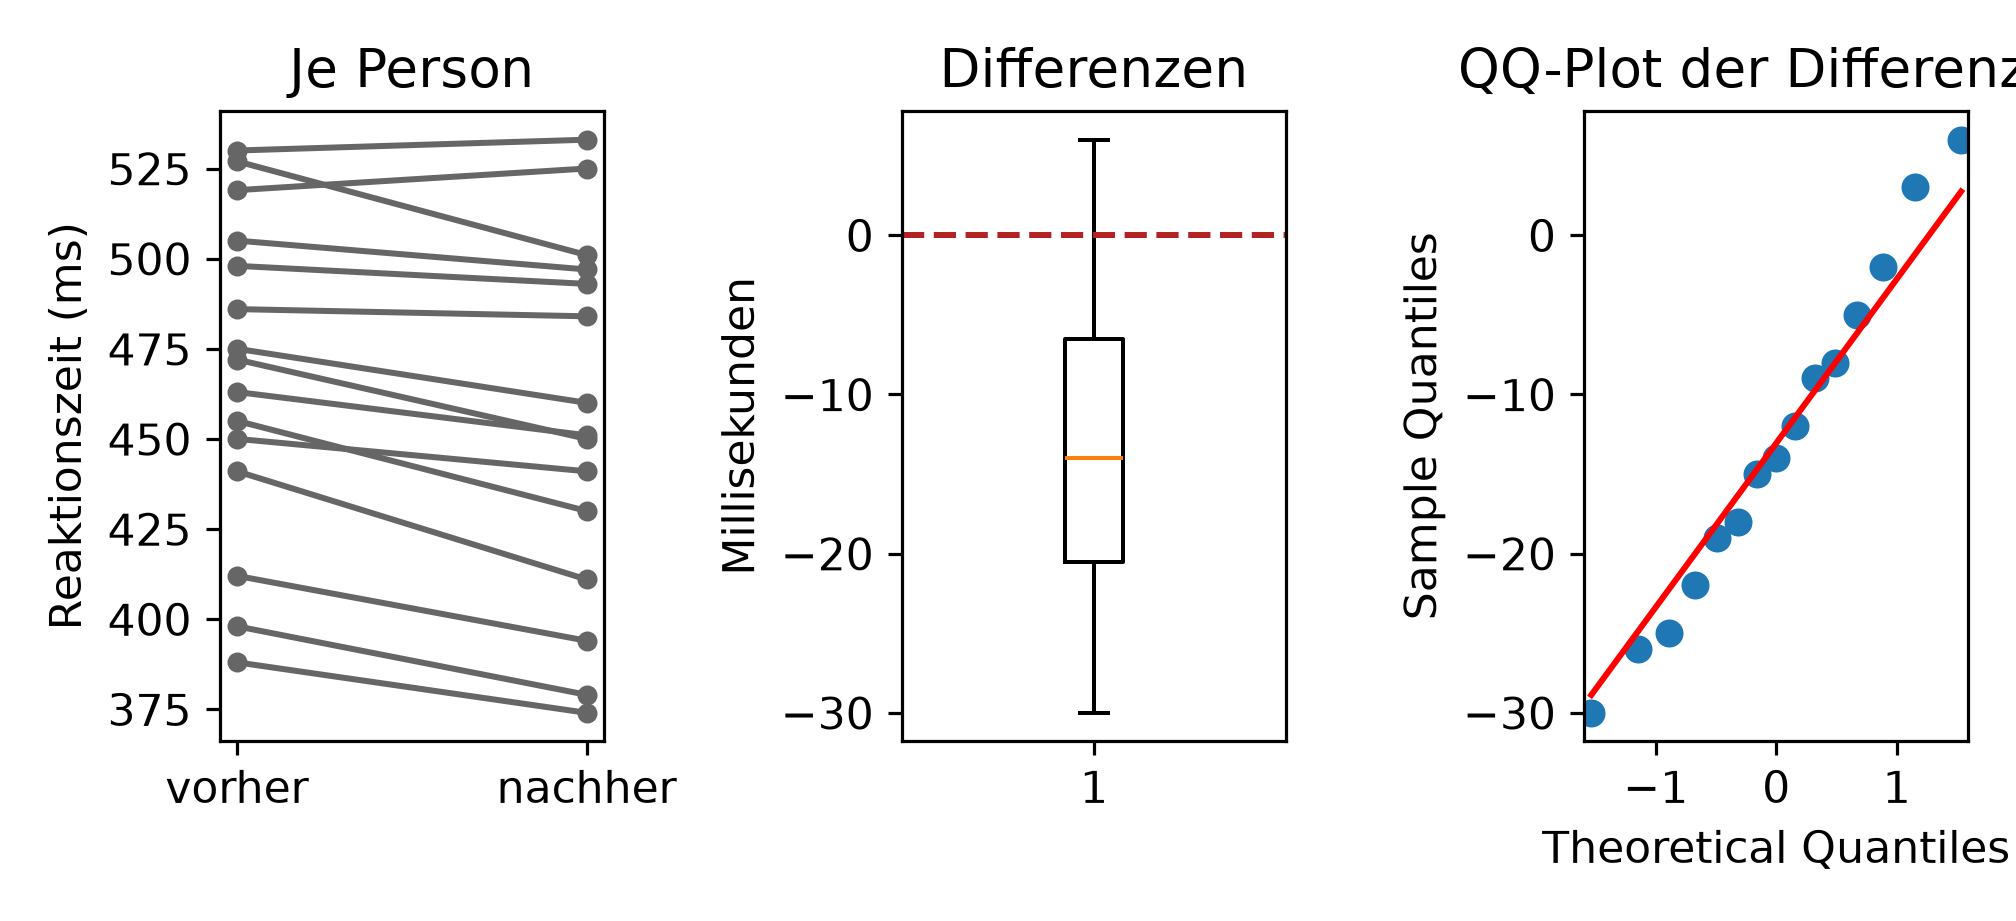
Im linken Bild verläuft fast jede Linie nach unten: Die meisten Personen sind nachher schneller. Zugleich liegen die Linien weit auseinander, von knapp 390 bis über 530 Millisekunden. Diese Spanne zwischen den Personen ist rund viermal so gross wie die Veränderung innerhalb einer Person, und die Korrelation zwischen den beiden Messungen beträgt 0.98.
Genau daraus zieht der gepaarte Test seine Schärfe: Was beide Messungen einer Person gemeinsam haben, kürzt sich in der Differenz heraus.
Die Differenzen selbst sind unauffällig verteilt, der QQ-Plot zeigt keine Abweichung von Belang, und der Boxplot liegt vollständig unterhalb der Nulllinie.
    Paired t-test

data:  nachher and vorher
t = -4.7443, df = 14, p-value = 0.0003138
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 -18.973752  -7.159581
sample estimates:
mean difference
      -13.06667
Fehlt das Wort Paired, wurde paired = TRUE vergessen, und das Ergebnis ist ein anderes, siehe Beispiel 2.
t
-4.744
Die mittlere Differenz liegt 4.74 Standardfehler unter null.
Das Vorzeichen folgt der Reihenfolge der Argumente: nachher minus vorher, negativ heisst also schneller geworden.
df
14
Freiheitsgrade
Anzahl Paare minus eins, nicht Anzahl Messungen minus eins. Bei 15 Personen mit 30 Messwerten sind es 14, nicht 28.
p-value
0.00031
Wahrscheinlichkeit einer mindestens so grossen mittleren Differenz, wenn sich in Wahrheit nichts geändert hätte
Deutlich unter 0.05.
mean difference
-13.07
mittlere Veränderung in Millisekunden
Die eigentliche Effektgrösse. Nach der Schulung sind die Personen im Mittel 13 ms schneller.
95 percent confidence interval
-18.97 bis -7.16
Intervall für die Differenz, nicht für einen Mittelwert
Anders als beim Einstichprobentest steht hier direkt die interessierende Grösse. Plausibel ist eine Verbesserung zwischen 7 und 19 ms.
Effektstärke in R
-1.23
Differenz in Einheiten der Streuung der Differenzen
Das ist \(d_z\): -13.07 geteilt durch 10.67. Er beantwortet die Frage “wie gross ist die Veränderung im Verhältnis dazu, wie unterschiedlich die Veränderungen ausfallen”.
cohen_d in Python
0.27
Differenz in Einheiten der Streuung zwischen den Personen
Nicht derselbe Wert und kein Fehler, sondern eine andere Definition, siehe den Kasten unten.
power (nur Python)
0.166
Trefferwahrscheinlichkeit für den beobachteten Effekt
Niedrig, weil pingouin sie aus dem kleinen d von 0.27 berechnet und nicht aus \(d_z\). Im Nachhinein berechnete Power ist ohnehin nur eingeschränkt aussagekräftig.
BF10 (nur Python)
105.4
Bayes-Faktor
Die Daten sind rund hundertmal wahrscheinlicher unter einer Veränderung als unter Gleichheit.
Cohens d ist bei gepaarten Daten nicht eindeutig, und die beiden Sprachen wählen verschieden. R gibt mit effectsize::cohens_d(paired = TRUE) den Wert -1.23 aus, pingouin gibt 0.27 aus. Beide sind richtig gerechnet, sie teilen nur durch etwas anderes:
Nenner
Wert hier
Frage, die er beantwortet
\(d_z\) (R)
Streuung der Differenzen, 10.67 ms
-1.23
Wie deutlich ist die Veränderung im Verhältnis zu ihrer eigenen Schwankung?
\(d\) (pingouin)
gepoolte Streuung der beiden Messreihen, rund 47.9 ms
0.27
Wie gross ist die Veränderung im Verhältnis zu den Unterschieden zwischen Personen?
\(d_z\) hängt an der Korrelation der beiden Messungen und wird gross, sobald die Paarung gut greift; er eignet sich für die Planung eines weiteren gepaarten Versuchs. Das gepoolte \(d\) ist mit Effektstärken aus Zweistichprobenvergleichen vergleichbar und eignet sich für die Einordnung gegen Literaturwerte. Wer eine Effektstärke berichtet, schreibt deshalb dazu, welche gemeint ist; die blosse Angabe “d = 1.23” ist ohne diesen Zusatz nicht deutbar.
Interpretation und Ergebnissatz
Berichtet wird die Veränderung in Millisekunden mit ihrem Intervall, nicht der p-Wert allein. Ob 13 ms viel sind, entscheidet die Sache: Bei einer Aufgabe mit Reaktionszeiten um 460 ms sind das rund drei Prozent.
Und eine Grenze des Designs gehört dazu: Gemessen wurde vorher und nachher ohne Kontrollgruppe. Die Verbesserung kann von der Schulung kommen, ebenso gut aber vom blossen Wiederholen der Aufgabe. Der gepaarte Test misst die Veränderung, nicht ihre Ursache.
Nach der Schulung sind die Reaktionszeiten kürzer (vorher M = 467.9 ms, SD = 44.9; nachher M = 454.9 ms, SD = 50.7; n = 15 Personen): mittlere Veränderung -13.1 ms, 95-Prozent-Konfidenzintervall -19.0 bis -7.2 ms, t(14) = -4.74, p < 0.001, \(d_z\) = -1.23 (gepoolt: d = 0.27). Ohne Kontrollgruppe lässt sich die Veränderung nicht ursächlich der Schulung zuschreiben.
Frage und Datenlage
Dieselben Daten wie in Beispiel 1, nur wird die Paarung diesmal ignoriert und mit paired = FALSE gerechnet. Das passiert in der Praxis leicht: Die Daten liegen in zwei Spalten, und die Zuordnung zur Person ist nicht sichtbar.
    Welch Two Sample t-test

data:  nachher and vorher
t = -0.74676, df = 27.598, p-value = 0.4615
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -48.93293  22.79960
sample estimates:
mean of x mean of y
 454.8667  467.9333
Derselbe Unterschied von 13 ms, sechsmal kleinere Teststatistik.
df
14
rund 27.6
Ungepaart gibt es scheinbar mehr Freiheitsgrade, was nach mehr Information aussieht. Das Gegenteil ist der Fall.
p-value
0.00031
0.462
Aus einem klaren Befund wird ein Nullbefund.
Streuung im Nenner
SD der Differenzen: 10.7 ms
SD zwischen den Personen: rund 48 ms
Hier steckt die ganze Erklärung.
Der ungepaarte Test vergleicht zwei Mittelwerte und misst die Zufallsstreuung an den Unterschieden zwischen den Personen. Die betragen hier rund 48 ms und haben mit der Wirkung der Schulung nichts zu tun. Vor dieser Kulisse verschwindet eine Veränderung von 13 ms.
Der gepaarte Test rechnet dagegen mit den fünfzehn Differenzen. Deren Streuung beträgt 10.7 ms, weil sich der Personenunterschied beim Subtrahieren heraushebt. Derselbe Effekt wird dadurch messbar.
Interpretation und Ergebnissatz
Die Lehre ist nicht “gepaart rechnen ist besser”, sondern: Das Verfahren muss zum Erhebungsdesign passen. Bei gepaarten Daten ungepaart zu rechnen verschenkt Information und findet echte Effekte oft nicht. Der umgekehrte Fehler ist schwerwiegender: Unabhängige Daten gepaart zu rechnen erfindet eine Zuordnung, die es nicht gibt, und liefert Ergebnisse, die durch nichts gedeckt sind.
Die Frage, an der sich das entscheidet, lautet immer gleich: Gibt es einen sachlichen Grund, warum Wert Nummer 7 der einen Reihe zu Wert Nummer 7 der anderen gehört? Dieselbe Person, dasselbe Werkstück, derselbe Standort. Wenn ja, ist es gepaart; wenn sich die Reihenfolge einer Spalte ohne Informationsverlust mischen liesse, ist es das nicht.
Die Auswertung erfolgte gepaart, da beide Messungen an denselben fünfzehn Personen erhoben wurden. Eine ungepaarte Auswertung derselben Daten hätte den Effekt nicht gefunden (t = -0.75, p = 0.46), weil sie die Unterschiede zwischen den Personen als Zufallsstreuung behandelt.
Frage und Datenlage
Zwölf Personen, dieselbe Aufgabe, aber statt einer Schulung liegt nur eine Woche zwischen den Messungen. Erwartet wird keine Veränderung; das Beispiel zeigt, wie ein Nullbefund bei gepaarten Daten aussieht.
    Paired t-test

data:  nach_woche and vor_woche
t = 0.27596, df = 11, p-value = 0.7877
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 -2.906509  3.739842
sample estimates:
mean difference
      0.4166667
Die Daten sind mit “keine Veränderung” gut vereinbar.
95 percent confidence interval
-2.91 bis 3.74 ms
Die aussagekräftigste Zeile, und hier ausnahmsweise eine starke Aussage: Das Intervall ist nur rund sieben Millisekunden breit. Veränderungen von mehr als vier Millisekunden sind mit diesen Daten kaum vereinbar.
cohen_d
0.08
Vernachlässigbar.
Interpretation und Ergebnissatz
Dieser Nullbefund ist deutlich mehr wert als der aus Beispiel 2 des Einstichprobentests. Der Grund ist das schmale Intervall: Weil die Paarung die Streuung auf 5.2 ms drückt, schliesst dieser Nullbefund grosse Veränderungen tatsächlich aus.
Damit lässt sich mehr sagen als “nichts gefunden”: Eine Veränderung von mehr als etwa vier Millisekunden ist mit den Daten nicht vereinbar. Ob das als Nachweis der Stabilität genügt, entscheidet die vorab festgelegte Toleranz. Formal sauber wäre auch hier ein Äquivalenztest, aber die Aussage des Intervalls geht in dieselbe Richtung und ist bereits belastbar.
Über eine Woche ohne Massnahme verändert sich die Reaktionszeit nicht nachweisbar (mittlere Veränderung 0.4 ms, 95-Prozent-Konfidenzintervall -2.9 bis 3.7 ms, t(11) = 0.28, p = 0.79, n = 12 Personen). Das Intervall schliesst Veränderungen von mehr als vier Millisekunden praktisch aus.
Frage und Datenlage
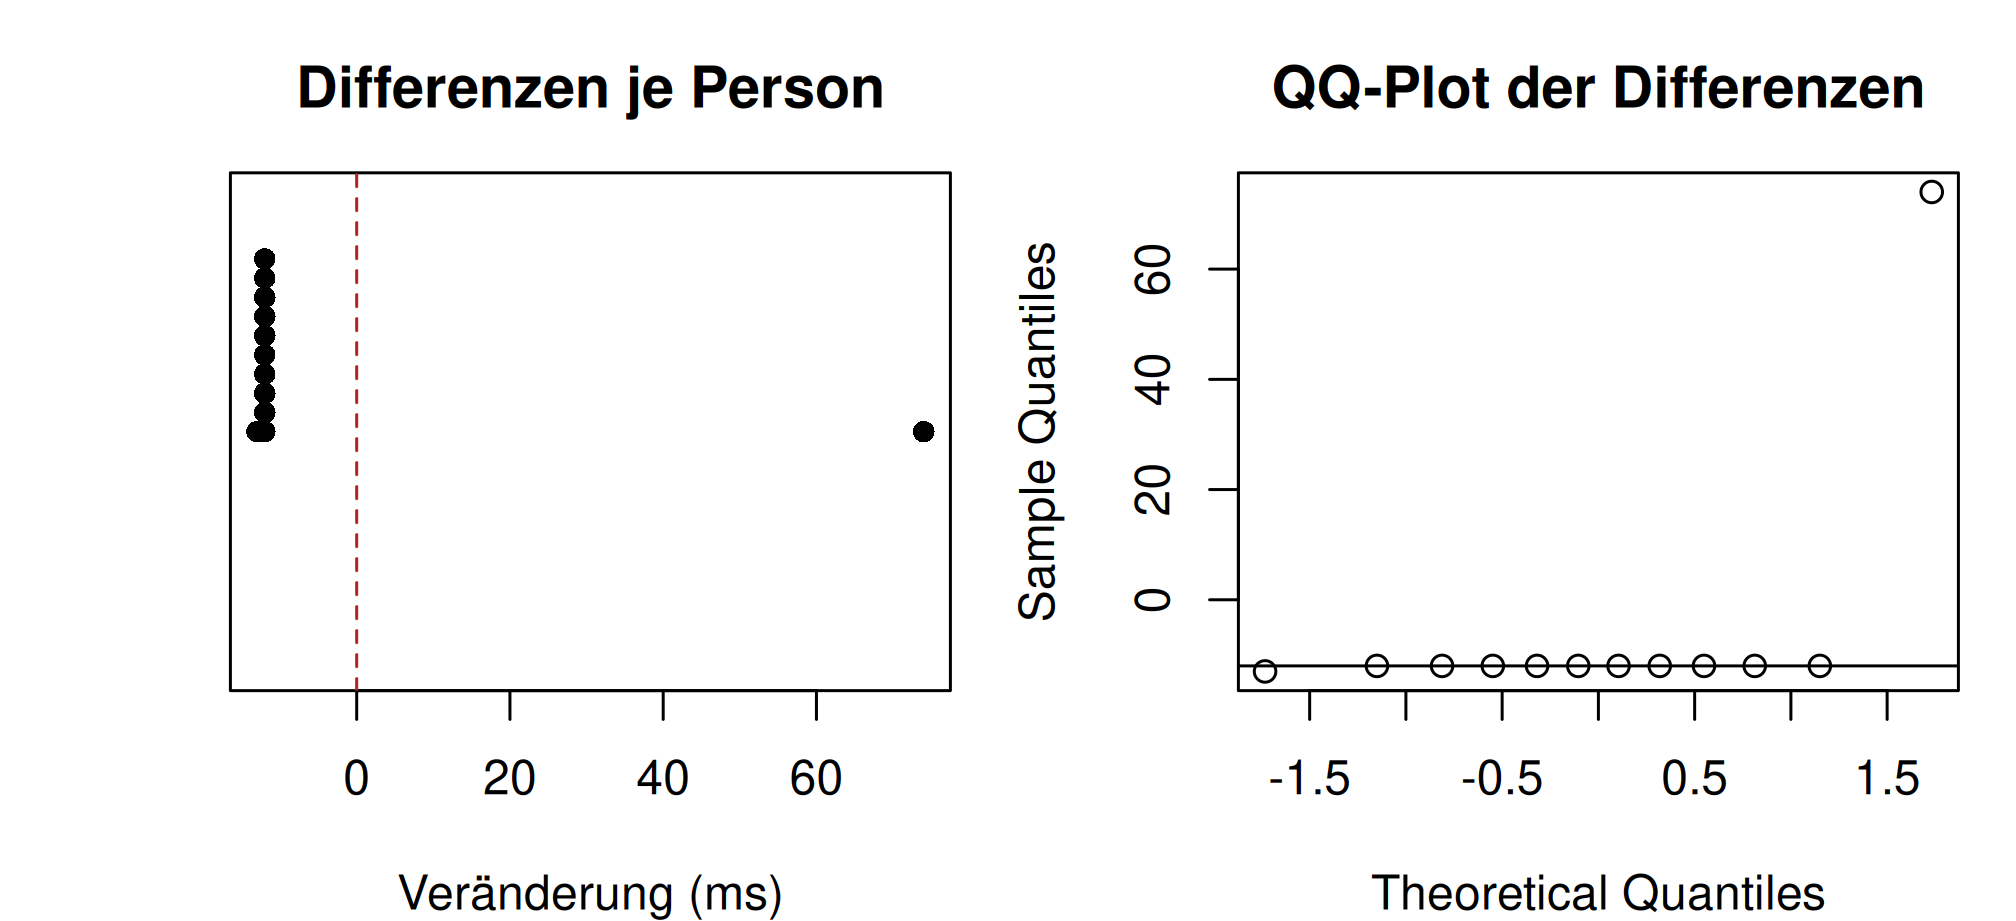
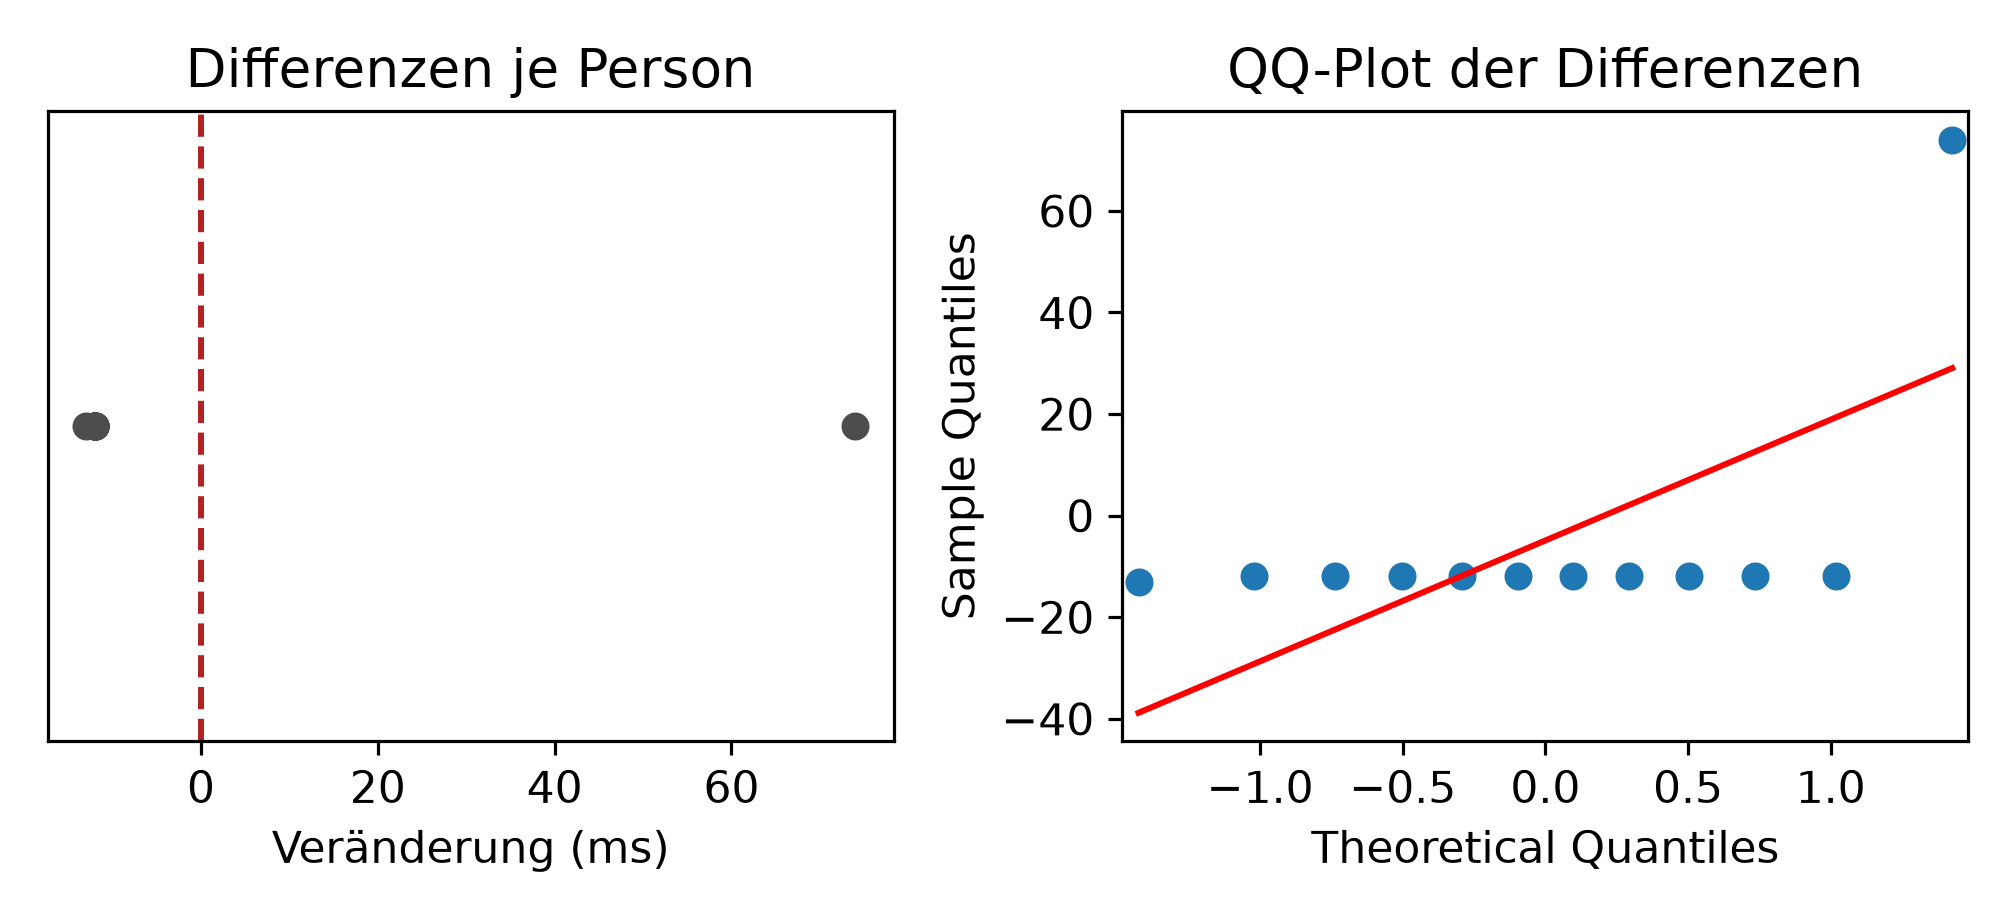
Zwölf Personen, wieder eine Massnahme dazwischen. Elf Personen verbessern sich um rund zwölf Millisekunden, eine verschlechtert sich um 74. Solche Einzelfälle kommen vor: eine Störung während der Messung, ein Missverständnis der Aufgabe, ein technisches Problem.
Mittelwert der Differenzen -4.9 ms, Median -12.0 ms, Standardabweichung 24.9 ms. Die Lücke zwischen Mittelwert und Median ist das Warnsignal: Ein einziger Wert zieht den Mittelwert um sieben Millisekunden nach oben und verdoppelt die Streuung. Im QQ-Plot liegt er weit ausserhalb.
    Paired t-test

data:  nach_m and vor_m
t = -0.68528, df = 11, p-value = 0.5074
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 -20.70812  10.87479
sample estimates:
mean difference
      -4.916667
wilcox.test(nach_m, vor_m, paired =TRUE)
    Wilcoxon signed rank exact test

data:  nach_m and vor_m
V = 12, p-value = 0.02832
alternative hypothesis: true location shift is not equal to 0
t_wert, t_p = stats.ttest_rel(nach_m, vor_m)v_wert, v_p = stats.wilcoxon(diff_m)print("gepaarter t-Test t =", round(t_wert, 4), " p =", round(t_p, 4))print("Wilcoxon (gepaart) V =", v_wert, " p =", round(v_p, 4))
Output Zeile für Zeile
Ausgabe
Wert hier
Wie er zu lesen ist
t-Test mean difference
-4.92
Sieht nach einer kleinen Verbesserung aus, beschreibt aber keine einzige der zwölf Personen: Elf verbesserten sich um zwölf, eine verschlechterte sich um 74.
t-Test t
-0.685
Der Standardfehler beträgt 7.2 ms, weil der eine Wert die Streuung verdoppelt.
t-Test p-value
0.507
Nicht signifikant.
t-Test Intervall
-20.71 bis 10.87 ms
Über 31 ms breit; es schliesst nichts aus.
Wilcoxon V
12
Die Rangsumme der positiven Differenzen. Nur eine Person hat sich verschlechtert, deshalb ist der Wert klein.
Wilcoxon p-value
0.028
Signifikant, also die gegenteilige Entscheidung.
Interpretation und Ergebnissatz
Der Rangtest sieht, dass sich elf von zwölf Personen verbessert haben. Der t-Test sieht den Mittelwert der Differenzen, geteilt durch eine Streuung, die ein einzelner Wert bestimmt.
Die Reihenfolge bleibt dieselbe wie immer: erst die Verteilung der Differenzen ansehen, dann das Verfahren wählen, dann rechnen. Und der auffällige Fall gehört in den Bericht, nicht in den Papierkorb. Wenn sich klären lässt, dass die Messung gestört war, wird sie mit Begründung ausgeschlossen; bleibt die Ursache offen, wird das Ergebnis mit und ohne den Fall berichtet.
Die Differenzen enthalten einen Extremwert (eine Verschlechterung um 74 ms bei elf Verbesserungen um rund 12 ms), weshalb vorab rangbasiert ausgewertet wurde. Die Reaktionszeit verkürzt sich (Wilcoxon für verbundene Stichproben, V = 12, p = 0.028, n = 12; Median der Veränderung -12.0 ms). Ein Mittelwertvergleich wäre an diesem Einzelfall gescheitert (t(11) = -0.69, p = 0.51).
Verständnisfragen
Der gepaarte Test liefert p < 0.001, der ungepaarte auf denselben Daten p = 0.85. Welche Zahl gilt?
Die des gepaarten Tests, wenn die Daten tatsächlich gepaart erhoben wurden
Richtig. Die Paarung entfernt die Streuung zwischen den Objekten. Der ungepaarte Test misst den Effekt an einer viel grösseren Streuung und übersieht ihn deshalb.
Die des ungepaarten Tests, weil er konservativer ist
Konservativ ist hier kein Vorzug, sondern das Ergebnis einer falschen Annahme über die Datenstruktur.
Der Mittelwert beider p-Werte
p-Werte werden nicht gemittelt.
Nach dem Zusammenführen zweier Messreihen springt die Standardabweichung der Differenzen von 0.3 auf 12. Was ist zu prüfen?
Ob die Paarung noch stimmt
Richtig. Eine Streuung in der Grössenordnung der Unterschiede zwischen den Objekten deutet darauf hin, dass die Zuordnung verloren ging und falsche Paare gebildet wurden.
Ob die Messgeräte kalibriert waren
Möglich, aber dann wäre auch der Mittelwert der Differenzen betroffen.
Nichts, das ist normal
Es ist das Gegenteil von normal: die Paarung soll die Streuung gerade verkleinern.
Warum sind bei 20 Maschinen die Freiheitsgrade 19 und nicht 38?
Weil die Analyse auf 20 Differenzen beruht
Richtig. Aus 40 Messwerten werden 20 Paare und daraus 20 Differenzen; ein Freiheitsgrad geht für den Mittelwert verloren.
Weil zwei Parameter geschätzt werden
Das wäre die Rechnung beim ungepaarten Test mit zwei Gruppen.
Weil die Hälfte der Werte redundant ist
Redundant ist nichts; die Information steckt in den Differenzen.
Für eine Massnahme wurden gezielt die 20 Maschinen mit dem höchsten Verbrauch ausgewählt. Nach der Wartung liegt der Verbrauch signifikant niedriger. Was fehlt für den Schluss auf die Wirkung?
Nichts, das Ergebnis ist eindeutig
Es ist statistisch eindeutig und inhaltlich nicht.
Eine Kontrollgruppe, wegen der Regression zur Mitte
Richtig. Objekte, die wegen extremer Werte ausgewählt wurden, zeigen bei der zweiten Messung schon aus statistischen Gründen weniger extreme Werte, auch ohne jede Massnahme.
Ein grösserer Stichprobenumfang
Mehr Maschinen würden denselben systematischen Fehler nur präziser reproduzieren.