fig, achse = plt.subplots(figsize=(7, 3))
_ = sns.boxplot(data=messung, x="typ", y="verbrauch", color="0.85",
showfliers=False, ax=achse)
_ = sns.stripplot(data=messung, x="typ", y="verbrauch", size=3, alpha=0.5,
color="0.25", ax=achse)
plt.tight_layout()
plt.show()seaborn und plotly
Kernideen
- seaborn baut auf matplotlib auf: jede seaborn-Grafik bleibt eine matplotlib-Figur, und der Feinschliff läuft weiterhin über die Achse.
- Es erwartet Daten im langen Format, eine Zeile je Beobachtung.
- Statistische Standardgrafiken entstehen mit einem Aufruf statt mit zehn.
- Funktionen auf Achsenebene nehmen
ax=, Funktionen auf Rasterebene erzeugen eine eigene Figur und nehmen es nicht. - plotly erzeugt interaktive Grafiken für HTML, nicht für Papier.
- Interaktivität lohnt sich nur, wenn sie eine Frage beantwortet, die man vorher nicht kennt.
Erklärung
Vorwissen: matplotlib für Figure und Axes, pandas für die Datenstruktur und Tidy Data für das lange Format. Welche Darstellung zur Aufgabe passt, klärt Diagrammtyp wählen.
Was seaborn abnimmt
matplotlib zeichnet, seaborn fasst zusammen. Der Unterschied zeigt sich bei Standardaufgaben der Datenanalyse: Gruppen vergleichen, Verteilungen darstellen, Zusammenhänge mit Ausgleichsgerade zeigen. In matplotlib sind das jeweils mehrere Schritte, gruppieren, aggregieren, positionieren, beschriften; in seaborn ist es ein Aufruf, der die Daten selbst gruppiert.
Der Preis ist eine Vorbedingung: Die Daten müssen im langen Format vorliegen und die Spaltennamen werden zu Beschriftungen. Wer das breite Format hat, muss vorher umformen.
Achsenebene oder Rasterebene
Die Eigenheit, über die man einmal stolpert:
| Ebene | Funktionen | Zeichnet in | Nimmt ax= |
|---|---|---|---|
| Achsenebene | scatterplot, lineplot, boxplot, histplot, regplot |
eine bestehende Achse | ja |
| Rasterebene | relplot, catplot, displot, lmplot, pairplot |
eine eigene Figur mit Facetten | nein |
Die Rasterfunktionen sind die facettierten Geschwister der Achsenfunktionen: relplot(kind="scatter") ist scatterplot plus FacetGrid.
Die wichtigsten Funktionen
| Aufgabe | Funktion | Bemerkung |
|---|---|---|
| Verteilung | sns.histplot, sns.kdeplot, sns.ecdfplot |
ecdfplot zeigt alle Daten ohne Bandbreitenwahl |
| Gruppen vergleichen | sns.boxplot, sns.violinplot, sns.stripplot |
Box und Punkte kombinieren |
| Zusammenhang | sns.scatterplot, sns.regplot, sns.lmplot |
regplot zeichnet Gerade samt Konfidenzband |
| Mengen | sns.barplot, sns.countplot |
barplot aggregiert selbst und zeigt Unsicherheit |
| Verlauf | sns.lineplot |
aggregiert mehrere Werte je x automatisch |
| Matrix | sns.heatmap |
für Korrelationen, mit annot=True beschriftet |
| Aufteilen | sns.relplot, sns.displot, sns.catplot |
die Varianten mit eingebauter Facettierung |
plotly: wann Interaktivität lohnt
plotly erzeugt Grafiken, die im Browser reagieren: Werte beim Überfahren, Zoomen, Serien ein- und ausblenden. Das ist nützlich, wenn die Grafik eine Frage beantwortet, die man nicht vorher kennt, beim eigenen Erkunden oder in einem Dashboard.
Für Bericht und Druck bleibt die statische Grafik die richtige Wahl: Sie hat eine Aussage, und die steht im Titel. Eine interaktive Grafik verschiebt die Arbeit zum Publikum, und das ist genau dann falsch, wenn die Aussage feststeht.
plotly ist in der Rechenumgebung dieser Seite nicht installiert; die entsprechenden Beispiele stehen deshalb als Listing.
Der Datensatz dieser Seite
240 Messungen mit Laufzeit, Maschinentyp, Standort und Verbrauch, deterministisch erzeugt.
Beispiele
Frage und Datenlage
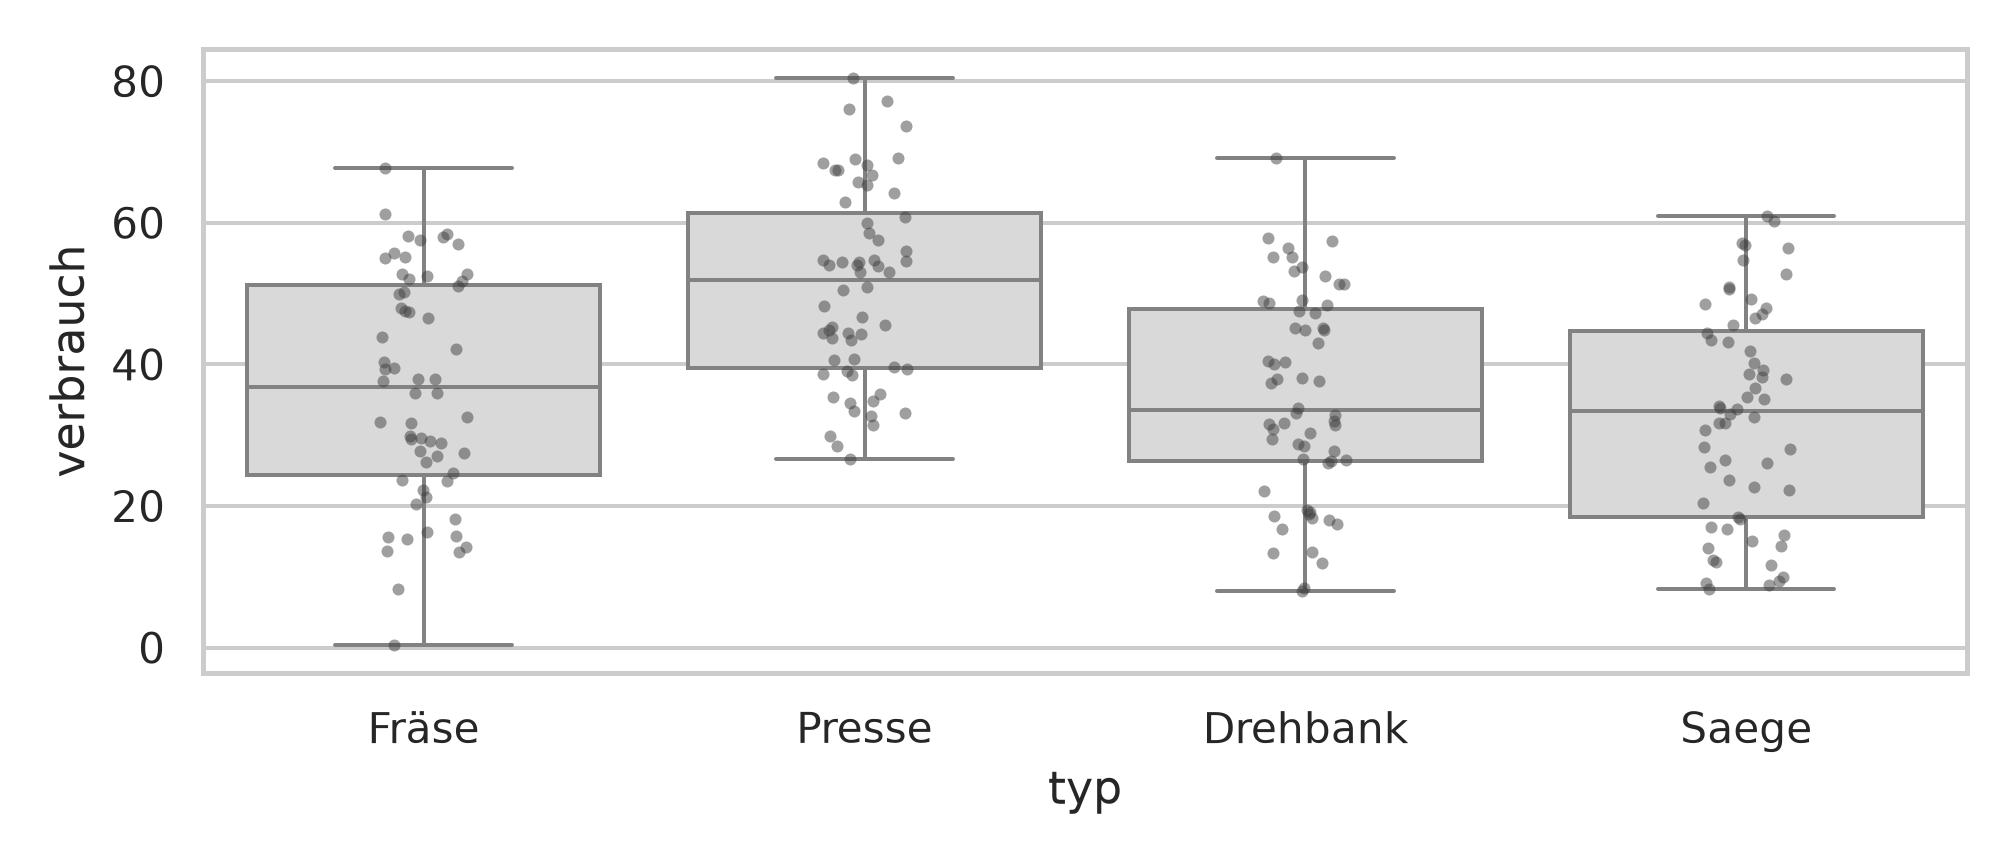
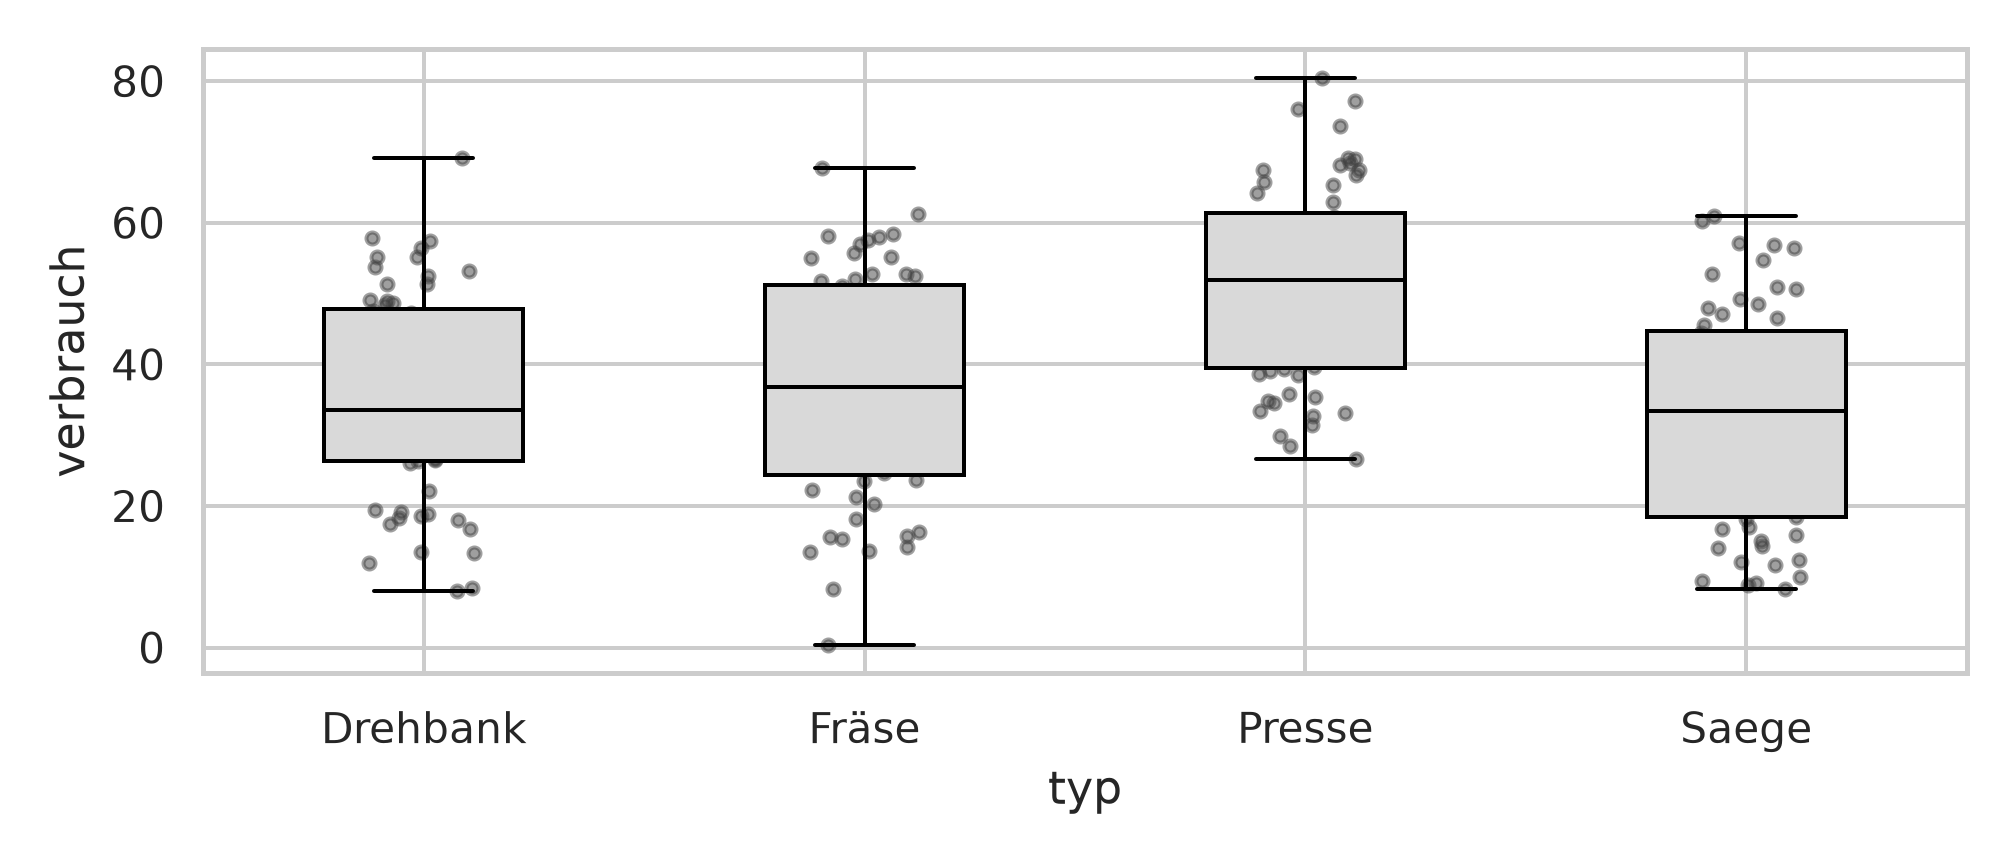
Ein Boxplot des Verbrauchs je Maschinentyp, mit den Einzelwerten darüber. Einmal mit seaborn, einmal mit matplotlib von Hand und gezählt, was das an Code kostet.
Rechnung
typen = sorted(messung["typ"].unique())
gruppen = [messung.loc[messung["typ"] == t, "verbrauch"].to_numpy() for t in typen]
fig, achse = plt.subplots(figsize=(7, 3))
# set_xticks statt tick_labels/labels: die Namen dieses Arguments haben sich
# zwischen den matplotlib-Versionen geaendert.
_ = achse.boxplot(gruppen, showfliers=False, patch_artist=True,
boxprops={"facecolor": "0.85"},
medianprops={"color": "black"})
_ = achse.set_xticks(range(1, len(typen) + 1), typen)
streu = (lehmer(99, len(messung)) - 0.5) * 0.25
for k, (t, werte) in enumerate(zip(typen, gruppen), start=1):
maske = (messung["typ"] == t).to_numpy()
_ = achse.scatter(k + streu[maske], werte, s=9, alpha=0.5, color="0.25")
_ = achse.set_xlabel("typ")
_ = achse.set_ylabel("verbrauch")
plt.tight_layout()
plt.show()print(messung.groupby("typ")["verbrauch"]
.agg(anzahl="count", mittel="mean", median="median", sd="std").round(2))
zeilen = {"seaborn": 4, "matplotlib von Hand": 11}
print({**zeilen, "verhaeltnis": round(zeilen["matplotlib von Hand"]
/ zeilen["seaborn"], 2)})Output Zeile für Zeile
| Typ | Anzahl | Mittel | Median | SD |
|---|---|---|---|---|
| Drehbank | 60 | 35.50 | 33.50 | 14.53 |
| Fräse | 60 | 36.60 | 36.85 | 15.89 |
| Presse | 60 | 51.02 | 51.95 | 13.70 |
| Saege | 60 | 32.60 | 33.35 | 15.25 |
| Fassung | Codezeilen (ohne subplots, tight_layout, show) |
|---|---|
| seaborn | 4 |
| matplotlib von Hand | 11 |
| Verhältnis | 2.75 |
| Beobachtung | Erklärung |
|---|---|
| seaborn braucht keine Gruppierung im Code | x="typ" genügt. Die Aufteilung in vier Gruppen, ihre Reihenfolge und die Achsenbeschriftung kommen aus den Daten. |
| Von Hand sind es die Schritte einzeln | Gruppen bilden, Liste übergeben, Beschriftungen setzen, Streuung für die Punkte erzeugen, je Gruppe zeichnen. Jeder Schritt ist eine Stelle, an der etwas schiefgehen kann. |
| Der Faktor liegt bei 2.75 | Und er wächst mit der Zahl der Gruppierungsvariablen: Bei zwei Gruppierungen (hue=) bleibt seaborn bei einem Aufruf, die Handarbeit verdoppelt die Schleife. |
| Das Ergebnis ist dasselbe Objekt | seaborn gibt ein matplotlib-Axes zurück. Alles, was danach kommt, Titel, Grenzen, Anmerkungen, läuft über die gewohnten Aufrufe. |
| Die Pressen liegen mit 51.02 klar über den anderen | Und die Sägen mit 32.60 darunter. Der Boxplot zeigt das, die Einzelwerte zeigen zusätzlich, wie stark sich die Gruppen überlappen. |
Der Zusatz, der fast nichts kostet und viel bringt: stripplot über den Boxplot legen. Damit sind beide Fragen beantwortet, Lage und Streuung aus der Box, Form und Fallzahl aus den Punkten. Siehe Diagrammtyp wählen, Beispiel 1, wo ein Boxplot eine zweigipflige Verteilung verbirgt.
Ab etwa 500 Punkten je Gruppe wird stripplot unübersichtlich; dann ist violinplot oder boxenplot die bessere Wahl.
Interpretation und Ergebnissatz
Derselbe Boxplot mit Einzelwerten kostet in seaborn 4 und in matplotlib 11 Codezeilen, ein Verhältnis von 2.75. Die Pressen liegen mit einem Mittel von 51.02 über den übrigen Typen, die Sägen mit 32.60 darunter.
Frage und Datenlage
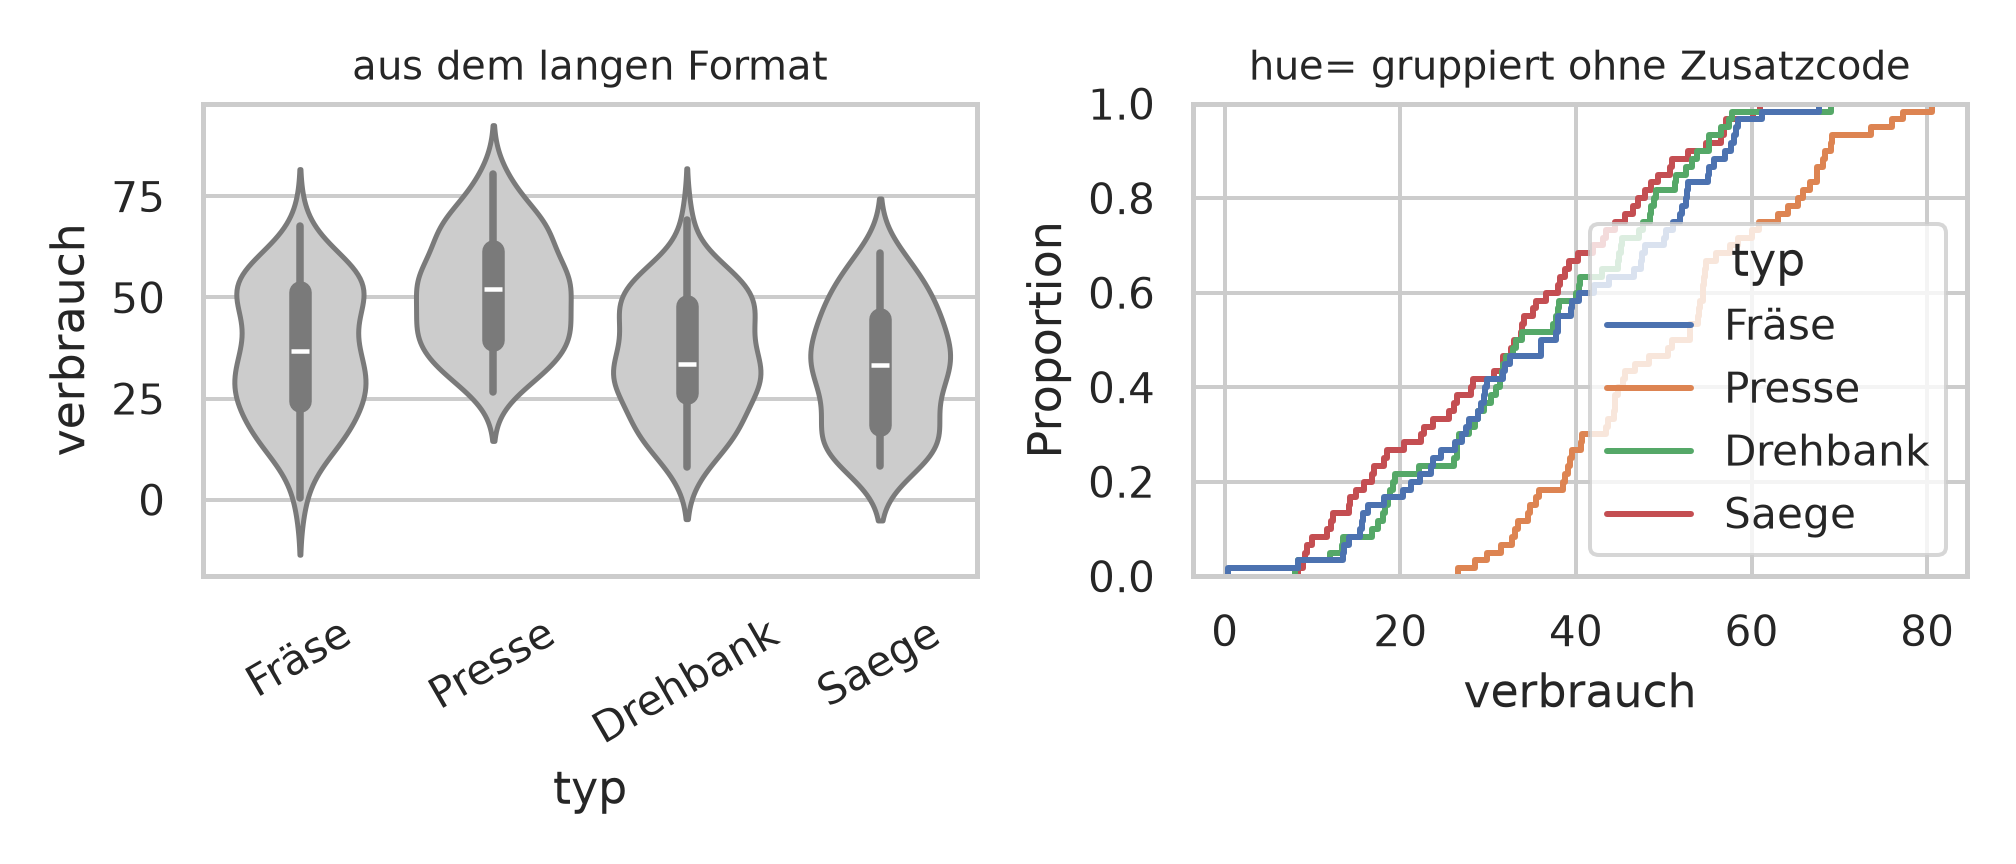
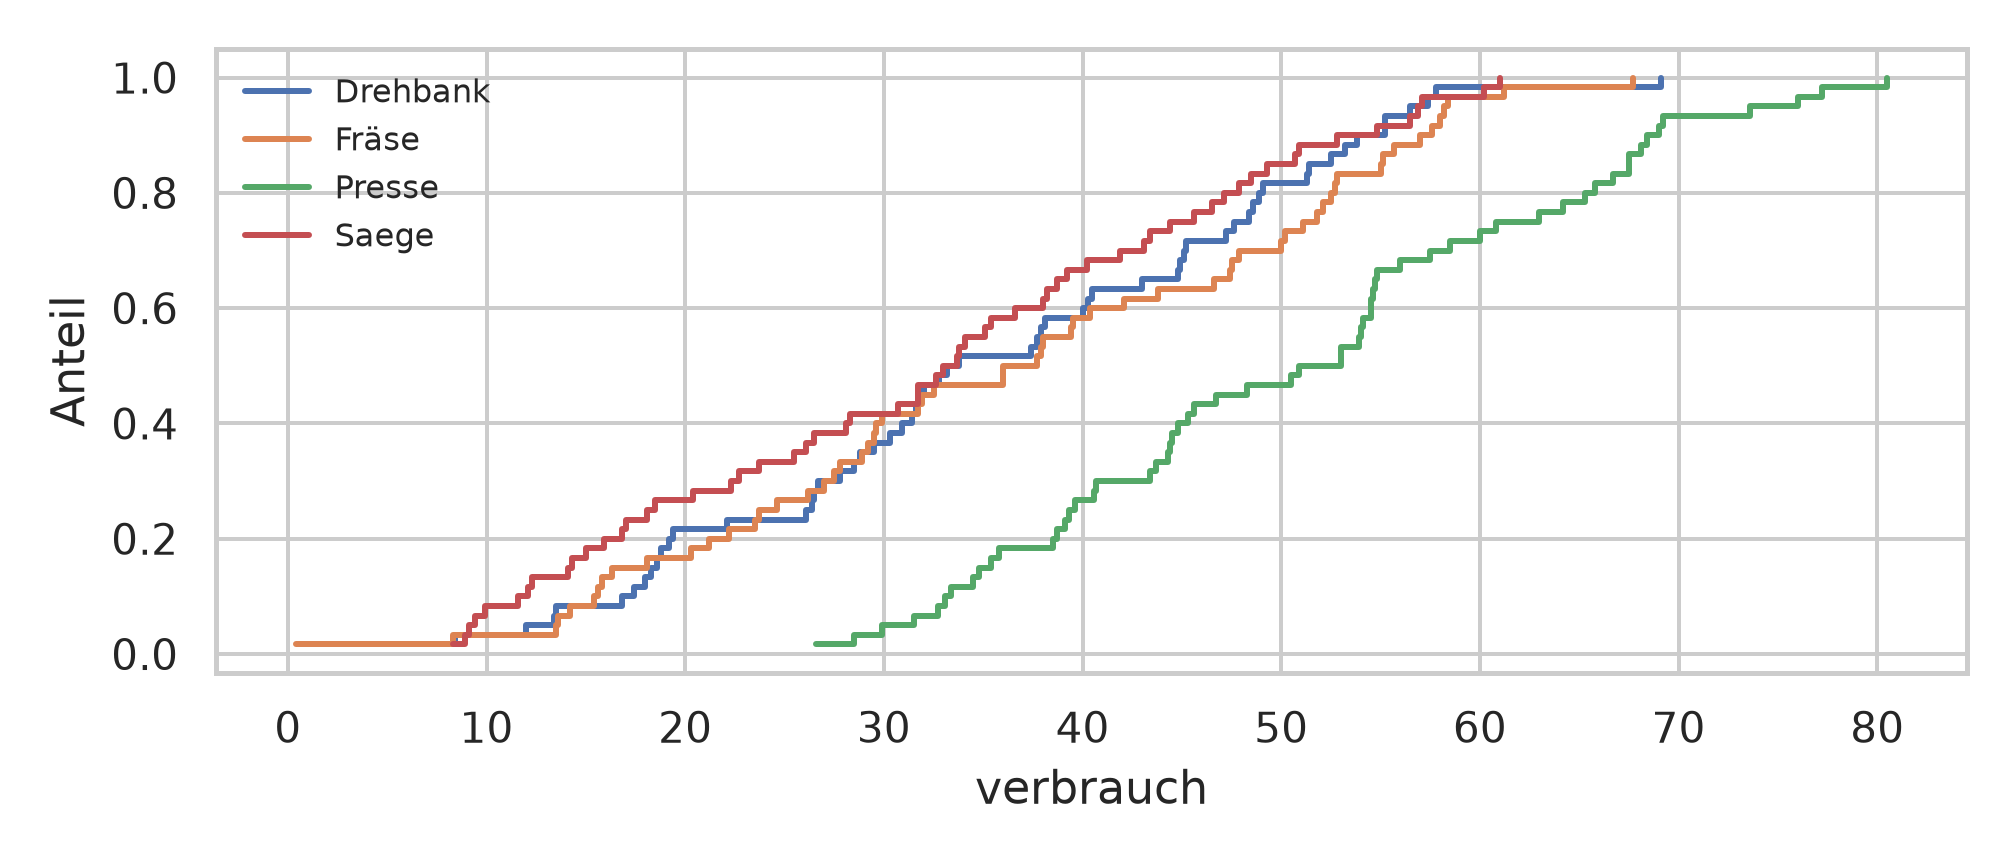
Dieselben Daten im breiten und im langen Format. seaborn arbeitet mit dem langen und der Weg dorthin ist eine Zeile.
Rechnung
# Breites Format: eine Spalte je Typ
breit = (messung.assign(nr=messung.groupby("typ").cumcount())
.pivot(index="nr", columns="typ", values="verbrauch"))
print(breit.head(3).round(1))
print({"breit_form": breit.shape, "lang_form": messung.shape})
# Zurueck ins lange Format
lang = breit.reset_index().melt(id_vars="nr", var_name="typ",
value_name="verbrauch")
print(lang.head(3))
print({"lang_zeilen": len(lang), "fehlende": int(lang["verbrauch"].isna().sum())})fig, achsen = plt.subplots(1, 2, figsize=(7, 3))
_ = sns.violinplot(data=messung, x="typ", y="verbrauch", color="0.8",
ax=achsen[0])
_ = achsen[0].set_title("aus dem langen Format", fontsize=10)
_ = achsen[0].tick_params(axis="x", rotation=30)
_ = sns.ecdfplot(data=messung, x="verbrauch", hue="typ", ax=achsen[1])
_ = achsen[1].set_title("hue= gruppiert ohne Zusatzcode", fontsize=10)
plt.tight_layout()
plt.show()fig, achse = plt.subplots(figsize=(7, 3))
for t in sorted(messung["typ"].unique()):
werte = np.sort(messung.loc[messung["typ"] == t, "verbrauch"].to_numpy())
anteil = np.arange(1, len(werte) + 1) / len(werte)
_ = achse.step(werte, anteil, where="post", label=t)
_ = achse.legend(fontsize=8, frameon=False)
_ = achse.set_xlabel("verbrauch")
_ = achse.set_ylabel("Anteil")
plt.tight_layout()
plt.show()Output Zeile für Zeile
| Format | Form |
|---|---|
| breit | (60, 4), eine Spalte je Typ |
| lang | (240, 4), eine Zeile je Messung |
nach melt |
240 Zeilen, 0 fehlende Werte |
| Beobachtung | Erklärung |
|---|---|
| Das breite Format hat 60 Zeilen und 4 Spalten | Es funktioniert nur, weil alle vier Gruppen gleich gross sind. Bei ungleichen Gruppen entstünden fehlende Werte. |
| Das lange Format hat 240 Zeilen | Eine je Messung. Die Gruppenzugehörigkeit steht als Wert in einer Spalte, nicht als Spaltenname. |
| seaborn braucht genau diese Form | x="typ" verweist auf eine Spalte. Im breiten Format gäbe es keine solche Spalte, der Typ wäre im Spaltennamen versteckt. |
melt ist die eine Zeile dorthin |
id_vars bleibt stehen, alles andere wird zu zwei Spalten: Name und Wert. In R heisst das pivot_longer. |
hue="typ" erzeugt die Gruppen samt Legende |
Die Handarbeit daneben braucht eine Schleife, ein label= je Durchlauf und einen legend()-Aufruf und die Sortierung der Werte für die Verteilungsfunktion obendrein. |
Die Faustregel zum Erkennen des langen Formats: Jede Spalte ist eine Variable, jede Zeile eine Beobachtung. Steht in einem Spaltennamen ein Datenwert, ein Jahr, ein Produktname, ein Maschinentyp, ist das Format breit.
Ausführlich unter Tidy Data.
Interpretation und Ergebnissatz
Im breiten Format stehen die 240 Messungen als 60 Zeilen mal 4 Spalten, im langen als 240 Zeilen mit der Gruppenzugehörigkeit als Spaltenwert. Nur die zweite Form lässt sich mit
x="typ"undhue="typ"ansprechen;meltist der Weg dorthin.
Frage und Datenlage
sns.scatterplot nimmt ax=, sns.relplot nicht. Warum und was zurückgegeben wird.
Rechnung
fig, achse = plt.subplots(figsize=(3, 2))
ergebnis_achse = sns.scatterplot(data=messung, x="laufzeit", y="verbrauch",
ax=achse)
print({"scatterplot_gibt_zurueck": type(ergebnis_achse).__name__,
"ist_dieselbe_achse": ergebnis_achse is achse})
plt.close(fig)
ergebnis_raster = sns.relplot(data=messung, x="laufzeit", y="verbrauch",
col="typ", col_wrap=2, height=1.4)
print({"relplot_gibt_zurueck": type(ergebnis_raster).__name__,
"anzahl_teilbilder": ergebnis_raster.axes.size,
"hat_eigene_figur": ergebnis_raster.figure is not fig})
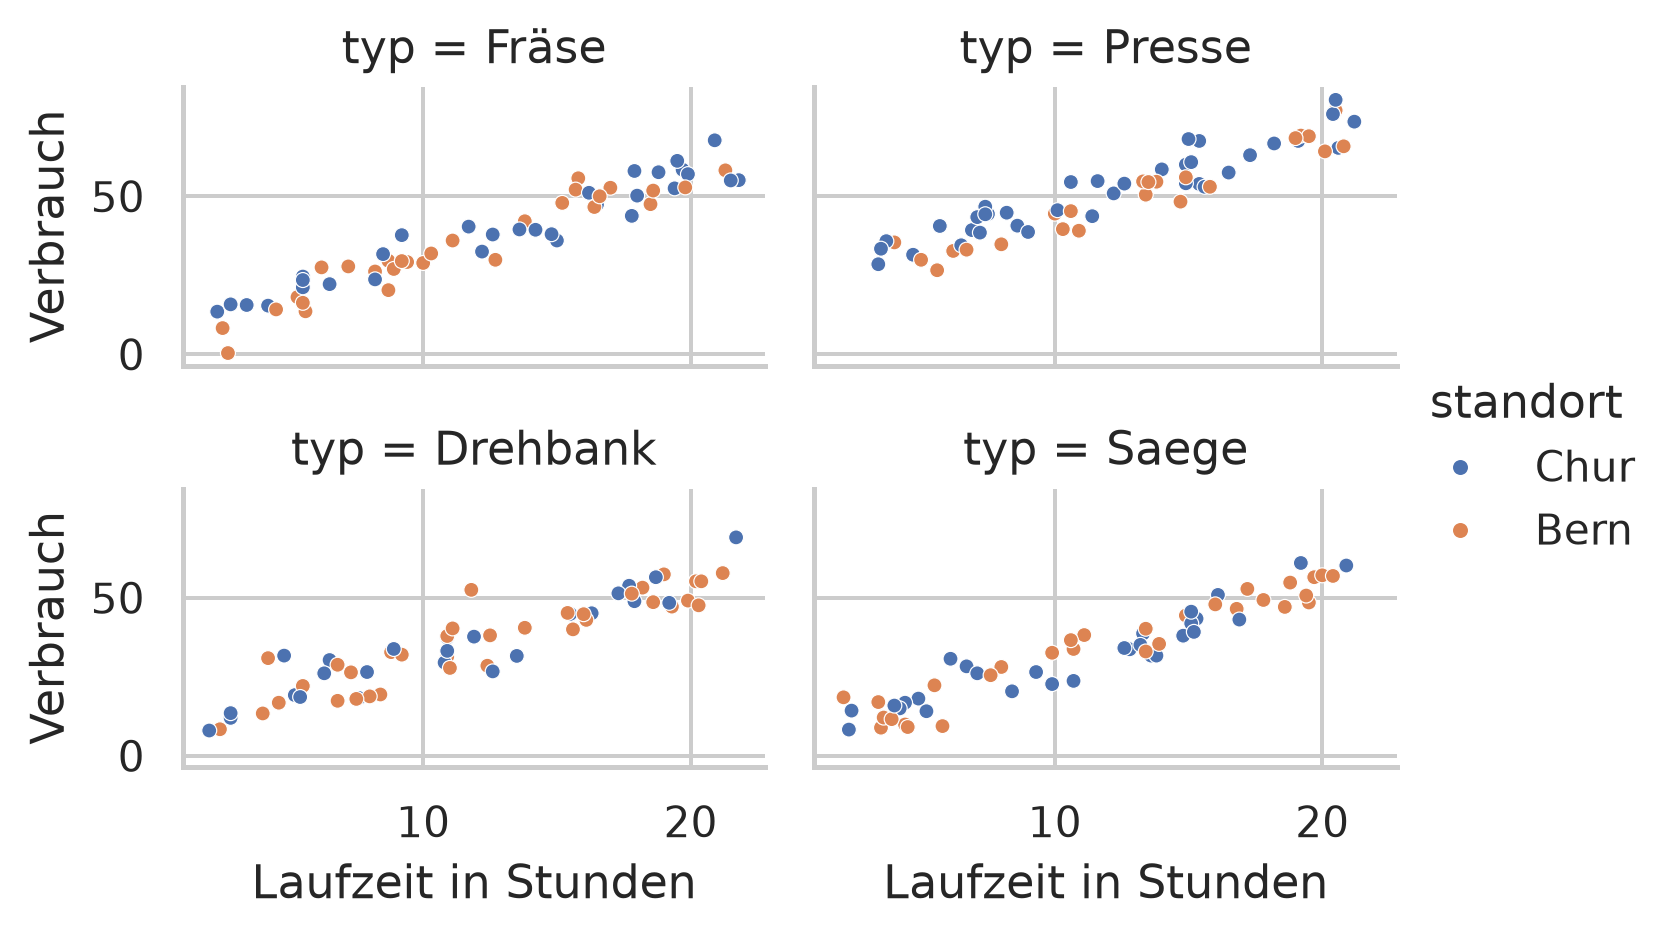
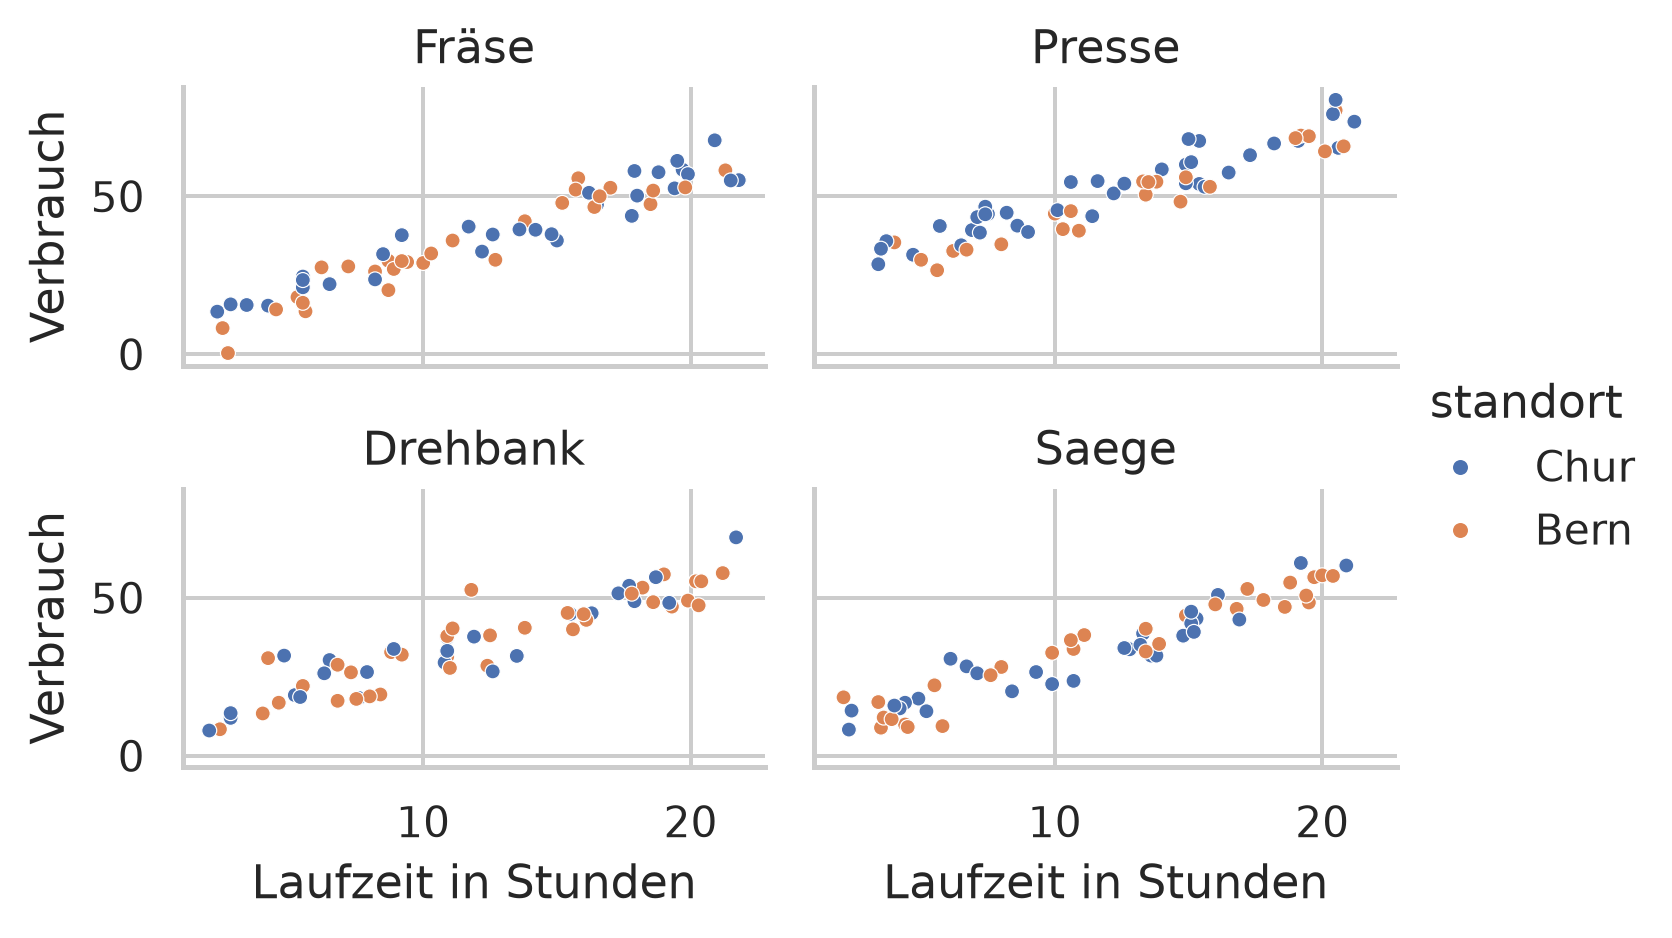
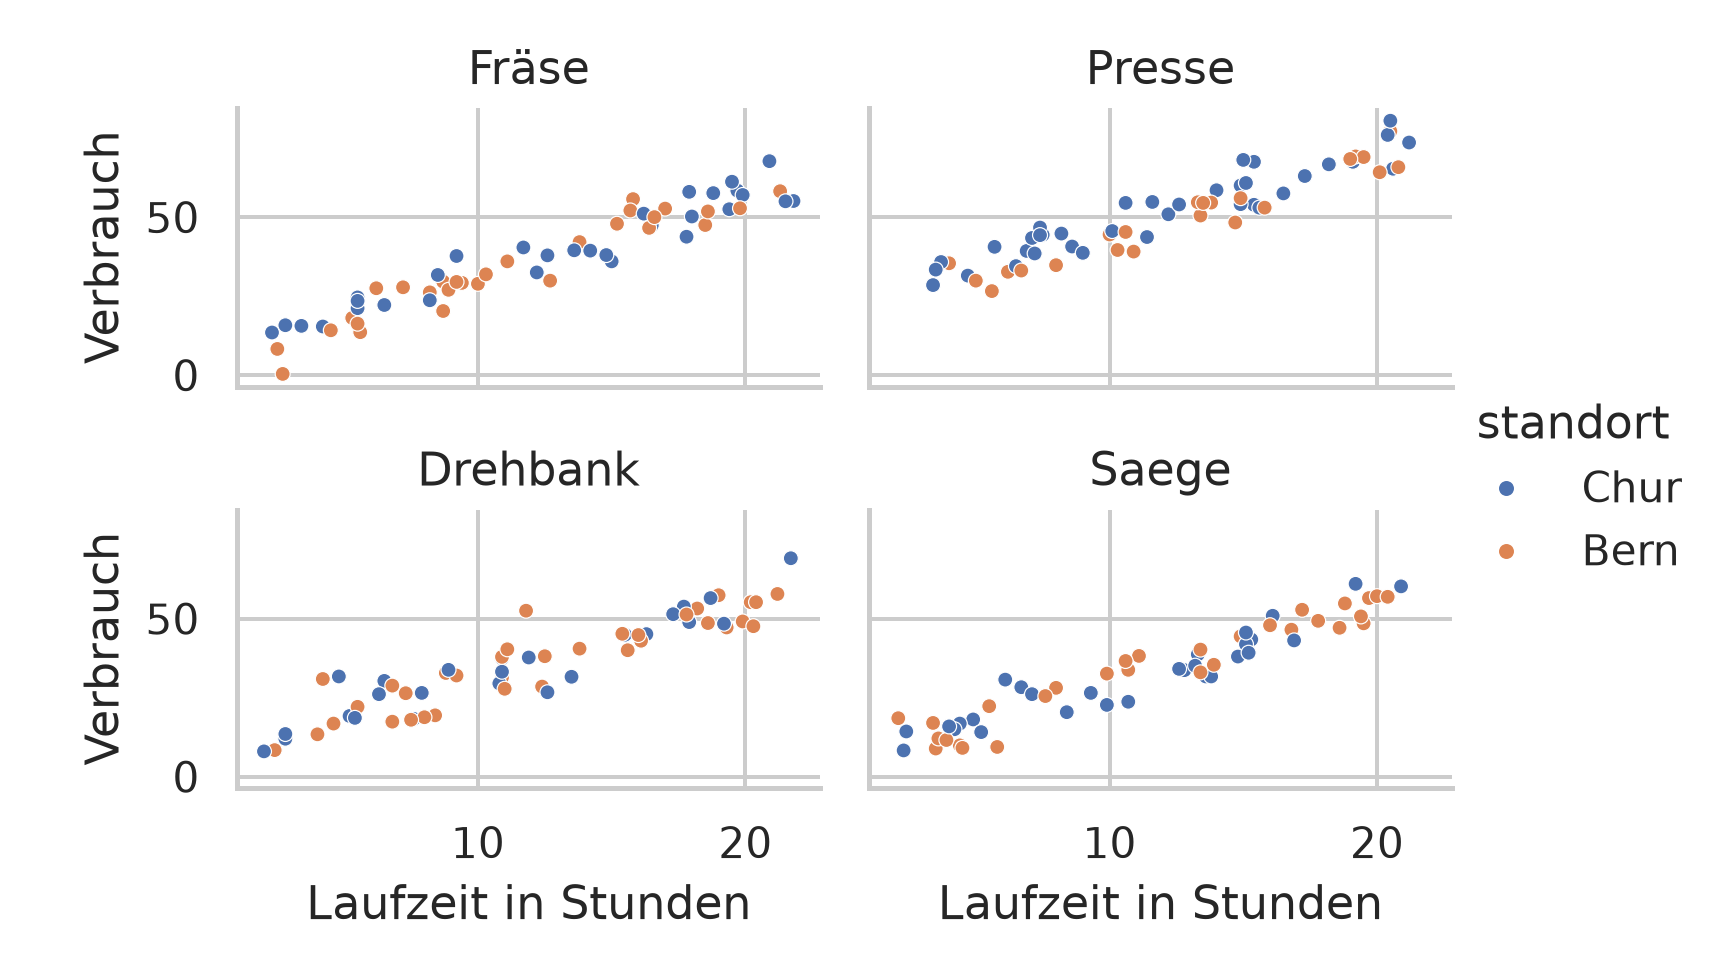
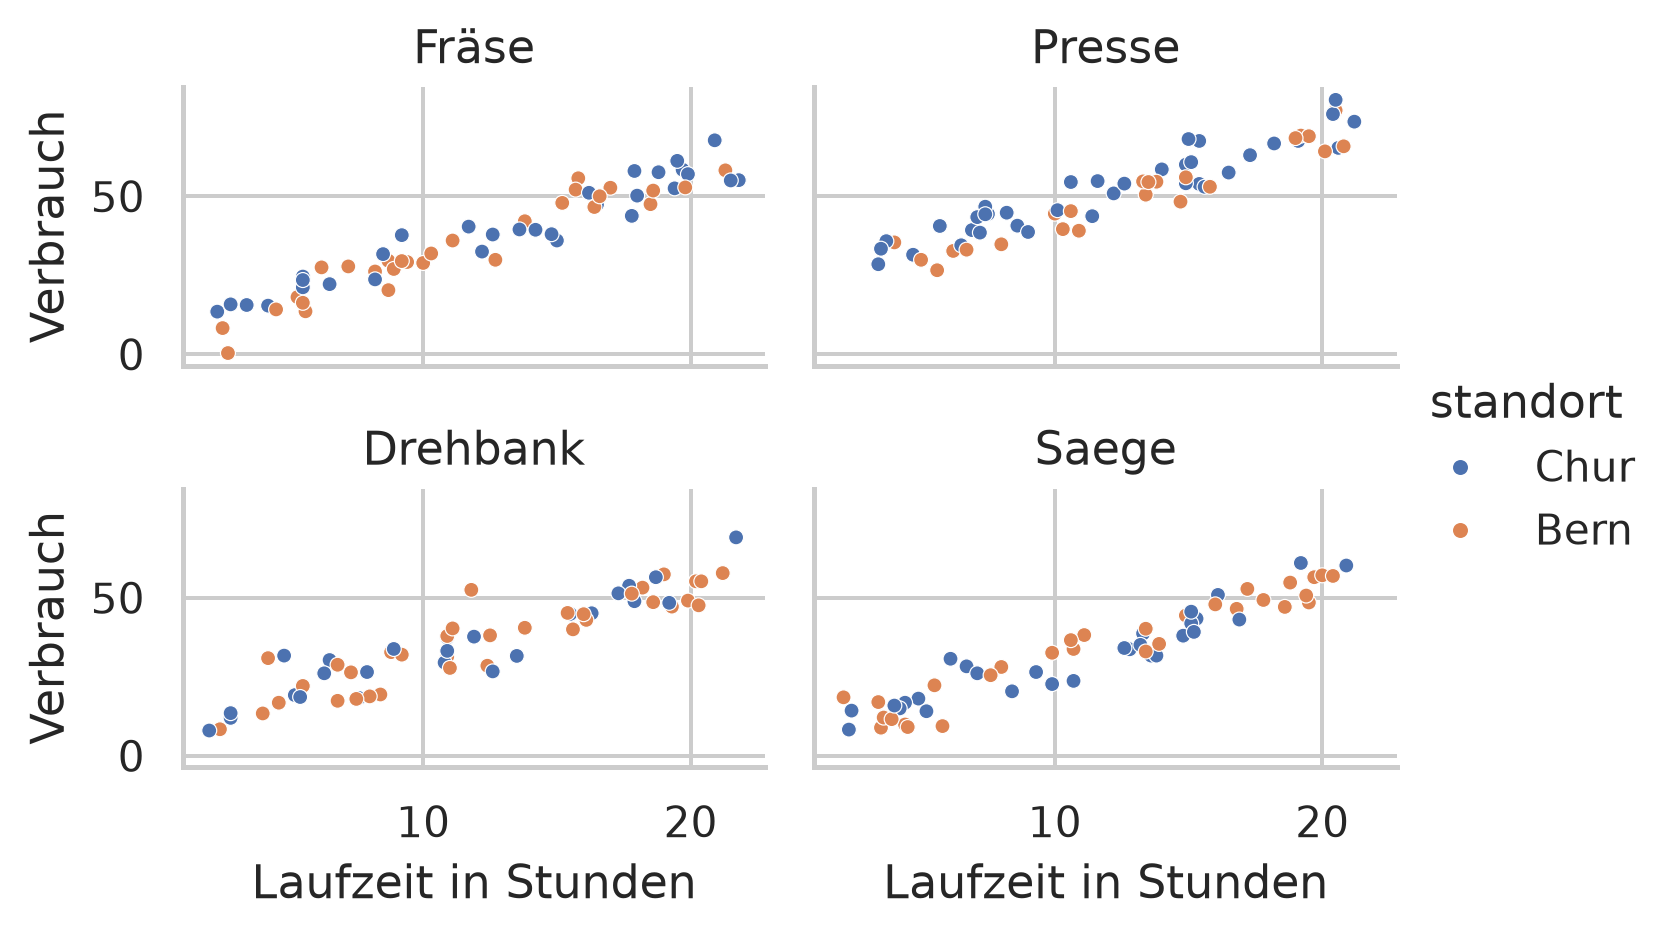
plt.close(ergebnis_raster.figure)raster = sns.relplot(data=messung, x="laufzeit", y="verbrauch", col="typ",
hue="standort", col_wrap=2, height=1.7, aspect=1.5, s=14)
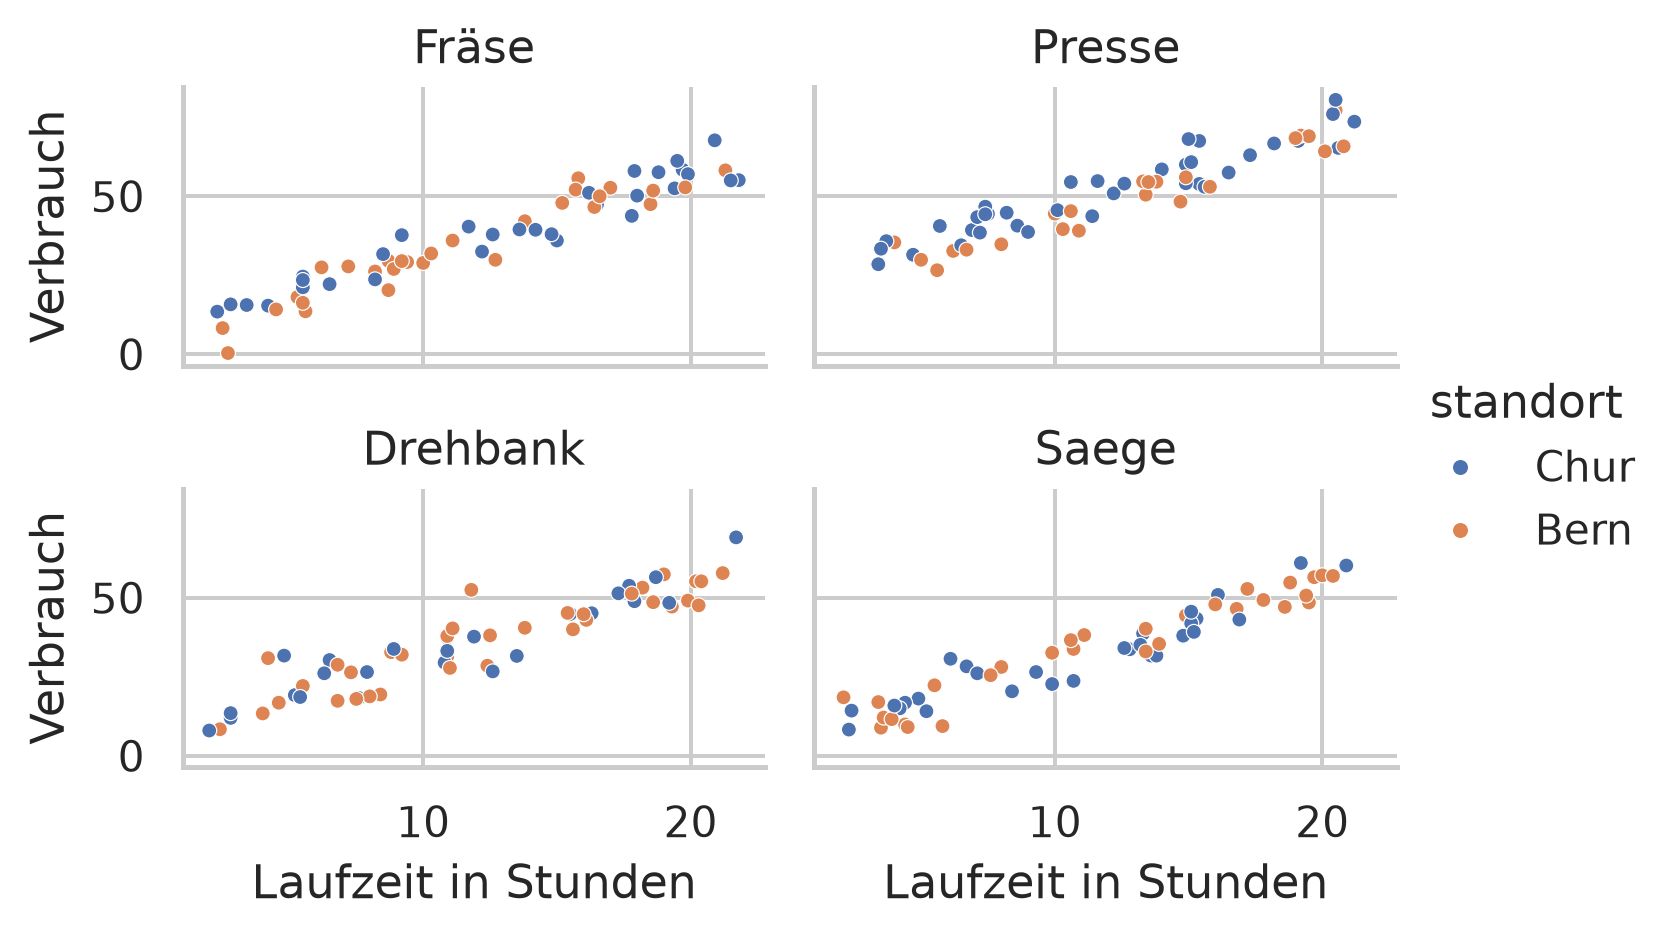
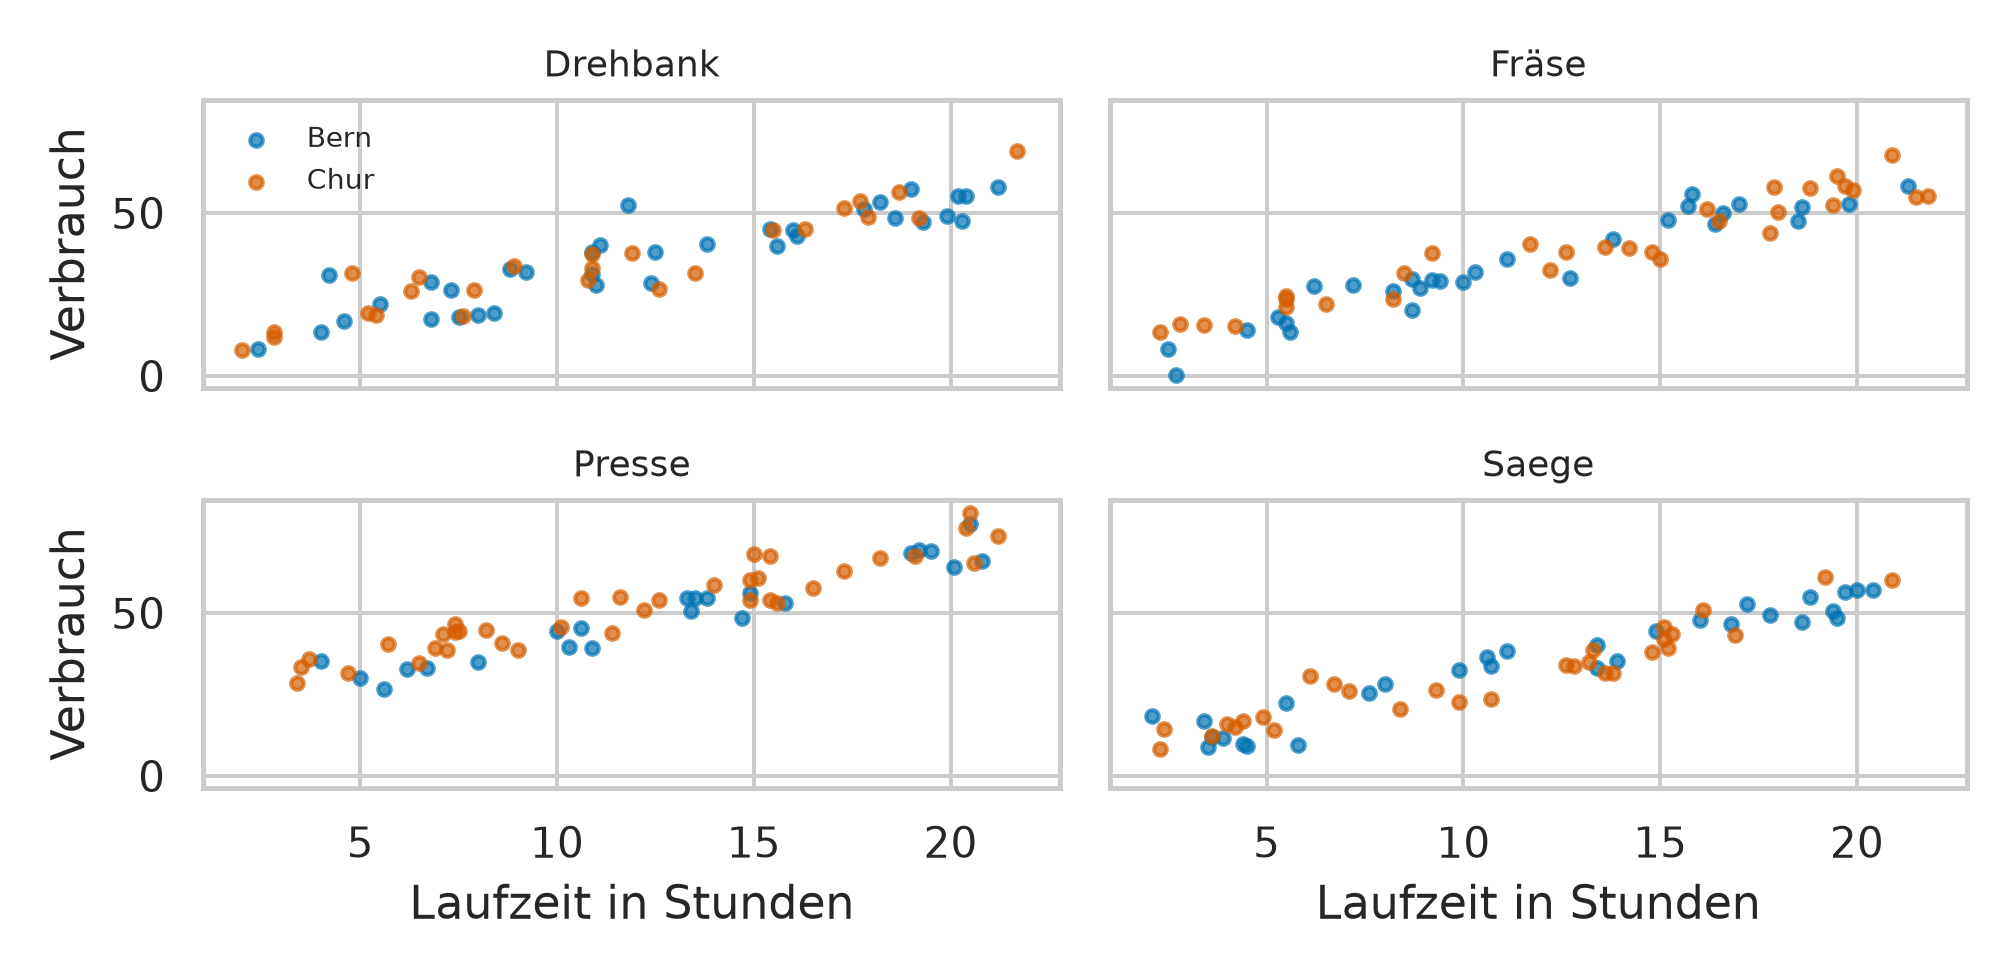
_ = raster.set_axis_labels("Laufzeit in Stunden", "Verbrauch")_ = raster.set_titles("{col_name}")plt.show()typen = sorted(messung["typ"].unique())farben = {"Bern": "#0072B2", "Chur": "#D55E00"}fig, achsen = plt.subplots(2, 2, figsize=(7, 3.4), sharex=True, sharey=True)for achse, t in zip(achsen.ravel(), typen):
teil = messung[messung["typ"] == t]
for ort, gruppe in teil.groupby("standort"):
_ = achse.scatter(gruppe["laufzeit"], gruppe["verbrauch"], s=10,
alpha=0.7, color=farben[ort], label=ort)
_ = achse.set_title(t, fontsize=9)
_ = achsen[0, 0].legend(fontsize=7, frameon=False)
for achse in achsen[-1]:
_ = achse.set_xlabel("Laufzeit in Stunden")
for achse in achsen[:, 0]:
_ = achse.set_ylabel("Verbrauch")
plt.tight_layout()
plt.show()print(pd.crosstab(messung["typ"], messung["standort"]))
print(messung.groupby(["typ", "standort"])["verbrauch"].mean().round(2))Output Zeile für Zeile
| Aufruf | Rückgabe | ax= |
|---|---|---|
sns.scatterplot(..., ax=achse) |
Axes, und zwar dieselbe | ja |
sns.relplot(...) |
FacetGrid mit 4 Teilbildern, eigene Figur | nein |
Verteilung auf Typ und Standort:
| Bern | Chur | |
|---|---|---|
| Drehbank | 35 | 25 |
| Fräse | 29 | 31 |
| Presse | 23 | 37 |
| Saege | 30 | 30 |
| Beobachtung | Erklärung |
|---|---|
scatterplot gibt dieselbe Achse zurück, die es bekommen hat |
Deshalb lässt sich danach wie gewohnt weiterarbeiten: achse.set_title(...), achse.axhline(...). |
relplot gibt ein FacetGrid zurück |
Das ist kein Axes. Es hat eine eigene Figure, eigene Methoden (set_axis_labels, set_titles) und lässt sich nicht in eine vorbereitete Achse zeichnen. |
| Der Fehler tritt immer gleich auf | Man baut fig, achsen = plt.subplots(...), ruft dann relplot(..., ax=achsen[0]) und bekommt einen Fehler über ein unerwartetes Argument. Lösung: die Funktion ohne rel/cat/dis-Vorsilbe nehmen. |
| Die Standorte sind nicht gleichmässig verteilt | 23 zu 37 bei den Pressen, 35 zu 25 bei den Drehbänken. Das ist Zufall der Zuteilung und ein Grund, die Fallzahlen je Facette anzuschreiben. |
| Von Hand kostet dasselbe Bild eine doppelte Schleife | Über Typen und über Standorte, plus Legende und Achsenbeschriftung an den richtigen Rändern. |
Die Paare merken sich leicht:
| Achsenebene | Rasterebene |
|---|---|
scatterplot, lineplot |
relplot |
boxplot, violinplot, barplot, stripplot |
catplot |
histplot, kdeplot, ecdfplot |
displot |
regplot |
lmplot |
Wer ax= braucht, nimmt die linke Spalte. Wer Facetten will, die rechte.
Interpretation und Ergebnissatz
sns.scatterplotgibt dasselbeAxeszurück, das es überax=bekommen hat;sns.relplotgibt einFacetGridmit vier Teilbildern und eigener Figur zurück und kennt keinax=. Die vier Typen verteilen sich ungleich auf die Standorte, von 23 zu 37 bis 35 zu 25.
Frage und Datenlage
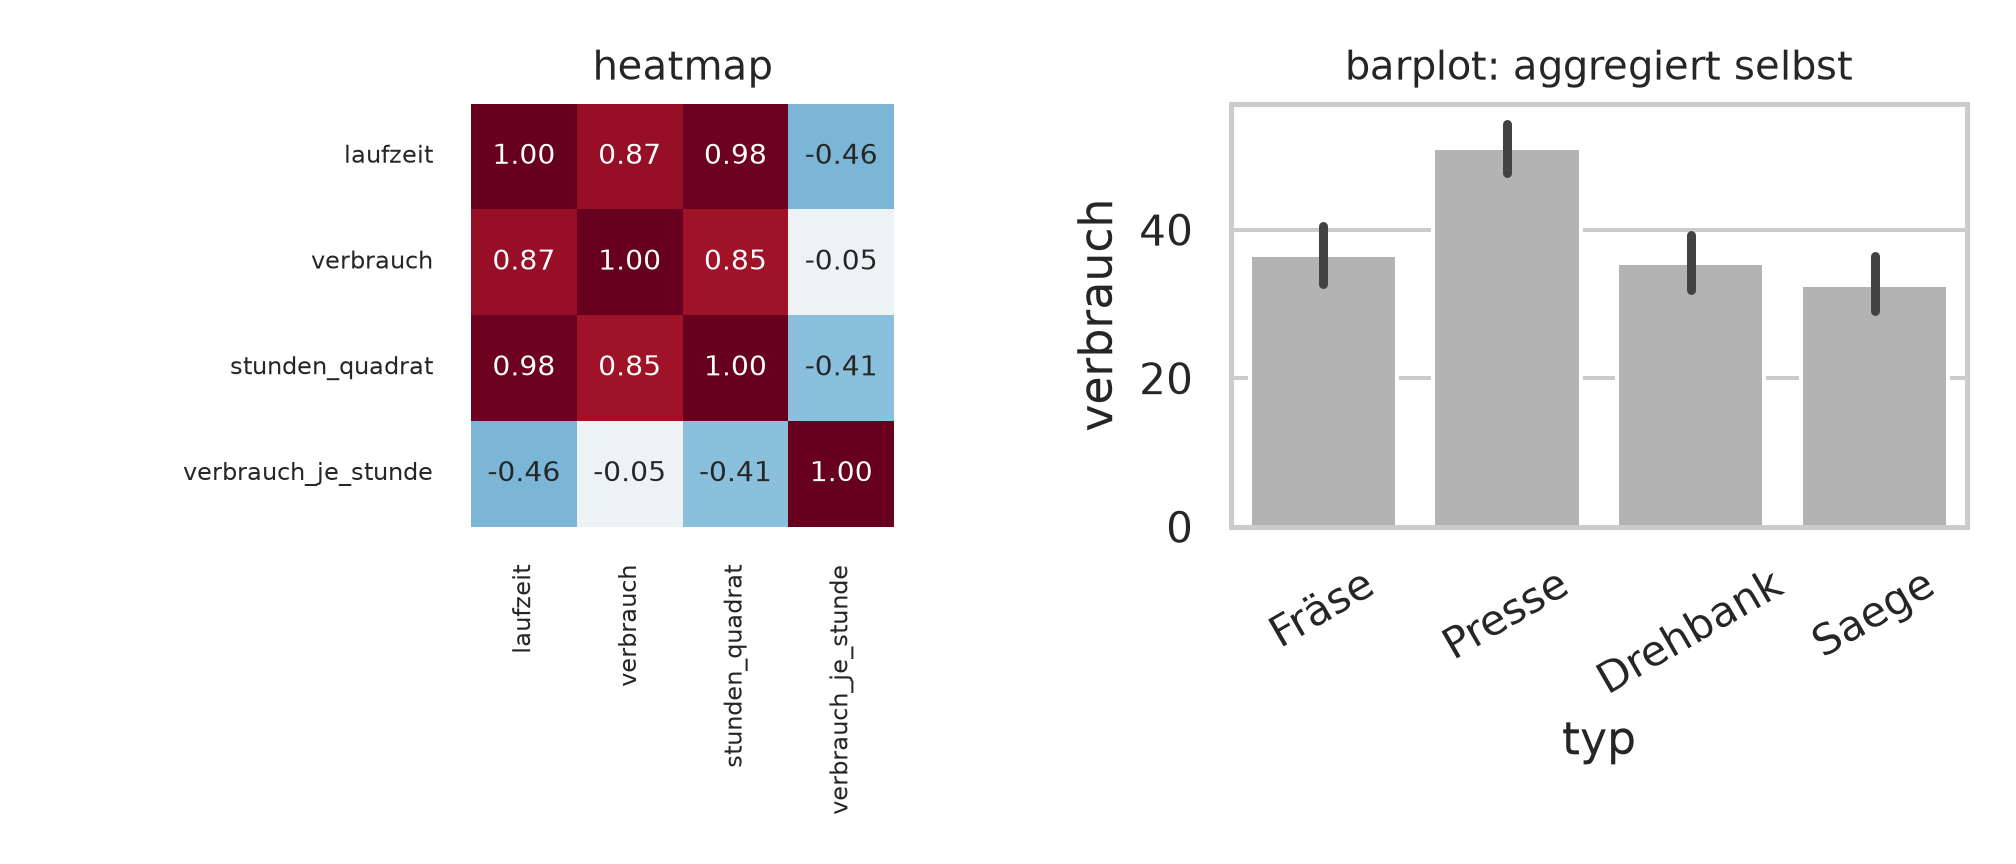
Zwei Funktionen, die mehr tun, als sie auf den ersten Blick zeigen: heatmap für eine Korrelationsmatrix und barplot, der selbst aggregiert und ein Unsicherheitsmass einzeichnet.
Rechnung
erweitert = messung.assign(
stunden_quadrat=messung["laufzeit"] ** 2,
verbrauch_je_stunde=messung["verbrauch"] / messung["laufzeit"])
korr = erweitert[["laufzeit", "verbrauch", "stunden_quadrat",
"verbrauch_je_stunde"]].corr()
print(korr.round(3))
fig, achsen = plt.subplots(1, 2, figsize=(7, 3))
_ = sns.heatmap(korr, annot=True, fmt=".2f", cmap="RdBu_r", vmin=-1, vmax=1,
square=True, cbar=False, ax=achsen[0],
annot_kws={"size": 7})
_ = achsen[0].set_title("heatmap", fontsize=10)
_ = achsen[0].tick_params(labelsize=6)
_ = sns.barplot(data=messung, x="typ", y="verbrauch", errorbar=("ci", 95),
color="0.7", ax=achsen[1])
_ = achsen[1].set_title("barplot: aggregiert selbst", fontsize=10)
_ = achsen[1].tick_params(axis="x", rotation=30)
plt.tight_layout()
plt.show()# Was barplot im Hintergrund rechnet
zusammen = messung.groupby("typ")["verbrauch"].agg(
mittel="mean", sd="std", anzahl="count")
zusammen["standardfehler"] = zusammen["sd"] / np.sqrt(zusammen["anzahl"])
zusammen["ki_unten"] = zusammen["mittel"] - 1.96 * zusammen["standardfehler"]
zusammen["ki_oben"] = zusammen["mittel"] + 1.96 * zusammen["standardfehler"]
print(zusammen.round(3)) mittel sd anzahl standardfehler ki_unten ki_oben
typ
Drehbank 35.500 14.532 60 1.876 31.823 39.177
Fräse 36.595 15.894 60 2.052 32.573 40.617
Presse 51.017 13.701 60 1.769 47.550 54.484
Saege 32.603 15.251 60 1.969 28.744 36.462
print({"korrelation_laufzeit_verbrauch":
round(float(messung["laufzeit"].corr(messung["verbrauch"])), 4)}){'korrelation_laufzeit_verbrauch': 0.8694}
Output Zeile für Zeile
Korrelationsmatrix:
| laufzeit | verbrauch | |
|---|---|---|
| laufzeit | 1.000 | 0.869 |
| verbrauch | 0.869 | 1.000 |
Was barplot im Hintergrund rechnet:
| Typ | Mittel | SD | Standardfehler | 95-Prozent-Intervall |
|---|---|---|---|---|
| Drehbank | 35.50 | 14.53 | 1.876 | 31.82 bis 39.18 |
| Fräse | 36.60 | 15.89 | 2.051 | 32.58 bis 40.62 |
| Presse | 51.02 | 13.70 | 1.769 | 47.55 bis 54.48 |
| Saege | 32.60 | 15.25 | 1.969 | 28.74 bis 36.46 |
| Beobachtung | Erklärung |
|---|---|
barplot zeigt nicht die Summe, sondern den Mittelwert |
Das ist die häufigste Überraschung. Wer Summen will, aggregiert vorher und nimmt barplot mit estimator="sum" oder gleich achse.bar. |
| Und er zeichnet von sich aus ein Konfidenzintervall | errorbar=("ci", 95). Damit macht seaborn genau das richtig, was ein reines Balkendiagramm falsch macht, siehe Diagrammtyp wählen, Beispiel 5. |
| Das Intervall der Pressen überlappt keines der anderen | 47.55 bis 54.48 gegen höchstens 40.62. Der Unterschied ist damit anders als in jenem Beispiel tatsächlich belegt. |
Die Heatmap braucht vmin, vmax und eine divergierende Palette |
Sonst nutzt sie den Wertebereich der Daten aus und Null liegt nicht in der Mitte. Bei Korrelationen ist Null der Nullpunkt, siehe Farbe. |
annot=True schreibt die Zahlen hinein |
Eine Heatmap ohne Zahlen ist bei wenigen Zellen eine verschenkte Tabelle. |
Die Voreinstellung von heatmap ist eine Falle. Ohne vmin=-1, vmax=1 wird die Farbskala auf den beobachteten Bereich gestreckt: Eine Matrix mit Korrelationen zwischen 0.80 und 1.00 sieht dann aus, als reiche sie von “nichts” bis “alles”.
Bei Korrelationsmatrizen gehören deshalb immer dazu:
sns.heatmap(korr, vmin=-1, vmax=1, cmap="RdBu_r", annot=True, fmt=".2f")Interpretation und Ergebnissatz
Laufzeit und Verbrauch korrelieren mit 0.869.
barplotzeigt den Mittelwert je Gruppe samt 95-Prozent-Intervall: Die Pressen liegen mit 47.55 bis 54.48 ausserhalb aller anderen Intervalle, die höchstens bis 40.62 reichen.
Frage und Datenlage
Eine interaktive Grafik ersetzt rechnerisch eine bestimmte Zahl statischer Grafiken. Diese Zahl lässt sich ausrechnen und sie ist das Argument für oder gegen den Aufwand.
Rechnung
# Wie viele statische Grafiken bräuchte es, um dieselben Fragen zu beantworten?
auswahl = {"Maschinentyp (4 plus alle)": 5,
"Standort (2 plus beide)": 3,
"Kennzahl": 3,
"Zeitraum": 2}
print(auswahl){'Maschinentyp (4 plus alle)': 5, 'Standort (2 plus beide)': 3, 'Kennzahl': 3, 'Zeitraum': 2}
anzahl = 1
for wert in auswahl.values():
anzahl *= wert
print({"kombinationen": anzahl}){'kombinationen': 90}
# Und wie viele davon tatsaechlich gebraucht werden
for genutzt in (1, 3, 10):
print(f"genutzt {genutzt:2d} von {anzahl}: "
f"{100 * genutzt / anzahl:5.1f} Prozent der vorbereiteten Grafiken")genutzt 1 von 90: 1.1 Prozent der vorbereiteten Grafiken
genutzt 3 von 90: 3.3 Prozent der vorbereiteten Grafiken
genutzt 10 von 90: 11.1 Prozent der vorbereiteten Grafiken
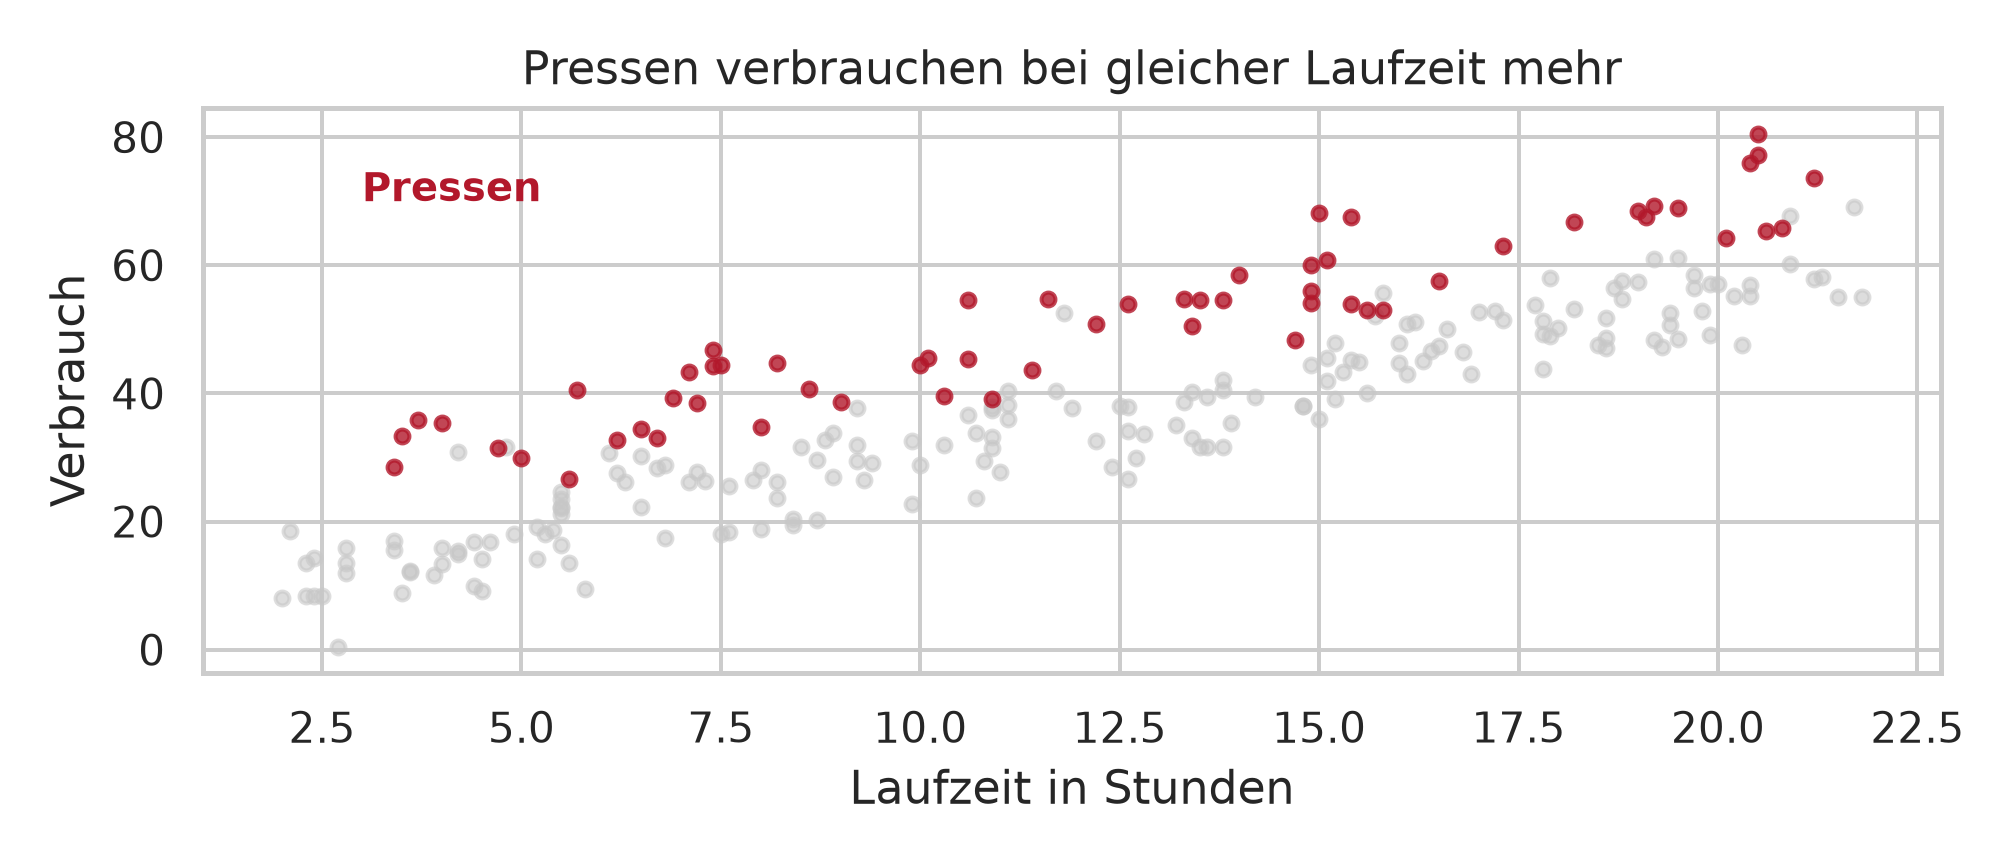
fig, achse = plt.subplots(figsize=(7, 3))
ist_presse = messung["typ"] == "Presse"
_ = achse.scatter(messung.loc[~ist_presse, "laufzeit"],
messung.loc[~ist_presse, "verbrauch"],
s=12, alpha=0.6, color="#c7c7c7")
_ = achse.scatter(messung.loc[ist_presse, "laufzeit"],
messung.loc[ist_presse, "verbrauch"],
s=12, alpha=0.8, color="#b2182b")
_ = achse.annotate("Pressen", xy=(3, 70), color="#b2182b", fontsize=10,
fontweight="bold")
_ = achse.set_title("Pressen verbrauchen bei gleicher Laufzeit mehr")
_ = achse.set_xlabel("Laufzeit in Stunden")
_ = achse.set_ylabel("Verbrauch")
plt.tight_layout()
plt.show()import plotly.express as px
abb = px.scatter(messung, x="laufzeit", y="verbrauch", color="typ",
facet_col="standort",
hover_data=["typ", "standort"],
labels={"laufzeit": "Laufzeit in Stunden",
"verbrauch": "Verbrauch"},
title="Verbrauch nach Laufzeit")
abb.update_layout(template="simple_white")
abb.show()
# Als eigenständige HTML-Datei, etwa für den Versand
abb.write_html("verbrauch.html", include_plotlyjs="cdn")include_plotlyjs="cdn" hält die Datei klein, verlangt dafür aber eine Internetverbindung beim Öffnen. Mit include_plotlyjs=True wird die Bibliothek eingebettet: rund 3 Megabyte, dafür offline lesbar.
Output Zeile für Zeile
| Auswahlmöglichkeit | Stufen |
|---|---|
| Maschinentyp (4 plus “alle”) | 5 |
| Standort (2 plus “beide”) | 3 |
| Kennzahl | 3 |
| Zeitraum | 2 |
| Kombinationen insgesamt | 90 |
| tatsächlich angesehen | Anteil der vorbereiteten Grafiken |
|---|---|
| 1 von 90 | 1.1 Prozent |
| 3 von 90 | 3.3 Prozent |
| 10 von 90 | 11.1 Prozent |
| Beobachtung | Erklärung |
|---|---|
| Vier Auswahlfelder ergeben 90 mögliche Ansichten | Und das ist ein bescheidenes Dashboard. Statisch vorzubereiten ist das nicht. |
| Wer eine feste Aussage hat, braucht eine | Dann sind 89 der 90 Ansichten Ballast, und die interaktive Fassung verschiebt nur Arbeit zum Publikum. |
| Die Rechnung ist das Entscheidungskriterium | Interaktiv lohnt sich, wenn die Zahl der sinnvollen Fragen gross und die Auswahl vorab unbekannt ist. Ist beides nicht der Fall, ist die statische Grafik besser. |
| Die statische Fassung trifft eine Entscheidung | Pressen rot, alles andere grau, Aussage im Titel. Sie beantwortet eine Frage vollständig statt neunzig halb. |
| Für Papier und PDF gibt es keine Alternative | Eine interaktive Grafik wird dort zum Standbild und zwar zu dem, das gerade eingestellt war. |
Die Entscheidungshilfe in vier Zeilen:
| Lage | Wahl |
|---|---|
| Aussage steht fest, Publikum liest | statisch |
| Publikum stellt eigene Fragen | interaktiv |
| Ausgabe ist Papier oder PDF | statisch |
| eigenes Erkunden während der Analyse | interaktiv, oder gleich im Notebook |
Mehr zur Abwägung unter Dashboards und Interaktivität.
Interpretation und Ergebnissatz
Vier Auswahlfelder mit 5, 3, 3 und 2 Stufen ergeben 90 mögliche Ansichten. Wer eine feste Aussage hat, braucht davon eine, 1.1 Prozent. Interaktivität lohnt sich, wenn die Auswahl vorab unbekannt ist, und sonst nicht.
Verständnisfragen
Ein seaborn-Aufruf mit relplot soll in eine vorbereitete Achse gezeichnet werden, aber ax= wird nicht akzeptiert. Warum?
relplot arbeitet auf Rasterebene und erzeugt eine eigene Figur
scatterplot oder lineplot.
ax, existiert aber nur auf Achsenebene.
sns.barplot(data=df, x="typ", y="verbrauch"), was zeigen die Balken?
estimator="sum" oder aggregiert vorher.
countplot zuständig.
Warum braucht sns.heatmap bei einer Korrelationsmatrix vmin=-1, vmax=1?
annot=True nicht
seaborn verlangt das lange Format. Woran erkennt man, dass Daten breit sind?
melt beziehungsweise pivot_longer führt dorthin.
Ein Dashboard hat vier Auswahlfelder mit 5, 3, 3 und 2 Stufen. Wie viele Ansichten sind das?
Derselbe Boxplot mit Einzelwerten kostet in seaborn 4 und von Hand 11 Codezeilen. Was folgt daraus?
Verlinkte Ressourcen
- seaborn: Übersicht der Funktionen
- seaborn: Overview of plotting functions
- plotly express: Einstieg
- matplotlib, worauf seaborn aufsetzt
- Dashboards und Interaktivität, wann sich der Aufwand lohnt
- Tidy Data, das lange Format