Typische Fragestellungen: Prognose einer Absatzreihe mit Trend und Saison, Modellierung der Abhängigkeitsstruktur, Vergleich verschiedener Modellordnungen über Informationskriterien.
ARIMA-Modelle beschreiben eine Reihe durch drei Bausteine: die eigene Vergangenheit (AR), die Vergangenheit der Fehler (MA) und die Anzahl nötiger Differenzen (I). SARIMA ergänzt dieselben Bausteine für die saisonale Ebene. Der Vorteil gegenüber der Glättung ist die explizite Modellierung der Abhängigkeit und die saubere Herleitung der Prognoseintervalle; der Preis ist die Wahl der Ordnung.
Ordnung des autoregressiven Teils: wie viele frühere Werte
\(d\)
Anzahl Differenzen, um Stationarität zu erreichen
\(q\)
Ordnung des Fehlerteils: wie viele frühere Fehler
\(\phi_i\)
Gewichte der früheren Werte
\(\theta_j\)
Gewichte der früheren Fehler
\(\varepsilon_t\)
Rauschen, unabhängig und mit konstanter Streuung
SARIMA ergänzt \((P, D, Q)_s\) für die saisonale Ebene, wobei \(s\) die Periode ist, also 12 bei Monatsdaten. Ein SARIMA(1,1,1)(0,1,1)\(_{12}\) differenziert also einmal gewöhnlich und einmal saisonal.
Die Ordnung liest man aus den Korrelogrammen der stationär gemachten Reihe, siehe Stationarität, ACF und PACF:
Muster
Deutung
PACF bricht nach \(p\) Abständen ab, ACF fällt langsam
AR(\(p\))
ACF bricht nach \(q\) Abständen ab, PACF fällt langsam
MA(\(q\))
beide fallen langsam
gemischtes Modell, Ordnung über Informationskriterien wählen
Spitzen bei Vielfachen der Periode
saisonale Anteile nötig
Voraussetzungen und ihre Prüfung
Voraussetzung
Was sie bedeutet
Prüfung
Folge bei Verletzung
Vorgehen
Stationarität nach Differenzieren
Niveau und Streuung konstant
ACF, ADF- und KPSS-Test
Koeffizienten nicht interpretierbar, Prognose driftet
differenzieren, logarithmieren
Konstante Streuung
Die Schwankungsbreite wächst nicht
Grafik
Prognoseintervalle falsch
logarithmieren, Box-Cox
Residuen ohne Autokorrelation
Das Modell hat alle Struktur erfasst
ACF der Residuen, Ljung-Box
Intervalle zu schmal, Prognose systematisch daneben
Ordnung erhöhen, saisonale Anteile prüfen
Genügend Beobachtungen
Faustregel: mindestens 50, für Saison vier Perioden
Länge prüfen
Ordnung nicht schätzbar, Überanpassung
einfachere Modelle
Kein Strukturbruch
Ein Modell für die ganze Reihe
Grafik
Modell mittelt über zwei Regime
Reihe teilen
Sparsame Ordnung
Nicht mehr Parameter als nötig
Informationskriterien, Testfehler
Überanpassung, schlechte Prognose
Ordnung reduzieren
Output lesen
R, summary(Arima(...)):
Grösse
Was sie sagt
Faustregel oder Falle
ARIMA(1,1,1)(0,1,1)[12]
gewählte Ordnung, gewöhnlich und saisonal
die Zahl in Klammern ist die Periode
ar1, ma1
Koeffizienten der gewöhnlichen Anteile
Betrag unter eins nötig für Stationarität
sma1
saisonaler MA-Koeffizient
oft nahe minus eins bei saisonal differenzierten Reihen
s.e.
Standardfehler je Koeffizient
Koeffizient geteilt durch Standardfehler über 2 heisst bedeutsam
sigma^2
Streuung der Residuen
Grundlage der Prognoseintervalle
log likelihood
Anpassungsmass
nur zwischen Modellen auf identischen Daten vergleichbar
AIC, AICc, BIC
Informationskriterien
kleiner ist besser; AICc bei kurzen Reihen bevorzugen
Training set error measures
RMSE, MAE, MAPE auf den Trainingsdaten
nicht zur Beurteilung der Prognose geeignet
ACF1
Autokorrelation der Residuen im ersten Abstand
nahe null erwartet
Python, SARIMAX.summary():
Grösse
Was sie sagt
Unterschied zu R
coef, std err, z, P>|z|
Koeffizienten mit Test
R nennt keine p-Werte, nur Standardfehler
sigma2
Residuenstreuung
wie sigma^2
Log Likelihood, AIC, BIC
Anpassung
AICc fehlt
Ljung-Box (L1) (Q)
Test auf Autokorrelation im ersten Abstand
in R über checkresiduals()
Jarque-Bera (JB)
Test auf Normalität der Residuen
in R im Diagnoseplot
Heteroskedasticity (H)
Test auf konstante Streuung
in R nicht enthalten
Warnungen zu Konvergenz
Optimierung nicht konvergiert
ernst nehmen, Ordnung vereinfachen
Zwei Unterschiede in der Handhabung: In Python steht die Periode als vierter Wert in seasonal_order, in R getrennt über frequency der Reihe. Und SARIMAX schätzt standardmässig kein konstantes Glied, wenn differenziert wird, während R mit include.drift steuerbar ist; bei Reihen mit Trend nach einer Differenz ist das ein häufiger Grund für abweichende Prognosen.
Beispiele
Alle Beispiele arbeiten mit derselben konstruierten Absatzreihe: 96 Monate ab Januar 2018 mit linearem Trend, Jahressaison und einem autokorrelierten Fehler (AR(1) mit Koeffizient 0.6). Die letzten zwölf Monate bleiben als Testteil ungesehen; geschätzt wird auf den ersten 84.
Vor jedem ARIMA-Modell stehen zwei Entscheidungen: wie oft differenziert wird (\(d\) und \(D\)) und welche Ordnungen (\(p\), \(q\), \(P\), \(Q\)) daraus folgen. Beide werden aus den Korrelogrammen der stationär gemachten Reihe gelesen.
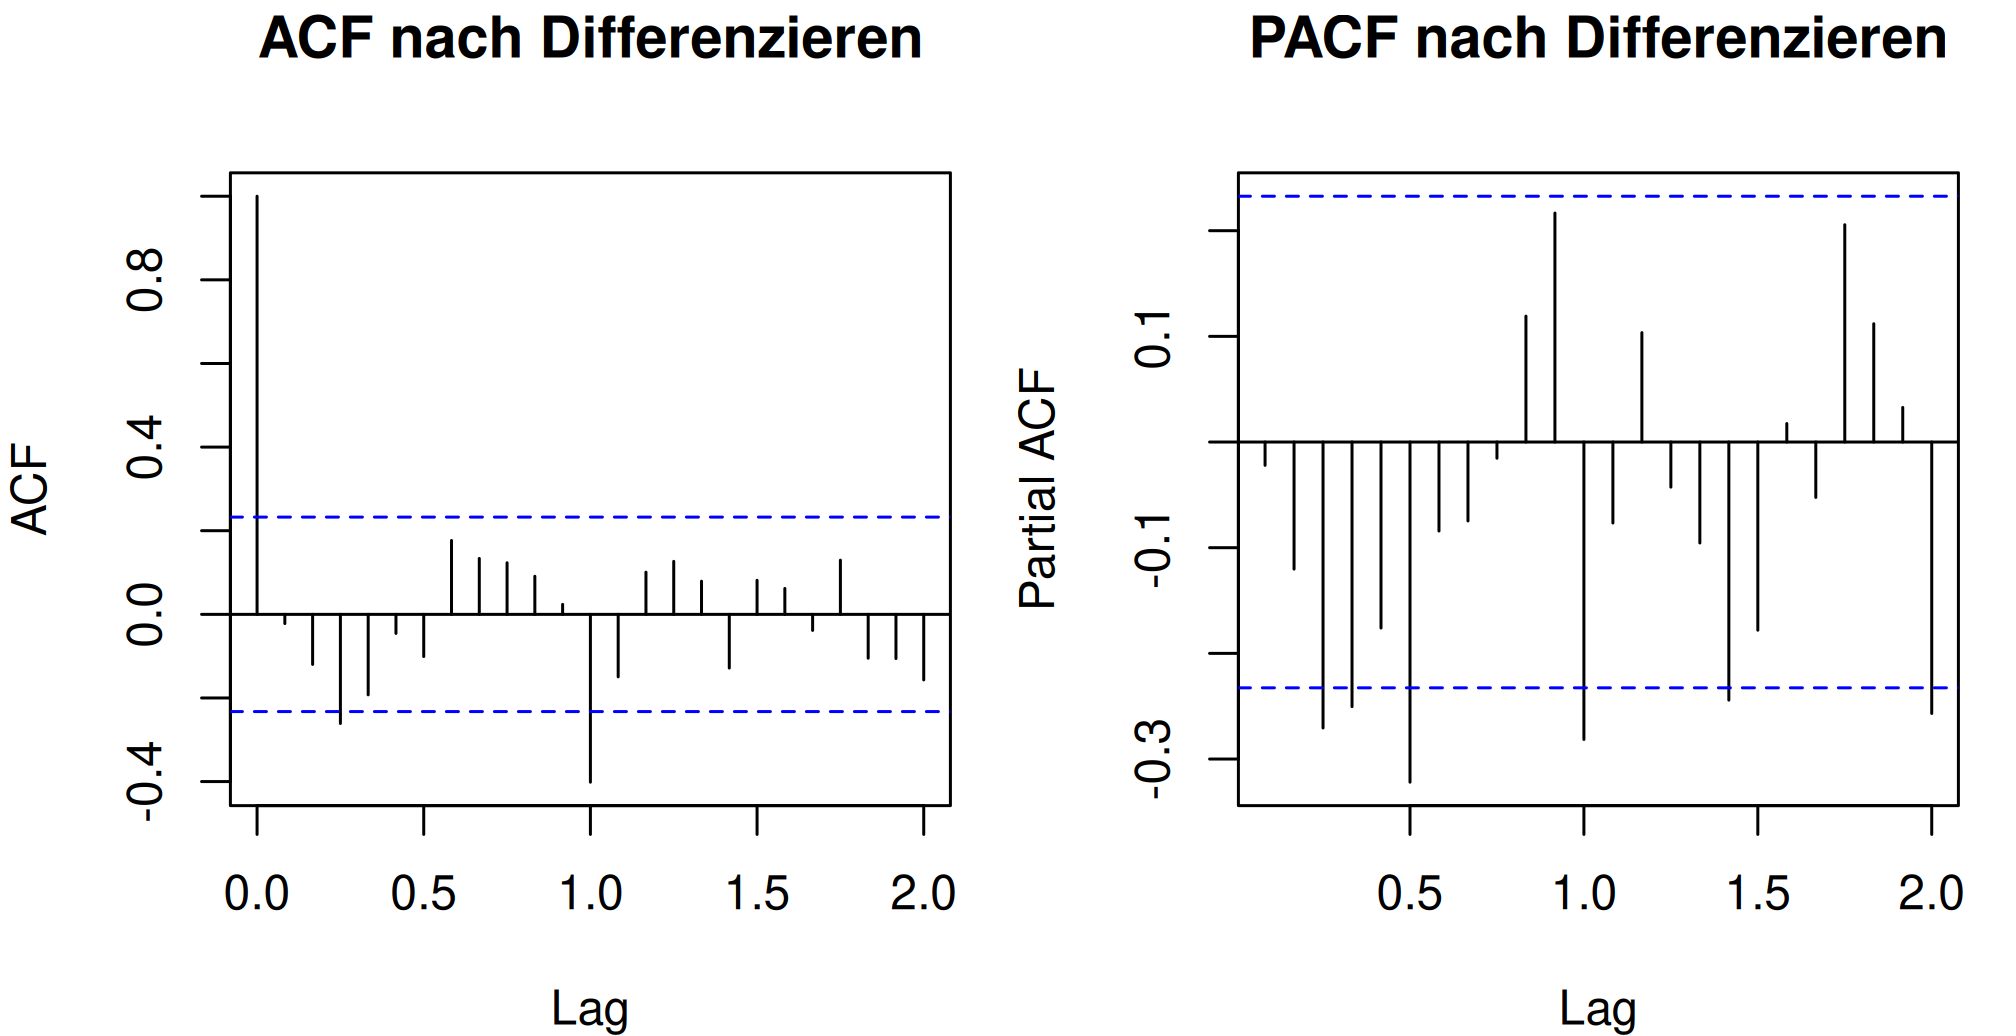
stationaer <-diff(diff(training, lag =12))par(mfrow =c(1, 2), mar =c(4, 4, 3, 1))acf(stationaer, lag.max =24, main ="ACF nach Differenzieren")pacf(stationaer, lag.max =24, main ="PACF nach Differenzieren")par(mfrow =c(1, 1))round(c(n =length(stationaer),grenze =1.96/sqrt(length(stationaer)),sd_roh =sd(training),sd_stationaer =sd(stationaer)), 3)
            n        grenze        sd_roh sd_stationaer
       71.000         0.233       105.072        25.937
Abbildung 1: Beispiel 1: ACF und PACF nach gewöhnlichem und saisonalem Differenzieren.
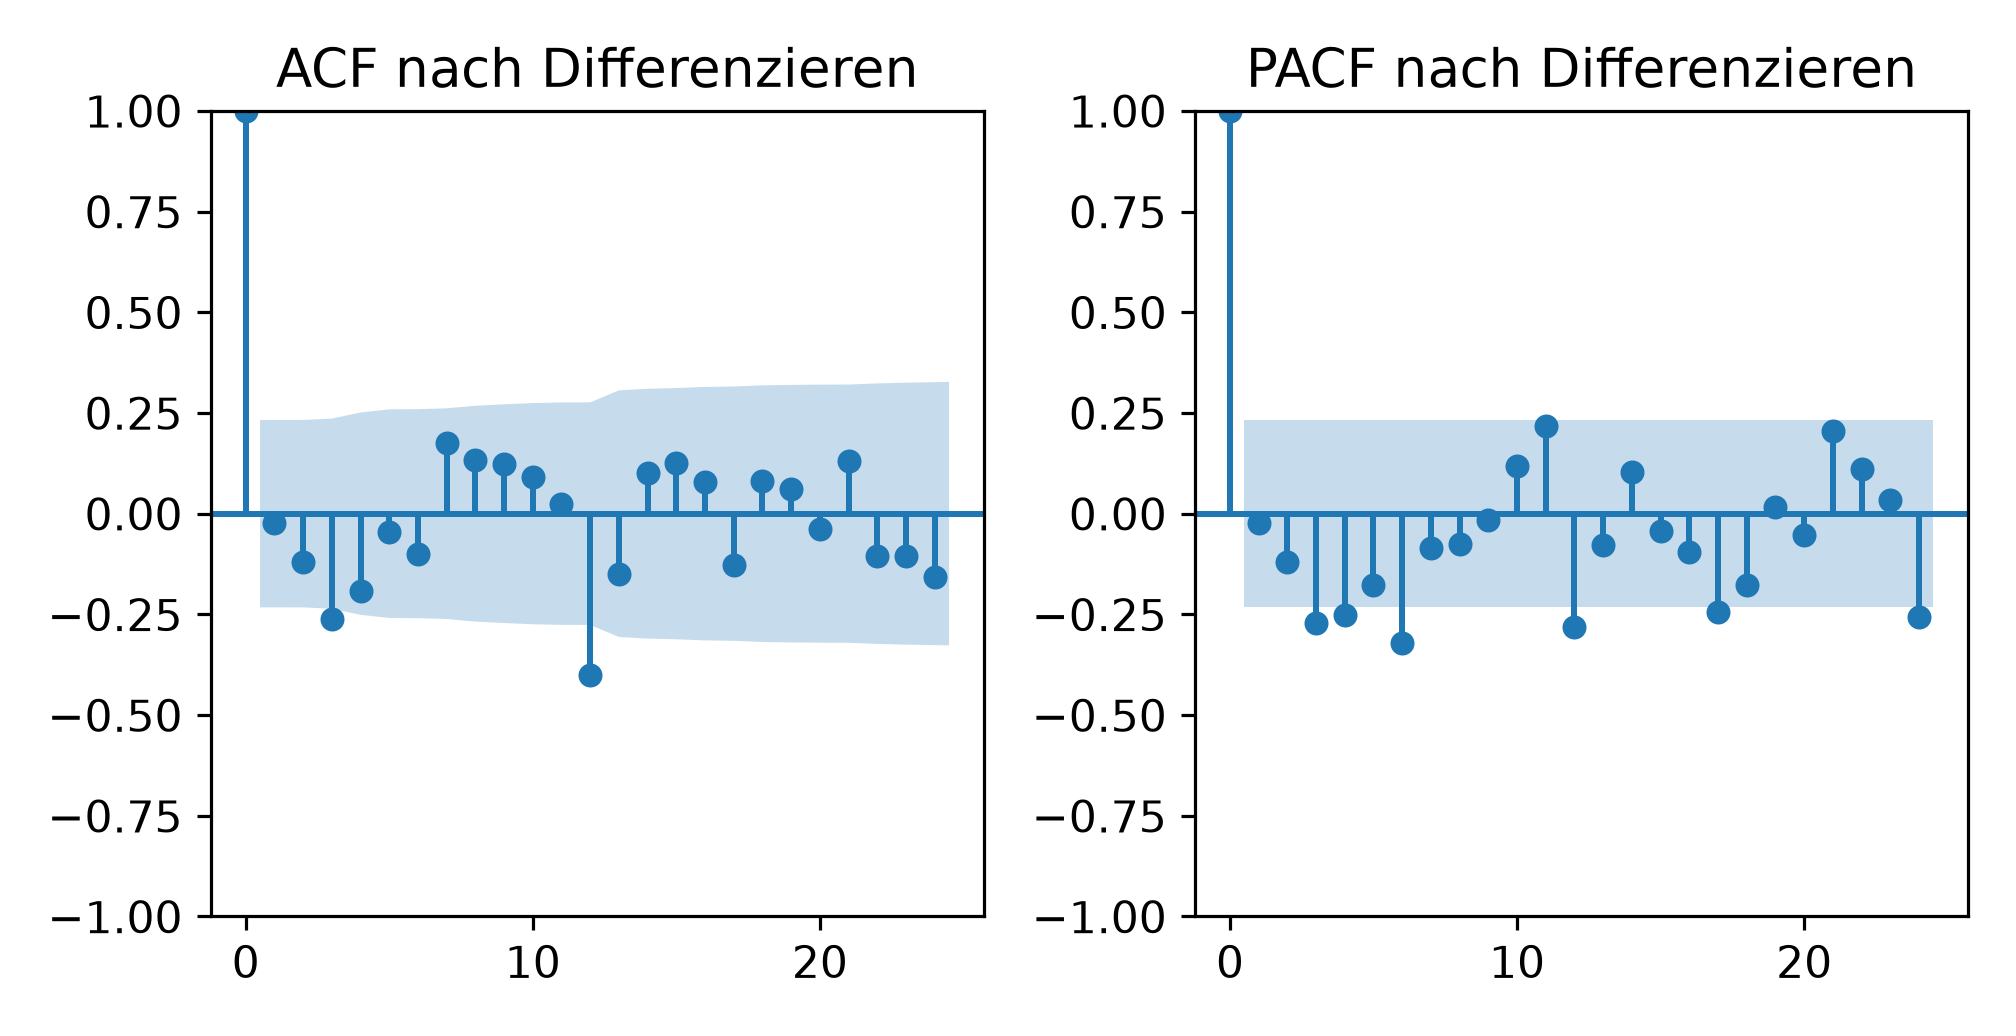
from statsmodels.graphics.tsaplots import plot_acf, plot_pacffrom statsmodels.tsa.stattools import adfuller, acf, pacfstationaer = training.diff(12).diff().dropna()fig, achsen = plt.subplots(1, 2, figsize=(7, 3.6))plot_acf(stationaer, ax=achsen[0], lags=24, title="ACF nach Differenzieren")plot_pacf(stationaer, ax=achsen[1], lags=24, title="PACF nach Differenzieren", method="ywm")plt.tight_layout()plt.show()
Abbildung 2: Beispiel 1: dieselben Korrelogramme in Python.
print("ADF p nach Differenzieren:", round(adfuller(stationaer)[1], 4))
Nach einer gewöhnlichen und einer saisonalen Differenz bleiben 71 Werte übrig; die Konfidenzgrenze liegt bei ±0.233. Der ADF-Test bestätigt Stationarität (p = 0.009).
Abstand
1
2
3
4
5
6
11
12
13
ACF
-0.022
-0.120
-0.261
-0.193
-0.046
-0.101
0.024
-0.401
-0.149
PACF
-0.022
-0.120
-0.271
-0.250
-0.176
-0.322
0.217
-0.281
-0.077
Ausgabe
Wie sie zu lesen ist
ACF bei 12: -0.401
Der grösste Einzelwert und weit ausserhalb der Grenze. Ein negativer Wert genau bei der Periode ist die Signatur des saisonalen Differenzierens: Es erzeugt eine saisonale MA-Struktur. Daraus folgt \(Q = 1\).
Keine weitere Spitze bei 24
Ein saisonaler MA-Term reicht; \(Q = 2\) wäre nicht begründet.
Auf der kurzen Skala ist das Bild unklar
ACF und PACF haben beide einen Ausschlag bei 3 und danach kleinere Werte, ohne dass eine der beiden sauber abbricht. Genau der Fall aus der Theorie: beide fallen allmählich ab, also gemischtes Modell, die Ordnung ist nicht ablesbar.
Streuung vor und nach dem Differenzieren
sinkt deutlich
ndiffs und nsdiffs in R
schlagen \(d\) und \(D\) vor
Was die Korrelogramme hier leisten und was nicht. Sie liefern eindeutig \(D = 1\) und \(Q = 1\), die saisonale Ebene ist klar. Für die gewöhnliche Ebene geben sie nur die Auskunft “es ist etwas da, aber weder reines AR noch reines MA”. Die Wahl zwischen (1,1,1), (0,1,1), (1,1,0) und (2,1,2) fällt deshalb in Beispiel 2 über Informationskriterien und den Testfehler, nicht über das Bild.
Das ist der Normalfall. Lehrbuchbeispiele mit klar abbrechender PACF sind konstruiert; echte Reihen sehen aus wie diese.
Interpretation und Ergebnissatz
Die Reihe wird einmal gewöhnlich und einmal saisonal differenziert; danach ist sie stationär (ADF p = 0.009). Die ACF zeigt bei Abstand 12 einen deutlich negativen Wert (-0.40), was für einen saisonalen MA-Term spricht (\(Q = 1\)). Auf der kurzen Zeitskala brechen weder ACF noch PACF ab; die gewöhnliche Ordnung wird über Informationskriterien gewählt.
Frage und Datenlage
Vier Kandidaten für die gewöhnliche Ordnung, alle mit derselben saisonalen Struktur \((0,1,1)_{12}\). Welcher gewinnt, und woran misst man das?
R nimmt (1,1,1), Python (2,1,2). Das ist der wichtigste Befund dieses Beispiels und kein Widerspruch, sondern die Folge davon, dass Arima() und SARIMAX verschieden rechnen.
Die Zahlenniveaus liegen 130 Punkte auseinander
Die beiden Funktionen behandeln die Startwerte der differenzierten Reihe verschieden; R bezieht die Likelihood auf die volle Reihe, Python auf die differenzierte. Verglichen wird deshalb innerhalb einer Umgebung, nie über die Tabs hinweg.
Warum Python (2,1,2) bevorzugt
Weil hier enforce_stationarity und enforce_invertibility abgeschaltet sind, darf das grösste Modell an den Rand des Parameterraums laufen und holt sich dort ein besseres Kriterium. R lässt das nicht zu.
Die log-Likelihood steigt immer mit mehr Parametern
Das ist keine Information, sondern eine Selbstverständlichkeit; deshalb braucht es überhaupt Kriterien.
AIC und BIC bestrafen Parameter verschieden
AIC mit 2 je Parameter, BIC mit \(\ln n\), hier also 4.4. AICc korrigiert AIC zusätzlich für kleine Stichproben und ist bei \(n = 84\) die bessere Wahl.
Unterschiede unter etwa zwei gelten als unbedeutend
In der R-Spalte liegen (0,1,1) und (1,1,0) mit 637.62 und 637.82 gleichauf; zwischen ihnen entscheidet das Kriterium nichts.
Zwei Regeln zu Informationskriterien, die oft verletzt werden:
Sie sind nur zwischen Modellen auf identischen Daten vergleichbar. Wer \(d\) oder \(D\) ändert, ändert die Daten, auf die das Modell passt, die Werte sind dann nicht mehr vergleichbar. Nur \(p\), \(q\), \(P\) und \(Q\) dürfen variieren.
Ein kleines Kriterium ist keine gute Prognose. Es misst die Anpassung an die Trainingsdaten, bestraft um die Parameterzahl. Bewertet wird auf dem Testteil.
Die automatische Suche in R landet meist nicht bei der von Hand gewählten Ordnung, sondern bei einer Variante mit Drift und saisonalen AR-Termen. Beide beschreiben dieselbe Struktur, Trend plus Jahressaison, nur über verschiedene Bauteile. Das ist der Normalfall und kein Widerspruch.
Interpretation
Das Kriterium liefert eine Vorauswahl, keine Entscheidung. Die Entscheidung fällt über Residuendiagnostik (Beispiel 4) und Testfehler (Beispiel 3).
Frage und Datenlage
Das Modell SARIMA(1,1,1)(0,1,1)\(_{12}\) wird geschätzt und seine Ausgabe Zeile für Zeile gelesen. Dabei zeigt sich ein Problem, das die Informationskriterien nicht anzeigen.
modell <-Arima(training, order =c(1, 1, 1), seasonal =c(0, 1, 1))summary(modell)
Series: training
ARIMA(1,1,1)(0,1,1)[12]

Coefficients:
         ar1      ma1     sma1
      0.5535  -1.0000  -0.9999
s.e.  0.1008   0.0726   0.2714

sigma^2 = 249.6:  log likelihood = -309.16
AIC=626.33   AICc=626.93   BIC=635.38

Training set error measures:
                     ME     RMSE      MAE         MPE     MAPE      MASE
Training set -0.5614175 14.21601 10.23293 -0.07878486 1.517141 0.2157456
                   ACF1
Training set 0.09953009
# Zum Vergleich: ohne die gewoehnliche Differenz, dafuer mit Driftohne_d <-Arima(training, order =c(1, 0, 0), seasonal =c(0, 1, 1),include.drift =TRUE)round(coef(ohne_d), 4)
Trägheit auf der gewöhnlichen Ebene: Gut die Hälfte der Abweichung überträgt sich auf den Folgemonat. Schätzung geteilt durch Standardfehler ergibt 5.5 beziehungsweise 3.3, deutlich von null verschieden.
ma1 beziehungsweise ma.L1
-1.000 / -1.000
0.073 / 1393
Beide landen exakt auf -1. Hier stimmt etwas nicht.
sma1 beziehungsweise ma.S.L12
-1.000 / -1.000
0.271 / 3098
Ebenfalls am Rand, hier aber der Normalfall.
sigma^2
249.6 / 247.8
Streuung der Residuen, Grundlage der Prognoseintervalle.
Befund
Erklärung
Der MA-Koeffizient liegt exakt bei -1.000
Auf dem Rand des zulässigen Bereichs; Invertierbarkeit verlangt einen Betrag unter eins. Dass beide Umgebungen dort landen, ist der eigentliche Befund.
Die Standardfehler unterscheiden sich um vier Grössenordnungen
R erzwingt Invertierbarkeit und meldet einen unauffälligen Wert von 0.073; Python hat die Schranke hier abgeschaltet, läuft frei in den Rand und meldet 1393, also “an dieser Stelle ist die Likelihood flach, der Wert ist unbestimmt”. Die ehrlichere Ausgabe ist die von Python, weil sie das Problem sichtbar macht statt es wegzuklemmen.
Was das inhaltlich bedeutet
Ein MA(1)-Koeffizient von -1 hebt eine Differenz genau wieder auf. Das Modell sagt also: die gewöhnliche Differenz war unnötig. Und das stimmt, die Reihe wurde mit einem deterministischen Trend erzeugt, der nicht wegdifferenziert gehört, siehe Stationarität, Beispiel 3.
ma.S.L12 = -1.000 ist dagegen unauffällig
Bei saisonal differenzierten Reihen ist ein saisonaler MA-Koeffizient nahe -1 der Regelfall und kein Warnzeichen.
Die Alternative ohne gewöhnliche Differenz
(1,0,0)(0,1,1) mit Drift kommt ohne Randwert aus. In R lautet der Drift 3.96 je Monat (nahe an den eingebauten 4), in Python nennt trend="c" stattdessen ein Absolutglied.
Warum die Informationskriterien das nicht zeigen: Ein Modell, das eine überflüssige Differenz durch einen MA-Term von -1 wieder aufhebt, passt genauso gut wie das Modell ohne beides. Die Likelihood ist gleich, die Parameterzahl um eins höher, der AIC-Nachteil beträgt magere zwei Punkte und verschwindet im Vergleich mit anderen Ordnungen.
Woran man es erkennt, ist deshalb immer der Blick auf die Koeffizienten:
Zeichen
Bedeutung
MA-Koeffizient nahe -1 auf der gewöhnlichen Ebene
\(d\) ist um eins zu hoch
AR-Koeffizient nahe +1
\(d\) ist um eins zu niedrig; die Reihe ist noch nicht stationär
Standardfehler um Grössenordnungen zu gross
die Likelihood ist flach, das Modell überparametrisiert
Interpretation und Ergebnissatz
Das Modell SARIMA(1,1,1)(0,1,1)\(_{12}\) schätzt einen AR-Koeffizienten von 0.55 (SE 0.10); der gewöhnliche MA-Koeffizient läuft mit -1.00 auf den Rand des Parameterraums, was auf eine überflüssige gewöhnliche Differenz hinweist. Eine Variante ohne diese Differenz und mit Drift schätzt dieselbe Trägheit ohne Randwert und einen Drift von 3.96 je Monat.
Frage und Datenlage
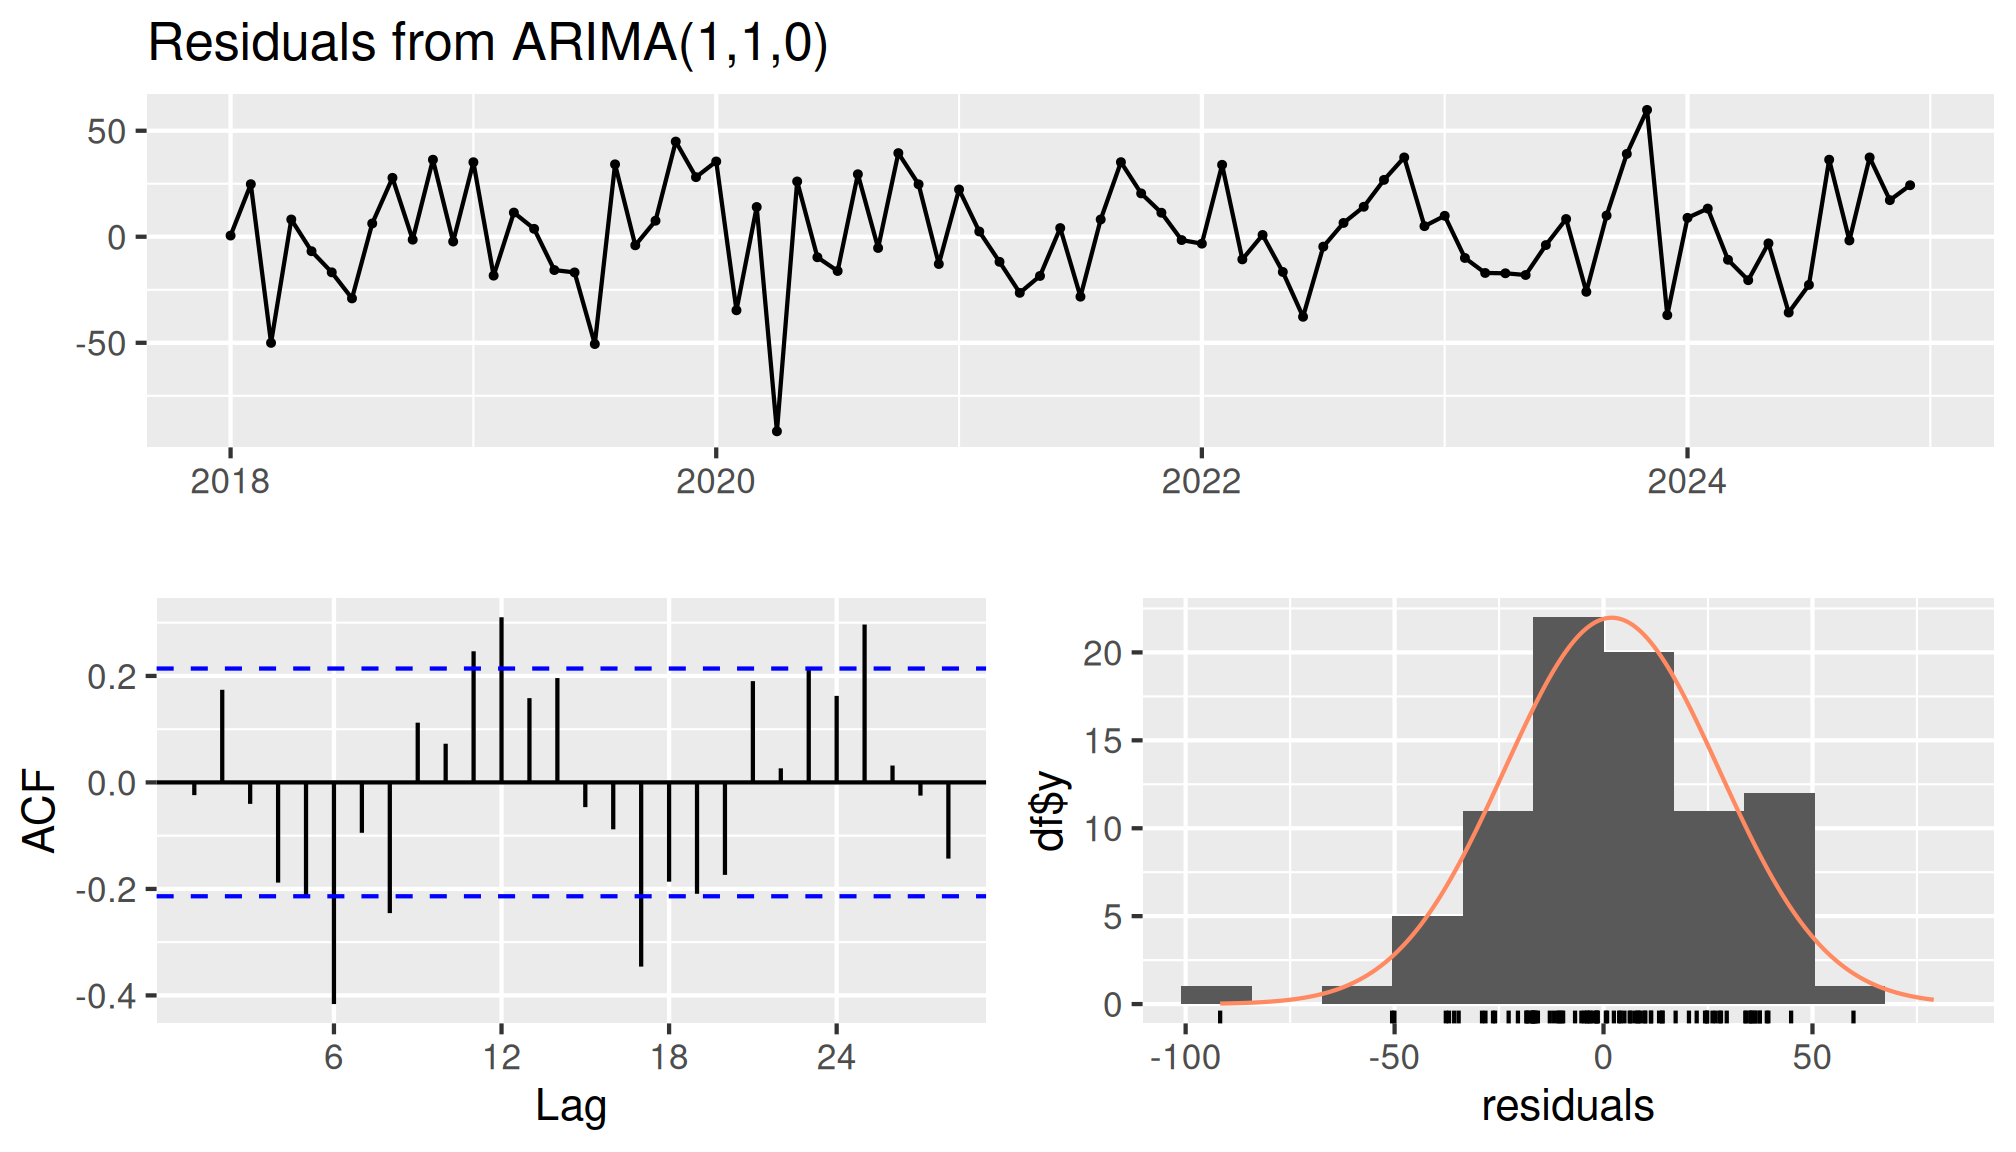
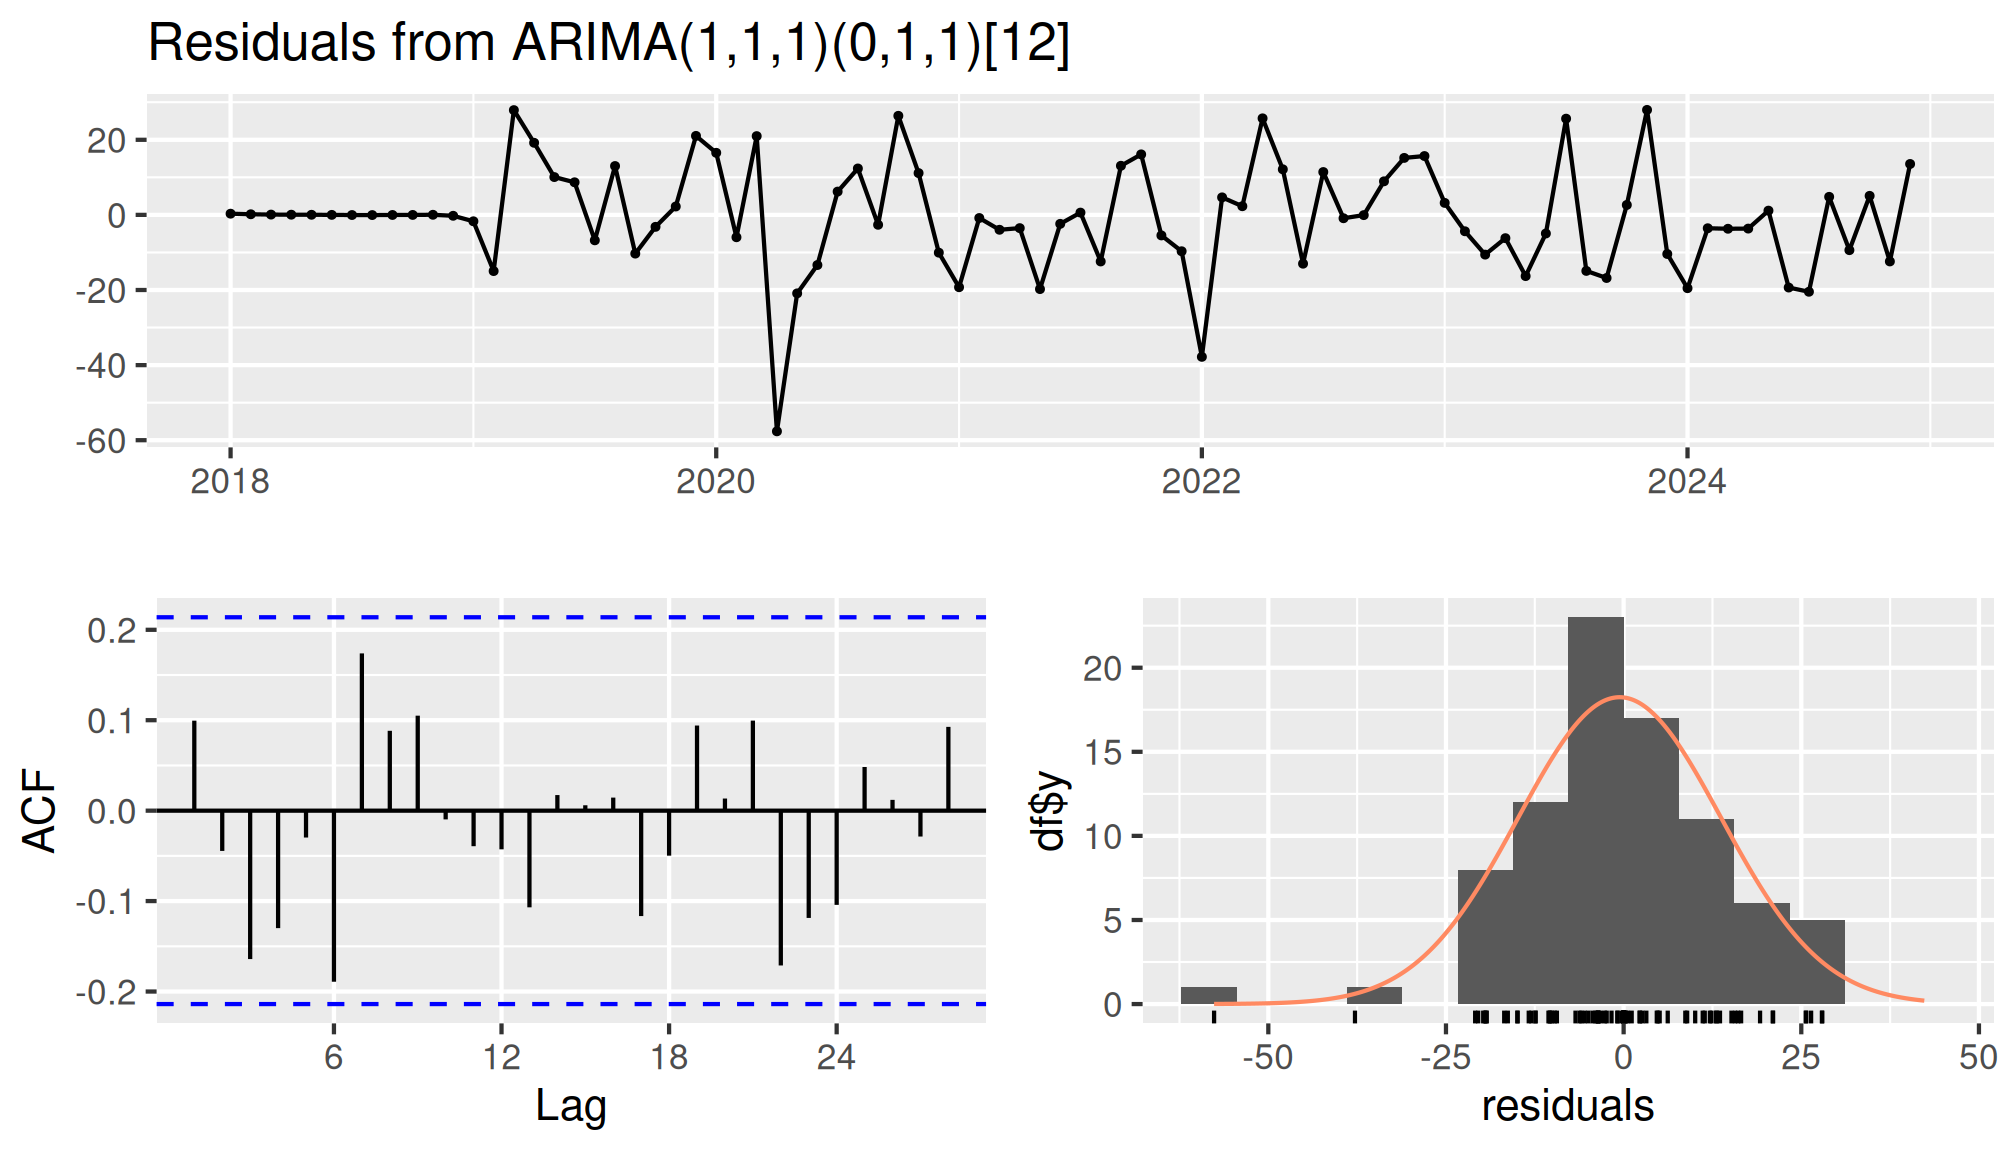
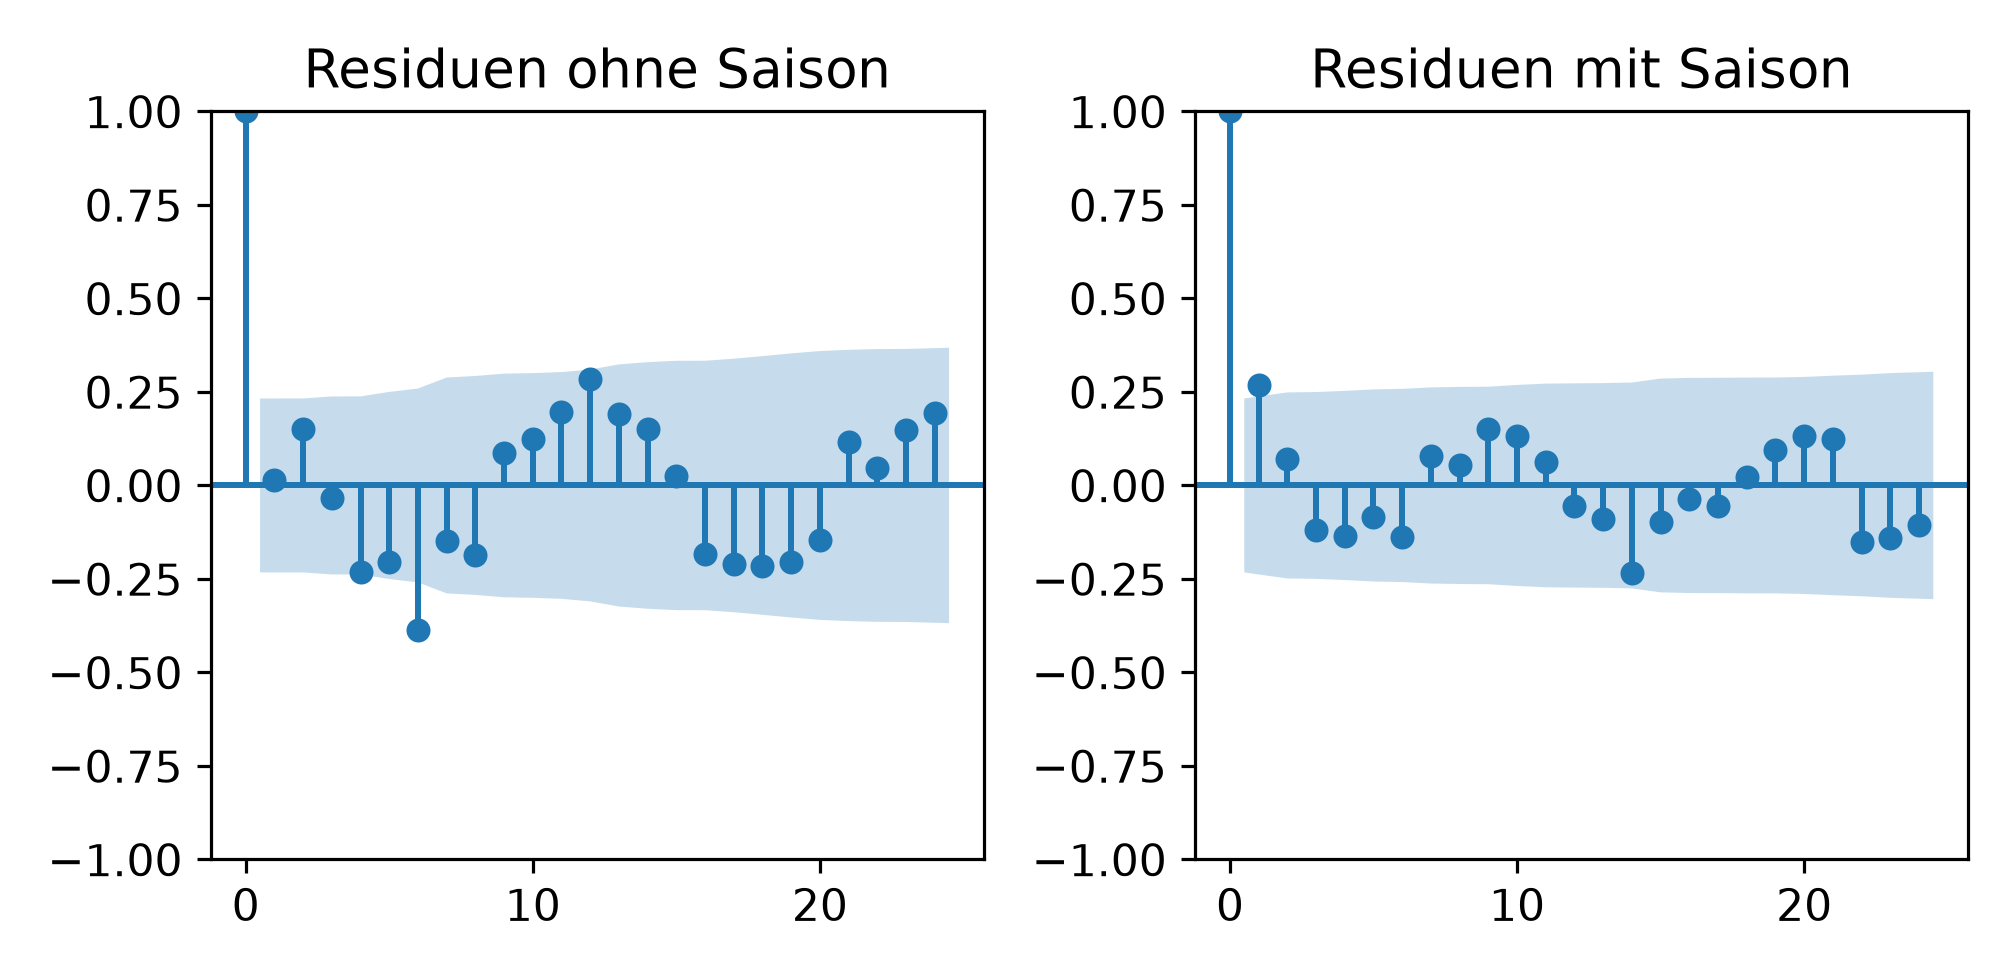
Der entscheidende Prüfschritt. Ein Modell ohne saisonale Anteile passt scheinbar, lässt aber Struktur in den Residuen zurück. Verglichen werden ARIMA(1,1,0) ohne Saison und das vollständige Modell.
ohne Saison  Ljung-Box p: [0.0001, 0.0] | ACF(12) = +0.284 | ACF(24) = +0.193
mit Saison   Ljung-Box p: [0.2401, 0.1234] | ACF(12) = -0.054 | ACF(24) = -0.106
Output Zeile für Zeile
Modell
Ljung-Box p (12)
Ljung-Box p (24)
ACF(12)
ACF(24)
ohne Saison
0.0001
< 0.0001
+0.284
+0.193
mit Saison
0.240
0.123
-0.054
-0.106
(Python-Werte. checkresiduals() in R wählt die Anzahl Abstände selbst, für das Modell ohne Saison 17 statt 12 und kommt auf \(Q^* = 70.8\) mit p = 7·10⁻⁹, also zum selben Schluss.)
Befund
Erklärung
ACF(12) = +0.284 ohne Saison
Die Residuen von vor zwölf Monaten sagen etwas über die heutigen, genau die Saisonstruktur, die das Modell nicht kennt. Bei 24 noch +0.193.
Ljung-Box p = 0.0001
Der Test verwirft die Annahme unkorrelierter Residuen deutlich. Er prüft alle Abstände bis 12 gemeinsam.
Mit Saison: ACF(12) = -0.054, p = 0.24
Innerhalb der Konfidenzgrenzen, der Test unauffällig. Die Struktur ist erfasst.
Die Punktprognosen sind dabei nicht das Hauptproblem
Verzerrt sind vor allem die Intervalle: Das Modell behandelt verbleibende Struktur als Rauschen und schätzt die Unsicherheit falsch ein.
Die Diagnose ist zugleich das Rezept:
Wo die Spitze liegt
Was fehlt
bei Vielfachen der Periode (12, 24)
saisonale Anteile, \(P\), \(Q\) oder \(D\)
beim ersten Abstand
ein gewöhnlicher AR- oder MA-Term
langsam abfallend über viele Abstände
eine Differenz
überall verstreut, einzelne knapp draussen
nichts; bei 24 Abständen ist ein Ausreisser zufällig zu erwarten
Und immer beides prüfen: ACF und Test, nicht eines allein. Der Test fasst zusammen und sagt nicht, wo das Problem sitzt; die Grafik sagt es, hat aber keine Schwelle.
Interpretation und Ergebnissatz
Ohne saisonale Anteile bleiben die Residuen deutlich autokorreliert (Ljung-Box p < .001, ACF bei Abstand 12 gleich +0.28). Das vollständige Modell besteht die Prüfung (p = 0.24, ACF(12) = -0.05); berichtet wird dieses.
Frage und Datenlage
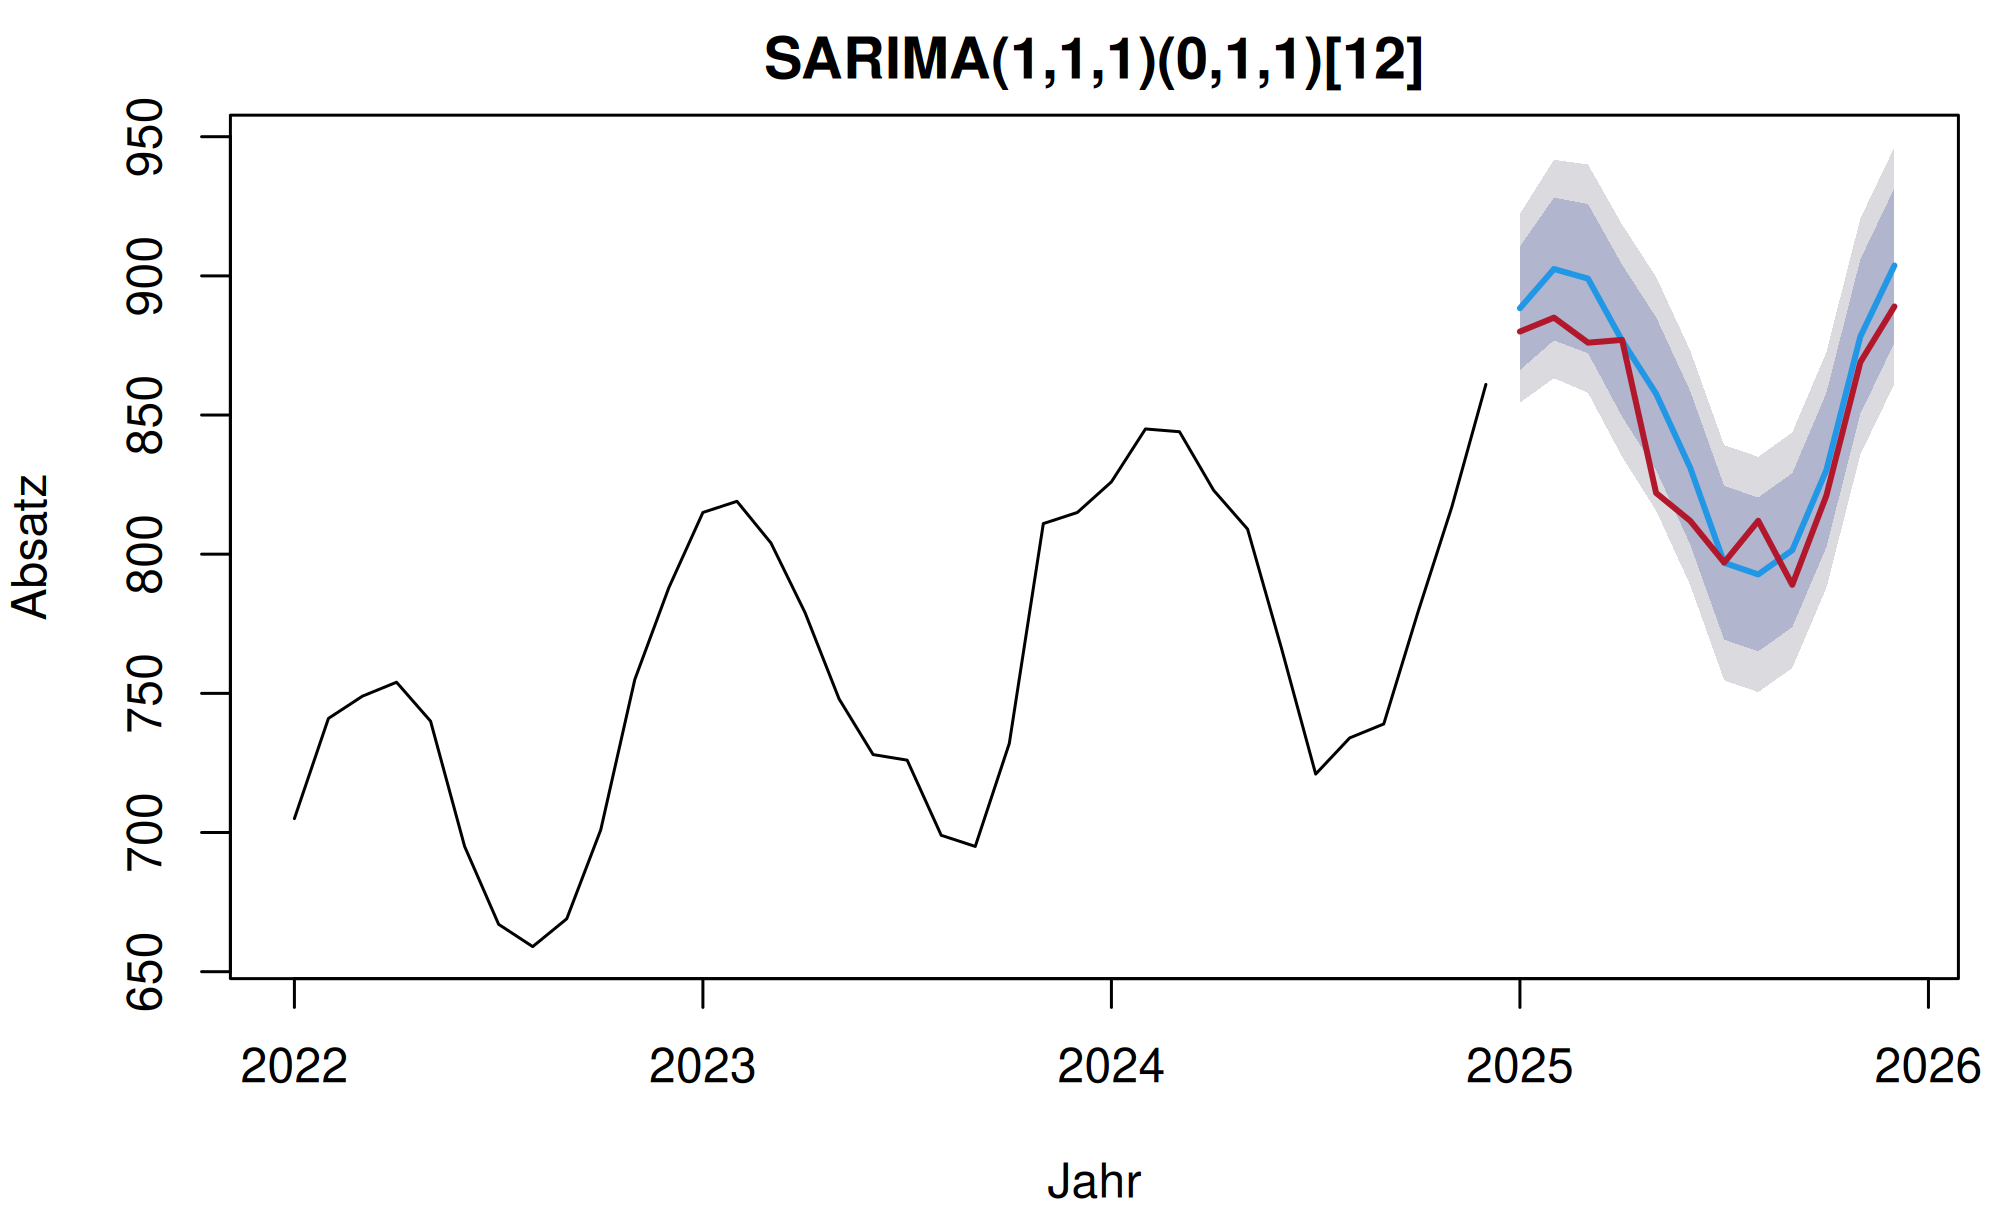
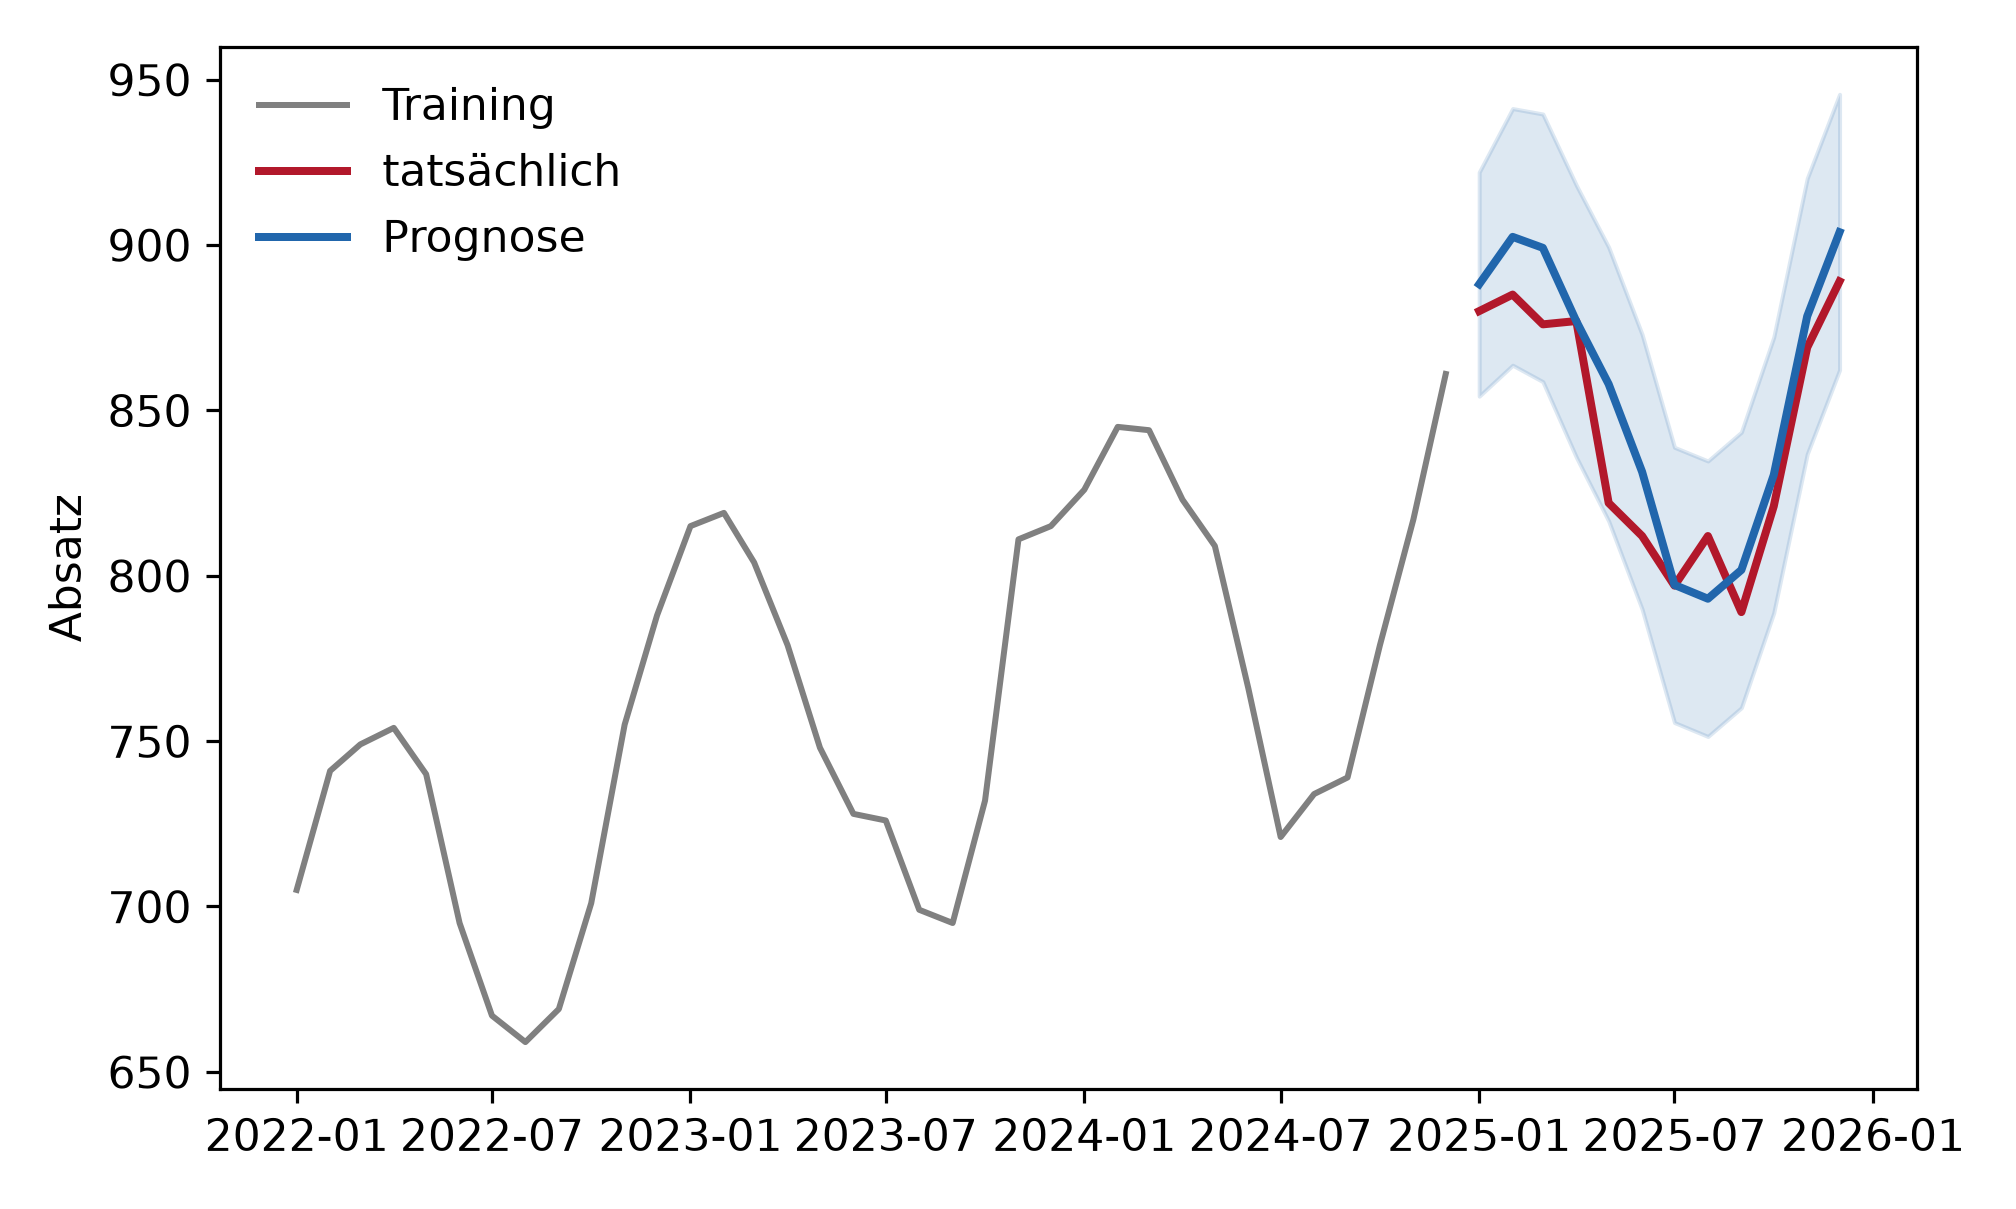
Zwölf Monate Prognose gegen die tatsächlichen Werte und gegen drei einfachere Modelle. Rechtfertigt der Aufwand sich?
Das rechtfertigt den Aufwand gegenüber “gar kein Modell”.
Gegenüber Holt-Winters beträgt der Vorsprung rund einen Punkt RMSE
Also 6 Prozent in Python, 12 Prozent in R. Das ist der Vergleich, der wirklich zählt: gegen das einfachere Verfahren, das dieselbe Aufgabe löst. Ob der Gewinn den zusätzlichen Aufwand aus Ordnungswahl und Diagnostik wert ist, ist eine Sachfrage, keine statistische.
Das Modell ohne Saison ist schlechter als die naive Prognose
72.6 gegen 50.3. Ein Modell kann alles andere unterbieten, wenn ihm der wichtigste Bestandteil fehlt.
Bandbreite Monat 1 gegen Monat 12
67.7 gegen 83.4
Warum SARIMA hier nur knapp gewinnt, obwohl die Reihe mit einem autokorrelierten Fehler konstruiert wurde: Der AR(1)-Anteil mit Koeffizient 0.6 trägt zwar zur Prognose bei, aber nur für die ersten Monate. Danach ist sein Beitrag abgeklungen (\(0.6^{6} = 0.05\)), und übrig bleibt dasselbe, was Holt-Winters auch kann, Trend und Saison fortschreiben.
Die allgemeine Lehre: Der Vorsprung eines Modells über eine explizite Abhängigkeitsstruktur ist bei kurzen Horizonten gross und bei langen klein.
Interpretation und Ergebnissatz
Das Modell SARIMA(1,1,1)(0,1,1)\(_{12}\) prognostiziert die folgenden zwölf Monate mit einem RMSE von 17.1 (MAPE 1.7 Prozent), gegenüber 50.3 (5.6 Prozent) bei der naiven saisonalen Prognose und 18.2 (1.8 Prozent) bei Holt-Winters. Alle tatsächlichen Werte liegen im 95-Prozent-Prognoseintervall, dessen Breite von 68 auf 83 Einheiten wächst. Der Gewinn gegenüber der naiven Prognose ist gross, gegenüber dem einfacheren Verfahren gering.
Frage und Datenlage
Ein einzelner Testzeitraum ist eine Stichprobe von eins. Was, wenn gerade dieses Jahr besonders gut oder schlecht prognostizierbar war? Die rollierende Bewertung verschiebt den Prognosezeitpunkt über die Reihe.
Python: 18 Prognosen aus 3 Fenstern; R: tsCV() schiebt um je einen Schritt und sammelt deutlich mehr
Beobachtung
Deutung
Die Werte liegen nahe beieinander
17.1 gegen 18.1 in Python, 17.0 gegen 19.0 in R. Der einmalige Testteil war also nicht ungewöhnlich günstig, ein beruhigender Befund.
Die rollierende Zahl beruht auf mehr Prognosen
und ist damit weniger vom gewählten Abschnitt abhängig. Bei knapp beieinander liegenden Modellen ist sie die richtige Grundlage.
Der Horizont unterscheidet sich
6 statt 12 Monate. Kürzere Horizonte sind leichter, deshalb sind die Zahlen nicht direkt vergleichbar, nur die Grössenordnung.
Der Preis
Das Modell wird für jedes Fenster neu geschätzt. Bei drei Fenstern ist das harmlos, bei einer langen Reihe mit Schrittweite eins nicht.
Die R-Funktion tsCV() macht es gründlicher: Sie schiebt den Zeitpunkt um je einen Schritt weiter und liefert daher viel mehr Fehler. Die Python-Schleife oben nimmt Schritte von sechs Monaten, um die Rechenzeit zu begrenzen. Beide Zahlen sind deshalb nicht direkt vergleichbar, wohl aber jede für sich mit dem einmaligen Testfehler.
Wann sich der Aufwand lohnt: wenn zwei Modelle im einmaligen Testfehler weniger als etwa zehn Prozent auseinanderliegen, wie hier SARIMA und Holt-Winters. Dann entscheidet ein einzelner Testabschnitt zufällig.
Interpretation und Ergebnissatz
In einer rollierenden Bewertung mit sechs Monaten Horizont erreicht das Modell einen RMSE von 18.1 (Python, drei Fenster) beziehungsweise 19.0 (R, tsCV()), gegenüber 17.0 auf dem einmaligen Testteil. Die Prognosegüte hängt damit nicht am gewählten Testabschnitt.
Interpretationsfallen
Informationskriterien vergleichen nur gleiche Daten. Wer die Anzahl Differenzen ändert, darf AIC-Werte nicht mehr vergleichen.
Ein kleines AIC ist keine gute Prognose. Bewertet wird auf einem Testteil, nicht am Kriterium.
Residuen ohne Prüfung sind ein Kunstfehler. ACF und Ljung-Box gehören zu jedem berichteten Modell.
Die automatische Suche ersetzt das Denken nicht. Sie findet ein Modell mit gutem Kriterium; ob die Ordnung zur Reihe passt, sagt die Grafik.
Überdifferenzieren verschlechtert das Modell. Eine Differenz mehr als nötig erzeugt künstliche Struktur, siehe Stationarität.
Koeffizienten sind selten inhaltlich deutbar. Ein AR-Koeffizient von 0.6 beschreibt Trägheit, nicht eine Ursache.
Prognosen driften zum Mittel. Über längere Horizonte laufen ARIMA-Prognosen gegen einen konstanten Wert oder eine Gerade; die Intervalle werden dabei sehr breit.
Kein Modell überlebt einen Strukturbruch. Wer über einen Bruch hinweg schätzt, mittelt zwei Regime.
Ergebnis berichten
Vorlage für den Ergebnissatz:
Die Reihe wurde als [Ordnung] modelliert (geschätzt auf [Zeitraum], n = [n]). Die Residuen zeigen keine Autokorrelation (Ljung-Box p = [p]). Auf dem Testteil von [h] Perioden erreicht die Prognose einen RMSE von [Wert] und einen MAPE von [Wert] Prozent, gegenüber [Wert] beziehungsweise [Wert] bei der naiven saisonalen Prognose.
Genannt werden: Modellordnung samt Periode, Trainingszeitraum und n, Anzahl Differenzen und deren Begründung, Koeffizienten mit Standardfehlern, Informationskriterium, Residuendiagnostik, Fehlermasse auf dem Testteil und der Vergleich mit einer naiven Prognose.
viele Reihen, viele Prädiktoren, Deutbarkeit zweitrangig
Verständnisfragen
Die ACF der Residuen zeigt Spitzen bei den Abständen 12 und 24. Was fehlt dem Modell?
Saisonale Anteile
Richtig. Spitzen bei Vielfachen der Periode sind das Zeichen für nicht erfasste Saisonstruktur. Ergänzt wird ein saisonaler AR- oder MA-Term, oft zusammen mit saisonalem Differenzieren.
Ein zusätzlicher gewöhnlicher AR-Term
Der würde den ersten Abstand betreffen, nicht Vielfache von zwölf.
Eine weitere gewöhnliche Differenz
Sie entfernt Trend, nicht Saison.
Modell A hat AIC 512 bei zwei Differenzen, Modell B hat AIC 498 bei einer Differenz. Welches ist besser?
B, das AIC ist kleiner
Die Werte sind nicht vergleichbar.
Nicht entscheidbar: verschiedene Anzahl Differenzen heisst verschiedene Daten
Richtig. Informationskriterien gelten nur zwischen Modellen auf identischen Daten. Verglichen wird dann über die Prognosegüte auf einem Testteil.
A, weil weniger Differenzen sparsamer sind
A hat mehr Differenzen, und Sparsamkeit entscheidet hier nicht.
Was bedeutet ein AR-Koeffizient von 0.6?
Trägheit: ein Teil der Abweichung vom Niveau überträgt sich auf den nächsten Zeitpunkt
Richtig. Der Wert beschreibt die Struktur der Reihe, nicht eine Ursache. Beträge unter eins sind für Stationarität nötig.
Der nächste Wert ist 60 Prozent des aktuellen
Der Koeffizient wirkt auf die Abweichung vom Niveau, nicht auf den Wert selbst.
Das Modell erklärt 60 Prozent der Varianz
Das wäre eine andere Kennzahl.
Die automatische Suche wählt ARIMA(3,0,2) für eine Reihe mit sichtbarem Trend. Was ist zu prüfen?
Ob die Reihe differenziert werden müsste; ohne Differenz modelliert das Modell den Trend über viele AR-Terme
Richtig. Eine hohe AR-Ordnung bei d = 0 und sichtbarem Trend ist ein typisches Zeichen. Ein Blick auf ACF und Stationaritätstests klärt es.
Nichts, die Suche minimiert das Kriterium
Sie tut das, kann dabei aber eine unpassende Struktur wählen.