Typische Fragestellungen: Unterscheidet sich der Durchsatz zwischen drei Standorten, die Haltbarkeit zwischen vier Materialien, die Bearbeitungszeit zwischen mehreren Teams. Gemeinsam ist ihnen eine metrische Zielgrösse und eine Gruppierung mit mehr als zwei Stufen.
Der Grund für ein eigenes Verfahren ist die Fehlerrate. Bei drei Gruppen gibt es drei Paarvergleiche, bei fünf Gruppen schon zehn. Wer sie alle einzeln auf dem Fünf-Prozent-Niveau prüft, findet fast sicher irgendwo einen Unterschied, auch wenn keiner besteht, siehe multiples Testen. Die Varianzanalyse stellt stattdessen eine einzige Frage: Gibt es überhaupt einen Unterschied irgendwo? Erst wenn die Antwort ja lautet, folgen die paarweisen Vergleiche mit Korrektur.
Die Streuung aller Werte wird in zwei Teile zerlegt: den Teil, der auf die Unterschiede zwischen den Gruppenmittelwerten zurückgeht, und den Teil innerhalb der Gruppen. Sind die Gruppen wirklich verschieden, ist der erste Teil gross gegenüber dem zweiten.
\[F = \frac{\text{mittlere Quadratsumme zwischen den Gruppen}}{\text{mittlere Quadratsumme innerhalb der Gruppen}}\]
Bestandteil
Bedeutung
\(SS_{\text{zwischen}}\)
Abweichungen der Gruppenmittelwerte vom Gesamtmittel, gewichtet mit der Gruppengrösse
\(SS_{\text{innerhalb}}\)
Abweichungen der einzelnen Werte von ihrem Gruppenmittel
\(df_{\text{zwischen}}\)
Anzahl Gruppen minus eins
\(df_{\text{innerhalb}}\)
Gesamtzahl Beobachtungen minus Anzahl Gruppen
\(F\)
Verhältnis der beiden mittleren Quadratsummen, unter der Nullhypothese nahe eins
\(\eta^2\)
Anteil der Streuung, der auf die Gruppierung entfällt
Die Nullhypothese lautet, dass alle Gruppenerwartungswerte gleich sind. Die Alternative ist nicht “alle sind verschieden”, sondern “mindestens einer weicht ab”. Das ist der Grund, warum ein signifikanter F-Wert allein noch keine Aussage darüber erlaubt, welche Gruppen sich unterscheiden.
Formal ist die Varianzanalyse ein Spezialfall der linearen Regression mit einem kategorialen Prädiktor. Dieselben Daten, dieselben Quadratsummen, andere Darstellung; das letzte Szenario auf dieser Seite zeigt es an den Zahlen.
Voraussetzungen und ihre Prüfung
Voraussetzung
Was sie bedeutet
Prüfung
Folge bei Verletzung
Vorgehen
Unabhängigkeit
Beobachtungen beeinflussen sich weder innerhalb noch zwischen den Gruppen
Zwei Unterschiede in der Handhabung. Beide Funktionen erwarten die Daten in langer Form, also eine Zeile je Beobachtung mit einer Gruppenspalte, aov() über eine Formel und pg.anova über Spaltennamen. Und pg.anova liefert die Effektstärke gleich mit, während summary() nur die Quadratsummen zeigt, aus denen sie sich berechnen lässt.
Interpretationsfallen
Ein signifikanter F-Wert sagt nicht, welche Gruppen sich unterscheiden. Dafür braucht es die paarweisen Vergleiche mit Korrektur.
Paarweise t-Tests ohne Korrektur erhöhen die Rate falscher Alarme, siehe multiples Testen.
Nicht signifikant ist kein Nachweis von Gleichheit. Das gilt hier wie beim t-Test.
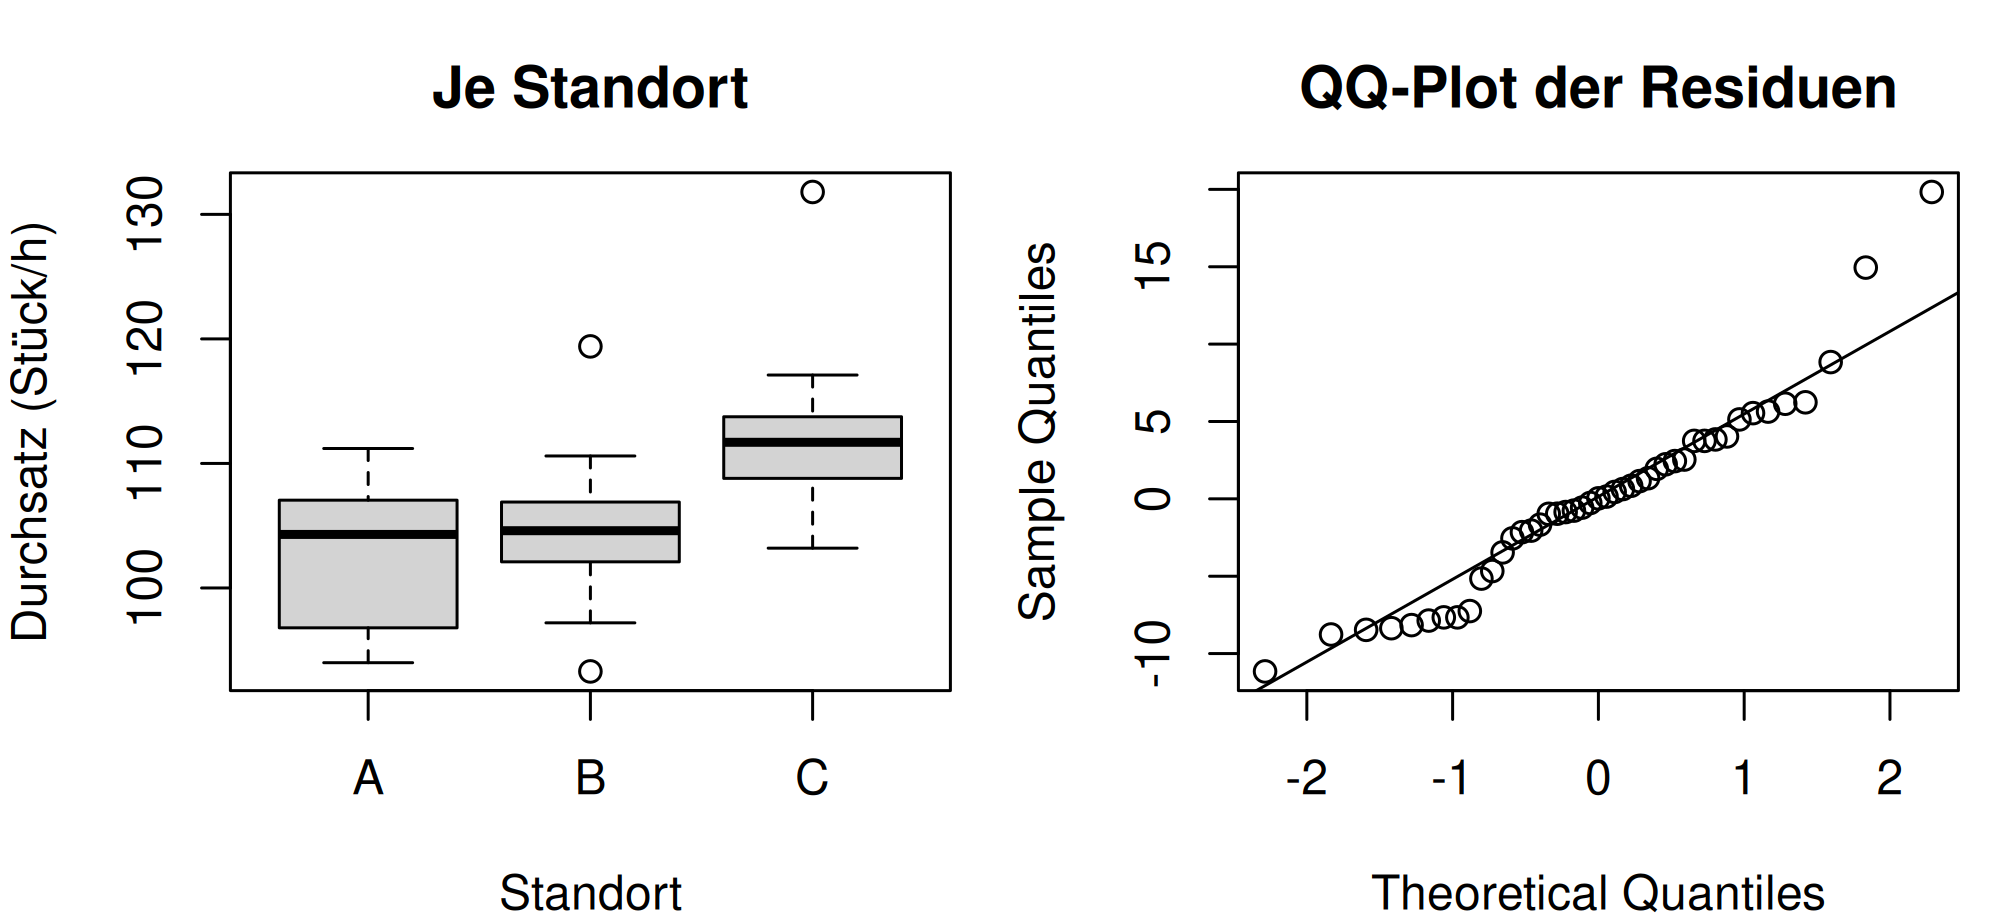
Der QQ-Plot gehört zu den Residuen. Die Rohwerte dürfen mehrgipflig sein, das ist gerade der gesuchte Effekt.
Ungleiche Varianzen bei ungleichen Gruppengrössen sind der gefährliche Fall. Im Zweifel die Welch-Variante rechnen.
Post-hoc-Vergleiche nur nach vorab festgelegtem Plan. Wer erst die Daten ansieht und dann die interessanten Paare auswählt, prüft nicht mehr fair.
Eta-Quadrat ist keine Relevanz. Ein hoher Anteil erklärter Streuung sagt nichts darüber, ob der Unterschied fachlich zählt.
Ergebnis berichten
Vorlage für den Ergebnissatz:
[Zielgrösse] unterscheidet sich zwischen den [Anzahl] Gruppen: F([df zwischen], [df innerhalb]) = [F], p = [p], Eta-Quadrat = [Wert]. Im paarweisen Vergleich nach [Verfahren] unterscheidet sich [Gruppe] von [Gruppe] um [Differenz] [Einheit], 95-Prozent-Konfidenzintervall [unten] bis [oben].
Immer genannt werden: Gruppengrössen, Mittelwerte und Streuungen je Gruppe, die F-Statistik mit beiden Freiheitsgraden, der p-Wert, eine Effektstärke, das verwendete Post-hoc-Verfahren und die Entscheidung zwischen gewöhnlicher und Welch-Variante samt Begründung.
Alle Beispiele rechnen mit den fest eingetragenen Daten aus dem Setup-Chunk: Durchsatz dreier Standorte in Stück pro Stunde. R und Python sehen dieselben Zahlen, jeder Wert im Text ist nachprüfbar.
An drei Standorten wird derselbe Artikel gefertigt. Von jedem liegen fünfzehn Schichten mit dem erreichten Durchsatz vor. Die Frage lautet: Unterscheiden sich die Standorte, und falls ja, welche?
Die beiden Teilfragen brauchen zwei verschiedene Werkzeuge, und das ist der wichtigste Punkt dieser Seite. Die Varianzanalyse beantwortet nur die erste: Gibt es überhaupt einen Unterschied irgendwo? Welche Standorte sich unterscheiden, beantworten erst die Post-hoc-Vergleiche.
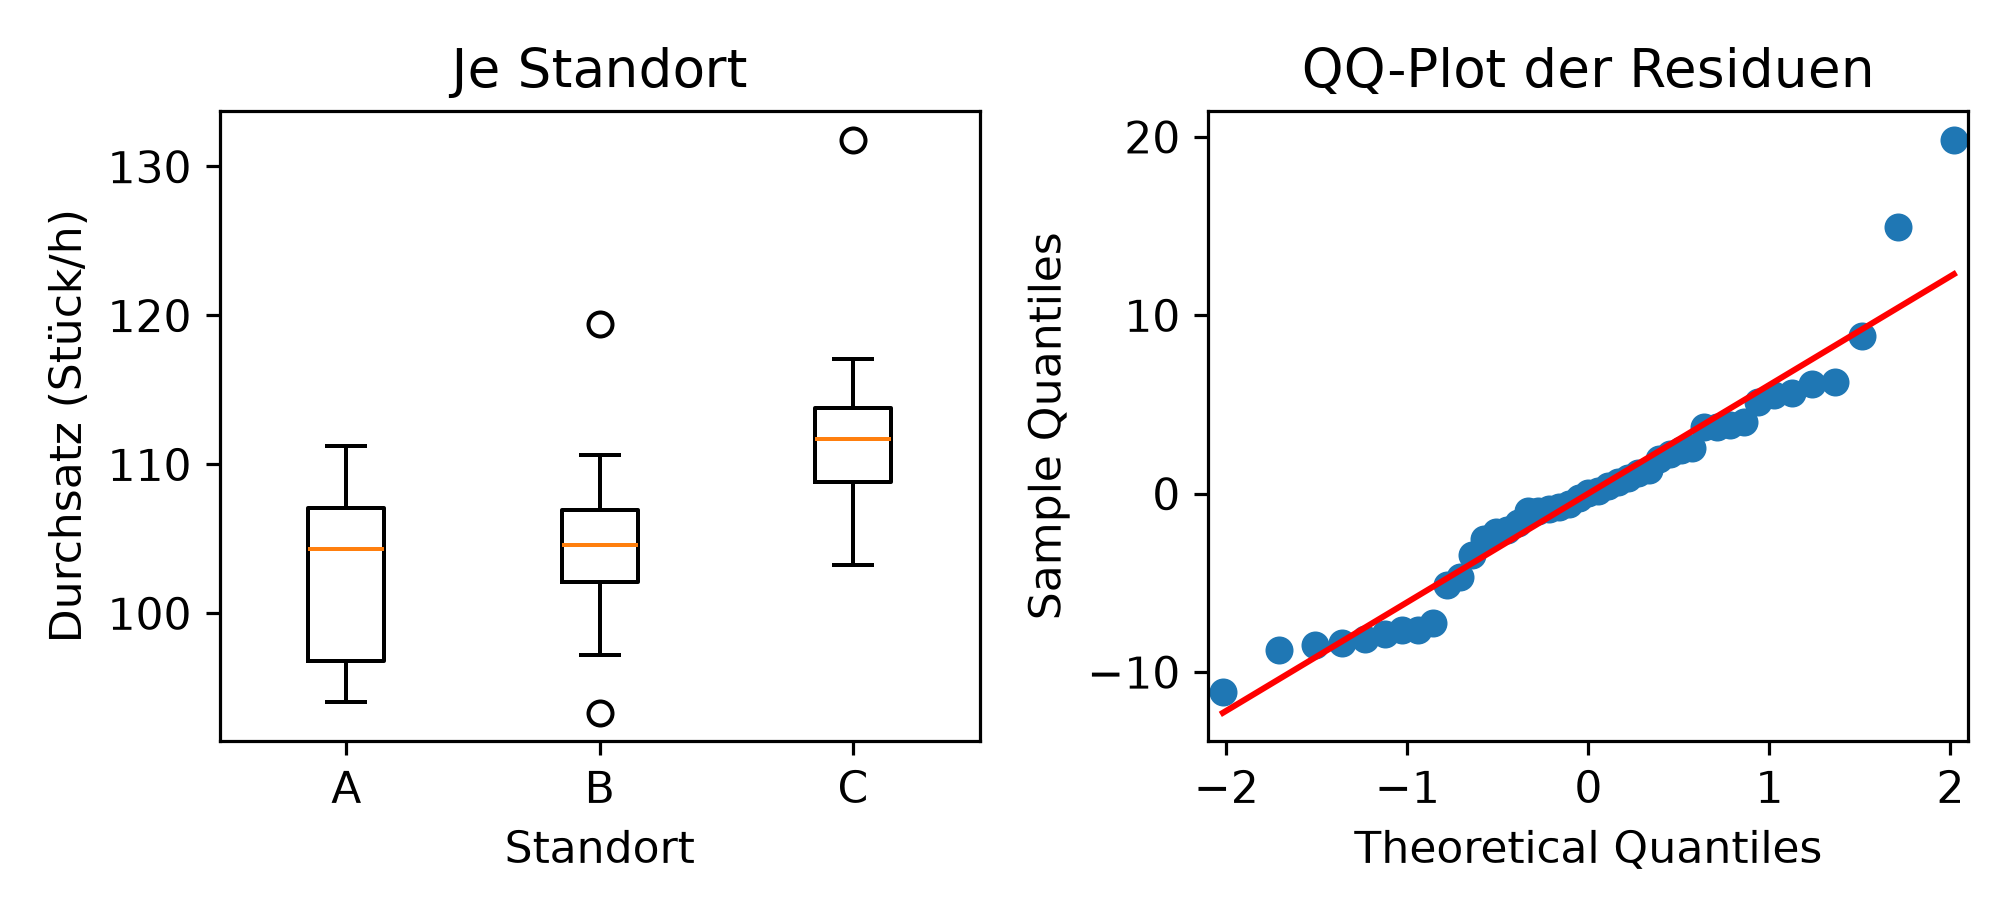
modell <-aov(durchsatz ~ standort, data = werk)par(mfrow =c(1, 2), mar =c(4, 4, 3, 1))boxplot(durchsatz ~ standort, data = werk, xlab ="Standort",ylab ="Durchsatz (Stück/h)", main ="Je Standort")qqnorm(residuals(modell), main ="QQ-Plot der Residuen")qqline(residuals(modell))par(mfrow =c(1, 1))car::leveneTest(durchsatz ~ standort, data = werk)
Levene's Test for Homogeneity of Variance (center = median)
      Df F value Pr(>F)
group  2  0.0837 0.9198
      42
Die drei Streuungen liegen zwischen 5.8 und 7.0 und damit dicht beieinander; der Levene-Test bestätigt das mit p = 0.92. Ein grosserp-Wert ist hier die gute Nachricht, weil die Nullhypothese dieses Tests die Gleichheit der Varianzen ist. Der QQ-Plot der Residuen zeigt keine Auffälligkeit, und die Gruppen sind gleich gross. Die klassische Varianzanalyse ist anwendbar.
Im Boxplot ist bereits sichtbar, worauf es hinausläuft: A und B liegen fast übereinander, C liegt deutlich höher.
Die klassische Ausgabe der Varianzanalyse ist eine Tabelle mit zwei Zeilen. Sie zerlegt die gesamte Streuung des Durchsatzes in zwei Teile.
Ausgabe
Wert hier
Bedeutung
Wie er zu lesen ist
Df Standort
2
Freiheitsgrade zwischen den Gruppen
Anzahl Gruppen minus eins.
Df Residuals
42
Freiheitsgrade innerhalb
Gesamtzahl der Messungen minus Anzahl Gruppen, also 45 minus 3.
Sum Sq Standort
765.6
Streuung zwischen den Standorten
Wie weit die drei Gruppenmittelwerte vom Gesamtmittelwert abweichen.
Sum Sq Residuals
1668.4
Streuung innerhalb der Standorte
Wie weit die einzelnen Schichten von ihrem eigenen Gruppenmittelwert abweichen. Das ist die Zufallsstreuung, gegen die verglichen wird.
Mean Sq Standort
382.8
Quadratsumme geteilt durch Freiheitsgrade
765.6 geteilt durch 2.
Mean Sq Residuals
39.7
dasselbe für die Residuen
1668.4 geteilt durch 42. Die Wurzel daraus, rund 6.3 Stück pro Stunde, ist die typische Schwankung einer Schicht.
F value
9.636
Verhältnis der beiden mittleren Quadrate
382.8 geteilt durch 39.7. Die Streuung zwischen den Standorten ist knapp zehnmal so gross wie die zufällige Streuung innerhalb. Bei völlig gleichen Standorten läge F im Mittel bei etwa 1.
Pr(>F)
0.00036
p-Wert des Gesamttests
Irgendwo zwischen den drei Standorten besteht ein Unterschied. Welche es sind, sagt diese Zeile nicht.
Eta2
0.3145
Anteil der erklärten Streuung
765.6 geteilt durch 2434.0. Rund 31 Prozent der Durchsatzschwankung gehen auf den Standort zurück, der Rest auf alles andere. Anhaltspunkte: 0.01 klein, 0.06 mittel, 0.14 gross.
\(\eta^2\) ist dieselbe Zahl wie das Bestimmtheitsmass einer Regression auf denselben Daten, siehe Beispiel 4. Die Varianzanalyse ist kein eigenes Verfahren, sondern eine andere Darstellung eines linearen Modells.
Post-hoc: welche Standorte unterscheiden sich?
Der Gesamttest sagt nur, dass es irgendwo einen Unterschied gibt. Für die Frage, zwischen welchen Standorten, braucht es paarweise Vergleiche mit Korrektur für multiples Testen. Ohne Korrektur läge die Wahrscheinlichkeit eines falschen Alarms bei drei Vergleichen nicht bei 5, sondern bei bis zu rund 14 Prozent.
Kein nachweisbarer Unterschied. Das Intervall enthält die Null und lässt Unterschiede in beide Richtungen zu.
C gegen A
9.61
4.02 bis 15.20
0.0004
Deutlich. Standort C fertigt im Mittel rund zehn Stück pro Stunde mehr als A.
C gegen B
7.51
1.92 bis 13.10
0.0061
Ebenfalls deutlich, wenn auch knapper.
Damit ist die eigentliche Frage beantwortet, und die Antwort ist präziser als “die Standorte unterscheiden sich”: C hebt sich von den beiden anderen ab, A und B unterscheiden sich nicht nachweisbar.
Die p-Werte sind korrigiert, das heisst sie sind grösser als ein einzelner t-Test ergäbe. Genau das ist beabsichtigt: Wer drei Vergleiche anstellt, hat drei Gelegenheiten für einen falschen Alarm, und die Korrektur bezahlt dafür mit etwas Schärfe.
Interpretation und Ergebnissatz
Berichtet werden beide Ebenen. Der Gesamttest rechtfertigt, dass überhaupt paarweise verglichen wurde; die paarweisen Intervalle sagen, worin der Unterschied besteht und wie gross er ist.
Ob zehn Stück pro Stunde viel sind, entscheidet die Sache: Bei rund 105 Stück sind das etwa neun Prozent, über eine Schicht gerechnet also ein spürbarer Betrag. Der nächste Schritt wäre nicht ein weiterer Test, sondern die Frage, woran es liegt.
Der Durchsatz unterscheidet sich zwischen den drei Standorten (F(2, 42) = 9.64, p < 0.001, \(\eta^2\) = 0.31). Post-hoc nach Tukey liegt Standort C über A (Differenz 9.6 Stück/h, 95-Prozent-Konfidenzintervall 4.0 bis 15.2, p < 0.001) und über B (7.5 Stück/h, 1.9 bis 13.1, p = 0.006); A und B unterscheiden sich nicht nachweisbar (2.1 Stück/h, -3.5 bis 7.7, p = 0.64). Varianzhomogenität war gegeben (Levene p = 0.92), n = 15 je Standort.
Frage und Datenlage
Dieselbe Fragestellung an drei anderen Standorten, wieder je fünfzehn Schichten. Das Beispiel zeigt, wie ein Nullbefund in der Varianzanalyse aussieht und warum danach keine Post-hoc-Vergleiche folgen.
Fast gleich gross. Genau das erwartet man, wenn die Gruppen sich nicht unterscheiden: Beide schätzen dann dieselbe Zufallsstreuung.
F value
0.864
Kleiner als 1. Die Unterschiede zwischen den Standorten sind sogar etwas kleiner, als der Zufall allein erwarten liesse.
Pr(>F)
0.429
Kein Nachweis.
Eta2
0.0395
Rund vier Prozent, im Bereich dessen, was bei drei Gruppen und 45 Messungen rein zufällig entsteht.
Ein F-Wert unter 1 ist kein Fehler und kein Hinweis auf einen “negativen Effekt”. F ist ein Verhältnis zweier Varianzschätzungen und schwankt um 1, wenn die Nullhypothese gilt. Ungefähr die Hälfte aller Nullbefunde liefert deshalb F kleiner als 1.
Interpretation und Ergebnissatz
Nach diesem Ergebnis folgen keine Post-hoc-Vergleiche. Der Gesamttest ist das Eintrittsbillett; ohne ihn paarweise weiterzusuchen, bis sich ein Paar findet, ist genau der Fehler, gegen den die Varianzanalyse gebaut wurde.
Und wie bei jedem Nullbefund gilt: Nicht nachweisbar ist nicht dasselbe wie gleich. Bei fünfzehn Schichten je Standort und einer Streuung von rund 7 Stück pro Stunde bleiben Unterschiede von mehreren Stück durchaus vereinbar; die Tukey-Intervalle würden das zeigen, wenn man sie berechnete.
Zwischen den drei Standorten ist kein Unterschied im Durchsatz nachweisbar (F(2, 42) = 0.86, p = 0.43, \(\eta^2\) = 0.04, n = 15 je Standort). Auf paarweise Vergleiche wurde verzichtet, da der Gesamttest nicht signifikant ist. Ein Nachweis der Gleichwertigkeit ist damit nicht erbracht.
Frage und Datenlage
Drei Standorte mit sehr verschiedenen Gruppengrössen und sehr verschiedener Streuung: zehn Schichten mit sehr gleichmässigem Betrieb, zwanzig mit stark schwankendem, dreissig mit mittlerem. Diese Kombination aus ungleichen Gruppengrössen und ungleichen Varianzen ist der Fall, in dem die klassische Varianzanalyse versagt.
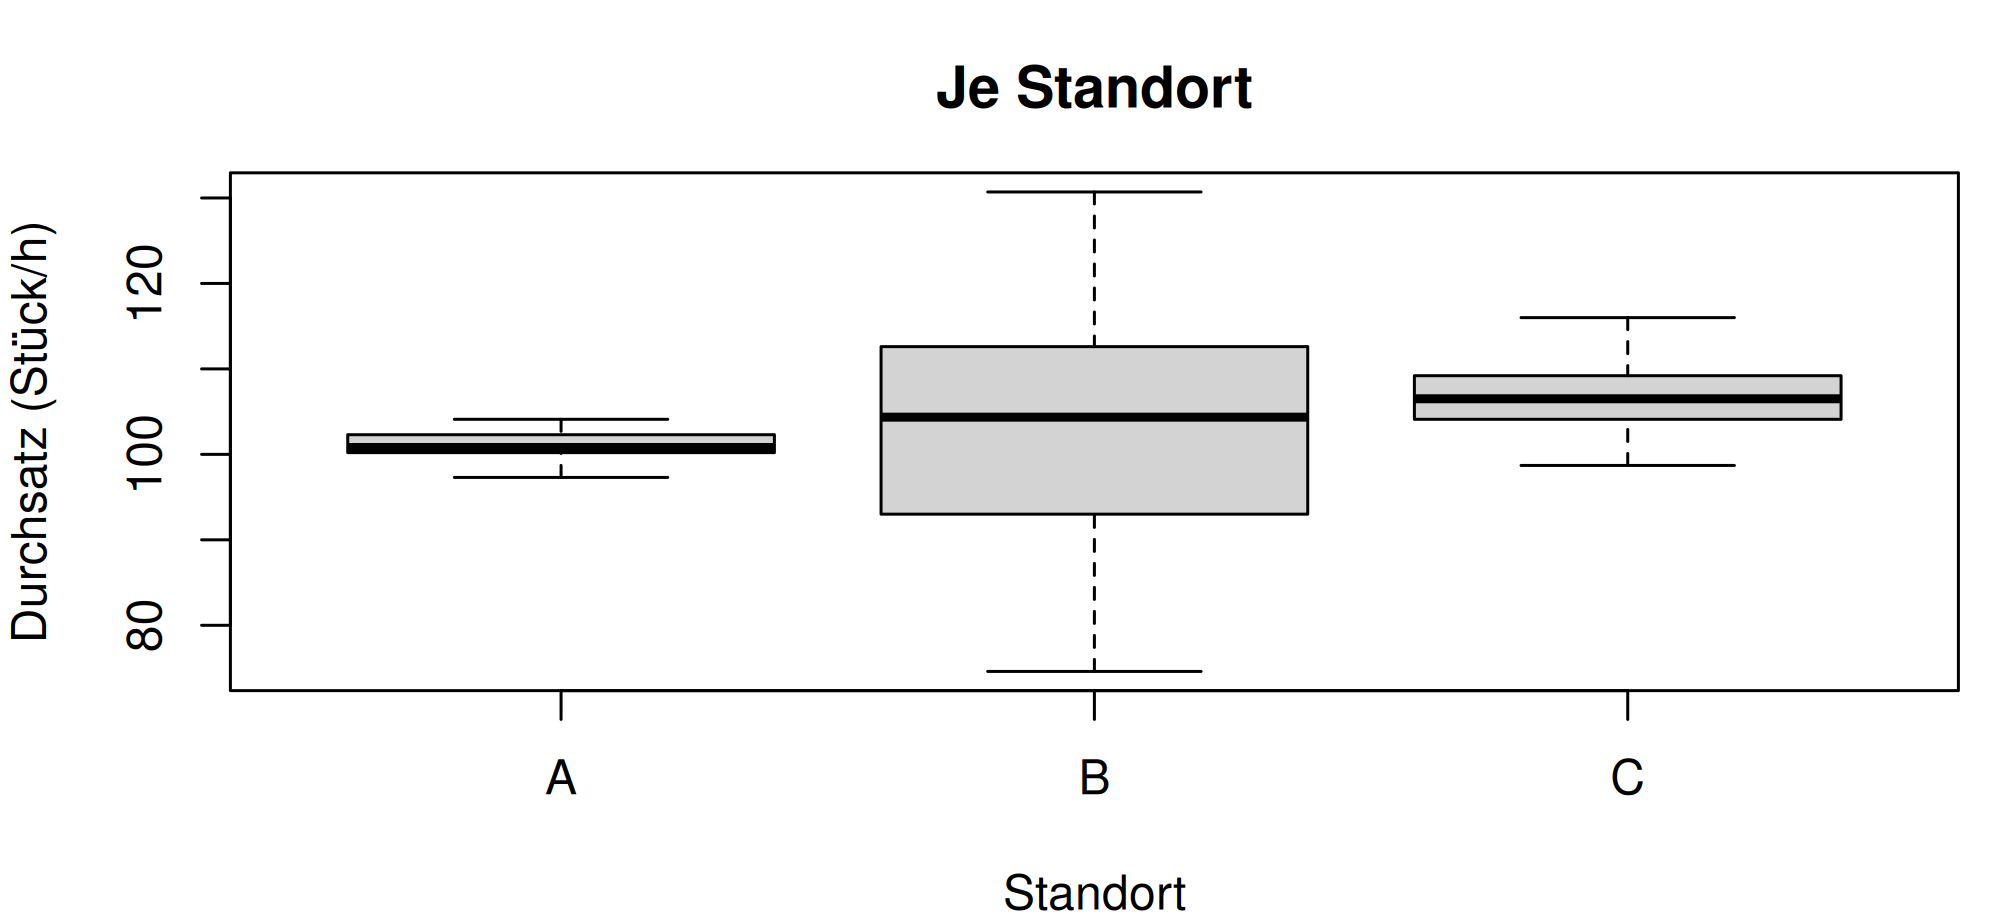
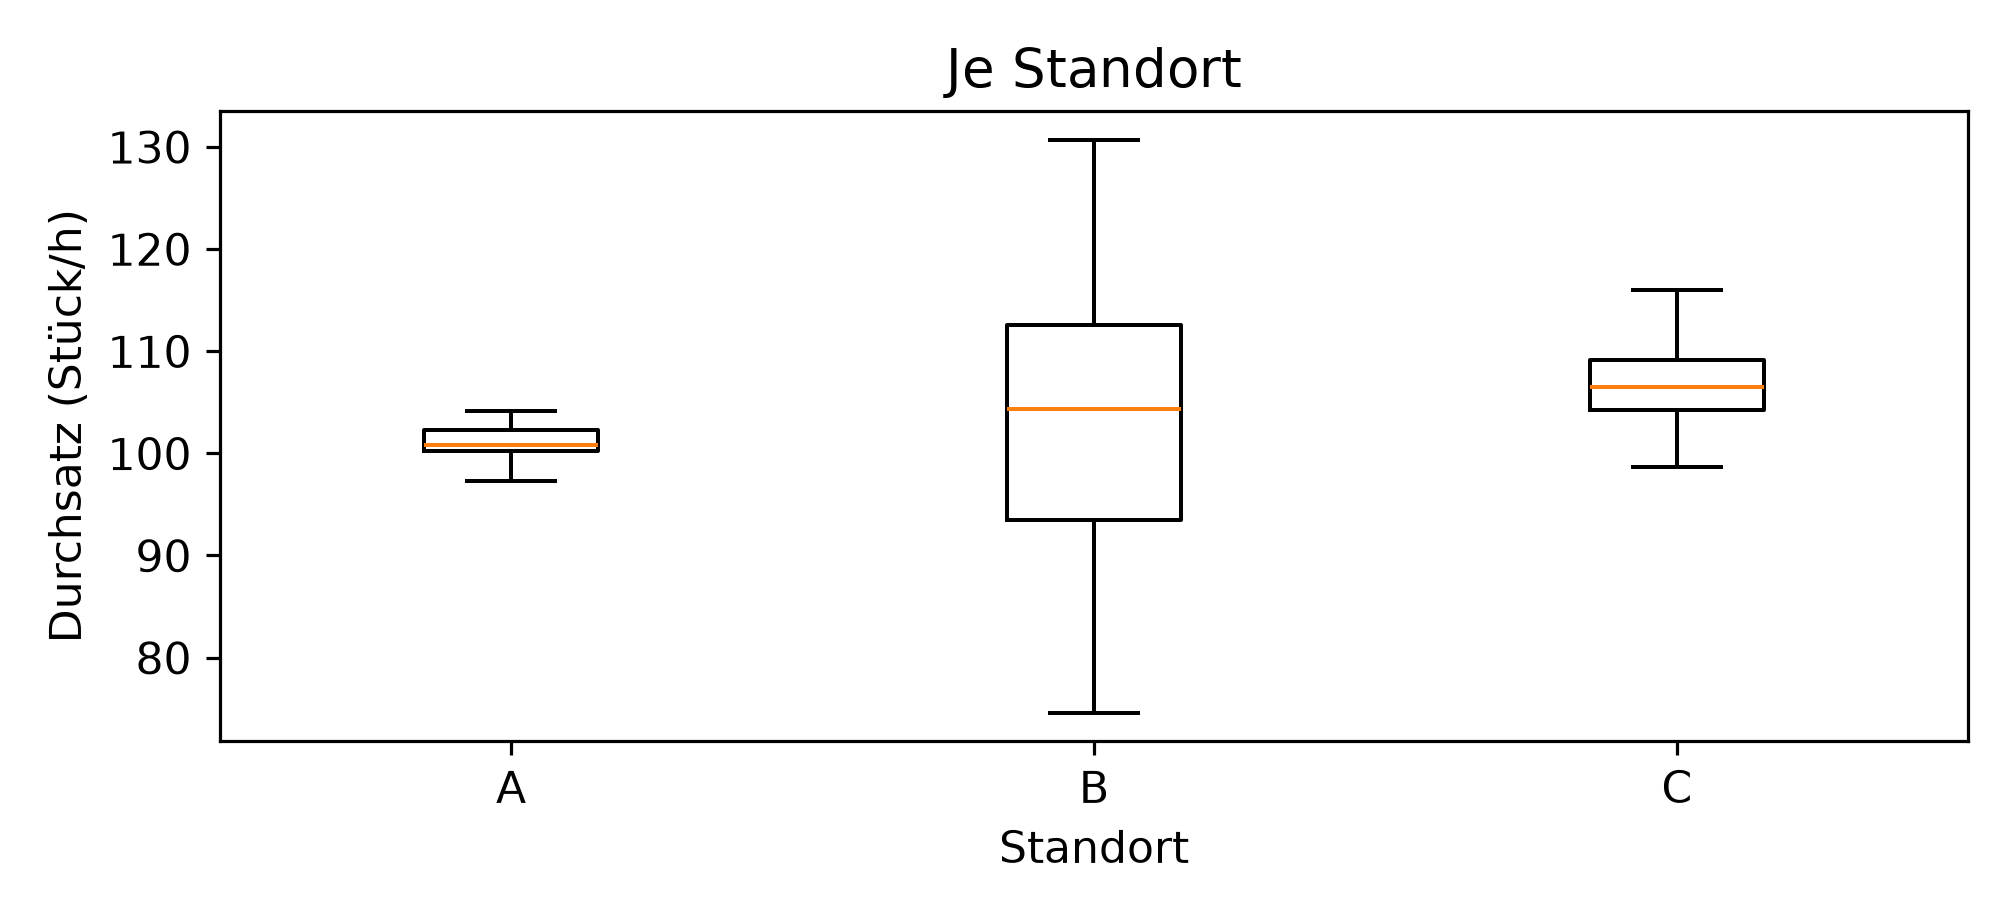
Standort B streut siebenmal so stark wie A, und die Gruppen sind unterschiedlich gross. Der Levene-Test liefert p = 0.0000012, also einen klaren Befund gegen die Varianzhomogenität. Damit ist die Voraussetzung der klassischen Varianzanalyse verletzt, und zwar in der ungünstigsten Konstellation: Die grösste Streuung gehört nicht zur grössten Gruppe.
summary(aov(durchsatz ~ standort, data = werk_streuung)) # klassisch
            Df Sum Sq Mean Sq F value Pr(>F)
standort     2    330  164.88   2.356  0.104
Residuals   57   3988   69.97
oneway.test(durchsatz ~ standort, data = werk_streuung,var.equal =FALSE) # Welch
    One-way analysis of means (not assuming equal variances)

data:  durchsatz and standort
F = 19.467, num df = 2.000, denom df = 31.906, p-value = 2.977e-06
kruskal.test(durchsatz ~ standort, data = werk_streuung) # rangbasiert
    Kruskal-Wallis rank sum test

data:  durchsatz by standort
Kruskal-Wallis chi-squared = 10.421, df = 2, p-value = 0.005458
print(pg.anova(data=werk_streuung, dv="durchsatz", between="standort").round(4))print(pg.welch_anova(data=werk_streuung, dv="durchsatz", between="standort").round(6))h_wert, h_p = stats.kruskal(*[werk_streuung.loc[werk_streuung["standort"] == g, "durchsatz"]for g in"ABC"])print("Kruskal-Wallis H =", round(h_wert, 4), " p =", round(h_p, 6))
Output Zeile für Zeile
Verfahren
Teststatistik
p-Wert
Wie das zu lesen ist
Klassische Varianzanalyse
F(2, 57) = 2.356
0.104
Kein Nachweis. Dieses Ergebnis ist nicht vertrauenswürdig, weil die Voraussetzung verletzt ist.
Welch-Varianzanalyse
F(2, 31.9) = 19.467
0.0000030
Ein klarer Befund auf denselben Daten.
Kruskal-Wallis
H(2) = 10.421
0.0055
Ebenfalls signifikant, rangbasiert und damit gegen die Streuungsunterschiede robust.
Die Erklärung steht in der Konstruktion des F-Werts. Der Nenner der klassischen Varianzanalyse ist eine gemeinsame Schätzung der Zufallsstreuung über alle Gruppen hinweg. Standort B mit seiner Streuung von 13.6 zieht diese gemeinsame Schätzung nach oben und macht damit auch die Unterschiede zwischen A und C unsichtbar, obwohl diese beiden Gruppen sehr gleichmässig messen.
Die Welch-Variante schätzt die Streuung je Gruppe getrennt und gewichtet entsprechend. Sie zahlt dafür mit gebrochenen Freiheitsgraden, hier 31.9 statt 57, und findet den Unterschied trotzdem.
Die Welch-Variante ist bei ungleichen Gruppengrössen der sicherere Standardfall, genau wie beim t-Test für zwei Stichproben. Sie kostet fast nichts, wenn die Varianzen tatsächlich gleich sind, und rettet das Ergebnis, wenn sie es nicht sind. In R ist sie über oneway.test() zu haben, nicht über aov().
Interpretation und Ergebnissatz
Die Wahl fällt an der Voraussetzungsprüfung, also am Levene-Test und am Boxplot, und sie fällt vor dem Blick auf die p-Werte. Hier führt sie zur Welch-Variante.
Bemerkenswert ist der Nebenbefund: Die Streuung selbst ist ein Ergebnis. Ein Standort, dessen Durchsatz zwischen 74 und 131 Stück schwankt, hat ein anderes Problem als einen zu niedrigen Mittelwert, und dieses Problem findet kein Mittelwertvergleich.
Die Varianzhomogenität ist deutlich verletzt (Levene p < 0.001; Standardabweichungen 1.95, 13.60 und 3.91 bei n = 10, 20 und 30), weshalb die Welch-Variante verwendet wurde. Der Durchsatz unterscheidet sich zwischen den Standorten (F(2, 31.9) = 19.47, p < 0.001). Die klassische Varianzanalyse hätte den Unterschied nicht gefunden (F(2, 57) = 2.36, p = 0.10). Zusätzlich auffällig ist die stark erhöhte Streuung an Standort B.
Frage und Datenlage
Die Daten aus Beispiel 1, diesmal als lineares Modell gerechnet. Das Beispiel zeigt, dass Varianzanalyse und Regression nicht zwei Verfahren sind, sondern zwei Ausgabeformate desselben Modells.
linear <-lm(durchsatz ~ standort, data = werk)summary(linear)
Call:
lm(formula = durchsatz ~ standort, data = werk)

Residuals:
     Min       1Q   Median       3Q      Max
-11.1533  -3.4600   0.0333   3.7467  19.8333

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  102.360      1.627  62.899  < 2e-16 ***
standortB      2.093      2.301   0.910 0.368235
standortC      9.607      2.301   4.174 0.000147 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 6.303 on 42 degrees of freedom
Multiple R-squared:  0.3145,    Adjusted R-squared:  0.2819
F-statistic: 9.636 on 2 and 42 DF,  p-value: 0.0003594
anova(linear)
Analysis of Variance Table

Response: durchsatz
          Df Sum Sq Mean Sq F value    Pr(>F)
standort   2  765.6  382.80  9.6364 0.0003594 ***
Residuals 42 1668.4   39.72
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
linear = smf.ols("durchsatz ~ C(standort)", data=werk).fit()print(linear.summary().tables[1])print("F =", round(linear.fvalue, 4), " p =", round(linear.f_pvalue, 8)," R^2 =", round(linear.rsquared, 4))
Output Zeile für Zeile
Ausgabe
Wert hier
Bedeutung
Wie er zu lesen ist
(Intercept)
102.36
Mittelwert der Referenzgruppe
Das ist exakt der Mittelwert von Standort A. R wählt die erste Faktorstufe als Referenz, hier alphabetisch A.
standortB
2.09
Differenz B minus A
Dieselbe Zahl wie im Tukey-Vergleich B gegen A.
standortC
9.61
Differenz C minus A
Ebenso.
Pr(>|t|) für standortB
0.368
p-Wert dieses Vergleichs
Nicht derselbe wie bei Tukey (dort 0.637), weil hier keine Korrektur für multiples Testen erfolgt.
F-statistic
9.636 auf 2 und 42 df
Gesamttest des Modells
Exakt der F-Wert der Varianzanalyse.
Multiple R-squared
0.3145
Anteil erklärter Streuung
Exakt das \(\eta^2\) der Varianzanalyse.
anova(linear)
dieselbe Tabelle wie summary(aov(...))
Beide Ausgaben stammen aus demselben angepassten Modell.
Interpretation und Ergebnissatz
Drei Dinge folgen daraus, und alle drei sind praktisch nützlich.
Erstens ist die Wahl zwischen aov() und lm() eine Frage der Darstellung, nicht des Verfahrens. aov() zeigt die Zerlegung der Streuung, lm() zeigt die Differenzen zu einer Referenzgruppe. Wen die Grösse der Unterschiede interessiert, ist mit der Regressionsausgabe besser bedient.
Zweitens erklärt es, warum der t-Test für zwei Stichproben ein Sonderfall ist: Bei zwei Gruppen hat das Modell einen einzigen Koeffizienten, und dann gilt F gleich t im Quadrat.
Drittens öffnet es den Weg zu allem, was die Varianzanalyse allein nicht kann. Weitere Einflussgrössen, metrische Kovariaten, Wechselwirkungen: Sobald das Modell als Regression geschrieben ist, kommen sie einfach als weitere Terme dazu, siehe multiple lineare Regression.
Die Voreinstellung der Referenzgruppe verdient Aufmerksamkeit: R nimmt die erste Faktorstufe, also die alphabetisch erste. Wer eine inhaltlich sinnvolle Referenz braucht, etwa den Hauptstandort, setzt sie mit relevel() beziehungsweise über Treatment(reference=...) in der Formel. Sonst berichtet man Differenzen zu einer Gruppe, die nur durch ihren Anfangsbuchstaben ausgezeichnet ist.
Ein lineares Modell mit dem Standort als Faktor liefert dieselben Ergebnisse wie die Varianzanalyse (F(2, 42) = 9.64, p < 0.001, R² = 0.31 entspricht \(\eta^2\)). Gegenüber Standort A liegt B um 2.1 Stück/h höher (p = 0.37) und C um 9.6 Stück/h (p < 0.001); die p-Werte sind hier unkorrigiert und deshalb kleiner als die Tukey-Werte.
Verständnisfragen
Die Varianzanalyse ergibt p = 0.002. Welche Aussage ist zulässig?
Alle drei Gruppen unterscheiden sich voneinander
Die Alternative lautet nur, dass mindestens eine abweicht.
Mindestens eine Gruppe weicht von den übrigen ab
Richtig. Welche das ist, beantwortet erst ein paarweiser Vergleich mit Korrektur.
Die grösste beobachtete Differenz ist signifikant
Das ist eine eigene Frage, und wer sie nach dem Blick auf die Daten stellt, prüft nicht mehr fair.
Drei Gruppen sollen verglichen werden. Warum nicht einfach drei t-Tests?
Weil die Rate falscher Alarme mit der Anzahl Vergleiche steigt
Richtig. Bei drei unabhängigen Vergleichen auf dem Fünf-Prozent-Niveau liegt die Wahrscheinlichkeit für mindestens einen falschen Alarm bereits bei rund vierzehn Prozent.
Weil der t-Test nur bei Normalverteilung gilt
Diese Annahme trifft die Varianzanalyse genauso.
Weil t-Tests bei drei Gruppen nicht rechenbar sind
Rechenbar sind sie, nur die Fehlerkontrolle stimmt nicht.
Der QQ-Plot der Rohwerte zeigt drei Gipfel. Ist die Voraussetzung verletzt?
Ja, die Werte sind nicht normalverteilt
Geprüft wird nicht die Gesamtverteilung der Rohwerte.
Nein, geprüft werden die Residuen
Richtig. Verschiedene Gruppenmittelwerte erzeugen genau dieses Bild; die Annahme betrifft die Abweichungen vom jeweiligen Gruppenmittel.
Nein, die Annahme ist bei mehr als zwei Gruppen unnötig
Sie gilt weiter, nur bezieht sie sich auf die Residuen.
Eine Gruppe mit zehn Beobachtungen streut dreimal so stark wie eine mit dreissig. Was folgt?
Nichts, die Varianzanalyse ist robust
Robust ist sie bei gleichen Gruppengrössen; hier sind sie ungleich.
Die Welch-Variante rechnen und sie berichten
Richtig. Ungleiche Varianzen zusammen mit ungleichen Gruppengrössen verfehlen das Niveau, und die Richtung des Fehlers hängt davon ab, wo die grosse Streuung sitzt.