Effektstärken

Effektstärke
Interpretation
R
Python
Cohens d, Hedges g, r und η²: wie gross ist der Unterschied wirklich?

Kernideen

  • Eine Effektstärke beantwortet die Frage wie gross, ein p-Wert die Frage vom Zufall unterscheidbar. Die beiden hängen nur über den Stichprobenumfang zusammen.
  • Cohens \(d\) misst die Mittelwertdifferenz in Einheiten der Streuung. Dieselbe Differenz kann je nach Streuung ein winziger oder ein riesiger Effekt sein.
  • Effektstärken sind vom Stichprobenumfang unabhängig. Der p-Wert ist es nicht: Mit wachsendem n wird jeder noch so kleine Effekt signifikant.
  • Eine Effektstärke ohne Konfidenzintervall ist eine Punktschätzung wie jede andere und bei kleinem n sehr unsicher.
  • Die Anhaltspunkte “0.2 klein, 0.5 mittel, 0.8 gross” sind eine Notlösung für Gebiete ohne eigene Erfahrungswerte, keine Naturkonstanten.

Erklärung

Die drei Familien

Familie Masse Wofür Bereich
Differenzmasse Cohens \(d\), Hedges \(g\) Mittelwertunterschiede zwischen Gruppen unbeschränkt, praktisch -3 bis 3
Zusammenhangsmasse \(r\), \(R^2\), \(\eta^2\), Cramérs \(V\) Stärke eines Zusammenhangs 0 bis 1, \(r\) auch negativ
Verhältnismasse Odds Ratio, Risikoverhältnis binäre Zielgrössen 0 bis unendlich, 1 heisst kein Effekt

Welches passt, ergibt sich aus dem Verfahren:

Verfahren Übliches Mass
t-Test Cohens \(d\), bei kleinem n Hedges \(g\)
gepaarter t-Test \(d_z\) auf den Differenzen, siehe dortigen Kasten
Varianzanalyse \(\eta^2\) oder partielles \(\eta^2\)
Korrelation \(r\) ist bereits eine Effektstärke
Regression \(R^2\), und der Koeffizient in seiner Einheit
Chi-Quadrat Cramérs \(V\)
logistische Regression Odds Ratio
Rangtests rangbiseriale Korrelation, CLES

Cohens d und seine Geschwister

\[d = \frac{\bar{x}_2 - \bar{x}_1}{s_{\text{gepoolt}}}, \qquad s_{\text{gepoolt}} = \sqrt{\frac{(n_1-1)s_1^2 + (n_2-1)s_2^2}{n_1+n_2-2}}\]

Der Zähler ist die Effektgrösse in der Einheit der Messung, der Nenner macht sie einheitenlos. Genau dadurch wird \(d\) zwischen Studien vergleichbar und verliert zugleich den Bezug zur Sache: 0.5 sagt nichts darüber, ob es um Millimeter oder Monate geht.

Hedges \(g\) korrigiert eine Verzerrung, die \(d\) bei kleinen Stichproben nach oben treibt. Der Korrekturfaktor beträgt \(1 - \frac{3}{4(n_1+n_2)-9}\), bei insgesamt 24 Fällen also rund 0.965. Ab etwa 50 Fällen ist der Unterschied belanglos; darunter gehört \(g\) berichtet.

Die Anhaltspunkte und ihre Grenzen

\(d\) Bezeichnung Überlappung der Verteilungen Anteil von B über dem Median von A
0.2 klein 92 % 58 %
0.5 mittel 80 % 69 %
0.8 gross 69 % 79 %
1.2 sehr gross 55 % 88 %

Diese Bezeichnungen stammen aus einem Vorschlag für die Sozialwissenschaften und wurden dort ausdrücklich als Notlösung eingeführt. In einem Fachgebiet mit eigenen Erfahrungswerten ist der Vergleich mit früheren Studien die bessere Einordnung. In der Fertigung kann \(d = 0.2\) teuer sein, in der Psychologie ist \(d = 0.8\) ungewöhnlich gross.

Umrechnung

Die Masse lassen sich ineinander überführen, was beim Vergleich von Studien mit verschiedenen Verfahren hilft:

Von Nach Formel Beispiel \(d = 0.5\)
\(d\) \(r\) \(r = d/\sqrt{d^2+4}\) 0.243
\(r\) \(d\) \(d = 2r/\sqrt{1-r^2}\)
\(d\) CLES \(\Phi(d/\sqrt{2})\) 0.638
\(\eta^2\) \(f\) \(f = \sqrt{\eta^2/(1-\eta^2)}\)

Die Common Language Effect Size ist die verständlichste Übersetzung. Sie beantwortet die Frage: Wie wahrscheinlich ist es, dass ein zufällig gewählter Fall aus Gruppe B über einem zufällig gewählten aus Gruppe A liegt? Bei \(d = 0.5\) sind das 64 Prozent, bei \(d = 0\) genau 50 Prozent.

Diese Zahl braucht keine Statistikkenntnisse und macht sofort deutlich, wie bescheiden ein “mittlerer” Effekt ist: In gut einem Drittel der Vergleiche gewinnt die andere Gruppe.

Beispiele

Frage und Datenlage

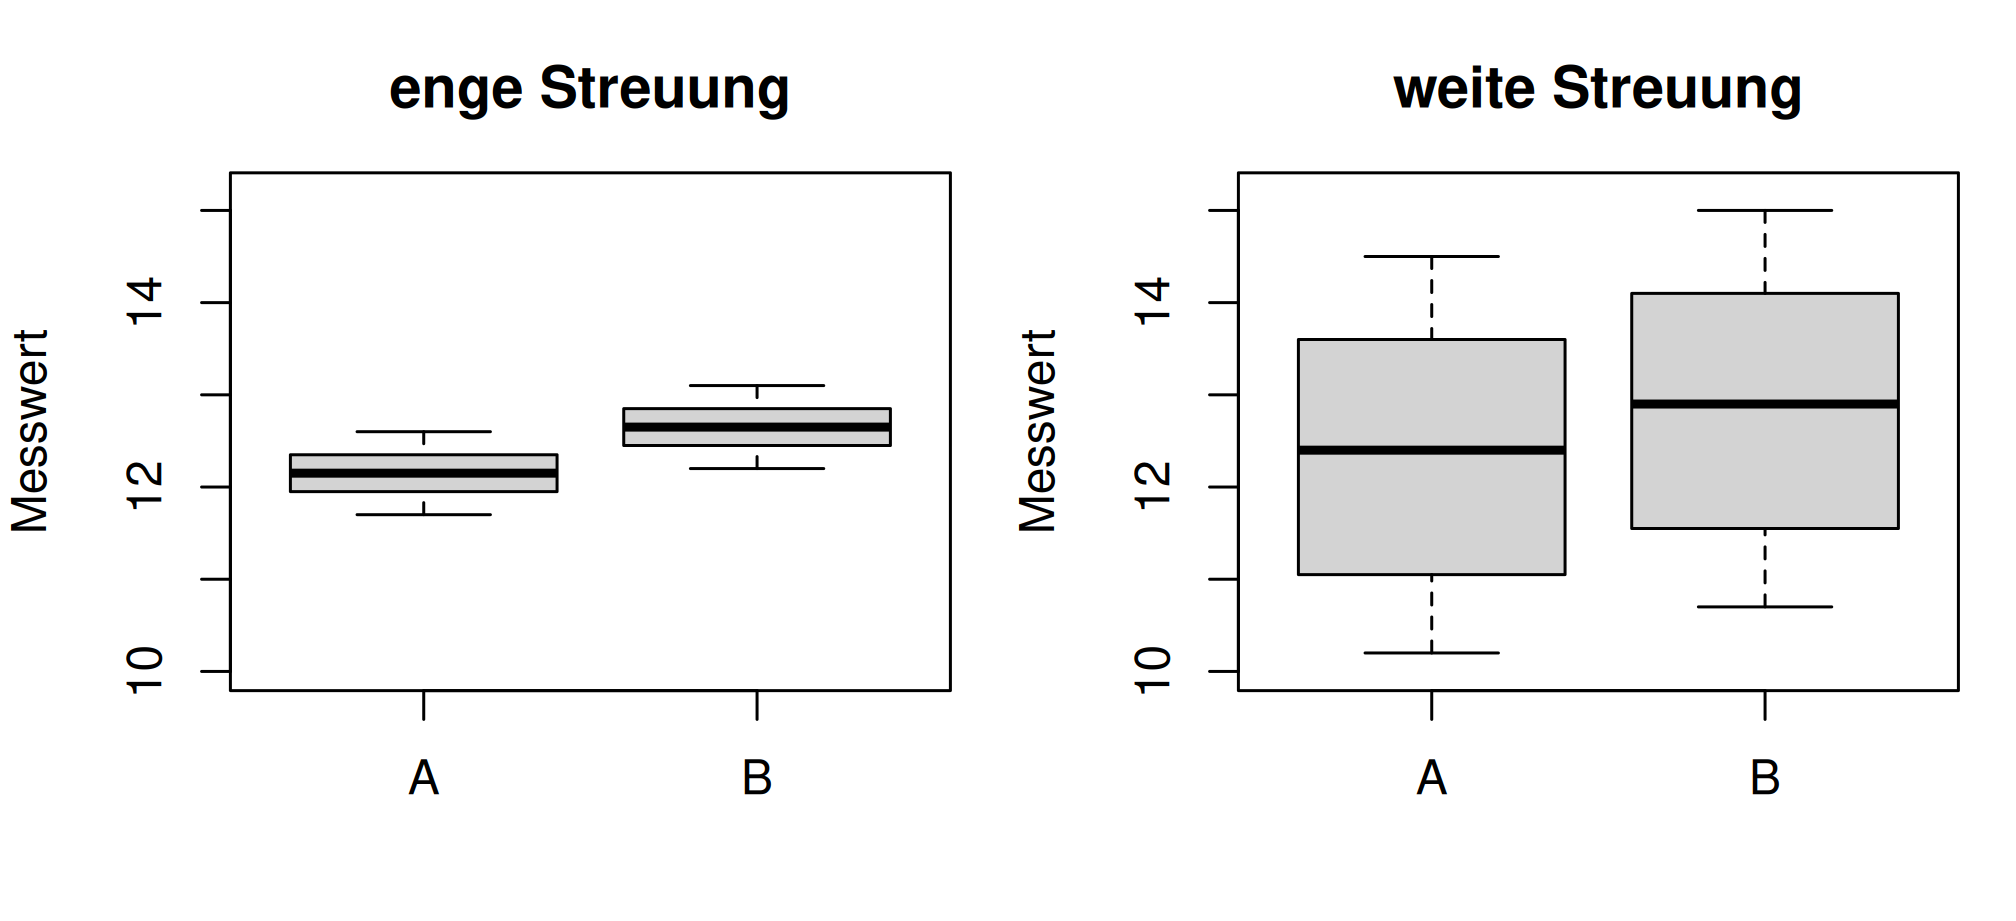
Zwei Vergleiche, beide mit einer Mittelwertdifferenz von genau 0.50 Einheiten. Im ersten streuen die Werte eng, im zweiten weit. Die Frage lautet: Ist das derselbe Effekt?

Rechnung

par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))
boxplot(list(A = eng_a, B = eng_b), main = "enge Streuung",
        ylab = "Messwert", ylim = c(10, 15.2))
boxplot(list(A = weit_a, B = weit_b), main = "weite Streuung",
        ylab = "Messwert", ylim = c(10, 15.2))
par(mfrow = c(1, 1))

effekt(eng_a, eng_b)
  differenz gepoolte_sd           d    hedges_g       unten        oben 
     0.5000      0.2812      1.7779      1.7166      0.8328      2.7230 
effekt(weit_a, weit_b)
  differenz gepoolte_sd           d    hedges_g       unten        oben 
     0.5000      1.4513      0.3445      0.3326     -0.4616      1.1506 
t.test(eng_b, eng_a, var.equal = TRUE)$p.value
[1] 0.0002535206
t.test(weit_b, weit_a, var.equal = TRUE)$p.value
[1] 0.407821
Abbildung 1: Beispiel 1: dieselbe Differenz vor unterschiedlichem Hintergrund.
fig, achsen = plt.subplots(1, 2, figsize=(7, 3.2))
for achse, paar, titel in zip(achsen, [(eng_a, eng_b), (weit_a, weit_b)],
                              ["enge Streuung", "weite Streuung"]):
    achse.boxplot(list(paar))
    achse.set_xticks([1, 2], ["A", "B"])
    achse.set_ylim(10, 15.2)
    achse.set_ylabel("Messwert")
    achse.set_title(titel)
plt.tight_layout()
plt.show()
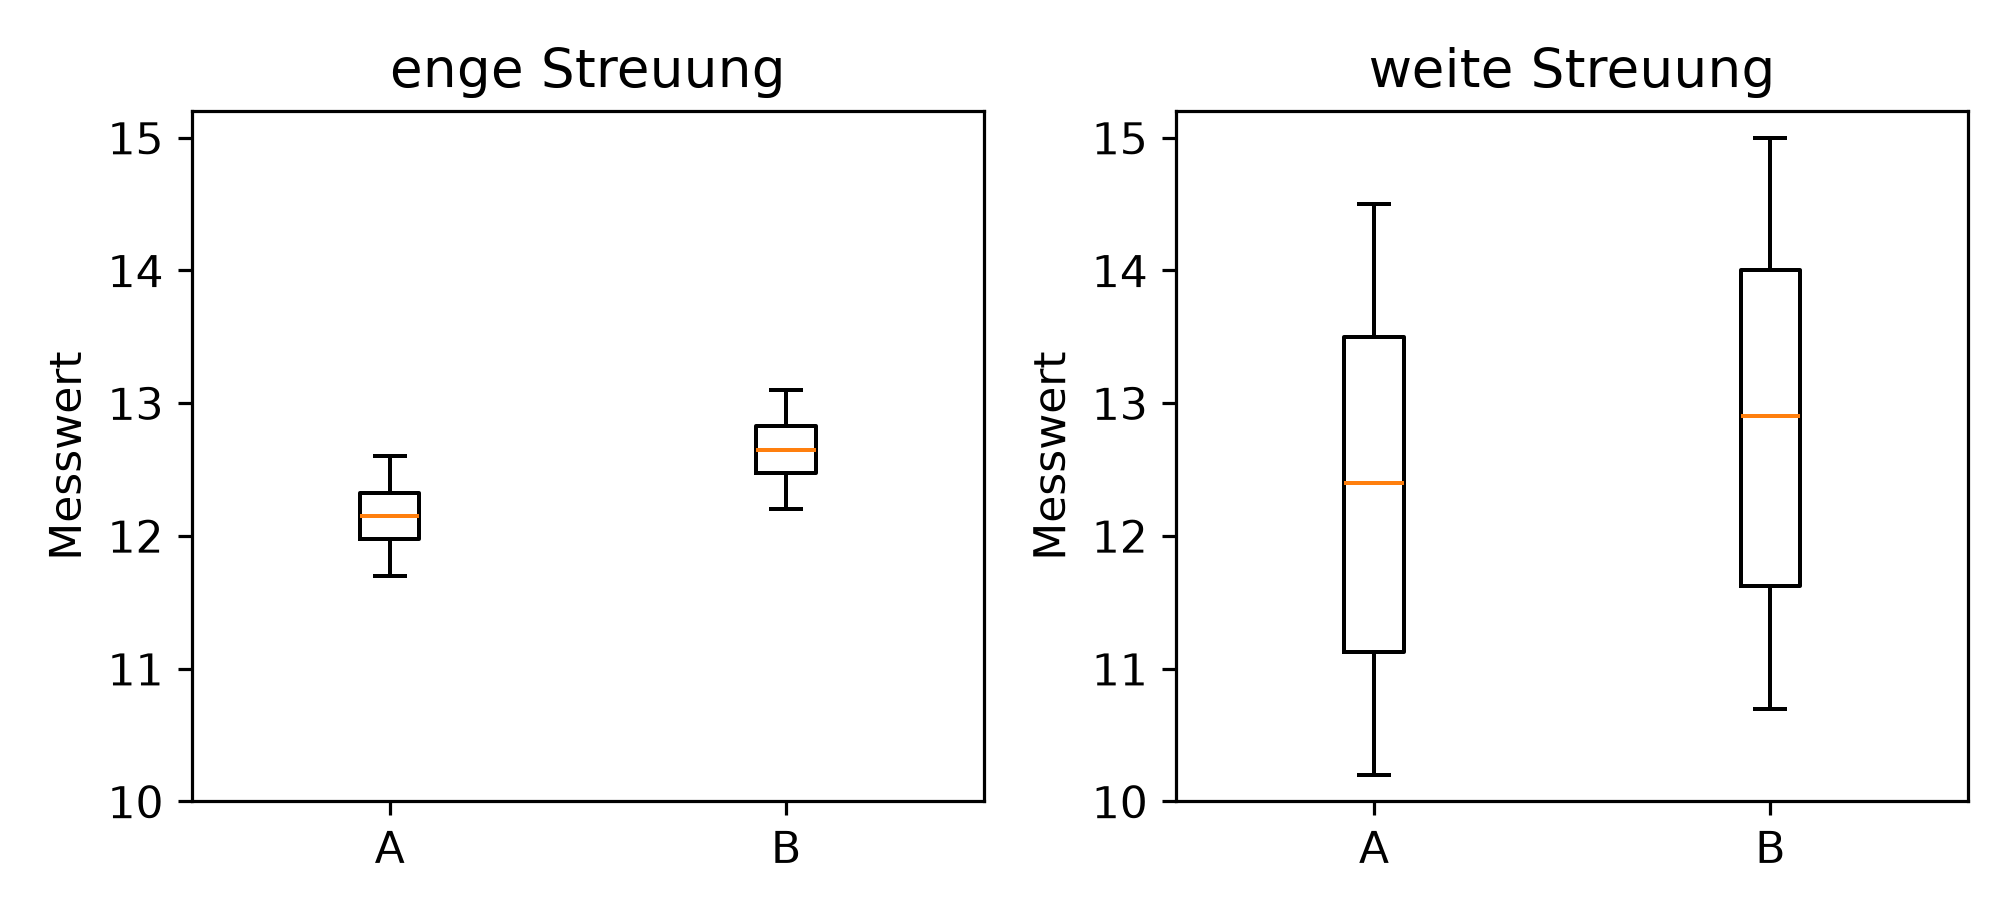
Abbildung 2: Beispiel 1: dieselbe Darstellung in Python.
print(pd.DataFrame({"eng": effekt(eng_a, eng_b),
                    "weit": effekt(weit_a, weit_b)}))
                eng    weit
differenz    0.5000  0.5000
gepoolte_sd  0.2812  1.4513
d            1.7779  0.3445
hedges_g     1.7166  0.3326
unten        0.8328 -0.4616
oben         2.7230  1.1506
print("p eng: ", round(stats.ttest_ind(eng_b, eng_a).pvalue, 6))
p eng:  0.000254
print("p weit:", round(stats.ttest_ind(weit_b, weit_a).pvalue, 6))
p weit: 0.407821

Output Zeile für Zeile

Kennzahl enge Streuung weite Streuung Wie das zu lesen ist
Mittelwertdifferenz 0.500 0.500 Identisch. In der Einheit der Messung ist der Unterschied derselbe.
gepoolte Standardabweichung 0.281 1.451 Der Unterschied steckt hier: gut fünfmal so gross.
Cohens \(d\) 1.778 0.345 Ein Faktor von fünf, allein aus der Streuung. Links ein sehr grosser, rechts ein kleiner Effekt.
Hedges \(g\) 1.717 0.333 Um 3.5 Prozent kleiner, weil bei 24 Fällen die Korrektur greift.
Näherungsintervall für \(d\) 0.83 bis 2.72 -0.46 bis 1.15 Beide Intervalle sind breit; bei 12 Fällen je Gruppe ist die Effektstärke schlecht bestimmt.
p-Wert 0.00025 0.408 Derselbe Unterschied, einmal hochsignifikant, einmal weit von jeder Schwelle entfernt.

Interpretation

Die Boxplots machen sichtbar, was die Zahlen sagen: Links liegen die beiden Gruppen fast getrennt nebeneinander, rechts überlappen sie fast vollständig.

Daraus folgt, wozu die Standardisierung dient und wo ihre Grenze liegt. Sie macht Effekte über Messgrössen hinweg vergleichbar, indem sie die Differenz an der natürlichen Schwankung misst. Zugleich geht die Einheit verloren: \(d = 1.78\) sagt nicht, dass der Unterschied praktisch zählt.

Deshalb gehören immer beide Zahlen in den Bericht: die Differenz in ihrer Einheit für die Sache, die Effektstärke für den Vergleich mit anderen Studien.

Frage und Datenlage

Der Effekt ist festgehalten bei \(d = 0.5\). Verändert wird nur der Stichprobenumfang. Die Frage lautet: Was macht das mit dem p-Wert, und was mit der Effektstärke?

Rechnung

d <- 0.5
tabelle <- data.frame(n_je_gruppe = c(10, 20, 50, 100, 400))
tabelle$t <- d * sqrt(tabelle$n_je_gruppe / 2)
tabelle$p <- 2 * (1 - pt(abs(tabelle$t), 2 * tabelle$n_je_gruppe - 2))
tabelle$d <- d
round(tabelle, 5)
  n_je_gruppe       t       p   d
1          10 1.11803 0.27825 0.5
2          20 1.58114 0.12214 0.5
3          50 2.50000 0.01408 0.5
4         100 3.53553 0.00051 0.5
5         400 7.07107 0.00000 0.5
d = 0.5
n_je = np.array([10, 20, 50, 100, 400])
t = d * np.sqrt(n_je / 2)
p = 2 * (1 - stats.t.cdf(np.abs(t), 2 * n_je - 2))
print(pd.DataFrame({"n_je_gruppe": n_je, "t": t.round(3),
                    "p": p.round(5), "d": d}))
   n_je_gruppe      t        p    d
0           10  1.118  0.27825  0.5
1           20  1.581  0.12214  0.5
2           50  2.500  0.01408  0.5
3          100  3.536  0.00051  0.5
4          400  7.071  0.00000  0.5

Output Zeile für Zeile

n je Gruppe t p d
10 1.118 0.278 0.5
20 1.581 0.122 0.5
50 2.500 0.014 0.5
100 3.536 0.0005 0.5
400 7.071 < 0.00001 0.5

Derselbe Effekt wandert von “nicht nachweisbar” zu “hochsignifikant”, ohne dass sich an der Sache etwas ändert. Die Effektstärke bleibt konstant, weil sie den Stichprobenumfang gar nicht enthält.

Daraus folgen zwei praktische Regeln.

Ein nicht signifikantes Ergebnis bei kleinem n sagt wenig. Bei zehn Fällen je Gruppe bleibt ein mittlerer Effekt in vier von fünf Fällen unentdeckt, siehe Power.

Ein signifikantes Ergebnis bei sehr grossem n sagt ebenfalls wenig, jedenfalls nicht über die Grösse. Bei 400 Fällen je Gruppe genügt \(d = 0.14\) für p < 0.05.

Interpretation

Diese Tabelle ist der Grund, warum ein p-Wert allein keine Aussage über die Sache trägt. Er vermischt zwei Dinge: wie gross der Effekt ist und wie viele Daten vorliegen. Die Effektstärke trennt das erste heraus.

Frage und Datenlage

Effektstärken werden meist als blosse Zahl berichtet. Sie sind aber Schätzungen wie jede andere und haben eine Unsicherheit. Wie gross ist sie?

Rechnung

effekt(eng_a, eng_b)
  differenz gepoolte_sd           d    hedges_g       unten        oben 
     0.5000      0.2812      1.7779      1.7166      0.8328      2.7230 
# Zum Vergleich das Paket, das die genauere Methode ueber die
# nichtzentrale t-Verteilung verwendet
effectsize::cohens_d(eng_b, eng_a)
Cohen's d |       95% CI
------------------------
1.78      | [0.81, 2.72]

- Estimated using pooled SD.
effectsize::hedges_g(eng_b, eng_a)
Hedges' g |       95% CI
------------------------
1.72      | [0.78, 2.63]

- Estimated using pooled SD.
print(effekt(eng_a, eng_b))
differenz      0.5000
gepoolte_sd    0.2812
d              1.7779
hedges_g       1.7166
unten          0.8328
oben           2.7230
dtype: float64
# Wie breit waere das Intervall bei mehr Daten? Dieselbe Effektstaerke,
# verschiedene Umfaenge.
d_fest = 1.7779
for n in (12, 30, 100, 300):
    se = np.sqrt(2 * n / (n * n) + d_fest ** 2 / (4 * n))
    print(f"n je Gruppe = {n:3d}: {d_fest - 1.96*se:.3f} bis {d_fest + 1.96*se:.3f}"
          f"  (Breite {2*1.96*se:.3f})")
n je Gruppe =  12: 0.833 bis 2.723  (Breite 1.890)
n je Gruppe =  30: 1.180 bis 2.376  (Breite 1.195)
n je Gruppe = 100: 1.451 bis 2.105  (Breite 0.655)
n je Gruppe = 300: 1.589 bis 1.967  (Breite 0.378)

Output Zeile für Zeile

Ausgabe Wert hier Wie er zu lesen ist
\(d\) 1.778 Ein sehr grosser Effekt.
Hedges \(g\) 1.717 Die Korrektur um Faktor 0.965 bei 24 Fällen. Der Unterschied ist hier klein, bei sechs Fällen je Gruppe wären es rund 8 Prozent.
Näherungsintervall 0.83 bis 2.72 Fast zwei Einheiten breit. Mit denselben Daten ist alles zwischen “gross” und “extrem gross” vereinbar.
Intervall bei n = 30 siehe Ausgabe Es schrumpft mit wachsendem n, aber langsam: Für eine Halbierung der Breite braucht es viermal so viele Fälle.

Warum die Intervalle zwischen den Verfahren abweichen. Die Hilfsfunktion auf dieser Seite verwendet eine Normalapproximation, damit R und Python dieselbe Zahl liefern und die Rechnung nachvollziehbar bleibt. Das Paket effectsize rechnet über die nichtzentrale t-Verteilung und ist damit genauer, besonders bei kleinem n und grossem \(d\). Die Grössenordnung ist dieselbe, die Grenzen unterscheiden sich.

Für einen Bericht ist die Paketvariante die richtige Wahl. Für das Verständnis ist die Formel nützlich: Der Standardfehler von \(d\) hängt fast nur an n, und deshalb sind Effektstärken aus kleinen Studien grundsätzlich unzuverlässig.

Interpretation

Die verbreitete Praxis, eine Effektstärke als blosse Zahl zu berichten, verdeckt diese Unsicherheit. Bei zwölf Fällen je Gruppe ist die Angabe “\(d = 1.78\)” technisch richtig und praktisch wenig wert; “\(d = 1.78\), Intervall 0.83 bis 2.72” ist ehrlich.

Das erklärt auch, warum Effektstärken aus kleinen Studien in Metaanalysen regelmässig nach unten korrigiert werden: Kleine Studien, die es überhaupt in eine Veröffentlichung schaffen, haben meist überschätzte Effekte, weil nur die zufällig grossen signifikant wurden.

Frage und Datenlage

\(d = 0.5\)” sagt Fachleuten etwas und sonst niemandem. Welche Übersetzungen gibt es, und was sagen sie?

Rechnung

uebersetzung <- function(d) {
  round(c(d = d,
          r = d / sqrt(d^2 + 4),
          CLES = pnorm(d / sqrt(2)),
          ueberlappung = 2 * pnorm(-abs(d) / 2),
          ueber_median_A = pnorm(d)), 4)
}

t(sapply(c(0.2, 0.5, 0.8, 1.2, 1.78), uebersetzung))
        d      r   CLES ueberlappung ueber_median_A
[1,] 0.20 0.0995 0.5562       0.9203         0.5793
[2,] 0.50 0.2425 0.6382       0.8026         0.6915
[3,] 0.80 0.3714 0.7142       0.6892         0.7881
[4,] 1.20 0.5145 0.8019       0.5485         0.8849
[5,] 1.78 0.6648 0.8959       0.3735         0.9625
def uebersetzung(d):
    return {
        "d": d,
        "r": d / np.sqrt(d ** 2 + 4),
        "CLES": stats.norm.cdf(d / np.sqrt(2)),
        "ueberlappung": 2 * stats.norm.cdf(-abs(d) / 2),
        "ueber_median_A": stats.norm.cdf(d),
    }


print(pd.DataFrame([uebersetzung(d) for d in (0.2, 0.5, 0.8, 1.2, 1.78)]).round(4))
      d       r    CLES  ueberlappung  ueber_median_A
0  0.20  0.0995  0.5562        0.9203          0.5793
1  0.50  0.2425  0.6382        0.8026          0.6915
2  0.80  0.3714  0.7142        0.6892          0.7881
3  1.20  0.5145  0.8019        0.5485          0.8849
4  1.78  0.6648  0.8959        0.3735          0.9625

Output Zeile für Zeile

\(d\) \(r\) CLES Überlappung Anteil über dem Median von A
0.2 0.100 0.556 0.920 0.579
0.5 0.243 0.638 0.803 0.691
0.8 0.371 0.714 0.689 0.788
1.2 0.514 0.802 0.549 0.885
1.78 0.665 0.896 0.374 0.962
Übersetzung Wie sie sich liest
\(r\) Für den Vergleich mit Korrelationsstudien. Bemerkenswert: Ein “grosses” \(d\) von 0.8 entspricht einem \(r\) von 0.37, das für sich genommen als mittel gilt. Die Anhaltspunkte der beiden Masse passen nicht zueinander.
CLES “Greift man je einen Fall aus beiden Gruppen heraus, liegt der aus B in X Prozent der Fälle höher.” Die beste Zahl für Nichtfachleute.
Überlappung “So viel Prozent der beiden Verteilungen liegen übereinander.” Macht deutlich, wie viel Gemeinsamkeit auch bei grossen Effekten bleibt.
Anteil über dem Median von A “So viele aus B liegen über der Hälfte von A.” Nützlich, wenn eine Schwelle inhaltlich bedeutsam ist.

Interpretation

Die Zeile für \(d = 0.5\) ist die lehrreichste. Ein “mittlerer” Effekt bedeutet: Die beiden Verteilungen überlappen zu 80 Prozent, und in gut einem Drittel aller Paarvergleiche liegt die Kontrollgruppe höher. Wer das ausspricht, erzeugt ein sehr viel realistischeres Bild als “mittlerer Effekt, p < 0.05”.

Umgekehrt zeigt die letzte Zeile, wie ungewöhnlich der Effekt aus Beispiel 1 ist: Bei \(d = 1.78\) überlappen die Verteilungen nur noch zu 37 Prozent. Solche Werte kommen in erhobenen Daten selten vor und sind ein Anlass zu prüfen, ob die beiden Gruppen sich nicht in etwas anderem unterscheiden als gedacht.

Verständnisfragen

Zwei Studien finden dieselbe Mittelwertdifferenz von 0.5 Einheiten. Studie A berichtet \(d = 1.78\), Studie B \(d = 0.35\). Wie ist das möglich?

Die Streuung in den Gruppen ist verschieden
Richtig. Cohens \(d\) misst die Differenz in Einheiten der gepoolten Standardabweichung. Bei enger Streuung ist dieselbe Differenz ein grosser Effekt, bei weiter ein kleiner.
Eine der beiden hat sich verrechnet
Beide können korrekt gerechnet haben; \(d\) hängt eben nicht nur an der Differenz.
Die Stichprobenumfänge sind verschieden
Der Umfang beeinflusst \(d\) nicht, sondern nur seine Unsicherheit und den p-Wert.

Ein Versuch mit n = 400 je Gruppe liefert p < 0.001 bei \(d = 0.14\). Wie ist das zu berichten?

Als nachweisbarer, aber sehr kleiner Effekt, mit der Differenz in ihrer Einheit
Richtig. Der p-Wert sagt nur, dass der Effekt bei diesem Umfang vom Zufall unterscheidbar ist. Ob er zählt, entscheidet die Effektstärke und die Sache.
Als starker Nachweis eines Effekts
Stark ist der Nachweis, nicht der Effekt. Die beiden Wörter meinen Verschiedenes.
Gar nicht, \(d = 0.14\) liegt unter der Schwelle für “klein”
Berichtet wird, was gefunden wurde; die Einordnung gehört dazu, das Verschweigen nicht.

Warum sollte bei zwölf Fällen je Gruppe Hedges \(g\) statt Cohens \(d\) berichtet werden?

Weil \(d\) bei kleinen Stichproben systematisch zu gross ausfällt
Richtig. Der Korrekturfaktor beträgt hier rund 0.965 und wird mit sinkendem n grösser. Ab etwa 50 Fällen insgesamt ist der Unterschied belanglos.
Weil \(g\) ein Konfidenzintervall hat und \(d\) nicht
Beide haben eines.
Weil \(d\) eine Normalverteilung voraussetzt und \(g\) nicht
Die Voraussetzungen sind dieselben.

Ein Effekt von \(d = 0.5\) gilt als mittel. Was bedeutet das anschaulich?

Die Verteilungen überlappen zu 80 Prozent; in gut einem Drittel der Paarvergleiche liegt die Kontrollgruppe höher
Richtig. Die Common Language Effect Size beträgt 0.638, also gewinnt die Vergleichsgruppe in 36 Prozent der Vergleiche. “Mittel” klingt deutlicher, als es ist.
Die Hälfte der Fälle verbessert sich
Effektstärken beschreiben Verteilungen, nicht Anteile von Personen mit einer Veränderung.
Der Unterschied beträgt 50 Prozent
\(d\) ist kein Prozentwert, sondern ein Vielfaches der Standardabweichung.

Verlinkte Ressourcen