Typische Fragestellungen: Kündigen Monatsverträge früher als Jahresverträge, fallen Bauteile eines Lieferanten früher aus, unterscheiden sich zwei Behandlungen in der Zeit bis zum Rückfall.
Der Test ist der statistische Nachbau dessen, was man in zwei Kaplan-Meier-Kurven sieht. Er sagt, ob der Abstand mit Zufall vereinbar ist. Er sagt nicht, wie gross der Unterschied ist: Es gibt kein Effektmass. Wer eines braucht, nimmt das Cox-Modell, dessen Hazard Ratio genau diese Lücke füllt.
Der Test geht jeden Zeitpunkt durch, an dem ein Ereignis eintritt, und fragt: Wie viele Ereignisse wären in dieser Gruppe zu erwarten, wenn beide Gruppen dasselbe Risiko hätten? Erwartet wird proportional zur Anzahl unter Risiko. Beobachtete und erwartete Ereignisse werden über alle Zeitpunkte summiert und verglichen.
\[\chi^2 = \frac{(O_1 - E_1)^2}{V}\]
Bestandteil
Bedeutung
\(O_g\)
beobachtete Ereignisse in Gruppe \(g\) über alle Zeitpunkte
\(E_g\)
erwartete Ereignisse unter der Nullhypothese gleicher Hazard-Raten
\(V\)
Varianz der Differenz, aus der Anzahl unter Risiko je Zeitpunkt
Freiheitsgrade
Anzahl Gruppen minus eins
Der Erwartungswert an einem Zeitpunkt \(t_i\) ist \(E_{1i} = d_i \cdot n_{1i} / n_i\), die Ereignisse dieses Zeitpunkts, aufgeteilt nach dem Anteil der Gruppe an allen unter Risiko. Man kann das als eine Kette von Vierfeldertafeln lesen, eine je Ereigniszeitpunkt, deren Abweichungen aufsummiert werden.
Die Nullhypothese lautet, dass die Überlebensfunktionen der Gruppen identisch sind. Weil der Test über alle Zeitpunkte summiert, ist er am schärfsten, wenn der Unterschied in eine Richtung geht und über die Zeit ähnlich bleibt. Genau das ist seine Stärke und seine Schwäche.
Der Test prüft eine an den Daten optimierte Grenze
Gruppen inhaltlich definieren
Kurven kreuzen sich nicht
Der Unterschied wechselt nicht die Richtung
Kaplan-Meier-Kurven ansehen
Test verliert Schärfe, kann nichts finden, obwohl Unterschiede bestehen
abschnittsweise vergleichen, gewichtete Varianten
Genügend Ereignisse
Nicht die Fallzahl zählt, sondern die Ereigniszahl
Ereignisse je Gruppe zählen
Test hat kaum Schärfe
Beobachtungszeit verlängern, Gruppen zusammenfassen
Output lesen
R, survdiff():
Grösse
Was sie sagt
Faustregel oder Falle
N
Anzahl Beobachtungen je Gruppe
nicht ausschlaggebend für die Schärfe
Observed
beobachtete Ereignisse je Gruppe
die Grösse, die zählt
Expected
erwartete Ereignisse unter gleicher Hazard-Rate
berücksichtigt die Zeit unter Risiko
(O-E)^2/E
Beitrag der Gruppe zur Statistik
zeigt, welche Gruppe die Abweichung treibt
(O-E)^2/V
varianzgewichteter Beitrag
bei zwei Gruppen in beiden Zeilen gleich und identisch mit Chisq
Chisq
Teststatistik
ohne Freiheitsgrade nicht deutbar
df
Freiheitsgrade, Gruppen minus eins
bei zwei Gruppen eins
p
p-Wert
keine Aussage über die Grösse des Unterschieds
Wichtiger als die Statistik ist der Vergleich von Observed und Expected: Er zeigt die Richtung. Mehr beobachtete als erwartete Ereignisse heisst höheres Risiko in dieser Gruppe.
Python, logrank_test(...).print_summary():
Grösse
Was sie sagt
Unterschied zu R
test_statistic
Chi-Quadrat-Statistik
wie Chisq
p
p-Wert
wie p
-log2(p)
p-Wert als Bits
in R nicht enthalten, nur eine andere Skala
test_name
verwendete Variante
benennt, ob gewichtet gerechnet wurde
Was in Python fehlt, sind die beobachteten und erwarteten Ereignisse je Gruppe. Die Richtung muss man sich also getrennt verschaffen, etwa über die Kaplan-Meier-Mediane oder eine eigene Rechnung (Beispiel 1 zeigt sie). Wer den vollständigen Vergleich braucht, rechnet zusätzlich ein Cox-Modell, dessen Hazard Ratio Richtung und Grösse in einer Zahl liefert.
Interpretationsfallen
Kein Effektmass. Der Test liefert keine Grösse des Unterschieds. Ein kleiner p-Wert bei grosser Ereigniszahl kann einen unbedeutenden Unterschied betreffen.
Nicht signifikant ist kein Beweis für Gleichheit. Entscheidend ist die Zahl der Ereignisse, nicht die der Beobachtungen.
Kreuzende Kurven machen den Test blind. Vorher ansehen, nicht nachher erklären.
Der Test prüft die ganzen Kurven. Wer eine Aussage zu zwölf Monaten braucht, vergleicht Anteile mit Konfidenzintervall.
Keine Kontrolle weiterer Grössen. Ein Gruppenunterschied kann von einer dritten Variablen kommen; hier ist es das Cox-Modell, das kontrolliert.
Gruppen nicht nachträglich bilden. Eine an den Daten optimierte Grenze macht den p-Wert wertlos.
Mehrere Gruppen bedeuten mehrere Vergleiche. Der Gesamttest sagt nur, dass irgendwo ein Unterschied besteht; paarweise Vergleiche brauchen eine Korrektur, siehe multiples Testen.
Ergebnis berichten
Vorlage für den Ergebnissatz:
Die Überlebenskurven unterscheiden sich zwischen [Gruppen] (Log-Rank-Test, Chi-Quadrat([df]) = [Wert], p = [p]). In [Gruppe] traten [beobachtet] Ereignisse gegenüber [erwartet] erwarteten auf; der Median beträgt [Median] gegenüber [Median] [Einheit].
Genannt werden Teststatistik mit Freiheitsgraden und p-Wert, Ereigniszahlen je Gruppe, beobachtete gegenüber erwarteten Ereignissen als Richtungsangabe, die Mediane oder Anteile zu festen Zeitpunkten, und die Feststellung, dass die Kurven sich nicht kreuzen.
Beispiel 1 rechnet den Test an zehn Fällen vollständig von Hand nach. Die Beispiele 2 und 3 verwenden den Abo-Datensatz aus Kaplan-Meier (400 Fitnessabos, Stichtag nach 24 Monaten); die Beispiele 4 und 5 zwei eigens dafür konstruierte Datensätze.
taucht nirgends als eigene Zeile auf, senkt aber ab \(t = 5\) die Spalten \(n_i\) und \(n_{Ai}\). Genau wie bei Kaplan-Meier.
\(E_{Ai}\) bei \(t = 3\)
Zwei Ereignisse, vier von neun unter Risiko gehören zu A → erwartet werden 0.889 Ereignisse in A. Beobachtet wird eines.
Die Erwartung ist nie ganzzahlig
Sie ist keine Zählung, sondern ein Anteil. Erst die Summe ist mit der beobachteten Zählung vergleichbar.
\(V_i\) bei \(t = 10\) ist null
Nur noch ein Fall unter Risiko, und der gehört zu B: An diesem Zeitpunkt ist nichts mehr zu verteilen. Der Schritt trägt zur Statistik nichts bei.
\(O_A = 4\) gegen \(E_A = 3.12\)
Gruppe A hatte etwas mehr Ereignisse als erwartet, eine Abweichung in der Grössenordnung eines knappen Ereignisses.
\(\chi^2 = 0.47\), \(p = 0.49\)
Vollkommen mit Zufall vereinbar. Bei sieben Ereignissen insgesamt wäre auch schwer etwas anderes zu erwarten.
Die Varianz \(V_i\) ist die der hypergeometrischen Verteilung: Aus \(n_i\) Fällen, von denen \(n_{Ai}\) zu A gehören, werden \(d_i\) “gezogen” (die Ereignisse). Der Faktor\(\frac{n_i - d_i}{n_i - 1}\) ist die Korrektur für das Ziehen ohne Zurücklegen, er wird null, wenn alle Verbliebenen ein Ereignis haben, weil dann nichts mehr zufällig ist.
Interpretation und Ergebnissatz
Ein Unterschied zwischen den Gruppen lässt sich nicht nachweisen (Log-Rank-Test, \(\chi^2\)(1) = 0.47, p = 0.49; 4 beobachtete gegenüber 3.1 erwarteten Ereignissen in Gruppe A bei insgesamt 7 Ereignissen).
Frage und Datenlage
Zwei Dinge gehören geprüft, bevor der Test gerechnet wird: ob genügend Ereignisse vorliegen, nicht Fälle und ob die Kurven sich kreuzen.
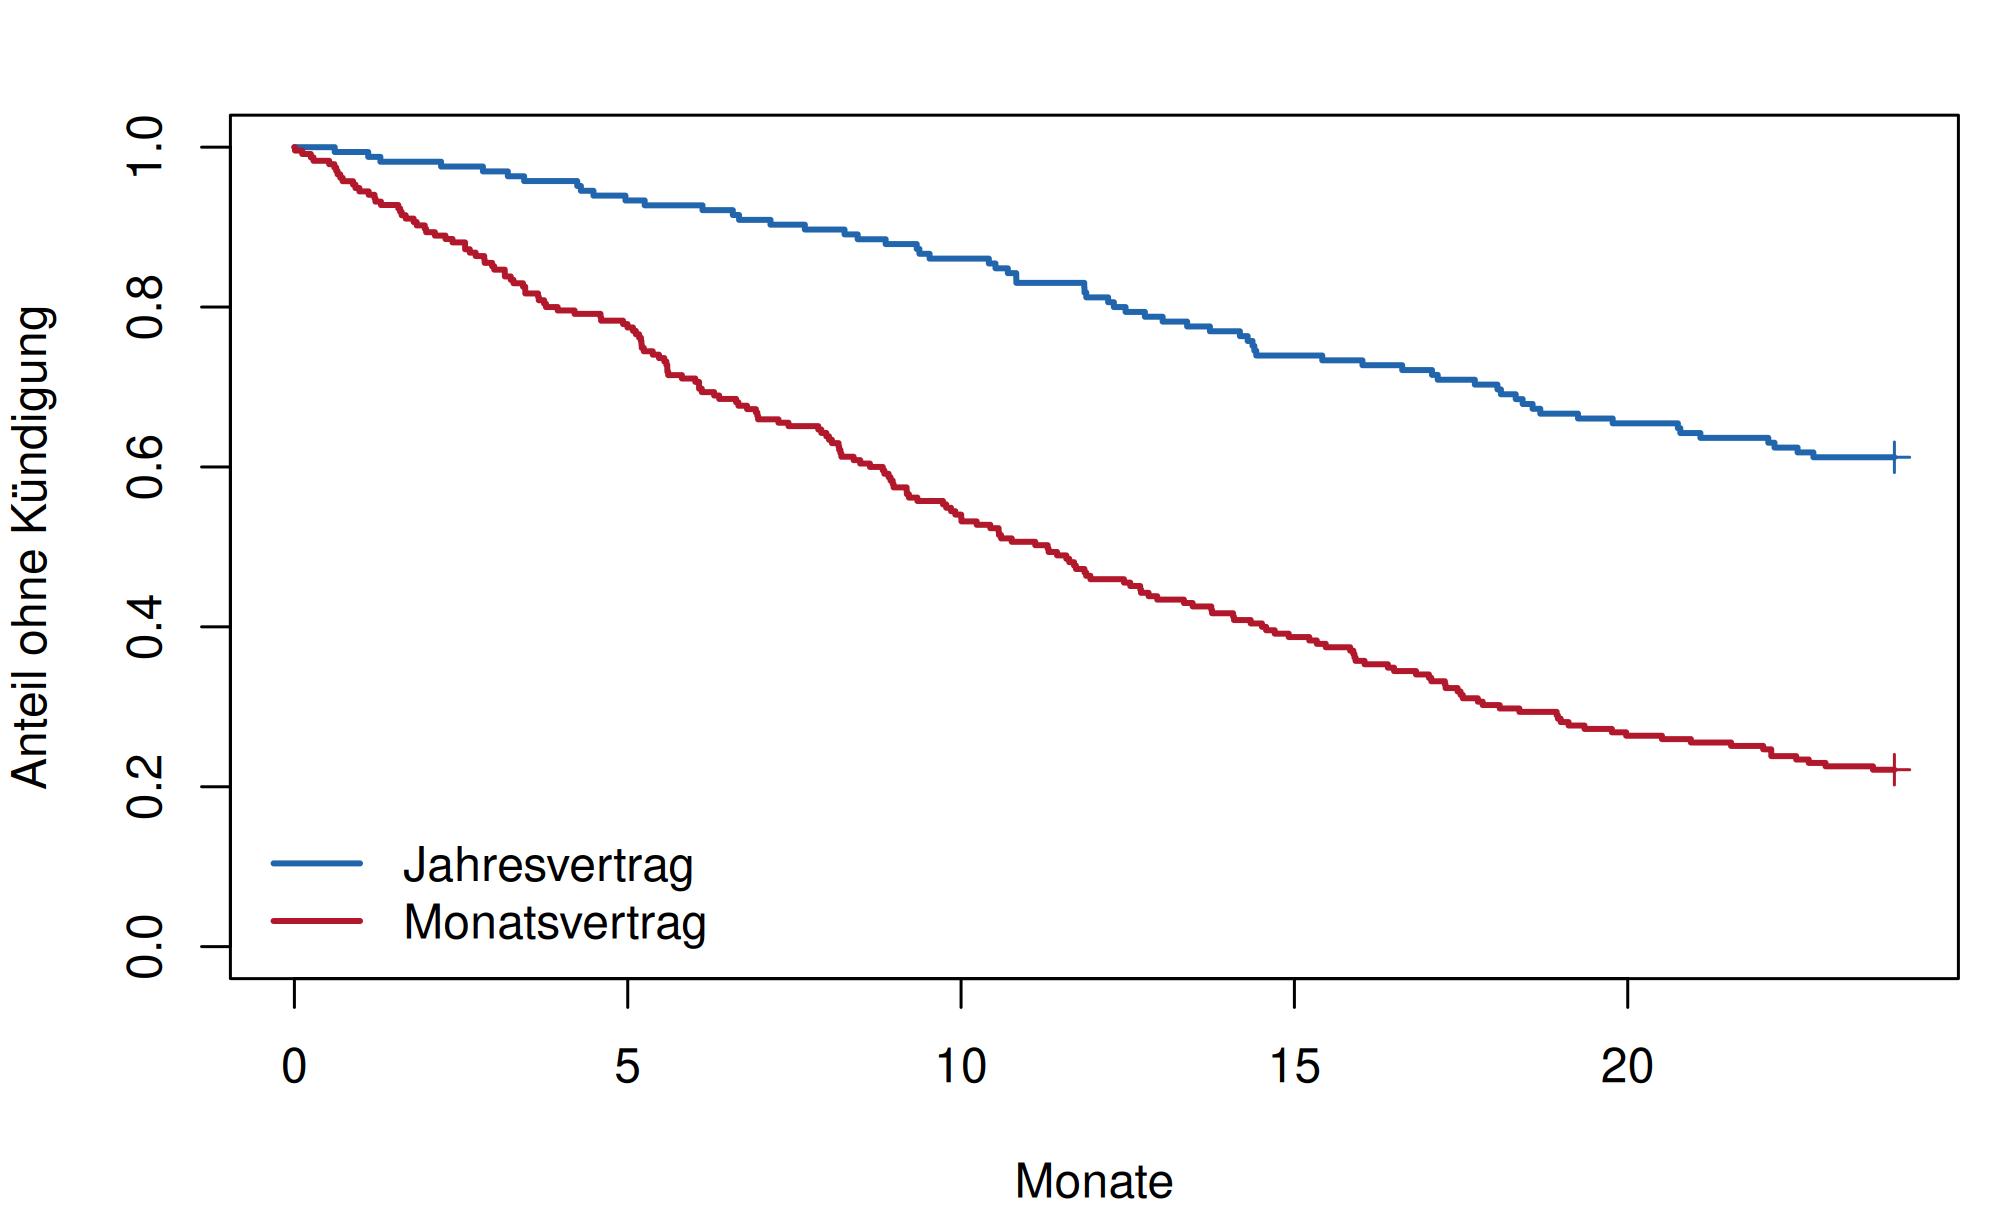
Abbildung 1: Beispiel 2: die Kurven trennen sich früh und kreuzen sich nicht. Genau dafür ist der Test gebaut.
print(pd.crosstab(abo["vertrag"], abo["status"]))
status     0    1
vertrag
Jahr     101   64
Monat     52  183
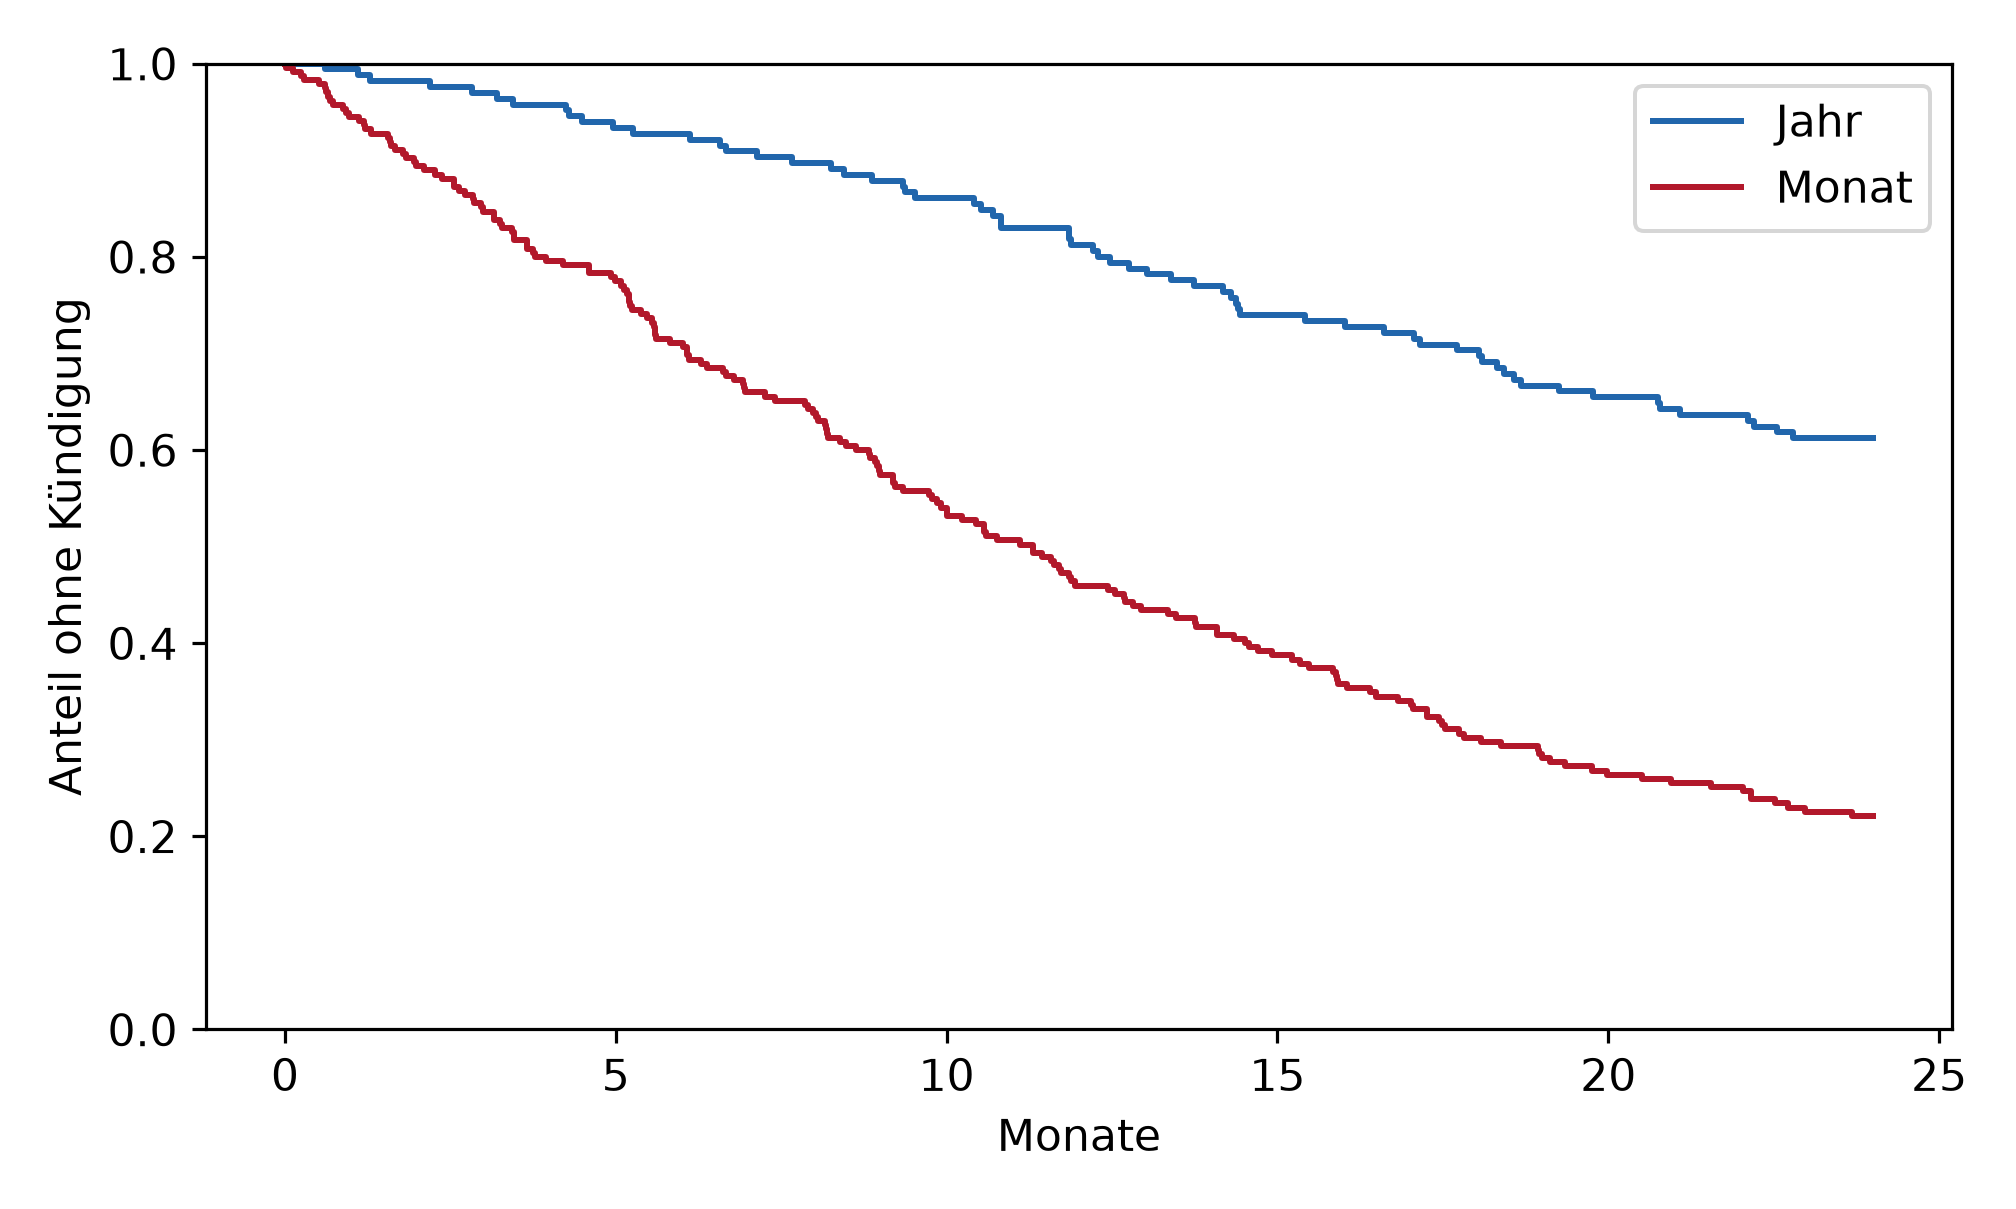
fig, achse = plt.subplots()for name, farbe in [("Jahr", "#2166ac"), ("Monat", "#b2182b")]: teil = abo[abo["vertrag"] == name] KaplanMeierFitter().fit(teil["zeit"], teil["status"], label=name) \ .plot_survival_function(ax=achse, ci_show=False, color=farbe)achse.set_xlabel("Monate")achse.set_ylabel("Anteil ohne Kündigung")achse.set_ylim(0, 1)
(0.0, 1.0)
plt.tight_layout()plt.show()
Abbildung 2: Beispiel 2: dieselbe Prüfung in Python.
Output Zeile für Zeile
Vertragsart
zensiert (0)
Ereignis (1)
n
Jahr
101
64
165
Monat
52
183
235
Prüfpunkt
Befund
Bewertung
Ereignisse je Gruppe
64 und 183
Reichlich. Als grobe Faustregel gelten etwa zehn Ereignisse je Gruppe als untere Grenze für einen aussagekräftigen Test; hier ist das um ein Vielfaches erfüllt.
Fälle je Gruppe
165 und 235
Diese Zahlen sind nicht die entscheidenden. Ein Datensatz mit 5000 Fällen und 8 Ereignissen liefert einen schwachen Test.
Verlauf der Kurven
trennen sich in den ersten Monaten und bleiben getrennt
Kein Kreuzen. Der Unterschied hat über den ganzen Zeitraum dasselbe Vorzeichen, der Fall, für den der Test gebaut ist.
Zensierungsanteil je Gruppe
61 Prozent gegen 22 Prozent
Ungleich, aber unproblematisch: Die Zensierung ist rein administrativ (alle am Stichtag), und dass die Gruppe mit dem geringeren Risiko den Stichtag häufiger erreicht, ist die Folge des Effekts, nicht seine Ursache.
Interpretation
Beide Voraussetzungen sind erfüllt; der Test darf gerechnet werden. Diese Reihenfolge, erst Kurven, dann Test, ist keine Formalie, wie Beispiel 5 zeigt.
Frage und Datenlage
Unterscheidet sich die Laufzeit von Monats- und Jahresverträgen?
def beobachtet_erwartet(daten, spalte, gruppe):"""Was lifelines nicht ausgibt: O und E je Gruppe.""" zeit, status = daten["zeit"].values, daten["status"].values ist_gruppe = (daten[spalte] == gruppe).values O = E =0.0for tt insorted(set(zeit[status ==1])): unter_risiko = zeit >= tt ereignis = (zeit == tt) & (status ==1) O += (ereignis & ist_gruppe).sum() E += ereignis.sum() * (unter_risiko & ist_gruppe).sum() / unter_risiko.sum()return O, Efor name in ["Jahr", "Monat"]: O, E = beobachtet_erwartet(abo, "vertrag", name) km = KaplanMeierFitter().fit(abo.loc[abo["vertrag"] == name, "zeit"], abo.loc[abo["vertrag"] == name, "status"]) anteile = km.survival_function_at_times([12, 24]).round(3).valuesprint(f"{name:6s} O = {O:5.0f} E = {E:6.1f} O/E = {O / E:.2f}"f" S(12) = {anteile[0]:.3f} S(24) = {anteile[1]:.3f}")
Jahr   O =    64  E =  128.9  O/E = 0.50  S(12) = 0.812  S(24) = 0.612
Monat  O =   183  E =  118.1  O/E = 1.55  S(12) = 0.460  S(24) = 0.221
Output Zeile für Zeile
Gruppe
n
beobachtet \(O\)
erwartet \(E\)
\(O/E\)
\(\hat{S}(12)\)
\(\hat{S}(24)\)
Jahresvertrag
165
64
128.9
0.50
0.812
0.612
Monatsvertrag
235
183
118.1
1.55
0.460
0.221
gesamt
400
247
247.0
\[\chi^2(1) = 69.66, \qquad p = 7 \cdot 10^{-17}\]
Ausgabe
Wert hier
Wie er zu lesen ist
\(E\) summiert sich auf 247
Die Erwartungen verteilen genau die tatsächlich eingetretenen Ereignisse auf die Gruppen um. Deshalb ist \(O - E\) in einer Gruppe immer das Negative der anderen: -64.9 und +64.9.
\(O/E = 0.50\) bei Jahresverträgen
halb so viele Kündigungen wie erwartet
Bei gleichem Risiko in beiden Gruppen wären hier 129 Kündigungen aufgetreten. Es waren 64.
\(O/E = 1.55\) bei Monatsverträgen
rund die Hälfte mehr als erwartet
Die Richtung des Effekts steht hier und nirgendwo sonst im Testergebnis.
\(\chi^2(1) = 69.66\)
Bei einem Freiheitsgrad. Der kritische Wert für 5 Prozent liegt bei 3.84, der beobachtete Wert übertrifft ihn um das Achtzehnfache.
\(p = 7 \cdot 10^{-17}\)
praktisch null
Berichtet wird “p < .001”. Weitere Stellen anzugeben, suggeriert eine Genauigkeit, die der Test nicht hat.
\(\hat{S}(12)\): 0.812 gegen 0.460
Das ist die Grösse des Unterschieds. Sie steht nicht im Test.
Das Verhältnis \(O/E\) liegt nahe bei dem, was ein Cox-Modell als Hazard Ratio schätzen würde (\(1.55 / 0.50 \approx 3.1\)), ist aber kein Effektmass im eigentlichen Sinn: Es hat keinen Standardfehler, kein Konfidenzintervall, und es hängt an der Zusammensetzung der Risikomengen. Als Richtungsangabe taugt es, als berichtete Effektstärke nicht.
Interpretation und Ergebnissatz
Die Laufzeit unterscheidet sich deutlich zwischen den Vertragsarten (Log-Rank-Test, \(\chi^2\)(1) = 69.7, p < .001, n = 400 mit 247 Kündigungen). Bei Monatsverträgen traten 183 Kündigungen gegenüber 118 unter gleichem Risiko erwarteten auf, bei Jahresverträgen 64 gegenüber 129. Nach zwölf Monaten bestehen noch 46.0 Prozent der Monats- und 81.2 Prozent der Jahresverträge.
Frage und Datenlage
Zwei Gruppen zu je 100 Fällen, die aus derselben Verteilung stammen. Der Test sollte nichts finden und was heisst das dann?
for name in ["A", "B"]: O, E = beobachtet_erwartet(abo_b, "gruppe", name)print(f"Gruppe {name}: O = {O:.0f} E = {E:.1f}")
Gruppe A: O = 50  E = 50.2
Gruppe B: O = 51  E = 50.8
Output Zeile für Zeile
Gruppe
n
beobachtet
erwartet
Differenz
A
100
50
50.2
-0.2
B
100
51
50.8
+0.2
\[\chi^2(1) = 0.002, \qquad p = 0.96\]
Ausgabe
Wie sie zu lesen ist
\(O\) und \(E\) praktisch identisch
Genau das Bild, das unter der Nullhypothese zu erwarten ist.
\(\chi^2 = 0.002\)
Nahe null. Solche Werte sind unter der Nullhypothese normal, aber nicht “besonders bestätigend”, auch \(\chi^2 = 2.5\) wäre unauffällig.
\(p = 0.96\)
Ein hoher p-Wert ist kein Beleg für Gleichheit. Er sagt nur: Diese Daten sind mit gleichen Kurven vereinbar.
101 Ereignisse insgesamt
Die entscheidende Zahl für die Aussagekraft. Mit 101 Ereignissen würde ein Hazard Ratio von etwa 1.5 zuverlässig gefunden, eines von 1.15 aber meist nicht.
Was ein Nullbefund berichtsfähig macht: die Angabe, wie gross ein Effekt hätte sein müssen, um bei dieser Ereigniszahl entdeckt zu werden. Praktisch geschieht das über ein Cox-Modell: Sein Konfidenzintervall für das Hazard Ratio zeigt unmittelbar, welche Effektgrössen die Daten noch zulassen, dieselbe Logik wie beim Konfidenzintervall gegenüber dem p-Wert.
Interpretation und Ergebnissatz
Ein Unterschied zwischen den Gruppen lässt sich nicht nachweisen (Log-Rank-Test, \(\chi^2\)(1) = 0.00, p = 0.96; 50 gegenüber 51 Ereignissen bei je 100 Fällen). Ob kleinere Unterschiede bestehen, lässt sich mit dieser Ereigniszahl nicht entscheiden.
Frage und Datenlage
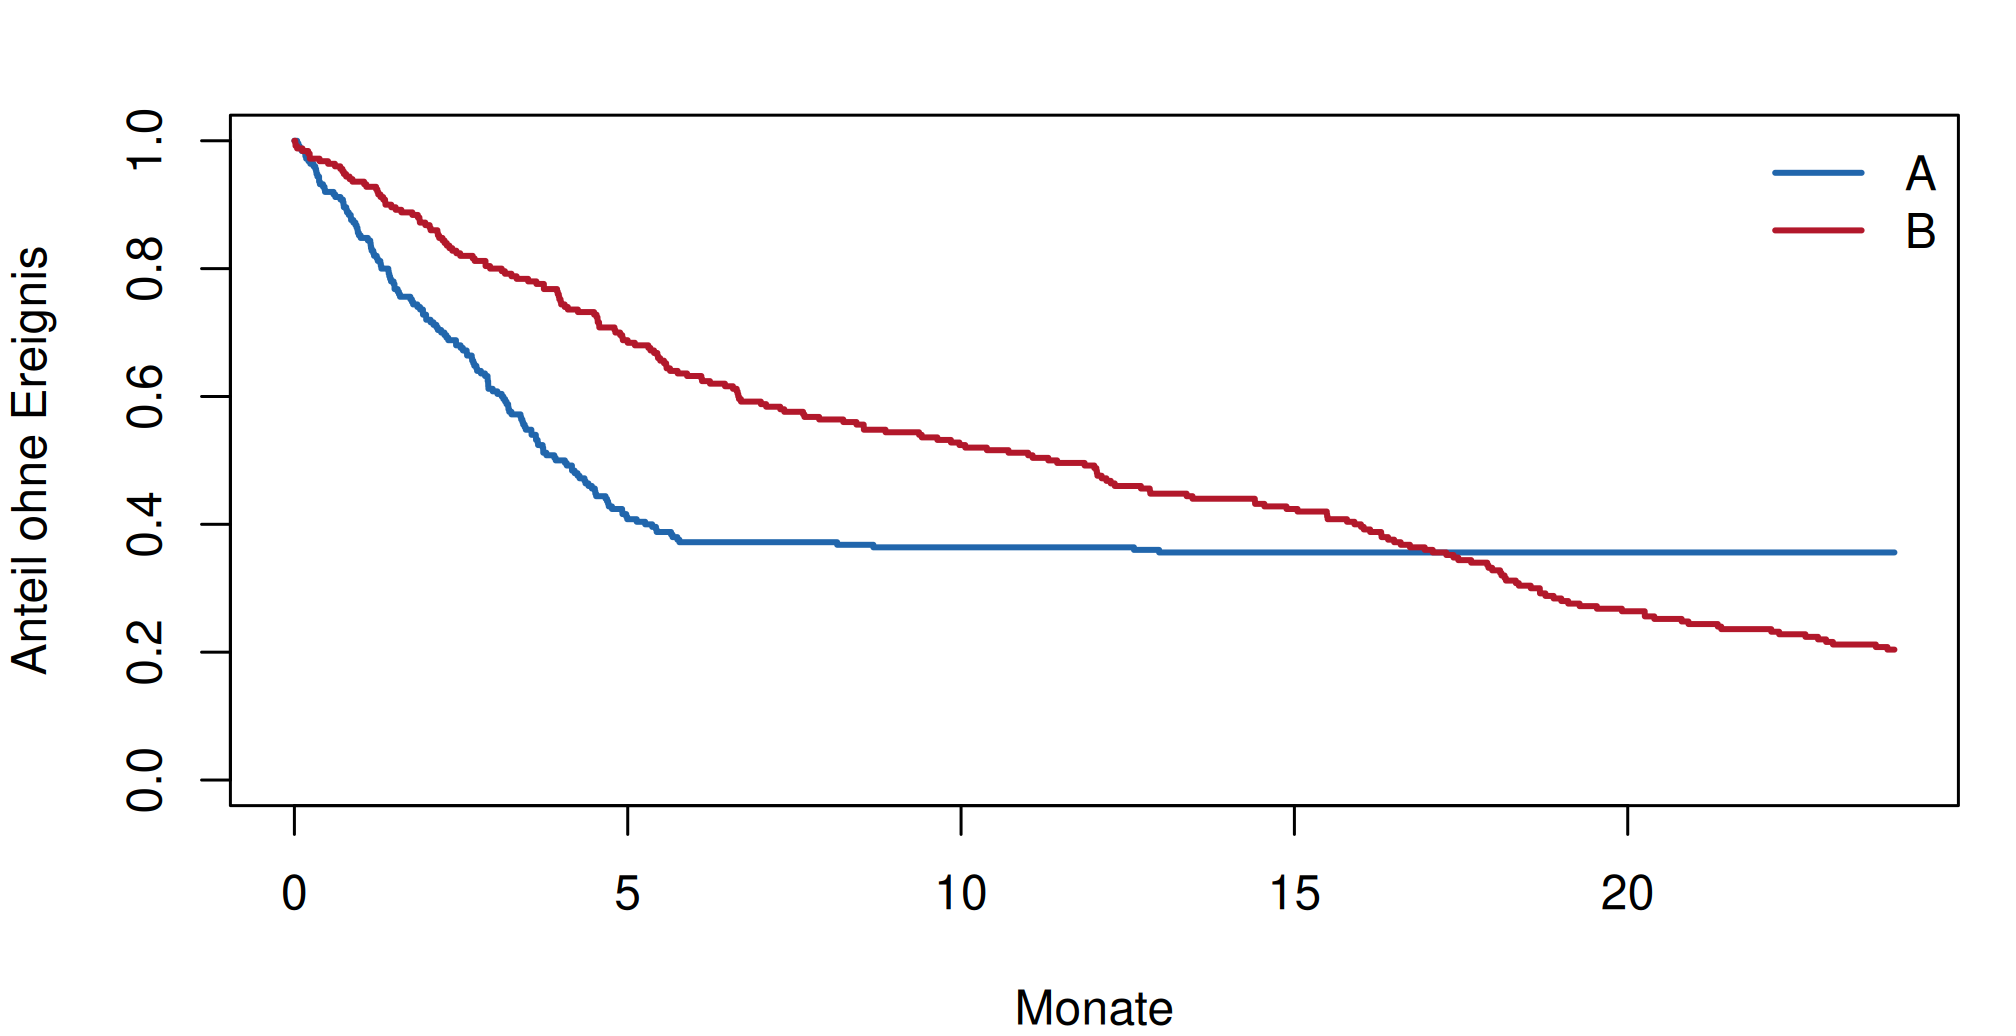
Der wichtigste Fallstrick des Verfahrens. Zwei Gruppen zu je 250 Fällen:
Gruppe A hat in den ersten sechs Monaten ein hohes Risiko, danach ein sehr niedriges, das Muster einer Operation mit früher Komplikationsgefahr und gutem Verlauf danach.
Gruppe B hat durchgehend ein mittleres Risiko.
Die beiden Kurven kreuzen sich. Was macht der Test daraus?
# Getrennt nach Zeitabschnitt: erst alles bei Monat 6 zensieren, dann# nur die betrachten, die Monat 6 ueberlebt habenfrueh_teil = kreuz.assign( z=np.minimum(kreuz["zeit"], 6), s=((kreuz["status"] ==1) & (kreuz["zeit"] <=6)).astype(int))spaet_teil = kreuz[kreuz["zeit"] >6]for name, daten, zs in [("Monate 0 bis 6", frueh_teil, ("z", "s")), ("Monate 6 bis 24", spaet_teil, ("zeit", "status"))]: ta = daten[daten["gruppe"] =="A"] tb = daten[daten["gruppe"] =="B"] t = logrank_test(ta[zs[0]], tb[zs[0]], ta[zs[1]], tb[zs[1]])print(f"{name}: chi2 = {t.test_statistic:.2f}, p = {t.p_value:.3g}")
Monate 0 bis 6: chi2 = 37.60, p = 8.67e-10
Monate 6 bis 24: chi2 = 86.60, p = 1.33e-20
Output Zeile für Zeile
Zuerst die Kurven in Zahlen:
Gruppe
\(\hat{S}(6)\)
\(\hat{S}(24)\)
Ereignisse
A
0.372
0.356
161
B
0.632
0.204
199
Nach sechs Monaten steht A deutlich schlechter (37 gegen 63 Prozent), nach 24 Monaten deutlich besser (36 gegen 20 Prozent). Die Kurven kreuzen sich.
Und nun die Tests:
Vergleich
\(\chi^2\)
p
Gesamter Zeitraum
0.004
0.95
Monate 0 bis 6
37.60
\(9 \cdot 10^{-10}\)
Monate 6 bis 24
86.61
\(1 \cdot 10^{-20}\)
Beobachtung
Erklärung
Der Gesamttest findet nichts
\(\chi^2 = 0.004\) ist so nahe an null, wie es überhaupt geht. Ein Bericht, der nur diese Zeile enthält, sagt “kein Unterschied nachweisbar”, bei zwei Gruppen, die kaum verschiedener sein könnten.
Beide Teilabschnitte finden sehr viel
Und zwar mit entgegengesetztem Vorzeichen: In den ersten sechs Monaten hat A mehr Ereignisse als erwartet, danach dramatisch weniger.
Warum sich das aufhebt
Der Test summiert \(O_i - E_i\) über alle Zeitpunkte, bevor er quadriert. Frühe positive und späte negative Abweichungen kürzen sich in dieser Summe. Erst danach wird das Quadrat gebildet, es ist also nicht so, dass Abweichungen “unabhängig vom Vorzeichen” zählen würden.
Woran man es erkennt
Nur am Bild. Die Teststatistik selbst gibt keinen Hinweis auf das Problem; ein kleines \(\chi^2\) sieht bei kreuzenden Kurven genauso aus wie bei tatsächlich gleichen Kurven.
Die abschnittsweisen p-Werte sind hier eine Veranschaulichung, kein Berichtsergebnis. Wer die Grenze bei sechs Monaten nach dem Blick auf die Kurven wählt, hat einen an den Daten optimierten Schnitt gesetzt, und die p-Werte sind dadurch zu klein. Zulässig ist das Vorgehen nur mit einer vorab aus der Sache begründeten Grenze, hier etwa “Ende der postoperativen Phase”.
Die sauberen Alternativen: ein Cox-Modell mit zeitabhängigem Effekt, das den Wechsel selbst schätzt, oder eine vorab festgelegte gewichtete Variante des Tests (Gehan-Wilcoxon betont frühe, Fleming-Harrington je nach Parameter frühe oder späte Unterschiede).
Interpretation und Ergebnissatz
Die Überlebenskurven kreuzen sich bei etwa sechs Monaten; Gruppe A hat früh ein deutlich höheres, später ein deutlich niedrigeres Risiko. Ein einzelner Log-Rank-Test über den ganzen Zeitraum (\(\chi^2\)(1) = 0.00, p = 0.95) ist deshalb nicht aussagekräftig, die gegenläufigen Abweichungen heben sich auf. Berichtet werden die Anteile zu festen Zeitpunkten (nach 6 Monaten 37.2 gegen 63.2 Prozent, nach 24 Monaten 35.6 gegen 20.4 Prozent) und ein Modell mit zeitabhängigem Effekt.
Verständnisfragen
Der Test ergibt p = 0.6, die Gruppen haben je 150 Beobachtungen, aber nur 18 und 21 Ereignisse. Was folgt?
Die Gruppen unterscheiden sich nicht
Das behauptet mehr, als die Daten tragen.
Mit so wenigen Ereignissen hat der Test kaum Schärfe
Richtig. Die Genauigkeit hängt an der Ereigniszahl, nicht an der Fallzahl. Bei 39 Ereignissen insgesamt bleiben auch deutliche Unterschiede unentdeckt.
Die Beobachtungszeit war zu lang
Eine längere Beobachtung würde mehr Ereignisse liefern und den Test schärfen.
Die Kaplan-Meier-Kurven kreuzen sich bei etwa sechs Monaten. Der Log-Rank-Test über den ganzen Zeitraum ergibt p = 0.95. Wie ist das zu deuten?
Der Test ist hier nicht aussagekräftig, weil sich die Beiträge aufheben
Richtig. Er summiert die Abweichungen über die Zeit, bevor er quadriert; entgegengesetzte Abweichungen kürzen sich. Die Frage muss lauten, wann sich die Gruppen unterscheiden.
Die Gruppen sind über den ganzen Verlauf gleich
Genau das widerlegen die kreuzenden Kurven.
Die Kurven kreuzen sich nur zufällig
Möglich, aber dann zeigt man es an den Konfidenzbändern, statt den Gesamttest zu deuten.
Warum liefert der Log-Rank-Test kein Effektmass?
Weil er beobachtete gegen erwartete Ereignisse stellt, ohne ein Modell für die Grösse des Unterschieds
Richtig. Er ist ein reiner Test. Ein Effektmass liefert das Cox-Modell mit dem Hazard Ratio, samt Konfidenzintervall.
Weil das Effektmass in der Statistik steht, man muss es nur umrechnen
Aus Chi-Quadrat lässt sich kein Hazard Ratio gewinnen.
Weil die Zensierung ein Effektmass unmöglich macht
Das Cox-Modell schätzt eines, ebenfalls mit zensierten Daten.
In einer Gruppe sind 183 Ereignisse beobachtet, 118 erwartet. Was heisst das?
In dieser Gruppe traten mehr Ereignisse auf als bei gleichem Risiko zu erwarten wäre
Richtig. Die erwarteten Ereignisse berücksichtigen die Zeit unter Risiko. Mehr beobachtete als erwartete heisst höheres Risiko und das ist die einzige Stelle, an der die Richtung des Effekts im Testergebnis steht.
Die Gruppe ist grösser als die andere
Die Gruppengrösse steckt bereits in der Erwartung.
Das Ergebnis ist damit signifikant
Ob die Abweichung mit Zufall vereinbar ist, entscheidet der p-Wert.
Warum ist der erwartete Wert je Gruppe nie eine ganze Zahl?
Weil er die Ereignisse jedes Zeitpunkts nach dem Anteil unter Risiko aufteilt
Richtig. Bei zwei Ereignissen und vier von neun unter Risiko in Gruppe A werden 0.889 Ereignisse erwartet. Erst die Summe über alle Zeitpunkte ist mit der beobachteten Zählung vergleichbar.
Weil gerundet wird
Es wird nicht gerundet; der Wert ist exakt ein Anteil.
Weil zensierte Fälle anteilig gezählt werden
Zensierte Fälle zählen gar nicht als Ereignis, sie verkleinern nur die Anzahl unter Risiko.