Diskrete Verteilungen

Verteilungen
Wahrscheinlichkeit
R
Python
Binomial, Poisson und geometrisch, mit ihren Anwendungsfällen.

Kernideen

  • Welche Verteilung passt, entscheidet der Erzeugungsmechanismus, nicht das Aussehen der Daten.
  • Die Binomialverteilung zählt Erfolge bei fester Versuchszahl, mit drei Voraussetzungen, an denen sie in der Praxis regelmässig scheitert.
  • Die Poissonverteilung zählt Ereignisse je Intervall, ohne dass die Zahl der Gelegenheiten bekannt sein müsste.
  • Bei der Poissonverteilung sind Erwartungswert und Varianz gleich, ein brauchbarer Prüfstein an echten Daten.
  • Bei vielen Versuchen mit kleiner Erfolgswahrscheinlichkeit nähert sich die Binomial- der Poissonverteilung an.
  • Das dpqr-Schema gilt für jede Verteilung, und die Grenze zwischen “höchstens” und “mindestens” ist die häufigste Fehlerquelle.

Erklärung

Vorwissen: Zufallsvariablen, insbesondere Wahrscheinlichkeitsfunktion, Verteilungsfunktion und Erwartungswert. Die Unabhängigkeit aus bedingte Wahrscheinlichkeit kehrt hier als Voraussetzung der Binomialverteilung wieder.

Die Binomialverteilung

Wiederholt man denselben Versuch mit zwei möglichen Ausgängen mehrfach und zählt die Erfolge, entsteht die Binomialverteilung:

\[P(X = k) = \underbrace{\binom{n}{k}}_{\text{wie viele Wege}} \cdot \underbrace{p^k (1-p)^{n-k}}_{\text{Wahrscheinlichkeit eines Weges}}\]

Der hintere Teil ist die Wahrscheinlichkeit einer bestimmten Abfolge, etwa Erfolg, Fehlschlag, Erfolg. Der Binomialkoeffizient zählt, wie viele solche Abfolgen zu genau \(k\) Erfolgen führen.

Kennzahl Formel
Erwartungswert \(n \cdot p\)
Varianz \(n \cdot p \cdot (1-p)\)

Die drei Voraussetzungen sind zugleich die Stellen, an denen die Verteilung in der Praxis scheitert:

Voraussetzung Typische Verletzung Dann passt
feste Versuchszahl \(n\) Ereignisse in einem Zeitraum ohne bekannte Gelegenheitszahl Poisson
unabhängige Versuche Ziehen ohne Zurücklegen aus einer kleinen Grundgesamtheit hypergeometrisch
konstantes \(p\) die Erfolgswahrscheinlichkeit schwankt zwischen den Versuchen Beta-Binomial, oder ein Modell mit Kovariablen

Die Poissonverteilung

Manchmal gibt es keine feste Versuchszahl. Wie viele Störungen treten pro Schicht auf, wie viele Anrufe pro Stunde? Ereignisse treten in einem Intervall auf, ohne dass man sagen könnte, wie viele Gelegenheiten es gegeben hätte.

\[P(X = k) = \frac{\lambda^k e^{-\lambda}}{k!}\]

Ein einziger Parameter, die mittlere Anzahl je Intervall und die auffälligste Eigenschaft:

\[E(X) = \text{Var}(X) = \lambda\]

Das ist ein Prüfstein für echte Daten. Liegt die beobachtete Streuung deutlich über dem Mittel, spricht das gegen das Modell; man nennt das Überdispersion und findet sie oft dort, wo Ereignisse in Schüben auftreten.

Weitere diskrete Verteilungen

Verteilung Zählt Parameter Erwartungswert
Bernoulli einen einzelnen Versuch \(p\) \(p\)
Binomial Erfolge bei \(n\) Versuchen \(n\), \(p\) \(np\)
Geometrisch Versuche bis zum ersten Erfolg \(p\) \(1/p\)
Negativ-binomial Versuche bis zum \(r\)-ten Erfolg \(r\), \(p\) \(r/p\)
Hypergeometrisch Erfolge beim Ziehen ohne Zurücklegen \(N\), \(K\), \(n\) \(n K/N\)
Poisson Ereignisse je Intervall \(\lambda\) \(\lambda\)
Diskrete Gleichverteilung jeden Wert gleich oft \(a\), \(b\) \(\frac{a+b}{2}\)

Die negativ-binomiale Verteilung ist zugleich die übliche Antwort auf Überdispersion: Sie hat einen zweiten Parameter, mit dem die Varianz über den Erwartungswert hinauswachsen darf.

Das dpqr-Schema

Präfix Frage R Python
d Wie wahrscheinlich ist genau dieser Wert? dbinom(3, 10, 0.3) binom.pmf(3, 10, 0.3)
p Wie wahrscheinlich ist höchstens dieser Wert? pbinom(3, 10, 0.3) binom.cdf(3, 10, 0.3)
q Welcher Wert wird mit dieser Wahrscheinlichkeit unterschritten? qbinom(0.95, 10, 0.3) binom.ppf(0.95, 10, 0.3)
r Ziehe Zufallszahlen rbinom(5, 10, 0.3) binom.rvs(10, 0.3, size=5)

Beispiele

Frage und Datenlage

Fünf Versuche, Erfolgswahrscheinlichkeit 0.3. Wie wahrscheinlich sind genau zwei Erfolge und woher kommt die Zahl?

Rechnung

n <- 5; k <- 2; p <- 0.3

round(c(wege = choose(n, k),
        ein_weg = p^k * (1 - p)^(n - k),
        von_hand = choose(n, k) * p^k * (1 - p)^(n - k),
        eingebaut = dbinom(k, size = n, prob = p)), 6)
     wege   ein_weg  von_hand eingebaut 
 10.00000   0.03087   0.30870   0.30870 
round(c(erwartungswert = n * p, varianz = n * p * (1 - p)), 4)
erwartungswert        varianz 
          1.50           1.05 
# Die ganze Verteilung
round(dbinom(0:5, size = 5, prob = 0.3), 4)
[1] 0.1681 0.3601 0.3087 0.1323 0.0284 0.0024
sum(dbinom(0:5, size = 5, prob = 0.3))
[1] 1
gitter <- expand.grid(k = 0:20, p = c(0.2, 0.5, 0.8))
gitter$dichte <- dbinom(gitter$k, size = 20, prob = gitter$p)
gitter$p_label <- paste("p =", gitter$p)

ggplot(gitter, aes(k, dichte)) +
  geom_col(fill = "grey70", width = 0.7) +
  facet_wrap(~ p_label) +
  labs(x = "Anzahl Erfolge", y = "Wahrscheinlichkeit")
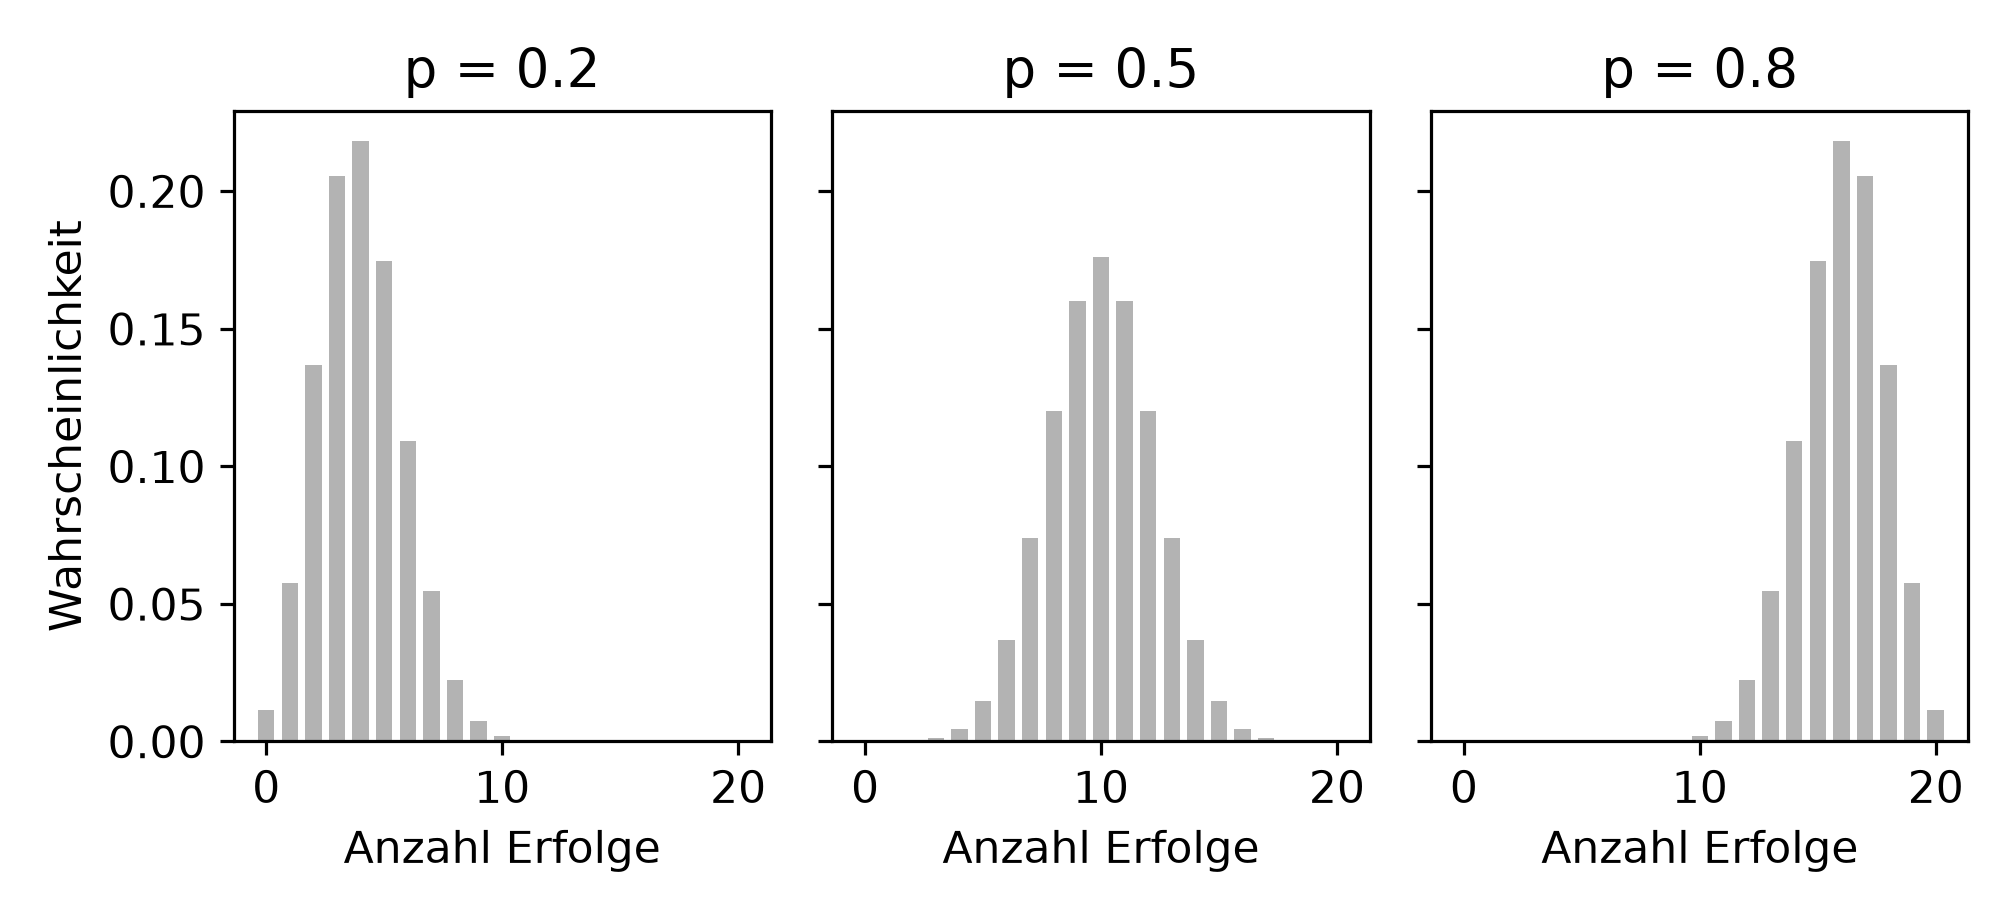
Abbildung 1: Beispiel 1: Binomialverteilung für n = 20 bei drei Erfolgswahrscheinlichkeiten.
n, k, p = 5, 2, 0.3

print({"wege": comb(n, k),
       "ein_weg": round(p ** k * (1 - p) ** (n - k), 6),
       "von_hand": round(comb(n, k) * p ** k * (1 - p) ** (n - k), 6),
       "eingebaut": round(float(stats.binom.pmf(k, n, p)), 6)})
{'wege': 10, 'ein_weg': 0.03087, 'von_hand': 0.3087, 'eingebaut': 0.3087}
print({"erwartungswert": n * p, "varianz": round(n * p * (1 - p), 4)})
{'erwartungswert': 1.5, 'varianz': 1.05}
print(np.round(stats.binom.pmf(np.arange(6), 5, 0.3), 4))
[0.1681 0.3601 0.3087 0.1323 0.0283 0.0024]
print(float(stats.binom.pmf(np.arange(6), 5, 0.3).sum()))
0.9999999999999996
gitter = np.arange(0, 21)
fig, achsen = plt.subplots(1, 3, figsize=(7, 3.2), sharey=True)
for achse, p_wert in zip(achsen, [0.2, 0.5, 0.8]):
    achse.bar(gitter, stats.binom.pmf(gitter, 20, p_wert), color="0.7",
              width=0.7)
    achse.set_title(f"p = {p_wert}")
    achse.set_xlabel("Anzahl Erfolge")
achsen[0].set_ylabel("Wahrscheinlichkeit")
plt.tight_layout()
plt.show()
Abbildung 2: Beispiel 1: dieselben drei Verteilungen in Python.

Output Zeile für Zeile

Bestandteil Wert Bedeutung
\(\binom{5}{2}\) 10 Zehn Abfolgen führen zu genau zwei Erfolgen: EEFFF, EFEFF, …
\(p^2 (1-p)^3\) 0.03087 Die Wahrscheinlichkeit einer dieser Abfolgen und zwar jeder einzelnen, weil die Reihenfolge nichts ändert.
Produkt 0.30870 \(10 \cdot 0.03087\).
dbinom(2, 5, 0.3) 0.30870 Identisch.
Erwartungswert 1.5 \(n \cdot p\). Zwei Erfolge sind also der wahrscheinlichste Wert, obwohl der Erwartungswert 1.5 beträgt.
Varianz 1.05 \(n p (1-p)\).
Die ganze Verteilung 0.1681, 0.3602, 0.3087, 0.1323, 0.0284, 0.0024 Summe genau 1.
Beobachtung Erklärung
Die Formel zerfällt sauber in zwei Fragen “Wie viele Wege gibt es?” und “Wie wahrscheinlich ist ein Weg?” Beide stammen aus der Kombinatorik.
Bei \(p = 0.5\) ist die Verteilung symmetrisch Im mittleren Bild. Bei \(p = 0.2\) ist sie rechtsschief, bei \(p = 0.8\) linksschief.
Die Schiefe verschwindet mit wachsendem \(n\) Bei \(n = 20\) und \(p = 0.2\) ist sie schon deutlich schwächer als bei \(n = 5\). Das ist der zentrale Grenzwertsatz am Werk.

Interpretation und Ergebnissatz

Bei fünf unabhängigen Versuchen mit einer Erfolgswahrscheinlichkeit von 0.3 treten mit 30.9 Prozent Wahrscheinlichkeit genau zwei Erfolge auf (Erwartungswert 1.5, Varianz 1.05).

Frage und Datenlage

Zehn Versuche, \(p = 0.3\). Vier Fragen, die sich um jeweils eine Zahl unterscheiden und genau dort liegt die häufigste Fehlerquelle.

Rechnung

round(c(
  genau_3 = dbinom(3, 10, 0.3),
  hoechstens_3 = pbinom(3, 10, 0.3),
  mehr_als_3 = 1 - pbinom(3, 10, 0.3),
  mindestens_3 = 1 - pbinom(2, 10, 0.3),
  zwischen_2_und_5 = pbinom(5, 10, 0.3) - pbinom(1, 10, 0.3)
), 6)
         genau_3     hoechstens_3       mehr_als_3     mindestens_3 
        0.266828         0.649611         0.350389         0.617217 
zwischen_2_und_5 
        0.803343 
# q ist die Umkehrung von p, aber nur naeherungsweise: die Verteilung springt
round(c(q_95 = qbinom(0.95, 10, 0.3),
        p_bei_5 = pbinom(5, 10, 0.3),
        p_bei_4 = pbinom(4, 10, 0.3)), 4)
   q_95 p_bei_5 p_bei_4 
 5.0000  0.9527  0.8497 
# Zufallszahlen, hier deterministisch ueber die Quantilfunktion
qbinom(lehmer(3141, 8), size = 10, prob = 0.3)
[1] 0 2 2 3 3 4 4 2
print({
    "genau_3": round(float(stats.binom.pmf(3, 10, 0.3)), 6),
    "hoechstens_3": round(float(stats.binom.cdf(3, 10, 0.3)), 6),
    "mehr_als_3": round(float(stats.binom.sf(3, 10, 0.3)), 6),
    "mindestens_3": round(float(1 - stats.binom.cdf(2, 10, 0.3)), 6),
    "zwischen_2_und_5": round(float(stats.binom.cdf(5, 10, 0.3)
                                    - stats.binom.cdf(1, 10, 0.3)), 6),
})
{'genau_3': 0.266828, 'hoechstens_3': 0.649611, 'mehr_als_3': 0.350389, 'mindestens_3': 0.617217, 'zwischen_2_und_5': 0.803343}
print({"q_95": int(stats.binom.ppf(0.95, 10, 0.3)),
       "p_bei_5": round(float(stats.binom.cdf(5, 10, 0.3)), 4),
       "p_bei_4": round(float(stats.binom.cdf(4, 10, 0.3)), 4)})
{'q_95': 5, 'p_bei_5': 0.9527, 'p_bei_4': 0.8497}
print(stats.binom.ppf(lehmer(3141, 8), 10, 0.3).astype(int))
[0 2 2 3 3 4 4 2]

Output Zeile für Zeile

Frage Rechnung Ergebnis
genau 3 \(P(X = 3)\) 0.2668
höchstens 3 \(F(3)\) 0.6496
mehr als 3 \(1 - F(3)\) 0.3504
mindestens 3 \(1 - F(\mathbf{2})\) 0.6172
zwischen 2 und 5 (einschliesslich) \(F(5) - F(\mathbf{1})\) 0.9078
Beobachtung Erklärung
“mehr als 3” und “mindestens 3” unterscheiden sich um 0.267 Genau um \(P(X = 3)\). Bei stetigen Verteilungen wäre der Unterschied null, hier ist er der grösste Einzelwert der Verteilung.
Für “mindestens \(k\)” wird bei \(k-1\) abgezogen \(1 - F(k-1)\). Diese Verschiebung um eins ist die häufigste Fehlerquelle im Umgang mit diskreten Verteilungen.
Für “zwischen \(a\) und \(b\) einschliesslich” \(F(b) - F(a-1)\). Ebenfalls die Verschiebung.
qbinom(0.95) liefert 5 Und \(F(5) = 0.9527\), \(F(4) = 0.8497\). Es gibt also keinen Wert mit \(F = 0.95\) exakt; die Quantilfunktion gibt den kleinsten Wert zurück, dessen Verteilungsfunktion 0.95 erreicht oder überschreitet.

Die Merkregel in einer Zeile: p-Funktionen sind bei diskreten Verteilungen immer “kleiner oder gleich”. Alles andere leitet sich davon ab:

Gesucht Rechnung
\(P(X \le k)\) \(F(k)\)
\(P(X < k)\) \(F(k-1)\)
\(P(X > k)\) \(1 - F(k)\)
\(P(X \ge k)\) \(1 - F(k-1)\)
\(P(a \le X \le b)\) \(F(b) - F(a-1)\)

Und ein Genauigkeitshinweis: Für sehr kleine Wahrscheinlichkeiten im rechten Rand ist 1 - pbinom(...) numerisch ungenau, weil von eins abgezogen wird. R bietet dafür lower.tail = FALSE, scipy die Funktion sf, beide rechnen den oberen Rand direkt.

Interpretation

Die fünf Zahlen unterscheiden sich um bis zu das Dreifache, obwohl alle Formulierungen umgangssprachlich ähnlich klingen. Wer eine Wahrscheinlichkeit berichtet, nennt deshalb die Grenze mit.

Frage und Datenlage

Aus einer Urne mit zehn Kugeln, davon drei roten, wird fünfmal gezogen. Einmal mit Zurücklegen (binomial) und einmal ohne (hypergeometrisch). Wie gross ist der Unterschied?

Rechnung

N <- 10; K <- 3; n <- 5
k <- 0:3

round(rbind(
  binomial = dbinom(k, size = n, prob = K / N),
  hypergeometrisch = dhyper(k, m = K, n = N - K, k = n)
), 4)
                   [,1]   [,2]   [,3]   [,4]
binomial         0.1681 0.3601 0.3087 0.1323
hypergeometrisch 0.0833 0.4167 0.4167 0.0833
round(c(
  ew_beide = n * K / N,
  var_binomial = n * (K / N) * (1 - K / N),
  var_hypergeometrisch = n * (K / N) * (1 - K / N) * (N - n) / (N - 1),
  korrekturfaktor = (N - n) / (N - 1)
), 4)
            ew_beide         var_binomial var_hypergeometrisch 
              1.5000               1.0500               0.5833 
     korrekturfaktor 
              0.5556 
# Bei grosser Grundgesamtheit verschwindet der Unterschied
round(dhyper(k, m = 3000, n = 7000, k = 5), 4)
[1] 0.1680 0.3602 0.3088 0.1323
par(mfrow = c(1, 2), mar = c(4, 4, 3, 1))
breite <- 0.35
plot(k - breite / 2, dbinom(k, n, K / N), type = "h", lwd = 8, col = "grey55",
     ylim = c(0, 0.45), xlab = "rote Kugeln", ylab = "Wahrscheinlichkeit",
     main = "N = 10")
points(k + breite / 2, dhyper(k, K, N - K, n), type = "h", lwd = 8,
       col = "grey80")
legend("topright", legend = c("mit Zurücklegen", "ohne"),
       fill = c("grey55", "grey80"), bty = "n", cex = 0.8)

plot(k - breite / 2, dbinom(k, n, 0.3), type = "h", lwd = 8, col = "grey55",
     ylim = c(0, 0.45), xlab = "rote Kugeln", ylab = "",
     main = "N = 10000")
points(k + breite / 2, dhyper(k, 3000, 7000, 5), type = "h", lwd = 8,
       col = "grey80")
par(mfrow = c(1, 1))
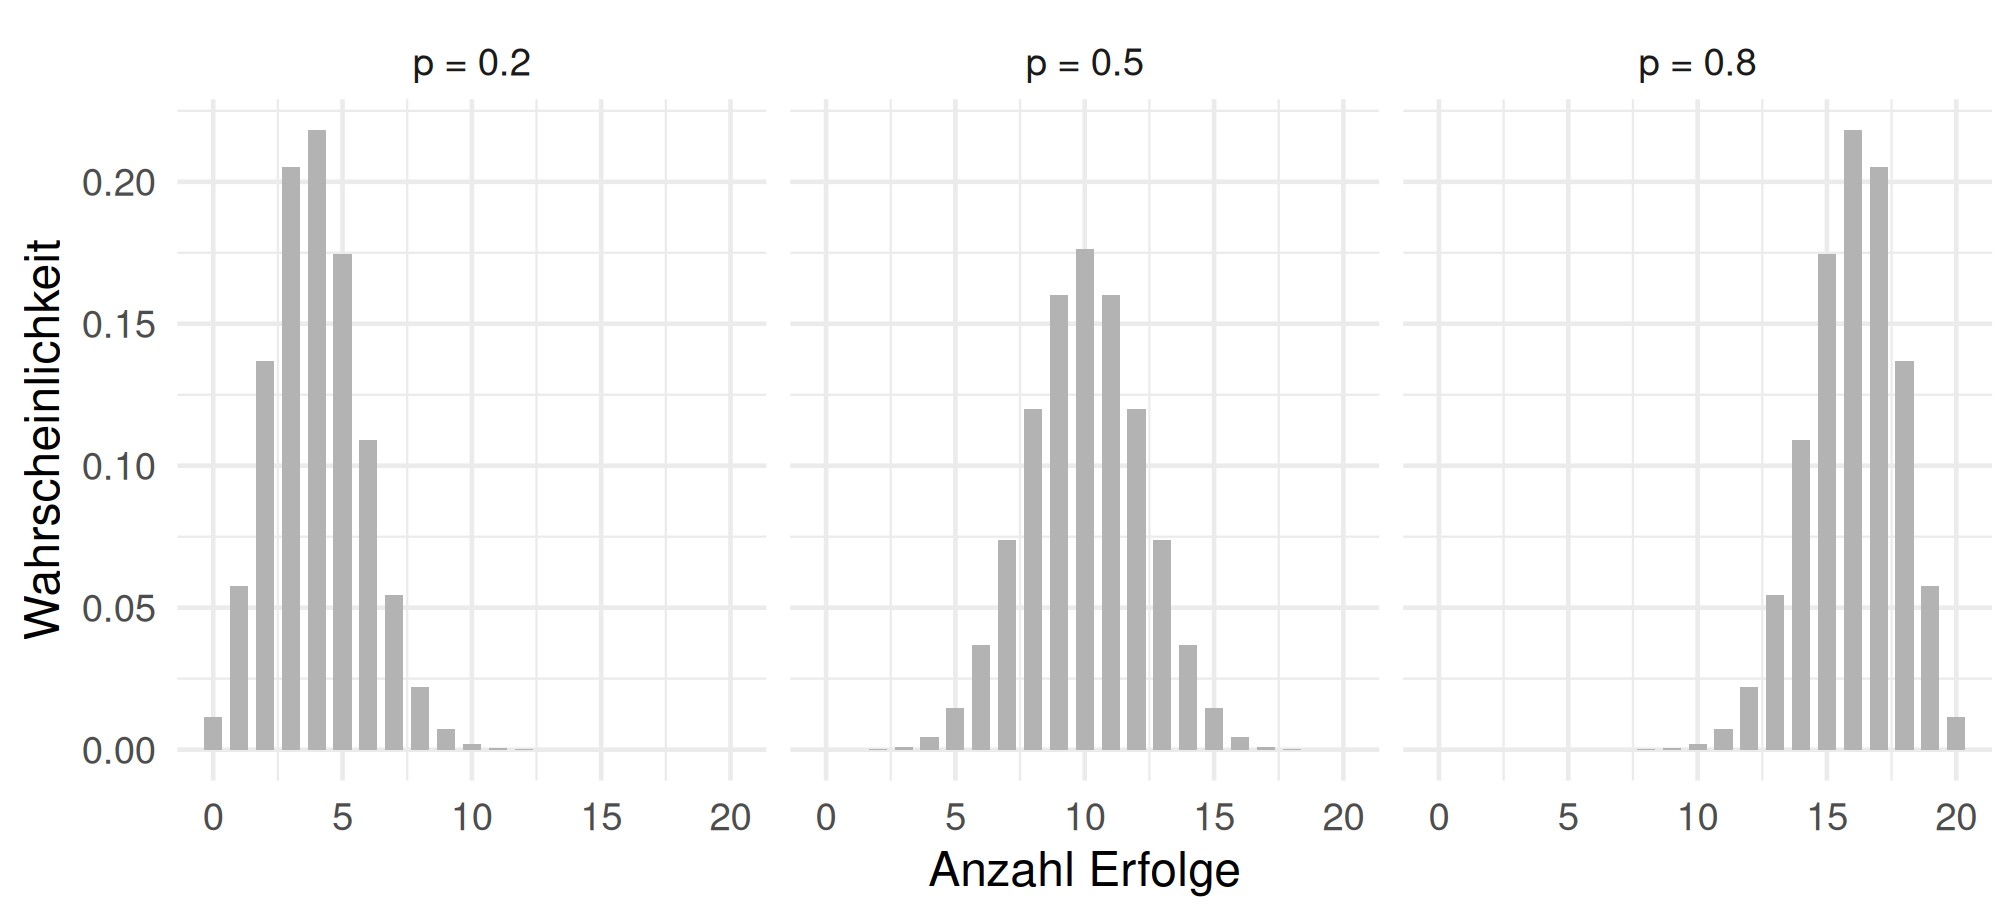
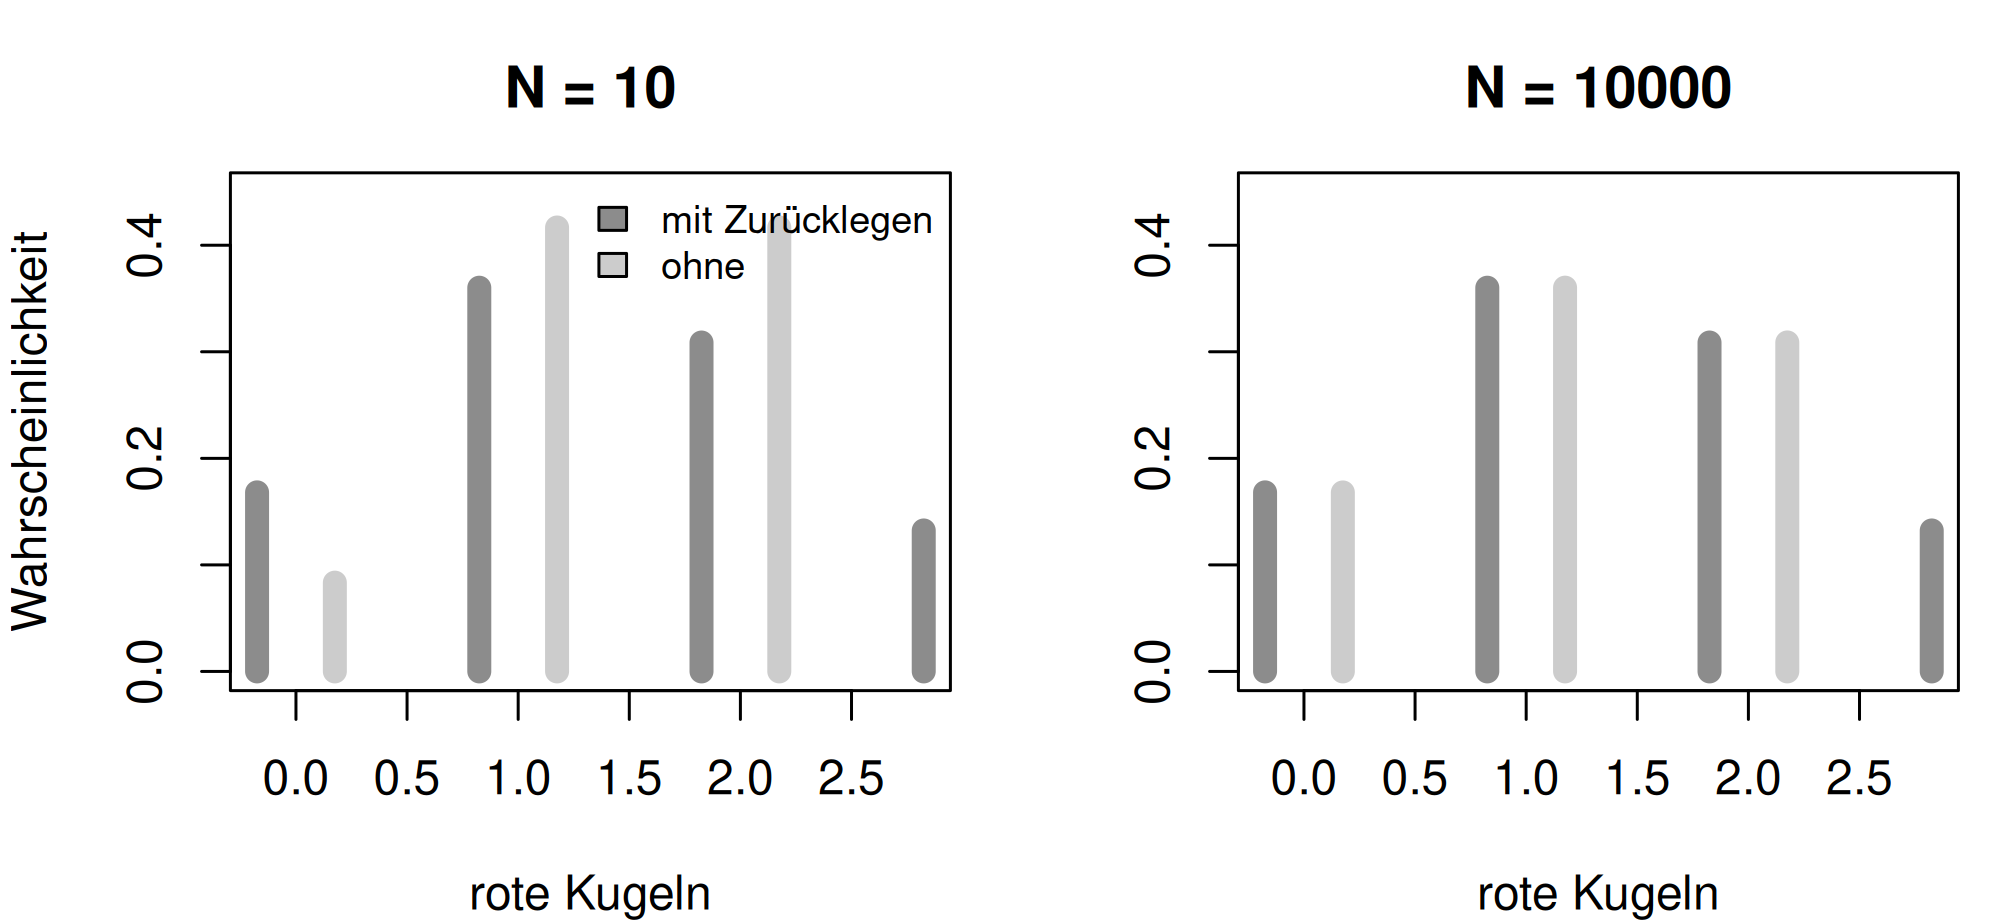
Abbildung 3: Beispiel 3: mit und ohne Zurücklegen, links bei zehn Kugeln, rechts bei zehntausend.
N, K, n = 10, 3, 5
k = np.arange(4)

print(pd.DataFrame({
    "binomial": stats.binom.pmf(k, n, K / N),
    "hypergeometrisch": stats.hypergeom.pmf(k, N, K, n),
}, index=k).round(4).T)
                       0       1       2       3
binomial          0.1681  0.3601  0.3087  0.1323
hypergeometrisch  0.0833  0.4167  0.4167  0.0833
print({"ew_beide": n * K / N,
       "var_binomial": round(n * (K / N) * (1 - K / N), 4),
       "var_hypergeometrisch": round(float(stats.hypergeom.var(N, K, n)), 4),
       "korrekturfaktor": round((N - n) / (N - 1), 4)})
{'ew_beide': 1.5, 'var_binomial': 1.05, 'var_hypergeometrisch': 0.5833, 'korrekturfaktor': 0.5556}
print(np.round(stats.hypergeom.pmf(k, 10000, 3000, 5), 4))
[0.168  0.3602 0.3088 0.1323]
fig, achsen = plt.subplots(1, 2, figsize=(7, 3.2), sharey=True)
breite = 0.35
for achse, (gross, treffer, titel) in zip(achsen, [
        (10, 3, "N = 10"), (10000, 3000, "N = 10000")]):
    achse.bar(k - breite / 2, stats.binom.pmf(k, n, 0.3), width=breite,
              color="0.55", label="mit Zurücklegen")
    achse.bar(k + breite / 2, stats.hypergeom.pmf(k, gross, treffer, n),
              width=breite, color="0.8", label="ohne")
    achse.set_title(titel)
    achse.set_xlabel("rote Kugeln")
achsen[0].set_ylabel("Wahrscheinlichkeit")
achsen[0].legend(frameon=False, fontsize=8)
plt.tight_layout()
plt.show()
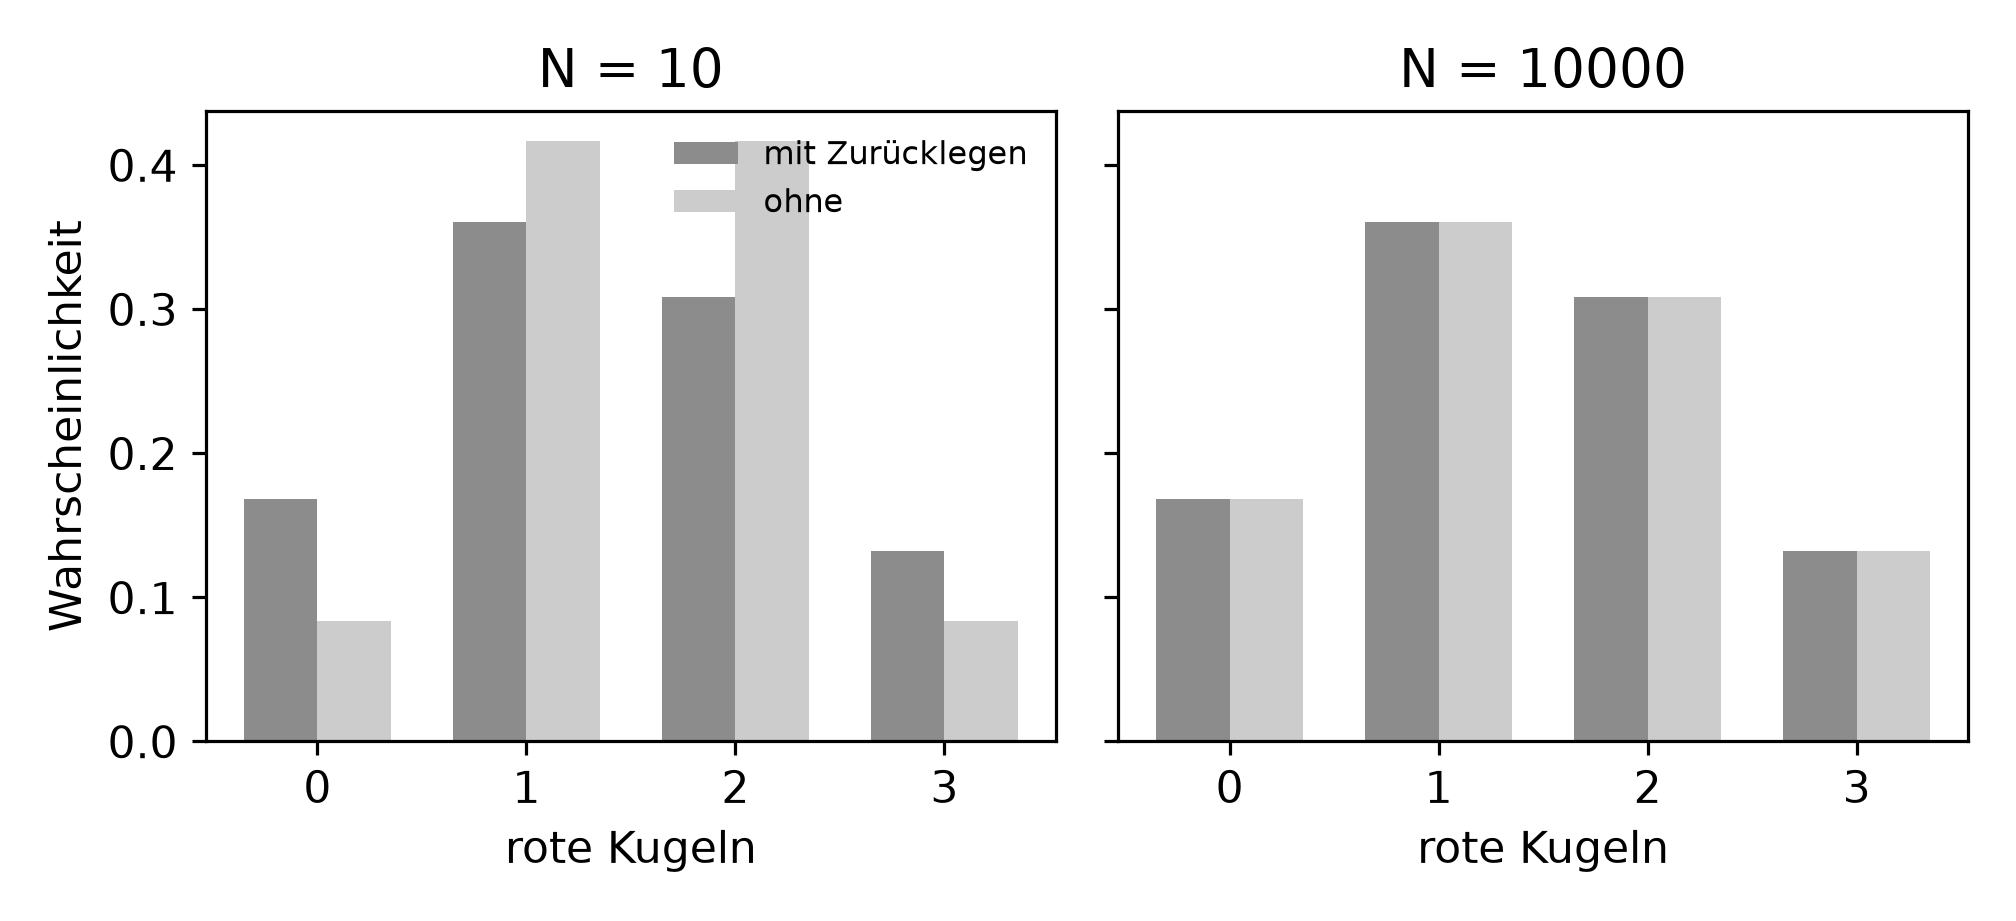
Abbildung 4: Beispiel 3: dieselbe Gegenüberstellung in Python.

Output Zeile für Zeile

rote Kugeln 0 1 2 3
mit Zurücklegen (binomial) 0.1681 0.3601 0.3087 0.1323
ohne Zurücklegen (hypergeometrisch) 0.0833 0.4167 0.4167 0.0833
Kennzahl binomial hypergeometrisch
Erwartungswert 1.5 1.5
Varianz 1.050 0.583
Verhältnis 0.5556
Beobachtung Erklärung
Die Erwartungswerte stimmen überein Beide 1.5. Das Ziehen ohne Zurücklegen verschiebt den Schwerpunkt nicht.
Die Varianz ist deutlich kleiner 0.583 gegen 1.050, also 55.6 Prozent. Der Faktor ist exakt \(\frac{N-n}{N-1} = \frac{5}{9}\), die Endlichkeitskorrektur.
Die hypergeometrische Verteilung ist enger Sie kann bei drei roten Kugeln in der Urne höchstens drei ziehen; die binomiale erlaubt theoretisch fünf. Genau diese Begrenzung erzeugt die kleinere Streuung.
Bei \(N = 10\,000\) sind beide praktisch gleich 0.1680, 0.3602, 0.3088, 0.1323 gegen 0.1681, 0.3601, 0.3087, 0.1323. Der Korrekturfaktor beträgt dort 0.9996.

Die praktische Faustregel: Ist die Stichprobe kleiner als etwa 5 Prozent der Grundgesamtheit, darf man ohne Zurücklegen wie mit Zurücklegen rechnen. Der Korrekturfaktor liegt dann über 0.95.

Diese Endlichkeitskorrektur taucht überall wieder auf, wo aus einer begrenzten Grundgesamtheit gezogen wird, etwa beim Standardfehler eines Anteils in einer Vollerhebung eines Betriebs. Wer sie weglässt, rechnet den Standardfehler zu gross, also das Konfidenzintervall zu breit. Das ist die seltene Sorte Fehler, die zu vorsichtig ist.

Interpretation und Ergebnissatz

Beim Ziehen ohne Zurücklegen aus einer Urne mit zehn Kugeln beträgt die Varianz 0.58 gegenüber 1.05 beim Ziehen mit Zurücklegen; der Erwartungswert von 1.5 bleibt unverändert. Bei einer Grundgesamtheit von 10 000 ist der Unterschied vernachlässigbar.

Frage und Datenlage

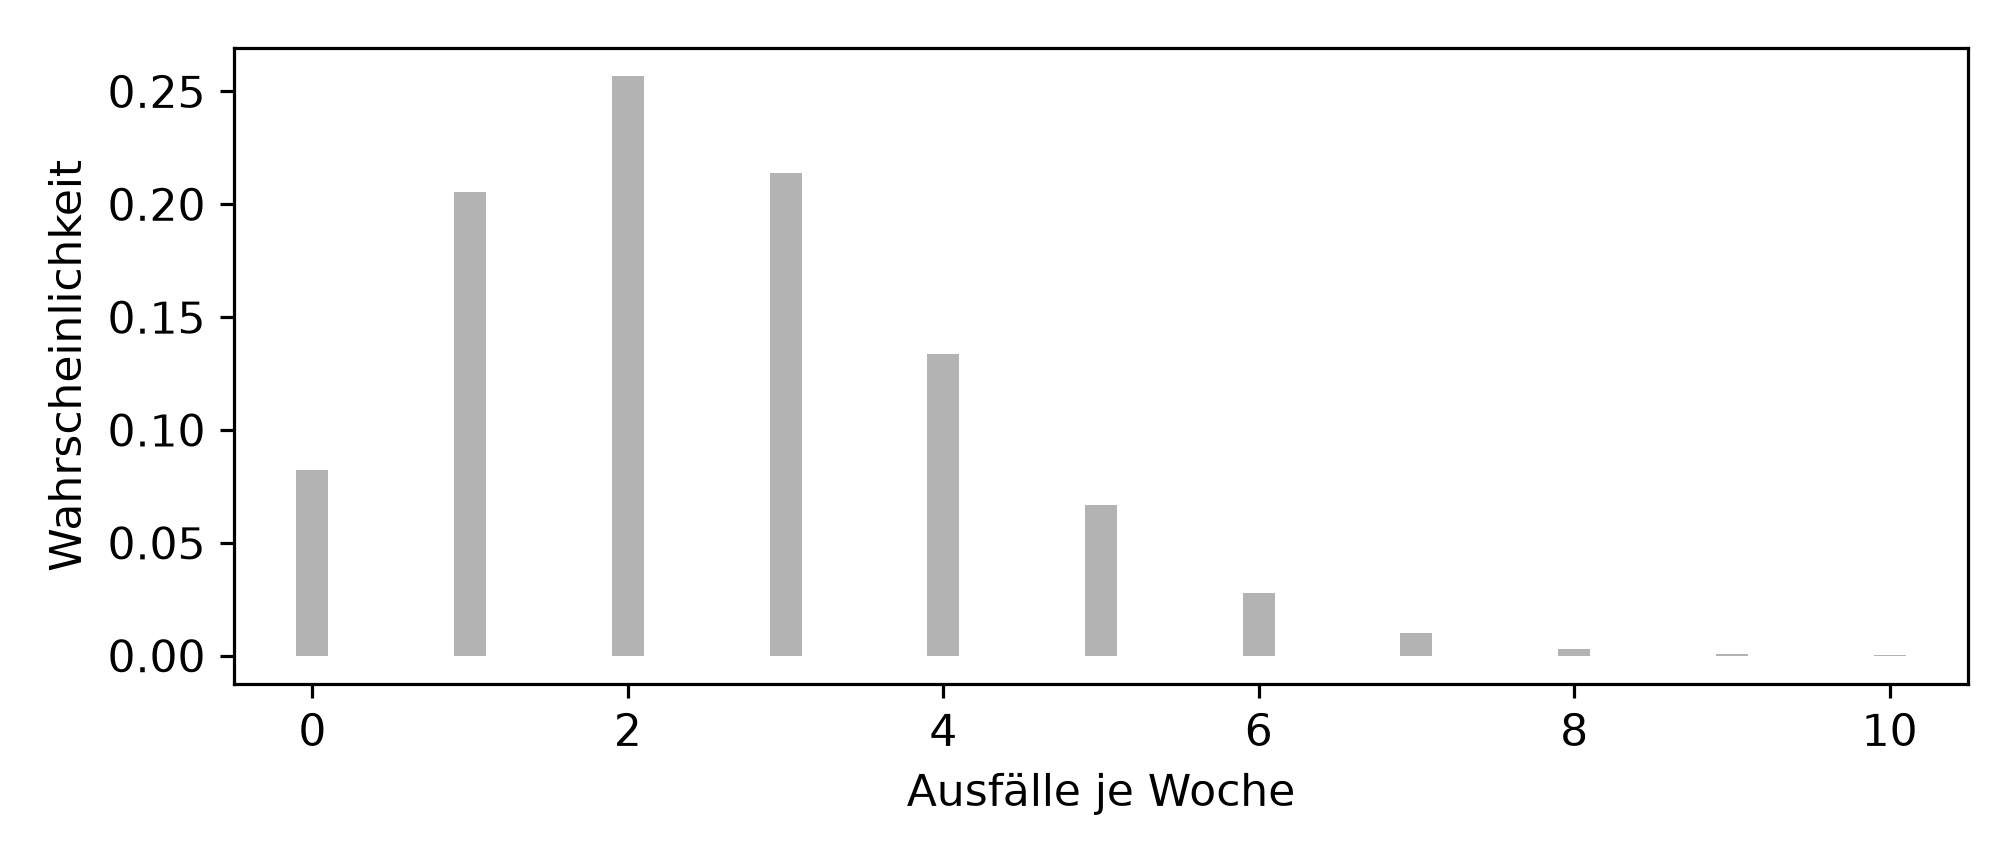
In einem Betrieb fallen im Mittel 2.5 Maschinen je Woche aus. Wie wahrscheinlich sind null Ausfälle, wie wahrscheinlich fünf oder mehr und woran erkennt man, dass das Modell nicht passt?

Rechnung

lambda <- 2.5
k <- 0:10

round(dpois(k, lambda), 4)
 [1] 0.0821 0.2052 0.2565 0.2138 0.1336 0.0668 0.0278 0.0099 0.0031 0.0009
[11] 0.0002
ew <- sum(k * dpois(k, lambda))
varianz <- sum((k - ew)^2 * dpois(k, lambda))
round(c(lambda = lambda, erwartungswert = ew, varianz = varianz), 4)
        lambda erwartungswert        varianz 
        2.5000         2.4993         2.4953 
round(c(keine_ausfaelle = dpois(0, lambda),
        hoechstens_2 = ppois(2, lambda),
        mindestens_5 = 1 - ppois(4, lambda)), 4)
keine_ausfaelle    hoechstens_2    mindestens_5 
         0.0821          0.5438          0.1088 
par(mar = c(4, 4, 2, 1))
plot(k, dpois(k, lambda), type = "h", lwd = 8, col = "grey70",
     xlab = "Ausfälle je Woche", ylab = "Wahrscheinlichkeit")
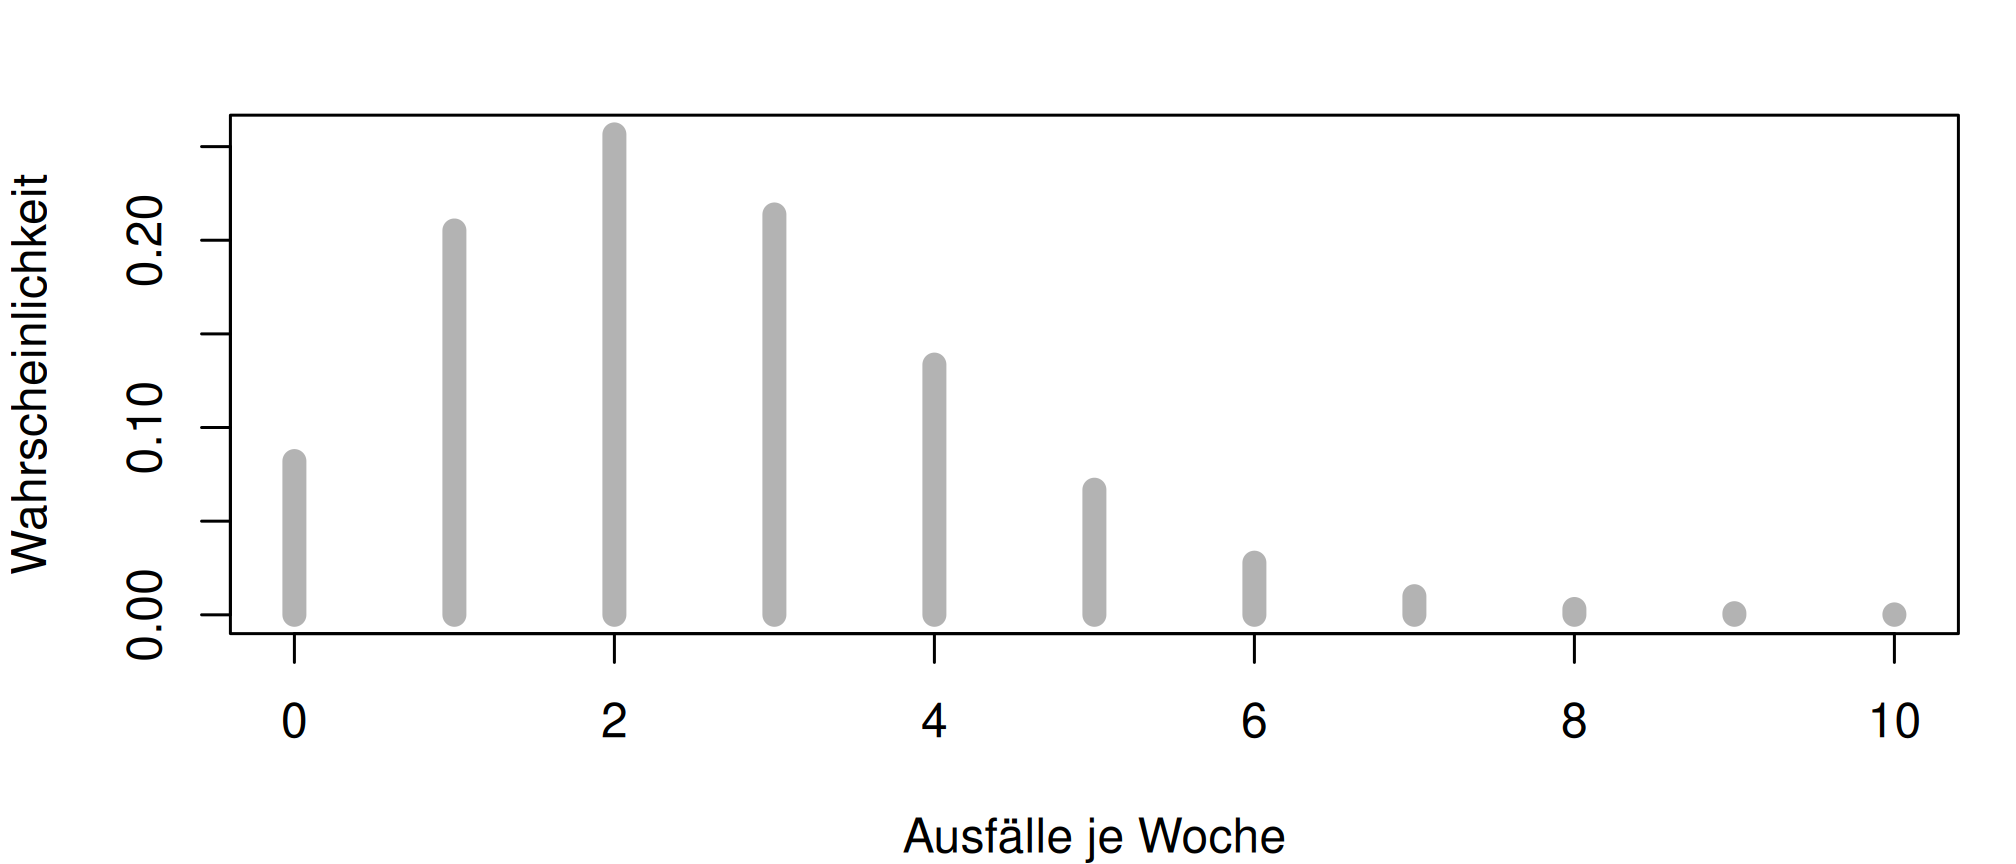
Abbildung 5: Beispiel 4: Poissonverteilung mit lambda = 2.5.
lam = 2.5
k = np.arange(11)

print(np.round(stats.poisson.pmf(k, lam), 4))
[8.210e-02 2.052e-01 2.565e-01 2.138e-01 1.336e-01 6.680e-02 2.780e-02
 9.900e-03 3.100e-03 9.000e-04 2.000e-04]
ew = float((k * stats.poisson.pmf(k, lam)).sum())
varianz = float(((k - ew) ** 2 * stats.poisson.pmf(k, lam)).sum())
print({"lambda": lam, "erwartungswert": round(ew, 4),
       "varianz": round(varianz, 4)})
{'lambda': 2.5, 'erwartungswert': 2.4993, 'varianz': 2.4953}
print({"keine_ausfaelle": round(float(stats.poisson.pmf(0, lam)), 4),
       "hoechstens_2": round(float(stats.poisson.cdf(2, lam)), 4),
       "mindestens_5": round(float(stats.poisson.sf(4, lam)), 4)})
{'keine_ausfaelle': 0.0821, 'hoechstens_2': 0.5438, 'mindestens_5': 0.1088}
fig, achse = plt.subplots(figsize=(7, 3))
achse.vlines(k, 0, stats.poisson.pmf(k, lam), lw=8, color="0.7")
achse.set_xlabel("Ausfälle je Woche")
achse.set_ylabel("Wahrscheinlichkeit")
plt.tight_layout()
plt.show()
Abbildung 6: Beispiel 4: dieselbe Verteilung in Python.

Output Zeile für Zeile

Ausfälle 0 1 2 3 4 5 6
\(P(X = k)\) 0.0821 0.2052 0.2565 0.2138 0.1336 0.0668 0.0278
Frage Ergebnis
keine Ausfälle 0.0821
höchstens zwei 0.5438
mindestens fünf 0.1088
Erwartungswert 2.5000
Varianz 2.5000
Beobachtung Erklärung
Der wahrscheinlichste Wert ist 2, nicht 2.5 Der Erwartungswert muss kein möglicher Wert sein. Bei ganzzahligem \(\lambda\) sind sogar zwei Werte gleich wahrscheinlich.
Erwartungswert gleich Varianz Exakt 2.5 beide. Diese Eigenschaft hat sonst keine der gebräuchlichen Verteilungen und deshalb ist sie ein Prüfstein.
Die Verteilung ist rechtsschief Nach unten bei null begrenzt, nach oben offen. Mit wachsendem \(\lambda\) wird sie symmetrischer.
In 8.2 Prozent der Wochen fällt nichts aus Nützlicher als der Erwartungswert für die Personalplanung.

Der Prüfstein in der Praxis: Werden 52 Wochen beobachtet und ergibt sich ein Mittel von 2.5 bei einer Varianz von 9, ist das Poisson-Modell widerlegt. Das Verhältnis Varianz zu Mittelwert heisst Dispersionsindex:

Index Bedeutung Typische Ursache Modell
\(\approx 1\) Poisson passt Poisson
\(> 1\) Überdispersion Ereignisse in Schüben; eine Störung zieht die nächste nach sich negativ-binomial
\(< 1\) Unterdispersion Ereignisse gleichmässiger als zufällig, etwa durch Wartungsintervalle selten; Conway-Maxwell-Poisson

Überdispersion ist der weitaus häufigere Fall. Wer sie übersieht und trotzdem ein Poisson-Modell rechnet, bekommt zu kleine Standardfehler und damit zu enge Intervalle und zu kleine p-Werte.

Interpretation und Ergebnissatz

Bei einer mittleren Ausfallrate von 2.5 je Woche bleiben 8.2 Prozent der Wochen ausfallfrei, und in 10.9 Prozent treten fünf oder mehr Ausfälle auf. Erwartungswert und Varianz sind beide 2.5; eine beobachtete Varianz deutlich darüber würde gegen das Modell sprechen.

Frage und Datenlage

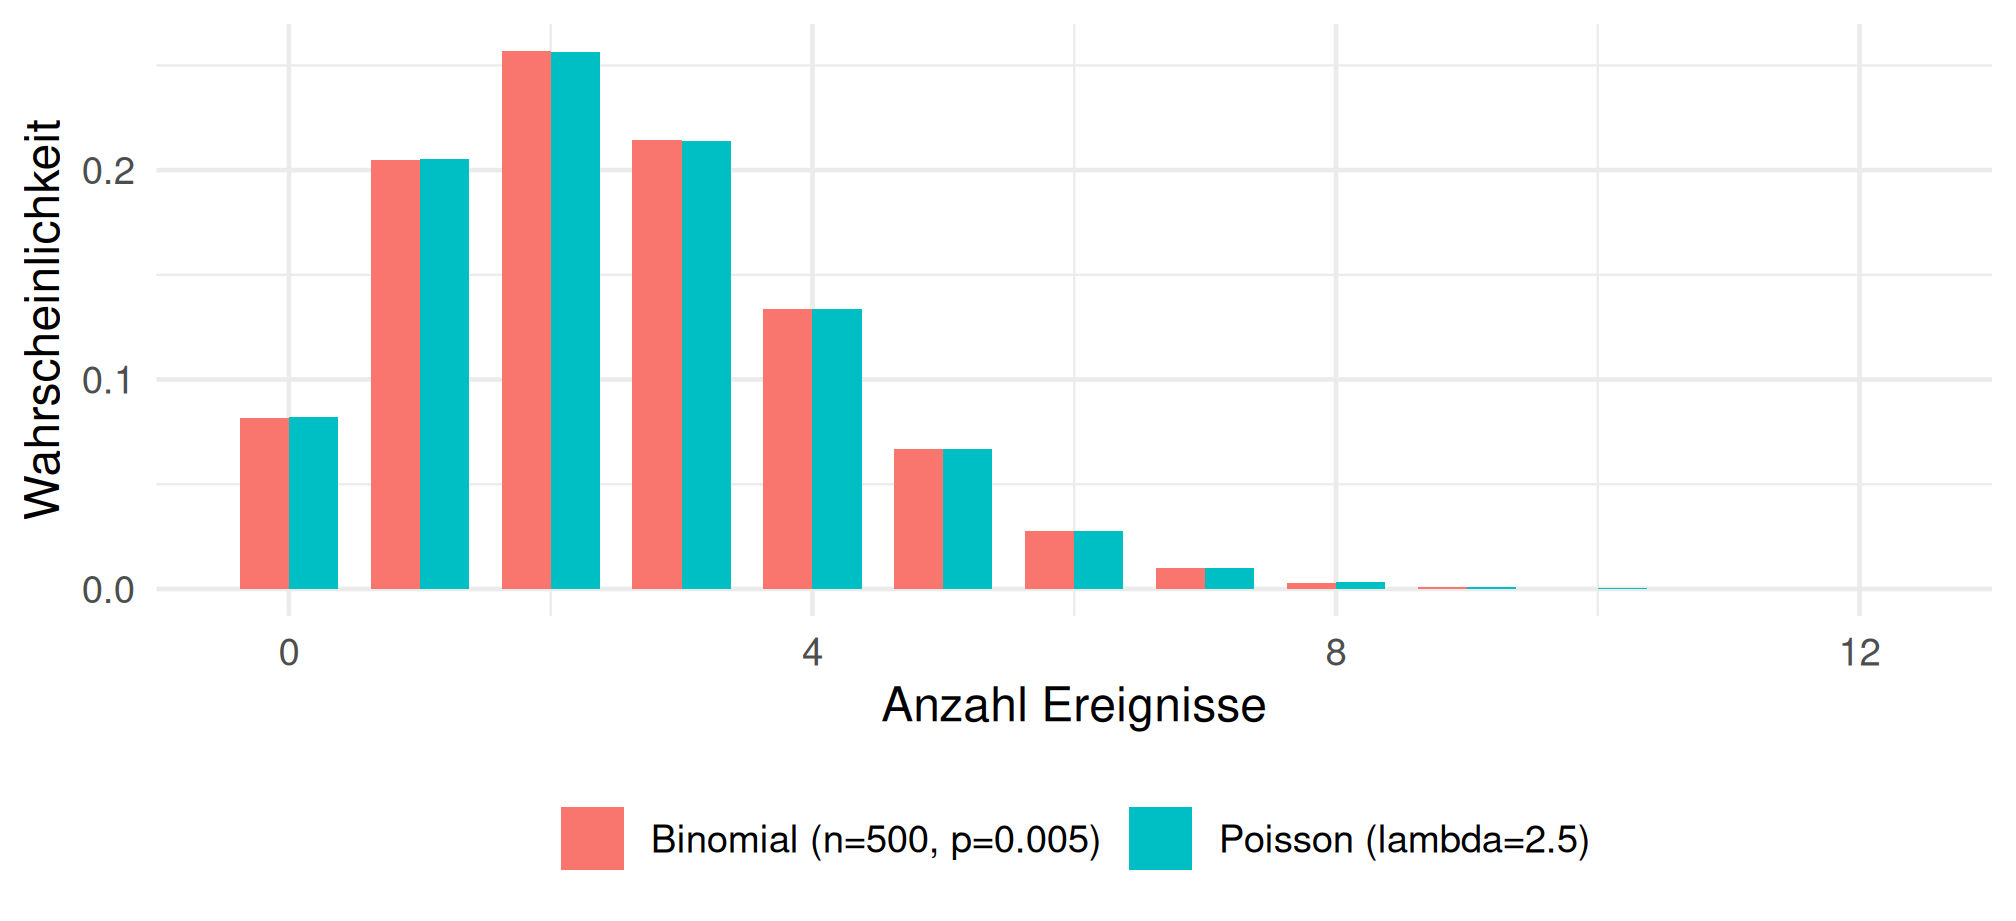
Bei vielen Versuchen mit kleiner Erfolgswahrscheinlichkeit nähert sich die Binomial- der Poissonverteilung an. Vier Kombinationen mit demselben \(\lambda = np = 2.5\) zeigen, wie gut.

Rechnung

k <- 0:12
vergleich <- data.frame(
  k = rep(k, 2),
  dichte = c(dbinom(k, size = 500, prob = 0.005), dpois(k, 2.5)),
  modell = rep(c("Binomial (n=500, p=0.005)", "Poisson (lambda=2.5)"),
               each = length(k))
)

ggplot(vergleich, aes(k, dichte, fill = modell)) +
  geom_col(position = "dodge", width = 0.75) +
  labs(x = "Anzahl Ereignisse", y = "Wahrscheinlichkeit", fill = NULL) +
  theme(legend.position = "bottom")

# Wie gut ist die Naeherung bei gleichem Erwartungswert?
for (paar in list(c(500, 0.005), c(50, 0.05), c(10, 0.25), c(5, 0.5))) {
  nb <- paar[1]; pb <- paar[2]
  abweichung <- max(abs(dbinom(k, nb, pb) - dpois(k, nb * pb)))
  cat(sprintf("n = %4.0f | p = %5.3f | lambda = %.2f | max. Abweichung %.5f | Var %.3f gegen %.3f\n",
              nb, pb, nb * pb, abweichung, nb * pb * (1 - pb), nb * pb))
}
n =  500 | p = 0.005 | lambda = 2.50 | max. Abweichung 0.00059 | Var 2.487 gegen 2.500
n =   50 | p = 0.050 | lambda = 2.50 | max. Abweichung 0.00611 | Var 2.375 gegen 2.500
n =   10 | p = 0.250 | lambda = 2.50 | max. Abweichung 0.03652 | Var 1.875 gegen 2.500
n =    5 | p = 0.500 | lambda = 2.50 | max. Abweichung 0.09874 | Var 1.250 gegen 2.500
Abbildung 7: Beispiel 5: Binomialverteilung mit n = 500 und p = 0.005 gegen die Poissonverteilung.
k = np.arange(13)
breite = 0.4

fig, achse = plt.subplots(figsize=(7, 3.2))
achse.bar(k - breite / 2, stats.binom.pmf(k, 500, 0.005), width=breite,
          label="Binomial (n=500, p=0.005)", color="0.55")
achse.bar(k + breite / 2, stats.poisson.pmf(k, 2.5), width=breite,
          label="Poisson (lambda=2.5)", color="0.8")
achse.set_xlabel("Anzahl Ereignisse")
achse.set_ylabel("Wahrscheinlichkeit")
achse.legend(frameon=False)
plt.tight_layout()
plt.show()
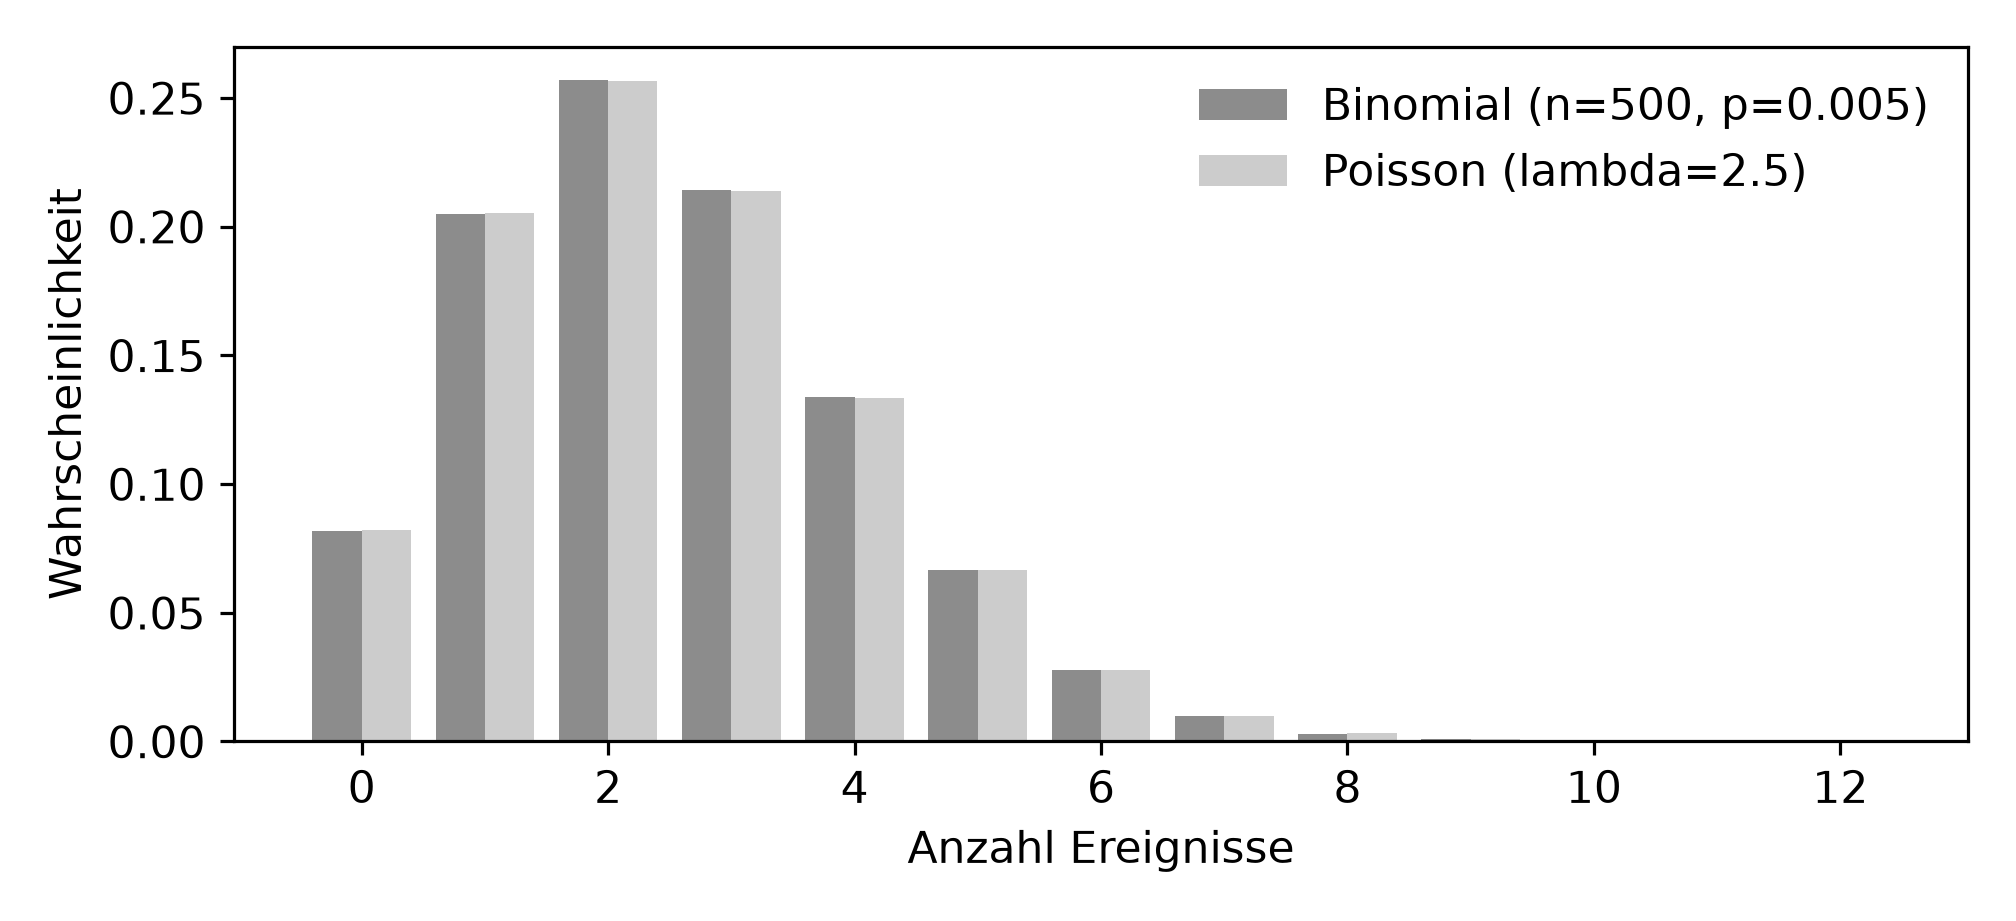
Abbildung 8: Beispiel 5: dieselbe Annäherung in Python.
for nb, pb in [(500, 0.005), (50, 0.05), (10, 0.25), (5, 0.5)]:
    abweichung = np.abs(stats.binom.pmf(k, nb, pb)
                        - stats.poisson.pmf(k, nb * pb)).max()
    print(f"n = {nb:4d} | p = {pb:5.3f} | lambda = {nb * pb:.2f}"
          f" | max. Abweichung {abweichung:.5f}"
          f" | Var {nb * pb * (1 - pb):.3f} gegen {nb * pb:.3f}")
n =  500 | p = 0.005 | lambda = 2.50 | max. Abweichung 0.00059 | Var 2.487 gegen 2.500
n =   50 | p = 0.050 | lambda = 2.50 | max. Abweichung 0.00611 | Var 2.375 gegen 2.500
n =   10 | p = 0.250 | lambda = 2.50 | max. Abweichung 0.03652 | Var 1.875 gegen 2.500
n =    5 | p = 0.500 | lambda = 2.50 | max. Abweichung 0.09874 | Var 1.250 gegen 2.500

Output Zeile für Zeile

Alle vier haben denselben Erwartungswert \(\lambda = 2.5\):

n p grösste Abweichung Varianz binomial Varianz Poisson
500 0.005 0.00059 2.4875 2.5
50 0.050 0.00611 2.3750 2.5
10 0.250 0.03652 1.8750 2.5
5 0.500 0.09874 1.2500 2.5
Beobachtung Erklärung
Die Näherung wird um den Faktor 170 schlechter Von 0.0006 auf 0.099, während der Erwartungswert derselbe bleibt. Entscheidend ist allein, wie klein \(p\) ist.
Der Grund steht in der Varianzspalte Binomial hat \(np(1-p)\), Poisson hat \(np\). Die beiden fallen zusammen, wenn \((1-p) \approx 1\), also bei kleinem \(p\). Bei \(p = 0.5\) ist die Binomialvarianz nur halb so gross.
Bei \(n = 500\) liegen die Balken deckungsgleich Ein Unterschied von 0.0006 ist in keiner Grafik zu sehen.
Die Faustregel \(n \ge 50\) und \(p \le 0.05\), oder \(np \le 10\). Bei \(n = 5\) und \(p = 0.5\) ist beides verletzt.

Warum die Näherung praktisch nützlich ist, obwohl die Binomialverteilung genauso leicht zu rechnen wäre: Die Zahl der Gelegenheiten ist in der Praxis meist unbekannt.

Wie viele Gelegenheiten gab es für einen Maschinenausfall in einer Woche? Wie viele für einen Tippfehler auf einer Seite? Die Frage ist nicht beantwortbar und muss es auch nicht sein, weil die Poissonverteilung nur die Rate braucht. Das ist der eigentliche Gewinn, nicht die Rechenersparnis.

Und die Umkehrung erklärt die Anwendungsfälle: Wo man die Gelegenheiten zählen kann (zehn Bauteile geprüft, hundert Personen befragt), ist die Binomialverteilung die richtige.

Interpretation und Ergebnissatz

Die Binomialverteilung mit n = 500 und p = 0.005 unterscheidet sich von der Poissonverteilung mit \(\lambda\) = 2.5 um höchstens 0.0006 in der Punktwahrscheinlichkeit. Bei n = 5 und p = 0.5 beträgt die Abweichung 0.099; die Näherung setzt kleines p voraus, nicht nur den passenden Erwartungswert.

Verständnisfragen

Warum ist 1 - pbinom(3, 10, 0.3) die Wahrscheinlichkeit für mehr als drei Erfolge und nicht für mindestens drei?

Weil pbinom(3, ...) höchstens drei bedeutet und die Drei einschliesst
Richtig. Das Gegenereignis dazu ist vier und aufwärts. Für mindestens drei müsste 1 - pbinom(2, ...) stehen, im Beispiel ein Unterschied von 0.35 gegenüber 0.62.
Weil pbinom bei null zu zählen beginnt
Das tut es, ändert aber nichts an der Grenze.
Weil die Binomialverteilung diskret ist
Diskret ist sie, und genau deshalb ist die Verschiebung um eins überhaupt möglich. Der Grund liegt aber in der Bedeutung von höchstens.

Aus einer Urne mit zehn Kugeln, davon drei roten, wird fünfmal ohne Zurücklegen gezogen. Warum ist die Anzahl roter Kugeln nicht binomialverteilt?

Weil die Stichprobe zu klein ist
Der Umfang ist nicht die Bedingung.
Weil sich die Erfolgswahrscheinlichkeit mit jeder Ziehung ändert
Richtig. Nach einer gezogenen roten Kugel sind nur noch zwei von neun rot. Zuständig ist die hypergeometrische Verteilung, deren Varianz um den Faktor (N-n)/(N-1) kleiner ist, hier 0.58 statt 1.05.
Weil es nur zwei Farben gibt
Zwei Ausgänge sind gerade die Voraussetzung der Binomialverteilung.

Im Mittel fallen 2.5 Maschinen pro Woche aus, die beobachtete Varianz beträgt 9. Was folgt daraus?

Nichts, Mittel und Varianz dürfen abweichen
Bei den meisten Verteilungen ja. Bei der Poissonverteilung nicht, und die wäre hier das naheliegende Modell.
Das Poisson-Modell passt nicht
Richtig. Bei ihr sind Erwartungswert und Varianz gleich. Ein Dispersionsindex von 3.6 heisst Überdispersion und deutet auf Ausfälle in Schüben; passend wäre ein negativ-binomiales Modell.
Die Ausfälle sind normalverteilt
Aus der Abweichung folgt nur, dass Poisson nicht passt, nicht welches Modell zutrifft.

Zwei Modelle haben denselben Erwartungswert \(np = \lambda = 2.5\): Binomial mit n = 5, p = 0.5 und Poisson. Wie gut ist die Näherung?

Schlecht, die Näherung braucht kleines p, nicht nur den passenden Erwartungswert
Richtig. Die grösste Abweichung beträgt 0.099. Der Grund liegt in der Varianz: binomial np(1-p) = 1.25 gegen Poisson np = 2.5.
Gut, weil die Erwartungswerte übereinstimmen
Der Erwartungswert allein genügt nicht.
Die Frage ist nicht entscheidbar
Der Vergleich der Punktwahrscheinlichkeiten beantwortet sie unmittelbar.

Warum ist die Poissonverteilung praktisch nützlicher als die Binomialverteilung, wenn Ereignisse selten sind?

Weil sie die Zahl der Gelegenheiten nicht braucht
Richtig. Wie viele Gelegenheiten es für einen Maschinenausfall in einer Woche gab, lässt sich nicht beantworten. Die Poissonverteilung braucht nur die Rate.
Weil sie schneller zu rechnen ist
Der Rechenaufwand spielt heute keine Rolle.
Weil sie genauer ist
Sie ist eine Näherung; genauer wäre die Binomialverteilung, wenn man ihre Parameter kennte.

Verlinkte Ressourcen