Verteilungen, Ausreisser und Zusammenhänge systematisch sichten.
Kernideen
Explorative Analyse erzeugt Fragen, sie beantwortet keine.
Die Erwartung wird vor dem Blick in die Daten formuliert, sonst bestätigt man, was man ohnehin vermutet hat.
Variation: ein Merkmal für sich ansehen. Kovariation: zwei Merkmale gemeinsam.
Auffällige Muster verraten meist etwas über die Erhebung, nicht über den untersuchten Gegenstand.
Platzhalter für fehlende Werte sind gefährlicher als offene Lücken, weil sie mitgerechnet werden.
Die Grafiken dieser Phase sind Arbeitsmittel und dürfen hässlich sein.
Jeder Befund ist vorläufig, bis er an neuen Daten geprüft ist.
Erklärung
Vorwissen:Data Wrangling für die Aufbereitung, Skalenniveaus und Lage- und Streuungsmasse für die Kennzahlen sowie ggplot2 für die Grafiken. Diese Seite bringt keine neue Technik, sondern ordnet die bisherigen zu einem Vorgehen. Was dabei an Mängeln auffällt, behandelt die Datenqualität.
Was EDA ist und was nicht
Zwischen Rohdaten und Modell liegt eine Phase, die in Lehrbüchern oft fehlt und in der Praxis den Ausschlag gibt. Sie besteht nicht darin, eine Liste vorgeschriebener Kennzahlen abzuarbeiten. Sie besteht aus einer Schleife: eine Frage an die Daten stellen, sie mit einer Kennzahl oder Grafik beantworten, aus der Antwort die nächste Frage ableiten.
Daraus folgt etwas Praktisches. Die Grafiken dieser Phase sind Arbeitsmittel und dürfen hässlich sein. Wer hier schon an Farben und Beschriftung feilt, verlangsamt sich genau dort, wo Tempo zählt. Sorgfalt in der Gestaltung kommt später, wenn feststeht, was überhaupt gezeigt werden soll.
Die Erwartung kommt vor dem Blick
Der menschliche Verstand findet für fast jedes Bild eine Erklärung, auch für Zufall. Wer eine Grafik ansieht und danach überlegt, was sie bedeutet, bestätigt oft nur, was er ohnehin vermutet hat.
Der Gegenzug ist billig und wirksam: vorher aufschreiben, was man erwartet. Etwa so, für das Merkmal Blutdruck: Werte zwischen 90 und 180, eingipflig, leicht rechtsschief, Mittelwert um 130. Weicht die Grafik davon ab, fällt es sofort auf, und die Abweichung ist der interessante Teil.
Die Reihenfolge
Schritt
Frage
Werkzeug
1. Struktur
Wie viele Zeilen, welche Spalten, welche Typen?
str(), info()
2. Vollständigkeit
Wo fehlen Werte, wo stehen Platzhalter?
Zählen, Minimum und Maximum
3. Variation
Wertebereich, Form, Gipfel, Absonderlichkeiten je Merkmal
Histogramm, Boxplot, Kennzahlen
4. Kovariation
Welche Merkmale hängen zusammen?
Streudiagramm, Boxplots je Gruppe, Kreuztabelle
5. Aufteilung
Ändert sich das Bild je Gruppe?
dieselben Grafiken, nach Gruppen getrennt
Schritt 2 vor Schritt 3 ist wichtig: Ein Platzhalter von -1 oder 999 verzerrt jede Kennzahl, und zwar unauffällig.
Welche Darstellung wozu
Kombination
Darstellung
ein metrisches Merkmal
Histogramm, Boxplot, Verteilungsfunktion
ein kategoriales Merkmal
Häufigkeitstabelle, Stabdiagramm
metrisch und metrisch
Streudiagramm
metrisch und kategorial
Boxplots nebeneinander
kategorial und kategorial
Kreuztabelle, gestapelte Balken
Beispiele
Alle Beispiele arbeiten mit demselben konstruierten Datensatz: 400 Untersuchungen mit Gewicht, Alter, Standort und Blutdruck. Eingebaut sind drei Auffälligkeiten, wie sie in echten Exporten vorkommen, welche, verrät die Auswertung selbst.
Der erste Blick gilt nicht der Verteilung, sondern der Vollständigkeit: Wie viele Zeilen, welche Typen, wo fehlen Werte und wo stehen Platzhalter, die wie Werte aussehen?
     gewicht  alter  blutdruck
min     -1.0     18       92.0
max    124.5     74      160.0
Output Zeile für Zeile
Merkmal
Typ
fehlend
Minimum
Maximum
Auffällig?
gewicht
numerisch
0
-1.0
124.5
ja, ein Gewicht von -1 kg gibt es nicht
alter
ganzzahlig
0
18
74
nein
standort
Text
0
nein (Bern 200, Chur 129, Sion 71)
blutdruck
numerisch
18
92
160
die Lücken sind offen deklariert
Beobachtung
Erklärung
gewicht hat null fehlende Werte und trotzdem ein Problem
Die -1 ist ein Platzhalter: Irgendeine Erfassungsstelle hat “unbekannt” als -1 codiert. Für R und Python ist das eine gültige Zahl.
blutdruck hat 18 offene Lücken
Das ist der harmlosere Fall: NA beziehungsweise NaN wird von jeder Kennzahl ausgeschlossen oder erzeugt eine Fehlermeldung.
Der Blick auf Minimum und Maximum findet beides
Deshalb steht er vor jeder Verteilungsgrafik. Eine Kennzahl allein verrät den Platzhalter nicht, bei drei Fällen von 400 verschiebt er den Mittelwert um weniger als ein Prozent.
Die Standorte sind ungleich besetzt
200, 129 und 71. Für alle Gruppenvergleiche heisst das: relative Häufigkeiten verwenden.
Die üblichen Platzhalter, nach denen sich zu suchen lohnt:
Wert
Herkunft
-1, -99, -999
Codierung für “unbekannt” in älteren Erfassungssystemen
0 bei Merkmalen, die nicht null sein können
Gewicht, Blutdruck, Alter
999, 9999
dasselbe wie oben, nur nach oben
1900-01-01, 1970-01-01
Standarddatum bei fehlender Eingabe
leere Zeichenkette gegen NA
zwei verschiedene Zustände, die gleich aussehen
Sie alle haben eine Eigenschaft gemeinsam: Sie werden mitgerechnet. Eine offene Lücke fällt auf, ein Platzhalter nicht.
Interpretation und Ergebnissatz
Der Datensatz umfasst 400 Beobachtungen. Beim Blutdruck fehlen 18 Werte (4.5 Prozent), beim Gewicht sind drei Werte mit dem Platzhalter -1 codiert. Beide werden vor der Auswertung als fehlend gekennzeichnet.
Frage und Datenlage
Drei Werte von 400, kann das viel ausmachen? Die Antwort hängt davon ab, welche Kennzahl man ansieht.
                  n mittel    sd  min median
mit_platzhalter 400  80.53 13.20 -1.0   80.5
bereinigt       397  81.15 11.17 49.7   80.6
Output Zeile für Zeile
Kennzahl
mit Platzhaltern
bereinigt
Abweichung
n
400
397
Mittelwert
80.53
81.15
-0.8 %
Standardabweichung
13.20
11.17
+18 %
Minimum
-1.0
49.7
Median
80.5
80.6
+0.1
Beobachtung
Erklärung
Der Mittelwert verschiebt sich kaum
Drei von 400 Werten, jeder rund 82 kg zu tief, das macht 0.6 kg auf den Mittelwert. Wer nur ihn ansieht, merkt nichts.
Die Standardabweichung ist 18 Prozent zu gross
Weil sie quadriert: \((80.5 - (-1))^2 = 6642\) je Platzhalter. Drei davon beherrschen die Summe.
Der Median bewegt sich um 0.1 kg
Er zählt nur ab. Drei Extremwerte am unteren Ende verschieben ihn um anderthalb Rangpositionen, bei 400 Werten praktisch nichts.
Das Minimum verrät alles
-1.0 gegen 49.7. Es ist die billigste und wirksamste Prüfung, die es gibt.
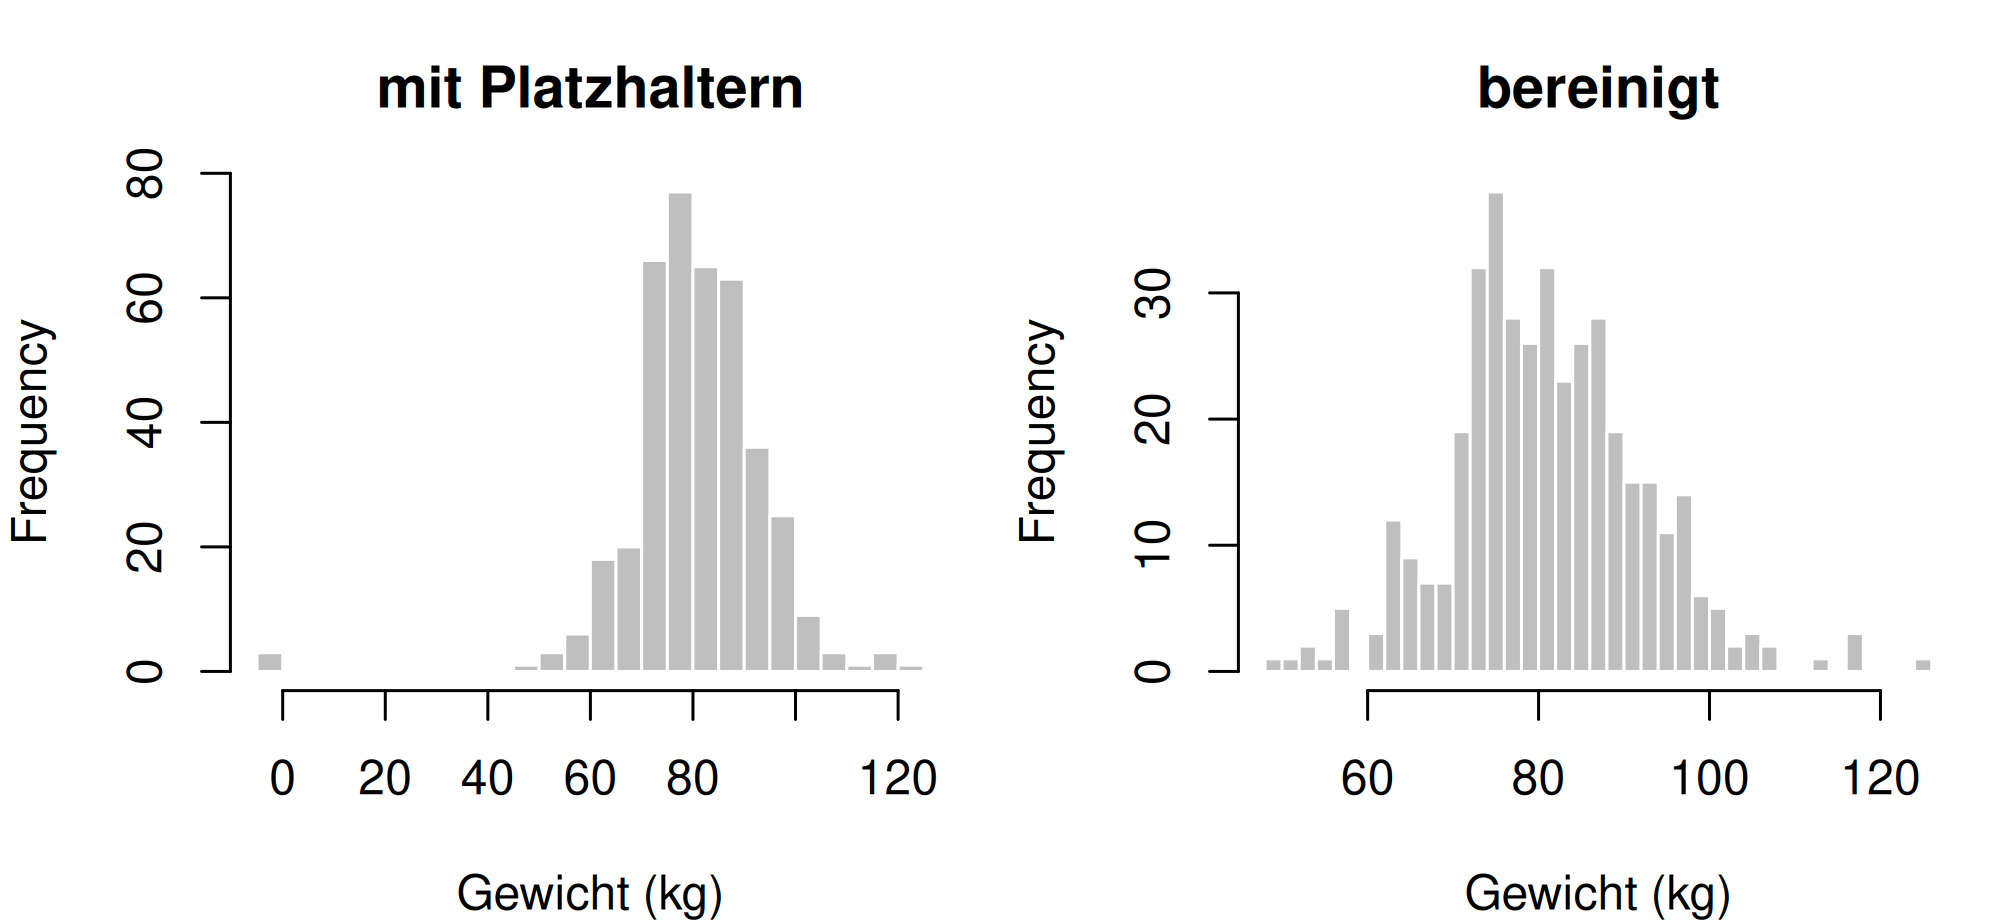
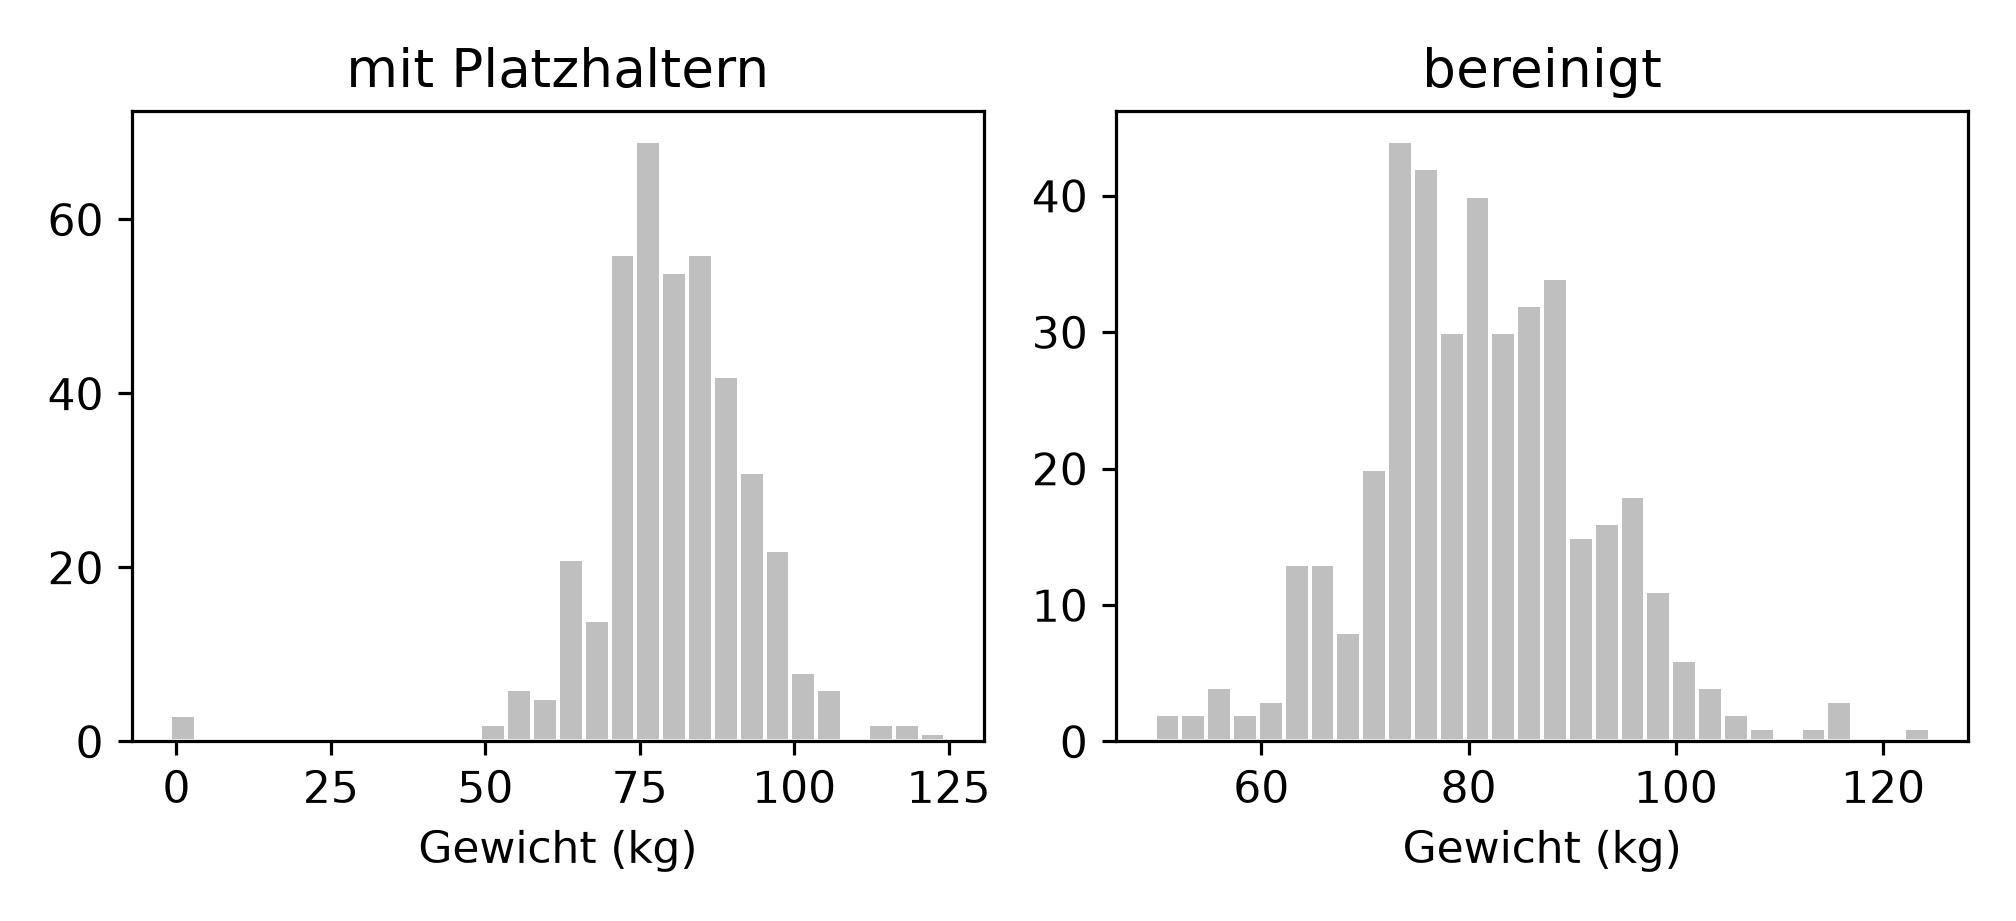
Im linken Histogramm sitzt ein winziger Balken bei -1
Bei 30 Klassen über einen Bereich von 125 kg ist er kaum zu sehen und die Hauptverteilung wird zusammengedrückt, weil die Achse bis -1 reicht.
Warum das die gefährlichste Sorte Datenfehler ist: Er erzeugt keine Fehlermeldung, verändert die auffälligste Kennzahl kaum und die unauffälligste stark. Ein Bericht mit “Mittelwert 80.5 kg, Standardabweichung 13.2” sieht vollkommen plausibel aus.
Und die Folge zieht sich durch: Jedes Konfidenzintervall, jeder t-Test und jede Regression, die auf dieser Streuung beruhen, sind zu breit beziehungsweise zu schwach.
Was nicht geht: die drei Zeilen stillschweigend löschen. Berichtet gehört, wie viele Werte aus welchem Grund entfernt wurden.
Interpretation und Ergebnissatz
Drei Gewichtsangaben waren mit dem Platzhalter -1 codiert und wurden als fehlend gekennzeichnet (n = 397 statt 400). Dadurch sinkt die Standardabweichung von 13.20 auf 11.17 kg, während sich der Mittelwert nur um 0.6 kg ändert.
Frage und Datenlage
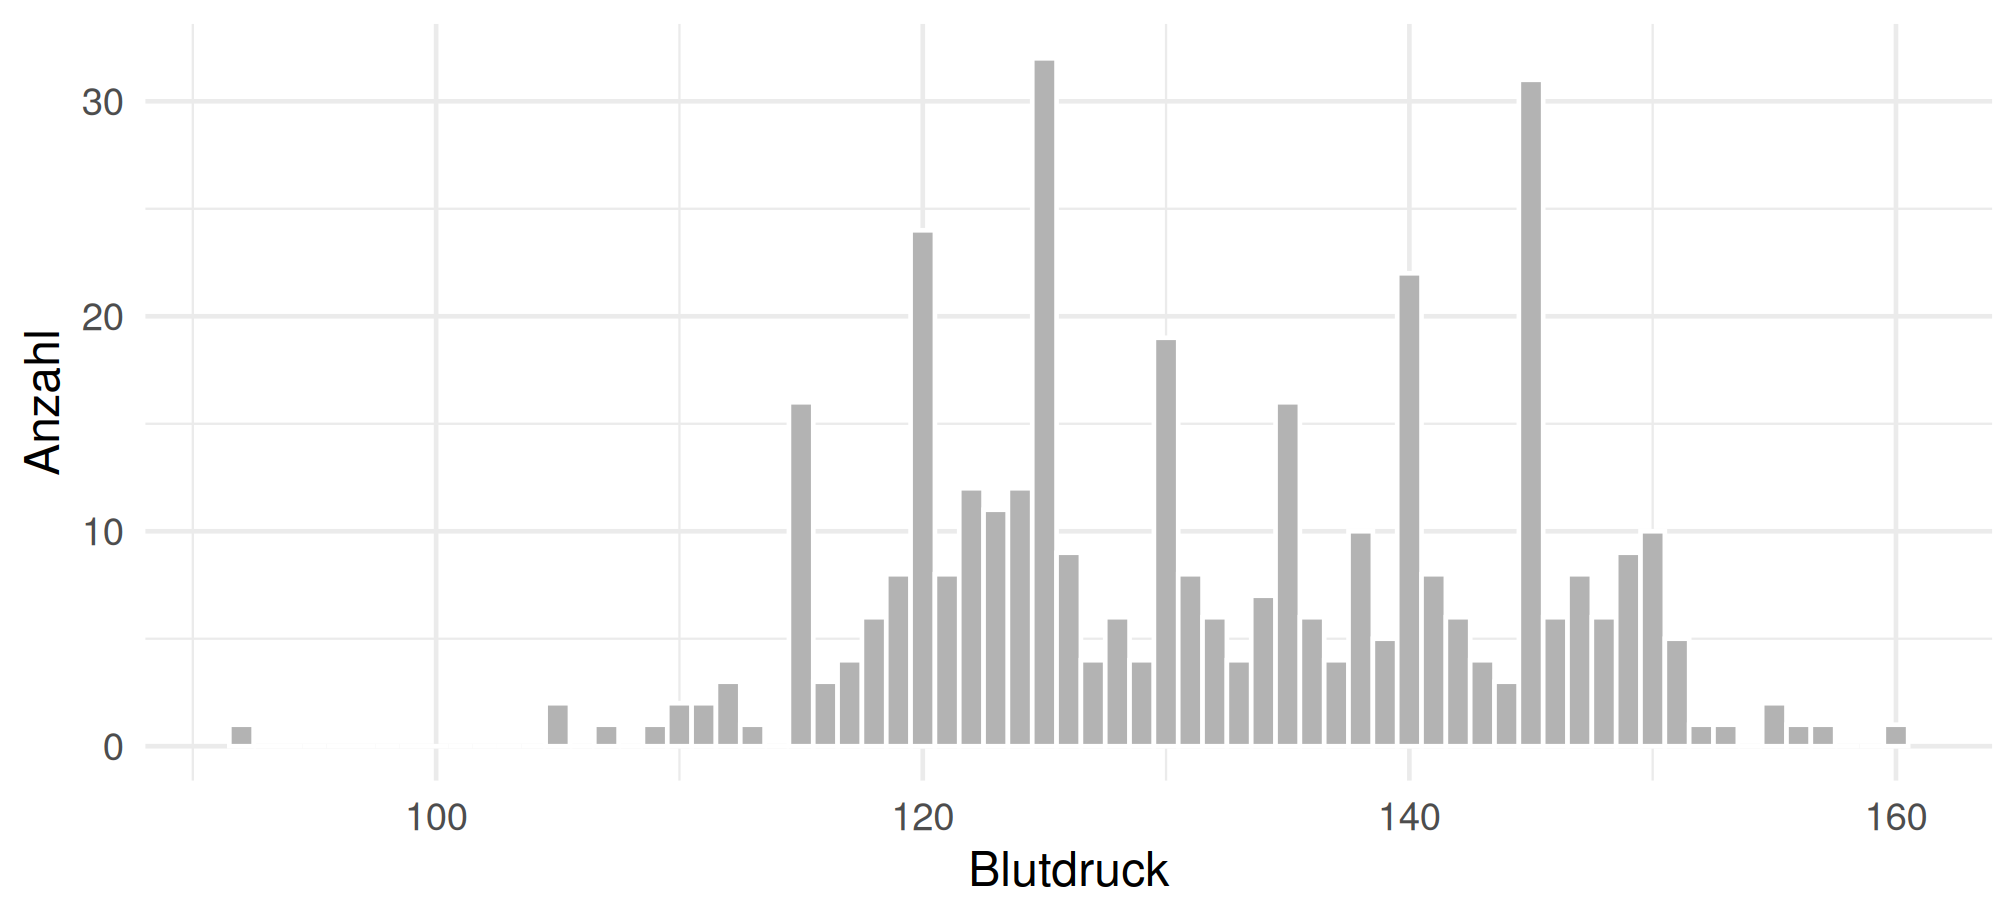
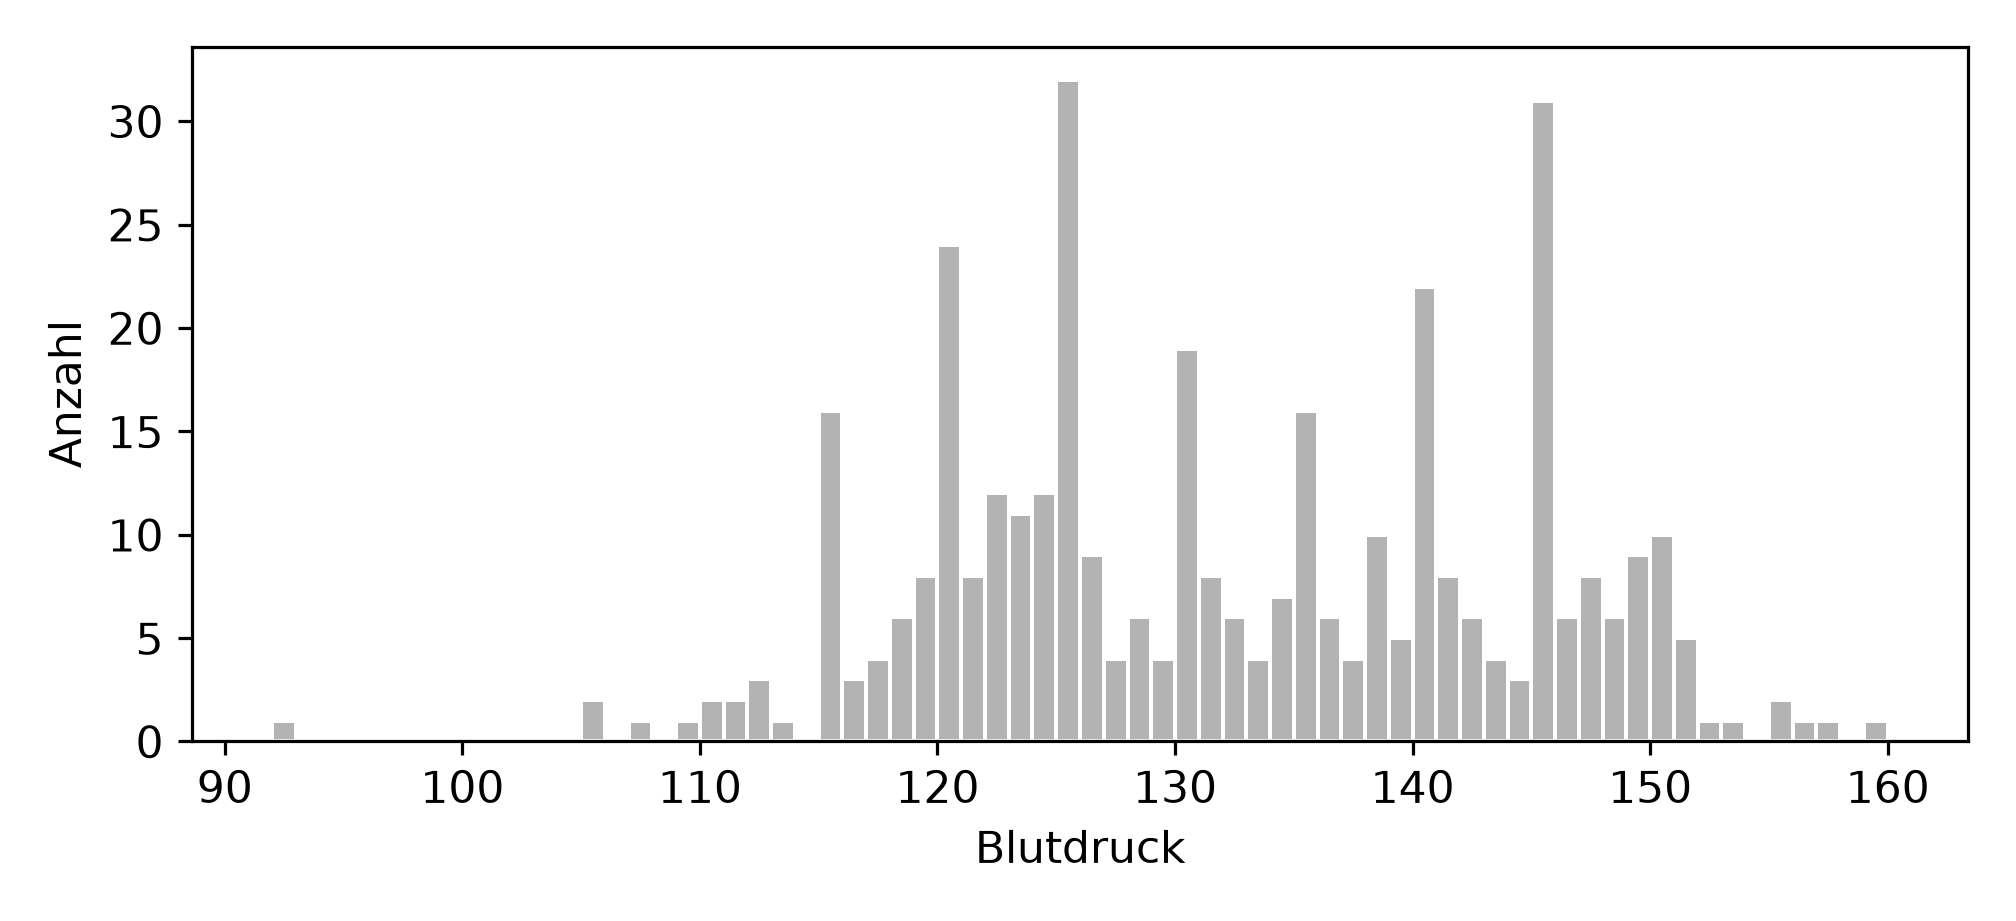
Die Erwartung für den Blutdruck war notiert: Werte zwischen 90 und 180, eingipflig, leicht rechtsschief, Mittelwert um 130. Stimmt das Bild damit überein?
print("Anteil auf 0 oder 5:",round(float(endziffern[0.0] + endziffern[5.0]), 3))
Anteil auf 0 oder 5: 0.463
Output Zeile für Zeile
Die Erwartung gegen den Befund:
Erwartet
Beobachtet
Stimmt?
Werte zwischen 90 und 180
92 bis 160
ja
eingipflig
ja
ja
Mittelwert um 130
131.85
ja
glatte Form
stark gezackt
nein
Und die Endziffern, die den Zacken erklären:
Endziffer
0
1
2
3
4
5
6
7
8
9
Anteil
0.204
0.081
0.076
0.055
0.058
0.259
0.065
0.058
0.073
0.071
Beobachtung
Erklärung
Erwartet wären 10 Prozent je Endziffer
Bei sauber gemessenen Werten.
Beobachtet: 20.4 und 25.9 Prozent auf 0 und 5
Zusammen 46.3 Prozent statt der erwarteten 20.
Die übrigen acht Ziffern liegen bei 5.5 bis 8.1 Prozent
Also unter 10, genau um den Betrag, der auf 0 und 5 zusätzlich landet.
Das ist eine Rundungspräferenz
Ein Teil der Werte wurde nicht abgelesen, sondern geschätzt und auf fünf gerundet. Hier betrifft es rund 150 der 400 Beobachtungen.
Was das für die Auswertung heisst: Die Genauigkeit ist geringer, als die Zahlen suggerieren. Konkret:
Kennzahlen wie Mittelwert und Median bleiben brauchbar, die Rundung streut in beide Richtungen und hebt sich weitgehend auf.
Der Anteil unter einem Grenzwert wird unzuverlässig, wenn der Grenzwert selbst auf 0 oder 5 endet. Ein Schwellenwert von 140 trifft mitten in eine Häufung.
Feine Unterschiede zwischen Gruppen verschwinden im Rundungsrauschen.
Solche Muster sind fast immer Hinweise auf die Erhebung, nicht auf den untersuchten Gegenstand. Gehäufte Rundwerte, verdächtig glatte Mittelwerte oder identische Wiederholungen entstehen beim Erfassen, nicht in der Natur.
Und sie fallen nur bei Klassenbreite 1 auf. Ein Histogramm mit der üblichen Klassenzahl hätte die Zacken weggeglättet, ein Beispiel dafür, dass man in der Erkundungsphase absichtlich zu fein auflöst.
Interpretation und Ergebnissatz
Die Blutdruckwerte enden zu 46.3 Prozent auf 0 oder 5, erwartet wären 20 Prozent. Ein erheblicher Teil der Werte wurde offenbar gerundet erfasst; die tatsächliche Messgenauigkeit liegt bei etwa 5 mmHg.
Frage und Datenlage
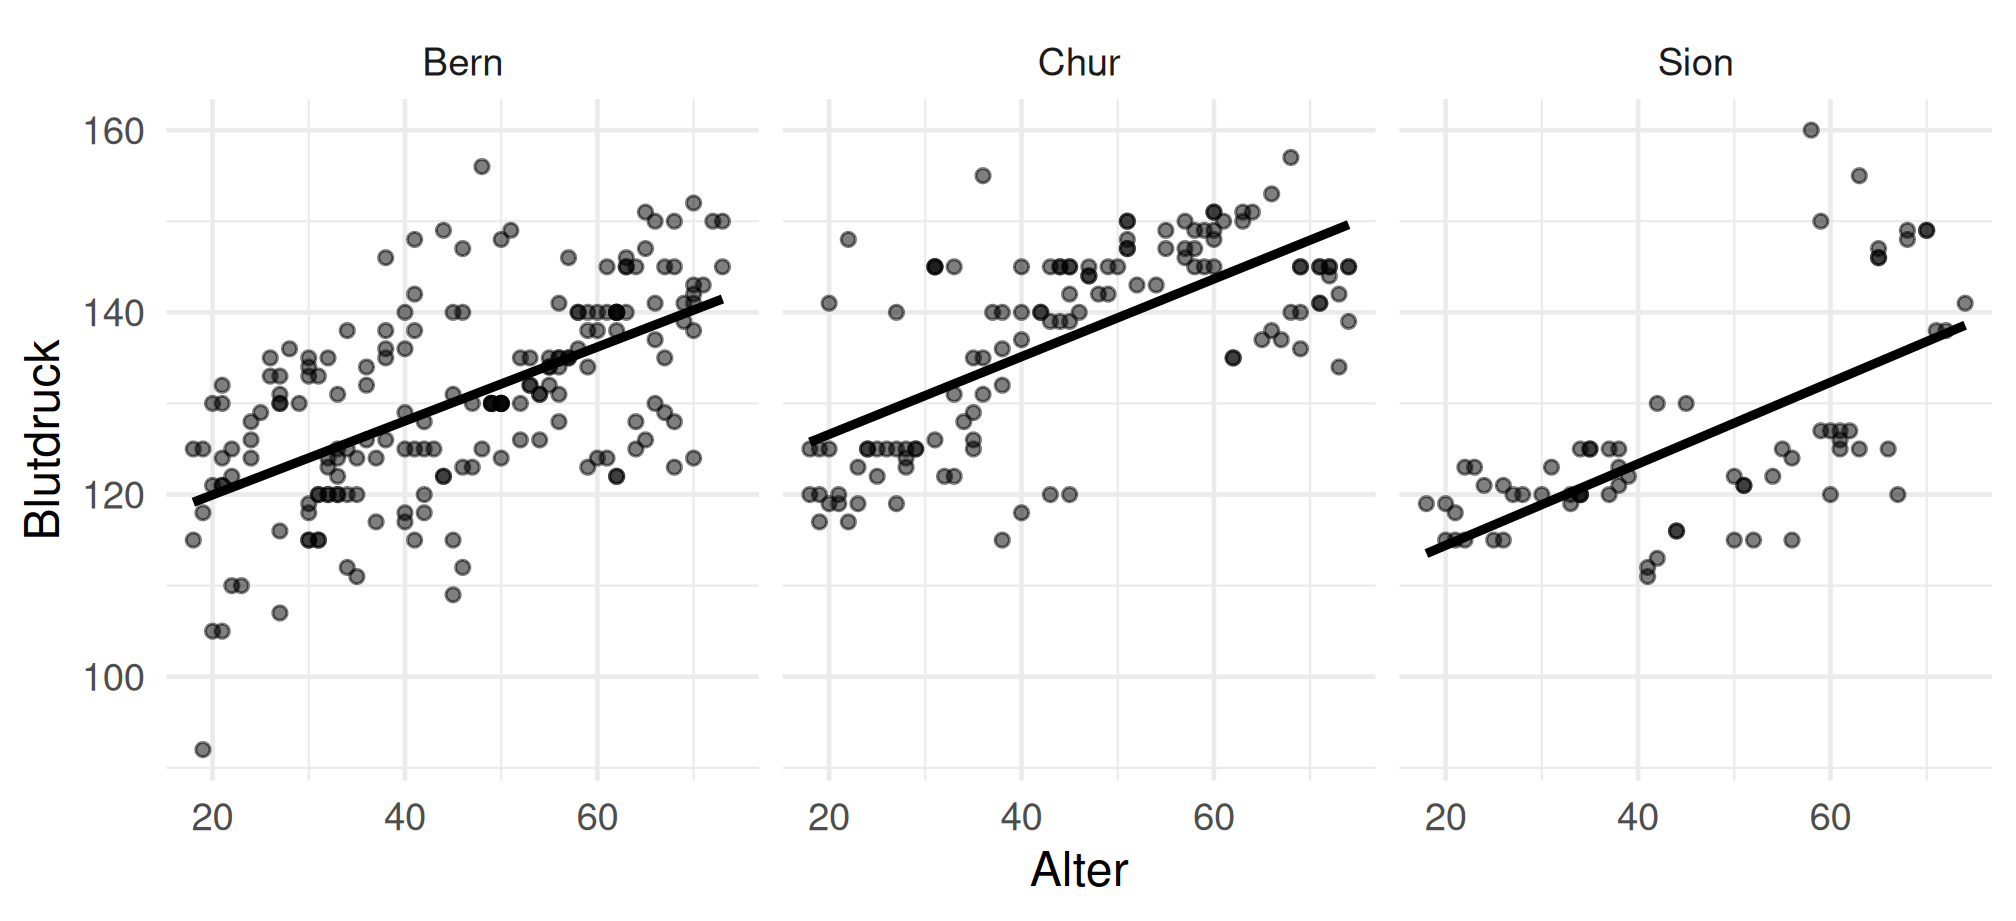
Blutdruck gegen Alter und ändert sich das Bild, wenn man nach Standort trennt?
           alter gewicht blutdruck
alter      1.000  -0.034     0.581
gewicht   -0.034   1.000     0.230
blutdruck  0.581   0.230     1.000
Output Zeile für Zeile
Standort
n
Steigung je Jahr
Achsenabschnitt
mittlerer Blutdruck
Bern
190
0.406
111.8
130.3
Chur
123
0.426
118.1
137.6
Sion
69
0.447
105.5
125.9
Beobachtung
Erklärung
Die Steigungen sind praktisch gleich
0.41 bis 0.45 mmHg je Lebensjahr. Der Zusammenhang zwischen Alter und Blutdruck ist an allen drei Standorten derselbe.
Die Niveaus unterscheiden sich
Chur liegt rund 12 mmHg über Sion. Die drei Geraden verlaufen parallel, nur versetzt.
Das ist der Unterschied zwischen Versatz und Wechselwirkung
Verschiedene Achsenabschnitte bei gleicher Steigung heissen: Der Standort verschiebt das Niveau, ändert aber nicht den Alterseffekt. Verschiedene Steigungen wären eine Wechselwirkung, dann müsste man je Standort getrennt berichten.
Die Korrelationen
Alter mit Blutdruck 0.581, Gewicht mit Blutdruck 0.230
Warum die Aufteilung nach einer dritten Variablen zum Pflichtprogramm gehört: Ohne sie hätte man einen Gesamtzusammenhang zwischen Alter und Blutdruck gesehen und die Standortunterschiede in der Streuung versteckt. Im Extremfall kann eine Aufteilung den Zusammenhang sogar umkehren, das ist Simpsons Paradoxon, siehe multiple Regression.
Die Faustregel: Nach jeder Variablen aufteilen, die inhaltlich als Erklärung in Frage kommt, und zwar bevor man einen Gesamtbefund formuliert. Bei drei bis fünf Kandidaten ist das schnell erledigt; bei zwanzig braucht es eine Auswahl aus dem Fachwissen.
Und die Gegenwarnung: Wer lange genug aufteilt, findet immer eine Gruppe, in der etwas auffällig aussieht. Deshalb ist jeder so gefundene Befund vorläufig, bis er an neuen Daten geprüft ist.
Interpretation und Ergebnissatz
Der Blutdruck steigt an allen drei Standorten mit etwa 0.4 mmHg je Lebensjahr (0.41 bis 0.45). Die Standorte unterscheiden sich im Niveau: Chur liegt im Mittel bei 137.6 mmHg, Bern bei 130.3 und Sion bei 125.9. Der Befund ist explorativ und für eine Prüfung an neuen Daten vorzumerken.
Frage und Datenlage
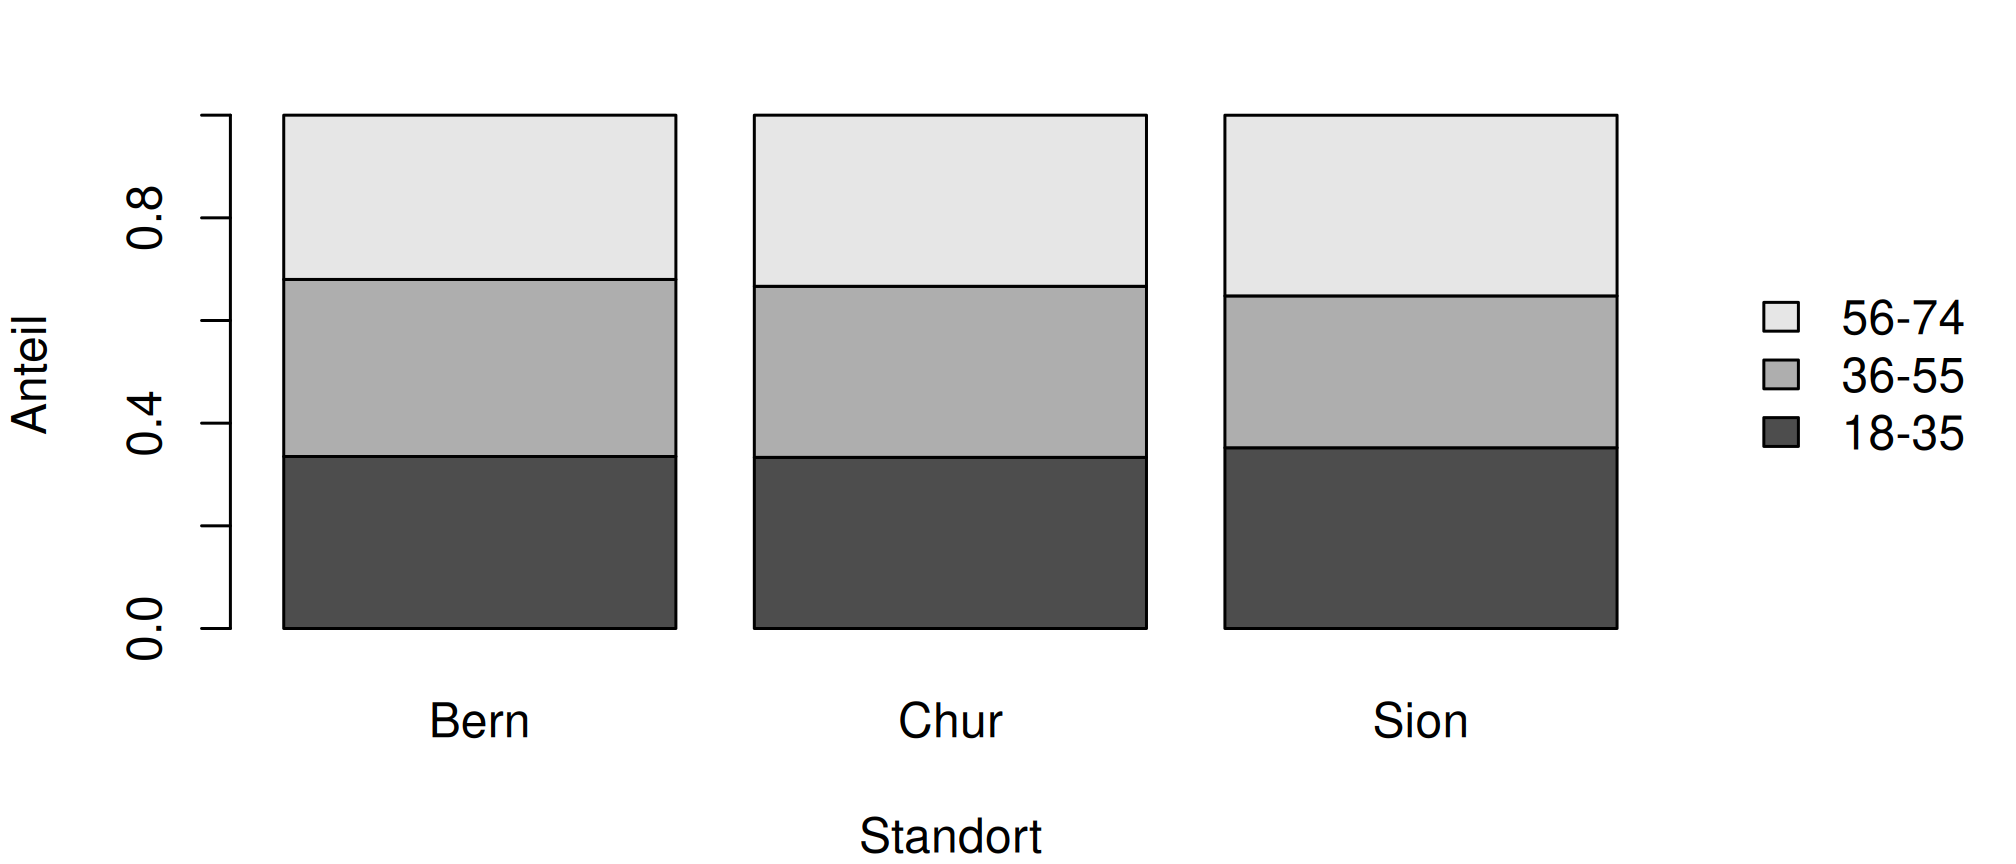
Sind die Altersgruppen über die Standorte gleich verteilt? Wenn nicht, wäre der Standortunterschied aus Beispiel 4 teilweise ein Alterseffekt.
Bern hat in jeder Altersgruppe die meisten Fälle, weil Bern insgesamt die meisten hat.
Die Anteile sind es
Und sie liegen alle bei rund einem Drittel. Die Altersverteilung ist über die Standorte praktisch identisch.
Was daraus für Beispiel 4 folgt
Der Standortunterschied im Blutdruck ist kein verkappter Alterseffekt. Wären in Chur überwiegend ältere Personen erfasst, hätte man den Unterschied damit erklären können.
Die Mediane des Blutdrucks je Standort
130, 140 und 122 bestätigen das Bild aus Beispiel 4 auch robust, also ohne Einfluss einzelner Extremwerte.
Die Reihenfolge, in der diese beiden Beispiele stehen, ist kein Zufall. Erst fällt ein Unterschied auf (Beispiel 4), dann wird nach der naheliegendsten Alternativerklärung gesucht (Beispiel 5). So sieht die Schleife aus, aus der EDA besteht:
Frage → Grafik oder Kennzahl → Befund → nächste Frage aus dem Befund
Und sie hört nicht auf, weil die Daten erschöpft wären, sondern weil einem keine Alternativerklärung mehr einfällt, die man prüfen könnte. Genau deshalb ist das Ergebnis eine Hypothese und kein Nachweis.
Interpretation und Ergebnissatz
Die Altersgruppen sind über die drei Standorte gleichmässig verteilt (je rund ein Drittel je Gruppe, n = 200, 129 und 71). Der beobachtete Blutdruckunterschied zwischen den Standorten lässt sich damit nicht durch eine unterschiedliche Altersstruktur erklären.
Verständnisfragen
Ein Merkmal hat null fehlende Werte, aber ein Minimum von -1 bei einer Grösse, die nicht negativ sein kann. Was liegt vor?
Ein Platzhalter für “unbekannt”, der als Zahl gespeichert wurde
Richtig. Er wird von jeder Kennzahl mitgerechnet, ohne eine Warnung auszulösen. Der Blick auf Minimum und Maximum jedes Merkmals findet solche Fälle.
Ein Messfehler
Möglich, aber -1 bei genau drei Fällen sieht nach Codierung aus, nicht nach Messung.
Nichts Besonderes, drei von 400 fallen nicht ins Gewicht
Für den Mittelwert stimmt das ungefähr; die Standardabweichung wächst um 18 Prozent.
Warum fällt ein Platzhalter beim Mittelwert kaum auf, bei der Standardabweichung aber deutlich?
Weil die Standardabweichung die Abweichungen quadriert
Richtig. Ein Wert 80 Einheiten daneben trägt zum Mittelwert 80/n bei, zur Varianz aber \(80^2/n\). Deshalb ist die Streuung die empfindlichere Anzeige.
Weil der Mittelwert robuster ist als die Standardabweichung
Robust ist keines von beiden; sie sind nur verschieden empfindlich.
Weil der Platzhalter negativ ist
Das Vorzeichen spielt keine Rolle, nur der Abstand zum Rest.
Die Endziffern eines Messwerts verteilen sich zu 46 Prozent auf 0 und 5. Was folgt daraus?
Ein Teil der Werte wurde gerundet erfasst
Richtig. Erwartet wären 20 Prozent. Solche Muster verraten etwas über die Erhebung, nicht über den untersuchten Gegenstand und die tatsächliche Genauigkeit ist geringer, als die Zahlen suggerieren.
Die Daten sind gefälscht
Das ist eine viel stärkere Behauptung. Rundung beim Ablesen ist die harmlose und häufigste Erklärung.
Die Stichprobe ist zu klein
Bei 382 Werten wäre die Abweichung von 20 auf 46 Prozent durch Zufall ausgeschlossen.
Drei Streudiagramme zeigen für drei Standorte praktisch dieselbe Steigung, aber verschiedene Achsenabschnitte. Wie ist das zu deuten?
Der Standort verschiebt das Niveau, ändert aber den Alterseffekt nicht
Richtig. Parallele Geraden heissen Versatz ohne Wechselwirkung. Verschiedene Steigungen wären eine Wechselwirkung, und dann müsste man je Standort getrennt berichten.
Der Standort hat keinen Einfluss
Er hat einen, nämlich auf das Niveau.
Die Standorte sind nicht vergleichbar
Gerade weil die Steigungen übereinstimmen, sind sie es.
Eine explorative Analyse findet in einer von zwölf Untergruppen einen deutlichen Unterschied. Was ist damit gezeigt?
Eine Hypothese, die an neuen Daten zu prüfen ist
Richtig. Wer lange genug aufteilt, findet immer eine auffällige Gruppe. Ein Test auf denselben Daten prüft nichts, weil die Fragestellung aus ihnen stammt.
Ein Effekt in dieser Untergruppe
Möglich, aber nicht belegt.
Nichts, Untergruppenanalysen sind wertlos
Sie sind das Werkzeug, um Hypothesen zu finden. Nur nachweisen können sie nichts.