Jede Clusteranalyse endet mit zwei Fragen, die das Verfahren selbst nicht beantwortet: Wie viele Gruppen, und gibt es überhaupt Gruppen? Diese Seite behandelt die Werkzeuge dafür.
Wichtig ist die Grenze: Alle Masse hier sind innere Gütemasse. Sie beurteilen, wie gut die Aufteilung zur Geometrie der Daten passt, nicht ob sie inhaltlich sinnvoll ist. Ein Clustering mit ausgezeichneter Silhouette kann fachlich wertlos sein, und eine mittelmässige Aufteilung kann genau die Segmente liefern, mit denen man arbeiten will.
keine Suche nötig, aber Beurteilung der Lösung trotzdem sinnvoll
Grundidee und Modell
Drei Werkzeuge, die verschiedene Fragen beantworten.
Silhouette beurteilt jede Beobachtung einzeln:
\[s_i = \frac{b_i - a_i}{\max(a_i, b_i)}\]
Bestandteil
Bedeutung
\(a_i\)
mittlere Distanz zu den übrigen Mitgliedern der eigenen Gruppe
\(b_i\)
mittlere Distanz zur nächstgelegenen fremden Gruppe
\(s_i\)
Wert zwischen minus eins und eins
Werte nahe eins heissen: eigene Gruppe deutlich näher als die nächste fremde. Werte um null heissen: die Beobachtung liegt auf der Grenze. Negative Werte heissen: sie wäre in einer anderen Gruppe besser aufgehoben. Der Mittelwert über alle Beobachtungen ist ein Gesamtmass, das sich über verschiedene k vergleichen lässt.
Ellbogen betrachtet die Streuung innerhalb der Gruppen über k. Diese sinkt immer, aber der Zugewinn wird ab einem Punkt klein. Der Knick ist der Kandidat. Das Verfahren ist verbreitet und schwach: Der Knick ist oft nicht eindeutig.
Gap-Statistik vergleicht die erreichte Streuung mit der, die sich in Zufallsdaten gleicher Ausdehnung ergibt:
Streuung innerhalb der Gruppen bei k Gruppen, in den echten Daten
\(\overline{\log W_k^{\text{Zufall}}}\)
Mittelwert desselben Werts über B Zufallsdatensätze, gleichmässig verteilt über denselben Wertebereich
Gap
wie viel besser die echten Daten sich teilen lassen als reines Rauschen
Der grosse Vorteil: Die Gap-Statistik wird auch für k = 1 berechnet. Sie kann als einzige der drei Methoden die Antwort “eine Gruppe”, also keine Struktur, überhaupt liefern.
Die übliche Auswahlregel stammt von Tibshirani: Gewählt wird das kleinste k, dessen Gap mindestens so gross ist wie der Gap des nächsten k abzüglich dessen Standardfehler. So wird nicht auf zufällige Ausschläge reagiert.
Voraussetzungen und ihre Prüfung
Voraussetzung
Was sie bedeutet
Prüfung
Folge bei Verletzung
Vorgehen
Dieselbe Distanz wie beim Clustering
Gütemass und Verfahren beurteilen dasselbe
Distanzmass prüfen
Bewertung passt nicht zur Lösung
dasselbe Mass verwenden
Standardisierte Daten
Kein Merkmal dominiert
Varianzen vergleichen
Silhouette misst nur die grösste Variable
vor dem Clustering standardisieren
Kompakte Gruppenform
Silhouette bevorzugt kugelige Gruppen
Streudiagramm
Ringe und Ketten werden abgestraft, obwohl sie Gruppen sind
dichtebasierte Masse, oder Beurteilung im Bild
Genügend Beobachtungen je Gruppe
Kleine Gruppen haben instabile Werte
Gruppengrössen
Silhouette schwankt stark
k verkleinern
Mehrere Kriterien
Ein Mass allein entscheidet nicht
Silhouette, Ellbogen, Gap zusammen ansehen
Scheingenauigkeit
mindestens zwei Kriterien plus Inhalt
Output lesen
R:
Grösse
Was sie sagt
Faustregel oder Falle
silhouette(...)[, "sil_width"]
Silhouettenwert je Beobachtung
negative Werte markieren falsch zugeordnete Fälle
Mittelwert der Silhouette
Gesamtmass für ein k
über 0.5 gilt als deutliche Struktur, unter 0.25 als kaum vorhanden
summary(silhouette(...))$clus.avg.widths
Mittelwert je Gruppe
eine schwache Gruppe unter guten fällt hier auf
tot.withinss
Streuung innerhalb der Gruppen
sinkt immer mit k, taugt nur für den Verlauf
clusGap(...)
fertige Gap-Statistik je k mit Standardfehler
zieht die Referenzdaten selbst; braucht einen Startwert für Reproduzierbarkeit
maxSE(...)
wendet die Auswahlregel auf eine Gap-Tabelle an
method = "Tibs2001SEmax" ist die Regel oben
Python:
Zugriff
Was er liefert
Unterschied zu R
silhouette_score(X, labels)
Mittelwert über alle Beobachtungen
in R der Mittelwert der Spalte sil_width
silhouette_samples(X, labels)
Werte je Beobachtung
wie die Spalte in R
inertia_
Streuung innerhalb
wie tot.withinss
keine Gap-Statistik
selbst implementieren, siehe Beispiel 4
in R über clusGap enthalten
kein Silhouettendiagramm
selbst zeichnen, siehe Beispiel 2
in R über plot(silhouette(...))
Die Faustregeln zur Silhouette sind Konvention, keine Grenzwerte mit statistischer Bedeutung. Sie helfen beim Einordnen, ersetzen aber nicht den Blick auf die Gruppen.
Interpretationsfallen
Ein Optimum ist kein Beleg für Struktur. Silhouette und Ellbogen liefern immer ein bestes k, auch in Rauschen. Nur die Gap-Statistik kann “eine Gruppe” empfehlen.
Die Streuung innerhalb taugt nicht als Gütemass. Sie sinkt zwangsläufig mit k; brauchbar ist nur ihr Verlauf.
Der Ellbogen ist oft nicht eindeutig. Wo drei Personen drei verschiedene Knicke sehen, trägt das Kriterium nichts.
Der Silhouettenmittelwert verdeckt Unterschiede. Eine schlecht abgegrenzte Gruppe fällt nur im Diagramm oder in den Gruppenmittelwerten auf.
Silhouette bevorzugt kugelige Gruppen. Bei ringförmigen oder langgezogenen Strukturen bestraft sie richtige Lösungen.
Innere Masse sagen nichts über Nutzen. Ob Segmente brauchbar sind, entscheidet die Sache, nicht die Geometrie.
Grenzwerte sind Konvention. 0.5 als Schwelle für deutliche Struktur ist eine Faustregel, die von Dimensionszahl und Datenlage abhängt.
Ergebnis berichten
Vorlage für den Ergebnissatz:
Die Gruppenzahl wurde anhand von [Kriterien] auf k = [k] festgelegt (n = [n], [Verfahren], standardisierte Merkmale). Die mittlere Silhouette beträgt [Wert], je Gruppe [Werte]; [Anzahl] Beobachtungen haben einen negativen Wert. Die Gap-Statistik empfiehlt [k]. Auf Teilstichproben bleibt die Silhouette bei [Bereich].
Genannt werden: alle herangezogenen Kriterien und ihre Ergebnisse, nicht nur das gewählte; die mittlere Silhouette gesamt und je Gruppe; Anzahl negativer Werte; Gruppengrössen; und die Feststellung, dass überhaupt Struktur vorliegt.
Alle Beispiele arbeiten mit denselben 270 Kunden wie die Seiten zu k-Means und zum hierarchischen Clustering: Besuche und Umsatz, drei eingebaute Gruppen von 120, 90 und 60 Personen, z-standardisiert.
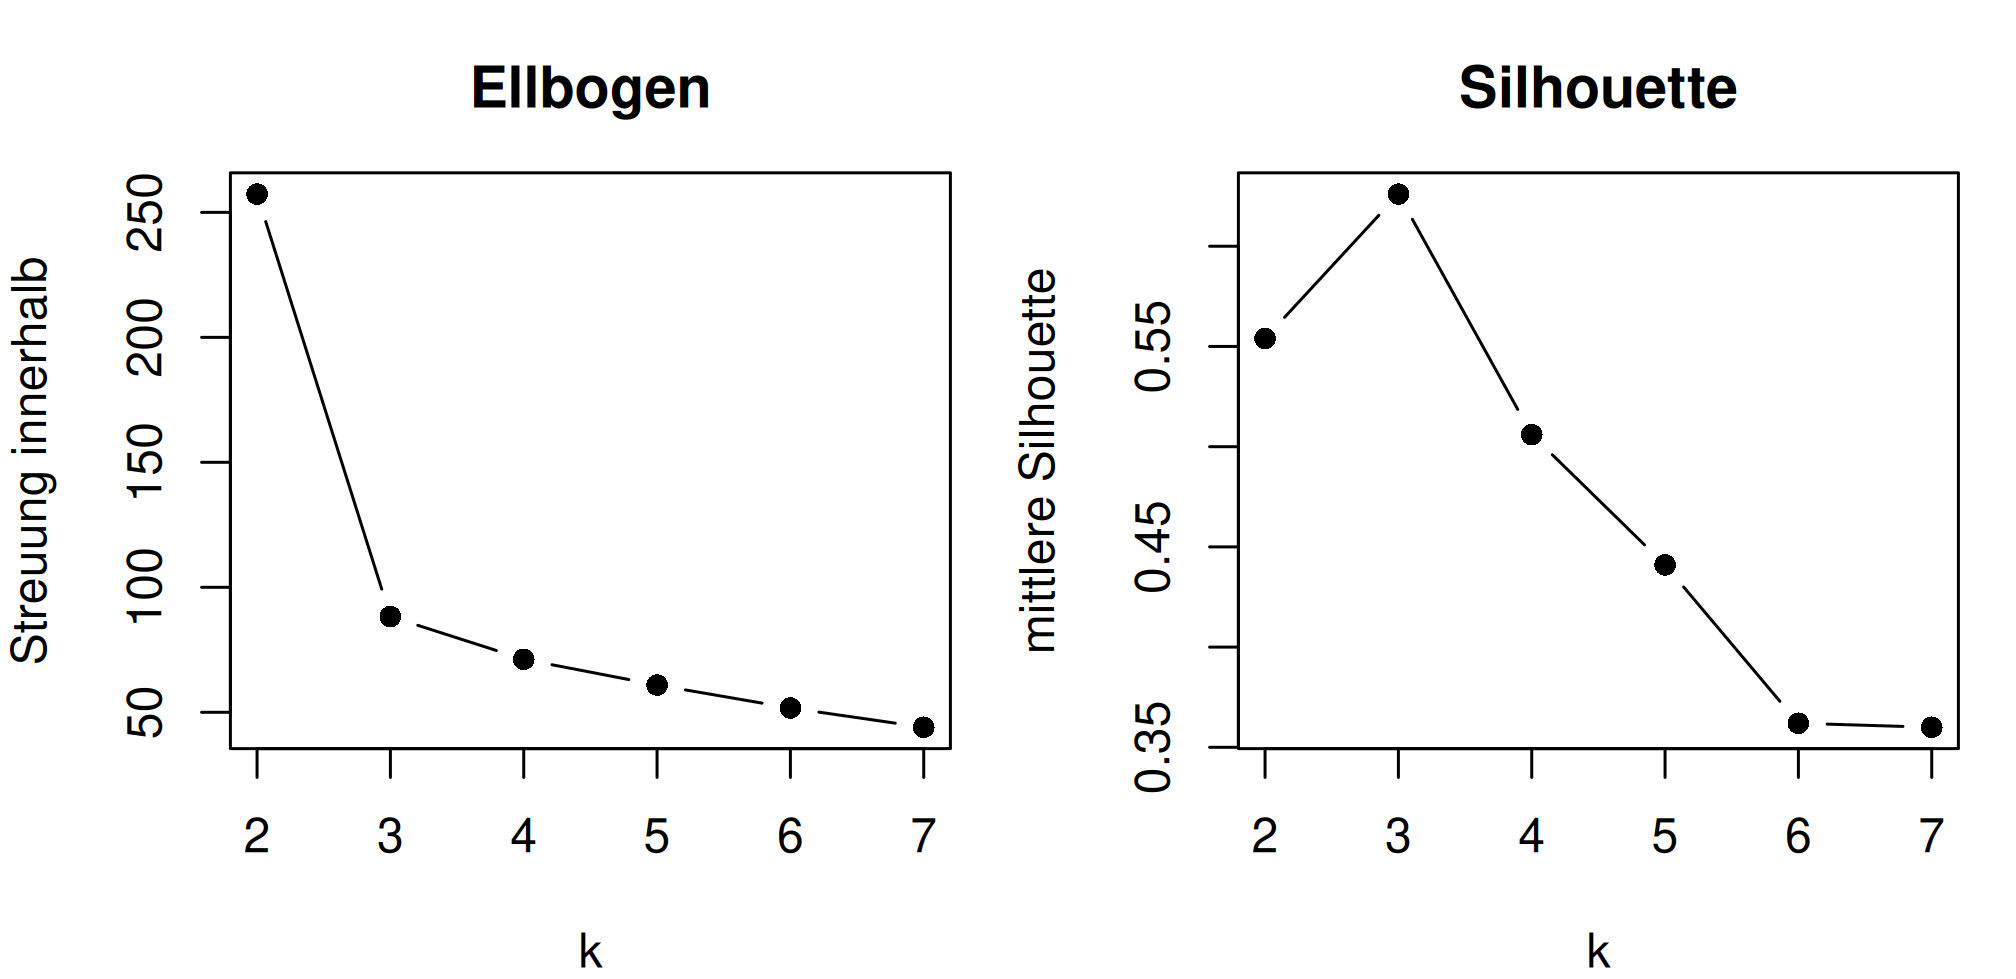
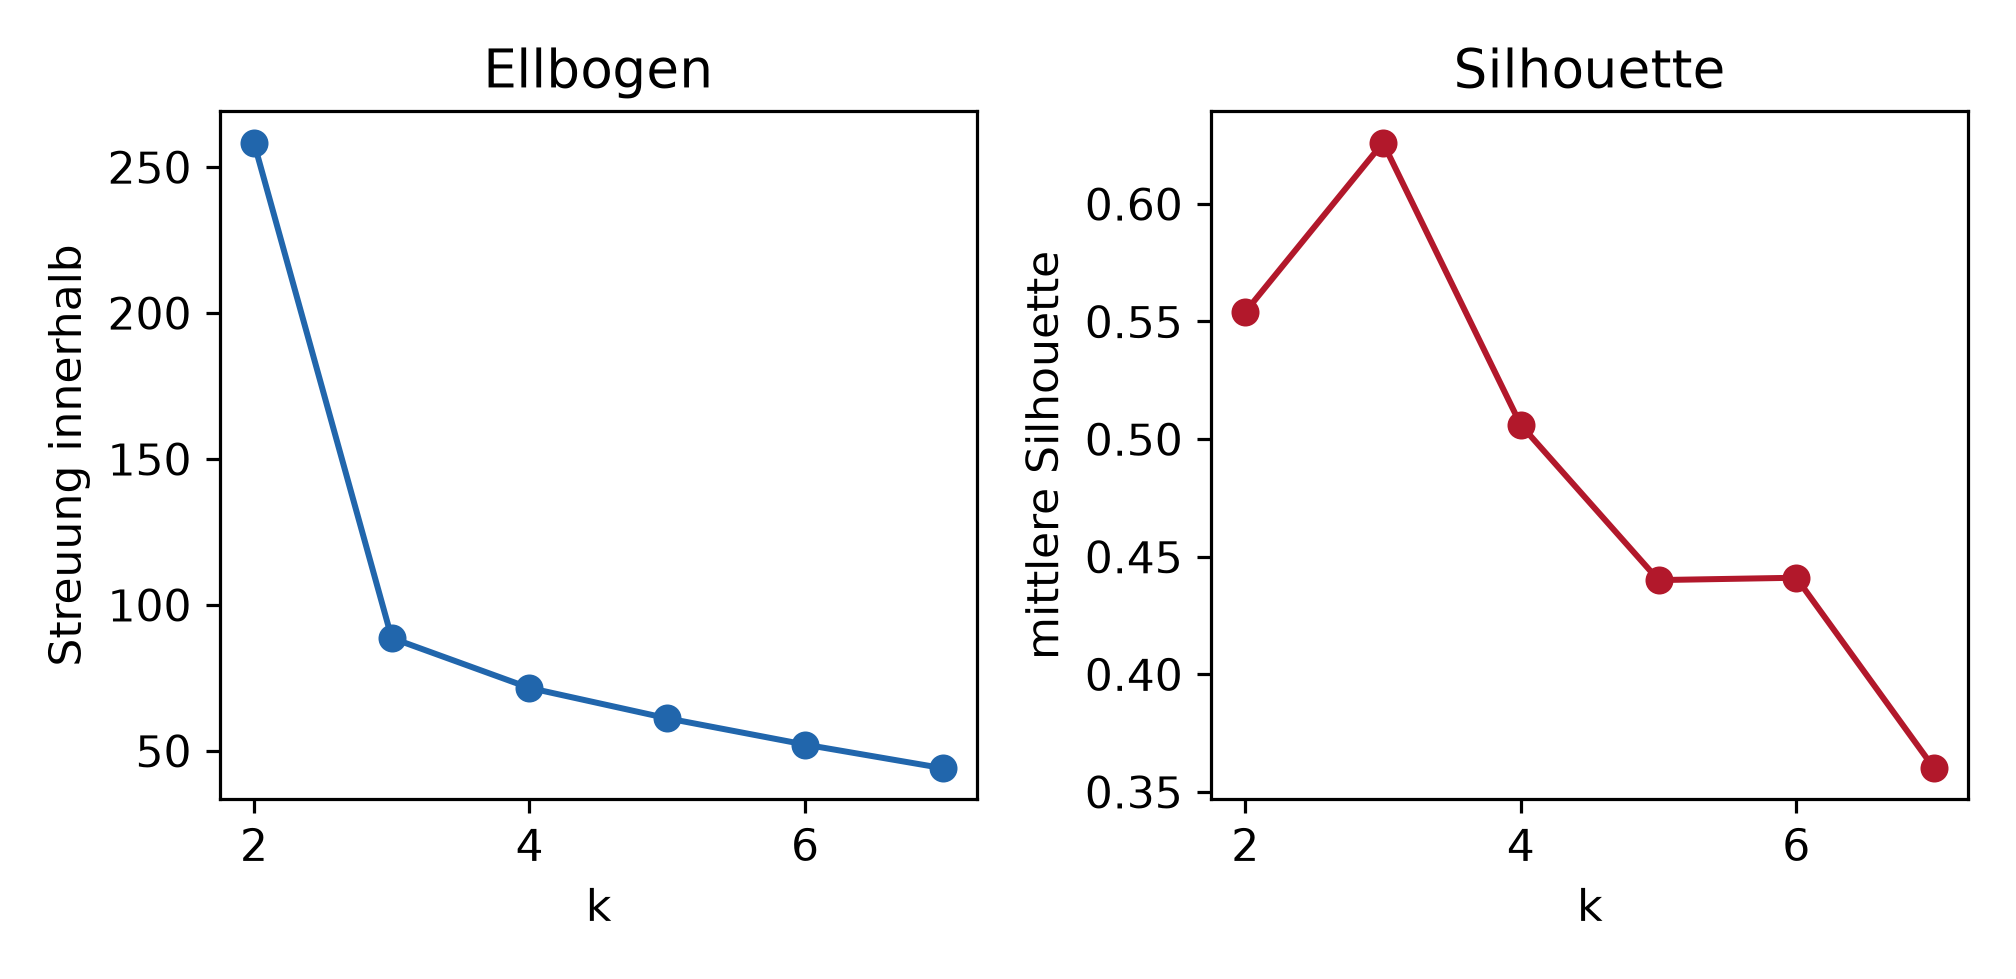
Für jedes k von 2 bis 7 werden drei Kennzahlen nebeneinandergestellt: die Streuung innerhalb der Gruppen, die mittlere Silhouette und die kleinste Gruppengrösse. Welche davon kann k begründen?
Abbildung 2: Beispiel 1: dieselben beiden Verläufe in Python.
print("bestes k nach Silhouette:",int(tabelle.loc[tabelle["silhouette"].idxmax(), "k"]))
bestes k nach Silhouette: 3
Output Zeile für Zeile
k
Streuung innerhalb
mittlere Silhouette
kleinste Gruppe
2
258.3
0.554
59
3
88.6
0.626
58
4
71.5
0.506
49
5
61.1
0.440
27
6
52.1
0.441
24
7
44.0
0.360
27
Spalte
Verlauf
Was daraus folgt
Streuung innerhalb
fällt monoton, von 258 auf 44
Sie kann k nicht begründen, denn sie fällt immer. Brauchbar ist nur die Form des Verlaufs: der Absturz von 258 auf 89, danach ein flaches Auslaufen. Das ist der Ellbogen bei k = 3.
mittlere Silhouette
steigt auf 0.626 und fällt danach
Das entscheidende Verhalten: Anders als die Streuung hat sie ein echtes Maximum. Ein zu grosses k zerschneidet vorhandene Gruppen, die Beobachtungen rücken näher an fremde Gruppen, und der Wert sinkt.
kleinste Gruppe
59, 58, 49, 27, 24, 27
Ab k = 5 entstehen Gruppen von unter 30 Kunden. Kein Gütemass, sondern ein praktisches Argument: Wovon man nicht sinnvoll berichten kann, das braucht man nicht zu trennen.
Silhouette bei k = 6
0.441, minimal über k = 5 mit 0.440
Ein Ausschlag ohne Bedeutung. Er zeigt sich auch daran, dass R hier 0.362 liefert: Ab k = 5 existieren mehrere fast gleich gute Aufteilungen, und welche gefunden wird, hängt vom Startwert ab. Ein Grund, nie das nackte Maximum zu nehmen, sondern den Verlauf anzusehen.
Der Ellbogen ist das bekannteste und schwächste der Kriterien. Hier ist er deutlich, weil die Struktur klar ist; in echten Daten sieht die Kurve oft aus wie eine gleichmässige Rutsche, und dann sehen drei Personen drei verschiedene Knicke. Die Silhouette ist besser, weil sie ein Optimum hat statt einer Neigung.
Interpretation und Ergebnissatz
Der Verlauf der Streuung innerhalb der Gruppen knickt nach k = 3 deutlich ab (258.3 → 88.6 → 71.5), und die mittlere Silhouette hat bei k = 3 ihr Maximum (0.626). Beide Kriterien sprechen für drei Gruppen.
Frage und Datenlage
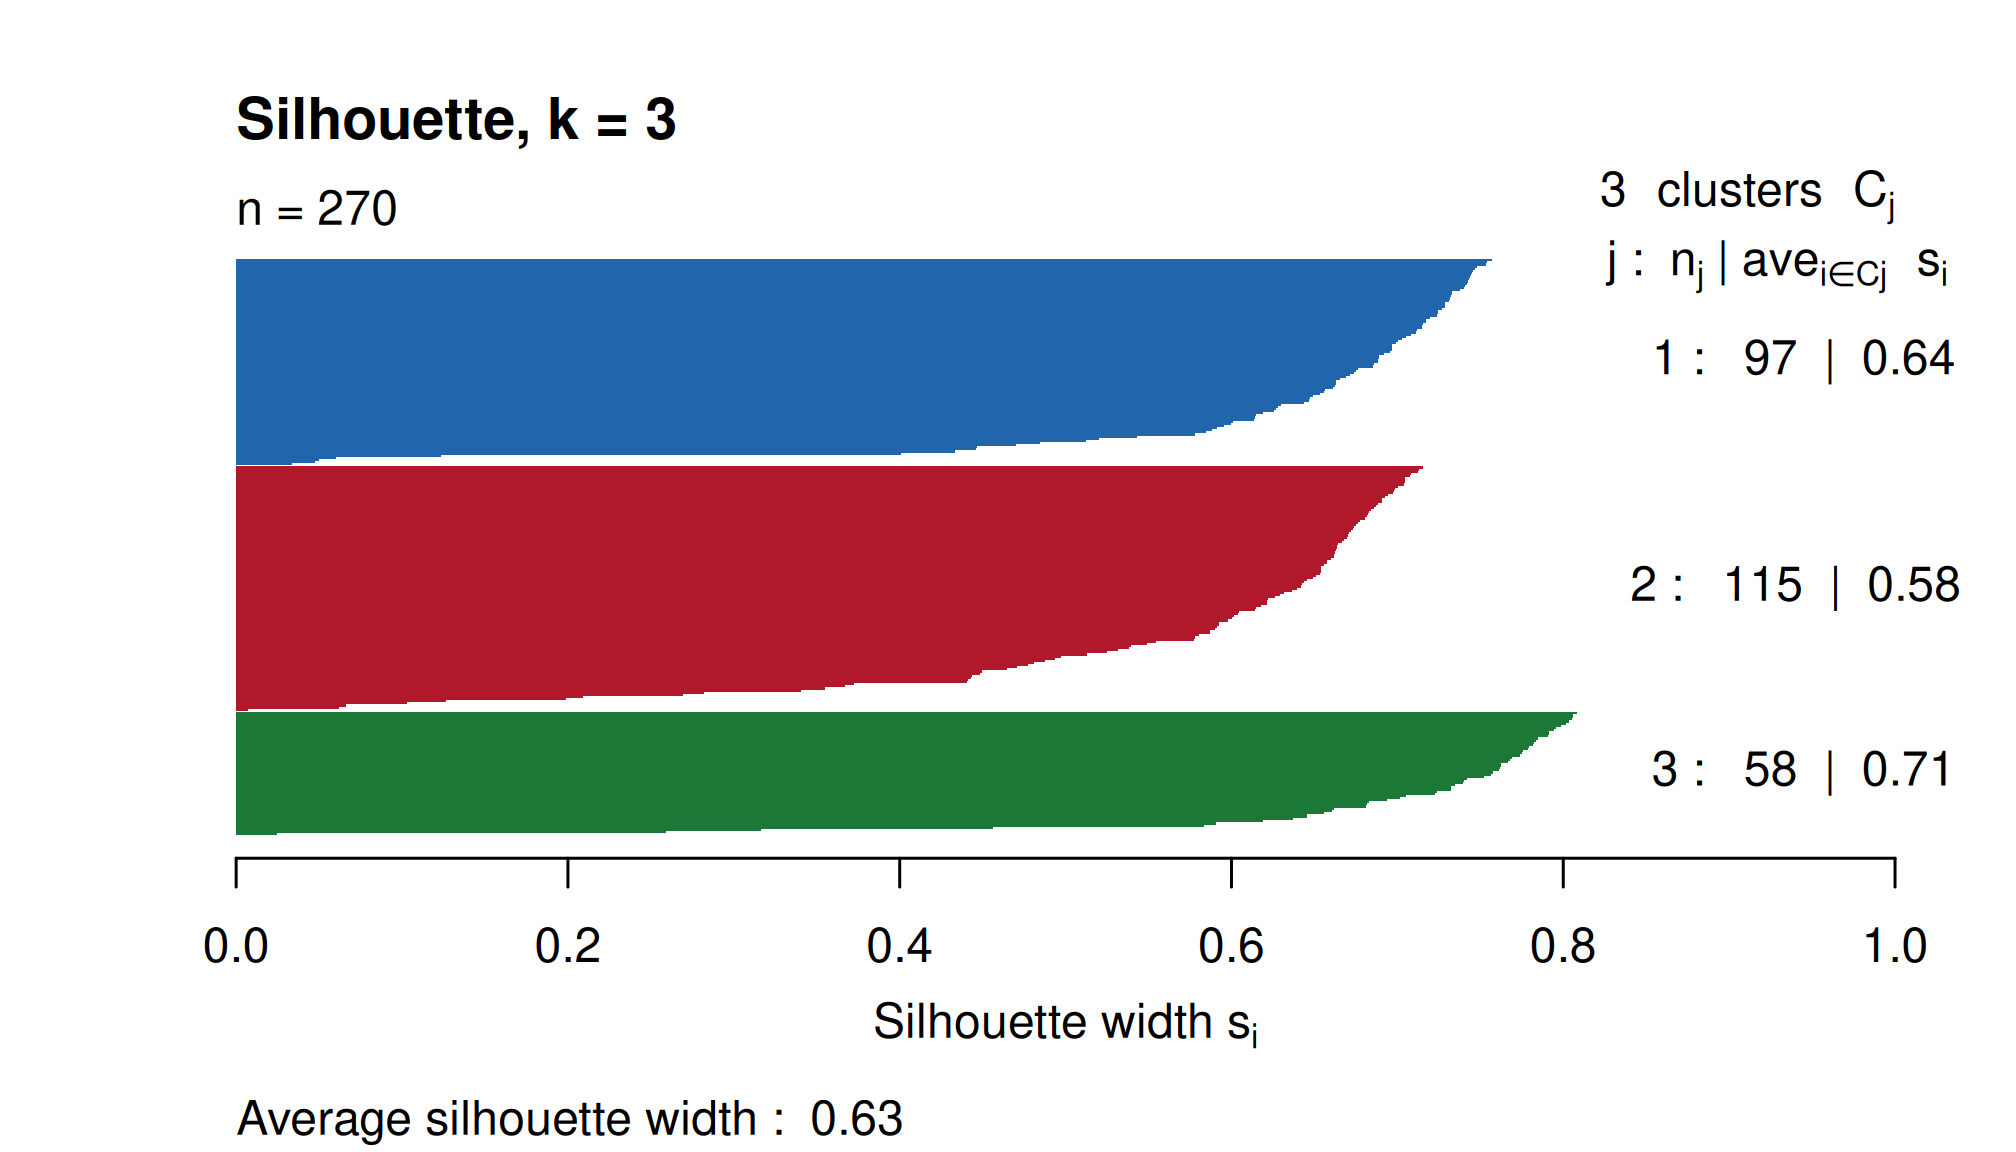
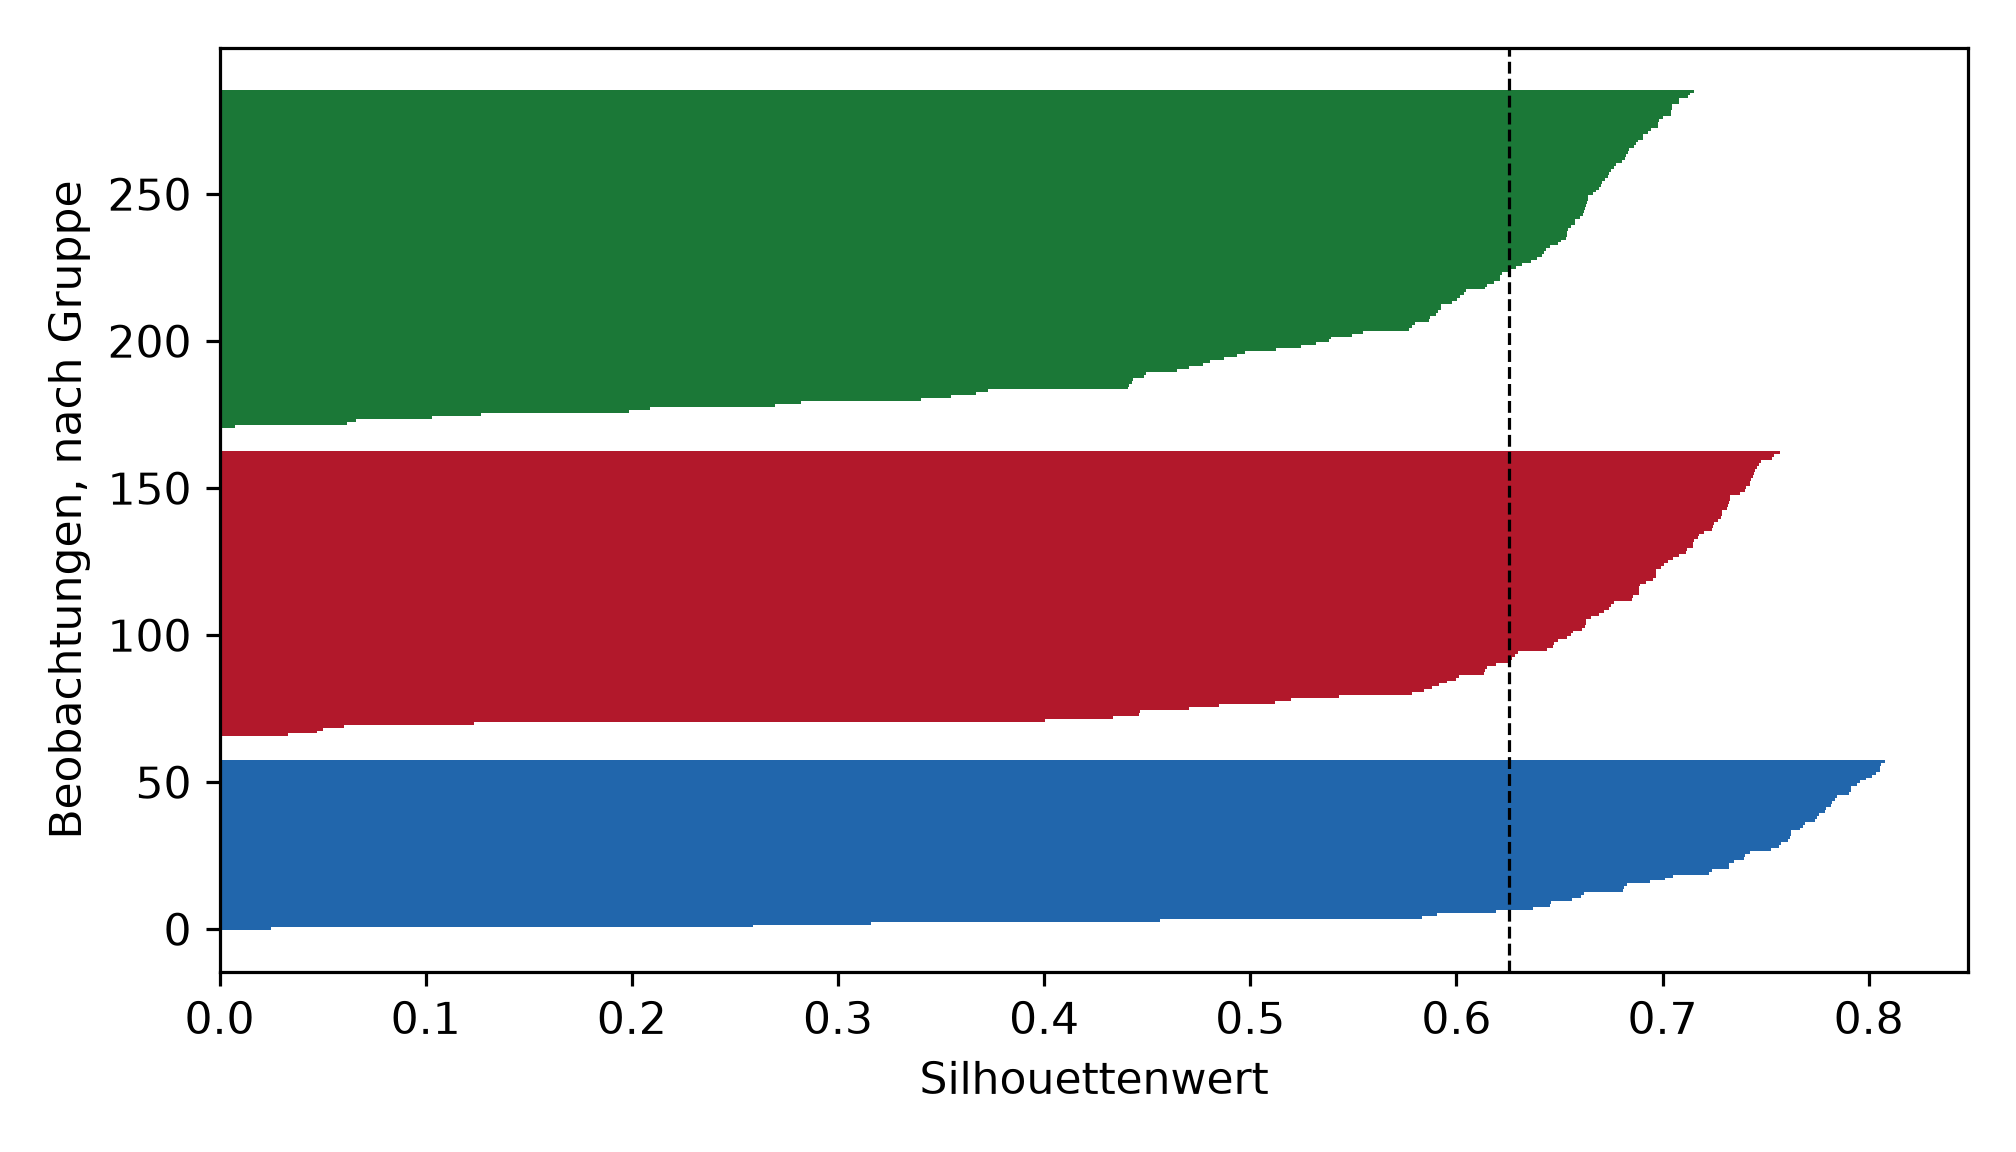
Der Mittelwert von 0.626 verdeckt, wie sich die Werte auf die drei Gruppen verteilen. Das Silhouettendiagramm zeigt jede Beobachtung einzeln.
am besten abgegrenzt: wenige Besuche bei hohem Umsatz, in beiden Merkmalen weit weg von den anderen
Gelegenheitskunden
97
0.636
Stammkunden
115
0.576
am schwächsten abgegrenzt: liegt zwischen den beiden anderen und hat deshalb die kürzeste Distanz zur nächsten fremden Gruppe
gesamt
270
0.626
negative Werte
0
Keine einzige Beobachtung wäre in einer anderen Gruppe besser aufgehoben.
Drei Dinge lassen sich im Diagramm ablesen:
Merkmal im Bild
Bedeutung
Breite der Blöcke
die Gruppengrössen
Höhe je Block
wie gut die Gruppe abgegrenzt ist. Ein deutlich flacherer Block verrät eine schwache Gruppe, auch wenn der Gesamtmittelwert gut aussieht.
Balken links der Null
Beobachtungen, die einer fremden Gruppe näher sind als der eigenen. Wenige sind normal, viele ein Hinweis auf eine schlechte Aufteilung.
Die Spanne von 0.576 bis 0.707 ist der eigentliche Ertrag dieses Beispiels: Die drei Gruppen sind verschieden gut abgegrenzt, und der Mittelwert sagt das nicht. Bei einer Lösung, in der eine Gruppe bei 0.15 läge und zwei bei 0.70, wäre der Mittelwert immer noch gut und die Lösung trotzdem fragwürdig.
Interpretation und Ergebnissatz
Die mittlere Silhouette beträgt 0.63 (n = 270, k = 3), je Gruppe 0.71, 0.64 und 0.58. Keine Beobachtung hat einen negativen Wert. Die Gruppen sind damit durchgehend deutlich abgegrenzt; am schwächsten die grösste Gruppe, die geometrisch zwischen den beiden anderen liegt.
Frage und Datenlage
Der wichtigste Fall dieser Seite. 270 Beobachtungen aus einer einzigen Wolke, also ohne jede Gruppenstruktur. Was sagen Silhouette und Ellbogen dazu?
k = 2 | within:  357.3 | Silhouette: 0.331
k = 3 | within:  245.1 | Silhouette: 0.344
k = 4 | within:  188.4 | Silhouette: 0.337
k = 5 | within:  157.1 | Silhouette: 0.315
k = 6 | within:  127.8 | Silhouette: 0.333
Output Zeile für Zeile
k
Silhouette im Rauschen
Silhouette in den Kundendaten
2
0.331
0.554
3
0.344
0.626
4
0.337
0.506
5
0.315
0.440
6
0.333
0.441
Beobachtung
Deutung
Es gibt ein bestes k, nämlich 3 mit 0.344
Und es ist reiner Zufall. Die Methode liefert immer ein Optimum, weil sie nach dem besten k fragt und nicht danach, ob es überhaupt Gruppen gibt.
Der Wert liegt deutlich über null
0.344 sieht nicht nach “nichts” aus. Nach der verbreiteten Faustregel wäre das eine “schwache, aber erkennbare Struktur”. Es ist keine.
Der Verlauf ist flach
0.331, 0.344, 0.337, 0.315, 0.333, die Werte liegen alle beieinander. Bei den Kundendaten reicht die Spanne von 0.360 bis 0.626. Ein flacher Verlauf ohne ausgeprägtes Maximum ist das Warnzeichen.
Absolute Schwellen versagen
Der Silhouettenwert hängt auch von der Anzahl Dimensionen ab; in höherdimensionalen Daten sind selbst 0.3 im Rauschen keine Seltenheit.
Die Reihenfolge der Fragen entscheidet. Wer zuerst nach der Gruppenzahl fragt, bekommt immer eine Antwort und findet immer Segmente. Sie lassen sich hinterher sogar beschreiben, weil jede Aufteilung Mittelwertunterschiede erzeugt. Erst kommt die Frage, ob Struktur vorliegt und dafür braucht es die Gap-Statistik aus Beispiel 4.
Interpretation
Silhouette und Ellbogen sind Werkzeuge zur Wahl von k unter der Annahme, dass Gruppen existieren. Diese Annahme prüfen sie nicht.
Frage und Datenlage
Die Gap-Statistik vergleicht die erreichte Streuung mit derjenigen in Zufallsdaten gleicher Ausdehnung. Als einzige der drei Methoden wird sie auch für k = 1 berechnet und kann damit “keine Struktur” sagen. Angewendet wird sie auf beide Datensätze: die Kunden und das Rauschen aus Beispiel 3.
k gap SE
1 1.092 0.044
2 0.904 0.039
3 0.885 0.038
4 0.743 0.038
5 0.683 0.031
6 0.689 0.033
print("gewähltes k (Rauschen):", waehle_k(gap_rauschen))
gewähltes k (Rauschen): 1
Output Zeile für Zeile
Kundendaten:
k
1
2
3
4
5
6
7
Gap
0.353
0.577
1.192
0.973
0.913
0.883
0.881
SE
0.042
0.042
0.041
0.037
0.031
0.032
0.036
Rauschen:
k
1
2
3
4
5
6
Gap
1.092
0.904
0.885
0.743
0.683
0.689
SE
0.044
0.039
0.038
0.038
0.031
0.033
Ausgabe
Wert hier
Wie er zu lesen ist
Kunden, Gap bei k = 3
1.192, klar der höchste
Die echten Daten lassen sich bei drei Gruppen erheblich besser teilen als gleichmässig gestreute Zufallsdaten desselben Wertebereichs.
Kunden, Auswahlregel
k = 3
Bei k = 1 und k = 2 liegt der Gap unter dem des jeweils nächsten k abzüglich SE, die Regel geht also weiter. Bei k = 3 ist 1.192 grösser als 0.973 - 0.037, also wird gestoppt.
Rauschen, Gap bei k = 1
1.092, der höchste Wert
Die Aufteilung in mehr als eine Gruppe verbessert nichts gegenüber Zufallsdaten.
Rauschen, Auswahlregel
k = 1
Die einzige der drei Methoden, die diese Antwort überhaupt geben kann. Ellbogen und Silhouette haben in Beispiel 3 fröhlich k = 3 empfohlen.
Standardfehler
um 0.03 bis 0.04
Die Streuung über die B = 20 Referenzdatensätze. Er verhindert, dass die Regel auf zufällige Ausschläge reagiert.
Warum die Referenzdaten gleichverteilt sind und nicht normalverteilt: Die Gleichverteilung über den Wertebereich ist die strukturloseste Verteilung, die denselben Raum füllt. Eine Normalverteilung hätte selbst eine Verdichtung in der Mitte, also bereits eine Art Struktur.
R bringt das Verfahren als cluster::clusGap() fertig mit, samt maxSE() für die Auswahlregel. Hier ist es von Hand implementiert, damit R und Python dieselben Zahlen liefern: clusGap() zieht seine Referenzdaten zufällig, die Funktion oben deterministisch.
Interpretation und Ergebnissatz
Die Gap-Statistik (B = 20 gleichverteilte Referenzdatensätze) erreicht ihr Maximum bei k = 3 (Gap 1.19, SE 0.04); die Auswahlregel nach Tibshirani bestätigt k = 3. In den strukturlosen Vergleichsdaten empfiehlt dieselbe Rechnung k = 1, obwohl Silhouette und Ellbogen dort ein Optimum bei k = 3 anzeigen.
Frage und Datenlage
Alle bisherigen Masse beurteilen eine Aufteilung auf einem Datensatz. Sie sagen nichts darüber, ob dieselbe Lösung bei leicht anderen Daten wieder entstünde. Das prüft man durch Wiederholung auf Teilstichproben: 20-mal 80 Prozent der Kunden, jeweils neu geclustert.
Praktisch identisch mit den 0.626 auf den vollen Daten.
Spanne
0.6067 bis 0.6518
Eine Breite von 0.045. Alle 20 Läufe liegen deutlich über der Faustregel von 0.5.
Standardabweichung
0.0118
Weniger als zwei Hundertstel. Die Lösung hängt nicht an einzelnen Beobachtungen.
kleinste Gruppe
41 bis 53
Zu erwarten wären rund 80 Prozent von 58, also etwa 46. Die Schwankung passt zur Ziehung und nicht zu einer wechselnden Aufteilung. Dass die Grössenverhältnisse erhalten bleiben, ist wichtiger noch als der Kennzahlwert.
Was ein instabiles Ergebnis aussähe: eine Spanne von etwa 0.35 bis 0.65, oder Gruppengrössen, die zwischen den Läufen zwischen 10 und 90 springen. Dann hinge die Aufteilung an wenigen Beobachtungen, und das gehört in den Bericht, auch wenn der Wert auf den vollen Daten gut aussieht.
Die Silhouette ist dabei nur ein Stellvertreter. Aussagekräftiger, aber aufwendiger ist der direkte Vergleich der Zuordnungen über den bereinigten Rand-Index: Landen dieselben Kunden in denselben Gruppen?
Interpretation und Ergebnissatz
Auf 20 Teilstichproben zu je 80 Prozent bleibt die mittlere Silhouette bei 0.61 bis 0.65 (Mittel 0.63, SD 0.01), und die Gruppengrössenverhältnisse bleiben erhalten. Die Dreigruppenlösung ist damit stabil.
Verständnisfragen
In strukturlosen Zufallsdaten ergibt die Silhouette ein Maximum von 0.344 bei k = 3. Was folgt daraus?
Nichts über die Existenz von Gruppen
Richtig. Silhouette und Ellbogen beantworten die Frage nach dem besten k unter der Annahme, dass Gruppen existieren. Sie prüfen diese Annahme nicht und liefern deshalb auch in Rauschen ein Optimum.
Es gibt eine schwache, aber erkennbare Struktur
Genau das legt der Wert nahe, und genau das ist die Falle. Die Daten stammen aus einer einzigen Wolke.
Die Daten müssen standardisiert werden
Sie waren es bereits.
Welches der drei Kriterien kann die Antwort “keine Gruppenstruktur” liefern?
Die Gap-Statistik
Richtig, weil sie als einzige auch für k = 1 berechnet wird und mit Zufallsdaten derselben Ausdehnung vergleicht. Ist der Gap bei k = 1 am grössten, liegt keine Struktur vor.
Die Silhouette
Sie ist für k = 1 nicht definiert; es gibt dann keine nächste fremde Gruppe.
Der Ellbogen
Die Streuung innerhalb sinkt mit k, ganz gleich ob Gruppen existieren.
Die mittlere Silhouette beträgt 0.62. Je Gruppe ergeben sich 0.71, 0.64 und 0.58. Was ist die Lehre daraus?
Die Gruppen sind unterschiedlich gut abgegrenzt, und der Mittelwert zeigt das nicht
Richtig. Hier ist die Spanne harmlos; läge eine Gruppe bei 0.15 und zwei bei 0.70, wäre der Mittelwert immer noch gut und die Lösung trotzdem fragwürdig. Deshalb gehören die Werte je Gruppe in den Bericht.
Die Lösung ist schlecht, weil eine Gruppe unter 0.6 liegt
0.58 ist ein guter Wert; die Schwellen sind ohnehin Konvention.
Der Mittelwert wurde falsch berechnet
Er ist das mit den Gruppengrössen gewichtete Mittel der Einzelwerte, nicht der Gruppenmittel.
Warum sind die Referenzdaten der Gap-Statistik gleichverteilt und nicht normalverteilt?
Weil die Gleichverteilung über den Wertebereich die strukturloseste Verteilung ist
Richtig. Eine Normalverteilung hätte eine Verdichtung in der Mitte, also bereits eine Art Struktur, und der Vergleich wäre zu milde.
Weil sie schneller zu erzeugen ist
Der Unterschied im Aufwand ist vernachlässigbar.
Weil die echten Daten nicht normalverteilt sind
Die Verteilung der echten Daten spielt für die Wahl der Referenz keine Rolle.
Auf 20 Teilstichproben schwankt die mittlere Silhouette zwischen 0.61 und 0.65. Was sagt das?
Die Lösung ist stabil, sie hängt nicht an einzelnen Beobachtungen
Richtig. Eine Spanne von 0.045 bei einem Mittel von 0.63 ist schmal. Zusätzlich lohnt sich der Blick auf die Gruppengrössen: Bleiben auch die Verhältnisse erhalten?
Die Silhouette ist unzuverlässig
Sie schwankt, weil die Daten wechseln, nicht weil das Mass ungenau wäre.
Es hätten mehr Teilstichproben gezogen werden müssen
Bei dieser geringen Streuung ändern mehr Ziehungen am Bild nichts.